VAE: подробное описание и генерация изображений MNIST
В этом руководстве от мотивации VAE, вероятностной модели, вывода ELBO и итоговой цели обучения переходим к реализации генерации изображений MNIST. Главное — понять, почему VAE устроен именно так, и как при обучении и генерации проверить, действительно ли модель выучила латентное пространство, из которого можно сэмплировать.
0. Путь изучения
Основную линию VAE можно свести к четырём шагам:
- Обычный автоэнкодер умеет восстанавливать данные, но его латентное пространство не обязательно пригодно для случайного сэмплирования.
- Модель с латентной переменной описывает схему «сначала сэмплируем , затем генерируем », но предельное правдоподобие трудно вычислить напрямую.
- VAE вводит приближённое апостериорное распределение и использует ELBO вместо непосредственно не оптимизируемого истинного правдоподобия.
- Итоговая цель обучения — «функция потерь реконструкции + функция потерь KL»: модель должна хорошо восстанавливать данные и одновременно держать латентное пространство близким к стандартному нормальному распределению.
VAE — генеративная модель с вероятностным латентным пространством. Она объединяет способность автоэнкодера к реконструкции и вероятностный подход вариационного вывода, благодаря чему можно сэмплировать из простого априорного распределения и генерировать новые данные.
1. Зачем нужен VAE
1.1 Что на самом деле хочет выучить генеративная модель
Пусть есть обучающие данные:
Генеративная модель стремится выучить истинное распределение данных:
где — данные, — параметры модели. Цель обучения по максимуму правдоподобия:
Эта цель означает: реальные образцы должны получать высокую вероятность в распределении модели.
После обучения генеративная модель должна уметь:
- оценивать, похож ли образец на реальные данные;
- случайно сэмплировать новые образцы;
- интерполировать и управлять в латентном пространстве;
- выявлять низкоразмерную структуру, лежащую в основе данных.
1.2 Проблемы обычного автоэнкодера
Обычный автоэнкодер устроен так:
Цель — чтобы реконструкция была близка к исходному входу :
Обычный AE подходит для сжатия, снижения размерности, удаления шума и обучения признаков, но сам по себе он не является генеративной моделью. Причина в том, что энкодер AE выдаёт одну точку:
Это лишь гарантирует, что обучающие образцы отображаются в какие-то точки латентного пространства, но не гарантирует, что всё пространство непрерывно, регулярно и пригодно для сэмплирования.
Поэтому возникают три проблемы:
- В латентном пространстве могут быть «дыры».
- Случайно сэмплированные не обязательно дают осмысленные образцы.
- Интерполяция между двумя образцами в латентном пространстве может давать бессмысленные результаты.
Обычный AE умеет восстанавливать, но не гарантирует генерацию.
1.3 Естественная идея латентной генеративной модели
Чтобы генерировать данные, можно предположить, что за каждым образцом стоит латентная переменная . Процесс генерации:
Обычно априорное распределение берут стандартным нормальным:
Совместное распределение:
Если модель удаётся обучить, генерация сводится к тому, чтобы сэмплировать из и пропустить его через декодер, получив .
1.4 Почему прямое обучение латентной модели трудно
В обучающих данных есть только , но нет соответствующих . Поэтому обучение опирается на предельное правдоподобие:
Если декодер — нейросеть, этот интеграл обычно не имеет аналитического решения. Причины:
- — многомерная непрерывная переменная;
- задаётся сложной нелинейной нейросетью;
- интеграл не имеет аналитического решения;
- численное интегрирование для каждого образца слишком дорого.
Истинное апостериорное распределение тоже не вычислить напрямую:
Поскольку знаменатель не вычисляется, тоже недоступно.
Ключевой ход VAE — заменить истинное апостериорное распределение обучаемым приближённым распределением и построить оптимизируемую нижнюю границу.
1.5 Базовая модель VAE
В VAE есть три вероятностных объекта:
- Априорное распределение:
- Распределение генерации:
- Приближённое апостериорное распределение:
В нейросетевой реализации:
- энкодер задаёт ;
- декодер задаёт ;
- стандартное нормальное распределение задаёт .
Энкодер больше не выдаёт одну точку, а выдаёт распределение:
То есть он выводит среднее и логарифм дисперсии . Затем из этого распределения сэмплируется , который подаётся в декодер для реконструкции или генерации.
Главное отличие VAE от обычного AE:
Это изменение превращает латентную переменную из «точки кодирования» в «распределение», и именно это создаёт основу для случайной генерации и регуляризации латентного пространства.
2. Вывод модели VAE
В этом разделе рассмотрены два пути вывода. Они дают один и тот же ELBO, но отвечают на разные вопросы.
-
Путь 1: неравенство Йенсена
Отвечает на вопрос: почему можно превратить невычислимое в оптимизируемую нижнюю границу. -
Путь 2: разложение правдоподобия
Отвечает на вопрос: чем ELBO отличается от истинного .
2.1 Путь 1: получаем оптимизируемую нижнюю границу через неравенство Йенсена
Цель этого пути — из исходной цели построить нижнюю границу, которую можно оптимизировать.
VAE изначально хочет максимизировать предельное логарифмическое правдоподобие:
Проблема в том, что интеграл невычислим. Поскольку в обучающих данных есть только , а не наблюдается, все возможные нужно проинтегрировать.
Первый шаг — умножить и разделить подынтегральное выражение на распределение :
Это не меняет значения, так как мы одновременно умножаем и делим на одну и ту же величину. Цель такого преобразования — переписать интеграл как математическое ожидание по :
Второй шаг — внести логарифм под знак математического ожидания с помощью неравенства Йенсена. Поскольку — вогнутая функция:
Положим:
Получаем:
Правая часть и есть ELBO:
Поэтому VAE оптимизирует не невычислимое , а его нижнюю границу:
Теперь разложим ELBO на реализуемую форму. Из совместного распределения:
получаем:
Разделяем член реконструкции и член KL:
Это итог пути 1:
В нём два члена:
- — член реконструкции, который побуждает декодер восстанавливать из ;
- — член априорной регуляризации, который побуждает распределение энкодера приближаться к стандартному нормальному распределению.
При обучении обычно минимизируют отрицательный ELBO:
То есть:
Если:
и:
то член KL имеет аналитическое решение:
Если сеть выводит , обозначаемый logvar, то часто записывают:
2.2 Путь 2: понимаем разрыв между ELBO и правдоподобием через разложение
Этот путь не начинает с неравенства Йенсена, а сразу раскладывает истинное логарифмическое правдоподобие на две части. Цель — объяснить, почему ELBO является нижней границей и насколько она отличается от искомой величины.
Поскольку не зависит от :
Далее переписываем через байесовское соотношение. Из:
получаем:
Затем вводим в дробь:
Разбиваем произведение под логарифмом на сумму:
Первый член — ELBO:
Второй член — KL-дивергенция между приближённым и истинным апостериорным распределениями:
Итак:
Поскольку KL-дивергенция всегда неотрицательна:
имеем:
Это итог пути 2:
ELBO является нижней границей, потому что отличается от истинного на неотрицательную величину — KL-дивергенцию апостериорного распределения.
Этот путь также объясняет два разных KL-члена:
- — теоретическая разница между апостериорными распределениями, которая объясняет разрыв между ELBO и истинным правдоподобием, но не может вычисляться напрямую, так как истинное апостериорное распределение недоступно;
- — априорный член в функции потерь, который можно вычислять напрямую и который делает латентное пространство близким к стандартному нормальному распределению.
Оба пути приводят к одной и той же цели обучения. Итоговая модель VAE устроена так:
- энкодер выводит и ;
- с помощью репараметризации получаем ;
- декодер реконструирует или генерирует изображение из ;
- функция потерь состоит из члена реконструкции и члена KL.
3. Реализация VAE на коде
В этом разделе фрагменты кода поясняют способ реализации. Полный код находится в файлах:
code/train_mnist_unet_vae.pycode/generate_mnist_unet_vae.py
Набор данных — MNIST. Он скачивается автоматически, поэтому о данных беспокоиться не нужно; достаточно самостоятельно установить torch.
Здесь модель использует структуру в духе U-Net с каскадной свёрточной субдискретизацией и повышением разрешения. Важно: на этапе генерации есть только случайная латентная переменная и нет входного изображения, поэтому нельзя опираться на пропускные признаки (skip feature) из входа. В коде используется «иерархическая свёрточная структура в духе U-Net», а не полноценный U-Net с пропусками от входа.
3.1 Структура модели
Основная модель в скрипте обучения — UNetVAE. Энкодер уменьшает изображение MNIST до высокоразмерных признаков, а затем выводит mu и logvar:
self.enc1 = nn.Sequential(nn.Conv2d(1, base, 3, padding=1), nn.GroupNorm(4, base), nn.SiLU())
self.enc2 = nn.Sequential(nn.Conv2d(base, base * 2, 4, stride=2, padding=1), nn.GroupNorm(8, base * 2), nn.SiLU())
self.enc3 = nn.Sequential(nn.Conv2d(base * 2, base * 4, 4, stride=2, padding=1), nn.GroupNorm(8, base * 4), nn.SiLU())
self.fc_mu = nn.Linear(base * 4 * 7 * 7, latent_dim)
self.fc_logvar = nn.Linear(base * 4 * 7 * 7, latent_dim)
Декодер проецирует латентную переменную обратно в карту признаков , а затем поэтапно повышает разрешение до :
self.fc_dec = nn.Linear(latent_dim, base * 4 * 7 * 7)
self.dec1 = nn.Sequential(nn.ConvTranspose2d(base * 4, base * 2, 4, stride=2, padding=1), nn.GroupNorm(8, base * 2), nn.SiLU())
self.dec2 = nn.Sequential(nn.ConvTranspose2d(base * 2, base, 4, stride=2, padding=1), nn.GroupNorm(4, base), nn.SiLU())
self.out = nn.Conv2d(base, 1, 3, padding=1)
Выходной слой не подключает sigmoid напрямую; при обучении используется binary_cross_entropy_with_logits. Так вычисления численно устойчивее.
3.2 Репараметризация
Исходная форма выборки:
Репараметризация записывает её так:
Код:
std = torch.exp(0.5 * logvar)
eps = torch.randn_like(std)
z = mu + std * eps
Таким образом, случайность приходит из eps, а z — дифференцируемая функция mu и logvar, поэтому градиенты проходят от декодера к энкодеру.
После репараметризации модель при обучении фактически вычисляет дифференцируемую оценку отрицательного ELBO. Для одного обучающего образца поток вычислений можно записать так:
Тогда цель для одного образца:
Если выходное распределение декодера — гауссово:
то после отбрасывания констант, не зависящих от параметров модели, член реконструкции эквивалентен среднеквадратичной ошибке, и фактически оптимизируется выражение:
Здесь первый член — ошибка реконструкции, второй — KL-дивергенция между и стандартным нормальным априорным распределением . При обучении с мини-батчем обычно берут среднее по образцам батча:
В приведённом ниже коде MNIST энкодер выводит logvar, то есть , поэтому KL-член записывается так:
Если член реконструкции использует binary_cross_entropy_with_logits, то итоговый loss кода реализует эту цель для батча:
3.3 Цель обучения
Пиксели MNIST нормированы в , поэтому для члена реконструкции используется бинарная перекрёстная энтропия. В скрипте обучения применяется её версия на логитах:
recon_loss = F.binary_cross_entropy_with_logits(recon_logits, x, reduction="sum") / x.size(0)
kl_loss = -0.5 * torch.sum(1 + logvar - mu.pow(2) - logvar.exp()) / x.size(0)
loss = recon_loss + beta * kl_loss
Здесь beta — вес KL. В начале обучения можно использовать прогрев KL (KL warm-up):
beta = min(1.0, epoch / max(1, args.warmup_epochs)) * args.beta
Так модель сначала учится базовой реконструкции, а затем постепенно усиливается ограничение на латентное пространство, что помогает смягчить эффект «исчезновения KL».
3.4 Выходные данные скрипта обучения
train_mnist_unet_vae.py сохраняет:
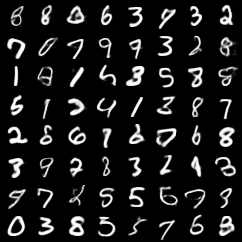
checkpoints/mnist_unet_vae.pt— веса модели и конфигурацию;outputs/recon_epoch_XXX.png— сравнение исходных изображений и реконструкций;outputs/sample_epoch_XXX.png— изображения, сгенерированные из стандартного нормального априорного распределения.
Запуск:
python train_mnist_unet_vae.py --epochs 20 --batch-size 128 --latent-dim 32
Если есть CUDA, скрипт автоматически использует GPU.
Результаты выполнения:
(1)Результат реконструкции исходных изображений
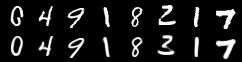
(2)Результат генерации по выборке
3.5 Проверка скрипта генерации
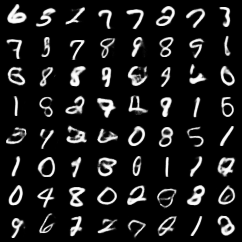
generate_mnist_unet_vae.py выполняет только генерацию:
- загружает обученный checkpoint;
- сэмплирует ;
- подаёт его в декодер;
- сохраняет сетку сгенерированных изображений.
Запуск:
python generate_mnist_unet_vae.py --checkpoint checkpoints/mnist_unet_vae.pt --num-samples 64
Скрипту генерации не нужны обучающие данные: он опирается только на обученный декодер.
Результат тестовой генерации:
3.6 Практические приёмы реализации
-
Лучше выводить
logvar.
Прямой вывод дисперсии может давать отрицательные значения или численный взрыв. Логарифм дисперсии стабильнее. -
Записывайте отдельно члены реконструкции и KL.
Только общий loss — недостаточно. KL, близкий к 0, может означать, что латентная переменная не используется. -
Сохраняйте изображения реконструкции и генерации.
По реконструкции видно, научились ли энкодер и декодер сжимать и восстанавливать; по сгенерированным образцам — пригодно ли латентное пространство для генерации. -
Структура в духе U-Net должна подходить задаче генерации.
Классический U-Net использует пропускные соединения от входа. В VAE при генерации входного изображения нет, поэтому здесь используется иерархическая свёрточная структура без пропусков от входа. -
Не увеличивайте размерность латентного пространства без разбора.
Для MNIST можно начинать с 16, 32 или 64. Слишком маленькая размерность даёт плохую реконструкцию, слишком большая может оставить часть измерений неиспользуемыми.
4. Частые вопросы
4.1 Не является ли VAE обычным AE с добавлением шума?
Нет. Основа VAE — вероятностная латентная модель и цель обучения ELBO. Шум — лишь часть выборки из апостериорного распределения.
4.2 Почему VAE может генерировать изображения из случайного
При обучении KL-член приближает к . Поэтому после обучения , взятый из стандартного нормального распределения, с большей вероятностью попадает в область, которую декодер умеет декодировать.
4.3 Почему в коде обучения используются логиты
Для MNIST с бинарной перекрёстной энтропией binary_cross_entropy_with_logits стабильнее, чем сначала применить sigmoid, а затем BCE. Сигмоиду применяют при генерации и сохранении изображений.
4.4 Почему не используются пропуски (skip) из традиционного U-Net
Пропуски классического U-Net передают признаки входного изображения в декодер. При генерации VAE входного изображения нет, есть только случайный , поэтому такие входные признаки использовать нельзя. Здесь применяется структура в духе U-Net с каскадной субдискретизацией и повышением разрешения.
5. Итоги
Итоговая модель VAE состоит из трёх частей:
Итоговая цель обучения:
где:
Ценность VAE в том, что модель не просто учится воспроизводить вход, а организует данные в непрерывное, регулярное и пригодное для выборки латентное пространство. Такое пространство позволяет генерировать новые образцы, интерполировать и заниматься обучением представлений.
6. Задания для самопроверки
- Почему обычный AE не гарантирует эффективность случайной выборки?
- Почему VAE заставляет энкодер выводить распределение, а не точку?
- Почему трудно оптимизировать напрямую?
- Как из неравенства Йенсена получается ELBO?
- Что показывает соотношение ?
- Почему KL-член в функции потерь обучения — это ?
- Почему трюк репараметризации делает процесс выборки обучаемым?
- Что может означать KL-потеря, близкая к 0?
- Почему при оценке VAE нужно смотреть одновременно на изображения реконструкции и на случайно сэмплированные образцы?