DDPM: подробное описание и реализация в коде
В этом руководстве мы начинаем с ограничений VAE, объясняем, почему DDPM заменяет «генерацию за один шаг» на «многошаговое удаление шума», и шаг за шагом выводим прямой процесс добавления шума, обратную генерацию, ELBO, истинное апостериорное распределение, цель предсказания шума, а затем итоговые формулы обучения и сэмплирования.
0. Путь изучения
Основную линию DDPM можно свести к пяти шагам:
- VAE генерирует изображение через латентную переменную за один шаг, но допущения о сжатии и реконструкции могут приводить к потере деталей.
- DDPM не старается сразу создать полное изображение, а сначала задаёт фиксированный процесс добавления шума, который постепенно превращает реальное изображение в гауссов шум.
- При генерации мы начинаем с гауссова шума и обучаем нейросеть понимать, как на каждом шаге убрать немного шума.
- Строгий вывод опирается на максимальное правдоподобие и ELBO, но в итоге задача упрощается до интуитивной задачи обучения с учителем: предсказать шум, добавленный к изображению.
- При реализации ключевое — не сложная функция потерь, а правильная работа с расписанием шума, временными шагами, входами и выходами U-Net, формулой сэмплирования и диапазоном значений.
DDPM постепенно добавляет шум к изображению, пока оно не станет почти чистым шумом, а затем обучает модель обратному процессу — шаг за шагом убирать шум. Так сложная задача «сгенерировать изображение за один шаг» разбивается на множество простых задач «предсказать и убрать немного шума».
Наиболее распространённая цель обучения DDPM:
где:
То есть при обучении мы знаем истинный шум , а сеть должна по зашумлённому изображению и шагу предсказать этот шум.
1. Зачем нужен DDPM
1.1 Проблемы VAE
VAE важен, но у него есть несколько типичных проблем.
Во-первых, VAE обычно сжимает изображение в низкоразмерную латентную переменную:
Если ёмкость недостаточна, детали теряются, и генерируемые изображения часто выходят размытыми.
Во-вторых, член реконструкции VAE часто соответствует поточечному правдоподобию. Для гауссова правдоподобия максимизация обычно эквивалентна минимизации среднеквадратичной ошибки. Среднеквадратичная ошибка поощряет модель выдавать «усреднённый ответ», а усреднённые изображения часто выглядят недостаточно резкими.
В-третьих, VAE генерирует из за один шаг:
Это требует, чтобы декодер за один прямой проход перешёл от абстрактной семантики к всем пиксельным деталям. Для сложных изображений такая нагрузка очень велика.
Основное противоречие VAE можно понимать так:
Он хочет генерировать изображения из регулярного, пригодного для выборки латентного пространства, но сжатие и однократное декодирование могут терять высокочастотные детали.
1.2 Как DDPM меняет подход
DDPM больше не рассматривает генерацию как:
а как:
Здесь:
- — реальное чистое изображение;
- — изображения, которые постепенно зашумляются;
- близко к стандартному гауссову шуму.
При генерации сначала сэмплируется:
а затем на каждом шаге выполняется простая операция:
По текущему зашумлённому изображению предсказать шум и убрать немного шума.
Преимущества DDPM:
- Стабильная цель обучения; не нужно состязательное обучение, как в GAN.
- Каждый шаг решает простую задачу — локальное удаление шума.
- Генерация происходит в пространстве изображений постепенно, и не нужно сжимать все детали в маленькую латентную переменную.
- U-Net может сохранять пространственные детали на разных масштабах.
- Из вывода по ELBO можно получить простую MSE-цель для предсказания шума.
2. Базовая постановка DDPM
DDPM включает два процесса:
- Прямой процесс диффузии: фиксированное правило, не требующее обучения; постепенно добавляет шум к реальному изображению.
- Обратный процесс генерации: обучаемый; из шума постепенно восстанавливает изображение.
2.1 Прямой процесс диффузии
Прямой процесс начинается с реального изображения :
DDPM задаёт его как цепь Маркова:
Марковская цепь означает: если известно , то для получения не нужно напрямую смотреть на более ранние состояния.
Добавление шума на каждом шаге задаётся так:
Здесь:
- — интенсивность шума на шаге ;
- означает, что в каждом измерении добавляется независимый гауссов шум с дисперсией ;
- сохраняет часть сигнала предыдущего изображения.
Обычно вводят:
Тогда:
2.2 Переход от распределения к формуле сэмплирования
Если:
то можно записать:
Применяя это к одношаговому прямому распределению DDPM:
получаем:
где:
Это формула одношагового добавления шума.
2.3 Почему коэффициенты берутся с квадратным корнем
Многие новички спрашивают: почему , а не ?
Предположим, что дисперсия примерно равна , а дисперсия шума тоже равна . Если:
то дисперсия примерно равна:
То есть после каждого шага добавления шума общий масштаб не становится внезапно больше или меньше.
Если же взять:
то дисперсия станет:
и она уже не будет точно равна . Поэтому в DDPM используется квадратный корень: он сохраняет стабильное соотношение дисперсий сигнала и шума.
3. От одношагового добавления шума к добавлению шума на произвольном шаге
При обучении DDPM добавлять шум от до шаг за шагом было бы медленно. К счастью, у прямого процесса есть замкнутая формула, которая позволяет напрямую получить из для любого шага.
Итоговая формула:
где:
Соответствующая формула сэмплирования:
где:
Эта формула очень важна. Она означает, что при обучении можно случайно выбрать шаг и сразу построить соответствующее зашумлённое изображение .
3.1 Разворачиваем замкнутую формулу в два шага
Формула одного шага:
Запишем предыдущий шаг:
Подставим в первую формулу:
Раскроем скобки:
Последние два члена — линейные комбинации независимых гауссовых шумов, поэтому они тоже гауссовы. Их дисперсия равна:
Поэтому их можно объединить в один новый стандартный гауссов шум :
Продолжая подстановку до , получим:
Определим:
и получим формулу для произвольного шага:
3.2 Почему близок к стандартному гауссову шуму
Поскольку:
а:
при достаточно большом :
Подставим в:
Первый член исчезает:
а второй превращается в:
Итак:
Это объясняет, почему генерация может начинаться с чистого гауссова шума.
4. Обратный процесс диффузии
Прямой процесс задан вручную и не обучается. Обучению подлежит обратный процесс:
Совместное распределение модели:
где:
Обратный шаг также обычно задаётся гауссовым распределением:
Здесь:
- — обратное среднее, предсказываемое нейросетью;
- — обратная дисперсия, которую в базовых реализациях часто фиксируют и не обучают;
- вход сети — зашумлённое изображение и шаг ;
- выход сети можно задать как среднее, предсказание исходного изображения или предсказание шума .
Интуитивно, один обратный шаг делает следующее:
По текущему зашумлённому изображению предположить, где должно находиться немного более чистое изображение .
5. Цель обучения: от максимального правдоподобия к ELBO
Как генеративная модель, DDPM в идеале должен максимизировать правдоподобие реальных изображений:
Но:
Этот интеграл требует проинтегрировать все промежуточные переменные , и напрямую вычислить его сложно.
Поэтому DDPM использует вариационную нижнюю границу. При обучении минимизируется отрицательный ELBO:
где:
Подробный алгебраический вывод приведён в приложении A. В основном тексте оставлен только итог:
Здесь три типа членов.
Первый член:
выражает требование, чтобы конечное распределение шума было близко к стандартному гауссову. Поскольку при достаточно большом верно , этот член обычно близок к константе.
Средние члены:
составляют основу обучения. Они требуют, чтобы обратный шаг, предсказанный моделью , был близок к истинной апостериорной вероятности .
Последний член:
— ошибка восстановления из .
Таким образом, ключевой вопрос DDPM:
Как заставить нейросеть научиться приближать истинную апостериорную вероятность ?
6. Истинная апостериорная вероятность и сопоставление средних
Истинная апостериорная вероятность:
означает: если известны исходное изображение и текущее зашумлённое , то каким должно быть распределение предыдущего состояния .
По формуле Байеса:
Поскольку прямой процесс — марковская цепь:
поэтому:
Все три распределения справа гауссовы, поэтому результат тоже гауссов:
где:
и:
Подробный вывод коэффициентов — в приложении B. Сейчас важен смысл:
- истинное апостериорное среднее — линейная комбинация и ;
- оно показывает наиболее разумное центральное положение, если идти от назад на один шаг;
- при обучении можно потребовать, чтобы предсказанное моделью среднее приближалось к этому истинному среднему.
Модель обратного распределения:
Если дисперсия фиксирована, то часть KL, зависящая от параметров модели, сводится к MSE между средними:
где — константа, не зависящая от параметров .
Этот шаг превращает сложную задачу сопоставления вероятностей в более простую:
Заставить предсказанное моделью обратное среднее приближаться к истинному среднему апостериорного распределения.
7. От предсказания среднего к предсказанию шума
Теоретически сеть может напрямую предсказывать:
Но в практике DDPM чаще предсказывают шум:
Этот переход кажется внезапным, но на самом деле он следует из переписывания формул.
7.1 Сначала предсказываем
Истинное апостериорное среднее можно записать как:
где:
При генерации истинного мы не знаем, поэтому можно пусть сеть предсказывает исходное изображение:
и построить:
Это показывает, что предсказание исходного изображения и предсказание среднего можно преобразовать друг в друга.
7.2 Затем переходим от предсказания к предсказанию шума
Прямая формула:
Выразим :
Если сеть предсказывает шум:
то можно построить предсказанное исходное изображение:
Подставив в среднее из предыдущего раздела, получаем наиболее распространённую параметризацию обратного среднего DDPM:
Полное алгебраическое упрощение — в приложении C.
7.3 Почему предпочитают предсказывать шум
Предсказание шума имеет три интуитивных преимущества.
Первое — контрольный сигнал доступен. При обучении мы сами сэмплируем:
а затем строим:
поэтому истинный шум — известная метка.
Второе — единая форма цели. Каким бы сложным ни было содержание изображения, шум всегда берётся из стандартного нормального распределения:
Третье — интуитивная формула сэмплирования. Модель предсказывает шум в текущем изображении, а затем вычитает его из .
8. Итоговая цель обучения и формулы сэмплирования
8.1 От сопоставления средних к MSE для шума
Истинное апостериорное среднее можно записать через шум:
Среднее модели:
Их разность:
Следовательно:
Подставляя это в член сопоставления средних для KL, получаем взвешенную MSE для шума:
В практике DDPM часто используют упрощённую цель без сложного весового множителя:
где:
Это самая распространённая цель обучения DDPM.
8.2 Процесс обучения
Одна итерация обучения состоит из следующих шагов:
- Взять реальное изображение из набора данных:
- Случайно выбрать шаг времени:
- Сэмплировать гауссов шум:
- Построить зашумлённое изображение по замкнутой формуле:
- Попросить сеть предсказать шум:
- Минимизировать ошибку предсказания шума:
8.3 Процесс сэмплирования
После обучения генерация начинается с чистого гауссова шума:
затем от до выполняется шаг:
где:
Подставив среднее в форме предсказания шума:
Обычно на последнем шаге случайный шум больше не добавляют, то есть принимают:
Так итоговый не будет дополнительно искажён последним шумом.
9. Реализация DDPM на коде
В этом разделе код STL10 показывает, как формулы DDPM превращаются в реализацию на PyTorch. Полный код находится в файлах:
code/train_stl10_ddpm.pycode/generate_stl10_ddpm.py
Набор данных — STL10: в коде используется split="train", изображения по умолчанию приводятся к размеру . При первом запуске набор скачивается автоматически; заранее установите torch и torchvision.
Реализация использует базовую конфигурацию DDPM: линейное расписание beta, цель предсказания шума, MSE-потерю и небольшой U-Net как предсказатель шума. Цель — сначала запустить замкнутый цикл «при обучении добавляем шум, модель предсказывает шум, при сэмплировании шаг за шагом убираем шум», а не создать самую мощную диффузионную модель.
9.1 Набор данных и диапазон изображений
STL10 — RGB-изображения, поэтому входная форма модели:
В скрипте обучения сначала изображения изменяются до заданного размера, затем пиксели нормируются в :
transform = transforms.Compose(
    [
        transforms.Resize((args.image_size, args.image_size)),
        transforms.ToTensor(),
        transforms.Normalize((0.5, 0.5, 0.5), (0.5, 0.5, 0.5)),
    ]
)
train_set = datasets.STL10(
    root=args.data_dir,
    split="train",
    download=True,
    transform=transform,
)
Normalize((0.5,0.5,0.5),(0.5,0.5,0.5)) переводит исходные пиксели из в :
Причина в том, что DDPM в итоге постепенно приближает изображения к гауссову шуму. Когда диапазон изображения близок к , масштаб данных и масштаб шума лучше согласуются. При сохранении изображений результат переводится обратно в :
utils.save_image((images + 1) / 2, out_path, nrow=int(num_samples**0.5))
9.2 Временное вложение
Сеть DDPM не может смотреть только на зашумлённое изображение ; ей также необходимо знать текущий шаг времени . Одно и то же изображение при и при имеет совершенно разный уровень шума, и без информации о времени сеть не знает, сколько шума нужно убрать.
В коде используется синусоидальное временное вложение, которое превращает целочисленный шаг в непрерывный вектор:
class SinusoidalTimeEmbedding(nn.Module):
    def __init__(self, dim: int) -> None:
        super().__init__()
        self.dim = dim

    def forward(self, t: torch.Tensor) -> torch.Tensor:
        half = self.dim // 2
        freq = torch.exp(
            -math.log(10000)
            * torch.arange(half, device=t.device, dtype=torch.float32)
            / max(half - 1, 1)
        )
        angles = t.float()[:, None] * freq[None, :]
        emb = torch.cat([angles.sin(), angles.cos()], dim=-1)
        return F.pad(emb, (0, self.dim % 2))
Полученный временной вектор проходит через MLP:
self.time_mlp = nn.Sequential(
    SinusoidalTimeEmbedding(time_dim),
    nn.Linear(time_dim, time_dim),
    nn.SiLU(),
    nn.Linear(time_dim, time_dim),
)
Так каждый шаг времени получает условный вектор, который может использовать сеть.
9.3 Как остаточные блоки вводят информацию о времени
Каждый остаточный блок U-Net получает два входа: признаки изображения x и временные признаки time_emb. Временные признаки сначала проецируются линейным слоем до текущего числа каналов и затем добавляются к свёрточной карте признаков:
class ResBlock(nn.Module):
    def __init__(self, in_ch: int, out_ch: int, time_dim: int) -> None:
        super().__init__()
        self.conv1 = nn.Conv2d(in_ch, out_ch, 3, padding=1)
        self.norm1 = nn.GroupNorm(norm_groups(out_ch), out_ch)
        self.conv2 = nn.Conv2d(out_ch, out_ch, 3, padding=1)
        self.norm2 = nn.GroupNorm(norm_groups(out_ch), out_ch)
        self.time_proj = nn.Sequential(nn.SiLU(), nn.Linear(time_dim, out_ch))
        self.skip = nn.Conv2d(in_ch, out_ch, 1) if in_ch != out_ch else nn.Identity()

    def forward(self, x: torch.Tensor, time_emb: torch.Tensor) -> torch.Tensor:
        h = F.silu(self.norm1(self.conv1(x)))
        h = h + self.time_proj(time_emb)[:, :, None, None]
        h = F.silu(self.norm2(self.conv2(h)))
        return h + self.skip(x)
Здесь:
time_proj(time_emb)имеет форму[B, C];[:, :, None, None]превращает её в[B, C, 1, 1];- при сложении с
hона автоматически распространяется (broadcast) на всю карту признаков.
Этот шаг соответствует условной сети в формуле:
То есть при предсказании шума модель одновременно зависит от состояния изображения и шага времени .
9.4 U-Net как предсказатель шума
Основная модель скрипта обучения — UNet96. Она получает зашумлённое RGB-изображение и выводит предсказание шума того же размера:
Модель сначала понижает разрешение, извлекая семантические признаки, а затем повышает его, восстанавливая пространственное разрешение:
self.in_conv = nn.Conv2d(in_ch, base, 3, padding=1)
self.down1 = ResBlock(base, base, time_dim)
self.down2 = ResBlock(base, base * 2, time_dim)
self.down3 = ResBlock(base * 2, base * 4, time_dim)
self.down4 = ResBlock(base * 4, base * 8, time_dim)
self.mid = ResBlock(base * 8, base * 8, time_dim)

self.up3 = ResBlock(base * 8 + base * 4, base * 4, time_dim)
self.up2 = ResBlock(base * 4 + base * 2, base * 2, time_dim)
self.up1 = ResBlock(base * 2 + base, base, time_dim)
self.out = nn.Sequential(
    nn.GroupNorm(norm_groups(base), base),
    nn.SiLU(),
    nn.Conv2d(base, in_ch, 3, padding=1),
)
При прямом проходе на этапе повышения разрешения глубокие признаки конкатенируются с признаками, сохранёнными на этапе понижения:
x1 = self.down1(self.in_conv(x), time_emb)
x2 = self.down2(self.pool(x1), time_emb)
x3 = self.down3(self.pool(x2), time_emb)
x4 = self.down4(self.pool(x3), time_emb)
h = self.mid(x4, time_emb)

h = F.interpolate(h, scale_factor=2, mode="nearest")
h = self.up3(torch.cat([h, x3], dim=1), time_emb)
h = F.interpolate(h, scale_factor=2, mode="nearest")
h = self.up2(torch.cat([h, x2], dim=1), time_emb)
h = F.interpolate(h, scale_factor=2, mode="nearest")
h = self.up1(torch.cat([h, x1], dim=1), time_emb)
return self.out(h)
Пропускные соединения здесь очень важны. DDPM предсказывает шум для каждого пикселя, поэтому нужны одновременно глобальная семантика и локальная текстура с точным положением. Ветвь понижения разрешения расширяет рецептивное поле, ветвь повышения восстанавливает разрешение, а пропускные соединения возвращают в декодер мелкие детали.
9.5 Вспомогательный класс Diffusion
Класс Diffusion выполняет две задачи:
- заранее вычисляет коэффициенты, нужные для прямой диффузии и обратного сэмплирования;
- предоставляет две основные функции:
q_sampleиsample.
При инициализации сначала задаётся линейное расписание beta:
self.betas = torch.linspace(beta_start, beta_end, timesteps, device=self.device)
self.alphas = 1.0 - self.betas
self.alpha_bars = torch.cumprod(self.alphas, dim=0)
self.sqrt_alpha_bars = torch.sqrt(self.alpha_bars)
self.sqrt_one_minus_alpha_bars = torch.sqrt(1.0 - self.alpha_bars)
Это соответствует ранее выведенным соотношениям:
Поскольку эти величины зависят только от шага времени, их следует вычислить один раз при инициализации, а не пересчитывать на каждом батче.
_extract берёт из таблицы коэффициентов длины timesteps значения, соответствующие шагам текущего батча:
def _extract(self, values: torch.Tensor, t: torch.Tensor, x: torch.Tensor) -> torch.Tensor:
    return values.gather(0, t).view(t.size(0), *((1,) * (x.ndim - 1)))
Например, если в батче 32 изображения и для каждого случайно выбран свой шаг, _extract извлекает 32 соответствующих значения и приводит их к форме [B,1,1,1], чтобы их можно было умножать на тензор изображений.
9.6 Как при обучении построить
Обучение DDPM не требует пошагового добавления шума от до : используется замкнутая формула:
Функция q_sample в коде реализует именно эту формулу:
def q_sample(
    self,
    x0: torch.Tensor,
    t: torch.Tensor,
    noise: torch.Tensor | None = None,
) -> torch.Tensor:
    if noise is None:
        noise = torch.randn_like(x0)
    return (
        self._extract(self.sqrt_alpha_bars, t, x0) * x0
        + self._extract(self.sqrt_one_minus_alpha_bars, t, x0) * noise
    )
Здесь noise — контрольный сигнал для обучения. Поскольку шум сэмплируется нами самими, метка обучения известна заранее и не требует ручной разметки.
9.7 Цель обучения
Одна итерация обучения состоит из пяти шагов:
- взять из набора реальное изображение ;
- случайно выбрать шаг времени ;
- случайно сэмплировать шум ;
- по замкнутой формуле получить ;
- попросить модель по предсказать .
Ключевой код скрипта обучения:
for x0, _ in train_loader:
    x0 = x0.to(device)
    t = torch.randint(0, args.timesteps, (x0.size(0),), device=device)
    noise = torch.randn_like(x0)
    xt = diffusion.q_sample(x0, t, noise)
    loss = F.mse_loss(model(xt, t), noise)

    optimizer.zero_grad(set_to_none=True)
    loss.backward()
    optimizer.step()
Это прямо соответствует упрощённой цели:
Обратите внимание: модель не предсказывает напрямую чистое изображение , а предсказывает шум , добавленный на этом шаге. После предсказания шума при сэмплировании можно по формуле DDPM построить обратное среднее.
9.8 Выходные данные скрипта обучения
train_stl10_ddpm.py сохраняет:
checkpoints/stl10_ddpm.pt— веса модели и необходимую конфигурацию;outputs/stl10_sample_epoch_XXX.png— изображения в стиле STL10, сгенерированные из шума во время обучения.
В checkpoint сохраняется:
{
    "model_state": model.state_dict(),
    "base": args.base,
    "timesteps": args.timesteps,
    "image_size": args.image_size,
}
Эти параметры используются скриптом генерации. Особенно важен image_size: STL10 по умолчанию использует , и на этапе генерации он должен совпадать с обучением.
Пример запуска:
python train_stl10_ddpm.py --epochs 200 --batch-size 32 --image-size 96
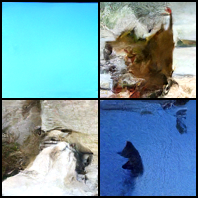
Результаты показаны ниже. В начале обучения шум сильный, а к 200-й эпохе модель уже восстанавливает некоторые контуры, но качество остаётся средним. Чтобы материал было проще понять, в руководстве не добавлено много улучшений — например, механизма внимания или генерации с условием по классу. После прохождения курса их можно изучить самостоятельно.
9.9 Процесс генерации
После обучения генерация начинается с чистого гауссова шума:
затем выполняется обратный цикл по шагам времени:
Этот процесс реализован функцией sample:
@torch.no_grad()
def sample(self, model: nn.Module, shape: tuple[int, int, int, int]) -> torch.Tensor:
    model.eval()
    x = torch.randn(shape, device=self.device)

    for step in reversed(range(self.timesteps)):
        t = torch.full((shape[0],), step, device=self.device, dtype=torch.long)
        pred_noise = model(x, t)
        beta_t = self._extract(self.betas, t, x)
        alpha_t = self._extract(self.alphas, t, x)
        alpha_bar_t = self._extract(self.alpha_bars, t, x)
        mean = (1.0 / torch.sqrt(alpha_t)) * (
            x - beta_t / torch.sqrt(1.0 - alpha_bar_t) * pred_noise
        )
        x = mean if step == 0 else mean + torch.sqrt(beta_t) * torch.randn_like(x)

    return x.clamp(-1, 1)
Обратное среднее:
Строка кода:
x = mean if step == 0 else mean + torch.sqrt(beta_t) * torch.randn_like(x)
означает, что на последнем шаге дополнительный случайный шум не добавляется. Иначе итоговый был бы искажён последним шумом.
9.10 Проверка скрипта генерации
generate_stl10_ddpm.py выполняет только генерацию и не читает обучающие данные. Его поток:
- загрузить
checkpoints/stl10_ddpm.pt; - по
baseиimage_sizeиз checkpoint восстановитьUNet96; - загрузить веса модели;
- выполнить обратное сэмплирование из стандартного гауссова шума;
- сохранить сгенерированные изображения.
Ключевой код:
checkpoint = torch.load(args.checkpoint, map_location=device)
image_size = int(checkpoint.get("image_size", 96))
model = UNet96(base=int(checkpoint["base"])).to(device)
model.load_state_dict(checkpoint["model_state"])

diffusion = Diffusion(timesteps=int(checkpoint["timesteps"]), device=device)
with torch.no_grad():
    images = diffusion.sample(model, (args.num_samples, 3, image_size, image_size))
    utils.save_image((images + 1) / 2, args.out, nrow=max(1, int(args.num_samples**0.5)))
Пример запуска:
python generate_stl10_ddpm.py --checkpoint checkpoints/stl10_ddpm.pt --out outputs/generated_stl10.png --num-samples 1
По умолчанию генерируется одно изображение , чтобы быстро проверить, действительно ли модель может получить видимую структуру из шума. Чтобы увидеть несколько изображений, увеличьте --num-samples.
Результат генерации:

10. Частые вопросы
10.1 Прямой процесс DDPM выучивается?
Нет. Прямой процесс:
задан вручную как фиксированное правило добавления шума. Обучается обратный процесс:
10.2 Почему при обучении не добавляют шум пошагово
Потому что существует замкнутая формула:
которая позволяет получить из сразу для любого шага.
10.3 Почему цель — предсказание шума, а не изображения
Потому что при обучении шум мы сэмплируем сами, и он естественно является меткой обучения. После предсказания шума можно либо восстановить , либо построить обратное среднее:
Поэтому предсказание шума не слабее: оно эквивалентно обучению шага обратного удаления шума.
10.4 В чём главное различие между DDPM и VAE
VAE:
то есть генерирует изображение из латентной переменной за один шаг.
DDPM:
то есть генерирует изображение из шума за несколько шагов удаления шума.
10.5 Каковы недостатки DDPM
Главный недостаток — медленное сэмплирование. Обычно нужно пройти от к шаг за шагом; базовая версия может требовать от нескольких сотен до тысяч шагов. Для ускорения можно использовать DDIM, ускоренные сэмплеры или методы дистилляции.
11. Итоги
Основная логика DDPM такая:
- Фиксированное прямое добавление шума:
- Получение зашумления на произвольном шаге:
- Обучение обратному удалению шума:
- Использование ELBO для сопоставления с истинной апостериорной вероятностью:
- Перевод гауссовой KL в MSE для средних и затем в MSE для предсказания шума:
По сравнению с VAE, DDPM не сжимает всю информацию изображения в низкоразмерную латентную переменную, а постепенно удаляет шум прямо в пространстве изображений. Его цель выводится из вероятностных соображений, но в итоге она сводится к очень простой задаче обучения с учителем.
12. Задания для самопроверки
- Почему VAE склонен генерировать размытые изображения?
- Почему DDPM не генерирует изображение из латентной переменной за один шаг?
- За что отвечает в прямом процессе?
- Почему в формуле одношагового добавления шума используются квадратные корни?
- Как напрямую сэмплировать для любого шага из ?
- Почему близок к стандартному гауссову шуму?
- Почему обратный процесс DDPM моделируют гауссовым распределением?
- Какое ограничение задаёт средний член KL в разложении ELBO?
- Почему истинная апостериорная вероятность имеет аналитическое решение?
- Почему предсказание шума эквивалентно обучению обратному удалению шума?
- Почему при сэмплировании на последнем шаге обычно не добавляют шум?
- Что произойдёт с сетью DDPM без временного вложения?
Приложение A: подробный вывод разложения ELBO для DDPM
DDPM минимизирует отрицательный ELBO:
Раскроем совместное распределение модели:
Раскроем прямое распределение:
Подставим:
Разобьём логарифм на сумму:
Для используем:
откуда:
Подставив эти величины и сократив телескопические члены, получим:
Записав в форме KL:
Это показывает, что обучение DDPM по сути состоит в том, чтобы обратный шаг модели совпадал с истинной апостериорной вероятностью, выведенной из прямого процесса.
Приложение B: подробный вывод истинной апостериорной вероятности
Обозначим:
Требуется найти:
По формуле Байеса:
где:
Рассмотрим только экспоненциальную часть, зависящую от :
Раскроем первый член:
Члены, зависящие от :
Раскроем второй член:
Члены, зависящие от :
Объединяем:
Стандартная экспоненциальная форма гауссова распределения:
Сравниваем коэффициенты при квадратичном члене:
Значит:
Приведём к общему знаменателю:
Так как:
и:
то:
Поэтому:
То есть:
Теперь найдём среднее. Из линейного члена:
Следовательно:
Подставим :
Получаем:
Итак:
Приложение C: вывод формулы обратного среднего через предсказание шума
Известно:
И:
Подставим:
Поскольку:
имеем:
Значит:
Объединим коэффициенты при :
Приведём к общему знаменателю:
Так как:
и:
то:
Значит, коэффициент при равен:
Итого:
Вынесем :