Основы математики диффузии и введение в разбор задач
Главная задача генеративной модели
Мы хотим, чтобы модель выучила распределение данных , а затем могла брать из него новые образцы .
Например: распределение изображений лиц, распределение рукописных цифр, распределение точек окружности, распределение текстов, аудио и видео.
Но распределение данных обычно очень сложное: мы не можем явно записать ни его распределение, ни функцию плотности, поэтому нужны специальные приёмы.
Многих новичков отпугивает обилие формул при изучении диффузионных моделей. На самом деле идея диффузии проста. Этот текст объясняет диффузионные модели с помощью простого кода и помогает освоить VAE и DDPM без сложных выводов. Первая часть даёт математическую базу, которая понадобится для последующих формул. Если вы хотите сразу почувствовать диффузию, перейдите ко второй части: там упрощённые версии VAE и DDPM, которые дают полный и простой опыт. Третья часть на примере второй показывает, почему некоторые функции из второй части нельзя получить напрямую и поэтому нужна диффузионная модель.
Часть 1. Математическая база
1. Формула Байеса
Формула Байеса часто записывается так:
Главная идея формулы: увидев результат, восстанавливаем наиболее вероятную причину, которая его породила.
В машинном обучении, статистическом выводе, распознавании образов и обработке естественного языка формула Байеса очень важна. Разберём каждый символ формулы.
| Символ | Название | Смысл |
|---|---|---|
| Скрытая переменная / латентная причина | Ненаблюдаемая причина, которую мы хотим восстановить | |
| Наблюдаемые данные | Данные или явление, которые мы уже видим | |
| Априорная вероятность | Вероятность причины до того, как мы увидели данные | |
| Правдоподобие | Вероятность увидеть данные , если причина известна | |
| Апостериорная вероятность | Вероятность причины после того, как мы увидели данные | |
| Свидетельство / маргинальное правдоподобие | Общая вероятность наблюдать данные |
: латентная причина
— объект, который мы хотим восстановить. Обычно он не наблюдается напрямую, а скрыт за данными, поэтому его называют скрытой переменной.
Например: по симптомам пациента мы хотим понять, какая у него болезнь.
: наблюдаемые данные
— данные, которые мы уже наблюдаем.
Например: набор симптомов. В формуле Байеса мы по наблюдаемому восстанавливаем причину .
То есть — результат, а — возможная причина этого результата.
: свидетельство или маргинальное правдоподобие
— общая вероятность наблюдать данные . Её называют свидетельством или маргинальным правдоподобием.
Например, симптомы «высокая температура, кашель, насморк» могут быть вызваны многими причинами: простудой, гриппом, аллергией, пневмонией, другими заболеваниями.
Поэтому учитывает вероятность такого результата со стороны всех возможных причин.
Если причины дискретны, можно записать:
Его главная роль: нормировать вероятности, чтобы апостериорные вероятности всех возможных причин в сумме давали 1.
: априорная вероятность
— наше начальное представление о причине до того, как мы увидели данные . Её называют априорной вероятностью.
Например, при оценке того, болен ли человек простудой, если сейчас сезон гриппа, то сама причина «простуда» встречается чаще; если это не сезон, вероятность может быть ниже.
Поэтому — это наше суждение о причине на основе опыта до наблюдения свидетельств.
: правдоподобие
— вероятность наблюдать данные , если причина уже определена. Её называют правдоподобием.
Например: если человек действительно простужен, какова вероятность, что у него будут «высокая температура, кашель, насморк»?
Здесь связь такая:
Она измеряет, насколько хорошо данная причина объясняет наблюдаемое явление. Если причина хорошо объясняет данные, правдоподобие велико; если плохо, оно мало.
: апостериорная вероятность
— вероятность причины после того, как мы наблюдали данные . Её называют апостериорной вероятностью.
Это то, что формула Байеса в итоге должна вычислить.
Например: увидев у человека «высокую температуру, кашель, насморк», мы хотим знать, насколько вероятно, что у него действительно простуда:
То есть апостериорная вероятность — это переоценка причины после того, как увидели результат.
Роль формулы Байеса — объединить априорную вероятность и наблюдаемые данные и получить апостериорную вероятность.
Формула Байеса:
Её можно понимать так: апостериорная вероятность = правдоподобие × априорная вероятность ÷ свидетельство.
То есть:
| Элемент формулы | Интуитивный смысл |
|---|---|
| Насколько вероятна причина, если результат уже виден | |
| Насколько вероятен результат, если причина верна | |
| Насколько причина вероятна сама по себе | |
| Насколько результат вообще распространён |
Таким образом, главная роль формулы Байеса: по уже наблюдаемым данным и с учётом накопленного опыта обновить наше представление о причине.
2. Неравенство Йенсена
Для вогнутой функции верно:
Для выпуклой функции верно:
В машинном обучении обычно обозначает , и это вогнутая функция, поэтому:
Во многих моделях мы хотим максимизировать , но часто представляет собой интеграл:
Значит:
Такую величину обычно трудно оптимизировать напрямую. Неравенство Йенсена позволяет построить нижнюю границу, то есть:
Эта нижняя граница лежит в основе многих генеративных моделей.
3. Гауссово распределение
Гауссово распределение, также называемое нормальным, — самое частое распределение в генеративных моделях.
Одномерное гауссово распределение
Одномерное гауссово распределение записывается как:
Теперь выведем его функцию плотности.
Начнём со стандартного нормального распределения:
Плотность стандартного нормального распределения можно записать как:
где — неизвестная константа. Так как — плотность вероятности, она должна удовлетворять условию нормировки:
Подставляем :
А гауссов интеграл равен:
Значит:
Откуда:
Итак, плотность стандартного нормального распределения:
Пусть случайная величина имеет общее нормальное распределение:
Одномерное гауссово распределение можно привести к стандартному.
Положим:
Тогда плотность стандартного нормального распределения:
Поскольку:
получаем:
По формуле преобразования плотности непрерывной случайной величины:
Подставляем :
Подставляем плотность стандартного нормального распределения:
Упрощаем:
Итак, плотность общего нормального распределения:
Здесь — среднее, — дисперсия, — стандартное отклонение. Среднее задаёт центр распределения, дисперсия — его ширину.
Многомерное гауссово распределение
В задачах воплощённого ИИ изображения, латентные переменные и двумерные точки обычно являются не одномерными величинами, а многомерными векторами.
Многомерное гауссово распределение записывается как:
Его плотность:
Здесь: — размерность, — вектор среднего, — ковариационная матрица.
Если ковариация — единичная матрица:
то получаем стандартное многомерное гауссово распределение:
4. Дивергенция Кульбака — Лейблера (KL)
Дивергенция KL измеряет различие между двумя распределениями вероятностей; её также называют относительной энтропией.
Пусть есть два распределения: истинное и приближающее .
Тогда KL-дивергенция для приближения с помощью определяется как:
Для непрерывных случайных величин:
KL-дивергенцию можно понимать так: если истинное распределение — , а вы кодируете или моделируете его с помощью , то в среднем вы переплачиваете определённое количество информации.
То есть — реальная ситуация, — ваше модельное предположение. Чем меньше KL-дивергенция, тем ближе к ; если она равна , распределения совпадают.
Простой пример
Пусть:
Тогда:
При натуральном логарифме результат приблизительно равен:
Связь KL-дивергенции и перекрёстной энтропии
Перекрёстная энтропия определяется как:
Энтропия:
KL-дивергенция удовлетворяет:
Поэтому в машинном обучении минимизация перекрёстной энтропии при фиксированном эквивалентна минимизации KL-дивергенции.
Итак, KL-дивергенция измеряет, сколько информации в среднем мы теряем, когда используем распределение вместо истинного .
Часть 2. Простой пример генерации
Прямое изучение VAE, DDPM и потоковых моделей (FM) может сбивать с толку. Я сам в начале был в растерянности, поэтому объясняю процесс генерации на простом примере. Это хорошо подготовит к диффузионным моделям. Мы разберём базовые шаги генерации на примере кольца.
Мы ничего не обучаем, а используем явно написанные правила, чтобы смоделировать три подхода к генерации:
-
Прямое сэмплирование: берём точки непосредственно из математического определения окружности.
-
Имитация сэмплирования VAE: сначала сэмплируем из априорного распределения латентной переменной, затем с помощью декодера в один шаг получаем точку на окружности.
-
Имитация сэмплирования DDPM: начинаем с гауссова шума и шаг за шагом убираем шум, пока точки не окажутся на окружности.
Целевое распределение — двумерная окружность: , то есть окружность радиуса .
Мы хотим сгенерировать набор двумерных точек:
которые лежат на окружности радиуса :
Например, пусть:
Тогда цель — получить распределение такого вида:
        * * * * *
     *             *
   *                 *
  *                   *
  *                   *
   *                 *
     *             *
        * * * * *
Способ первый: прямое сэмплирование окружности
Точку на окружности можно параметризовать углом:
Если хотим, чтобы точки были равномерно распределены по окружности, достаточно равномерно распределить угол:
Затем вычисляем:
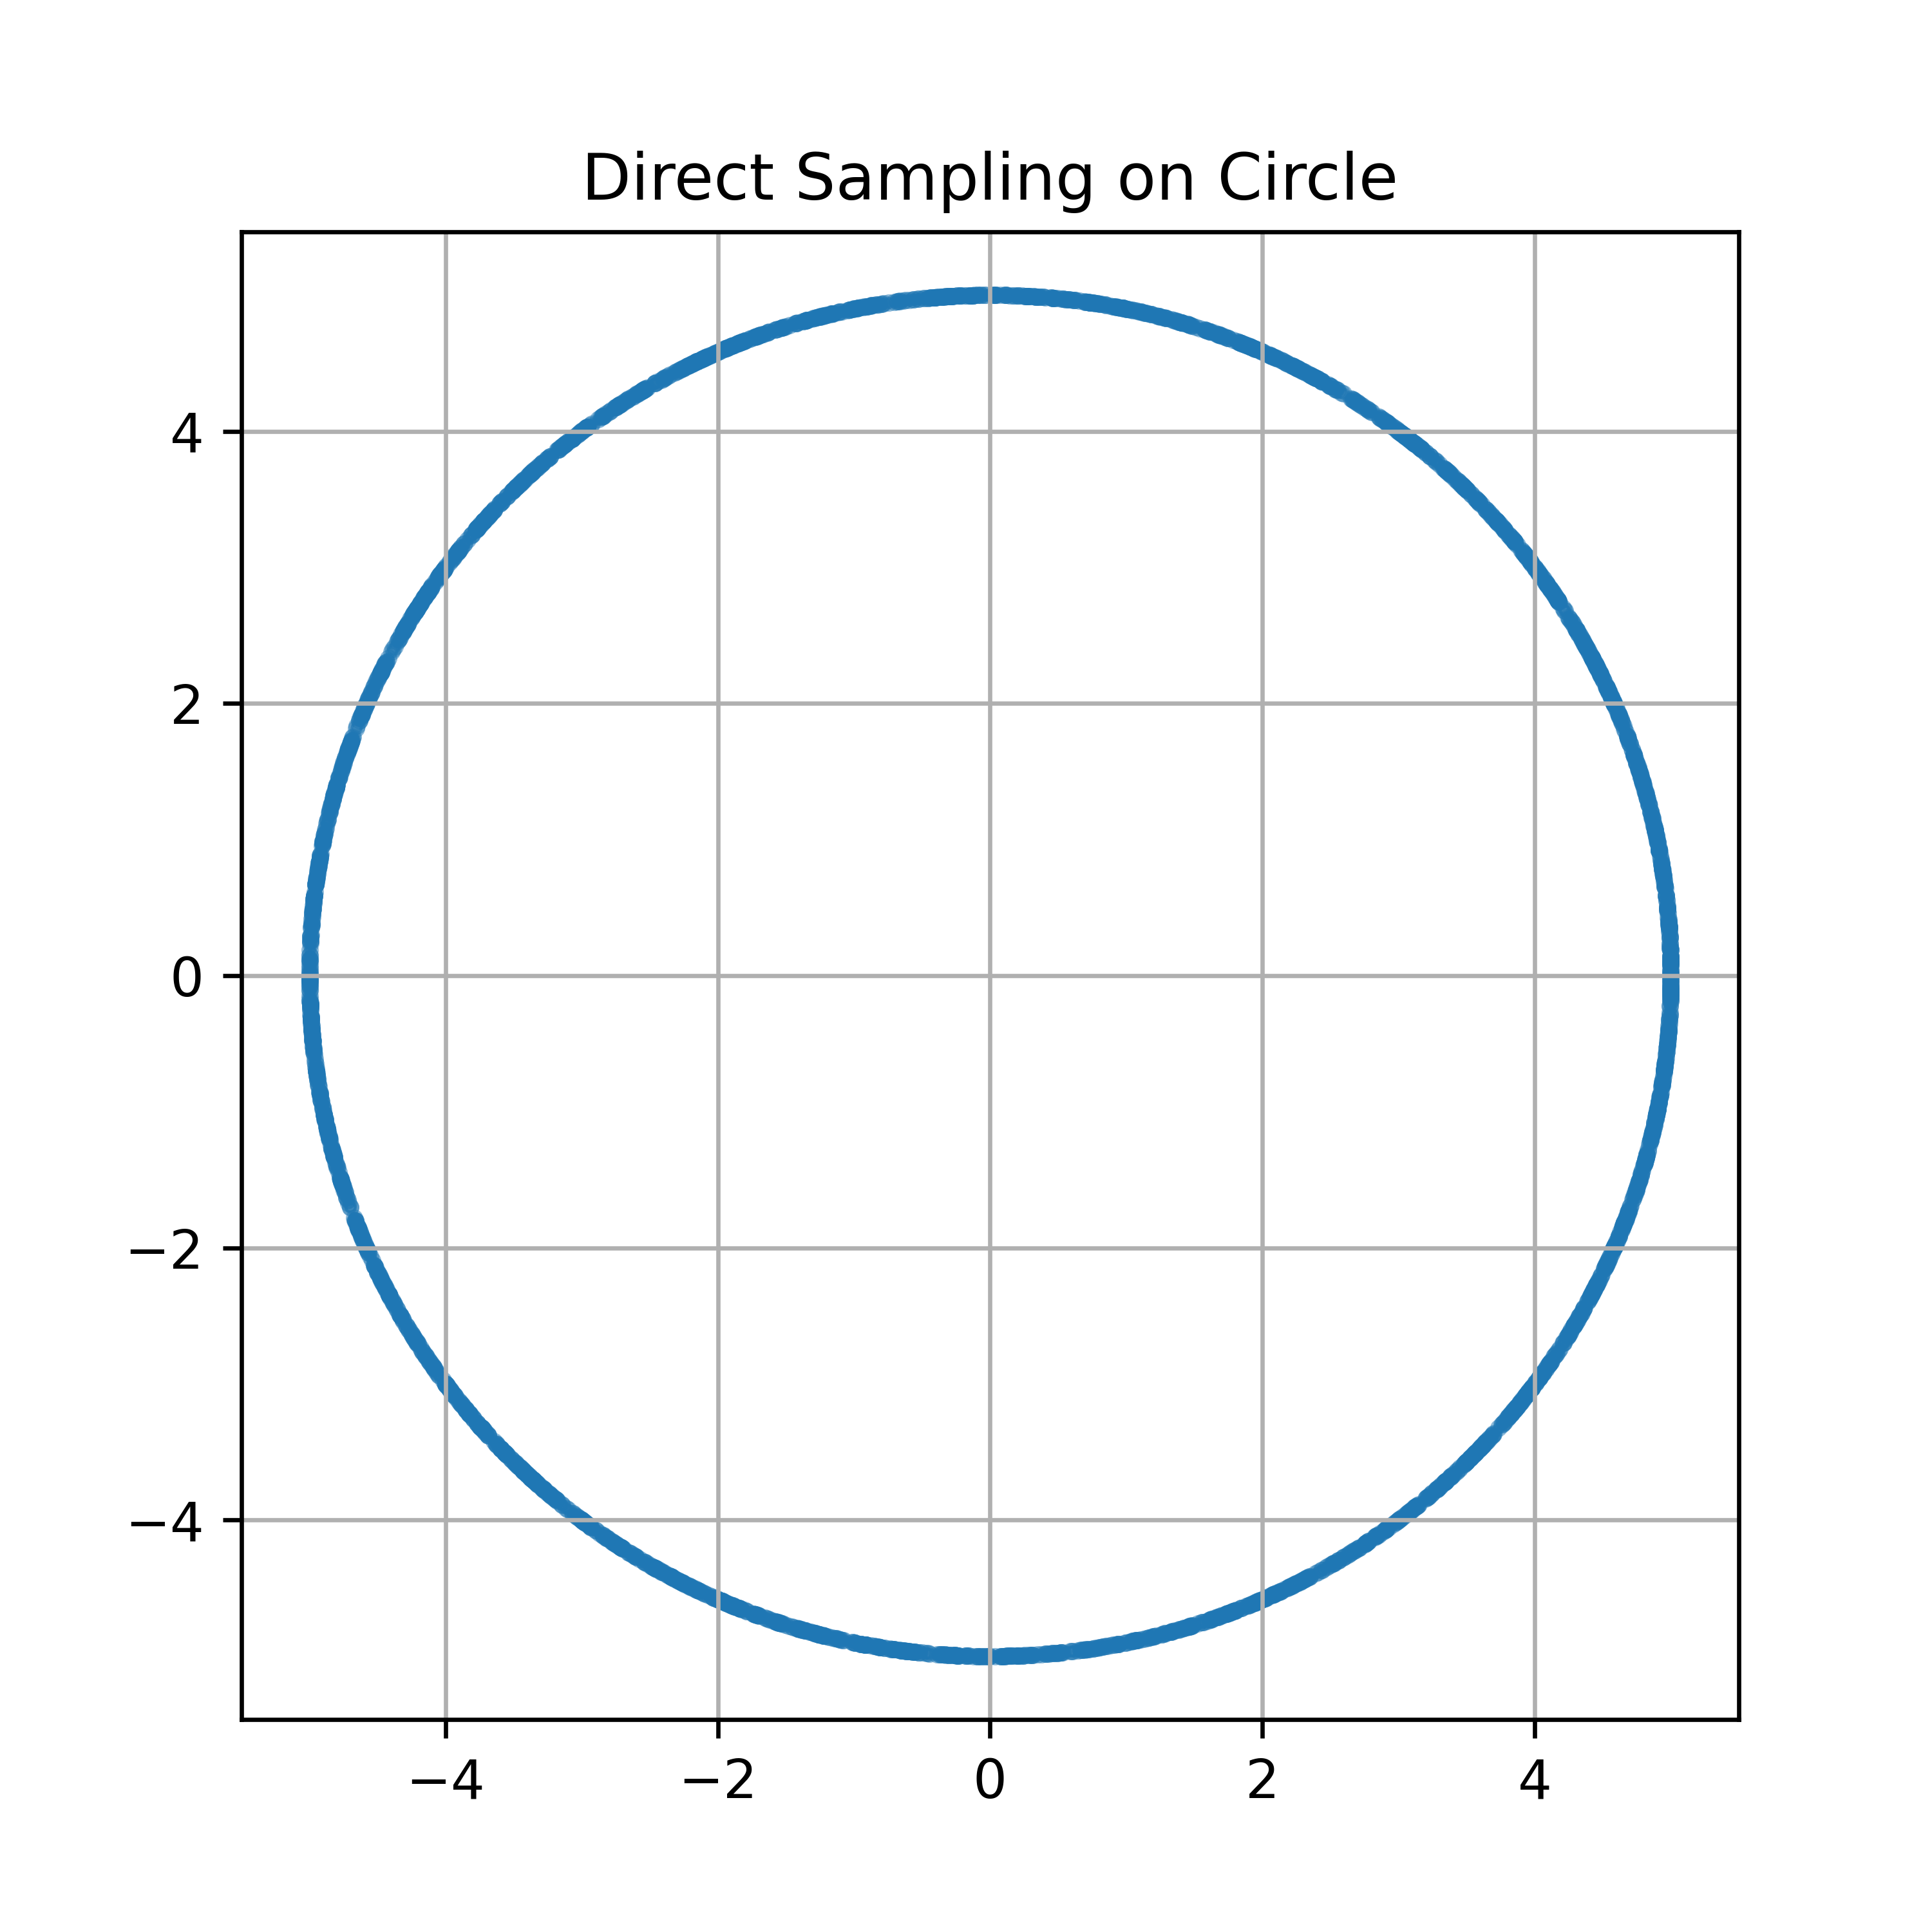
Это самое прямое сэмплирование окружности: если известна явная форма целевого распределения, из него можно сэмплировать напрямую.
Реализация — в файле direct.py из папки code; результат:
Способ второй: имитация сэмплирования окружности VAE
Процесс генерации VAE обычно такой:
Самое распространённое априорное распределение — стандартное нормальное:
Если декодер детерминированный, можно упростить:
То есть основная логика генерации VAE: сначала сэмплируем латентную переменную , затем через декодер получаем .
Можно задать «ручной» декодер:
где:
Затем проецируем эту двумерную гауссову точку на окружность радиуса :
где:
Раскрывая:
Реализация — в файле vae_imitat.py из папки code; результат:
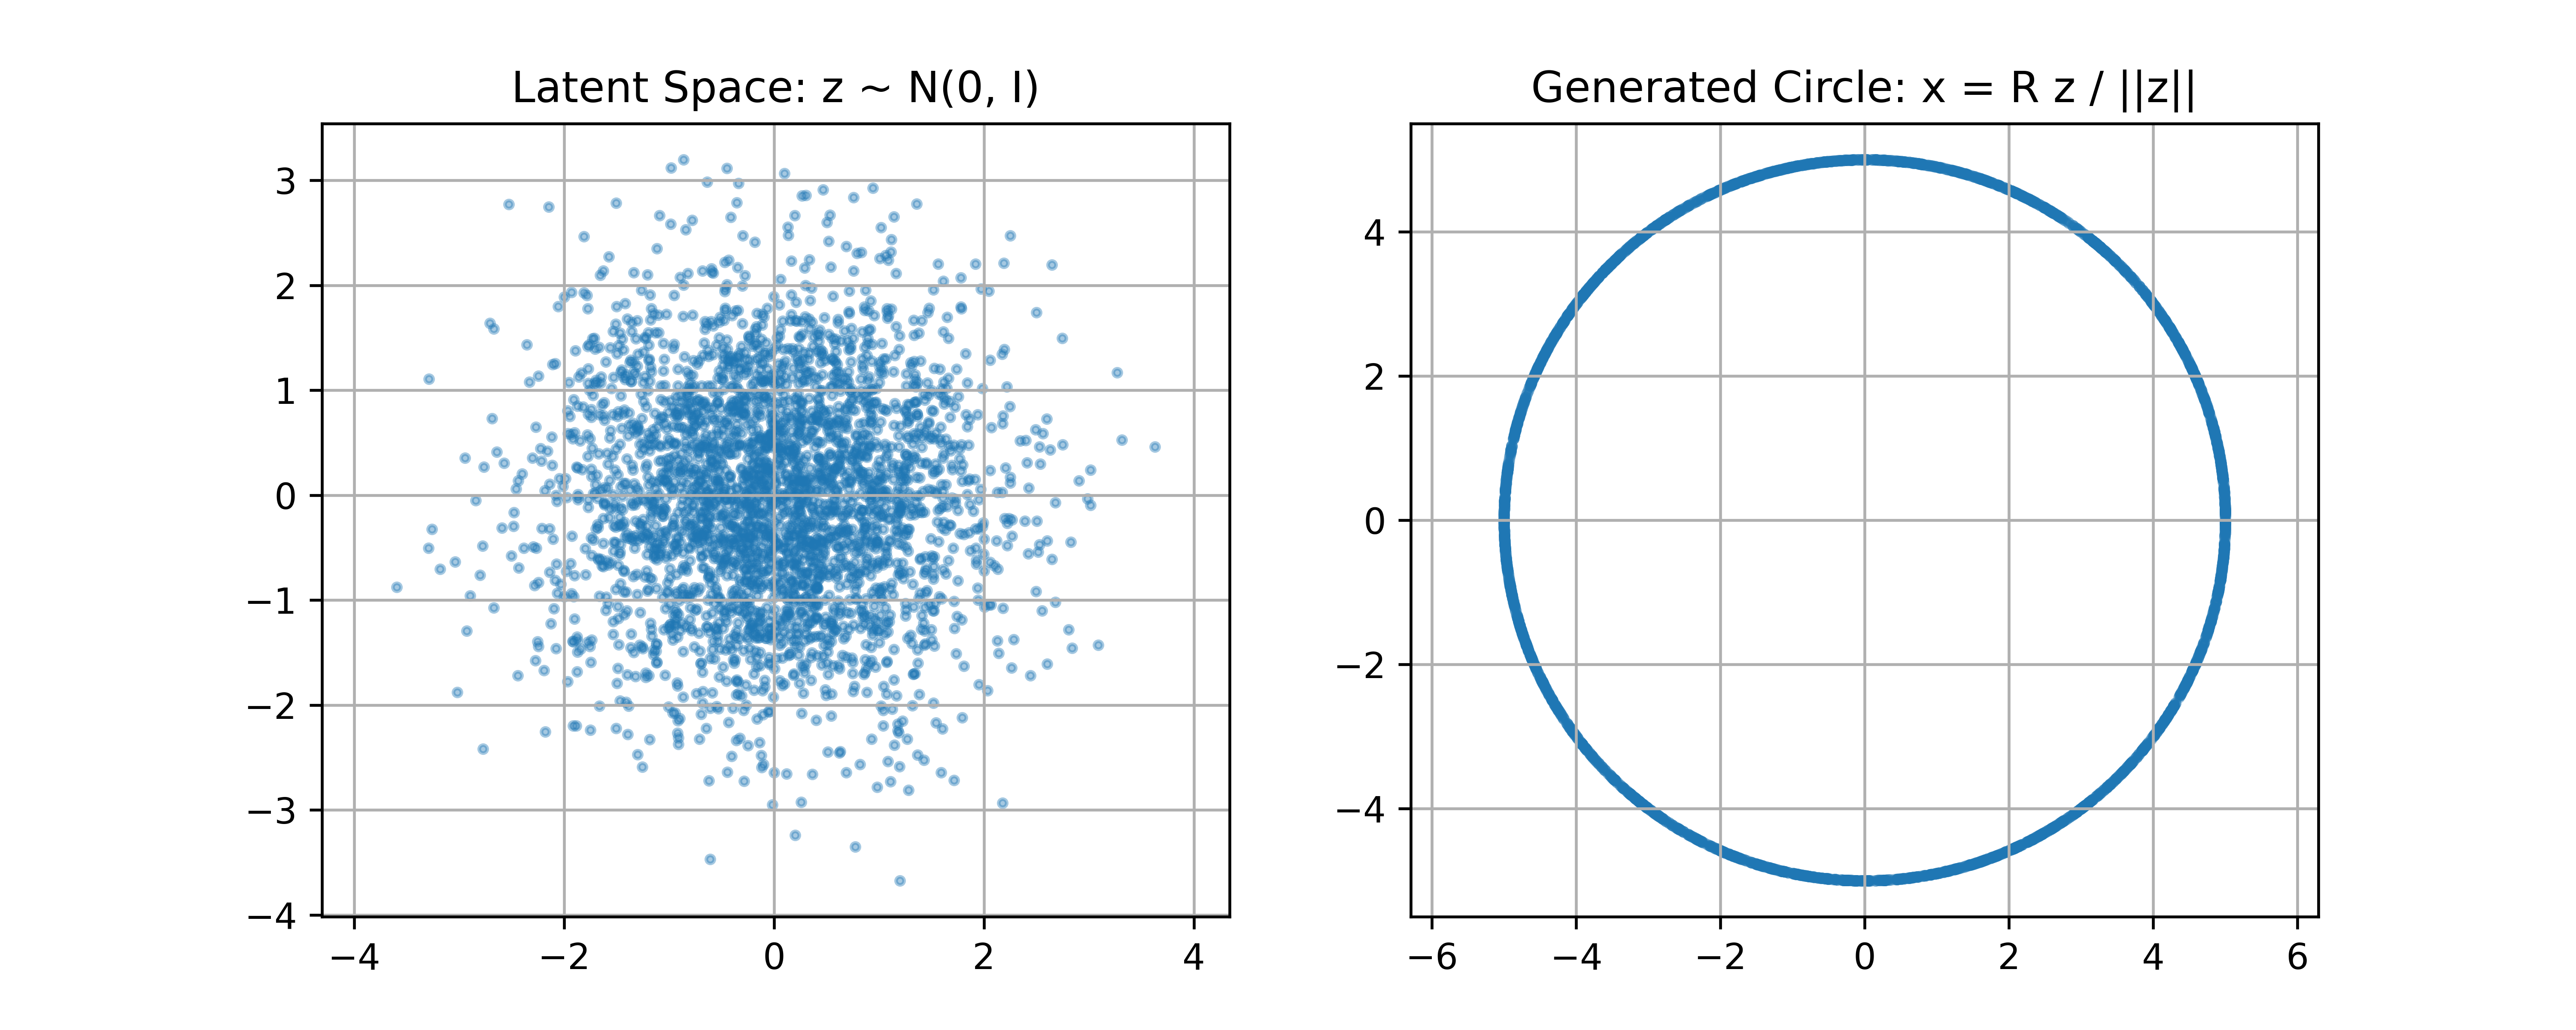
Реальный VAE генерирует данные обычно за один шаг. Это может привести к тому, что результаты будут смещаться к среднему; поэтому появился DDPM. Сейчас полезно просто понимать эту разницу; подробнее мы разберём VAE отдельно.
Разница между DDPM и VAE
VAE:
Это генерация в один шаг.
DDPM:
Это многошаговая генерация.
Способ третий: имитация сэмплирования окружности DDPM
Генерация DDPM выполняется не за один шаг.
Её процесс:
затем постепенное удаление шума:
и в конце получаем образец данных:
Для окружности это означает, что в конце хотим:
Настоящий DDPM состоит из двух процессов: 1. прямого зашумления и 2. обратного удаления шума.
Чтобы понять идею, мы сначала напишем ручное правило удаления шума, имитирующее сэмплирование DDPM.
Основная идея такая:
-
Начинаем с гауссова шума.
-
На каждом шаге предсказываем «чистую» точку на окружности.
-
Текущая точка сдвигается к предсказанной точке на окружности.
-
На каждом шаге добавляем немного шума, который постепенно уменьшается.
-
В конце точки оказываются около окружности.
Для любой текущей точки можно спроецировать её на окружность радиуса :
Это можно рассматривать как ручную модель удаления шума: в настоящем DDPM предсказывает нейронная сеть.
Пусть текущая точка — , предсказанная чистая точка:
Затем обновляем:
где:
Здесь определяет, насколько сильно мы приближаемся к окружности на каждом шаге, а — сколько случайного шума добавляется. По мере продвижения сэмплирования должно уменьшаться.
Реализация — в файле ddpm_imitat.py из папки code; результат:
Вы увидите процесс:
стандартный гауссов шум -> точки постепенно притягиваются к окружности -> в итоге образуется окружность радиуса R
Часть 3. Упрощения в реальных моделях
1. VAE
Настоящий VAE задаётся так:
где — распределение, которое определяет нейросетевой декодер.
Типичная форма:
При сэмплировании:
где:
В нашей упрощённой версии:
заменено на:
2. DDPM
Прямой процесс настоящего DDPM:
Обучаем нейросеть:
При сэмплировании начинаем с:
и шаг за шагом удаляем шум.
В нашей упрощённой версии предсказание нейросети заменено геометрической проекцией:
То есть в настоящем DDPM нейросеть учится превращать в , а в нашей упрощённой версии мы напрямую проецируем на окружность с помощью ручного правила.
В реальных задачах у нас нет возможности получить распределение, которое можно записать явной математической формулой, как окружность. Поэтому нужны нейросети, кодирование и декодирование, репараметризация и другие приёмы, чтобы выучить такое распределение.
Как именно VAE, DDPM и FM учат распределения и генерируют данные, а также о современных применениях диффузионной генерации в воплощённом ИИ, например DreamDojo, DreamZero, и о других моделях понимания и генерации, таких как JEPA и LeWM, мы расскажем в следующих главах. Надеюсь, после этой главы у вас появится первичное понимание диффузионных моделей.
Спасибо за чтение, пристегните ремни! Поехали к следующим главам~