Погружение в глубокое обучение
Эта книга — русскоязычное издание учебника по глубокому обучению, основанного на китайской версии «Dive into Deep Learning». Оригинал сочетает объяснения, математику и исполняемый код на Python: идея в том, чтобы сначала показать, как работает метод, а затем сразу применить его на реальных данных.
Учебник начинается с основ: данных и предварительных знаний (линейная алгебра, математический анализ, теория вероятностей), затем рассматриваются линейные модели, многослойные перцептроны, вычислительные аспекты обучения, свёрточные и рекуррентные сети, механизмы внимания, методы оптимизации, вычислительную производительность, компьютерное зрение и обработку естественного языка. Код приведён для нескольких фреймворков глубокого обучения.
Книга распространяется по лицензии CC BY-SA 4.0. Авторство оригинала, лицензия и происхождение материалов описаны на страницах «Авторство и лицензия» и «Происхождение материалов».
Перевод выполнен полностью: предисловие, установка, обозначения, главы 1–15, приложение «Инструменты для глубокого обучения» и список литературы. Рисунки и таблицы пронумерованы по разделам, как в оригинале. Сведения о том, что изменено относительно оригинала, см. страницу «Происхождение материалов».
Предисловие
Ещё несколько лет назад ни в крупных компаниях, ни в стартапах не было целых отделов специалистов по глубокому обучению, разрабатывающих интеллектуальные продукты и услуги. Когда в эту область пришли мы, младшие из авторов, машинное обучение ещё не попадало в заголовки газет. Наши родители понятия не имели, что такое машинное обучение, не говоря уже о том, почему мы могли бы предпочесть его карьере в медицине или юриспруденции. Машинное обучение было перспективной академической дисциплиной с узким кругом практических применений. А те применения, которые существовали, — например, распознавание речи и компьютерное зрение, — требовали столько предметных знаний, что их обычно считали совершенно отдельными областями, где машинное обучение было лишь небольшим компонентом. Поэтому нейронные сети — предшественники моделей глубокого обучения, которым посвящена эта книга, — считались устаревшим инструментом.
Всего за последние пять лет глубокое обучение застало мир врасплох и ускорило прогресс в самых разных областях: компьютерном зрении, обработке естественного языка, автоматическом распознавании речи, обучении с подкреплением и статистическом моделировании. Благодаря этим достижениям мы можем создавать автомобили с более высокой степенью автономности, чем когда-либо (хотя и не такой высокой, как пытаются убедить нас некоторые компании), системы умных ответов, которые сами составляют черновики обычных писем и освобождают людей от угнетающе огромных почтовых ящиков, и программы, которые в го и других играх обыгрывают лучших игроков мира — а это ещё недавно считалось делом далёкого будущего. Эти инструменты уже оказывают всё более широкое влияние на промышленность и общество: они меняют способы создания фильмов и диагностики заболеваний и играют растущую роль в фундаментальных науках — от астрофизики до биологии.
О книге
Эта книга — наша попытка сделать глубокое обучение доступным: научить читателя концепциям, контексту и коду.
Среда, объединяющая код, математику и HTML
Чтобы любая вычислительная технология раскрыла весь свой потенциал, она должна быть хорошо понята, хорошо документирована и опираться на зрелые, хорошо поддерживаемые инструменты. Ключевые идеи должны быть чётко изложены, чтобы новым специалистам требовалось как можно меньше времени на то, чтобы войти в курс дела. Зрелые библиотеки должны автоматизировать типовые задачи, а примеры кода должны позволять практикам легко изменять, применять и расширять типовые приложения под свои нужды. Возьмём для примера динамические веб-приложения. Хотя многие компании, например Amazon, разработали успешные веб-приложения на основе баз данных ещё в 1990-х годах, потенциал этой технологии для поддержки творческих предпринимателей был реализован в гораздо большей степени за последние десять лет — отчасти благодаря появлению мощных, хорошо документированных фреймворков.
Проверить потенциал глубокого обучения непросто, потому что любое отдельное приложение объединяет разные дисциплины. Применение глубокого обучения требует одновременно понимать: (1) мотивацию постановки задачи определённым образом; (2) математику данного подхода к моделированию; (3) алгоритмы оптимизации, подгоняющие модели под данные; (4) инженерные приёмы, позволяющие эффективно обучать модели, справляться с вычислительными ловушками и максимально использовать имеющееся оборудование. Учить одновременно критическому мышлению, необходимому для формулировки задач, математике, необходимой для их решения, и программным инструментам, необходимым для реализации этих решений, — серьёзная задача.
Когда мы начинали работу над этой книгой, не существовало ресурсов, которые одновременно: (1) были бы актуальными; (2) охватывали все области современного машинного обучения с достаточной технической глубиной; (3) сочетали качественное изложение, характерное для хорошего учебника, с чистым исполняемым кодом, какой ожидаешь найти в практических руководствах. Мы нашли множество примеров кода о том, как пользоваться тем или иным фреймворком глубокого обучения (например, как выполнять базовые численные вычисления с матрицами в TensorFlow) или как реализовать конкретные приёмы (например, фрагменты кода для LeNet, AlexNet, ResNet), разбросанные по блогам и репозиториям GitHub. Однако такие примеры обычно сосредоточены на том, как реализовать тот или иной подход, и оставляют за кадром обсуждение того, почему принимаются те или иные алгоритмические решения. Интерактивные ресурсы по отдельным темам появлялись лишь время от времени — например, увлекательные записи в блоге Distill или личные блоги, — но они охватывали лишь избранные темы глубокого обучения и часто не содержали кода. С другой стороны, появилось несколько учебников, из которых самый известный — «Deep Learning» (Goodfellow et al., 2016), — дающих всестороннее обзорное изложение концепций глубокого обучения, но они не связывают описание этих концепций с их реализацией в коде, и порой читатель остаётся в полном неведении относительно того, как их реализовать. Кроме того, слишком много ресурсов спрятано за платными стенами коммерческих поставщиков курсов.
Мы поставили себе целью создать ресурс, который: (1) был бы свободно доступен всем; (2) обладал бы достаточной технической глубиной, чтобы стать отправной точкой на пути к тому, чтобы стать настоящим специалистом по прикладному машинному обучению; (3) включал бы исполняемый код, показывающий читателям, как решать задачи на практике; (4) позволял быстро обновляться как нам, так и сообществу в целом; (5) дополнялся форумом для интерактивного обсуждения технических деталей и ответов на вопросы.
Эти цели нередко противоречили друг другу. Формулы, теоремы и ссылки лучше всего оформлять и вёрстывать в LaTeX. Код лучше всего описывать на Python. Веб-страницы изначально строятся на HTML и JavaScript. Кроме того, мы хотим, чтобы содержимое было доступно и как исполняемый код, и как печатная книга, и как загружаемый PDF, и как сайт в интернете. Подходящих под эти требования инструментов и рабочих процессов не существует, поэтому нам пришлось собрать их самим. Наш подход подробно описан в разделе 16.5. Мы выбрали GitHub для хранения исходников и приёма правок, блокноты Jupyter — для сочетания кода, формул и текста, Sphinx — как движок вёрстки, создающий разные выходные форматы, и Discourse — для форума. Хотя наша система ещё несовершенна, эти решения дают хороший компромисс между противоречивыми требованиями. Мы полагаем, что это, возможно, первая книга, изданная с использованием такого интегрированного рабочего процесса.
Обучение на практике
Многие учебники последовательно излагают набор тем, каждую очень подробно. Например, превосходный учебник Криса Бишопа (Bishop, 2006) учит каждой теме настолько обстоятельно, что добраться до главы о линейной регрессии требует немалой работы. Хотя специалисты любят эту книгу именно за её основательность, для начинающих это свойство ограничивает её полезность как вводного текста.
В этой книге мы будем излагать большинство концепций по мере необходимости. Иными словами, вы будете узнавать концепции именно тогда, когда они нужны для достижения какой-то практической цели. Хотя в начале мы потратим некоторое время на базовые сведения — линейную алгебру и вероятность, — мы хотим, чтобы вы успели почувствовать удовлетворение от обучения модели прежде, чем вникать в более экзотические распределения вероятностей.
Помимо нескольких вводных разделов, дающих ускоренный курс базовой математики, каждая последующая глава вводит разумное число новых концепций и содержит несколько самодостаточных рабочих примеров на реальных наборах данных. Это создаёт организационные трудности. Некоторые модели логично было бы сгруппировать в одном разделе. А некоторые идеи лучше всего преподавать, последовательно запуская несколько моделей. С другой стороны, у подхода «один рабочий пример — один раздел» есть большое преимущество: он позволяет как можно проще начать собственный исследовательский проект, воспользовавшись нашим кодом. Достаточно скопировать содержимое раздела и приступить к изменениям.
Исполняемый код мы будем перемежать справочным материалом по мере необходимости. Как правило, мы будем ошибаться в сторону того, чтобы предоставлять инструменты раньше, чем полностью объясним их (а справочные сведения дадим позже). Например, мы можем использовать стохастический градиентный спуск, прежде чем полностью объясним, почему он полезен или почему он работает. Это помогает дать практикам «боеприпасы», необходимые для быстрого решения задач, но требует от читателя доверия к некоторым нашим решениям.
Эта книга будет учить концепциям глубокого обучения с нуля. Иногда нам хочется углубиться в детали моделей, которые обычно скрыты высокоуровневыми абстракциями фреймворков глубокого обучения. Особенно это касается базовых учебных разделов, где мы хотим, чтобы вы понимали всё, что происходит в данном слое или оптимизаторе. В таких случаях мы обычно приводим два варианта примера: в одном мы реализуем всё с нуля, опираясь только на операции с тензорами и автоматическое дифференцирование; в другом, более практичном, пишем лаконичный код с помощью высокоуровневых API фреймворков глубокого обучения. Как только мы объясним, как работает какой-то компонент, в последующих разделах мы будем пользоваться высокоуровневыми API.
Содержание и структура
Книгу можно условно разделить на три части, показанные на рис. 1 разными цветами:
Рис. 1. Структура книги
-
Первая часть охватывает основы и предварительные знания. Глава 1 — введение в глубокое обучение. В главе 2 мы быстро знакомим вас с необходимыми для практики глубокого обучения предварительными сведениями: как хранить и обрабатывать данные и как применять различные численные операции, основанные на базовых понятиях линейной алгебры, математического анализа и теории вероятностей. Главы 3 и 4 охватывают самые базовые концепции и приёмы глубокого обучения, такие как линейная регрессия, многослойные перцептроны и регуляризация.
-
Следующие шесть глав посвящены современным приёмам глубокого обучения. Глава 5 описывает ключевые компоненты вычислений в глубоком обучении и закладывает основу для реализации более сложных моделей в дальнейшем. Затем в главах 6 и 7 мы представляем свёрточные нейронные сети (convolutional neural network, CNN) — мощный инструмент, составляющий основу большинства современных систем компьютерного зрения. Далее, в главах 8 и 9, мы вводим рекуррентные нейронные сети (recurrent neural network, RNN) — модели, использующие временную или последовательную структуру данных и обычно применяемые для обработки естественного языка и прогнозирования временных рядов. В главе 10 мы представляем новый класс моделей, использующих приём под названием механизмы внимания; в последнее время они начали вытеснять рекуррентные нейронные сети в обработке естественного языка. Эта часть поможет вам быстро освоить основные инструменты, лежащие в основе большинства современных приложений глубокого обучения.
-
Третья часть посвящена масштабируемости, эффективности и приложениям. Сначала в главе 11 мы обсуждаем несколько распространённых алгоритмов оптимизации, используемых для обучения моделей глубокого обучения. В следующей главе 12 рассматриваются несколько ключевых факторов, влияющих на вычислительную производительность кода глубокого обучения. В главе 13 мы показываем основные применения глубокого обучения в компьютерном зрении. В главах 14 и 15 мы показываем, как предобучать модели языковых представлений и применять их к задачам обработки естественного языка.
Код
В большинстве разделов этой книги есть исполняемый код, потому что мы считаем интерактивный опыт обучения очень важным в глубоком обучении. Сейчас некоторую интуицию можно выработать только методом проб и ошибок: слегка подправляя код и наблюдая за результатом. В идеале изящная математическая теория могла бы точно подсказать, как менять код для достижения желаемого результата. К сожалению, такой изящной теории пока нет. Несмотря на все наши усилия, формальных объяснений для разных приёмов по-прежнему не хватает — как потому, что математика, описывающая эти модели, может быть очень сложной, так и потому, что серьёзное изучение этих тем лишь недавно набрало обороты. Мы надеемся, что по мере развития теории глубокого обучения будущие версии этой книги смогут дать понимание там, где текущая версия не может.
Иногда, чтобы избежать лишних повторений, мы выносим в пакет d2l функции, классы и прочее, которые часто импортируются и используются в книге. Любой блок кода — функцию, класс или набор импортов, — который нужно сохранить в пакете, мы помечаем #@save. Подробное описание этих функций и классов приведено в разделе 16.6. Пакет d2l лёгкий и требует в качестве зависимостей только следующие пакеты и модули:
#@save
import collections
from collections import defaultdict
from IPython import display
import math
from matplotlib import pyplot as plt
from matplotlib_inline import backend_inline
import os
import pandas as pd
import random
import re
import shutil
import sys
import tarfile
import time
import requests
import zipfile
import hashlib
d2l = sys.modules[__name__]
MXNet: большая часть кода в этой книге основана на Apache MXNet. MXNet — фреймворк глубокого обучения с открытым исходным кодом, который выбирают Amazon, а также многие университеты и компании. Весь код этой книги прошёл проверку на последней версии MXNet. Однако из-за быстрого развития глубокого обучения часть кода в печатной версии оригинала может перестать работать в будущих версиях MXNet. Мы планируем поддерживать онлайн-версию в актуальном состоянии. Если вы столкнётесь с такой проблемой, обратитесь к разделу «Установка», чтобы обновить код и среду выполнения.
Вот как мы импортируем модули из MXNet:
MXNet:
#@save
from mxnet import autograd, context, gluon, image, init, np, npx
from mxnet.gluon import nn, rnn
PyTorch: большая часть кода в этой книге основана на PyTorch — фреймворке глубокого обучения с открытым исходным кодом, очень популярном в исследовательском сообществе. Весь код этой книги прошёл проверку на последней версии PyTorch. Однако из-за быстрого развития глубокого обучения часть кода в печатной версии оригинала может перестать работать в будущих версиях PyTorch. Мы планируем поддерживать онлайн-версию в актуальном состоянии. Если вы столкнётесь с такой проблемой, обратитесь к разделу «Установка», чтобы обновить код и среду выполнения.
Вот как мы импортируем модули из PyTorch:
PyTorch:
#@save
import numpy as np
import torch
import torchvision
from torch import nn
from torch.nn import functional as F
from torch.utils import data
from torchvision import transforms
from PIL import Image
TensorFlow: большая часть кода в этой книге основана на TensorFlow — фреймворке глубокого обучения с открытым исходным кодом, очень популярном и в исследовательском сообществе, и в промышленности. Весь код этой книги прошёл проверку на последней версии TensorFlow. Однако из-за быстрого развития глубокого обучения часть кода в печатной версии оригинала может перестать работать в будущих версиях TensorFlow. Мы планируем поддерживать онлайн-версию в актуальном состоянии. Если вы столкнётесь с такой проблемой, обратитесь к разделу «Установка», чтобы обновить код и среду выполнения.
Вот как мы импортируем модули из TensorFlow:
TensorFlow:
#@save
import numpy as np
import tensorflow as tf
PaddlePaddle:
#@save
import numpy as np
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
from paddle.nn import functional as F
from paddle.vision import transforms
import paddle.vision as paddlevision
from PIL import Image
paddle.disable_signal_handler()
Целевая аудитория
Книга рассчитана на студентов (бакалавриата и магистратуры), инженеров и исследователей, которые хотят уверенно овладеть практическими приёмами глубокого обучения. Поскольку мы объясняем каждую концепцию с нуля, предварительный опыт глубокого или машинного обучения не требуется. Полноценное изложение методов глубокого обучения требует некоторой математики и программирования, но мы предполагаем лишь базовые знания: линейная алгебра, математический анализ, вероятность и самые основы программирования на Python. Кроме того, в приложениях к онлайн-версии оригинала мы даём обзор большей части математики, которая используется в книге. В большинстве случаев мы отдаём предпочтение интуиции и идеям перед математической строгостью. Есть много замечательных книг, которые могут увести заинтересованного читателя гораздо дальше. «Линейный анализ» Белы Боллобаша (Bollobas, 1999) глубоко рассматривает линейную алгебру и функциональный анализ. «All of Statistics» (Wasserman, 2013) — отличное руководство по статистике. Если вы раньше не пользовались языком Python, можно внимательно изучить этот учебник по Python.
Форум
В связи с этой книгой мы запустили форум discuss.d2l.ai. Если у вас возникнут вопросы по какому-либо разделу книги, ссылку на соответствующую страницу обсуждения вы найдёте в конце каждого раздела.
Благодарности
Мы благодарим сотни авторов англоязычных и китайских черновиков. Они помогли улучшить содержание и дали ценные отзывы. Мы благодарим Анируддха Дагара (Anirudh Dagar) и Тана Юаня (Tang Yuan), которые адаптировали часть ранних версий реализаций на MXNet к PyTorch и TensorFlow соответственно. Мы благодарим команду Baidu, которая адаптировала более новые реализации на PyTorch к PaddlePaddle. Мы благодарим Чжан Шуая (Zhang Shuai) за интеграцию обновлённого стиля LaTeX в сборку PDF-файла.
Особо мы хотим поблагодарить каждого, кто участвовал в работе над китайской версией, — их самоотверженный труд сделал эту книгу лучше. Их идентификаторы на GitHub или имена (в произвольном порядке): alxnorden, avinashingit, bowen0701, brettkoonce, Chaitanya Prakash Bapat, cryptonaut, Davide Fiocco, edgarroman, gkutiel, John Mitro, Liang Pu, Rahul Agarwal, Mohamed Ali Jamaoui, Michael (Stu) Stewart, Mike Müller, NRauschmayr, Prakhar Srivastav, sad-, sfermigier, Sheng Zha, sundeepteki, topecongiro, tpdi, vermicelli, Vishaal Kapoor, Vishwesh Ravi Shrimali, YaYaB, Yuhong Chen, Evgeniy Smirnov, lgov, Simon Corston-Oliver, Igor Dzreyev, Ha Nguyen, pmuens, Andrei Lukovenko, senorcinco, vfdev-5, dsweet, Mohammad Mahdi Rahimi, Abhishek Gupta, uwsd, DomKM, Lisa Oakley, Bowen Li, Aarush Ahuja, Prasanth Buddareddygari, brianhendee, mani2106, mtn, lkevinzc, caojilin, Lakshya, Fiete Lüer, Surbhi Vijayvargeeya, Muhyun Kim, dennismalmgren, adursun, Anirudh Dagar, liqingnz, Pedro Larroy, lgov, ati-ozgur, Jun Wu, Matthias Blume, Lin Yuan, geogunow, Josh Gardner, Maximilian Böther, Rakib Islam, Leonard Lausen, Abhinav Upadhyay, rongruosong, Steve Sedlmeyer, Ruslan Baratov, Rafael Schlatter, liusy182, Giannis Pappas, ati-ozgur, qbaza, dchoi77, Adam Gerson, Phuc Le, Mark Atwood, christabella, vn09, Haibin Lin, jjangga0214, RichyChen, noelo, hansent, Giel Dops, dvincent1337, WhiteD3vil, Peter Kulits, codypenta, joseppinilla, ahmaurya, karolszk, heytitle, Peter Goetz, rigtorp, Tiep Vu, sfilip, mlxd, Kale-ab Tessera, Sanjar Adilov, MatteoFerrara, hsneto, Katarzyna Biesialska, Gregory Bruss, Duy–Thanh Doan, paulaurel, graytowne, Duc Pham, sl7423, Jaedong Hwang, Yida Wang, cys4, clhm, Jean Kaddour, austinmw, trebeljahr, tbaums, Cuong V. Nguyen, pavelkomarov, vzlamal, NotAnotherSystem, J-Arun-Mani, jancio, eldarkurtic, the-great-shazbot, doctorcolossus, gducharme, cclauss, Daniel-Mietchen, hoonose, biagiom, abhinavsp0730, jonathanhrandall, ysraell, Nodar Okroshiashvili, UgurKap, Jiyang Kang, StevenJokes, Tomer Kaftan, liweiwp, netyster, ypandya, NishantTharani, heiligerl, SportsTHU, Hoa Nguyen, manuel-arno-korfmann-webentwicklung, aterzis-personal, nxby, Xiaoting He, Josiah Yoder, mathresearch, mzz2017, jroberayalas, iluu, ghejc, BSharmi, vkramdev, simonwardjones, LakshKD, TalNeoran, djliden, Nikhil95, Oren Barkan, guoweis, haozhu233, pratikhack, 315930399, tayfununal, steinsag, charleybeller, Andrew Lumsdaine, Jiekui Zhang, Deepak Pathak, Florian Donhauser, Tim Gates, Adriaan Tijsseling, Ron Medina, Gaurav Saha, Murat Semerci, Lei Mao, Zhu Yuanxiang, thebesttv, Quanshangze Du, Yanbo Chen.
Мы благодарим Amazon Web Services, и в особенности Свами Сивасубраманиана (Swami Sivasubramanian), Питера ДеСантиса (Peter DeSantis), Адама Селипски (Adam Selipsky) и Эндрю Джесси (Andrew Jassy), за щедрую поддержку работы над этой книгой. Без доступного времени, ресурсов, обсуждений с коллегами и постоянного ободрения эта книга не была бы написана.
Резюме
- Глубокое обучение произвело переворот в распознавании образов, предложив набор технологий, которые применяются в компьютерном зрении, обработке естественного языка и автоматическом распознавании речи.
- Чтобы успешно применять глубокое обучение, необходимо понимать, как сформулировать задачу, математику моделирования, алгоритмы подгонки моделей к данным и инженерные приёмы, с помощью которых всё это реализуется.
- Эта книга — всесторонний ресурс, в котором текст, рисунки, математика и код собраны в одном месте.
- Чтобы получить ответы на вопросы, связанные с этой книгой, зайдите на наш форум discuss.d2l.ai.
- Все блокноты Jupyter можно скачать на GitHub.
Упражнения
- Зарегистрируйте учётную запись на форуме этой книги discuss.d2l.ai.
- Установите Python на свой компьютер.
- Перейдите по ссылкам в конце раздела на форум: там вы можете попросить о помощи, обсудить книгу и найти ответы на вопросы, общаясь с авторами и сообществом.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
-
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
-
Bollobás, B. (1999). Linear analysis. Cambridge University Press.
-
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press. http://www.deeplearningbook.org
-
Wasserman, L. (2013). All of statistics: A concise course in statistical inference. Springer Science & Business Media.
-
Bollobás, B. (1999). Linear analysis. Cambridge University Press.
Установка
Чтобы быстро начать работу и получить практический опыт, нам нужно настроить среду для запуска Python, Jupyter Notebook, необходимых библиотек и кода этой книги.
Установка Miniconda
Проще всего установить Miniconda, которая работает на Python 3.x. Если conda уже установлена, следующие шаги можно пропустить. Зайдите на сайт Miniconda и выберите подходящую версию в соответствии с вашей версией Python 3.x.
Если вы используете macOS и версия Python — 3.9 (на ней мы тестировали код), скачайте bash-скрипт, в имени которого есть строка «MacOSX», и выполните следующее:
# Пример для процессора Intel; имя файла может отличаться
sh Miniconda3-py39_4.12.0-MacOSX-x86_64.sh -b
Если вы используете Linux и версия Python — 3.9 (на ней мы тестировали код), скачайте bash-скрипт, в имени которого есть строка «Linux», и выполните следующее:
# Имя файла может отличаться
sh Miniconda3-py39_4.12.0-Linux-x86_64.sh -b
Затем инициализируйте оболочку терминала, чтобы можно было запускать conda напрямую.
~/miniconda3/bin/conda init
Теперь закройте и заново откройте текущую оболочку. Создайте новое окружение командой:
conda create --name d2l python=3.9 -y
Теперь активируйте окружение d2l:
conda activate d2l
Установка фреймворка глубокого обучения и пакета d2l
Перед установкой фреймворка глубокого обучения проверьте, есть ли на компьютере доступный GPU. Например, посмотрите, установлен ли на компьютере GPU NVIDIA и CUDA. Если на машине нет GPU, беспокоиться не стоит: для первых глав вполне достаточно CPU. Но если вы хотите комфортно пройти все главы, заранее обзаведитесь GPU и установите GPU-версию фреймворка глубокого обучения.
MXNet: чтобы установить GPU-версию MXNet, сначала нужно узнать установленную версию CUDA (это можно проверить командой nvcc --version или cat /usr/local/cuda/version.txt). Предположим, что установлена CUDA 10.1; выполните следующие команды:
# Для пользователей Linux и macOS
pip install mxnet-cu101==1.7.0
# Для пользователей Windows
pip install mxnet-cu101==1.7.0 -f https://dist.mxnet.io/python
Число в конце mxnet-cu101 можно менять в соответствии с версией CUDA, например: для CUDA 10.0 — cu100, для CUDA 9.0 — cu90.
Если на машине нет GPU NVIDIA или CUDA, CPU-версию MXNet можно установить так:
pip install mxnet==1.7.0.post1
PyTorch: CPU- или GPU-версию PyTorch можно установить так:
pip install torch==1.12.0
pip install torchvision==0.13.0
TensorFlow: CPU- или GPU-версию TensorFlow можно установить так:
pip install tensorflow==2.8.0
pip install tensorflow-probability==0.16.0
PaddlePaddle: чтобы установить GPU-версию PaddlePaddle, сначала нужно узнать установленную версию CUDA (это можно проверить командой nvcc --version или cat /usr/local/cuda/version.txt). Предположим, что установлена CUDA 11.2; выполните следующую команду:
python -m pip install paddlepaddle-gpu==2.3.2.post112 -f https://www.paddlepaddle.org.cn/whl/linux/mkl/avx/stable.html
Если на машине нет GPU NVIDIA или CUDA, CPU-версию PaddlePaddle можно установить так:
# Параметр -i задаёт зеркало PyPI университета Цинхуа; его можно опустить
python -m pip install paddlepaddle==2.3.2 -i https://pypi.tuna.tsinghua.edu.cn/simple
Следующий шаг — установить пакет d2l, чтобы было удобно вызывать функции и классы, которые часто используются в книге:
pip install d2l==0.17.6
Скачивание блокнотов D2L
Далее нужно скачать код книги. Можно скачать и распаковать его, выбрав пункт с блокнотами Jupyter вверху HTML-страницы книги на сайте оригинала zh.d2l.ai, либо загрузить следующим образом:
MXNet:
mkdir d2l-zh && cd d2l-zh
curl https://zh-v2.d2l.ai/d2l-zh-2.0.0.zip -o d2l-zh.zip
unzip d2l-zh.zip && rm d2l-zh.zip
cd mxnet
PyTorch:
mkdir d2l-zh && cd d2l-zh
curl https://zh-v2.d2l.ai/d2l-zh-2.0.0.zip -o d2l-zh.zip
unzip d2l-zh.zip && rm d2l-zh.zip
cd pytorch
TensorFlow:
mkdir d2l-zh && cd d2l-zh
curl https://zh-v2.d2l.ai/d2l-zh-2.0.0.zip -o d2l-zh.zip
unzip d2l-zh.zip && rm d2l-zh.zip
cd tensorflow
PaddlePaddle:
mkdir d2l-zh && cd d2l-zh
curl https://zh-v2.d2l.ai/d2l-zh-2.0.0.zip -o d2l-zh.zip
unzip d2l-zh.zip && rm d2l-zh.zip
cd paddle
Примечание: если unzip не установлен, его можно установить командой sudo apt install unzip.
После установки откройте Jupyter Notebook командой (в командной строке Windows перед запуском этой команды сначала перейдите в каталог с только что распакованным кодом книги):
jupyter notebook
Теперь откройте в браузере http://localhost:8888 (обычно он открывается автоматически). После этого можно запускать код каждого раздела книги. Перед запуском кода книги, обновлением фреймворка глубокого обучения или пакета d2l всегда выполняйте conda activate d2l, чтобы активировать среду выполнения. Чтобы выйти из окружения, выполните conda deactivate.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Обозначения
Ниже приведён обзор обозначений, используемых в книге.
Числа
- — скаляр
- — вектор
- — матрица
- — тензор
- — единичная матрица
- , — -й элемент вектора
- , — элемент матрицы в -й строке и -м столбце
Теория множеств
- — множество
- — множество целых чисел
- — множество действительных чисел
- — множество -мерных действительных векторов
- — множество действительных матриц с строками и столбцами
- — объединение множеств и
- — пересечение множеств и
- — разность множеств и (относительное дополнение до )
Функции и операторы
- — функция
- — натуральный логарифм
- — показательная функция
- — индикаторная функция
- — транспонирование вектора или матрицы
- — обратная матрица
- — поэлементное умножение
- — конкатенация
- — мощность множества
- — норма
- — норма
- — скалярное произведение векторов и
- — сумма
- — произведение
- — определение
Математический анализ
- — производная по
- — частная производная по
- — градиент по
- — определённый интеграл по на отрезке от до
- — неопределённый интеграл по
Теория вероятностей и теория информации
- — распределение вероятностей
- — случайная величина имеет распределение вероятностей
- — условная вероятность при условии
- — функция плотности вероятности
- — математическое ожидание функции по
- — случайные величины и независимы
- — случайные величины и условно независимы при заданной случайной величине
- — дисперсия случайной величины
- — стандартное отклонение случайной величины
- — ковариация случайных величин и
- — корреляция случайных величин и
- — энтропия случайной величины
- — дивергенция Кульбака — Лейблера между и
Сложность
- — обозначение «O-большое»
1. Введение
Ещё совсем недавно почти каждая компьютерная программа, с которой мы ежедневно сталкиваемся, создавалась разработчиками «с нуля». Допустим, нам нужно написать приложение для управления интернет-магазином. Несколько часов поломав голову у доски, мы, вероятно, набросали бы общие контуры решения примерно такого вида: сначала пользователь работает с приложением через интерфейс в веб-браузере или мобильном приложении; затем приложение обращается к движку базы данных, чтобы сохранять историю транзакций и отслеживать действия каждого пользователя. Главная часть такого приложения — «бизнес-логика», которая подробно описывает, что программа должна делать в каждой из возможных ситуаций.
Чтобы доработать бизнес-логику, разработчики должны продумать все пограничные случаи, которые могут возникнуть, и для каждого предусмотреть подходящее правило. Когда покупатель нажимает «добавить в корзину», приложение создаёт запись в таблице корзин, связывая идентификатор пользователя с идентификатором товара. Конечно, написать безупречное приложение с первой попытки почти невозможно, но в большинстве случаев разработчики могут опираться на бизнес-логику, писать соответствующий ей код и тестировать его до тех пор, пока он не начнёт удовлетворять потребности пользователей. Проектировать автоматизированные системы, которые управляют работой продуктов и сервисов, исходя из бизнес-логики, — выдающееся достижение человеческого мышления.
К счастью, для растущего сообщества специалистов по машинному обучению автоматизация многих задач уже не зависит от логики, которую человек способен заранее предусмотреть. Представим, что разработчику нужно решить одну из следующих задач:
- написать приложение, которое получает географические данные, спутниковые снимки и часть исторических метеорологических данных и предсказывает завтрашнюю погоду;
- написать приложение, которое принимает вопрос, сформулированный естественным языком, и правильно на него отвечает;
- написать приложение, которое принимает изображение, распознаёт на нём людей и обводит контуром каждого из них;
- написать приложение, которое рекомендует пользователю товары, которые ему, вероятно, понравятся, но которые он вряд ли найдёт при обычном просмотре.
В этих случаях даже сильнейшие программисты не смогут предложить идеальное решение, и причины могут быть разными. Иногда задача подчиняется закономерностям, которые меняются со временем, и программа должна подстраиваться автоматически. Иногда связи внутри задачи слишком сложны (например, связь между пикселями и абстрактными категориями) и требуют тысяч или миллионов вычислений. Даже когда человеческий глаз без усилий справляется с подобными задачами, вычисления, которые за этим стоят, недоступны человеческому осознанию.
Машинное обучение (machine learning, ML) — класс мощных методов, которые умеют учиться на опыте. Обычно алгоритм машинного обучения использует наблюдаемые данные или взаимодействие со средой, и по мере накопления опыта его качество растёт. Напротив, интернет-магазин из нашего примера, выполняющий одну и ту же бизнес-логику, не станет лучше, сколько бы опыта ни накопил, — если только разработчики не заметят проблему и не обновят программу. Эта книга проведёт читателя в мир машинного обучения и уделит особое внимание основам глубокого обучения (deep learning, DL). Глубокое обучение — мощный набор методов, который стимулирует прогресс в таких областях, как компьютерное зрение, обработка естественного языка, здравоохранение и геномика.
1.1 Машинное обучение в повседневной жизни
Машинное обучение окружает нас повсюду. Представим, что авторы этой книги вместе едут в кофейню. Астон достаёт iPhone и говорит: «Hey Siri!» — и система распознавания речи в телефоне просыпается. Затем Му Ли говорит Siri: «Поехали в кофейню Starbucks». Система распознавания речи автоматически переводит речь в текст и запускает приложение карт. Приложение, запустившись, отбирает несколько маршрутов и для каждого показывает расчётное время в пути…
Так видно, что машинное обучение пронизывает всю нашу жизнь: за несколько секунд взаимодействия с телефоном может одновременно работать сразу несколько моделей машинного обучения.
Теперь предположим, что нам нужно написать программу, которая реагирует на «ключевое слово пробуждения» — например, «Alexa», «Сяо Ай Тунсюэ» (小爱同学) или «Hey Siri». Попробуем написать её на компьютере обычным редактором кода, как показано на рис. 1.1. Задача кажется трудноразрешимой: микрофон собирает около 44 000 отсчётов в секунду, и каждый из них — измерение амплитуды звуковой волны. Но это измерение нельзя напрямую связать с ключевым словом. Как написать программу, которая по сырому аудиофрагменту с микрофона надёжно выдаёт предсказание из множества — содержит ли фрагмент ключевое слово? Мы не знаем, как написать такую программу. Именно поэтому нужно машинное обучение.
Рис. 1.1. Распознавание ключевого слова
Как правило, даже если мы не знаем, как явно объяснить компьютеру, как по входу получить выход, наш мозг всё равно способен выполнять такие когнитивные функции. Иначе говоря, даже не зная, как написать программу, которая распознаёт слово «Alexa», наш мозг сам умеет его распознавать. Благодаря этой способности мы можем собрать набор данных (dataset) — большое количество аудиофрагментов, в которых помечено, есть ли в них ключевое слово. При использовании алгоритма машинного обучения нам не нужно «явно» конструировать систему, которая распознаёт ключевое слово. Вместо этого достаточно определить гибкую программную схему, поведение которой задаётся множеством параметров (parameter). Затем с помощью набора данных подбираются «наилучшие текущие значения параметров» — такие, при которых выбранная мера качества показывает наилучший результат выполнения задачи.
Что же такое параметры? Их можно представить как ручки настройки: поворачивая их, мы меняем поведение программы. Программа с конкретным набором настроенных параметров называется моделью (model). Совокупность всех различных программ (отображений «вход — выход», которые можно получить, меняя параметры) называется семейством моделей. Метапрограмма, которая использует набор данных, чтобы выбрать параметры, называется алгоритмом обучения (learning algorithm).
Прежде чем решать задачу с помощью алгоритма машинного обучения, мы должны точно её определить: установить, каковы вход (input) и выход (output), и выбрать подходящее семейство моделей. В нашем примере модель получает аудио в качестве входа и выдаёт выбор «да» или «нет». Если всё пойдёт хорошо, то после обучения модель обычно правильно предсказывает, содержит ли фрагмент ключевое слово.
Теперь модель каждый раз, когда слышит «Alexa», отвечает «да». Поскольку ключевое слово выбрано произвольно, нам может понадобиться достаточно богатое семейство моделей, чтобы в нём нашлись разные модели. Например, другая модель того же семейства будет отвечать «да» только на «Hey Siri». В идеале одно и то же семейство моделей должно подходить и для распознавания «Alexa», и для распознавания «Hey Siri», ведь интуитивно это похожие задачи. Однако если нам нужно работать с совершенно другими входами или выходами, например, преобразовывать изображение в подпись или текст с английского на китайский, может понадобиться совсем другое семейство моделей.
Но если все «кнопки» модели (её параметры) выставлены случайно, она вряд ли распознает «Alexa», «Hey Siri» или любое другое слово. В машинном обучении обучение (learning) — процесс тренировки модели. В ходе него мы находим правильный набор параметров, благодаря которому модель ведёт себя нужным образом. Иначе говоря, мы обучаем (train) модель на данных. Как показано на рис. 1.2, процесс обучения обычно включает следующие шаги:
- Начинаем с модели со случайно заданными параметрами; такая модель пока ничего «не умеет».
- Получаем примеры данных (например, аудиофрагменты и соответствующие метки «да» или «нет»).
- Подстраиваем параметры так, чтобы модель лучше работала на этих примерах.
- Повторяем шаги 2 и 3, пока работа модели над задачей не станет удовлетворительной.
Рис. 1.2. Типичный процесс обучения
Итак, вместо программы распознавания ключевого слова мы написали программу, которая учится. Если взять огромный размеченный набор данных, она, скорее всего, научится распознавать ключевое слово. Такой подход — «определять поведение программы с помощью набора данных» — можно назвать программированием с данными (programming with data). Например, можно сконструировать «детектор кошек», показав системе машинного обучения множество фотографий кошек и собак. Детектор в итоге научится выдавать очень большое положительное число для изображения кошки и очень маленькое отрицательное — для изображения собаки. Если же детектор не уверен, кошка или собака на снимке, он выдаст число, близкое к нулю…
Этот пример — лишь верхушка айсберга среди распространённых применений машинного обучения. Глубокое обучение — один из главных разделов машинного обучения, и далее в этом разделе мы разберём его подробнее.
1.2 Ключевые компоненты машинного обучения
Начнём с основных компонентов. Они присутствуют в любой задаче машинного обучения:
- данные (data), которые можно использовать для обучения;
- модель (model), которая преобразует данные;
- целевая функция (objective function), которая количественно выражает эффективность модели;
- алгоритм (algorithm), который подстраивает параметры модели для оптимизации целевой функции.
1.2.1 Данные
Без данных нет и науки о данных. Каждый набор данных состоит из отдельных примеров (example, sample), которые, как правило, подчиняются условию независимости и одинаковой распределённости (independently and identically distributed, i.i.d.). Примеры иногда называют точками данных (data point) или экземплярами данных (data instance). Обычно каждый пример описывается набором признаков (features, или ковариат (covariates)), на основе которых модель машинного обучения делает предсказания. В задачах обучения с учителем особый атрибут, который нужно предсказать, называется меткой (label, или целевым значением (target)).
При работе с изображениями каждая фотография — это пример, а её признаки задаются упорядоченным списком значений для каждого пикселя. Например, цветная фотография размером состоит из чисел, где «3» соответствует интенсивности красного, зелёного и синего каналов в каждой точке. Или возьмём медицинские данные: при заданном наборе стандартных признаков (возраста, жизненных показателей, диагнозов) по ним можно пытаться предсказать, выживет ли пациент.
Если у всех примеров одно и то же число признаков, то вектор признаков имеет фиксированную длину; эта длина называется размерностью (dimensionality) данных. Фиксированная длина вектора признаков — удобное свойство: она избавляет от лишних забот и позволяет единообразно обрабатывать большое количество примеров.
Однако не все данные можно представить векторами фиксированной длины. Например, если изображения получены со стандартного микроскопа, фиксированный размер разумен, но изображения из интернета вряд ли будут иметь одинаковое разрешение или форму. Можно обрезать их до стандартного размера, но этот приём ограничен и грозит потерей информации. Текстовые данные ещё меньше подходят под требование фиксированной длины: например, в отзывах покупателей на таких сайтах, как Amazon, одни тексты очень короткие («Отлично!»), а другие — длинные. По сравнению с традиционными методами машинного обучения одно из главных преимуществ глубокого обучения — способность работать с данными разной длины.
Как правило, чем больше данных, тем проще работать. Больше данных позволяет обучать более мощные модели и снижает зависимость от заранее сформулированных гипотез. Переход от небольших наборов данных к большим стал основой успеха современного глубокого обучения: без больших наборов данных многие захватывающие модели оказываются бесполезными. Даже если некоторые модели глубокого обучения работают на небольших наборах, по качеству они не превосходят традиционные методы.
Однако одних огромных объёмов данных недостаточно — нужны правильные данные. Если данные полны ошибок или их признаки не позволяют предсказать целевое значение, модель, скорее всего, окажется бесполезной. Эту мысль выражает известная поговорка: «Мусор на входе — мусор на выходе» («Garbage in, garbage out.»). Более того, плохие предсказания могут в разы усугубить последствия. В чувствительных приложениях — например, предиктивной полиции (predictive policing), отборе резюме и моделях кредитного риска — особенно важно помнить о последствиях «мусорных» данных.
Распространённая проблема — несбалансированные наборы данных: например, в медицинском обучающем наборе какие-то группы людей совсем не представлены. Представим, что мы хотим обучить модель распознавать рак кожи, но эта модель (на обучающем наборе) никогда не «видела» людей с тёмной кожей. Тогда она окажется беспомощной.
Другой пример: если обучить модель отбора резюме на «прошлых решениях о найме», модель может незаметно перенять исторические несправедливости и автоматизировать их. И всё это может происходить без чьего-либо ведома. Поэтому, когда данные недостаточно репрезентативны или содержат социальные предубеждения, модель с высокой вероятностью будет предвзятой.
1.2.2 Модель
Большинство задач машинного обучения связано с преобразованием данных. Например, система может по фотографии предсказывать, улыбается ли человек, или по набору показаний датчиков определять, насколько показания нормальны или аномальны. Простые модели справляются с такими задачами, но задачи, которые рассматриваются в этой книге, выходят за пределы возможностей классических методов. Главное отличие глубокого обучения от классических подходов в том, что оно опирается на мощные модели — сложные нейронные сети, в которых слои преобразований данных следуют один за другим; поэтому оно и называется глубоким обучением (deep learning). Обсуждая глубокие модели, мы также будем упоминать традиционные методы.
1.2.3 Целевая функция
Выше машинное обучение определялось как «обучение на опыте». Под «обучением» здесь понимается способность модели самостоятельно улучшать выполнение задачи. Но что считать настоящим улучшением?
В машинном обучении нужно определить меру того, насколько хороша или плоха модель. В большинстве случаев такую меру можно оптимизировать. Её называют целевой функцией (objective function).
Обычно целевую функцию задают так, чтобы её минимизировали, — ведь чем меньше, тем лучше. Поэтому такие функции иногда называют функциями потерь (loss function, или cost function). Но это лишь соглашение: можно взять и другую функцию и максимизировать её. Эти два подхода по сути эквивалентны и отличаются только знаком.
Когда задача состоит в предсказании числовых значений, самая распространённая функция потерь — квадратичная ошибка (squared error): квадрат разности между предсказанным и фактическим значениями. Для задач классификации чаще всего минимизируют долю ошибок — долю примеров, для которых предсказание не совпало с действительностью. Одни целевые функции (например, квадратичную ошибку) легко оптимизировать, а другие (например, долю ошибок) трудно оптимизировать напрямую из-за недифференцируемости или других сложностей. В таких случаях обычно оптимизируют суррогатную цель (surrogate objective).
Обычно функция потерь определяется через параметры модели и зависит от набора данных. На одном наборе данных мы можем найти наилучшие значения параметров, минимизируя суммарные потери. Набор данных, собранный для обучения, называется обучающим набором данных (training dataset, или обучающим набором (training set)). Однако модель, которая хорошо работает на обучающих данных, не обязательно покажет такой же результат на «новых данных». Эти новые данные обычно называют тестовым набором данных (test dataset, или тестовым набором (test set)).
Итак, доступные данные обычно делят на две части: обучающий набор, по которому подбираются параметры модели, и тестовый набор, по которому оценивается подобранная модель. Затем мы смотрим, как модель работает на каждой из этих частей.
Качество модели на обучающих данных можно сравнить с баллами ученика на пробном экзамене. Этот результат служит ориентиром перед настоящим экзаменом: даже если баллы обнадёживают, они не гарантируют успеха. Иначе говоря, результаты на тестовых данных могут заметно отличаться от результатов на обучающих. Модель, которая хорошо работает на обучающем наборе, но не переносит этот результат на тестовый, называют переобученной (overfitting). Как и в жизни: можно отлично написать пробный экзамен, но не обязательно так же сдать настоящий.
1.2.4 Алгоритм оптимизации
Когда у нас есть источник данных и их представление, модель и подходящая функция потерь, нужен алгоритм, который найдёт наилучшие значения параметров, минимизирующие функцию потерь.
В глубоком обучении большинство популярных алгоритмов оптимизации основано на базовом методе — градиентном спуске (gradient descent). Вкратце: на каждом шаге градиентный спуск проверяет каждый параметр и смотрит, в каком направлении изменится ошибка на обучающем наборе, если немного изменить именно этот параметр. Затем параметры смещаются в направлении, которое уменьшает потери.
1.3 Виды задач машинного обучения
Задача распознавания ключевого слова — лишь малая часть широкого спектра приложений машинного обучения. Ниже перечислены распространённые задачи и приложения, которые пригодятся нам дальше в книге. Мы будем часто ссылаться на введённые понятия: данные, модели и алгоритмы оптимизации.
1.3.1 Обучение с учителем
Обучение с учителем (supervised learning) хорошо справляется с предсказанием меток по заданным входным признакам. Каждая пара «признаки — метка» называется примером (example). Иногда, даже когда метка неизвестна, примером называют и просто входные признаки. Наша цель — построить модель, которая отображает любой вектор входных признаков в метку, то есть делает предсказание.
Приведём конкретный пример: пусть нужно предсказать, случится ли у пациента сердечный приступ. Тогда наблюдаемый исход — «приступ был» или «приступа не было» — станет меткой примера. Входными признаками могут быть жизненные показатели, например пульс, диастолическое и систолическое давление.
Обучение с учителем работает потому, что при подборе параметров мы предоставляем модели набор данных, в котором у каждого примера есть истинная метка. На языке теории вероятностей мы хотим предсказывать условную вероятность метки при заданных входных признаках.
Обучение с учителем — лишь один из нескольких классов задач машинного обучения, но в промышленности большинство успешных приложений использует именно его. Причина в том, что многие важные задачи можно чётко сформулировать как оценку неизвестной величины по имеющимся данным. Например:
- по снимку компьютерной томографии (КТ) опухоли определить, является ли она раковой;
- по английскому предложению предсказать правильный перевод на французский;
- по финансовым отчётам за текущий месяц спрогнозировать цену акций на следующий месяц.
Процесс обучения с учителем обычно делится на три большие части:
- Случайным образом выбрать подмножество из большого набора известных примеров и получить для каждого из них истинную метку. Иногда метки уже есть (например, выздоровел ли пациент в течение года?), иногда их нужно разметить вручную (например, при классификации изображений). Входы вместе с соответствующими метками образуют обучающий набор данных.
- Выбрать алгоритм обучения с учителем, который получает на вход обучающий набор данных и возвращает «обученную модель».
- Подать на вход обученной модели признаки ранее не встречавшихся примеров и использовать её выход как предсказание соответствующей метки.
Весь процесс обучения с учителем показан на рис. 1.3.
Рис. 1.3. Обучение с учителем
Итак, даже если описать задачу как предсказание метки по заданным входным признакам, обучение с учителем может принимать самые разные формы моделей и требует множества решений, которые зависят от типа, размера и количества входов и выходов. Например, для обработки «последовательностей произвольной длины» и «последовательностей фиксированной длины» используются разные модели.
1.3.1.1 Регрессия
Регрессия (regression) — одна из простейших задач обучения с учителем.
Допустим, есть таблица данных о продаже домов: каждая строка соответствует дому, каждый столбец — связанному с ним атрибуту, например площади, количеству спален, количеству ванных комнат, расстоянию пешком до центра города и т. д. Атрибуты каждой строки образуют вектор признаков одного дома. Если человек живёт в Нью-Йорке или в Сан-Франциско и он не является генеральным директором Amazon, Google, Microsoft или Facebook, то вектор признаков его дома (площадь, количество спален, количество ванных комнат, расстояние пешком) может выглядеть примерно так: . Если же человек живёт в Питтсбурге, вектор, скорее всего, будет ближе к …
Когда человек ищет новое жильё, ему может понадобиться оценить справедливую рыночную стоимость дома. Почему это задача регрессии? Потому что выходом служит число — цена продажи (то есть метка). Когда метка может принимать любое числовое значение, мы говорим о задаче регрессии, и цель — построить модель, предсказания которой максимально близки к истинным значениям метки.
Многие задачи из жизни относятся к регрессии. Например, предсказание оценки, которую пользователь поставит фильму, — задача регрессии. Любопытный факт: в 2009 году тот, кто придумал отличный алгоритм предсказания оценок фильмов, мог бы выиграть премию Netflix Prize в 1 миллион долларов. Ещё один пример — предсказание того, сколько дней пациент пробудет в больнице.
В целом хорошее эмпирическое правило таково: если вопрос касается «сколько», скорее всего, перед нами задача регрессии. Например:
- сколько часов займёт эта операция;
- сколько миллиметров осадков выпадет в городе за следующие 6 часов.
Даже если вы никогда не использовали машинное обучение, вы, возможно, уже неявно решали задачи регрессии. Например, вы вызвали сантехника, он три часа чистил канализационную трубу и выставил счёт на 350 долларов. Ваш друг нанял того же мастера на 2 часа и получил счёт на 250 долларов. Если кто-то попросит вас оценить стоимость очистки от засора, вы можете предположить, что мастер берёт фиксированную плату за выезд и затем почасовую оплату. Если эти допущения верны, то, имея два примера, вы уже можете определить структуру его тарифов: 50 долларов за выезд и ещё 100 долларов в час. Таким образом, сами того не заметив, вы поняли и применили алгоритм линейной регрессии.
Однако эти допущения не всегда уместны. Например, некоторые различия могут объясняться несколькими факторами, помимо двух признаков. В таких случаях мы будем стараться обучить модель, которая минимизирует разницу между предсказанными и фактическими значениями меток. Большинство глав этой книги будет посвящено минимизации квадратичной функции потерь.
1.3.1.2 Классификация
Хотя модели регрессии хорошо решают задачи «сколько», многие задачи такими не являются. Например, банк хочет добавить в своё мобильное приложение функцию фотографирования чеков. Приложение должно автоматически распознавать текст на изображении и сопоставлять рукописные символы с соответствующими известными символами.
Вопросы вида «какой именно» относятся к задачам классификации (classification). В задаче классификации модель предсказывает, к какой категории (category, формально — классу (class)) относится пример. Например, рукописные цифры могут относиться к 10 классам: метками будут числа от 0 до 9.
Простейший случай — когда классов всего два; это называется бинарной классификацией (binomial classification). Например, набор данных может состоять из изображений животных, а метки — из двух классов: {кошка, собака}. Регрессия обучает функцию, которая выдаёт число; классификация обучает классификатор, который выдаёт предсказанный класс.
Но как модель приходит к жёсткому предсказанию «да» или «нет»? Понять это можно через язык вероятностей: по признакам примера модель назначает каждому возможному классу вероятность. Например, в уже знакомом примере с кошками и собаками классификатор может выдать вероятность 0,9 того, что на изображении кошка. Что означает это число? Его можно понимать так: классификатор на 90% уверен, что изображена кошка. Величина вероятностей классов передаёт меру неопределённости модели; в последующих главах книги мы обсудим и другие алгоритмы, которые используют понятие неопределённости.
Когда классов больше двух, задача называется многоклассовой классификацией (multiclass classification). Распространённый пример — распознавание рукописных символов . В отличие от регрессии, стандартная функция потерь для задач классификации — кросс-энтропия (cross-entropy), которая подробно разбирается в разделе 3.4 «Softmax-регрессия».
Заметим, что самый частый класс не обязательно будет тем классом, который мы в итоге выбираем для принятия решения. Например, пусть на заднем дворе растёт гриб, как на рис. 1.4.
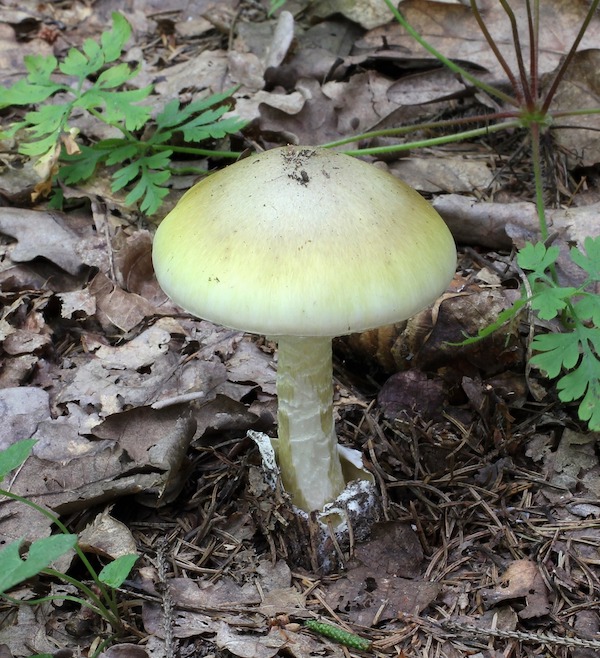
Рис. 1.4. Бледная поганка — есть нельзя!!
Теперь мы хотим обучить детектор ядовитых грибов, который по фотографии предсказывает, ядовит ли гриб. Предположим, классификатор выдаёт для гриба с рис. 1.4 вероятность 0,2 того, что это бледная поганка. Иначе говоря, классификатор на 80% уверен, что гриб не бледная поганка. Тем не менее мы его есть не станем: не стоит рисковать 20% вероятностью смерти. Неопределённость риска весит для нас гораздо больше, чем выгода. Поэтому в качестве функции потерь нужно использовать ожидаемый риск: вероятность каждого исхода умножить на связанный с ним выигрыш (или ущерб). В этом случае потери от употребления гриба равны , а потери от того, что мы его выбросим, равны . Осторожность, как выясняется, была оправдана: гриб с рис. 1.4 действительно является бледной поганкой.
Классификация может быть гораздо сложнее двоичной или многоклассовой. Например, существуют варианты задач классификации, которые используют иерархию и предполагают наличие определённых связей между классами. Поэтому не все ошибки равноценны: люди предпочли бы ошибиться, отнеся объект к близкому классу, а не к далёкому. Это обычно называют иерархической классификацией (hierarchical classification). Ранний пример — Карл Линней, который построил иерархическую классификацию животных.
В классификации животных, например, принять ши-тцу за шнауцера может быть не так уж плохо. Но если модель спутает ши-тцу с динозавром, это будет нелепо. Насколько важна та или иная иерархическая связь, может зависеть от того, как пользователь собирается применять модель. Например, гремучник и безвредный уж могут быть близки по родству, но если спутать гремучника с ужом, последствия могут быть серьёзными, ведь гремучник ядовит, а уж — нет.
1.3.1.3 Задачи разметки
Некоторые задачи классификации хорошо подходят для двоичной или многоклассовой классификации. Например, можно обучить обычный двоичный классификатор, который отличает кошек от собак. С помощью современных алгоритмов компьютерного зрения такую модель обучить несложно. Однако, как бы точна она ни была, при встрече с новым животным она может растеряться. Например, на рис. 1.5 показана иллюстрация к популярной немецкой сказке «Бременские музыканты»: на фоне деревьев изображены кот, петух, собака и осёл. В зависимости от того, что именно мы хотим делать с моделью, считать эту задачу двоичной классификацией может не иметь смысла. Вместо этого мы, возможно, захотим, чтобы модель описывала содержимое входного изображения: кот, петух, собака и осёл.
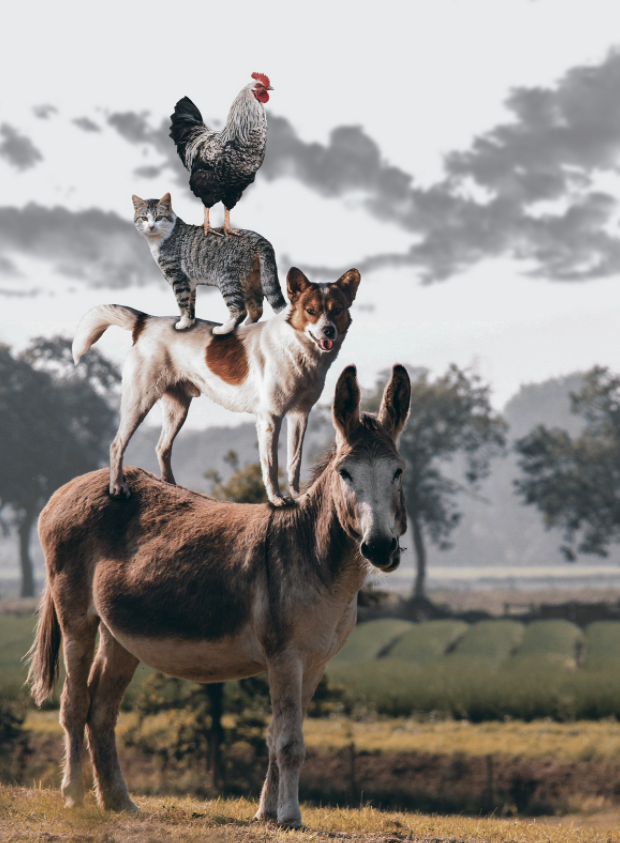
Рис. 1.5. Кот, петух, собака и осёл
Задачи предсказания нескольких не исключающих друг друга классов называются многометочной классификацией (multi-label classification). Например, метки, которые авторы технических блогов ставят своим постам: «машинное обучение», «технологии», «гаджеты», «языки программирования», «Linux», «облачные вычисления», «AWS». Типичная статья получает 5–10 меток, потому что эти понятия связаны между собой: пост об облачных вычислениях может упоминать AWS, а пост о машинном обучении — языки программирования.
Подобные задачи встречаются и при обработке биомедицинской литературы. Правильная разметка публикаций важна: она помогает исследователям эффективно просматривать литературу. В Национальной медицинской библиотеке США (The United States National Library of Medicine) специалисты-аннотаторы просматривают каждую статью, индексируемую в PubMed, и связывают её с соответствующими терминами из MeSH (MeSH — набор примерно из 28 000 меток). Это очень трудоёмкий процесс: между архивированием статьи и её разметкой обычно проходит год. Здесь алгоритмы машинного обучения могут выставлять предварительные метки, пока каждая статья не получит строгой ручной проверки. Кстати, в последние годы организация BioASQ проводит соревнования именно по этой задаче.
1.3.1.4 Поиск
Иногда нам нужно не просто вывести класс или вещественное значение, а упорядочить набор объектов. В информационном поиске именно это и требуется. Например, в веб-поиске цель — не просто классифицировать пару «запрос — страница», а из огромного множества результатов найти те, которые нужнее всего пользователю. Порядок результатов тоже очень важен: алгоритм обучения должен выдавать упорядоченное подмножество элементов. Иначе говоря, если нужно вернуть первые 5 букв алфавита, ответы «A, B, C, D, E» и «C, A, B, E, D» различаются. Даже если набор результатов одинаков, порядок внутри него иногда оказывается важным.
Одно из возможных решений: сначала присвоить каждому элементу набора оценку релевантности, а затем выбрать элементы с наивысшими оценками. PageRank — ранний пример такой системы оценок, с которой начинался поисковик Google; но её особенность в том, что она не зависит от конкретного запроса. В этом подходе поисковая система сначала применяет простой фильтр релевантности, чтобы выделить набор подходящих записей, а затем ранжирует результаты, содержащие условия запроса, по PageRank. Сегодня поисковые системы используют машинное обучение и модели поведения пользователей, чтобы получать оценки релевантности веб-страниц, и многие научные конференции посвящены этой теме.
1.3.1.5 Рекомендательные системы
Другой класс задач, связанных с поиском и ранжированием, — рекомендательные системы (recommender systems). Их цель — персонализированные рекомендации конкретному пользователю. Например, для фильмов страницы рекомендаций у любителей научной фантастики и у любителей комедий могут сильно различаться. Похожие приложения встречаются в розничной торговле, музыке и новостях.
В некоторых приложениях клиенты дают явную обратную связь, выражая свою симпатию к товарам, например через оценки и отзывы на Amazon. В других случаях обратная связь неявная: например, если пользователь пропускает некоторые песни в плейлисте, это может говорить о том, что эти песни ему не подходят. В целом рекомендательная система оценивает соответствие пары «пользователь — объект»; эта оценка может быть предсказанным рейтингом или вероятностью покупки. Затем для каждого пользователя система выбирает объекты с наивысшими оценками и рекомендует их. Описанные алгоритмы просты; промышленные рекомендательные системы устроены гораздо сложнее и учитывают подробную активность пользователя и характеристики товаров. Алгоритмы таких систем настраиваются так, чтобы улавливать предпочтения человека.
Например, на рис. 1.6 показаны книги по глубокому обучению, которые Amazon рекомендует на основе персонализированного алгоритма; рекомендации точно уловили интересы автора.
Рис. 1.6. Книги по глубокому обучению, рекомендованные Amazon на основе персонализированного алгоритма. Скриншот страницы стороннего сайта не включён в перевод
Несмотря на большую практическую ценность, использовать рекомендательные системы только как модели предсказания не всегда достаточно. Во-первых, наши данные содержат лишь цензурированную обратную связь (censored feedback): пользователи склонны оценивать то, что вызвало у них сильные эмоции. Например, в пятибалльной системе оценок фильмов будет много пятёрок и единиц, а троек — заметно меньше. Во-вторых, рекомендательные системы могут образовывать петли обратной связи (feedback loop). Система сначала продвигает товар с большими продажами (который, возможно, считается лучшим); пользователи затем покупают то, что им рекомендуют, и алгоритм обучения, не учитывая этого эффекта, будет рекомендовать такой товар ещё чаще. Итак, вопросы о том, как учитывать цензуру, стимулы и петли обратной связи, — важные открытые исследовательские проблемы.
1.3.1.6 Обучение последовательностям
Большинство перечисленных выше задач имеют входы и выходы фиксированного размера. Например, при предсказании цены дома мы рассматриваем фиксированный набор признаков: площадь, количество спален, количество ванных комнат, время пешком до центра. В задаче классификации изображений вход — изображение фиксированного размера, а выход — фиксированное число вероятностей (по одной на каждый класс). В таких случаях модель использует вход только как «сырьё» для выхода и не «запоминает» конкретное содержимое входа.
Если примеры на входе не связаны между собой, такие модели могут работать идеально. Но если вход непрерывен, модели может понадобиться «память». Например, как обрабатывать видеоклип? Каждый клип может состоять из разного числа кадров. Зная предыдущий кадр, мы можем лучше предсказать происходящее в следующем. То же касается языка: входы и выходы машинного перевода — тоже последовательности слов.
В медицине последовательные входы и выходы важны ещё больше. Представим модель, которая следит за пациентами в реанимации и подаёт сигнал тревоги, если риск смерти в течение следующих 24 часов превышает пороговое значение. Нам совсем не хочется отбрасывать всю историю болезни пациента за каждый прошедший час и делать прогноз только по последним измерениям.
Эти задачи — примеры обучения последовательностям (sequence learning), одного из самых захватывающих направлений машинного обучения. Обучение последовательностям предполагает получение входной последовательности, выдачу выходной последовательности или и то, и другое. В частности, входы и выходы могут иметь переменную длину, как в машинном переводе или при расшифровке речи в текст. Невозможно рассмотреть все типы преобразования последовательностей, поэтому отметим несколько частных случаев.
Разметка и синтаксический разбор. Это аннотирование текстовой последовательности атрибутами. Иначе говоря, число входов и выходов в основном одинаково. Например, мы можем захотеть узнать, где находятся глагол и подлежащее, или какие слова являются именованными сущностями. Обычно цель — разобрать и аннотировать текст на основе структурных и грамматических предположений, чтобы получить какие-то аннотации. Это звучит гораздо сложнее, чем есть на самом деле. Ниже приведён очень простой пример: предложение аннотировано «метками», которые показывают, какие слова обозначают именованные сущности. Метка «Ent» — сокращение от сущность (entity).
Том ужинает в Вашингтоне с Салли
Ent - - Ent - Ent
Автоматическое распознавание речи. В распознавании речи входная последовательность — запись речи говорящего (см. рис. 1.7), а выходная — текстовая расшифровка сказанного. Трудность в том, что аудиокадров значительно больше, чем слов в тексте: звук обычно оцифровывается с частотой 8 или 16 кГц. То есть соответствия 1:1 между аудио и текстом нет: тысячи отсчётов могут соответствовать одному слову. Это тоже задача «последовательность в последовательность», в которой выход гораздо короче входа.
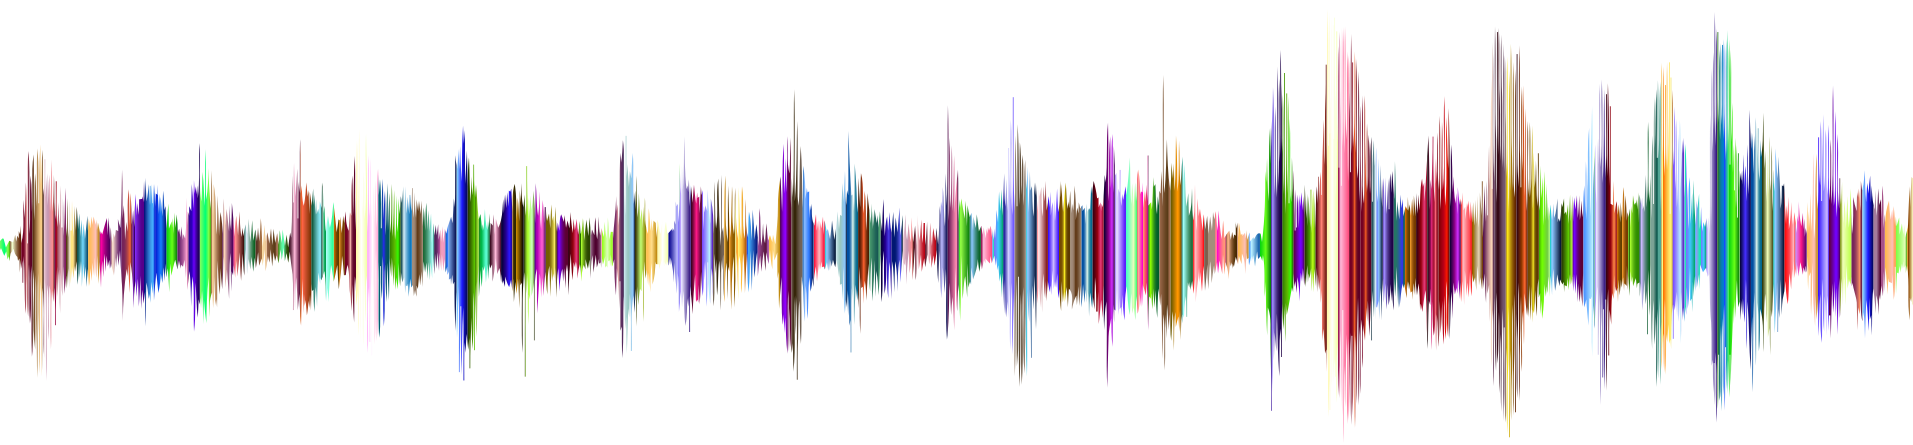
Рис. 1.7. «-D-e-e-p- L-ea-r-ni-ng-» в записи
Синтез речи (преобразование текста в речь). Это обратная задача распознавания речи: входом является текст, а выходом — аудиофайл. В этом случае выход гораздо длиннее входа. Человеку несложно определить, что аудиозапись звучит неестественно, но для компьютера это не так просто.
Машинный перевод. В распознавании речи входы и выходы следуют в одном и том же порядке. В машинном переводе, напротив, порядок очень важен: мы по-прежнему преобразуем одну последовательность в другую, но количество входных и выходных элементов, как правило, не совпадает, и порядок соответствующих элементов тоже может различаться. Например, в примере ниже «неверное выравнивание» показывает характерную особенность немецкого синтаксиса — тенденцию ставить глагол в конец предложения.
Немецкий: Haben Sie sich schon dieses grossartige Lehrwerk angeschaut?
Английский: Did you already check out this excellent tutorial?
Неверное выравнивание: Did you yourself already this excellent tutorial looked-at?
Другие задачи тоже используют обучение последовательностям. Например, определение порядка, в котором пользователь читает веб-страницу, — задача двумерного анализа макета. Диалоговые задачи сложнее: чтобы определить следующую реплику в диалоге, нужно учитывать историю беседы и знания о реальном мире… Все эти направления — горячие темы в исследованиях обучения последовательностям.
1.3.2 Обучение без учителя
До сих пор все примеры относились к обучению с учителем: модели требовалось предоставлять огромный набор данных, в котором каждый пример содержит признаки и соответствующее значение метки. В шутку можно сказать, что модель обучения с учителем похожа на сотрудника с очень специфической работой и очень скучным начальником. Начальник стоит за спиной и точно говорит, что делать в каждой ситуации, пока сотрудник не научится сопоставлять ситуации с действиями. Угодить такому начальнику легко: нужно как можно быстрее распознать закономерности и копировать его поведение.
Если же работа не имеет чёткой цели, приходится учиться «самостоятельно». Например, начальник может выдать большой массив данных и попросить провести по нему какое-то исследование в области науки о данных, не уточняя, каким должен быть результат. Задачи машинного обучения, в данных которых нет «целевого значения», обычно называют обучением без учителя (unsupervised learning); в последующих главах книги мы обсудим методы обучения без учителя. Итак, на какие вопросы может отвечать обучение без учителя? Рассмотрим несколько примеров.
- Кластеризация (clustering): можно ли разделить данные на группы без меток? Например, по набору фотографий разбить их на пейзажи, собак, младенцев, кошек и горные вершины. Или по истории просмотров веб-страниц пользователей выделить тех, чьё поведение похоже.
- Метод главных компонент (principal component analysis): можно ли найти небольшое число параметров, которые точно описывают линейно связанные свойства данных? Например, траекторию мяча можно описать его скоростью, диаметром и массой. Портные уже разработали небольшой набор параметров, довольно точно описывающих форму человеческого тела, чтобы подгонять одежду. Ещё один пример: существует ли в евклидовом пространстве представление объектов произвольной структуры, в котором символические свойства хорошо согласуются с отношениями между объектами? Такое представление может описывать сущности и их связи, например «Рим» «Италия» «Франция» «Париж».
- Причинность (causality) и вероятностные графические модели (probabilistic graphical models): можно ли описать первопричины многих наблюдаемых данных? Например, если у нас есть демографические данные о стоимости жилья, загрязнении, преступности, географии, образовании и зарплатах, можно ли выявить связи между ними, опираясь только на эмпирические данные?
- Генеративно-состязательные сети (generative adversarial networks): дают способ синтезировать данные, в том числе такие сложные неструктурированные данные, как изображения и аудио. Лежащий в основе статистический механизм — проверка, неотличимы ли настоящие данные от поддельных. Это ещё одна важная и захватывающая область обучения без учителя.
1.3.3 Взаимодействие со средой
Некоторые задаются вопросом: откуда берутся входные данные машинного обучения и куда направляются его выходы? До сих пор, будь то обучение с учителем или без, мы заранее получали большой объём данных, затем запускали модель и больше не взаимодействовали со средой. Всё обучение происходило отдельно от среды; такое обучение называют офлайн-обучением (offline learning).
Для обучения с учителем процесс сбора данных из среды выглядит так, как показано на рис. 1.8.
Рис. 1.8. Сбор данных из среды для обучения с учителем
У простого офлайн-обучения есть своя привлекательность: можно изолированно заниматься распознаванием образов, не отвлекаясь на другие задачи. Но недостаток в том, что круг решаемых задач довольно ограничен. Поэтому от искусственного интеллекта мы ожидаем не только предсказаний, но и взаимодействия с реальной средой. В отличие от предсказания, «взаимодействие со средой» действительно влияет на неё. Здесь ИИ — это «интеллектуальный агент», а не просто «модель предсказания». Значит, нужно учитывать, что его действия могут влиять на будущие наблюдения.
Рассмотрение взаимодействия со средой открывает целый ряд новых задач моделирования. Вот несколько примеров:
- Помнит ли среда, что мы делали раньше?
- Помогает ли среда нам в моделировании? Например, пользователь диктует текст в систему распознавания речи.
- Пытается ли среда обыграть модель? Например, в состязательных сценариях, таких как фильтрация спама или игры?
- Важна ли среда?
- Меняется ли среда? Например, будут ли будущие данные всегда похожи на прошлые или они меняются со временем — естественным образом или в ответ на наши автоматизированные инструменты?
Последний вопрос ведёт к проблеме сдвига распределения (distribution shift): обучающие и тестовые данные различаются. Далее кратко описана задача обучения с подкреплением — класс задач, которые явно учитывают взаимодействие со средой.
1.3.4 Обучение с подкреплением
Если вас интересует разработка систем, которые взаимодействуют со средой и выполняют действия, машинное обучение, скорее всего, приведёт вас к обучению с подкреплением (reinforcement learning). Оно может применяться в робототехнике, диалоговых системах и даже при создании ИИ для видеоигр. Глубокое обучение с подкреплением (deep reinforcement learning), в котором глубокое обучение применяется к задачам обучения с подкреплением, — очень популярная область исследований. Прорывными примерами стали глубокая Q-сеть (Q-network), которая победила людей в играх Atari, используя только визуальный вход, и программа AlphaGo, которая обыграла чемпиона мира по го.
В задаче обучения с подкреплением агент (agent) взаимодействует со средой в последовательности временных шагов. В каждый момент времени агент получает от среды наблюдение (observation) и должен выбрать действие (action), которое передаётся обратно в среду через некоторый механизм (его иногда называют исполнительным устройством). После этого агент получает от среды награду (reward). Затем начинается новый цикл: агент получает последующее наблюдение, выбирает следующее действие и т. д. Процесс обучения с подкреплением показан на рис. 1.9. Обратите внимание: цель обучения с подкреплением — получить хорошую стратегию (policy). Действие, которое выбирает агент, определяется стратегией — функцией, которая отображает наблюдения среды в действия.
Рис. 1.9. Взаимодействие обучения с подкреплением и среды
Схема обучения с подкреплением очень общая. Например, любую задачу обучения с учителем можно превратить в задачу обучения с подкреплением. Пусть у нас есть задача классификации: можно создать агента, у которого каждый класс соответствует «действию». Затем создаём среду, которая выдаёт агенту награду. Эта награда совпадает с функцией потерь исходной задачи обучения с учителем.
Конечно, обучение с подкреплением может решать и многие задачи, недоступные обучению с учителем. Например, в обучении с учителем мы всегда предполагаем, что входы связаны с правильными метками. В обучении с подкреплением нельзя рассчитывать, что среда подскажет агенту оптимальное действие для каждого наблюдения. Как правило, агент получает только награды. Более того, среда может даже не сообщать, какие именно действия привели к награде.
Рассмотрим пример: обучение с подкреплением в шахматах. Единственный настоящий сигнал награды появляется в конце партии: если агент выигрывает, он получает награду 1, если проигрывает — −1. Поэтому агент должен решить задачу распределения заслуги (credit assignment): определить, какие действия заслуживают поощрения, а какие — наказания. Это похоже на повышение сотрудника: оно, скорее всего, отражает множество действий за весь предыдущий год. Чтобы получить новое повышение в будущем, нужно понять, какие именно действия к нему привели.
Обучение с подкреплением может также столкнуться с проблемой частичной наблюдаемости (partial observability): текущее наблюдение может не содержать всей информации о текущем состоянии. Представим уборочного робота, который оказался в доме со множеством одинаковых кладовок. Чтобы вычислить точное положение робота (а значит, и его состояние), нужно учитывать предыдущие наблюдения, сделанные до того, как он зашёл в кладовку.
Наконец, в любой момент времени агент, обучающийся с подкреплением, может знать хорошую стратегию, но при этом существуют многие лучшие стратегии, которых он ещё не пробовал. Агент должен постоянно выбирать: использовать ли текущую лучшую стратегию или исследовать новое пространство стратегий, отказавшись от части краткосрочной награды ради знаний. Это дилемма исследования и использования (exploration vs. exploitation).
Общая задача обучения с подкреплением очень широка. Действия агента влияют на последующие наблюдения, а награда связана только с выбранными действиями. Среда может быть полностью или частично наблюдаемой; разобрать все эти сложности было бы слишком трудно даже исследователям. Кроме того, не каждая практическая задача обладает всеми этими сложностями. Поэтому учёные изучают частные случаи задач обучения с подкреплением.
Если среда полностью наблюдаема, задача обучения с подкреплением называется марковским процессом принятия решений (Markov decision process). Если состояние не зависит от предыдущих действий, задача называется контекстуальным бандитом (contextual bandit problem). Если состояний нет и есть лишь набор изначально неизвестных действий с неизвестными наградами, это классическая задача многорукого бандита (multi-armed bandit problem).
1.4 Истоки
Для решения самых разных задач машинного обучения глубокое обучение предлагает мощные инструменты. Хотя многие методы глубокого обучения совершили значительный прорыв лишь недавно, основные идеи использования данных и нейронных сетей развивались уже несколько столетий. Людям давно хотелось анализировать данные и предсказывать будущие результаты, и на этом желании во многом держатся естественные науки.
Например, распределение Бернулли названо в честь Якоба Бернулли (1654–1705). А нормальное распределение открыл Карл Фридрих Гаусс (1777–1855): он изобрёл алгоритм наименьших квадратов, который до сих пор используется для решения множества задач — от страховых расчётов до медицинской диагностики. Эти инструменты породили экспериментальный подход в естественных науках: например, закон Ома для тока и напряжения на резисторе прекрасно описывается линейной моделью.
Даже в Средние века математики обладали тонким чутьём в вопросах оценивания (estimation). Например, Якоб Кёбель (1460–1533) в своей книге по геометрии показывает, как через среднюю длину стоп 16 взрослых мужчин можно получить длину одного фута.
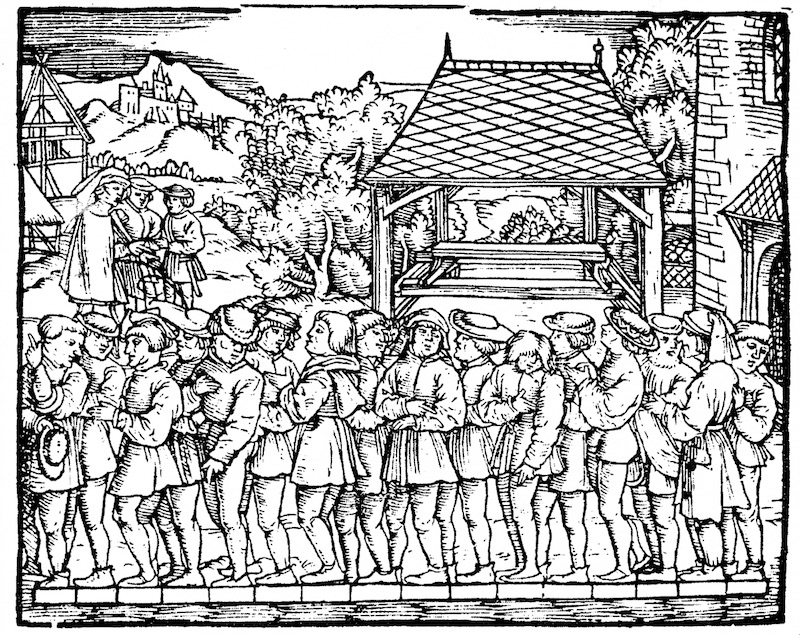
Рис. 1.10. Оценка длины одного фута
На рис. 1.10 показано, как работает эта оценка. Шестнадцать взрослых мужчин выстраиваются в ряд, ступня к ступне. Затем их общую длину делят на 16, получая оценку, которая и считается одним футом. Позднее алгоритм усовершенствовали, чтобы учесть стопы с необычными размерами: двух человек с самыми короткими и самыми длинными стопами исключают, а для остальных берут среднее. Это один из первых примеров усечённого среднего (trimmed mean estimate).
С накоплением и доступностью данных статистика по-настоящему расцвела. Рональд Фишер (1890–1962) внёс большой вклад в теорию статистики и её применение в генетике. Многие его алгоритмы (например, линейный дискриминантный анализ) и формулы (например, информационная матрица Фишера) до сих пор широко используются. Более того, набор данных об ирисах, который Фишер опубликовал в 1936 году, до сих пор иногда используется для проверки алгоритмов машинного обучения. Фишер также был сторонником евгеники, и это напоминает нам: этически сомнительное использование данных имеет такую же долгую историю, как и его продуктивное применение в промышленности и естественных науках.
Вторым источником влияния на машинное обучение стали информационная теория Клода Шеннона (1916–2001) и теория вычислений Алана Тьюринга (1912–1954). В своей знаменитой статье «Вычислительные машины и разум» (Turing, 1950) Тьюринг поставил вопрос: «Могут ли машины мыслить?» В описанном им тесте машину можно считать «разумной», если человеку-оценщику трудно отличить её ответы в текстовом диалоге от ответов человека.
Другое влияние пришло из нейробиологии и психологии. Один из самых ранних алгоритмов появился в пионерской книге Дональда Хебба (1904–1985) «Организация поведения» (Hebb, 1949). Хебб предположил, что нейроны обучаются через активное усиление связей. Этот принцип стал прототипом алгоритма обучения перцептрона Розенблатта и получил название «хеббовского обучения». Он также заложил основу многих алгоритмов стохастического градиентного спуска, которые используются в современном глубоком обучении: усиление желаемого поведения и ослабление нежелательного помогают получить в нейронной сети хорошие значения параметров.
Нейронные сети (neural networks) получили название по биологической аналогии. Более века назад (начиная с моделей Александра Бейна 1873 года и Джеймса Шеррингтона 1890 года) исследователи пытались собирать вычислительные схемы, похожие на сети взаимодействующих нейронов. Со временем биологические трактовки стали менее буквальными, но название сохранилось. В основе большинства современных сетей лежат несколько ключевых принципов:
- чередование линейных и нелинейных элементов обработки, которые обычно называют слоями (layers);
- использование правила цепочки (также называемого обратным распространением ошибки (backpropagation)) для одновременной настройки всех параметров сети.
После первого быстрого развития исследования нейронных сетей примерно с 1995 года застопорились и лишь в 2005 году начали понемногу оживать. Главных причин две. Во-первых, обучение сетей очень дорого в вычислительном отношении: в конце прошлого века оперативная память уже была достаточно вместительной, а вычислительной мощности не хватало. Во-вторых, наборы данных были относительно небольшими. Набор данных об ирисах Фишера был популярным инструментом проверки алгоритмов, а набор MNIST из 60 000 рукописных цифр считался огромным. С учётом нехватки данных и вычислительных ресурсов мощные статистические инструменты, такие как ядерные методы (kernel methods), решающие деревья (decision trees) и графовые модели (graph models), на практике показывали себя лучше. В отличие от нейронных сетей, эти алгоритмы не требуют недель обучения и обладают сильным теоретическим обоснованием, которое позволяет получать предсказуемые результаты.
1.5 Развитие глубокого обучения
Примерно с 2010 года нейросетевые алгоритмы, которые раньше казались вычислительно неосуществимыми, стали популярными. Причин две. Во-первых, появление интернет-компаний, обслуживающих сотни миллионов пользователей, сделало крупные наборы данных доступными. Во-вторых, распространение дешёвых и качественных датчиков, дешёвого хранения данных (закон Крайдера, Kryder’s law) и дешёвых вычислений (закон Мура), особенно благодаря распространению GPU, сделало огромную вычислительную мощность доступной.
Это показано в таблице 1.1.
Таблица 1.1. Объём данных, памяти и вычислительной мощности по десятилетиям
| Год | Объём данных | Память | Производительность (FLOPS) |
|---|---|---|---|
| 1970 | 100 (ирисы Фишера) | 1 KB | 100 KF (Intel 8080) |
| 1980 | 1 K (цены на жильё в Бостоне) | 100 KB | 1 MF (Intel 80186) |
| 1990 | 10 K (распознавание рукописных символов) | 10 MB | 10 MF (Intel 80486) |
| 2000 | 10 M (веб-страницы) | 100 MB | 1 GF (Intel Core) |
| 2010 | 10 G (реклама) | 1 GB | 1 TF (Nvidia C2050) |
| 2020 | 1 T (социальные сети) | 100 GB | 1 PF (Nvidia DGX-2) |
Очевидно, что оперативная память не поспевает за ростом данных. В то же время вычислительная мощность растёт быстрее, чем объём доступных данных. Это означает, что статистические модели должны становиться эффективнее по памяти (обычно этого добиваются добавлением нелинейности), а благодаря росту вычислительного бюджета могут тратить больше времени на оптимизацию параметров. Поэтому машинное обучение и статистика переместили внимание с (обобщённых) линейных моделей и ядерных методов на глубокие нейронные сети. Так появились многие «рабочие лошадки» глубокого обучения: многослойный перцептрон (McCulloch and Pitts, 1943), свёрточные нейронные сети (LeCun et al., 1998), долгая краткосрочная память (LSTM, Graves and Schmidhuber, 2005) и Q-обучение (Watkins and Dayan, 1992). После долгого периода забвения они были «открыты заново» в последнее десятилетие.
В последнее десятилетие прогресс в статистических моделях, приложениях и алгоритмах напоминает кембрийский взрыв — период стремительной эволюции видов в истории Земли. Самые передовые технологии — это не просто результат применения имеющихся ресурсов к алгоритмам полувековой давности. Ниже перечислены идеи, которые помогли исследователям за последнее десятилетие добиться огромного прогресса (хотя затронуты лишь самые заметные из них).
- Новые методы управления ёмкостью модели, например исключение (dropout) (Srivastava et al., 2014), помогают снизить риск переобучения. Это достигается внедрением шума во всю нейронную сеть (Bishop, 1995): на этапе обучения веса заменяются случайными величинами.
- Механизм внимания решает задачу, которая мучила статистику более века: как увеличить память и сложность системы, не увеличивая число обучаемых параметров. Исследователи нашли элегантное решение, используя обучаемые структуры-указатели (Bahdanau et al., 2014). Не нужно запоминать всю текстовую последовательность (например, для машинного перевода с представлением фиксированной размерности) — достаточно хранить указатели на промежуточные состояния процесса перевода. Это существенно повышает точность на длинных последовательностях, потому что модели больше не нужно помнить всю последовательность, прежде чем начать генерировать новую.
- Многоэтапные конструкции. Например, сети памяти (memory networks) (Sukhbaatar et al., 2015) и нейронные программисты-интерпретаторы (Reed and De Freitas, 2015). Они позволяют статистикам описывать итеративные методы вывода. Эти инструменты дают возможность многократно изменять внутреннее состояние глубокой нейронной сети и выполнять последующие шаги цепочки рассуждений — по аналогии с тем, как процессор меняет память в ходе вычислений.
- Ещё одно ключевое открытие — изобретение генеративно-состязательных сетей (generative adversarial networks) (Goodfellow et al., 2014). В традиционных моделях статистические методы оценки плотности и порождающих моделей были сосредоточены на поиске подходящего (обычно приближённого) вероятностного распределения и алгоритмов семплирования, поэтому их возможности сильно ограничивались гибкостью статистических моделей. Ключевое новшество GAN — замена семплера произвольным алгоритмом с дифференцируемыми параметрами. Эти параметры затем подстраиваются так, чтобы дискриминатор (по сути, двухвыборочный тест) не мог отличить поддельные данные от настоящих. Благодаря возможности генерировать данные произвольным алгоритмом эта идея открыла дорогу к оценке плотности для самых разных методов. Примеры — скачущие зебры (Zhu et al., 2017) и фальшивые лица знаменитостей (Karras et al., 2017). Даже любители-рисовальщики могут создавать фотореалистичные изображения по эскизам, описывающим расположение элементов сцены (Park et al., 2019).
- Во многих случаях одного GPU недостаточно для обработки огромных объёмов данных, доступных для обучения. За последнее десятилетие заметно выросли возможности построения параллельных и распределённых алгоритмов обучения. Одна из ключевых сложностей при разработке масштабируемых алгоритмов — рабочий инструмент оптимизации в глубоком обучении, стохастический градиентный спуск, опирается на относительно небольшие минибатчи данных. Однако минибатч ограничивает эффективность GPU. Например, обучение на 1024 GPU, если на каждом из них минибатч состоит из 32 изображений, эквивалентно минибатчу примерно из 32 000 изображений. Последние работы — сначала (Li, 2017), затем (You et al., 2017) и (Jia et al., 2018) — увеличили размер батча до 64 000 и сократили время обучения ResNet-50 на наборе ImageNet до менее чем 7 минут. Для сравнения: первоначально такое обучение занимало дни.
- Параллельные вычисления также внесли весомый вклад в прогресс обучения с подкреплением. Это привело к значительным успехам: компьютеры показывают сверхчеловеческие результаты в го, играх Atari, StarCraft и физических симуляциях (например, с MuJoCo). Описание того, как это было достигнуто в AlphaGo, см., например, в работе (Silver et al., 2016). Кратко: обучение с подкреплением работает лучше всего, когда доступно огромное количество троек «состояние, действие, награда», то есть когда можно пробовать очень многое, чтобы понять связи между ними. Симуляции дают такую возможность.
- Фреймворки глубокого обучения сыграли решающую роль в распространении идей. Инструменты первого поколения, которые позволяли легко строить модели, включали Caffe, Torch и Theano. Многие новаторские статьи были написаны с их помощью. Сейчас их вытеснили TensorFlow (часто используемый через высокоуровневый API Keras), CNTK, Caffe 2 и Apache MXNet. Инструменты третьего поколения — императивные фреймворки глубокого обучения — впервые появились, по-видимому, в Chainer, который описывает модели с помощью синтаксиса, похожего на NumPy в Python. Эту идею переняли PyTorch, Gluon API из MXNet и JAX.
Разделение труда между «системными исследователями, которые создают лучшие инструменты» и «исследователями статистического моделирования, которые создают лучшие нейронные сети» значительно упростило работу. Например, ещё в 2014 году обучение модели линейной регрессии было непростым домашним заданием для аспирантов по машинному обучению в Университете Карнеги — Меллона. Сейчас эта задача решается меньше чем в 10 строках кода, так что её может выполнить любой программист.
1.6 Успехи глубокого обучения
Искусственный интеллект давно умеет получать результаты, которых трудно добиться другими методами. Например, системы сортировки почты с оптическим распознаванием символов работают с 1990-х годов — ведь именно из этой задачи родился знаменитый набор рукописных цифр MNIST. То же относится к чтению банковских чеков и оценке кредитоспособности заявителей. Системы автоматически проверяют финансовые операции на мошенничество. Это стало опорой многих платёжных систем электронной коммерции, таких как PayPal, Stripe, Alipay, WeChat, Apple, Visa и Mastercard. Компьютерные программы для шахмат соревнуются уже десятилетия. Машинное обучение обеспечивает поиск, рекомендации, персонализацию и ранжирование в интернете. Иначе говоря, машинное обучение вездесуще, хотя часто остаётся незаметным.
Совсем недавно ИИ привлёк всеобщее внимание прежде всего благодаря решению задач, которые раньше считались неразрешимыми и напрямую связаны с потребителями. Многие такие прорывы обязаны глубокому обучению.
- Интеллектуальные ассистенты, такие как Siri от Apple, Alexa от Amazon и Google Assistant, довольно точно отвечают на устные вопросы. Это включает и простые задачи — например, включить свет (что особенно важно для людей с инвалидностью), записаться к парикмахеру или провести диалог со службой телефонной поддержки. Возможно, это самый заметный признак того, что ИИ уже влияет на нашу жизнь.
- Ключевой элемент цифровых ассистентов — точное распознавание речи. Постепенно в некоторых приложениях точность таких систем достигла уровня человека (Xiong et al., 2018).
- Распознавание объектов тоже сильно продвинулось. Определить объекты на изображении в 2010 году было довольно сложной задачей. В бенчмарке ImageNet исследователи из NEC Labs и Университета Иллинойса в Урбана — Шампейн получили ошибку Top-5, равную 28% (Lin et al., 2010). К 2017 году эта ошибка снизилась до 2,25% (Hu et al., 2018). Аналогично впечатляющие результаты получены при определении видов птиц и диагностике рака кожи.
- Игры долгое время были крепостью человеческого интеллекта. Начиная с TD-Gammon — программы для игры в нарды (backgammon), которая использовала обучение с временно́й разностью, прогресс алгоритмов и вычислений привёл к широкому распространению таких методов. В отличие от нард, в шахматах гораздо более сложное пространство состояний и набор действий. Deep Blue от IBM использовал массовый параллелизм, специализированное оборудование и эффективный поиск по дереву игры (Campbell et al., 2002), чтобы победить Гарри Каспарова. Го намного сложнее из-за огромного пространства состояний. AlphaGo в 2015 году достиг уровня человека в игре, используя глубокое обучение в сочетании с поиском по дереву методом Монте-Карло (Silver et al., 2016). В покере трудность в том, что пространство состояний велико и наблюдается не полностью (мы не знаем карт соперника). Программа Libratus (Brown and Sandholm, 2017) превзошла результаты людей в покере, используя эффективную структурированную стратегию. Это показывает, что в основе впечатляющего прогресса в играх лежат продвинутые алгоритмы.
- Самоуправляемые автомобили и грузовики — ещё одно свидетельство прогресса ИИ. Полностью автономные машины пока не стали повседневностью, но в этом направлении достигнуты серьёзные успехи: продукты таких компаний, как Tesla, NVIDIA и Waymo, обеспечивают как минимум частичную автономность. Полная автономия так трудна, потому что правильное вождение требует умения воспринимать среду, рассуждать и встраивать правила в систему. Сейчас глубокое обучение применяется в основном к компьютерному зрению этих задач, а остальное инженеры настраивают вручную.
Приведённый список лишь слегка затрагивает влияние машинного обучения на практические приложения. Например, недавние прорывы в робототехнике, логистике, вычислительной биологии, физике элементарных частиц и астрономии хотя бы частично обязаны машинному обучению. Поэтому машинное обучение становится необходимым инструментом инженеров и учёных.
В нетехнических статьях об ИИ часто поднимают вопрос о «сингулярности ИИ»: системы машинного обучения обретут сознание и независимо от своих создателей начнут принимать решения, которые непосредственно влияют на жизнь людей. До некоторой степени ИИ уже влияет на жизнь людей: автоматическая оценка кредитоспособности, автономное вождение автомобилей, автоматическое решение об освобождении под залог и т. д. Даже Alexa может включить для нас кофеварку.
К счастью, мы ещё очень далеки от разумной системы ИИ, способной контролировать своих создателей. Во-первых, системы ИИ проектируются, обучаются и внедряются определённым, целенаправленным образом. Хотя их поведение может создавать иллюзию универсального интеллекта, в основе их дизайна лежит сочетание правил, эвристик и статистических моделей. Во-вторых, пока не существует «искусственного общего интеллекта» — инструментов, которые могли бы самосовершенствоваться, самостоятельно рассуждать и, пытаясь решить общую задачу, менять, расширять и улучшать собственную архитектуру.
Более насущная проблема — применение ИИ в повседневной жизни. Многие рутинные работы водителей грузовиков и продавцов, вероятно, тоже будут автоматизированы. Сельскохозяйственные роботы, возможно, снизят стоимость органического земледелия, а также автоматизируют уборку урожая. Этот этап промышленной революции может глубоко повлиять на значительные части общества, поскольку водители грузовиков и продавцы — одни из самых распространённых профессий во многих странах. Кроме того, если статистические модели применять без должного внимания, они могут привести к расовым, гендерным или возрастным предубеждениям, а если такие модели автоматически управляют решениями, возникают обоснованные вопросы о справедливости программ. Важно убедиться, что эти алгоритмы применяются осторожно. По нашему нынешнему пониманию, это более насущная угроза, чем риск злонамеренного сверхразума, который уничтожит человечество.
1.7 Особенности
До сих пор мы в общих чертах говорили о машинном обучении — одновременно и разделе ИИ, и подходе к ИИ. Глубокое обучение — подмножество машинного обучения, но калейдоскоп алгоритмов и приложений затрудняет оценку того, что именно составляет специфику глубокого обучения. Это как пытаться определить состав пиццы: почти каждый ингредиент можно заменить.
Как уже говорилось, машинное обучение может использовать данные, чтобы выучить преобразование входов в выходы, например при распознавании речи — преобразование аудио в текст. При этом часто нужно представить данные так, чтобы алгоритму было удобно преобразовывать это представление в выход. Глубокое обучение «глубокое» потому, что модель изучает много «слоёв» преобразований, каждый из которых даёт свой уровень представления. Например, слои вблизи входа могут представлять низкоуровневые детали данных, а слои ближе к классифицирующему выходу — более абстрактные понятия, полезные для различения. Поскольку обучение представлений (representation learning) направлено на поиск самих представлений, глубокое обучение можно назвать «многоуровневым обучением представлений».
Задачи, рассмотренные выше, — обучение на сырых аудиосигналах, на исходных значениях пикселей изображения или отображение предложений произвольной длины в соответствующие предложения на иностранном языке, — это задачи, в которых глубокое обучение превосходит традиционные методы машинного обучения. Оказывается, эти многослойные модели способны обрабатывать низкоуровневые сенсорные данные так, как не могли предыдущие инструменты. Несомненно, самая заметная общая черта методов глубокого обучения — сквозное обучение (end-to-end training). То есть вместо того, чтобы собирать систему из отдельно настроенных компонентов, систему строят целиком и совместно настраивают её характеристики.
Например, в компьютерном зрении учёные привыкли отделять процесс конструирования признаков от построения модели машинного обучения. Детектор границ Canny (Canny, 1987) и извлекатель признаков SIFT (Lowe, 2004), которые отображают изображение в векторы признаков, в прошлом десятилетии занимали безраздельное господство. Раньше ключевой частью применения машинного обучения к этим задачам было придумывание вручную сконструированных признаков, которые преобразовывали бы данные в форму, подходящую для поверхностных моделей. Однако людям через конструирование признаков удаётся сделать очень немного по сравнению с миллионами выборов, которые алгоритм делает автоматически. С появлением глубокого обучения эти извлекатели признаков были заменены автоматически настраиваемыми фильтрами, что повысило точность.
Поэтому ключевое преимущество глубокого обучения в том, что оно заменяет не только поверхностные модели в конце традиционного конвейера обучения, но и трудоёмкий процесс конструирования признаков. Кроме того, заменяя большую часть предметной предобработки, глубокое обучение устраняет многие границы, которые раньше разделяли компьютерное зрение, распознавание речи, обработку естественного языка, медицинскую информатику и другие прикладные области, и предлагает единый набор инструментов для решения разнообразных задач.
Помимо сквозного обучения, мы наблюдаем переход от параметрических статистических описаний к полностью непараметрическим моделям. Когда данных мало, приходится полагаться на упрощённые предположения о реальности, чтобы получить полезные модели. Когда данных много, их можно заменить непараметрическими моделями, которые точнее подстраиваются под реальность. В каком-то смысле это отражает прогресс физики в середине прошлого века, когда появились компьютеры: вместо ручных параметрических приближений поведения электронов теперь можно опираться на численное моделирование соответствующих уравнений в частных производных. Это приводит к более точным моделям, хотя часто ценой интерпретируемости.
Другое отличие от прежних работ — готовность принимать субоптимальные решения, работать с невыпуклыми нелинейными задачами оптимизации и пробовать идеи до того, как они доказаны. Эмпиризм в решении статистических задач в сочетании с быстрым притоком талантов привёл к стремительному развитию практичных алгоритмов. Правда, во многих случаях это достигается ценой переделки и переизобретения инструментов, существовавших десятилетиями.
Наконец, сообщество глубокого обучения гордится тем, что его участники делятся инструментами между академией и бизнесом: публикуют множество отличных библиотек алгоритмов, статистических моделей и обученных открытых нейронных сетей. В этом духе данная книга распространяется и используется бесплатно. Мы стремимся снизить порог входа в глубокое обучение для каждого и надеемся, что читатели извлекут из неё пользу.
Резюме
- Машинное обучение изучает, как компьютерные системы могут использовать опыт (обычно данные), чтобы повышать производительность в конкретных задачах. Оно объединяет идеи статистики, интеллектуального анализа данных и оптимизации. Обычно машинное обучение используется как средство создания решений в области ИИ.
- Обучение представлений как класс машинного обучения сосредоточено на том, как автоматически находить подходящие способы представления данных. Глубокое обучение — это многоуровневое обучение представлений, осуществляемое за счёт изучения многих уровней преобразований.
- Глубокое обучение заменяет не только поверхностные модели традиционного машинного обучения, но и трудоёмкое конструирование признаков.
- Многие недавние достижения в глубоком обучении вызваны в основном дешёвыми датчиками и огромными объёмами данных из интернет-приложений, а также прорывами в вычислениях (с помощью GPU).
- Оптимизация всей системы — ключевой фактор высокой производительности. Открытость эффективных фреймворков глубокого обучения сильно облегчает проектирование и реализацию такой оптимизации.
Упражнения
- Какие части кода, который вы сейчас пишете, могли бы «учиться», то есть улучшаться через обучение и автоматическое определение проектных решений, принятых в коде? Содержит ли ваш код эвристические проектные решения?
- Для каких ваших задач есть много примеров решений, но нет конкретного автоматизированного способа? Это могут быть главные кандидаты для применения глубокого обучения.
- Если рассматривать развитие ИИ как новую промышленную революцию, какова связь между алгоритмами и данными? Похожа ли она на связь паровой машины и угля? В чём фундаментальное различие?
- В каких ещё областях можно применить сквозной метод обучения, например в задачах с рис. 1.2, в физике, инженерии и эконометрике?
Литература
- Bahdanau, D., Cho, K., & Bengio, Y. (2014). Neural machine translation by jointly learning to align and translate. arXiv preprint arXiv:1409.0473.
- Bishop, C. M. (1995). Training with noise is equivalent to Tikhonov regularization. Neural Computation, 7(1), 108–116.
- Brown, N., & Sandholm, T. (2017). Libratus: The superhuman AI for no-limit poker. In IJCAI (pp. 5226–5228).
- Campbell, M., Hoane Jr., A. J., & Hsu, F.-h. (2002). Deep Blue. Artificial Intelligence, 134(1–2), 57–83.
- Canny, J. (1987). A computational approach to edge detection. In Readings in Computer Vision (pp. 184–203). Elsevier.
- Goodfellow, I., Pouget-Abadie, J., Mirza, M., Xu, B., Warde-Farley, D., Ozair, S., Courville, A., & Bengio, Y. (2014). Generative adversarial nets. In Advances in Neural Information Processing Systems (pp. 2672–2680).
- Graves, A., & Schmidhuber, J. (2005). Framewise phoneme classification with bidirectional LSTM and other neural network architectures. Neural Networks, 18(5–6), 602–610.
- Hebb, D. O. (1949). The organization of behavior. Wiley.
- Hu, J., Shen, L., & Sun, G. (2018). Squeeze-and-excitation networks. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (pp. 7132–7141).
- Jia, X., Song, S., He, W., et al. (2018). Highly scalable deep learning training system with mixed-precision: Training ImageNet in four minutes. arXiv preprint arXiv:1807.11205.
- Karras, T., Aila, T., Laine, S., & Lehtinen, J. (2017). Progressive growing of GANs for improved quality, stability, and variation. arXiv preprint arXiv:1710.10196.
- LeCun, Y., Bottou, L., Bengio, Y., & Haffner, P. (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278–2324.
- Li, M. (2017). Scaling distributed machine learning with system and algorithm co-design [PhD thesis]. Carnegie Mellon University.
- Lin, Y., Lv, F., Zhu, S., et al. (2010). ImageNet classification: Fast descriptor coding and large-scale SVM training. Large Scale Visual Recognition Challenge.
- Lowe, D. G. (2004). Distinctive image features from scale-invariant keypoints. International Journal of Computer Vision, 60(2), 91–110.
- McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. The Bulletin of Mathematical Biophysics, 5(4), 115–133.
- Park, T., Liu, M.-Y., Wang, T.-C., & Zhu, J.-Y. (2019). Semantic image synthesis with spatially-adaptive normalization. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 2337–2346).
- Reed, S., & De Freitas, N. (2015). Neural programmer-interpreters. arXiv preprint arXiv:1511.06279.
- Silver, D., Huang, A., Maddison, C. J., et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature, 529(7587), 484.
- Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I., & Salakhutdinov, R. (2014). Dropout: A simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 15(1), 1929–1958.
- Sukhbaatar, S., Weston, J., Fergus, R., et al. (2015). End-to-end memory networks. In Advances in Neural Information Processing Systems (pp. 2440–2448).
- Turing, A. M. (1950). Computing machinery and intelligence. Mind, 59(236), 433–460.
- Watkins, C. J. C. H., & Dayan, P. (1992). Q-learning. Machine Learning, 8(3–4), 279–292.
- Xiong, W., Wu, L., Alleva, F., Droppo, J., Huang, X., & Stolcke, A. (2018). The Microsoft 2017 conversational speech recognition system. In 2018 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP) (pp. 5934–5938). IEEE.
- You, Y., Gitman, I., & Ginsburg, B. (2017). Large batch training of convolutional networks. arXiv preprint arXiv:1708.03888.
- Zhu, J.-Y., Park, T., Isola, P., & Efros, A. A. (2017). Unpaired image-to-image translation using cycle-consistent adversarial networks. In Proceedings of the IEEE International Conference on Computer Vision (pp. 2223–2232).
2. Предварительные знания
Чтобы учиться глубокому обучению, сначала нужно освоить некоторые базовые навыки. Все методы машинного обучения так или иначе извлекают информацию из данных. Поэтому сначала мы изучим практические навыки работы с данными: их хранение, обработку и предварительную подготовку.
Машинное обучение обычно работает с большими наборами данных. Некоторые наборы данных можно представлять как таблицу, в которой строки соответствуют примерам, а столбцы — признакам. Линейная алгебра даёт методы для работы с табличными данными. Мы не будем вдаваться в детали, а сосредоточимся на основных принципах матричных операций и на их реализации.
Глубокое обучение — это обучение через оптимизацию.
Для модели с параметрами мы хотим найти такие значения параметров, при которых модель лучше всего приближает данные.
На каждом шаге алгоритма, чтобы понять, как именно менять параметры, нужны некоторые знания математического анализа.
В этой главе мы кратко их изложим.
К счастью, пакет autograd вычисляет производные автоматически, и о нём тоже пойдёт речь в этой главе.
Машинное обучение также связано с предсказаниями: зная наблюдаемую информацию, каким может быть значение некоторого неизвестного свойства? Чтобы строго делать выводы в условиях неопределённости, нужен язык теории вероятностей.
Наконец, официальная документация содержит множество описаний и примеров, которые выходят за рамки этой книги. В конце главы мы покажем, как найти нужную информацию в официальной документации.
Книга не предъявляет к математической подготовке читателя чрезмерных требований: достаточно правильно понимать математику, необходимую для глубокого обучения. Это не означает, что математики в книге нет: в этой главе кратко изложены базовые и часто используемые математические сведения, чтобы читатель мог понять бо́льшую часть математики, встречающейся в тексте. Если же читатель хочет глубоко разобраться во всей математике, он может дополнительно изучить материал из математического приложения к книге.
2.1 Манипулирование данными
Чтобы выполнять различные операции с данными, нам нужен способ их хранить и обрабатывать. Обычно нужно сделать две важные вещи: (1) получить данные; (2) обработать их после того, как они попали в компьютер. Без способа хранить данные получать их не имеет смысла.
Для начала познакомимся с -мерными массивами, которые также называют тензорами (tensor).
Тем, кто пользовался пакетом NumPy для Python, этот раздел будет знаком.
Какой бы фреймворк глубокого обучения ни использовался, его класс тензоров (в MXNet это ndarray, в PyTorch и TensorFlow — Tensor) похож на ndarray из NumPy.
Однако фреймворки глубокого обучения предлагают несколько важных возможностей, которых нет у ndarray из NumPy:
во-первых, они хорошо поддерживают ускоренные вычисления на GPU, тогда как NumPy работает только на CPU;
во-вторых, класс тензоров поддерживает автоматическое дифференцирование.
Эти возможности делают класс тензоров более подходящим для глубокого обучения.
Если не оговорено иное, под тензорами в этой книге понимаются экземпляры класса тензоров.
2.1.1 Начало работы
Цель этого раздела — познакомить читателя с базовыми инструментами численных вычислений, которые понадобятся при чтении книги. Если вам трудно понять некоторые математические понятия или функции библиотек, не беспокойтесь: в следующих главах эти темы будут разобраны на практических примерах. Если у вас уже есть соответствующий опыт и вы хотите глубже изучить математику, можете пропустить этот раздел.
MXNet: Сначала импортируем модуль np (numpy) и модуль npx (numpy_extension) из MXNet.
Модуль np содержит функции, которые поддерживает NumPy, а модуль npx — набор расширенных функций для глубокого обучения в среде, похожей на NumPy.
При работе с тензорами почти всегда вызывают функцию set_np: она нужна для совместимости с другими компонентами MXNet, работающими с тензорами.
PyTorch: Сначала импортируем torch. Обратите внимание: хотя фреймворк называется PyTorch, в коде используется имя torch, а не pytorch.
TensorFlow: Сначала импортируем tensorflow. Поскольку это имя довольно длинное, после импорта часто используют короткий псевдоним tf.
MXNet:
from mxnet import np, npx
npx.set_np()
PyTorch:
import torch
TensorFlow:
import tensorflow as tf
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
Тензор представляет собой массив числовых значений, который может иметь несколько измерений. Тензор с одной осью соответствует математическому понятию вектора (vector); тензор с двумя осями соответствует математической матрице (matrix); тензоры с большим числом осей специального математического названия не имеют.
MXNet: Сначала создадим вектор-строку x с помощью arange. Она содержит первые 12 целых чисел, начиная с 0; по умолчанию они создаются как числа с плавающей точкой. Каждое значение тензора называют его элементом (element). Например, в тензоре x 12 элементов. Если не указано иное, новый тензор сохраняется в оперативной памяти, а вычисления выполняются на CPU.
PyTorch: Сначала создадим вектор-строку x с помощью arange. Она содержит первые 12 целых чисел, начиная с 0; по умолчанию они создаются как целые числа, но можно указать и тип с плавающей точкой. Каждое значение тензора называют его элементом (element). Например, в тензоре x 12 элементов. Если не указано иное, новый тензор сохраняется в оперативной памяти, а вычисления выполняются на CPU.
TensorFlow: Сначала создадим вектор-строку x с помощью range. Она содержит первые 12 целых чисел, начиная с 0; по умолчанию они создаются как целые числа, но можно указать и тип с плавающей точкой. Каждое значение тензора называют его элементом (element). Например, в тензоре x 12 элементов. Если не указано иное, новый тензор сохраняется в оперативной памяти, а вычисления выполняются на CPU.
MXNet:
x = np.arange(12)
x
PyTorch:
x = torch.arange(12)
x
TensorFlow:
x = tf.range(12)
x
PaddlePaddle:
x = paddle.arange(12)
x
Форму тензора (длину вдоль каждой оси) можно получить через атрибут shape.
x.shape
Если нужно узнать только общее число элементов тензора, то есть произведение всех элементов формы, можно проверить его размер (size).
Поскольку здесь мы работаем с вектором, его shape и size по сути совпадают.
MXNet:
x.size
PyTorch:
x.numel()
TensorFlow:
tf.size(x)
PaddlePaddle:
x.numel()
Чтобы изменить форму тензора, не меняя число элементов и их значения, можно вызвать функцию reshape.
Например, можно превратить тензор x из вектора-строки формы (12,) в матрицу формы (3, 4).
Новый тензор содержит те же значения, что и исходный, но теперь он рассматривается как матрица из 3 строк и 4 столбцов.
Важно подчеркнуть: хотя форма тензора изменилась, значения его элементов не изменились.
Обратите внимание, что при изменении формы размер тензора не меняется.
MXNet, PyTorch:
X = x.reshape(3, 4)
X
TensorFlow:
X = tf.reshape(x, (3, 4))
X
PaddlePaddle:
X = paddle.reshape(x, (3, 4))
X
Не обязательно указывать каждое измерение вручную.
Если целевая форма — (высота, ширина), то, зная ширину, высоту можно вычислить автоматически, и делить самостоятельно не нужно.
В предыдущем примере, чтобы получить матрицу из 3 строк, мы вручную указали 3 строки и 4 столбца.
К счастью, можно воспользоваться автоматическим вычислением размерности, указав -1.
То есть вместо x.reshape(3, 4) можно написать x.reshape(-1, 4) или x.reshape(3, -1).
Иногда хочется инициализировать тензор нулями, единицами, другими константами или числами, случайно выбранными из определённого распределения. Например, создадим тензор формы (2, 3, 4), все элементы которого равны 0. Код выглядит так:
MXNet:
np.zeros((2, 3, 4))
PyTorch:
torch.zeros((2, 3, 4))
TensorFlow:
tf.zeros((2, 3, 4))
PaddlePaddle:
paddle.zeros((2, 3, 4))
Аналогично можно создать тензор формы (2, 3, 4), все элементы которого равны 1:
MXNet:
np.ones((2, 3, 4))
PyTorch:
torch.ones((2, 3, 4))
TensorFlow:
tf.ones((2, 3, 4))
PaddlePaddle:
paddle.ones((2, 3, 4))
Иногда значения элементов тензора удобно получить случайной выборкой из определённого распределения. Например, когда мы создаём массивы как параметры нейронной сети, их значения обычно задают случайным образом. Следующий код создаёт тензор формы (3, 4). Каждый его элемент случайно выбирается из стандартного нормального (гауссова) распределения со средним 0 и стандартным отклонением 1.
MXNet:
np.random.normal(0, 1, size=(3, 4))
PyTorch:
torch.randn(3, 4)
TensorFlow:
tf.random.normal(shape=[3, 4])
PaddlePaddle:
paddle.randn((3, 4),'float32')
Также можно задать значения элементов тензора явно, передав Python-список (или вложенный список) с числами. Здесь внешний список соответствует оси 0, а внутренние списки — оси 1.
MXNet:
np.array([[2, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
PyTorch:
torch.tensor([[2, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
TensorFlow:
tf.constant([[2, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
PaddlePaddle:
paddle.to_tensor([[2, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
2.1.2 Операторы
Нас интересуют не только чтение и запись данных. Мы хотим выполнять над данными математические операции. Самые простые и полезные из них — поэлементные (elementwise) операции. Они применяют стандартный скалярный оператор к каждому элементу массива. Для функций, которые принимают два массива, поэлементная операция применяет бинарный оператор к каждой паре элементов, стоящих в одинаковых позициях двух массивов. Поэлементную функцию можно построить на основе любой функции, которая переводит скаляр в скаляр.
В математической записи унарный скалярный оператор (принимающий один аргумент) обозначается как . Это значит, что функция отображает любое вещественное число () в другое вещественное число. Аналогично бинарный скалярный оператор (принимающий два аргумента) обозначается как . Для любых двух векторов и одинаковой формы и бинарного оператора мы получаем вектор . Вычисляется он так: , где , и — элементы векторов , и соответственно. Здесь мы превращаем скалярную функцию в поэлементную векторную операцию и получаем функцию , которая возвращает вектор.
Для любых тензоров одинаковой формы стандартные арифметические операторы (+, -, *, / и **) выполняются поэлементно.
Поэлементную операцию можно выполнять над любыми двумя тензорами одинаковой формы.
В примере ниже через запятую перечислены пять результатов поэлементных операций — они образуют кортеж.
MXNet:
x = np.array([1, 2, 4, 8])
y = np.array([2, 2, 2, 2])
x + y, x - y, x * y, x / y, x ** y # Оператор ** — возведение в степень
PyTorch:
x = torch.tensor([1.0, 2, 4, 8])
y = torch.tensor([2, 2, 2, 2])
x + y, x - y, x * y, x / y, x ** y # Оператор ** — возведение в степень
TensorFlow:
x = tf.constant([1.0, 2, 4, 8])
y = tf.constant([2.0, 2, 2, 2])
x + y, x - y, x * y, x / y, x ** y # Оператор ** — возведение в степень
PaddlePaddle:
x = paddle.to_tensor([1.0, 2, 4, 8])
y = paddle.to_tensor([2, 2, 2, 2])
x + y, x - y, x * y, x / y, x**y # Оператор ** — возведение в степень
Поэлементно можно применять и другие вычисления, например унарные операторы, такие как экспонента.
MXNet:
np.exp(x)
PyTorch:
torch.exp(x)
TensorFlow:
tf.exp(x)
PaddlePaddle:
paddle.exp(x)
Помимо поэлементных вычислений, можно выполнять и линейно-алгебраические операции, включая скалярное произведение векторов и умножение матриц. Ключевые положения линейной алгебры мы разберём в разделе 2.3.
Также можно объединять (concatenate) несколько тензоров, укладывая их встык в один больший тензор. Нужно лишь передать список тензоров и указать, по какой оси их соединять. В примере ниже показано, что происходит при соединении двух матриц по строкам (вдоль оси 0, первого элемента формы) и по столбцам (вдоль оси 1, второго элемента формы). Длина первого выходного тензора по оси 0 (6) равна сумме длин входных тензоров по оси 0 (); длина второго выходного тензора по оси 1 (8) равна сумме длин входных тензоров по оси 1 ().
MXNet:
X = np.arange(12).reshape(3, 4)
Y = np.array([[2, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
np.concatenate([X, Y], axis=0), np.concatenate([X, Y], axis=1)
PyTorch:
X = torch.arange(12, dtype=torch.float32).reshape((3,4))
Y = torch.tensor([[2.0, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
torch.cat((X, Y), dim=0), torch.cat((X, Y), dim=1)
TensorFlow:
X = tf.reshape(tf.range(12, dtype=tf.float32), (3, 4))
Y = tf.constant([[2.0, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
tf.concat([X, Y], axis=0), tf.concat([X, Y], axis=1)
PaddlePaddle:
X = paddle.arange(12, dtype='float32').reshape((3, 4))
Y = paddle.to_tensor([[2.0, 1, 4, 3], [1, 2, 3, 4], [4, 3, 2, 1]])
paddle.concat((X, Y), axis=0), paddle.concat((X, Y), axis=1)
Иногда нужно построить двоичный тензор с помощью логических операторов.
Возьмём X == Y: в каждой позиции, где X и Y равны, соответствующий элемент нового тензора равен 1.
Это значит, что логическое выражение X == Y в этой позиции истинно, а в остальных позициях ложно, то есть равно 0.
X == Y
Суммирование всех элементов тензора даёт тензор из одного элемента.
MXNet, PyTorch, PaddlePaddle:
X.sum()
TensorFlow:
tf.reduce_sum(X)
2.1.3 Механизм broadcasting
Выше мы видели, как выполнять поэлементные операции над тензорами одинаковой формы. Даже при разных формах можно выполнять поэлементные операции, используя механизм broadcasting. Он работает так:
- Один или оба массива расширяются за счёт копирования элементов так, чтобы после преобразования оба тензора имели одинаковую форму;
- Над полученными массивами выполняется поэлементная операция.
В большинстве случаев broadcasting происходит вдоль осей длины 1, как в следующем примере:
MXNet:
a = np.arange(3).reshape(3, 1)
b = np.arange(2).reshape(1, 2)
a, b
PyTorch:
a = torch.arange(3).reshape((3, 1))
b = torch.arange(2).reshape((1, 2))
a, b
TensorFlow:
a = tf.reshape(tf.range(3), (3, 1))
b = tf.reshape(tf.range(2), (1, 2))
a, b
PaddlePaddle:
a = paddle.reshape(paddle.arange(3), (3, 1))
b = paddle.reshape(paddle.arange(2), (1, 2))
a, b
Поскольку a и b — матрицы формы и , их непосредственное сложение невозможно: формы не совпадают.
Мы расширяем (broadcast) обе матрицы до одной большей матрицы : матрица a копирует столбец, матрица b копирует строки, а затем результаты складываются поэлементно.
MXNet, PyTorch, TensorFlow, PaddlePaddle:
a + b
2.1.4 Индексация и срезы
Как и в любом другом массиве Python, к элементам тензора можно обращаться по индексам. Как и во всех массивах Python, первый элемент имеет индекс 0, а последний — индекс -1; для указания диапазона можно задавать границы, при которых включается первый элемент и исключается последний.
Так, с помощью [-1] можно выбрать последний элемент, а с помощью [1:3] — второй и третий элементы:
X[-1], X[1:3]
MXNet, PyTorch: Помимо чтения, с помощью индексов можно записывать значения в элементы матрицы.
TensorFlow: Тензоры (Tensors) в TensorFlow неизменяемы и не поддерживают присваивание.
Переменные (Variables) в TensorFlow — изменяемые контейнеры, в которые можно присваивать значения.
Помните, что в TensorFlow градиенты не распространяются обратно через Variable.
Кроме присваивания всей переменной целиком, можно записывать значения и в отдельные элементы Variable по индексу.
MXNet, PyTorch, PaddlePaddle:
X[1, 2] = 9
X
TensorFlow:
X_var = tf.Variable(X)
X_var[1, 2].assign(9)
X_var
Если нужно присвоить одно и то же значение нескольким элементам, достаточно проиндексировать все нужные элементы и присвоить им значение.
Например, [0:2, :] обращается к первой и второй строкам, где «:» означает все элементы вдоль оси 1 (столбцы).
Хотя мы говорим об индексации матриц, это работает и для векторов, и для тензоров с более чем двумя осями.
MXNet, PyTorch, PaddlePaddle:
X[0:2, :] = 12
X
TensorFlow:
X_var = tf.Variable(X)
X_var[0:2, :].assign(tf.ones(X_var[0:2,:].shape, dtype = tf.float32) * 12)
X_var
2.1.5 Экономия памяти
Некоторые операции могут приводить к выделению памяти под новый результат.
Например, если написать Y = X + Y, то Y будет указывать не на прежний тензор, а на тензор в новой области памяти.
В примере ниже мы покажем это с помощью функции id() из Python, которая возвращает адрес объекта в памяти.
После выполнения Y = Y + X видно, что id(Y) указывает на другое место.
Это происходит потому, что Python сначала вычисляет Y + X, выделяет под результат новую память, и только потом переставляет Y на эту новую область.
before = id(Y)
Y = Y + X
id(Y) == before
Такое поведение может быть нежелательно по двум причинам:
- Во-первых, нам не хочется без необходимости постоянно выделять память. В машинном обучении могут быть сотни мегабайт параметров, которые обновляются многократно в секунду. Обычно такие обновления хотелось бы выполнять на месте (in-place);
- Во-вторых, если не обновлять на месте, на старую область памяти по-прежнему будут ссылаться другие переменные, и часть кода может случайно использовать устаревшие параметры.
MXNet, PyTorch: К счастью, выполнить операцию на месте очень просто.
Можно присвоить результат операции заранее выделенному массиву с помощью срезов, например Y[:] = <выражение>.
Чтобы показать это, сначала создадим новую матрицу Z той же формы, что и Y, и с помощью zeros_like выделим блок из одних нулей.
TensorFlow: Variables — это изменяемые контейнеры в TensorFlow, которые позволяют хранить параметры модели.
Результат операции можно присвоить Variable с помощью assign.
Чтобы показать это, создадим Z той же формы, что и тензор Y, и с помощью zeros_like выделим блок из одних нулей.
MXNet:
Z = np.zeros_like(Y)
print('id(Z):', id(Z))
Z[:] = X + Y
print('id(Z):', id(Z))
PyTorch:
Z = torch.zeros_like(Y)
print('id(Z):', id(Z))
Z[:] = X + Y
print('id(Z):', id(Z))
TensorFlow:
Z = tf.Variable(tf.zeros_like(Y))
print('id(Z):', id(Z))
Z.assign(X + Y)
print('id(Z):', id(Z))
PaddlePaddle:
Z = paddle.zeros_like(Y)
print('id(Z):', id(Z))
Z = X + Y
print('id(Z):', id(Z))
MXNet, PyTorch: Если в дальнейших вычислениях X не используется, можно также написать X[:] = X + Y или X += Y, чтобы уменьшить затраты памяти на операцию.
TensorFlow: Даже если вы храните состояние в Variable, может понадобиться избегать лишнего выделения памяти под тензоры, которые не являются параметрами модели, чтобы дополнительно снизить расход памяти.
Поскольку тензоры TensorFlow неизменяемы, а градиенты не проходят через Variable, TensorFlow не предоставляет явного способа выполнить отдельную операцию на месте.
Однако TensorFlow предоставляет декоратор tf.function, который заключает вычисления в граф TensorFlow; перед запуском граф компилируется и оптимизируется.
Это позволяет TensorFlow удалять неиспользуемые значения и повторно использовать ранее выделенную память для значений, которые уже не нужны.
Так расход памяти на вычисления в TensorFlow сводится к минимуму.
MXNet, PyTorch, PaddlePaddle:
before = id(X)
X += Y
id(X) == before
TensorFlow:
@tf.function
def computation(X, Y):
Z = tf.zeros_like(Y) # Это неиспользуемое значение будет удалено
A = X + Y # Когда оно больше не нужно, память будет переиспользована
B = A + Y
C = B + Y
return C + Y
computation(X, Y)
2.1.6 Преобразование в другие объекты Python
MXNet, TensorFlow: Преобразовать тензор фреймворка глубокого обучения в NumPy-тензор (ndarray) несложно, и обратное преобразование тоже.
Результат при этом не разделяет память с исходным тензором.
Эта небольшая неприятность на самом деле очень важна: при вычислениях на CPU или GPU, если пакет NumPy в Python тоже захочет использовать тот же блок памяти для других операций, не хочется останавливать вычисления и ждать его.
PyTorch: Преобразовать тензор фреймворка в NumPy-тензор (ndarray) так же просто, и обратно.
Тензоры torch и массивы numpy разделяют одну и ту же область памяти, поэтому изменение одного из них (в том числе операцией на месте) меняет и другой.
MXNet:
A = X.asnumpy()
B = np.array(A)
type(A), type(B)
PyTorch:
A = X.numpy()
B = torch.tensor(A)
type(A), type(B)
TensorFlow:
A = X.numpy()
B = tf.constant(A)
type(A), type(B)
PaddlePaddle:
A = X.numpy()
B = paddle.to_tensor(A)
type(A), type(B)
Чтобы преобразовать тензор размера 1 в скаляр Python, можно вызвать функцию item или встроенные функции Python.
MXNet:
a = np.array([3.5])
a, a.item(), float(a), int(a)
PyTorch:
a = torch.tensor([3.5])
a, a.item(), float(a), int(a)
TensorFlow:
a = tf.constant([3.5]).numpy()
a, a.item(), float(a), int(a)
PaddlePaddle:
a = paddle.to_tensor([3.5])
a, a.item(), float(a), int(a)
Резюме
- Основной интерфейс для хранения и обработки данных в глубоком обучении — тензор (-мерный массив). Он предоставляет множество возможностей: базовые математические операции, broadcasting, индексацию, срезы, экономию памяти и преобразование в другие объекты Python.
Упражнения
- Запустите код из этого раздела. Замените условие
X == YнаX < YилиX > Yи посмотрите, какой тензор получится. - Замените два тензора, над которыми выполняется поэлементная операция с broadcasting, на тензоры другой формы (например, трёхмерные). Совпадает ли результат с вашими ожиданиями?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
2.2 Предобработка данных
Чтобы использовать глубокое обучение для решения задач реального мира, мы часто начинаем с предобработки исходных данных, а не с уже готовых данных в формате тензоров.
Из инструментов анализа данных в Python обычно используют пакет pandas.
Как и многие другие расширения обширной экосистемы Python, pandas умеет работать с тензорами.
В этом разделе мы кратко покажем, как предобработать исходные данные с помощью pandas и как преобразовать их в формат тензоров.
В последующих главах будут описаны и другие методы предобработки данных.
2.2.1 Чтение набора данных
Для примера мы сначала создадим искусственный набор данных и сохраним его в CSV-файл ../data/house_tiny.csv (файл со значениями, разделёнными запятыми).
Данные в других форматах можно обрабатывать похожим образом.
Ниже мы построчно запишем набор данных в CSV-файл.
import os
os.makedirs(os.path.join('..', 'data'), exist_ok=True)
data_file = os.path.join('..', 'data', 'house_tiny.csv')
with open(data_file, 'w') as f:
f.write('NumRooms,Alley,Price\n') # Имена столбцов
f.write('NA,Pave,127500\n') # Каждая строка — один пример данных
f.write('2,NA,106000\n')
f.write('4,NA,178100\n')
f.write('NA,NA,140000\n')
Чтобы загрузить исходный набор данных из созданного CSV-файла, импортируем пакет pandas и вызовем функцию read_csv.
В этом наборе данных четыре строки и три столбца.
Каждая строка описывает количество комнат («NumRooms»), тип переулка («Alley») и цену дома («Price»).
# Если pandas не установлен, достаточно раскомментировать следующие строки, чтобы его установить
# !pip install pandas
import pandas as pd
data = pd.read_csv(data_file)
print(data)
2.2.2 Обработка пропущенных значений
Обратите внимание: значения «NaN» обозначают пропущенные данные. Для обработки пропущенных данных обычно применяют импутацию (заполнение пропусков) и удаление, где импутация заменяет пропущенное значение подходящим значением, а удаление просто игнорирует пропущенные значения. Здесь мы рассмотрим импутацию.
С помощью индексации по позиции iloc разделим data на inputs и outputs: первые — это два первых столбца data, а вторые — последний столбец.
Пропущенные числовые значения в inputs мы заменим средним значением того столбца, в котором они находятся.
inputs, outputs = data.iloc[:, 0:2], data.iloc[:, 2]
inputs = inputs.fillna(inputs.mean())
print(inputs)
Для категориальных или дискретных значений в inputs мы будем считать «NaN» отдельной категорией.
Поскольку столбец «Alley» принимает только два категориальных значения «Pave» и «NaN», pandas может автоматически преобразовать его в два столбца «Alley_Pave» и «Alley_nan».
Строка, в которой тип переулка «Pave», получит в столбце «Alley_Pave» значение 1, а в столбце «Alley_nan» — значение 0.
Строка без типа переулка получит в «Alley_Pave» значение 0, а в «Alley_nan» — значение 1.
inputs = pd.get_dummies(inputs, dummy_na=True)
print(inputs)
2.2.3 Преобразование в формат тензора
Теперь все элементы inputs и outputs имеют числовой тип, и их можно преобразовать в тензоры.
Когда данные представлены в формате тензоров, их можно обрабатывать с помощью функций для тензоров, которые были введены в разделе 2.1.
MXNet:
from mxnet import np
X, y = np.array(inputs.to_numpy(dtype=float)), np.array(outputs.to_numpy(dtype=float))
X, y
PyTorch:
import torch
X = torch.tensor(inputs.to_numpy(dtype=float))
y = torch.tensor(outputs.to_numpy(dtype=float))
X, y
TensorFlow:
import tensorflow as tf
X = tf.constant(inputs.to_numpy(dtype=float))
y = tf.constant(outputs.to_numpy(dtype=float))
X, y
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
X, y = paddle.to_tensor(inputs.values), paddle.to_tensor(outputs.values)
X, y
Резюме
- Пакет
pandas— распространённый в Python инструмент анализа данных, и он совместим с тензорами. - При работе с пропущенными данными в
pandasмы в зависимости от ситуации выбираем импутацию или удаление.
Упражнения
Создайте исходный набор данных с большим количеством строк и столбцов.
- Удалите столбец, в котором больше всего пропущенных значений.
- Преобразуйте предобработанный набор данных в формат тензоров.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
2.3 Линейная алгебра
После того как мы научились хранить и обрабатывать данные, кратко повторим основные сведения из линейной алгебры. Они помогут читателю понять и реализовать большинство моделей, которые рассматриваются в этой книге. В этом разделе мы введём базовые математические объекты линейной алгебры, операции над ними и их обозначения, а также покажем, как реализовать их в коде.
2.3.1 Скаляры
Если вы когда-нибудь расплачивались в ресторане, вы уже знакомы с некоторыми базовыми понятиями линейной алгебры, например со сложением и умножением чисел. Допустим, температура в Пекине составляет (градусы Фаренгейта — единица измерения температуры, отличная от градусов Цельсия). Строго говоря, одно число называют скаляром (scalar). Чтобы перевести это значение в более привычные градусы Цельсия, можно вычислить выражение , подставив . В этом выражении каждое из чисел (, и ) — скаляр. Символы и называют переменными (variable): они обозначают неизвестные скалярные значения.
В этой книге скалярные переменные обозначаются обычными строчными буквами (например, , и ). Через обозначают пространство всех (непрерывных) вещественных скаляров; строгое определение пространства (space) мы дадим позже, а пока достаточно помнить, что запись — формальный способ сказать, что — вещественный скаляр. Символ читается как «принадлежит» и означает «является элементом множества». Например, запись показывает, что и — числа, которые могут принимать только значения или .
Скаляр представляется тензором, содержащим один элемент. Следующий код создаёт два скаляра и выполняет над ними знакомые арифметические операции: сложение, умножение, деление и возведение в степень.
MXNet:
from mxnet import np, npx
npx.set_np()
x = np.array(3.0)
y = np.array(2.0)
x + y, x * y, x / y, x ** y
PyTorch:
import torch
x = torch.tensor(3.0)
y = torch.tensor(2.0)
x + y, x * y, x / y, x**y
TensorFlow:
import tensorflow as tf
x = tf.constant(3.0)
y = tf.constant(2.0)
x + y, x * y, x / y, x**y
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
x = paddle.to_tensor([3.0])
y = paddle.to_tensor([2.0])
x + y, x * y, x / y, x**y
2.3.2 Векторы
Вектор можно рассматривать как список скалярных значений. Эти значения называют элементами (element) или компонентами (component) вектора. Когда векторы представляют примеры из набора данных, значения их компонентов имеют вполне конкретный смысл. Например, если мы обучаем модель оценивать риск невозврата кредита, каждому заявителю можно сопоставить вектор, компоненты которого соответствуют его доходу, стажу работы, числу прошлых просрочек и другим факторам. Если же мы изучаем риск сердечного приступа у пациентов больницы, каждого пациента можно представить вектором, компоненты которого — последние показатели жизнедеятельности, уровень холестерина, ежедневное время физической активности и т. д. В математической записи векторы обычно обозначают жирными строчными буквами (например, , и ).
Вектор представляют одномерным тензором. В общем случае тензор может иметь любую длину в пределах ограничений памяти компьютера.
MXNet:
x = np.arange(4)
x
PyTorch:
x = torch.arange(4)
x
TensorFlow:
x = tf.range(4)
x
PaddlePaddle:
x = paddle.arange(4)
x
К любому элементу вектора можно обратиться по индексу: например, обозначает -й элемент. Заметим, что элемент — скаляр, поэтому при обращении к нему он не выделяется жирным шрифтом. Большинство литературы по умолчанию считает векторы столбцами, и в этой книге мы придерживаемся того же соглашения. В математической записи вектор можно представить так:
где — элементы вектора. В коде элементы вектора доступны через индексацию тензора.
MXNet:
x[3]
PyTorch:
x[3]
TensorFlow:
x[3]
PaddlePaddle:
x[3]
2.3.2.1 Длина, размерность и форма
Вектор — это просто массив чисел, и, как у любого массива, у вектора есть длина. Если мы хотим сказать, что вектор состоит из вещественных скаляров, можно записать . Длину вектора обычно называют его размерностью (dimension).
Как и у обычных массивов Python, длину тензора можно получить с помощью встроенной функции len().
MXNet:
len(x)
PyTorch:
len(x)
TensorFlow:
len(x)
PaddlePaddle:
len(x)
Когда вектор представлен тензором с одной осью, его длину можно получить и через атрибут .shape.
Форма (shape) — это кортеж, в котором перечислены длины тензора вдоль каждой оси (то есть размеры по каждому измерению).
У тензора с одной осью форма содержит только один элемент.
MXNet:
x.shape
PyTorch:
x.shape
TensorFlow:
x.shape
PaddlePaddle:
x.shape
Слово «размерность» (dimension) в разных контекстах означает разное, и это часто сбивает с толку. Чтобы избежать путаницы, уточним: размерность вектора или оси — это длина вектора или оси, то есть число его элементов. Однако размерность тензора — это число его осей. В этом смысле размерность оси тензора — это длина этой оси.
2.3.3 Матрицы
Как вектор обобщает скаляр с нулевого порядка на первый, так матрица обобщает вектор с первого порядка на второй. Матрицы обычно обозначают жирными заглавными буквами (например, , и ), а в коде представляют тензорами с двумя осями.
Запись означает, что матрица состоит из строк и столбцов вещественных скаляров. Любую матрицу можно представить как таблицу, в которой каждый элемент стоит в -й строке и -м столбце:
Для любой матрицы её форма — (, ), или . Если у матрицы одинаковое число строк и столбцов, её форма квадратная; такую матрицу называют квадратной (square matrix).
Когда мы вызываем функцию, создающую тензор, матрицу формы можно получить, задав два размера и .
MXNet:
A = np.arange(20).reshape(5, 4)
A
PyTorch:
A = torch.arange(20).reshape(5, 4)
A
TensorFlow:
A = tf.reshape(tf.range(20), (5, 4))
A
PaddlePaddle:
A = paddle.reshape(paddle.arange(20), (5, 4))
A
Скалярный элемент матрицы можно получить по индексу строки () и индексу столбца (), например как . Если элементы матрицы не выписаны явно, как в формуле (2.3.2), для обозначения можно просто использовать строчную букву с двумя индексами. Чтобы запись оставалась компактной, запятую между индексами ставим только тогда, когда это необходимо, например и .
Если поменять местами строки и столбцы матрицы, результат называют транспонированием (transpose). Транспонированную матрицу обычно обозначают : если , то для любых и выполняется . Таким образом, транспонированная матрица из формулы (2.3.2) имеет форму :
Теперь получим транспонированную матрицу в коде.
MXNet:
A.T
PyTorch:
A.T
TensorFlow:
tf.transpose(A)
PaddlePaddle:
paddle.transpose(A, perm=[1, 0])
Особый вид квадратных матриц составляют симметричные матрицы (symmetric matrix): матрица симметрична, если она равна своей транспонированной: . Определим симметричную матрицу :
MXNet:
B = np.array([[1, 2, 3], [2, 0, 4], [3, 4, 5]])
B
PyTorch:
B = torch.tensor([[1, 2, 3], [2, 0, 4], [3, 4, 5]])
B
TensorFlow:
B = tf.constant([[1, 2, 3], [2, 0, 4], [3, 4, 5]])
B
PaddlePaddle:
B = paddle.to_tensor([[1, 2, 3], [2, 0, 4], [3, 4, 5]])
B
Теперь сравним B с её транспонированной матрицей.
MXNet, PyTorch:
B == B.T
TensorFlow:
B == tf.transpose(B)
PaddlePaddle:
B == paddle.transpose(B, perm=[1, 0])
Матрицы — полезные структуры данных: они позволяют организовывать данные с разными закономерностями. Например, строки матрицы могут соответствовать разным домам (примерам данных), а столбцы — разным признакам. Тем, кто работал с электронными таблицами или прочитал раздел 2.2, это знакомо. Поэтому, хотя отдельный вектор по умолчанию считается столбцом, в матрице, представляющей табличный набор данных, каждый пример чаще записывают строкой. Это соглашение будет использоваться в следующих главах и соответствует распространённой практике глубокого обучения. Например, вдоль самой внешней оси тензора можно обращаться к минибатчу примеров или перебирать его.
2.3.4 Тензоры
Так же как векторы обобщают скаляры, а матрицы — векторы, можно построить структуры данных с большим числом осей. Тензоры (здесь слово «тензор» означает алгебраический объект) — общий способ описания -мерных массивов с произвольным числом осей. Например, вектор — это тензор первого порядка, а матрица — тензор второго порядка. Тензоры обозначают прописными буквами особого шрифта (например, , и ), а их индексация (например, и ) устроена так же, как у матриц.
Тензоры становятся особенно важными, когда мы начинаем работать с изображениями. Изображение — это -мерный массив, в котором три оси соответствуют высоте, ширине и каналу (channel) — оси цветовых каналов (красного, зелёного и синего). Однако пока отложим тензоры более высоких порядков и сосредоточимся на основах.
MXNet:
X = np.arange(24).reshape(2, 3, 4)
X
PyTorch:
X = torch.arange(24).reshape(2, 3, 4)
X
TensorFlow:
X = tf.reshape(tf.range(24), (2, 3, 4))
X
PaddlePaddle:
X = paddle.reshape(paddle.arange(24), (2, 3, 4))
X
2.3.5 Основные свойства арифметики тензоров
Скаляры, векторы, матрицы и тензоры с любым числом осей обладают полезными свойствами. Например, из определения поэлементных операций видно, что любая поэлементная унарная операция не меняет форму своего операнда. Аналогично, для любых двух тензоров одинаковой формы результат поэлементной бинарной операции тоже является тензором той же формы. Например, сложение двух матриц одинаковой формы выполняется поэлементно.
MXNet:
A = np.arange(20).reshape(5, 4)
B = A.copy() # Выделяем новую память и присваиваем B копию A
A, A + B
PyTorch:
A = torch.arange(20, dtype=torch.float32).reshape(5, 4)
B = A.clone() # Выделяем новую память и присваиваем B копию A
A, A + B
TensorFlow:
A = tf.reshape(tf.range(20, dtype=tf.float32), (5, 4))
B = A # Нельзя скопировать A в B с выделением новой памяти
A, A + B
PaddlePaddle:
A = paddle.reshape(paddle.arange(20, dtype=paddle.float32), (5, 4))
B = A.clone() # Выделяем новую память и присваиваем B копию A
A, A + B
В частности, поэлементное умножение двух матриц называют произведением Адамара (Hadamard product) и обозначают символом . Для матрицы элемент, стоящий в -й строке и -м столбце, равен . Произведение Адамара матриц (определённой в формуле (2.3.2)) и имеет вид:
MXNet:
A * B
PyTorch:
A * B
TensorFlow:
A * B
PaddlePaddle:
A * B
Умножение тензора на скаляр или сложение с ним не меняет форму тензора: каждый элемент тензора складывается со скаляром или умножается на него.
MXNet:
a = 2
X = np.arange(24).reshape(2, 3, 4)
a + X, (a * X).shape
PyTorch:
a = 2
X = torch.arange(24).reshape(2, 3, 4)
a + X, (a * X).shape
TensorFlow:
a = 2
X = tf.reshape(tf.range(24), (2, 3, 4))
a + X, (a * X).shape
PaddlePaddle:
a = 2
X = paddle.reshape(paddle.arange(24), (2, 3, 4))
a + X, (a * X).shape
2.3.6 Редукция
Полезная операция, которую можно выполнить над любым тензором, — вычисление суммы его элементов. Для обозначения суммы используется символ . Сумму элементов вектора длины можно записать как . В коде для этого есть функция суммирования:
MXNet:
x = np.arange(4)
x, x.sum()
PyTorch:
x = torch.arange(4, dtype=torch.float32)
x, x.sum()
TensorFlow:
x = tf.range(4, dtype=tf.float32)
x, tf.reduce_sum(x)
PaddlePaddle:
x = paddle.arange(4, dtype=paddle.float32)
x, x.sum()
Можно записать сумму элементов тензора произвольной формы. Например, сумма элементов матрицы записывается как .
MXNet:
A.shape, A.sum()
PyTorch:
A.shape, A.sum()
TensorFlow:
A.shape, tf.reduce_sum(A)
PaddlePaddle:
A.shape, A.sum()
По умолчанию вызов функции суммирования уменьшает размерность тензора по всем осям, превращая его в скаляр.
Кроме того, можно указать, по какой оси выполнять суммирование для уменьшения размерности.
Для матрицы, чтобы просуммировать все строки и уменьшить размерность по оси 0, укажем axis=0.
Поскольку входная матрица суммируется по оси 0 для получения выходного вектора, размерность по оси 0 пропадает из формы результата.
MXNet:
A_sum_axis0 = A.sum(axis=0)
A_sum_axis0, A_sum_axis0.shape
PyTorch:
A_sum_axis0 = A.sum(axis=0)
A_sum_axis0, A_sum_axis0.shape
TensorFlow:
A_sum_axis0 = tf.reduce_sum(A, axis=0)
A_sum_axis0, A_sum_axis0.shape
PaddlePaddle:
A_sum_axis0 = A.sum(axis=0)
A_sum_axis0, A_sum_axis0.shape
Указание axis=1 приводит к суммированию элементов по всем столбцам, то есть к уменьшению размерности по оси 1.
Поэтому размерность по оси 1 пропадает из формы результата.
MXNet:
A_sum_axis1 = A.sum(axis=1)
A_sum_axis1, A_sum_axis1.shape
PyTorch:
A_sum_axis1 = A.sum(axis=1)
A_sum_axis1, A_sum_axis1.shape
TensorFlow:
A_sum_axis1 = tf.reduce_sum(A, axis=1)
A_sum_axis1, A_sum_axis1.shape
PaddlePaddle:
A_sum_axis1 = A.sum(axis=1)
A_sum_axis1, A_sum_axis1.shape
Суммирование по строкам и столбцам матрицы даёт тот же результат, что и суммирование всех её элементов.
MXNet, PyTorch:
A.sum(axis=[0, 1]) # Результат совпадает с A.sum()
TensorFlow:
tf.reduce_sum(A, axis=[0, 1]) # Результат совпадает с tf.reduce_sum(A)
PaddlePaddle:
A.sum(axis=[0, 1])
Связанная с суммой величина — среднее значение (mean или average). Его вычисляют, разделив сумму на число элементов. В коде есть функция для вычисления среднего значения тензора любой формы.
MXNet:
A.mean(), A.sum() / A.size
PyTorch:
A.mean(), A.sum() / A.numel()
TensorFlow:
tf.reduce_mean(A), tf.reduce_sum(A) / tf.size(A).numpy()
PaddlePaddle:
A.mean(), A.sum() / A.numel()
Аналогично, функция среднего значения может уменьшать размерность тензора по заданной оси.
MXNet, PyTorch:
A.mean(axis=0), A.sum(axis=0) / A.shape[0]
TensorFlow:
tf.reduce_mean(A, axis=0), tf.reduce_sum(A, axis=0) / A.shape[0]
PaddlePaddle:
A.mean(axis=0), A.sum(axis=0) / A.shape[0]
2.3.6.1 Суммирование без уменьшения размерности
Иногда при вычислении суммы или среднего полезно сохранить число осей неизменным.
MXNet, PyTorch:
sum_A = A.sum(axis=1, keepdims=True)
sum_A
TensorFlow:
sum_A = tf.reduce_sum(A, axis=1, keepdims=True)
sum_A
PaddlePaddle:
sum_A = paddle.sum(A, axis=1, keepdim=True)
sum_A
Например, поскольку sum_A после суммирования по строкам по-прежнему имеет две оси, мы можем разделить A на sum_A с помощью broadcasting.
MXNet:
A / sum_A
PyTorch:
A / sum_A
TensorFlow:
A / sum_A
PaddlePaddle:
A / sum_A
Если нужно вычислить накопленную сумму элементов A вдоль оси, например axis=0 (по строкам), можно вызвать функцию cumsum.
Она не уменьшает размерность входного тензора ни по одной из осей.
MXNet, PyTorch:
A.cumsum(axis=0)
TensorFlow:
tf.cumsum(A, axis=0)
PaddlePaddle:
A.cumsum(axis=0)
2.3.7 Скалярное произведение (dot product)
Мы уже изучили поэлементные операции, суммирование и среднее значение. Ещё одна из самых базовых операций — скалярное произведение. Для двух векторов их скалярное произведение (dot product) (или ) — это сумма произведений элементов, стоящих на одинаковых позициях: .
MXNet:
y = np.ones(4)
x, y, np.dot(x, y)
PyTorch:
y = torch.ones(4, dtype = torch.float32)
x, y, torch.dot(x, y)
TensorFlow:
y = tf.ones(4, dtype=tf.float32)
x, y, tf.tensordot(x, y, axes=1)
PaddlePaddle:
y = paddle.ones(shape=[4], dtype='float32')
x, y, paddle.dot(x, y)
Заметим, что скалярное произведение двух векторов можно вычислить поэлементным умножением с последующим суммированием:
MXNet:
np.sum(x * y)
PyTorch:
torch.sum(x * y)
TensorFlow:
tf.reduce_sum(x * y)
PaddlePaddle:
paddle.sum(x * y)
Скалярное произведение полезно во многих случаях. Например, пусть задан набор значений, представленный вектором , и набор весов, представленный вектором . Взвешенная сумма значений из с весами записывается как скалярное произведение . Если веса неотрицательны и в сумме дают 1 (то есть ), скалярное произведение задаёт взвешенное среднее (weighted average). Если нормировать оба вектора до единичной длины, скалярное произведение равно косинусу угла между ними. Понятие длины (length) будет формально введено далее в этом разделе.
2.3.8 Матрично-векторное произведение
Теперь, когда мы знаем, как вычислять скалярное произведение, можно перейти к матрично-векторному произведению (matrix-vector product). Вспомним матрицу и вектор , определённые в формулах (2.3.2) и (2.3.1). Представим матрицу через её вектор-строки:
где каждый — вектор-строка, задающая -ю строку матрицы. Матрично-векторное произведение — это вектор-столбец длины , -й элемент которого равен скалярному произведению :
Умножение матрицы можно рассматривать как преобразование векторов из в . Такие преобразования очень полезны: например, умножение на квадратную матрицу может представлять поворот. В следующих главах мы увидим, что матрично-векторные произведения позволяют описывать сложные вычисления, с помощью которых по значениям предыдущего слоя вычисляется каждый слой нейронной сети.
MXNet: В коде матрично-векторное произведение тензоров вычисляется той же функцией dot, что и скалярное произведение.
При вызове np.dot(A, x) для матрицы A и вектора x выполняется матрично-векторное произведение.
Заметим, что число столбцов A (длина по оси 1) должно совпадать с размерностью x (его длиной).
PyTorch: В коде матрично-векторное произведение тензоров вычисляется функцией mv.
При вызове torch.mv(A, x) для матрицы A и вектора x выполняется матрично-векторное произведение.
Заметим, что число столбцов A (длина по оси 1) должно совпадать с размерностью x (его длиной).
TensorFlow: В коде для матрично-векторного произведения тензоров используется функция matvec.
При вызове tf.linalg.matvec(A, x) выполняется матрично-векторное произведение.
Заметим, что число столбцов A (длина по оси 1) должно совпадать с размерностью x (его длиной).
MXNet:
A.shape, x.shape, np.dot(A, x)
PyTorch:
A.shape, x.shape, torch.mv(A, x)
TensorFlow:
A.shape, x.shape, tf.linalg.matvec(A, x)
PaddlePaddle:
A.shape, x.shape, paddle.mv(A, x)
2.3.9 Матрично-матричное умножение
Освоив скалярное произведение и матрично-векторное произведение, понять матрично-матричное умножение (matrix-matrix multiplication) несложно.
Пусть даны две матрицы и :
Обозначим вектор-строкой -ю строку матрицы , а вектор-столбцом — -й столбец матрицы . Чтобы получить матричное произведение , проще всего рассмотреть строки и столбцы :
Если просто вычислять каждый элемент как скалярное произведение , получим:
Матрично-матричное умножение можно рассматривать как матрично-векторных произведений, результаты которых объединяются в матрицу размера .
В коде ниже мы перемножаем A и B. Здесь A — матрица 5×4, а B — матрица 4×3.
После умножения получаем матрицу 5×3.
MXNet:
B = np.ones(shape=(4, 3))
np.dot(A, B)
PyTorch:
B = torch.ones(4, 3)
torch.mm(A, B)
TensorFlow:
B = tf.ones((4, 3), tf.float32)
tf.matmul(A, B)
PaddlePaddle:
B = paddle.ones(shape=[4, 3], dtype='float32')
paddle.mm(A, B)
Матрично-матричное умножение можно называть просто умножением матриц; не путайте его с произведением Адамара.
2.3.10 Нормы
Одними из самых полезных операций линейной алгебры являются нормы (norm). Неформально норма вектора показывает, насколько «велик» этот вектор. Понятие «величины» (size) здесь не связано с размерностью: речь идёт о величине компонентов.
В линейной алгебре норма вектора — это функция , которая сопоставляет вектору скаляр. Для любого вектора норма должна обладать определёнными свойствами. Первое свойство: если умножить все элементы вектора на константу , его норма умножится на абсолютное значение этой константы:
Второе свойство — знакомое неравенство треугольника:
Третье свойство: норма неотрицательна:
Это разумно: в большинстве случаев наименьший «размер» чего бы то ни было равен 0. Последнее свойство требует, чтобы норма равнялась 0 тогда и только тогда, когда все компоненты вектора равны 0:
Норма напоминает метрику расстояния. Неотрицательность и неравенство треугольника, знакомые из школьной геометрии (например, из теоремы Пифагора), дают хорошее представление о том, что это такое. На самом деле евклидово расстояние является -нормой: если элементы -мерного вектора равны , то его -норма равна квадратному корню из суммы квадратов его элементов:
где в обозначении -нормы индекс , как правило, опускают: означает . В коде -норму вектора можно вычислить так.
MXNet:
u = np.array([3, -4])
np.linalg.norm(u)
PyTorch:
u = torch.tensor([3.0, -4.0])
torch.norm(u)
TensorFlow:
u = tf.constant([3.0, -4.0])
tf.norm(u)
PaddlePaddle:
u = paddle.to_tensor([3.0, -4.0])
paddle.norm(u)
В глубоком обучении чаще используют квадрат -нормы. Также часто встречается -норма, равная сумме абсолютных значений элементов вектора:
По сравнению с -нормой -норма менее чувствительна к выбросам. Для вычисления -нормы сочетают функцию модуля и поэлементное суммирование.
MXNet:
np.abs(u).sum()
PyTorch:
torch.abs(u).sum()
TensorFlow:
tf.reduce_sum(tf.abs(u))
PaddlePaddle:
paddle.abs(u).sum()
И -норма, и -норма являются частными случаями более общей -нормы:
Аналогично -норме вектора, матрица имеет норму Фробениуса (Frobenius norm) — квадратный корень из суммы квадратов её элементов:
Норма Фробениуса удовлетворяет всем свойствам норм для векторов: её можно рассматривать как -норму матрицы, развёрнутой в вектор. Вызов следующей функции вычисляет норму Фробениуса матрицы.
MXNet:
np.linalg.norm(np.ones((4, 9)))
PyTorch:
torch.norm(torch.ones((4, 9)))
TensorFlow:
tf.norm(tf.ones((4, 9)))
PaddlePaddle:
paddle.norm(paddle.ones(shape=[4, 9], dtype='float32'))
2.3.10.1 Нормы и цели
В глубоком обучении мы часто решаем задачи оптимизации: максимизировать вероятность, приписанную наблюдаемым данным; минимизировать расстояние между предсказаниями и истинными наблюдениями. Объекты (слова, товары или новостные статьи) представляют векторами так, чтобы расстояние между похожими объектами было мало, а между различными — велико. Цель — пожалуй, самая важная составляющая алгоритмов глубокого обучения (помимо данных) — обычно выражается через норму.
2.3.11 Дополнительные сведения о линейной алгебре
В этом разделе мы изложили линейную алгебру, которая нужна для чтения этой книги и понимания современного глубокого обучения. Однако линейная алгебра гораздо шире, и многие её разделы полезны для машинного обучения. Например, матрицы можно раскладывать на множители, и такие разложения помогают выявлять низкоразмерную структуру в реальных наборах данных. Целая подобласть машинного обучения занимается тем, что использует матричные разложения и их обобщения на тензоры высокого порядка, чтобы находить структуру в данных и решать задачи предсказания. Когда вы начнёте экспериментировать и применять работающие модели машинного обучения к реальным данным, вам захочется изучить больше математики. Поэтому на этом раздел заканчивается, а дальнейшие математические сведения будут появляться по ходу книги.
Если хотите узнать о линейной алгебре больше, можно обратиться к онлайн-приложению об операциях линейной алгебры или к другим хорошим ресурсам (Strang, 1993; Kolter, 2008; Petersen and Pedersen, 2008).
Резюме
- Скаляры, векторы, матрицы и тензоры — базовые математические объекты линейной алгебры.
- Векторы обобщают скаляры, а матрицы обобщают векторы.
- Скаляры, векторы, матрицы и тензоры имеют соответственно 0, 1, 2 и произвольное число осей.
- Тензор можно уменьшать по размерности с помощью
sumиmeanпо заданным осям. - Поэлементное умножение двух матриц называется их произведением Адамара. Оно отличается от матричного умножения.
- В глубоком обучении мы часто используем нормы: -норму, -норму и норму Фробениуса.
- Над скалярами, векторами, матрицами и тензорами можно выполнять разнообразные операции.
Упражнения
- Докажите, что транспонирование матрицы дважды даёт , то есть .
- Даны матрицы и . Докажите, что сумма их транспонированных равна транспонированной сумме, то есть .
- Для произвольной квадратной матрицы всегда ли матрица симметрична? Почему?
- В этом разделе определён тензор
Xформы . Что выведетlen(X)? - Для тензора
Xпроизвольной формы всегда лиlen(X)соответствует длине какой-либо осиX? Какой именно? - Выполните
A/A.sum(axis=1)и посмотрите, что произойдёт. Объясните, почему так происходит. - Рассмотрим тензор формы . Какую форму имеет результат суммирования по осям 0, 1 и 2?
- Передайте в функцию
linalg.normтензор с тремя или более осями и посмотрите на результат. Что эта функция вычисляет для тензора произвольной формы?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Kolter, Z. (2008). Linear Algebra Review and Reference. Available online.
- Petersen, K. B., Pedersen, M. S., et al. (2008). The matrix cookbook. Technical University of Denmark, 7(15), 510.
- Strang, G. (1993). Introduction to linear algebra (Vol. 3). Wellesley-Cambridge Press, Wellesley, MA.
2.4 Математический анализ
2500 лет назад древние греки нашли способ вычислять площадь многоугольника: они разбивали его на треугольники и складывали их площади. Чтобы найти площадь фигуры криволинейной формы (например, круга), древние греки вписывали в неё многоугольники. Как показано на рис. 2.4.1, чем больше равных сторон у вписанного многоугольника, тем он ближе к кругу. Этот процесс также называют методом исчерпывания (method of exhaustion).
Рис. 2.4.1. Вычисление площади круга методом исчерпывания
На самом деле метод исчерпывания — начало интегрального исчисления (integral calculus). Более 2000 лет спустя появилась другая ветвь математического анализа — дифференциальное исчисление (differential calculus). Важнейшее применение дифференциального исчисления — задачи оптимизации, то есть поиск наилучшего способа что-то сделать. Как обсуждалось в разделе 2.3.10.1, такие задачи повсеместны в глубоком обучении.
В глубоком обучении мы «обучаем» модели, постоянно их обновляя, чтобы по мере поступления всё большего количества данных модели становились лучше. Обычно «стать лучше» означает минимизацию функции потерь (loss function) — оценки того, насколько «плоха» модель. В конечном счёте нас интересует создание модели, которая хорошо работает на данных, которых она никогда не видела. Но «обучение» модели может лишь подогнать её под данные, которые мы реально видим. Поэтому задачу подгонки модели можно разбить на две ключевые части:
- оптимизация (optimization): подгонка модели под наблюдаемые данные;
- обобщение (generalization): математические принципы и практический опыт, которые помогают получать модели, работающие на данных, выходящих за пределы обучающего набора.
Чтобы помочь читателю лучше понять задачи и методы оптимизации в следующих главах, этот раздел содержит очень краткое введение, которое поможет быстро освоить дифференциальное исчисление, часто используемое в глубоком обучении.
2.4.1 Производные и дифференциалы
Начнём с вычисления производных — это ключевой шаг почти всех алгоритмов оптимизации в глубоком обучении. В глубоком обучении обычно выбирают функции потерь, дифференцируемые по параметрам модели. Проще говоря, для каждого параметра мы хотим знать, насколько быстро растут или убывают потери, если увеличить или уменьшить этот параметр на бесконечно малую величину.
Пусть есть функция , входные и выходные значения которой — скаляры. Если у существует производная, её определяет предел
Если существует, то функция называется дифференцируемой (differentiable) в точке . Если дифференцируема в каждой точке некоторого интервала, то она дифференцируема на этом интервале. Производную из формулы (2.4.1) можно интерпретировать как мгновенную (instantaneous) скорость изменения по . Такая мгновенная скорость изменения вычисляется по изменению аргумента при стремлении к .
Чтобы лучше понять производную, проведём эксперимент. Определим следующим образом:
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from matplotlib_inline import backend_inline
from mxnet import np, npx
npx.set_np()
def f(x):
return 3 * x ** 2 - 4 * x
PyTorch:
%matplotlib inline
from d2l import torch as d2l
from matplotlib_inline import backend_inline
import numpy as np
def f(x):
return 3 * x ** 2 - 4 * x
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
from matplotlib_inline import backend_inline
import numpy as np
def f(x):
return 3 * x ** 2 - 4 * x
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
from matplotlib_inline import backend_inline
import numpy as np
def f(x):
return 3 * x ** 2 - 4 * x
Положив и устремив к , получим, что численное значение в формуле (2.4.1) приближается к . Хотя этот эксперимент не является математическим доказательством, позже мы увидим, что при производная действительно равна .
def numerical_lim(f, x, h):
return (f(x + h) - f(x)) / h
h = 0.1
for i in range(5):
print(f'h={h:.5f}, численный предел={numerical_lim(f, 1, h):.5f}')
h *= 0.1
Познакомимся с несколькими эквивалентными обозначениями производной. Для , где и — независимая и зависимая переменные функции , следующие выражения эквивалентны:
где символы и — операторы дифференцирования, которые обозначают операцию дифференцирования. Для дифференцирования распространённых функций можно пользоваться следующими правилами:
- ( — константа)
- (степенное правило (power rule), — любое действительное число)
Чтобы продифференцировать функцию, составленную из простых функций, полезны следующие правила. Пусть функции и дифференцируемы, а — константа. Тогда:
Правило константного множителя
Правило суммы
Правило произведения
Правило частного
Теперь применим эти правила, чтобы вычислить . При получаем : численный результат в эксперименте выше действительно близок к . При эта производная также равна угловому коэффициенту касательной к кривой .
Чтобы наглядно изобразить эту интерпретацию производной, будем использовать matplotlib — популярную библиотеку построения графиков на Python.
Чтобы настроить свойства графиков, создаваемых matplotlib, нужно определить несколько вспомогательных функций.
Функция use_svg_display указывает пакету matplotlib выводить графики в формате svg для более чёткого изображения.
Обратите внимание: комментарий #@save — специальная отметка, которая сохраняет соответствующую функцию, класс или оператор в пакете d2l.
Поэтому их можно вызывать напрямую (например, d2l.use_svg_display()), не определяя заново.
def use_svg_display(): #@save
"""Показывает графики в формате svg в Jupyter"""
backend_inline.set_matplotlib_formats('svg')
Функция set_figsize задаёт размер графиков.
Здесь можно напрямую использовать d2l.plt, поскольку импорт from matplotlib import pyplot as plt помечен для сохранения в пакете d2l.
def set_figsize(figsize=(3.5, 2.5)): #@save
"""Задаёт размер графика matplotlib"""
use_svg_display()
d2l.plt.rcParams['figure.figsize'] = figsize
Функция set_axes задаёт свойства осей графика, построенного с помощью matplotlib.
#@save
def set_axes(axes, xlabel, ylabel, xlim, ylim, xscale, yscale, legend):
"""Задаёт оси графика matplotlib"""
axes.set_xlabel(xlabel)
axes.set_ylabel(ylabel)
axes.set_xscale(xscale)
axes.set_yscale(yscale)
axes.set_xlim(xlim)
axes.set_ylim(ylim)
if legend:
axes.legend(legend)
axes.grid()
Имея эти три функции для настройки графика, определим функцию plot, которая позволяет кратко строить несколько кривых: в книге нам часто придётся визуализировать множество кривых.
#@save
def plot(X, Y=None, xlabel=None, ylabel=None, legend=None, xlim=None,
ylim=None, xscale='linear', yscale='linear',
fmts=('-', 'm--', 'g-.', 'r:'), figsize=(3.5, 2.5), axes=None):
"""Строит точки данных"""
if legend is None:
legend = []
set_figsize(figsize)
axes = axes if axes else d2l.plt.gca()
# Если у X одна ось, возвращаем True
def has_one_axis(X):
return (hasattr(X, "ndim") and X.ndim == 1 or isinstance(X, list)
and not hasattr(X[0], "__len__"))
if has_one_axis(X):
X = [X]
if Y is None:
X, Y = [[]] * len(X), X
elif has_one_axis(Y):
Y = [Y]
if len(X) != len(Y):
X = X * len(Y)
axes.cla()
for x, y, fmt in zip(X, Y, fmts):
if len(x):
axes.plot(x, y, fmt)
else:
axes.plot(y, fmt)
set_axes(axes, xlabel, ylabel, xlim, ylim, xscale, yscale, legend)
Теперь можем построить график функции и её касательной в точке , где коэффициент — угловой коэффициент касательной.
x = np.arange(0, 3, 0.1)
plot(x, [f(x), 2 * x - 3], 'x', 'f(x)', legend=['f(x)', 'Касательная (x=1)'])
2.4.2 Частные производные
До сих пор мы рассматривали дифференцирование только функций одной переменной. В глубоком обучении функции обычно зависят от многих переменных. Поэтому нужно обобщить идею дифференцирования на функции многих переменных (multivariate function).
Пусть — функция от переменных. Частная производная (partial derivative) по -му аргументу равна:
Чтобы вычислить , можно считать константами и найти производную по . Для обозначения частных производных следующие записи эквивалентны:
2.4.3 Градиенты
Частные производные многомерной функции по всем её переменным можно собрать в вектор — градиент (gradient) функции. Точнее, пусть функция принимает -мерный вектор и возвращает скаляр. Градиент функции по — это вектор из частных производных:
где при отсутствии неоднозначности часто записывают как .
Пусть — -мерный вектор. При дифференцировании многомерных функций часто используются следующие правила:
- для всех справедливо ;
- для всех справедливо ;
- для всех справедливо ;
- .
Аналогично, для любой матрицы справедливо . Как мы увидим дальше, градиенты играют важную роль при построении алгоритмов оптимизации в глубоком обучении.
2.4.4 Цепное правило
Однако с помощью описанных выше правил вычислять градиенты может быть трудно. Дело в том, что в глубоком обучении многомерные функции обычно составные (composite), поэтому применить перечисленные выше правила к их дифференцированию трудно. К счастью, для дифференцирования составных функций можно использовать цепное правило (chain rule).
Начнём с функций одной переменной. Пусть функции и дифференцируемы. Тогда по цепному правилу:
Теперь рассмотрим более общий случай, когда функция зависит от произвольного числа переменных. Пусть дифференцируемая функция имеет аргументы , причём каждая дифференцируемая функция имеет аргументы . Заметим, что — функция от . Для любого цепное правило даёт:
Резюме
- Дифференцирование и интегрирование — две ветви математического анализа; первое применимо к задачам оптимизации в глубоком обучении.
- Производную можно интерпретировать как мгновенную скорость изменения функции по её переменной; она также равна угловому коэффициенту касательной к графику функции.
- Градиент — это вектор, компонентами которого служат частные производные многомерной функции по всем её переменным.
- Цепное правило позволяет дифференцировать составные функции.
Упражнения
- Постройте график функции и её касательной в точке .
- Найдите градиент функции .
- Чему равен градиент функции ?
- Запишите цепное правило для функции , где , , .
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
2.5 Автоматическое дифференцирование
Как говорилось в разделе 2.4, вычисление производных — ключевой шаг почти всех алгоритмов оптимизации в глубоком обучении. Сами по себе вычисления производных просты и требуют лишь базового математического анализа. Но для сложных моделей ручное обновление параметров — очень трудоёмкая работа, и к тому же легко допустить ошибку.
Фреймворки глубокого обучения ускоряют вычисление производных, вычисляя их автоматически, то есть используя автоматическое дифференцирование (automatic differentiation). На практике по заданной модели система строит вычислительный граф (computational graph), в котором отслеживается, какие данные и какие операции комбинируются для получения результата. Автоматическое дифференцирование позволяет системе затем распространять градиенты назад (backpropagate). Здесь обратное распространение (backpropagation) означает обход всего вычислительного графа с заполнением частных производных по каждому параметру.
2.5.1 Простой пример
В качестве демонстрации предположим, что мы хотим продифференцировать функцию по вектору-столбцу .
Сначала создадим переменную x и присвоим ей начальное значение.
MXNet:
from mxnet import autograd, np, npx
npx.set_np()
x = np.arange(4.0)
x
PyTorch:
import torch
x = torch.arange(4.0)
x
TensorFlow:
import tensorflow as tf
x = tf.range(4, dtype=tf.float32)
x
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
x = paddle.arange(4, dtype='float32')
x
Прежде чем вычислять градиент по , нужно место, где он будет храниться. Важно, что мы не будем выделять новую память при каждом дифференцировании по параметру. Поскольку мы часто обновляем одни и те же параметры тысячи раз, выделение новой памяти каждый раз может быстро исчерпать ресурсы. Заметим, что градиент скалярной функции по вектору — это вектор той же формы, что и .
MXNet:
# Выделяем память под градиент тензора вызовом attach_grad
x.attach_grad()
# После вычисления градиента по x он доступен через атрибут 'grad'; изначально его значение равно 0
x.grad
PyTorch:
x.requires_grad_(True) # Эквивалентно x=torch.arange(4.0,requires_grad=True)
x.grad # Значение по умолчанию — None
TensorFlow:
x = tf.Variable(x)
PaddlePaddle:
x = paddle.to_tensor(x, stop_gradient=False)
x.grad # Значение по умолчанию — None
Теперь вычислим .
MXNet:
# Помещаем код внутрь autograd.record, чтобы построить вычислительный граф
with autograd.record():
y = 2 * np.dot(x, x)
y
PyTorch:
y = 2 * torch.dot(x, x)
y
TensorFlow:
# Записываем все вычисления на ленту
with tf.GradientTape() as t:
y = 2 * tf.tensordot(x, x, axes=1)
y
PaddlePaddle:
y = 2 * paddle.dot(x, x)
y
x — вектор длины 4; вычисляя скалярное произведение x и x, мы получаем скаляр, присвоенный y.
Далее вызовем функцию обратного распространения, чтобы автоматически вычислить градиент y по каждой компоненте x и выведем эти градиенты.
MXNet:
y.backward()
x.grad
PyTorch:
y.backward()
x.grad
TensorFlow:
x_grad = t.gradient(y, x)
x_grad
PaddlePaddle:
y.backward()
x.grad
Градиент функции по должен быть равен . Быстро проверим, что градиент вычислен верно.
MXNet, PyTorch, PaddlePaddle:
x.grad == 4 * x
TensorFlow:
x_grad == 4 * x
Теперь вычислим другую функцию от x.
MXNet:
with autograd.record():
y = x.sum()
y.backward()
x.grad # Перезаписывается новым вычисленным градиентом
PyTorch:
# По умолчанию PyTorch накапливает градиенты, поэтому предыдущие значения нужно обнулить
x.grad.zero_()
y = x.sum()
y.backward()
x.grad
TensorFlow:
with tf.GradientTape() as t:
y = tf.reduce_sum(x)
t.gradient(y, x) # Перезаписывается новым вычисленным градиентом
PaddlePaddle:
# По умолчанию PaddlePaddle накапливает градиенты, поэтому предыдущие значения нужно очистить
x.clear_gradient()
y = paddle.sum(x)
y.backward()
x.grad
2.5.2 Обратное распространение для нескалярных переменных
Когда y не является скаляром, наиболее естественной интерпретацией производной вектора y по вектору x будет матрица.
Для тензоров высокого порядка и размерности результатом дифференцирования может быть тензор высокого порядка.
Хотя такие более сложные объекты действительно встречаются в продвинутом машинном обучении (в том числе в глубоком обучении), при вызове обратного распространения для вектора обычно вычисляют производные функции потерь для каждого компонента батча обучающих примеров. Здесь наша цель — не вычислить матрицу производных, а вычислить сумму частных производных для каждого примера в батче по отдельности.
MXNet:
# При вызове backward для векторной переменной y (функции от x) элементы y суммируются,
# образуя новую скалярную переменную. Затем вычисляется градиент этой скалярной переменной по x
with autograd.record():
y = x * x # y — вектор
y.backward()
x.grad # Эквивалентно y=sum(x*x)
PyTorch:
# Для вызова backward у нескаляра нужно передать аргумент gradient, задающий градиент
# дифференцируемой функции по self. В этом примере нам нужна только сумма частных производных,
# поэтому подходит градиент, равный 1
x.grad.zero_()
y = x * x
# Эквивалентно y.backward(torch.ones(len(x)))
y.sum().backward()
x.grad
TensorFlow:
with tf.GradientTape() as t:
y = x * x
t.gradient(y, x) # Эквивалентно y=tf.reduce_sum(x*x)
PaddlePaddle:
x.clear_gradient()
y = x * x
paddle.sum(y).backward()
x.grad
2.5.3 Отделение вычислений
Иногда мы хотим вынести некоторые вычисления за пределы записанного вычислительного графа.
Например, пусть y вычисляется как функция x, а z — как функция y и x.
Предположим, мы хотим вычислить градиент z по x, но по какой-то причине хотим рассматривать y как константу и учитывать только то, как x действует после вычисления y.
Здесь можно отделить y, вернув новую переменную u, которая имеет то же значение, что и y, но отбрасывает информацию о том, как y была вычислена в графе.
Иными словами, градиент не будет распространяться назад через u к x.
Поэтому следующая функция обратного распространения вычисляет частную производную z=u*x по x, рассматривая u как константу, а не частную производную z=x*x*x по x.
MXNet:
with autograd.record():
y = x * x
u = y.detach()
z = u * x
z.backward()
x.grad == u
PyTorch:
x.grad.zero_()
y = x * x
u = y.detach()
z = u * x
z.sum().backward()
x.grad == u
TensorFlow:
# Установите persistent=True, чтобы вызывать t.gradient несколько раз
with tf.GradientTape(persistent=True) as t:
y = x * x
u = tf.stop_gradient(y)
z = u * x
x_grad = t.gradient(z, x)
x_grad == u
PaddlePaddle:
x.clear_gradient()
y = x * x
u = y.detach()
z = u * x
paddle.sum(z).backward()
x.grad == u
Поскольку вычисление y записано, мы можем затем вызвать обратное распространение для y и получить производную y=x*x по x, то есть 2*x.
MXNet:
y.backward()
x.grad == 2 * x
PyTorch:
x.grad.zero_()
y.sum().backward()
x.grad == 2 * x
TensorFlow:
t.gradient(y, x) == 2 * x
PaddlePaddle:
x.clear_gradient()
paddle.sum(y).backward()
x.grad == 2 * x
2.5.4 Вычисление градиентов для потока управления Python
Одно из преимуществ автоматического дифференцирования в том, что
даже если вычислительный граф функции строится через управляющие конструкции Python (условия, циклы или произвольные вызовы функций), мы всё равно можем вычислить градиент получившейся переменной.
В приведённом ниже коде число итераций цикла while и результат оператора if зависят от значения входа a.
MXNet:
def f(a):
b = a * 2
while np.linalg.norm(b) < 1000:
b = b * 2
if b.sum() > 0:
c = b
else:
c = 100 * b
return c
PyTorch:
def f(a):
b = a * 2
while b.norm() < 1000:
b = b * 2
if b.sum() > 0:
c = b
else:
c = 100 * b
return c
TensorFlow:
def f(a):
b = a * 2
while tf.norm(b) < 1000:
b = b * 2
if tf.reduce_sum(b) > 0:
c = b
else:
c = 100 * b
return c
PaddlePaddle:
def f(a):
b = a * 2
while paddle.norm(b) < 1000:
b = b * 2
if paddle.sum(b) > 0:
c = b
else:
c = 100 * b
return c
Вычислим градиент.
MXNet:
a = np.random.normal()
a.attach_grad()
with autograd.record():
d = f(a)
d.backward()
PyTorch:
a = torch.randn(size=(), requires_grad=True)
d = f(a)
d.backward()
TensorFlow:
a = tf.Variable(tf.random.normal(shape=()))
with tf.GradientTape() as t:
d = f(a)
d_grad = t.gradient(d, a)
d_grad
PaddlePaddle:
a = paddle.to_tensor(paddle.randn(shape=[1]), stop_gradient=False)
d = f(a)
d.backward()
Теперь проанализируем определённую выше функцию f.
Заметим, что по входу a она кусочно-линейна.
Иными словами, для любого a найдётся некоторая константа k, такая что f(a)=k*a, причём значение k зависит от входа a. Поэтому правильность градиента можно проверить, сравнив его с d/a.
MXNet, PyTorch, PaddlePaddle:
a.grad == d / a
TensorFlow:
d_grad == d / a
Резюме
- Фреймворки глубокого обучения могут вычислять производные автоматически: сначала мы присоединяем градиент к переменной, по которой хотим вычислять частные производные, затем записываем вычисление целевого значения, выполняем его обратное распространение и получаем градиент.
Упражнения
- Почему вычисление производной второго порядка обходится дороже, чем производной первого порядка?
- Запустите функцию обратного распространения сразу повторно после её выполнения и посмотрите, что произойдёт.
- В примере с потоком управления мы вычисляем производную
dпоa. Что произойдёт, если изменить переменнуюaна случайный вектор или матрицу? - Придумайте другой пример для вычисления градиента с потоком управления, запустите его и проанализируйте результат.
- Пусть . Постройте графики и , причём производную вычислите без использования равенства .
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
2.6 Вероятность
Попросту говоря, машинное обучение — это предсказание.
Например, по клинической истории пациента мы можем захотеть предсказать вероятность того, что у него случится сердечный приступ в следующем году. При обнаружении аномалий в работе реактивного двигателя самолёта мы хотим оценить, насколько вероятно, что набор показаний двигателя соответствует нормальной работе. В обучении с подкреплением мы хотим, чтобы агент (agent) разумно действовал в среде. Это означает, что нужно учитывать вероятность получить высокую награду при каждом из возможных действий. При построении рекомендательных систем тоже нужно учитывать вероятности. Например, если мы работаем в большом интернет-магазине книг, нам может понадобиться оценить вероятность того, что определённый пользователь купит определённую книгу. Для этого нам нужна теория вероятностей. Существуют целые курсы, специализации, научные статьи, профессии и даже факультеты, посвящённые теории вероятностей. Поэтому цель этого раздела — не изучить всю дисциплину целиком. Скорее, мы хотим дать читателю базовые сведения о вероятности, чтобы он мог начать строить первые модели глубокого обучения и самостоятельно их исследовать.
Теперь рассмотрим более внимательно первый пример: различение кошек и собак по фотографиям. На первый взгляд это может казаться простой задачей, но для машины она может оказаться серьёзным испытанием. Прежде всего, сложность задачи может зависеть от разрешения изображения.
Рис. 2.6.1. Изображения разного разрешения (, , , и пикселей)
Как видно на рис. 2.6.1, хотя человек легко распознаёт кошек и собак при разрешении пикселей, при пикселях это становится трудной задачей, а при пикселях почти невозможно. Иначе говоря, наша способность различать кошек и собак на большом расстоянии (а значит, при меньшем разрешении) может превратиться в простое угадывание. Теория вероятностей даёт нам формальный способ выразить степень нашей уверенности. Если мы полностью уверены, что на изображении кошка, то вероятность того, что метка — «кошка», то есть , равна . Если у нас нет никаких доказательств того, что или , то можно считать эти два варианта равновероятными: . Если мы не очень уверены, что на изображении кошка, можно приписать вероятности значение .
Теперь второй пример: по данным метеонаблюдений мы хотим предсказать вероятность того, что завтра в Пекине будет дождь. Если сейчас лето, вероятность дождя равна 0,5.
В обоих случаях результат нам неизвестен, но между ними есть ключевое различие. В первом случае изображение на самом деле либо кошка, либо собака. Во втором результат действительно является случайным событием. Таким образом, вероятность — гибкий язык для выражения степени нашей уверенности, и его можно эффективно применять в самых разных областях.
2.6.1 Основы теории вероятностей
Допустим, мы бросаем кубик и хотим узнать, какова вероятность выпадения единицы, а не какого-либо другого числа. Если кубик честный, то все шесть исходов равновозможны, и поэтому можно сказать, что вероятность выпадения равна .
Однако для реального кубика, полученного с завода, нужно проверить, нет ли в нём дефекта. Единственный способ сделать это — бросить его много раз и записать результаты. Каждый бросок даёт одно значение из . Для каждого значения естественный способ — разделить число его появлений на общее число бросков. Так мы получаем оценку вероятности этого события (event). Закон больших чисел (law of large numbers) утверждает: по мере увеличения числа бросков эта оценка будет всё ближе к истинной вероятности. Попробуем это на коде!
Сначала импортируем необходимые пакеты.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import np, npx
import random
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
from torch.distributions import multinomial
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
import tensorflow_probability as tfp
import numpy as np
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import random
import numpy as np
В статистике процесс извлечения выборки из распределения вероятностей называют выборкой (sampling). Грубо говоря, распределение (distribution) можно считать присвоением вероятностей событиям; более строгое определение мы дадим позже. Распределение, которое присваивает вероятности некоторому набору дискретных вариантов, называют мультиномиальным распределением (multinomial distribution).
Чтобы извлечь выборку, то есть бросить кубик, достаточно передать вектор вероятностей. Результат — другой вектор той же длины: его значение с индексом — это число раз, когда в выборке выпал исход .
MXNet:
fair_probs = [1.0 / 6] * 6
np.random.multinomial(1, fair_probs)
PyTorch:
fair_probs = torch.ones([6]) / 6
multinomial.Multinomial(1, fair_probs).sample()
TensorFlow:
fair_probs = tf.ones(6) / 6
tfp.distributions.Multinomial(1, fair_probs).sample()
PaddlePaddle:
fair_probs = [1.0 / 6] * 6
paddle.distribution.Multinomial(1, paddle.to_tensor(fair_probs)).sample()
Когда мы оцениваем честность кубика, нужно сгенерировать много выборок из одного и того же распределения.
Если делать это циклом for на Python, работа будет невероятно медленной.
Поэтому мы используем функции фреймворка глубокого обучения, которые извлекают сразу несколько выборок и возвращают независимые выборки нужной формы.
MXNet:
np.random.multinomial(10, fair_probs)
PyTorch:
multinomial.Multinomial(10, fair_probs).sample()
TensorFlow:
tfp.distributions.Multinomial(10, fair_probs).sample()
PaddlePaddle:
paddle.distribution.Multinomial(10, paddle.to_tensor(fair_probs)).sample()
Теперь, когда мы умеем извлекать выборки для кубика, можно смоделировать 1000 бросков. Затем подсчитаем, сколько раз выпала каждая грань. Конкретно: вычислим относительные частоты, которые и будут оценками истинных вероятностей.
MXNet:
counts = np.random.multinomial(1000, fair_probs).astype(np.float32)
counts / 1000
PyTorch:
# Сохраняем результаты как 32-битные числа с плавающей точкой для деления
counts = multinomial.Multinomial(1000, fair_probs).sample()
counts / 1000 # Относительная частота как оценка
TensorFlow:
counts = tfp.distributions.Multinomial(1000, fair_probs).sample()
counts / 1000
PaddlePaddle:
counts = paddle.distribution.Multinomial(1000, paddle.to_tensor(fair_probs)).sample()
counts / 1000
Поскольку данные получены с честного кубика, мы знаем, что истинная вероятность каждого исхода равна , примерно , поэтому оценки, полученные выше, выглядят разумно.
Мы также можем увидеть, как эти вероятности со временем сходятся к истинным. Проведём 500 групп экспериментов, в каждой из которых возьмём по 10 выборок.
MXNet:
counts = np.random.multinomial(10, fair_probs, size=500)
cum_counts = counts.astype(np.float32).cumsum(axis=0)
estimates = cum_counts / cum_counts.sum(axis=1, keepdims=True)
d2l.set_figsize((6, 4.5))
for i in range(6):
d2l.plt.plot(estimates[:, i].asnumpy(),
label=("P(кубик=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Группы экспериментов')
d2l.plt.gca().set_ylabel('Оценка вероятности')
d2l.plt.legend();
PyTorch:
counts = multinomial.Multinomial(10, fair_probs).sample((500,))
cum_counts = counts.cumsum(dim=0)
estimates = cum_counts / cum_counts.sum(dim=1, keepdims=True)
d2l.set_figsize((6, 4.5))
for i in range(6):
d2l.plt.plot(estimates[:, i].numpy(),
label=("P(кубик=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Группы экспериментов')
d2l.plt.gca().set_ylabel('Оценка вероятности')
d2l.plt.legend();
TensorFlow:
counts = tfp.distributions.Multinomial(10, fair_probs).sample(500)
cum_counts = tf.cumsum(counts, axis=0)
estimates = cum_counts / tf.reduce_sum(cum_counts, axis=1, keepdims=True)
d2l.set_figsize((6, 4.5))
for i in range(6):
d2l.plt.plot(estimates[:, i].numpy(),
label=("P(кубик=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Группы экспериментов')
d2l.plt.gca().set_ylabel('Оценка вероятности')
d2l.plt.legend();
PaddlePaddle:
counts = paddle.distribution.Multinomial(10, paddle.to_tensor(fair_probs)).sample((500,1))
cum_counts = counts.cumsum(axis=0)
cum_counts = cum_counts.squeeze(axis=1)
estimates = cum_counts / cum_counts.sum(axis=1, keepdim=True)
d2l.set_figsize((6, 4.5))
for i in range(6):
d2l.plt.plot(estimates[:, i],
label=("P(кубик=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Группы экспериментов')
d2l.plt.gca().set_ylabel('Оценка вероятности')
d2l.plt.legend()
Каждая сплошная линия соответствует одной из шести граней кубика и показывает оценку вероятности выпадения этой грани после каждой группы экспериментов. По мере того как мы получаем больше данных, эти 6 кривых сходятся к истинным вероятностям.
2.6.1.1 Аксиомы теории вероятностей
В случае с бросанием кубика множество называют пространством выборки (sample space) или пространством исходов (outcome space), а каждый его элемент — исходом (outcome). Событие (event) — это набор исходов из пространства выборки. Например, «выпала » () и «выпало нечётное число» () — допустимые события при бросании кубика. Заметим, что если исход случайного эксперимента принадлежит , то событие произошло. То есть если выпала , то, поскольку , можно сказать, что событие «выпало нечётное число» произошло.
Вероятность (probability) можно рассматривать как функцию, которая сопоставляет множествам действительные значения. В заданном пространстве выборки вероятность события , обозначаемая , обладает следующими свойствами:
- для любого события его вероятность никогда не бывает отрицательной: ;
- вероятность всего пространства выборки равна : ;
- для любой счётной последовательности несовместных (mutually exclusive) событий , то есть таких, что для всех , вероятность того, что произойдёт одно из них, равна сумме их вероятностей: .
Перечисленные свойства — аксиомы теории вероятностей, которые предложил Колмогоров в 1933 году. С помощью этой системы аксиом можно обойти философские споры о случайности и вместо этого строго рассуждать на языке математики. Например, пусть событие — всё пространство выборки, а для всех выполнено . Тогда можно доказать, что , то есть вероятность невозможного события равна .
2.6.1.2 Случайные величины
В нашем эксперименте с бросанием кубика мы ввели понятие случайной величины (random variable). Случайная величина может быть почти любой величиной, и она принимает одно из значений, возможных в случайном эксперименте. Рассмотрим случайную величину , значения которой принадлежат пространству выборки кубика . Событие «выпала » можно записать как или , а его вероятность — как или . Записью мы отличаем случайную величину от значений , которые она может принимать. Однако такая запись может быть громоздкой. Чтобы упростить обозначения, с одной стороны, можно записывать как распределение (distribution) случайной величины : оно сообщает, с какой вероятностью принимает то или иное значение. С другой стороны, можно просто писать для вероятности того, что случайная величина принимает значение . Поскольку события в теории вероятностей — это наборы исходов из пространства выборки, можно задавать диапазоны значений случайной величины. Например, обозначает событие , то есть вероятность того, что принимает значение , или . Эквивалентно, — это вероятность того, что случайная величина принимает значения из .
Обратите внимание на различие между дискретными (discrete) случайными величинами (например, гранями кубика) и непрерывными (continuous) случайными величинами (например, весом и ростом человека). В реальной жизни не имеет особого смысла измерять, совпадает ли рост двух людей в точности. Если производить измерения достаточно точно, окажется, что на Земле нет двух людей с одинаковым ростом. В таких случаях осмысленнее спрашивать, попадает ли рост человека в заданный интервал, например между 1,79 м и 1,81 м. В подобных ситуациях возможность получить то или иное значение выражают через плотность (density). Вероятность того, что рост в точности равен 1,80 м, равна 0, но плотность не равна 0. На любом интервале между двумя разными ростами вероятность ненулевая. В оставшейся части раздела мы будем рассматривать вероятности в дискретном пространстве. Вероятности непрерывных случайных величин можно найти в разделе о случайных величинах математического приложения к книге.
2.6.2 Работа с несколькими случайными величинами
Во многих случаях нам приходится рассматривать несколько случайных величин. Например, нам может понадобиться смоделировать связь между болезнями и симптомами. Для заданной болезни и симптома, например «грипп» и «кашель», у пациента каждое из них с некоторой вероятностью присутствует или отсутствует. Нам нужно оценить эти вероятности и связи между ними, чтобы использовать выводы для улучшения медицинской помощи.
Ещё более сложный пример: изображение содержит миллионы пикселей, а значит, миллионы случайных величин. Во многих случаях к изображению прилагается метка (label), указывающая объект на изображении; метку тоже можно рассматривать как случайную величину. Можно даже считать случайными величинами все метаданные: положение, время, диафрагму, фокусное расстояние, ISO, расстояние фокусировки и тип камеры. Все эти величины случайны и встречаются совместно. Когда мы работаем с несколькими случайными величинами, нас интересует сразу несколько из них.
2.6.2.1 Совместная вероятность
Первое понятие — совместная вероятность (joint probability) . Для любых значений и совместная вероятность отвечает на вопрос: какова вероятность того, что одновременно выполняются и ? Заметим, что для любых значений и выполняется . Это очевидно: чтобы одновременно произошли и , должно произойти , и должно произойти (и наоборот). Поэтому вероятность одновременного наступления и не превышает вероятности наступления каждого из этих событий по отдельности.
2.6.2.2 Условная вероятность
Из неравенства для совместной вероятности следует интересное соотношение: . Это отношение называют условной вероятностью (conditional probability) и обозначают : это вероятность того, что , при условии, что уже произошло.
2.6.2.3 Теорема Байеса
Из определения условной вероятности можно вывести одно из самых полезных уравнений статистики — теорему Байеса (Bayes’ theorem). По правилу умножения (multiplication rule) имеем . По симметрии получаем . Предполагая, что , и выражая одну из условных вероятностей, получаем
Здесь мы используем компактную запись: — совместное распределение (joint distribution), а — условное распределение (conditional distribution). Такое распределение можно вычислить при заданных значениях .
2.6.2.4 Маргинализация
Чтобы складывать вероятности событий, нужно правило суммы (sum rule): вероятность равна сумме совместных вероятностей со всеми возможными значениями :
Это называется маргинализацией (marginalization). Вероятность или распределение, полученное в результате маргинализации, называют маргинальной вероятностью (marginal probability) или маргинальным распределением (marginal distribution).
2.6.2.5 Независимость
Другое полезное свойство — зависимость (dependence) и независимость (independence). Если две случайные величины и независимы, то наступление события не зависит от наступления события . В этом случае статистики обычно записывают . По теореме Байеса сразу получаем и . Во всех остальных случаях мы называем и зависимыми. Например, два последовательных броска кубика — независимые события. В отличие от них, положение выключателя и яркость комнаты не независимы (потому что возможны перегорание лампочки, перебой электропитания или поломка выключателя).
Поскольку равносильно , две случайные величины независимы тогда и только тогда, когда их совместное распределение равно произведению их отдельных распределений. Аналогично, при заданной третьей случайной величине две величины и условно независимы (conditionally independent) тогда и только тогда, когда . Это записывают как .
2.6.2.6 Применение
Разберём пример! Предположим, врач проводит пациенту тест на ВИЧ (вирус иммунодефицита человека). Тест довольно точен: если пациент здоров, вероятность ложного положительного результата составляет всего 1%; если пациент действительно инфицирован ВИЧ, тест никогда не даёт отрицательного результата. Обозначим через результат диагностики ( — положительный, — отрицательный), а через — статус ВИЧ-инфекции ( — инфицирован, — нет). Условные вероятности приведены в таблице 2.6.1.
Таблица 2.6.1. Условная вероятность
| Условная вероятность | ||
|---|---|---|
| 1 | 0.01 | |
| 0 | 0.99 |
Заметим, что сумма по каждому столбцу равна 1 (а по строкам — нет), поскольку условные вероятности, как и вероятности, должны в сумме давать 1. Вычислим вероятность того, что пациент инфицирован ВИЧ, если тест положителен, то есть . Очевидно, что ответ зависит от того, насколько распространено заболевание, поскольку это влияет на число ложных срабатываний. Предположим, что население в целом здорово, например . Чтобы применить теорему Байеса, нужно с помощью маргинализации и правила умножения найти
Значит,
Иными словами, несмотря на очень точный тест, вероятность того, что пациент действительно инфицирован ВИЧ, составляет лишь 13,06%. Как видим, вероятности могут противоречить интуиции.
Что делать пациенту после такого тревожного известия? Скорее всего, он попросит врача провести повторный тест, чтобы уточнить диагноз. Второй тест обладает другими характеристиками: он не так точен, как первый, как показано в таблице 2.6.2.
Таблица 2.6.2. Условная вероятность
| Условная вероятность | ||
|---|---|---|
| 0.98 | 0.03 | |
| 0.02 | 0.97 |
К сожалению, второй тест тоже даёт положительный результат. Вычислим необходимые вероятности для применения теоремы Байеса, предполагая условную независимость:
Теперь можно применить маргинализацию и правило умножения:
Наконец, при двух положительных тестах вероятность того, что пациент инфицирован, равна
Таким образом, второй тест позволяет с большей уверенностью судить о наличии заболевания. Хотя второй тест гораздо менее точен, чем первый, он всё же заметно повышает наш прогноз вероятности.
2.6.3 Математическое ожидание и дисперсия
Чтобы охарактеризовать основные свойства распределения вероятностей, нужны количественные меры. Математическое ожидание (expectation, или среднее значение (average)) случайной величины записывается как
Если аргумент функции — случайная величина, взятая из распределения , то математическое ожидание равно
Во многих случаях нам хочется измерить, насколько случайная величина отклоняется от своего математического ожидания. Это можно выразить через дисперсию (variance):
Квадратный корень из дисперсии называют стандартным отклонением (standard deviation). Дисперсия функции случайной величины показывает, насколько значения функции отклоняются от её математического ожидания при выборке различных значений из распределения случайной величины:
Резюме
- Из распределения вероятностей можно извлекать выборки.
- Для анализа нескольких случайных величин можно использовать совместные распределения, условные распределения, теорему Байеса, маргинализацию и предположения о независимости.
- Математическое ожидание и дисперсия — практичные меры, с помощью которых можно обобщённо описать ключевые характеристики распределений вероятностей.
Упражнения
- Проведите групп экспериментов, в каждой из которых берётся выборок. Меняйте и , наблюдайте и анализируйте результаты экспериментов.
- Даны два события с вероятностями и . Вычислите верхнюю и нижнюю границы для и . (Подсказка: используйте диаграмму Венна, чтобы показать эти случаи.)
- Предположим, что у нас есть последовательность случайных величин, например , и , где зависит только от , а зависит только от . Можно ли упростить совместную вероятность ? (Подсказка: это цепь Маркова.)
- В разделе 2.6.2.6 первый тест точнее. Почему бы не провести первый тест дважды вместо того, чтобы проводить первый и второй тесты?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
2.7 Работа с документацией
MXNet: Из-за ограниченного объёма книга не может описать каждую функцию и класс MXNet. Документация API, другие учебные материалы и примеры содержат множество сведений, выходящих за рамки этой книги. В этом разделе приведены некоторые рекомендации по работе с API MXNet.
PyTorch: Из-за ограниченного объёма книга не может описать каждую функцию и класс PyTorch. Документация API, другие учебные материалы и примеры содержат множество сведений, выходящих за рамки этой книги. В этом разделе приведены некоторые рекомендации по работе с API PyTorch.
TensorFlow: Из-за ограниченного объёма книга не может описать каждую функцию и класс TensorFlow. Документация API, другие учебные материалы и примеры содержат множество сведений, выходящих за рамки этой книги. В этом разделе приведены некоторые рекомендации по работе с API TensorFlow.
2.7.1 Поиск всех функций и классов модуля
Чтобы узнать, какие функции и классы можно вызывать в модуле, используют функцию dir.
Например, мы можем получить список всех атрибутов модуля генерации случайных чисел:
MXNet:
from mxnet import np
print(dir(np.random))
PyTorch:
import torch
print(dir(torch.distributions))
TensorFlow:
import tensorflow as tf
print(dir(tf.random))
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
print(dir(paddle.distribution))
Обычно можно не обращать внимания на функции, имена которых начинаются и заканчиваются на «__» (двойное подчёркивание): это специальные объекты Python.
Также можно пропустить функции, имена которых начинаются с одиночного «_»: обычно это внутренние функции.
По оставшимся именам функций и атрибутов можно предположить, что этот модуль предоставляет различные методы генерации случайных чисел, в том числе выборку из равномерного (uniform), нормального (normal) и мультиномиального (multinomial) распределений.
2.7.2 Поиск применения конкретных функций и классов
Более подробное описание того, как использовать заданную функцию или класс, можно получить с помощью функции help.
Например, посмотрим, как использовать функцию ones для создания тензоров.
MXNet:
help(np.ones)
PyTorch:
help(torch.ones)
TensorFlow:
help(tf.ones)
PaddlePaddle:
help(paddle.ones)
Из документации видно, что функция ones создаёт новый тензор заданной формы и задаёт значения всех его элементов равными 1.
Далее проверим это описание на небольшом примере:
MXNet:
np.ones(4)
PyTorch:
torch.ones(4)
TensorFlow:
tf.ones(4)
PaddlePaddle:
paddle.ones([4], dtype='float32')
В Jupyter Notebook можно использовать символ ?, чтобы открыть документацию в другом окне браузера.
Например, команда list? выведет почти то же, что и help(list), но в новом окне браузера.
Кроме того, если написать два знака вопроса, как в list??, будет показан код Python, реализующий эту функцию.
Резюме
- Официальная документация содержит множество описаний и примеров, выходящих за рамки этой книги.
- Документацию по API можно получить, вызвав функции
dirиhelp, или в Jupyter Notebook с помощью?и??.
Упражнения
- Найдите документацию по любой функции или классу в фреймворке глубокого обучения. Попробуйте найти её на официальном сайте этого фреймворка.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
3. Линейные нейронные сети
Прежде чем переходить к глубоким нейронным сетям, нужно освоить основы обучения нейронных сетей. В этой главе мы опишем весь процесс обучения: определение простой архитектуры, подготовку данных, выбор функции потерь и способ обучения модели. Чтобы материал было легче усвоить, мы начнём с классического алгоритма — линейных нейронных сетей. Линейная регрессия и softmax-регрессия из классической статистики и машинного обучения можно рассматривать как линейные нейронные сети. Эти знания станут основой для более сложных методов, которые встретятся в остальных частях книги.
3.1 Линейная регрессия
Регрессия (regression) — это класс методов, которые описывают связь между одной или несколькими независимыми переменными и зависимой переменной. В естественных и социальных науках регрессия часто используется для описания зависимости выхода от входов.
В большинстве задач машинного обучения речь идёт о предсказании (prediction). Если нужно предсказать числовое значение, мы имеем дело с задачей регрессии. Типичные примеры: предсказание цены (недвижимости, акций и т. п.), предсказание времени пребывания пациента в стационаре, предсказание спроса (например, объёма продаж в розничной торговле). Но не всякое предсказание — задача регрессии. В следующих разделах мы рассмотрим задачи классификации, в которых цель состоит в том, чтобы определить, к какой из категорий относятся данные.
3.1.1 Основные элементы линейной регрессии
Линейная регрессия (linear regression) появилась в начале XIX века. Это самый простой и самый распространённый из стандартных инструментов регрессии. Она опирается на несколько базовых предположений. Во-первых, связь между признаками и целевой величиной линейна: можно представить как взвешенную сумму элементов , и при этом допускается небольшой шум в наблюдениях. Во-вторых, шум считается «обычным», например распределённым по нормальному закону.
Чтобы объяснить линейную регрессию, рассмотрим практический пример. Допустим, мы хотим оценивать стоимость дома (в долларах) по его площади (в квадратных футах) и возрасту (в годах). Для построения модели, которая предсказывает цену, нужен реальный набор данных. Он включает цену продажи, площадь и возраст каждого дома. В терминах машинного обучения такой набор называется обучающим набором данных (training data set) или обучающим набором (training set). Каждая строка данных (например, сведения об одной сделке с домом) называется примером (sample), или точкой данных (data point), или экземпляром данных (data instance). Величину, которую мы хотим предсказать (в нашем примере — цену), называют меткой (label) или целевой величиной (target). Независимые переменные, на основе которых делается предсказание (площадь и возраст), называются признаками (feature) или ковариатами (covariate).
Количество примеров в наборе данных обозначим через . Вход примера с индексом запишем как , а соответствующую метку — как .
3.1.1.1 Линейная модель
Предположение о линейности означает, что целевую величину (цену дома) можно выразить как взвешенную сумму признаков (площади и возраста):
В формуле (3.1.1) и называются весами (weight); они определяют, насколько каждый признак влияет на предсказание. Величина называется смещением (bias), сдвигом (offset) или свободным членом (intercept). Смещение задаёт предсказание в случае, когда все признаки равны нулю. В реальности у дома не бывает нулевой площади, и возраст ровно в ноль лет тоже встречается редко, но смещение всё равно необходимо: без него выразительность модели была бы ограничена. Строго говоря, формула (3.1.1) задаёт аффинное преобразование (affine transformation) входных признаков. Оно состоит из линейного преобразования, которое даёт взвешенная сумма признаков, и сдвига (translation) на величину смещения.
Задача состоит в том, чтобы по обучающим данным найти веса и смещение , при которых предсказанные цены в среднем близки к реальным. Выход модели определяется аффинным преобразованием входных признаков; параметры этого преобразования задаются выбранными весами и смещением.
В машинном обучении мы обычно работаем с данными высокой размерности, поэтому модель удобно записывать в обозначениях линейной алгебры. Если входные данные содержат признаков, предсказание (символ «крышка» обозначает оценку величины ) записывается так:
Соберём все признаки в вектор , а все веса — в вектор . Тогда модель записывается компактно через скалярное произведение:
В формуле (3.1.2) вектор соответствует признакам одного примера. Для всего набора из примеров удобно использовать матрицу : каждая её строка — это пример, а каждый столбец — отдельный признак.
Для всей матрицы признаков вектор предсказаний вычисляется как произведение матрицы на вектор:
Прибавление смещения к каждому элементу выполняется по правилу broadcasting (подробно о нём см. в разделе 2.1.3). Имея обучающие признаки и известные метки , линейная регрессия ищет такие веса и смещение , при которых для новых примеров из того же распределения, что и , ошибка предсказания будет минимальной.
Мы считаем, что наилучшая модель для предсказания по линейна, но найти реальный набор из примеров, для которого при всех выполняется точное равенство , практически невозможно. Какими бы способами мы ни измеряли признаки и метки , небольшие ошибки наблюдений неизбежны. Поэтому даже когда связь между признаками и метками считается линейной, в модель добавляют шумовой член, который учитывает ошибки наблюдений.
Прежде чем искать наилучшие параметры модели (model parameters) и , нам нужны две вещи: (1) способ измерить качество модели; (2) способ обновлять модель так, чтобы её предсказания становились лучше.
3.1.1.2 Функция потерь
Прежде чем подгонять модель под данные, нужно определить меру качества подгонки. Функция потерь (loss function) измеряет расхождение между истинным значением целевой величины и предсказанным. Обычно потери выбирают неотрицательными: чем меньше потери, тем лучше, а при идеальном предсказании потери равны нулю. В задачах регрессии чаще всего используют квадратичную функцию потерь. Если для примера предсказание равно , а истинная метка — , квадратичная ошибка задаётся формулой:
Множитель принципиально ничего не меняет, но упрощает формулы: при дифференцировании он сокращается с показателем степени 2. Поскольку обучающий набор не находится под нашим контролем, эмпирическая ошибка зависит только от параметров модели. Чтобы это стало нагляднее, рассмотрим задачу регрессии с одним признаком. График на рис. 3.1.1 показывает данные и подогнанную к ним линейную модель.
Рис. 3.1.1. Подгонка данных с помощью линейной модели
Из-за квадратичного члена большое расхождение между предсказанием и наблюдением даёт большие потери. Чтобы оценить качество модели на всём наборе данных, нужно усреднить потери по обучающим примерам:
При обучении мы ищем параметры (), которые минимизируют суммарные потери по всем обучающим примерам:
3.1.1.3 Аналитическое решение
Линейная регрессия — очень простая задача оптимизации. В отличие от большинства моделей, которые будут рассмотрены в книге, её решение можно записать одной формулой. Такое решение называют аналитическим (analytical solution). Сначала включим смещение в вектор параметров , добавив к матрице признаков столбец из единиц. Тогда задача предсказания сводится к минимизации . У этой функции есть единственная критическая точка, которая соответствует минимуму потерь на всей области определения. Приравняв производную потерь по нулю, получаем аналитическое решение:
Простые задачи, такие как линейная регрессия, имеют аналитическое решение, но многие задачи его не имеют. Аналитическое решение удобно для математического анализа, однако оно слишком сильно ограничено по применимости и поэтому почти не используется в глубоком обучении.
3.1.1.4 Стохастический градиентный спуск по минибатчам
Даже когда аналитического решения нет, модель можно эффективно обучать. В книге мы будем использовать градиентный спуск (gradient descent) — метод, который подходит почти для любой модели глубокого обучения. Он постепенно уменьшает ошибку, сдвигая параметры в направлении убывания функции потерь.
Самый простой вариант градиентного спуска: вычислить производную функции потерь (средних потерь по всему набору данных) по параметрам модели, то есть градиент. Но на практике это может быть очень медленно, потому что перед каждым обновлением параметров пришлось бы проходить весь набор данных. Поэтому обычно на каждом шаге случайно выбирают небольшой минибатч примеров. Такой вариант называется стохастическим градиентным спуском по минибатчам (minibatch stochastic gradient descent).
На каждой итерации сначала случайно выбирается минибатч , состоящий из фиксированного числа обучающих примеров. Затем вычисляется градиент средних потерь минибатча по параметрам модели. Наконец, градиент умножается на заранее заданное положительное число и вычитается из текущих значений параметров.
Это обновление записывается формулой ( обозначает частную производную):
Итак, алгоритм состоит из следующих шагов: (1) инициализировать параметры модели, например случайными значениями; (2) многократно выбирать случайный минибатч примеров и сдвигать параметры в направлении антиградиента. Для квадратичных потерь и аффинного преобразования обновления можно записать явно:
В формуле (3.1.4) и — векторы. Такая векторная запись понятнее, чем поэлементная запись через . — количество примеров в минибатче, то есть размер батча (batch size). — скорость обучения (learning rate). Размер батча и скорость обучения обычно задаются заранее вручную, а не выучиваются моделью. Такие величины, которые можно настраивать, но которые не обновляются в процессе обучения, называются гиперпараметрами (hyperparameter). Подбор гиперпараметров (hyperparameter tuning) — это процесс их выбора. Гиперпараметры обычно подбирают по результатам обучения, оценивая качество модели на отдельном проверочном наборе данных (validation dataset).
После заданного числа итераций (или при выполнении другого условия остановки) мы фиксируем оценки параметров . Но даже если функция действительно линейна и без шума, эти оценки не будут точно совпадать с минимумом функции потерь. Алгоритм постепенно приближается к минимуму, но за конечное число шагов не может достичь его абсолютно точно.
Линейная регрессия — задача, у которой на всей области есть только один минимум. Однако для сложных моделей, таких как глубокие нейронные сети, поверхность функции потерь обычно содержит много минимумов. Практики глубокого обучения редко тратят много усилий на то, чтобы найти набор параметров с наименьшими потерями на обучающем наборе. Гораздо сложнее найти параметры, которые дают небольшие потери на данных, которых модель никогда не видела. Эта задача называется обобщением (generalization).
3.1.1.5 Предсказания с помощью обученной модели
Имея обученную линейную модель , мы можем оценить цену нового дома, которого не было в обучающих данных, по его площади и возрасту . Процесс получения оценки целевой величины по признакам называется предсказанием (prediction) или выводом (inference).
В этой книге мы стараемся придерживаться термина предсказание. Термин вывод уже стал стандартным в глубоком обучении, но он не вполне точен: в статистике выводом (inference) называют оценку параметров по данным. Поэтому в разговоре со статистиками путаница в терминах иногда приводит к недоразумениям.
3.1.2 Векторизация для ускорения вычислений
При обучении модели мы часто хотим обрабатывать сразу весь минибатч примеров.
Для этого нужно векторизовать вычисления и использовать библиотеки линейной алгебры, а не писать медленные циклы for на Python.
Чтобы показать, насколько это важно, сравним два способа сложения векторов.
Создадим два вектора из единиц длины 10000.
В первом способе будем обходить векторы циклом for на Python; во втором — воспользуемся перегруженным оператором +.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
import math
from mxnet import np
import time
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import math
import torch
import numpy as np
import time
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import math
import tensorflow as tf
import numpy as np
import time
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import numpy as np
import time
import paddle
n = 10000
a = d2l.ones([n])
b = d2l.ones([n])
Так как в книге мы будем часто измерять время работы кода, определим таймер:
class Timer: #@save
"""Запись времени выполнения нескольких запусков"""
def __init__(self):
self.times = []
self.start()
def start(self):
"""Запуск таймера"""
self.tik = time.time()
def stop(self):
"""Остановка таймера и запись времени в список"""
self.times.append(time.time() - self.tik)
return self.times[-1]
def avg(self):
"""Возврат среднего времени"""
return sum(self.times) / len(self.times)
def sum(self):
"""Возврат суммарного времени"""
return sum(self.times)
def cumsum(self):
"""Возврат накопленного времени"""
return np.array(self.times).cumsum().tolist()
Теперь можно измерить время работы.
Сначала используем цикл for, складывая элементы по одному.
MXNet, PyTorch:
c = d2l.zeros(n)
timer = Timer()
for i in range(n):
c[i] = a[i] + b[i]
f'{timer.stop():.5f} сек'
TensorFlow:
c = tf.Variable(d2l.zeros(n))
timer = Timer()
for i in range(n):
c[i].assign(a[i] + b[i])
f'{timer.stop():.5f} сек'
PaddlePaddle:
c = d2l.zeros([n])
timer = Timer()
for i in range(n):
c[i] = a[i] + b[i]
f'{timer.stop():.5f} сек'
Теперь используем перегруженный оператор + для поэлементного сложения.
timer.start()
d = a + b
f'{timer.stop():.5f} сек'
Результат очевиден: второй способ значительно быстрее первого. Векторизованный код обычно даёт ускорение на порядки. Кроме того, мы переносим больше математических операций в библиотеку и меньше пишем вычислений вручную, что снижает вероятность ошибок.
3.1.3 Нормальное распределение и квадратичные потери
Далее объясним функцию потерь, исходя из предположения о распределении шума.
Нормальное распределение тесно связано с линейной регрессией. Нормальное распределение (normal distribution), также называемое гауссовым (Gaussian distribution), впервые применил в астрономии немецкий математик Гаусс. Если случайная величина имеет среднее значение и дисперсию (стандартное отклонение ), то её плотность вероятности задаётся формулой:
Теперь определим функцию Python для нормального распределения.
def normal(x, mu, sigma):
p = 1 / math.sqrt(2 * math.pi * sigma**2)
return p * np.exp(-0.5 / sigma**2 * (x - mu)**2)
Теперь построим график нормального распределения.
MXNet:
# Снова используем numpy для построения графика
x = np.arange(-7, 7, 0.01)
# Пары среднего значения и стандартного отклонения
params = [(0, 1), (0, 2), (3, 1)]
d2l.plot(x.asnumpy(), [normal(x, mu, sigma).asnumpy() for mu, sigma in params], xlabel='x',
ylabel='p(x)', figsize=(4.5, 2.5),
legend=[f'среднее {mu}, ст. откл. {sigma}' for mu, sigma in params])
PyTorch, TensorFlow, PaddlePaddle:
# Снова используем numpy для построения графика
x = np.arange(-7, 7, 0.01)
# Пары среднего значения и стандартного отклонения
params = [(0, 1), (0, 2), (3, 1)]
d2l.plot(x, [normal(x, mu, sigma) for mu, sigma in params], xlabel='x',
ylabel='p(x)', figsize=(4.5, 2.5),
legend=[f'среднее {mu}, ст. откл. {sigma}' for mu, sigma in params])
Как видно, изменение среднего значения сдвигает распределение вдоль оси , а увеличение дисперсии делает распределение более пологим и снижает его пик.
Квадратичные потери (среднеквадратичная ошибка) можно использовать в линейной регрессии потому, что мы считаем шум в наблюдениях нормально распределённым. Наблюдения описываются моделью с шумом:
где .
Теперь можно записать правдоподобие (likelihood) того, что при данном наблюдается конкретное значение :
По принципу максимального правдоподобия оптимальные значения и — это те, при которых правдоподобие всего набора данных максимально:
Оценка, полученная по принципу максимального правдоподобия, называется оценкой максимального правдоподобия (maximum likelihood estimator). Максимизировать произведение большого числа экспонент сложно, но, не меняя сути задачи, можно вместо этого максимизировать логарифм правдоподобия. По историческим причинам задачи оптимизации обычно формулируют как минимизацию, поэтому вместо максимизации мы минимизируем отрицательный логарифм правдоподобия . Получаем:
Если считать фиксированной константой, первое слагаемое можно отбросить, потому что оно не зависит от и . Второе слагаемое с точностью до константного множителя совпадает с уже введённой среднеквадратичной ошибкой. К тому же решение задачи не зависит от . Итак, при гауссовом шуме минимизация среднеквадратичной ошибки эквивалентна оценке линейной модели по принципу максимального правдоподобия.
3.1.4 От линейной регрессии к глубоким сетям
До сих пор мы говорили только о линейных моделях. Нейронные сети описывают гораздо более широкий класс моделей, и линейную модель тоже можно описать языком нейронных сетей, то есть рассматривать её как простейшую нейронную сеть. Начнём с того, что перепишем модель в терминах «слоёв».
3.1.4.1 Диаграмма нейронной сети
Специалисты по глубокому обучению любят рисовать схемы, чтобы наглядно показывать происходящее в модели. На рис. 3.1.2 линейная регрессия изображена в виде нейронной сети. Схема показывает только структуру связей, то есть какой вход соединён с каким выходом, а значения весов и смещения на ней не отражены.
Рис. 3.1.2. Линейная регрессия — однослойная нейронная сеть
В сети с рис. 3.1.2 входами служат , поэтому число входов (или размерность признаков, feature dimensionality) входного слоя равно . Выход сети — , значит, число выходов выходного слоя равно 1. Входные значения заданы, а вычислительный нейрон здесь один. Поскольку вычисления происходят в нейронах, при подсчёте числа слоёв входной слой обычно не учитывают. Поэтому у сети с рис. 3.1.2 один слой. Линейную регрессию можно рассматривать как нейронную сеть, состоящую из одного искусственного нейрона, или как однослойную нейронную сеть.
В линейной регрессии каждый вход соединён с каждым выходом (в данном случае выход один). Такое преобразование (выходной слой на рис. 3.1.2) называют полносвязным слоем (fully-connected layer), или плотным слоем (dense layer). Сети, построенные из таких слоёв, подробно рассматриваются в следующей главе.
3.1.4.2 Биология
Линейная регрессия была придумана в 1795 году, задолго до вычислительной нейробиологии, поэтому описывать её как нейронную сеть может показаться неуместным. Однако почему специалисты по кибернетике и нейробиологии Уоррен Маккаллок и Уолтер Питтс, начав разрабатывать модель искусственного нейрона, взяли в качестве отправной точки именно линейную модель? Посмотрим на рис. 3.1.3: это изображение биологического нейрона. На нём видны дендриты (входные окончания), ядро (аналог центрального процессора), аксон (выходное волокно) и концевые разветвления аксона (выходные окончания). Аксон соединяется с другими нейронами через синапсы.
Рис. 3.1.3. Настоящий нейрон
Дендриты получают информацию от других нейронов (или от сенсоров окружающей среды, например сетчатки). Эта информация взвешивается синаптическими весами , которые определяют силу воздействия входа: произведение может возбуждать или подавлять нейрон. Взвешенные входы из разных источников суммируются в ядре в виде ; затем сигнал передаётся по аксону для дальнейшей обработки, обычно с некоторым нелинейным преобразованием . После этого сигнал либо достигает цели (например, мышцы), либо через дендриты передаётся другому нейрону.
Конечно, многие такие элементы можно соединить между собой и обучить подходящим алгоритмом. Тогда поведение всей системы окажется гораздо богаче и сложнее поведения одного нейрона. Эта идея выросла из изучения настоящих биологических нервных систем.
Сегодняшние исследования в глубоком обучении почти не черпают вдохновение напрямую из нейронауки. Стюарт Рассел и Питер Норвиг в своём классическом учебнике по искусственному интеллекту Artificial Intelligence: A Modern Approach (Russell and Norvig, 2016) сравнивают это с авиацией: хотя самолёты, возможно, и вдохновлены птицами, на протяжении веков орнитология не была главным двигателем авиационных инноваций. Точно так же сегодня источником вдохновения для глубокого обучения служат математика, статистика и информатика — не меньше, а то и больше, чем биология.
Резюме
- Ключевые элементы модели машинного обучения — обучающие данные, функция потерь, алгоритм оптимизации и сама модель.
- Векторизация делает математические выражения короче и ускоряет вычисления.
- Минимизация целевой функции и оценка по принципу максимального правдоподобия — по сути одна и та же задача.
- Модель линейной регрессии тоже можно рассматривать как простую нейронную сеть.
Упражнения
- Предположим, у нас есть данные . Нужно найти константу , которая минимизирует .
- Найдите аналитическое решение для оптимального .
- Как эта задача и её решение связаны с нормальным распределением?
- Выведите аналитическое решение задачи линейной регрессии с квадратичной ошибкой. Для упрощения можно опустить смещение (его можно учесть, добавив к столбец из единиц).
- Запишите задачу оптимизации в матричной и векторной форме (все данные — одна матрица, все целевые значения — один вектор).
- Вычислите градиент функции потерь по .
- Найдите аналитическое решение, приравняв градиент нулю и решив матричное уравнение.
- Когда такой подход может оказаться лучше стохастического градиентного спуска? Когда он может не работать?
- Пусть шум в модели распределён по экспоненциальному закону: .
- Запишите отрицательный логарифм правдоподобия данных для этой модели.
- Попробуйте записать аналитическое решение.
- Предложите алгоритм стохастического градиентного спуска для этой задачи. Где могут возникнуть проблемы? (Подсказка: что происходит с параметрами при многократных обновлениях вблизи стационарной точки?) Попробуйте решить эту проблему.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
3.2 Линейная регрессия с нуля
Разобравшись с основными идеями линейной регрессии, можно перейти к её реализации в коде. В этом разделе мы реализуем весь метод с нуля: конвейер данных, модель, функцию потерь и оптимизатор — стохастический градиентный спуск по минибатчам. Современные фреймворки глубокого обучения почти полностью автоматизируют эту работу, но реализация с нуля гарантирует, что мы понимаем, что происходит. Кроме того, знание внутреннего устройства пригодится, когда понадобится самостоятельно изменить модель, слой или функцию потерь. В этом разделе мы используем только тензоры и автоматическое дифференцирование. В последующих главах мы будем опираться на возможности фреймворков и рассмотрим более краткие реализации.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, np, npx
import random
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
import random
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
import random
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import random
import paddle
3.2.1 Генерация набора данных
Для простоты создадим искусственный набор данных на основе линейной модели с шумом. Наша задача — по этому конечному набору восстановить параметры модели. Мы будем использовать данные небольшой размерности, чтобы их было легко визуализировать. В приведённом ниже коде создаётся набор из 1000 примеров, каждый из которых содержит 2 признака, выбранных из стандартного нормального распределения. Синтетический набор данных представляет собой матрицу .
Метки и данные создадим по линейной модели с параметрами , и шумовым членом :
Величину можно рассматривать как возможную ошибку наблюдения при измерении меток. Здесь мы считаем выполненными стандартные предположения: распределена нормально со средним 0. Для простоты стандартное отклонение положим равным 0.01. Код ниже генерирует синтетический набор данных.
MXNet, PyTorch, PaddlePaddle:
def synthetic_data(w, b, num_examples): #@save
"""Генерация y = Xw + b + шум"""
X = d2l.normal(0, 1, (num_examples, len(w)))
y = d2l.matmul(X, w) + b
y += d2l.normal(0, 0.01, y.shape)
return X, d2l.reshape(y, (-1, 1))
TensorFlow:
def synthetic_data(w, b, num_examples): #@save
"""Генерация y = Xw + b + шум"""
X = d2l.zeros((num_examples, w.shape[0]))
X += tf.random.normal(shape=X.shape)
y = d2l.matmul(X, tf.reshape(w, (-1, 1))) + b
y += tf.random.normal(shape=y.shape, stddev=0.01)
y = d2l.reshape(y, (-1, 1))
return X, y
true_w = d2l.tensor([2, -3.4])
true_b = 4.2
features, labels = synthetic_data(true_w, true_b, 1000)
Обратите внимание: каждая строка features содержит двумерный пример данных, а каждая строка labels — одномерное значение метки (скаляр).
print('features:', features[0],'\nlabel:', labels[0])
Чтобы увидеть линейную зависимость между признаками и метками, построим диаграмму рассеяния второго признака features[:, 1] и labels.
d2l.set_figsize()
d2l.plt.scatter(d2l.numpy(features[:, 1]), d2l.numpy(labels), 1);
3.2.2 Чтение набора данных
Напомним, что при обучении модели мы проходим по набору данных, на каждом шаге берём небольшой минибатч и используем его для обновления модели. Поскольку этот процесс лежит в основе обучения алгоритмов машинного обучения, стоит определить функцию, которая перемешивает примеры и выдаёт их минибатчами.
В приведённом ниже коде определим функцию data_iter, которая принимает размер батча, матрицу признаков и вектор меток, а возвращает минибатчи размера batch_size.
Каждый минибатч содержит набор признаков и меток.
MXNet, PyTorch, PaddlePaddle:
def data_iter(batch_size, features, labels):
num_examples = len(features)
indices = list(range(num_examples))
# Примеры читаются в случайном порядке, без определённой последовательности
random.shuffle(indices)
for i in range(0, num_examples, batch_size):
batch_indices = d2l.tensor(
indices[i: min(i + batch_size, num_examples)])
yield features[batch_indices], labels[batch_indices]
TensorFlow:
def data_iter(batch_size, features, labels):
num_examples = len(features)
indices = list(range(num_examples))
# Примеры читаются в случайном порядке, без определённой последовательности
random.shuffle(indices)
for i in range(0, num_examples, batch_size):
j = tf.constant(indices[i: min(i + batch_size, num_examples)])
yield tf.gather(features, j), tf.gather(labels, j)
Обычно мы используем преимущество параллельных вычислений на GPU и обрабатываем минибатчи разумного размера. Каждый пример можно обрабатывать параллельно с остальными, и градиенты функции потерь для каждого примера тоже вычисляются параллельно. GPU может обработать несколько сотен примеров почти за то же время, что и один.
Чтобы почувствовать работу с минибатчами, прочитаем первый минибатч и выведем его.
Форма минибатча признаков показывает размер батча и число входных признаков.
Аналогично, форма батча меток совпадает с batch_size.
batch_size = 10
for X, y in data_iter(batch_size, features, labels):
print(X, '\n', y)
break
При итерации мы последовательно получаем разные минибатчи, пока не пройдём весь набор данных. Реализованная выше итерация хорошо подходит для учебных целей, но работает неэффективно и на реальных задачах может создать проблемы. Например, она требует загрузить все данные в память и выполнять много случайных обращений к памяти. Встроенные в фреймворки итераторы работают значительно эффективнее: они умеют читать данные из файлов и принимать данные из потоков.
3.2.3 Инициализация параметров модели
Прежде чем начинать оптимизацию параметров модели методом минибатчевого стохастического градиентного спуска, нам нужны начальные значения параметров. В приведённом коде веса инициализируются случайными числами из нормального распределения со средним 0 и стандартным отклонением 0.01, а смещение — нулём.
MXNet:
w = np.random.normal(0, 0.01, (2, 1))
b = np.zeros(1)
w.attach_grad()
b.attach_grad()
PyTorch:
w = torch.normal(0, 0.01, size=(2,1), requires_grad=True)
b = torch.zeros(1, requires_grad=True)
TensorFlow:
w = tf.Variable(tf.random.normal(shape=(2, 1), mean=0, stddev=0.01),
trainable=True)
b = tf.Variable(tf.zeros(1), trainable=True)
PaddlePaddle:
w = d2l.normal(0, 0.01, shape=(2,1))
b = d2l.zeros(shape=[1])
# w и b — создаваемые параметры модели; stop_gradient по умолчанию равен True, то есть градиент не вычисляется, поэтому его нужно установить в False
w.stop_gradient = False
b.stop_gradient = False
После инициализации параметров наша задача — обновлять их до тех пор, пока они не станут достаточно хорошо описывать данные. На каждом шаге нужно вычислять градиент функции потерь по параметрам модели. Зная градиент, мы можем сдвинуть каждый параметр в направлении уменьшения потерь. Вычислять градиенты вручную утомительно и легко ошибиться, поэтому никто этого не делает. Для вычисления градиентов мы используем автоматическое дифференцирование, введённое в разделе 2.5.
3.2.4 Определение модели
Далее определим модель, которая связывает входные данные и параметры с выходом модели. Напомним, что для вычисления выхода линейной модели достаточно умножить матрицу признаков на вектор весов и прибавить смещение . Обратите внимание: — вектор, а — скаляр. Как описано в разделе 2.1.3 о broadcasting, при сложении вектора со скаляром скаляр прибавляется к каждому элементу вектора.
def linreg(X, w, b): #@save
"""Модель линейной регрессии"""
return d2l.matmul(X, w) + b
3.2.5 Определение функции потерь
Поскольку нам нужен градиент функции потерь, сначала определим её.
Здесь используем квадратичную функцию потерь, описанную в разделе 3.1.
В реализации нужно привести форму истинных значений y к форме предсказаний y_hat.
def squared_loss(y_hat, y): #@save
"""Квадратичные потери"""
return (y_hat - d2l.reshape(y, y_hat.shape)) ** 2 / 2
3.2.6 Определение алгоритма оптимизации
Как мы обсуждали в разделе 3.1, у линейной регрессии есть аналитическое решение. Однако у других моделей, которые встретятся в книге, аналитического решения нет. Поэтому здесь мы используем минибатчевый стохастический градиентный спуск.
На каждом шаге берём минибатч, случайно выбранный из набора данных, вычисляем градиент потерь по параметрам и сдвигаем параметры в направлении уменьшения потерь.
Функция ниже реализует обновление минибатчевым стохастическим градиентным спуском.
Она принимает набор параметров модели, скорость обучения и размер батча.
Величина шага определяется скоростью обучения lr.
Поскольку потери, которые мы вычисляем, — это сумма по минибатчу, мы нормируем шаг на размер батча (batch_size), чтобы размер шага не зависел от выбранного размера батча.
MXNet:
def sgd(params, lr, batch_size): #@save
"""Минибатчевый стохастический градиентный спуск"""
for param in params:
param[:] = param - lr * param.grad / batch_size
PyTorch:
def sgd(params, lr, batch_size): #@save
"""Минибатчевый стохастический градиентный спуск"""
with torch.no_grad():
for param in params:
param -= lr * param.grad / batch_size
param.grad.zero_()
TensorFlow:
def sgd(params, grads, lr, batch_size): #@save
"""Минибатчевый стохастический градиентный спуск"""
for param, grad in zip(params, grads):
param.assign_sub(lr*grad/batch_size)
PaddlePaddle:
#@save
def sgd(params, lr, batch_size):
"""Минибатчевый стохастический градиентный спуск"""
with paddle.no_grad():
for i, param in enumerate(params):
param -= lr * params[i].grad / batch_size
params[i].set_value(param)
params[i].clear_gradient()
3.2.7 Обучение
Теперь у нас есть все элементы, необходимые для обучения модели, и можно реализовать основную часть — процесс обучения.
Понимание этого кода очень важно: после начала работы с глубоким обучением почти один и тот же процесс будет повторяться снова и снова.
На каждой итерации мы берём минибатч обучающих примеров, пропускаем его через модель и получаем предсказания.
После вычисления потерь запускаем обратное распространение ошибки и сохраняем градиенты параметров.
Наконец, вызываем оптимизатор sgd, чтобы обновить параметры модели.
Кратко весь процесс выглядит так:
- инициализировать параметры;
- повторять обучение, пока оно не завершится:
- вычислить градиент ;
- обновить параметры .
В течение каждой эпохи (epoch) функция data_iter проходит весь набор данных, и каждый обучающий пример используется один раз (предполагается, что число примеров делится на размер батча).
Число эпох num_epochs и скорость обучения lr — гиперпараметры; здесь они равны 3 и 0.03 соответственно.
Подбор гиперпараметров — непростая задача, обычно он требует многих проб и ошибок.
Сейчас мы оставим эти детали в стороне; подробно о них пойдёт речь в главе 11.
lr = 0.03
num_epochs = 3
net = linreg
loss = squared_loss
MXNet:
for epoch in range(num_epochs):
for X, y in data_iter(batch_size, features, labels):
with autograd.record():
l = loss(net(X, w, b), y) # Потери на минибатче X и y
# Вычислить градиент l по [w, b]
l.backward()
sgd([w, b], lr, batch_size) # Обновить параметры по их градиентам
train_l = loss(net(features, w, b), labels)
print(f'эпоха {epoch + 1}, потери {float(train_l.mean()):f}')
PyTorch:
for epoch in range(num_epochs):
for X, y in data_iter(batch_size, features, labels):
l = loss(net(X, w, b), y) # Потери на минибатче X и y
# Поскольку форма l равна (batch_size, 1), а не скаляр, все элементы l
# складываются, и по полученной сумме вычисляется градиент по [w, b]
l.sum().backward()
sgd([w, b], lr, batch_size) # Обновить параметры по их градиентам
with torch.no_grad():
train_l = loss(net(features, w, b), labels)
print(f'эпоха {epoch + 1}, потери {float(train_l.mean()):f}')
TensorFlow:
for epoch in range(num_epochs):
for X, y in data_iter(batch_size, features, labels):
with tf.GradientTape() as g:
l = loss(net(X, w, b), y) # Потери на минибатче X и y
# Вычислить градиент l по [w, b]
dw, db = g.gradient(l, [w, b])
# Обновить параметры по их градиентам
sgd([w, b], [dw, db], lr, batch_size)
train_l = loss(net(features, w, b), labels)
print(f'эпоха {epoch + 1}, потери {float(tf.reduce_mean(train_l)):f}')
PaddlePaddle:
for epoch in range(num_epochs):
for X, y in data_iter(batch_size, features, labels):
l = loss(net(X, w, b), y) # Потери на минибатче X и y
# Поскольку форма l равна (batch_size, 1), а не скаляр, все элементы l
# складываются, и по полученной сумме вычисляется градиент по [w, b]
l.sum().backward()
sgd([w, b], lr, batch_size) # Обновить параметры по их градиентам
with paddle.no_grad():
train_l = loss(net(features, w, b), labels)
print(f'эпоха {epoch + 1}, потери {float(train_l.mean()):f}')
Поскольку мы сгенерировали данные сами, нам известны истинные параметры. Поэтому можно сравнить истинные параметры с параметрами, найденными в ходе обучения, чтобы оценить, насколько успешно прошло обучение. На практике найденные параметры действительно оказываются очень близкими к истинным.
print(f'Ошибка оценки w: {true_w - d2l.reshape(w, true_w.shape)}')
print(f'Ошибка оценки b: {true_b - b}')
Не стоит считать, что параметры всегда восстанавливаются идеально. В машинном обучении нас обычно интересует не точное восстановление истинных параметров, а то, насколько точно модель предсказывает. К счастью, даже в сложных задачах оптимизации стохастический градиентный спуск обычно находит очень хорошие решения. Одна из причин в том, что в глубоких сетях существует много комбинаций параметров, дающих очень точные предсказания.
Резюме
- Мы изучили, как реализовать и оптимизировать глубокую сеть. При этом использовались только тензоры и автоматическое дифференцирование: не нужно было ни определять слои, ни писать сложные оптимизаторы.
- Этот раздел лишь затронул основы. В следующих разделах мы опишем другие модели на основе введённых понятий и научимся реализовывать их более кратко.
Упражнения
- Что произойдёт, если инициализировать веса нулями? Будет ли алгоритм по-прежнему работать?
- Предположим, мы хотим построить модель зависимости напряжения от тока. Можно ли использовать автоматическое дифференцирование для обучения параметров модели?
- Можно ли, опираясь на закон Планка, по спектральной плотности энергии излучения определить температуру объекта?
- Какие проблемы могут возникнуть при вычислении производных второго порядка? Как их можно решить?
- Зачем в функции
squared_lossнужна операцияreshape? - Попробуйте разные скорости обучения и посмотрите, как быстро уменьшается значение функции потерь.
- Как изменится поведение
data_iter, если число примеров не делится на размер батча?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
3.3 Линейная регрессия: краткая реализация
За последние годы благодаря большому интересу к глубокому обучению многие компании, учёные и энтузиасты создали множество зрелых открытых фреймворков. Эти фреймворки автоматизируют повторяющуюся работу, которая встречается во всех алгоритмах обучения на основе градиентов. В разделе 3.2 мы использовали только две возможности: (1) хранение данных и линейную алгебру с помощью тензоров; (2) вычисление градиентов с помощью автоматического дифференцирования. На практике же итераторы данных, функции потерь, оптимизаторы и слои нейронных сетей встречаются так часто, что современные библиотеки глубокого обучения уже реализуют все эти компоненты.
В этом разделе мы покажем, как с помощью фреймворка глубокого обучения кратко реализовать линейную регрессию из раздела 3.2.
3.3.1 Генерация набора данных
Как и в разделе 3.2, сначала сгенерируем набор данных.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, gluon, np, npx
npx.set_np()
PyTorch:
from d2l import torch as d2l
import numpy as np
import torch
from torch.utils import data
TensorFlow:
from d2l import tensorflow as d2l
import numpy as np
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import numpy as np
import paddle
true_w = d2l.tensor([2, -3.4])
true_b = 4.2
features, labels = d2l.synthetic_data(true_w, true_b, 1000)
3.3.2 Чтение набора данных
Вместо того чтобы писать итератор самостоятельно, мы можем вызвать готовый API фреймворка для чтения данных.
Передадим в API массивы features и labels, а размер батча задаём через итератор данных.
Булев параметр is_train определяет, нужно ли итератору перемешивать данные на каждой эпохе.
MXNet:
def load_array(data_arrays, batch_size, is_train=True): #@save
"""Построение итератора данных Gluon"""
dataset = gluon.data.ArrayDataset(*data_arrays)
return gluon.data.DataLoader(dataset, batch_size, shuffle=is_train)
PyTorch:
def load_array(data_arrays, batch_size, is_train=True): #@save
"""Построение итератора данных PyTorch"""
dataset = data.TensorDataset(*data_arrays)
return data.DataLoader(dataset, batch_size, shuffle=is_train)
TensorFlow:
def load_array(data_arrays, batch_size, is_train=True): #@save
"""Построение итератора данных TensorFlow"""
dataset = tf.data.Dataset.from_tensor_slices(data_arrays)
if is_train:
dataset = dataset.shuffle(buffer_size=1000)
dataset = dataset.batch(batch_size)
return dataset
PaddlePaddle:
#@save
def load_array(data_arrays, batch_size, is_train=True):
"""Построение итератора данных Paddle"""
dataset = paddle.io.TensorDataset(data_arrays)
return paddle.io.DataLoader(dataset, batch_size=batch_size,
shuffle=is_train,
return_list=True)
batch_size = 10
data_iter = load_array((features, labels), batch_size)
Использовать data_iter мы будем так же, как функцию data_iter в разделе 3.2.
Чтобы проверить, что всё работает, прочитаем и выведем первый минибатч.
В отличие от раздела 3.2, здесь мы создаём итератор Python с помощью iter и получаем из него первый элемент с помощью next.
next(iter(data_iter))
3.3.3 Определение модели
В разделе 3.2 мы явно задавали параметры модели и писали вычисления через базовые операции линейной алгебры. Но когда модели становятся сложнее, а строить их приходится почти каждый день, хочется упростить эту работу. Это похоже на создание страницы блога с нуля: один раз это полезно, но если на каждый новый блог инженеру приходится тратить месяц, это неэффективно.
Для стандартных моделей глубокого обучения можно использовать готовые слои фреймворка.
Тогда остаётся только выбрать, из каких слоёв строить модель, и не нужно заботиться о деталях их реализации.
Сначала определим переменную модели net — экземпляр класса Sequential.
Класс Sequential соединяет слои последовательно: при подаче входных данных Sequential передаёт их первому слою, затем выход первого слоя становится входом второго, и так далее.
В примере ниже модель состоит из одного слоя, поэтому Sequential здесь формально не нужен.
Но почти все следующие модели будут многослойными, и уже сейчас стоит познакомиться со «стандартным конвейером».
Вспомним однослойную сеть с рис. 3.1.2. Этот слой называется полносвязным (fully-connected layer), потому что каждый его вход через матрично-векторное умножение связан с каждым выходом.
MXNet: в Gluon полносвязный слой определяется классом Dense.
Поскольку нам нужен только один скалярный выход, число выходов задаём равным 1.
Для удобства Gluon не требует указывать размерность входа для каждого слоя.
Поэтому здесь не нужно говорить, сколько входов поступает в слой.
Когда мы впервые передаём данные в модель, например при вызове net(X), Gluon сам определяет размерности входов каждого слоя.
Подробнее этот механизм будет описан ниже в этом разделе.
PyTorch: в PyTorch полносвязный слой определяется классом Linear.
Обратите внимание, что в nn.Linear передаются два аргумента.
Первый задаёт размерность входных признаков (2), второй — размерность выходных признаков, которая равна 1, так как выход — один скаляр.
TensorFlow: в Keras полносвязный слой определяется классом Dense.
Поскольку нам нужен только один скалярный выход, число выходов задаём равным 1.
Для удобства Keras не требует указывать размерность входа для каждого слоя.
Поэтому здесь не нужно говорить, сколько входов поступает в слой.
Когда мы впервые передаём данные в модель, например при вызове net(X), Keras сам определяет размерности входов каждого слоя.
Подробнее этот механизм будет описан ниже в этом разделе.
PaddlePaddle: в PaddlePaddle полносвязный слой определяется классом Linear.
Обратите внимание, что в nn.Linear передаются два аргумента.
Первый задаёт размерность входных признаков (2), второй — размерность выходных признаков, которая равна 1, так как выход — один скаляр.
# nn — сокращение от neural network (нейронная сеть)
from mxnet.gluon import nn
net = nn.Sequential()
net.add(nn.Dense(1))
# nn — сокращение от neural network (нейронная сеть)
from torch import nn
net = nn.Sequential(nn.Linear(2, 1))
# keras — высокоуровневый API TensorFlow
net = tf.keras.Sequential()
net.add(tf.keras.layers.Dense(1))
# nn — сокращение от neural network (нейронная сеть)
from paddle import nn
net = nn.Sequential(nn.Linear(2, 1))
3.3.4 Инициализация параметров модели
Прежде чем использовать net, нужно инициализировать параметры модели: веса и смещение линейной регрессии.
Фреймворки обычно предоставляют готовые методы инициализации.
Здесь мы задаём, что каждый вес случайно выбирается из нормального распределения со средним 0 и стандартным отклонением 0.01, а смещение инициализируется нулём.
MXNet: мы импортируем модуль initializer из MXNet, который содержит различные методы инициализации параметров.
В Gluon init — сокращённое обращение к пакету initializer.
Способ инициализации весов задаётся вызовом init.Normal(sigma=0.01).
По умолчанию смещения инициализируются нулями.
PyTorch: так же как и при создании nn.Linear, где мы задаём размерности входа и выхода, теперь мы можем напрямую обращаться к параметрам и задавать их начальные значения.
Первый слой сети выбирается как net[0], а доступ к параметрам осуществляется через атрибуты weight.data и bias.data.
Значения параметров можно также перезаписать методами с суффиксом _ — normal_ и fill_.
TensorFlow: модуль initializers в TensorFlow предоставляет различные методы инициализации параметров.
В Keras самый простой способ задать инициализацию — указать параметр kernel_initializer при создании слоя.
Здесь мы заново создаём net.
PaddlePaddle: так же как и при создании nn.Linear, где мы задаём размерности входа и выхода, теперь мы можем напрямую обращаться к параметрам и задавать их начальные значения.
Первый слой сети выбирается как net[0], а доступ к параметрам осуществляется через атрибуты weight и bias.
Метод инициализации весов задаётся вызовом nn.initializer.Normal(0, 0.01).
По умолчанию смещения инициализируются нулями.
from mxnet import init
net.initialize(init.Normal(sigma=0.01))
net[0].weight.data.normal_(0, 0.01)
net[0].bias.data.fill_(0)
initializer = tf.initializers.RandomNormal(stddev=0.01)
net = tf.keras.Sequential()
net.add(tf.keras.layers.Dense(1, kernel_initializer=initializer))
weight_attr = paddle.ParamAttr(initializer=
paddle.nn.initializer.Normal(0, 0.01))
bias_attr = paddle.ParamAttr(initializer=None)
net = nn.Sequential(nn.Linear(2, 1, weight_attr=weight_attr,
bias_attr=bias_attr))
MXNet: код выше может показаться простым, но здесь есть одна важная деталь. Мы инициализируем параметры сети, хотя Gluon ещё не знает, сколько входов будет у модели. Вход может иметь 2 признака, а может и 2000. Gluon обходит эту проблему: инициализация на самом деле выполняется отложенно (deferred) — только тогда, когда мы впервые передаём данные через сеть. Заметьте, что до этого параметры не инициализированы, поэтому обращаться к ним или изменять их нельзя.
TensorFlow: код выше может показаться простым, но здесь есть одна важная деталь. Мы инициализируем параметры сети, хотя Keras ещё не знает, сколько входов будет у модели. Вход может иметь 2 признака, а может и 2000. Keras обходит эту проблему: инициализация выполняется отложенно (deferred) — только тогда, когда мы впервые передаём данные через сеть. Заметьте, что до этого параметры не инициализированы, поэтому обращаться к ним или изменять их нельзя.
3.3.5 Определение функции потерь
MXNet: в Gluon модуль loss содержит различные функции потерь.
В этом примере мы используем среднеквадратичную ошибку Gluon (L2Loss).
PyTorch: среднеквадратичная ошибка вычисляется классом MSELoss, также известным как квадрат -нормы.
По умолчанию он возвращает среднее значение потерь по всем примерам.
TensorFlow: среднеквадратичная ошибка вычисляется классом MeanSquaredError, также известным как квадрат -нормы.
По умолчанию он возвращает среднее значение потерь по всем примерам.
PaddlePaddle: среднеквадратичная ошибка вычисляется классом MSELoss, также известным как квадрат -нормы.
По умолчанию он возвращает среднее значение потерь по всем примерам.
loss = gluon.loss.L2Loss()
loss = nn.MSELoss()
loss = tf.keras.losses.MeanSquaredError()
loss = nn.MSELoss()
3.3.6 Определение алгоритма оптимизации
Минибатчевый стохастический градиентный спуск — стандартный инструмент для оптимизации нейронных сетей. Фреймворки реализуют множество его вариантов.
MXNet: Gluon реализует этот алгоритм и его варианты через класс Trainer.
При создании Trainer мы указываем параметры, которые нужно оптимизировать (их можно получить из модели net через net.collect_params()), алгоритм оптимизации (sgd) и словарь гиперпараметров, необходимых алгоритму.
Для минибатчевого стохастического градиентного спуска достаточно задать learning_rate; здесь он равен 0.03.
PyTorch: минибатчевый стохастический градиентный спуск — стандартный инструмент для оптимизации нейронных сетей, а PyTorch реализует множество его вариантов в модуле optim.
Когда мы создаём экземпляр SGD, мы указываем параметры для оптимизации (их можно получить из модели через net.parameters()) и словарь гиперпараметров, нужных алгоритму.
Для минибатчевого стохастического градиентного спуска достаточно задать lr; здесь он равен 0.03.
TensorFlow: минибатчевый стохастический градиентный спуск — стандартный инструмент для оптимизации нейронных сетей, а Keras реализует множество его вариантов в модуле optimizers.
Для минибатчевого стохастического градиентного спуска достаточно задать learning_rate; здесь он равен 0.03.
PaddlePaddle: минибатчевый стохастический градиентный спуск — стандартный инструмент для оптимизации нейронных сетей, а PaddlePaddle реализует множество его вариантов в модуле optimizer.
Для минибатчевого стохастического градиентного спуска достаточно задать learning_rate; здесь он равен 0.03.
from mxnet import gluon
trainer = gluon.Trainer(net.collect_params(), 'sgd', {'learning_rate': 0.03})
trainer = torch.optim.SGD(net.parameters(), lr=0.03)
trainer = tf.keras.optimizers.SGD(learning_rate=0.03)
trainer = paddle.optimizer.SGD(learning_rate=0.03,
parameters=net.parameters())
3.3.7 Обучение
Реализовать модель с помощью высокоуровневого API фреймворка можно достаточно коротким кодом. Нам не нужно отдельно выделять параметры, задавать функцию потерь или вручную реализовывать минибатчевый стохастический градиентный спуск. По мере усложнения моделей преимущества высокоуровневого API становятся всё заметнее. Когда все базовые компоненты готовы, код обучения очень похож на тот, что мы писали с нуля.
Напомним: в каждой эпохе мы полностью проходим набор данных (train_data) и последовательно получаем из него минибатчи входов и соответствующих меток.
Для каждого минибатча выполняем следующие шаги:
- вызываем
net(X), получаем предсказание и вычисляем потериl(прямое распространение); - вычисляем градиенты с помощью обратного распространения ошибки;
- обновляем параметры модели, вызывая оптимизатор.
Чтобы оценить качество обучения, после каждой эпохи вычисляем потери на всём наборе данных и выводим их для контроля процесса.
MXNet:
num_epochs = 3
for epoch in range(num_epochs):
for X, y in data_iter:
with autograd.record():
l = loss(net(X), y)
l.backward()
trainer.step(batch_size)
l = loss(net(features), labels)
print(f'эпоха {epoch + 1}, потери {l.mean().asnumpy():f}')
PyTorch:
num_epochs = 3
for epoch in range(num_epochs):
for X, y in data_iter:
l = loss(net(X) ,y)
trainer.zero_grad()
l.backward()
trainer.step()
l = loss(net(features), labels)
print(f'эпоха {epoch + 1}, потери {l:f}')
TensorFlow:
num_epochs = 3
for epoch in range(num_epochs):
for X, y in data_iter:
with tf.GradientTape() as tape:
l = loss(net(X, training=True), y)
grads = tape.gradient(l, net.trainable_variables)
trainer.apply_gradients(zip(grads, net.trainable_variables))
l = loss(net(features), labels)
print(f'эпоха {epoch + 1}, потери {l:f}')
PaddlePaddle:
num_epochs = 3
for epoch in range(num_epochs):
for i,(X, y) in enumerate (data_iter()):
l = loss(net(X) ,y)
trainer.clear_grad()
l.backward()
trainer.step()
l = loss(net(features), labels)
print(f'эпоха {epoch + 1},'f'потери {l}')
Теперь сравним истинные параметры, использованные при генерации набора данных, с параметрами модели, полученными в результате обучения на ограниченных данных.
Чтобы получить параметры, обращаемся к нужному слою net, а затем читаем его веса и смещение.
Как и в разделе 3.2, оцененные параметры оказываются очень близки к истинным.
MXNet:
w = net[0].weight.data()
print(f'Ошибка оценки w: {true_w - d2l.reshape(w, true_w.shape)}')
b = net[0].bias.data()
print(f'Ошибка оценки b: {true_b - b}')
PyTorch:
w = net[0].weight.data
print('Ошибка оценки w:', true_w - d2l.reshape(w, true_w.shape))
b = net[0].bias.data
print('Ошибка оценки b:', true_b - b)
TensorFlow:
w = net.get_weights()[0]
print('Ошибка оценки w:', true_w - d2l.reshape(w, true_w.shape))
b = net.get_weights()[1]
print('Ошибка оценки b:', true_b - b)
PaddlePaddle:
w = net[0].weight
print('Ошибка оценки w:', true_w - w.reshape(true_w.shape))
b = net[0].bias
print('Ошибка оценки b:', true_b - b)
Резюме
MXNet:
- Модель можно реализовать в Gluon более кратко.
- В Gluon модуль
dataсодержит инструменты для обработки данных, модульnn— большое число слоёв нейронных сетей, а модульloss— многие распространённые функции потерь. - Модуль
initializerв MXNet предоставляет различные методы инициализации параметров модели. - Размерности и хранение данных определяются автоматически, но не следует пытаться обращаться к параметрам до их инициализации.
PyTorch:
- Модель можно реализовать в PyTorch с помощью высокоуровневого API более кратко.
- В PyTorch модуль
dataсодержит инструменты для обработки данных, а модульnn— большое число слоёв нейронных сетей и распространённых функций потерь. - Параметры можно инициализировать, заменяя их значения методами с суффиксом
_.
TensorFlow:
- Модель можно реализовать в TensorFlow с помощью высокоуровневого API более кратко.
- В TensorFlow модуль
dataсодержит инструменты для обработки данных, а модульkeras— большое число слоёв нейронных сетей и распространённых функций потерь. - Модуль
initializersв TensorFlow предоставляет различные методы инициализации параметров модели. - Размерности и хранение данных определяются автоматически, но не следует пытаться обращаться к параметрам до их инициализации.
Упражнения
- Как нужно изменить скорость обучения, если вместо суммарных потерь минибатча использовать среднее значение потерь по минибатчу?
- Посмотрите документацию фреймворков: какие функции потерь и методы инициализации они предоставляют? Замените исходную функцию потерь на функцию Хубера (Huber loss):
- Как получить доступ к градиентам линейной регрессии?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
3.4 Softmax-регрессия
В разделе 3.1 мы ввели линейную регрессию. Затем в разделе 3.2 мы реализовали её с нуля, а в разделе 3.3 — кратко, с помощью высокоуровневого API фреймворка.
Регрессия подходит для задач, в которых нужно предсказать сколько: например, цену, по которой продастся дом, число побед бейсбольной команды или количество дней пребывания пациента в больнице.
Но нас также интересуют задачи классификации. В них спрашивают не «сколько», а «какой»:
- попадёт ли письмо в папку «Спам»?
- подпишется ли пользователь на сервис или нет?
- на изображении осёл, собака, кошка или курица?
- какой фильм пользователь, скорее всего, посмотрит дальше?
Специалисты по машинному обучению употребляют слово «классификация» для двух близких, но различных задач:
- нас интересует только «жёсткая» категория — к какому классу относится пример;
- нас интересует «мягкая» категория — вероятность принадлежности примера каждому классу.
Граница между ними часто размыта. Одна из причин в том, что даже если нас интересует только жёсткая категория, мы всё равно нередко используем модели, которые выдают мягкие категории.
3.4.1 Задача классификации
Начнём с задачи классификации изображений. Пусть каждый вход — полутоновое изображение размером . Значение каждого пикселя мы запишем одним числом, поэтому каждому изображению соответствуют четыре признака . Кроме того, будем считать, что каждое изображение относится к одному из классов: «кошка», «курица» или «собака».
Теперь нужно выбрать способ записи меток. Есть два очевидных варианта. Самая прямая идея — взять , где целые числа соответствуют классам . Это эффективный способ хранения такой информации на компьютере. Если между классами есть естественный порядок — например, при предсказании возрастной группы — то имеет смысл свести задачу к регрессии и сохранить этот порядок.
Но в общей задаче классификации порядок классов не связан с их смыслом. К счастью, статистики давно придумали простой способ записи категориальных данных: прямое кодирование (one-hot encoding). Это вектор, размерность которого равна числу классов. Компонента, соответствующая классу, равна 1, а все остальные компоненты равны 0. В нашем примере метка — трёхмерный вектор: соответствует «кошке», — «курице», — «собаке»:
3.4.2 Архитектура сети
Чтобы оценить условные вероятности для всех возможных классов, нужна модель с несколькими выходами — по одному на каждый класс. Чтобы решить задачу классификации линейной моделью, нужно столько аффинных функций, сколько выходов: каждый выход имеет собственную аффинную функцию. В нашем примере четыре признака и три возможных класса, поэтому понадобятся 12 скалярных весов (с индексами у ) и 3 скалярных смещения (с индексами у ). Для каждого входа вычислим три ненормированных предсказания (логиты) , и :
Этот процесс вычисления можно изобразить в виде нейронной сети (рис. 3.4.1). Как и линейная регрессия, softmax-регрессия — однослойная нейронная сеть. Поскольку каждый из выходов , и зависит от всех входов , , и , выходной слой softmax-регрессии тоже является полносвязным.
Рис. 3.4.1. Softmax-регрессия — однослойная нейронная сеть
Для краткости по-прежнему используем обозначения линейной алгебры: . Эта форма удобна и для математической записи, и для кода. Все веса мы собираем в матрицу размера . Для признаков данного примера выход получается умножением матрицы весов на вектор признаков с последующим прибавлением смещения .
3.4.3 Затраты параметров полносвязных слоёв
Как мы увидим в следующих главах, полносвязные слои встречаются в глубоком обучении повсеместно. Однако, как следует из названия, полносвязный слой «полностью» связан со входами и может содержать очень много обучаемых параметров. Точнее, для полносвязного слоя с входами и выходами число параметров составляет . На практике это число может оказаться непомерно большим. К счастью, стоимость преобразования входов в выходов можно снизить до , где гиперпараметр можно задавать гибко, чтобы найти баланс между экономией параметров и качеством модели (Zhang et al., 2021).
3.4.4 Операция softmax
Теперь оптимизируем параметры так, чтобы максимизировать вероятность наблюдаемых данных. Чтобы получить предсказание, зададим правило выбора, например: взять метку с наибольшей вероятностью.
Мы хотим, чтобы выход модели можно было понимать как вероятность принадлежности классу , а в качестве предсказания выбирать класс с наибольшим значением . Например, если , и равны 0.1, 0.8 и 0.1 соответственно, то мы предсказываем класс 2, в нашем примере — «курицу».
Можно ли напрямую считать ненормированные предсказания искомыми вероятностями? Нет, по двум причинам. Во-первых, сумма выходов линейного слоя ничем не ограничена, и она не обязана равняться 1. Во-вторых, в зависимости от входа выходы могут быть отрицательными. Это нарушает базовые аксиомы вероятности, о которых шла речь в разделе 2.6.
Чтобы интерпретировать выход как вероятности, нужно гарантировать, что на любых данных выход неотрицателен и в сумме равен 1. Кроме того, нужна целевая функция, которая побуждает модель точно оценивать вероятности. Например, среди всех примеров, для которых классификатор выдаёт вероятность 0.5, половина должна действительно принадлежать предсказанному классу. Это свойство называется калибровкой (calibration).
Функция softmax делает именно это. Её предложил в 1959 году социолог Дункан Люс на основе теории моделей выбора (choice model). Softmax преобразует ненормированные предсказания в неотрицательные числа с суммой 1, сохраняя при этом дифференцируемость. Для этого сначала каждое ненормированное предсказание возводится в экспоненту (это гарантирует неотрицательность), а затем каждый результат делится на сумму всех результатов (это гарантирует, что сумма равна 1):
Для всех выполняется . Поэтому можно считать корректным распределением вероятностей. Операция softmax не меняет порядка ненормированных предсказаний , а только определяет вероятности, которые получает каждый класс. Поэтому при предсказании по-прежнему можно выбирать наиболее вероятный класс:
Хотя softmax — нелинейная функция, выход softmax-регрессии по-прежнему определяется аффинным преобразованием входных признаков. Поэтому softmax-регрессия — это линейная модель (linear model).
3.4.5 Векторизация для минибатчей
Чтобы повысить эффективность вычислений и полностью загрузить GPU, векторные вычисления обычно выполняют на минибатчах. Пусть прочитан батч примеров с размерностью признаков (числом входов) и размером батча , а число выходных классов равно . Тогда признаки минибатча , веса , смещение . Векторная запись softmax-регрессии выглядит так:
По сравнению с обработкой одного примера за раз векторизация минибатча ускоряет умножение матрицы на матрицу . Поскольку каждая строка соответствует одному примеру, операцию softmax можно выполнять построчно (rowwise): для каждой строки сначала берём экспоненты всех элементов, а затем нормируем их суммой. В формуле (3.4.2) сложение выполняется по правилу broadcasting. Минибатч ненормированных предсказаний и выходных вероятностей — это матрицы размера .
3.4.6 Функция потерь
Далее нам нужна функция потерь, которая измеряет качество предсказаний. Мы будем использовать оценку максимального правдоподобия — тот же подход, что и в линейной регрессии (раздел 3.1.3).
3.4.6.1 Логарифмическое правдоподобие
Функция softmax даёт вектор , который можно интерпретировать как «условную вероятность каждого класса при заданном входе ». Например, . Пусть весь набор данных содержит примеров, где пример с индексом состоит из вектора признаков и вектора-метки прямого кодирования . Сравним предсказания с истинными значениями:
По принципу максимального правдоподобия мы максимизируем , что эквивалентно минимизации отрицательного логарифма правдоподобия:
где для любой метки и предсказания модели функция потерь имеет вид:
Функция потерь (3.4.3) обычно называется кросс-энтропийной потерей (cross-entropy loss), как будет показано ниже. Поскольку — прямое кодирование вектора длины , все слагаемые, кроме одного, обращаются в нуль. Все — предсказанные вероятности, поэтому их логарифмы никогда не превышают 0. Значит, если модель правильно предсказывает истинную метку, то есть , потери уже нельзя уменьшить. Однако на практике этого часто не добиться. Например, в наборе данных могут встречаться шумные метки (некоторые примеры размечены ошибочно), или входные признаки могут не содержать достаточно информации для идеальной классификации каждого примера.
3.4.6.2 Softmax и его производные
Поскольку softmax и связанная с ним функция потерь встречаются очень часто, полезно понимать, как они вычисляются. Подставим (3.4.1) в потерю (3.4.3) и воспользуемся определением softmax:
Найдём производную по произвольному ненормированному предсказанию :
Иными словами, производная — это разность между вероятностью, которую softmax-модель назначила классу, и тем, что произошло на самом деле (выраженным прямым кодированием метки). В этом смысле результат очень похож на то, что мы видели в регрессии, где градиент — это разность между наблюдаемым значением и оценкой . Это не случайное совпадение: для любой модели из экспоненциального семейства распределений (см. раздел приложения о математических распределениях) градиент логарифма правдоподобия выражается именно так. Это значительно упрощает вычисление градиентов на практике.
3.4.6.3 Кросс-энтропийная потеря
Теперь рассмотрим ситуацию, когда наблюдается не один исход, а целое распределение исходов. Метку можно записать в той же форме, что и раньше, только теперь это вектор вероятностей, например , а не бинарный вектор . Потерю определяем формулой (3.4.3): она представляет собой ожидаемое значение потерь по всем распределениям меток. Эта потеря называется кросс-энтропийной потерей (cross-entropy loss) и относится к самым распространённым функциям потерь в задачах классификации. Чтобы её понять, введём основы теории информации. Подробности можно найти в разделе приложения о теории информации.
3.4.7 Основы теории информации
Теория информации (information theory) изучает кодирование, декодирование, передачу информации и её наиболее краткое представление.
3.4.7.1 Энтропия
Центральная идея теории информации — количественно оценить информационное содержание данных. В теории информации эта величина называется энтропией (entropy) распределения и вычисляется по формуле:
Одна из основных теорем теории информации гласит: чтобы закодировать данные, случайно извлечённые из распределения , нужно как минимум «нат» (nat). «Нат» — аналог бита, только логарифм берётся по основанию , а не 2. Таким образом, один нат равен бита.
3.4.7.2 Информационное содержание
Какая связь между сжатием и предсказанием? Представим поток данных, который мы хотим сжать. Если каждый следующий элемент легко предсказать, такой поток легко сжать. Крайний пример: если все элементы потока одинаковы, поток очень скучен — мы всегда знаем следующий элемент, поэтому передавать ничего не нужно. Событие «следующий элемент — это XX» не несёт никакой информации.
Но если мы не можем полностью предсказать каждое событие, то иногда будем «удивляться». Клод Шеннон предложил измерять степень этого удивления информационным содержанием . Это величина для наблюдения события , которому приписана (субъективная) вероятность . Чем меньше вероятность события, тем сильнее удивление и тем больше его информационное содержание. Энтропия, определённая формулой (3.4.4), — это математическое ожидание информационного содержания при условии, что назначенные вероятности точно соответствуют процессу порождения данных.
3.4.7.3 Повторный взгляд на кросс-энтропию
Если представить энтропию как «степень удивления того, кто знает истинные вероятности», то что такое кросс-энтропия? Кросс-энтропия от к обозначается . Её можно понимать как «ожидаемое удивление наблюдателя с субъективными вероятностями , когда он видит данные, порождённые вероятностями ». Кросс-энтропия минимальна при . В этом случае кросс-энтропия от к равна .
Итак, кросс-энтропийную цель классификации можно рассматривать двумя способами: (i) максимизация правдоподобия наблюдаемых данных; (ii) минимизация удивления, необходимого для передачи метки.
3.4.8 Предсказания модели и их оценка
После обучения softmax-регрессии для любого примера можно предсказать вероятность каждого выходного класса. Обычно в качестве итогового класса берут класс с наибольшей предсказанной вероятностью. Если предсказание совпадает с фактическим классом (меткой), то оно верно. В дальнейших экспериментах качество модели мы будем оценивать по точности (accuracy) — отношению числа правильных предсказаний к общему числу предсказаний.
Резюме
- Операция softmax преобразует вектор в распределение вероятностей.
- Softmax-регрессия подходит для задач классификации: она использует распределение вероятностей по классам, которое даёт операция softmax.
- Кросс-энтропия — хорошая мера различия между двумя распределениями вероятностей: она показывает, сколько битов нужно для кодирования данных при использовании модели.
Упражнения
- Углубимся в связь между экспоненциальным семейством и softmax.
- Вычислите вторую производную функции кросс-энтропийной потери softmax .
- Вычислите дисперсию распределения, заданного , и сравните её со второй производной из предыдущего пункта.
- Предположим, что три класса имеют одинаковую вероятность, то есть вектор вероятностей равен .
- Какие проблемы возникнут, если попытаться построить для них двоичный код?
- Постройте более удачный код. Подсказка: что будет, если кодировать два независимых наблюдения? Что будет, если закодировать наблюдений совместно?
- Название softmax на самом деле не совсем точно описывает введённое отображение (хотя многие в глубоком обучении используют именно это название). Настоящий softmax определяется как .
- Докажите, что .
- Докажите, что выполняется при .
- Докажите, что для выполняется .
- Как выглядел бы soft-min?
- Обобщите это на случай более чем двух чисел.
3.5 Набор данных для классификации изображений
Набор данных MNIST (LeCun et al., 1998) — один из самых широко используемых наборов для классификации изображений, но как эталон для сравнения методов он слишком прост. Поэтому мы будем использовать похожий, но более сложный набор — Fashion-MNIST (Xiao et al., 2017).
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import gluon
import sys
d2l.use_svg_display()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torchvision import transforms
from torch.utils import data
d2l.use_svg_display()
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
d2l.use_svg_display()
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import sys
import paddle
from paddle.vision import transforms
d2l.use_svg_display()
3.5.1 Чтение набора данных
Мы можем загрузить набор Fashion-MNIST в память с помощью встроенных функций фреймворка.
MXNet:
mnist_train = gluon.data.vision.FashionMNIST(train=True)
mnist_test = gluon.data.vision.FashionMNIST(train=False)
PyTorch:
# Преобразование ToTensor переводит изображения из формата PIL в 32-битные числа
# с плавающей точкой и делит их на 255, чтобы значения всех пикселей лежали в диапазоне от 0 до 1
trans = transforms.ToTensor()
mnist_train = torchvision.datasets.FashionMNIST(
root="../data", train=True, transform=trans, download=True)
mnist_test = torchvision.datasets.FashionMNIST(
root="../data", train=False, transform=trans, download=True)
TensorFlow:
mnist_train, mnist_test = tf.keras.datasets.fashion_mnist.load_data()
PaddlePaddle:
trans = transforms.ToTensor()
mnist_train = paddle.vision.datasets.FashionMNIST(mode="train",
transform=trans)
mnist_test = paddle.vision.datasets.FashionMNIST(mode="test", transform=trans)
Набор Fashion-MNIST состоит из изображений десяти классов. Каждый класс представлен 6000 изображениями в обучающем наборе (train dataset) и 1000 изображениями в тестовом наборе (test dataset). Таким образом, обучающий и тестовый наборы содержат 60 000 и 10 000 изображений соответственно. Тестовый набор не используется для обучения, а только для оценки качества модели.
MXNet, PyTorch, PaddlePaddle:
len(mnist_train), len(mnist_test)
TensorFlow:
len(mnist_train[0]), len(mnist_test[0])
Высота и ширина каждого входного изображения составляют 28 пикселей. Набор состоит из изображений в оттенках серого, поэтому число каналов равно 1. Для краткости в этой книге форму изображения высотой пикселей и шириной пикселей будем записывать как или (, ).
mnist_train[0][0].shape
Набор Fashion-MNIST содержит 10 классов: футболка (t-shirt), брюки (trouser), пуловер (pullover), платье (dress), пальто (coat), сандалия (sandal), рубашка (shirt), кроссовок (sneaker), сумка (bag) и ботильон (ankle boot). Следующая функция преобразует числовые метки в текстовые названия классов.
def get_fashion_mnist_labels(labels): #@save
"""Возвращает текстовые метки набора Fashion-MNIST"""
text_labels = ['футболка', 'брюки', 'пуловер', 'платье', 'пальто',
'сандалия', 'рубашка', 'кроссовок', 'сумка', 'ботильон']
return [text_labels[int(i)] for i in labels]
Теперь создадим функцию, которая визуализирует эти примеры.
MXNet, TensorFlow:
def show_images(imgs, num_rows, num_cols, titles=None, scale=1.5): #@save
"""Вывод списка изображений"""
figsize = (num_cols * scale, num_rows * scale)
_, axes = d2l.plt.subplots(num_rows, num_cols, figsize=figsize)
axes = axes.flatten()
for i, (ax, img) in enumerate(zip(axes, imgs)):
ax.imshow(d2l.numpy(img))
ax.axes.get_xaxis().set_visible(False)
ax.axes.get_yaxis().set_visible(False)
if titles:
ax.set_title(titles[i])
return axes
PyTorch:
def show_images(imgs, num_rows, num_cols, titles=None, scale=1.5): #@save
"""Вывод списка изображений"""
figsize = (num_cols * scale, num_rows * scale)
_, axes = d2l.plt.subplots(num_rows, num_cols, figsize=figsize)
axes = axes.flatten()
for i, (ax, img) in enumerate(zip(axes, imgs)):
if torch.is_tensor(img):
# Тензор изображения
ax.imshow(img.numpy())
else:
# Изображение PIL
ax.imshow(img)
ax.axes.get_xaxis().set_visible(False)
ax.axes.get_yaxis().set_visible(False)
if titles:
ax.set_title(titles[i])
return axes
PaddlePaddle:
#@save
def show_images(imgs, num_rows, num_cols, titles=None, scale=1.5):
"""Вывод списка изображений"""
figsize = (num_cols * scale, num_rows * scale)
_, axes = d2l.plt.subplots(num_rows, num_cols, figsize=figsize)
axes = axes.flatten()
for i, (ax, img) in enumerate(zip(axes, imgs)):
if paddle.is_tensor(img):
# Тензор изображения
ax.imshow(img.numpy())
else:
# Изображение PIL
ax.imshow(img)
ax.axes.get_xaxis().set_visible(False)
ax.axes.get_yaxis().set_visible(False)
if titles:
ax.set_title(titles[i])
return axes
Ниже показаны изображения и соответствующие метки первых нескольких примеров обучающего набора.
MXNet:
X, y = mnist_train[:18]
print(X.shape)
show_images(X.squeeze(axis=-1), 2, 9, titles=get_fashion_mnist_labels(y));
PyTorch:
X, y = next(iter(data.DataLoader(mnist_train, batch_size=18)))
show_images(X.reshape(18, 28, 28), 2, 9, titles=get_fashion_mnist_labels(y));
TensorFlow:
X = tf.constant(mnist_train[0][:18])
y = tf.constant(mnist_train[1][:18])
show_images(X, 2, 9, titles=get_fashion_mnist_labels(y));
PaddlePaddle:
X, y = next(iter(paddle.io.DataLoader(mnist_train, batch_size=18)))
show_images(X.reshape([18, 28, 28]), 2, 9, titles=get_fashion_mnist_labels(y));
3.5.2 Чтение минибатчей
Чтобы упростить чтение обучающих и тестовых наборов, мы используем встроенные итераторы данных, а не создаём их с нуля.
Напомним, что на каждой итерации загрузчик данных читает минибатч размера batch_size.
Встроенный итератор перемешивает все примеры, поэтому минибатчи читаются без смещения.
MXNet:
batch_size = 256
def get_dataloader_workers(): #@save
"""На платформах, отличных от Windows, для чтения данных используются 4 процесса"""
return 0 if sys.platform.startswith('win') else 4
# Преобразование ToTensor переводит изображения из формата uint8 в 32-битные числа
# с плавающей точкой и делит их на 255, чтобы значения всех пикселей лежали в диапазоне от 0 до 1
transformer = gluon.data.vision.transforms.ToTensor()
train_iter = gluon.data.DataLoader(mnist_train.transform_first(transformer),
batch_size, shuffle=True,
num_workers=get_dataloader_workers())
PyTorch:
batch_size = 256
def get_dataloader_workers(): #@save
"""Для чтения данных используются 4 процесса"""
return 4
train_iter = data.DataLoader(mnist_train, batch_size, shuffle=True,
num_workers=get_dataloader_workers())
TensorFlow:
batch_size = 256
train_iter = tf.data.Dataset.from_tensor_slices(
mnist_train).batch(batch_size).shuffle(len(mnist_train[0]))
PaddlePaddle:
batch_size = 256
def get_dataloader_workers(): #@save
"""Для чтения данных используются 4 процесса"""
return 4
train_iter = paddle.io.DataLoader(dataset=mnist_train,
batch_size=batch_size,
shuffle=True,
return_list=True,
num_workers=get_dataloader_workers())
Посмотрим, сколько времени занимает чтение обучающих данных.
timer = d2l.Timer()
for X, y in train_iter:
continue
f'{timer.stop():.2f} сек'
3.5.3 Объединение всех компонентов
Теперь определим функцию load_data_fashion_mnist, которая загружает набор Fashion-MNIST и читает его.
Функция возвращает итераторы данных для обучающих и проверочных наборов.
Кроме того, она принимает необязательный параметр resize, с помощью которого можно изменить размер изображений.
MXNet:
def load_data_fashion_mnist(batch_size, resize=None): #@save
"""Загрузка набора Fashion-MNIST и чтение его в память"""
dataset = gluon.data.vision
trans = [dataset.transforms.ToTensor()]
if resize:
trans.insert(0, dataset.transforms.Resize(resize))
trans = dataset.transforms.Compose(trans)
mnist_train = dataset.FashionMNIST(train=True).transform_first(trans)
mnist_test = dataset.FashionMNIST(train=False).transform_first(trans)
return (gluon.data.DataLoader(mnist_train, batch_size, shuffle=True,
num_workers=get_dataloader_workers()),
gluon.data.DataLoader(mnist_test, batch_size, shuffle=False,
num_workers=get_dataloader_workers()))
PyTorch:
def load_data_fashion_mnist(batch_size, resize=None): #@save
"""Загрузка набора Fashion-MNIST и чтение его в память"""
trans = [transforms.ToTensor()]
if resize:
trans.insert(0, transforms.Resize(resize))
trans = transforms.Compose(trans)
mnist_train = torchvision.datasets.FashionMNIST(
root="../data", train=True, transform=trans, download=True)
mnist_test = torchvision.datasets.FashionMNIST(
root="../data", train=False, transform=trans, download=True)
return (data.DataLoader(mnist_train, batch_size, shuffle=True,
num_workers=get_dataloader_workers()),
data.DataLoader(mnist_test, batch_size, shuffle=False,
num_workers=get_dataloader_workers()))
TensorFlow:
def load_data_fashion_mnist(batch_size, resize=None): #@save
"""Загрузка набора Fashion-MNIST и чтение его в память"""
mnist_train, mnist_test = tf.keras.datasets.fashion_mnist.load_data()
# Все значения делятся на 255, чтобы значения пикселей лежали в диапазоне от 0 до 1,
# в конец добавляется измерение батча, а метки приводятся к типу int32.
process = lambda X, y: (tf.expand_dims(X, axis=3) / 255,
tf.cast(y, dtype='int32'))
resize_fn = lambda X, y: (
tf.image.resize_with_pad(X, resize, resize) if resize else X, y)
return (
tf.data.Dataset.from_tensor_slices(process(*mnist_train)).batch(
batch_size).shuffle(len(mnist_train[0])).map(resize_fn),
tf.data.Dataset.from_tensor_slices(process(*mnist_test)).batch(
batch_size).map(resize_fn))
PaddlePaddle:
#@save
def load_data_fashion_mnist(batch_size, resize=None):
"""Загрузка набора Fashion-MNIST и чтение его в память"""
trans = [transforms.ToTensor()]
if resize:
trans.insert(0, transforms.Resize(resize))
trans = transforms.Compose(trans)
mnist_train = paddle.vision.datasets.FashionMNIST(mode="train",
transform=trans)
mnist_test = paddle.vision.datasets.FashionMNIST(mode="test",
transform=trans)
return (paddle.io.DataLoader(dataset=mnist_train,
batch_size=batch_size,
shuffle=True,
return_list=True,
num_workers=get_dataloader_workers()),
paddle.io.DataLoader(dataset=mnist_test,
batch_size=batch_size,
return_list=True,
shuffle=True,
num_workers=get_dataloader_workers()))
Проверим работу функции load_data_fashion_mnist с изменением размера изображений, передав параметр resize.
train_iter, test_iter = load_data_fashion_mnist(32, resize=64)
for X, y in train_iter:
print(X.shape, X.dtype, y.shape, y.dtype)
break
Теперь всё готово к работе с набором Fashion-MNIST: в следующих разделах мы будем использовать его для оценки различных алгоритмов классификации.
Резюме
- Fashion-MNIST — набор данных с изображениями одежды десяти классов. Мы будем использовать его в следующих главах для оценки различных алгоритмов классификации.
- Форму изображения высотой и шириной пикселей будем записывать как или (, ).
- Итераторы данных — ключевой компонент для высокой производительности. Хорошо реализованные итераторы, использующие возможности высокопроизводительных вычислений, не дают замедлять обучение.
Упражнения
- Повлияет ли уменьшение
batch_size(например, до 1) на производительность чтения данных? - Производительность итераторов данных очень важна. Достаточно ли быстра текущая реализация? Исследуйте различные способы её улучшить.
- Посмотрите онлайн-документацию API фреймворка. Какие ещё наборы данных доступны?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
3.6 Softmax-регрессия с нуля
Так же как мы реализовали линейную регрессию с нуля, softmax-регрессию тоже полезно реализовать самостоятельно: это важная основа, поэтому стоит знать детали её реализации. В этом разделе мы используем набор Fashion-MNIST, который ввели в разделе 3.5, и зададим размер батча для итератора данных равным 256.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, np, npx, gluon
from IPython import display
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from IPython import display
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
from IPython import display
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from IPython import display
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
3.6.1 Инициализация параметров модели
Как и в примере с линейной регрессией, каждый пример здесь представляется вектором фиксированной длины. Каждое исходное изображение из набора данных имеет размер . В этом разделе мы разворачиваем каждое изображение в вектор длины 784. В следующих главах мы поговорим о признаках, которые учитывают пространственную структуру изображения, а пока будем рассматривать каждую позицию пикселя как отдельный признак.
Напомним, что в softmax-регрессии число выходов равно числу классов.
Поскольку в нашем наборе данных 10 классов, размерность выхода сети равна 10.
Поэтому веса образуют матрицу размера , а смещение — строку размера .
Как и в линейной регрессии, веса W инициализируем из нормального распределения, а смещение b — нулями.
MXNet:
num_inputs = 784
num_outputs = 10
W = np.random.normal(0, 0.01, (num_inputs, num_outputs))
b = np.zeros(num_outputs)
W.attach_grad()
b.attach_grad()
PyTorch:
num_inputs = 784
num_outputs = 10
W = torch.normal(0, 0.01, size=(num_inputs, num_outputs), requires_grad=True)
b = torch.zeros(num_outputs, requires_grad=True)
TensorFlow:
num_inputs = 784
num_outputs = 10
W = tf.Variable(tf.random.normal(shape=(num_inputs, num_outputs),
mean=0, stddev=0.01))
b = tf.Variable(tf.zeros(num_outputs))
PaddlePaddle:
num_inputs = 784
num_outputs = 10
W = paddle.normal(0, 0.01, shape=(num_inputs, num_outputs))
b = paddle.zeros(shape=(num_outputs,))
W.stop_gradient=False
b.stop_gradient=False
3.6.2 Определение операции softmax
Прежде чем реализовать модель softmax-регрессии, кратко напомним, как оператор sum работает вдоль заданного измерения тензора.
Как описано в разделах 2.3.6 и 2.3.6.1, для матрицы X можно просуммировать все элементы (по умолчанию).
Также можно суммировать только по одной оси: по столбцам (ось 0) или по строкам (ось 1).
Если X — тензор формы (2, 3) и мы суммируем по столбцам, то результатом будет вектор формы (3,).
При вызове оператора sum можно указать, что нужно сохранить количество осей исходного тензора и не схлопывать суммируемое измерение.
Тогда получится двумерный тензор формы (1, 3).
PyTorch, PaddlePaddle:
X = d2l.tensor([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]])
d2l.reduce_sum(X, 0, keepdim=True), d2l.reduce_sum(X, 1, keepdim=True)
MXNet, TensorFlow:
X = d2l.tensor([[1.0, 2.0, 3.0], [4.0, 5.0, 6.0]])
d2l.reduce_sum(X, 0, keepdims=True), d2l.reduce_sum(X, 1, keepdims=True)
Напомним, что реализация softmax состоит из трёх шагов:
- возведение каждого элемента в экспоненту (с помощью
exp); - суммирование по каждой строке (каждый пример в минибатче — это строка), что даёт нормирующую константу для каждого примера;
- деление каждой строки на её нормирующую константу, чтобы сумма элементов строки стала равна 1.
Прежде чем смотреть на код, запишем формулу:
Знаменатель, или нормирующая константа, иногда называется статистической суммой (partition function), а её логарифм — логарифмом статистической суммы. Это название пришло из статистической физики, где такое уравнение описывает распределение совокупности частиц.
MXNet, TensorFlow:
def softmax(X):
X_exp = d2l.exp(X)
partition = d2l.reduce_sum(X_exp, 1, keepdims=True)
return X_exp / partition # Здесь используется broadcasting
PyTorch, PaddlePaddle:
def softmax(X):
X_exp = d2l.exp(X)
partition = d2l.reduce_sum(X_exp, 1, keepdim=True)
return X_exp / partition # Здесь используется broadcasting
Как видно из кода, для любого случайного входа каждый элемент становится неотрицательным числом. Кроме того, по законам теории вероятностей сумма каждой строки равна 1.
MXNet, PyTorch, PaddlePaddle:
X = d2l.normal(0, 1, (2, 5))
X_prob = softmax(X)
X_prob, d2l.reduce_sum(X_prob, 1)
TensorFlow:
X = tf.random.normal((2, 5), 0, 1)
X_prob = softmax(X)
X_prob, tf.reduce_sum(X_prob, 1)
Заметим, что хотя математически всё выглядит корректно, наша реализация недостаточно аккуратна. Очень большие или очень маленькие элементы матрицы могут вызвать численное переполнение или антипереполнение (underflow), но мы никак этого не предотвращаем.
3.6.3 Определение модели
После определения операции softmax мы можем реализовать модель softmax-регрессии.
В приведённом ниже коде описано, как входные данные отображаются в выход сети.
Обратите внимание: перед передачей данных в модель мы используем функцию reshape, чтобы развернуть каждое исходное изображение в вектор.
def net(X):
return softmax(d2l.matmul(d2l.reshape(X, (-1, W.shape[0])), W) + b)
3.6.4 Определение функции потерь
Далее реализуем функцию кросс-энтропийной потери, введённую в разделе 3.4. Это, вероятно, самая распространённая функция потерь в глубоком обучении, поскольку задач классификации гораздо больше, чем задач регрессии.
Напомним, что кросс-энтропия — это отрицательный логарифм предсказанной вероятности истинной метки.
Вместо того чтобы перебирать предсказания циклом for в Python (что обычно неэффективно), мы выберем нужные элементы с помощью операции индексирования.
Ниже создадим данные y_hat с предсказанными вероятностями для 2 примеров в 3 классах и их метки y.
По y видно, что для первого примера правильным является первый класс, а для второго — третий.
Используя y как индексы для y_hat, выберем вероятность первого класса для первого примера и вероятность третьего класса для второго примера.
MXNet, PyTorch, PaddlePaddle:
y = d2l.tensor([0, 2])
y_hat = d2l.tensor([[0.1, 0.3, 0.6], [0.3, 0.2, 0.5]])
y_hat[[0, 1], y]
TensorFlow:
y_hat = tf.constant([[0.1, 0.3, 0.6], [0.3, 0.2, 0.5]])
y = tf.constant([0, 2])
tf.boolean_mask(y_hat, tf.one_hot(y, depth=y_hat.shape[-1]))
Теперь реализация кросс-энтропийной потери занимает всего одну строку кода.
MXNet, PyTorch:
def cross_entropy(y_hat, y):
return - d2l.log(y_hat[range(len(y_hat)), y])
cross_entropy(y_hat, y)
TensorFlow:
def cross_entropy(y_hat, y):
return -tf.math.log(tf.boolean_mask(
y_hat, tf.one_hot(y, depth=y_hat.shape[-1])))
cross_entropy(y_hat, y)
PaddlePaddle:
def cross_entropy(y_hat, y):
return - paddle.log(y_hat[[i for i in range(len(y_hat))], y.squeeze()])
cross_entropy(y_hat, y)
3.6.5 Классификационная точность
Для заданного распределения вероятностей y_hat, когда нужно выдать жёсткое предсказание (hard prediction), обычно выбирают класс с наибольшей вероятностью.
Многие приложения требуют именно такого выбора.
Например, Gmail должен отнести письмо к одной из категорий: «Основные», «Социальные», «Обновления» или «Форумы».
Gmail, возможно, оценивает вероятности внутри себя, но в итоге ему всё равно нужно выбрать один класс.
Предсказание считается правильным, если оно совпадает с меткой y.
Классификационная точность (accuracy) — это отношение числа правильных предсказаний к общему числу предсказаний.
Напрямую оптимизировать точность может быть трудно, потому что она не дифференцируема.
Тем не менее точность — это обычно та мера качества, которая нас интересует больше всего, и при обучении классификаторов за ней почти всегда следят.
Чтобы вычислить точность, выполним следующие действия.
Во-первых, если y_hat — матрица, то предполагаем, что во втором измерении хранятся оценки каждого класса.
Мы используем argmax, чтобы получить индекс максимального элемента в каждой строке и определить предсказанный класс.
Затем сравниваем предсказанные классы с истинными значениями y.
Поскольку оператор равенства == чувствителен к типу данных, приводим тип y_hat к типу y.
В результате получаем тензор из нулей (неверно) и единиц (верно).
Наконец, суммируем его и получаем число правильных предсказаний.
def accuracy(y_hat, y): #@save
"""Вычисляет количество правильных предсказаний"""
if len(y_hat.shape) > 1 and y_hat.shape[1] > 1:
y_hat = d2l.argmax(y_hat, axis=1)
cmp = d2l.astype(y_hat, y.dtype) == y
return float(d2l.reduce_sum(d2l.astype(cmp, y.dtype)))
Ниже приведена версия для PaddlePaddle.
PaddlePaddle:
#@save
def accuracy(y_hat, y):
"""Вычисляет количество правильных предсказаний"""
if len(y_hat.shape) > 1 and y_hat.shape[1] > 1:
y_hat = y_hat.argmax(axis=1)
if len(y_hat.shape) < len(y.shape):
cmp = y_hat.astype(y.dtype) == y.squeeze()
else:
cmp = y_hat.astype(y.dtype) == y
return float(cmp.astype(y.dtype).sum())
Продолжим использовать переменные y_hat и y, определённые выше, как предсказанное распределение вероятностей и метки.
Первый пример получает предсказанный класс 2 (максимальный элемент строки равен 0.6 и стоит на индексе 2), что не совпадает с истинной меткой 0.
Второй пример получает предсказанный класс 2 (максимальный элемент строки равен 0.5 и стоит на индексе 2), что совпадает с истинной меткой 2.
Итого классификационная точность для этих двух примеров равна 0.5.
accuracy(y_hat, y) / len(y)
Аналогично, для любого набора данных, доступного через итератор data_iter, можно вычислить точность произвольной модели net.
MXNet, TensorFlow:
def evaluate_accuracy(net, data_iter): #@save
"""Вычисляет точность модели на заданном наборе данных"""
metric = Accumulator(2) # Количество правильных предсказаний, общее количество предсказаний
for X, y in data_iter:
metric.add(accuracy(net(X), y), d2l.size(y))
return metric[0] / metric[1]
PyTorch:
def evaluate_accuracy(net, data_iter): #@save
"""Вычисляет точность модели на заданном наборе данных"""
if isinstance(net, torch.nn.Module):
net.eval() # Переводим модель в режим оценки
metric = Accumulator(2) # Количество правильных предсказаний, общее количество предсказаний
with torch.no_grad():
for X, y in data_iter:
metric.add(accuracy(net(X), y), d2l.size(y))
return metric[0] / metric[1]
PaddlePaddle:
#@save
def evaluate_accuracy(net, data_iter):
"""Вычисляет точность модели на заданном наборе данных"""
if isinstance(net, paddle.nn.Layer):
net.eval() # Переводим модель в режим оценки
metric = Accumulator(2) # Количество правильных предсказаний, общее количество предсказаний
with paddle.no_grad():
for X, y in data_iter:
metric.add(accuracy(net(X), y), d2l.size(y))
return metric[0] / metric[1]
Здесь мы определяем вспомогательный класс Accumulator, который накапливает суммы нескольких переменных.
В функции evaluate_accuracy в экземпляре Accumulator создаются 2 переменные: одна хранит количество правильных предсказаний, другая — общее количество предсказаний.
Обе переменные накапливаются по мере прохода по набору данных.
class Accumulator: #@save
"""Накопление сумм по n переменным"""
def __init__(self, n):
self.data = [0.0] * n
def add(self, *args):
self.data = [a + float(b) for a, b in zip(self.data, args)]
def reset(self):
self.data = [0.0] * len(self.data)
def __getitem__(self, idx):
return self.data[idx]
Поскольку модель net инициализирована случайными весами, её точность должна быть близка к случайному угадыванию.
Например, при 10 классах точность равна 0.1.
evaluate_accuracy(net, test_iter)
3.6.6 Обучение
Код обучения softmax-регрессии должен выглядеть очень знакомо, если мы вспомним реализацию линейной регрессии в разделе 3.2.
Здесь мы переработаем процесс обучения так, чтобы его можно было повторно использовать.
Сначала определим функцию, которая обучает модель на одной эпохе.
Обратите внимание, что updater — это функция обновления параметров модели, которая принимает размер батча в качестве аргумента.
Это может быть функция d2l.sgd или встроенная оптимизационная функция фреймворка.
MXNet:
def train_epoch_ch3(net, train_iter, loss, updater): #@save
"""Обучает модель в течение одной эпохи (определение см. в главе 3)"""
# Суммарные потери на обучении, суммарная точность на обучении, число примеров
metric = Accumulator(3)
if isinstance(updater, gluon.Trainer):
updater = updater.step
for X, y in train_iter:
# Вычисляем градиенты и обновляем параметры
with autograd.record():
y_hat = net(X)
l = loss(y_hat, y)
l.backward()
updater(X.shape[0])
metric.add(float(l.sum()), accuracy(y_hat, y), y.size)
# Возвращаем потери на обучении и точность на обучении
return metric[0] / metric[2], metric[1] / metric[2]
PyTorch:
def train_epoch_ch3(net, train_iter, loss, updater): #@save
"""Обучает модель в течение одной эпохи (определение см. в главе 3)"""
# Переводим модель в режим обучения
if isinstance(net, torch.nn.Module):
net.train()
# Суммарные потери на обучении, суммарная точность на обучении, число примеров
metric = Accumulator(3)
for X, y in train_iter:
# Вычисляем градиенты и обновляем параметры
y_hat = net(X)
l = loss(y_hat, y)
if isinstance(updater, torch.optim.Optimizer):
# Используем встроенный в PyTorch оптимизатор и функцию потерь
updater.zero_grad()
l.mean().backward()
updater.step()
else:
# Используем самописные оптимизатор и функцию потерь
l.sum().backward()
updater(X.shape[0])
metric.add(float(l.sum()), accuracy(y_hat, y), y.numel())
# Возвращаем потери на обучении и точность на обучении
return metric[0] / metric[2], metric[1] / metric[2]
TensorFlow:
def train_epoch_ch3(net, train_iter, loss, updater): #@save
"""Обучает модель в течение одной эпохи (определение см. в главе 3)"""
# Суммарные потери на обучении, суммарная точность на обучении, число примеров
metric = Accumulator(3)
for X, y in train_iter:
# Вычисляем градиенты и обновляем параметры
with tf.GradientTape() as tape:
y_hat = net(X)
# Встроенные в Keras функции потерь принимают аргументы в порядке (метки, предсказания),
# это отличается от реализаций, которые мы используем в этой книге.
# Здесь реализация принимает (предсказания, метки), например описанная выше «кросс-энтропия»
if isinstance(loss, tf.keras.losses.Loss):
l = loss(y, y_hat)
else:
l = loss(y_hat, y)
if isinstance(updater, tf.keras.optimizers.Optimizer):
params = net.trainable_variables
grads = tape.gradient(l, params)
updater.apply_gradients(zip(grads, params))
else:
updater(X.shape[0], tape.gradient(l, updater.params))
# Функции потерь Keras по умолчанию возвращают среднюю потерю по батчу
l_sum = l * float(tf.size(y)) if isinstance(
loss, tf.keras.losses.Loss) else tf.reduce_sum(l)
metric.add(l_sum, accuracy(y_hat, y), tf.size(y))
# Возвращаем потери на обучении и точность на обучении
return metric[0] / metric[2], metric[1] / metric[2]
PaddlePaddle:
#@save
def train_epoch_ch3(net, train_iter, loss, updater):
"""Обучает модель в течение одной эпохи (определение см. в главе 3)"""
# Переводим модель в режим обучения
if isinstance(net, paddle.nn.Layer):
net.train()
# Суммарные потери на обучении, суммарная точность на обучении, число примеров
metric = Accumulator(3)
for X, y in train_iter:
# Вычисляем градиенты и обновляем параметры
y_hat = net(X)
l = loss(y_hat, y)
if isinstance(updater, paddle.optimizer.Optimizer):
# Используем встроенный в PaddlePaddle оптимизатор и функцию потерь
updater.clear_grad()
l.mean().backward()
updater.step()
else:
# Используем самописные оптимизатор и функцию потерь
l.sum().backward()
updater(X.shape[0])
metric.add(float(l.sum()), accuracy(y_hat, y), y.numel())
return metric[0] / metric[2], metric[1] / metric[2]
Прежде чем показать реализацию функции обучения, определим вспомогательный класс Animator для рисования данных в виде анимации.
Это упростит код в остальных разделах книги.
class Animator: #@save
"""Рисование данных в анимации"""
def __init__(self, xlabel=None, ylabel=None, legend=None, xlim=None,
ylim=None, xscale='linear', yscale='linear',
fmts=('-', 'm--', 'g-.', 'r:'), nrows=1, ncols=1,
figsize=(3.5, 2.5)):
# Поэтапно рисуем несколько линий
if legend is None:
legend = []
d2l.use_svg_display()
self.fig, self.axes = d2l.plt.subplots(nrows, ncols, figsize=figsize)
if nrows * ncols == 1:
self.axes = [self.axes, ]
# Используем lambda-функцию, чтобы зафиксировать аргументы
self.config_axes = lambda: d2l.set_axes(
self.axes[0], xlabel, ylabel, xlim, ylim, xscale, yscale, legend)
self.X, self.Y, self.fmts = None, None, fmts
def add(self, x, y):
# Добавляем на график несколько точек данных
if not hasattr(y, "__len__"):
y = [y]
n = len(y)
if not hasattr(x, "__len__"):
x = [x] * n
if not self.X:
self.X = [[] for _ in range(n)]
if not self.Y:
self.Y = [[] for _ in range(n)]
for i, (a, b) in enumerate(zip(x, y)):
if a is not None and b is not None:
self.X[i].append(a)
self.Y[i].append(b)
self.axes[0].cla()
for x, y, fmt in zip(self.X, self.Y, self.fmts):
self.axes[0].plot(x, y, fmt)
self.config_axes()
display.display(self.fig)
display.clear_output(wait=True)
Далее реализуем функцию обучения train_ch3: она обучает модель net на данных из train_iter и выполняет несколько эпох (число задаётся параметром num_epochs).
В конце каждой эпохи модель оценивается на тестовых данных из test_iter.
Ход обучения визуализируем с помощью класса Animator.
def train_ch3(net, train_iter, test_iter, loss, num_epochs, updater): #@save
"""Обучает модель (определение см. в главе 3)"""
animator = Animator(xlabel='epoch', xlim=[1, num_epochs], ylim=[0.3, 0.9],
legend=['train loss', 'train acc', 'test acc'])
for epoch in range(num_epochs):
train_metrics = train_epoch_ch3(net, train_iter, loss, updater)
test_acc = evaluate_accuracy(net, test_iter)
animator.add(epoch + 1, train_metrics + (test_acc,))
train_loss, train_acc = train_metrics
assert train_loss < 0.5, train_loss
assert train_acc <= 1 and train_acc > 0.7, train_acc
assert test_acc <= 1 and test_acc > 0.7, test_acc
Для реализации с нуля мы используем определённый в разделе 3.2 минибатчевый стохастический градиентный спуск для оптимизации функции потерь модели, скорость обучения установим равной 0.1.
MXNet, PyTorch, PaddlePaddle:
lr = 0.1
def updater(batch_size):
return d2l.sgd([W, b], lr, batch_size)
TensorFlow:
class Updater(): #@save
"""Обновление параметров методом минибатчевого стохастического градиентного спуска"""
def __init__(self, params, lr):
self.params = params
self.lr = lr
def __call__(self, batch_size, grads):
d2l.sgd(self.params, grads, self.lr, batch_size)
updater = Updater([W, b], lr=0.1)
Теперь обучим модель за 10 эпох.
Обратите внимание: число эпох (num_epochs) и скорость обучения (lr) — настраиваемые гиперпараметры.
Изменяя их значения, можно повысить точность классификации модели.
num_epochs = 10
train_ch3(net, train_iter, test_iter, cross_entropy, num_epochs, updater)
3.6.7 Предсказание
Теперь, когда обучение завершено, модель готова предсказывать классы изображений. Для набора изображений сравним их истинные метки (первая строка текстового вывода) с предсказаниями модели (вторая строка текстового вывода).
def predict_ch3(net, test_iter, n=6): #@save
"""Предсказывает метки (определение см. в главе 3)"""
for X, y in test_iter:
break
trues = d2l.get_fashion_mnist_labels(y)
preds = d2l.get_fashion_mnist_labels(d2l.argmax(net(X), axis=1))
titles = [true +'\n' + pred for true, pred in zip(trues, preds)]
d2l.show_images(
d2l.reshape(X[0:n], (n, 28, 28)), 1, n, titles=titles[0:n])
predict_ch3(net, test_iter)
Резюме
- С помощью softmax-регрессии можно обучать модели многоклассовой классификации.
- Обучение softmax-регрессии очень похоже на обучение линейной регрессии: сначала читаем данные, затем определяем модель и функцию потерь, после чего обучаем модель с помощью алгоритма оптимизации. Большинство распространённых моделей глубокого обучения имеют похожий процесс обучения.
Упражнения
- В этом разделе функция
softmaxреализована напрямую по математическому определению операции softmax. Какие проблемы это может вызвать? Подсказка: попробуйте вычислить величину . - Функция
cross_entropyв этом разделе реализована по определению кросс-энтропийной потери. Что в ней может быть не так? Подсказка: подумайте, на какой области определён логарифм. - Предложите решения для двух предыдущих проблем.
- Всегда ли оптимально возвращать класс с наибольшей вероятностью? Например, допустимо ли так поступать в медицинской диагностике?
- Предположим, мы используем softmax-регрессию, чтобы предсказывать следующее слово. Какие проблемы может создать слишком большое число возможных слов?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
3.7 Softmax-регрессия: краткая реализация
В разделе 3.3 мы убедились, что высокоуровневый API фреймворков упрощает реализацию линейной регрессии. Точно так же с помощью высокоуровневого API удобно реализовать и softmax-регрессию. В этом разделе, как и в разделе 3.6, мы продолжаем работать с набором Fashion-MNIST и сохраняем размер батча равным 256.
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, init, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
3.7.1 Инициализация параметров модели
Как описано в разделе 3.4, выходной слой softmax-регрессии — полносвязный слой.
Поэтому для реализации модели достаточно добавить в Sequential один полносвязный слой с 10 выходами.
Здесь Sequential формально тоже не нужен, но он служит основой для построения глубоких моделей.
Веса по-прежнему инициализируем случайными значениями из нормального распределения со средним 0 и стандартным отклонением 0.01.
MXNet:
net = nn.Sequential()
net.add(nn.Dense(10))
net.initialize(init.Normal(sigma=0.01))
PyTorch:
# PyTorch не меняет форму входных данных неявно. Поэтому перед линейным слоем
# мы определяем слой Flatten, который приводит входную форму сети к нужному виду
net = nn.Sequential(nn.Flatten(), nn.Linear(784, 10))
def init_weights(m):
if type(m) == nn.Linear:
nn.init.normal_(m.weight, std=0.01)
net.apply(init_weights);
TensorFlow:
net = tf.keras.models.Sequential()
net.add(tf.keras.layers.Flatten(input_shape=(28, 28)))
weight_initializer = tf.keras.initializers.RandomNormal(mean=0.0, stddev=0.01)
net.add(tf.keras.layers.Dense(10, kernel_initializer=weight_initializer))
PaddlePaddle:
net = nn.Sequential(nn.Flatten(), nn.Linear(784, 10))
def init_weights(m):
if type(m) == nn.Linear:
nn.initializer.Normal(m.weight, std=0.01)
net.apply(init_weights);
3.7.2 Переосмысление реализации softmax
В примере из раздела 3.6 мы сначала вычисляли выход модели, а затем передавали его в кросс-энтропийную потерю. С математической точки зрения это вполне корректно. Однако с вычислительной точки зрения экспоненты могут создавать проблемы с численной стабильностью.
Напомним, что softmax задаётся формулой , где — предсказанное распределение вероятностей, а — -й элемент ненормированного предсказания .
Если некоторые очень велики, то может превысить максимальное число, которое допускает тип данных, — возникает переполнение (overflow).
Тогда числитель или знаменатель становится равным inf (бесконечности), и в итоге получаем , равные 0, inf или nan (не число).
В таких случаях корректное значение кросс-энтропии вычислить невозможно.
Один из приёмов решения этой проблемы: перед вычислением softmax вычесть из всех величину . Видно, что сдвиг всех на одну и ту же константу не меняет результат softmax:
После вычитания и нормировки некоторые величины могут иметь большие по модулю отрицательные значения.
Из-за ограниченной точности окажется очень близким к нулю, то есть возникнет антипереполнение (underflow).
Эти значения могут округлиться до нуля, так что станет равным нулю, а — -inf.
После нескольких шагов обратного распространения мы можем получить целый экран неприятных nan.
Хотя мы вычисляем экспоненты, в итоге в кросс-энтропийной потере берётся их логарифм. Поэтому, объединив softmax и кросс-энтропию, можно избежать проблем численной стабильности при обратном распространении. Как видно из следующих равенств, можно не вычислять , а сразу использовать , поскольку сокращается:
Традиционная функция softmax по-прежнему нужна, если мы хотим оценивать вероятности, которые выдаёт модель. Однако в функцию потерь мы передаём не вероятности softmax, а ненормированные предсказания: softmax и его логарифм вычисляются внутри кросс-энтропийной потери одновременно. Это разумный приём, родственный «трюку LogSumExp».
MXNet:
loss = gluon.loss.SoftmaxCrossEntropyLoss()
PyTorch, PaddlePaddle:
loss = nn.CrossEntropyLoss(reduction='none')
TensorFlow:
loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)
3.7.3 Алгоритм оптимизации
Здесь используем минибатчевый стохастический градиентный спуск со скоростью обучения 0.1. Это тот же алгоритм, что и в примере линейной регрессии, что показывает универсальность оптимизаторов.
MXNet:
trainer = gluon.Trainer(net.collect_params(), 'sgd', {'learning_rate': 0.1})
PyTorch:
trainer = torch.optim.SGD(net.parameters(), lr=0.1)
TensorFlow:
trainer = tf.keras.optimizers.SGD(learning_rate=.1)
PaddlePaddle:
trainer = paddle.optimizer.SGD(learning_rate=0.1, parameters=net.parameters())
3.7.4 Обучение
Далее вызываем функцию обучения, определённую в разделе 3.6, и обучаем модель.
num_epochs = 10
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
Как и раньше, алгоритм сходится к довольно высокой точности, а код теперь заметно короче.
Резюме
- С помощью высокоуровневого API фреймворков softmax-регрессию можно реализовать значительно короче.
- С вычислительной точки зрения реализация softmax-регрессии довольно сложна. Во многих случаях фреймворки дополнительно принимают меры предосторожности сверх известных приёмов, чтобы обеспечить численную стабильность. Это избавляет нас от ловушек, которые возникают на практике, когда модели пишутся с нуля.
Упражнения
- Попробуйте подобрать гиперпараметры, например размер батча, число эпох и скорость обучения, и посмотрите, как меняются результаты.
- Увеличьте число эпох. Почему через некоторое время точность на тестовых данных начинает снижаться? Как можно решить эту проблему?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- LeCun, Y., Bottou, L., Bengio, Y., & Haffner, P. (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278–2324.
- Russell, S. J., & Norvig, P. (2016). Artificial intelligence: A modern approach. Pearson Education.
- Xiao, H., Rasul, K., & Vollgraf, R. (2017). Fashion-MNIST: A novel image dataset for benchmarking machine learning algorithms. arXiv preprint arXiv:1708.07747.
- Zhang, A., Tay, Y., Zhang, S., Chan, A., Luu, A. T., Hui, S. C., & Fu, J. (2021). Beyond fully-connected layers with quaternions: Parameterization of hypercomplex multiplications with 1/n parameters. In International Conference on Learning Representations.
4. Многослойные перцептроны
В этой главе мы впервые познакомимся с по-настоящему глубокими сетями. Простейшие глубокие сети называются многослойными перцептронами. Многослойный перцептрон состоит из нескольких слоёв нейронов: каждый слой связан с предыдущим, получая от него входные данные, и с последующим, влияя на его нейроны. Когда мы обучаем модели большой ёмкости, нам грозит риск переобучения. Поэтому глава начинается с базовых понятий: переобучения, недообучения и выбора модели. Для борьбы с этими проблемами мы рассмотрим методы регуляризации, в том числе затухание весов (weight decay) и исключение (dropout). Мы также обсудим численную устойчивость и инициализацию параметров: без этого глубокие сети не удаётся успешно обучить. В конце главы изложенный материал будет применён к реальной задаче: прогнозированию цен на жильё. Вопросы вычислительной производительности, масштабируемости и эффективности мы рассмотрим в следующих главах.
4.1 Многослойный перцептрон
В главе 3 мы ввели softmax-регрессию (раздел 3.4), затем реализовали её с нуля (раздел 3.6) и с помощью высокоуровневого API (раздел 3.7). Этот алгоритм обучал классификатор распознавать 10 классов одежды по изображениям низкого разрешения. При этом мы научились подготавливать данные, преобразовывать выход в корректное распределение вероятностей и применять подходящую функцию потерь, чтобы минимизировать её по параметрам модели. Мы освоили всё это в контексте простой линейной модели. Теперь можно перейти к глубоким нейронным сетям, которым и посвящена основная часть книги.
4.1.1 Скрытые слои
В разделе 3.1.1 мы описали аффинное преобразование: линейное преобразование с добавлением смещения. Вспомним архитектуру softmax-регрессии (рис. 3.4.1). Эта модель напрямую отображает входы в выходы одним аффинным преобразованием, после чего применяет softmax. Если метки действительно связаны с входными данными аффинным преобразованием, такого подхода достаточно. Однако линейность аффинного преобразования — очень сильное допущение.
4.1.1.1 Линейные модели могут ошибаться
Например, линейность подразумевает монотонность: увеличение любого признака всегда приводит к увеличению выхода модели (если соответствующий вес положителен) или к его уменьшению (если вес отрицателен). Иногда это разумно. Допустим, мы хотим предсказать, вернёт ли человек кредит. При прочих равных заёмщик с более высоким доходом, скорее всего, вернёт кредит, чем заёмщик с более низким доходом. Но хотя доход и вероятность возврата связаны монотонно, связь эта не линейна. Рост дохода с 0 до 50 тысяч может повысить вероятность возврата сильнее, чем рост с 1 миллиона до 1 миллиона 50 тысяч. Один из способов справиться с этим — предварительно обработать данные так, чтобы линейность стала более уместной, например взять в качестве признака логарифм дохода.
Однако легко найти и примеры, где монотонность нарушается. Допустим, мы хотим предсказать смертность по температуре тела. Для людей с температурой выше 37 градусов Цельсия риск растёт вместе с температурой. А для людей с температурой ниже 37 градусов, напротив, чем выше температура, тем ниже риск. И в этом случае проблему можно решить подходящей предобработкой: например, использовать в качестве признака расстояние до 37 градусов.
Но как классифицировать изображения кошек и собак? Увеличение яркости пикселя в позиции всегда повышает (или всегда понижает) вероятность того, что на изображении собака? Опора на линейную модель неявно предполагает, что различать кошек и собак достаточно, оценивая яркость отдельных пикселей. В мире, где классы не меняются при переворачивании изображения, такой подход обречён на провал.
По сравнению с предыдущим примером здесь линейность абсурдна, и простой предобработкой с этой проблемой не справиться. Дело в том, что важность любого пикселя сложным образом зависит от его окружения, то есть от значений соседних пикселей. Нам нужно представление данных, которое учитывает взаимодействия между признаками. Линейную модель над таким представлением построить было бы разумно, но вручную вычислить его мы не умеем. В глубоких нейронных сетях мы по наблюдаемым данным одновременно обучаем и скрытое представление, и линейный предсказатель, применяемый к этому представлению.
4.1.1.2 Добавление скрытых слоёв в сеть
Ограничения линейной модели можно преодолеть, добавив в сеть один или несколько скрытых слоёв, что позволяет моделировать более общие функциональные зависимости. Самый простой способ — последовательно соединить несколько полносвязных слоёв. Каждый слой передаёт свой выход следующему, пока не будет получен окончательный выход. Первые слоёв можно считать представлением, а последний слой — линейным предсказателем. Такая архитектура обычно называется многослойным перцептроном (multilayer perceptron, MLP). Ниже многослойный перцептрон показан на схеме (рис. 4.1.1).
Рис. 4.1.1. Многослойный перцептрон с одним скрытым слоем из 5 скрытых нейронов
Этот многослойный перцептрон имеет 4 входа и 3 выхода, а его скрытый слой содержит 5 скрытых нейронов. Входной слой не выполняет вычислений, поэтому для получения выхода от сети нужно вычислить только скрытый и выходной слои. Значит, у этого многослойного перцептрона два слоя. Обратите внимание, что оба слоя полносвязные. Каждый вход влияет на каждый нейрон скрытого слоя, а каждый нейрон скрытого слоя, в свою очередь, влияет на каждый нейрон выходного слоя.
Однако, как сказано в разделе 3.4.3, число параметров у многослойного перцептрона с полносвязными слоями может оказаться непомерно большим. Даже если не менять размер входа или выхода, между экономией параметров и эффективностью модели можно найти компромисс (Zhang et al., 2021).
4.1.1.3 От линейности к нелинейности
Как и в предыдущих главах, мы представляем минибатч из примеров матрицей , где каждый пример имеет входных признаков. Для многослойного перцептрона с одним скрытым слоем из скрытых нейронов выход скрытого слоя обозначим . Его называют скрытым представлением (hidden representations). В формулах и в коде также называют переменной скрытого слоя (hidden-layer variable) или скрытой переменной (hidden variable). Поскольку скрытый и выходной слои полносвязные, есть веса скрытого слоя , смещения скрытого слоя , веса выходного слоя и смещения выходного слоя . Формально выход многослойного перцептрона с одним скрытым слоем вычисляется так:
Обратите внимание: после добавления скрытого слоя модели приходится отслеживать и обновлять дополнительные параметры. Но что мы получаем взамен? В определённой выше модели — ничего! Причина проста: скрытые нейроны заданы аффинными функциями входа, а выход (до применения softmax) — аффинная функция скрытых нейронов. Аффинная функция от аффинной функции сама является аффинной, а линейная модель, которую мы уже рассматривали, и так могла представить любую аффинную функцию.
Эту эквивалентность можно показать: при любых значениях весов скрытый слой можно «свернуть» и получить эквивалентную однослойную модель с параметрами и :
Чтобы раскрыть потенциал многослойной архитектуры, нужен ещё один ключевой элемент: после аффинного преобразования к каждому скрытому нейрону применяется нелинейная функция активации (activation function) . Выход функции активации (то есть ) называют активацией (activations). В общем случае с функцией активации невозможно свести многослойный перцептрон к линейной модели:
Каждая строка соответствует одному примеру минибатча. Для удобства записи мы определяем нелинейную функцию как действующую на вход построчно, то есть по одному примеру за раз. Так же мы записывали softmax в разделе 3.4.5. Однако функции активации, применяемые к скрытым слоям в этом разделе, обычно действуют не только построчно, но и поэлементно. Это означает, что после вычисления линейной части слоя каждую активацию можно вычислить, не глядя на значения других скрытых нейронов. Так устроено большинство функций активации.
Чтобы построить более общий многослойный перцептрон, можно продолжить наращивать такие скрытые слои, например и , слой за слоем, что даёт более выразительную модель.
4.1.1.4 Универсальная аппроксимационная теорема
Многослойный перцептрон может улавливать сложные взаимодействия входов через скрытые нейроны, активность которых зависит от значений входов. Скрытые узлы несложно настроить так, чтобы они выполняли произвольные вычисления. Например, многослойный перцептрон способен аппроксимировать любую логическую операцию над парой входов. Даже с одним скрытым слоем при достаточном числе нейронов и правильных весах можно смоделировать любую функцию, хотя на практике такую функцию выучить трудно. Нейронные сети немного похожи на язык C. Как и любой современный язык программирования, C может выразить любую вычислимую программу. Но на практике самая трудная часть — придумать программу, которая соответствует спецификации.
Более того, хотя один скрытый слой позволяет обучить любую функцию, это не значит, что нужно решать все задачи с помощью сети с одним скрытым слоем. На деле за счёт более глубоких (а не более широких) сетей многие функции можно аппроксимировать гораздо проще. Мы вернёмся к этому подробнее в последующих главах.
4.1.2 Функции активации
Функция активации (activation function) определяет, должен ли нейрон активироваться, вычисляя взвешенную сумму и добавляя смещение. Она преобразует входной сигнал в выход и является дифференцируемой операцией. Большинство функций активации нелинейны. Поскольку функции активации лежат в основе глубокого обучения, кратко рассмотрим некоторые из них.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, np, npx
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
4.1.2.1 Функция ReLU
Самая популярная функция активации — выпрямленный линейный блок (rectified linear unit, ReLU). Она проста в реализации и хорошо работает во многих задачах предсказания. ReLU задаёт очень простое нелинейное преобразование. Для элемента функция ReLU определяется как максимум из этого элемента и :
Проще говоря, ReLU оставляет только положительные элементы и обнуляет отрицательные, то есть обнуляет соответствующие активации. Чтобы получить наглядное представление, построим график функции. Как видно из графика, функция активации кусочно-линейна.
MXNet:
x = np.arange(-8.0, 8.0, 0.1)
x.attach_grad()
with autograd.record():
y = npx.relu(x)
d2l.plot(x, y, 'x', 'relu(x)', figsize=(5, 2.5))
PyTorch:
x = torch.arange(-8.0, 8.0, 0.1, requires_grad=True)
y = torch.relu(x)
d2l.plot(x.detach(), y.detach(), 'x', 'relu(x)', figsize=(5, 2.5))
TensorFlow:
x = tf.Variable(tf.range(-8.0, 8.0, 0.1), dtype=tf.float32)
y = tf.nn.relu(x)
d2l.plot(x.numpy(), y.numpy(), 'x', 'relu(x)', figsize=(5, 2.5))
PaddlePaddle:
x = paddle.arange(-8.0, 8.0, 0.1, dtype='float32')
x.stop_gradient = False
y = paddle.nn.functional.relu(x)
d2l.plot(x.detach().numpy(), y.detach().numpy(), 'x', 'relu(x)', figsize=(5, 2.5))
Производная ReLU равна 0, когда вход отрицателен, и 1, когда вход положителен. Заметим, что в точке, где вход в точности равен 0, ReLU не дифференцируема. В этом случае по умолчанию используем левую производную: при входе 0 производная равна 0. Этим случаем можно пренебречь, поскольку вход почти никогда в точности не равен 0. Здесь уместна старая поговорка: «Если тонкие граничные условия важны, мы, скорее всего, занимаемся математикой, а не инженерией». Теперь построим производную ReLU.
MXNet:
y.backward()
d2l.plot(x, x.grad, 'x', 'grad of relu', figsize=(5, 2.5))
PyTorch:
y.backward(torch.ones_like(x), retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of relu', figsize=(5, 2.5))
TensorFlow:
with tf.GradientTape() as t:
y = tf.nn.relu(x)
d2l.plot(x.numpy(), t.gradient(y, x).numpy(), 'x', 'grad of relu',
figsize=(5, 2.5))
PaddlePaddle:
y.backward(paddle.ones_like(x), retain_graph=True)
d2l.plot(x.detach().numpy(), x.grad.numpy(), 'x', 'grad of relu', figsize=(5, 2.5))
ReLU используют потому, что с ней очень хорошо работать при дифференцировании: она либо полностью пропускает параметр, либо полностью его обнуляет. Это улучшает оптимизацию и смягчает проблему затухающих градиентов, которая мешала ранним нейронным сетям (подробнее об этом позже).
Существует много вариантов ReLU, в том числе параметрический ReLU (parameterized ReLU, pReLU) (He et al., 2015). Эта версия добавляет к ReLU линейный член, поэтому часть информации проходит даже при отрицательных значениях параметра:
4.1.2.2 Сигмоидная функция
Для входа, заданного на , сигмоидная функция (sigmoid) преобразует вход в выход на интервале (0, 1). Поэтому сигмоиду часто называют функцией сжатия (squashing function): она сжимает любой вход из диапазона (-inf, inf) в значение из интервала (0, 1):
В ранних нейронных сетях учёных интересовала модель биологического нейрона, который либо «возбуждается», либо нет. Поэтому пионеры этой области, начиная с создателей искусственного нейрона Маккаллока и Питтса, работали с пороговыми элементами. Пороговый элемент выдаёт 0, если вход ниже некоторого порога, и 1, если вход превышает порог.
Когда внимание исследователей обратилось к обучению на основе градиентов, сигмоида стала естественным выбором, потому что она является гладким, дифференцируемым приближением к пороговому элементу. Когда мы хотим трактовать выход как вероятность для задачи бинарной классификации, сигмоида по-прежнему широко используется как функция активации выходного нейрона (сигмоиду можно рассматривать как частный случай softmax). Однако в скрытых слоях её применяют сейчас гораздо реже: её чаще заменяет более простая и легче обучаемая ReLU. В последующих главах о рекуррентных нейронных сетях мы опишем архитектуры, в которых сигмоидные элементы управляют потоком временной информации.
Теперь построим сигмоиду. Заметим, что при входах, близких к 0, сигмоида почти линейна.
MXNet:
with autograd.record():
y = npx.sigmoid(x)
d2l.plot(x, y, 'x', 'sigmoid(x)', figsize=(5, 2.5))
PyTorch:
y = torch.sigmoid(x)
d2l.plot(x.detach(), y.detach(), 'x', 'sigmoid(x)', figsize=(5, 2.5))
TensorFlow:
y = tf.nn.sigmoid(x)
d2l.plot(x.numpy(), y.numpy(), 'x', 'sigmoid(x)', figsize=(5, 2.5))
PaddlePaddle:
y = paddle.nn.functional.sigmoid(x)
d2l.plot(x.detach().numpy(), y.detach().numpy(), 'x', 'sigmoid(x)', figsize=(5, 2.5))
Производная сигмоиды задаётся формулой:
График производной сигмоиды показан ниже. Заметим, что при входе 0 производная сигмоиды достигает максимума 0.25; по мере удаления входа от 0 в любую сторону производная приближается к 0.
MXNet:
y.backward()
d2l.plot(x, x.grad, 'x', 'grad of sigmoid', figsize=(5, 2.5))
PyTorch:
# Очистить предыдущие градиенты
x.grad.data.zero_()
y.backward(torch.ones_like(x),retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of sigmoid', figsize=(5, 2.5))
TensorFlow:
with tf.GradientTape() as t:
y = tf.nn.sigmoid(x)
d2l.plot(x.numpy(), t.gradient(y, x).numpy(), 'x', 'grad of sigmoid',
figsize=(5, 2.5))
PaddlePaddle:
# Очистить предыдущие градиенты.
x.clear_gradient()
y.backward(paddle.ones_like(x), retain_graph=True)
d2l.plot(x.detach().numpy(), x.grad.numpy(), 'x', 'grad of sigmoid', figsize=(5, 2.5))
4.1.2.3 Функция tanh
Как и сигмоида, функция tanh (гиперболический тангенс) также сжимает вход в интервал (-1, 1). Формула функции tanh:
Теперь построим tanh. Заметим, что при входах, близких к 0, tanh почти линейна. Форма графика похожа на сигмоиду, но tanh симметрична относительно начала координат.
MXNet:
with autograd.record():
y = np.tanh(x)
d2l.plot(x, y, 'x', 'tanh(x)', figsize=(5, 2.5))
PyTorch:
y = torch.tanh(x)
d2l.plot(x.detach(), y.detach(), 'x', 'tanh(x)', figsize=(5, 2.5))
TensorFlow:
y = tf.nn.tanh(x)
d2l.plot(x.numpy(), y.numpy(), 'x', 'tanh(x)', figsize=(5, 2.5))
PaddlePaddle:
y = paddle.tanh(x)
d2l.plot(x.detach().numpy(), y.detach().numpy(), 'x', 'tanh(x)', figsize=(5, 2.5))
Производная tanh равна:
График производной tanh показан ниже. При входе, близком к 0, производная tanh близка к максимуму 1. Как и в случае сигмоиды, по мере удаления входа от 0 в любую сторону производная приближается к 0.
MXNet:
y.backward()
d2l.plot(x, x.grad, 'x', 'grad of tanh', figsize=(5, 2.5))
PyTorch:
# Очистить предыдущие градиенты
x.grad.data.zero_()
y.backward(torch.ones_like(x),retain_graph=True)
d2l.plot(x.detach(), x.grad, 'x', 'grad of tanh', figsize=(5, 2.5))
TensorFlow:
with tf.GradientTape() as t:
y = tf.nn.tanh(x)
d2l.plot(x.numpy(), t.gradient(y, x).numpy(), 'x', 'grad of tanh',
figsize=(5, 2.5))
PaddlePaddle:
# Очистить предыдущие градиенты.
x.clear_gradient()
y.backward(paddle.ones_like(x), retain_graph=True)
d2l.plot(x.detach().numpy(), x.grad.numpy(), 'x', 'grad of tanh', figsize=(5, 2.5))
Итак, мы разобрали, как сочетание нелинейных функций позволяет строить многослойные нейронные сети с большей выразительной способностью. Кстати, этих знаний уже достаточно, чтобы владеть инструментарием, которым пользовались специалисты по глубокому обучению примерно в 1990 году. В некоторых отношениях вы даже в выгодном положении по сравнению с работавшими в 1990-х: вы можете опираться на мощные открытые фреймворки глубокого обучения и строить модели в несколько строк кода, тогда как раньше обучение таких сетей требовало тысяч строк на C или Fortran.
Резюме
- Многослойный перцептрон добавляет один или несколько полносвязных скрытых слоёв между входным и выходным слоями и преобразует выход скрытых слоёв с помощью функции активации.
- Распространённые функции активации: ReLU, сигмоида и tanh.
Упражнения
- Вычислите производную функции активации pReLU.
- Докажите, что многослойный перцептрон, использующий только ReLU (или pReLU), строит непрерывную кусочно-линейную функцию.
- Докажите, что .
- Предположим, что мы применяем нелинейный элемент к минибатчу данных по одному примеру за раз. Какие проблемы это вызовет?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- He, K., Zhang, X., Ren, S., & Sun, J. (2015). Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification. Proceedings of the IEEE International Conference on Computer Vision, 1026–1034.
4.2 Реализация многослойного перцептрона с нуля
В разделе 4.1 мы описали многослойный перцептрон (MLP). Теперь попробуем реализовать его сами. Чтобы результаты было легко сравнить с результатами softmax-регрессии, полученными в разделе 3.6, мы продолжим использовать набор данных для классификации изображений Fashion-MNIST (раздел 3.5).
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, np, npx
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
4.2.1 Инициализация параметров модели
Напомним, что каждое изображение Fashion-MNIST состоит из значений яркости пикселей. Всего изображения делятся на 10 классов. Если не учитывать пространственную структуру пикселей, каждое изображение можно считать вектором из 784 входных признаков, а весь набор данных — простым набором для классификации с 10 классами. Сначала реализуем многослойный перцептрон с одним скрытым слоем, содержащим 256 скрытых нейронов. Обратите внимание, что обе эти величины можно считать гиперпараметрами. Обычно ширину слоёв выбирают равной степени двойки. Это связано с тем, как память выделяется и адресуется в аппаратном обеспечении: такой выбор часто позволяет сделать вычисления эффективнее.
Параметры представим несколькими тензорами. Обратите внимание, что для каждого слоя нужно хранить матрицу весов и вектор смещений. Как и раньше, выделяем память для градиентов функции потерь по этим параметрам.
MXNet:
num_inputs, num_outputs, num_hiddens = 784, 10, 256
W1 = np.random.normal(scale=0.01, size=(num_inputs, num_hiddens))
b1 = np.zeros(num_hiddens)
W2 = np.random.normal(scale=0.01, size=(num_hiddens, num_outputs))
b2 = np.zeros(num_outputs)
params = [W1, b1, W2, b2]
for param in params:
param.attach_grad()
PyTorch:
num_inputs, num_outputs, num_hiddens = 784, 10, 256
W1 = nn.Parameter(torch.randn(
num_inputs, num_hiddens, requires_grad=True) * 0.01)
b1 = nn.Parameter(torch.zeros(num_hiddens, requires_grad=True))
W2 = nn.Parameter(torch.randn(
num_hiddens, num_outputs, requires_grad=True) * 0.01)
b2 = nn.Parameter(torch.zeros(num_outputs, requires_grad=True))
params = [W1, b1, W2, b2]
TensorFlow:
num_inputs, num_outputs, num_hiddens = 784, 10, 256
W1 = tf.Variable(tf.random.normal(
shape=(num_inputs, num_hiddens), mean=0, stddev=0.01))
b1 = tf.Variable(tf.zeros(num_hiddens))
W2 = tf.Variable(tf.random.normal(
shape=(num_hiddens, num_outputs), mean=0, stddev=0.01))
b2 = tf.Variable(tf.zeros(num_outputs))
params = [W1, b1, W2, b2]
PaddlePaddle:
num_inputs, num_outputs, num_hiddens = 784, 10, 256
W1 = paddle.randn([num_inputs, num_hiddens]) * 0.01
W1.stop_gradient = False
b1 = paddle.zeros([num_hiddens])
b1.stop_gradient = False
W2 = paddle.randn([num_hiddens, num_outputs]) * 0.01
W2.stop_gradient = False
b2 = paddle.zeros([num_outputs])
b2.stop_gradient = False
params = [W1, b1, W2, b2]
4.2.2 Функция активации
Чтобы точно понимать устройство модели, реализуем функцию активации ReLU сами, а не вызываем встроенную функцию relu.
MXNet:
def relu(X):
return np.maximum(X, 0)
PyTorch:
def relu(X):
a = torch.zeros_like(X)
return torch.max(X, a)
TensorFlow:
def relu(X):
return tf.math.maximum(X, 0)
PaddlePaddle:
def relu(X):
a = paddle.zeros_like(X)
return paddle.maximum(X, a)
4.2.3 Модель
Поскольку пространственную структуру мы не учитываем, с помощью reshape преобразуем каждое двумерное изображение в вектор длины num_inputs.
Реализация модели занимает всего несколько строк.
MXNet:
def net(X):
X = d2l.reshape(X, (-1, num_inputs))
H = relu(np.dot(X, W1) + b1)
return np.dot(H, W2) + b2
PyTorch:
def net(X):
X = d2l.reshape(X, (-1, num_inputs))
H = relu(X@W1 + b1) # Здесь «@» означает матричное умножение
return (H@W2 + b2)
TensorFlow:
def net(X):
X = d2l.reshape(X, (-1, num_inputs))
H = relu(tf.matmul(X, W1) + b1)
return tf.matmul(H, W2) + b2
PaddlePaddle:
def net(X):
X = X.reshape((-1, num_inputs))
H = relu(X@W1 + b1) # Здесь «@» означает матричное умножение
return (H@W2 + b2)
4.2.4 Функция потерь
Softmax мы уже реализовали с нуля (раздел 3.6), поэтому здесь для softmax и функции потерь кросс-энтропии используем встроенные функции высокоуровневого API. Напомним, что мы обсуждали эти тонкие вопросы в разделе 3.7.2. Читателям, которым интересны детали реализации, рекомендуем изучить исходный код функций потерь.
MXNet:
loss = gluon.loss.SoftmaxCrossEntropyLoss()
PyTorch, PaddlePaddle:
loss = nn.CrossEntropyLoss(reduction='none')
TensorFlow:
def loss(y_hat, y):
return tf.losses.sparse_categorical_crossentropy(
y, y_hat, from_logits=True)
4.2.5 Обучение
К счастью, процесс обучения многослойного перцептрона полностью совпадает с процессом обучения softmax-регрессии.
Можно напрямую вызвать функцию train_ch3 из пакета d2l (см. раздел 3.6), задав число эпох 10 и скорость обучения 0.1.
MXNet:
num_epochs, lr = 10, 0.1
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs,
lambda batch_size: d2l.sgd(params, lr, batch_size))
PyTorch:
num_epochs, lr = 10, 0.1
updater = torch.optim.SGD(params, lr=lr)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, updater)
TensorFlow:
num_epochs, lr = 10, 0.1
updater = d2l.Updater([W1, W2, b1, b2], lr)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, updater)
PaddlePaddle:
num_epochs, lr = 10, 0.1
updater = paddle.optimizer.SGD(learning_rate=lr, parameters=params)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, updater)
Чтобы оценить обученную модель, применим её к тестовым данным.
d2l.predict_ch3(net, test_iter)
Резюме
- Реализовать простой многослойный перцептрон вручную несложно. Однако при большом числе слоёв реализация с нуля становится громоздкой (например, приходится давать имена и вести учёт параметров модели).
Упражнения
- Меняя гиперпараметр
num_hiddensпри неизменных остальных параметрах, посмотрите, как это влияет на результат. Определите наилучшее значение этого гиперпараметра. - Попробуйте добавить больше скрытых слоёв и посмотрите, как это повлияет на результат.
- Как на результат влияет скорость обучения? Какую скорость обучения нужно выбрать, чтобы получить лучший результат при неизменной архитектуре модели и остальных гиперпараметрах (включая число эпох)?
- Какой наилучший результат можно получить, оптимизируя все гиперпараметры совместно (скорость обучения, число эпох, число скрытых слоёв, число скрытых элементов в каждом слое)?
- Объясните, почему работа сразу с несколькими гиперпараметрами сложнее.
- Придумайте разумную стратегию поиска по нескольким гиперпараметрам.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
4.3 Краткая реализация многослойного перцептрона
В этом разделе мы покажем, как реализовать многослойный перцептрон короче, с помощью высокоуровневого API.
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, init, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
4.3.1 Модель
По сравнению с краткой реализацией softmax-регрессии (раздел 3.7) здесь есть одно отличие: мы добавляем два полносвязных слоя вместо одного. Первый слой — скрытый слой, который содержит 256 скрытых нейронов и использует функцию активации ReLU. Второй слой — выходной.
MXNet:
net = nn.Sequential()
net.add(nn.Dense(256, activation='relu'),
nn.Dense(10))
net.initialize(init.Normal(sigma=0.01))
PyTorch:
net = nn.Sequential(nn.Flatten(),
nn.Linear(784, 256),
nn.ReLU(),
nn.Linear(256, 10))
def init_weights(m):
if type(m) == nn.Linear:
nn.init.normal_(m.weight, std=0.01)
net.apply(init_weights);
TensorFlow:
net = tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(256, activation='relu'),
tf.keras.layers.Dense(10)])
PaddlePaddle:
net = nn.Sequential(nn.Flatten(),
nn.Linear(784, 256),
nn.ReLU(),
nn.Linear(256, 10))
for layer in net:
if type(layer) == nn.Linear:
weight_attr = paddle.framework.ParamAttr(initializer=paddle.nn.initializer.Normal(mean=0.0, std=0.01))
layer.weight_attr = weight_attr
Процесс обучения реализуется точно так же, как при реализации softmax-регрессии. Такое модульное устройство позволяет отделить всё, что относится к архитектуре модели, от остального.
MXNet:
batch_size, lr, num_epochs = 256, 0.1, 10
loss = gluon.loss.SoftmaxCrossEntropyLoss()
trainer = gluon.Trainer(net.collect_params(), 'sgd', {'learning_rate': lr})
PyTorch:
batch_size, lr, num_epochs = 256, 0.1, 10
loss = nn.CrossEntropyLoss(reduction='none')
trainer = torch.optim.SGD(net.parameters(), lr=lr)
TensorFlow:
batch_size, lr, num_epochs = 256, 0.1, 10
loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)
trainer = tf.keras.optimizers.SGD(learning_rate=lr)
PaddlePaddle:
batch_size, lr, num_epochs = 256, 0.1, 10
loss = nn.CrossEntropyLoss(reduction='none')
trainer = paddle.optimizer.SGD(parameters=net.parameters(), learning_rate=lr)
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
Резюме
- Многослойный перцептрон можно реализовать с помощью высокоуровневого API существенно короче.
- Для одной и той же задачи классификации реализация многослойного перцептрона совпадает с реализацией softmax-регрессии, за исключением того, что в многослойном перцептроне добавляется скрытый слой с функцией активации.
Упражнения
- Попробуйте добавить разное число скрытых слоёв (можно также менять скорость обучения). Какая настройка даёт лучший результат?
- Попробуйте разные функции активации. Какая из них работает лучше всего?
- Попробуйте разные способы инициализации весов. Какой метод работает лучше всего?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
4.4 Выбор модели, недообучение и переобучение
Цель специалиста по машинному обучению — находить закономерности (pattern). Но как понять, что модель действительно нашла закономерность, которая обобщается, а не просто запомнила данные? Например, мы хотим найти закономерность между генетическими данными пациентов и состоянием деменции, где метка принимает значения из множества . Поскольку генетические данные однозначно определяют каждого человека (не считая близнецов), в этой задаче возможно просто запомнить весь набор данных.
Нам не нужна модель, которая рассуждает так: «Это Боб! Я помню его! У него деменция!» Причина проста: когда модель будет развёрнута, ей придётся делать выводы о пациентах, которых она никогда не видела. Только если модель действительно выявила обобщаемую закономерность, её прогнозы будут полезны.
Формально наша цель — найти такие закономерности, которые отражают свойства генеральной совокупности, из которой взят обучающий набор. Если это удаётся, модель может оценивать риск даже для людей, которых она никогда не встречала. Как находить закономерности, которые можно обобщать, — фундаментальный вопрос машинного обучения.
Трудность в том, что при обучении модели мы видим лишь небольшую часть данных. Крупнейший открытый набор изображений содержит около миллиона изображений. Но чаще всего мы учимся на тысячах или десятках тысяч примеров. В крупной больничной системе могут быть доступны сотни тысяч медицинских карт. Работая с ограниченной выборкой, можно столкнуться с такой ситуацией: когда собрано больше данных, выясняется, что ранее найденная очевидная связь не выполняется.
Явление, при котором модель описывает обучающие данные лучше, чем реальную закономерность в генеральной совокупности, называют переобучением (overfitting), а методы борьбы с ним — регуляризацией (regularization). В предыдущих главах некоторые читатели, возможно, уже наблюдали переобучение, экспериментируя с набором Fashion-MNIST. Если менять архитектуру модели или гиперпараметры, то при достаточном числе нейронов, слоёв и эпох обучения модель в конце концов может достичь идеальной точности на обучающем наборе, хотя точность на тестовых данных при этом падает.
4.4.1 Ошибка обучения и ошибка обобщения
Чтобы подробнее разобрать это явление, нужно понимать ошибку обучения и ошибку обобщения. Ошибка обучения (training error) — это ошибка модели, вычисленная на обучающем наборе данных. Ошибка обобщения (generalization error) — это математическое ожидание ошибки модели, когда её применяют к бесконечному числу примеров данных, взятых из того же исходного распределения, что и обучающие данные.
Проблема в том, что точно вычислить ошибку обобщения нельзя: бесконечное число примеров — это абстракция. На практике ошибку обобщения можно оценить, применив модель к независимому тестовому набору, состоящему из случайно выбранных примеров, которые не встречались в обучающем наборе.
Следующие три мысленных эксперимента помогут лучше понять эту ситуацию. Представим студента, который готовится к итоговому экзамену. Старательный студент будет решать упражнения и проверять себя на экзаменационных задачах прошлых лет. Тем не менее хороший результат на прошлых задачах не гарантирует, что он хорошо справится с настоящим экзаменом. Например, студент может пытаться подготовиться, просто заучивая ответы на задачи. Он даже может полностью запомнить ответы на прошлые экзамены. Другой студент может готовиться, пытаясь понять, почему даны именно такие ответы. В большинстве случаев второй сдаст экзамен лучше.
Аналогично рассмотрим модель, которая отвечает на вопросы, просто заглядывая в таблицу. Если множество допустимых входов дискретно и достаточно мало, то после просмотра многих обучающих примеров такой метод может работать хорошо. Но когда модель сталкивается с никогда не виденными примерами, её результат едва ли лучше случайного угадывания. Дело в том, что пространство входов слишком велико, и невозможно запомнить ответ на каждый возможный вход. Например, рассмотрим полутоновое изображение . Если каждый пиксель может принимать одно из значений яркости, то существует возможных изображений. Это значит, что количество низкоразрешённых полутоновых изображений размером с ноготь намного больше числа атомов во Вселенной. Даже если нам и встретятся такие данные, хранить всю таблицу поиска мы всё равно не сможем.
Наконец, рассмотрим задачу классификации результатов броска монеты (класс 0: орёл, класс 1: решка). Пусть монета честная: тогда, каким бы ни был алгоритм, ошибка обобщения всегда равна . Однако для большинства алгоритмов мы должны ожидать, что ошибка обучения будет меньше (хотя это зависит от везения). Рассмотрим набор данных {0, 1, 1, 1, 0, 1}. Наш алгоритм, не имея дополнительных признаков, будет склонен всегда предсказывать преобладающий класс; по нашей ограниченной выборке им кажется 1. В этом случае модель, которая всегда предсказывает класс 1, даст ошибку , что заметно лучше нашей ошибки обобщения. Но по мере роста объёма данных вероятность того, что доля орлов заметно отклонится от , будет снижаться, и ошибка обучения будет приближаться к ошибке обобщения.
4.4.1.1 Статистическая теория обучения
Поскольку обобщение — фундаментальная проблема машинного обучения, многие математики и теоретики посвятили жизнь изучению её формальной теории. В одноимённой теореме Гливенко и Кантелли вывели скорость, с которой ошибка обучения сходится к ошибке обобщения. В серии новаторских работ Вапник и Червоненкис распространили эту теорию на более широкий класс функций. Эти работы заложили основы статистической теории обучения.
В рассмотренном и далее в книге случае обучения с учителем мы предполагаем, что обучающие и тестовые данные независимо извлечены из одного и того же распределения. Это предположение обычно называют предположением о независимости и одинаковой распределённости (i.i.d. assumption; independent and identically distributed). Оно означает, что процесс выборки данных не «запоминает» предыдущие примеры. Иначе говоря, связь между вторым и третьим извлечёнными примерами не сильнее, чем связь между вторым и двухмиллионным.
Чтобы стать хорошим специалистом по машинному обучению, нужно уметь критически мыслить. Предположения часто уязвимы: несложно придумать ситуации, в которых они не выполняются. Допустим, мы обучили модель предсказания смертельного риска на данных пациентов медицинского центра Калифорнийского университета в Сан-Франциско и применили её к данным пациентов Массачусетской больницы общего профиля. Что тогда произойдёт? Эти два распределения могут заметно различаться. К тому же процесс выборки может зависеть от времени. Например, при классификации тем в микроблогах новостной цикл создаёт временную зависимость обсуждаемых тем, что нарушает предположение о независимости.
Иногда модель продолжает работать очень хорошо, даже если предположение о независимой и одинаковой распределённости нарушено незначительно. Например, существует много полезных инструментов, уже применяемых на практике: распознавание лиц, распознавание речи и машинный перевод. В конце концов, почти в любом реальном применении есть хотя бы некоторые отклонения от этого предположения.
Однако некоторые нарушения предположения точно создадут проблемы. Например, если мы попытаемся обучить систему распознавания лиц только на изображениях студентов, а затем использовать её для наблюдения за пожилыми людьми в доме престарелых, это вряд ли сработает, поскольку лица студентов часто сильно отличаются от лиц пожилых людей.
В следующих разделах мы будем обсуждать проблемы, возникающие из-за нарушения предположения о независимой и одинаковой распределённости. Пока же даже при принятии этого предположения понимать обобщаемость — непростая задача. Более того, теоретические основы, объясняющие обобщающую способность глубоких нейронных сетей, по-прежнему ставят в тупик выдающихся учёных в области теории обучения.
Когда мы обучаем модель, мы стремимся найти функцию, которая как можно лучше соответствует обучающим данным. Но если она подгоняется «слишком хорошо» и не может хорошо обобщаться на невидимые данные, возникает переобучение. Именно этого мы хотим избегать или контролировать. В глубоком обучении есть много эвристических приёмов, направленных на предотвращение переобучения.
4.4.1.2 Сложность модели
Если модель простая, а данных много, мы ожидаем, что ошибка обобщения будет близка к ошибке обучения. Если модель сложнее, а примеров меньше, мы ожидаем, что ошибка обучения уменьшится, а ошибка обобщения возрастёт. Что именно делает модель сложной, — непростой вопрос. Способность модели хорошо обобщаться зависит от многих факторов. Например, модель с большим числом параметров может считаться более сложной, а модель, у которой параметры могут принимать значения из более широкого диапазона, — тоже более сложной. Для нейронных сетей обычно считается, что модель, которой нужно больше итераций обучения, сложнее, а модель, для которой нужна ранняя остановка (early stopping), то есть меньшее число эпох обучения, — проще.
Сравнивать сложность принципиально разных классов моделей (например, деревьев решений и нейронных сетей) трудно. Пока полезно простое эмпирическое правило: статистики считают сложной модель, которая легко объясняет произвольные факты, а модель с ограниченной выразительностью, но хорошо объясняющая данные, может быть полезнее на практике. В философии это тесно связано с критерием фальсифицируемости научных теорий Поппера: теория хороша, если она согласуется с данными и существуют конкретные проверки, которые могли бы доказать её неверность. Это важно, потому что все статистические оценки — это индуктивные выводы post hoc. То есть мы делаем оценки после наблюдения фактов, и поэтому они подвержены корреляционным ошибкам. Сейчас отложим философию и займёмся более практичными вопросами.
Чтобы дать интуитивное представление, мы выделим несколько факторов, которые обычно влияют на обобщающую способность модели.
- Число настраиваемых параметров. Когда число настраиваемых параметров (иногда его называют числом степеней свободы) велико, модель, как правило, склонна к переобучению.
- Значения параметров. Когда веса могут принимать значения из широкого диапазона, модель может оказаться более склонной к переобучению.
- Число обучающих примеров. Даже простая модель может переобучиться на наборе из одного-двух примеров. А чтобы переобучиться на наборе из миллионов примеров, нужна очень гибкая модель.
4.4.2 Выбор модели
В машинном обучении мы обычно оцениваем несколько кандидатов и затем выбираем итоговую модель. Этот процесс называется выбором модели (model selection). Иногда сравниваемые модели принципиально различаются (например, дерево решений и линейная модель). В других случаях мы сравниваем модели одного и того же класса с разными значениями гиперпараметров.
Например, при обучении многослойного перцептрона мы можем захотеть сравнить модели с разным числом скрытых слоёв, разным числом скрытых элементов и разными комбинациями функций активации. Чтобы определить лучшую модель среди кандидатов, обычно используют проверочный набор.
4.4.2.1 Проверочный набор
По сути, пока мы не определили все гиперпараметры, мы не хотим использовать тестовый набор. Если во время выбора модели использовать тестовые данные, есть риск переобучиться на тестовых данных, а это серьёзная проблема. Если мы переобучились на обучающих данных, оценку на тестовых данных можно использовать, чтобы это заметить. Но если мы переобучились на тестовых данных, как мы узнаем об этом?
Поэтому ни в коем случае нельзя полагаться на тестовые данные при выборе модели. Однако и опираться только на обучающие данные для выбора модели нельзя, поскольку по ним мы не можем оценить ошибку обобщения.
На практике ситуация сложнее. В идеале тестовые данные нужно использовать один раз — чтобы оценить лучшую модель или сравнить несколько моделей. Но на деле тестовые данные редко выбрасывают после одного использования. У нас редко бывает достаточно данных, чтобы для каждого этапа экспериментов брать новый тестовый набор.
Частое решение этой проблемы — разделить данные на три части: помимо обучающего и тестового наборов выделить проверочный набор данных (validation dataset), или проверочный набор (validation set). Но на практике граница между проверочными и тестовыми данными часто размыта. Если явно не сказано иное, в экспериментах этой книги мы фактически используем наборы, которые правильнее было бы назвать обучающими и проверочными, и настоящего тестового набора нет. Поэтому точность, которую книга приводит для каждого эксперимента, — это точность на проверочном наборе, а не на тестовом.
4.4.2.2 -кратная перекрёстная проверка
Когда обучающих данных мало, для построения достаточно большого проверочного набора их может не хватить. Популярное решение этой проблемы — -кратная перекрёстная проверка (K-fold cross-validation). Здесь исходные обучающие данные разбиваются на непересекающихся подмножеств. Затем выполняются обучений и проверок модели: каждый раз модель обучается на подмножествах и проверяется на оставшемся подмножестве (том, которое не использовалось для обучения в этом проходе). В итоге ошибки обучения и проверки оцениваются как среднее по экспериментам.
4.4.3 Недообучение или переобучение?
Когда мы сравниваем ошибки обучения и проверки, нужно обращать внимание на два типичных случая. Во-первых, стоит обратить внимание на ситуацию, когда и ошибка обучения, и ошибка проверки велики, но разница между ними невелика. Если модель не может снизить ошибку обучения, это может означать, что она слишком простая (то есть недостаточно выразительна) и не способна уловить закономерность, которую пытается выучить. Кроме того, поскольку ошибка обобщения (разница между ошибками обучения и проверки) мала, у нас есть основания полагать, что более сложная модель могла бы снизить ошибку обучения. Это явление называют недообучением (underfitting).
С другой стороны, если ошибка обучения заметно ниже ошибки проверки, это указывает на серьёзное переобучение (overfitting). Заметим, что переобучение не всегда плохо. В особенности в глубоком обучении хорошо известно, что лучшие предсказательные модели часто показывают на обучающих данных результаты заметно лучше, чем на удержанных (проверочных) данных. В конечном счёте нас обычно больше интересует ошибка проверки, чем разрыв между ошибками обучения и проверки.
Переобучение или недообучение может зависеть от сложности модели и от размера доступного обучающего набора данных, о чём речь пойдёт ниже.
4.4.3.1 Сложность модели
Чтобы проиллюстрировать классическую интуицию о переобучении и сложности модели, рассмотрим пример со многочленами. Имея обучающие данные, состоящие из одного признака и соответствующей вещественной метки , мы пытаемся найти многочлен степени , который оценивает метку :
Это просто задача линейной регрессии: признаками служат степени , весами — , а смещение задаётся (поскольку для всех ). Поскольку это линейная регрессия, в качестве функции потерь можно использовать квадратичную ошибку.
Многочлен высокой степени гораздо сложнее многочлена низкой степени. У многочлена высокой степени больше параметров и шире выбор функций модели. Поэтому при фиксированном обучающем наборе данных ошибка обучения многочлена высокой степени всегда должна быть не больше (в худшем случае такой же), чем у многочлена низкой степени. Более того, если примеры содержат разные значения , многочлен степени, равной числу примеров, может идеально подогнаться под обучающий набор. На рис. 4.4.1 показана связь между степенью многочлена и недообучением, а также переобучением.
Рис. 4.4.1. Влияние сложности модели на недообучение и переобучение
4.4.3.2 Размер набора данных
Ещё один важный фактор — размер набора данных. Чем меньше обучающих примеров, тем выше вероятность переобучения и тем оно сильнее. С ростом объёма обучающих данных ошибка обобщения обычно уменьшается. Кроме того, в общем случае больше данных не бывает лишним. Для фиксированной задачи и распределения данных между сложностью модели и размером набора данных обычно есть связь. Имея больше данных, мы можем попытаться подогнать более сложную модель. Способность подгонять более сложные модели может быть полезна. Если данных недостаточно, более простые модели могут оказаться полезнее. Для многих задач глубокое обучение превосходит линейные модели только при наличии тысяч обучающих примеров. В известной мере нынешний подъём глубокого обучения обязан дешёвым системам хранения, подключённым устройствам и огромным наборам данных, которые дала цифровая экономика.
4.4.4 Полиномиальная регрессия
Теперь мы можем исследовать эти понятия на примере подгонки многочленов.
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, np, npx
from mxnet.gluon import nn
import math
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
import numpy as np
import math
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
import numpy as np
import math
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
import numpy as np
import math
4.4.4.1 Генерация набора данных
По заданному мы будем генерировать метки обучающих и тестовых данных с помощью следующего многочлена третьей степени:
Шумовой член распределён нормально, с математическим ожиданием 0 и стандартным отклонением 0.1. В процессе оптимизации обычно хочется избегать очень больших значений градиентов и функции потерь. Поэтому мы масштабируем признаки от к . Это позволяет избежать очень больших значений показателей при больших . Мы сгенерируем по 100 примеров для обучающего и для тестового наборов.
max_degree = 20 # Максимальная степень многочлена
n_train, n_test = 100, 100 # Размеры обучающего и тестового наборов данных
true_w = np.zeros(max_degree) # Выделить большой объём памяти
true_w[0:4] = np.array([5, 1.2, -3.4, 5.6])
features = np.random.normal(size=(n_train + n_test, 1))
np.random.shuffle(features)
poly_features = np.power(features, np.arange(max_degree).reshape(1, -1))
for i in range(max_degree):
poly_features[:, i] /= math.gamma(i + 1) # gamma(n)=(n-1)!
# Размерность labels: (n_train+n_test,)
labels = np.dot(poly_features, true_w)
labels += np.random.normal(scale=0.1, size=labels.shape)
Аналогично одночлены, хранящиеся в poly_features, перемасштабированы гамма-функцией, где .
Посмотрим на первые два примера из сгенерированного набора данных.
Первое значение — постоянный признак, соответствующий смещению.
PyTorch, TensorFlow, PaddlePaddle:
# Преобразовать NumPy ndarray в tensor
true_w, features, poly_features, labels = [d2l.tensor(x, dtype=
d2l.float32) for x in [true_w, features, poly_features, labels]]
features[:2], poly_features[:2, :], labels[:2]
4.4.4.2 Обучение и тестирование модели
Сначала реализуем функцию, которая оценивает потери модели на заданном наборе данных.
MXNet, TensorFlow:
def evaluate_loss(net, data_iter, loss): #@save
"""Оценить потери модели на заданном наборе данных"""
metric = d2l.Accumulator(2) # Сумма потерь, количество примеров
for X, y in data_iter:
l = loss(net(X), y)
metric.add(d2l.reduce_sum(l), d2l.size(l))
return metric[0] / metric[1]
PyTorch:
def evaluate_loss(net, data_iter, loss): #@save
"""Оценить потери модели на заданном наборе данных"""
metric = d2l.Accumulator(2) # Сумма потерь, количество примеров
for X, y in data_iter:
out = net(X)
y = d2l.reshape(y, out.shape)
l = loss(out, y)
metric.add(d2l.reduce_sum(l), d2l.size(l))
return metric[0] / metric[1]
PaddlePaddle:
def evaluate_loss(net, data_iter, loss): #@save
"""Оценить потери модели на заданном наборе данных."""
metric = d2l.Accumulator(2) # Сумма потерь, количество примеров
for X, y in data_iter:
out = net(X)
y = y.reshape(out.shape)
l = loss(out, y)
metric.add(l.sum(), l.numel())
return metric[0] / metric[1]
Теперь определим функцию обучения.
MXNet:
def train(train_features, test_features, train_labels, test_labels,
num_epochs=400):
loss = gluon.loss.L2Loss()
net = nn.Sequential()
# Смещение не задаём, так как оно уже реализовано в полиномиальных признаках
net.add(nn.Dense(1, use_bias=False))
net.initialize()
batch_size = min(10, train_labels.shape[0])
train_iter = d2l.load_array((train_features, train_labels), batch_size)
test_iter = d2l.load_array((test_features, test_labels), batch_size,
is_train=False)
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'learning_rate': 0.01})
animator = d2l.Animator(xlabel='эпоха', ylabel='потери', yscale='log',
xlim=[1, num_epochs], ylim=[1e-3, 1e2],
legend=['обучение', 'тест'])
for epoch in range(num_epochs):
d2l.train_epoch_ch3(net, train_iter, loss, trainer)
if epoch == 0 or (epoch + 1) % 20 == 0:
animator.add(epoch + 1, (evaluate_loss(net, train_iter, loss),
evaluate_loss(net, test_iter, loss)))
print('вес:', net[0].weight.data().asnumpy())
PyTorch:
def train(train_features, test_features, train_labels, test_labels,
num_epochs=400):
loss = nn.MSELoss(reduction='none')
input_shape = train_features.shape[-1]
# Смещение не задаём, так как оно уже реализовано в полиномиальных признаках
net = nn.Sequential(nn.Linear(input_shape, 1, bias=False))
batch_size = min(10, train_labels.shape[0])
train_iter = d2l.load_array((train_features, train_labels.reshape(-1,1)),
batch_size)
test_iter = d2l.load_array((test_features, test_labels.reshape(-1,1)),
batch_size, is_train=False)
trainer = torch.optim.SGD(net.parameters(), lr=0.01)
animator = d2l.Animator(xlabel='эпоха', ylabel='потери', yscale='log',
xlim=[1, num_epochs], ylim=[1e-3, 1e2],
legend=['обучение', 'тест'])
for epoch in range(num_epochs):
d2l.train_epoch_ch3(net, train_iter, loss, trainer)
if epoch == 0 or (epoch + 1) % 20 == 0:
animator.add(epoch + 1, (evaluate_loss(net, train_iter, loss),
evaluate_loss(net, test_iter, loss)))
print('вес:', net[0].weight.data.numpy())
TensorFlow:
def train(train_features, test_features, train_labels, test_labels,
num_epochs=400):
loss = tf.losses.MeanSquaredError()
input_shape = train_features.shape[-1]
# Смещение не задаём, так как оно уже реализовано в полиномиальных признаках
net = tf.keras.Sequential()
net.add(tf.keras.layers.Dense(1, use_bias=False))
batch_size = min(10, train_labels.shape[0])
train_iter = d2l.load_array((train_features, train_labels), batch_size)
test_iter = d2l.load_array((test_features, test_labels), batch_size,
is_train=False)
trainer = tf.keras.optimizers.SGD(learning_rate=.01)
animator = d2l.Animator(xlabel='эпоха', ylabel='потери', yscale='log',
xlim=[1, num_epochs], ylim=[1e-3, 1e2],
legend=['обучение', 'тест'])
for epoch in range(num_epochs):
d2l.train_epoch_ch3(net, train_iter, loss, trainer)
if epoch == 0 or (epoch + 1) % 20 == 0:
animator.add(epoch + 1, (evaluate_loss(net, train_iter, loss),
evaluate_loss(net, test_iter, loss)))
print('вес:', net.get_weights()[0].T)
PaddlePaddle:
def train(train_features, test_features, train_labels, test_labels,
num_epochs=400):
loss = nn.MSELoss()
input_shape = train_features.shape[-1]
# Смещение не задаём, так как оно уже реализовано в полиномиальных признаках
net = nn.Sequential(nn.Linear(input_shape, 1, bias_attr=False))
batch_size = min(10, train_labels.shape[0])
print(batch_size)
train_iter = d2l.load_array(((train_features, train_labels.reshape([-1,1]))),
batch_size)
test_iter = d2l.load_array((test_features, test_labels.reshape([-1,1])),
batch_size, is_train=False)
trainer = paddle.optimizer.SGD(parameters=net.parameters(), learning_rate=0.01)
animator = d2l.Animator(xlabel='эпоха', ylabel='потери', yscale='log',
xlim=[1, num_epochs], ylim=[1e-3, 1e2],
legend=['обучение', 'тест'])
for epoch in range(num_epochs):
d2l.train_epoch_ch3(net, train_iter, loss, trainer)
if epoch == 0 or (epoch + 1) % 20 == 0:
animator.add(epoch + 1, (evaluate_loss(net, train_iter, loss),
evaluate_loss(net, test_iter, loss)))
print('вес:', net[0].weight.numpy())
4.4.4.3 Подгонка многочленом третьей степени (нормальный случай)
Сначала используем многочлен третьей степени — той же степени, что и функция генерации данных. Результаты показывают, что модель эффективно снижает потери как на обучении, так и на тесте. Найденные параметры модели также близки к истинным значениям .
# Из полиномиальных признаков выбираем первые 4 измерения, то есть 1, x, x^2/2!, x^3/3!
train(poly_features[:n_train, :4], poly_features[n_train:, :4],
labels[:n_train], labels[n_train:])
4.4.4.4 Линейная подгонка (недообучение)
Посмотрим на линейную подгонку: снизить ошибку обучения такой модели довольно трудно. После последней эпохи потери на обучении остаются высокими. Если использовать линейную модель для приближения нелинейной зависимости, например многочлена третьей степени, она будет склонна к недообучению.
# Из полиномиальных признаков выбираем первые 2 измерения, то есть 1 и x
train(poly_features[:n_train, :2], poly_features[n_train:, :2],
labels[:n_train], labels[n_train:])
4.4.4.5 Подгонка многочленом высокой степени (переобучение)
Теперь попробуем обучить модель многочленом слишком высокой степени. В этом случае данных недостаточно, чтобы выучить, что коэффициенты высоких степеней должны быть близки к нулю. Поэтому такая слишком сложная модель легко подстраивается под шум в обучающих данных. Хотя потери на обучении удаётся эффективно уменьшить, потери на тесте остаются высокими. Таким образом, сложная модель переобучилась на данных.
# Берём все измерения полиномиальных признаков
train(poly_features[:n_train, :], poly_features[n_train:, :],
labels[:n_train], labels[n_train:], num_epochs=1500)
В следующих разделах мы продолжим обсуждать проблему переобучения и методы борьбы с ней, например затухание весов и исключение (dropout).
Резюме
- Недообучение означает, что модель не может дальше снижать ошибку обучения. Переобучение означает, что ошибка обучения заметно меньше ошибки проверки.
- Ошибку обобщения нельзя оценить по ошибке обучения, поэтому простая минимизация ошибки обучения не обязательно приводит к уменьшению ошибки обобщения. Модели машинного обучения нужно защищать от переобучения, то есть не допускать слишком большой ошибки обобщения.
- Проверочный набор можно использовать для выбора модели, но делать это следует аккуратно.
- Следует выбирать модель подходящей сложности и не использовать слишком мало обучающих примеров.
Упражнения
- Можно ли точно решить эту задачу полиномиальной регрессии? Подсказка: используйте линейную алгебру.
- Рассмотрите выбор модели для многочленов.
- Постройте график зависимости ошибки обучения от сложности модели (степени многочлена). Что вы наблюдаете? Многочлен какой степени нужен, чтобы уменьшить ошибку обучения до 0?
- Постройте график ошибки на тесте в этом случае.
- Постройте такой же график в зависимости от объёма данных.
- Что произойдёт, если не нормировать полиномиальные признаки ()? Можно ли решить эту проблему другим способом?
- Может ли ошибка обобщения быть равна нулю?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
4.5 Затухание весов
В предыдущем разделе мы описали проблему переобучения. В этом разделе мы познакомимся с некоторыми методами регуляризации моделей. Переобучение всегда можно смягчить, собрав больше обучающих данных. Однако это может быть дорого, требовать много времени или быть вне нашего контроля, поэтому в краткосрочной перспективе такой путь обычно невозможен. Если же у нас уже есть как можно больше качественных данных, мы можем сосредоточиться на методах регуляризации.
Напомним, что в примере с полиномиальной регрессией (раздел 4.4) мы могли ограничивать ёмкость модели, меняя степень полинома. На практике ограничение числа признаков — распространённый способ борьбы с переобучением. Однако простое отбрасывание признаков может оказаться слишком грубым инструментом. Продолжим пример с полиномиальной регрессией и рассмотрим, что происходит при многомерных входах. Естественное обобщение многочленов на многомерные данные называется одночленами (monomials) — это произведения степеней переменных. Степень одночлена равна сумме степеней его множителей. Например, и — одночлены степени 3.
Заметим, что с ростом степени число членов степени быстро возрастает. При переменных число членов степени равно , то есть . Поэтому даже небольшое изменение степени, например с 2 до 3, заметно увеличивает сложность модели. Если ограничивать только число признаков (в полиномиальной регрессии — степень многочлена), модель может оставаться либо слишком простой, либо слишком сложной. Нам нужен более тонкий инструмент, который позволяет регулировать сложность функции и находить подходящий баланс.
4.5.1 Нормы и затухание весов
В разделе 2.3.10 мы описали - и -нормы, которые являются частными случаями более общих -норм. В обучении параметризованных моделей машинного обучения затухание весов (weight decay) — один из самых широко используемых методов регуляризации; его также называют -регуляризацией. Этот метод измеряет сложность функции через её расстояние до нуля, поскольку среди всех функций функция (которая для всех входов возвращает ) в некотором смысле самая простая. Но как точно измерить расстояние между функцией и нулём? Единого правильного ответа нет. Фактически над этим вопросом работают функциональный анализ и теория банаховых пространств.
Простой способ — измерять сложность линейной функции через некоторую норму вектора весов, например . Чтобы вектор весов оставался небольшим, чаще всего его норму добавляют в задачу минимизации потерь в качестве штрафного члена. Вместо того чтобы минимизировать только ошибку предсказания на обучающих метках, мы минимизируем сумму ошибки предсказания и штрафного члена. Теперь, если вектор весов становится слишком большим, алгоритм обучения будет в большей степени заниматься минимизацией нормы весов . Именно этого мы и хотим. Вернёмся к примеру линейной регрессии из раздела 3.1. Наши потери задаются формулой:
Напомним, что — признаки примера , — метка примера , а — параметры весов и смещения. Чтобы штрафовать размер вектора весов, нужно каким-то образом добавить в функцию потерь. Но как модель должна сбалансировать этот новый дополнительный штраф с исходными потерями? На практике этот компромисс задаётся коэффициентом регуляризации — неотрицательным гиперпараметром, который подбирают по проверочным данным:
При мы возвращаемся к исходной функции потерь. При мы ограничиваем размер . Здесь по-прежнему делим на : при взятии производной квадратичной функции двойка и сокращаются, и выражения для обновления получаются аккуратными и простыми. Почему здесь используется квадрат нормы, а не сама норма (то есть евклидово расстояние)? Так удобнее вычислять. Взяв квадрат -нормы, мы избавляемся от квадратного корня и получаем сумму квадратов компонент вектора весов. Благодаря этому производная штрафа легко вычисляется: производная суммы равна сумме производных.
Почему для начала мы выбираем именно -норму, а не -норму? На самом деле этот выбор и эффективен, и популярен во всей статистике. -регуляризованная линейная модель образует классический алгоритм гребневой регрессии (ridge regression), а -регуляризованная линейная регрессия — близкую базовую модель статистики, обычно называемую лассо-регрессией (lasso regression). Одна из причин использовать -норму в том, что она сильно штрафует большие компоненты вектора весов. Это заставляет алгоритм обучения отдавать предпочтение моделям, в которых веса равномерно распределены по большому числу признаков. На практике это может делать такие модели более устойчивыми к ошибкам наблюдений в отдельных переменных. Напротив, -штраф приводит к тому, что модель концентрирует веса на небольшом числе признаков, а остальные веса обнуляет. Это называется отбором признаков (feature selection), и такая возможность может быть полезна в других задачах.
Используя те же обозначения, что и в формуле (3.1.4), запишем обновление минибатчевого стохастического градиентного спуска для регрессии с -регуляризацией:
Как и раньше, мы обновляем по разности между предсказанием и наблюдаемым значением. Но одновременно мы стремимся уменьшить размер до нуля. Поэтому этот метод иногда называют затуханием весов. Если учитывать только штрафной член, на каждом шаге оптимизации веса затухают. По сравнению с отбором признаков затухание весов даёт непрерывный механизм настройки сложности функции. Меньшие значения соответствуют менее ограниченным , а большие значения накладывают более сильные ограничения на .
Штрафовать ли соответствующее смещение , на практике решают по-разному, и в разных слоях нейронной сети это тоже может различаться. Обычно смещение выходного слоя сети не регуляризуют.
4.5.2 Многомерная линейная регрессия
Продемонстрируем затухание весов на простом примере.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, gluon, init, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
from torch import nn
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
Сначала сгенерируем данные, как и раньше по формуле:
Мы выбираем метку как линейную функцию входов. Метка также искажается гауссовым шумом с математическим ожиданием 0 и стандартным отклонением 0.01. Чтобы эффект переобучения стал заметнее, можно увеличить размерность задачи до и использовать небольшой обучающий набор из 20 примеров.
n_train, n_test, num_inputs, batch_size = 20, 100, 200, 5
true_w, true_b = d2l.ones((num_inputs, 1)) * 0.01, 0.05
train_data = d2l.synthetic_data(true_w, true_b, n_train)
train_iter = d2l.load_array(train_data, batch_size)
test_data = d2l.synthetic_data(true_w, true_b, n_test)
test_iter = d2l.load_array(test_data, batch_size, is_train=False)
4.5.3 Реализация с нуля
Теперь реализуем затухание весов с нуля: достаточно добавить к исходной целевой функции квадратичный штраф .
4.5.3.1 Инициализация параметров модели
Сначала определим функцию, которая случайным образом инициализирует параметры модели.
MXNet:
def init_params():
w = np.random.normal(scale=1, size=(num_inputs, 1))
b = np.zeros(1)
w.attach_grad()
b.attach_grad()
return [w, b]
PyTorch:
def init_params():
w = torch.normal(0, 1, size=(num_inputs, 1), requires_grad=True)
b = torch.zeros(1, requires_grad=True)
return [w, b]
TensorFlow:
def init_params():
w = tf.Variable(tf.random.normal(mean=1, shape=(num_inputs, 1)))
b = tf.Variable(tf.zeros(shape=(1, )))
return [w, b]
PaddlePaddle:
def init_params():
w = paddle.normal(0, 1, shape=(num_inputs, 1))
w.stop_gradient = False
b = paddle.zeros(shape=[1])
b.stop_gradient = False
return [w, b]
4.5.3.2 Определение штрафа -нормы
Самый удобный способ реализовать этот штраф — возвести все элементы в квадрат и просуммировать их.
MXNet:
def l2_penalty(w):
return (w**2).sum() / 2
PyTorch:
def l2_penalty(w):
return torch.sum(w.pow(2)) / 2
TensorFlow:
def l2_penalty(w):
return tf.reduce_sum(tf.pow(w, 2)) / 2
PaddlePaddle:
def l2_penalty(w):
return paddle.sum(w.pow(2)) / 2
4.5.3.3 Определение кода обучения
Приведённый ниже код подгоняет модель под обучающий набор и оценивает её на тестовом наборе.
Начиная с главы 3 линейная сеть и квадратичная функция потерь не меняются, поэтому мы импортируем их через d2l.linreg и d2l.squared_loss.
Единственное отличие: теперь в потери входит штрафной член.
MXNet:
def train(lambd):
w, b = init_params()
net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
num_epochs, lr = 100, 0.003
animator = d2l.Animator(xlabel='эпохи', ylabel='потери', yscale='log',
xlim=[5, num_epochs], legend=['обучение', 'тест'])
for epoch in range(num_epochs):
for X, y in train_iter:
with autograd.record():
# Добавлен штраф L2-нормы,
# broadcasting делает l2_penalty(w) вектором длины batch_size
l = loss(net(X), y) + lambd * l2_penalty(w)
l.backward()
d2l.sgd([w, b], lr, batch_size)
if (epoch + 1) % 5 == 0:
animator.add(epoch + 1, (d2l.evaluate_loss(net, train_iter, loss),
d2l.evaluate_loss(net, test_iter, loss)))
print('L2-норма w:', np.linalg.norm(w))
PyTorch:
def train(lambd):
w, b = init_params()
net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
num_epochs, lr = 100, 0.003
animator = d2l.Animator(xlabel='эпохи', ylabel='потери', yscale='log',
xlim=[5, num_epochs], legend=['обучение', 'тест'])
for epoch in range(num_epochs):
for X, y in train_iter:
# Добавлен штраф L2-нормы,
# broadcasting делает l2_penalty(w) вектором длины batch_size
l = loss(net(X), y) + lambd * l2_penalty(w)
l.sum().backward()
d2l.sgd([w, b], lr, batch_size)
if (epoch + 1) % 5 == 0:
animator.add(epoch + 1, (d2l.evaluate_loss(net, train_iter, loss),
d2l.evaluate_loss(net, test_iter, loss)))
print('L2-норма w:', torch.norm(w).item())
TensorFlow:
def train(lambd):
w, b = init_params()
net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
num_epochs, lr = 100, 0.003
animator = d2l.Animator(xlabel='эпохи', ylabel='потери', yscale='log',
xlim=[5, num_epochs], legend=['обучение', 'тест'])
for epoch in range(num_epochs):
for X, y in train_iter:
with tf.GradientTape() as tape:
# Добавлен штраф L2-нормы,
# broadcasting делает l2_penalty(w) вектором длины batch_size
l = loss(net(X), y) + lambd * l2_penalty(w)
grads = tape.gradient(l, [w, b])
d2l.sgd([w, b], grads, lr, batch_size)
if (epoch + 1) % 5 == 0:
animator.add(epoch + 1, (d2l.evaluate_loss(net, train_iter, loss),
d2l.evaluate_loss(net, test_iter, loss)))
print('L2-норма w:', tf.norm(w).numpy())
PaddlePaddle:
def train(lambd):
w, b = init_params()
net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
num_epochs, lr = 100, 0.003
animator = d2l.Animator(xlabel='эпохи', ylabel='потери', yscale='log',
xlim=[5, num_epochs], legend=['обучение', 'тест'])
for epoch in range(num_epochs):
for X, y in train_iter():
# Добавлен штраф L2-нормы,
# broadcasting делает l2_penalty(w) вектором длины `batch_size`
l = loss(net(X), y) + lambd * l2_penalty(w)
l.sum().backward()
d2l.sgd([w, b], lr, batch_size)
if (epoch + 1) % 5 == 0:
animator.add(epoch + 1, (d2l.evaluate_loss(net, train_iter, loss),
d2l.evaluate_loss(net, test_iter, loss)))
print('L2-норма w:', paddle.norm(w).item())
4.5.3.4 Обучение без регуляризации
Теперь запустим код с lambd = 0, то есть без затухания весов.
Обратите внимание: ошибка обучения уменьшилась, а ошибка на тесте — нет.
Это означает серьёзное переобучение.
train(lambd=0)
4.5.3.5 Обучение с затуханием весов
Теперь запустим код с затуханием весов. Обратите внимание: ошибка обучения возросла, а ошибка на тесте уменьшилась. Это именно тот эффект, которого мы ожидаем от регуляризации.
train(lambd=3)
4.5.4 Краткая реализация
Поскольку затухание весов широко используется при оптимизации нейронных сетей, фреймворки глубокого обучения встраивают его в алгоритмы оптимизации, чтобы его можно было применять с любой функцией потерь. Кроме того, такая интеграция удобна с вычислительной точки зрения: затухание весов можно добавить в алгоритм без дополнительных вычислительных затрат. Поскольку часть обновления, отвечающая за затухание весов, зависит только от текущего значения каждого параметра, оптимизатор должен обращаться к каждому параметру хотя бы один раз.
MXNet: В приведённом ниже коде мы задаём гиперпараметр затухания весов wd прямо при создании Trainer.
По умолчанию Gluon применяет затухание и к весам, и к смещениям.
Обратите внимание, что при обновлении параметров модели гиперпараметр wd умножается на wd_mult.
Поэтому, если установить wd_mult равным нулю, смещение не будет затухать.
PyTorch: В приведённом ниже коде мы задаём гиперпараметр затухания весов weight_decay прямо при создании оптимизатора.
По умолчанию PyTorch применяет затухание и к весам, и к смещениям.
Здесь мы задаём weight_decay только для весов, поэтому смещение не затухает.
TensorFlow: В приведённом ниже коде мы создаём -регуляризатор с гиперпараметром затухания весов wd и применяем его к слою сети через аргумент kernel_regularizer.
MXNet:
def train_concise(wd):
net = nn.Sequential()
net.add(nn.Dense(1))
net.initialize(init.Normal(sigma=1))
loss = gluon.loss.L2Loss()
num_epochs, lr = 100, 0.003
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'learning_rate': lr, 'wd': wd})
# Параметры смещения не затухают. Имена смещений обычно заканчиваются на «bias»
net.collect_params('.*bias').setattr('wd_mult', 0)
animator = d2l.Animator(xlabel='эпохи', ylabel='потери', yscale='log',
xlim=[5, num_epochs], legend=['обучение', 'тест'])
for epoch in range(num_epochs):
for X, y in train_iter:
with autograd.record():
l = loss(net(X), y)
l.backward()
trainer.step(batch_size)
if (epoch + 1) % 5 == 0:
animator.add(epoch + 1, (d2l.evaluate_loss(net, train_iter, loss),
d2l.evaluate_loss(net, test_iter, loss)))
print('L2-норма w:', np.linalg.norm(net[0].weight.data()))
PyTorch:
def train_concise(wd):
net = nn.Sequential(nn.Linear(num_inputs, 1))
for param in net.parameters():
param.data.normal_()
loss = nn.MSELoss(reduction='none')
num_epochs, lr = 100, 0.003
# Параметры смещения не затухают
trainer = torch.optim.SGD([
{"params":net[0].weight,'weight_decay': wd},
{"params":net[0].bias}], lr=lr)
animator = d2l.Animator(xlabel='эпохи', ylabel='потери', yscale='log',
xlim=[5, num_epochs], legend=['обучение', 'тест'])
for epoch in range(num_epochs):
for X, y in train_iter:
trainer.zero_grad()
l = loss(net(X), y)
l.mean().backward()
trainer.step()
if (epoch + 1) % 5 == 0:
animator.add(epoch + 1,
(d2l.evaluate_loss(net, train_iter, loss),
d2l.evaluate_loss(net, test_iter, loss)))
print('L2-норма w:', net[0].weight.norm().item())
TensorFlow:
def train_concise(wd):
net = tf.keras.models.Sequential()
net.add(tf.keras.layers.Dense(
1, kernel_regularizer=tf.keras.regularizers.l2(wd)))
net.build(input_shape=(1, num_inputs))
w, b = net.trainable_variables
loss = tf.keras.losses.MeanSquaredError()
num_epochs, lr = 100, 0.003
trainer = tf.keras.optimizers.SGD(learning_rate=lr)
animator = d2l.Animator(xlabel='эпохи', ylabel='потери', yscale='log',
xlim=[5, num_epochs], legend=['обучение', 'тест'])
for epoch in range(num_epochs):
for X, y in train_iter:
with tf.GradientTape() as tape:
# В tf.keras для пользовательского цикла обучения потери нужно добавлять вручную.
l = loss(net(X), y) + net.losses
grads = tape.gradient(l, net.trainable_variables)
trainer.apply_gradients(zip(grads, net.trainable_variables))
if (epoch + 1) % 5 == 0:
animator.add(epoch + 1, (d2l.evaluate_loss(net, train_iter, loss),
d2l.evaluate_loss(net, test_iter, loss)))
print('L2-норма w:', tf.norm(net.get_weights()[0]).numpy())
PaddlePaddle:
def train_concise(wd):
weight_attr = paddle.framework.ParamAttr(initializer=paddle.nn.initializer.Normal(mean=0.0, std=1.0))
bias_attr = paddle.framework.ParamAttr(initializer=paddle.nn.initializer.Normal(mean=0.0, std=1.0))
net = nn.Sequential(nn.Linear(num_inputs, 1, weight_attr=weight_attr, bias_attr=bias_attr))
loss = nn.MSELoss()
num_epochs, lr = 100, 0.003
# Параметры смещения не затухают.
trainer = paddle.optimizer.SGD(parameters=net[0].parameters(), learning_rate=lr, weight_decay=wd*1.0)
animator = d2l.Animator(xlabel='эпохи', ylabel='потери', yscale='log',
xlim=[5, num_epochs], legend=['обучение', 'тест'])
for epoch in range(num_epochs):
for X, y in train_iter:
l = loss(net(X), y)
l.backward()
trainer.step()
trainer.clear_grad()
if (epoch + 1) % 5 == 0:
animator.add(epoch + 1, (d2l.evaluate_loss(net, train_iter, loss),
d2l.evaluate_loss(net, test_iter, loss)))
print('L2-норма w:', net[0].weight.norm().item())
Эти графики выглядят так же, как графики при реализации затухания весов с нуля. Однако они работают быстрее и проще в реализации. Для более сложных задач это преимущество будет заметнее.
train_concise(0)
train_concise(3)
До сих пор мы касались только понятия простой линейной функции. Что считать простой нелинейной функцией — вопрос более сложный. Например, воспроизводящие ядерные гильбертовы пространства (RKHS) позволяют применять для нелинейных функций инструменты, введённые для линейных. К сожалению, алгоритмы на основе RKHS плохо масштабируются на большие многомерные данные. В этой книге мы по умолчанию будем использовать простую эвристику: применять затухание весов ко всем слоям глубокой сети.
Резюме
- Регуляризация — распространённый способ борьбы с переобучением: к функции потерь на обучающем наборе добавляется штрафной член, чтобы снизить сложность полученной модели.
- Особый способ сохранить модель простой — затухание весов с -штрафом. Это приводит к затуханию весов на шаге обновления алгоритма обучения.
- Затухание весов поддерживается оптимизаторами фреймворков глубокого обучения.
- В одной и той же реализации обучения разные наборы параметров могут вести себя по-разному при обновлении.
Упражнения
- Поэкспериментируйте со значениями в задаче из этого раздела. Постройте график точности на обучении и на тесте как функцию . Что вы наблюдаете?
- Используйте проверочный набор, чтобы найти наилучшее значение . Действительно ли оно оптимально? Важно ли это?
- Какими будут уравнения обновления, если в качестве штрафа используется (регуляризация )?
- Мы знаем, что . Можно ли найти аналогичное матричное уравнение (см. норму Фробениуса в разделе 2.3.10)?
- Вспомните связь между ошибкой обучения и ошибкой обобщения. Кроме затухания весов, увеличения объёма обучающих данных и использования модели подходящей сложности, какие ещё способы борьбы с переобучением вы можете придумать?
- В байесовской статистике мы используем произведение априорного распределения и правдоподобия. Через формулу получаем апостериорное распределение. Как получить регуляризацию через ?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
4.6 Исключение (dropout)
В разделе 4.5 мы познакомились с классическим методом регуляризации статистических моделей: штрафом за -норму весов. С вероятностной точки зрения обоснование этого метода такое: мы уже предполагали априорное распределение, согласно которому значения весов берутся из гауссова распределения с нулевым математическим ожиданием. Более наглядно: мы хотим, чтобы модель извлекала признаки глубже, то есть распределяла веса между многими признаками, а не слишком полагалась на несколько потенциально ложных связей.
4.6.1 Переосмысление переобучения
Когда признаков много, а примеров мало, линейные модели склонны к переобучению. И наоборот: когда примеров больше, чем признаков, линейные модели обычно не переобучаются. К сожалению, надёжность обобщения линейных моделей имеет свою цену. Проще говоря, линейные модели не учитывают взаимодействия между признаками. Для каждого признака линейная модель должна задать положительный или отрицательный вес, не обращая внимания на остальные признаки.
Этот фундаментальный компромисс между обобщающей способностью и гибкостью называют компромиссом между смещением и дисперсией (bias-variance tradeoff). Линейные модели имеют большое смещение: они способны представлять лишь небольшой класс функций. Однако дисперсия таких моделей мала: на разных случайных выборках данных они дают похожие результаты.
Глубокие нейронные сети находятся на другом конце спектра смещения и дисперсии. В отличие от линейных моделей, нейронные сети не ограничиваются тем, что рассматривают каждый признак по отдельности, а выучивают взаимодействия между признаками. Например, нейронная сеть может вывести, что сочетание слов «Нигерия» и «Western Union» в письме указывает на спам, хотя по отдельности эти слова спамом не являются.
Даже когда примеров гораздо больше, чем признаков, глубокая нейронная сеть может переобучиться. В 2017 году группа исследователей обучила глубокие сети на изображениях со случайными метками. Это продемонстрировало огромную гибкость нейронных сетей: людям трудно связать входы со случайными выходными метками, но нейронная сеть, оптимизируемая стохастическим градиентным спуском, может безошибочно пометить каждое изображение обучающего набора. Что это означает? Предположим, метки распределены равномерно случайно и есть 10 классов. Тогда классификатор на тестовых данных едва ли сможет превзойти точность 10%, так что разрыв в обобщении составит 90%, то есть переобучение будет очень сильным.
Свойства обобщения глубоких сетей остаются загадкой, а математические основы этого явления — открытым исследовательским вопросом. Читателей, которым интересна теория, мы призываем изучить эту тему глубже. В этом разделе мы сосредоточимся на практических инструментах, которые помогают улучшить обобщающую способность глубоких сетей.
4.6.2 Устойчивость к возмущениям
Прежде чем разбираться в обобщающей способности, определим, что такое «хорошая» модель предсказания. Мы ожидаем, что хорошая модель будет хорошо работать на неизвестных данных. Классическая теория обобщения утверждает, что для сокращения разрыва между результатами на обучении и на тесте нужно ориентироваться на простые модели. Простота может проявляться в малой размерности; мы обсуждали это в разделе 4.4, рассматривая одночлены в линейных моделях. Кроме того, как мы видели в разделе 4.5, при обсуждении затухания весов (-регуляризации), норма параметров тоже служит полезной мерой простоты.
Ещё один взгляд на простоту — гладкость: функция не должна быть чувствительна к малым изменениям входа. Например, при классификации изображений мы ожидаем, что добавление случайного шума к пикселям практически не повлияет на результат. В 1995 году Кристофер Бишоп показал, что обучение с входным шумом эквивалентно регуляризации Тихонова (Bishop, 1995). Эта работа математически подтвердила связь между требованием гладкости функции и требованием её устойчивости к случайному шуму на входе.
Затем в 2014 году Сривастава и соавторы (Srivastava et al., 2014) предложили, как применить идею Бишопа к внутренним слоям сети. Их идея: во время обучения вводить шум в каждый слой сети перед вычислением последующих слоёв. Ведь при обучении глубокой сети с несколькими слоями введение шума лишь усиливает гладкость отображения «вход — выход».
Этот приём получил название исключение (dropout). Исключение во время прямого распространения вводит шум при вычислении каждого внутреннего слоя; сейчас это распространённый приём обучения нейронных сетей. Метод назвали исключением, потому что в ходе обучения мы как бы отбрасываем (drop out) некоторые нейроны. На каждой итерации обучения стандартное исключение заключается в том, что перед вычислением следующего слоя часть узлов текущего слоя обнуляется.
Стоит отметить, что в оригинальной статье об исключении приводится аналогия с половым размножением. Переобучение нейронных сетей связано с тем, что каждый слой зависит от активаций предыдущего слоя; такое состояние авторы называют «коадаптацией». По их мнению, исключение разрушает коадаптацию так же, как половое размножение разрушает коадаптированные гены.
Тогда ключевая задача — понять, как именно вводить такой шум. Одна из идей — вводить шум несмещённым (unbiased) образом. Тогда при фиксированных остальных слоях математическое ожидание каждого слоя совпадает с его значением без шума.
В работе Бишопа к входам линейной модели добавляли гауссов шум. На каждой итерации обучения к входу добавлялся шум , распределённый с нулевым математическим ожиданием. Так получается возмущённая точка , для которой математическое ожидание .
В стандартной регуляризации исключением смещение каждого слоя устраняется нормировкой на долю сохранённых (не отброшенных) узлов. Иными словами, каждая промежуточная активация с вероятностью исключения заменяется случайной величиной следующим образом:
По построению математическое ожидание такой модели не меняется: .
4.6.3 Исключение на практике
Вспомним многослойный перцептрон с одним скрытым слоем и пятью скрытыми нейронами (рис. 4.1.1). Если применить исключение к скрытому слою, обнуляя скрытые нейроны с вероятностью , результат можно рассматривать как сеть, состоящую только из подмножества исходных нейронов. Например, на рис. 4.6.1 удалены и , поэтому вычисление выхода больше не зависит от и , а их градиенты при обратном распространении тоже обнуляются. Так слой выходов не может чрезмерно полагаться ни на один из элементов .
Рис. 4.6.1. Многослойный перцептрон до и после исключения (dropout)
Обычно при тестировании исключение не применяют. Для обученной модели и нового примера мы не отбрасываем никаких узлов, поэтому нормировка не нужна. Однако есть исключения: некоторые исследователи применяют исключение и на этапе тестирования, чтобы оценить «неопределённость» предсказаний нейронной сети. Если предсказания, полученные при множестве различных масок исключения, совпадают, можно сказать, что сеть работает стабильнее.
4.6.4 Реализация с нуля
Чтобы реализовать функцию исключения для одного слоя, мы берём выборку из равномерного распределения размером, равным размерности слоя нейронной сети. Затем сохраняем узлы, для которых значение выборки больше , а остальные отбрасываем.
В приведённом ниже коде мы реализуем функцию dropout_layer, которая отбрасывает элементы тензора входа X с вероятностью dropout, а оставшиеся элементы масштабирует, деля их на 1.0-dropout.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, gluon, init, np, npx
from mxnet.gluon import nn
npx.set_np()
def dropout_layer(X, dropout):
assert 0 <= dropout <= 1
# В этом случае все элементы отбрасываются
if dropout == 1:
return np.zeros_like(X)
# В этом случае все элементы сохраняются
if dropout == 0:
return X
mask = np.random.uniform(0, 1, X.shape) > dropout
return mask.astype(np.float32) * X / (1.0 - dropout)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
def dropout_layer(X, dropout):
assert 0 <= dropout <= 1
# В этом случае все элементы отбрасываются
if dropout == 1:
return torch.zeros_like(X)
# В этом случае все элементы сохраняются
if dropout == 0:
return X
mask = (torch.rand(X.shape) > dropout).float()
return mask * X / (1.0 - dropout)
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
def dropout_layer(X, dropout):
assert 0 <= dropout <= 1
# В этом случае все элементы отбрасываются
if dropout == 1:
return tf.zeros_like(X)
# В этом случае все элементы сохраняются
if dropout == 0:
return X
mask = tf.random.uniform(
shape=tf.shape(X), minval=0, maxval=1) < 1 - dropout
return tf.cast(mask, dtype=tf.float32) * X / (1.0 - dropout)
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
from paddle import nn
import random
warnings.filterwarnings("ignore", category=DeprecationWarning)
from d2l import paddle as d2l
def dropout_layer(X, dropout):
assert 0 <= dropout <= 1
# В этом случае все элементы отбрасываются.
if dropout == 1:
return paddle.zeros_like(X)
# В этом случае все элементы сохраняются.
if dropout == 0:
return X
mask = (paddle.to_tensor(paddle.uniform(X.shape)) > dropout).astype('float32')
return mask * X / (1.0 - dropout)
Проверим функцию dropout_layer на нескольких примерах.
Пропустим вход X через исключение с вероятностями 0, 0.5 и 1.
MXNet:
X = np.arange(16).reshape(2, 8)
print(dropout_layer(X, 0))
print(dropout_layer(X, 0.5))
print(dropout_layer(X, 1))
PyTorch:
X= torch.arange(16, dtype = torch.float32).reshape((2, 8))
print(X)
print(dropout_layer(X, 0.))
print(dropout_layer(X, 0.5))
print(dropout_layer(X, 1.))
TensorFlow:
X = tf.reshape(tf.range(16, dtype=tf.float32), (2, 8))
print(X)
print(dropout_layer(X, 0.))
print(dropout_layer(X, 0.5))
print(dropout_layer(X, 1.))
PaddlePaddle:
X= paddle.arange(16, dtype = paddle.float32).reshape((2, 8))
print(X)
print(dropout_layer(X, 0.))
print(dropout_layer(X, 0.5))
print(dropout_layer(X, 1.))
4.6.4.1 Определение параметров модели
Как и раньше, используем набор данных Fashion-MNIST, введённый в разделе 3.5. Определим многослойный перцептрон с двумя скрытыми слоями, каждый из которых содержит 256 элементов.
MXNet:
num_inputs, num_outputs, num_hiddens1, num_hiddens2 = 784, 10, 256, 256
W1 = np.random.normal(scale=0.01, size=(num_inputs, num_hiddens1))
b1 = np.zeros(num_hiddens1)
W2 = np.random.normal(scale=0.01, size=(num_hiddens1, num_hiddens2))
b2 = np.zeros(num_hiddens2)
W3 = np.random.normal(scale=0.01, size=(num_hiddens2, num_outputs))
b3 = np.zeros(num_outputs)
params = [W1, b1, W2, b2, W3, b3]
for param in params:
param.attach_grad()
PyTorch, PaddlePaddle:
num_inputs, num_outputs, num_hiddens1, num_hiddens2 = 784, 10, 256, 256
TensorFlow:
num_outputs, num_hiddens1, num_hiddens2 = 10, 256, 256
4.6.4.2 Определение модели
Исключение можно применять к выходу каждого скрытого слоя (после функции активации), и вероятность исключения можно задавать для каждого слоя отдельно. Распространённый приём — ставить меньшую вероятность исключения ближе ко входному слою. Ниже модель задаёт вероятность исключения 0.2 для первого скрытого слоя и 0.5 для второго; исключение действует только при обучении.
MXNet:
dropout1, dropout2 = 0.2, 0.5
def net(X):
X = X.reshape(-1, num_inputs)
H1 = npx.relu(np.dot(X, W1) + b1)
# Dropout используется только при обучении модели
if autograd.is_training():
# Добавить слой dropout после первого полносвязного слоя
H1 = dropout_layer(H1, dropout1)
H2 = npx.relu(np.dot(H1, W2) + b2)
if autograd.is_training():
# Добавить слой dropout после второго полносвязного слоя
H2 = dropout_layer(H2, dropout2)
return np.dot(H2, W3) + b3
PyTorch:
dropout1, dropout2 = 0.2, 0.5
class Net(nn.Module):
def __init__(self, num_inputs, num_outputs, num_hiddens1, num_hiddens2,
is_training = True):
super(Net, self).__init__()
self.num_inputs = num_inputs
self.training = is_training
self.lin1 = nn.Linear(num_inputs, num_hiddens1)
self.lin2 = nn.Linear(num_hiddens1, num_hiddens2)
self.lin3 = nn.Linear(num_hiddens2, num_outputs)
self.relu = nn.ReLU()
def forward(self, X):
H1 = self.relu(self.lin1(X.reshape((-1, self.num_inputs))))
# Dropout используется только при обучении модели
if self.training == True:
# Добавить слой dropout после первого полносвязного слоя
H1 = dropout_layer(H1, dropout1)
H2 = self.relu(self.lin2(H1))
if self.training == True:
# Добавить слой dropout после второго полносвязного слоя
H2 = dropout_layer(H2, dropout2)
out = self.lin3(H2)
return out
net = Net(num_inputs, num_outputs, num_hiddens1, num_hiddens2)
TensorFlow:
dropout1, dropout2 = 0.2, 0.5
class Net(tf.keras.Model):
def __init__(self, num_outputs, num_hiddens1, num_hiddens2):
super().__init__()
self.input_layer = tf.keras.layers.Flatten()
self.hidden1 = tf.keras.layers.Dense(num_hiddens1, activation='relu')
self.hidden2 = tf.keras.layers.Dense(num_hiddens2, activation='relu')
self.output_layer = tf.keras.layers.Dense(num_outputs)
def call(self, inputs, training=None):
x = self.input_layer(inputs)
x = self.hidden1(x)
# Dropout используется только при обучении модели
if training:
# Добавить слой dropout после первого полносвязного слоя
x = dropout_layer(x, dropout1)
x = self.hidden2(x)
if training:
# Добавить слой dropout после второго полносвязного слоя
x = dropout_layer(x, dropout2)
x = self.output_layer(x)
return x
net = Net(num_outputs, num_hiddens1, num_hiddens2)
PaddlePaddle:
dropout1, dropout2 = 0.2, 0.5
class Net(nn.Layer):
def __init__(self, num_inputs, num_outputs, num_hiddens1, num_hiddens2,
is_training = True):
super(Net, self).__init__()
self.num_inputs = num_inputs
self.training = is_training
self.lin1 = nn.Linear(num_inputs, num_hiddens1)
self.lin2 = nn.Linear(num_hiddens1, num_hiddens2)
self.lin3 = nn.Linear(num_hiddens2, num_outputs)
self.relu = nn.ReLU()
def forward(self, X):
H1 = self.relu(self.lin1(X.reshape((-1, self.num_inputs))))
# Dropout используется только при обучении модели
if self.training == True:
# Добавить слой dropout после первого полносвязного слоя
H1 = dropout_layer(H1, dropout1)
H2 = self.relu(self.lin2(H1))
if self.training == True:
# Добавить слой dropout после второго полносвязного слоя
H2 = dropout_layer(H2, dropout2)
out = self.lin3(H2)
return out
net = Net(num_inputs, num_outputs, num_hiddens1, num_hiddens2)
4.6.4.3 Обучение и тестирование
Это похоже на обучение и тестирование многослойного перцептрона, описанные выше.
MXNet:
num_epochs, lr, batch_size = 10, 0.5, 256
loss = gluon.loss.SoftmaxCrossEntropyLoss()
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs,
lambda batch_size: d2l.sgd(params, lr, batch_size))
PyTorch:
num_epochs, lr, batch_size = 10, 0.5, 256
loss = nn.CrossEntropyLoss(reduction='none')
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
trainer = torch.optim.SGD(net.parameters(), lr=lr)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
TensorFlow:
num_epochs, lr, batch_size = 10, 0.5, 256
loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
trainer = tf.keras.optimizers.SGD(learning_rate=lr)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
PaddlePaddle:
num_epochs, lr, batch_size = 10, 0.5, 256
loss = nn.CrossEntropyLoss(reduction='none')
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
trainer = paddle.optimizer.SGD(learning_rate=lr, parameters=net.parameters())
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
4.6.5 Краткая реализация
В высокоуровневом API фреймворков достаточно добавить слой Dropout после каждого полносвязного слоя и передать вероятность исключения единственным аргументом конструктора.
При обучении слой Dropout случайным образом отбрасывает выход предыдущего слоя (то есть вход следующего слоя) с заданной вероятностью.
При тестировании слой Dropout только передаёт данные дальше.
MXNet:
net = nn.Sequential()
net.add(nn.Dense(256, activation="relu"),
# Добавить слой dropout после первого полносвязного слоя
nn.Dropout(dropout1),
nn.Dense(256, activation="relu"),
# Добавить слой dropout после второго полносвязного слоя
nn.Dropout(dropout2),
nn.Dense(10))
net.initialize(init.Normal(sigma=0.01))
PyTorch:
net = nn.Sequential(nn.Flatten(),
nn.Linear(784, 256),
nn.ReLU(),
# Добавить слой dropout после первого полносвязного слоя
nn.Dropout(dropout1),
nn.Linear(256, 256),
nn.ReLU(),
# Добавить слой dropout после второго полносвязного слоя
nn.Dropout(dropout2),
nn.Linear(256, 10))
def init_weights(m):
if type(m) == nn.Linear:
nn.init.normal_(m.weight, std=0.01)
net.apply(init_weights);
TensorFlow:
net = tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(256, activation=tf.nn.relu),
# Добавить слой dropout после первого полносвязного слоя
tf.keras.layers.Dropout(dropout1),
tf.keras.layers.Dense(256, activation=tf.nn.relu),
# Добавить слой dropout после второго полносвязного слоя
tf.keras.layers.Dropout(dropout2),
tf.keras.layers.Dense(10),
])
PaddlePaddle:
weight_attr = paddle.ParamAttr(initializer=paddle.nn.initializer.Normal(std=0.01))
net = nn.Sequential(nn.Flatten(),
nn.Linear(784, 256, weight_attr=weight_attr),
nn.ReLU(),
# Добавить слой dropout после первого полносвязного слоя
nn.Dropout(dropout1),
nn.Linear(256, 256, weight_attr=weight_attr),
nn.ReLU(),
# Добавить слой dropout после второго полносвязного слоя
nn.Dropout(dropout2),
nn.Linear(256, 10, weight_attr=weight_attr))
Далее обучим и протестируем модель.
MXNet:
trainer = gluon.Trainer(net.collect_params(), 'sgd', {'learning_rate': lr})
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
PyTorch:
trainer = torch.optim.SGD(net.parameters(), lr=lr)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
TensorFlow:
trainer = tf.keras.optimizers.SGD(learning_rate=lr)
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
PaddlePaddle:
trainer = paddle.optimizer.SGD(learning_rate=0.5, parameters=net.parameters())
d2l.train_ch3(net, train_iter, test_iter, loss, num_epochs, trainer)
Резюме
- Исключение в прямом распространении отбрасывает часть нейронов при вычислении каждого внутреннего слоя.
- Исключение помогает избежать переобучения; обычно его используют вместе с методами, которые контролируют размерность и размер весовых векторов.
- Исключение заменяет активацию случайной величиной с математическим ожиданием .
- Исключение применяется только при обучении.
Упражнения
- Что произойдёт, если изменить вероятности исключения для первого и второго слоёв? В частности, что будет, если поменять эти слои местами? Спроектируйте эксперимент, чтобы ответить на эти вопросы, количественно опишите результат и сформулируйте качественные выводы.
- Увеличьте число эпох обучения и сравните результаты с исключением и без него.
- Какова дисперсия активаций в каждом скрытом слое при применении и без применения исключения? Постройте график того, как дисперсия активаций каждого скрытого слоя меняется со временем для обеих моделей.
- Почему при тестировании обычно не используют исключение?
- Возьмите модель из этого раздела в качестве примера и сравните эффекты исключения и затухания весов. Что произойдёт, если использовать исключение и затухание весов одновременно? Складываются ли их эффекты? Уменьшается ли выигрыш (или становится хуже)? Они взаимно компенсируют друг друга?
- Что произойдёт, если применять исключение к отдельным весам матрицы весов, а не к активациям?
- Придумайте другой метод введения случайного шума в каждый слой, отличный от стандартного исключения. Попробуйте разработать метод, который при фиксированной архитектуре на наборе Fashion-MNIST работает лучше исключения.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
4.7 Прямое распространение, обратное распространение и вычислительные графы
Мы уже знаем, как обучать модель с помощью минибатчевого стохастического градиентного спуска. Однако при реализации этого алгоритма мы учитывали только вычисления, связанные с прямым распространением (forward propagation). При вычислении градиентов мы лишь вызывали функцию обратного распространения, предоставляемую фреймворком глубокого обучения, не вдаваясь в детали.
Автоматическое вычисление градиентов (автоматическое дифференцирование) сильно упрощает реализацию алгоритмов глубокого обучения. До появления автоматического дифференцирования даже небольшая корректировка сложной модели требовала пересчёта громоздких производных, а научным статьям приходилось тратить много страниц на вывод правил обновления. В этом разделе на основе базовой математики и вычислительных графов мы подробно рассмотрим обратное распространение ошибки. Для начала сосредоточимся на многослойном перцептроне с одним скрытым слоем и затуханием весов (-регуляризацией).
4.7.1 Прямое распространение
Прямое распространение (forward propagation, или forward pass) — это последовательное, от входного слоя к выходному, вычисление и сохранение результатов каждого слоя нейронной сети.
Разберём шаг за шагом механику нейронной сети с одним скрытым слоем. Для простоты будем считать, что входной пример , а скрытый слой не содержит смещения. Промежуточная переменная здесь:
где — веса скрытого слоя. Пропустив промежуточную переменную через функцию активации , получаем вектор скрытых активаций длины :
Скрытая переменная тоже является промежуточной. Пусть параметры выходного слоя состоят только из весов . Тогда выходная переменная — вектор длины :
Пусть функция потерь равна , а метка примера — . Тогда можно вычислить потери для одного примера данных:
По определению -регуляризации при заданном гиперпараметре регуляризационный член равен
где норма Фробениуса матрицы — это -норма, применённая к матрице, развёрнутой в вектор. Наконец, регуляризованные потери модели на данном примере данных равны:
В дальнейшем обсуждении будем называть целевой функцией (objective function).
4.7.2 Вычислительный граф прямого распространения
Построение вычислительного графа помогает наглядно представить зависимости между операторами и переменными в вычислении. На рис. 4.7.1 показан вычислительный граф для описанной простой сети. Квадраты обозначают переменные, а круги — операторы. Входы находятся в левом нижнем углу, а выходы — в правом верхнем. Обратите внимание, что стрелки, показывающие поток данных, направлены в основном вправо и вверх.
Рис. 4.7.1. Вычислительный граф прямого распространения
4.7.3 Обратное распространение ошибки
Обратное распространение ошибки (backward propagation, или backpropagation) — это метод вычисления градиентов параметров нейронной сети. Коротко говоря, метод по правилу цепочки из математического анализа обходит сеть в обратном порядке: от выходного слоя к входному. Алгоритм сохраняет все промежуточные переменные (частные производные), которые нужны для вычисления градиентов некоторых параметров. Пусть даны функции и , где входы и выходы — тензоры произвольной формы. По правилу цепочки можно вычислить производную по :
Здесь оператор перемножает свои аргументы после выполнения необходимых операций (транспонирования и перестановки аргументов). Для векторов всё просто: это обычное умножение матрицы на матрицу. Для тензоров высокой размерности используются соответствующие оси. Оператор объединяет все эти случаи.
Напомним, что параметрами простой сети с одним скрытым слоем из вычислительного графа (рис. 4.7.1) являются и . Цель обратного распространения — вычислить градиенты и . Для этого мы последовательно применяем правило цепочки и вычисляем градиенты каждой промежуточной переменной и параметра. Порядок вычислений противоположен порядку прямого распространения, потому что мы начинаем с результата вычислительного графа и движемся к параметрам. Первый шаг — вычислить градиенты целевой функции по слагаемым и :
Далее по правилу цепочки вычисляем градиент целевой функции по выходной переменной :
Затем вычисляем градиенты регуляризационного члена по двум параметрам:
Теперь можно вычислить градиент параметров, ближайших к выходному слою, . По правилу цепочки получаем:
Чтобы получить градиент по , нужно продолжить обратное распространение от выходного слоя к скрытому. Градиент по выходу скрытого слоя задаётся формулой:
Поскольку функция активации применяется поэлементно, для вычисления градиента промежуточной переменной , , нужно использовать поэлементное умножение, которое обозначим :
Наконец, получаем градиент параметров, ближайших к входному слою, . По правилу цепочки:
4.7.4 Обучение нейронных сетей
При обучении нейронной сети прямое и обратное распространение зависят друг от друга. При прямом распространении мы проходим вычислительный граф в направлении зависимостей и вычисляем все переменные на пути. Затем эти значения используются при обратном распространении, где порядок вычислений противоположен.
Рассмотрим нашу простую сеть. С одной стороны, при прямом распространении регуляризационный член (формула (4.7.1)) зависит от текущих значений параметров модели и . Эти значения задаёт алгоритм оптимизации по результатам обратного распространения на последней итерации. С другой стороны, при обратном распространении вычисление градиентов параметров (формула (4.7.2)) зависит от текущего значения скрытой переменной , которое задаёт прямое распространение.
Поэтому при обучении нейронной сети, после инициализации параметров модели, мы чередуем прямое и обратное распространение, используя градиенты, полученные при обратном распространении, для обновления параметров модели. Обратите внимание, что обратное распространение повторно использует промежуточные значения, сохранённые при прямом распространении, чтобы не вычислять их заново. Одно из следствий: промежуточные значения нужно хранить до завершения обратного распространения. Это одна из причин, почему обучение требует больше памяти (видеопамяти), чем одно только предсказание. Кроме того, размер этих промежуточных значений примерно пропорционален числу слоёв сети и размеру батча. Поэтому обучение глубоких сетей на больших батчах легче приводит к ошибке нехватки памяти (out of memory).
Резюме
- Прямое распространение последовательно вычисляет и сохраняет промежуточные переменные в вычислительном графе, определённом нейронной сетью, от входного слоя к выходному.
- Обратное распространение ошибки последовательно, в обратном порядке (от выходного слоя к входному), вычисляет и сохраняет градиенты промежуточных переменных и параметров нейронной сети.
- При обучении моделей глубокого обучения прямое и обратное распространение зависят друг от друга.
- Обучение требует больше памяти, чем предсказание.
Упражнения
- Пусть для скалярной функции аргумент — матрица размера . Какова размерность градиента по ?
- Добавьте смещение в скрытый слой модели, описанной в этом разделе (в регуляризационный член смещение включать не нужно).
- Нарисуйте соответствующий вычислительный граф.
- Выведите уравнения прямого и обратного распространения.
- Вычислите объём памяти, необходимый для обучения и предсказания модели, описанной в этом разделе.
- Предположим, что нужно вычислить вторую производную. Что произойдёт с вычислительным графом? Сколько времени, по вашей оценке, займут вычисления?
- Предположим, что вычислительный граф слишком велик для имеющегося у вас GPU.
- Попробуйте разделить его между несколькими GPU.
- Каковы преимущества и недостатки по сравнению с обучением на минибатчах?
4.8 Численная устойчивость и инициализация модели
До сих пор каждая реализованная нами модель инициализировала параметры из заранее заданного распределения. Можно подумать, что схема инициализации — нечто само собой разумеющееся, и не вникать в то, как именно её выбирают. Может даже показаться, что выбор схемы инициализации не так уж важен. На самом деле выбор схемы инициализации играет огромную роль в обучении нейронных сетей и критически важен для сохранения численной устойчивости. Более того, схемы инициализации интересным образом связаны с выбором нелинейных функций активации. Какую функцию мы выберем и как инициализируем параметры, может определить, насколько быстро сойдётся алгоритм оптимизации. Неудачный выбор может привести к взрыву или затуханию градиентов во время обучения. В этом разделе мы подробнее рассмотрим эти темы и обсудим некоторые полезные эвристики, которые пригодятся на протяжении всей работы с глубоким обучением.
4.8.1 Затухающие и взрывающиеся градиенты
Рассмотрим глубокую сеть с слоями, входом и выходом . Каждый слой задаётся преобразованием с параметрами — весами ; его скрытая переменная — (положим ). Нашу сеть можно записать так:
Если все скрытые переменные и входы — векторы, градиент по любому набору параметров можно записать так:
Другими словами, градиент — это произведение матриц и вектора градиента . Поэтому мы подвержены проблемам численного антипереполнения (underflow). Такие проблемы часто возникают, когда перемножается слишком много вероятностей. При работе с вероятностями распространённый приём — перейти к логарифмическому пространству, то есть перенести нагрузку представления чисел с мантиссы на показатель степени. К сожалению, в нашем случае проблема серьёзнее: матрицы изначально могут иметь самые разные собственные значения. Они могут быть как маленькими, так и большими, а их произведение — очень большим или очень малым.
Риски нестабильных градиентов не ограничиваются численным представлением: они угрожают и устойчивости алгоритма оптимизации. Возможны два варианта проблем. Первый — взрыв градиентов (gradient exploding): обновления параметров становятся слишком большими, и устойчивая сходимость модели нарушается. Второй — затухание градиентов (gradient vanishing): обновления параметров слишком малы, на каждом шаге параметры почти не сдвигаются, и модель перестаёт учиться.
4.8.1.1 Затухание градиентов
Раньше была популярна сигмоидная функция (упоминалась в разделе 4.1), потому что она напоминает пороговую функцию. Ранние искусственные нейронные сети вдохновлялись биологическими, и идея, что нейрон либо полностью активен, либо полностью неактивен (как биологический нейрон), была привлекательной. Однако именно сигмоида — одна из распространённых причин затухания градиентов. Рассмотрим подробнее, почему сигмоида приводит к затуханию градиентов.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, np, npx
npx.set_np()
x = np.arange(-8.0, 8.0, 0.1)
x.attach_grad()
with autograd.record():
y = npx.sigmoid(x)
y.backward()
d2l.plot(x, [y, x.grad], legend=['sigmoid', 'градиент'], figsize=(4.5, 2.5))
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
x = torch.arange(-8.0, 8.0, 0.1, requires_grad=True)
y = torch.sigmoid(x)
y.backward(torch.ones_like(x))
d2l.plot(x.detach().numpy(), [y.detach().numpy(), x.grad.numpy()],
legend=['sigmoid', 'градиент'], figsize=(4.5, 2.5))
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
x = tf.Variable(tf.range(-8.0, 8.0, 0.1))
with tf.GradientTape() as t:
y = tf.nn.sigmoid(x)
d2l.plot(x.numpy(), [y.numpy(), t.gradient(y, x).numpy()],
legend=['sigmoid', 'градиент'], figsize=(4.5, 2.5))
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
x = paddle.arange(start=-8.0, end=8.0, step=0.1, dtype='float32')
x.stop_gradient = False
y = paddle.nn.functional.sigmoid(x)
y.backward(paddle.ones_like(x))
d2l.plot(x.detach().numpy(), [y.detach().numpy(), x.grad.numpy()],
legend=['sigmoid', 'градиент'], figsize=(4.5, 2.5))
Как видно на графике, когда вход сигмоиды велик или мал по модулю, её градиент затухает. Кроме того, при обратном распространении через множество слоёв градиент всего произведения может затухнуть, если только входы сигмоиды не окажутся близкими к нулю. Когда слоёв много, без особой осторожности градиент может обрываться на каком-нибудь слое. Именно эта проблема долгое время мешала обучению глубоких сетей. Поэтому семейство более стабильных функций ReLU стало стандартным выбором на практике (хотя с точки зрения нейронаук это выглядит не слишком правдоподобно).
4.8.1.2 Взрыв градиентов
Взрыв градиентов может быть не менее проблематичным. Чтобы это продемонстрировать, сгенерируем 100 гауссовых случайных матриц и перемножим их с некоторой начальной матрицей. При выбранном нами масштабе (дисперсия ) произведение матриц взрывается. Если это происходит из-за инициализации глубокой сети, у градиентного спуска нет шансов сойтись.
MXNet:
M = np.random.normal(size=(4, 4))
print('Одна матрица \n', M)
for i in range(100):
M = np.dot(M, np.random.normal(size=(4, 4)))
print('После умножения на 100 матриц\n', M)
PyTorch:
M = torch.normal(0, 1, size=(4,4))
print('Одна матрица \n',M)
for i in range(100):
M = torch.mm(M,torch.normal(0, 1, size=(4, 4)))
print('После умножения на 100 матриц\n', M)
TensorFlow:
M = tf.random.normal((4, 4))
print('Одна матрица \n', M)
for i in range(100):
M = tf.matmul(M, tf.random.normal((4, 4)))
print('После умножения на 100 матриц\n', M.numpy())
PaddlePaddle:
M = paddle.normal(0, 1, shape=(4,4))
print('Одна матрица \n',M)
for i in range(100):
M = paddle.mm(M, paddle.normal(0, 1, shape=(4, 4)))
print('После умножения на 100 матриц\n', M)
4.8.1.3 Нарушение симметрии
Ещё одна проблема в проектировании нейронных сетей связана с симметрией, присущей их параметризации. Представим простой многослойный перцептрон с одним скрытым слоем и двумя скрытыми нейронами. Мы можем переставить веса первого слоя , а также веса выходного слоя, и получить ту же функцию. Первый скрытый нейрон ничем принципиально не отличается от второго. Иными словами, между скрытыми нейронами каждого слоя существует симметрия перестановок.
Предположим, выходной слой превращает два скрытых нейрона многослойного перцептрона в один выходной нейрон. Представим, что мы инициализируем все параметры скрытого слоя константой . Что тогда произойдёт? При прямом распространении оба скрытых нейрона получают одинаковые входы и параметры и выдают одинаковые активации, которые передаются выходному нейрону. При обратном распространении дифференцирование выходного нейрона по даёт градиент, все элементы которого равны. Поэтому после шага градиентного спуска (например, минибатчевого стохастического градиентного спуска) все элементы по-прежнему будут одинаковыми. Такие итерации никогда не нарушат симметрию, и выразительная способность сети никогда не будет полностью использована. Скрытый слой будет вести себя так, будто в нём всего один нейрон. Обратите внимание: хотя минибатчевый стохастический градиентный спуск не нарушает эту симметрию, регуляризация исключением (dropout) — нарушает.
4.8.2 Инициализация параметров
Один из способов решить (или хотя бы смягчить) описанные проблемы — правильная инициализация параметров. Внимательность при оптимизации и подходящая регуляризация могут дополнительно повысить устойчивость.
4.8.2.1 Инициализация по умолчанию
В предыдущих разделах, например в разделе 3.3, мы инициализировали веса из нормального распределения. Если метод инициализации не указан, фреймворк использует случайную инициализацию по умолчанию; для задач средней сложности она обычно работает хорошо.
4.8.2.2 Инициализация Xavier
Посмотрим, как распределён масштаб выходов полносвязного слоя без нелинейности (например, скрытых переменных). Для этого слоя с входами и соответствующими весами выход задаётся формулой
Веса независимо извлечены из одного и того же распределения. Предположим, что это распределение имеет нулевое среднее и дисперсию . Заметим, что это не значит, что распределение обязательно гауссово: важно лишь, чтобы существовали среднее и дисперсия. Теперь предположим, что входы слоя также имеют нулевое среднее и дисперсию , независимы от и друг от друга. В этом случае можно вычислить среднее и дисперсию :
Один из способов сохранить дисперсию неизменной — задать . Теперь рассмотрим обратное распространение: мы сталкиваемся с похожей проблемой, хотя градиенты распространяются от слоёв, более близких к выходу. Рассуждая так же, как для прямого распространения, видим, что дисперсия градиентов может возрасти, если не выполнено условие , где — число выходов слоя. Получается дилемма: одновременно выполнить оба условия невозможно. Поэтому достаточно потребовать:
На этом основана стандартная и практичная инициализация Xavier (Xavier initialization), названная по имени первого автора статьи, в которой она предложена (Glorot and Bengio, 2010). Обычно при инициализации Xavier веса берутся из гауссова распределения с нулевым средним и дисперсией . Можно также выбрать равномерное распределение: дисперсия равномерного распределения равна . Подставив в условие на , получим диапазон инициализации:
Хотя предположение «нет нелинейности» в нейронных сетях легко нарушается, на практике метод инициализации Xavier оказался эффективным.
4.8.2.3 Дополнительное чтение
Приведённые рассуждения лишь слегка затрагивают современные методы инициализации параметров. Фреймворки глубокого обучения обычно реализуют десятки различных эвристик. Кроме того, инициализация параметров остаётся активной областью фундаментальных исследований в глубоком обучении. Сюда относятся эвристики для связывания (разделения) параметров, сверхразрешения, последовательных моделей и других случаев. Например, Xiao et al. (2018) показали, что с помощью тщательно продуманной инициализации можно обучить нейронную сеть из 10 000 слоёв без архитектурных ухищрений.
Если вам интересна эта тема, мы рекомендуем подробно изучить материал этого раздела, прочитать статьи, в которых предлагаются и анализируются эти эвристики, а затем познакомиться с последними публикациями по теме. Возможно, вы даже наткнётесь на удачную идею или придумаете её сами и реализуете её в одном из фреймворков глубокого обучения.
Резюме
- Затухание и взрыв градиентов — частые проблемы глубоких сетей. При инициализации параметров нужна большая осторожность, чтобы градиенты и параметры оставались под контролем.
- Эвристические методы инициализации нужны, чтобы начальные градиенты не были ни слишком большими, ни слишком малыми.
- Функция активации ReLU смягчает проблему затухания градиентов, что ускоряет сходимость.
- Случайная инициализация необходима, чтобы нарушить симметрию до начала оптимизации.
- Инициализация Xavier показывает, что для каждого слоя дисперсия выхода не зависит от числа входов, а дисперсия градиентов не зависит от числа выходов.
Упражнения
- Помимо перестановочной симметрии многослойного перцептрона, можете ли вы придумать другие случаи, в которых нейронная сеть может обладать симметрией, которую нужно нарушить?
- Можно ли инициализировать все весовые параметры линейной регрессии или softmax-регрессии одним и тем же значением?
- Найдите в литературе аналитические оценки собственных значений произведения двух матриц. Что это говорит о том, как обеспечить правильные условия для градиентов?
- Если мы знаем, что некоторые члены расходятся, можем ли мы исправить это постфактум? Ознакомьтесь со статьёй о масштабировании скорости обучения по слоям (You et al., 2017).
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Glorot, X., & Bengio, Y. (2010). Understanding the difficulty of training deep feedforward neural networks. Proceedings of the Thirteenth International Conference on Artificial Intelligence and Statistics, 249–256.
4.9 Окружение и сдвиг распределения
Выше мы рассмотрели много практических применений машинного обучения: подгоняли модели под разные наборы данных. Однако мы ни разу не задумывались о том, откуда берутся данные и что мы в итоге собираемся делать с результатами модели. Обычно разработчики располагают некоторыми данными и спешат построить модель, не задумываясь об этих фундаментальных вопросах.
Многие неудачные внедрения машинного обучения (то есть практического применения) объясняются именно таким подходом. Иногда модель показывает отличную точность на тестовом наборе. Но когда распределение данных внезапно меняется, модель в эксплуатации терпит катастрофический провал. Ещё коварнее то, что развёртывание самой модели иногда становится катализатором, который нарушает распределение данных. Приведём немного абсурдный, но, возможно, реалистичный пример. Допустим, мы обучили модель риска дефолта для заёмщиков, которая предсказывает, кто вернёт кредит, а кто — нет. Модель обнаруживает, что с риском дефолта связана обувь заявителя: те, кто носит оксфорды, возвращают кредиты, а те, кто носит кроссовки, — нет. После этого модель может начать выдавать кредиты всем, кто носит оксфорды, и отказывать всем, кто носит кроссовки.
Такая ситуация может иметь катастрофические последствия. Во-первых, как только модель начинает принимать решения на основе обуви, клиенты это понимают и меняют своё поведение. Вскоре все заявители будут носить оксфорды, но их кредитоспособность при этом не возрастёт. Итак, в многочисленных приложениях машинного обучения возникают похожие проблемы: вводя решения, основанные на модели, в окружающую среду, мы можем испортить саму модель.
Мы не можем обсудить все проблемы в одном разделе, но хотим показать некоторые типичные из них, стимулировать критическое мышление и помочь вовремя замечать такие ситуации, чтобы смягчить катастрофический ущерб. Одни решения просты (требовать «правильных» данных), другие технически сложны (внедрять системы обучения с подкреплением), а третьим требуется выйти за рамки статистического прогнозирования и решить трудные философские вопросы, связанные с этической стороной применения алгоритмов.
4.9.1 Виды сдвига распределения
Начнём с того, как может меняться распределение данных и какие меры помогут сохранить качество модели. В классическом случае предполагается, что обучающие данные выбираются из некоторого распределения , а тестовые данные содержат неразмеченные примеры, извлечённые из другого распределения . Трезвый взгляд на вещи таков: без каких-либо предположений о взаимосвязи между и обучить классификатор невозможно.
Рассмотрим задачу бинарной классификации: отличить собак от кошек. Если распределение может сдвигаться произвольным образом, то возможна патологическая ситуация, когда распределение входов не меняется: , но метки полностью инвертируются: . Иными словами, все «кошки» в будущем окажутся собаками, а то, что мы раньше называли «собаками», станет кошками. Поскольку распределение входов при этом не меняется, нельзя отличить такую ситуацию от ситуации, в которой распределение вообще не меняется.
К счастью, при некоторых ограничивающих предположениях о том, как могут измениться данные в будущем, некоторые алгоритмы способны обнаружить такой сдвиг и даже динамически подстраиваться, повышая точность исходного классификатора.
4.9.1.1 Сдвиг ковариат (covariate shift)
Среди различных видов сдвига распределения, пожалуй, лучше всего изучен сдвиг ковариат. Здесь предполагается, что распределение входов может меняться со временем, но функция меток (то есть условное распределение ) не меняется. Статистики называют это сдвигом ковариат (covariate shift), поскольку проблема возникает из-за изменения распределения ковариат (признаков). Иногда можно делать выводы о сдвиге распределения, не привлекая причинно-следственные связи, но если мы считаем, что вызывает , то сдвиг ковариат — естественное предположение.
Рассмотрим задачу различения кошек и собак: обучающие данные включают изображения с рис. 4.9.1.
Рис. 4.9.1. Обучающие данные для различения кошек и собак
При тестировании нам нужно классифицировать изображения с рис. 4.9.2.
Рис. 4.9.2. Тестовые данные для различения кошек и собак
Обучающий набор состоит из настоящих фотографий, а тестовый содержит только мультяшные картинки. Если обучаться на наборе данных, существенно отличающемся по признакам от тестового, без методов адаптации к новой области могут возникнуть проблемы.
4.9.1.2 Сдвиг меток (label shift)
Сдвиг меток (label shift) описывает противоположную ситуацию по сравнению со сдвигом ковариат. Здесь предполагается, что маргинальная вероятность меток может меняться, а условное распределение классов между областями остаётся неизменным. Сдвиг меток — разумное предположение, когда мы считаем, что вызывает . Например, при предсказании болезни пациента мы можем опираться на симптомы, даже если относительная распространённость болезни со временем меняется. Сдвиг меток здесь уместен, потому что болезнь вызывает симптомы. В других случаях предположения о сдвиге меток и сдвиге ковариат могут выполняться одновременно. Например, если метки детерминированы, предположение о сдвиге ковариат выполняется, даже когда вызывает . Интересно, что в таких случаях методы, основанные на предположении о сдвиге меток, обычно оказываются предпочтительнее, поскольку они работают с объектом, который похож на метку (обычно низкоразмерный), а не на вход (обычно высокоразмерный).
4.9.1.3 Сдвиг концепции (concept shift)
Мы также можем столкнуться со сдвигом концепции (concept shift): ситуацией, когда меняется определение меток. Это звучит странно: кошка — это кошка, разве нет? Однако другие категории со временем тоже меняют значение в зависимости от контекста употребления. Диагностические критерии психических расстройств, мода, названия должностей и тому подобное — повседневные примеры сдвига концепции. Оказывается, если мы объедем Соединённые Штаты и будем менять источники данных в зависимости от географического положения, то обнаружим заметный сдвиг концепции в отношении названий «газированных напитков», как показано на рис. 4.9.3.
Рис. 4.9.3. Сдвиг концепции в названиях газированных напитков в США (карта: Alan McConchie, PopVsSoda.com, CC BY)
Если бы мы создавали систему машинного перевода, распределение могло бы зависеть от того, где мы находимся. Такую проблему может быть трудно заметить. Поэтому полезно использовать знание о сдвигах, которые постепенно происходят во времени или в пространстве.
4.9.2 Примеры сдвига распределения
Прежде чем углубляться в формальную часть и алгоритмы, рассмотрим несколько конкретных ситуаций, в которых сдвиг ковариат или концепции может быть неочевидным.
4.9.2.1 Медицинская диагностика
Допустим, мы хотим создать алгоритм обнаружения рака. Мы собираем данные здоровых людей и пациентов, обучаем на них алгоритм. Он хорошо работает, показывает высокую точность, и мы делаем вывод, что он готов к успешному применению в медицинской диагностике. Но не торопитесь.
Распределение данных, которые мы собрали для обучения, может заметно отличаться от того, с чем алгоритм столкнётся на практике. Это случилось со стартапом, с которым несколько авторов этой книги сотрудничали несколько лет назад. Стартап разрабатывал метод анализа крови для выявления заболевания, которое поражает пожилых мужчин, и хотел использовать образцы крови пациентов, которые у них были. Однако получить образцы крови у здоровых мужчин гораздо сложнее, чем у уже имеющихся в системе пациентов. В качестве компенсации стартап собирал донорскую кровь у студентов университетского кампуса, чтобы использовать её как здоровую контрольную группу для разработки тестов. Затем стартап спросил нас, можем ли мы помочь построить классификатор для выявления болезни.
Как мы объяснили им, действительно легко различать здоровых и больных с почти идеальной точностью. Однако это может объясняться тем, что испытуемые различаются по возрасту, уровню гормонов, физической активности, питанию, употреблению алкоголя и многим другим факторам, не связанным с болезнью. Классификатор для обнаружения болезни, вероятно, не будет работать на практике. В такой выборке может проявляться экстремальный сдвиг ковариат. Кроме того, такую ситуацию обычно нельзя исправить стандартными методами. Короче говоря, стартап напрасно потратил большие деньги.
4.9.2.2 Беспилотные автомобили
Одна из компаний, которая хотела использовать машинное обучение для разработки беспилотных автомобилей, ключевым компонентом сделала «детектор бордюров». Поскольку реальная аннотированная разметка дорогая, компания придумала «умную» идею: использовать синтетические данные из рендеринга игрового движка как дополнительные обучающие данные. Это хорошо сработало на «тестовых данных», взятых из того же движка, но в реальном автомобиле оказалось катастрофой. Как выяснилось, бордюры в движке были отрисованы очень простой текстурой. Более того, все бордюры были отрисованы одной и той же текстурой, и детектор бордюров быстро выучил именно этот «признак».
Нечто похожее произошло, когда армия США впервые попыталась обнаруживать танки в лесу. Аэрофотоснимки леса без танков сделали одним набором, а затем, поставив танки в лес, сделали второй набор снимков. Классификатор, обученный на этих двух наборах, казался работающим очень хорошо. К сожалению, классификатор научился лишь отличать деревья с тенями от деревьев без теней: первый набор снимков был сделан утром, а второй — в полдень.
4.9.2.3 Нестационарные распределения
Более тонкая ситуация возникает, когда распределение меняется медленно, а модель не обновляется достаточно часто. Это называется нестационарным распределением (nonstationary distribution). Вот несколько типичных примеров:
- обучили модель для компьютерной рекламы, но не обновляли её достаточно часто (например, модель, обученная в 2009 году, не знает о неизвестном тогда новом устройстве iPad, которое только что вышло на рынок);
- построили фильтр спама, который хорошо обнаруживает весь спам. Однако авторы спама стали изобретательнее и создают новые сообщения, которые не похожи ни на один спам, встречавшийся раньше;
- построили систему рекомендации товаров, которая работала всю зиму, но продолжает рекомендовать рождественские шапки и спустя долгое время после Рождества.
4.9.2.4 Другие примеры
- Построили детектор лиц, который хорошо работает на всех эталонных тестах, но подводит на тестовых данных: проблемные примеры — крупные планы, где лицо занимает всё изображение (в обучающем наборе таких данных не было).
- Построили поисковую систему для рынка США и хотим развернуть её в Великобритании.
- Обучили классификатор изображений на крупном наборе данных, в котором количество примеров каждого класса почти одинаково, например 1000 классов по 1000 изображений в каждом. Но при развёртывании в реальном мире распределение фактических меток заведомо неравномерно.
4.9.3 Коррекция сдвига распределения
Как мы уже обсуждали, во многих случаях обучающее и тестовое распределения различаются. В некоторых случаях нам повезёт: модель будет работать корректно, несмотря на сдвиг ковариат, меток или концепции. В других случаях мы можем добиться лучшего результата, применив стратегии, которые смягчают сдвиг. Оставшаяся часть раздела посвящена техническим деталям методов, которые противодействуют такому сдвигу.
4.9.3.1 Эмпирический и истинный риски
Сначала поразмыслим о том, что же на самом деле происходит во время обучения модели? Признаки и метки обучающего набора данных перебираются, и после каждого минибатча параметры модели обновляются. Для простоты не будем учитывать регуляризацию, поэтому обучающие потери минимизируются:
где — функция потерь, которая измеряет, насколько «плохо» предсказание при заданной метке . Статистики называют эту величину в формуле (4.9.1) эмпирическим риском. Эмпирический риск (empirical risk) аппроксимирует истинный риск (true risk) — среднюю потерю на всех обучающих данных, то есть математическое ожидание потерь по всем данным, извлечённым из истинного распределения :
Однако на практике мы обычно не можем получить всю генеральную совокупность данных. Поэтому минимизация эмпирического риска (empirical risk minimization), то есть минимизация (4.9.1), — практическая стратегия машинного обучения, которая надеется приближённо минимизировать истинный риск.
4.9.3.2 Коррекция сдвига ковариат
Пусть для размеченных данных нам нужно оценить . Однако наблюдения взяты из некоторого исходного распределения , а не из целевого распределения . К счастью, предположение о зависимости означает, что условное распределение не меняется: . Если исходное распределение «неверно», мы можем скорректировать это, используя простое тождество при вычислении истинного риска:
Иными словами, нужно пересчитать вес каждого примера данных как отношение вероятностей того, что пример получен из правильного распределения, и того, что он получен из неправильного:
Подставив веса в каждый пример данных , мы можем обучить модель с помощью «взвешенной эмпирической минимизации риска»:
Поскольку это отношение неизвестно, его нужно оценить. Существует много методов, включая изощрённые подходы теории операторов, которые пытаются напрямую перекалибровать ожидаемый оператор с помощью принципа минимальной нормы или максимальной энтропии. Для любого из таких методов нам нужны выборки из двух распределений: «настоящего» распределения , доступного через тестовые данные, и обучающего распределения , которое легко получить искусственно. Заметим, что нам нужны только признаки , а доступ к меткам не требуется.
В этом случае есть очень эффективный метод, который даёт почти такие же хорошие результаты, как и исходный: логистическая регрессия (logistic regression). Это частный случай softmax-регрессии (см. раздел 3.4) для бинарной классификации. Итак, мы обучаем классификатор различать данные, извлечённые из , и данные, извлечённые из . Если два распределения невозможно различить, значит, соответствующие примеры могли быть получены из любого из них. С другой стороны, примеры, которые хорошо различаются, должны соответственно существенно увеличивать или уменьшать свой вес.
Для простоты предположим, что мы извлекаем одинаковое количество примеров из и из . Обозначим метку : для данных из и для данных из . Тогда вероятность в смешанном наборе данных равна
Поэтому, если используем логистическую регрессию, где ( — параметризованная функция), естественным образом получаем:
Итак, нам нужно решить две задачи. Первая — различить данные из двух распределений. Вторая — минимизировать взвешенный эмпирический риск (4.9.3), в котором слагаемые взвешены с коэффициентами .
Теперь рассмотрим полный алгоритм коррекции сдвига ковариат. Пусть есть обучающий набор и неразмеченный тестовый набор . При сдвиге ковариат предполагаем, что при взяты из некоторого исходного распределения, а — из целевого. Типичный алгоритм коррекции сдвига ковариат выглядит так:
- Сформировать обучающий набор для бинарной классификации: .
- Обучить бинарный классификатор с помощью логистической регрессии и получить функцию .
- Взвесить обучающие данные весами или, лучше, , где — константа.
- Обучить модель на с весами в функции (4.9.3).
Заметим, что этот алгоритм опирается на важное предположение: каждый пример данных из целевого распределения (например, тестового) должен иметь ненулевую вероятность появиться при обучении. Если мы найдём точку, в которой , но , соответствующий весовой коэффициент будет бесконечным.
4.9.3.3 Коррекция сдвига меток
Пусть мы решаем задачу классификации с классами. Используем те же обозначения, что и в разделе 4.9.3.2: и — исходное распределение (например, при обучении) и целевое распределение (например, при тестировании). Предположим, что распределение меток меняется со временем: , но условное распределение классов не меняется: . Если исходное распределение «неверно», можно внести поправку, используя тождество для истинного риска (4.9.2):
Здесь весовые коэффициенты соответствуют отношению правдоподобий меток
Преимущество сдвига меток в том, что если у нас есть достаточно хорошая модель на исходном распределении, то можно получить состоятельную оценку этих весов, не имея дела со всеми остальными измерениями. В глубоком обучении входы часто представляют собой высокоразмерные объекты (например, изображения), а метки обычно низкоразмерны (например, классы).
Чтобы оценить целевое распределение меток, сначала берём готовый классификатор с достаточно хорошими характеристиками (обычно обученный на обучающих данных) и вычисляем его матрицу ошибок на проверочном наборе (тоже из обучающего распределения). Матрица ошибок — это матрица размера , в которой каждый столбец соответствует классу метки, а каждая строка — классу предсказания модели. Значение каждой ячейки — это доля примеров проверочного набора, у которых истинная метка равна , а предсказание модели — .
Теперь мы не можем напрямую вычислить матрицу ошибок на целевых данных, поскольку не видим истинных меток в реальной среде, если только не построим сложный процесс разметки в реальном времени. Однако можно усреднить предсказания модели на тестовых данных и получить усреднённый выход модели , где -й элемент — суммарная оценка предсказаний модели для класса на тестовом наборе.
Оказывается, если классификатор изначально достаточно точен, целевые данные содержат только уже встречавшиеся классы, и выполняется предположение о сдвиге меток (это самое сильное предположение), то можно оценить распределение меток на тестовом наборе, решив простую линейную систему
поскольку как оценка выполняется для всех , где — -й элемент -мерного вектора распределения меток . Если классификатор изначально достаточно точен, матрица ошибок обратима, и мы получаем решение .
Поскольку метки исходных данных известны, оценить распределение несложно. Тогда для любого обучающего примера с меткой можно вычислить вес по оценённому отношению и подставить его во взвешенную минимизацию эмпирического риска (4.9.3).
4.9.3.4 Коррекция сдвига концепции
Сдвиг концепции трудно устранить принципиальным образом. Например, если задача внезапно меняется с «различения кошек и собак» на «различение белых и чёрных животных», то остаётся лишь заново собрать метки и обучить модель с нуля. К счастью, на практике такие резкие сдвиги редки. Обычно же изменения концепции происходят медленно. Вот несколько примеров:
- В компьютерной рекламе после выхода нового продукта старые продукты становятся менее популярными. Значит, распределение рекламы и её популярность меняются постепенно, и любой предсказатель кликов должен меняться вместе с ними;
- Из-за износа окружающей среды линзы дорожных камер постепенно портятся, ухудшая качество изображений;
- Новостной контент меняется постепенно (то есть появляются новые новости).
В таких случаях можно использовать тот же подход, что и при обучении сети: адаптировать её к изменениям данных. Иными словами, мы обновляем веса существующей сети новыми данными, а не обучаем её заново с нуля.
4.9.4 Таксономия задач обучения
Теперь, разобравшись, как справляться со сдвигом распределения, можно рассмотреть и другие аспекты формализации задач машинного обучения.
4.9.4.1 Пакетное обучение
При пакетном обучении (batch learning) у нас есть обучающие признаки и метки , с помощью которых мы обучаем . Затем эту модель применяют к новым данным из того же распределения. Например, мы можем обучить детектор кошек на большом количестве фотографий кошек и собак. После обучения детектор становится частью системы компьютерного зрения «умной кошачьей двери», которая пропускает только кошек. Затем эта система устанавливается у заказчика дома и практически больше не обновляется.
4.9.4.2 Онлайн-обучение
Помимо «пакетного» обучения, можно обучаться «онлайн», то есть на отдельных данных по одному. Точнее, сначала мы наблюдаем , затем выдаём оценку и только после этого наблюдаем . По нашему решению мы получаем вознаграждение или штраф. Многие практические задачи относятся к этому классу. Например, нам нужно предсказать завтрашнюю цену акций, чтобы на основе прогноза совершать сделки. В конце дня мы оцениваем, принёс ли прогноз прибыль. Иначе говоря, в онлайн-обучении (online learning) действует следующий цикл: получая новые наблюдения, мы непрерывно улучшаем модель.
4.9.4.3 Многорукие бандиты
Многорукие бандиты (bandits) — частный случай описанной задачи. В большинстве задач обучения у нас есть непрерывно параметризованная функция (например, глубокая сеть). В задаче многоруких бандитов же число доступных действий (рычагов, которые можно дёргать) конечно. Неудивительно, что для этой более простой задачи можно получить более сильные теоретические гарантии оптимальности. Мы упоминаем её в основном потому, что её часто рассматривают как отдельный сценарий обучения.
4.9.4.4 Управление
Во многих случаях среда «запоминает» наши действия. Не обязательно в состязательной форме, но она помнит, и её реакция зависит от предыдущих событий. Например, контроллер кофейного котла будет наблюдать разные температуры в зависимости от того, нагревали ли котёл до этого. В таких случаях популярным выбором служит алгоритм ПИД-регулятора (пропорционально-интегрально-дифференциальный). Аналогично поведение пользователя новостного сайта зависит от того, что ему показывали раньше (например, большинство новостей он читает только один раз). Многие такие алгоритмы строят модель среды, в которой их действия выглядят менее случайными. В последние годы теорию управления (например, варианты ПИД-регуляторов) также применяют для автоматической настройки гиперпараметров, чтобы получить лучшее качество декодирования и реконструкции, а также повысить разнообразие генерируемого текста и качество реконструкции изображений (Shao et al., 2020).
4.9.4.5 Обучение с подкреплением
Обучение с подкреплением (reinforcement learning) делает акцент на том, как действовать в среде, чтобы максимизировать ожидаемую выгоду. Примеры его применения — шахматы, го, нарды или StarCraft. Ещё пример — создание контроллера для беспилотного автомобиля или иная реакция на поведение других участников движения (например, попытка избежать препятствия, попытка спровоцировать аварию или попытка сотрудничать).
4.9.4.6 Учёт среды
Ключевое различие между описанными ситуациями состоит в том, что стратегия, которая работает в статичной среде, может перестать работать, если среда способна меняться. Например, арбитражная возможность, которую нашёл трейдер, скорее всего исчезнет, как только он начнёт её использовать. Скорость и характер изменений среды во многом определяют, какие алгоритмы мы можем применять. Например, если мы знаем, что всё меняется медленно, мы можем потребовать, чтобы любые оценки тоже менялись медленно. Если же мы знаем, что среда может меняться мгновенно, но такие изменения очень редки, мы можем учитывать это при использовании алгоритма. Такие знания особенно важны, когда задача, которую решает специалист по данным, со временем меняется.
4.9.5 Справедливость, ответственность и прозрачность в машинном обучении
Наконец, важно помнить, что, когда мы внедряем системы машинного обучения, мы оптимизируем не просто модель предсказания, а обычно предоставляем инструмент, который будет использоваться для (частично или полностью) автоматизированного принятия решений. Эти технические системы могут повлиять на жизнь каждого человека через принимаемые ими решения.
Переход от предсказаний к решениям ставит не только новые технические вопросы, но и ряд этических, которые нужно тщательно обдумать. Если мы внедряем систему медицинской диагностики, нужно знать, для каких групп людей она может работать, а для каких — нет. Игнорирование предвидимого риска для подгруппы населения может привести к низкому качеству медицинской помощи. Кроме того, спроектировав всю систему принятия решений, нужно отступить на шаг и заново продумать, как мы оцениваем нашу технологию. В результате такого смещения перспективы мы обнаружим, что точность редко оказывается подходящей мерой. Например, когда мы превращаем предсказания в действия, мы обычно учитываем потенциальную цену ошибок разного рода. К примеру, ошибочное отнесение изображения к одному классу может рассматриваться как расовая дискриминация, а ошибочное отнесение к другому классу — как безвредное. Тогда мы, возможно, должны соответствующим образом скорректировать пороги, учитывая эти социальные ценности при проектировании способа принятия решений. Нужно также следить за тем, как системы предсказаний создают петли обратной связи. Например, рассмотрим систему прогнозирующей полиции, которая направляет патрули в районы с предсказанным высоким уровнем преступности. Нетрудно увидеть, как появляется тревожная закономерность:
- В районах с высоким уровнем преступности патрулирование усиливается;
- Поэтому там обнаруживается больше правонарушений, и эти данные попадают в обучающие данные для будущих итераций;
- Видя больше положительных примеров, модель предсказывает, что в этих районах будет ещё больше преступлений;
- На следующей итерации обновлённая модель будет ещё сильнее ориентироваться на тот же район, что приведёт к выявлению ещё большего числа преступлений, и так далее.
Часто в процессе корректировки модели механизмы, которыми предсказания модели связаны с обучающими данными, не получают объяснения; исследователи называют это явление «неконтролируемой петлёй обратной связи». Кроме того, сначала нужно убедиться, что мы решаем правильную задачу. Например, алгоритмы предсказания сейчас играют огромную посредническую роль в распространении информации: должны ли новости, которые видит человек, определяться страницами Facebook, которые ему нравятся? Это лишь несколько из этических дилемм, с которыми можно столкнуться в карьере специалиста по машинному обучению.
Резюме
- Во многих случаях обучающие и тестовые наборы берутся не из одного распределения. Это называется сдвигом распределения.
- Истинный риск — это ожидаемая средняя потеря по всем данным, извлечённым из истинного распределения. Однако эту совокупность данных обычно получить нельзя. Эмпирический риск — средняя потеря на обучающих данных — используется для приближения истинного риска. На практике мы выполняем эмпирическую минимизацию риска.
- При соответствующих предположениях сдвиги ковариат и меток можно обнаружить и скорректировать ещё во время тестирования. Игнорирование такого сдвига при тестировании может стать проблемой.
- В некоторых случаях среда может запоминать автоматические действия и отвечать на них неожиданным образом. При построении моделей нужно учитывать эту возможность, продолжать мониторинг работающих систем и быть готовыми к тому, что модель и среда неожиданным образом переплетутся между собой.
Упражнения
- Что происходит, когда мы меняем поведение поисковой системы? Что могут сделать пользователи? А рекламодатели?
- Реализуйте детектор сдвига ковариат. Подсказка: постройте классификатор.
- Реализуйте коррекцию сдвига ковариат.
- Что ещё, помимо сдвига распределения, влияет на то, насколько эмпирический риск близок к истинному?
Литература
- Shao, H., Yao, S., Sun, D., Zhang, A., Liu, S., Liu, D., Wang, J., & Abdelzaher, T. (2020). ControlVAE: Controllable variational autoencoder. Proceedings of the 37th International Conference on Machine Learning.
4.10 Практика: соревнование Kaggle по прогнозированию цен на жильё
В предыдущих разделах мы познакомились с базовыми инструментами обучения глубоких сетей и методами регуляризации (такими как затухание весов и исключение). В этом разделе мы применим изученное на практике, участвуя в соревновании на Kaggle. Соревнование по прогнозированию цен на жильё на Kaggle — хорошая отправная точка. Этот набор данных собрал Барт Де Кок в 2011 году (De Cock, 2011); он охватывает цены на жильё в городе Эймс (штат Айова) в 2006–2010 годах. Набор довольно универсален, и для него не нужна сложная архитектура модели. Он гораздо больше и содержит больше признаков, чем известный набор данных о ценах на жильё в Бостоне, собранный Харрисоном и Рубинфельдом.
В этом разделе мы подробно рассмотрим предобработку данных, проектирование модели и выбор гиперпараметров. Проделав всё самостоятельно, вы получите практический опыт, который пригодится в работе специалиста по данным.
4.10.1 Загрузка и кэширование набора данных
На протяжении всей книги мы будем загружать различные наборы данных и обучать и тестировать на них модели.
Здесь мы реализуем несколько функций, которые упрощают загрузку данных.
Сначала создадим словарь DATA_HUB, который сопоставляет строковое имя набора данных с парой значений: URL набора данных и хеш-суммой SHA-1 для проверки целостности файла.
Все такие наборы данных размещены на сайте по адресу DATA_URL.
import os
import requests
import zipfile
import tarfile
import hashlib
#@save
DATA_HUB = dict()
DATA_URL = 'http://d2l-data.s3-accelerate.amazonaws.com/'
Функция download ниже загружает набор данных, кэширует его в локальном каталоге (по умолчанию ../data) и возвращает имя загруженного файла.
Если файл набора данных уже есть в каталоге кэша и его SHA-1 совпадает со значением из DATA_HUB, будет использован кэшированный файл, чтобы не скачивать его повторно.
def download(name, cache_dir=os.path.join('..', 'data')): #@save
"""Скачать файл из DATA_HUB и вернуть локальное имя файла"""
assert name in DATA_HUB, f"{name} отсутствует в {DATA_HUB}"
url, sha1_hash = DATA_HUB[name]
os.makedirs(cache_dir, exist_ok=True)
fname = os.path.join(cache_dir, url.split('/')[-1])
if os.path.exists(fname):
sha1 = hashlib.sha1()
with open(fname, 'rb') as f:
while True:
data = f.read(1048576)
if not data:
break
sha1.update(data)
if sha1.hexdigest() == sha1_hash:
return fname # Попадание в кэш
print(f'Загрузка {fname} из {url}...')
r = requests.get(url, stream=True, verify=True)
with open(fname, 'wb') as f:
f.write(r.content)
return fname
Нам также понадобятся две вспомогательные функции: одна скачивает и распаковывает zip- или tar-архив, а другая скачивает в кэш все наборы данных из DATA_HUB, используемые в книге.
def download_extract(name, folder=None): #@save
"""Скачать и распаковать zip/tar-файл"""
fname = download(name)
base_dir = os.path.dirname(fname)
data_dir, ext = os.path.splitext(fname)
if ext == '.zip':
fp = zipfile.ZipFile(fname, 'r')
elif ext in ('.tar', '.gz'):
fp = tarfile.open(fname, 'r')
else:
assert False, 'Распаковывать можно только zip/tar-файлы'
fp.extractall(base_dir)
return os.path.join(base_dir, folder) if folder else data_dir
def download_all(): #@save
"""Скачать все файлы из DATA_HUB"""
for name in DATA_HUB:
download(name)
4.10.2 Kaggle
Kaggle — популярная сегодня платформа для соревнований по машинному обучению; каждое соревнование строится вокруг как минимум одного набора данных. Многие соревнования спонсируются организациями, которые выплачивают премии за лучшие решения. Платформа помогает участникам общаться через форумы и обмениваться кодом, что способствует сотрудничеству и соперничеству. Погоня за местом в таблице лидеров нередко отвлекает от главного: некоторые исследователи близоруко сосредотачиваются на этапах предобработки, вместо того чтобы думать о фундаментальных вопросах. Но объективная платформа очень ценна: она позволяет напрямую и количественно сравнивать конкурирующие методы и делиться кодом. Так каждый может узнать, какие методы работают, а какие — нет. Чтобы участвовать в соревнованиях Kaggle, сначала нужно зарегистрировать аккаунт.
На странице соревнования по прогнозированию цен на жильё данные можно найти на вкладке «Data». Прогнозы можно отправить по адресу, указанному ниже, там же можно посмотреть свою позицию в рейтинге:
https://www.kaggle.com/c/house-prices-advanced-regression-techniques
Скриншоты страниц сайта Kaggle в книгу не включены: это страницы стороннего сайта.
4.10.3 Чтение набора данных
Обратите внимание, что данные соревнования разделены на обучающий и тестовый наборы. Каждая запись содержит характеристики дома и его атрибуты: тип улицы, год постройки, тип крыши, состояние подвала и так далее. Признаки имеют разные типы данных. Например, год постройки задан целым числом, тип крыши — дискретной категорией, остальные признаки — вещественными числами. Здесь реальность усложняет задачу: например, некоторые данные полностью отсутствуют, и пропуски просто помечены как «NA». Цена каждого дома указана только в обучающем наборе (в конце концов, это соревнование). Мы хотим разделить обучающий набор, чтобы создать проверочный набор, но после отправки прогнозов в Kaggle оценить модель мы сможем только на официальном тестовом наборе. На вкладке «Data» есть ссылки для скачивания данных.
Прежде чем начать, загрузим и обработаем данные с помощью pandas, с которым мы познакомились в разделе 2.2.
Поэтому перед продолжением нужно убедиться, что pandas установлен.
К счастью, если вы читаете эту книгу в Jupyter, можно установить pandas, не покидая блокнота.
MXNet:
# Если pandas не установлен, раскомментируйте следующую строку
# !pip install pandas
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import gluon, autograd, init, np, npx
from mxnet.gluon import nn
import pandas as pd
npx.set_np()
PyTorch:
# Если pandas не установлен, раскомментируйте следующую строку
# !pip install pandas
%matplotlib inline
from d2l import torch as d2l
import torch
from torch import nn
import pandas as pd
import numpy as np
TensorFlow:
# Если pandas не установлен, раскомментируйте следующую строку
# !pip install pandas
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
import pandas as pd
import numpy as np
PaddlePaddle:
# Если pandas не установлен, раскомментируйте следующую строку
# !pip install pandas
%matplotlib inline
import warnings
import pandas as pd
import numpy as np
warnings.filterwarnings(action='ignore')
import paddle
from paddle import nn
warnings.filterwarnings("ignore", category=DeprecationWarning)
from d2l import paddle as d2l
Для удобства можно использовать описанный выше скрипт, чтобы скачать и закэшировать набор данных о домах Kaggle.
DATA_HUB['kaggle_house_train'] = ( #@save
DATA_URL + 'kaggle_house_pred_train.csv',
'585e9cc93e70b39160e7921475f9bcd7d31219ce')
DATA_HUB['kaggle_house_test'] = ( #@save
DATA_URL + 'kaggle_house_pred_test.csv',
'fa19780a7b011d9b009e8bff8e99922a8ee2eb90')
Загрузим два CSV-файла с обучающими и тестовыми данными с помощью pandas.
train_data = pd.read_csv(download('kaggle_house_train'))
test_data = pd.read_csv(download('kaggle_house_test'))
Обучающий набор содержит 1460 примеров, каждый из которых имеет 80 признаков и 1 метку. Тестовый набор содержит 1459 примеров, каждый из которых имеет 80 признаков.
print(train_data.shape)
print(test_data.shape)
Посмотрим на первые четыре и последние два признака, а также на соответствующие метки (цены домов).
print(train_data.iloc[0:4, [0, 1, 2, 3, -3, -2, -1]])
Видно, что в каждом примере первый признак — идентификатор. Он помогает модели различать обучающие примеры. Хотя это удобно, для прогноза этот признак никакой информации не несёт. Поэтому, прежде чем передавать данные модели, мы удаляем его из набора данных.
all_features = pd.concat((train_data.iloc[:, 1:-1], test_data.iloc[:, 1:]))
4.10.4 Предобработка данных
Как уже сказано, данные имеют разные типы. Прежде чем начать моделирование, нужно их предобработать. Сначала заменим все пропущенные значения средним значением соответствующего признака. Затем, чтобы привести все признаки к единому масштабу, стандартизуем данные, приводя признаки к нулевому среднему и единичной дисперсии:
где и — среднее значение и стандартное отклонение соответственно. Теперь признаки имеют нулевое среднее и единичную дисперсию, то есть и . Интуитивно стандартизация данных полезна по двум причинам. Во-первых, это упрощает оптимизацию. Во-вторых, поскольку мы не знаем, какие признаки связаны между собой, мы не хотим, чтобы штраф назначал коэффициент одному признаку больше, чем другим.
# Если тестовые данные недоступны, среднее и стандартное отклонение можно вычислить по обучающим данным
numeric_features = all_features.dtypes[all_features.dtypes != 'object'].index
all_features[numeric_features] = all_features[numeric_features].apply(
lambda x: (x - x.mean()) / (x.std()))
# После стандартизации все средние равны нулю, поэтому пропуски можно заменить нулём
all_features[numeric_features] = all_features[numeric_features].fillna(0)
Далее обработаем дискретные значения.
К ним относятся такие признаки, как «MSZoning».
Мы заменяем их прямым кодированием (one-hot), тем же способом, что и при преобразовании многоклассовых меток в векторы ранее (см. раздел 3.4.1).
Например, признак «MSZoning» содержит значения «RL» и «Rm».
Мы создадим два новых индикаторных признака «MSZoning_RL» и «MSZoning_RM» со значениями 0 или 1.
Согласно прямому кодированию, если исходное значение «MSZoning» — «RL», то «MSZoning_RL» равно 1, а «MSZoning_RM» равно 0.
Пакет pandas делает это за нас автоматически.
# Dummy_na=True считает «na» (пропущенное значение) допустимым значением признака и создаёт для него индикаторный признак
all_features = pd.get_dummies(all_features, dummy_na=True)
all_features.shape
Видно, что это преобразование увеличивает общее число признаков с 79 до 331.
Наконец, через атрибут values мы
извлекаем данные из формата pandas в формат NumPy и преобразуем их в тензоры для обучения.
n_train = train_data.shape[0]
train_features = d2l.tensor(all_features[:n_train].values, dtype=d2l.float32)
test_features = d2l.tensor(all_features[n_train:].values, dtype=d2l.float32)
train_labels = d2l.tensor(
train_data.SalePrice.values.reshape(-1, 1), dtype=d2l.float32)
4.10.5 Обучение
Для начала обучим линейную модель с квадратичной функцией потерь. Линейная модель вряд ли позволит выиграть соревнование, но она служит проверкой здравого смысла: есть ли в данных осмысленная информация. Если здесь мы не сможем работать лучше случайного угадывания, скорее всего, в обработке данных есть ошибка. Если всё пойдёт хорошо, линейная модель будет служить базовой (baseline) моделью, и мы поймём, насколько лучшая модель превосходит простую.
MXNet:
loss = gluon.loss.L2Loss()
def get_net():
net = nn.Sequential()
net.add(nn.Dense(1))
net.initialize()
return net
PyTorch, PaddlePaddle:
loss = nn.MSELoss()
in_features = train_features.shape[1]
def get_net():
net = nn.Sequential(nn.Linear(in_features,1))
return net
TensorFlow:
loss = tf.keras.losses.MeanSquaredError()
def get_net():
net = tf.keras.models.Sequential()
net.add(tf.keras.layers.Dense(
1, kernel_regularizer=tf.keras.regularizers.l2(weight_decay)))
return net
Цены на жильё, как и цены акций, нас интересуют в относительных величинах, а не в абсолютных. Поэтому мы больше заботимся об относительной ошибке , чем об абсолютной ошибке . Например, если мы оцениваем стоимость дома в сельской местности Огайо и ошибаемся на 100 000 долларов, при том что типичный дом там стоит 125 000 долларов, то модель, скорее всего, работает плохо. С другой стороны, та же ошибка в 100 000 долларов для особняка в районе Калифорнии, где медианная цена превышает 4 миллиона долларов, может означать хороший прогноз.
Один из способов решить эту проблему — измерять расхождение логарифмом цены. Фактически именно эту метрику ошибки официально использует соревнование для оценки качества решений. Условие равносильно . Поэтому среднеквадратичная ошибка между логарифмом предсказанной цены и логарифмом истинной метки:
MXNet:
def log_rmse(net, features, labels):
# Чтобы стабилизировать значение при взятии логарифма, значения меньше 1 заменяем на 1
clipped_preds = np.clip(net(features), 1, float('inf'))
return np.sqrt(2 * loss(np.log(clipped_preds), np.log(labels)).mean())
PyTorch:
def log_rmse(net, features, labels):
# Чтобы стабилизировать значение при взятии логарифма, значения меньше 1 заменяем на 1
clipped_preds = torch.clamp(net(features), 1, float('inf'))
rmse = torch.sqrt(loss(torch.log(clipped_preds),
torch.log(labels)))
return rmse.item()
TensorFlow:
def log_rmse(y_true, y_pred):
# Чтобы стабилизировать значение при взятии логарифма, значения меньше 1 заменяем на 1
clipped_preds = tf.clip_by_value(y_pred, 1, float('inf'))
return tf.sqrt(tf.reduce_mean(loss(
tf.math.log(y_true), tf.math.log(clipped_preds))))
PaddlePaddle:
def log_rmse(net, features, labels):
# Чтобы стабилизировать значение при взятии логарифма, значения меньше 1 заменяем на 1
clipped_preds = paddle.clip(net(features), 1, float('inf'))
rmse = paddle.sqrt(loss(paddle.log(clipped_preds),
paddle.log(labels)))
return rmse.item()
В отличие от предыдущих разделов, наша функция обучения будет опираться на оптимизатор Adam (его подробно опишем в следующих главах). Главное достоинство Adam в том, что он менее чувствителен к выбору начальной скорости обучения.
MXNet:
def train(net, train_features, train_labels, test_features, test_labels,
num_epochs, learning_rate, weight_decay, batch_size):
train_ls, test_ls = [], []
train_iter = d2l.load_array((train_features, train_labels), batch_size)
# Здесь используется оптимизатор Adam
trainer = gluon.Trainer(net.collect_params(), 'adam', {
'learning_rate': learning_rate, 'wd': weight_decay})
for epoch in range(num_epochs):
for X, y in train_iter:
with autograd.record():
l = loss(net(X), y)
l.backward()
trainer.step(batch_size)
train_ls.append(log_rmse(net, train_features, train_labels))
if test_labels is not None:
test_ls.append(log_rmse(net, test_features, test_labels))
return train_ls, test_ls
PyTorch:
def train(net, train_features, train_labels, test_features, test_labels,
num_epochs, learning_rate, weight_decay, batch_size):
train_ls, test_ls = [], []
train_iter = d2l.load_array((train_features, train_labels), batch_size)
# Здесь используется оптимизатор Adam
optimizer = torch.optim.Adam(net.parameters(),
lr = learning_rate,
weight_decay = weight_decay)
for epoch in range(num_epochs):
for X, y in train_iter:
optimizer.zero_grad()
l = loss(net(X), y)
l.backward()
optimizer.step()
train_ls.append(log_rmse(net, train_features, train_labels))
if test_labels is not None:
test_ls.append(log_rmse(net, test_features, test_labels))
return train_ls, test_ls
TensorFlow:
def train(net, train_features, train_labels, test_features, test_labels,
num_epochs, learning_rate, weight_decay, batch_size):
train_ls, test_ls = [], []
train_iter = d2l.load_array((train_features, train_labels), batch_size)
# Здесь используется оптимизатор Adam
optimizer = tf.keras.optimizers.Adam(learning_rate)
net.compile(loss=loss, optimizer=optimizer)
for epoch in range(num_epochs):
for X, y in train_iter:
with tf.GradientTape() as tape:
y_hat = net(X)
l = loss(y, y_hat)
params = net.trainable_variables
grads = tape.gradient(l, params)
optimizer.apply_gradients(zip(grads, params))
train_ls.append(log_rmse(train_labels, net(train_features)))
if test_labels is not None:
test_ls.append(log_rmse(test_labels, net(test_features)))
return train_ls, test_ls
PaddlePaddle:
def train(net, train_features, train_labels, test_features, test_labels,
num_epochs, learning_rate, weight_decay, batch_size):
train_ls, test_ls = [], []
train_iter = d2l.load_array((train_features, train_labels), batch_size)
# Здесь используется оптимизатор Adam
optimizer = paddle.optimizer.Adam(learning_rate=learning_rate*1.0,
parameters=net.parameters(),
weight_decay=weight_decay*1.0)
for epoch in range(num_epochs):
for X, y in train_iter:
l = loss(net(X), y)
l.backward()
optimizer.step()
optimizer.clear_grad()
train_ls.append(log_rmse(net, train_features, train_labels))
if test_labels is not None:
test_ls.append(log_rmse(net, test_features, test_labels))
return train_ls, test_ls
4.10.6 K-кратная перекрёстная проверка
В разделе, посвящённом выбору модели (раздел 4.4), мы описали K-кратную перекрёстную проверку. Она помогает выбирать модель и настраивать гиперпараметры. Сначала определим функцию, которая возвращает данные i-го фолда при K-кратной перекрёстной проверке. Конкретно, она выбирает i-й фрагмент в качестве проверочных данных, а остальные части — в качестве обучающих. Заметим, что это не самый эффективный способ работы с данными: при гораздо большем наборе данных могут подойти другие решения.
def get_k_fold_data(k, i, X, y):
assert k > 1
fold_size = X.shape[0] // k
X_train, y_train = None, None
for j in range(k):
idx = slice(j * fold_size, (j + 1) * fold_size)
X_part, y_part = X[idx, :], y[idx]
if j == i:
X_valid, y_valid = X_part, y_part
elif X_train is None:
X_train, y_train = X_part, y_part
else:
X_train = d2l.concat([X_train, X_part], 0)
y_train = d2l.concat([y_train, y_part], 0)
return X_train, y_train, X_valid, y_valid
Когда мы обучили модель K раз в K-кратной перекрёстной проверке, возвращаем среднее значение ошибок обучения и проверки.
def k_fold(k, X_train, y_train, num_epochs, learning_rate, weight_decay,
batch_size):
train_l_sum, valid_l_sum = 0, 0
for i in range(k):
data = get_k_fold_data(k, i, X_train, y_train)
net = get_net()
train_ls, valid_ls = train(net, *data, num_epochs, learning_rate,
weight_decay, batch_size)
train_l_sum += train_ls[-1]
valid_l_sum += valid_ls[-1]
if i == 0:
d2l.plot(list(range(1, num_epochs + 1)), [train_ls, valid_ls],
xlabel='эпоха', ylabel='rmse', xlim=[1, num_epochs],
legend=['обучение', 'проверка'], yscale='log')
print(f'Фолд {i + 1}, log rmse на обучении {float(train_ls[-1]):f}, '
f'log rmse на проверке {float(valid_ls[-1]):f}')
return train_l_sum / k, valid_l_sum / k
4.10.7 Выбор модели
В этом примере мы выбираем набор ненастроенных гиперпараметров и оставляем читателю возможность улучшить модель. Поиск хорошего набора гиперпараметров может занять время — в зависимости от того, сколько переменных мы оптимизируем. При достаточно большом наборе данных и разумно заданных гиперпараметрах K-кратная перекрёстная проверка обычно даёт устойчивые результаты при повторных запусках. Однако если мы опробуем неудачные гиперпараметры, проверочная ошибка может перестать отражать истинную ошибку.
k, num_epochs, lr, weight_decay, batch_size = 5, 100, 5, 0, 64
train_l, valid_l = k_fold(k, train_features, train_labels, num_epochs, lr,
weight_decay, batch_size)
print(f'{k}-кратная проверка: средняя log rmse на обучении: {float(train_l):f}, '
f'средняя log rmse на проверке: {float(valid_l):f}')
Обратите внимание: иногда ошибка обучения для набора гиперпараметров может быть очень низкой, а ошибка K-кратной перекрёстной проверки — намного выше. Это указывает на переобучение модели. На протяжении всего обучения мы хотим следить за двумя величинами: ошибкой обучения и ошибкой проверки. Небольшое переобучение может говорить о том, что имеющихся данных достаточно для более мощной модели. Сильное переобучение, напротив, может означать, что стоит воспользоваться методами регуляризации.
4.10.8 Отправка прогнозов на Kaggle
Теперь, когда мы знаем, какие гиперпараметры выбрать, можно обучить модель на всех данных (а не только на 1 − 1/K от данных, как в перекрёстной проверке). Затем полученную модель можно применить к тестовому набору. Сохранение прогнозов в CSV-файл упрощает отправку результатов на Kaggle.
def train_and_pred(train_features, test_features, train_labels, test_data,
num_epochs, lr, weight_decay, batch_size):
net = get_net()
train_ls, _ = train(net, train_features, train_labels, None, None,
num_epochs, lr, weight_decay, batch_size)
d2l.plot(np.arange(1, num_epochs + 1), [train_ls], xlabel='эпоха',
ylabel='log rmse', xlim=[1, num_epochs], yscale='log')
print(f'log rmse на обучении: {float(train_ls[-1]):f}')
# Применить сеть к тестовому набору
preds = d2l.numpy(net(test_features))
# Преобразовать формат для экспорта в Kaggle
test_data['SalePrice'] = pd.Series(preds.reshape(1, -1)[0])
submission = pd.concat([test_data['Id'], test_data['SalePrice']], axis=1)
submission.to_csv('submission.csv', index=False)
Если прогнозы на тестовом наборе похожи на прогнозы, полученные во время K-кратной перекрёстной проверки, пора загружать их на Kaggle.
Следующий код создаст файл submission.csv.
train_and_pred(train_features, test_features, train_labels, test_data,
num_epochs, lr, weight_decay, batch_size)
Далее прогнозы можно отправить на Kaggle и посмотреть, как они соотносятся с реальными ценами домов (метками) на тестовом наборе. Процедура очень простая.
- Войдите на сайт Kaggle и откройте страницу соревнования по прогнозированию цен на жильё.
- Нажмите кнопку «Submit Predictions» или «Late Submission» (на момент написания этих строк она находится справа).
- Нажмите кнопку «Upload Submission File» в пунктирной рамке внизу страницы и выберите файл с прогнозами.
- Нажмите кнопку «Make Submission» внизу страницы, чтобы увидеть результат.
Резюме
- Реальные данные обычно содержат смесь разных типов данных, их нужно предобработать.
- Распространённые приёмы предобработки: приведение вещественных данных к нулевому среднему и единичной дисперсии; замена пропущенных значений средним.
- Преобразование категориальных признаков в индикаторные позволяет трактовать их как one-hot вектор.
- Для выбора модели и настройки гиперпараметров можно использовать K-кратную перекрёстную проверку.
- Логарифм полезен, когда важна относительная ошибка.
Упражнения
- Насколько хорошо работает ваш прогноз, отправленный на Kaggle?
- Можно ли улучшить модель, напрямую минимизируя логарифм цены? Что произойдёт, если предсказывать логарифм цены, а не саму цену?
- Всегда ли хорошая идея заменять пропущенные значения средними? Подсказка: можно ли построить ситуацию, в которой значения пропадают не случайно?
- Улучшите результат на Kaggle, настраивая гиперпараметры с помощью K-кратной перекрёстной проверки.
- Улучшите модель (например, слои, затухание весов и исключение), чтобы повысить результат.
- Что произойдёт, если мы не стандартизируем непрерывные числовые признаки, как это сделано в этом разделе?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
5. Вычисления глубокого обучения
Помимо огромных наборов данных и мощного оборудования, в быстром развитии глубокого обучения незаменимую роль сыграли хорошие программные инструменты. Начиная с новаторской библиотеки Theano, выпущенной в 2007 году, гибкие открытые инструменты позволили исследователям быстро создавать прототипы моделей: они избавляли от повторной работы при использовании стандартных компонентов и при этом сохраняли возможность вносить низкоуровневые изменения. Со временем библиотеки глубокого обучения превратились в инструменты с всё более крупными абстракциями. Так же как разработчики полупроводников перешли от задания отдельных транзисторов к логическим схемам и далее к написанию кода, исследователи нейронных сетей перешли от рассмотрения поведения отдельных искусственных нейронов к построению сетей на уровне слоёв, а при проектировании архитектуры обычно оперируют ещё более крупными блоками (block).
В предыдущих главах мы ввели основные понятия машинного обучения и постепенно познакомились с полноценными моделями глубокого обучения. В предыдущей главе мы реализовали с нуля каждый компонент многослойного перцептрона, а затем показали, как с помощью высокоуровневых API легко получить ту же модель. Чтобы было проще учиться, мы вызывали библиотеки глубокого обучения, но пропускали детали их работы. В этой главе мы глубже разберём ключевые компоненты вычислений глубокого обучения: построение моделей, доступ к параметрам и их инициализацию, проектирование пользовательских слоёв и блоков, запись моделей на диск и чтение с диска, а также использование GPU для значительного ускорения вычислений. Эти знания помогут перейти от роли «начинающего» пользователя глубокого обучения к роли «продвинутого» пользователя. Хотя в этой главе не вводятся новые модели или наборы данных, последующие главы о продвинутых моделях во многом опираются на материал этой главы.
5.1 Слои и блоки
Когда мы впервые знакомились с нейронными сетями, мы рассматривали линейные модели с одним выходом. Здесь вся модель состоит всего из одного нейрона. Обратите внимание, что отдельный нейрон (i) принимает некоторый набор входов; (ii) генерирует соответствующий скалярный выход; (iii) имеет набор связанных параметров (parameters), которые можно обновлять, чтобы оптимизировать некоторую целевую функцию.
Затем, когда мы стали рассматривать сети с несколькими выходами, мы воспользовались векторизованными вычислениями, чтобы описать целый слой нейронов. Как и отдельные нейроны, слои (i) принимают набор входов, (ii) генерируют соответствующие выходы и (iii) описываются набором настраиваемых параметров. Когда мы работали с softmax-регрессией, один слой сам по себе был моделью. Однако даже позднее, когда мы ввели многослойные перцептроны, мы по-прежнему могли считать, что модель сохраняет ту же базовую структуру.
Интересно, что для многослойных перцептронов и вся модель, и составляющие её слои обладают этой структурой. Вся модель принимает исходные входные данные (признаки), генерирует выходы (предсказания) и содержит некоторые параметры (совокупность параметров всех составляющих слоёв). Аналогично, каждый отдельный слой получает входные данные (от предыдущего слоя), генерирует выходы (входы для следующего слоя) и имеет набор настраиваемых параметров, которые обновляются на основе сигнала, распространяющегося назад от следующего слоя.
Оказывается, полезнее рассматривать компоненты, которые «больше одного слоя», но «меньше всей модели». Например, архитектура ResNet-152, широко распространённая в компьютерном зрении, насчитывает сотни слоёв, которые организованы как повторяющиеся шаблоны из групп слоёв (groups of layers). Эта архитектура ResNet выиграла задачи распознавания и обнаружения на соревнованиях ImageNet и COCO 2015 года (He et al., 2016a). До сих пор архитектура ResNet остаётся предпочтительной для многих задач компьютерного зрения. В других областях, например в обработке естественного языка и речи, похожие архитектуры, в которых группы слоёв чередуются по повторяющимся шаблонам, также широко распространены.
Для реализации таких сложных сетей мы вводим понятие блока нейронной сети. Блок (block) может описывать отдельный слой, компонент из нескольких слоёв или всю модель целиком. Использование блоков для абстракции удобно тем, что несколько блоков можно объединять в более крупный компонент, и этот процесс обычно рекурсивен, как показано на рис. 5.1.1. Определив код, который порождает блоки по требованию, мы можем реализовать сложную нейронную сеть короткой программой.
Рис. 5.1.1. Несколько слоёв объединяются в блок, образуя более крупную модель
С точки зрения программирования блок представлен классом (class). Любой его подкласс должен определять функцию прямого распространения (forward propagation), которая преобразует входы в выходы, и должен хранить все необходимые параметры. Обратите внимание, что некоторым блокам параметры вовсе не нужны. Наконец, для вычисления градиентов блок должен иметь функцию обратного распространения. При определении собственных блоков обратное распространение обеспечивается автоматическим дифференцированием (введённым в разделе 2.5), поэтому нам достаточно продумать функцию прямого распространения и необходимые параметры.
Прежде чем создавать собственный блок, вспомним код многослойного перцептрона (раздел 4.3). Следующий код создаёт сеть, в которой есть полносвязный скрытый слой из 256 элементов с функцией активации ReLU и полносвязный выходной слой из 10 элементов без функции активации.
MXNet:
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
net = nn.Sequential()
net.add(nn.Dense(256, activation='relu'))
net.add(nn.Dense(10))
net.initialize()
X = np.random.uniform(size=(2, 20))
net(X)
PyTorch:
import torch
from torch import nn
from torch.nn import functional as F
net = nn.Sequential(nn.Linear(20, 256), nn.ReLU(), nn.Linear(256, 10))
X = torch.rand(2, 20)
net(X)
TensorFlow:
import tensorflow as tf
net = tf.keras.models.Sequential([
tf.keras.layers.Dense(256, activation=tf.nn.relu),
tf.keras.layers.Dense(10),
])
X = tf.random.uniform((2, 20))
net(X)
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
from paddle import nn
from paddle.nn import functional as F
net = nn.Sequential(nn.Linear(20, 256), nn.ReLU(), nn.Linear(256, 10))
X = paddle.rand([2, 20])
net(X)
MXNet: В этом примере мы строим модель, создавая экземпляр nn.Sequential, а возвращённый объект присваиваем переменной net.
Затем мы многократно вызываем функцию add у переменной net, добавляя слои в порядке их выполнения.
Проще говоря, nn.Sequential задаёт особый тип Block, то есть класс, который в Gluon представляет блок, и хранит упорядоченный список Block.
Функция add добавляет каждый последующий Block в этот список.
Заметьте, что каждый слой является экземпляром класса Dense, а сам класс Dense является подклассом Block.
До сих пор мы получали выход модели, вызывая net(X).
Это по сути сокращение для net.forward(X), и такая возможность реализована через функцию __call__ класса Block, что является приёмом Python.
Функция прямого распространения очень проста: она соединяет каждый Block из списка, передавая выход каждого блока на вход следующему.
PyTorch: В этом примере мы строим модель, создавая экземпляр nn.Sequential, а порядок выполнения слоёв передаём ему как аргументы.
Проще говоря, nn.Sequential задаёт особый тип Module, то есть класс, который в PyTorch представляет блок, и хранит упорядоченный список Module.
Обратите внимание, что оба полносвязных слоя являются экземплярами класса Linear, который сам является подклассом Module.
Кроме того, до сих пор мы получали выход модели, вызывая net(X).
Это сокращение для net.__call__(X).
Эта функция прямого распространения очень проста: она соединяет каждый блок из списка, передавая выход каждого блока на вход следующего.
TensorFlow: В этом примере мы строим модель, создавая экземпляр keras.models.Sequential, а порядок выполнения слоёв передаём ему как аргументы.
Проще говоря, Sequential задаёт особый тип keras.Model, то есть класс, который в Keras представляет блок.
Он хранит упорядоченный список Model.
Оба полносвязных слоя являются экземплярами класса Dense, который сам является подклассом Model.
Функция прямого распространения (call) также очень проста: она соединяет каждый блок из списка, передавая выход каждого блока на вход следующего.
Заметьте, что до сих пор мы получали выход модели, вызывая net(X).
Это сокращение для net.call(X), и такая возможность реализована через функцию __call__ класса Block, что является приёмом Python.
PaddlePaddle: В этом примере мы строим модель, создавая экземпляр nn.Sequential, а порядок выполнения слоёв передаём ему как аргументы.
Проще говоря, nn.Sequential задаёт особый тип Layer, то есть класс, который в PaddlePaddle представляет блок.
Он хранит упорядоченный список Layer.
Обратите внимание, что оба полносвязных слоя являются экземплярами класса Linear, который сам является подклассом Layer.
Кроме того, до сих пор мы получали выход модели, вызывая net(X).
Это сокращение для net.__call__(X).
Эта функция прямого распространения очень проста: она соединяет каждый блок из списка, передавая выход каждого блока на вход следующего.
5.1.1 Пользовательские блоки
Чтобы интуитивно понять, как работают блоки, проще всего реализовать блок самостоятельно. Прежде чем реализовывать собственный блок, кратко перечислим базовые функции, которые должен предоставлять каждый блок.
MXNet, TensorFlow:
- Принимать входные данные в качестве аргумента функции прямого распространения.
- Генерировать выход с помощью функции прямого распространения. Обратите внимание, что форма выхода может отличаться от формы входа. Например, первый полносвязный слой нашей модели выше принимает входные данные произвольной размерности, но возвращает выход размерности 256.
- Вычислять градиент выхода по входу, доступ к которому обеспечивает функция обратного распространения. Обычно это происходит автоматически.
- Хранить и предоставлять доступ к параметрам, необходимым для вычисления прямого распространения.
- При необходимости инициализировать параметры модели.
PyTorch, PaddlePaddle:
- Принимать входные данные в качестве аргумента функции прямого распространения.
- Генерировать выход с помощью функции прямого распространения. Обратите внимание, что форма выхода может отличаться от формы входа. Например, первый полносвязный слой нашей модели выше принимает 20-мерный вход, но возвращает выход размерности 256.
- Вычислять градиент выхода по входу, доступ к которому обеспечивает функция обратного распространения. Обычно это происходит автоматически.
- Хранить и предоставлять доступ к параметрам, необходимым для вычисления прямого распространения.
- При необходимости инициализировать параметры модели.
В приведённом ниже фрагменте кода мы пишем блок с нуля.
Он содержит многослойный перцептрон со скрытым слоем из 256 элементов и выходным слоем размерности 10.
Обратите внимание, что класс MLP ниже наследуется от класса, представляющего блок.
Нам нужно предоставить только собственный конструктор (функцию __init__ в Python) и функцию прямого распространения.
MXNet:
class MLP(nn.Block):
# Объявляем слои с параметрами. Здесь объявляем два полносвязных слоя
def __init__(self, **kwargs):
# Вызываем конструктор родительского класса Block у MLP, чтобы выполнить необходимую инициализацию.
# Так при создании экземпляра можно также передавать другие аргументы функции, например параметры модели params (будут описаны далее)
super().__init__(**kwargs)
self.hidden = nn.Dense(256, activation='relu') # Скрытый слой
self.out = nn.Dense(10) # Выходной слой
# Определяем прямое распространение модели: как по входу X получить нужный выход модели
def forward(self, X):
return self.out(self.hidden(X))
PyTorch:
class MLP(nn.Module):
# Объявляем слои с параметрами. Здесь объявляем два полносвязных слоя
def __init__(self):
# Вызываем конструктор родительского класса Module у MLP, чтобы выполнить необходимую инициализацию.
# Так при создании экземпляра можно также передавать другие аргументы функции, например параметры модели params (будут описаны далее)
super().__init__()
self.hidden = nn.Linear(20, 256) # Скрытый слой
self.out = nn.Linear(256, 10) # Выходной слой
# Определяем прямое распространение модели: как по входу X получить нужный выход модели
def forward(self, X):
# Обратите внимание, что здесь мы используем функциональную версию ReLU, которая определена в модуле nn.functional.
return self.out(F.relu(self.hidden(X)))
TensorFlow:
class MLP(tf.keras.Model):
# Объявляем слои с параметрами. Здесь объявляем два полносвязных слоя
def __init__(self):
# Вызываем конструктор родительского класса Model у MLP, чтобы выполнить необходимую инициализацию.
# Так при создании экземпляра можно также передавать другие аргументы функции, например параметры модели params (будут описаны далее)
super().__init__()
# Скрытый слой
self.hidden = tf.keras.layers.Dense(units=256, activation=tf.nn.relu)
self.out = tf.keras.layers.Dense(units=10) # Выходной слой
# Определяем прямое распространение модели: как по входу X получить нужный выход модели
def call(self, X):
return self.out(self.hidden((X)))
PaddlePaddle:
class MLP(nn.Layer):
# Объявляем слои с параметрами. Здесь объявляем два полносвязных слоя
def __init__(self):
# Вызываем конструктор родительского класса Layer у MLP, чтобы выполнить необходимую инициализацию.
# Так при создании экземпляра можно также передавать другие аргументы функции, например параметры модели `params` (будут описаны далее)
super().__init__()
self.hidden = nn.Linear(20, 256) # Скрытый слой
self.out = nn.Linear(256, 10) # Выходной слой
# Определяем прямое распространение модели: как по входу `X` получить нужный выход модели
def forward(self, X):
# Обратите внимание, что здесь мы используем функциональную версию ReLU, которая определена в модуле nn.functional.
return self.out(F.relu(self.hidden(X)))
Сначала посмотрим на функцию прямого распространения.
Она принимает X в качестве входа, вычисляет скрытое представление с функцией активации и возвращает ненормированный выход.
В этой реализации MLP оба слоя являются переменными экземпляра.
Чтобы понять, почему это разумно, представьте, что мы создали два многослойных перцептрона (net1 и net2) и обучаем их на разных данных.
Естественно ожидать, что они выучат две разные модели.
Теперь мы создаём слои многослойного перцептрона и затем вызываем их при каждом вызове функции прямого распространения.
Обратите внимание на несколько ключевых деталей.
Во-первых, наша функция __init__ вызывает конструктор родительского класса через super().__init__(),
что избавляет от необходимости писать повторяющийся шаблонный код.
Затем мы создаём два полносвязных слоя: self.hidden и self.out.
Заметьте, что, если только мы не реализуем новый оператор, нам не нужно беспокоиться о функции обратного распространения или инициализации параметров: система сгенерирует их автоматически.
Проверим, как работает эта функция:
MXNet:
net = MLP()
net.initialize()
net(X)
PyTorch, PaddlePaddle:
net = MLP()
net(X)
TensorFlow:
net = MLP()
net(X)
Главное достоинство блоков — их универсальность.
Мы можем создавать подклассы блоков, чтобы получить слои (например, класс для полносвязного слоя), целые модели (например, класс MLP выше) или компоненты средней сложности.
Эту универсальность мы активно используем в следующих главах, например при работе со свёрточными нейронными сетями.
5.1.2 Последовательный блок
Теперь можно внимательнее рассмотреть, как работает класс Sequential.
Напомним, что Sequential предназначен для последовательного соединения других модулей.
Чтобы построить собственный упрощённый MySequential, нам достаточно определить две ключевые функции:
- функцию, которая добавляет блоки в список по одному;
- функцию прямого распространения, которая передаёт входные данные через цепочку блоков в порядке их добавления.
Приведённый ниже класс MySequential обеспечивает ту же функциональность, что и стандартный класс Sequential.
MXNet:
class MySequential(nn.Block):
def add(self, block):
# Здесь block — экземпляр подкласса Block, и мы предполагаем, что у него есть уникальное имя. Мы сохраняем его
# в переменной-члене _children класса Block. Тип block — OrderedDict.
# Когда экземпляр MySequential вызывает функцию initialize, система автоматически инициализирует
# все члены _children
self._children[block.name] = block
def forward(self, X):
# OrderedDict гарантирует обход членов в порядке их добавления
for block in self._children.values():
X = block(X)
return X
PyTorch:
class MySequential(nn.Module):
def __init__(self, *args):
super().__init__()
for idx, module in enumerate(args):
# Здесь module — экземпляр подкласса Module. Мы сохраняем его в переменной-члене
# _modules класса Module. Тип _modules — OrderedDict
self._modules[str(idx)] = module
def forward(self, X):
# OrderedDict гарантирует обход членов в порядке их добавления
for block in self._modules.values():
X = block(X)
return X
TensorFlow:
class MySequential(tf.keras.Model):
def __init__(self, *args):
super().__init__()
self.modules = []
for block in args:
# Здесь block — экземпляр подкласса tf.keras.layers.Layer
self.modules.append(block)
def call(self, X):
for module in self.modules:
X = module(X)
return X
PaddlePaddle:
class MySequential(nn.Layer):
def __init__(self, *layers):
super(MySequential, self).__init__()
# Если передан кортеж
if len(layers) > 0 and isinstance(layers[0], tuple):
for name, layer in layers:
# Метод add_sublayer добавляет layer в self._sub_layers (кортеж)
self.add_sublayer(name, layer)
else:
for idx, layer in enumerate(layers):
self.add_sublayer(str(idx), layer)
def forward(self, X):
# OrderedDict гарантирует обход членов в порядке их добавления
for layer in self._sub_layers.values():
X = layer(X)
return X
MXNet: Функция add добавляет блок в упорядоченный словарь _children.
Читатель может спросить, зачем у каждого Block в Gluon есть атрибут _children и почему мы используем его, а не собственный список Python.
Проще говоря, главное преимущество _children в том,
что при инициализации параметров блока Gluon знает, что нужно искать вложенные блоки, которым требуется инициализация параметров, в словаре _children.
PyTorch: Функция __init__ добавляет каждый модуль в упорядоченный словарь _modules по одному.
Читатель может спросить, зачем у каждого Module есть атрибут _modules и почему мы используем его, а не собственный список Python.
Проще говоря, главное преимущество _modules в том,
что при инициализации параметров модуля система знает, что нужно искать вложенные блоки, которым требуется инициализация параметров, в словаре _modules.
PaddlePaddle: Функция __init__ добавляет каждый модуль в упорядоченный словарь _sub_layers по одному.
Читатель может спросить, зачем у каждого Layer есть атрибут _sub_layers и почему мы используем его, а не собственный список Python.
Проще говоря, главное преимущество _sub_layers в том,
что при инициализации параметров модуля система знает, что нужно искать вложенные блоки, которым требуется инициализация параметров, в словаре _sub_layers.
Когда вызывается функция прямого распространения MySequential,
каждый добавленный блок выполняется в том порядке, в котором он был добавлен.
Теперь мы можем переписать многослойный перцептрон, используя наш класс MySequential.
MXNet:
net = MySequential()
net.add(nn.Dense(256, activation='relu'))
net.add(nn.Dense(10))
net.initialize()
net(X)
PyTorch, PaddlePaddle:
net = MySequential(nn.Linear(20, 256), nn.ReLU(), nn.Linear(256, 10))
net(X)
TensorFlow:
net = MySequential(
tf.keras.layers.Dense(units=256, activation=tf.nn.relu),
tf.keras.layers.Dense(10))
net(X)
Обратите внимание, что использование MySequential совпадает с использованием Sequential из предыдущего кода
(как описано в разделе 4.3).
5.1.3 Выполнение кода в функции прямого распространения
Класс Sequential упрощает конструирование моделей:
он позволяет составлять новые архитектуры, не определяя собственный класс.
Однако не все архитектуры являются простыми последовательными.
Когда нужна большая гибкость, приходится определять собственные блоки.
Например, мы можем захотеть использовать управляющие конструкции Python в функции прямого распространения.
Кроме того, нам может понадобиться выполнять произвольные математические операции, а не только полагаться на заранее определённые слои нейронной сети.
До сих пор
все операции в нашей сети работали с активациями сети и её параметрами.
Однако иногда нам может понадобиться включить в вычисления величину, которая не является результатом предыдущего слоя и не является обновляемым параметром.
Назовём такую величину постоянным параметром (constant parameter).
Например, нам нужна функция слоя
,
где — вход,
— параметр,
а — заданная константа, которая не обновляется в процессе оптимизации.
Поэтому мы реализуем класс FixedHiddenMLP, как показано ниже:
MXNet:
class FixedHiddenMLP(nn.Block):
def __init__(self, **kwargs):
super().__init__(**kwargs)
# Случайные весовые параметры, созданные функцией get_constant, не обновляются во время обучения (то есть это постоянные параметры)
self.rand_weight = self.params.get_constant(
'rand_weight', np.random.uniform(size=(20, 20)))
self.dense = nn.Dense(20, activation='relu')
def forward(self, X):
X = self.dense(X)
# Используем созданный постоянный параметр, а также функции relu и dot
X = npx.relu(np.dot(X, self.rand_weight.data()) + 1)
# Повторно используем полносвязный слой. Это равносильно тому, что два полносвязных слоя разделяют параметры
X = self.dense(X)
# Управляющая конструкция
while np.abs(X).sum() > 1:
X /= 2
return X.sum()
PyTorch:
class FixedHiddenMLP(nn.Module):
def __init__(self):
super().__init__()
# Случайный весовой параметр без вычисления градиента. Поэтому во время обучения он остаётся неизменным
self.rand_weight = torch.rand((20, 20), requires_grad=False)
self.linear = nn.Linear(20, 20)
def forward(self, X):
X = self.linear(X)
# Используем созданный постоянный параметр, а также функции relu и mm
X = F.relu(torch.mm(X, self.rand_weight) + 1)
# Повторно используем полносвязный слой. Это равносильно тому, что два полносвязных слоя разделяют параметры
X = self.linear(X)
# Управляющая конструкция
while X.abs().sum() > 1:
X /= 2
return X.sum()
TensorFlow:
class FixedHiddenMLP(tf.keras.Model):
def __init__(self):
super().__init__()
self.flatten = tf.keras.layers.Flatten()
# Случайный весовой параметр, созданный функцией tf.constant, не обновляется во время обучения (то есть это постоянный параметр)
self.rand_weight = tf.constant(tf.random.uniform((20, 20)))
self.dense = tf.keras.layers.Dense(20, activation=tf.nn.relu)
def call(self, inputs):
X = self.flatten(inputs)
# Используем созданный постоянный параметр, а также функции relu и matmul
X = tf.nn.relu(tf.matmul(X, self.rand_weight) + 1)
# Повторно используем полносвязный слой. Это равносильно тому, что два полносвязных слоя разделяют параметры.
X = self.dense(X)
# Управляющая конструкция
while tf.reduce_sum(tf.math.abs(X)) > 1:
X /= 2
return tf.reduce_sum(X)
PaddlePaddle:
class FixedHiddenMLP(nn.Layer):
def __init__(self):
super().__init__()
# Случайный весовой параметр без вычисления градиента. Поэтому во время обучения он остаётся неизменным.
self.rand_weight = paddle.rand([20, 20])
self.linear = nn.Linear(20, 20)
def forward(self, X):
X = self.linear(X)
# Используем созданный постоянный параметр, а также функции relu и mm.
X = F.relu(paddle.tensor.mm(X, self.rand_weight) + 1)
# Повторно используем полносвязный слой. Это равносильно тому, что два полносвязных слоя разделяют параметры.
X = self.linear(X)
# Управляющая конструкция
while X.abs().sum() > 1:
X /= 2
return X.sum()
В этой модели FixedHiddenMLP мы реализовали скрытый слой,
весовой параметр которого (self.rand_weight) случайно инициализируется при создании экземпляра и после этого остаётся постоянным.
Этот весовой параметр не является параметром модели, поэтому он никогда не обновляется при обратном распространении.
Затем нейронная сеть пропускает выход этого фиксированного слоя через полносвязный слой.
Обратите внимание, что перед возвратом выхода модель делает кое-что необычное:
она выполняет цикл while, в котором делит выходной вектор на , пока норма больше .
Наконец, модель возвращает сумму всех элементов X.
Заметим, что такая операция, скорее всего, не встречается в практических задачах:
мы лишь показываем, как произвольный код можно включить в вычислительный поток нейронной сети.
MXNet:
net = FixedHiddenMLP()
net.initialize()
net(X)
PyTorch, TensorFlow, PaddlePaddle:
net = FixedHiddenMLP()
net(X)
Мы можем свободно комбинировать различные способы сборки блоков. В следующем примере мы вкладываем блоки друг в друга несколькими способами.
MXNet:
class NestMLP(nn.Block):
def __init__(self, **kwargs):
super().__init__(**kwargs)
self.net = nn.Sequential()
self.net.add(nn.Dense(64, activation='relu'),
nn.Dense(32, activation='relu'))
self.dense = nn.Dense(16, activation='relu')
def forward(self, X):
return self.dense(self.net(X))
chimera = nn.Sequential()
chimera.add(NestMLP(), nn.Dense(20), FixedHiddenMLP())
chimera.initialize()
chimera(X)
PyTorch:
class NestMLP(nn.Module):
def __init__(self):
super().__init__()
self.net = nn.Sequential(nn.Linear(20, 64), nn.ReLU(),
nn.Linear(64, 32), nn.ReLU())
self.linear = nn.Linear(32, 16)
def forward(self, X):
return self.linear(self.net(X))
chimera = nn.Sequential(NestMLP(), nn.Linear(16, 20), FixedHiddenMLP())
chimera(X)
TensorFlow:
class NestMLP(tf.keras.Model):
def __init__(self):
super().__init__()
self.net = tf.keras.Sequential()
self.net.add(tf.keras.layers.Dense(64, activation=tf.nn.relu))
self.net.add(tf.keras.layers.Dense(32, activation=tf.nn.relu))
self.dense = tf.keras.layers.Dense(16, activation=tf.nn.relu)
def call(self, inputs):
return self.dense(self.net(inputs))
chimera = tf.keras.Sequential()
chimera.add(NestMLP())
chimera.add(tf.keras.layers.Dense(20))
chimera.add(FixedHiddenMLP())
chimera(X)
PaddlePaddle:
class NestMLP(nn.Layer):
def __init__(self):
super().__init__()
self.net = nn.Sequential(nn.Linear(20, 64), nn.ReLU(),
nn.Linear(64, 32), nn.ReLU())
self.linear = nn.Linear(32, 16)
def forward(self, X):
return self.linear(self.net(X))
chimera = nn.Sequential(NestMLP(), nn.Linear(16, 20), FixedHiddenMLP())
chimera(X)
5.1.4 Эффективность
MXNet: Читатель может начать беспокоиться об эффективности. Ведь мы выполняем много обращений к словарям, исполняем код и много других операций на Python внутри высокопроизводительной библиотеки глубокого обучения. Проблема глобальной блокировки интерпретатора в Python хорошо известна. В контексте глубокого обучения мы опасаемся, что чрезвычайно быстрый GPU будет простаивать, ожидая, пока CPU выполнит код на Python, прежде чем запустить следующую задачу.
Лучший способ ускорить Python — полностью избежать его использования. Gluon делает это, позволяя использовать гибридное программирование (hybridization), которое будет описано позднее. Интерпретатор Python выполняет блок при первом вызове. Среда выполнения Gluon запоминает происходящее, и при следующем вызове она ускоряет вычисления, минуя Python. В некоторых случаях это может значительно ускорить работу, но когда управляющая конструкция (как описано выше) направляет выполнение по разным ветвям сети, нужна особая осторожность. Мы рекомендуем заинтересованным читателям после прочтения этой главы изучить раздел о гибридном программировании (раздел 12.1), чтобы разобраться в компиляции.
PyTorch: Читатель может начать беспокоиться об эффективности. Ведь мы выполняем много обращений к словарям, исполняем код и много других операций на Python внутри высокопроизводительной библиотеки глубокого обучения. Проблема глобальной блокировки интерпретатора в Python хорошо известна. В контексте глубокого обучения мы опасаемся, что чрезвычайно быстрый GPU будет простаивать, ожидая, пока CPU выполнит код на Python, прежде чем запустить следующую задачу.
TensorFlow: Читатель может начать беспокоиться об эффективности. Ведь мы выполняем много обращений к словарям, исполняем код и много других операций на Python внутри высокопроизводительной библиотеки глубокого обучения. Проблема глобальной блокировки интерпретатора в Python хорошо известна. В контексте глубокого обучения мы опасаемся, что чрезвычайно быстрый GPU будет простаивать, ожидая, пока CPU выполнит код на Python, прежде чем запустить следующую задачу.
PaddlePaddle: Читатель может начать беспокоиться об эффективности. Ведь мы выполняем много обращений к словарям, исполняем код и много других операций на Python внутри высокопроизводительной библиотеки глубокого обучения. Проблема глобальной блокировки интерпретатора в Python хорошо известна. В контексте глубокого обучения мы опасаемся, что чрезвычайно быстрый GPU будет простаивать, ожидая, пока CPU выполнит код на Python, прежде чем запустить следующую задачу.
Резюме
- Блок может состоять из множества слоёв; блок может состоять из множества блоков.
- Блоки могут содержать код.
- Блоки отвечают за большой объём внутренней обработки, включая инициализацию параметров и обратное распространение.
- Последовательное соединение слоёв и блоков обеспечивает блок
Sequential.
Упражнения
- Какие проблемы возникнут, если хранить блоки в
MySequentialв виде списка Python? - Реализуйте блок, который принимает два блока, например
net1иnet2, и возвращает конкатенацию выходов обеих сетей при прямом распространении. Это называется параллельным блоком. - Допустим, мы хотим соединить несколько экземпляров одной и той же сети. Реализуйте функцию, которая создаёт несколько экземпляров одного и того же блока и на их основе строит более крупную сеть.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
5.2 Управление параметрами
Выбрав архитектуру и задав гиперпараметры, мы переходим к этапу обучения. На этом этапе цель состоит в том, чтобы найти значения параметров модели, которые минимизируют функцию потерь. После обучения эти параметры понадобятся нам для будущих предсказаний. Кроме того, иногда мы хотим извлечь параметры, чтобы повторно использовать их в других условиях, сохранить модель, чтобы её можно было выполнить в другом программном обеспечении, или изучить параметры для научного понимания.
В предыдущих разделах мы полагались только на фреймворк глубокого обучения при обучении модели и пропускали детали работы с параметрами. В этом разделе мы рассмотрим следующее:
- доступ к параметрам для отладки, диагностики и визуализации;
- инициализация параметров;
- совместное использование параметров между различными компонентами модели.
Сначала рассмотрим многослойный перцептрон с одним скрытым слоем.
MXNet:
from mxnet import init, np, npx
from mxnet.gluon import nn
npx.set_np()
net = nn.Sequential()
net.add(nn.Dense(8, activation='relu'))
net.add(nn.Dense(1))
net.initialize() # Используем метод инициализации по умолчанию
X = np.random.uniform(size=(2, 4))
net(X) # Прямое распространение
PyTorch:
import torch
from torch import nn
net = nn.Sequential(nn.Linear(4, 8), nn.ReLU(), nn.Linear(8, 1))
X = torch.rand(size=(2, 4))
net(X)
TensorFlow:
import tensorflow as tf
net = tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(4, activation=tf.nn.relu),
tf.keras.layers.Dense(1),
])
X = tf.random.uniform((2, 4))
net(X)
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
from paddle import nn
net = nn.Sequential(nn.Linear(4, 8), nn.ReLU(), nn.Linear(8, 1))
X = paddle.rand([2, 4])
net(X)
5.2.1 Доступ к параметрам
Параметры можно получить из уже существующей модели.
Если модель задана с помощью Sequential, к любому её слою можно обратиться по индексу.
Модель ведёт себя как список, а параметры каждого слоя находятся в его атрибутах.
Как показано ниже, мы можем проверить параметры второго полносвязного слоя.
MXNet:
print(net[1].params)
PyTorch, PaddlePaddle:
print(net[2].state_dict())
TensorFlow:
print(net.layers[2].weights)
Вывод даёт нам несколько важных сведений. Во-первых, этот полносвязный слой содержит два параметра: весовую матрицу и вектор смещений. Оба хранятся как числа с плавающей точкой одинарной точности (float32). Обратите внимание, что имена параметров позволяют однозначно идентифицировать каждый параметр, даже в сети из сотен слоёв.
5.2.1.1 Целевые параметры
Каждый параметр представлен экземпляром класса параметров. Чтобы выполнить с параметром какую-либо операцию, сначала нужно получить доступ к его числовому значению. Существует несколько способов это сделать: одни проще, другие универсальнее. Код ниже извлекает смещение из второго полносвязного слоя (то есть из третьего слоя сети). Извлечённый объект является экземпляром класса параметров, и далее мы обращаемся к значению этого параметра.
MXNet:
print(type(net[1].bias))
print(net[1].bias)
print(net[1].bias.data())
PyTorch:
print(type(net[2].bias))
print(net[2].bias)
print(net[2].bias.data)
TensorFlow:
print(type(net.layers[2].weights[1]))
print(net.layers[2].weights[1])
print(tf.convert_to_tensor(net.layers[2].weights[1]))
PaddlePaddle:
print(type(net[2].bias))
print(net[2].bias)
print(net[2].bias.value)
MXNet, PyTorch, PaddlePaddle: Параметры — составные объекты, которые содержат значения, градиенты и дополнительную информацию. Поэтому нам и нужно явно обращаться к значениям параметров. Помимо значения, мы также можем получить градиент каждого параметра. В приведённой сети мы ещё не вызывали обратное распространение, поэтому градиенты параметров находятся в начальном состоянии.
MXNet:
net[1].weight.grad()
PyTorch, PaddlePaddle:
net[2].weight.grad == None
5.2.1.2 Одновременный доступ ко всем параметрам
Когда нужно выполнить операцию над всеми параметрами, обращаться к каждому по отдельности может быть неудобно. Это становится особенно сложно при работе с более сложными блоками (например, с вложенными блоками), так как тогда приходится рекурсивно обходить всё дерево, чтобы извлечь параметры каждого вложенного блока. Ниже мы сравним доступ к параметрам первого полносвязного слоя с доступом ко всем слоям.
MXNet:
print(net[0].collect_params())
print(net.collect_params())
PyTorch, PaddlePaddle:
print(*[(name, param.shape) for name, param in net[0].named_parameters()])
print(*[(name, param.shape) for name, param in net.named_parameters()])
TensorFlow:
print(net.layers[1].weights)
print(net.get_weights())
Это даёт нам другой способ доступа к параметрам сети, как показано ниже.
MXNet:
net.collect_params()['dense1_bias'].data()
PyTorch:
net.state_dict()['2.bias'].data
TensorFlow:
net.get_weights()[1]
PaddlePaddle:
net.state_dict()['2.bias']
5.2.1.3 Сбор параметров из вложенных блоков
Посмотрим, как работает соглашение об именовании параметров, если вкладывать блоки друг в друга. Сначала определим функцию, которая создаёт блоки (её можно назвать «фабрикой блоков»), а затем объединим эти блоки в более крупный блок.
MXNet:
def block1():
net = nn.Sequential()
net.add(nn.Dense(32, activation='relu'))
net.add(nn.Dense(16, activation='relu'))
return net
def block2():
net = nn.Sequential()
for _ in range(4):
# Вложение блоков
net.add(block1())
return net
rgnet = nn.Sequential()
rgnet.add(block2())
rgnet.add(nn.Dense(10))
rgnet.initialize()
rgnet(X)
PyTorch:
def block1():
return nn.Sequential(nn.Linear(4, 8), nn.ReLU(),
nn.Linear(8, 4), nn.ReLU())
def block2():
net = nn.Sequential()
for i in range(4):
# Вложение блоков
net.add_module(f'block {i}', block1())
return net
rgnet = nn.Sequential(block2(), nn.Linear(4, 1))
rgnet(X)
TensorFlow:
def block1(name):
return tf.keras.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(4, activation=tf.nn.relu)],
name=name)
def block2():
net = tf.keras.Sequential()
for i in range(4):
# Вложение блоков
net.add(block1(name=f'block-{i}'))
return net
rgnet = tf.keras.Sequential()
rgnet.add(block2())
rgnet.add(tf.keras.layers.Dense(1))
rgnet(X)
PaddlePaddle:
def block1():
return nn.Sequential(nn.Linear(4, 8), nn.ReLU(),
nn.Linear(8, 4), nn.ReLU())
def block2():
net = nn.Sequential()
for i in range(4):
# Вложение блоков
net.add_sublayer(f'block {i}', block1())
return net
rgnet = nn.Sequential(block2(), nn.Linear(4, 1))
rgnet(X)
Спроектировав сеть, посмотрим, как она работает.
MXNet:
print(rgnet.collect_params)
print(rgnet.collect_params())
PyTorch, PaddlePaddle:
print(rgnet)
TensorFlow:
print(rgnet.summary())
Поскольку слои вложены иерархически, к ним можно обращаться так же, как по индексам вложенного списка. Ниже мы получаем смещение первого слоя во втором подблоке первого основного блока.
MXNet:
rgnet[0][1][0].bias.data()
PyTorch:
rgnet[0][1][0].bias.data
TensorFlow:
rgnet.layers[0].layers[1].layers[1].weights[1]
PaddlePaddle:
print(rgnet[0].state_dict()['block 0.0.bias'])
5.2.2 Инициализация параметров
Теперь, когда мы знаем, как получить доступ к параметрам, рассмотрим, как правильно их инициализировать. Мы обсуждали необходимость хорошей инициализации в разделе 4.8. Фреймворки глубокого обучения предоставляют инициализацию по умолчанию, а также позволяют создавать собственные методы инициализации, которые удовлетворяют нашим правилам.
MXNet: По умолчанию MXNet инициализирует весовые параметры, случайно выбирая их из равномерного распределения , а параметры смещения задаёт равными 0.
Модуль init MXNet предоставляет несколько готовых методов инициализации.
PyTorch: По умолчанию PyTorch инициализирует весовые матрицы и векторы смещений равномерно в диапазоне, который вычисляется по размерностям входа и выхода.
Модуль nn.init PyTorch предоставляет несколько готовых методов инициализации.
TensorFlow: По умолчанию Keras инициализирует весовые матрицы равномерно в диапазоне, который вычисляется по размерностям входа и выхода.
Параметры смещения задаются равными 0.
TensorFlow предоставляет различные методы инициализации в корневом модуле и в модуле keras.initializers.
PaddlePaddle: По умолчанию PaddlePaddle инициализирует весовые матрицы методом Xavier, а параметры смещения задаёт равными 0.
Модуль nn.initializer PaddlePaddle предоставляет несколько готовых методов инициализации.
5.2.2.1 Встроенная инициализация
Начнём с вызова встроенного инициализатора. Приведённый ниже код инициализирует все весовые параметры гауссовскими случайными величинами со стандартным отклонением 0.01, а параметры смещения задаёт равными нулю.
MXNet:
# Параметр force_reinit гарантирует, что параметры будут заново инициализированы,
# независимо от того, инициализировались ли они ранее
net.initialize(init=init.Normal(sigma=0.01), force_reinit=True)
net[0].weight.data()[0]
PyTorch:
def init_normal(m):
if type(m) == nn.Linear:
nn.init.normal_(m.weight, mean=0, std=0.01)
nn.init.zeros_(m.bias)
net.apply(init_normal)
net[0].weight.data[0], net[0].bias.data[0]
TensorFlow:
net = tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(
4, activation=tf.nn.relu,
kernel_initializer=tf.random_normal_initializer(mean=0, stddev=0.01),
bias_initializer=tf.zeros_initializer()),
tf.keras.layers.Dense(1)])
net(X)
net.weights[0], net.weights[1]
PaddlePaddle:
def init_normal(m):
if type(m) == nn.Linear:
paddle.nn.initializer.Normal(mean=0.0, std=0.01)
paddle.zeros(m.bias)
net.apply(init_normal)
net[0].weight[0],net[0].state_dict()['bias']
Мы также можем инициализировать все параметры заданной константой, например 1.
MXNet:
net.initialize(init=init.Constant(1), force_reinit=True)
net[0].weight.data()[0]
PyTorch:
def init_constant(m):
if type(m) == nn.Linear:
nn.init.constant_(m.weight, 1)
nn.init.zeros_(m.bias)
net.apply(init_constant)
net[0].weight.data[0], net[0].bias.data[0]
TensorFlow:
net = tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(
4, activation=tf.nn.relu,
kernel_initializer=tf.keras.initializers.Constant(1),
bias_initializer=tf.zeros_initializer()),
tf.keras.layers.Dense(1),
])
net(X)
net.weights[0], net.weights[1]
PaddlePaddle:
def init_constant(m):
if type(m) == nn.Linear:
paddle.nn.initializer.Constant(value = 1)
paddle.zeros(m.bias)
net.apply(init_constant)
net[0].weight[0],net[0].state_dict()['bias']
Также мы можем применять разные методы инициализации к разным блокам. Например, ниже мы инициализируем первый слой нейронной сети методом Xavier, а затем третий слой инициализируем константой 42.
MXNet:
net[0].weight.initialize(init=init.Xavier(), force_reinit=True)
net[1].initialize(init=init.Constant(42), force_reinit=True)
print(net[0].weight.data()[0])
print(net[1].weight.data())
PyTorch:
def init_xavier(m):
if type(m) == nn.Linear:
nn.init.xavier_uniform_(m.weight)
def init_42(m):
if type(m) == nn.Linear:
nn.init.constant_(m.weight, 42)
net[0].apply(init_xavier)
net[2].apply(init_42)
print(net[0].weight.data[0])
print(net[2].weight.data)
TensorFlow:
net = tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(
4,
activation=tf.nn.relu,
kernel_initializer=tf.keras.initializers.GlorotUniform()),
tf.keras.layers.Dense(
1, kernel_initializer=tf.keras.initializers.Constant(1)),
])
net(X)
print(net.layers[1].weights[0])
print(net.layers[2].weights[0])
PaddlePaddle:
def xavier(m):
if type(m) == nn.Linear:
paddle.nn.initializer.XavierUniform(m.weight)
def init_42(m):
if type(m) == nn.Linear:
paddle.nn.initializer.Constant(42)
net[0].apply(xavier)
net[2].apply(init_42)
print(net[0].weight[0])
print(net[2].weight)
5.2.2.2 Пользовательская инициализация
Иногда фреймворк глубокого обучения не предоставляет нужный нам метод инициализации. В следующем примере мы используем приведённое ниже распределение, чтобы определить метод инициализации для произвольного весового параметра :
MXNet: Здесь мы определяем подкласс класса Initializer.
Обычно достаточно реализовать функцию _init_weight, которая принимает тензор-аргумент (data) и присваивает ему нужное значение инициализации.
PyTorch: Аналогично мы реализуем функцию my_init и применяем её к net.
TensorFlow: Здесь мы определяем подкласс Initializer и реализуем функцию __call__.
Эта функция возвращает требуемый тензор заданной формы и типа данных.
PaddlePaddle: Аналогично мы реализуем функцию my_init и применяем её к net.
MXNet:
class MyInit(init.Initializer):
def _init_weight(self, name, data):
print('Инициализация', name, data.shape)
data[:] = np.random.uniform(-10, 10, data.shape)
data *= np.abs(data) >= 5
net.initialize(MyInit(), force_reinit=True)
net[0].weight.data()[:2]
PyTorch:
def my_init(m):
if type(m) == nn.Linear:
print("Инициализация", *[(name, param.shape)
for name, param in m.named_parameters()][0])
nn.init.uniform_(m.weight, -10, 10)
m.weight.data *= m.weight.data.abs() >= 5
net.apply(my_init)
net[0].weight[:2]
TensorFlow:
class MyInit(tf.keras.initializers.Initializer):
def __call__(self, shape, dtype=None):
data=tf.random.uniform(shape, -10, 10, dtype=dtype)
factor=(tf.abs(data) >= 5)
factor=tf.cast(factor, tf.float32)
return data * factor
net = tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(
4,
activation=tf.nn.relu,
kernel_initializer=MyInit()),
tf.keras.layers.Dense(1),
])
net(X)
print(net.layers[1].weights[0])
PaddlePaddle:
def my_init(m):
if type(m) == nn.Linear:
print("Инициализация", *[(name, param.shape)
for name, param in m.named_parameters()][0])
paddle.nn.initializer.XavierUniform(m.weight, -10, 10)
h = paddle.abs(m.weight) >= 5
h = paddle.to_tensor(h)
m = paddle.to_tensor(m.weight)
m *= h
net.apply(my_init)
net[0].weight[:2]
Обратите внимание, что мы всегда можем задавать параметры напрямую.
MXNet:
net[0].weight.data()[:] += 1
net[0].weight.data()[0, 0] = 42
net[0].weight.data()[0]
PyTorch:
net[0].weight.data[:] += 1
net[0].weight.data[0, 0] = 42
net[0].weight.data[0]
TensorFlow:
net.layers[1].weights[0][:].assign(net.layers[1].weights[0] + 1)
net.layers[1].weights[0][0, 0].assign(42)
net.layers[1].weights[0]
PaddlePaddle:
net[0].weight.set_value(net[0].weight.numpy() + 1)
val = net[0].weight.numpy()
val[0, 0] = 42
net[0].weight.set_value(val)
net[0].weight[0]
MXNet: Для продвинутых пользователей: если нужно изменять параметры внутри области autograd, следует использовать set_data, чтобы не вводить в заблуждение механизм автоматического дифференцирования.
5.2.3 Связывание параметров
Иногда нам хочется совместно использовать параметры между несколькими слоями: мы можем определить один плотный слой, а затем использовать его параметры для задания параметров другого слоя.
MXNet:
net = nn.Sequential()
# Нужно дать общему слою имя, чтобы можно было обращаться к его параметрам
shared = nn.Dense(8, activation='relu')
net.add(nn.Dense(8, activation='relu'),
shared,
nn.Dense(8, activation='relu', params=shared.params),
nn.Dense(10))
net.initialize()
X = np.random.uniform(size=(2, 20))
net(X)
# Проверяем, совпадают ли параметры
print(net[1].weight.data()[0] == net[2].weight.data()[0])
net[1].weight.data()[0, 0] = 100
# Убедимся, что это действительно один и тот же объект, а не просто совпадающие значения
print(net[1].weight.data()[0] == net[2].weight.data()[0])
PyTorch:
# Нужно дать общему слою имя, чтобы можно было обращаться к его параметрам
shared = nn.Linear(8, 8)
net = nn.Sequential(nn.Linear(4, 8), nn.ReLU(),
shared, nn.ReLU(),
shared, nn.ReLU(),
nn.Linear(8, 1))
net(X)
# Проверяем, совпадают ли параметры
print(net[2].weight.data[0] == net[4].weight.data[0])
net[2].weight.data[0, 0] = 100
# Убедимся, что это действительно один и тот же объект, а не просто совпадающие значения
print(net[2].weight.data[0] == net[4].weight.data[0])
TensorFlow:
# tf.keras ведёт себя немного иначе: он автоматически удаляет повторяющиеся слои
shared = tf.keras.layers.Dense(4, activation=tf.nn.relu)
net = tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
shared,
shared,
tf.keras.layers.Dense(1),
])
net(X)
# Проверяем, различаются ли параметры
print(len(net.layers) == 3)
PaddlePaddle:
# Нужно дать общему слою имя, чтобы можно было обращаться к его параметрам.
shared = nn.Linear(8, 8)
net = nn.Sequential(nn.Linear(4, 8), nn.ReLU(),
shared, nn.ReLU(),
shared, nn.ReLU(),
nn.Linear(8, 1))
net(X)
# Проверяем, совпадают ли параметры
print(net[2].weight[0] == net[4].weight[0])
MXNet: Этот пример показывает, что параметры второго и третьего слоёв связаны. Они не только имеют одинаковые значения, но и представлены одним и тем же тензором. Поэтому, если мы изменим один из параметров, изменится и другой. Возникает вопрос: что происходит с градиентами, когда параметры связаны? Ответ: поскольку модельные параметры содержат градиенты, при обратном распространении градиенты второго и третьего скрытых слоёв складываются.
PyTorch: Этот пример показывает, что параметры третьего и пятого слоёв нейронной сети связаны. Они не только имеют одинаковые значения, но и представлены одним и тем же тензором. Поэтому, если мы изменим один из параметров, изменится и другой. Возникает вопрос: что происходит с градиентами, когда параметры связаны? Ответ: поскольку модельные параметры содержат градиенты, при обратном распространении градиенты второго скрытого слоя (то есть третьего слоя сети) и третьего скрытого слоя (то есть пятого слоя сети) складываются.
Резюме
- Существует несколько способов доступа к параметрам модели, их инициализации и связывания.
- Мы можем использовать пользовательские методы инициализации.
Упражнения
- Используя модель
FancyMLP, определённую в разделе 5.1, получите доступ к параметрам её слоёв. - Изучите документацию модуля инициализации, чтобы узнать о различных методах инициализации.
- Постройте многослойный перцептрон с общими параметрами слоёв и обучите его. Во время обучения наблюдайте за параметрами и градиентами слоёв модели.
- Почему совместное использование параметров — хорошая идея?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
5.3 Отложенная инициализация
До сих пор при построении сети мы оставляли без внимания следующие моменты:
- мы определили архитектуру сети, но не задали размерность входа;
- мы добавляли слои, не указывая выходную размерность предыдущего слоя;
- при инициализации параметров у нас даже нет достаточной информации, чтобы определить, сколько параметров должна содержать модель.
Некоторые читатели могут удивиться тому, что наш код вообще работает. Ведь фреймворк глубокого обучения не может знать, какой будет размерность входа сети. Секрет в том, что фреймворк использует отложенную инициализацию (defers initialization): он откладывает инициализацию и определяет размер каждого слоя динамически — только тогда, когда данные впервые проходят через модель.
Позднее, при работе со свёрточными нейронными сетями, эта техника окажется ещё удобнее, поскольку входная размерность (то есть разрешение изображения) будет влиять на размерность каждого последующего слоя. Уже сейчас мы можем задавать параметры, не зная заранее их размерностей, и такая возможность существенно упрощает определение и изменение моделей. Далее мы подробнее рассмотрим механизм инициализации.
5.3.1 Создание экземпляра сети
Сначала создадим экземпляр многослойного перцептрона.
MXNet:
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
def get_net():
net = nn.Sequential()
net.add(nn.Dense(256, activation='relu'))
net.add(nn.Dense(10))
return net
net = get_net()
TensorFlow:
import tensorflow as tf
net = tf.keras.models.Sequential([
tf.keras.layers.Dense(256, activation=tf.nn.relu),
tf.keras.layers.Dense(10),
])
Поскольку размерность входа пока неизвестна, сеть не может знать размерность весов входного слоя. Поэтому фреймворк пока не инициализировал ни один параметр, что мы проверим, попытавшись получить доступ к параметрам.
MXNet:
print(net.collect_params)
print(net.collect_params())
TensorFlow:
[net.layers[i].get_weights() for i in range(len(net.layers))]
MXNet: Обратите внимание, что при существующих объектах параметров входная размерность каждого слоя равна -1.
MXNet использует специальное значение -1, чтобы обозначить, что размерность параметра пока неизвестна.
В этот момент попытка обратиться к net[0].weight.data() вызовет ошибку времени выполнения,
которая сообщит, что сначала нужно инициализировать сеть и только потом получать доступ к параметрам.
Теперь посмотрим, что происходит, когда мы пытаемся инициализировать параметры с помощью функции initialize.
TensorFlow: Обратите внимание, что объекты всех слоёв существуют, но веса пусты.
Вызов net.get_weights() приведёт к ошибке, потому что веса ещё не инициализированы.
MXNet:
net.initialize()
net.collect_params()
MXNet: Как видно, ничего не изменилось.
Когда входная размерность неизвестна, вызов initialize не инициализирует параметры по-настоящему.
Вместо этого MXNet запоминает, что параметры нужно инициализировать, и при этом может задать распределение для инициализации.
Далее пропустим данные через сеть, чтобы фреймворк наконец инициализировал параметры.
MXNet:
X = np.random.uniform(size=(2, 20))
net(X)
net.collect_params()
TensorFlow:
X = tf.random.uniform((2, 20))
net(X)
[w.shape for w in net.get_weights()]
Как только мы узнаём, что размерность входа равна 20, фреймворк может определить форму матрицы весов первого слоя, подставив значение 20. Определив форму первого слоя, фреймворк переходит ко второму слою и так далее, пока не станут известны все формы. Заметьте, что в данном случае отложенной инициализации требует только первый слой, но фреймворк всё равно инициализирует слои последовательно. Когда все формы параметров известны, фреймворк может инициализировать параметры.
Резюме
- Отложенная инициализация позволяет фреймворку автоматически определять формы параметров, что упрощает изменение архитектуры модели и помогает избежать некоторых распространённых ошибок.
- Мы можем пропустить данные через модель, чтобы фреймворк в конце концов инициализировал параметры.
Упражнения
- Что произойдёт, если задать входную размерность первого слоя, но не задавать размерности последующих слоёв? Происходит ли инициализация сразу?
- Что будет, если задать несовпадающие размерности?
- Что нужно сделать, если входные данные имеют разную размерность? Подсказка: обратитесь к разделу о связывании параметров.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
5.4 Пользовательские слои
Одна из причин успеха глубокого обучения — гибкость нейронных сетей: мы можем комбинировать различные слои самыми разными способами и создавать архитектуры, подходящие для самых разных задач. Например, исследователи изобрели слои, специально предназначенные для обработки изображений, текста, последовательных данных и для выполнения динамического программирования. Иногда нам встречается слой, которого ещё нет в фреймворке глубокого обучения, или мы сами хотим придумать новый слой. В таких случаях приходится создавать пользовательский слой. В этом разделе показано, как это сделать.
5.4.1 Слои без параметров
Сначала создадим пользовательский слой без параметров.
Вспомним введение блоков в разделе 5.1: этот материал должен быть знаком.
Приведённый ниже класс CenteredLayer вычитает среднее значение из своего входа.
Чтобы создать его, нужно унаследоваться от базового класса слоя и реализовать функцию прямого распространения.
MXNet:
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
class CenteredLayer(nn.Block):
def __init__(self, **kwargs):
super().__init__(**kwargs)
def forward(self, X):
return X - X.mean()
PyTorch:
import torch
from torch import nn
import torch.nn.functional as F
class CenteredLayer(nn.Module):
def __init__(self):
super().__init__()
def forward(self, X):
return X - X.mean()
TensorFlow:
import tensorflow as tf
class CenteredLayer(tf.keras.Model):
def __init__(self):
super().__init__()
def call(self, inputs):
return inputs - tf.reduce_mean(inputs)
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
from paddle import nn
import paddle.nn.functional as F
class CenteredLayer(nn.Layer):
def __init__(self):
super().__init__()
def forward(self, X):
return X - X.mean()
Подадим в этот слой какие-нибудь данные, чтобы проверить, что он работает как ожидается.
MXNet:
layer = CenteredLayer()
layer(np.array([1, 2, 3, 4, 5]))
PyTorch:
layer = CenteredLayer()
layer(torch.FloatTensor([1, 2, 3, 4, 5]))
TensorFlow:
layer = CenteredLayer()
layer(tf.constant([1, 2, 3, 4, 5]))
PaddlePaddle:
layer = CenteredLayer()
layer(paddle.to_tensor([1, 2, 3, 4, 5], dtype='float32'))
Теперь мы можем включить слой как компонент в более сложную модель.
MXNet:
net = nn.Sequential()
net.add(nn.Dense(128), CenteredLayer())
net.initialize()
PyTorch, PaddlePaddle:
net = nn.Sequential(nn.Linear(8, 128), CenteredLayer())
TensorFlow:
net = tf.keras.Sequential([tf.keras.layers.Dense(128), CenteredLayer()])
В качестве дополнительной проверки здравого смысла мы можем отправить в сеть случайные данные и убедиться, что среднее значение выхода равно 0. Поскольку мы работаем с числами с плавающей точкой, из-за ограниченной точности хранения мы всё равно можем получить очень маленькое ненулевое число.
MXNet:
Y = net(np.random.uniform(size=(4, 8)))
Y.mean()
PyTorch:
Y = net(torch.rand(4, 8))
Y.mean()
TensorFlow:
Y = net(tf.random.uniform((4, 8)))
tf.reduce_mean(Y)
PaddlePaddle:
Y = net(paddle.rand([4, 8]))
Y.mean()
5.4.2 Слои с параметрами
Выше мы разобрали, как определять простые слои. Теперь определим слои, которые имеют параметры, настраиваемые в процессе обучения. Для создания параметров мы можем использовать встроенные функции, которые обеспечивают базовое управление: доступом, инициализацией, совместным использованием, сохранением и загрузкой параметров модели. Одно из преимуществ этого подхода в том, что нам не нужно писать собственный механизм сериализации для каждого пользовательского слоя.
Теперь реализуем пользовательскую версию полносвязного слоя.
Напомним, что этому слою нужны два параметра: один для весов и другой для смещения.
В этой реализации в качестве функции активации используем ReLU.
Слой принимает два входных аргумента: in_units и units, которые задают количество входов и количество выходов соответственно.
MXNet:
class MyDense(nn.Block):
def __init__(self, units, in_units, **kwargs):
super().__init__(**kwargs)
self.weight = self.params.get('weight', shape=(in_units, units))
self.bias = self.params.get('bias', shape=(units,))
def forward(self, x):
linear = np.dot(x, self.weight.data(ctx=x.ctx)) + self.bias.data(
ctx=x.ctx)
return npx.relu(linear)
PyTorch:
class MyLinear(nn.Module):
def __init__(self, in_units, units):
super().__init__()
self.weight = nn.Parameter(torch.randn(in_units, units))
self.bias = nn.Parameter(torch.randn(units,))
def forward(self, X):
linear = torch.matmul(X, self.weight.data) + self.bias.data
return F.relu(linear)
TensorFlow:
class MyDense(tf.keras.Model):
def __init__(self, units):
super().__init__()
self.units = units
def build(self, X_shape):
self.weight = self.add_weight(name='weight',
shape=[X_shape[-1], self.units],
initializer=tf.random_normal_initializer())
self.bias = self.add_weight(
name='bias', shape=[self.units],
initializer=tf.zeros_initializer())
def call(self, X):
linear = tf.matmul(X, self.weight) + self.bias
return tf.nn.relu(linear)
PaddlePaddle:
class MyLinear(nn.Layer):
def __init__(self, in_units, units):
super().__init__()
self.weight = paddle.create_parameter(shape=(in_units, units), dtype='float32')
self.bias = paddle.create_parameter(shape=(units,), dtype='float32')
def forward(self, X):
linear = paddle.matmul(X, self.weight) + self.bias
return F.relu(linear)
MXNet, TensorFlow: Далее мы создаём экземпляр класса MyDense и обращаемся к его параметрам модели.
PyTorch, PaddlePaddle: Далее мы создаём экземпляр класса MyLinear и обращаемся к его параметрам модели.
MXNet:
dense = MyDense(units=3, in_units=5)
dense.params
PyTorch, PaddlePaddle:
linear = MyLinear(5, 3)
linear.weight
TensorFlow:
dense = MyDense(3)
dense(tf.random.uniform((2, 5)))
dense.get_weights()
Мы можем выполнять прямое распространение, используя пользовательский слой напрямую.
MXNet:
dense.initialize()
dense(np.random.uniform(size=(2, 5)))
PyTorch:
linear(torch.rand(2, 5))
TensorFlow:
dense(tf.random.uniform((2, 5)))
PaddlePaddle:
linear(paddle.randn([2, 5]))
Мы также можем построить модель с помощью пользовательского слоя, используя его точно так же, как встроенный полносвязный слой.
MXNet:
net = nn.Sequential()
net.add(MyDense(8, in_units=64),
MyDense(1, in_units=8))
net.initialize()
net(np.random.uniform(size=(2, 64)))
PyTorch:
net = nn.Sequential(MyLinear(64, 8), MyLinear(8, 1))
net(torch.rand(2, 64))
TensorFlow:
net = tf.keras.models.Sequential([MyDense(8), MyDense(1)])
net(tf.random.uniform((2, 64)))
PaddlePaddle:
net = nn.Sequential(MyLinear(64, 8), MyLinear(8, 1))
net(paddle.rand([2, 64]))
Резюме
- Мы можем создавать пользовательские слои на основе базового класса слоя. Это позволяет определять гибкие новые слои, поведение которых отличается от любого существующего слоя фреймворка глубокого обучения.
- После определения пользовательского слоя его можно вызывать в любой среде и в любой архитектуре сети.
- Слои могут иметь локальные параметры, которые можно создавать с помощью встроенных функций.
Упражнения
- Разработайте слой, который принимает входные данные и вычисляет понижение размерности тензора: он возвращает .
- Разработайте слой, который возвращает первую половину коэффициентов Фурье входных данных.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
5.5 Чтение и запись файлов
До сих пор мы обсуждали, как обрабатывать данные, а также как строить, обучать и тестировать модели глубокого обучения. Однако иногда мы хотим сохранить обученную модель, чтобы использовать её в будущем в различных условиях (например, для предсказаний при развёртывании). Кроме того, при запуске длительного процесса обучения разумно регулярно сохранять промежуточные результаты, чтобы при неожиданном отключении питания сервера не потерять результаты вычислений за несколько дней. Поэтому пора научиться загружать и сохранять векторы весов и целые модели.
5.5.1 Загрузка и сохранение тензоров
Для отдельного тензора можно напрямую вызвать функции load и save, чтобы читать и записывать его.
Обе эти функции требуют указать имя файла; функция save также принимает сохраняемую переменную.
MXNet:
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
x = np.arange(4)
npx.save('x-file', x)
PyTorch:
import torch
from torch import nn
from torch.nn import functional as F
x = torch.arange(4)
torch.save(x, 'x-file')
TensorFlow:
import tensorflow as tf
import numpy as np
x = tf.range(4)
np.save('x-file.npy', x)
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
from paddle import nn
from paddle.nn import functional as F
x = paddle.arange(4)
paddle.save(x, 'x-file')
Теперь мы можем считать данные, сохранённые в файле, обратно в память.
MXNet:
x2 = npx.load('x-file')
x2
PyTorch:
x2 = torch.load('x-file')
x2
TensorFlow:
x2 = np.load('x-file.npy', allow_pickle=True)
x2
PaddlePaddle:
x2 = paddle.load('x-file')
x2
Мы можем сохранить список тензоров и затем прочитать их обратно в память.
MXNet:
y = np.zeros(4)
npx.save('x-files', [x, y])
x2, y2 = npx.load('x-files')
(x2, y2)
PyTorch:
y = torch.zeros(4)
torch.save([x, y],'x-files')
x2, y2 = torch.load('x-files')
(x2, y2)
TensorFlow:
y = tf.zeros(4)
np.save('xy-files.npy', [x, y])
x2, y2 = np.load('xy-files.npy', allow_pickle=True)
(x2, y2)
PaddlePaddle:
y = paddle.zeros([4])
paddle.save([x,y], 'x-file')
x2, y2 = paddle.load('x-file')
(x2, y2)
Мы даже можем записывать и читать словарь, который отображает строки в тензоры. Это удобно, когда нужно читать или записывать все весовые параметры модели.
MXNet:
mydict = {'x': x, 'y': y}
npx.save('mydict', mydict)
mydict2 = npx.load('mydict')
mydict2
PyTorch:
mydict = {'x': x, 'y': y}
torch.save(mydict, 'mydict')
mydict2 = torch.load('mydict')
mydict2
TensorFlow:
mydict = {'x': x, 'y': y}
np.save('mydict.npy', mydict)
mydict2 = np.load('mydict.npy', allow_pickle=True)
mydict2
PaddlePaddle:
mydict = {'x': x, 'y': y}
paddle.save(mydict, 'mydict')
mydict2 = paddle.load('mydict')
mydict2
5.5.2 Загрузка и сохранение параметров модели
Сохранять отдельный весовой вектор (или другой тензор) действительно полезно, но если мы хотим сохранить всю модель и загрузить её позже, сохранять каждый вектор по отдельности будет слишком громоздко: у нас могут быть сотни параметров, разбросанных по всей модели. Поэтому фреймворки глубокого обучения предоставляют встроенные функции для сохранения и загрузки всей сети. Важно учитывать, что при этом сохраняются параметры модели, а не вся модель целиком. Например, если у нас есть трёхслойный многослойный перцептрон, архитектуру нужно указать отдельно. Поскольку сама модель может содержать произвольный код, её сложно сериализовать. Поэтому, чтобы восстановить модель, нужно сгенерировать архитектуру с помощью кода, а затем загрузить параметры с диска. Попробуем это на знакомом многослойном перцептроне.
MXNet:
class MLP(nn.Block):
def __init__(self, **kwargs):
super(MLP, self).__init__(**kwargs)
self.hidden = nn.Dense(256, activation='relu')
self.output = nn.Dense(10)
def forward(self, x):
return self.output(self.hidden(x))
net = MLP()
net.initialize()
X = np.random.uniform(size=(2, 20))
Y = net(X)
PyTorch:
class MLP(nn.Module):
def __init__(self):
super().__init__()
self.hidden = nn.Linear(20, 256)
self.output = nn.Linear(256, 10)
def forward(self, x):
return self.output(F.relu(self.hidden(x)))
net = MLP()
X = torch.randn(size=(2, 20))
Y = net(X)
TensorFlow:
class MLP(tf.keras.Model):
def __init__(self):
super().__init__()
self.flatten = tf.keras.layers.Flatten()
self.hidden = tf.keras.layers.Dense(units=256, activation=tf.nn.relu)
self.out = tf.keras.layers.Dense(units=10)
def call(self, inputs):
x = self.flatten(inputs)
x = self.hidden(x)
return self.out(x)
net = MLP()
X = tf.random.uniform((2, 20))
Y = net(X)
PaddlePaddle:
class MLP(nn.Layer):
def __init__(self):
super().__init__()
self.hidden = nn.Linear(20, 256)
self.output = nn.Linear(256, 10)
def forward(self, x):
return self.output(F.relu(self.hidden(x)))
net = MLP()
X = paddle.randn(shape=[2, 20])
Y = net(X)
Далее мы сохраним параметры модели в файл с именем «mlp.params».
MXNet:
net.save_parameters('mlp.params')
PyTorch:
torch.save(net.state_dict(), 'mlp.params')
TensorFlow:
net.save_weights('mlp.params')
PaddlePaddle:
paddle.save(net.state_dict(), 'mlp.pdparams')
Чтобы восстановить модель, мы создаём копию исходного многослойного перцептрона. Здесь нам не нужно случайным образом инициализировать параметры модели, вместо этого напрямую загружаем параметры, сохранённые в файле.
MXNet:
clone = MLP()
clone.load_parameters('mlp.params')
PyTorch:
clone = MLP()
clone.load_state_dict(torch.load('mlp.params'))
clone.eval()
TensorFlow:
clone = MLP()
clone.load_weights('mlp.params')
PaddlePaddle:
clone = MLP()
clone.set_state_dict(paddle.load('mlp.pdparams'))
clone.eval()
Поскольку у двух экземпляров одинаковые параметры модели, при одинаковом входе X
результаты вычислений обоих экземпляров должны совпадать.
Проверим это.
MXNet:
Y_clone = clone(X)
Y_clone == Y
PyTorch, PaddlePaddle:
Y_clone = clone(X)
Y_clone == Y
TensorFlow:
Y_clone = clone(X)
Y_clone == Y
Резюме
- Функции
saveиloadиспользуются для записи и чтения тензорных объектов в файлы. - Мы можем сохранять и загружать все параметры сети через словарь параметров.
- Архитектуру модели нужно сохранять в коде, а не в параметрах.
Упражнения
- Даже если не требуется развёртывать обученную модель на других устройствах, какая практическая польза от сохранения параметров модели?
- Предположим, мы хотим использовать только часть сети, чтобы включить её в другую архитектуру. Например, мы хотим использовать первые два слоя предыдущей сети в новой сети. Как это сделать?
- Как сохранить одновременно архитектуру сети и её параметры? Какие ограничения нужно наложить на архитектуру?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
5.6 Графические процессоры (GPU)
В таблице 1.1 мы рассмотрели быстрый рост вычислительной мощности за последние 20 лет. Вкратце: с 2000 года производительность GPU возрастает в 1000 раз каждые десять лет.
В этом разделе мы обсудим, как использовать эту вычислительную мощность в исследованиях. Сначала рассмотрим работу с одним GPU, а затем — работу с несколькими GPU и с несколькими серверами (каждый из которых имеет несколько GPU).
Сначала рассмотрим, как использовать один GPU NVIDIA для вычислений.
Прежде всего убедитесь, что установлен как минимум один GPU NVIDIA.
Затем загрузите драйвер NVIDIA и CUDA
и следуйте инструкциям по настройке нужных путей.
Когда эти подготовительные шаги выполнены, можно использовать команду nvidia-smi, чтобы посмотреть информацию о видеокарте.
!nvidia-smi
MXNet: Читатель, возможно, заметил, что тензоры MXNet почти совпадают с ndarray NumPy.
Но есть и важные отличия, одно из которых — MXNet поддерживает разные аппаратные устройства.
В MXNet у каждого массива есть контекст (context). По умолчанию все переменные и связанные с ними вычисления выделяются процессору CPU. Иногда контекстом может быть GPU. Когда мы распределяем задачи по нескольким серверам, всё становится сложнее. Разумно сопоставляя массивы с контекстами, можно минимизировать время передачи данных между устройствами. Например, при обучении нейронной сети на сервере с GPU мы обычно хотим, чтобы параметры модели находились на GPU.
Далее нужно убедиться, что установлена версия MXNet с поддержкой GPU.
Если установлена версия MXNet для CPU, её сначала нужно удалить.
Например, командой pip uninstall mxnet, а затем установить версию MXNet с поддержкой GPU, соответствующую версии CUDA.
Например, если установлена CUDA 10.0, можно установить MXNet для CUDA 10.0 командой pip install mxnet-cu100.
PyTorch: В PyTorch у каждого массива есть устройство (device), которое обычно называют контекстом (context). По умолчанию все переменные и связанные с ними вычисления выделяются CPU. Иногда контекстом может быть GPU. Когда мы распределяем задачи по нескольким серверам, всё становится сложнее. Разумно сопоставляя массивы с контекстами, можно минимизировать время передачи данных между устройствами. Например, при обучении нейронной сети на сервере с GPU мы обычно хотим, чтобы параметры модели находились на GPU.
PaddlePaddle: В PaddlePaddle у каждого тензора есть устройство (device), которое обычно называют контекстом (context). По умолчанию все переменные и связанные с ними вычисления выделяются CPU. Иногда контекстом может быть GPU. Когда мы распределяем задачи по нескольким серверам, всё становится сложнее. Разумно сопоставляя массивы с контекстами, можно минимизировать время передачи данных между устройствами. Например, при обучении нейронной сети на сервере с GPU мы обычно хотим, чтобы параметры модели находились на GPU.
Далее нужно убедиться, что установлена версия PaddlePaddle с поддержкой GPU.
Если установлена версия PaddlePaddle для CPU, её сначала нужно удалить.
Затем установите версию PaddlePaddle с поддержкой GPU, соответствующую вашей версии CUDA.
Например, если у вас установлена CUDA 10.1, можно установить PaddlePaddle для CUDA 10.1 командой
conda install paddlepaddle-gpu==2.2.2 cudatoolkit=10.1 --channel https://mirrors.tuna.tsinghua.edu.cn/anaconda/cloud/Paddle/.
Чтобы выполнить программы из этого раздела, нужно как минимум два GPU. Заметим, что для большинства настольных компьютеров это может быть роскошью, но в облаке такие ресурсы легко получить. Например, можно использовать многопроцессорные экземпляры AWS EC2 с несколькими GPU. Остальные главы книги в основном не требуют нескольких GPU, а этот раздел лишь показывает, как данные передаются между разными устройствами.
5.6.1 Вычислительные устройства
Мы можем указать устройства, которые используются для хранения и вычислений, например CPU или GPU. По умолчанию тензоры создаются в оперативной памяти, а затем вычисляются на CPU.
MXNet: В MXNet CPU и GPU обозначаются как cpu() и gpu().
Важно понимать, что cpu() (или любое целое число в скобках) обозначает все физические CPU и память,
то есть вычисления MXNet будут пытаться использовать все ядра CPU.
Однако gpu() представляет только одну карту и соответствующую видеопамять.
Если GPU несколько, для обозначения i-го GPU (i начинается с 0) используется gpu(i).
Кроме того, gpu(0) и gpu() эквивалентны.
PyTorch: В PyTorch CPU и GPU обозначаются как torch.device('cpu') и torch.device('cuda').
Важно понимать, что устройство cpu означает все физические CPU и память,
то есть вычисления PyTorch будут пытаться использовать все ядра CPU.
Однако устройство gpu представляет только одну карту и соответствующую видеопамять.
Если GPU несколько, для обозначения i-го GPU (i начинается с 0) используется torch.device(f'cuda:{i}').
Кроме того, cuda:0 и cuda эквивалентны.
PaddlePaddle: В PaddlePaddle CPU и GPU обозначаются как paddle.device.set_device('cpu') и paddle.device.set_device('gpu').
Важно понимать, что устройство cpu означает все физические CPU и память,
то есть вычисления PaddlePaddle будут пытаться использовать все ядра CPU.
Однако устройство gpu представляет только одну карту и соответствующую видеопамять.
Если GPU несколько, используется paddle.device.get_device(), где выведенное число — это номер карты
(например, gpu:3 означает карту 3; учтите, что нумерация GPU начинается с 0).
Кроме того, gpu:0 и gpu эквивалентны.
MXNet:
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
npx.cpu(), npx.gpu(), npx.gpu(1)
PyTorch:
import torch
from torch import nn
torch.device('cpu'), torch.device('cuda'), torch.device('cuda:1')
TensorFlow:
import tensorflow as tf
tf.device('/CPU:0'), tf.device('/GPU:0'), tf.device('/GPU:1')
PaddlePaddle:
import paddle
from paddle import nn
paddle.device.set_device("cpu"), paddle.CUDAPlace(0), paddle.CUDAPlace(1)
Мы можем узнать количество доступных GPU.
MXNet:
npx.num_gpus()
PyTorch:
torch.cuda.device_count()
TensorFlow:
len(tf.config.experimental.list_physical_devices('GPU'))
PaddlePaddle:
paddle.device.cuda.device_count()
Теперь определим две удобные функции, которые позволяют запускать код даже при отсутствии всех нужных GPU.
MXNet:
def try_gpu(i=0): #@save
"""Если существует, возвращает gpu(i), иначе cpu()"""
return npx.gpu(i) if npx.num_gpus() >= i + 1 else npx.cpu()
def try_all_gpus(): #@save
"""Возвращает все доступные GPU; если GPU нет, возвращает [cpu()]"""
devices = [npx.gpu(i) for i in range(npx.num_gpus())]
return devices if devices else [npx.cpu()]
try_gpu(), try_gpu(10), try_all_gpus()
PyTorch:
def try_gpu(i=0): #@save
"""Если существует, возвращает gpu(i), иначе cpu()"""
if torch.cuda.device_count() >= i + 1:
return torch.device(f'cuda:{i}')
return torch.device('cpu')
def try_all_gpus(): #@save
"""Возвращает все доступные GPU; если GPU нет, возвращает [cpu(),]"""
devices = [torch.device(f'cuda:{i}')
for i in range(torch.cuda.device_count())]
return devices if devices else [torch.device('cpu')]
try_gpu(), try_gpu(10), try_all_gpus()
TensorFlow:
def try_gpu(i=0): #@save
"""Если существует, возвращает gpu(i), иначе cpu()"""
if len(tf.config.experimental.list_physical_devices('GPU')) >= i + 1:
return tf.device(f'/GPU:{i}')
return tf.device('/CPU:0')
def try_all_gpus(): #@save
"""Возвращает все доступные GPU; если GPU нет, возвращает [cpu(),]"""
num_gpus = len(tf.config.experimental.list_physical_devices('GPU'))
devices = [tf.device(f'/GPU:{i}') for i in range(num_gpus)]
return devices if devices else [tf.device('/CPU:0')]
try_gpu(), try_gpu(10), try_all_gpus()
PaddlePaddle:
#@save
def try_gpu(i=0):
"""Если существует, возвращает gpu(i), иначе cpu()."""
if paddle.device.cuda.device_count() >= i + 1:
return paddle.CUDAPlace(i)
return paddle.CPUPlace()
#@save
def try_all_gpus():
"""Возвращает все доступные GPU; если GPU нет, возвращает [cpu(),]."""
devices = [paddle.CUDAPlace(i)
for i in range(paddle.device.cuda.device_count())]
return devices if devices else paddle.CPUPlace()
try_gpu(),try_gpu(10),try_all_gpus()
5.6.2 Тензоры и GPU
Мы можем определить, на каком устройстве находится тензор. По умолчанию тензоры создаются на CPU.
MXNet:
x = np.array([1, 2, 3])
x.ctx
PyTorch:
x = torch.tensor([1, 2, 3])
x.device
TensorFlow:
x = tf.constant([1, 2, 3])
x.device
PaddlePaddle:
x = paddle.to_tensor([1, 2, 3])
x.place
Важно помнить, что когда мы выполняем операции над несколькими объектами, они должны находиться на одном и том же устройстве. Например, если мы складываем два тензора, нужно убедиться, что оба тензора находятся на одном устройстве. В противном случае фреймворк не будет знать, где сохранить результат и даже где выполнить вычисления.
5.6.2.1 Хранение на GPU
Есть несколько способов хранить тензоры на GPU.
Например, мы можем указать устройство хранения при создании тензора.
Далее мы создаём тензорную переменную X на первом gpu.
Тензор, созданный на GPU, занимает видеопамять только этого GPU.
Использование памяти можно посмотреть командой nvidia-smi.
В общем случае нужно следить за тем, чтобы не создавать данные, которые превышают объём видеопамяти GPU.
MXNet:
X = np.ones((2, 3), ctx=try_gpu())
X
PyTorch:
X = torch.ones(2, 3, device=try_gpu())
X
TensorFlow:
with try_gpu():
X = tf.ones((2, 3))
X
PaddlePaddle:
X = paddle.to_tensor(paddle.ones(shape=[2, 3]), place=try_gpu())
X
Предположим, что у нас есть как минимум два GPU. Тогда следующий код создаст случайный тензор на втором GPU.
MXNet:
Y = np.random.uniform(size=(2, 3), ctx=try_gpu(1))
Y
PyTorch:
Y = torch.rand(2, 3, device=try_gpu(1))
Y
TensorFlow:
with try_gpu(1):
Y = tf.random.uniform((2, 3))
Y
PaddlePaddle:
Y = paddle.to_tensor(paddle.rand([2, 3]), place=try_gpu(1))
Y
5.6.2.2 Копирование
Если мы хотим вычислить X + Y, нужно решить, где выполнить эту операцию.
Например, как показано на рис. 5.6.1, мы можем передать X на второй GPU и выполнить операцию там.
Не нужно просто складывать X и Y, так как это приведёт к исключению:
среда выполнения не знает, что делать, и не может найти данные на одном устройстве.
Поскольку Y находится на втором GPU, нам нужно сначала переместить туда X, и только затем выполнить сложение.
Рис. 5.6.1. Копирование данных для выполнения операций на одном устройстве
MXNet:
Z = X.copyto(try_gpu(1))
print(X)
print(Z)
PyTorch, PaddlePaddle:
Z = X.cuda(1)
print(X)
print(Z)
TensorFlow:
with try_gpu(1):
Z = X
print(X)
print(Z)
Теперь данные находятся на одном GPU (Z и Y находятся на нём), и мы можем их сложить.
Y + Z
MXNet: Предположим, что переменная Z уже находится на втором GPU.
Если теперь вызвать Z.copyto(gpu(1)), что произойдёт?
Даже если переменная уже находится на целевом устройстве (втором GPU), она всё равно будет скопирована и сохранена в новом выделенном участке видеопамяти.
Иногда мы хотим копировать переменную, только если она находится на другом устройстве.
В таком случае можно вызвать as_in_ctx.
Если переменная уже находится на указанном устройстве, эта функция ничего не делает.
Выбирайте as_in_ctx, если только вам специально не нужна копия.
PyTorch: Предположим, что переменная Z уже находится на втором GPU.
Если мы всё равно вызовем Z.cuda(1), что произойдёт?
Она вернёт Z, не копируя данные и не выделяя новую память.
TensorFlow: Предположим, что переменная Z уже находится на втором GPU.
Если мы по-прежнему вызовем Z2 = Z в той же области устройства, что произойдёт?
Она вернёт Z, не копируя данные и не выделяя новую память.
MXNet:
Z.as_in_ctx(try_gpu(1)) is Z
PyTorch, PaddlePaddle:
Z.cuda(1) is Z
TensorFlow:
with try_gpu(1):
Z2 = Z
Z2 is Z
5.6.2.3 Дополнительные замечания
GPU используют для машинного обучения, поскольку отдельный GPU работает сравнительно быстро. Однако передача данных между устройствами (CPU, GPU и другими машинами) занимает гораздо больше времени, чем вычисления. Это также усложняет распараллеливание, потому что приходится ждать, пока данные будут отправлены (или получены), прежде чем выполнять дальнейшие операции. Поэтому операции копирования требуют особой осторожности. Как правило, много мелких операций гораздо хуже одной крупной. Кроме того, выполнять несколько операций за раз лучше, чем множество отдельных операций, разбросанных по коду. Если одно устройство должно ждать другое, чтобы выполнить следующую операцию, такая операция может блокироваться. Это немного похоже на заказ кофе стоя в очереди — в отличие от предварительного заказа по телефону, когда к приходу гостя в кафе кофе уже готов.
Наконец, когда мы выводим тензор или преобразуем его в формат NumPy, а данных в оперативной памяти нет, фреймворк сначала копирует их в память, что создаёт дополнительные накладные расходы на передачу. Хуже того, такие операции подчиняются глобальной блокировке интерпретатора, и всё вынуждено ждать, пока Python завершит работу.
5.6.3 Нейронные сети и GPU
Аналогично нейронные сети тоже могут задавать устройство. Приведённый ниже код размещает параметры модели на GPU.
MXNet:
net = nn.Sequential()
net.add(nn.Dense(1))
net.initialize(ctx=try_gpu())
PyTorch:
net = nn.Sequential(nn.Linear(3, 1))
net = net.to(device=try_gpu())
TensorFlow:
strategy = tf.distribute.MirroredStrategy()
with strategy.scope():
net = tf.keras.models.Sequential([
tf.keras.layers.Dense(1)])
PaddlePaddle:
net = nn.Sequential(nn.Linear(3, 1))
net=net.to(try_gpu())
В следующих главах мы увидим больше примеров запуска моделей на GPU, так как вычисления там станут более ресурсоёмкими.
Когда входные данные являются тензорами на GPU, модель будет вычислять результат на том же GPU.
net(X)
Убедимся, что параметры модели хранятся на том же GPU.
MXNet:
net[0].weight.data().ctx
PyTorch:
net[0].weight.data.device
TensorFlow:
net.layers[0].weights[0].device, net.layers[0].weights[1].device
PaddlePaddle:
net[0].weight.place
Итак, пока все данные и параметры находятся на одном устройстве, мы можем эффективно обучать модель. В следующих разделах мы увидим несколько таких примеров.
Резюме
- Можно указать устройство для хранения и вычислений, например CPU или GPU. По умолчанию данные создаются в основной памяти, а затем вычисляются на CPU.
- Фреймворки глубокого обучения требуют, чтобы все входные данные для вычислений находились на одном устройстве, будь то CPU или GPU.
- Неосторожное перемещение данных может значительно снизить производительность. Типичная ошибка выглядит так: вычисляется потеря на GPU для каждого минибатча, а затем она выводится пользователю в командной строке (или записывается в
ndarrayNumPy). Это вызывает глобальную блокировку интерпретатора и блокирует все GPU. Лучше выделить память на GPU под журнал и переносить только крупные порции данных.
Упражнения
- Попробуйте более ресурсоёмкую задачу, например перемножение больших матриц, и сравните скорость CPU и GPU. А что получится для задачи с небольшим объёмом вычислений?
- Как нам читать и записывать параметры модели на GPU?
- Замерьте время, необходимое для перемножения 1000 матриц размера , и запишите норму Фробениуса выходной матрицы после каждого результата, а не сохраняйте журнал на GPU и не передавайте только итоговый результат.
- Замерьте время одновременного выполнения двух умножений матриц на двух GPU и последовательного выполнения тех же двух умножений на одном GPU. Подсказка: должно получиться почти линейное масштабирование.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
6. Свёрточные нейронные сети
В предыдущих главах мы уже встречались с данными изображений. Каждый пример такого набора данных представляет собой двумерную сетку пикселей, а каждый пиксель может быть одним числом или набором чисел — в зависимости от того, чёрно-белое изображение или цветное. До сих пор наши способы работы с такими структурно богатыми данными были недостаточно эффективными. Мы просто разворачивали изображение в одномерный вектор, теряя пространственную структуру каждого изображения, и подавали его в полносвязный многослойный перцептрон. Поскольку порядок элементов признаков в таких сетях не меняется, наилучший результат даёт использование априорных знаний — взаимосвязи соседних пикселей. Именно так из данных изображений можно выучить эффективную модель.
В этой главе мы познакомимся со свёрточными нейронными сетями (convolutional neural network, CNN) — мощным классом нейронных сетей, созданным для обработки данных изображений. Модели на основе свёрточных архитектур доминируют в компьютерном зрении: почти все современные соревнования и коммерческие приложения, связанные с распознаванием изображений, обнаружением объектов или семантической сегментацией, опираются на этот подход.
Современные свёрточные сети возникли благодаря биологии, теории групп и серии вспомогательных экспериментов. Свёрточным сетям нужно меньше параметров, чем сетям с полносвязной архитектурой, и свёртку легко распараллелить на GPU. Поэтому свёрточные сети позволяют не только эффективно обучаться на данных и получать точные модели, но и эффективно вычислять их. Со временем практики всё чаще используют свёрточные сети. Даже в задачах с одномерными последовательностями, где обычно применяются рекуррентные сети (например, в анализе аудио, текстов и временных рядов), свёрточные сети становятся всё популярнее. Некоторые тонкие модификации свёрточных сетей позволяют применять их и к данным на графах, и в рекомендательных системах.
В начале главы мы рассмотрим базовые элементы, из которых строится любая свёрточная сеть. Это сама операция свёртки, тонкости заполнения (padding) и шага (stride), слои пулинга (pooling), которые объединяют информацию из соседних областей, использование нескольких каналов (channel) на каждом слое и подробное обсуждение современных архитектур свёрточных сетей. В конце главы мы построим полную, работающую модель LeNet — первую успешно применённую свёрточную нейронную сеть, появившуюся даже раньше современного глубокого обучения. В следующей главе мы подробно разберём реализации некоторых популярных и сравнительно новых архитектур свёрточных сетей, в которых используются большинство классических приёмов, применяемых практиками сегодня.
6.1 От полносвязных слоёв к свёрткам
Многослойные перцептроны, которые мы рассматривали ранее, хорошо подходят для табличных данных, где строки соответствуют примерам, а столбцы — признакам. Для табличных данных мы ищем закономерности, которые могут включать взаимодействие признаков, но не можем заранее предполагать какую-либо априорную структуру этих взаимодействий. В таком случае многослойный перцептрон может оказаться лучшим выбором. Однако для высокоразмерных перцептивных данных, таких как изображения, сеть без какой-либо структуры может стать непрактичной.
Возьмём для примера задачу классификации кошек и собак из предыдущих глав. Предположим, что у нас есть достаточно большой набор размеченных фотографий, каждая из которых содержит миллионы пикселей. Значит, каждый входной пример имеет миллион измерений. Даже если уменьшить размер скрытого слоя до 1000, полносвязный слой будет содержать параметров. Обучить такую модель практически невозможно: для этого понадобились бы огромные вычислительные ресурсы на GPU, опыт распределённого обучения и незаурядное терпение.
Некоторые читатели могут возразить, что миллионного разрешения, пожалуй, и не нужно. Однако даже при разрешении в сто тысяч пикселей скрытого слоя из 1000 нейронов может не хватить, чтобы выучить хорошие признаки изображения, и в реальных системах нам всё равно понадобятся миллиарды параметров. Кроме того, чтобы подобрать такое количество параметров, требуется огромный объём данных. Тем не менее люди и машины сегодня хорошо различают кошек и собак. Это потому, что в изображениях уже есть богатая структура, которую могут использовать и человек, и модель. Свёрточные нейронные сети (convolutional neural networks, CNN) — это изобретательный способ использовать известные структуры природных изображений в машинном обучении.
6.1.1 Инвариантность
Представим, что мы хотим найти некоторый объект на картинке. Разумно предположить, что способ поиска не должен зависеть от того, где находится объект. В идеале наша система должна опираться на здравый смысл: свинья обычно не летает по небу, а самолёт обычно не плавает в воде. Но если свинья окажется в верхней части картинки, мы всё равно должны её узнать.
Вдохновение можно почерпнуть из детской игры «Где Вальдо?» (рис. 6.1.1). В ней много запутанных сцен, полных движения, а Вальдо обычно прячется в маловероятных местах, и задача читателя — найти его. Внешность Вальдо очень приметна, но в пёстрой сцене найти его всё равно непросто, как иголку в стоге сена. Однако то, как выглядит Вальдо, не зависит от того, где он спрятан, поэтому можно просканировать изображение «детектором Вальдо». Такой детектор разбивает изображение на области и оценивает для каждой из них вероятность того, что там находится Вальдо. Свёрточные нейронные сети как раз и систематизируют эту идею — пространственную инвариантность (spatial invariance), — и на её основе позволяют выучивать полезные представления, используя меньше параметров.
Рис. 6.1.1. Сцена из игры «Где Вальдо?». Иллюстрация стороннего издания не включена в перевод
Теперь сформулируем эти идеи, чтобы помочь нам проектировать архитектуры нейронных сетей для компьютерного зрения:
- Инвариантность к сдвигу (translation invariance): какое бы место изображения ни занимал объект, первые слои сети должны одинаково реагировать на одну и ту же область изображения. Это и есть инвариантность к сдвигу.
- Локальность (locality): первые слои сети должны опираться только на небольшие локальные области входного изображения и не придавать излишнего значения связям между далёкими областями. Это и есть принцип локальности. В итоге эти локальные признаки можно объединить и делать предсказание для всего изображения.
Посмотрим, как эти принципы переводятся на язык математики.
6.1.2 Ограничения многослойного перцептрона
Прежде всего, входом многослойного перцептрона служит двумерное изображение , а его скрытое представление с математической точки зрения является матрицей, а в коде — двумерным тензором. При этом и имеют одинаковую форму. Для удобства можно считать, что и вход, и скрытое представление обладают пространственной структурой.
Обозначим и значения пикселей во входном изображении и в скрытом представлении в позиции . Чтобы каждый скрытый нейрон получал информацию о каждом пикселе входа, заменим матрицу весов (как мы делали раньше в многослойном перцептроне) четырёхмерным тензором весов . Пусть содержит параметры смещения. Тогда полносвязный слой можно формально записать так:
Переход от к — чисто формальный, поскольку элементы этих двух четырёхмерных тензоров взаимно однозначно соответствуют друг другу. Достаточно переиндексировать пару , положив и , откуда получаем . Индексы и пробегают всё изображение, сдвигаясь в положительную и отрицательную стороны. Значение в любой фиксированной позиции скрытого представления получается как взвешенная сумма пикселей входа с центром в , где весами служат .
6.1.2.1 Инвариантность к сдвигу
Теперь применим первый принцип — инвариантность к сдвигу. Это означает, что сдвиг объекта во входе должен приводить лишь к сдвигу в скрытом представлении . Иными словами, и фактически не зависят от , то есть , а — константа, например . Поэтому определение можно упростить:
Это и есть свёртка (convolution). Мы взвешиваем пиксели в окрестности позиции с коэффициентами и получаем . Заметьте, что коэффициентов гораздо меньше, чем , ведь первые больше не зависят от положения в изображении. Это большой шаг вперёд!
6.1.2.2 Локальность
Теперь применим второй принцип — локальность. Как уже говорилось, чтобы собрать релевантную информацию для вычисления , не следует уходить далеко от точки . Это означает, что вне диапазона или можно положить . Тогда можно переписать так:
Проще говоря, формула (6.1.1) задаёт свёрточный слой (convolutional layer), а свёрточные нейронные сети — особый класс нейронных сетей, содержащих свёрточные слои. В сообществе глубокого обучения называют ядром свёртки (convolution kernel) или фильтром (filter), а иногда просто весами этого свёрточного слоя; обычно эти веса — обучаемые параметры. Когда локальная область обработки изображения мала, разница между обучением свёрточной сети и многослойного перцептрона может быть огромной: если раньше для описания одного слоя многослойного перцептрона могли понадобиться миллиарды параметров, то свёрточной сети часто хватает нескольких сотен параметров, и при этом не нужно менять размерность входа или скрытого представления.
Ценой значительного сокращения числа параметров становится то, что наши признаки теперь инвариантны к сдвигу, а при вычислении каждого скрытого значения слой учитывает только локальную информацию. Всё обучение весов опирается на индуктивное смещение (inductive bias). Когда это смещение соответствует реальности, мы получаем модели, эффективные по объёму выборки, которые хорошо обобщаются на новые данные. Но если смещение не соответствует действительности — например, если изображение не обладает инвариантностью к сдвигу, — модель может с трудом подгонять обучающие данные.
6.1.3 Свёртка
Прежде чем двигаться дальше, кратко вспомним, почему описанная выше операция называется свёрткой. В математике свёртка двух функций (например, ) определяется как
Иными словами, свёртка измеряет перекрытие и , когда одну из функций «переворачивают» и сдвигают на . В дискретном случае интеграл превращается в сумму. Например, для векторов из бесконечномерного пространства с индексами из , квадрат которых суммируем, получаем следующее определение:
Для двумерных тензоров суммирование ведётся по соответствующим индексам: для и для :
Это похоже на формулу (6.1.1), но есть одно существенное отличие: вместо здесь используются разности индексов. Однако это различие поверхностно, ведь мы всегда можем согласовать знаки между формулами (6.1.1) и (6.1.2). Исходное определение из формулы (6.1.1) точнее описывает взаимную корреляцию (cross-correlation), о которой пойдёт речь в следующем разделе.
6.1.4 Вернёмся к игре «Где Вальдо?»
Вернёмся к игре «Где Вальдо?» и посмотрим, как она выглядит на самом деле. Свёрточный слой по фильтру выбирает окно заданного размера и взвешенно обрабатывает изображение, как показано на рис. 6.1.2. Наша цель — выучить модель, которая находила бы места, где Вальдо скорее всего прячется.
Рис. 6.1.2. Поиск Вальдо. Иллюстрация стороннего издания не включена в перевод
6.1.4.1 Каналы
Однако у этого подхода есть недостаток: мы игнорируем то, что изображения обычно имеют три канала — три основных цвета (красный, зелёный и синий). На самом деле изображение — это не двумерный, а трёхмерный тензор с высотой, шириной и цветом, например пикселя. Первые две оси связаны с пространственным положением пикселя, а третья может рассматриваться как многомерное представление каждого пикселя. Поэтому будем индексировать как . Соответственно свёртка принимает вид с весами вместо .
Кроме того, поскольку входное изображение трёхмерно, скрытое представление также целесообразно хранить в виде трёхмерного тензора. Иными словами, для каждой пространственной позиции мы хотим иметь не одно скрытое представление, а набор. Такой набор можно представить как стопку двумерных сеток, наложенных друг на друга. Поэтому скрытое представление удобно считать набором каналов (channel), каждый из которых — двумерный тензор. Эти каналы иногда называют картами признаков (feature maps), поскольку каждый из них передаёт последующим слоям набор пространственно организованных признаков. Интуитивно можно представить, что в нижних слоях, близких ко входу, одни каналы выделяют края, а другие — текстуры.
Чтобы поддерживать несколько каналов во входе и скрытом представлении , добавим в четвёртую координату, то есть . Таким образом,
где индекс в скрытом представлении обозначает выходной канал, а дальше трёхмерный тензор становится входом следующего свёрточного слоя. Поэтому формула (6.1.3) задаёт свёрточный слой с несколькими каналами, где — веса этого слоя.
Однако многие вопросы ещё остаются открытыми. Например, можно ли ожидать появления Вальдо в любом месте изображения? Как эффективно вычислять выходной слой? Как выбрать подходящую функцию активации? Какие решения при проектировании сети помогут обучить эффективную сеть? Мы обсудим эти вопросы в других частях этой главы.
Резюме
- Инвариантность к сдвигу позволяет обрабатывать локальные участки изображения одинаковым образом независимо от их положения.
- Локальность означает, что для вычисления соответствующего скрытого представления нужна лишь небольшая часть локальных пикселей изображения.
- При обработке изображений свёрточные слои обычно требуют меньше параметров, чем полносвязные, но при этом позволяют строить эффективные модели.
- Свёрточная нейронная сеть (CNN) — особый класс нейронных сетей, который может содержать несколько свёрточных слоёв.
- Несколько входных и выходных каналов позволяют модели в каждой пространственной позиции извлекать разные аспекты изображения.
Упражнения
- Предположим, что свёрточный слой (6.1.1) имеет локальную область . Докажите, что в этом случае ядро свёртки для каждой группы каналов независимо реализует полносвязный слой.
- Почему инвариантность к сдвигу тоже может оказаться плохой идеей?
- Над какими вопросами нам нужно задуматься, когда мы получаем скрытые представления для пикселей на границах изображения?
- Опишите похожую архитектуру свёрточного слоя для аудиоданных.
- Подходят ли свёрточные слои и для текстовых данных? Почему?
- Докажите, что в формуле (6.1.2) выполняется .
6.2 Свёртки для изображений
В предыдущем разделе мы разобрали принцип работы свёрточного слоя, теперь посмотрим, как он применяется на практике. Поскольку свёрточные нейронные сети созданы для анализа данных изображений, в этом разделе мы будем рассматривать именно изображения.
6.2.1 Операция взаимной корреляции
Строго говоря, название «свёрточный слой» некорректно, поскольку на самом деле он выполняет взаимную корреляцию (cross-correlation), а не свёртку. Как описано в разделе 6.1, в свёрточном слое входной тензор и ядро свёртки с помощью взаимной корреляции дают выходной тензор.
Сначала временно отвлечёмся от каналов (третьего измерения) и посмотрим, как обрабатывать двумерные данные изображения и скрытые представления. На рис. 6.2.1 входом служит двумерный тензор высотой и шириной (то есть формы ). Высота и ширина ядра свёртки равны , а форма окна свёртки (или окна ядра) определяется высотой и шириной ядра, то есть равна .
Рис. 6.2.1. Двумерная взаимная корреляция. Затенённая часть — первый элемент выхода, а также элементы входного и ядерного тензоров, используемые для его вычисления:
В двумерной взаимной корреляции окно свёртки начинает движение из левого верхнего угла входного тензора и скользит слева направо и сверху вниз. Когда окно переходит в новое положение, входящая в него часть тензора поэлементно умножается на ядро, полученные произведения суммируются в одно скалярное значение, и это значение становится элементом выходного тензора в данной позиции. В приведённом примере четыре элемента выходного тензора получаются двумерной взаимной корреляцией; выход имеет высоту и ширину :
Обратите внимание, что выход немного меньше входа. Это происходит потому, что ширина и высота ядра больше 1, а ядро выполняет взаимную корреляцию только в тех позициях изображения, где оно полностью помещается. Таким образом, размер выхода равен размеру входа , уменьшенному на размер ядра , то есть:
Это связано с тем, что ядру нужно достаточно места, чтобы «двигаться» по изображению. Позже мы увидим, как дополнять границы изображения нулями, чтобы обеспечить место для движения ядра и сохранить размер выхода. А сейчас реализуем описанный процесс в функции corr2d, которая принимает входной тензор X и ядерный тензор K и возвращает выходной тензор Y.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
MXNet, PyTorch, PaddlePaddle:
def corr2d(X, K): #@save
"""Вычисляет двумерную взаимную корреляцию"""
h, w = K.shape
Y = d2l.zeros((X.shape[0] - h + 1, X.shape[1] - w + 1))
for i in range(Y.shape[0]):
for j in range(Y.shape[1]):
Y[i, j] = d2l.reduce_sum((X[i: i + h, j: j + w] * K))
return Y
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
def corr2d(X, K): #@save
"""Вычисляет двумерную взаимную корреляцию"""
h, w = K.shape
Y = tf.Variable(tf.zeros((X.shape[0] - h + 1, X.shape[1] - w + 1)))
for i in range(Y.shape[0]):
for j in range(Y.shape[1]):
Y[i, j].assign(tf.reduce_sum(
X[i: i + h, j: j + w] * K))
return Y
Используя входной тензор X и ядерный тензор K с рис. 6.2.1, проверим результат описанной двумерной взаимной корреляции.
X = d2l.tensor([[0.0, 1.0, 2.0], [3.0, 4.0, 5.0], [6.0, 7.0, 8.0]])
K = d2l.tensor([[0.0, 1.0], [2.0, 3.0]])
corr2d(X, K)
6.2.2 Свёрточные слои
Свёрточный слой выполняет взаимную корреляцию входа и весов ядра и после добавления скалярного смещения формирует выход. Поэтому у свёрточного слоя два обучаемых параметра: веса ядра и скалярное смещение. Как и полносвязные слои ранее, при обучении моделей на основе свёрточных слоёв веса ядра мы инициализируем случайными значениями.
Опираясь на функцию corr2d, определённую выше, реализуем двумерный свёрточный слой. В конструкторе __init__ объявляем weight и bias как два параметра модели. Функция прямого распространения вызывает corr2d и добавляет смещение.
MXNet:
class Conv2D(nn.Block):
def __init__(self, kernel_size, **kwargs):
super().__init__(**kwargs)
self.weight = self.params.get('weight', shape=kernel_size)
self.bias = self.params.get('bias', shape=(1,))
def forward(self, x):
return corr2d(x, self.weight.data()) + self.bias.data()
PyTorch:
class Conv2D(nn.Module):
def __init__(self, kernel_size):
super().__init__()
self.weight = nn.Parameter(torch.rand(kernel_size))
self.bias = nn.Parameter(torch.zeros(1))
def forward(self, x):
return corr2d(x, self.weight) + self.bias
TensorFlow:
class Conv2D(tf.keras.layers.Layer):
def __init__(self):
super().__init__()
def build(self, kernel_size):
initializer = tf.random_normal_initializer()
self.weight = self.add_weight(name='w', shape=kernel_size,
initializer=initializer)
self.bias = self.add_weight(name='b', shape=(1, ),
initializer=initializer)
def call(self, inputs):
return corr2d(inputs, self.weight) + self.bias
PaddlePaddle:
class Conv2D(nn.Layer):
def __init__(self, kernel_size):
super().__init__()
self.weight = paddle.ParamAttr(paddle.rand(kernel_size))
self.bias = paddle.ParamAttr(paddle.zeros(1))
def forward(self, x):
return corr2d(x, self.weight) + self.bias
Ядро с высотой и шириной называют свёрткой или ядром . Свёрточный слой с ядром также называем слоем .
6.2.3 Обнаружение границ объектов на изображении
Ниже приведён простой пример применения свёрточного слоя: по местам, где меняются пиксели, мы обнаруживаем границы разных цветов на изображении. Сначала построим чёрно-белое изображение размером пикселей. Четыре средних столбца чёрные (), остальные пиксели белые ().
MXNet, PyTorch, PaddlePaddle:
X = d2l.ones((6, 8))
X[:, 2:6] = 0
X
TensorFlow:
X = tf.Variable(tf.ones((6, 8)))
X[:, 2:6].assign(tf.zeros(X[:, 2:6].shape))
X
Далее построим ядро K высотой и шириной . При взаимной корреляции выход равен нулю, если два горизонтально соседних элемента одинаковы, и отличен от нуля в противном случае.
K = d2l.tensor([[1.0, -1.0]])
Теперь выполним взаимную корреляцию входа X и ядра K. Как видно ниже, единица в выходе Y соответствует границе от белого к чёрному, а −1 — границе от чёрного к белому; в остальных случаях выход равен .
Y = corr2d(X, K)
Y
Теперь транспонируем входное изображение и снова выполним ту же взаимную корреляцию. Результат показан ниже: вертикальные границы, которые мы обнаружили раньше, исчезли. Неудивительно: ядро K умеет обнаруживать только вертикальные границы и не замечает горизонтальных.
corr2d(d2l.transpose(X), K)
6.2.4 Изучение ядра свёртки
Если нам нужны только чёрно-белые границы, детектора [1, -1] достаточно. Однако когда ядра имеют более сложные значения или когда слоёв свёртки много, вручную проектировать фильтры невозможно. Можно ли выучить ядро, которое по X получает Y?
Проверим, можно ли выучить ядро, которое по X даёт Y, опираясь только на пары «вход — выход». Сначала построим свёрточный слой и инициализируем его ядро случайным тензором. Затем на каждой итерации сравниваем квадратичную ошибку между Y и выходом свёрточного слоя и вычисляем градиенты для обновления ядра. Для простоты используем встроенный двумерный свёрточный слой и не будем учитывать смещение.
MXNet:
# Строим двумерный свёрточный слой с 1 выходным каналом и ядром формы (1, 2)
conv2d = nn.Conv2D(1, kernel_size=(1, 2), use_bias=False)
conv2d.initialize()
# Этот двумерный свёрточный слой использует четырёхмерный формат входа и выхода
# (размер батча, канал, высота, ширина), где размер батча и количество каналов равны 1
X = X.reshape(1, 1, 6, 8)
Y = Y.reshape(1, 1, 6, 7)
lr = 3e-2 # Скорость обучения
for i in range(10):
with autograd.record():
Y_hat = conv2d(X)
l = (Y_hat - Y) ** 2
l.backward()
# Обновляем ядро свёртки
conv2d.weight.data()[:] -= lr * conv2d.weight.grad()
if (i + 1) % 2 == 0:
print(f'эпоха {i+1}, потери {float(l.sum()):.3f}')
PyTorch:
# Строим двумерный свёрточный слой с 1 выходным каналом и ядром формы (1, 2)
conv2d = nn.Conv2d(1,1, kernel_size=(1, 2), bias=False)
# Этот двумерный свёрточный слой использует четырёхмерный формат входа и выхода
# (размер батча, канал, высота, ширина), где размер батча и количество каналов равны 1
X = X.reshape((1, 1, 6, 8))
Y = Y.reshape((1, 1, 6, 7))
lr = 3e-2 # Скорость обучения
for i in range(10):
Y_hat = conv2d(X)
l = (Y_hat - Y) ** 2
conv2d.zero_grad()
l.sum().backward()
# Обновляем ядро свёртки
conv2d.weight.data[:] -= lr * conv2d.weight.grad
if (i + 1) % 2 == 0:
print(f'эпоха {i+1}, потери {l.sum():.3f}')
TensorFlow:
# Строим двумерный свёрточный слой с 1 выходным каналом и ядром формы (1, 2)
conv2d = tf.keras.layers.Conv2D(1, (1, 2), use_bias=False)
# Этот двумерный свёрточный слой использует четырёхмерный формат входа и выхода
# (размер батча, высота, ширина, канал), где размер батча и количество каналов равны 1
X = tf.reshape(X, (1, 6, 8, 1))
Y = tf.reshape(Y, (1, 6, 7, 1))
lr = 3e-2 # Скорость обучения
Y_hat = conv2d(X)
for i in range(10):
with tf.GradientTape(watch_accessed_variables=False) as g:
g.watch(conv2d.weights[0])
Y_hat = conv2d(X)
l = (abs(Y_hat - Y)) ** 2
# Обновляем ядро свёртки
update = tf.multiply(lr, g.gradient(l, conv2d.weights[0]))
weights = conv2d.get_weights()
weights[0] = conv2d.weights[0] - update
conv2d.set_weights(weights)
if (i + 1) % 2 == 0:
print(f'эпоха {i+1}, потери {tf.reduce_sum(l):.3f}')
PaddlePaddle:
# Строим двумерный свёрточный слой с 1 выходным каналом и ядром формы (1, 2)
conv2d = nn.Conv2D(1, 1, kernel_size=(1, 2))
# Этот двумерный свёрточный слой использует четырёхмерный формат входа и выхода
# (размер батча, канал, высота, ширина), где размер батча и количество каналов равны 1
X = X.reshape((1, 1, 6, 8))
Y = Y.reshape((1, 1, 6, 7))
lr = 3e-2 # Скорость обучения
for i in range(10):
Y_hat = conv2d(X)
l = (Y_hat - Y) ** 2
conv2d.clear_gradients()
l.sum().backward()
# Обновляем ядро свёртки
with paddle.no_grad():
conv2d.weight[:] -= lr * conv2d.weight.grad
if (i + 1) % 2 == 0:
print(f'эпоха {i+1}, потери {l.sum().item():.3f}')
После итераций ошибка стала достаточно малой. Теперь посмотрим на весовой тензор выученного ядра.
MXNet:
d2l.reshape(conv2d.weight.data(), (1, 2))
PyTorch:
d2l.reshape(conv2d.weight.data, (1, 2))
TensorFlow:
d2l.reshape(conv2d.get_weights()[0], (1, 2))
PaddlePaddle:
d2l.reshape(conv2d.weight, (1, 2))
Внимательный читатель наверняка заметит, что выученные веса ядра очень близки к ядру K, которое мы определили ранее.
6.2.5 Взаимная корреляция и свёртка
Вспомним соответствие между взаимной корреляцией и свёрткой, которое мы наблюдали в разделе 6.1. Чтобы получить результат формальной свёртки, нужно выполнить строгую свёртку, определённую в формуле (6.1.2), а не взаимную корреляцию. К счастью, разница невелика: достаточно отразить двумерный ядерный тензор по горизонтали и по вертикали, а затем выполнить взаимную корреляцию входного тензора.
Стоит заметить, что ядро выучивается из данных, поэтому выход свёрточного слоя не меняется, выполняет ли слой строгую свёртку или взаимную корреляцию. Чтобы это показать, предположим, что слой выполняет взаимную корреляцию и выучивает ядро с рис. 6.2.1, которое здесь обозначено матрицей . При прочих равных условиях, если тот же слой выполняет строгую свёртку, выученное ядро после горизонтального и вертикального отражения будет совпадать с . Иными словами, если свёрточный слой применит строгую свёртку к входу с рис. 6.2.1 и ядру , он получит тот же выход, что и при взаимной корреляции на рис. 6.2.1.
Чтобы соответствовать стандартной терминологии литературы по глубокому обучению, мы и дальше будем называть «взаимную корреляцию» свёрткой, хотя строго говоря это разные операции. Кроме того, веса ядерного тензора будем называть его элементами.
6.2.6 Карты признаков и рецептивные поля
Как говорилось в разделе 6.1.4.1, выход свёрточного слоя с рис. 6.2.1 иногда называют картой признаков (feature map): его можно рассматривать как преобразование, которое переводит вход в пространственное представление для следующего слоя. В свёрточной нейронной сети для любого элемента некоторого слоя рецептивное поле (receptive field) — это все элементы (из всех предыдущих слоёв), которые могут влиять на вычисление в ходе прямого распространения.
Обратите внимание, что рецептивное поле может быть больше самого входа. Поясним это на примере с рис. 6.2.1: при ядре рецептивное поле затенённого выходного элемента со значением — это четыре элемента затенённой части входа. Пусть предыдущий выход имеет размер , и за ним следует свёрточный слой, который получает и выдаёт один элемент . В этом случае рецептивное поле на включает все четыре элемента , а рецептивное поле на входе включает все девять входных элементов. Поэтому, когда какому-либо элементу карты признаков нужно уловить признаки более широкой области входа, можно строить более глубокую сеть.
Резюме
- Ядром двумерного свёрточного слоя является двумерная взаимная корреляция. В простейшем случае она выполняется над двумерным входом и ядром, после чего добавляется смещение.
- Мы можем спроектировать ядро свёртки, которое обнаруживает границы на изображении.
- Параметры ядра можно выучить из данных.
- При обучении ядра выход свёрточного слоя почти не зависит от того, выполняется ли строгая свёртка или взаимная корреляция.
- Чтобы выявить признаки на более широкой области входа, можно строить более глубокие свёрточные сети.
Упражнения
- Постройте изображение
Xс диагональными границами.- Что произойдёт, если применить к
XядроKиз этого раздела? - Что произойдёт при транспонировании
X? - Что произойдёт при транспонировании
K?
- Что произойдёт, если применить к
- Какое сообщение об ошибке появляется при автоматическом дифференцировании созданного нами
Conv2D? - Как, изменяя входной и ядерный тензоры, представить взаимную корреляцию в виде матричного умножения?
- Вручную спроектируйте несколько ядер свёртки.
- Каков вид ядра для второй производной?
- Каков вид ядра для интегрирования?
- Каков минимальный размер ядра для вычисления производной порядка ?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
6.3 Заполнение и шаг
В предыдущем примере (рис. 6.2.1) высота и ширина входа равны , высота и ширина ядра — , а выход имеет размерность . Как мы обобщили в разделе 6.2, если форма входа равна , а форма ядра — , то форма выхода равна . Таким образом, форма выхода свёртки зависит от формы входа и формы ядра.
Что ещё влияет на размер выхода? В этом разделе мы рассмотрим заполнение (padding) и шаг (stride). Рассмотрим такой сценарий. Иногда после нескольких последовательных свёрток выход оказывается заметно меньше входа. Это происходит потому, что высота и ширина ядра обычно больше . Например, изображение пикселей после свёрточных слоёв уменьшится до пикселей. Так граничные пиксели исходного изображения теряют много полезной информации. Заполнение — самый эффективный способ решить эту проблему. Иногда же нам может понадобиться существенно уменьшить высоту и ширину изображения, например если исходное разрешение входа избыточно. В таких случаях помогает шаг (stride).
6.3.1 Заполнение
Как уже говорилось, при последовательном применении нескольких свёрток мы часто теряем пиксели по краям. Поскольку ядра обычно малы, одна свёртка теряет лишь несколько пикселей, но при большом числе последовательных свёрточных слоёв потери накапливаются. Простой способ решить эту проблему — заполнение (padding): по границам входного изображения добавляют элементы, обычно нулевые. Например, на рис. 6.3.1 вход дополнен до , поэтому выход увеличивается до . Затенённая часть — первый элемент выхода и элементы входного и ядерного тензоров, использованные для его вычисления: .
Рис. 6.3.1. Двумерная взаимная корреляция с заполнением
В общем случае, если добавить строк заполнения (примерно половину сверху и половину снизу) и столбцов (примерно половину слева и половину справа), форма выхода будет равна
Это означает, что высота и ширина выхода увеличиваются соответственно на и .
Во многих случаях нужно задать и , чтобы вход и выход имели одинаковую высоту и ширину. Это упрощает предсказание формы выхода каждого слоя при построении сети. Пусть нечётно: тогда мы заполняем по строк с обеих сторон по высоте. Если же чётно, один из вариантов — добавить строк сверху входа и строк снизу. Ширину заполняем аналогично.
Высота и ширина ядер в свёрточных нейронных сетях обычно нечётны, например 1, 3, 5 или 7. Преимущество нечётных размеров в том, что при сохранении пространственных размеров мы можем добавлять одинаковое количество строк сверху и снизу и одинаковое количество столбцов слева и справа.
Кроме того, нечётные размеры ядра и заполнения удобны и в записи. Для любого двумерного тензора X при выполнении условий:
- размер ядра нечётный;
- число строк и столбцов заполнения одинаково с каждой стороны;
- выход имеет ту же высоту и ширину, что и вход;
можно утверждать: выход Y[i, j] получается взаимной корреляцией ядра с окрестностью входа X, центр которой находится в X[i, j].
Например, в примере ниже мы создаём двумерный свёрточный слой с высотой и шириной и добавляем по 1 пикселю заполнения со всех сторон. При входе высотой и шириной выход тоже имеет высоту и ширину .
MXNet:
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
# Для удобства определим функцию, которая вычисляет свёрточный слой.
# Эта функция инициализирует веса свёрточного слоя и добавляет или убирает
# нужные размерности у входа и выхода
def comp_conv2d(conv2d, X):
conv2d.initialize()
# Здесь (1, 1) означает, что размер батча и количество каналов равны 1
X = X.reshape((1, 1) + X.shape)
Y = conv2d(X)
# Опускаем первые два измерения: размер батча и каналы
return Y.reshape(Y.shape[2:])
# Обратите внимание: с каждой стороны добавлена 1 строка или столбец,
# поэтому всего добавлено 2 строки или 2 столбца
conv2d = nn.Conv2D(1, kernel_size=3, padding=1)
X = np.random.uniform(size=(8, 8))
comp_conv2d(conv2d, X).shape
PyTorch:
import torch
from torch import nn
# Для удобства определим функцию, которая вычисляет свёрточный слой.
# Эта функция инициализирует веса свёрточного слоя и добавляет или убирает
# нужные размерности у входа и выхода
def comp_conv2d(conv2d, X):
# Здесь (1, 1) означает, что размер батча и количество каналов равны 1
X = X.reshape((1, 1) + X.shape)
Y = conv2d(X)
# Опускаем первые два измерения: размер батча и каналы
return Y.reshape(Y.shape[2:])
# Обратите внимание: с каждой стороны добавлена 1 строка или столбец,
# поэтому всего добавлено 2 строки или 2 столбца
conv2d = nn.Conv2d(1, 1, kernel_size=3, padding=1)
X = torch.rand(size=(8, 8))
comp_conv2d(conv2d, X).shape
TensorFlow:
import tensorflow as tf
# Для удобства определим функцию, которая вычисляет свёрточный слой.
# Эта функция инициализирует веса свёрточного слоя и добавляет или убирает
# нужные размерности у входа и выхода
def comp_conv2d(conv2d, X):
# Здесь (1, 1) означает, что размер батча и количество каналов равны 1
X = tf.reshape(X, (1, ) + X.shape + (1, ))
Y = conv2d(X)
# Опускаем первые два измерения: размер батча и каналы
return tf.reshape(Y, Y.shape[1:3])
# Обратите внимание: с каждой стороны добавлена 1 строка или столбец,
# поэтому всего добавлено 2 строки или 2 столбца
conv2d = tf.keras.layers.Conv2D(1, kernel_size=3, padding='same')
X = tf.random.uniform(shape=(8, 8))
comp_conv2d(conv2d, X).shape
PaddlePaddle:
import warnings
warnings.filterwarnings(action='ignore')
import paddle
from paddle import nn
# Для удобства определим функцию, которая вычисляет свёрточный слой.
# Эта функция инициализирует веса свёрточного слоя и добавляет или убирает
# нужные размерности у входа и выхода
def comp_conv2d(conv2d, X):
# Здесь (1, 1) означает, что размер батча и количество каналов равны 1
X = paddle.reshape(X, [1, 1] + X.shape)
Y = conv2d(X)
return Y.reshape(Y.shape[2:]) # Отбрасываем ненужные первые два измерения: батч и каналы
# Обратите внимание: с каждой стороны добавлена 1 строка или столбец,
# поэтому всего добавлено 2 строки или 2 столбца
conv2d = nn.Conv2D(in_channels=1, out_channels=1, kernel_size=3, padding=1)
X = paddle.rand((8, 8))
comp_conv2d(conv2d, X).shape
Если высота и ширина ядра различаются, мы можем заполнять по высоте и ширине по-разному, чтобы выход и вход имели одинаковые высоту и ширину. В следующем примере используется ядро высотой и шириной ; заполнение по высоте равно , по ширине — .
MXNet:
conv2d = nn.Conv2D(1, kernel_size=(5, 3), padding=(2, 1))
comp_conv2d(conv2d, X).shape
PyTorch:
conv2d = nn.Conv2d(1, 1, kernel_size=(5, 3), padding=(2, 1))
comp_conv2d(conv2d, X).shape
TensorFlow:
conv2d = tf.keras.layers.Conv2D(1, kernel_size=(5, 3), padding='same')
comp_conv2d(conv2d, X).shape
PaddlePaddle:
conv2d = nn.Conv2D(in_channels=1, out_channels=1, kernel_size=(5, 3), padding=(2, 1))
comp_conv2d(conv2d, X).shape
6.3.2 Шаг
При вычислении взаимной корреляции окно свёртки начинает движение из левого верхнего угла входного тензора и сдвигается вниз и вправо. В предыдущих примерах мы по умолчанию сдвигали окно на один элемент за раз. Однако иногда ради эффективности вычислений или для уменьшения числа выборок окно может пропускать промежуточные положения и сдвигаться сразу на несколько элементов.
Количество элементов, на которое окно сдвигается за один шаг, называют шагом (stride). До сих пор мы использовали шаг по высоте и ширине, равный . Как же устроен шаг больше единицы? На рис. 6.3.2 показана двумерная взаимная корреляция с вертикальным шагом и горизонтальным шагом . Затенённая часть — выходные элементы, а также элементы входного и ядерного тензоров, используемые для их вычисления: и .
Видно, что для вычисления второго элемента первого столбца выхода окно свёртки сдвигается вниз на три строки, а для второго элемента первой строки — вправо на два столбца. Когда же окно продолжает сдвигаться вправо ещё на два столбца, выхода нет: входные элементы не могут заполнить окно (если только мы не добавим ещё один столбец заполнения).
Рис. 6.3.2. Двумерная взаимная корреляция с вертикальным шагом и горизонтальным шагом
В общем случае при вертикальном шаге и горизонтальном шаге форма выхода равна
Если задать и , форма выхода упрощается до . Более того, если высота и ширина входа делятся на вертикальный и горизонтальный шаги, форма выхода равна .
Теперь зададим шаг по высоте и ширине равным 2, что уменьшит высоту и ширину входа вдвое.
MXNet:
conv2d = nn.Conv2D(1, kernel_size=3, padding=1, strides=2)
comp_conv2d(conv2d, X).shape
PyTorch:
conv2d = nn.Conv2d(1, 1, kernel_size=3, padding=1, stride=2)
comp_conv2d(conv2d, X).shape
TensorFlow:
conv2d = tf.keras.layers.Conv2D(1, kernel_size=3, padding='same', strides=2)
comp_conv2d(conv2d, X).shape
PaddlePaddle:
conv2d = nn.Conv2D(1, 1, kernel_size=3, padding=1, stride=2)
comp_conv2d(conv2d, X).shape
Теперь рассмотрим чуть более сложный пример.
MXNet:
conv2d = nn.Conv2D(1, kernel_size=(3, 5), padding=(0, 1), strides=(3, 4))
comp_conv2d(conv2d, X).shape
PyTorch:
conv2d = nn.Conv2d(1, 1, kernel_size=(3, 5), padding=(0, 1), stride=(3, 4))
comp_conv2d(conv2d, X).shape
TensorFlow:
conv2d = tf.keras.layers.Conv2D(1, kernel_size=(3,5), padding='valid',
strides=(3, 4))
comp_conv2d(conv2d, X).shape
PaddlePaddle:
conv2d = nn.Conv2D(1, 1, kernel_size=(3, 5), padding=(0, 1), stride=(3, 4))
comp_conv2d(conv2d, X).shape
Для краткости, если число заполняемых строк и столбцов по высоте и ширине входа равно и соответственно, будем называть это заполнением . При заполнение равно . Аналогично, если шаги по высоте и ширине равны и , будем говорить о шаге . В частном случае шаг равен . По умолчанию заполнение равно 0, а шаг равен 1. На практике мы редко используем несогласованные шаги или заполнение, то есть обычно и .
Резюме
- Заполнение увеличивает высоту и ширину выхода. Его часто используют, чтобы выход имел ту же высоту и ширину, что и вход.
- Шаг уменьшает высоту и ширину выхода; например, высота и ширина выхода составляют лишь от высоты и ширины входа ( — целое число больше ).
- Заполнение и шаг можно использовать для эффективной настройки размерности данных.
Упражнения
- Для последнего примера этого раздела вычислите форму выхода и проверьте, совпадает ли она с результатом эксперимента.
- В экспериментах этого раздела попробуйте другие комбинации заполнения и шага.
- Что означает шаг для аудиосигнала?
- В чём вычислительное преимущество шага больше ?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
6.4 Многоканальные входы и выходы
В разделе 6.1.4.1 мы говорили о том, что каждое изображение состоит из нескольких каналов и что свёрточных слоёв может быть много. Например, цветное изображение имеет стандартные RGB-каналы — красный, зелёный и синий. Однако до сих пор мы рассматривали лишь упрощённый пример с одним входным и одним выходным каналом. Это позволяло считать вход, ядро и выход двумерными тензорами.
Когда мы добавляем каналы, и входы, и скрытые представления становятся трёхмерными тензорами. Например, каждое входное RGB-изображение имеет форму . Ось размером мы называем измерением канала (channel). В этом разделе мы подробнее рассмотрим ядра с несколькими входными и выходными каналами.
6.4.1 Несколько входных каналов
Когда вход содержит несколько каналов, нужно построить ядро с таким же числом входных каналов, как у входных данных, чтобы выполнять взаимную корреляцию. Пусть число входных каналов равно ; тогда у ядра тоже должно быть входных каналов. Если форма окна ядра равна , то при ядро можно считать двумерным тензором формы .
Однако при каждый входной канал ядра содержит тензор формы . Если объединить таких тензоров, получим ядро формы . Поскольку и вход, и ядро имеют по каналов, мы можем выполнить двумерную взаимную корреляцию двумерного тензора каждого входного канала с двумерным тензором соответствующего канала ядра, а затем просуммировать результаты по каналам (складываем результатов), получив один двумерный тензор. Это и есть результат двумерной взаимной корреляции для многоканального входа и ядра с несколькими входными каналами.
На рис. 6.4.1 показан пример двумерной взаимной корреляции с двумя входными каналами. Затенённая часть — первый элемент выхода, а также элементы входа и ядра, используемые для его вычисления: .
Рис. 6.4.1. Взаимная корреляция для двух входных каналов
Чтобы лучше понять эту операцию, реализуем многоканальную взаимную корреляцию. Коротко говоря, мы выполняем взаимную корреляцию для каждого канала и затем складываем результаты.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
MXNet, PyTorch, PaddlePaddle:
def corr2d_multi_in(X, K):
# Перебираем нулевое измерение «X» и «K» (измерение каналов), затем складываем результаты
return sum(d2l.corr2d(x, k) for x, k in zip(X, K))
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
def corr2d_multi_in(X, K):
# Перебираем нулевое измерение «X» и «K» (измерение каналов), затем складываем результаты
return tf.reduce_sum([d2l.corr2d(x, k) for x, k in zip(X, K)], axis=0)
Построим входной тензор X и ядерный тензор K, соответствующие значениям с рис. 6.4.1, и проверим результат взаимной корреляции.
X = d2l.tensor([[[0.0, 1.0, 2.0], [3.0, 4.0, 5.0], [6.0, 7.0, 8.0]],
[[1.0, 2.0, 3.0], [4.0, 5.0, 6.0], [7.0, 8.0, 9.0]]])
K = d2l.tensor([[[0.0, 1.0], [2.0, 3.0]], [[1.0, 2.0], [3.0, 4.0]]])
corr2d_multi_in(X, K)
6.4.2 Несколько выходных каналов
До сих пор, сколько бы входных каналов ни было, выходной канал у нас был один. Однако, как мы обсуждали в разделе 6.1.4.1, на каждом слое необходимо несколько выходных каналов. В самых популярных архитектурах нейронных сетей по мере углубления сети число выходных каналов часто увеличивают, одновременно уменьшая пространственное разрешение, чтобы получить большую глубину по каналам. Интуитивно можно считать каждый канал откликом на определённый признак. Реальность, впрочем, сложнее: каналы не обучаются независимо, а оптимизируются для совместного использования. Поэтому несколько выходных каналов — это не просто обучение нескольких одноканальных детекторов.
Обозначим число входных и выходных каналов через и , а высоту и ширину ядра — через и . Чтобы получить выход с несколькими каналами, для каждого выходного канала создадим ядерный тензор формы ; таким образом, ядро имеет форму . При взаимной корреляции каждый выходной канал сначала получает все входные каналы, а затем результат вычисляется с помощью ядра, соответствующего этому выходному каналу.
Ниже реализуем функцию взаимной корреляции, вычисляющую выход с несколькими каналами.
def corr2d_multi_in_out(X, K):
# Перебираем нулевое измерение «K» и для каждого ядра выполняем взаимную корреляцию с входом «X».
# Затем объединяем все результаты в один тензор
return d2l.stack([corr2d_multi_in(X, k) for k in K], 0)
Соединив ядерный тензор K с K+1 (каждый элемент K увеличен на ) и K+2, построим ядро с выходными каналами.
K = d2l.stack((K, K + 1, K + 2), 0)
K.shape
Теперь выполним взаимную корреляцию входного тензора X и ядерного тензора K. Выход теперь содержит канала; результат первого канала совпадает с ранее полученным результатом для входа X с несколькими входными и одним выходным каналом.
corr2d_multi_in_out(X, K)
6.4.3 Свёрточные слои
Свёртка , то есть при , на первый взгляд кажется бессмысленной. Ведь суть свёртки — эффективно выделять корреляции между соседними пикселями, а свёртка этим явно не занимается. Тем не менее она очень популярна и часто входит в проекты сложных глубоких сетей. Разберём подробнее, какую роль она играет.
Поскольку окно минимально, свёртка утрачивает присущую свёрточным слоям способность выявлять взаимодействие соседних элементов по высоте и ширине. Фактически все вычисления свёртки происходят по каналам.
На рис. 6.4.2 показана взаимная корреляция с ядром при входных и выходных каналах. Здесь вход и выход имеют одинаковые высоту и ширину, а каждый элемент выхода — линейная комбинация элементов входа в той же позиции. Свёрточный слой можно рассматривать как полносвязный слой, применяемый в каждой позиции пикселя, который преобразует входных значений в выходных. Поскольку это по-прежнему свёрточный слой, веса одинаковы для всех пикселей. При этом свёрточный слой требует весов размерности и, кроме того, смещения.
Рис. 6.4.2. Взаимная корреляция с ядром при 3 входных и 2 выходных каналах. Вход и выход имеют одинаковые высоту и ширину
Теперь реализуем свёртку с помощью полносвязного слоя. Обратите внимание, что нам нужно изменить форму входных и выходных данных.
def corr2d_multi_in_out_1x1(X, K):
c_i, h, w = X.shape
c_o = K.shape[0]
X = d2l.reshape(X, (c_i, h * w))
K = d2l.reshape(K, (c_o, c_i))
# Матричное умножение, как в полносвязном слое
Y = d2l.matmul(K, X)
return d2l.reshape(Y, (c_o, h, w))
При выполнении свёртки приведённая функция эквивалентна ранее реализованной функции взаимной корреляции corr2d_multi_in_out. Проверим это на примере данных.
MXNet, PyTorch, PaddlePaddle:
X = d2l.normal(0, 1, (3, 3, 3))
K = d2l.normal(0, 1, (2, 3, 1, 1))
TensorFlow:
X = d2l.normal((3, 3, 3), 0, 1)
K = d2l.normal((2, 3, 1, 1), 0, 1)
Y1 = corr2d_multi_in_out_1x1(X, K)
Y2 = corr2d_multi_in_out(X, K)
assert float(d2l.reduce_sum(d2l.abs(Y1 - Y2))) < 1e-6
Резюме
- Несколько входных и выходных каналов позволяют расширять модель свёрточного слоя.
- При применении к каждому пикселю свёрточный слой эквивалентен полносвязному слою.
- Свёрточные слои обычно используют, чтобы менять число каналов в слое сети и управлять сложностью модели.
Упражнения
- Предположим, что у нас есть две свёрточные операции с ядрами размеров и (без нелинейной функции активации между ними).
- Докажите, что эти операции можно представить одной свёрткой.
- Какова размерность эквивалентного одного ядра?
- А верно ли обратное?
- Пусть вход имеет форму , ядро — , заполнение — , шаг — .
- Каковы вычислительные затраты прямого распространения (умножения и сложения)?
- Каков объём занимаемой памяти?
- Каков объём памяти при обратном распространении?
- Каковы вычислительные затраты обратного распространения?
- Если удвоить число входных и выходных каналов, насколько вырастет число вычислений? А что, если удвоить заполнение?
- Если высота и ширина ядра равны , какова вычислительная сложность прямого распространения?
- Совпадают ли полностью переменные
Y1иY2из последнего примера этого раздела? Почему? - Как реализовать свёртку через матричное умножение, если окно свёртки не ?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
6.5 Слои пулинга
Обычно при обработке изображений мы хотим постепенно уменьшать пространственное разрешение скрытых представлений и агрегировать информацию. Тогда по мере подъёма по слоям нейронной сети рецептивное поле (область входа), к которой чувствителен каждый нейрон, становится всё больше.
Задачи машинного обучения часто связаны с глобальным содержимым изображения (например, «есть ли на изображении кот?»), поэтому нейроны последнего слоя должны быть чувствительны ко всему входу. Постепенно агрегируя информацию и получая всё более грубые карты, мы в итоге приходим к глобальному представлению, сохраняя при этом все преимущества свёрточных слоёв на промежуточных уровнях.
Кроме того, при обнаружении низкоуровневых признаков (например, границ из раздела 6.2) мы обычно хотим, чтобы эти признаки сохраняли некоторую степень инвариантности к сдвигу. Например, если мы возьмём чёрно-белое изображение X с чёткими контурами и сдвинем всё изображение на один пиксель вправо, то есть Z[i, j] = X[i, j + 1], то выход для нового изображения Z может сильно отличаться. На практике же при смене ракурса съёмки положение объектов почти никогда не совпадает в точности по пикселям. Даже при съёмке неподвижного объекта со штатива вибрация камеры из-за движения затвора может сдвинуть все объекты влево или вправо на один пиксель (кроме дорогих камер, в которых есть специальные средства против этого).
В этом разделе мы рассмотрим слои пулинга (pooling), которые решают две задачи: снижают чувствительность свёрточного слоя к положению и уменьшают чувствительность к пространственному понижению разрешения представления.
6.5.1 Максимальный и средний пулинг
Как и свёрточный слой, оператор пулинга состоит из окна фиксированной формы, которое скользит по всем областям входа с заданным шагом, и для каждой позиции, пройденной окном (его иногда называют окном пулинга), вычисляет выход. Однако в отличие от взаимной корреляции входа и ядра в свёрточном слое слой пулинга не содержит параметров. Вместо этого операция пулинга детерминирована: обычно мы вычисляем максимум или среднее всех элементов в окне пулинга. Эти операции называют слоем максимального пулинга (maximum pooling) и слоем среднего пулинга (average pooling) соответственно.
В обоих случаях, как и при взаимной корреляции, окно пулинга начинает движение из левого верхнего угла входного тензора и скользит слева направо и сверху вниз. В каждой позиции окна вычисляется максимум или среднее входного подтензора внутри окна — в зависимости от того, используется ли максимальный или средний пулинг.
Рис. 6.5.1. Максимальный пулинг с окном . Затенённая часть — первый элемент выхода и элементы входа, используемые для его вычисления:
Выходной тензор на рис. 6.5.1 имеет высоту и ширину . Четыре его элемента — максимумы в каждом окне пулинга:
Слой пулинга с окном формы называют слоем пулинга , а саму операцию — пулингом .
Вернёмся к примеру с обнаружением границ объектов из начала этого раздела: теперь используем выход свёрточного слоя как вход для максимального пулинга . Пусть вход свёрточного слоя — X, а выход пулинга — Y. Независимо от того, равны ли X[i, j] и X[i, j + 1] или X[i, j + 1] и X[i, j + 2], слой пулинга всегда выдаёт Y[i, j] = 1. То есть при максимальном пулинге свёрточный слой по-прежнему распознаёт нужный шаблон, даже если он сдвинут на один элемент по высоте или ширине.
В приведённом ниже коде функция pool2d реализует прямое распространение слоя пулинга. Она похожа на функцию corr2d из раздела 6.2. Однако здесь у нас нет ядра, а выход — это максимум или среднее значение в каждой области входа.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
MXNet, PyTorch, PaddlePaddle:
def pool2d(X, pool_size, mode='max'):
p_h, p_w = pool_size
Y = d2l.zeros((X.shape[0] - p_h + 1, X.shape[1] - p_w + 1))
for i in range(Y.shape[0]):
for j in range(Y.shape[1]):
if mode == 'max':
Y[i, j] = X[i: i + p_h, j: j + p_w].max()
elif mode == 'avg':
Y[i, j] = X[i: i + p_h, j: j + p_w].mean()
return Y
TensorFlow:
import tensorflow as tf
def pool2d(X, pool_size, mode='max'):
p_h, p_w = pool_size
Y = tf.Variable(tf.zeros((X.shape[0] - p_h + 1, X.shape[1] - p_w +1)))
for i in range(Y.shape[0]):
for j in range(Y.shape[1]):
if mode == 'max':
Y[i, j].assign(tf.reduce_max(X[i: i + p_h, j: j + p_w]))
elif mode =='avg':
Y[i, j].assign(tf.reduce_mean(X[i: i + p_h, j: j + p_w]))
return Y
Построим входной тензор X из рис. 6.5.1 и проверим выход двумерного максимального пулинга.
X = d2l.tensor([[0.0, 1.0, 2.0], [3.0, 4.0, 5.0], [6.0, 7.0, 8.0]])
pool2d(X, (2, 2))
Кроме того, проверим средний пулинг.
pool2d(X, (2, 2), 'avg')
6.5.2 Заполнение и шаг
Как и свёрточный слой, слой пулинга может менять форму выхода. Как и раньше, мы можем использовать заполнение и шаг, чтобы получить нужную форму выхода. Ниже мы используем встроенный в фреймворк двумерный слой максимального пулинга, чтобы показать работу заполнения и шага в пулинге. Сначала построим входной тензор X с четырьмя измерениями, где число примеров и число каналов равны 1.
TensorFlow: обратите внимание, что TensorFlow использует синтаксис «канал последним» (channels-last) и оптимизирован под него: в TensorFlow последнее измерение входа — это канал.
MXNet, PyTorch:
X = d2l.reshape(d2l.arange(16, dtype=d2l.float32), (1, 1, 4, 4))
X
TensorFlow:
X = d2l.reshape(d2l.arange(16, dtype=d2l.float32), (1, 4, 4, 1))
X
PaddlePaddle:
X = paddle.arange(16, dtype="float32").reshape((1, 1, 4, 4))
X
По умолчанию шаг в фреймворках совпадает с размером окна пулинга. Поэтому если мы используем окно формы (3, 3), то по умолчанию получаем шаг формы (3, 3).
MXNet:
pool2d = nn.MaxPool2D(3)
# Слой пулинга не содержит параметров, поэтому нет необходимости вызывать функцию инициализации
pool2d(X)
PyTorch:
pool2d = nn.MaxPool2d(3)
pool2d(X)
TensorFlow:
pool2d = tf.keras.layers.MaxPool2D(pool_size=[3, 3])
pool2d(X)
PaddlePaddle:
pool2d = nn.MaxPool2D(3, stride=3)
pool2d(X)
Заполнение и шаг можно задать вручную.
MXNet:
pool2d = nn.MaxPool2D(3, padding=1, strides=2)
pool2d(X)
PyTorch:
pool2d = nn.MaxPool2d(3, padding=1, stride=2)
pool2d(X)
TensorFlow:
paddings = tf.constant([[0, 0], [1,0], [1,0], [0,0]])
X_padded = tf.pad(X, paddings, "CONSTANT")
pool2d = tf.keras.layers.MaxPool2D(pool_size=[3, 3], padding='valid',
strides=2)
pool2d(X_padded)
PaddlePaddle:
pool2d = nn.MaxPool2D(3, padding=1, stride=2)
pool2d(X)
Конечно, мы можем задать прямоугольное окно пулинга произвольного размера и отдельно задать высоту и ширину заполнения и шага.
MXNet:
pool2d = nn.MaxPool2D((2, 3), padding=(0, 1), strides=(2, 3))
pool2d(X)
PyTorch:
pool2d = nn.MaxPool2d((2, 3), stride=(2, 3), padding=(0, 1))
pool2d(X)
TensorFlow:
paddings = tf.constant([[0, 0], [0, 0], [1, 1], [0, 0]])
X_padded = tf.pad(X, paddings, "CONSTANT")
pool2d = tf.keras.layers.MaxPool2D(pool_size=[2, 3], padding='valid',
strides=(2, 3))
pool2d(X_padded)
PaddlePaddle:
pool2d = nn.MaxPool2D((2, 3), padding=(0, 1), stride=(2, 3))
pool2d(X)
6.5.3 Несколько каналов
При обработке многоканальных входных данных слой пулинга работает с каждым входным каналом отдельно, а не суммирует входы по каналам, как свёрточный слой. Это значит, что число выходных каналов слоя пулинга совпадает с числом входных каналов. Ниже объединим тензоры X и X + 1 по измерению каналов, чтобы построить вход с 2 каналами.
TensorFlow: так как в TensorFlow используется синтаксис «канал последним», нам нужно объединять тензоры по последнему измерению входа.
MXNet, PyTorch, PaddlePaddle:
X = d2l.concat((X, X + 1), 1)
X
TensorFlow:
X = tf.concat([X, X + 1], 3)
Как видно ниже, после пулинга число выходных каналов по-прежнему равно 2.
MXNet:
pool2d = nn.MaxPool2D(3, padding=1, strides=2)
pool2d(X)
PyTorch:
pool2d = nn.MaxPool2d(3, padding=1, stride=2)
pool2d(X)
TensorFlow:
paddings = tf.constant([[0, 0], [1,0], [1,0], [0,0]])
X_padded = tf.pad(X, paddings, "CONSTANT")
pool2d = tf.keras.layers.MaxPool2D(pool_size=[3, 3], padding='valid',
strides=2)
pool2d(X_padded)
PaddlePaddle:
pool2d = paddle.nn.MaxPool2D(3, padding=1, stride=2)
pool2d(X)
TensorFlow: результат выше на первый взгляд выглядит иначе, но выходы MXNet и PyTorch численно совпадают. Различие только в размерностях: если читать выход по вертикали, он даёт тот же результат, что и в других реализациях.
Резюме
- Для заданного входного элемента максимальный пулинг возвращает максимум в своём окне, а средний пулинг — среднее значение в окне.
- Одно из главных преимуществ слоя пулинга — уменьшение чрезмерной чувствительности свёрточного слоя к положению.
- Для слоя пулинга можно задать заполнение и шаг.
- Использование максимального пулинга с шагом больше 1 позволяет уменьшить пространственные размерности (высоту и ширину).
- Число выходных каналов слоя пулинга совпадает с числом входных каналов.
Упражнения
- Попробуйте реализовать средний пулинг как частный случай свёрточного слоя.
- Попробуйте реализовать максимальный пулинг как частный случай свёрточного слоя.
- Пусть вход слоя пулинга имеет размер , окно пулинга — , заполнение — , шаг — . Каковы вычислительные затраты этого слоя пулинга?
- Почему максимальный и средний пулинг работают по-разному?
- Нужен ли нам минимальный пулинг? Можно ли заменить его известной функцией?
- Помимо среднего и максимального пулинга, есть ли другие функции, которые стоит рассмотреть (подсказка: вспомните
softmax)? Почему они не получили распространения?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
6.6 Свёрточные нейронные сети (LeNet)
В предыдущих разделах мы изучили все компоненты, необходимые для построения полноценной свёрточной нейронной сети. Вспомним, что ранее мы применяли модель softmax-регрессии (раздел 3.6) и многослойный перцептрон (раздел 4.2) к изображениям одежды из набора Fashion-MNIST. Чтобы использовать softmax-регрессию и многослойный перцептрон, мы сначала разворачивали каждое изображение размером в одномерный вектор фиксированной длины из 784 элементов, а затем обрабатывали его полносвязными слоями. Теперь же, когда мы освоили свёрточные слои, мы можем сохранить пространственную структуру изображения. Кроме того, замена полносвязных слоёв свёрточными даёт ещё одно преимущество: модель становится проще и требует меньше параметров.
В этом разделе мы рассмотрим LeNet — одну из первых опубликованных свёрточных нейронных сетей, которая привлекла большое внимание благодаря высокой эффективности в задачах компьютерного зрения. Модель была предложена в 1989 году Яном Лекуном (Yann LeCun), исследователем из лабораторий AT&T Bell, в честь которого она и названа. Её целью было распознавание рукописных цифр на изображениях (LeCun et al., 1998). Тогда Лекун опубликовал первую работу, в которой свёрточная нейронная сеть была успешно обучена методом обратного распространения ошибки; эта работа стала итогом более чем десятилетия развития нейронных сетей.
В то время LeNet показывала результаты, сравнимые с результатами метода опорных векторов (support vector machines), и стала одним из ведущих методов обучения с учителем. LeNet широко применялась в банкоматах (ATM) для распознавания цифр на чеках. И даже сегодня некоторые банкоматы работают с кодом, который Ян Лекун и его коллега Леон Ботту написали в 1990-х годах!
6.6.1 LeNet
В целом LeNet (LeNet-5) состоит из двух частей:
- свёрточный кодировщик: состоит из двух свёрточных слоёв;
- блок полносвязных слоёв: состоит из трёх полносвязных слоёв.
Архитектура показана на рис. 6.6.1.
Рис. 6.6.1. Поток данных в LeNet. На входе — рукописная цифра, на выходе — вероятности 10 возможных результатов
Базовый элемент каждого свёрточного блока — свёрточный слой, функция активации sigmoid и слой среднего пулинга. Заметьте: хотя ReLU и максимальный пулинг работают эффективнее, в 1990-х годах их ещё не было. Каждый свёрточный слой использует ядро и активацию sigmoid. Эти слои отображают вход в несколько двумерных карт признаков, обычно одновременно увеличивая число каналов. Первый свёрточный слой имеет 6 выходных каналов, второй — 16. Каждая операция пулинга (шаг 2) за счёт пространственного понижения разрешения уменьшает размерность в 4 раза. Форма выхода свёртки определяется размером батча, числом каналов, высотой и шириной.
Чтобы передать выход свёрточных блоков в блок полносвязных слоёв, нужно развернуть каждый пример в минибатче. Иными словами, мы преобразуем четырёхмерный вход в двумерный, который ожидают полносвязные слои. Первое измерение этого двумерного представления индексирует примеры в минибатче, а второе задаёт плоский векторный вид каждого примера. Блок полносвязных слоёв LeNet содержит три полносвязных слоя с 120, 84 и 10 выходами. Поскольку мы решаем задачу классификации, 10-мерный выход соответствует числу результатов классификации.
Из приведённого ниже кода LeNet видно, что реализовать такую модель во фреймворке глубокого обучения очень просто: достаточно создать блок Sequential и соединить в нём нужные слои.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, gluon, init, np, npx
from mxnet.gluon import nn
npx.set_np()
net = nn.Sequential()
net.add(nn.Conv2D(channels=6, kernel_size=5, padding=2, activation='sigmoid'),
nn.AvgPool2D(pool_size=2, strides=2),
nn.Conv2D(channels=16, kernel_size=5, activation='sigmoid'),
nn.AvgPool2D(pool_size=2, strides=2),
# По умолчанию «Dense» автоматически преобразует вход формы
# (размер батча, количество каналов, высота, ширина) во вход формы
# (размер батча, количество каналов × высота × ширина)
nn.Dense(120, activation='sigmoid'),
nn.Dense(84, activation='sigmoid'),
nn.Dense(10))
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
net = nn.Sequential(
nn.Conv2d(1, 6, kernel_size=5, padding=2), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2),
nn.Conv2d(6, 16, kernel_size=5), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2),
nn.Flatten(),
nn.Linear(16 * 5 * 5, 120), nn.Sigmoid(),
nn.Linear(120, 84), nn.Sigmoid(),
nn.Linear(84, 10))
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
def net():
return tf.keras.models.Sequential([
tf.keras.layers.Conv2D(filters=6, kernel_size=5, activation='sigmoid',
padding='same'),
tf.keras.layers.AvgPool2D(pool_size=2, strides=2),
tf.keras.layers.Conv2D(filters=16, kernel_size=5,
activation='sigmoid'),
tf.keras.layers.AvgPool2D(pool_size=2, strides=2),
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(120, activation='sigmoid'),
tf.keras.layers.Dense(84, activation='sigmoid'),
tf.keras.layers.Dense(10)])
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn, optimizer
net = nn.Sequential(
nn.Conv2D(1, 6, kernel_size=5, padding=2), nn.Sigmoid(),
nn.AvgPool2D(kernel_size=2, stride=2),
nn.Conv2D(6, 16, kernel_size=5), nn.Sigmoid(),
nn.AvgPool2D(kernel_size=2, stride=2),
nn.Flatten(),
nn.Linear(16 * 5 * 5, 120), nn.Sigmoid(),
nn.Linear(120, 84), nn.Sigmoid(),
nn.Linear(84, 10))
Мы внесли небольшое изменение в исходную модель: убрали гауссову активацию последнего слоя. В остальном эта сеть совпадает с исходной LeNet-5.
Теперь пропустим через LeNet одноканальное (чёрно-белое) изображение размером . Печатая форму выхода каждого слоя, мы можем проверить модель и убедиться, что она работает так, как мы ожидаем, — см. рис. 6.6.2.
Рис. 6.6.2. Упрощённая схема LeNet
MXNet:
X = np.random.uniform(size=(1, 1, 28, 28))
net.initialize()
for layer in net:
X = layer(X)
print(layer.name, 'форма выхода:\t', X.shape)
PyTorch:
X = torch.rand(size=(1, 1, 28, 28), dtype=torch.float32)
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'форма выхода: \t',X.shape)
TensorFlow:
X = tf.random.uniform((1, 28, 28, 1))
for layer in net().layers:
X = layer(X)
print(layer.__class__.__name__, 'форма выхода: \t', X.shape)
PaddlePaddle:
X = paddle.rand((1, 1, 28, 28), 'float32')
for layer in net:
X = layer(X)
print(layer.__class__.__name__, 'форма выхода: \t', X.shape)
Обратите внимание: во всём свёрточном блоке высота и ширина признаков уменьшаются по сравнению с предыдущим слоем. Первый свёрточный слой использует заполнение в 2 пикселя, чтобы компенсировать уменьшение признаков из-за ядра . Второй же свёрточный слой заполнения не имеет, поэтому его высота и ширина уменьшаются на 4 пикселя. По мере подъёма по слоям число каналов растёт: с 1 на входе до 6 после первого свёрточного слоя и до 16 после второго. Одновременно высота и ширина каждого слоя пулинга уменьшаются вдвое. Наконец, каждый полносвязный слой уменьшает размерность, и в итоге получается выход, размерность которого совпадает с числом классов.
6.6.2 Обучение модели
Теперь, когда LeNet реализована, посмотрим, как LeNet показывает себя на наборе данных Fashion-MNIST.
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size=batch_size)
Хотя у свёрточных сетей параметров немного, их вычислительная стоимость всё равно высока по сравнению с глубокими многослойными перцептронами, поскольку каждый параметр участвует в большем числе умножений. Ускорить обучение можно с помощью GPU.
MXNet, PyTorch: для оценки нам нужно немного изменить функцию evaluate_accuracy из раздела 3.6. Поскольку весь набор данных находится в оперативной памяти, перед вычислениями на GPU его нужно скопировать в память GPU.
MXNet:
def evaluate_accuracy_gpu(net, data_iter, device=None): #@save
"""Вычисляет точность модели на наборе данных с помощью GPU"""
if not device: # Определяем устройство, на котором находится первый параметр
device = list(net.collect_params().values())[0].list_ctx()[0]
metric = d2l.Accumulator(2) # Количество верных предсказаний, общее количество предсказаний
for X, y in data_iter:
X, y = X.as_in_ctx(device), y.as_in_ctx(device)
metric.add(d2l.accuracy(net(X), y), d2l.size(y))
return metric[0] / metric[1]
PyTorch:
def evaluate_accuracy_gpu(net, data_iter, device=None): #@save
"""Вычисляет точность модели на наборе данных с помощью GPU"""
if isinstance(net, nn.Module):
net.eval() # Переводим модель в режим оценки
if not device:
device = next(iter(net.parameters())).device
# Количество верных предсказаний, общее количество предсказаний
metric = d2l.Accumulator(2)
with torch.no_grad():
for X, y in data_iter:
if isinstance(X, list):
# Нужно для дообучения BERT (будет рассмотрено позже)
X = [x.to(device) for x in X]
else:
X = X.to(device)
y = y.to(device)
metric.add(d2l.accuracy(net(X), y), d2l.size(y))
return metric[0] / metric[1]
PaddlePaddle:
def evaluate_accuracy_gpu(net, data_iter, device=None): #@save
"""Вычисляет точность модели на наборе данных с помощью GPU"""
if isinstance(net, nn.Layer):
net.eval() # Переводим модель в режим оценки
if not device:
device = next(iter(net.parameters())).place
paddle.set_device("gpu:{}".format(str(device)[-2]))
# Количество верных предсказаний, общее количество предсказаний
metric = d2l.Accumulator(2)
with paddle.no_grad():
for X, y in data_iter:
if isinstance(X, list):
# Нужно для дообучения BERT
X = [paddle.to_tensor(x, place=device) for x in X]
else:
X = paddle.to_tensor(X, place=device)
y = paddle.to_tensor(y, place=device)
metric.add(d2l.accuracy(net(X), y), d2l.size(y))
return metric[0] / metric[1]
Для использования GPU нужна небольшая доработка. В отличие от функции train_epoch_ch3, определённой в разделе 3.6, перед прямым и обратным распространением каждый минибатч нужно переместить на заданное устройство (например, GPU).
Как показано ниже, функция обучения train_ch6 похожа на train_ch3 из раздела 3.6. Поскольку мы реализуем многослойную нейронную сеть, мы в основном будем пользоваться высокоуровневым API. Приведённая ниже функция обучения принимает на вход модель, созданную высокоуровневым API, и выполняет соответствующую оптимизацию. Параметры модели мы инициализируем методом Xavier, описанным в разделе 4.8. Как и для полносвязных слоёв, используем функцию потерь кросс-энтропии и минибатчевый стохастический градиентный спуск.
MXNet:
#@save
def train_ch6(net, train_iter, test_iter, num_epochs, lr, device):
"""Обучает модель на GPU (определено в главе 6)"""
net.initialize(force_reinit=True, ctx=device, init=init.Xavier())
loss = gluon.loss.SoftmaxCrossEntropyLoss()
trainer = gluon.Trainer(net.collect_params(),
'sgd', {'learning_rate': lr})
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=['потери (обучение)', 'точность (обучение)',
'точность (тест)'])
timer, num_batches = d2l.Timer(), len(train_iter)
for epoch in range(num_epochs):
metric = d2l.Accumulator(3) # Сумма потерь на обучении, сумма точности, количество примеров
for i, (X, y) in enumerate(train_iter):
timer.start()
# Ниже — основное отличие от «d2l.train_epoch_ch3»
X, y = X.as_in_ctx(device), y.as_in_ctx(device)
with autograd.record():
y_hat = net(X)
l = loss(y_hat, y)
l.backward()
trainer.step(X.shape[0])
metric.add(l.sum(), d2l.accuracy(y_hat, y), X.shape[0])
timer.stop()
train_l = metric[0] / metric[2]
train_acc = metric[1] / metric[2]
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(train_l, train_acc, None))
test_acc = evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch + 1, (None, None, test_acc))
print(f'потери {train_l:.3f}, точность на обучении {train_acc:.3f}, '
f'точность на тесте {test_acc:.3f}')
print(f'{metric[2] * num_epochs / timer.sum():.1f} примеров/с '
f'на {str(device)}')
PyTorch:
#@save
def train_ch6(net, train_iter, test_iter, num_epochs, lr, device):
"""Обучает модель на GPU (определено в главе 6)"""
def init_weights(m):
if type(m) == nn.Linear or type(m) == nn.Conv2d:
nn.init.xavier_uniform_(m.weight)
net.apply(init_weights)
print('обучение на', device)
net.to(device)
optimizer = torch.optim.SGD(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss()
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=['потери (обучение)', 'точность (обучение)',
'точность (тест)'])
timer, num_batches = d2l.Timer(), len(train_iter)
for epoch in range(num_epochs):
# Сумма потерь на обучении, сумма точности, количество примеров
metric = d2l.Accumulator(3)
net.train()
for i, (X, y) in enumerate(train_iter):
timer.start()
optimizer.zero_grad()
X, y = X.to(device), y.to(device)
y_hat = net(X)
l = loss(y_hat, y)
l.backward()
optimizer.step()
with torch.no_grad():
metric.add(l * X.shape[0], d2l.accuracy(y_hat, y), X.shape[0])
timer.stop()
train_l = metric[0] / metric[2]
train_acc = metric[1] / metric[2]
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(train_l, train_acc, None))
test_acc = evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch + 1, (None, None, test_acc))
print(f'потери {train_l:.3f}, точность на обучении {train_acc:.3f}, '
f'точность на тесте {test_acc:.3f}')
print(f'{metric[2] * num_epochs / timer.sum():.1f} примеров/с '
f'на {str(device)}')
TensorFlow:
class TrainCallback(tf.keras.callbacks.Callback): #@save
"""Обратный вызов, который визуализирует ход обучения"""
def __init__(self, net, train_iter, test_iter, num_epochs, device_name):
self.timer = d2l.Timer()
self.animator = d2l.Animator(
xlabel='эпоха', xlim=[1, num_epochs], legend=[
'потери (обучение)', 'точность (обучение)', 'точность (тест)'])
self.net = net
self.train_iter = train_iter
self.test_iter = test_iter
self.num_epochs = num_epochs
self.device_name = device_name
def on_epoch_begin(self, epoch, logs=None):
self.timer.start()
def on_epoch_end(self, epoch, logs):
self.timer.stop()
test_acc = self.net.evaluate(
self.test_iter, verbose=0, return_dict=True)['accuracy']
metrics = (logs['loss'], logs['accuracy'], test_acc)
self.animator.add(epoch + 1, metrics)
if epoch == self.num_epochs - 1:
batch_size = next(iter(self.train_iter))[0].shape[0]
num_examples = batch_size * tf.data.experimental.cardinality(
self.train_iter).numpy()
print(f'потери {metrics[0]:.3f}, точность на обучении {metrics[1]:.3f}, '
f'точность на тесте {metrics[2]:.3f}')
print(f'{num_examples / self.timer.avg():.1f} примеров/с на '
f'{str(self.device_name)}')
#@save
def train_ch6(net_fn, train_iter, test_iter, num_epochs, lr, device):
"""Обучает модель на GPU (определено в главе 6)"""
device_name = device._device_name
strategy = tf.distribute.OneDeviceStrategy(device_name)
with strategy.scope():
optimizer = tf.keras.optimizers.SGD(learning_rate=lr)
loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)
net = net_fn()
net.compile(optimizer=optimizer, loss=loss, metrics=['accuracy'])
callback = TrainCallback(net, train_iter, test_iter, num_epochs,
device_name)
net.fit(train_iter, epochs=num_epochs, verbose=0, callbacks=[callback])
return net
PaddlePaddle:
#@save
def train_ch6(net, train_iter, test_iter, num_epochs, lr, device):
"""Обучает модель на GPU (определено в главе 6)"""
def init_weights(m):
if type(m) == nn.Linear or type(m) == nn.Conv2D:
nn.initializer.XavierUniform(m.weight)
net.apply(init_weights)
print('обучение на', device)
net.to(device)
optimizer = paddle.optimizer.SGD(learning_rate=lr, parameters=net.parameters())
loss = nn.CrossEntropyLoss()
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=['потери (обучение)', 'точность (обучение)',
'точность (тест)'])
timer, num_batches = d2l.Timer(), len(train_iter)
for epoch in range(num_epochs):
# Сумма потерь на обучении, сумма точности, количество примеров
metric = d2l.Accumulator(3)
net.train()
for i, (X, y) in enumerate(train_iter):
timer.start()
optimizer.clear_grad()
X, y = paddle.to_tensor(X, place=device), paddle.to_tensor(y, place=device)
y_hat = net(X)
l = loss(y_hat, y)
l.backward()
optimizer.step()
with paddle.no_grad():
metric.add(l * X.shape[0], d2l.accuracy(y_hat, y), X.shape[0])
timer.stop()
train_l = metric[0] / metric[2]
train_acc = metric[1] / metric[2]
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(train_l, train_acc, None))
test_acc = evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch + 1, (None, None, test_acc))
print(f'потери {train_l:.3f}, точность на обучении {train_acc:.3f}, '
f'точность на тесте {test_acc:.3f}')
print(f'{metric[2] * num_epochs / timer.sum():.1f} примеров/с '
f'на {str(device)}')
Теперь обучим и оценим модель LeNet-5.
lr, num_epochs = 0.9, 10
train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
Резюме
- Свёрточная нейронная сеть (CNN) — это сеть, использующая свёрточные слои.
- В свёрточной нейронной сети свёрточные слои, нелинейные функции активации и слои пулинга комбинируются.
- Чтобы построить высокопроизводительную свёрточную сеть, обычно располагают свёрточные слои так, чтобы постепенно уменьшать пространственное разрешение представления и одновременно увеличивать число каналов.
- В традиционных свёрточных сетях представление, полученное свёрточным блоком, перед выходом обрабатывается одним или несколькими полносвязными слоями.
- LeNet — одна из первых опубликованных свёрточных нейронных сетей.
Упражнения
- Что произойдёт, если заменить средний пулинг на максимальный?
- Попробуйте построить более сложную сеть на основе LeNet, чтобы повысить её точность.
- Измените размер окна свёртки.
- Измените число выходных каналов.
- Измените функцию активации (например, на ReLU).
- Измените число свёрточных слоёв.
- Измените число полносвязных слоёв.
- Подберите скорость обучения и другие детали обучения (например, инициализацию и число эпох).
- Попробуйте улучшенную сеть на наборе данных MNIST.
- Покажите значения активаций первого и второго слоёв LeNet для разных входов (например, свитера и пальто).
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- LeCun, Y., Bottou, L., Bengio, Y., & Haffner, P. (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278–2324.
7. Современные свёрточные нейронные сети
В предыдущей главе мы познакомились с основными принципами свёрточных нейронных сетей. В этой главе речь пойдёт о современных архитектурах свёрточных сетей; многие современные исследования в этой области опираются на её материал.
Каждая модель, рассмотренная в этой главе, в своё время доминировала в своей области, и многие из них становились победителями соревнования ImageNet. С 2010 года это соревнование служит ориентиром для прогресса в обучении с учителем в компьютерном зрении.
Эти модели включают:
- AlexNet. Это первая большая нейронная сеть, которая превзошла традиционные модели компьютерного зрения в крупном визуальном соревновании;
- сети с использованием блоков (VGG). Они строятся из многократно повторяющихся блоков;
- сеть в сети (NiN). Она повторно использует блоки из свёрточных слоёв и свёрточных слоёв (вместо полносвязных слоёв) для построения глубоких сетей;
- сеть с параллельными конкатенациями (GoogLeNet). Она использует параллельно соединённые ветви и извлекает информацию одновременно с помощью свёрточных слоёв разных размеров окна и слоёв максимального пулинга;
- остаточная сеть (ResNet). Она с помощью остаточных блоков создаёт сквозные пути для данных, проходящие через несколько слоёв, и является самой популярной архитектурой в компьютерном зрении;
- плотно связанная сеть (DenseNet). Её вычислительные затраты высоки, но она даёт лучшие результаты.
Идея глубокой нейронной сети очень проста: слои накладываются друг на друга. Однако из-за различий в архитектуре и выборе гиперпараметров производительность таких сетей может сильно меняться. Архитектуры, описанные в этой главе, — результат сочетания человеческой интуиции и математических соображений, а также большого числа экспериментов и проб и ошибок.
Мы будем рассматривать модели в хронологическом порядке. Это поможет проследить историю развития области и выработать интуицию о том, как она движется. Такой подход также помогает разрабатывать собственные архитектуры. Например, пакетная нормализация (batch normalization) и остаточные сети (ResNet), о которых пойдёт речь в этой главе, дают важные идеи для проектирования и обучения глубоких нейронных сетей.
7.1 Глубокие свёрточные нейронные сети (AlexNet)
После появления LeNet свёрточные нейронные сети приобрели известность в компьютерном зрении и машинном обучении. Однако они не стали доминирующим подходом в этих областях. Дело в том, что LeNet хорошо работала на небольших наборах данных, но вопрос о производительности и осуществимости обучения свёрточных сетей на более крупных и реалистичных данных оставался открытым. Фактически с начала 1990-х до 2012 года нейронные сети в основном уступали другим методам машинного обучения, например методу опорных векторов (support vector machines).
В компьютерном зрении сравнивать нейронные сети напрямую с другими методами машинного обучения, пожалуй, некорректно. Входом свёрточной сети служат исходные значения пикселей или значения, прошедшие простую предобработку (например, центрирование и масштабирование). Но когда речь идёт о традиционных методах машинного обучения, никто не подаёт на вход сырые пиксели. В традиционном конвейере компьютерного зрения признаки тщательно конструировались вручную. Для таких методов основной прогресс достигался за счёт более удачных идей о признаках, а сами обученные алгоритмы часто были лишь объяснением уже достигнутого результата.
Хотя в 1990-е годы уже существовали аппаратные ускорители для нейронных сетей, одних только они не хватало, чтобы создать глубокие многоканальные многослойные свёрточные сети с большим числом параметров. Кроме того, наборы данных тогда оставались относительно небольшими. Помимо этих препятствий, в арсенале не хватало ключевых приёмов обучения нейронных сетей: эвристической инициализации параметров, вариантов стохастического градиентного спуска, функций активации без «сжатия» сигнала (non-squashing) и эффективных методов регуляризации.
Поэтому вместо обучения сквозной системы (от пикселей до результата классификации) классический конвейер машинного обучения выглядел примерно так:
- Получить интересный набор данных. На ранних этапах сбор таких наборов требовал дорогих датчиков (лучшие изображения того времени имели около миллиона пикселей).
- На основе оптики, геометрии, других знаний и случайных открытий вручную предобработать набор признаков.
- Извлечь признаки стандартными алгоритмами, такими как SIFT (масштабно-инвариантное преобразование признаков) (Lowe, 2004) и SURF (ускоренные устойчивые признаки) (Bay et al., 2006), или другими вручную настраиваемыми конвейерами.
- Подать извлечённые признаки в любимый классификатор (например, линейную модель или другой метод на основе ядер) и обучить его.
Если поговорить с исследователями машинного обучения, выяснится, что они считают машинное обучение одновременно важным и красивым: элегантные теории доказывают свойства различных моделей. Машинное обучение — быстро развивающаяся, строгая и очень полезная область. Однако разговор с исследователями компьютерного зрения даст совсем другую картину. Они скажут о неудобной истине: двигателем прогресса в их области являются признаки данных, а не алгоритмы обучения. По их мнению, для итоговой точности модели большие или более чистые наборы данных либо чуть лучшее извлечение признаков дают гораздо больший выигрыш, чем любой алгоритм обучения.
7.1.1 Изучение представлений
Другой способ предсказать развитие этой области — посмотреть, как извлекаются признаки изображений. До 2012 года признаки изображений вычислялись вручную. Фактически разработка новой функции признаков, улучшение результатов и публикация статьи были излюбленным занятием исследователей. Доминировали SIFT (Lowe, 2004), SURF (Bay et al., 2006), HOG (гистограммы направленных градиентов) (Dalal and Triggs, 2005), «мешки визуальных слов» (bags of visual words) и подобные методы извлечения признаков.
Другая группа исследователей, в которую входили Ян ЛеКун (Yann LeCun), Джефф Хинтон (Geoff Hinton), Йошуа Бенджио (Yoshua Bengio), Эндрю Ын (Andrew Ng), Амари Сюнъити (Shun’ichi Amari) и Юрген Шмидхубер (Juergen Schmidhuber), придерживалась иного взгляда: признаки сами должны обучаться. Более того, они считали, что при разумной сложности признаки должны строиться из нескольких совместно обучаемых слоёв нейронной сети, каждый из которых имеет обучаемые параметры. В машинном зрении нижние слои могут обнаруживать границы, цвета и текстуры. Так, Алекс Крижевский (Alex Krizhevsky), Илья Суцкевер (Ilya Sutskever) и Джефф Хинтон предложили новый вариант свёрточной нейронной сети — AlexNet, который произвёл сенсацию на соревновании ImageNet в 2012 году. Название AlexNet происходит от имени Алекса Крижевского, первого автора статьи (Krizhevsky et al., 2012).
Интересно, что в нижних слоях сети модель выучивает извлекатели признаков, похожие на традиционные фильтры. Иллюстрация этих признаков из статьи AlexNet (Krizhevsky et al., 2012) в книгу не включена: это рисунок стороннего издания, его можно посмотреть в оригинальной статье.
Верхние слои AlexNet опираются на эти низкоуровневые представления и строят более крупные признаки: глаза, носы, травинки и т. д. Ещё выше слои могут распознавать целые объекты: людей, самолёты, собак или фрисби. Итоговые скрытые нейроны могут выучивать комплексное представление изображения, благодаря которому объекты разных классов легко различать. Долгое время группа упорных исследователей пыталась выучить послойные представления визуальных данных, однако эти попытки долго не давали прорыва. Прорыв в глубоких свёрточных сетях произошёл в 2012 году. Его можно объяснить двумя ключевыми факторами.
7.1.1.1 Недостающий компонент: данные
Глубоким моделям с большим числом признаков нужно много размеченных данных, чтобы заметно превзойти традиционные методы, основанные на выпуклой оптимизации (например, линейные методы и методы на основе ядер).
Однако из-за ограниченной памяти ранних компьютеров и скромных исследовательских бюджетов 1990-х годов большинство работ опиралось на небольшие открытые наборы данных. Например, многие статьи использовали несколько публичных наборов Калифорнийского университета в Ирвайне (UCI), и многие из них содержали лишь несколько сотен или тысяч изображений, снятых в неестественных условиях и с низким разрешением. Ситуацию улучшила волна больших данных примерно с 2010 года. В 2009 году был опубликован набор данных ImageNet и запущено соревнование ImageNet Challenge: исследователям предлагалось обучать модели на 1 миллионе примеров, чтобы различать 1000 классов объектов. Набор ImageNet разработала группа исследователей под руководством профессора Фэй-Фэй Ли из Стэнфорда. Изображения каждого класса предварительно отбирались с помощью Google Image Search, а метки проставлялись через Amazon Mechanical Turk. Масштаб был беспрецедентным. Соревнование ImageNet Challenge стимулировало исследования в компьютерном зрении и машинном обучении: оно позволяло выяснить, какие модели лучше всего работают на данных большого масштаба.
7.1.1.2 Недостающий компонент: аппаратное обеспечение
Глубокое обучение очень требовательно к вычислительным ресурсам: обучение может занимать сотни эпох, и на каждой эпохе данные проходят через дорогостоящие слои линейной алгебры. Именно поэтому в 1990-е и в начале 2000-х исследователи предпочитали простые алгоритмы оптимизации выпуклых целевых функций. Однако обучение нейронных сетей на GPU изменило эту картину. Графические процессоры (Graphics Processing Unit, GPU) изначально создавались для ускорения обработки графики, что приносило пользу любителям компьютерных игр. GPU оптимизированы для высокопроизводительного умножения матриц и векторов, что служит базовым графическим задачам. К счастью, эти математические операции удивительно похожи на вычисления в свёрточных слоях. Поэтому NVIDIA и ATI начали оптимизировать GPU для вычислений общего назначения и даже продавать их как GPU общего назначения (general-purpose GPU, GPGPU).
Чем же GPU превосходят CPU?
Для начала разберёмся, что такое ядро центрального процессора (Central Processing Unit, CPU). Каждое ядро CPU обладает высокой тактовой частотой и кэшем третьего уровня (L3) объёмом до нескольких мегабайт. Ядра CPU хорошо подходят для выполнения самых разных инструкций: у них есть предсказатели ветвлений, глубокий конвейер и другие функции, благодаря которым процессор может выполнять самые разные программы. Однако это очевидное преимущество оборачивается слабым местом: универсальные ядра очень дорого производить. Им нужна большая площадь кристалла, сложные вспомогательные структуры (интерфейсы памяти, логика кэша между ядрами, высокоскоростные соединения и т. д.), при этом производительность каждой отдельной задачи у них довольно низкая. Современные ноутбуки имеют до 4 ядер, а даже в мощных серверах их редко бывает больше 64, потому что по соотношению цены и производительности это невыгодно.
В отличие от CPU, GPU состоит из небольших вычислительных блоков (детали различаются у NVIDIA, ATI, ARM и других производителей чипов), которые обычно объединяются в группы побольше (NVIDIA называет их warp). Каждое ядро GPU довольно слабое, иногда работает на частоте ниже 1 ГГц, но их огромное количество делает GPU быстрее CPU на несколько порядков. Например, архитектура NVIDIA Ampere последнего поколения обеспечивает до 312 TFlops производительности операций с плавающей точкой на один чип, тогда как производительность CPU с плавающей точкой пока не превышает 1 TFlops. Причина такого разрыва на самом деле проста. Во-первых, энергопотребление часто растёт квадратично с тактовой частотой. Допустим, ядро CPU работает в 4 раза быстрее ядра GPU, но вместо него можно использовать 16 ядер GPU; тогда суммарная производительность GPU будет в раза выше, чем у CPU. Во-вторых, ядра GPU устроены гораздо проще, поэтому они энергоэффективнее. Кроме того, многим операциям глубокого обучения нужна относительно высокая пропускная способность памяти, а у GPU она примерно в 10 раз выше, чем у CPU.
Вернёмся к прорыву 2012 года. Он произошёл, когда Алекс Крижевский и Илья Суцкевер реализовали глубокую свёрточную сеть, способную работать на GPU. Они увидели узкое место в вычислениях свёрточных сетей: свёртка и умножение матриц — операции, которые можно распараллелить на аппаратном уровне. Для быстрых свёрточных вычислений они использовали две видеокарты NVIDIA GTX 580 с 3 ГБ памяти каждая. Их разработка cuda-convnet несколько лет оставалась отраслевым стандартом и подхлестнула бум глубокого обучения.
7.1.2 AlexNet
В 2012 году появилась AlexNet. Она впервые показала, что признаки, выученные сетью, могут превосходить признаки, сконструированные вручную. Одним махом она переломила сложившуюся картину в исследованиях компьютерного зрения. AlexNet использует восемь слоёв свёрточной нейронной сети и с большим отрывом выиграла соревнование ImageNet 2012 года.
Архитектуры AlexNet и LeNet очень похожи, как показано на рис. 7.1.1. Обратите внимание: в книге приведена немного упрощённая версия AlexNet, без особенностей, которые в своё время требовали двух маломощных GPU для параллельной работы.
Рис. 7.1.1. От LeNet (слева) к AlexNet (справа)
Идеи AlexNet и LeNet очень похожи, но есть и заметные различия.
- AlexNet намного глубже сравнительно небольшой LeNet-5. AlexNet состоит из восьми слоёв: пяти свёрточных слоёв, двух полносвязных скрытых слоёв и одного полносвязного выходного слоя.
- AlexNet использует ReLU вместо sigmoid в качестве функции активации.
Ниже мы подробнее рассмотрим устройство AlexNet.
7.1.2.1 Проектирование модели
В первом слое AlexNet окно свёртки имеет форму . Поскольку большинство изображений ImageNet по ширине и высоте более чем в 10 раз больше изображений MNIST, для захвата объектов нужно окно свёртки побольше. Во втором слое форма окна уменьшается до , а затем до . Кроме того, после первого, второго и пятого свёрточных слоёв добавлены слои максимального пулинга с окном и шагом 2. Также число каналов свёртки в AlexNet в 10 раз больше, чем в LeNet.
После последнего свёрточного слоя идут два полносвязных слоя с 4096 выходами каждый. Эти два огромных полносвязных слоя содержат почти 1 ГБ параметров модели. Из-за ограниченной памяти ранних GPU исходная AlexNet использовала двухпоточную схему: каждый GPU хранил и вычислял только половину параметров модели. К счастью, сейчас в GPU памяти достаточно, поэтому модель обычно не приходится делить между несколькими GPU (поэтому AlexNet в этой книге несколько отличается от оригинальной статьи).
7.1.2.2 Функция активации
Кроме того, AlexNet заменила функцию активации sigmoid более простой ReLU. С одной стороны, вычисление ReLU проще: ей не нужны сложные операции возведения в степень, как у sigmoid. С другой стороны, при разных способах инициализации параметров ReLU делает обучение модели проще. Когда выход sigmoid очень близок к 0 или 1, градиент на этих участках почти нулевой, поэтому обратное распространение перестаёт обновлять некоторые параметры модели. Напротив, ReLU на положительной полуоси всегда имеет градиент, равный 1. Поэтому, если параметры модели инициализированы неправильно, sigmoid может на положительной полуоси получить почти нулевой градиент, и модель не сможет нормально обучаться.
7.1.2.3 Контроль ёмкости и предобработка
AlexNet контролирует сложность полносвязных слоёв с помощью исключения (dropout, раздел 4.6), тогда как LeNet использовала только затухание весов. Чтобы расширить данные, AlexNet во время обучения применяет большое количество аугментаций изображений: отражения, обрезку и изменение цвета. Это делает модель устойчивее, а больший объём выборки эффективно снижает переобучение. Подробнее об аугментации данных см. раздел 13.1.
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
net = nn.Sequential()
net.add(
# Здесь используем окно побольше, 11×11, чтобы захватывать объекты.
# Шаг 4 одновременно уменьшает высоту и ширину выхода.
# Кроме того, число выходных каналов намного больше, чем в LeNet
nn.Conv2D(96, kernel_size=11, strides=4, activation='relu'),
nn.MaxPool2D(pool_size=3, strides=2),
# Уменьшаем окно свёртки, используем заполнение 2, чтобы высота и ширина входа и выхода совпадали, и увеличиваем число выходных каналов
nn.Conv2D(256, kernel_size=5, padding=2, activation='relu'),
nn.MaxPool2D(pool_size=3, strides=2),
# Используем три последовательных свёрточных слоя с небольшим окном свёртки.
# Кроме последнего свёрточного слоя, число выходных каналов продолжает расти.
# После первых двух свёрточных слоёв пулинг не используется для уменьшения высоты и ширины входа
nn.Conv2D(384, kernel_size=3, padding=1, activation='relu'),
nn.Conv2D(384, kernel_size=3, padding=1, activation='relu'),
nn.Conv2D(256, kernel_size=3, padding=1, activation='relu'),
nn.MaxPool2D(pool_size=3, strides=2),
# Здесь выходов полносвязных слоёв в несколько раз больше, чем в LeNet. Слои dropout снижают переобучение
nn.Dense(4096, activation='relu'), nn.Dropout(0.5),
nn.Dense(4096, activation='relu'), nn.Dropout(0.5),
# Последний — выходной слой. Здесь используется Fashion-MNIST, поэтому число классов равно 10, а не 1000, как в статье
nn.Dense(10))
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
net = nn.Sequential(
# Здесь используем окно побольше, 11×11, чтобы захватывать объекты.
# Шаг 4 одновременно уменьшает высоту и ширину выхода.
# Кроме того, число выходных каналов намного больше, чем в LeNet
nn.Conv2d(1, 96, kernel_size=11, stride=4, padding=1), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2),
# Уменьшаем окно свёртки, используем заполнение 2, чтобы высота и ширина входа и выхода совпадали, и увеличиваем число выходных каналов
nn.Conv2d(96, 256, kernel_size=5, padding=2), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2),
# Используем три последовательных свёрточных слоя с небольшим окном свёртки.
# Кроме последнего свёрточного слоя, число выходных каналов продолжает расти.
# После первых двух свёрточных слоёв пулинг не используется для уменьшения высоты и ширины входа
nn.Conv2d(256, 384, kernel_size=3, padding=1), nn.ReLU(),
nn.Conv2d(384, 384, kernel_size=3, padding=1), nn.ReLU(),
nn.Conv2d(384, 256, kernel_size=3, padding=1), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2),
nn.Flatten(),
# Здесь выходов полносвязных слоёв в несколько раз больше, чем в LeNet. Слои dropout снижают переобучение
nn.Linear(6400, 4096), nn.ReLU(),
nn.Dropout(p=0.5),
nn.Linear(4096, 4096), nn.ReLU(),
nn.Dropout(p=0.5),
# Последний — выходной слой. Здесь используется Fashion-MNIST, поэтому число классов равно 10, а не 1000, как в статье
nn.Linear(4096, 10))
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
def net():
return tf.keras.models.Sequential([
# Здесь используем окно побольше, 11×11, чтобы захватывать объекты.
# Шаг 4 одновременно уменьшает высоту и ширину выхода.
# Кроме того, число выходных каналов намного больше, чем в LeNet
tf.keras.layers.Conv2D(filters=96, kernel_size=11, strides=4,
activation='relu'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2),
# Уменьшаем окно свёртки, используем заполнение 2, чтобы высота и ширина входа и выхода совпадали, и увеличиваем число выходных каналов
tf.keras.layers.Conv2D(filters=256, kernel_size=5, padding='same',
activation='relu'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2),
# Используем три последовательных свёрточных слоя с небольшим окном свёртки.
# Кроме последнего свёрточного слоя, число выходных каналов продолжает расти.
# После первых двух свёрточных слоёв пулинг не используется для уменьшения высоты и ширины входа
tf.keras.layers.Conv2D(filters=384, kernel_size=3, padding='same',
activation='relu'),
tf.keras.layers.Conv2D(filters=384, kernel_size=3, padding='same',
activation='relu'),
tf.keras.layers.Conv2D(filters=256, kernel_size=3, padding='same',
activation='relu'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2),
tf.keras.layers.Flatten(),
# Здесь выходов полносвязных слоёв в несколько раз больше, чем в LeNet. Слои dropout снижают переобучение
tf.keras.layers.Dense(4096, activation='relu'),
tf.keras.layers.Dropout(0.5),
tf.keras.layers.Dense(4096, activation='relu'),
tf.keras.layers.Dropout(0.5),
# Последний — выходной слой. Здесь используется Fashion-MNIST, поэтому число классов равно 10, а не 1000, как в статье
tf.keras.layers.Dense(10)
])
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.nn as nn
net = nn.Sequential(
# Здесь используем окно побольше, 11×11, чтобы захватывать объекты.
# Шаг 4 одновременно уменьшает высоту и ширину выхода.
# Кроме того, число выходных каналов намного больше, чем в LeNet
nn.Conv2D(1, 96, kernel_size=11, stride=4, padding=1), nn.ReLU(),
nn.MaxPool2D(kernel_size=3, stride=2),
# Уменьшаем окно свёртки, используем заполнение 2, чтобы высота и ширина входа и выхода совпадали, и увеличиваем число выходных каналов
nn.Conv2D(96, 256, kernel_size=5, padding=2), nn.ReLU(),
nn.MaxPool2D(kernel_size=3, stride=2),
# Используем три последовательных свёрточных слоя с небольшим окном свёртки.
# Кроме последнего свёрточного слоя, число выходных каналов продолжает расти.
# После первых двух свёрточных слоёв слой пулинга не используется для уменьшения высоты и ширины входа
nn.Conv2D(256, 384, kernel_size=3, padding=1), nn.ReLU(),
nn.Conv2D(384, 384, kernel_size=3, padding=1), nn.ReLU(),
nn.Conv2D(384, 256, kernel_size=3, padding=1), nn.ReLU(),
nn.MaxPool2D(kernel_size=3, stride=2), nn.Flatten(),
# Здесь выходов полносвязных слоёв в несколько раз больше, чем в LeNet. Слои dropout снижают переобучение
nn.Linear(6400, 4096), nn.ReLU(), nn.Dropout(p=0.5),
nn.Linear(4096, 4096), nn.ReLU(), nn.Dropout(p=0.5),
# Последний — выходной слой. Здесь используется Fashion-MNIST, поэтому число классов равно 10, а не 1000, как в статье
nn.Linear(4096, 10)
)
Построим одноканальные данные высотой и шириной 224, чтобы посмотреть форму выхода каждого слоя. Это соответствует архитектуре AlexNet с рис. 7.1.1.
MXNet:
X = np.random.uniform(size=(1, 1, 224, 224))
net.initialize()
for layer in net:
X = layer(X)
print(layer.name, 'форма выхода:\t', X.shape)
PyTorch:
X = torch.randn(1, 1, 224, 224)
for layer in net:
X=layer(X)
print(layer.__class__.__name__,'форма выхода:\t',X.shape)
TensorFlow:
X = tf.random.uniform((1, 224, 224, 1))
for layer in net().layers:
X = layer(X)
print(layer.__class__.__name__, 'форма выхода:\t', X.shape)
PaddlePaddle:
X = paddle.randn(shape=(1, 1, 224, 224))
for layer in net:
X=layer(X)
print(layer.__class__.__name__,'форма выхода:\t',X.shape)
7.1.3 Чтение набора данных
Хотя в оригинальной статье AlexNet обучалась на ImageNet, в этой книге используется набор Fashion-MNIST: даже на современных GPU обучение модели на ImageNet до сходимости может занимать часы или дни.
Главная проблема применения AlexNet к Fashion-MNIST в том, что разрешение изображений Fashion-MNIST ( пикселей) ниже, чем у изображений ImageNet. Чтобы это исправить, мы увеличим их до (обычно так делать неразумно, но здесь это сделано, чтобы эффективно использовать архитектуру AlexNet). Для такого изменения размера используется параметр resize функции d2l.load_data_fashion_mnist.
batch_size = 128
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=224)
7.1.4 Обучение AlexNet
Теперь AlexNet можно обучать. По сравнению с LeNet из раздела 6.6 основное отличие в том, что обучение идёт с меньшей скоростью обучения: сеть глубже и шире, изображения имеют более высокое разрешение, поэтому обучение свёрточных сетей здесь обходится дороже.
lr, num_epochs = 0.01, 10
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
Резюме
- Архитектура AlexNet похожа на LeNet, но использует больше свёрточных слоёв и больше параметров для работы с крупным набором данных ImageNet.
- Сегодня AlexNet уже превзойдена более эффективными архитектурами, но она стала ключевым шагом от мелких сетей к глубоким.
- Хотя код AlexNet всего на несколько строк длиннее кода LeNet, научному сообществу понадобились годы, чтобы принять концепцию глубокого обучения и начать применять её выдающиеся экспериментальные результаты. Свою роль сыграла и нехватка эффективных вычислительных инструментов.
- Dropout, ReLU и предобработка — другие ключевые приёмы, повышающие качество решения задач компьютерного зрения.
Упражнения
- Попробуйте увеличить число эпох обучения. Чем результаты отличаются от результатов LeNet? Почему?
- AlexNet, вероятно, слишком сложна для набора Fashion-MNIST.
- Попробуйте упростить модель, чтобы ускорить обучение и при этом не допустить заметного падения точности.
- Разработайте лучшую модель, которая сможет работать непосредственно с изображениями .
- Измените размер батча и понаблюдайте, как меняются точность модели и использование памяти GPU.
- Проанализируйте вычислительную производительность AlexNet.
- Какая часть AlexNet занимает больше всего памяти GPU?
- Какая часть требует больше всего вычислений?
- Какова пропускная способность памяти при вычислении результатов?
- Примените dropout и ReLU к LeNet-5. Станет ли результат лучше? Что будет, если добавить предобработку?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Bay, H., Tuytelaars, T., & Van Gool, L. (2006). SURF: Speeded up robust features. European Conference on Computer Vision, 404–417.
- Dalal, N., & Triggs, B. (2005). Histograms of oriented gradients for human detection. Proceedings of the IEEE CVPR, 1, 886–893.
- Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). ImageNet classification with deep convolutional neural networks. Advances in Neural Information Processing Systems, 1097–1105.
- Lowe, D. G. (2004). Distinctive image features from scale-invariant keypoints. International Journal of Computer Vision, 60(2), 91–110.
7.2 Сети с использованием блоков (VGG)
AlexNet показала, что глубокие нейронные сети работают, однако она не дала общего шаблона, по которому последующие исследователи могли бы проектировать новые сети. В следующих разделах мы рассмотрим несколько эвристических идей, которые часто используются при проектировании глубоких сетей.
Подобно тому как инженеры при проектировании микросхем переходят от размещения транзисторов к логическим элементам и затем к логическим блокам, архитектура нейронных сетей становится всё более абстрактной. Исследователи сначала рассматривали задачу с точки зрения отдельных нейронов, затем перешли к целым слоям, а теперь — к блокам, которые повторяют узоры из слоёв.
Идея использования блоков впервые появилась в сетях VGG из Visual Geometry Group Оксфордского университета. Используя циклы и подпрограммы, такие повторяющиеся архитектуры легко реализовать в коде любого современного фреймворка глубокого обучения.
7.2.1 VGG-блок
Базовые элементы классической свёрточной сети образуют такую последовательность:
- свёрточный слой с заполнением, которое сохраняет разрешение;
- нелинейная функция активации, например ReLU;
- слой пулинга, например слой максимального пулинга.
VGG-блок устроен похоже: он состоит из последовательности свёрточных слоёв, за которой следует слой максимального пулинга для пространственного уменьшения размерности. В исходной статье о VGG (Simonyan and Zisserman, 2014) использовались свёрточные ядра с заполнением 1 (сохраняющим высоту и ширину), а также слои максимального пулинга с окном и шагом 2 (после каждого блока разрешение уменьшается вдвое). В приведённом ниже коде мы определяем функцию vgg_block, которая реализует VGG-блок.
MXNet, TensorFlow: функция принимает два параметра: число свёрточных слоёв num_convs и число выходных каналов num_channels.
PyTorch: функция принимает три параметра: число свёрточных слоёв num_convs, число входных каналов in_channels и число выходных каналов out_channels.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
def vgg_block(num_convs, num_channels):
blk = nn.Sequential()
for _ in range(num_convs):
blk.add(nn.Conv2D(num_channels, kernel_size=3,
padding=1, activation='relu'))
blk.add(nn.MaxPool2D(pool_size=2, strides=2))
return blk
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
def vgg_block(num_convs, in_channels, out_channels):
layers = []
for _ in range(num_convs):
layers.append(nn.Conv2d(in_channels, out_channels,
kernel_size=3, padding=1))
layers.append(nn.ReLU())
in_channels = out_channels
layers.append(nn.MaxPool2d(kernel_size=2,stride=2))
return nn.Sequential(*layers)
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
def vgg_block(num_convs, num_channels):
blk = tf.keras.models.Sequential()
for _ in range(num_convs):
blk.add(tf.keras.layers.Conv2D(num_channels,kernel_size=3,
padding='same',activation='relu'))
blk.add(tf.keras.layers.MaxPool2D(pool_size=2, strides=2))
return blk
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.nn as nn
def vgg_block(num_convs, in_channels, out_channels):
layers = []
for _ in range(num_convs):
layers.append(
nn.Conv2D(in_channels, out_channels, kernel_size=3, padding=1))
layers.append(nn.ReLU())
in_channels = out_channels
layers.append(nn.MaxPool2D(kernel_size=2, stride=2))
return nn.Sequential(*layers)
7.2.2 Сеть VGG
Как и AlexNet и LeNet, сеть VGG делится на две части: первая состоит в основном из свёрточных слоёв и слоёв пулинга, вторая — из полносвязных слоёв. См. рис. 7.2.1.
Рис. 7.2.1. От AlexNet к VGG: в основе обеих сетей лежит блочный принцип
Сеть VGG соединяет несколько VGG-блоков (определённых в функции vgg_block), как показано на рис. 7.2.1. Её гиперпараметр conv_arch задаёт число свёрточных слоёв и число выходных каналов в каждом VGG-блоке. Полносвязная часть такая же, как у AlexNet.
Исходная сеть VGG имеет пять свёрточных блоков: в первых двух по одному свёрточному слою, в последних трёх — по два. Первый блок имеет 64 выходных канала, и каждый следующий блок удваивает их число, пока оно не достигнет 512. Поскольку сеть использует 8 свёрточных слоёв и 3 полносвязных слоя, её обычно называют VGG-11.
conv_arch = ((1, 64), (1, 128), (2, 256), (2, 512), (2, 512))
Ниже реализована VGG-11. Это несложно сделать циклом по conv_arch.
MXNet:
def vgg(conv_arch):
net = nn.Sequential()
# Свёрточная часть
for (num_convs, num_channels) in conv_arch:
net.add(vgg_block(num_convs, num_channels))
# Полносвязная часть
net.add(nn.Dense(4096, activation='relu'), nn.Dropout(0.5),
nn.Dense(4096, activation='relu'), nn.Dropout(0.5),
nn.Dense(10))
return net
net = vgg(conv_arch)
PyTorch:
def vgg(conv_arch):
conv_blks = []
in_channels = 1
# Свёрточная часть
for (num_convs, out_channels) in conv_arch:
conv_blks.append(vgg_block(num_convs, in_channels, out_channels))
in_channels = out_channels
return nn.Sequential(
*conv_blks, nn.Flatten(),
# Полносвязная часть
nn.Linear(out_channels * 7 * 7, 4096), nn.ReLU(), nn.Dropout(0.5),
nn.Linear(4096, 4096), nn.ReLU(), nn.Dropout(0.5),
nn.Linear(4096, 10))
net = vgg(conv_arch)
TensorFlow:
def vgg(conv_arch):
net = tf.keras.models.Sequential()
# Свёрточная часть
for (num_convs, num_channels) in conv_arch:
net.add(vgg_block(num_convs, num_channels))
# Полносвязная часть
net.add(tf.keras.models.Sequential([
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(4096, activation='relu'),
tf.keras.layers.Dropout(0.5),
tf.keras.layers.Dense(4096, activation='relu'),
tf.keras.layers.Dropout(0.5),
tf.keras.layers.Dense(10)]))
return net
net = vgg(conv_arch)
PaddlePaddle:
def vgg(conv_arch):
conv_blks = []
in_channels = 1
# Свёрточная часть
for (num_convs, out_channels) in conv_arch:
conv_blks.append(vgg_block(num_convs, in_channels, out_channels))
in_channels = out_channels
return nn.Sequential(*conv_blks, nn.Flatten(),
# Полносвязная часть
nn.Linear(out_channels * 7 * 7, 4096), nn.ReLU(),
nn.Dropout(0.5), nn.Linear(4096, 4096), nn.ReLU(),
nn.Dropout(0.5), nn.Linear(4096, 10))
net = vgg(conv_arch)
Далее построим выборку из одноканальных данных высотой и шириной 224 и посмотрим, какую форму имеет выход каждого слоя.
MXNet:
net.initialize()
X = np.random.uniform(size=(1, 1, 224, 224))
for blk in net:
X = blk(X)
print(blk.name, 'форма выхода:\t', X.shape)
PyTorch:
X = torch.randn(size=(1, 1, 224, 224))
for blk in net:
X = blk(X)
print(blk.__class__.__name__,'форма выхода:\t',X.shape)
TensorFlow:
X = tf.random.uniform((1, 224, 224, 1))
for blk in net.layers:
X = blk(X)
print(blk.__class__.__name__,'форма выхода:\t', X.shape)
PaddlePaddle:
X = paddle.randn(shape=(1, 1, 224, 224))
for blk in net:
X = blk(X)
print(blk.__class__.__name__,'форма выхода:\t',X.shape)
Как видно из кода, высота и ширина уменьшаются вдвое в каждом блоке и в итоге становятся равными 7. Затем представление выравнивается и подаётся в полносвязные слои.
7.2.3 Обучение модели
Поскольку VGG-11 требует больше вычислений, чем AlexNet, мы построим сеть с меньшим числом каналов, которой будет достаточно для обучения на наборе Fashion-MNIST.
MXNet, PyTorch, PaddlePaddle:
ratio = 4
small_conv_arch = [(pair[0], pair[1] // ratio) for pair in conv_arch]
net = vgg(small_conv_arch)
TensorFlow:
ratio = 4
small_conv_arch = [(pair[0], pair[1] // ratio) for pair in conv_arch]
# Напомним: это должна быть функция, которую передают в «d2l.train_ch6()». Чтобы использовать имеющиеся CPU/GPU, построение и компиляцию модели нужно выполнять внутри strategy.scope()
net = lambda: vgg(small_conv_arch)
За исключением немного более высокой скорости обучения, обучение модели проходит так же, как обучение AlexNet (см. раздел 7.1).
lr, num_epochs, batch_size = 0.05, 10, 128
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=224)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
Резюме
- VGG-11 строит сеть из повторно используемых свёрточных блоков. Различные модели VGG отличаются друг от друга числом свёрточных слоёв и числом выходных каналов в каждом блоке.
- Использование блоков делает описание сети очень компактным. Блоки позволяют эффективно проектировать сложные сети.
- В статье о VGG Симонян и Зиссерман экспериментировали с различными архитектурами. В частности, они обнаружили, что глубокие и узкие свёртки (то есть ) эффективнее неглубоких и широких.
Упражнения
- При печати размеров слоёв мы видим только 8 результатов, а не 11. Куда делись оставшиеся 3 слоя?
- По сравнению с AlexNet вычисления VGG выполняются гораздо медленнее, и ей требуется больше памяти GPU. Проанализируйте причины этого.
- Попробуйте изменить высоту и ширину изображений Fashion-MNIST с 224 на 96. Как это повлияет на эксперименты?
- Пользуясь таблицей 1 из статьи о VGG (Simonyan and Zisserman, 2014), постройте другие распространённые модели, например VGG-16 или VGG-19.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Simonyan, K., & Zisserman, A. (2014). Very deep convolutional networks for large-scale image recognition. arXiv preprint arXiv:1409.1556.
7.3 Сеть в сети (NiN)
LeNet, AlexNet и VGG имеют общий шаблон проектирования: сначала серия свёрточных и пулинговых слоёв извлекает пространственно-структурные признаки, затем полносвязные слои обрабатывают представление признаков. AlexNet и VGG улучшили LeNet главным образом тем, что расширили и углубили эти два модуля. Можно также представить себе использование полносвязных слоёв на раннем этапе этого процесса. Однако если использовать полносвязные слои, можно полностью утратить пространственную структуру представления. Сеть в сети (NiN) предлагает очень простое решение: применять многослойный перцептрон к каналам в каждом пикселе отдельно (Lin et al., 2013).
7.3.1 NiN-блок
Напомним, что входом и выходом свёрточного слоя служат четырёхмерные тензоры, оси которых соответствуют примерам, каналам, высоте и ширине. Кроме того, входом и выходом полносвязного слоя обычно служат двумерные тензоры, соответствующие примерам и признакам. Идея NiN состоит в том, чтобы в каждой позиции пикселя (для каждой высоты и ширины) применять полносвязный слой. Если связать веса со всеми пространственными позициями, это можно рассматривать как свёрточный слой (см. раздел 6.4) или как полносвязный слой, который независимо действует в каждой позиции пикселя. С другой точки зрения, каждый пиксель в пространственных измерениях можно считать отдельным примером, а измерение каналов — различными признаками.
На рис. 7.3.1 показаны основные архитектурные различия между VGG и NiN и их блоками. NiN-блок начинается с обычного свёрточного слоя, за которым следуют два свёрточных слоя . Эти два слоя играют роль поэлементных полносвязных слоёв с функцией активации ReLU. Форма окна свёртки первого слоя обычно задаётся пользователем. Окна последующих слоёв фиксированы и имеют размер .
Рис. 7.3.1. Сравнение архитектур VGG и NiN и их блоков
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
def nin_block(num_channels, kernel_size, strides, padding):
blk = nn.Sequential()
blk.add(nn.Conv2D(num_channels, kernel_size, strides, padding,
activation='relu'),
nn.Conv2D(num_channels, kernel_size=1, activation='relu'),
nn.Conv2D(num_channels, kernel_size=1, activation='relu'))
return blk
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
def nin_block(in_channels, out_channels, kernel_size, strides, padding):
return nn.Sequential(
nn.Conv2d(in_channels, out_channels, kernel_size, strides, padding),
nn.ReLU(),
nn.Conv2d(out_channels, out_channels, kernel_size=1), nn.ReLU(),
nn.Conv2d(out_channels, out_channels, kernel_size=1), nn.ReLU())
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
def nin_block(num_channels, kernel_size, strides, padding):
return tf.keras.models.Sequential([
tf.keras.layers.Conv2D(num_channels, kernel_size, strides=strides,
padding=padding, activation='relu'),
tf.keras.layers.Conv2D(num_channels, kernel_size=1,
activation='relu'),
tf.keras.layers.Conv2D(num_channels, kernel_size=1,
activation='relu')])
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.nn as nn
def nin_block(in_channels, out_channels, kernel_size, strides, padding):
return nn.Sequential(
nn.Conv2D(in_channels, out_channels, kernel_size, strides, padding),
nn.ReLU(),
nn.Conv2D(out_channels, out_channels, kernel_size=1),
nn.ReLU(),
nn.Conv2D(out_channels, out_channels, kernel_size=1),
nn.ReLU())
7.3.2 Модель NiN
Первоначальная сеть NiN появилась вскоре после AlexNet и явно была вдохновлена ею. NiN использует свёрточные слои с окнами , и , а число выходных каналов такое же, как в AlexNet. После каждого NiN-блока стоит слой максимального пулинга с окном и шагом 2.
Заметное отличие NiN от AlexNet в том, что NiN полностью отказывается от полносвязных слоёв. Вместо них NiN использует NiN-блок, число выходных каналов которого равно числу классов. В конце ставится глобальный средний пулинг (global average pooling), который выдаёт логиты. Преимущество такой конструкции в том, что она заметно сокращает число параметров модели. Однако на практике такой подход иногда увеличивает время обучения.
MXNet:
net = nn.Sequential()
net.add(nin_block(96, kernel_size=11, strides=4, padding=0),
nn.MaxPool2D(pool_size=3, strides=2),
nin_block(256, kernel_size=5, strides=1, padding=2),
nn.MaxPool2D(pool_size=3, strides=2),
nin_block(384, kernel_size=3, strides=1, padding=1),
nn.MaxPool2D(pool_size=3, strides=2),
nn.Dropout(0.5),
# Число классов меток равно 10
nin_block(10, kernel_size=3, strides=1, padding=1),
# Глобальный средний пулинг автоматически задаёт форму окна равной высоте и ширине входа
nn.GlobalAvgPool2D(),
# Преобразуем четырёхмерный выход в двумерный; его форма равна (размер батча, 10)
nn.Flatten())
PyTorch:
net = nn.Sequential(
nin_block(1, 96, kernel_size=11, strides=4, padding=0),
nn.MaxPool2d(3, stride=2),
nin_block(96, 256, kernel_size=5, strides=1, padding=2),
nn.MaxPool2d(3, stride=2),
nin_block(256, 384, kernel_size=3, strides=1, padding=1),
nn.MaxPool2d(3, stride=2),
nn.Dropout(0.5),
# Число классов меток равно 10
nin_block(384, 10, kernel_size=3, strides=1, padding=1),
nn.AdaptiveAvgPool2d((1, 1)),
# Преобразуем четырёхмерный выход в двумерный; его форма равна (размер батча, 10)
nn.Flatten())
TensorFlow:
def net():
return tf.keras.models.Sequential([
nin_block(96, kernel_size=11, strides=4, padding='valid'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2),
nin_block(256, kernel_size=5, strides=1, padding='same'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2),
nin_block(384, kernel_size=3, strides=1, padding='same'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2),
tf.keras.layers.Dropout(0.5),
# Число классов меток равно 10
nin_block(10, kernel_size=3, strides=1, padding='same'),
tf.keras.layers.GlobalAveragePooling2D(),
tf.keras.layers.Reshape((1, 1, 10)),
# Преобразуем четырёхмерный выход в двумерный; его форма равна (размер батча, 10)
tf.keras.layers.Flatten(),
])
PaddlePaddle:
net = nn.Sequential(
nin_block(1, 96, kernel_size=11, strides=4, padding=0),
nn.MaxPool2D(3, stride=2),
nin_block(96, 256, kernel_size=5, strides=1, padding=2),
nn.MaxPool2D(3, stride=2),
nin_block(256, 384, kernel_size=3, strides=1, padding=1),
nn.MaxPool2D(3, stride=2), nn.Dropout(0.5),
# Число классов меток равно 10
nin_block(384, 10, kernel_size=3, strides=1, padding=1),
nn.AdaptiveAvgPool2D((1, 1)),
# Преобразуем четырёхмерный выход в двумерный; его форма равна (размер батча, 10)
nn.Flatten())
Создадим пример данных, чтобы посмотреть форму выхода каждого блока.
MXNet:
X = np.random.uniform(size=(1, 1, 224, 224))
net.initialize()
for layer in net:
X = layer(X)
print(layer.name, 'форма выхода:\t', X.shape)
PyTorch:
X = torch.rand(size=(1, 1, 224, 224))
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'форма выхода:\t', X.shape)
TensorFlow:
X = tf.random.uniform((1, 224, 224, 1))
for layer in net().layers:
X = layer(X)
print(layer.__class__.__name__,'форма выхода:\t', X.shape)
PaddlePaddle:
X = paddle.rand(shape=(1, 1, 224, 224))
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'форма выхода:\t', X.shape)
7.3.3 Обучение модели
Как и прежде, мы обучаем модель на Fashion-MNIST. Обучение NiN похоже на обучение AlexNet и VGG.
lr, num_epochs, batch_size = 0.1, 10, 128
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=224)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
Резюме
- NiN использует блок, состоящий из одного свёрточного слоя и нескольких свёрточных слоёв . Такой блок можно использовать в свёрточной сети, чтобы добавить больше нелинейности для каждого пикселя.
- NiN удаляет полносвязные слои, склонные к переобучению, и заменяет их глобальным средним пулингом (то есть усреднением по всем позициям). Число каналов в этом слое равно требуемому числу выходов (например, для Fashion-MNIST — 10).
- Удаление полносвязных слоёв снижает переобучение и заметно сокращает число параметров NiN.
- Конструкция NiN повлияла на проектирование многих последующих свёрточных сетей.
Упражнения
- Подберите гиперпараметры NiN, чтобы повысить точность классификации.
- Зачем в NiN-блоке два свёрточных слоя ? Удалите один из них, затем наблюдайте и проанализируйте результаты.
- Подсчитайте ресурсы, которые использует NiN.
- Каково число параметров?
- Каков объём вычислений?
- Сколько памяти GPU нужно во время обучения?
- Сколько памяти GPU нужно во время предсказания?
- Что будет, если сразу сжать представление размера до ? Какие проблемы при этом возникнут?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Lin, M., Chen, Q., & Yan, S. (2013). Network in network. arXiv preprint arXiv:1312.4400.
7.4 Сеть с параллельными конкатенациями (GoogLeNet)
На соревновании ImageNet по распознаванию изображений в 2014 году выделилась архитектура под названием GoogLeNet (Szegedy et al., 2015). GoogLeNet заимствует идею последовательно соединённых сетей из NiN и развивает её. Главный вопрос статьи — какой размер свёрточного ядра наиболее подходит. В самом деле, популярные прежде сети использовали ядра от совсем маленьких до больших . Одна из мыслей статьи в том, что иногда полезно комбинировать свёрточные ядра разных размеров. В этом разделе мы представим немного упрощённую версию GoogLeNet: опустим некоторые особенности, которые добавлялись для стабилизации обучения, но при современных методах обучения уже не нужны.
7.4.1 Inception-блок
В GoogLeNet базовый свёрточный блок называется Inception-блоком (Inception block). Название, вероятно, происходит от фильма «Начало» (Inception), в котором звучит фраза «We need to go deeper» («Нам нужно идти глубже»).
Рис. 7.4.1. Архитектура Inception-блока
Как показано на рис. 7.4.1, Inception-блок состоит из четырёх параллельных путей. Первые три пути используют свёрточные слои с окнами , и и извлекают информацию из разных пространственных масштабов. Два средних пути сначала выполняют свёртку на входе, чтобы уменьшить число каналов и тем самым снизить сложность модели. Четвёртый путь использует слой максимального пулинга , за которым следует свёрточный слой , меняющий число каналов. Все четыре пути используют подходящее заполнение, чтобы высота и ширина входа и выхода совпадали. Наконец, выходы путей конкатенируются по измерению каналов, и результат становится выходом Inception-блока. В Inception-блоке обычно настраивают число выходных каналов каждого слоя.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
class Inception(nn.Block):
# c1--c4 — число выходных каналов каждого пути
def __init__(self, c1, c2, c3, c4, **kwargs):
super(Inception, self).__init__(**kwargs)
# Путь 1: один свёрточный слой 1x1
self.p1_1 = nn.Conv2D(c1, kernel_size=1, activation='relu')
# Путь 2: свёрточный слой 1x1, затем свёрточный слой 3x3
self.p2_1 = nn.Conv2D(c2[0], kernel_size=1, activation='relu')
self.p2_2 = nn.Conv2D(c2[1], kernel_size=3, padding=1,
activation='relu')
# Путь 3: свёрточный слой 1x1, затем свёрточный слой 5x5
self.p3_1 = nn.Conv2D(c3[0], kernel_size=1, activation='relu')
self.p3_2 = nn.Conv2D(c3[1], kernel_size=5, padding=2,
activation='relu')
# Путь 4: слой максимального пулинга 3x3, затем свёрточный слой 1x1
self.p4_1 = nn.MaxPool2D(pool_size=3, strides=1, padding=1)
self.p4_2 = nn.Conv2D(c4, kernel_size=1, activation='relu')
def forward(self, x):
p1 = self.p1_1(x)
p2 = self.p2_2(self.p2_1(x))
p3 = self.p3_2(self.p3_1(x))
p4 = self.p4_2(self.p4_1(x))
# Конкатенируем выходы по измерению каналов
return np.concatenate((p1, p2, p3, p4), axis=1)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
from torch.nn import functional as F
class Inception(nn.Module):
# c1--c4 — число выходных каналов каждого пути
def __init__(self, in_channels, c1, c2, c3, c4, **kwargs):
super(Inception, self).__init__(**kwargs)
# Путь 1: один свёрточный слой 1x1
self.p1_1 = nn.Conv2d(in_channels, c1, kernel_size=1)
# Путь 2: свёрточный слой 1x1, затем свёрточный слой 3x3
self.p2_1 = nn.Conv2d(in_channels, c2[0], kernel_size=1)
self.p2_2 = nn.Conv2d(c2[0], c2[1], kernel_size=3, padding=1)
# Путь 3: свёрточный слой 1x1, затем свёрточный слой 5x5
self.p3_1 = nn.Conv2d(in_channels, c3[0], kernel_size=1)
self.p3_2 = nn.Conv2d(c3[0], c3[1], kernel_size=5, padding=2)
# Путь 4: слой максимального пулинга 3x3, затем свёрточный слой 1x1
self.p4_1 = nn.MaxPool2d(kernel_size=3, stride=1, padding=1)
self.p4_2 = nn.Conv2d(in_channels, c4, kernel_size=1)
def forward(self, x):
p1 = F.relu(self.p1_1(x))
p2 = F.relu(self.p2_2(F.relu(self.p2_1(x))))
p3 = F.relu(self.p3_2(F.relu(self.p3_1(x))))
p4 = F.relu(self.p4_2(self.p4_1(x)))
# Конкатенируем выходы по измерению каналов
return torch.cat((p1, p2, p3, p4), dim=1)
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
class Inception(tf.keras.Model):
# c1--c4 — число выходных каналов каждого пути
def __init__(self, c1, c2, c3, c4):
super().__init__()
# Путь 1: один свёрточный слой 1x1
self.p1_1 = tf.keras.layers.Conv2D(c1, 1, activation='relu')
# Путь 2: свёрточный слой 1x1, затем свёрточный слой 3x3
self.p2_1 = tf.keras.layers.Conv2D(c2[0], 1, activation='relu')
self.p2_2 = tf.keras.layers.Conv2D(c2[1], 3, padding='same',
activation='relu')
# Путь 3: свёрточный слой 1x1, затем свёрточный слой 5x5
self.p3_1 = tf.keras.layers.Conv2D(c3[0], 1, activation='relu')
self.p3_2 = tf.keras.layers.Conv2D(c3[1], 5, padding='same',
activation='relu')
# Путь 4: слой максимального пулинга 3x3, затем свёрточный слой 1x1
self.p4_1 = tf.keras.layers.MaxPool2D(3, 1, padding='same')
self.p4_2 = tf.keras.layers.Conv2D(c4, 1, activation='relu')
def call(self, x):
p1 = self.p1_1(x)
p2 = self.p2_2(self.p2_1(x))
p3 = self.p3_2(self.p3_1(x))
p4 = self.p4_2(self.p4_1(x))
# Конкатенируем выходы по измерению каналов
return tf.keras.layers.Concatenate()([p1, p2, p3, p4])
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.nn as nn
import paddle.nn.functional as F
class Inception(nn.Layer):
# c1--c4 — число выходных каналов каждого пути
def __init__(self, in_channels, c1, c2, c3, c4, **kwargs):
super(Inception, self).__init__(**kwargs)
# Путь 1: один свёрточный слой 1x1
self.p1_1 = nn.Conv2D(in_channels, c1, kernel_size=1)
# Путь 2: свёрточный слой 1x1, затем свёрточный слой 3x3
self.p2_1 = nn.Conv2D(in_channels, c2[0], kernel_size=1)
self.p2_2 = nn.Conv2D(c2[0], c2[1], kernel_size=3, padding=1)
# Путь 3: свёрточный слой 1x1, затем свёрточный слой 5x5
self.p3_1 = nn.Conv2D(in_channels, c3[0], kernel_size=1)
self.p3_2 = nn.Conv2D(c3[0], c3[1], kernel_size=5, padding=2)
# Путь 4: слой максимального пулинга 3x3, затем свёрточный слой 1x1
self.p4_1 = nn.MaxPool2D(kernel_size=3, stride=1, padding=1)
self.p4_2 = nn.Conv2D(in_channels, c4, kernel_size=1)
def forward(self, x):
p1 = F.relu(self.p1_1(x))
p2 = F.relu(self.p2_2(F.relu(self.p2_1(x))))
p3 = F.relu(self.p3_2(F.relu(self.p3_1(x))))
p4 = F.relu(self.p4_2(self.p4_1(x)))
# Конкатенируем выходы по измерению каналов
return paddle.concat(x=[p1, p2, p3, p4], axis=1)
Почему же GoogLeNet так эффективна? Прежде всего заметим, что комбинация фильтров разных размеров позволяет исследовать изображение на разных масштабах: фильтры разного размера эффективно распознают детали изображения разного масштаба. Кроме того, разным фильтрам можно задавать разное число параметров.
7.4.2 Модель GoogLeNet
Как показано на рис. 7.4.2, GoogLeNet в общей сложности использует девять Inception-блоков и слои глобального среднего пулинга, чтобы получить свою оценку. Слои максимального пулинга между Inception-блоками понижают размерность. Первый модуль похож на AlexNet и LeNet, сочетание Inception-блоков унаследовано от VGG, а глобальный средний пулинг позволяет не использовать полносвязные слои в конце.
Рис. 7.4.2. Архитектура GoogLeNet
Теперь реализуем каждый модуль GoogLeNet по порядку. Первый модуль использует 64 канала и свёрточный слой .
MXNet:
b1 = nn.Sequential()
b1.add(nn.Conv2D(64, kernel_size=7, strides=2, padding=3, activation='relu'),
nn.MaxPool2D(pool_size=3, strides=2, padding=1))
PyTorch:
b1 = nn.Sequential(nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3),
nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
TensorFlow:
def b1():
return tf.keras.models.Sequential([
tf.keras.layers.Conv2D(64, 7, strides=2, padding='same',
activation='relu'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2, padding='same')])
PaddlePaddle:
b1 = nn.Sequential(nn.Conv2D(1, 64, kernel_size=7, stride=2, padding=3),
nn.ReLU(),
nn.MaxPool2D(kernel_size=3, stride=2,padding=1))
Второй модуль использует два свёрточных слоя: первый — свёрточный слой с 64 каналами; второй — свёрточный слой , который увеличивает число каналов втрое. Это соответствует второму пути Inception-блока.
MXNet:
b2 = nn.Sequential()
b2.add(nn.Conv2D(64, kernel_size=1, activation='relu'),
nn.Conv2D(192, kernel_size=3, padding=1, activation='relu'),
nn.MaxPool2D(pool_size=3, strides=2, padding=1))
PyTorch:
b2 = nn.Sequential(nn.Conv2d(64, 64, kernel_size=1),
nn.ReLU(),
nn.Conv2d(64, 192, kernel_size=3, padding=1),
nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
TensorFlow:
def b2():
return tf.keras.Sequential([
tf.keras.layers.Conv2D(64, 1, activation='relu'),
tf.keras.layers.Conv2D(192, 3, padding='same', activation='relu'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2, padding='same')])
PaddlePaddle:
b2 = nn.Sequential(nn.Conv2D(64, 64, kernel_size=1),
nn.ReLU(),
nn.Conv2D(64, 192, kernel_size=3, padding=1),
nn.ReLU(),
nn.MaxPool2D(kernel_size=3, stride=2, padding=1))
Третий модуль последовательно соединяет два полноценных Inception-блока. Выходное число каналов первого Inception-блока равно , а соотношение выходных каналов между путями составляет . Второй и третий пути сначала уменьшают число входных каналов до и соответственно, а затем применяют свёрточный слой. Выходное число каналов второго Inception-блока увеличивается до , а соотношение выходных каналов между путями составляет . Второй и третий пути сначала уменьшают число входных каналов до и соответственно.
MXNet:
b3 = nn.Sequential()
b3.add(Inception(64, (96, 128), (16, 32), 32),
Inception(128, (128, 192), (32, 96), 64),
nn.MaxPool2D(pool_size=3, strides=2, padding=1))
PyTorch:
b3 = nn.Sequential(Inception(192, 64, (96, 128), (16, 32), 32),
Inception(256, 128, (128, 192), (32, 96), 64),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
TensorFlow:
def b3():
return tf.keras.models.Sequential([
Inception(64, (96, 128), (16, 32), 32),
Inception(128, (128, 192), (32, 96), 64),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2, padding='same')])
PaddlePaddle:
b3 = nn.Sequential(Inception(192, 64, (96, 128), (16, 32), 32),
Inception(256, 128, (128, 192), (32, 96), 64),
nn.MaxPool2D(kernel_size=3, stride=2, padding=1))
Четвёртый модуль сложнее: он последовательно соединяет пять Inception-блоков, выходное число каналов которых равно , , , и . Распределение каналов по путям здесь похоже на третий модуль: больше всего каналов даёт второй путь со свёрткой , затем первый путь с одной свёрткой , далее третий путь со свёрткой и четвёртый путь с максимальным пулингом . Второй и третий пути сначала пропорционально уменьшают число каналов. Эти пропорции немного различаются в разных Inception-блоках.
MXNet:
b4 = nn.Sequential()
b4.add(Inception(192, (96, 208), (16, 48), 64),
Inception(160, (112, 224), (24, 64), 64),
Inception(128, (128, 256), (24, 64), 64),
Inception(112, (144, 288), (32, 64), 64),
Inception(256, (160, 320), (32, 128), 128),
nn.MaxPool2D(pool_size=3, strides=2, padding=1))
PyTorch:
b4 = nn.Sequential(Inception(480, 192, (96, 208), (16, 48), 64),
Inception(512, 160, (112, 224), (24, 64), 64),
Inception(512, 128, (128, 256), (24, 64), 64),
Inception(512, 112, (144, 288), (32, 64), 64),
Inception(528, 256, (160, 320), (32, 128), 128),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
TensorFlow:
def b4():
return tf.keras.Sequential([
Inception(192, (96, 208), (16, 48), 64),
Inception(160, (112, 224), (24, 64), 64),
Inception(128, (128, 256), (24, 64), 64),
Inception(112, (144, 288), (32, 64), 64),
Inception(256, (160, 320), (32, 128), 128),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2, padding='same')])
PaddlePaddle:
b4 = nn.Sequential(Inception(480, 192, (96, 208), (16, 48), 64),
Inception(512, 160, (112, 224), (24, 64), 64),
Inception(512, 128, (128, 256), (24, 64), 64),
Inception(512, 112, (144, 288), (32, 64), 64),
Inception(528, 256, (160, 320), (32, 128), 128),
nn.MaxPool2D(kernel_size=3, stride=2, padding=1))
Пятый модуль содержит два Inception-блока с выходным числом каналов и . Распределение каналов по путям здесь то же, что в третьем и четвёртом модулях, только числа другие. Важно, что за пятым модулем сразу следует выходной слой: как и в NiN, здесь используется глобальный средний пулинг, который приводит высоту и ширину каждого канала к 1. Наконец, выход превращается в двумерный массив, и к нему добавляется полносвязный слой с числом выходов, равным числу классов меток.
MXNet:
b5 = nn.Sequential()
b5.add(Inception(256, (160, 320), (32, 128), 128),
Inception(384, (192, 384), (48, 128), 128),
nn.GlobalAvgPool2D())
net = nn.Sequential()
net.add(b1, b2, b3, b4, b5, nn.Dense(10))
PyTorch:
b5 = nn.Sequential(Inception(832, 256, (160, 320), (32, 128), 128),
Inception(832, 384, (192, 384), (48, 128), 128),
nn.AdaptiveAvgPool2d((1,1)),
nn.Flatten())
net = nn.Sequential(b1, b2, b3, b4, b5, nn.Linear(1024, 10))
TensorFlow:
def b5():
return tf.keras.Sequential([
Inception(256, (160, 320), (32, 128), 128),
Inception(384, (192, 384), (48, 128), 128),
tf.keras.layers.GlobalAvgPool2D(),
tf.keras.layers.Flatten()
])
# «net» должна быть функцией, которую передают в «d2l.train_ch6()».
# Чтобы использовать имеющиеся CPU/GPU, построение и компиляцию модели нужно выполнять внутри «strategy.scope()»
def net():
return tf.keras.Sequential([b1(), b2(), b3(), b4(), b5(),
tf.keras.layers.Dense(10)])
PaddlePaddle:
b5 = nn.Sequential(Inception(832, 256, (160, 320), (32, 128), 128),
Inception(832, 384, (192, 384), (48, 128), 128),
nn.AdaptiveAvgPool2D((1, 1)),
nn.Flatten())
net = nn.Sequential(b1, b2, b3, b4, b5, nn.Linear(1024, 10))
Модель GoogLeNet вычислительно сложна, и её трудно модифицировать (например, менять число каналов, как это делается в VGG). Чтобы обучение на Fashion-MNIST было коротким, мы уменьшим высоту и ширину входа с 224 до 96, что упростит вычисления. Ниже показано, как меняется форма выхода каждого модуля.
MXNet:
X = np.random.uniform(size=(1, 1, 96, 96))
net.initialize()
for layer in net:
X = layer(X)
print(layer.name, 'форма выхода:\t', X.shape)
PyTorch:
X = torch.rand(size=(1, 1, 96, 96))
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'форма выхода:\t', X.shape)
TensorFlow:
X = tf.random.uniform(shape=(1, 96, 96, 1))
for layer in net().layers:
X = layer(X)
print(layer.__class__.__name__, 'форма выхода:\t', X.shape)
PaddlePaddle:
X = paddle.rand(shape=(1, 1, 96, 96))
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'форма выхода:\t', X.shape)
7.4.3 Обучение модели
Как и прежде, обучим модель на наборе Fashion-MNIST. Перед обучением приведём изображения к разрешению .
lr, num_epochs, batch_size = 0.1, 10, 128
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=96)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
Резюме
- Inception-блок — это подсеть с четырьмя путями. Он параллельно извлекает информацию с помощью свёрточных слоёв разной формы окна и слоёв максимального пулинга, а свёрточные слои уменьшают число каналов в каждом пикселе, что снижает сложность модели.
- GoogLeNet соединяет несколько тщательно спроектированных Inception-блоков с другими слоями (свёрточными и полносвязными). Соотношение числа каналов в Inception-блоках получено в результате большого числа экспериментов на наборе данных ImageNet.
- GoogLeNet и её преемники одно время были одними из самых эффективных моделей на ImageNet: при меньшей вычислительной сложности они дают сопоставимую точность.
Упражнения
- У GoogLeNet есть несколько последующих версий. Попробуйте реализовать и запустить их, затем проанализируйте результаты. Эти версии включают:
- добавление слоёв пакетной нормализации (batch normalization) (Ioffe and Szegedy, 2015), о которой пойдёт речь в разделе 7.5;
- корректировку модуля Inception (Szegedy et al., 2016);
- регуляризацию модели с помощью сглаживания меток (label smoothing) (Szegedy et al., 2016);
- добавление остаточных связей (Szegedy et al., 2017) (см. раздел 7.6).
- Каков минимальный размер изображения, с которым можно использовать GoogLeNet?
- Сравните размер параметров моделей AlexNet, VGG и NiN с GoogLeNet. Как две последние архитектуры существенно уменьшили размер параметров модели?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Ioffe, S., & Szegedy, C. (2015). Batch normalization: Accelerating deep network training by reducing internal covariate shift. arXiv preprint arXiv:1502.03167.
- Szegedy, C., Ioffe, S., Vanhoucke, V., & Alemi, A. A. (2017). Inception-v4, Inception-ResNet and the impact of residual connections on learning. Thirty-First AAAI Conference on Artificial Intelligence.
- Szegedy, C., Liu, W., Jia, Y., Sermanet, P., Reed, S., Anguelov, D., Erhan, D., Vanhoucke, V., & Rabinovich, A. (2015). Going deeper with convolutions. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 1–9.
- Szegedy, C., Vanhoucke, V., Ioffe, S., Shlens, J., & Wojna, Z. (2016). Rethinking the Inception architecture for computer vision. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2818–2826.
7.5 Пакетная нормализация
Обучение глубоких нейронных сетей очень трудно, особенно когда нужно добиться их сходимости за короткое время. В этом разделе мы рассмотрим пакетную нормализацию (batch normalization) (Ioffe and Szegedy, 2015) — популярный и эффективный приём, который ускоряет сходимость глубоких сетей. В сочетании с остаточными блоками, о которых пойдёт речь в разделе 7.6, пакетная нормализация позволяет обучать сети в более чем 100 слоёв.
7.5.1 Обучение глубоких сетей
Зачем нужны слои пакетной нормализации? Вспомним некоторые практические трудности, возникающие при обучении нейронных сетей.
Во-первых, способ предобработки данных часто сильно влияет на итоговый результат. Вспомним пример с применением многослойного перцептрона для предсказания цен на жильё (см. раздел 4.10). Работая с реальными данными, первым шагом мы стандартизуем входные признаки, так чтобы их среднее значение было равно 0, а дисперсия — 1. Интуитивно такая стандартизация хорошо сочетается с оптимизатором, поскольку выравнивает масштаб параметров.
Во-вторых, в типичных многослойных перцептронах и свёрточных сетях во время обучения промежуточные переменные (например, выходы аффинного преобразования в многослойном перцептроне) могут иметь очень широкий диапазон значений. Это касается как изменений от слоя к слою, так и разброса внутри одного слоя; кроме того, параметры модели меняются по мере обновлений в ходе обучения. Создатели пакетной нормализации неформально предположили, что такой сдвиг распределений этих переменных может мешать сходимости сети. Интуитивно можно предположить, что если значения переменных одного слоя в 100 раз больше, чем у другого, то для компенсации может понадобиться корректировка скорости обучения.
В-третьих, глубокие сети сложны и склонны к переобучению. Поэтому регуляризация становится ещё важнее.
Пакетная нормализация применяется к отдельному опциональному слою (а можно и ко всем слоям). Её принцип таков: на каждой итерации обучения мы сначала нормализуем входы, вычитая из них среднее и деля на стандартное отклонение, причём обе статистики вычисляются по текущему минибатчу. Затем применяем коэффициент масштаба и смещение. Именно из-за этой нормализации, основанной на статистиках батча, метод и получил название пакетная нормализация.
Заметим, что если применять пакетную нормализацию к минибатчу размера 1, мы ничему не научимся: после вычитания среднего каждый скрытый элемент станет равен 0. Поэтому метод эффективен и устойчив только при достаточно большом минибатче. Кроме того, при использовании пакетной нормализации выбор размера батча может быть важнее, чем без неё.
Формально пусть — вход из минибатча . Тогда пакетная нормализация преобразует по формуле:
(7.5.1)
В формуле (7.5.1) — выборочное среднее минибатча , а — выборочное стандартное отклонение минибатча . После стандартизации получаемый минибатч имеет среднее 0 и единичную дисперсию. Поскольку единичная дисперсия (как и некоторые другие «магические» числа) — субъективный выбор, обычно вводят параметр растяжения (scale) и параметр сдвига (shift) , имеющие ту же форму, что и . Заметим, что и — параметры, которые обучаются вместе с остальными параметрами модели.
Поскольку во время обучения амплитуда изменений промежуточных слоёв не должна быть слишком резкой, пакетная нормализация центрирует каждый слой и приводит его к заданным среднему и масштабу (через и ).
Формально и из формулы (7.5.1) вычисляются так:
Заметим, что к оценке дисперсии добавляется малая константа , чтобы мы никогда не делили на ноль, даже когда эмпирическая оценка дисперсии обращается в нуль. Оценки и с помощью шумных оценок среднего и дисперсии компенсируют проблему масштабирования. На первый взгляд шум кажется проблемой, но на самом деле он полезен.
Это известная в глубоком обучении тема. По причинам, которые пока не объяснены теоретически, различные источники шума при оптимизации обычно приводят к более быстрому обучению и меньшему переобучению: такое изменение действует как форма регуляризации. В ряде предварительных работ (Teye et al., 2018) и (Luo et al., 2018) свойства пакетной нормализации связываются с байесовскими априорными распределениями. Эти теории объясняют, почему пакетная нормализация лучше всего работает со средними размерами батча в диапазоне .
Кроме того, слой пакетной нормализации работает по-разному в «режиме обучения» (нормализация по статистикам минибатча) и в «режиме предсказания» (нормализация по статистикам всего набора данных). Во время обучения нельзя оценить среднее и дисперсию по всему набору данных, поэтому модель обучается, опираясь на среднее и дисперсию каждого минибатча. В режиме предсказания среднее и дисперсию пакетной нормализации можно точно вычислить по всему набору данных.
Теперь посмотрим, как пакетная нормализация работает на практике.
7.5.2 Слои пакетной нормализации
Напомним, что ключевое отличие пакетной нормализации от других слоёв в том, что она работает на полном минибатче, поэтому мы не можем, как раньше, игнорировать размер батча. Рассмотрим два случая: полносвязные слои и свёрточные слои. Их реализация пакетной нормализации немного различается.
7.5.2.1 Полносвязные слои
Обычно слой пакетной нормализации помещают в полносвязном слое между аффинным преобразованием и функцией активации. Пусть вход полносвязного слоя — , весовой параметр и параметр смещения — и , функция активации — , а оператор пакетной нормализации — . Тогда выход полносвязного слоя с пакетной нормализацией вычисляется так:
Напомним, что среднее и дисперсия вычисляются по тому же минибатчу, к которому применяется преобразование.
7.5.2.2 Свёрточные слои
Аналогично для свёрточных слоёв пакетную нормализацию можно применять после свёрточного слоя и перед нелинейной функцией активации. Когда у свёртки несколько выходных каналов, пакетную нормализацию нужно выполнять для каждого выходного канала: у каждого канала свои параметры растяжения и смещения, и оба они скалярные. Пусть минибатч содержит примеров, а выход свёртки для каждого канала имеет высоту и ширину . Тогда для свёрточного слоя мы одновременно выполняем пакетную нормализацию для каждого выходного канала по всем элементам. Поэтому при вычислении среднего и дисперсии мы собираем значения по всем пространственным позициям, а затем применяем одни и те же среднее и дисперсию в пределах канала, нормализуя значения в каждой пространственной позиции.
7.5.2.3 Пакетная нормализация в режиме предсказания
Как уже говорилось, пакетная нормализация ведёт себя по-разному в режимах обучения и предсказания. Во-первых, при использовании обученной модели для предсказания нам больше не нужны шумовые оценки выборочного среднего и не нужно оценивать дисперсию по каждому минибатчу. Во-вторых, модель может понадобиться для предсказания по одному примеру за раз. Обычно среднее и дисперсию по всему обучающему набору оценивают скользящим средним и используют их при предсказании, чтобы получать детерминированный результат. Таким образом, как и исключение (dropout), слой пакетной нормализации даёт разные результаты в режимах обучения и предсказания.
7.5.3 Реализация с нуля
Ниже мы с нуля реализуем слой пакетной нормализации на тензорах.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, np, npx, init
from mxnet.gluon import nn
npx.set_np()
def batch_norm(X, gamma, beta, moving_mean, moving_var, eps, momentum):
# Через autograd определяем, находимся ли мы в режиме обучения или предсказания
if not autograd.is_training():
# В режиме предсказания используем переданные скользящие среднее и дисперсию
X_hat = (X - moving_mean) / np.sqrt(moving_var + eps)
else:
assert len(X.shape) in (2, 4)
if len(X.shape) == 2:
# Для полносвязного слоя вычисляем среднее и дисперсию по измерению признаков
mean = X.mean(axis=0)
var = ((X - mean) ** 2).mean(axis=0)
else:
# Для двумерного свёрточного слоя вычисляем среднее и дисперсию по измерению каналов (axis=1).
# Здесь сохраняем форму X, чтобы потом можно было выполнять broadcasting
mean = X.mean(axis=(0, 2, 3), keepdims=True)
var = ((X - mean) ** 2).mean(axis=(0, 2, 3), keepdims=True)
# В режиме обучения стандартизуем с текущими средним и дисперсией
X_hat = (X - mean) / np.sqrt(var + eps)
# Обновляем скользящие среднее и дисперсию
moving_mean = momentum * moving_mean + (1.0 - momentum) * mean
moving_var = momentum * moving_var + (1.0 - momentum) * var
Y = gamma * X_hat + beta # Масштабирование и сдвиг
return Y, moving_mean, moving_var
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
def batch_norm(X, gamma, beta, moving_mean, moving_var, eps, momentum):
# Через is_grad_enabled определяем, находимся ли мы в режиме обучения или предсказания
if not torch.is_grad_enabled():
# В режиме предсказания используем переданные скользящие среднее и дисперсию
X_hat = (X - moving_mean) / torch.sqrt(moving_var + eps)
else:
assert len(X.shape) in (2, 4)
if len(X.shape) == 2:
# Для полносвязного слоя вычисляем среднее и дисперсию по измерению признаков
mean = X.mean(dim=0)
var = ((X - mean) ** 2).mean(dim=0)
else:
# Для двумерного свёрточного слоя вычисляем среднее и дисперсию по измерению каналов (axis=1).
# Здесь сохраняем форму X, чтобы потом можно было выполнять broadcasting
mean = X.mean(dim=(0, 2, 3), keepdim=True)
var = ((X - mean) ** 2).mean(dim=(0, 2, 3), keepdim=True)
# В режиме обучения стандартизуем с текущими средним и дисперсией
X_hat = (X - mean) / torch.sqrt(var + eps)
# Обновляем скользящие среднее и дисперсию
moving_mean = momentum * moving_mean + (1.0 - momentum) * mean
moving_var = momentum * moving_var + (1.0 - momentum) * var
Y = gamma * X_hat + beta # Масштабирование и сдвиг
return Y, moving_mean.data, moving_var.data
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
def batch_norm(X, gamma, beta, moving_mean, moving_var, eps):
# Вычисляем обратный квадратный корень из скользящей дисперсии
inv = tf.cast(tf.math.rsqrt(moving_var + eps), X.dtype)
# Масштабирование и сдвиг
inv *= gamma
Y = X * inv + (beta - moving_mean * inv)
return Y
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.nn as nn
def batch_norm(X, gamma, beta, moving_mean, moving_var, eps, momentum, is_training=True):
# Обработка BN в режиме обучения отличается от обработки в режиме предсказания
if not is_training:
# В режиме предсказания используем переданные скользящие среднее и дисперсию
X_hat = (X - moving_mean) / (moving_var + eps) ** 0.5
else:
assert len(X.shape) in (2, 4)
if len(X.shape) == 2:
# Для полносвязного слоя вычисляем среднее и дисперсию по измерению признаков
mean = paddle.mean(X)
var = paddle.mean(((X - mean) ** 2))
else:
# Для двумерного свёрточного слоя вычисляем среднее и дисперсию по измерению каналов (axis=1).
# Здесь сохраняем форму X, чтобы потом можно было выполнять broadcasting
mean = paddle.mean(X, axis=(0, 2, 3), keepdim=True)
var = paddle.mean(((X - mean) ** 2), axis=(0, 2, 3), keepdim=True)
# В режиме обучения стандартизуем с текущими средним и дисперсией
X_hat = (X - mean) / (var + eps) ** 0.5
# Обновляем скользящие среднее и дисперсию
moving_mean = momentum * moving_mean + (1.0 - momentum) * mean
moving_var = momentum * moving_var + (1.0 - momentum) * var
Y = gamma * X_hat + beta # Масштабирование и сдвиг
return Y, moving_mean, moving_var
Теперь мы можем создать корректный слой BatchNorm. Этот слой хранит параметры: растяжение gamma и смещение beta, которые обновляются во время обучения. Кроме того, слой хранит скользящие средние значения среднего и дисперсии, чтобы использовать их при предсказании.
Отвлекаясь от деталей алгоритма, обратим внимание на базовый шаблон реализации слоя. Обычно математику задают отдельной функцией, например batch_norm. Затем эту функцию встраивают в пользовательский слой, код которого отвечает за перенос данных на устройство (например, GPU), выделение и инициализацию необходимых переменных, отслеживание скользящих значений (здесь — среднего и дисперсии) и т. д.
Для простоты мы не будем автоматически выводить форму входа, поэтому нужно указать полное число признаков. Не беспокойтесь: API пакетной нормализации в фреймворках решает эти задачи за нас, и мы покажем это позже.
MXNet:
class BatchNorm(nn.Block):
# num_features: число выходов полносвязного слоя или число выходных каналов свёрточного слоя.
# num_dims: 2 — полносвязный слой, 4 — свёрточный слой
def __init__(self, num_features, num_dims, **kwargs):
super().__init__(**kwargs)
if num_dims == 2:
shape = (1, num_features)
else:
shape = (1, num_features, 1, 1)
# Параметры растяжения и смещения, участвующие в вычислении градиентов и обновлении, инициализируем единицами и нулями соответственно
self.gamma = self.params.get('gamma', shape=shape, init=init.One())
self.beta = self.params.get('beta', shape=shape, init=init.Zero())
# Переменные, которые не являются параметрами модели, инициализируем нулями и единицами
self.moving_mean = np.zeros(shape)
self.moving_var = np.ones(shape)
def forward(self, X):
# Если X не находится в памяти, копируем moving_mean и moving_var
# в видеопамять, где находится X
if self.moving_mean.ctx != X.ctx:
self.moving_mean = self.moving_mean.copyto(X.ctx)
self.moving_var = self.moving_var.copyto(X.ctx)
# Сохраняем обновлённые moving_mean и moving_var
Y, self.moving_mean, self.moving_var = batch_norm(
X, self.gamma.data(), self.beta.data(), self.moving_mean,
self.moving_var, eps=1e-12, momentum=0.9)
return Y
PyTorch:
class BatchNorm(nn.Module):
# num_features: число выходов полносвязного слоя или число выходных каналов свёрточного слоя.
# num_dims: 2 — полносвязный слой, 4 — свёрточный слой
def __init__(self, num_features, num_dims):
super().__init__()
if num_dims == 2:
shape = (1, num_features)
else:
shape = (1, num_features, 1, 1)
# Параметры растяжения и смещения, участвующие в вычислении градиентов и обновлении, инициализируем единицами и нулями соответственно
self.gamma = nn.Parameter(torch.ones(shape))
self.beta = nn.Parameter(torch.zeros(shape))
# Переменные, которые не являются параметрами модели, инициализируем нулями и единицами
self.moving_mean = torch.zeros(shape)
self.moving_var = torch.ones(shape)
def forward(self, X):
# Если X не находится в памяти, копируем moving_mean и moving_var
# в видеопамять, где находится X
if self.moving_mean.device != X.device:
self.moving_mean = self.moving_mean.to(X.device)
self.moving_var = self.moving_var.to(X.device)
# Сохраняем обновлённые moving_mean и moving_var
Y, self.moving_mean, self.moving_var = batch_norm(
X, self.gamma, self.beta, self.moving_mean,
self.moving_var, eps=1e-5, momentum=0.9)
return Y
TensorFlow:
class BatchNorm(tf.keras.layers.Layer):
def __init__(self, **kwargs):
super(BatchNorm, self).__init__(**kwargs)
def build(self, input_shape):
weight_shape = [input_shape[-1], ]
# Параметры растяжения и смещения, участвующие в вычислении градиентов и обновлении, инициализируем единицами и нулями соответственно
self.gamma = self.add_weight(name='gamma', shape=weight_shape,
initializer=tf.initializers.ones, trainable=True)
self.beta = self.add_weight(name='beta', shape=weight_shape,
initializer=tf.initializers.zeros, trainable=True)
# Переменные, которые не являются параметрами модели, инициализируем нулями и единицами
self.moving_mean = self.add_weight(name='moving_mean',
shape=weight_shape, initializer=tf.initializers.zeros,
trainable=False)
self.moving_variance = self.add_weight(name='moving_variance',
shape=weight_shape, initializer=tf.initializers.ones,
trainable=False)
super(BatchNorm, self).build(input_shape)
def assign_moving_average(self, variable, value):
momentum = 0.9
delta = variable * momentum + value * (1 - momentum)
return variable.assign(delta)
@tf.function
def call(self, inputs, training):
if training:
axes = list(range(len(inputs.shape) - 1))
batch_mean = tf.reduce_mean(inputs, axes, keepdims=True)
batch_variance = tf.reduce_mean(tf.math.squared_difference(
inputs, tf.stop_gradient(batch_mean)), axes, keepdims=True)
batch_mean = tf.squeeze(batch_mean, axes)
batch_variance = tf.squeeze(batch_variance, axes)
mean_update = self.assign_moving_average(
self.moving_mean, batch_mean)
variance_update = self.assign_moving_average(
self.moving_variance, batch_variance)
self.add_update(mean_update)
self.add_update(variance_update)
mean, variance = batch_mean, batch_variance
else:
mean, variance = self.moving_mean, self.moving_variance
output = batch_norm(inputs, moving_mean=mean, moving_var=variance,
beta=self.beta, gamma=self.gamma, eps=1e-5)
return output
PaddlePaddle:
class BatchNorm(nn.Layer):
def __init__(self, num_features, num_dims=4):
super(BatchNorm, self).__init__()
if num_dims == 2:
shape = (1, num_features)
else:
shape = (1, num_features, 1, 1)
# Параметры растяжения и смещения, участвующие в вычислении градиентов и обновлении, инициализируем единицами и нулями соответственно
self.gamma = self.create_parameter(
attr=None,
shape=shape,
dtype='float32',
is_bias=False,
default_initializer=nn.initializer.Assign(paddle.ones(shape=shape, dtype='float32')))
self.beta = self.create_parameter(
attr=None,
shape=shape,
dtype='float32',
is_bias=False,
default_initializer=nn.initializer.Assign(paddle.zeros(shape=shape, dtype='float32')))
self.moving_mean = paddle.zeros(shape=shape, dtype='float32')
self.moving_var = paddle.zeros(shape=shape, dtype='float32')
def forward(self, X):
# Сохраняем обновлённые moving_mean и moving_var
Y, self.moving_mean, self.moving_var = batch_norm(
X, self.gamma, self.beta, self.moving_mean,
self.moving_var, eps=1e-5, momentum=0.9, is_training=self.training)
return Y
7.5.4 Применение пакетной нормализации в LeNet
Чтобы лучше понять, как применять BatchNorm, используем её в модели LeNet (см. раздел 6.6). Напомним, что пакетная нормализация применяется после свёрточного или полносвязного слоя и перед соответствующей функцией активации.
MXNet:
net = nn.Sequential()
net.add(nn.Conv2D(6, kernel_size=5),
BatchNorm(6, num_dims=4),
nn.Activation('sigmoid'),
nn.AvgPool2D(pool_size=2, strides=2),
nn.Conv2D(16, kernel_size=5),
BatchNorm(16, num_dims=4),
nn.Activation('sigmoid'),
nn.AvgPool2D(pool_size=2, strides=2),
nn.Dense(120),
BatchNorm(120, num_dims=2),
nn.Activation('sigmoid'),
nn.Dense(84),
BatchNorm(84, num_dims=2),
nn.Activation('sigmoid'),
nn.Dense(10))
PyTorch:
net = nn.Sequential(
nn.Conv2d(1, 6, kernel_size=5), BatchNorm(6, num_dims=4), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2),
nn.Conv2d(6, 16, kernel_size=5), BatchNorm(16, num_dims=4), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2), nn.Flatten(),
nn.Linear(16*4*4, 120), BatchNorm(120, num_dims=2), nn.Sigmoid(),
nn.Linear(120, 84), BatchNorm(84, num_dims=2), nn.Sigmoid(),
nn.Linear(84, 10))
TensorFlow:
# Напомним: эту функцию нужно передать в d2l.train_ch6.
# Иначе говоря, чтобы использовать имеющиеся CPU/GPU, модель нужно создавать внутри strategy.scope()
def net():
return tf.keras.models.Sequential([
tf.keras.layers.Conv2D(filters=6, kernel_size=5,
input_shape=(28, 28, 1)),
BatchNorm(),
tf.keras.layers.Activation('sigmoid'),
tf.keras.layers.AvgPool2D(pool_size=2, strides=2),
tf.keras.layers.Conv2D(filters=16, kernel_size=5),
BatchNorm(),
tf.keras.layers.Activation('sigmoid'),
tf.keras.layers.AvgPool2D(pool_size=2, strides=2),
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(120),
BatchNorm(),
tf.keras.layers.Activation('sigmoid'),
tf.keras.layers.Dense(84),
BatchNorm(),
tf.keras.layers.Activation('sigmoid'),
tf.keras.layers.Dense(10)]
)
PaddlePaddle:
net = nn.Sequential(
nn.Conv2D(1, 6, kernel_size=5), BatchNorm(6, num_dims=4), nn.Sigmoid(),
nn.MaxPool2D(kernel_size=2, stride=2),
nn.Conv2D(6, 16, kernel_size=5), BatchNorm(16, num_dims=4), nn.Sigmoid(),
nn.MaxPool2D(kernel_size=2, stride=2),
nn.Flatten(), nn.Linear(16 * 4 * 4, 120), BatchNorm(120, num_dims=2), nn.Sigmoid(),
nn.Linear(120, 84), BatchNorm(84, num_dims=2), nn.Sigmoid(),
nn.Linear(84, 10))
Как и раньше, обучим сеть на наборе Fashion-MNIST. Этот код почти полностью совпадает с кодом, которым мы впервые обучали LeNet (см. раздел 6.6); главное отличие в том, что скорость обучения здесь намного больше.
MXNet, PyTorch, PaddlePaddle:
lr, num_epochs, batch_size = 1.0, 10, 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
TensorFlow:
lr, num_epochs, batch_size = 1.0, 10, 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
net = d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
Посмотрим, какие параметры растяжения gamma и смещения beta были выучены в первом слое пакетной нормализации.
MXNet:
net[1].gamma.data().reshape(-1,), net[1].beta.data().reshape(-1,)
PyTorch:
net[1].gamma.reshape((-1,)), net[1].beta.reshape((-1,))
TensorFlow:
tf.reshape(net.layers[1].gamma, (-1,)), tf.reshape(net.layers[1].beta, (-1,))
PaddlePaddle:
param = net.parameters()
print('gamma:', param[2].numpy().reshape(-1))
print('beta:', param[3].numpy().reshape(-1))
7.5.5 Краткая реализация
Помимо только что определённого BatchNorm, можно напрямую использовать BatchNorm, определённую во фреймворке глубокого обучения. Код получается почти таким же, как выше.
MXNet:
net = nn.Sequential()
net.add(nn.Conv2D(6, kernel_size=5),
nn.BatchNorm(),
nn.Activation('sigmoid'),
nn.AvgPool2D(pool_size=2, strides=2),
nn.Conv2D(16, kernel_size=5),
nn.BatchNorm(),
nn.Activation('sigmoid'),
nn.AvgPool2D(pool_size=2, strides=2),
nn.Dense(120),
nn.BatchNorm(),
nn.Activation('sigmoid'),
nn.Dense(84),
nn.BatchNorm(),
nn.Activation('sigmoid'),
nn.Dense(10))
PyTorch:
net = nn.Sequential(
nn.Conv2d(1, 6, kernel_size=5), nn.BatchNorm2d(6), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2),
nn.Conv2d(6, 16, kernel_size=5), nn.BatchNorm2d(16), nn.Sigmoid(),
nn.AvgPool2d(kernel_size=2, stride=2), nn.Flatten(),
nn.Linear(256, 120), nn.BatchNorm1d(120), nn.Sigmoid(),
nn.Linear(120, 84), nn.BatchNorm1d(84), nn.Sigmoid(),
nn.Linear(84, 10))
TensorFlow:
def net():
return tf.keras.models.Sequential([
tf.keras.layers.Conv2D(filters=6, kernel_size=5,
input_shape=(28, 28, 1)),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('sigmoid'),
tf.keras.layers.AvgPool2D(pool_size=2, strides=2),
tf.keras.layers.Conv2D(filters=16, kernel_size=5),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('sigmoid'),
tf.keras.layers.AvgPool2D(pool_size=2, strides=2),
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(120),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('sigmoid'),
tf.keras.layers.Dense(84),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('sigmoid'),
tf.keras.layers.Dense(10),
])
PaddlePaddle:
net = nn.Sequential(
nn.Conv2D(1, 6, kernel_size=5), nn.BatchNorm2D(6, momentum=0.1), nn.Sigmoid(),
nn.MaxPool2D(kernel_size=2, stride=2),
nn.Conv2D(6, 16, kernel_size=5), nn.BatchNorm2D(16, momentum=0.1), nn.Sigmoid(),
nn.MaxPool2D(kernel_size=2, stride=2),
nn.Flatten(),
nn.Linear(256, 120), nn.BatchNorm1D(120, momentum=0.1), nn.Sigmoid(),
nn.Linear(120, 84), nn.BatchNorm1D(84, momentum=0.1), nn.Sigmoid(),
nn.Linear(84, 10))
Теперь обучим модель с теми же гиперпараметрами. Заметим, что высокоуровневые API обычно работают значительно быстрее, поскольку их код скомпилирован в C++ или CUDA, тогда как наш пользовательский код написан на Python.
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
7.5.6 Спорные моменты
Интуитивно пакетная нормализация считается средством, которое делает оптимизацию более плавной. Однако нужно тщательно различать интуицию и реальное объяснение наблюдаемых явлений. Напомним, что мы даже не знаем, почему простые нейронные сети (многослойные перцептроны и традиционные свёрточные сети) работают так эффективно. Даже с исключением и затуханием весов они остаются очень гибкими, поэтому общие результаты теории обучения не позволяют объяснить, будут ли они обобщаться на невиданные данные.
В статье о пакетной нормализации авторы, помимо описания её применения, объяснили её принцип: уменьшением внутреннего сдвига ковариат (internal covariate shift). Предполагается, что упомянутый авторами внутренний сдвиг ковариат похож на описанную выше интуицию о том, что распределения значений переменных меняются в ходе обучения. Однако у этого объяснения есть две проблемы:
- такой сдвиг сильно отличается от строго определённого сдвига ковариат (covariate shift), поэтому название употреблено некорректно;
- это объяснение даёт лишь расплывчатую интуицию, но оставляет открытым вопрос: почему эта техника так эффективна?
Книга призвана передать интуицию, которой практики пользуются при разработке глубоких нейронных сетей. Однако важно отделять эти руководящие интуиции от установленных научных фактов. В конце концов, когда вы освоите эти методы и начнёте писать собственные научные статьи, вам понадобится ясно различать технику и интуицию.
По мере распространения пакетной нормализации объяснение через внутренний сдвиг ковариат регулярно возникало в технической литературе, в частности в широкой дискуссии о том, как следует представлять результаты исследований в машинном обучении. Али Рахими (Ali Rahimi), получая премию за проверку временем (Test of Time Award) на конференции NeurIPS 2017, произнёс запоминающуюся речь. В центре его выступления был «внутренний сдвиг ковариат», а современную практику глубокого обучения он сравнил с алхимией. Он подробно разобрал этот пример (Lipton and Steinhardt, 2018), обозначив тревожные тенденции в машинном обучении. Кроме того, некоторые авторы предложили другое объяснение успеха пакетной нормализации: по некоторым показателям её поведение противоположно тому, что утверждалось в исходной статье (Santurkar et al., 2018).
Однако по сравнению с тысячами похожих расплывчатых утверждений в литературе по машинному обучению внутренний сдвиг ковариат не заслуживает особой критики. Скорее всего, он стал предметом дискуссии благодаря широкому признанию у целевой аудитории. Пакетная нормализация уже зарекомендовала себя как незаменимый метод. Она применяется почти во всех классификаторах изображений, и на неё ссылаются в научной литературе десятки тысяч раз.
Резюме
- В процессе обучения модели пакетная нормализация использует среднее и стандартное отклонение минибатча, постоянно корректируя промежуточные выходы нейронной сети, так что значения промежуточных выходов всех слоёв становятся более стабильными.
- Пакетная нормализация в полносвязных и свёрточных слоях используется немного по-разному.
- Слой пакетной нормализации, как и слой исключения, по-разному работает в режимах обучения и предсказания.
- У пакетной нормализации много полезных побочных эффектов, главным образом регуляризация. С другой стороны, исходная мотивация — «уменьшение внутреннего сдвига ковариат» — не выглядит убедительным объяснением.
Упражнения
- Можно ли удалить параметры смещения из полносвязного или свёрточного слоя до применения пакетной нормализации? Почему?
- Сравните скорость обучения LeNet с пакетной нормализацией и без неё.
- Постройте график роста точности на обучающих и тестовых данных.
- Насколько большой может быть скорость обучения?
- Нужно ли выполнять пакетную нормализацию в каждом слое? Попробуйте.
- Можно ли заменить исключение (dropout) пакетной нормализацией? Как изменится поведение модели?
- Определите параметры
betaиgamma, наблюдайте и проанализируйте результаты. - Посмотрите онлайн-документацию по
BatchNormв высокоуровневом API, чтобы узнать о других применениях пакетной нормализации. - Исследовательская идея: какие ещё «нормализующие» преобразования можно применить? Подойдёт ли для этого интегральное преобразование вероятностей? А оценка полноранговой ковариационной матрицы?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Ioffe, S., & Szegedy, C. (2015). Batch normalization: Accelerating deep network training by reducing internal covariate shift. arXiv preprint arXiv:1502.03167.
- Lipton, Z. C., & Steinhardt, J. (2018). Troubling trends in machine learning scholarship. arXiv preprint arXiv:1807.03341.
- Luo, P., Wang, X., Shao, W., & Peng, Z. (2018). Towards understanding regularization in batch normalization. arXiv preprint.
- Santurkar, S., Tsipras, D., Ilyas, A., & Madry, A. (2018). How does batch normalization help optimization? Advances in Neural Information Processing Systems, 2483–2493.
- Teye, M., Azizpour, H., & Smith, K. (2018). Bayesian uncertainty estimation for batch normalized deep networks. arXiv preprint arXiv:1802.06455.
7.6 Остаточные сети (ResNet)
По мере того как мы проектируем всё более глубокие сети, становится крайне важным понимать, как добавленные слои улучшают производительность нейронной сети. Ещё важнее уметь проектировать такие сети, в которых добавление слоёв делает сеть более выразительной. Чтобы добиться качественного прорыва, нам понадобятся некоторые математические основы.
7.6.1 Классы функций
Сначала предположим, что существует определённый класс архитектур нейронных сетей , включающий настройки скорости обучения и других гиперпараметров. Для всех существуют некоторые наборы параметров (например, весов и смещений), которые можно получить, обучая сеть на подходящем наборе данных. Теперь предположим, что — функция, которую мы действительно хотим найти. Если , мы легко получим её обучением, но обычно нам так не повезёт. Вместо этого мы попытаемся найти функцию , которая окажется лучшим выбором внутри . Например, для набора данных с признаками и метками мы можем попытаться найти её, решив следующую задачу оптимизации:
Как же получить функцию, которая ближе к истинной ? Единственная разумная возможность — спроектировать более мощную архитектуру . Иначе говоря, мы ожидаем, что будет «ближе» к , чем . Однако если , то нет гарантии, что новая архитектура окажется «ближе». Более того, может оказаться даже хуже. Как показано на рис. 7.6.1, для классов функций, не вложенных друг в друга, более сложный класс функций не всегда приближается к «истинной» функции (сложность растёт от к ). На левой части рис. 7.6.1 ближе к , чем , но оказывается дальше. Напротив, для вложенных классов функций , показанных справа на рис. 7.6.1, этой проблемы можно избежать.
Рис. 7.6.1. Для классов функций, не вложенных друг в друга, более сложный класс (его показывает большая область) не гарантирует приближения к «истинной» функции (). Для вложенных классов функций такого не происходит
Поэтому мы можем гарантировать улучшение производительности, только если более сложный класс функций содержит меньший. Для глубоких нейронных сетей, если мы сможем обучить новый добавленный слой так, чтобы он стал тождественным отображением (identity function) , новая модель будет так же эффективна, как исходная. Кроме того, поскольку новая модель может найти лучшее решение для аппроксимации обучающего набора, добавление слоя, по-видимому, облегчает уменьшение ошибки обучения.
Для решения этой задачи Кайминг Хе (Kaiming He) и соавторы предложили остаточные сети (ResNet) (He et al., 2016a). Эта сеть победила на соревновании ImageNet Large Scale Visual Recognition Challenge в 2015 году и глубоко повлияла на проектирование последующих глубоких нейронных сетей. Главная идея остаточных сетей состоит в том, что каждый добавленный слой должен легче включать исходную функцию как один из своих элементов. Так появились остаточные блоки (residual blocks), и это проектное решение оказало большое влияние на построение глубоких нейронных сетей.
7.6.2 Остаточный блок
Сосредоточимся на локальном фрагменте сети. Как показано на рис. 7.6.2, пусть исходный вход — , а желаемое идеальное отображение — (это вход функции активации над рис. 7.6.2). Часть в пунктирной рамке слева на рис. 7.6.2 должна непосредственно аппроксимировать это отображение , а часть в пунктирной рамке справа — остаточное отображение . Остаточное отображение на практике обычно проще оптимизировать. Если в качестве желаемого отображения взять упомянутое выше тождественное отображение, достаточно обнулить веса и параметры смещения взвешенных операций (например, аффинных) в верхней части пунктирной рамки справа на рис. 7.6.2, и тогда станет тождественным отображением. На практике, когда идеальное отображение очень близко к тождественному, остаточное отображение способно уловить небольшие отклонения от него. Правая часть рис. 7.6.2 — основная архитектура ResNet: остаточный блок (residual block). В остаточном блоке вход может быстрее распространяться вперёд по межслойным связям данных.
Рис. 7.6.2. Обычный блок (слева) и остаточный блок (справа)
ResNet сохраняет полную конструкцию из свёрточных слоёв из VGG. Остаточный блок содержит сначала два свёрточных слоя с одинаковым числом выходных каналов. За каждым свёрточным слоем следуют слой пакетной нормализации и функция активации ReLU. Затем по межслойному пути данных мы пропускаем эти две свёрточные операции и складываем вход с выходом непосредственно перед последней функцией активации ReLU. Такая конструкция требует, чтобы выходы двух свёрточных слоёв имели ту же форму, что и вход, иначе их нельзя будет сложить. Если нужно изменить число каналов, необходимо добавить дополнительный свёрточный слой , который приведёт вход к нужной форме перед сложением. Реализация остаточного блока приведена ниже:
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
class Residual(nn.Block): #@save
def __init__(self, num_channels, use_1x1conv=False, strides=1, **kwargs):
super().__init__(**kwargs)
self.conv1 = nn.Conv2D(num_channels, kernel_size=3, padding=1,
strides=strides)
self.conv2 = nn.Conv2D(num_channels, kernel_size=3, padding=1)
if use_1x1conv:
self.conv3 = nn.Conv2D(num_channels, kernel_size=1,
strides=strides)
else:
self.conv3 = None
self.bn1 = nn.BatchNorm()
self.bn2 = nn.BatchNorm()
def forward(self, X):
Y = npx.relu(self.bn1(self.conv1(X)))
Y = self.bn2(self.conv2(Y))
if self.conv3:
X = self.conv3(X)
return npx.relu(Y + X)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
from torch.nn import functional as F
class Residual(nn.Module): #@save
def __init__(self, input_channels, num_channels,
use_1x1conv=False, strides=1):
super().__init__()
self.conv1 = nn.Conv2d(input_channels, num_channels,
kernel_size=3, padding=1, stride=strides)
self.conv2 = nn.Conv2d(num_channels, num_channels,
kernel_size=3, padding=1)
if use_1x1conv:
self.conv3 = nn.Conv2d(input_channels, num_channels,
kernel_size=1, stride=strides)
else:
self.conv3 = None
self.bn1 = nn.BatchNorm2d(num_channels)
self.bn2 = nn.BatchNorm2d(num_channels)
def forward(self, X):
Y = F.relu(self.bn1(self.conv1(X)))
Y = self.bn2(self.conv2(Y))
if self.conv3:
X = self.conv3(X)
Y += X
return F.relu(Y)
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
class Residual(tf.keras.Model): #@save
def __init__(self, num_channels, use_1x1conv=False, strides=1):
super().__init__()
self.conv1 = tf.keras.layers.Conv2D(
num_channels, padding='same', kernel_size=3, strides=strides)
self.conv2 = tf.keras.layers.Conv2D(
num_channels, kernel_size=3, padding='same')
self.conv3 = None
if use_1x1conv:
self.conv3 = tf.keras.layers.Conv2D(
num_channels, kernel_size=1, strides=strides)
self.bn1 = tf.keras.layers.BatchNormalization()
self.bn2 = tf.keras.layers.BatchNormalization()
def call(self, X):
Y = tf.keras.activations.relu(self.bn1(self.conv1(X)))
Y = self.bn2(self.conv2(Y))
if self.conv3 is not None:
X = self.conv3(X)
Y += X
return tf.keras.activations.relu(Y)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.nn as nn
from paddle.nn import functional as F
class Residual(nn.Layer): #@save
def __init__(self, input_channels, num_channels, use_1x1conv=False,
strides=1):
super(Residual, self).__init__()
self.conv1 = nn.Conv2D(input_channels, num_channels, kernel_size=3,
padding=1, stride=strides)
self.conv2 = nn.Conv2D(num_channels, num_channels, kernel_size=3,
padding=1)
if use_1x1conv:
self.conv3 = nn.Conv2D(input_channels, num_channels,
kernel_size=1, stride=strides)
else:
self.conv3 = None
self.bn1 = nn.BatchNorm2D(num_channels)
self.bn2 = nn.BatchNorm2D(num_channels)
self.relu = nn.ReLU()
def forward(self, X):
Y = F.relu(self.bn1(self.conv1(X)))
Y = self.bn2(self.conv2(Y))
if self.conv3:
X = self.conv3(X)
Y += X
return F.relu(Y)
Как показано на рис. 7.6.3, этот код порождает два типа сетей: при use_1x1conv=False вход добавляется к выходу до применения нелинейной функции ReLU; при use_1x1conv=True вход дополнительно проходит через свёртку , которая меняет число каналов и разрешение.
Рис. 7.6.3. Остаточные блоки без свёрточного слоя и с ним
Рассмотрим случай, когда форма входа и выхода совпадает.
MXNet:
blk = Residual(3)
blk.initialize()
X = np.random.uniform(size=(4, 3, 6, 6))
blk(X).shape
PyTorch:
blk = Residual(3,3)
X = torch.rand(4, 3, 6, 6)
Y = blk(X)
Y.shape
TensorFlow:
blk = Residual(3)
X = tf.random.uniform((4, 6, 6, 3))
Y = blk(X)
Y.shape
PaddlePaddle:
blk = Residual(3, 3)
X = paddle.rand([4, 3, 6, 6])
Y = blk(X)
Y.shape
Можно также одновременно увеличить число выходных каналов и уменьшить вдвое высоту и ширину выхода.
MXNet:
blk = Residual(6, use_1x1conv=True, strides=2)
blk.initialize()
blk(X).shape
PyTorch:
blk = Residual(3,6, use_1x1conv=True, strides=2)
blk(X).shape
TensorFlow:
blk = Residual(6, use_1x1conv=True, strides=2)
blk(X).shape
PaddlePaddle:
blk = Residual(3, 6, use_1x1conv=True, strides=2)
blk(X).shape
7.6.3 Модель ResNet
Первые два слоя ResNet такие же, как в GoogLeNet: после свёрточного слоя с 64 выходными каналами и шагом 2 идёт слой максимального пулинга с шагом 2. Отличие в том, что в ResNet после каждого свёрточного слоя добавлен слой пакетной нормализации.
MXNet:
net = nn.Sequential()
net.add(nn.Conv2D(64, kernel_size=7, strides=2, padding=3),
nn.BatchNorm(), nn.Activation('relu'),
nn.MaxPool2D(pool_size=3, strides=2, padding=1))
PyTorch:
b1 = nn.Sequential(nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3),
nn.BatchNorm2d(64), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
TensorFlow:
b1 = tf.keras.models.Sequential([
tf.keras.layers.Conv2D(64, kernel_size=7, strides=2, padding='same'),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('relu'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2, padding='same')])
PaddlePaddle:
b1 = nn.Sequential(nn.Conv2D(1, 64, kernel_size=7, stride=2, padding=3),
nn.BatchNorm2D(64), nn.ReLU(),
nn.MaxPool2D(kernel_size=3, stride=2, padding=1))
После этого GoogLeNet использует четыре модуля из Inception-блоков. ResNet использует четыре модуля из остаточных блоков, каждый из которых содержит несколько остаточных блоков с одинаковым числом выходных каналов. Число каналов первого модуля совпадает с числом входных каналов. Поскольку перед этим уже использован слой максимального пулинга с шагом 2, высоту и ширину уменьшать не нужно. Каждый последующий модуль в первом остаточном блоке удваивает число каналов предыдущего модуля и уменьшает вдвое высоту и ширину.
Реализуем этот модуль. Обратите внимание, что первый модуль обрабатывается особым образом.
MXNet:
def resnet_block(num_channels, num_residuals, first_block=False):
blk = nn.Sequential()
for i in range(num_residuals):
if i == 0 and not first_block:
blk.add(Residual(num_channels, use_1x1conv=True, strides=2))
else:
blk.add(Residual(num_channels))
return blk
PyTorch:
def resnet_block(input_channels, num_channels, num_residuals,
first_block=False):
blk = []
for i in range(num_residuals):
if i == 0 and not first_block:
blk.append(Residual(input_channels, num_channels,
use_1x1conv=True, strides=2))
else:
blk.append(Residual(num_channels, num_channels))
return blk
TensorFlow:
class ResnetBlock(tf.keras.layers.Layer):
def __init__(self, num_channels, num_residuals, first_block=False,
**kwargs):
super(ResnetBlock, self).__init__(**kwargs)
self.residual_layers = []
for i in range(num_residuals):
if i == 0 and not first_block:
self.residual_layers.append(
Residual(num_channels, use_1x1conv=True, strides=2))
else:
self.residual_layers.append(Residual(num_channels))
def call(self, X):
for layer in self.residual_layers.layers:
X = layer(X)
return X
PaddlePaddle:
def resnet_block(input_channels, num_channels, num_residuals,
first_block=False):
blk = []
for i in range(num_residuals):
if i == 0 and not first_block:
blk.append(
Residual(input_channels, num_channels, use_1x1conv=True,
strides=2))
else:
blk.append(Residual(num_channels, num_channels))
return blk
Далее добавим в ResNet все остаточные блоки; здесь в каждом модуле по два остаточных блока.
MXNet:
net.add(resnet_block(64, 2, first_block=True),
resnet_block(128, 2),
resnet_block(256, 2),
resnet_block(512, 2))
PyTorch, PaddlePaddle:
b2 = nn.Sequential(*resnet_block(64, 64, 2, first_block=True))
b3 = nn.Sequential(*resnet_block(64, 128, 2))
b4 = nn.Sequential(*resnet_block(128, 256, 2))
b5 = nn.Sequential(*resnet_block(256, 512, 2))
TensorFlow:
b2 = ResnetBlock(64, 2, first_block=True)
b3 = ResnetBlock(128, 2)
b4 = ResnetBlock(256, 2)
b5 = ResnetBlock(512, 2)
Наконец, как и в GoogLeNet, в ResNet добавляем слой глобального среднего пулинга и полносвязный выходной слой.
MXNet:
net.add(nn.GlobalAvgPool2D(), nn.Dense(10))
PyTorch:
net = nn.Sequential(b1, b2, b3, b4, b5,
nn.AdaptiveAvgPool2d((1,1)),
nn.Flatten(), nn.Linear(512, 10))
TensorFlow:
# Напомним, что ранее мы определили функцию, чтобы использовать различные вычислительные ресурсы,
# например GPU, в области tf.distribute.MirroredStrategy. Кроме того, хотя мы уже создали b1, b2, b3, b4 и b5,
# мы пересоздаём их внутри этой функции
def net():
return tf.keras.Sequential([
# Следующие слои такие же, как b1, созданный ранее
tf.keras.layers.Conv2D(64, kernel_size=7, strides=2, padding='same'),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.Activation('relu'),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2, padding='same'),
# Следующие слои такие же, как b2, b3, b4 и b5, созданные ранее
ResnetBlock(64, 2, first_block=True),
ResnetBlock(128, 2),
ResnetBlock(256, 2),
ResnetBlock(512, 2),
tf.keras.layers.GlobalAvgPool2D(),
tf.keras.layers.Dense(units=10)])
PaddlePaddle:
net = nn.Sequential(b1, b2, b3, b4, b5,
nn.AdaptiveAvgPool2D((1, 1)),
nn.Flatten(), nn.Linear(512, 10))
Каждый модуль содержит 4 свёрточных слоя (не считая свёрточного слоя для тождественного отображения). Вместе с первым свёрточным слоем и последним полносвязным слоем получаем 18 слоёв. Поэтому такую модель обычно называют ResNet-18. Изменяя число каналов и число остаточных блоков в модулях, можно получить разные модели ResNet, например более глубокую ResNet-152 с 152 слоями. Хотя основная архитектура ResNet похожа на GoogLeNet, ResNet проще и её легче модифицировать. Эти факторы привели к быстрому и широкому распространению ResNet. На рис. 7.6.4 показана полная архитектура ResNet-18.
Рис. 7.6.4. Архитектура ResNet-18
Прежде чем обучать ResNet, посмотрим, как меняется форма входа для разных модулей ResNet. Во всех предыдущих архитектурах разрешение уменьшалось, а число каналов росло, пока глобальный средний пулинг не соберёт все признаки.
MXNet:
X = np.random.uniform(size=(1, 1, 224, 224))
net.initialize()
for layer in net:
X = layer(X)
print(layer.name, 'форма выхода:\t', X.shape)
PyTorch:
X = torch.rand(size=(1, 1, 224, 224))
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'форма выхода:\t', X.shape)
TensorFlow:
X = tf.random.uniform(shape=(1, 224, 224, 1))
for layer in net().layers:
X = layer(X)
print(layer.__class__.__name__,'форма выхода:\t', X.shape)
PaddlePaddle:
X = paddle.rand(shape=(1, 1, 224, 224))
for layer in net:
X = layer(X)
print(layer.__class__.__name__,'форма выхода:\t', X.shape)
7.6.4 Обучение модели
Как и раньше, обучаем ResNet на наборе Fashion-MNIST.
lr, num_epochs, batch_size = 0.05, 10, 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=96)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
Резюме
- Изучение вложенных функций (nested function) — идеальный сценарий для обучения нейронных сетей. В глубоких нейронных сетях обучить дополнительный слой тождественному отображению (identity function) проще, хотя это и крайний случай.
- Остаточное отображение может более легко обучаться одной и той же функции, например приближать параметры весового слоя к нулю.
- Остаточные блоки (residual blocks) позволяют обучать эффективную глубокую нейронную сеть: вход может быстрее распространяться вперёд по остаточным связям между слоями.
- Остаточные сети (ResNet) оказали глубокое влияние на проектирование последующих глубоких нейронных сетей.
Упражнения
- Каково главное различие между Inception-блоком (рис. 7.4.1) и остаточным блоком? Как они связаны друг с другом после удаления некоторых путей в Inception-блоке?
- Используя таблицу 1 из статьи о ResNet (He et al., 2016a), реализуйте различные варианты модели.
- Для более глубоких сетей ResNet вводит архитектуру «bottleneck» (узкое место), которая снижает сложность модели. Попробуйте её реализовать.
- В последующих версиях ResNet авторы изменили порядок слоёв: вместо «свёрточный слой, слой пакетной нормализации, слой активации» стало «слой пакетной нормализации, слой активации, свёрточный слой». Попробуйте внести это изменение. Подробнее см. рис. 1 в статье (He et al., 2016b).
- Почему, даже если классы функций вложены, мы всё равно ограничиваем рост сложности функций?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- He, K., Zhang, X., Ren, S., & Sun, J. (2016a). Deep residual learning for image recognition. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 770–778.
- He, K., Zhang, X., Ren, S., & Sun, J. (2016b). Identity mappings in deep residual networks. European Conference on Computer Vision, 630–645.
7.7 Плотно связанные сети (DenseNet)
ResNet существенно изменила представление о том, как параметризовать функции в глубоких сетях. Плотно связанная сеть (DenseNet) (Huang et al., 2017) в некотором смысле является логическим развитием ResNet. Сначала разберёмся с этим математически.
7.7.1 От ResNet к DenseNet
Вспомним разложение в ряд Тейлора (Taylor expansion) произвольной функции: оно раскладывает функцию на члены всё более высокого порядка. При , близком к 0,
Аналогично ResNet представляет функцию в виде
То есть ResNet разбивает на две части: простое линейное слагаемое и сложное нелинейное слагаемое. Что если пойти дальше и разложить более чем на две части? Один из вариантов — DenseNet.
Рис. 7.7.1. Главное отличие ResNet (слева) и DenseNet (справа) в межслойных связях: сложение и конкатенация
Как показано на рис. 7.7.1, ключевое различие ResNet и DenseNet в том, что выход DenseNet — это конкатенация (на рисунке она обозначена ), а не простая сумма, как в ResNet. Поэтому после применения всё более сложной последовательности функций мы выполняем отображение от к её разложению:
Наконец, эти разложения объединяются в многослойный перцептрон, который снова уменьшает число признаков. Реализовать это очень просто: мы не добавляем слагаемые, а конкатенируем их. Название DenseNet происходит от «плотных связей» между переменными: последний слой связан со всеми предыдущими слоями. Плотные связи показаны на рис. 7.7.2.
Рис. 7.7.2. Плотные связи
Плотная сеть состоит в основном из двух частей: плотных блоков (dense block) и переходных слоёв (transition layer). Первые определяют, как соединять входы и выходы, а вторые управляют числом каналов, чтобы сеть не становилась слишком сложной.
7.7.2 Плотный блок
DenseNet использует усовершенствованную версию ResNet с архитектурой «пакетная нормализация, активация и свёртка» (см. упражнения в разделе 7.6). Сначала реализуем эту архитектуру.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
def conv_block(num_channels):
blk = nn.Sequential()
blk.add(nn.BatchNorm(),
nn.Activation('relu'),
nn.Conv2D(num_channels, kernel_size=3, padding=1))
return blk
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
def conv_block(input_channels, num_channels):
return nn.Sequential(
nn.BatchNorm2d(input_channels), nn.ReLU(),
nn.Conv2d(input_channels, num_channels, kernel_size=3, padding=1))
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
class ConvBlock(tf.keras.layers.Layer):
def __init__(self, num_channels):
super(ConvBlock, self).__init__()
self.bn = tf.keras.layers.BatchNormalization()
self.relu = tf.keras.layers.ReLU()
self.conv = tf.keras.layers.Conv2D(
filters=num_channels, kernel_size=(3, 3), padding='same')
self.listLayers = [self.bn, self.relu, self.conv]
def call(self, x):
y = x
for layer in self.listLayers.layers:
y = layer(y)
y = tf.keras.layers.concatenate([x,y], axis=-1)
return y
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.nn as nn
def conv_block(input_channels, num_channels):
return nn.Sequential(
nn.BatchNorm2D(input_channels), nn.ReLU(),
nn.Conv2D(input_channels, num_channels, kernel_size=3, padding=1))
Плотный блок состоит из нескольких свёрточных блоков, каждый из которых использует одинаковое число выходных каналов. Однако в прямом распространении мы конкатенируем по каналам вход и выход каждого свёрточного блока.
MXNet:
class DenseBlock(nn.Block):
def __init__(self, num_convs, num_channels, **kwargs):
super().__init__(**kwargs)
self.net = nn.Sequential()
for _ in range(num_convs):
self.net.add(conv_block(num_channels))
def forward(self, X):
for blk in self.net:
Y = blk(X)
# Конкатенируем входы и выходы каждого блока по измерению каналов
X = np.concatenate((X, Y), axis=1)
return X
PyTorch:
class DenseBlock(nn.Module):
def __init__(self, num_convs, input_channels, num_channels):
super(DenseBlock, self).__init__()
layer = []
for i in range(num_convs):
layer.append(conv_block(
num_channels * i + input_channels, num_channels))
self.net = nn.Sequential(*layer)
def forward(self, X):
for blk in self.net:
Y = blk(X)
# Конкатенируем входы и выходы каждого блока по измерению каналов
X = torch.cat((X, Y), dim=1)
return X
TensorFlow:
class DenseBlock(tf.keras.layers.Layer):
def __init__(self, num_convs, num_channels):
super(DenseBlock, self).__init__()
self.listLayers = []
for _ in range(num_convs):
self.listLayers.append(ConvBlock(num_channels))
def call(self, x):
for layer in self.listLayers.layers:
x = layer(x)
return x
PaddlePaddle:
class DenseBlock(nn.Layer):
def __init__(self, num_convs, input_channels, num_channels):
super(DenseBlock, self).__init__()
layer = []
for i in range(num_convs):
layer.append(
conv_block(num_channels * i + input_channels, num_channels))
self.net = nn.Sequential(*layer)
def forward(self, X):
for blk in self.net:
Y = blk(X)
# Конкатенируем входы и выходы каждого блока по измерению каналов
X = paddle.concat(x=[X, Y], axis=1)
return X
В следующем примере мы определяем DenseBlock с 2 свёрточными блоками по 10 выходных каналов.
При входе с 3 каналами получаем выход с каналами. Число выходных каналов свёрточного блока определяет, насколько вырастает число каналов по сравнению с входом, поэтому его называют темпом роста (growth rate).
MXNet:
blk = DenseBlock(2, 10)
blk.initialize()
X = np.random.uniform(size=(4, 3, 8, 8))
Y = blk(X)
Y.shape
PyTorch:
blk = DenseBlock(2, 3, 10)
X = torch.randn(4, 3, 8, 8)
Y = blk(X)
Y.shape
TensorFlow:
blk = DenseBlock(2, 10)
X = tf.random.uniform((4, 8, 8, 3))
Y = blk(X)
Y.shape
PaddlePaddle:
blk = DenseBlock(2, 3, 10)
X = paddle.randn([4, 3, 8, 8])
Y = blk(X)
Y.shape
7.7.3 Переходный слой
Поскольку каждый плотный блок увеличивает число каналов, при большом их количестве модель становится слишком сложной. Переходный слой как раз и позволяет управлять сложностью модели. Он уменьшает число каналов свёрточным слоем и вдвое уменьшает высоту и ширину с помощью слоя среднего пулинга с шагом 2, что дополнительно снижает сложность модели.
MXNet:
def transition_block(num_channels):
blk = nn.Sequential()
blk.add(nn.BatchNorm(), nn.Activation('relu'),
nn.Conv2D(num_channels, kernel_size=1),
nn.AvgPool2D(pool_size=2, strides=2))
return blk
PyTorch:
def transition_block(input_channels, num_channels):
return nn.Sequential(
nn.BatchNorm2d(input_channels), nn.ReLU(),
nn.Conv2d(input_channels, num_channels, kernel_size=1),
nn.AvgPool2d(kernel_size=2, stride=2))
TensorFlow:
class TransitionBlock(tf.keras.layers.Layer):
def __init__(self, num_channels, **kwargs):
super(TransitionBlock, self).__init__(**kwargs)
self.batch_norm = tf.keras.layers.BatchNormalization()
self.relu = tf.keras.layers.ReLU()
self.conv = tf.keras.layers.Conv2D(num_channels, kernel_size=1)
self.avg_pool = tf.keras.layers.AvgPool2D(pool_size=2, strides=2)
def call(self, x):
x = self.batch_norm(x)
x = self.relu(x)
x = self.conv(x)
return self.avg_pool(x)
PaddlePaddle:
def transition_block(input_channels, num_channels):
return nn.Sequential(
nn.BatchNorm2D(input_channels), nn.ReLU(),
nn.Conv2D(input_channels, num_channels, kernel_size=1),
nn.AvgPool2D(kernel_size=2, stride=2))
Применим переходный слой с 10 выходными каналами к выходу плотного блока из предыдущего примера. Число выходных каналов уменьшится до 10, а высота и ширина уменьшатся вдвое.
MXNet:
blk = transition_block(10)
blk.initialize()
blk(Y).shape
PyTorch, PaddlePaddle:
blk = transition_block(23, 10)
blk(Y).shape
TensorFlow:
blk = TransitionBlock(10)
blk(Y).shape
7.7.4 Модель DenseNet
Построим модель DenseNet. Сначала DenseNet использует такой же одиночный свёрточный слой и слой максимального пулинга, как и ResNet.
MXNet:
net = nn.Sequential()
net.add(nn.Conv2D(64, kernel_size=7, strides=2, padding=3),
nn.BatchNorm(), nn.Activation('relu'),
nn.MaxPool2D(pool_size=3, strides=2, padding=1))
PyTorch:
b1 = nn.Sequential(
nn.Conv2d(1, 64, kernel_size=7, stride=2, padding=3),
nn.BatchNorm2d(64), nn.ReLU(),
nn.MaxPool2d(kernel_size=3, stride=2, padding=1))
TensorFlow:
def block_1():
return tf.keras.Sequential([
tf.keras.layers.Conv2D(64, kernel_size=7, strides=2, padding='same'),
tf.keras.layers.BatchNormalization(),
tf.keras.layers.ReLU(),
tf.keras.layers.MaxPool2D(pool_size=3, strides=2, padding='same')])
PaddlePaddle:
b1 = nn.Sequential(
nn.Conv2D(1, 64, kernel_size=7, stride=2, padding=3),
nn.BatchNorm2D(64), nn.ReLU(),
nn.MaxPool2D(kernel_size=3, stride=2, padding=1))
Далее, аналогично четырём остаточным блокам ResNet, DenseNet использует четыре плотных блока. Как и в ResNet, можно задать число свёрточных слоёв в каждом плотном блоке. Здесь зададим 4, чтобы соответствовать ResNet-18 из раздела 7.6. Число выходных каналов свёрточных слоёв в плотном блоке (то есть темп роста) зададим равным 32, поэтому каждый плотный блок будет добавлять 128 каналов.
Между модулями ResNet уменьшает высоту и ширину остаточными блоками с шагом 2, тогда как DenseNet использует переходные слои, которые вдвое уменьшают и высоту, и ширину, и число каналов.
MXNet:
# num_channels — текущее число каналов
num_channels, growth_rate = 64, 32
num_convs_in_dense_blocks = [4, 4, 4, 4]
for i, num_convs in enumerate(num_convs_in_dense_blocks):
net.add(DenseBlock(num_convs, growth_rate))
# Число выходных каналов предыдущего плотного блока
num_channels += num_convs * growth_rate
# Между плотными блоками добавляем переходный слой, который уменьшает число каналов вдвое
if i != len(num_convs_in_dense_blocks) - 1:
num_channels //= 2
net.add(transition_block(num_channels))
PyTorch:
# num_channels — текущее число каналов
num_channels, growth_rate = 64, 32
num_convs_in_dense_blocks = [4, 4, 4, 4]
blks = []
for i, num_convs in enumerate(num_convs_in_dense_blocks):
blks.append(DenseBlock(num_convs, num_channels, growth_rate))
# Число выходных каналов предыдущего плотного блока
num_channels += num_convs * growth_rate
# Между плотными блоками добавляем переходный слой, который уменьшает число каналов вдвое
if i != len(num_convs_in_dense_blocks) - 1:
blks.append(transition_block(num_channels, num_channels // 2))
num_channels = num_channels // 2
TensorFlow:
def block_2():
net = block_1()
# num_channels — текущее число каналов
num_channels, growth_rate = 64, 32
num_convs_in_dense_blocks = [4, 4, 4, 4]
for i, num_convs in enumerate(num_convs_in_dense_blocks):
net.add(DenseBlock(num_convs, growth_rate))
# Число выходных каналов предыдущего плотного блока
num_channels += num_convs * growth_rate
# Между плотными блоками добавляем переходный слой, который уменьшает число каналов вдвое
if i != len(num_convs_in_dense_blocks) - 1:
num_channels //= 2
net.add(TransitionBlock(num_channels))
return net
PaddlePaddle:
# num_channels — текущее число каналов
num_channels, growth_rate = 64, 32
num_convs_in_dense_blocks = [4, 4, 4, 4]
blks = []
for i, num_convs in enumerate(num_convs_in_dense_blocks):
blks.append(DenseBlock(num_convs, num_channels, growth_rate))
# Число выходных каналов предыдущего плотного блока
num_channels += num_convs * growth_rate
# Между плотными блоками добавляем переходный слой, который уменьшает число каналов вдвое
if i != len(num_convs_in_dense_blocks) - 1:
blks.append(transition_block(num_channels, num_channels // 2))
num_channels = num_channels // 2
Как и в ResNet, в конце добавляем слой глобального среднего пулинга и полносвязный слой для вывода результата.
MXNet:
net.add(nn.BatchNorm(),
nn.Activation('relu'),
nn.GlobalAvgPool2D(),
nn.Dense(10))
PyTorch:
net = nn.Sequential(
b1, *blks,
nn.BatchNorm2d(num_channels), nn.ReLU(),
nn.AdaptiveAvgPool2d((1, 1)),
nn.Flatten(),
nn.Linear(num_channels, 10))
TensorFlow:
def net():
net = block_2()
net.add(tf.keras.layers.BatchNormalization())
net.add(tf.keras.layers.ReLU())
net.add(tf.keras.layers.GlobalAvgPool2D())
net.add(tf.keras.layers.Flatten())
net.add(tf.keras.layers.Dense(10))
return net
PaddlePaddle:
net = nn.Sequential(
b1, *blks,
nn.BatchNorm2D(num_channels), nn.ReLU(),
nn.AdaptiveMaxPool2D((1, 1)),
nn.Flatten(),
nn.Linear(num_channels, 10))
7.7.5 Обучение модели
Поскольку здесь используется достаточно глубокая сеть, в этом разделе мы уменьшаем высоту и ширину входа с 224 до 96, чтобы упростить вычисления.
lr, num_epochs, batch_size = 0.1, 10, 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size, resize=96)
d2l.train_ch6(net, train_iter, test_iter, num_epochs, lr, d2l.try_gpu())
Резюме
- В отличие от ResNet, где вход и выход складываются, плотно связанная сеть (DenseNet) конкатенирует вход и выход по измерению каналов.
- Основные строительные блоки DenseNet — плотные блоки и переходные слои.
- При построении DenseNet нужно добавлять переходные слои, которые управляют размерностью сети и снова уменьшают число каналов.
Упражнения
- Почему в переходном слое мы используем средний пулинг, а не максимальный?
- Одно из достоинств DenseNet в том, что её параметров меньше, чем у ResNet. Почему так?
- Один из недостатков DenseNet — чрезмерное потребление памяти (оперативной или видеопамяти GPU).
- Так ли это на самом деле? Попробуйте заменить форму входа на и посмотрите на фактическое потребление памяти GPU.
- Есть ли другой способ уменьшить потребление памяти GPU? Нужно ли для этого менять фреймворк?
- Реализуйте различные версии DenseNet, показанные в таблице 1 статьи о DenseNet (Huang et al., 2017).
- Примените идеи DenseNet для проектирования модели на основе многослойного перцептрона. Примените её к задаче прогнозирования цен на жильё из раздела 4.10.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Huang, G., Liu, Z., Van Der Maaten, L., & Weinberger, K. Q. (2017). Densely connected convolutional networks. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 4700–4708.
8. Рекуррентные нейронные сети
До сих пор мы встречались с двумя типами данных: табличными данными и данными изображений. Для изображений мы разработали специальные архитектуры свёрточных нейронных сетей, которые учитывают структуру таких данных. Иными словами, если у нас есть изображение, нужно эффективно использовать положение его пикселей: если переставить пиксели, понять содержание изображения станет очень трудно.
Главное, до сих пор мы по умолчанию считали, что данные порождаются некоторым распределением и что все примеры независимы и одинаково распределены (independently and identically distributed, i.i.d.). Однако большинство данных устроено иначе. Например, слова в статье записаны в определённом порядке: если их случайно переставить, исходный смысл текста будет трудно восстановить. Кадры видео, аудиосигнал в разговоре и поведение пользователей на сайте тоже упорядочены во времени. Поэтому для таких данных имеет смысл строить специальные модели, которые, скорее всего, будут работать лучше.
Есть и другая проблема: от нас может требоваться не просто обработать последовательность на входе, а продолжить её, то есть угадать, что будет дальше. Например, задача может состоять в том, чтобы продолжить последовательность . Такая задача типична для анализа временных рядов: с их помощью прогнозируют колебания фондового рынка, температурные кривые пациентов или ускорение, которое нужно гоночному автомобилю. Для работы с такими данными тоже нужны специальные модели.
Коротко говоря, если свёрточные нейронные сети эффективно работают с пространственной информацией, то рекуррентные нейронные сети (recurrent neural network, RNN), о которых пойдёт речь в этой главе, лучше справляются с последовательной информацией. Рекуррентная сеть вводит переменную состояния, которая хранит информацию о прошлом вместе с текущим входом, и благодаря ей определяет текущий выход.
Многие примеры использования рекуррентных сетей связаны с текстовыми данными, поэтому в этой главе мы особенно подробно рассмотрим языковые модели. После более подробного обзора последовательных данных мы познакомимся с практическими приёмами предобработки текста. Затем обсудим базовые понятия языковых моделей, которые послужат основой для проектирования рекуррентных сетей. Наконец, опишем способ вычисления градиентов в рекуррентных сетях, чтобы разобраться в проблемах, с которыми можно столкнуться при обучении таких моделей.
8.1 Модели последовательностей
Представьте, что кто-то смотрит фильмы на Netflix (международном видеосервисе). Преданный пользователь оценивает каждый фильм, ведь хороший фильм заслуживает поддержки и признания. Однако на деле всё не так просто. Со временем мнение людей о фильмах сильно меняется. Психологи даже дали названия этим явлениям:
- эффект привязки (anchoring): оценка формируется на основе мнений других людей. Например, после церемонии «Оскар» оценки фильма, оказавшегося в центре внимания, растут, хотя сам фильм остаётся прежним. Этот эффект сохраняется несколько месяцев, пока люди не забудут о наградах, которые получил фильм. Результаты показывают (Wu et al., 2017), что такой эффект повышает оценки больше чем на полпроцента.
- гедонистическая адаптация (hedonic adaptation): люди быстро принимают более хорошую или более плохую ситуацию и привыкают к ней как к новой норме. Например, посмотрев много хороших фильмов, люди начинают сильно ожидать, что следующий будет ещё лучше. Поэтому после множества выдающихся фильмов даже обычный может показаться плохим.
- сезонность (seasonality): мало кто любит смотреть фильмы про Санта-Клауса в августе.
- Иногда фильм становится непопулярным из-за недостойного поведения режиссёра или актёров во время съёмок.
- Некоторые фильмы становятся культовыми лишь потому, что они крайне плохи. Именно поэтому печально известны Plan 9 from Outer Space и Troll 2.
Короче говоря, оценки фильмов никогда не бывают постоянными. Поэтому учёт временной динамики может дать более точные рекомендации фильмов (Koren, 2009). Разумеется, последовательные данные — это не только оценки фильмов. Ниже приведено ещё несколько ситуаций.
- При работе с программами у многих пользователей складываются устойчивые привычки. Например, после школы социальные сети пользуются большей популярностью, а торговые приложения для акций чаще открывают в часы работы биржи.
- Предсказать завтрашнюю цену акции труднее, чем угадать цену по уже известным данным, хотя в обоих случаях мы оцениваем всего одно число. В конце концов, задним умом все крепки. В статистике предсказание за пределами известного диапазона наблюдений называют экстраполяцией (extrapolation), а оценку между уже имеющимися наблюдениями — интерполяцией (interpolation).
- По своей природе музыка, речь, текст и видео непрерывны. Если переставить их последовательность, исходный смысл будет утрачен. Например, заголовок «Собака укусила человека» звучит гораздо менее удивительно, чем «Человек укусил собаку», хотя состав слов в обоих предложениях одинаков.
- Землетрясения обладают сильной взаимосвязью: после сильного землетрясения часто следуют несколько слабых афтершоков, и их сила значительно выше, чем у афтершоков после слабых толчков. Более того, землетрясения связаны в пространстве и времени: афтершоки обычно происходят в пределах короткого промежутка времени и на небольшом расстоянии.
- Взаимодействие между людьми тоже непрерывно, что видно по спорам и дискуссиям в микроблогах.
8.1.1 Статистические инструменты
Для работы с последовательными данными нужны статистические инструменты и новые архитектуры глубоких нейронных сетей. Для простоты возьмём в качестве примера цены акций (индекс FTSE 100), показанные на рис. 8.1.1.
Рис. 8.1.1. Индекс FTSE 100 за последние 30 лет
Обозначим цену через : это цена, наблюдаемая на временном шаге (time step) . Заметьте, что в этой книге для последовательностей обычно дискретно и принимает целые значения или их подмножество. Предположим, что трейдер хочет успешно торговать на фондовом рынке в день , и поэтому прогнозирует по следующему соотношению:
8.1.1.1 Авторегрессионные модели
Для такого прогноза трейдер может использовать регрессионную модель, например ту, которую мы обучали в разделе 3.3. Есть лишь одна основная проблема: количество входных данных, то есть , зависит от . Иначе говоря, количество входов растёт вместе с объёмом накопленных данных, поэтому нужна приближённая схема, которая делает вычисления выполнимыми. Большая часть этой главы посвящена тому, как эффективно оценивать . В простейшем виде это сводится к двум стратегиям.
Первая стратегия состоит в том, что в реальных условиях очень длинная последовательность , вероятно, не нужна. Поэтому достаточно ограничиться временным окном длины , то есть использовать наблюдения . Самое очевидное преимущество такого подхода в том, что число параметров остаётся постоянным, по крайней мере при , и это позволяет обучать глубокую сеть, о которой мы говорили выше. Такие модели называют авторегрессионными, потому что они выполняют регрессию на самих себя.
Вторая стратегия, показанная на рис. 8.1.2, состоит в том, чтобы сохранять некоторую сводку прошлых наблюдений и одновременно обновлять и предсказание , и сводку . Так получается модель, которая оценивает по соотношению и обновляет по формуле . Поскольку никогда не наблюдается, такие модели называют скрытыми авторегрессионными моделями (latent autoregressive models).
Рис. 8.1.2. Скрытая авторегрессионная модель
В обоих случаях возникает очевидный вопрос: как получить обучающие данные? Классический подход — использовать исторические наблюдения, чтобы предсказывать следующее будущее наблюдение. Очевидно, что время не стоит на месте. Однако обычно предполагают, что хотя конкретные значения могут меняться, сама динамика последовательности не меняется. Такое допущение разумно, потому что новая динамика определяется новыми данными, а по имеющимся данным предсказать новую динамику нельзя. Статистики называют неизменную динамику стационарной (stationary). Поэтому оценку всей последовательности получают следующим образом:
Заметим, что приведённые рассуждения остаются верными, если мы имеем дело с дискретными объектами (например, словами), а не с непрерывными числами. Единственное отличие в том, что для дискретных объектов для оценки нужно использовать классификатор, а не регрессионную модель.
8.1.1.2 Марковские модели
Вспомним, что в авторегрессионном приближении для оценки мы используем вместо . Если такое приближение достаточно точно, говорят, что последовательность удовлетворяет марковскому условию (Markov condition). В частности, при получаем марковскую модель первого порядка (first-order Markov model), в которой задаётся формулой
Такая модель особенно удобна, когда принимает только дискретные значения: тогда с помощью динамического программирования результат можно точно вычислить вдоль марковской цепи. Например, мы можем эффективно вычислить :
Благодаря этому факту достаточно учитывать очень короткую предысторию в прошлых наблюдениях: . Динамическое программирование для скрытых марковских моделей выходит за рамки этого раздела (мы встретимся с ним в разделе 9.4), а инструменты динамического программирования широко используются в алгоритмах управления и обучения с подкреплением.
8.1.1.3 Причинность
В принципе, разложение в обратном порядке тоже допустимо. В самом деле, из формулы условной вероятности всегда следует:
Более того, если исходить из марковской модели, можно получить и обратное условное распределение. Однако во многих случаях у данных есть естественное направление: время идёт вперёд. Очевидно, что будущие события не могут влиять на прошлое. Поэтому, если мы изменим , это может повлиять на то, что случится в будущем, , но не наоборот. Иначе говоря, если мы изменим , распределение, основанное на прошлых событиях, не изменится. Поэтому объяснить обычно проще, чем . Например, в некоторых случаях для некоторого аддитивного шума можно найти , тогда как обратное представление невозможно (Hoyer et al., 2009). И именно это направление вперёд обычно и представляет для нас интерес. Питерс и соавторы (Peters et al., 2017) подробно излагают эту тему; наше обсуждение лишь слегка затрагивает эту тему.
8.1.2 Обучение
Теперь, когда мы познакомились со статистическими инструментами, попробуем применить их на практике! Сначала сгенерируем данные: используем синусоиду с аддитивным шумом, чтобы получить последовательность с временными шагами .
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, np, npx, gluon, init
from mxnet.gluon import nn
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
from torch import nn
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
MXNet, PyTorch, PaddlePaddle:
T = 1000 # Всего генерируем 1000 точек
time = d2l.arange(1, T + 1, dtype=d2l.float32)
x = d2l.sin(0.01 * time) + d2l.normal(0, 0.2, (T,))
d2l.plot(time, [x], 'время', 'x', xlim=[1, 1000], figsize=(6, 3))
TensorFlow:
T = 1000 # Всего генерируем 1000 точек
time = d2l.arange(1, T + 1, dtype=d2l.float32)
x = d2l.sin(0.01 * time) + d2l.normal([T], 0, 0.2)
d2l.plot(time, [x], 'время', 'x', xlim=[1, 1000], figsize=(6, 3))
Далее преобразуем последовательность в пары «признаки — метка» для модели. С помощью размера вложения построим пары данных и . Получится на примеров меньше, поскольку для первых значений у нас нет достаточной истории. Простое решение — отбросить эти первые примеры, если последовательность достаточно длинна; другой вариант — дополнить последовательность нулями. Здесь для обучения мы используем только первые 600 пар «признаки — метка».
MXNet, PyTorch, PaddlePaddle:
tau = 4
features = d2l.zeros((T - tau, tau))
for i in range(tau):
features[:, i] = x[i: T - tau + i]
labels = d2l.reshape(x[tau:], (-1, 1))
TensorFlow:
tau = 4
features = tf.Variable(d2l.zeros((T - tau, tau)))
for i in range(tau):
features[:, i].assign(x[i: T - tau + i])
labels = d2l.reshape(x[tau:], (-1, 1))
batch_size, n_train = 16, 600
# Для обучения используются только первые n_train примеров
train_iter = d2l.load_array((features[:n_train], labels[:n_train]),
batch_size, is_train=True)
Здесь мы обучаем модель с довольно простой архитектурой: многослойный перцептрон с двумя полносвязными слоями, функцией активации ReLU и квадратичной функцией потерь.
MXNet:
# Простой многослойный перцептрон
def get_net():
net = nn.Sequential()
net.add(nn.Dense(10, activation='relu'),
nn.Dense(1))
net.initialize(init.Xavier())
return net
# Квадратичная функция потерь
loss = gluon.loss.L2Loss()
PyTorch:
# Функция инициализации весов сети
def init_weights(m):
if type(m) == nn.Linear:
nn.init.xavier_uniform_(m.weight)
# Простой многослойный перцептрон
def get_net():
net = nn.Sequential(nn.Linear(4, 10),
nn.ReLU(),
nn.Linear(10, 1))
net.apply(init_weights)
return net
# Квадратичная функция потерь. Замечание: MSELoss вычисляет квадрат ошибки без множителя 1/2
loss = nn.MSELoss(reduction='none')
TensorFlow:
# Простой многослойный перцептрон
def get_net():
net = tf.keras.Sequential([tf.keras.layers.Dense(10, activation='relu'),
tf.keras.layers.Dense(1)])
return net
# Среднеквадратичная функция потерь. Замечание: MeanSquaredError вычисляет квадрат ошибки без множителя 1/2
loss = tf.keras.losses.MeanSquaredError()
PaddlePaddle:
def init_weights(m):
if type(m) == nn.Linear:
nn.initializer.XavierUniform(m.weight)
# Простой многослойный перцептрон
def get_net():
net = nn.Sequential(nn.Linear(4, 10),
nn.ReLU(),
nn.Linear(10, 1))
net.apply(init_weights)
return net
# Квадратичная функция потерь. Замечание: MSELoss вычисляет квадрат ошибки без множителя 1/2
loss = nn.MSELoss(reduction='none')
Теперь обучим модель. Код обучения строится так же, как в предыдущих разделах (например, в разделе 3.3), поэтому мы не будем вдаваться в подробности.
MXNet:
def train(net, train_iter, loss, epochs, lr):
trainer = gluon.Trainer(net.collect_params(), 'adam',
{'learning_rate': lr})
for epoch in range(epochs):
for X, y in train_iter:
with autograd.record():
l = loss(net(X), y)
l.backward()
trainer.step(batch_size)
print(f'эпоха {epoch + 1}, '
f'потери {d2l.evaluate_loss(net, train_iter, loss):f}')
net = get_net()
train(net, train_iter, loss, 5, 0.01)
PyTorch:
def train(net, train_iter, loss, epochs, lr):
trainer = torch.optim.Adam(net.parameters(), lr)
for epoch in range(epochs):
for X, y in train_iter:
trainer.zero_grad()
l = loss(net(X), y)
l.sum().backward()
trainer.step()
print(f'эпоха {epoch + 1}, '
f'потери {d2l.evaluate_loss(net, train_iter, loss):f}')
net = get_net()
train(net, train_iter, loss, 5, 0.01)
TensorFlow:
def train(net, train_iter, loss, epochs, lr):
trainer = tf.keras.optimizers.Adam()
for epoch in range(epochs):
for X, y in train_iter:
with tf.GradientTape() as g:
out = net(X)
l = loss(y, out)
params = net.trainable_variables
grads = g.gradient(l, params)
trainer.apply_gradients(zip(grads, params))
print(f'эпоха {epoch + 1}, '
f'потери {d2l.evaluate_loss(net, train_iter, loss):f}')
net = get_net()
train(net, train_iter, loss, 5, 0.01)
PaddlePaddle:
def train(net, train_iter, loss, epochs, lr):
trainer = paddle.optimizer.Adam(learning_rate=lr, parameters=net.parameters())
for epoch in range(epochs):
for i,(X, y) in enumerate (train_iter()):
trainer.clear_grad()
l = loss(net(X), y)
l.sum().backward()
trainer.step()
print(f'эпоха {epoch + 1}, '
f'потери {d2l.evaluate_loss(net, train_iter, loss):f}')
net = get_net()
train(net, train_iter, loss, 5, 0.01)
8.1.3 Предсказание
Поскольку ошибка обучения очень мала, мы ожидаем, что модель будет хорошо работать. Посмотрим, что это означает на практике. Прежде всего проверим способность модели предсказывать следующий временной шаг, то есть одношаговое предсказание (one-step-ahead prediction).
onestep_preds = net(features)
d2l.plot([time, time[tau:]],
[d2l.numpy(x), d2l.numpy(onestep_preds)], 'время',
'x', legend=['данные', 'одношаговые предсказания'], xlim=[1, 1000],
figsize=(6, 3))
Как и ожидалось, одношаговое предсказание работает неплохо.
Даже когда предсказания выходят за пределы (n_train + tau), их результат выглядит правдоподобно.
Однако есть небольшая проблема: если наблюдения заканчиваются на шаге , нам приходится двигаться вперёд шаг за шагом:
Обычно для наблюдений до предсказание на временном шаге , обозначаемое , называют -шаговым предсказанием (-step-ahead prediction). Поскольку наши наблюдения дошли до , его -шаговое предсказание равно . Иначе говоря, для многошагового предсказания нам приходится использовать собственные предсказания, а не исходные данные. Посмотрим, что получится.
MXNet, PyTorch:
multistep_preds = d2l.zeros(T)
multistep_preds[: n_train + tau] = x[: n_train + tau]
for i in range(n_train + tau, T):
multistep_preds[i] = net(
d2l.reshape(multistep_preds[i - tau: i], (1, -1)))
TensorFlow:
multistep_preds = tf.Variable(d2l.zeros(T))
multistep_preds[:n_train + tau].assign(x[:n_train + tau])
for i in range(n_train + tau, T):
multistep_preds[i].assign(d2l.reshape(net(
d2l.reshape(multistep_preds[i - tau: i], (1, -1))), ()))
PaddlePaddle:
multistep_preds = d2l.zeros([T])
multistep_preds[: n_train + tau] = x[: n_train + tau]
for i in range(n_train + tau, T):
multistep_preds[i] = net(
d2l.reshape(multistep_preds[i - tau: i], (1, -1)))
d2l.plot([time, time[tau:], time[n_train + tau:]],
[d2l.numpy(x), d2l.numpy(onestep_preds),
d2l.numpy(multistep_preds[n_train + tau:])], 'время',
'x', legend=['данные', 'одношаговые предсказания', 'многошаговые предсказания'],
xlim=[1, 1000], figsize=(6, 3))
Как видно из примера выше, зелёная линия предсказаний явно не идеальна. После нескольких шагов предсказания очень быстро затухают до константы. Почему этот алгоритм работает так плохо? Причина в накоплении ошибок. Предположим, что после шага мы накопили ошибку . Тогда вход на шаге оказывается возмущён на , и накопленная ошибка становится , где — некоторая константа; аналогично ведут себя и последующие ошибки предсказания. Поэтому ошибка может довольно быстро уводить предсказание от истинных наблюдений. Например, прогноз погоды на следующие 24 часа обычно довольно точен, но дальше точность быстро падает. Мы обсудим, как это улучшить, в этой и следующих главах.
Теперь, основываясь на и вычислив предсказания для всей последовательности, внимательнее рассмотрим трудности -шагового предсказания.
max_steps = 64
MXNet, PyTorch:
features = d2l.zeros((T - tau - max_steps + 1, tau + max_steps))
# Столбец i (i < tau) — наблюдения из x, временные шаги от (i) до (i+T-tau-max_steps+1)
for i in range(tau):
features[:, i] = x[i: i + T - tau - max_steps + 1]
# Столбец i (i >= tau) — предсказания с шага (i-tau+1), временные шаги от (i) до (i+T-tau-max_steps+1)
for i in range(tau, tau + max_steps):
features[:, i] = d2l.reshape(net(features[:, i - tau: i]), -1)
TensorFlow:
features = tf.Variable(d2l.zeros((T - tau - max_steps + 1, tau + max_steps)))
# Столбец i (i < tau) — наблюдения из x, временные шаги от (i) до (i+T-tau-max_steps+1)
for i in range(tau):
features[:, i].assign(x[i: i + T - tau - max_steps + 1].numpy())
# Столбец i (i >= tau) — предсказания с шага (i-tau+1), временные шаги от (i) до (i+T-tau-max_steps+1)
for i in range(tau, tau + max_steps):
features[:, i].assign(d2l.reshape(net((features[:, i - tau: i])), -1))
PaddlePaddle:
features = d2l.zeros((T - tau - max_steps + 1, tau + max_steps))
# Столбец i (i < tau) — наблюдения из x, временные шаги от (i+1) до (i+T-tau-max_steps+1)
for i in range(tau):
features[:, i] = x[i: i + T - tau - max_steps + 1]
# Столбец i (i >= tau) — предсказания с шага (i-tau+1), временные шаги от (i+1) до (i+T-tau-max_steps+1)
for i in range(tau, tau + max_steps):
features[:, i] = d2l.reshape(net(features[:, i - tau: i]), [-1])
steps = (1, 4, 16, 64)
d2l.plot([time[tau + i - 1: T - max_steps + i] for i in steps],
[d2l.numpy(features[:, tau + i - 1]) for i in steps], 'время', 'x',
legend=[f'{i}-шаговые предсказания' for i in steps], xlim=[5, 1000],
figsize=(6, 3))
Приведённый пример ясно показывает, как меняется качество предсказаний по мере того, как мы пытаемся заглянуть дальше в будущее. Хотя «-шаговое предсказание» всё ещё выглядит неплохо, любое предсказание дальше этого горизонта почти бесполезно.
Резюме
- Интерполяция (оценка между уже имеющимися наблюдениями) и экстраполяция (предсказание за пределами известных наблюдений) на практике значительно различаются по сложности. Поэтому при работе с последовательными данными во время обучения всегда нужно соблюдать их временной порядок, то есть лучше не обучать модель на будущих данных.
- Для оценки моделей последовательностей нужны специальные статистические инструменты; два распространённых выбора — авторегрессионные модели и скрытые авторегрессионные модели.
- Для причинных моделей, в которых время движется вперёд, прямая оценка обычно проще обратной.
- Для последовательности наблюдений до временного шага предсказание на шаге называют «-шаговым предсказанием». По мере увеличения ошибки быстро накапливаются, и качество предсказаний стремительно падает.
Упражнения
- Улучшите модель из этого раздела.
- Попробуйте использовать больше четырёх прошлых наблюдений. Сколько их нужно для получения точного результата?
- Сколько прошлых наблюдений понадобилось бы без шума? Подсказка: запишите и как решения дифференциального уравнения.
- Можно ли объединить старые наблюдения, сохранив общее число признаков? Может ли это повысить точность? Почему?
- Измените архитектуру нейронной сети и оцените её качество.
- Инвестор хочет найти хорошую ценную бумагу для покупки. Он смотрит на прошлую доходность, чтобы решить, какая из них, вероятно, покажет хорошие результаты. Что может пойти не так в этой стратегии?
- В какой мере модель причинного характера, в которой время движется вперёд, подходит для текста?
- Приведите пример, когда для описания динамики данных может понадобиться скрытая авторегрессионная модель.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Koren, Y. (2009). Collaborative filtering with temporal dynamics. Proceedings of the 15th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 447–456.
- Hoyer, P. O., Janzing, D., Mooij, J. M., Peters, J., & Schölkopf, B. (2009). Nonlinear causal discovery with additive noise models. Advances in Neural Information Processing Systems, 689–696.
- Peters, J., Janzing, D., & Schölkopf, B. (2017). Elements of causal inference: Foundations and learning algorithms. MIT Press.
- Wu, C.-Y., Ahmed, A., Beutel, A., Smola, A. J., & Jing, H. (2017). Recurrent recommender networks. Proceedings of the Tenth ACM International Conference on Web Search and Data Mining, 495–503.
8.2 Предобработка текста
В разделе 8.1 мы рассмотрели статистические инструменты, которые нужны для работы с последовательными данными, и трудности, возникающие при предсказании. Такие данные встречаются во многих формах, и текст — один из самых распространённых примеров. Например, статью можно рассматривать как последовательность слов или даже как последовательность символов. В этом разделе мы разберём типичные шаги предобработки текста. Обычно они включают следующее:
- загрузку текста в память в виде строк;
- разбиение строк на токены (например, на слова или символы);
- построение словаря, который сопоставляет разбитые токены с числовыми индексами;
- преобразование текста в последовательности числовых индексов, с которыми может работать модель.
MXNet:
import collections
from d2l import mxnet as d2l
import re
PyTorch:
import collections
from d2l import torch as d2l
import re
TensorFlow:
import collections
from d2l import tensorflow as d2l
import re
PaddlePaddle:
import collections
from d2l import paddle as d2l
import re
8.2.1 Чтение набора данных
Для начала загрузим текст книги Герберта Уэллса «Машина времени». Это довольно небольшой корпус: в нём немногим более 30 000 слов. Для первых экспериментов его достаточно, тогда как реальные коллекции документов могут содержать миллиарды слов. Функция ниже считывает набор данных в список строк текста. Для простоты мы здесь не учитываем знаки препинания и регистр букв.
#@save
d2l.DATA_HUB['time_machine'] = (d2l.DATA_URL + 'timemachine.txt',
'090b5e7e70c295757f55df93cb0a180b9691891a')
def read_time_machine(): #@save
"""Загружает набор данных «Машина времени» в список текстовых строк"""
with open(d2l.download('time_machine'), 'r') as f:
lines = f.readlines()
return [re.sub('[^A-Za-z]+', ' ', line).strip().lower() for line in lines]
lines = read_time_machine()
print(f'# Общее число строк текста: {len(lines)}')
print(lines[0])
print(lines[10])
8.2.2 Токенизация
Функция tokenize ниже принимает на вход список текстовых строк lines, каждый элемент которого — отдельная текстовая последовательность (например, одна строка текста).
Каждая текстовая последовательность разбивается на список токенов. Токен (token) — это базовая единица текста.
В итоге функция возвращает список списков токенов, где каждый токен является строкой.
def tokenize(lines, token='word'): #@save
"""Разбивает строки текста на токены-слова или токены-символы"""
if token == 'word':
return [line.split() for line in lines]
elif token == 'char':
return [list(line) for line in lines]
else:
print('ошибка: неизвестный тип токена: ' + token)
tokens = tokenize(lines)
for i in range(11):
print(tokens[i])
8.2.3 Словарь
Токены имеют строковый тип, а модели на вход нужны числа.
Теперь построим словарь (vocabulary), который сопоставляет строковые токены с числовыми индексами, начиная с .
Для этого мы сначала объединяем все документы обучающего набора, подсчитываем уникальные токены и получаем статистику, которую называют корпусом (corpus).
Затем каждому уникальному токену присваиваем числовой индекс в соответствии с частотой его появления.
Очень редкие токены обычно удаляют, чтобы снизить сложность.
Кроме того, любой токен, который отсутствует в корпусе или был удалён, отображается в специальный неизвестный токен «<unk>».
При желании можно добавить список зарезервированных токенов, например:
токен заполнения «<pad>»,
токен начала последовательности «<bos>»,
токен конца последовательности «<eos>».
class Vocab: #@save
"""Словарь текста"""
def __init__(self, tokens=None, min_freq=0, reserved_tokens=None):
if tokens is None:
tokens = []
if reserved_tokens is None:
reserved_tokens = []
# Сортировка по частоте появления
counter = count_corpus(tokens)
self._token_freqs = sorted(counter.items(), key=lambda x: x[1],
reverse=True)
# Индекс неизвестного токена равен 0
self.idx_to_token = ['<unk>'] + reserved_tokens
self.token_to_idx = {token: idx
for idx, token in enumerate(self.idx_to_token)}
for token, freq in self._token_freqs:
if freq < min_freq:
break
if token not in self.token_to_idx:
self.idx_to_token.append(token)
self.token_to_idx[token] = len(self.idx_to_token) - 1
def __len__(self):
return len(self.idx_to_token)
def __getitem__(self, tokens):
if not isinstance(tokens, (list, tuple)):
return self.token_to_idx.get(tokens, self.unk)
return [self.__getitem__(token) for token in tokens]
def to_tokens(self, indices):
if not isinstance(indices, (list, tuple)):
return self.idx_to_token[indices]
return [self.idx_to_token[index] for index in indices]
@property
def unk(self): # Индекс неизвестного токена равен 0
return 0
@property
def token_freqs(self):
return self._token_freqs
def count_corpus(tokens): #@save
"""Подсчёт частот токенов"""
# Здесь tokens — одномерный или двумерный список
if len(tokens) == 0 or isinstance(tokens[0], list):
# Превращаем список списков токенов в один список
tokens = [token for line in tokens for token in line]
return collections.Counter(tokens)
Построим словарь на основе набора данных «Машина времени» и выведем первые самые частые токены и их индексы.
vocab = Vocab(tokens)
print(list(vocab.token_to_idx.items())[:10])
Теперь мы можем преобразовать каждую строку текста в список числовых индексов.
for i in [0, 10]:
print('текст:', tokens[i])
print('индексы:', vocab[tokens[i]])
8.2.4 Собираем всё вместе
Чтобы использовать описанные функции, объединим все шаги в функции load_corpus_time_machine, которая возвращает corpus (список индексов токенов) и vocab (словарь корпуса «Машина времени»).
Здесь мы вносим два изменения по сравнению с предыдущими шагами:
- Чтобы упростить обучение в следующих разделах, мы токенизируем текст по символам, а не по словам;
- Строка набора данных «Машина времени» не обязательно является предложением или абзацем, а иногда может быть одним словом, поэтому возвращаемый
corpus— это один плоский список, а не список списков токенов.
def load_corpus_time_machine(max_tokens=-1): #@save
"""Возвращает список индексов токенов и словарь набора данных «Машина времени»"""
lines = read_time_machine()
tokens = tokenize(lines, 'char')
vocab = Vocab(tokens)
# Строки текста из «Машины времени» не обязательно являются предложениями или абзацами,
# поэтому все строки разворачиваем в один список
corpus = [vocab[token] for line in tokens for token in line]
if max_tokens > 0:
corpus = corpus[:max_tokens]
return corpus, vocab
corpus, vocab = load_corpus_time_machine()
len(corpus), len(vocab)
Резюме
- Текст — один из самых распространённых видов последовательных данных.
- Чтобы предобработать текст, обычно разбивают его на токены, строят словарь, который сопоставляет строковые токены с числовыми индексами, и преобразуют текст в индексы токенов, с которыми может работать модель.
Упражнения
- Токенизация — ключевой шаг предобработки, и она зависит от языка. Попробуйте найти ещё три распространённых способа токенизации текста.
- В экспериментах этого раздела разбейте текст на слова и измените параметр
min_freqэкземпляраVocab. Как это влияет на размер словаря?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
8.3 Языковые модели и набор данных
В разделе 8.2 мы узнали, как преобразовать текстовые данные в токены, которые можно рассматривать как последовательность дискретных наблюдений, например слов или символов. Пусть токены текста длины идут в порядке . Тогда () можно считать наблюдением или меткой текстовой последовательности на временном шаге . Для такой текстовой последовательности цель языковой модели (language model) — оценить совместную вероятность последовательности
Например, идеальная языковая модель, которая выбирает один токен за раз, , могла бы сама генерировать естественный текст. В отличие от обезьяны, которая печатает на пишущей машинке наугад, текст, полученный из такой модели, воспринимается как естественный язык (например, английский). Достаточно опираться на текст предыдущей части диалога, чтобы сгенерировать осмысленную реплику. Однако мы ещё очень далеки от систем, которые так работают, ведь для этого нужно «понимать» текст, а не просто порождать грамматически правильные фразы.
Тем не менее языковые модели очень полезны. Например, фразы «to recognize speech» и «to wreck a nice beach» звучат почти одинаково. Эта похожесть вызывает неоднозначность при распознавании речи, но её легко разрешить с помощью языковой модели, ведь смысл второй фразы странен. Аналогично в алгоритмах автоматического реферирования фраза «собака укусила человека» встречается гораздо чаще, чем «человек укусил собаку»; а фраза «я хочу съесть бабушку» звучит весьма странно, тогда как «я хочу есть, бабушка» — вполне нормально.
8.3.1 Обучение языковых моделей
Очевидно, что перед нами стоит задача моделирования документа или даже последовательности токенов. Предположим, что текст разбит на токены на уровне слов; тогда мы можем опереться на анализ последовательных моделей из раздела 8.1. Начнём с основных правил теории вероятностей:
Например, вероятность текстовой последовательности из четырёх слов равна:
Чтобы обучить языковую модель, нужно вычислить вероятности отдельных слов и условные вероятности появления слова при заданных предыдущих словах. Эти вероятности по сути и являются параметрами языковой модели.
Будем считать, что обучающий набор данных — это большой текстовый корпус. Например, это все статьи Википедии, проект Гутенберг или весь текст, опубликованный в сети. Вероятности слов в обучающем наборе можно вычислить по их относительной частоте. Например, оценку можно вычислить как долю предложений, начинающихся со слова «deep». Немного менее точный способ — подсчитать, сколько раз слово «deep» встречается в наборе данных, и разделить это число на общее количество слов в корпусе. Этот метод хорошо работает, особенно для часто встречающихся слов. Далее мы можем попытаться оценить
где и — количество появлений отдельного слова и пары соседних слов соответственно. К сожалению, пара «deep learning» встречается гораздо реже, поэтому оценить правильную вероятность для таких пар намного труднее. Особенно сложно для необычных сочетаний слов найти достаточное число вхождений, чтобы получить точную оценку. Для троек и более слов ситуация становится ещё хуже. Многие правдоподобные сочетания из трёх слов могут присутствовать в языке, но не встречаться в наборе данных. Если не предложить какое-либо решение, которое присвоит таким сочетаниям ненулевые счётчики, их нельзя будет использовать в языковой модели. Если набор данных мал или слова очень редки, то вероятность встретить такое слово даже один раз может оказаться слишком низкой.
Распространённая стратегия — выполнить некоторую форму сглаживания Лапласа (Laplace smoothing), добавив небольшую константу ко всем счётчикам. Пусть обозначает общее число слов в обучающем наборе, а — число уникальных слов. Это решение помогает в задачах с отдельными словами, например:
Здесь и — гиперпараметры. Возьмём в качестве примера: при сглаживание не применяется; при , стремящемся к бесконечности, приближается к равномерному распределению . Приведённые формулы — довольно простой вариант модели, описанной в (Wood et al., 2011).
Однако такие модели легко становятся неэффективными, по следующим причинам. Во-первых, нам приходится хранить все счётчики. Во-вторых, такой подход полностью игнорирует смысл слов. Например, слова «кот» (cat) и «кошачьи» (feline) могут встречаться в похожих контекстах, но учитывать такие связи в модели, опирающейся на контекст, довольно трудно. Наконец, длинные последовательности слов в основном не встречаются в обучающих данных, поэтому модель, которая просто подсчитывает частоты ранее «увиденных» последовательностей слов, заведомо будет плохо работать на таких примерах.
8.3.2 Марковские модели и -граммы
Прежде чем рассматривать решения с глубоким обучением, нужно ввести ещё несколько понятий и терминов. Вспомним марковские модели, которые мы обсуждали в разделе 8.1, и применим их к языковому моделированию. Если , то распределение на последовательности обладает марковским свойством первого порядка. Чем выше порядок, тем длиннее зависимости. Это свойство приводит ко многим приближённым формулам, которые можно использовать для моделирования последовательностей:
Обычно формулы с одной, двумя и тремя переменными называют соответственно униграммными (unigram), биграммными (bigram) и триграммными (trigram) моделями. Ниже мы узнаем, как строить более удачные модели.
8.3.3 Статистика естественного языка
Посмотрим, как выглядит статистика естественного языка на реальных данных. Построим словарь на основе набора данных «Машина времени», описанного в разделе 8.2, и выведем десять самых употребительных (самых частотных) слов.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
import random
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
import random
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
import random
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import random
tokens = d2l.tokenize(d2l.read_time_machine())
# Строки текста не обязательно являются предложениями или абзацами, поэтому объединяем все строки в один список
corpus = [token for line in tokens for token in line]
vocab = d2l.Vocab(corpus)
vocab.token_freqs[:10]
Как видно, самые популярные слова выглядят довольно скучно. Такие слова обычно называют стоп-словами (stop words), поэтому их можно отфильтровать. Тем не менее они всё же несут смысл, и мы продолжим использовать их в модели. Кроме того, очевидная проблема в том, что частоты слов убывают очень быстро. Например, частота самого частого слова значительно выше, чем у десятого: частота десятого меньше одной пятой частоты первого. Чтобы лучше разобраться, построим график частот слов:
freqs = [freq for token, freq in vocab.token_freqs]
d2l.plot(freqs, xlabel='токен: x', ylabel='частота: n(x)',
xscale='log', yscale='log')
По этому графику видно: частоты слов убывают быстро и предсказуемо. Если не учитывать первые несколько слов-исключений, остальные слова примерно ложатся на прямую в двойном логарифмическом масштабе. Это означает, что частоты слов подчиняются закону Ципфа (Zipf’s law): частота -го по популярности слова выражается формулой
или, что то же самое,
где — показатель, характеризующий распределение, а — константа. Из этого следует, что моделировать слова только подсчётом и сглаживанием нецелесообразно, поскольку такая модель сильно завышает частоты хвоста распределения, то есть редко употребляемых слов. А как обстоит дело с другими комбинациями токенов, например с биграммами, триграммами и так далее? Проверим, ведут ли себя частоты биграмм так же, как частоты униграмм.
bigram_tokens = [pair for pair in zip(corpus[:-1], corpus[1:])]
bigram_vocab = d2l.Vocab(bigram_tokens)
bigram_vocab.token_freqs[:10]
Здесь стоит обратить внимание: из десяти самых частых пар девять состоят из двух стоп-слов, и только одна связана с «the time». Теперь проверим, ведут ли себя так же частоты триграмм.
trigram_tokens = [triple for triple in zip(
corpus[:-2], corpus[1:-1], corpus[2:])]
trigram_vocab = d2l.Vocab(trigram_tokens)
trigram_vocab.token_freqs[:10]
Наконец, наглядно сравним частоты токенов в трёх моделях: униграммной, биграммной и триграммной.
bigram_freqs = [freq for token, freq in bigram_vocab.token_freqs]
trigram_freqs = [freq for token, freq in trigram_vocab.token_freqs]
d2l.plot([freqs, bigram_freqs, trigram_freqs], xlabel='токен: x',
ylabel='частота: n(x)', xscale='log', yscale='log',
legend=['униграммы', 'биграммы', 'триграммы'])
Этот график очень интересен, и на то есть несколько причин:
- Помимо униграмм, последовательности слов тоже подчиняются закону Ципфа, хотя показатель в формуле (8.3.1) меньше (величина показателя зависит от длины последовательности);
- Число -грамм в словаре не столь велико, что говорит о существовании в языке довольно значительной структуры, а это даёт надежду на применимость моделей;
- Многие -граммы встречаются очень редко, что делает сглаживание Лапласа совершенно непригодным для языкового моделирования. Вместо него мы будем использовать модели на основе глубокого обучения.
8.3.4 Чтение длинных последовательных данных
Поскольку последовательные данные по природе непрерывны, при их обработке нужно решить эту проблему. В разделе 8.1 мы сделали это довольно необычным способом: когда последовательность становится слишком длинной, чтобы модель могла обработать её целиком, мы можем разбить её на части, удобные для чтения моделью.
Прежде чем описывать модель, рассмотрим общую стратегию. Пусть языковая модель обучается нейронной сетью, которая за один раз обрабатывает минибатч последовательностей фиксированной длины (например, временных шагов). Вопрос в том, как случайно сгенерировать признаки и метки для минибатча данных.
Во-первых, поскольку текстовая последовательность может быть произвольной длины (например, весь роман «Машина времени»), её можно разбить на подпоследовательности с одинаковым числом временных шагов. При обучении нейронной сети такие минибатчи подпоследовательностей подаются в модель. Пусть сеть за один раз обрабатывает подпоследовательность из временных шагов. На рис. 8.3.1 показаны все способы получить подпоследовательности из исходной текстовой последовательности при , причём токен каждого временного шага соответствует одному символу. Обратите внимание, что, поскольку начальное положение можно задать любым смещением, у нас довольно много свободы.
Рис. 8.3.1. Разбиение текста: разные смещения дают разные подпоследовательности
Какую из подпоследовательностей на рис. 8.3.1 выбрать? На самом деле все они одинаково хороши. Однако если выбрать только одно смещение, то покрытие всех возможных подпоследовательностей для обучения сети будет ограниченным. Поэтому можно разбивать последовательность, начиная со случайного смещения, чтобы получить одновременно покрытие (coverage) и случайность (randomness). Ниже мы опишем, как реализовать две стратегии: случайную выборку (random sampling) и последовательное разбиение (sequential partitioning).
8.3.4.1 Случайная выборка
При случайной выборке каждый пример — это подпоследовательность, произвольно взятая из исходной длинной последовательности. В ходе итераций подпоследовательности из двух соседних случайных минибатчей не обязательно являются соседними в исходной последовательности. Для языкового моделирования цель состоит в том, чтобы по уже увиденным токенам предсказать следующий токен, поэтому метками служат исходная последовательность, сдвинутая на один токен.
Приведённый ниже код на каждом шаге случайным образом генерирует минибатч.
Здесь параметр batch_size задаёт число подпоследовательностей в минибатче, а параметр num_steps — число временных шагов в каждой подпоследовательности.
def seq_data_iter_random(corpus, batch_size, num_steps): #@save
"""Генерирует минибатч подпоследовательностей с помощью случайной выборки"""
# Разбиваем последовательность, начиная со случайного смещения (диапазон включает num_steps-1)
corpus = corpus[random.randint(0, num_steps - 1):]
# Вычитаем 1, поскольку нужно учесть метки
num_subseqs = (len(corpus) - 1) // num_steps
# Начальные индексы подпоследовательностей длины num_steps
initial_indices = list(range(0, num_subseqs * num_steps, num_steps))
# При случайной выборке подпоследовательности из двух соседних
# случайных минибатчей не обязательно соседствуют в исходной последовательности
random.shuffle(initial_indices)
def data(pos):
# Возвращает последовательность длины num_steps, начиная с позиции pos
return corpus[pos: pos + num_steps]
num_batches = num_subseqs // batch_size
for i in range(0, batch_size * num_batches, batch_size):
# Здесь initial_indices содержит случайные начальные индексы подпоследовательностей
initial_indices_per_batch = initial_indices[i: i + batch_size]
X = [data(j) for j in initial_indices_per_batch]
Y = [data(j + 1) for j in initial_indices_per_batch]
yield d2l.tensor(X), d2l.tensor(Y)
Сгенерируем последовательность от до . Пусть размер батча равен , а число временных шагов — ; тогда можно получить пар «признаки — метка». Если установить размер минибатча равным , то получится минибатча.
my_seq = list(range(35))
for X, Y in seq_data_iter_random(my_seq, batch_size=2, num_steps=5):
print('X: ', X, '\nY:', Y)
8.3.4.2 Последовательное разбиение
В ходе итераций, помимо случайной выборки из исходной последовательности, мы можем гарантировать, что подпоследовательности из двух соседних минибатчей также соседствуют в исходной последовательности. Эта стратегия сохраняет порядок разбитых подпоследовательностей при переходе от минибатча к минибатчу, поэтому её называют последовательным разбиением.
MXNet, PyTorch:
def seq_data_iter_sequential(corpus, batch_size, num_steps): #@save
"""Генерирует минибатч подпоследовательностей с помощью последовательного разбиения"""
# Разбиваем последовательность, начиная со случайного смещения
offset = random.randint(0, num_steps)
num_tokens = ((len(corpus) - offset - 1) // batch_size) * batch_size
Xs = d2l.tensor(corpus[offset: offset + num_tokens])
Ys = d2l.tensor(corpus[offset + 1: offset + 1 + num_tokens])
Xs, Ys = Xs.reshape(batch_size, -1), Ys.reshape(batch_size, -1)
num_batches = Xs.shape[1] // num_steps
for i in range(0, num_steps * num_batches, num_steps):
X = Xs[:, i: i + num_steps]
Y = Ys[:, i: i + num_steps]
yield X, Y
TensorFlow:
def seq_data_iter_sequential(corpus, batch_size, num_steps): #@save
"""Генерирует минибатч подпоследовательностей с помощью последовательного разбиения"""
# Разбиваем последовательность, начиная со случайного смещения
offset = random.randint(0, num_steps)
num_tokens = ((len(corpus) - offset - 1) // batch_size) * batch_size
Xs = d2l.tensor(corpus[offset: offset + num_tokens])
Ys = d2l.tensor(corpus[offset + 1: offset + 1 + num_tokens])
Xs = d2l.reshape(Xs, (batch_size, -1))
Ys = d2l.reshape(Ys, (batch_size, -1))
num_batches = Xs.shape[1] // num_steps
for i in range(0, num_batches * num_steps, num_steps):
X = Xs[:, i: i + num_steps]
Y = Ys[:, i: i + num_steps]
yield X, Y
PaddlePaddle:
def seq_data_iter_sequential(corpus, batch_size, num_steps): #@save
"""Генерирует минибатч подпоследовательностей с помощью последовательного разбиения"""
# Разбиваем последовательность, начиная со случайного смещения
offset = random.randint(0, num_steps)
num_tokens = ((len(corpus) - offset - 1) // batch_size) * batch_size
Xs = d2l.tensor(corpus[offset: offset + num_tokens])
Ys = d2l.tensor(corpus[offset + 1: offset + 1 + num_tokens])
Xs, Ys = Xs.reshape((batch_size, -1)), Ys.reshape((batch_size, -1))
num_batches = Xs.shape[1] // num_steps
for i in range(0, num_steps * num_batches, num_steps):
X = Xs[:, i: i + num_steps]
Y = Ys[:, i: i + num_steps]
yield X, Y
Используя те же параметры, считаем признаки X и метки Y минибатча подпоследовательностей при последовательном разбиении.
Если вывести их, можно заметить: в ходе итераций подпоследовательности из двух соседних минибатчей действительно соседствуют в исходной последовательности.
for X, Y in seq_data_iter_sequential(my_seq, batch_size=2, num_steps=5):
print('X: ', X, '\nY:', Y)
Теперь объединим обе функции выборки в один класс, чтобы позже использовать его как итератор данных.
class SeqDataLoader: #@save
"""Итератор для загрузки последовательных данных"""
def __init__(self, batch_size, num_steps, use_random_iter, max_tokens):
if use_random_iter:
self.data_iter_fn = d2l.seq_data_iter_random
else:
self.data_iter_fn = d2l.seq_data_iter_sequential
self.corpus, self.vocab = d2l.load_corpus_time_machine(max_tokens)
self.batch_size, self.num_steps = batch_size, num_steps
def __iter__(self):
return self.data_iter_fn(self.corpus, self.batch_size, self.num_steps)
Наконец, определим функцию load_data_time_machine, которая возвращает одновременно итератор данных и словарь,
поэтому её можно использовать так же, как другие функции с префиксом load_data
(например, d2l.load_data_fashion_mnist, определённую в разделе 3.5).
def load_data_time_machine(batch_size, num_steps, #@save
use_random_iter=False, max_tokens=10000):
"""Возвращает итератор и словарь набора данных «Машина времени»"""
data_iter = SeqDataLoader(
batch_size, num_steps, use_random_iter, max_tokens)
return data_iter, data_iter.vocab
Резюме
- Языковые модели — ключевой инструмент обработки естественного языка.
- -граммы обеспечивают практичный способ работы с длинными последовательностями за счёт ограничения учитываемых зависимостей.
- У длинных последовательностей есть проблема: они очень редко встречаются, а иногда и вовсе не встречаются.
- Закон Ципфа описывает распределение слов не только для униграмм, но и для других -грамм.
- Сглаживание Лапласа позволяет эффективно работать с редкими сочетаниями слов, которые, тем не менее, имеют богатую структуру.
- Основные способы чтения длинных последовательностей — случайная выборка и последовательное разбиение. Последнее гарантирует, что подпоследовательности из двух соседних минибатчей также соседствуют в исходной последовательности.
Упражнения
- Предположим, что в обучающем наборе данных есть слов. Сколько частот слов и смежных частот нужно хранить для четырёхграммной модели?
- Как моделировать последовательность диалогов?
- Показатели закона Ципфа для униграмм, биграмм и триграмм различны. Можете ли вы оценить их?
- Какие ещё способы чтения длинных последовательных данных вы можете предложить?
- Рассмотрим случайное смещение, которое мы используем для чтения длинных последовательностей.
- Почему случайное смещение — хорошая идея?
- Действительно ли оно даёт идеально равномерное распределение на последовательностях документа?
- Что нужно сделать, чтобы распределение стало более равномерным?
- Если мы хотим, чтобы пример последовательности был целым предложением, какие проблемы возникнут при выборке минибатчей? Как их решить?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Wood, F., Gasthaus, J., Archambeau, C., James, L., & Teh, Y. W. (2011). The sequence memoizer. Communications of the ACM, 54(2), 91–98.
8.4 Рекуррентные нейронные сети
В разделе 8.3 мы ввели модель -грамм, в которой условная вероятность появления слова на временном шаге зависит только от предыдущих слов. Если мы хотим учитывать влияние слов, которые стоят дальше, чем на шагов назад, нужно увеличивать . Однако число параметров модели при этом растёт экспоненциально, поскольку словарь должен хранить чисел. Поэтому вместо моделирования лучше использовать модель со скрытой переменной:
где — скрытое состояние (hidden state), также называемое скрытой переменной (hidden variable), которое хранит информацию о последовательности до временного шага . Обычно скрытое состояние на временном шаге можно вычислить по текущему входу и предыдущему скрытому состоянию :
Для функции из (8.4.1) модель со скрытой переменной не является приближением. В самом деле, может хранить все данные, наблюдённые до этого момента, однако такая операция может быть дорогой как по вычислениям, так и по памяти.
Вспомним скрытые слои с их скрытыми элементами, о которых шла речь в главе 4. Важно отличать скрытые слои от скрытых состояний. Как уже было сказано, скрытые слои находятся на пути от входа к выходу, если смотреть на них с точки зрения наблюдаемых величин, тогда как скрытое состояние — это то, что поступает на вход на каждом шаге, и вычисляется оно только по данным предыдущих временных шагов.
Рекуррентные нейронные сети (recurrent neural networks, RNNs) — это нейронные сети со скрытым состоянием. Прежде чем вводить модель рекуррентной сети, вспомним многослойный перцептрон из раздела 4.1.
8.4.1 Нейронные сети без скрытых состояний
Посмотрим на многослойный перцептрон с одним скрытым слоем. Пусть функция активации скрытого слоя равна . Дан минибатч размера с входной размерностью . Тогда выход скрытого слоя вычисляется по формуле
В (8.4.2) параметры скрытого слоя — весовая матрица и вектор смещения , а число скрытых элементов равно . Поэтому при сложении можно применить механизм broadcasting (см. раздел 2.1.3). Далее скрытую переменную используем как вход выходного слоя. Выходной слой задаётся формулой
где — выходные данные, — весовая матрица, а — вектор смещения выходного слоя. Если решается задача классификации, то для вычисления вероятностного распределения по классам можно использовать .
Это полностью аналогично задаче регрессии, которую мы решали в разделе 8.1, поэтому подробности опускаем. Достаточно того, что можно случайным образом выбирать пары «признаки — метка» и обучать параметры сети с помощью автоматического дифференцирования и стохастического градиентного спуска.
8.4.2 Рекуррентные нейронные сети со скрытыми состояниями
Когда появляется скрытое состояние, ситуация становится совсем другой. Пусть на временном шаге поступает минибатч входных данных . Иными словами, для минибатча из последовательностей каждая строка соответствует одному примеру из этой последовательности на временном шаге . Обозначим через скрытую переменную на временном шаге . В отличие от многослойного перцептрона, здесь мы сохраняем скрытую переменную предыдущего шага и вводим новый весовой параметр , который описывает, как использовать скрытую переменную предыдущего шага на текущем шаге. Конкретно, скрытая переменная текущего шага вычисляется по текущему входу и скрытой переменной предыдущего шага:
По сравнению с (8.4.2) в (8.4.3) добавлено слагаемое , которое реализует (8.4.1). Из связи между скрытыми переменными и видно, что эти переменные хранят и сохраняют историю последовательности до текущего временного шага, подобно состоянию или памяти нейронной сети на текущем шаге. Поэтому такие скрытые переменные называют скрытыми состояниями (hidden state). Поскольку на текущем шаге скрытое состояние определяется так же, как и на предыдущем, вычисление (8.4.3) является рекуррентным (recurrent). Отсюда и название: нейронные сети, в которых скрытое состояние вычисляется рекуррентно, называют рекуррентными нейронными сетями (recurrent neural network). Слой, который выполняет вычисления (8.4.3), называют рекуррентным слоем (recurrent layer).
Существует много способов построить рекуррентную нейронную сеть. Сеть со скрытым состоянием, заданным формулой (8.4.3), — одна из самых распространённых. Для шага выход выходного слоя вычисляется так же, как в многослойном перцептроне:
Параметры рекуррентной нейронной сети включают веса скрытого слоя , и смещение , а также веса выходного слоя и смещение . Стоит отметить, что на разных временных шагах рекуррентная нейронная сеть всегда использует одни и те же параметры модели. Поэтому число параметров сети не растёт с увеличением числа временных шагов.
На рис. 8.4.1 показана логика вычислений рекуррентной нейронной сети на трёх соседних временных шагах. На произвольном шаге вычисление скрытого состояния можно представить так:
- объединить входной вектор текущего шага и скрытое состояние предыдущего шага ;
- подать результат объединения в полносвязный слой с функцией активации . Выход этого полносвязного слоя — скрытое состояние текущего шага .
В данном случае параметры модели — это конкатенация и и смещение , все они берутся из (8.4.3). Скрытое состояние текущего шага участвует в вычислении скрытого состояния следующего шага . Кроме того, подаётся в полносвязный выходной слой, с помощью которого вычисляется выход текущего шага.
Рис. 8.4.1. Рекуррентная нейронная сеть со скрытым состоянием
Выше мы упомянули, что вычисление в скрытом состоянии эквивалентно умножению матрицы, полученной конкатенацией и , на матрицу, полученную конкатенацией и .
Это свойство можно доказать математически, но ниже мы проверим его простым кодом.
Сначала определим матрицы X, W_xh, H и W_hh, их формы — , , и .
Перемножим X с W_xh, H с W_hh, а затем сложим оба произведения: получим матрицу формы .
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
MXNet, PyTorch, PaddlePaddle:
X, W_xh = d2l.normal(0, 1, (3, 1)), d2l.normal(0, 1, (1, 4))
H, W_hh = d2l.normal(0, 1, (3, 4)), d2l.normal(0, 1, (4, 4))
d2l.matmul(X, W_xh) + d2l.matmul(H, W_hh)
TensorFlow:
X, W_xh = d2l.normal((3, 1), 0, 1), d2l.normal((1, 4), 0, 1)
H, W_hh = d2l.normal((3, 4), 0, 1), d2l.normal((4, 4), 0, 1)
d2l.matmul(X, W_xh) + d2l.matmul(H, W_hh)
Теперь объединим матрицы X и H по столбцам (ось 1), а матрицы W_xh и W_hh — по строкам (ось 0).
Эти конкатенации дают матрицы формы и .
Перемножив эти две объединённые матрицы, получим выходную матрицу той же формы , что и выше.
d2l.matmul(d2l.concat((X, H), 1), d2l.concat((W_xh, W_hh), 0))
8.4.3 Символьная языковая модель на основе рекуррентной нейронной сети
Вспомним языковую модель из раздела 8.3: наша цель — по прошлым и текущим токенам предсказать следующий токен, поэтому в качестве меток мы берём исходную последовательность, сдвинутую на один токен. Бенджио и соавторы впервые предложили использовать нейронные сети для языкового моделирования (Bengio et al., 2003). Далее рассмотрим, как построить языковую модель с помощью рекуррентной нейронной сети. Пусть размер минибатча равен , а текстовая последовательность в батче — «machine». Чтобы упростить обучение в дальнейшем, рассмотрим символьную языковую модель (character-level language model): текст разбивается на токены-символы, а не на слова. На рис. 8.4.2 показано, как с помощью символьной языковой модели на основе рекуррентной нейронной сети предсказать следующий символ по текущему и предыдущим символам.
Рис. 8.4.2. Символьная языковая модель на основе рекуррентной нейронной сети: входная и выходная последовательности — «machin» и «achine»
В ходе обучения мы применяем softmax к выходу выходного слоя на каждом временном шаге, а затем с помощью кросс-энтропийной функции потерь вычисляем ошибку между выходом модели и метками. Из-за рекуррентного вычисления скрытого состояния выход на третьем временном шаге на рис. 8.4.2 определяется последовательностью символов «m», «a» и «c». Поскольку в обучающих данных следующий символ этой последовательности — «h», потеря на третьем шаге зависит от вероятностного распределения следующего символа, которое строится по признакам «m», «a», «c» и метке «h» этого шага.
На практике мы используем минибатч размера , а каждый токен представляется -мерным вектором. Поэтому входной элемент на временном шаге будет матрицей размера , как и в обсуждении в разделе 8.4.2.
8.4.4 Перплексия (perplexity)
Наконец, обсудим, как измерять качество языковой модели; эта мера будет использоваться для оценки моделей на основе рекуррентных нейронных сетей в следующих разделах. Хорошая языковая модель способна очень точно предсказать, что мы увидим дальше. Рассмотрим продолжения фразы «It is raining …» («…дождь») от разных языковых моделей:
- «It is raining outside» («На улице дождь»);
- «It is raining banana tree» («На банановое дерево идёт дождь»);
- «It is raining piouw;kcj pwepoiut» («piouw;kcj pwepoiut — дождь»).
С точки зрения качества пример очевидно самый разумный и логически связный. Хотя модель, возможно, не очень точно отражает семантику последующих слов, ведь более совершенными продолжениями могли бы быть «It is raining in San Francisco» («В Сан-Франциско идёт дождь») и «It is raining in winter» («Зимой идёт дождь»), модель уже научилась определять, какие классы слов идут дальше. Пример гораздо хуже, поскольку он даёт бессмысленное продолжение. Тем не менее модель хотя бы научилась писать слова и улавливать некоторую связь между словами. Наконец, пример показывает, что недостаточно обученная модель не может правильно описать данные.
Качество модели можно измерить, вычислив правдоподобие последовательности. Однако это число трудно понимать и сравнивать. Ведь короткие последовательности гораздо более вероятны, чем длинные, поэтому вероятность того, что модель породит роман Толстого «Война и мир», неизбежно будет гораздо меньше, чем вероятность того, что она породит небольшую повесть Сент-Экзюпери «Маленький принц». При этом недостающее правдоподобие фактически соответствует среднему значению.
Здесь может помочь теория информации. Мы определяли энтропию, информационное содержание и кросс-энтропию, когда вводили softmax-регрессию (раздел 3.4.7), а дополнительные сведения по теории информации приведены в онлайн-приложении по теории информации. Если мы хотим сжать текст, можно предсказывать следующий токен по набору текущих токенов. Лучшая языковая модель позволяет точнее предсказывать следующий токен, а значит, при сжатии последовательности потребуется меньше битов. Поэтому качество можно измерить через среднее значение кросс-энтропийной потери по всем токенам последовательности:
где задаётся языковой моделью, а — фактический токен, наблюдаемый в последовательности на временном шаге . Это позволяет сравнивать качество документов разной длины. По историческим причинам специалисты по обработке естественного языка предпочитают использовать величину, которая называется перплексия (perplexity). Это просто экспонента от (8.4.4):
Перплексию лучше всего понимать как «среднее гармоническое число фактических вариантов выбора следующего токена». Рассмотрим несколько случаев.
- В лучшем случае модель всегда идеально оценивает вероятность метки-токена как . В этом случае перплексия модели равна .
- В худшем случае модель всегда предсказывает вероятность метки-токена, равную . В этом случае перплексия равна плюс бесконечности.
- В качестве базовой линии модель предсказывает равномерное распределение по всем доступным токенам словаря. В этом случае перплексия равна числу уникальных токенов в словаре. Более того, если хранить последовательность без какого-либо сжатия, это и будет наилучший способ кодирования. Поэтому такая оценка даёт важную верхнюю границу, которую должна превзойти любая практическая модель.
В следующих подразделах мы реализуем символьную языковую модель на основе рекуррентной нейронной сети и будем оценивать её с помощью перплексии.
Резюме
- Нейронная сеть, которая вычисляет скрытое состояние рекуррентно, называется рекуррентной нейронной сетью (RNN).
- Скрытое состояние рекуррентной нейронной сети может хранить историю последовательности до текущего временного шага.
- Число параметров рекуррентной нейронной сети не растёт с увеличением числа временных шагов.
- С помощью рекуррентной нейронной сети можно построить символьную языковую модель.
- Для оценки качества языковой модели можно использовать перплексию.
Упражнения
- Если мы используем рекуррентную нейронную сеть для предсказания следующего символа в текстовой последовательности, какова размерность выхода для каждого варианта?
- Почему рекуррентная нейронная сеть может на каком-либо временном шаге представлять условную вероятность текущего токена, опираясь на все предыдущие токены текстовой последовательности?
- Что происходит с градиентами, если выполнять обратное распространение по длинной последовательности?
- Какие проблемы связаны с языковой моделью, которую мы описали в этом разделе?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Bengio, Y., Ducharme, R., Vincent, P., & Jauvin, C. (2003). A neural probabilistic language model. Journal of Machine Learning Research, 3, 1137–1155.
8.5 Реализация рекуррентной нейронной сети с нуля
В этом разделе на основе описания из раздела 8.4 мы с нуля реализуем символьную языковую модель на основе рекуррентной нейронной сети. Модель будем обучать на наборе данных «Машина времени» Герберта Уэллса. Как и в разделе 8.3, сначала прочитаем набор данных.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
import math
from mxnet import autograd, gluon, np, npx
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import math
import torch
from torch import nn
from torch.nn import functional as F
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import math
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import paddle
from paddle import nn
from paddle.nn import functional as F
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
TensorFlow:
train_random_iter, vocab_random_iter = d2l.load_data_time_machine(
batch_size, num_steps, use_random_iter=True)
8.5.1 One-hot кодирование
Напомним, что в train_iter каждый токен представлен числовым индексом.
Если подавать такие индексы напрямую в нейронную сеть, обучение может быть затруднено.
Поэтому обычно каждый токен представляют более выразительным вектором признаков.
Самое простое представление называется one-hot кодированием (one-hot encoding); оно было введено в разделе 3.4.1.
Коротко говоря, каждый индекс отображается в свой единичный вектор.
Пусть число различных токенов в словаре равно (то есть len(vocab)), а индексы токенов принимают значения от до .
Если индекс токена равен целому числу , мы создаём вектор длины , заполненный нулями, и устанавливаем его элемент с индексом равным .
Полученный вектор — one-hot вектор исходного токена.
Ниже показаны one-hot векторы для индексов и :
MXNet:
npx.one_hot(np.array([0, 2]), len(vocab))
PyTorch:
F.one_hot(torch.tensor([0, 2]), len(vocab))
TensorFlow:
tf.one_hot(tf.constant([0, 2]), len(vocab))
PaddlePaddle:
F.one_hot(paddle.to_tensor([0, 2]), len(vocab))
Каждый выбранный минибатч имеет форму двумерного тензора: (размер батча, число временных шагов).
Функция one_hot превращает такой минибатч в трёхмерный тензор, последняя размерность которого равна размеру словаря (len(vocab)).
Мы часто переставляем оси входа, чтобы получить выход формы (число временных шагов, размер батча, размер словаря).
Это позволяет удобно перебирать минибатч по самой внешней оси и шаг за шагом обновлять скрытое состояние минибатча.
MXNet:
X = d2l.reshape(d2l.arange(10), (2, 5))
npx.one_hot(X.T, 28).shape
PyTorch:
X = d2l.reshape(d2l.arange(10), (2, 5))
F.one_hot(X.T, 28).shape
TensorFlow:
X = d2l.reshape(d2l.arange(10), (2, 5))
tf.one_hot(tf.transpose(X), 28).shape
PaddlePaddle:
X = paddle.arange(10).reshape((2, 5))
F.one_hot(X.T, 28).shape
8.5.2 Инициализация параметров модели
Теперь инициализируем параметры модели рекуррентной нейронной сети.
Число скрытых элементов num_hiddens — настраиваемый гиперпараметр.
При обучении языковой модели входы и выходы берутся из одного и того же словаря.
Поэтому их размерности совпадают и равны размеру словаря.
MXNet:
def get_params(vocab_size, num_hiddens, device):
num_inputs = num_outputs = vocab_size
def normal(shape):
return np.random.normal(scale=0.01, size=shape, ctx=device)
# Параметры скрытого слоя
W_xh = normal((num_inputs, num_hiddens))
W_hh = normal((num_hiddens, num_hiddens))
b_h = d2l.zeros(num_hiddens, ctx=device)
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = d2l.zeros(num_outputs, ctx=device)
# Включаем вычисление градиентов
params = [W_xh, W_hh, b_h, W_hq, b_q]
for param in params:
param.attach_grad()
return params
PyTorch:
def get_params(vocab_size, num_hiddens, device):
num_inputs = num_outputs = vocab_size
def normal(shape):
return torch.randn(size=shape, device=device) * 0.01
# Параметры скрытого слоя
W_xh = normal((num_inputs, num_hiddens))
W_hh = normal((num_hiddens, num_hiddens))
b_h = d2l.zeros(num_hiddens, device=device)
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = d2l.zeros(num_outputs, device=device)
# Включаем вычисление градиентов
params = [W_xh, W_hh, b_h, W_hq, b_q]
for param in params:
param.requires_grad_(True)
return params
TensorFlow:
def get_params(vocab_size, num_hiddens):
num_inputs = num_outputs = vocab_size
def normal(shape):
return d2l.normal(shape=shape,stddev=0.01,mean=0,dtype=tf.float32)
# Параметры скрытого слоя
W_xh = tf.Variable(normal((num_inputs, num_hiddens)), dtype=tf.float32)
W_hh = tf.Variable(normal((num_hiddens, num_hiddens)), dtype=tf.float32)
b_h = tf.Variable(d2l.zeros(num_hiddens), dtype=tf.float32)
# Параметры выходного слоя
W_hq = tf.Variable(normal((num_hiddens, num_outputs)), dtype=tf.float32)
b_q = tf.Variable(d2l.zeros(num_outputs), dtype=tf.float32)
params = [W_xh, W_hh, b_h, W_hq, b_q]
return params
PaddlePaddle:
def get_params(vocab_size, num_hiddens):
num_inputs = num_outputs = vocab_size
def normal(shape):
return paddle.randn(shape=shape)* 0.01
# Параметры скрытого слоя
W_xh = normal([num_inputs, num_hiddens])
W_hh = normal([num_hiddens, num_hiddens])
b_h = d2l.zeros(shape=[num_hiddens])
# Параметры выходного слоя
W_hq = normal([num_hiddens, num_outputs])
b_q = d2l.zeros(shape=[num_outputs])
# Включаем вычисление градиентов
params = [W_xh, W_hh, b_h, W_hq, b_q]
for param in params:
param.stop_gradient=False
return params
8.5.3 Модель рекуррентной нейронной сети
Чтобы определить модель рекуррентной нейронной сети,
сначала нужна функция init_rnn_state, которая возвращает скрытое состояние при инициализации.
Эта функция возвращает тензор, заполненный нулями, формы (размер батча, число скрытых элементов).
В следующих главах мы встретимся с ситуациями, когда скрытое состояние содержит несколько переменных; их удобнее хранить в кортеже.
MXNet:
def init_rnn_state(batch_size, num_hiddens, device):
return (d2l.zeros((batch_size, num_hiddens), ctx=device), )
PyTorch:
def init_rnn_state(batch_size, num_hiddens, device):
return (d2l.zeros((batch_size, num_hiddens), device=device), )
TensorFlow:
def init_rnn_state(batch_size, num_hiddens):
return (d2l.zeros((batch_size, num_hiddens)), )
PaddlePaddle:
def init_rnn_state(batch_size, num_hiddens):
return (paddle.zeros(shape=[batch_size, num_hiddens]), )
Функция rnn ниже определяет, как вычислить скрытое состояние и выход на одном временном шаге.
Модель рекуррентной нейронной сети реализует цикл по самой внешней оси inputs, чтобы последовательно обновлять скрытое состояние H минибатча.
Кроме того, здесь в качестве функции активации используется .
Как описано в разделе 4.1, при равномерном распределении элементов на вещественной оси среднее значение функции равно 0.
MXNet:
def rnn(inputs, state, params):
# Форма inputs: (число временных шагов, размер батча, размер словаря)
W_xh, W_hh, b_h, W_hq, b_q = params
H, = state
outputs = []
# Форма X: (размер батча, размер словаря)
for X in inputs:
H = np.tanh(np.dot(X, W_xh) + np.dot(H, W_hh) + b_h)
Y = np.dot(H, W_hq) + b_q
outputs.append(Y)
return np.concatenate(outputs, axis=0), (H,)
PyTorch:
def rnn(inputs, state, params):
# Форма inputs: (число временных шагов, размер батча, размер словаря)
W_xh, W_hh, b_h, W_hq, b_q = params
H, = state
outputs = []
# Форма X: (размер батча, размер словаря)
for X in inputs:
H = torch.tanh(torch.mm(X, W_xh) + torch.mm(H, W_hh) + b_h)
Y = torch.mm(H, W_hq) + b_q
outputs.append(Y)
return torch.cat(outputs, dim=0), (H,)
TensorFlow:
def rnn(inputs, state, params):
# Форма inputs: (число временных шагов, размер батча, размер словаря)
W_xh, W_hh, b_h, W_hq, b_q = params
H, = state
outputs = []
# Форма X: (размер батча, размер словаря)
for X in inputs:
X = tf.reshape(X,[-1,W_xh.shape[0]])
H = tf.tanh(tf.matmul(X, W_xh) + tf.matmul(H, W_hh) + b_h)
Y = tf.matmul(H, W_hq) + b_q
outputs.append(Y)
return d2l.concat(outputs, axis=0), (H,)
PaddlePaddle:
def rnn(inputs, state, params):
# Форма inputs: (число временных шагов, размер батча, размер словаря)
W_xh, W_hh, b_h, W_hq, b_q = params
H, = state
outputs = []
# Форма X: (размер батча, размер словаря)
for X in inputs:
H = paddle.tanh(paddle.mm(X, W_xh) + paddle.mm(H, W_hh) + b_h)
Y = paddle.mm(H, W_hq) + b_q
outputs.append(Y)
return paddle.concat(x=outputs, axis=0), (H,)
Определив все нужные функции, создадим класс, который объединяет эти функции и хранит параметры модели рекуррентной нейронной сети, реализованной с нуля.
MXNet:
class RNNModelScratch: #@save
"""Модель рекуррентной нейронной сети, реализованная с нуля"""
def __init__(self, vocab_size, num_hiddens, device, get_params,
init_state, forward_fn):
self.vocab_size, self.num_hiddens = vocab_size, num_hiddens
self.params = get_params(vocab_size, num_hiddens, device)
self.init_state, self.forward_fn = init_state, forward_fn
def __call__(self, X, state):
X = npx.one_hot(X.T, self.vocab_size)
return self.forward_fn(X, state, self.params)
def begin_state(self, batch_size, ctx):
return self.init_state(batch_size, self.num_hiddens, ctx)
PyTorch:
class RNNModelScratch: #@save
"""Модель рекуррентной нейронной сети, реализованная с нуля"""
def __init__(self, vocab_size, num_hiddens, device,
get_params, init_state, forward_fn):
self.vocab_size, self.num_hiddens = vocab_size, num_hiddens
self.params = get_params(vocab_size, num_hiddens, device)
self.init_state, self.forward_fn = init_state, forward_fn
def __call__(self, X, state):
X = F.one_hot(X.T, self.vocab_size).type(torch.float32)
return self.forward_fn(X, state, self.params)
def begin_state(self, batch_size, device):
return self.init_state(batch_size, self.num_hiddens, device)
TensorFlow:
class RNNModelScratch: #@save
"""Модель рекуррентной нейронной сети, реализованная с нуля"""
def __init__(self, vocab_size, num_hiddens,
init_state, forward_fn, get_params):
self.vocab_size, self.num_hiddens = vocab_size, num_hiddens
self.init_state, self.forward_fn = init_state, forward_fn
self.trainable_variables = get_params(vocab_size, num_hiddens)
def __call__(self, X, state):
X = tf.one_hot(tf.transpose(X), self.vocab_size)
X = tf.cast(X, tf.float32)
return self.forward_fn(X, state, self.trainable_variables)
def begin_state(self, batch_size, *args, **kwargs):
return self.init_state(batch_size, self.num_hiddens)
PaddlePaddle:
class RNNModelScratch: #@save
"""Модель рекуррентной нейронной сети, реализованная с нуля"""
def __init__(self, vocab_size, num_hiddens,
get_params, init_state, forward_fn):
self.vocab_size, self.num_hiddens = vocab_size, num_hiddens
self.params = get_params(vocab_size, num_hiddens)
self.init_state, self.forward_fn = init_state, forward_fn
def __call__(self, X, state):
X = F.one_hot(X.T, self.vocab_size)
return self.forward_fn(X, state, self.params)
def begin_state(self, batch_size):
return self.init_state(batch_size, self.num_hiddens)
Проверим, правильна ли форма выхода: например, сохраняется ли размерность скрытого состояния.
MXNet:
num_hiddens = 512
net = RNNModelScratch(len(vocab), num_hiddens, d2l.try_gpu(), get_params,
init_rnn_state, rnn)
state = net.begin_state(X.shape[0], d2l.try_gpu())
Y, new_state = net(X.as_in_context(d2l.try_gpu()), state)
Y.shape, len(new_state), new_state[0].shape
PyTorch:
num_hiddens = 512
net = RNNModelScratch(len(vocab), num_hiddens, d2l.try_gpu(), get_params,
init_rnn_state, rnn)
state = net.begin_state(X.shape[0], d2l.try_gpu())
Y, new_state = net(X.to(d2l.try_gpu()), state)
Y.shape, len(new_state), new_state[0].shape
TensorFlow:
# Определяем стратегию обучения для TensorFlow
device_name = d2l.try_gpu()._device_name
strategy = tf.distribute.OneDeviceStrategy(device_name)
num_hiddens = 512
with strategy.scope():
net = RNNModelScratch(len(vocab), num_hiddens, init_rnn_state, rnn,
get_params)
state = net.begin_state(X.shape[0])
Y, new_state = net(X, state)
Y.shape, len(new_state), new_state[0].shape
PaddlePaddle:
num_hiddens = 512
net = RNNModelScratch(len(vocab), num_hiddens, get_params,
init_rnn_state, rnn)
state = net.begin_state(X.shape[0])
Y, new_state = net(X, state)
Y.shape, len(new_state), new_state[0].shape
Видно, что форма выхода равна (число временных шагов размер батча, размер словаря), а форма скрытого состояния не меняется и равна (размер батча, число скрытых элементов).
8.5.4 Предсказание
Сначала определим функцию предсказания, которая генерирует новые символы после prefix; prefix — это строка из нескольких символов, которую задаёт пользователь.
При проходе по начальным символам prefix мы продолжаем передавать скрытое состояние на следующий временной шаг, но ничего не выводим.
Это называется периодом разогрева (warm-up), потому что в этот период модель обновляет себя (например, обновляет скрытое состояние), но предсказаний не делает.
После периода разогрева скрытое состояние обычно лучше подходит для предсказаний, чем исходное, и тогда модель начинает предсказывать символы и выводить их.
MXNet:
def predict_ch8(prefix, num_preds, net, vocab, device): #@save
"""Генерирует новые символы после prefix"""
state = net.begin_state(batch_size=1, ctx=device)
outputs = [vocab[prefix[0]]]
get_input = lambda: d2l.reshape(
d2l.tensor([outputs[-1]], ctx=device), (1, 1))
for y in prefix[1:]: # Период разогрева
_, state = net(get_input(), state)
outputs.append(vocab[y])
for _ in range(num_preds): # Предсказываем num_preds шагов
y, state = net(get_input(), state)
outputs.append(int(y.argmax(axis=1).reshape(1)))
return ''.join([vocab.idx_to_token[i] for i in outputs])
PyTorch:
def predict_ch8(prefix, num_preds, net, vocab, device): #@save
"""Генерирует новые символы после prefix"""
state = net.begin_state(batch_size=1, device=device)
outputs = [vocab[prefix[0]]]
get_input = lambda: d2l.reshape(d2l.tensor(
[outputs[-1]], device=device), (1, 1))
for y in prefix[1:]: # Период разогрева
_, state = net(get_input(), state)
outputs.append(vocab[y])
for _ in range(num_preds): # Предсказываем num_preds шагов
y, state = net(get_input(), state)
outputs.append(int(y.argmax(dim=1).reshape(1)))
return ''.join([vocab.idx_to_token[i] for i in outputs])
TensorFlow:
def predict_ch8(prefix, num_preds, net, vocab): #@save
"""Генерирует новые символы после prefix"""
state = net.begin_state(batch_size=1, dtype=tf.float32)
outputs = [vocab[prefix[0]]]
get_input = lambda: d2l.reshape(d2l.tensor([outputs[-1]]),
(1, 1)).numpy()
for y in prefix[1:]: # Период разогрева
_, state = net(get_input(), state)
outputs.append(vocab[y])
for _ in range(num_preds): # Предсказываем num_preds шагов
y, state = net(get_input(), state)
outputs.append(int(y.numpy().argmax(axis=1).reshape(1)))
return ''.join([vocab.idx_to_token[i] for i in outputs])
PaddlePaddle:
def predict_ch8(prefix, num_preds, net, vocab, device): #@save
"""Генерирует новые символы после prefix"""
state = net.begin_state(batch_size=1)
outputs = [vocab[prefix[0]]]
get_input = lambda: d2l.reshape(d2l.tensor(outputs[-1], place=device), (1, 1))
for y in prefix[1:]: # Период разогрева
_, state = net(get_input(), state)
outputs.append(vocab[y])
for _ in range(num_preds): # Предсказываем num_preds шагов
y, state = net(get_input(), state)
outputs.append(int(paddle.reshape(paddle.argmax(y,axis=1),shape=[1])))
return ''.join([vocab.idx_to_token[i] for i in outputs])
Теперь можно проверить функцию predict_ch8.
Зададим префикс time traveller и сгенерируем по нему 10 последующих символов.
Поскольку сеть ещё не обучена, предсказания будут бессмысленными.
MXNet, PyTorch, PaddlePaddle:
predict_ch8('time traveller ', 10, net, vocab, d2l.try_gpu())
TensorFlow:
predict_ch8('time traveller ', 10, net, vocab)
8.5.5 Отсечение градиентов
Для последовательности длины мы вычисляем градиенты на всех временных шагах; при обратном распространении возникает цепочка матричных умножений длины . Как описано в разделе 4.8, при большом это может привести к численной неустойчивости, например к взрыву или затуханию градиентов. Поэтому модели рекуррентных сетей часто требуют дополнительных приёмов, которые помогают стабилизировать обучение.
В общем случае при решении задачи оптимизации мы обновляем параметры модели. Пусть — вектор параметров, а — градиент для минибатча, взятый с отрицательным знаком. Если скорость обучения равна , то за одну итерацию обновляется до . Допустим дополнительно, что целевая функция хорошо себя ведёт: она липшицево непрерывна с постоянной (Lipschitz continuous). То есть для любых и выполнено:
В этом случае можно уверенно утверждать, что если обновить вектор параметров на , то
то есть значение функции не изменится больше чем на . Это одновременно и плохо, и хорошо. Плохо, что такая оценка ограничивает скорость продвижения; хорошо, что она ограничивает масштаб ухудшения, особенно когда мы движемся в неверном направлении.
Иногда градиенты могут быть очень большими, и тогда алгоритм оптимизации может не сойтись. Можно решить эту проблему, уменьшив скорость обучения . Но что делать, если большие градиенты встречаются редко? Тогда уменьшать скорость обучения не имеет смысла. Распространённая альтернатива — отсечь градиент , спроецировав его обратно на шар заданного радиуса :
Так мы гарантируем, что норма градиента никогда не превысит , а обновлённый градиент будет точно сонаправлен с исходным . Есть и полезный побочный эффект: отсечение ограничивает влияние любого отдельного минибатча (и любого отдельного примера в нём) на вектор параметров, что придаёт модели определённую устойчивость. Отсечение градиентов — быстрый способ справиться со взрывом градиентов; оно не решает проблему полностью, но входит в число эффективных приёмов.
Ниже мы определяем функцию, которая отсекает градиенты модели; модель может быть реализована с нуля или построена с помощью высокоуровневого API. Мы вычисляем норму градиентов по всем параметрам модели.
MXNet:
def grad_clipping(net, theta): #@save
"""Отсечение градиентов"""
if isinstance(net, gluon.Block):
params = [p.data() for p in net.collect_params().values()]
else:
params = net.params
norm = math.sqrt(sum((p.grad ** 2).sum() for p in params))
if norm > theta:
for param in params:
param.grad[:] *= theta / norm
PyTorch:
def grad_clipping(net, theta): #@save
"""Отсечение градиентов"""
if isinstance(net, nn.Module):
params = [p for p in net.parameters() if p.requires_grad]
else:
params = net.params
norm = torch.sqrt(sum(torch.sum((p.grad ** 2)) for p in params))
if norm > theta:
for param in params:
param.grad[:] *= theta / norm
TensorFlow:
def grad_clipping(grads, theta): #@save
"""Отсечение градиентов"""
theta = tf.constant(theta, dtype=tf.float32)
new_grad = []
for grad in grads:
if isinstance(grad, tf.IndexedSlices):
new_grad.append(tf.convert_to_tensor(grad))
else:
new_grad.append(grad)
norm = tf.math.sqrt(sum((tf.reduce_sum(grad ** 2)).numpy()
for grad in new_grad))
norm = tf.cast(norm, tf.float32)
if tf.greater(norm, theta):
for i, grad in enumerate(new_grad):
new_grad[i] = grad * theta / norm
else:
new_grad = new_grad
return new_grad
PaddlePaddle:
def grad_clipping(net, theta): #@save
"""Отсечение градиентов"""
if isinstance(net, nn.Layer):
params = [p for p in net.parameters() if not p.stop_gradient]
else:
params = net.params
norm = paddle.sqrt(sum(paddle.sum((p.grad ** 2)) for p in params))
if norm > theta:
with paddle.no_grad():
for param in params:
param.grad.set_value(param.grad * theta / norm)
8.5.6 Обучение
Прежде чем обучать модель, определим функцию, которая обучает модель в течение одной эпохи. Она отличается от функции обучения модели из раздела 3.6 тремя моментами.
- Разные способы выборки последовательных данных (случайная выборка и последовательное разбиение) приводят к разной инициализации скрытого состояния.
- Мы отсекаем градиенты перед обновлением параметров модели. Это гарантирует, что даже если в какой-то точке обучения произошёл взрыв градиента, модель не расходится.
- Модель оцениваем по перплексии, как описано в разделе 8.4.4. Такая мера гарантирует, что последовательности разной длины можно сравнивать.
Конкретно, при последовательном разбиении мы инициализируем скрытое состояние только в начале каждой эпохи. Поскольку -й пример следующего минибатча является соседним с -м примером текущего минибатча, скрытое состояние, полученное в последнем примере текущего минибатча, используется для инициализации скрытого состояния первого примера следующего минибатча. Так информация об истории последовательности, сохранённая в скрытом состоянии, может передаваться между соседними подпоследовательностями в пределах одной эпохи. Однако вычисление скрытого состояния в любой точке зависит от всех предыдущих минибатчей той же эпохи, и это усложняет вычисление градиентов. Чтобы уменьшить объём вычислений, перед обработкой каждого минибатча мы отсоединяем (detach) скрытое состояние от графа вычислений, так что вычисление градиента скрытого состояния ограничено временными шагами одного минибатча.
При случайной выборке каждый пример берётся из случайной позиции, поэтому скрытое состояние нужно переинициализировать для каждой эпохи.
Так же, как функция train_epoch_ch3 из раздела 3.6, updater — это общая функция обновления параметров модели.
Это может быть функция d2l.sgd, реализованная с нуля, или встроенная оптимизационная функция фреймворка глубокого обучения.
MXNet:
#@save
def train_epoch_ch8(net, train_iter, loss, updater, device, use_random_iter):
"""Обучает модель в течение одной эпохи (определение см. в главе 8)"""
state, timer = None, d2l.Timer()
metric = d2l.Accumulator(2) # Сумма потерь на обучении, количество токенов
for X, Y in train_iter:
if state is None or use_random_iter:
# Инициализируем state на первой итерации или при случайной выборке
state = net.begin_state(batch_size=X.shape[0], ctx=device)
else:
for s in state:
s.detach()
y = Y.T.reshape(-1)
X, y = X.as_in_ctx(device), y.as_in_ctx(device)
with autograd.record():
y_hat, state = net(X, state)
l = loss(y_hat, y).mean()
l.backward()
grad_clipping(net, 1)
updater(batch_size=1) # Поскольку функция mean уже вызвана
metric.add(l * d2l.size(y), d2l.size(y))
return math.exp(metric[0] / metric[1]), metric[1] / timer.stop()
PyTorch:
#@save
def train_epoch_ch8(net, train_iter, loss, updater, device, use_random_iter):
"""Обучает сеть в течение одной эпохи (определение см. в главе 8)"""
state, timer = None, d2l.Timer()
metric = d2l.Accumulator(2) # Сумма потерь на обучении, количество токенов
for X, Y in train_iter:
if state is None or use_random_iter:
# Инициализируем state на первой итерации или при случайной выборке
state = net.begin_state(batch_size=X.shape[0], device=device)
else:
if isinstance(net, nn.Module) and not isinstance(state, tuple):
# Для nn.GRU state — это тензор
state.detach_()
else:
# Для nn.LSTM и модели, написанной с нуля, state состоит из тензоров
for s in state:
s.detach_()
y = Y.T.reshape(-1)
X, y = X.to(device), y.to(device)
y_hat, state = net(X, state)
l = loss(y_hat, y.long()).mean()
if isinstance(updater, torch.optim.Optimizer):
updater.zero_grad()
l.backward()
grad_clipping(net, 1)
updater.step()
else:
l.backward()
grad_clipping(net, 1)
# Поскольку функция mean уже вызвана
updater(batch_size=1)
metric.add(l * d2l.size(y), d2l.size(y))
return math.exp(metric[0] / metric[1]), metric[1] / timer.stop()
TensorFlow:
#@save
def train_epoch_ch8(net, train_iter, loss, updater, use_random_iter):
"""Обучает модель в течение одной эпохи (определение см. в главе 8)"""
state, timer = None, d2l.Timer()
metric = d2l.Accumulator(2) # Сумма потерь на обучении, количество токенов
for X, Y in train_iter:
if state is None or use_random_iter:
# Инициализируем state на первой итерации или при случайной выборке
state = net.begin_state(batch_size=X.shape[0], dtype=tf.float32)
with tf.GradientTape(persistent=True) as g:
y_hat, state = net(X, state)
y = d2l.reshape(tf.transpose(Y), (-1))
l = loss(y, y_hat)
params = net.trainable_variables
grads = g.gradient(l, params)
grads = grad_clipping(grads, 1)
updater.apply_gradients(zip(grads, params))
# Keras по умолчанию возвращает среднюю потерю по батчу
metric.add(l * d2l.size(y), d2l.size(y))
return math.exp(metric[0] / metric[1]), metric[1] / timer.stop()
PaddlePaddle:
#@save
def train_epoch_ch8(net, train_iter, loss, updater, device, use_random_iter):
"""Обучает сеть в течение одной эпохи (определение см. в главе 8)"""
state, timer = None, d2l.Timer()
metric = d2l.Accumulator(2) # Сумма потерь на обучении, количество токенов
for X, Y in train_iter:
if state is None or use_random_iter:
# Инициализируем state на первой итерации или при случайной выборке
state = net.begin_state(batch_size=X.shape[0])
else:
if isinstance(net, nn.Layer) and not isinstance(state, tuple):
# Для nn.GRU state — это тензор
state.stop_gradient=True
else:
# Для nn.LSTM и модели, написанной с нуля, state состоит из тензоров
for s in state:
s.stop_gradient=True
y = paddle.reshape(Y.T,shape=[-1])
X = paddle.to_tensor(X, place=device)
y = paddle.to_tensor(y, place=device)
y_hat, state = net(X, state)
l = loss(y_hat, y).mean()
if isinstance(updater, paddle.optimizer.Optimizer):
updater.clear_grad()
l.backward()
grad_clipping(net, 1)
updater.step()
else:
l.backward()
grad_clipping(net, 1)
# Поскольку функция mean уже вызвана
updater(batch_size=1)
metric.add(l * d2l.size(y), d2l.size(y))
return math.exp(metric[0] / metric[1]), metric[1] / timer.stop()
Функция обучения модели рекуррентной нейронной сети поддерживает как реализацию с нуля, так и высокоуровневый API.
MXNet:
def train_ch8(net, train_iter, vocab, lr, num_epochs, device, #@save
use_random_iter=False):
"""Обучает модель (определение см. в главе 8)"""
loss = gluon.loss.SoftmaxCrossEntropyLoss()
animator = d2l.Animator(xlabel='эпоха', ylabel='перплексия',
legend=['обучение'], xlim=[10, num_epochs])
# Инициализация
if isinstance(net, gluon.Block):
net.initialize(ctx=device, force_reinit=True,
init=init.Normal(0.01))
trainer = gluon.Trainer(net.collect_params(),
'sgd', {'learning_rate': lr})
updater = lambda batch_size: trainer.step(batch_size)
else:
updater = lambda batch_size: d2l.sgd(net.params, lr, batch_size)
predict = lambda prefix: predict_ch8(prefix, 50, net, vocab, device)
# Обучение и предсказание
for epoch in range(num_epochs):
ppl, speed = train_epoch_ch8(
net, train_iter, loss, updater, device, use_random_iter)
if (epoch + 1) % 10 == 0:
animator.add(epoch + 1, [ppl])
print(f'перплексия {ppl:.1f}, {speed:.1f} токенов/с {str(device)}')
print(predict('time traveller'))
print(predict('traveller'))
PyTorch:
#@save
def train_ch8(net, train_iter, vocab, lr, num_epochs, device,
use_random_iter=False):
"""Обучает модель (определение см. в главе 8)"""
loss = nn.CrossEntropyLoss()
animator = d2l.Animator(xlabel='эпоха', ylabel='перплексия',
legend=['обучение'], xlim=[10, num_epochs])
# Инициализация
if isinstance(net, nn.Module):
updater = torch.optim.SGD(net.parameters(), lr)
else:
updater = lambda batch_size: d2l.sgd(net.params, lr, batch_size)
predict = lambda prefix: predict_ch8(prefix, 50, net, vocab, device)
# Обучение и предсказание
for epoch in range(num_epochs):
ppl, speed = train_epoch_ch8(
net, train_iter, loss, updater, device, use_random_iter)
if (epoch + 1) % 10 == 0:
print(predict('time traveller'))
animator.add(epoch + 1, [ppl])
print(f'перплексия {ppl:.1f}, {speed:.1f} токенов/с {str(device)}')
print(predict('time traveller'))
print(predict('traveller'))
TensorFlow:
#@save
def train_ch8(net, train_iter, vocab, lr, num_epochs, strategy,
use_random_iter=False):
"""Обучает модель (определение см. в главе 8)"""
with strategy.scope():
loss = tf.keras.losses.SparseCategoricalCrossentropy(
from_logits=True)
updater = tf.keras.optimizers.SGD(lr)
animator = d2l.Animator(xlabel='эпоха', ylabel='перплексия',
legend=['обучение'], xlim=[10, num_epochs])
predict = lambda prefix: predict_ch8(prefix, 50, net, vocab)
# Обучение и предсказание
for epoch in range(num_epochs):
ppl, speed = train_epoch_ch8(net, train_iter, loss, updater,
use_random_iter)
if (epoch + 1) % 10 == 0:
print(predict('time traveller'))
animator.add(epoch + 1, [ppl])
device = d2l.try_gpu()._device_name
print(f'перплексия {ppl:.1f}, {speed:.1f} токенов/с {str(device)}')
print(predict('time traveller'))
print(predict('traveller'))
PaddlePaddle:
#@save
def train_ch8(net, train_iter, vocab, lr, num_epochs, device, use_random_iter=False):
"""Обучает модель (определение см. в главе 8)"""
loss = nn.CrossEntropyLoss()
animator = d2l.Animator(xlabel='эпоха', ylabel='перплексия',
legend=['обучение'], xlim=[10, num_epochs])
# Инициализация
if isinstance(net, nn.Layer):
updater = paddle.optimizer.SGD(
learning_rate=lr, parameters=net.parameters())
else:
updater = lambda batch_size: d2l.sgd(net.params, lr, batch_size)
predict = lambda prefix: predict_ch8(prefix, 50, net, vocab, device)
# Обучение и предсказание
for epoch in range(num_epochs):
ppl, speed = train_epoch_ch8(
net, train_iter, loss, updater, device, use_random_iter)
if (epoch + 1) % 10 == 0:
print(predict('time traveller'))
animator.add(epoch + 1, [ppl])
print(f'перплексия {ppl:.1f}, {speed:.1f} токенов/с {str(device)}')
print(predict('time traveller'))
print(predict('traveller'))
Теперь обучим модель рекуррентной нейронной сети. Поскольку в наборе данных используется только 10 000 токенов, модели требуется больше эпох, чтобы хорошо сойтись.
MXNet, PyTorch, PaddlePaddle:
num_epochs, lr = 500, 1
train_ch8(net, train_iter, vocab, lr, num_epochs, d2l.try_gpu())
TensorFlow:
num_epochs, lr = 500, 1
train_ch8(net, train_iter, vocab, lr, num_epochs, strategy)
Наконец, посмотрим, что получится при случайной выборке.
MXNet, PyTorch:
net = RNNModelScratch(len(vocab), num_hiddens, d2l.try_gpu(), get_params,
init_rnn_state, rnn)
train_ch8(net, train_iter, vocab, lr, num_epochs, d2l.try_gpu(),
use_random_iter=True)
TensorFlow:
with strategy.scope():
net = RNNModelScratch(len(vocab), num_hiddens, init_rnn_state, rnn,
get_params)
train_ch8(net, train_iter, vocab_random_iter, lr, num_epochs, strategy,
use_random_iter=True)
PaddlePaddle:
net = RNNModelScratch(len(vocab), num_hiddens, get_params,
init_rnn_state, rnn)
train_ch8(net, train_iter, vocab, lr, num_epochs, d2l.try_gpu(),
use_random_iter=True)
Реализация описанной модели рекуррентной нейронной сети с нуля, хотя и поучительна, неудобна. В следующем разделе мы узнаем, как улучшить модель: например, как сделать её реализацию проще и быстрее.
Резюме
- Мы можем обучить символьную языковую модель на основе рекуррентной нейронной сети, которая генерирует продолжение текста по заданному пользователем префиксу.
- Простая языковая модель на основе рекуррентной нейронной сети состоит из кодирования входа, рекуррентной нейронной сети и генерации выхода.
- Перед обучением модели рекуррентной нейронной сети нужно инициализировать её состояние, причём при случайной выборке и последовательном разбиении используются разные способы инициализации.
- При последовательном разбиении нужно отделять градиенты, чтобы сократить объём вычислений.
- Перед любыми предсказаниями модель обновляет себя в период разогрева (например, получает скрытое состояние лучше начального).
- Отсечение градиентов помогает предотвратить взрыв градиентов, но не справляется с затуханием градиентов.
Упражнения
- Покажите, что one-hot кодирование эквивалентно выбору отдельного вектора внедрения (embedding) для каждого объекта.
- Улучшите перплексию, подбирая гиперпараметры (число эпох, число скрытых элементов, число временных шагов в минибатче, скорость обучения и т. д.).
- До какого значения можно снизить перплексию?
- Улучшит ли результат замена one-hot кодирования обучаемыми векторами внедрения?
- Как будет работать модель, если в качестве набора данных взять другую книгу Герберта Уэллса, например «Война миров»?
- Измените функцию предсказания так, чтобы вместо выбора наиболее вероятного следующего символа использовалась выборка.
- Что произойдёт?
- Настройте модель так, чтобы она отдавала предпочтение более вероятным вариантам: например, при выполняйте выборку из .
- Что произойдёт, если запустить код этого раздела без отсечения градиентов?
- Измените последовательное разбиение так, чтобы скрытое состояние не отделялось от вычислительного графа. Изменится ли время работы? А перплексия?
- Замените функцию активации на ReLU и повторите эксперименты этого раздела. Нужно ли по-прежнему отсекать градиенты? Почему?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
8.6 Краткая реализация рекуррентных нейронных сетей
Хотя раздел 8.5 полезен для понимания того, как устроены рекуррентные нейронные сети, его реализация неудобна. В этом разделе мы покажем, как с помощью функций высокоуровневого API фреймворка глубокого обучения реализовать ту же языковую модель эффективнее. Начнём, как и раньше, с чтения набора данных «Машина времени».
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn, rnn
npx.set_np()
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
from torch.nn import functional as F
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
from paddle.nn import functional as F
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
8.6.1 Определение модели
Высокоуровневый API предоставляет реализацию рекуррентных нейронных сетей.
Мы создадим рекуррентный слой rnn_layer с одним скрытым слоем из 256 скрытых элементов.
Многослойные рекуррентные сети мы пока не обсуждали (они будут рассмотрены в разделе 9.3).
Сейчас достаточно понимать многослойность так: выход одного рекуррентного слоя используется как вход следующего.
MXNet:
num_hiddens = 256
rnn_layer = rnn.RNN(num_hiddens)
rnn_layer.initialize()
PyTorch:
num_hiddens = 256
rnn_layer = nn.RNN(len(vocab), num_hiddens)
TensorFlow:
num_hiddens = 256
rnn_cell = tf.keras.layers.SimpleRNNCell(num_hiddens,
kernel_initializer='glorot_uniform')
rnn_layer = tf.keras.layers.RNN(rnn_cell, time_major=True,
return_sequences=True, return_state=True)
PaddlePaddle:
num_hiddens = 256
rnn_layer = nn.SimpleRNN(len(vocab), num_hiddens, time_major=True)
MXNet: инициализировать скрытое состояние просто: достаточно вызвать метод begin_state.
Функция возвращает список (state), в котором для каждого примера минибатча содержится начальное скрытое состояние.
Его форма — (число скрытых слоёв, размер батча, число скрытых элементов).
Для некоторых моделей, которые мы рассмотрим позже (например, для долгой краткосрочной памяти, LSTM), этот список содержит и другую информацию.
PyTorch: скрытое состояние задаём тензором формы (число скрытых слоёв, размер батча, число скрытых элементов).
MXNet:
state = rnn_layer.begin_state(batch_size=batch_size)
len(state), state[0].shape
PyTorch:
state = torch.zeros((1, batch_size, num_hiddens))
state.shape
TensorFlow:
state = rnn_cell.get_initial_state(batch_size=batch_size, dtype=tf.float32)
state.shape
PaddlePaddle:
state = paddle.zeros(shape=[1, batch_size, num_hiddens])
state.shape
Имея скрытое состояние и вход, мы можем с помощью обновлённого скрытого состояния вычислить выход.
Важно подчеркнуть, что «выход» rnn_layer (Y) не включает вычислений выходного слоя: это скрытые состояния на каждом временном шаге, которые можно подать на вход последующего выходного слоя.
MXNet: обновлённое скрытое состояние state_new, которое возвращает rnn_layer, — это скрытое состояние последнего временного шага минибатча.
Его можно использовать для инициализации скрытого состояния следующего минибатча в пределах одной эпохи при последовательном разбиении.
Если скрытых слоёв несколько, скрытое состояние каждого слоя хранится в переменной state_new.
Для некоторых моделей, которые мы рассмотрим позже (например, для LSTM), эта переменная содержит и другую информацию.
MXNet:
X = np.random.uniform(size=(num_steps, batch_size, len(vocab)))
Y, state_new = rnn_layer(X, state)
Y.shape, len(state_new), state_new[0].shape
PyTorch:
X = torch.rand(size=(num_steps, batch_size, len(vocab)))
Y, state_new = rnn_layer(X, state)
Y.shape, state_new.shape
TensorFlow:
X = tf.random.uniform((num_steps, batch_size, len(vocab)))
Y, state_new = rnn_layer(X, state)
Y.shape, len(state_new), state_new[0].shape
PaddlePaddle:
X = paddle.rand(shape=[num_steps, batch_size, len(vocab)])
Y, state_new = rnn_layer(X, state)
Y.shape, state_new.shape
Как и в разделе 8.5, определим класс RNNModel для полной модели рекуррентной нейронной сети.
Обратите внимание, что rnn_layer содержит только скрытый рекуррентный слой; выходной слой нужно создать отдельно.
MXNet:
#@save
class RNNModel(nn.Block):
"""Модель рекуррентной нейронной сети"""
def __init__(self, rnn_layer, vocab_size, **kwargs):
super(RNNModel, self).__init__(**kwargs)
self.rnn = rnn_layer
self.vocab_size = vocab_size
self.dense = nn.Dense(vocab_size)
def forward(self, inputs, state):
X = npx.one_hot(inputs.T, self.vocab_size)
Y, state = self.rnn(X, state)
# Полносвязный слой сначала меняет форму Y на (число временных шагов * размер батча, число скрытых элементов)
# Его выход имеет форму (число временных шагов * размер батча, размер словаря)
output = self.dense(Y.reshape(-1, Y.shape[-1]))
return output, state
def begin_state(self, *args, **kwargs):
return self.rnn.begin_state(*args, **kwargs)
PyTorch:
#@save
class RNNModel(nn.Module):
"""Модель рекуррентной нейронной сети"""
def __init__(self, rnn_layer, vocab_size, **kwargs):
super(RNNModel, self).__init__(**kwargs)
self.rnn = rnn_layer
self.vocab_size = vocab_size
self.num_hiddens = self.rnn.hidden_size
# Если RNN двунаправленная (об этом будет сказано позже), num_directions равно 2, иначе 1
if not self.rnn.bidirectional:
self.num_directions = 1
self.linear = nn.Linear(self.num_hiddens, self.vocab_size)
else:
self.num_directions = 2
self.linear = nn.Linear(self.num_hiddens * 2, self.vocab_size)
def forward(self, inputs, state):
X = F.one_hot(inputs.T.long(), self.vocab_size)
X = X.to(torch.float32)
Y, state = self.rnn(X, state)
# Полносвязный слой сначала меняет форму Y на (число временных шагов * размер батча, число скрытых элементов)
# Его выход имеет форму (число временных шагов * размер батча, размер словаря)
output = self.linear(Y.reshape((-1, Y.shape[-1])))
return output, state
def begin_state(self, device, batch_size=1):
if not isinstance(self.rnn, nn.LSTM):
# nn.GRU использует тензор в качестве скрытого состояния
return torch.zeros((self.num_directions * self.rnn.num_layers,
batch_size, self.num_hiddens),
device=device)
else:
# nn.LSTM использует кортеж в качестве скрытого состояния
return (torch.zeros((
self.num_directions * self.rnn.num_layers,
batch_size, self.num_hiddens), device=device),
torch.zeros((
self.num_directions * self.rnn.num_layers,
batch_size, self.num_hiddens), device=device))
TensorFlow:
#@save
class RNNModel(tf.keras.layers.Layer):
def __init__(self, rnn_layer, vocab_size, **kwargs):
super(RNNModel, self).__init__(**kwargs)
self.rnn = rnn_layer
self.vocab_size = vocab_size
self.dense = tf.keras.layers.Dense(vocab_size)
def call(self, inputs, state):
X = tf.one_hot(tf.transpose(inputs), self.vocab_size)
# rnn возвращает больше двух значений
Y, *state = self.rnn(X, state)
output = self.dense(tf.reshape(Y, (-1, Y.shape[-1])))
return output, state
def begin_state(self, *args, **kwargs):
return self.rnn.cell.get_initial_state(*args, **kwargs)
PaddlePaddle:
#@save
class RNNModel(nn.Layer):
"""Модель рекуррентной нейронной сети"""
def __init__(self, rnn_layer, vocab_size, **kwargs):
super(RNNModel, self).__init__(**kwargs)
self.rnn = rnn_layer
self.vocab_size = vocab_size
self.num_hiddens = self.rnn.hidden_size
# Если RNN двунаправленная (об этом будет сказано позже), num_directions равно 2, иначе 1
if self.rnn.num_directions==1:
self.num_directions = 1
self.linear = nn.Linear(self.num_hiddens, self.vocab_size)
else:
self.num_directions = 2
self.linear = nn.Linear(self.num_hiddens * 2, self.vocab_size)
def forward(self, inputs, state):
X = F.one_hot(inputs.T, self.vocab_size)
Y, state = self.rnn(X, state)
# Полносвязный слой сначала меняет форму Y на (число временных шагов * размер батча, число скрытых элементов)
# Его выход имеет форму (число временных шагов * размер батча, размер словаря)
output = self.linear(Y.reshape((-1, Y.shape[-1])))
return output, state
def begin_state(self, batch_size=1):
if not isinstance(self.rnn, nn.LSTM):
# nn.GRU использует тензор в качестве скрытого состояния
return paddle.zeros(shape=[self.num_directions * self.rnn.num_layers,
batch_size, self.num_hiddens])
else:
# nn.LSTM использует кортеж в качестве скрытого состояния
return (paddle.zeros(
shape=[self.num_directions * self.rnn.num_layers,
batch_size, self.num_hiddens]),
paddle.zeros(
shape=[self.num_directions * self.rnn.num_layers,
batch_size, self.num_hiddens]))
8.6.2 Обучение и предсказание
Прежде чем обучать модель, сделаем предсказание с помощью модели со случайными весами.
MXNet:
device = d2l.try_gpu()
net = RNNModel(rnn_layer, len(vocab))
net.initialize(force_reinit=True, ctx=device)
d2l.predict_ch8('time traveller', 10, net, vocab, device)
PyTorch:
device = d2l.try_gpu()
net = RNNModel(rnn_layer, vocab_size=len(vocab))
net = net.to(device)
d2l.predict_ch8('time traveller', 10, net, vocab, device)
TensorFlow:
device_name = d2l.try_gpu()._device_name
strategy = tf.distribute.OneDeviceStrategy(device_name)
with strategy.scope():
net = RNNModel(rnn_layer, vocab_size=len(vocab))
d2l.predict_ch8('time traveller', 10, net, vocab)
PaddlePaddle:
device = d2l.try_gpu()
net = RNNModel(rnn_layer, vocab_size=len(vocab))
d2l.predict_ch8('time traveller', 10, net, vocab, device)
Очевидно, что такая модель не выдаёт хороших результатов.
Далее мы вызываем train_ch8 с гиперпараметрами, определёнными в разделе 8.5, и обучаем модель с помощью высокоуровневого API.
MXNet, PyTorch:
num_epochs, lr = 500, 1
d2l.train_ch8(net, train_iter, vocab, lr, num_epochs, device)
TensorFlow:
num_epochs, lr = 500, 1
d2l.train_ch8(net, train_iter, vocab, lr, num_epochs, strategy)
PaddlePaddle:
num_epochs, lr = 500, 1.0
d2l.train_ch8(net, train_iter, vocab, lr, num_epochs, device)
По сравнению с предыдущим разделом модель благодаря более оптимизированному коду высокоуровневого API фреймворка за меньшее время достигает более низкой перплексии.
Резюме
- Высокоуровневый API фреймворков глубокого обучения предоставляет реализацию слоя рекуррентной нейронной сети.
- Рекуррентный слой высокоуровневого API возвращает выход и обновлённое скрытое состояние, а выходной слой всей модели нужно вычислить отдельно.
- По сравнению с рекуррентной нейронной сетью, реализованной с нуля, реализация с помощью высокоуровневого API ускоряет обучение.
Упражнения
- Попробуйте с помощью высокоуровневого API добиться переобучения модели рекуррентной нейронной сети. Получится ли?
- Что произойдёт, если увеличить число скрытых слоёв в модели рекуррентной нейронной сети? Будет ли модель работать корректно?
- Попробуйте с помощью рекуррентной нейронной сети реализовать авторегрессионную модель из раздела 8.1.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
8.7 Обратное распространение через время (BPTT)
До сих пор мы многократно упоминали такие понятия, как взрыв градиентов и затухание градиентов, а также необходимость отсоединять градиенты в рекуррентных сетях.
Например, в разделе 8.5 мы вызывали функцию detach для последовательности.
Чтобы быстро построить модель и понять, как она работает, мы не давали этим понятиям достаточного объяснения.
В этом разделе подробнее рассмотрим детали обратного распространения для моделей последовательностей и связанную с ним математику.
Когда мы впервые реализовывали рекуррентную нейронную сеть (раздел 8.5), мы столкнулись с проблемой взрыва градиентов. Если вы решали упражнения, то заметили, что отсечение градиентов крайне важно для сходимости модели. Чтобы лучше понять эту проблему, в этом разделе мы вспомним, как вычисляются градиенты для моделей последовательностей. Здесь нет ничего принципиально нового: мы по-прежнему используем цепное правило (правило дифференцирования сложной функции).
В разделе 4.7 мы описали прямое и обратное распространение для многослойного перцептрона и соответствующие вычислительные графы. В рекуррентной сети прямое распространение устроено относительно просто. Обратное распространение через время (backpropagation through time, BPTT) (Werbos, 1990) — это частный случай обратного распространения для рекуррентных нейронных сетей. Оно требует разворачивать вычислительный граф рекуррентной сети по одному временному шагу, чтобы получить зависимости между переменными модели и параметрами. Затем, используя цепное правило, применяем обратное распространение для вычисления и сохранения градиентов. Поскольку последовательность может быть довольно длинной, длинными могут быть и зависимости. Например, в последовательности из 1000 символов первый токен может сильно влиять на токен в конце. Такой расчёт невыполним на практике: он требует слишком много времени и памяти, а градиент получается через произведение более чем тысячи матриц и оказывается крайне неустойчивым. Процесс сопровождается и вычислительными, и статистическими неопределённостями. Ниже мы выясним, что происходит, и разберём, как решать эти проблемы на практике.
8.7.1 Анализ градиентов в рекуррентных нейронных сетях
Начнём с упрощённой модели, описывающей работу рекуррентной нейронной сети. Эта модель не учитывает всех особенностей скрытого состояния и деталей его обновления. Математическая запись здесь не различает явно скаляры, векторы и матрицы, поскольку для анализа эти детали не важны, а только усложнили бы обозначения.
В упрощённой модели скрытое состояние на временном шаге обозначим , вход — , выход — . Вспомним обсуждение в разделе 8.4.2: вход и скрытое состояние можно объединить и умножить на один весовой параметр скрытого слоя. Поэтому веса скрытого и выходного слоёв обозначим и соответственно. Скрытое состояние и выход на каждом временном шаге записываются так:
где и — преобразования скрытого и выходного слоёв соответственно. Таким образом, у нас есть цепочка , в которой элементы зависят друг от друга через рекуррентные вычисления. Прямое распространение устроено просто: мы поочерёдно проходим тройки по временным шагам, а затем с помощью целевой функции оцениваем разницу между выходами и соответствующими метками на всех временных шагах:
Для обратного распространения возникают более сложные вопросы, особенно при вычислении градиента целевой функции по параметру . Согласно цепному правилу:
В (8.7.2) первый и второй множители вычисляются легко, а вот третий, , создаёт трудности: нужно рекуррентно учесть влияние параметра на . Согласно рекуррентной формуле (8.7.1), зависит и от , и от , причём само тоже зависит от . Поэтому по цепному правилу получаем:
Чтобы вывести эти градиенты, рассмотрим три последовательности , для которых при выполнено и . Для легко получить:
Подставим вместо , и следующие выражения:
Тогда градиент в (8.7.3) удовлетворяет соотношению . Поэтому для каждого из (8.7.4) мы можем избавиться от рекуррентного вычисления в (8.7.3) и записать:
Хотя мы можем рекурсивно вычислять с помощью цепного правила, при большом цепочка становится очень длинной. Нужно найти способ справиться с этой проблемой.
8.7.1.1 Полное вычисление
Очевидно, можно просто вычислить всю сумму в (8.7.5). Однако такое вычисление очень медленное, и градиент может взрываться, поскольку малые изменения начальных условий могут сильно повлиять на результат. То есть возможен эффект, похожий на эффект бабочки: небольшое изменение начальных условий приводит к непропорционально большому изменению результата. Для оцениваемой модели это крайне нежелательно: мы ищем оценку, которая хорошо обобщается и устойчива. Поэтому на практике такой метод почти никогда не используют.
8.7.1.2 Усечение по времени
В качестве альтернативы можно усечь сумму в (8.7.5) после шагов. Именно это мы и делали до сих пор, например при отсоединении градиентов в разделе 8.5. Это даёт приближение истинного градиента: сумма обрывается на . На практике такой подход работает очень хорошо. Его обычно называют усечённым обратным распространением через время (Jaeger, 2002). Благодаря ему модель в основном учитывает краткосрочные влияния, а не долгосрочные. Это полезно, поскольку смещает оценку в сторону более простых и устойчивых моделей.
8.7.1.3 Случайное усечение
Наконец, можно заменить случайной величиной, которая в среднем даёт правильный результат, но при этом усекает последовательность. Для этого используется последовательность , заданная вероятностями : и , поэтому . Подставим её вместо градиента в (8.7.3):
Из определения следует, что . Каждый раз, когда , рекурсивное вычисление обрывается на временном шаге . В результате получается взвешенная сумма последовательностей разной длины, где длинные последовательности встречаются редко, поэтому им придаётся больший вес. Эту идею предложили Таллек и Оливье (Tallec and Ollivier, 2017).
8.7.1.4 Сравнение стратегий
Рис. 8.7.1. Сравнение стратегий вычисления градиентов в RNN: сверху вниз — случайное усечение, обычное усечение, полное вычисление
Рис. 8.7.1 иллюстрирует три стратегии обратного распространения через время при анализе первых символов книги «Машина времени» с помощью рекуррентной нейронной сети:
- первая строка — случайное усечение: текст разбивается на фрагменты разной длины;
- вторая строка — обычное усечение: текст разбивается на подпоследовательности одинаковой длины. Именно это мы делали в экспериментах с рекуррентными сетями;
- третья строка — полное обратное распространение через время: оно приводит к вычислительно неосуществимому выражению.
К сожалению, хотя случайное усечение теоретически привлекательно, на практике оно, вероятно, не лучше обычного усечения по нескольким причинам. Во-первых, после обратного распространения по нескольким последним временным шагам наблюдений уже достаточно, чтобы уловить реальные зависимости. Во-вторых, рост дисперсии нивелирует то преимущество, что более длинные временные шаги дают более точный градиент. В-третьих, нам на самом деле нужны модели, которые учитывают только короткодистанционные взаимодействия. Поэтому модели нужен именно тот лёгкий эффект регуляризации, который обеспечивает усечённое обратное распространение через время.
8.7.2 Детали обратного распространения через время
После общих принципов рассмотрим подробнее обратное распространение через время. В отличие от анализа из раздела 8.7.1, здесь мы покажем, как вычислить градиенты целевой функции по всем разложенным параметрам модели. Чтобы упростить изложение, рассмотрим рекуррентную нейронную сеть без параметров смещения, у которой в скрытом слое используется тождественное отображение в качестве функции активации (). Для временного шага пусть вход отдельного примера и соответствующая метка будут и . Скрытое состояние и выход вычисляются так:
где веса имеют размеры , и . Пусть — функция потерь на временном шаге . Тогда целевая функция — суммарные потери за временных шагов от начала последовательности — равна:
Чтобы визуализировать зависимости между переменными модели и её параметрами во время вычислений рекуррентной сети, можно построить вычислительный граф, показанный на рис. 8.7.2. Например, вычисление скрытого состояния на третьем шаге зависит от параметров модели и , от скрытого состояния предыдущего шага и от входа текущего шага .
Рис. 8.7.2. Граф вычислений, показывающий зависимости в рекуррентной нейронной сети с тремя временными шагами. Незакрашенные прямоугольники — переменные, закрашенные — параметры, кружки — операторы
Как уже было сказано, параметрами модели на рис. 8.7.2 являются , и . Обычно обучение требует вычисления градиентов по этим параметрам: , и . По зависимостям на рис. 8.7.2 можно обходить вычислительный граф против направления стрелок и последовательно вычислять и сохранять градиенты. Чтобы гибко представлять умножение матриц, векторов и скаляров различных форм в цепном правиле, мы используем оператор , описанный в разделе 4.7.
Сначала отметим, что в любой момент времени дифференцирование целевой функции по выходу модели вычисляется довольно просто:
Теперь можно вычислить градиент целевой функции по параметру выходного слоя : . По рис. 8.7.2 целевая функция зависит от через . По цепному правилу получаем:
где задаётся формулой (8.7.6).
Далее, как видно на рис. 8.7.2, на последнем временном шаге целевая функция зависит от скрытого состояния только через . Поэтому по цепному правилу градиент вычисляется легко:
Когда целевая функция зависит от через и , для любого временного шага всё становится сложнее. По цепному правилу градиент скрытого состояния при любом можно вычислить рекурсивно:
Для анализа раскроем рекурсию (8.7.8) для любого временного шага :
Из (8.7.9) видно, что даже в этом простом линейном примере проявляются ключевые проблемы моделей длинных последовательностей: в выражении возникает потенциально очень большая степень . В этой степени собственные значения, меньшие 1, исчезают, а большие 1 — расходятся. Это численно неустойчиво и проявляется в виде затухания или взрыва градиентов. Одно из решений — ограничить длину временных шагов по соображениям вычислительного удобства, как описано в разделе 8.7.1. На практике такое усечение реализуется отсоединением градиентов после заданного числа временных шагов. Позже мы узнаем, как более сложные модели последовательностей (например, LSTM) помогают смягчить эту проблему.
Наконец, из рис. 8.7.2 видно, что целевая функция зависит от параметров скрытого слоя и через скрытые состояния . Чтобы вычислить градиенты и , применим цепное правило:
где вычисляется рекурсивно по формулам (8.7.7) и (8.7.8) и является ключевой величиной, определяющей численную устойчивость.
Как мы объясняли в разделе 4.7, обратное распространение через время — это способ применения обратного распространения к рекуррентным нейронным сетям, поэтому обучение такой сети чередует прямое распространение и обратное распространение через время. Обратное распространение через время последовательно вычисляет и сохраняет указанные градиенты. В частности, сохранённые промежуточные значения повторно используются, чтобы не вычислять их заново; например, сохраняется , которое затем используется при вычислении и .
Резюме
- «Обратное распространение через время» применяется только к обратному распространению в моделях последовательностей со скрытыми состояниями.
- Усечение нужно для вычислительного удобства и численной устойчивости. Существует два вида усечения: обычное и случайное.
- Высокие степени матриц могут приводить к расхождению или затуханию собственных значений, что проявляется как взрыв или затухание градиентов.
- Для эффективности вычислений обратное распространение через время кэширует промежуточные значения во время вычислений.
Упражнения
- Пусть у нас есть симметричная матрица с собственными значениями и соответствующими собственными векторами (). Обычно считается, что собственные значения упорядочены так, что .
- Докажите, что имеет собственные значения .
- Докажите, что для случайного вектора вектор с высокой вероятностью будет лежать на одной прямой с собственным вектором матрицы . Формализуйте это доказательство.
- Что означают полученные результаты для градиентов в рекуррентных нейронных сетях?
- Существуют ли, кроме отсечения градиентов, другие способы борьбы со взрывом градиентов в рекуррентных нейронных сетях?
Литература
- Werbos, P. J. (1990). Backpropagation through time: What it does and how to do it. Proceedings of the IEEE, 78(10), 1550–1560.
- Jaeger, H. (2002). Tutorial on training recurrent neural networks, covering BPPT, RTRL, EKF and the “echo state network” approach (Vol. 5). GMD-Forschungszentrum Informationstechnik Bonn.
- Tallec, C., & Ollivier, Y. (2017). Unbiasing truncated backpropagation through time. arXiv preprint arXiv:1705.08209.
9. Современные рекуррентные нейронные сети
В предыдущей главе мы познакомились с основами рекуррентных нейронных сетей, которые лучше справляются с последовательными данными. Мы реализовали языковую модель на текстовых данных, но для многих современных задач обработки последовательностей этих методов может оказаться недостаточно.
Например, частая проблема рекуррентных нейронных сетей на практике — численная неустойчивость. Хотя мы уже применяли такие приёмы, как отсечение градиентов, чтобы смягчить эту проблему, её всё же нужно решать более сложными архитектурами последовательных моделей. Конкретно, мы представим две широко используемые сети: управляемый рекуррентный блок (gated recurrent unit, GRU) и долгую краткосрочную память (long short-term memory, LSTM). Затем расширим архитектуру рекуррентной нейронной сети с одним однонаправленным скрытым слоем. Опишем глубокие архитектуры с несколькими скрытыми слоями и обсудим двунаправленные конструкции, основанные на прямых и обратных рекуррентных вычислениях. Современные рекуррентные сети часто используют такие расширения. Объясняя эти варианты, мы продолжим рассматривать задачу языкового моделирования из главы 8.
На самом деле языковое моделирование раскрывает лишь малую часть возможностей обучения последовательностям. В самых разных задачах, например в автоматическом распознавании речи, преобразовании текста в речь и машинном переводе, и входы, и выходы — последовательности произвольной длины. Чтобы показать, как работать с такими данными, мы на примере машинного перевода опишем архитектуру «кодировщик — декодировщик» на основе рекуррентных нейронных сетей и лучевой поиск, с помощью которого генерируются последовательности.
9.1 Управляемый рекуррентный блок (GRU)
В разделе 8.7 мы рассмотрели, как вычисляются градиенты в рекуррентных нейронных сетях, и выяснили, что многократное умножение матриц может приводить к затуханию или взрыву градиентов. Посмотрим, что это значит на практике:
- Может сложиться ситуация, когда ранние наблюдения очень важны для прогнозирования всех последующих. Рассмотрим крайний случай: первое наблюдение содержит контрольную сумму, а цель — в конце последовательности определить, верна ли она. В этом случае влияние первого токена критически важно. Хотелось бы иметь механизм, который сохраняет важную раннюю информацию в ячейке памяти. Без такого механизма пришлось бы приписывать этому наблюдению очень большой градиент, поскольку оно влияет на все последующие наблюдения.
- Может сложиться ситуация, когда некоторые токены не несут полезной информации. Например, при анализе тональности веб-страницы вспомогательный HTML-код может не иметь отношения к эмоциям, которые передаёт страница. Хотелось бы иметь механизм, который пропускает такие токены при вычислении скрытого состояния.
- Может сложиться ситуация, когда между частями последовательности есть логический разрыв. Например, между главами книги или между периодами «медвежьего» и «бычьего» рынка ценных бумаг. В таком случае полезно иметь способ сбросить внутреннее представление состояния.
Для решения таких проблем в научной литературе предложено много методов. Одним из самых ранних была долгая краткосрочная память (long short-term memory, LSTM) (Hochreiter and Schmidhuber, 1997), которую мы рассмотрим в разделе 9.2. Управляемый рекуррентный блок (gated recurrent unit, GRU) (Cho et al., 2014b) — это немного упрощённый вариант LSTM, который обычно даёт сопоставимое качество, но вычисляется заметно быстрее (Chung et al., 2014). Поскольку управляемый блок проще, начнём с него.
9.1.1 Управление скрытым состоянием
Ключевое отличие управляемого рекуррентного блока от обычной рекуррентной нейронной сети в том, что первый поддерживает управление скрытым состоянием. Это значит, что у модели есть специальные механизмы, которые определяют, когда скрытое состояние нужно обновлять, а когда — сбрасывать. Эти механизмы обучаемые, и с их помощью можно решить перечисленные выше проблемы. Например, если первый токен очень важен, модель научится не обновлять скрытое состояние после первого наблюдения. Так же она научится пропускать нерелевантные наблюдения. Наконец, модель научится сбрасывать скрытое состояние, когда это потребуется. Подробнее о каждом из управляющих механизмов — ниже.
9.1.1.1 Вентиль сброса и вентиль обновления
Начнём с вентиля сброса (reset gate) и вентиля обновления (update gate). Спроектируем их как векторы со значениями из интервала , чтобы можно было строить выпуклые комбинации. Вентиль сброса позволяет контролировать, сколько из прошлого состояния, которое, возможно, ещё понадобится, нужно учесть. Вентиль обновления позволяет определить, какая часть нового состояния является копией старого.
На рис. 9.1.1 показано, как вентиль сброса и вентиль обновления получают входные данные: и тот и другой вычисляются по входу текущего временного шага и скрытому состоянию предыдущего шага. Выходы обоих вентилей формируются двумя полносвязными слоями с сигмоидной функцией активации.
Рис. 9.1.1. Вычисление вентиля сброса и вентиля обновления в модели управляемого рекуррентного блока (GRU)
Рассмотрим математическую запись управляемого рекуррентного блока. Для временного шага пусть вход — это минибатч (число примеров , число входов ), а скрытое состояние предыдущего шага — (число скрытых элементов ). Тогда вентиль сброса и вентиль обновления вычисляются так:
где и — весовые параметры, а — параметры смещения. Обратите внимание, что при суммировании срабатывает механизм broadcasting (см. раздел 2.1.3). Чтобы перевести значения в интервал , мы используем сигмоидную функцию (см. раздел 4.1).
9.1.1.2 Кандидат скрытого состояния
Далее объединим вентиль сброса с обычным механизмом обновления скрытого состояния из (8.4.3) и получим кандидат скрытого состояния (candidate hidden state) на временном шаге :
где и — весовые параметры, — параметр смещения, а символ обозначает поэлементное произведение (произведение Адамара). Здесь мы используем нелинейность tanh, чтобы значения кандидата оставались в интервале .
По сравнению с (8.4.3) в (9.1.1) элементы и перемножаются поэлементно, и это уменьшает влияние прошлых состояний. Когда элементы вентиля сброса близки к , мы возвращаемся к обычной рекуррентной нейронной сети из (8.4.3). Для элементов , близких к , кандидат скрытого состояния — это результат многослойного перцептрона, которому подан только вход . Значит, любое предыдущее скрытое состояние сбрасывается до значения по умолчанию.
На рис. 9.1.2 показан порядок вычислений после применения вентиля сброса.
Рис. 9.1.2. Вычисление кандидата скрытого состояния в модели управляемого рекуррентного блока
9.1.1.3 Скрытое состояние
Результат выше — это только кандидат скрытого состояния, и теперь нужно учесть действие вентиля обновления . Этот шаг определяет, в какой мере новое скрытое состояние берётся из старого , а в какой — из нового кандидата . Для этого достаточно поэлементно построить выпуклую комбинацию и , которую задаёт вентиль обновления . Так получается итоговая формула управляемого рекуррентного блока:
Когда вентиль обновления близок к , модель склонна сохранять старое состояние. В этом случае информация из по существу игнорируется, и шаг эффективно пропускается в цепочке зависимостей. Наоборот, когда близок к , новое скрытое состояние приближается к кандидату . Эти свойства помогают справиться с проблемой затухания градиентов в рекуррентных нейронных сетях и лучше улавливать зависимости между далеко расположенными временными шагами. Например, если вентиль обновления близок к на всех шагах некоторого подотрезка, то старое скрытое состояние из начала последовательности легко сохраняется и передаётся до её конца, независимо от длины последовательности.
На рис. 9.1.3 показано, как действие вентиля обновления влияет на поток вычислений.
Рис. 9.1.3. Вычисление скрытого состояния в модели управляемого рекуррентного блока
Итак, у управляемого рекуррентного блока две заметные особенности:
- вентиль сброса помогает улавливать краткосрочные зависимости в последовательности;
- вентиль обновления помогает улавливать долгосрочные зависимости в последовательности.
9.1.2 Реализация с нуля
Чтобы лучше понять модель управляемого рекуррентного блока, реализуем её с нуля. Сначала загрузим набор данных «Машина времени», который использовали в разделе 8.5:
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import rnn
npx.set_np()
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.nn.functional as F
from paddle import nn
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
9.1.2.1 Инициализация параметров модели
Следующий шаг — инициализация параметров модели. Веса мы извлекаем из нормального распределения со стандартным отклонением , а параметры смещения полагаем равными . Гиперпараметр num_hiddens задаёт число скрытых элементов. Создадим все веса и смещения, связанные с вентилем обновления, вентилем сброса, кандидатом скрытого состояния и выходным слоем.
MXNet:
def get_params(vocab_size, num_hiddens, device):
num_inputs = num_outputs = vocab_size
def normal(shape):
return np.random.normal(scale=0.01, size=shape, ctx=device)
def three():
return (normal((num_inputs, num_hiddens)),
normal((num_hiddens, num_hiddens)),
np.zeros(num_hiddens, ctx=device))
W_xz, W_hz, b_z = three() # Параметры вентиля обновления
W_xr, W_hr, b_r = three() # Параметры вентиля сброса
W_xh, W_hh, b_h = three() # Параметры кандидата скрытого состояния
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = np.zeros(num_outputs, ctx=device)
# Прикрепляем градиенты
params = [W_xz, W_hz, b_z, W_xr, W_hr, b_r, W_xh, W_hh, b_h, W_hq, b_q]
for param in params:
param.attach_grad()
return params
PyTorch:
def get_params(vocab_size, num_hiddens, device):
num_inputs = num_outputs = vocab_size
def normal(shape):
return torch.randn(size=shape, device=device)*0.01
def three():
return (normal((num_inputs, num_hiddens)),
normal((num_hiddens, num_hiddens)),
d2l.zeros(num_hiddens, device=device))
W_xz, W_hz, b_z = three() # Параметры вентиля обновления
W_xr, W_hr, b_r = three() # Параметры вентиля сброса
W_xh, W_hh, b_h = three() # Параметры кандидата скрытого состояния
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = d2l.zeros(num_outputs, device=device)
# Прикрепляем градиенты
params = [W_xz, W_hz, b_z, W_xr, W_hr, b_r, W_xh, W_hh, b_h, W_hq, b_q]
for param in params:
param.requires_grad_(True)
return params
TensorFlow:
def get_params(vocab_size, num_hiddens):
num_inputs = num_outputs = vocab_size
def normal(shape):
return d2l.normal(shape=shape,stddev=0.01,mean=0,dtype=tf.float32)
def three():
return (tf.Variable(normal((num_inputs, num_hiddens)), dtype=tf.float32),
tf.Variable(normal((num_hiddens, num_hiddens)), dtype=tf.float32),
tf.Variable(d2l.zeros(num_hiddens), dtype=tf.float32))
W_xz, W_hz, b_z = three() # Параметры вентиля обновления
W_xr, W_hr, b_r = three() # Параметры вентиля сброса
W_xh, W_hh, b_h = three() # Параметры кандидата скрытого состояния
# Параметры выходного слоя
W_hq = tf.Variable(normal((num_hiddens, num_outputs)), dtype=tf.float32)
b_q = tf.Variable(d2l.zeros(num_outputs), dtype=tf.float32)
params = [W_xz, W_hz, b_z, W_xr, W_hr, b_r, W_xh, W_hh, b_h, W_hq, b_q]
return params
PaddlePaddle:
def get_params(vocab_size, num_hiddens):
num_inputs = num_outputs = vocab_size
def normal(shape):
return paddle.randn(shape=shape)*0.01
def three():
return (normal((num_inputs, num_hiddens)),
normal((num_hiddens, num_hiddens)),
paddle.zeros([num_hiddens]))
W_xz, W_hz, b_z = three() # Параметры вентиля обновления
W_xr, W_hr, b_r = three() # Параметры вентиля сброса
W_xh, W_hh, b_h = three() # Параметры кандидата скрытого состояния
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = paddle.zeros([num_outputs])
# Прикрепляем градиенты
params = [W_xz, W_hz, b_z, W_xr, W_hr, b_r, W_xh, W_hh, b_h, W_hq, b_q]
for param in params:
param.stop_gradient = False
return params
9.1.2.2 Определение модели
Теперь определим функцию инициализации скрытого состояния init_gru_state. Как и функция init_rnn_state из раздела 8.5, она возвращает тензор формы (размер батча, число скрытых элементов), заполненный нулями.
MXNet:
def init_gru_state(batch_size, num_hiddens, device):
return (np.zeros(shape=(batch_size, num_hiddens), ctx=device), )
PyTorch:
def init_gru_state(batch_size, num_hiddens, device):
return (torch.zeros((batch_size, num_hiddens), device=device), )
TensorFlow:
def init_gru_state(batch_size, num_hiddens):
return (d2l.zeros((batch_size, num_hiddens)), )
PaddlePaddle:
def init_gru_state(batch_size, num_hiddens):
return (paddle.zeros([batch_size, num_hiddens]), )
Теперь мы готовы определить модель управляемого рекуррентного блока. Её архитектура совпадает с архитектурой базовой рекуррентной ячейки, отличаются только более сложные формулы обновления.
MXNet:
def gru(inputs, state, params):
W_xz, W_hz, b_z, W_xr, W_hr, b_r, W_xh, W_hh, b_h, W_hq, b_q = params
H, = state
outputs = []
for X in inputs:
Z = npx.sigmoid(np.dot(X, W_xz) + np.dot(H, W_hz) + b_z)
R = npx.sigmoid(np.dot(X, W_xr) + np.dot(H, W_hr) + b_r)
H_tilda = np.tanh(np.dot(X, W_xh) + np.dot(R * H, W_hh) + b_h)
H = Z * H + (1 - Z) * H_tilda
Y = np.dot(H, W_hq) + b_q
outputs.append(Y)
return np.concatenate(outputs, axis=0), (H,)
PyTorch:
def gru(inputs, state, params):
W_xz, W_hz, b_z, W_xr, W_hr, b_r, W_xh, W_hh, b_h, W_hq, b_q = params
H, = state
outputs = []
for X in inputs:
Z = torch.sigmoid((X @ W_xz) + (H @ W_hz) + b_z)
R = torch.sigmoid((X @ W_xr) + (H @ W_hr) + b_r)
H_tilda = torch.tanh((X @ W_xh) + ((R * H) @ W_hh) + b_h)
H = Z * H + (1 - Z) * H_tilda
Y = H @ W_hq + b_q
outputs.append(Y)
return torch.cat(outputs, dim=0), (H,)
TensorFlow:
def gru(inputs, state, params):
W_xz, W_hz, b_z, W_xr, W_hr, b_r, W_xh, W_hh, b_h, W_hq, b_q = params
H, = state
outputs = []
for X in inputs:
X = tf.reshape(X,[-1,W_xh.shape[0]])
Z = tf.sigmoid(tf.matmul(X, W_xz) + tf.matmul(H, W_hz) + b_z)
R = tf.sigmoid(tf.matmul(X, W_xr) + tf.matmul(H, W_hr) + b_r)
H_tilda = tf.tanh(tf.matmul(X, W_xh) + tf.matmul(R * H, W_hh) + b_h)
H = Z * H + (1 - Z) * H_tilda
Y = tf.matmul(H, W_hq) + b_q
outputs.append(Y)
return tf.concat(outputs, axis=0), (H,)
PaddlePaddle:
def gru(inputs, state, params):
W_xz, W_hz, b_z, W_xr, W_hr, b_r, W_xh, W_hh, b_h, W_hq, b_q = params
H,*_ = state
outputs = []
for X in inputs:
Z = F.sigmoid((X @ W_xz) + (H @ W_hz) + b_z)
R = F.sigmoid((X @ W_xr) + (H @ W_hr) + b_r)
H_tilda = paddle.tanh((X @ W_xh) + ((R * H) @ W_hh) + b_h)
H = Z * H + (1 - Z) * H_tilda
Y = H @ W_hq + b_q
outputs.append(Y)
return paddle.concat(outputs, axis=0), (H,*_)
9.1.2.3 Обучение и предсказание
Обучение и предсказание выполняются точно так же, как в разделе 8.5. По окончании обучения выведем перплексию на обучающем наборе, а также перплексию предсказанных последовательностей с префиксами «time traveler» и «traveler».
MXNet, PyTorch:
vocab_size, num_hiddens, device = len(vocab), 256, d2l.try_gpu()
num_epochs, lr = 500, 1
model = d2l.RNNModelScratch(len(vocab), num_hiddens, device, get_params,
init_gru_state, gru)
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
TensorFlow:
vocab_size, num_hiddens, device_name = len(vocab), 256, d2l.try_gpu()._device_name
# Определяем стратегию обучения
strategy = tf.distribute.OneDeviceStrategy(device_name)
num_epochs, lr = 500, 1
with strategy.scope():
model = d2l.RNNModelScratch(len(vocab), num_hiddens, init_gru_state, gru, get_params)
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, strategy)
PaddlePaddle:
vocab_size, num_hiddens, device = len(vocab), 256, d2l.try_gpu()
num_epochs, lr = 500, 1.0
model = d2l.RNNModelScratch(len(vocab), num_hiddens, get_params,
init_gru_state, gru)
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
9.1.3 Краткая реализация
Высокоуровневый API содержит все детали, которые мы разбирали выше, поэтому модель управляемого рекуррентного блока можно создать напрямую. Этот код работает значительно быстрее, потому что многие детали обрабатываются скомпилированными операторами, а не кодом на Python.
MXNet:
gru_layer = rnn.GRU(num_hiddens)
model = d2l.RNNModel(gru_layer, len(vocab))
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
PyTorch:
num_inputs = vocab_size
gru_layer = nn.GRU(num_inputs, num_hiddens)
model = d2l.RNNModel(gru_layer, len(vocab))
model = model.to(device)
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
TensorFlow:
gru_cell = tf.keras.layers.GRUCell(num_hiddens,
kernel_initializer='glorot_uniform')
gru_layer = tf.keras.layers.RNN(gru_cell, time_major=True,
return_sequences=True, return_state=True)
device_name = d2l.try_gpu()._device_name
strategy = tf.distribute.OneDeviceStrategy(device_name)
with strategy.scope():
model = d2l.RNNModel(gru_layer, vocab_size=len(vocab))
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, strategy)
PaddlePaddle:
num_inputs = vocab_size
gru_layer = nn.GRU(num_inputs, num_hiddens, time_major=True)
model = d2l.RNNModel(gru_layer, len(vocab))
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
Резюме
- Управляемые рекуррентные нейронные сети могут лучше улавливать зависимости между элементами последовательности, далеко расположенными друг от друга.
- Вентиль сброса помогает улавливать краткосрочные зависимости в последовательности.
- Вентиль обновления помогает улавливать долгосрочные зависимости в последовательности.
- Когда вентиль сброса открыт, управляемый рекуррентный блок ведёт себя как базовая рекуррентная сеть; когда открыт вентиль обновления, блок может пропускать подпоследовательности.
Упражнения
- Предположим, мы хотим использовать вход временного шага только для предсказания выхода на временном шаге . Каковы оптимальные значения вентилей сброса и обновления на каждом шаге?
- Настройте гиперпараметры и проанализируйте их влияние на время работы, перплексию и порядок выходных символов.
- Сравните, как разные реализации
rnn.RNNиrnn.GRUвлияют на время работы, перплексию и выходные строки. - Что будет, если реализовать только часть управляемого рекуррентного блока, например только вентиль сброса или только вентиль обновления?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735–1780.
- Cho, K., Van Merrienboer, B., Bahdanau, D., & Bengio, Y. (2014b). On the properties of neural machine translation: Encoder-decoder approaches. arXiv preprint arXiv:1409.1259.
- Chung, J., Gulcehre, C., Cho, K., & Bengio, Y. (2014). Empirical evaluation of gated recurrent neural networks on sequence modeling. arXiv preprint arXiv:1412.3555.
9.2 Долгая краткосрочная память (LSTM)
Долгое время у моделей со скрытыми переменными существовала проблема: сложно одновременно сохранять долгосрочную информацию и реагировать на короткие входные данные. Одним из самых ранних решений стала долгая краткосрочная память (long short-term memory, LSTM) (Hochreiter and Schmidhuber, 1997). У неё много общих свойств с управляемым рекуррентным блоком (раздел 9.1). Любопытно, что архитектура LSTM немного сложнее, чем у GRU, однако появилась она почти на двадцать лет раньше.
9.2.1 Ячейка памяти с вентилями
Архитектура LSTM, по-видимому, вдохновлена логическими вентилями компьютеров. LSTM вводит ячейку памяти (memory cell), или просто ячейку (cell). Некоторые авторы считают ячейку памяти особым видом скрытого состояния: у неё та же форма, что и у скрытого состояния, но предназначена она для хранения дополнительной информации. Чтобы управлять ячейкой памяти, нужно несколько вентилей. Один из них выводит содержимое ячейки наружу — это выходной вентиль (output gate). Другой решает, когда данные записываются в ячейку, — это входной вентиль (input gate). Нам также нужен механизм, который сбрасывает содержимое ячейки; им управляет вентиль забывания (forget gate). Мотивация та же, что и у управляемого рекуррентного блока: специальный механизм решает, когда запоминать входные данные или игнорировать их. Посмотрим, как это работает на практике.
9.2.1.1 Входной вентиль, вентиль забывания и выходной вентиль
Как и в управляемом рекуррентном блоке, входом для вентилей служат входные данные текущего временного шага и скрытое состояние предыдущего шага (рис. 9.2.1). Эти данные обрабатываются тремя полносвязными слоями с сигмоидной функцией активации, которые вычисляют значения входного вентиля, вентиля забывания и выходного вентиля. Поэтому значения всех трёх вентилей лежат в интервале .
Рис. 9.2.1. Входной вентиль, вентиль забывания и выходной вентиль в модели долгой краткосрочной памяти
Уточним математическую запись LSTM. Пусть есть скрытых элементов, размер батча равен , а число входов — . Тогда вход — это , а скрытое состояние предыдущего шага — . Соответственно, вентили на временном шаге определяются так: входной вентиль — , вентиль забывания — , выходной вентиль — . Их значения вычисляются по формулам:
где и — весовые параметры, а — параметры смещения.
9.2.1.2 Кандидат ячейки памяти
Поскольку работа вентилей пока не определена, сначала введём кандидат ячейки памяти (candidate memory cell) . Его вычисление похоже на вычисление трёх вентилей, но в качестве функции активации используется , и значения лежат в интервале . Уравнение на временном шаге имеет вид:
где и — весовые параметры, а — параметр смещения.
Кандидат ячейки памяти показан на рис. 9.2.2.
Рис. 9.2.2. Кандидат ячейки памяти в модели долгой краткосрочной памяти
9.2.1.3 Ячейка памяти
В управляемом рекуррентном блоке есть механизм, который контролирует запись новых данных и забывание старых. В LSTM есть похожая пара вентилей: входной вентиль определяет, сколько новых данных из нужно учесть, а вентиль забывания — сколько содержимого прошлой ячейки памяти сохранить. С помощью поэлементного умножения получаем:
Если вентиль забывания всегда равен , а входной вентиль — , то прошлая ячейка памяти сохраняется во времени и передаётся на текущий временной шаг. Такая конструкция введена, чтобы смягчить проблему затухания градиентов и лучше улавливать зависимости на больших расстояниях в последовательности.
Схема вычисления ячейки памяти показана на рис. 9.2.3.
Рис. 9.2.3. Вычисление ячейки памяти в модели долгой краткосрочной памяти
9.2.1.4 Скрытое состояние
Наконец, нужно определить, как вычисляется скрытое состояние . Здесь вступает в действие выходной вентиль. В LSTM скрытое состояние — это управляемая версия от ячейки памяти. Это гарантирует, что значения всегда лежат в интервале :
Когда выходной вентиль близок к , вся информация из памяти передаётся в блок предсказаний. Когда же выходной вентиль близок к , вся информация остаётся внутри ячейки памяти, а скрытое состояние не обновляется.
На рис. 9.2.4 показана схема движения данных.
Рис. 9.2.4. Вычисление скрытого состояния в модели долгой краткосрочной памяти
9.2.2 Реализация с нуля
Теперь реализуем LSTM с нуля. Как и в эксперименте из раздела 8.5, сначала загрузим набор данных «Машина времени»:
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import rnn
npx.set_np()
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
import paddle.nn.functional as Function
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
9.2.2.1 Инициализация параметров модели
Далее определим и инициализируем параметры модели. Как и раньше, гиперпараметр num_hiddens задаёт число скрытых элементов. Веса инициализируем из нормального распределения со стандартным отклонением , а параметры смещения полагаем равными .
MXNet:
def get_lstm_params(vocab_size, num_hiddens, device):
num_inputs = num_outputs = vocab_size
def normal(shape):
return np.random.normal(scale=0.01, size=shape, ctx=device)
def three():
return (normal((num_inputs, num_hiddens)),
normal((num_hiddens, num_hiddens)),
np.zeros(num_hiddens, ctx=device))
W_xi, W_hi, b_i = three() # Параметры входного вентиля
W_xf, W_hf, b_f = three() # Параметры вентиля забывания
W_xo, W_ho, b_o = three() # Параметры выходного вентиля
W_xc, W_hc, b_c = three() # Параметры кандидата ячейки памяти
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = np.zeros(num_outputs, ctx=device)
# Прикрепляем градиенты
params = [W_xi, W_hi, b_i, W_xf, W_hf, b_f, W_xo, W_ho, b_o, W_xc, W_hc,
b_c, W_hq, b_q]
for param in params:
param.attach_grad()
return params
PyTorch:
def get_lstm_params(vocab_size, num_hiddens, device):
num_inputs = num_outputs = vocab_size
def normal(shape):
return torch.randn(size=shape, device=device)*0.01
def three():
return (normal((num_inputs, num_hiddens)),
normal((num_hiddens, num_hiddens)),
d2l.zeros(num_hiddens, device=device))
W_xi, W_hi, b_i = three() # Параметры входного вентиля
W_xf, W_hf, b_f = three() # Параметры вентиля забывания
W_xo, W_ho, b_o = three() # Параметры выходного вентиля
W_xc, W_hc, b_c = three() # Параметры кандидата ячейки памяти
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = d2l.zeros(num_outputs, device=device)
# Прикрепляем градиенты
params = [W_xi, W_hi, b_i, W_xf, W_hf, b_f, W_xo, W_ho, b_o, W_xc, W_hc,
b_c, W_hq, b_q]
for param in params:
param.requires_grad_(True)
return params
TensorFlow:
def get_lstm_params(vocab_size, num_hiddens):
num_inputs = num_outputs = vocab_size
def normal(shape):
return tf.Variable(tf.random.normal(shape=shape, stddev=0.01,
mean=0, dtype=tf.float32))
def three():
return (normal((num_inputs, num_hiddens)),
normal((num_hiddens, num_hiddens)),
tf.Variable(tf.zeros(num_hiddens), dtype=tf.float32))
W_xi, W_hi, b_i = three() # Параметры входного вентиля
W_xf, W_hf, b_f = three() # Параметры вентиля забывания
W_xo, W_ho, b_o = three() # Параметры выходного вентиля
W_xc, W_hc, b_c = three() # Параметры кандидата ячейки памяти
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = tf.Variable(tf.zeros(num_outputs), dtype=tf.float32)
# Прикрепляем градиенты
params = [W_xi, W_hi, b_i, W_xf, W_hf, b_f, W_xo, W_ho, b_o, W_xc, W_hc,
b_c, W_hq, b_q]
return params
PaddlePaddle:
def get_lstm_params(vocab_size, num_hiddens):
num_inputs = num_outputs = vocab_size
def normal(shape):
return paddle.randn(shape=shape)*0.01
def three():
return (normal((num_inputs, num_hiddens)),
normal((num_hiddens, num_hiddens)),
d2l.zeros([num_hiddens]))
W_xi, W_hi, b_i = three() # Параметры входного вентиля
W_xf, W_hf, b_f = three() # Параметры вентиля забывания
W_xo, W_ho, b_o = three() # Параметры выходного вентиля
W_xc, W_hc, b_c = three() # Параметры кандидата ячейки памяти
# Параметры выходного слоя
W_hq = normal((num_hiddens, num_outputs))
b_q = d2l.zeros([num_outputs])
# Прикрепляем градиенты
params = [W_xi, W_hi, b_i, W_xf, W_hf, b_f, W_xo, W_ho, b_o, W_xc, W_hc,
b_c, W_hq, b_q]
for param in params:
param.stop_gradient = False
return params
9.2.2.2 Определение модели
В функции инициализации состояние LSTM должно возвращать дополнительную ячейку памяти: её значения равны 0, а форма — (размер батча, число скрытых элементов). Поэтому инициализация состояния выглядит так.
MXNet:
def init_lstm_state(batch_size, num_hiddens, device):
return (np.zeros((batch_size, num_hiddens), ctx=device),
np.zeros((batch_size, num_hiddens), ctx=device))
PyTorch:
def init_lstm_state(batch_size, num_hiddens, device):
return (torch.zeros((batch_size, num_hiddens), device=device),
torch.zeros((batch_size, num_hiddens), device=device))
TensorFlow:
def init_lstm_state(batch_size, num_hiddens):
return (tf.zeros(shape=(batch_size, num_hiddens)),
tf.zeros(shape=(batch_size, num_hiddens)))
PaddlePaddle:
def init_lstm_state(batch_size, num_hiddens):
return (paddle.zeros([batch_size, num_hiddens]),
paddle.zeros([batch_size, num_hiddens]))
Сама модель определена так, как мы обсуждали выше: три вентиля и дополнительная ячейка памяти. Обратите внимание, что в выходной слой передаётся только скрытое состояние, а ячейка памяти напрямую в вычислении выхода не участвует.
MXNet:
def lstm(inputs, state, params):
[W_xi, W_hi, b_i, W_xf, W_hf, b_f, W_xo, W_ho, b_o, W_xc, W_hc, b_c,
W_hq, b_q] = params
(H, C) = state
outputs = []
for X in inputs:
I = npx.sigmoid(np.dot(X, W_xi) + np.dot(H, W_hi) + b_i)
F = npx.sigmoid(np.dot(X, W_xf) + np.dot(H, W_hf) + b_f)
O = npx.sigmoid(np.dot(X, W_xo) + np.dot(H, W_ho) + b_o)
C_tilda = np.tanh(np.dot(X, W_xc) + np.dot(H, W_hc) + b_c)
C = F * C + I * C_tilda
H = O * np.tanh(C)
Y = np.dot(H, W_hq) + b_q
outputs.append(Y)
return np.concatenate(outputs, axis=0), (H, C)
PyTorch:
def lstm(inputs, state, params):
[W_xi, W_hi, b_i, W_xf, W_hf, b_f, W_xo, W_ho, b_o, W_xc, W_hc, b_c,
W_hq, b_q] = params
(H, C) = state
outputs = []
for X in inputs:
I = torch.sigmoid((X @ W_xi) + (H @ W_hi) + b_i)
F = torch.sigmoid((X @ W_xf) + (H @ W_hf) + b_f)
O = torch.sigmoid((X @ W_xo) + (H @ W_ho) + b_o)
C_tilda = torch.tanh((X @ W_xc) + (H @ W_hc) + b_c)
C = F * C + I * C_tilda
H = O * torch.tanh(C)
Y = (H @ W_hq) + b_q
outputs.append(Y)
return torch.cat(outputs, dim=0), (H, C)
TensorFlow:
def lstm(inputs, state, params):
W_xi, W_hi, b_i, W_xf, W_hf, b_f, W_xo, W_ho, b_o, W_xc, W_hc, b_c, W_hq, b_q = params
(H, C) = state
outputs = []
for X in inputs:
X=tf.reshape(X,[-1,W_xi.shape[0]])
I = tf.sigmoid(tf.matmul(X, W_xi) + tf.matmul(H, W_hi) + b_i)
F = tf.sigmoid(tf.matmul(X, W_xf) + tf.matmul(H, W_hf) + b_f)
O = tf.sigmoid(tf.matmul(X, W_xo) + tf.matmul(H, W_ho) + b_o)
C_tilda = tf.tanh(tf.matmul(X, W_xc) + tf.matmul(H, W_hc) + b_c)
C = F * C + I * C_tilda
H = O * tf.tanh(C)
Y = tf.matmul(H, W_hq) + b_q
outputs.append(Y)
return tf.concat(outputs, axis=0), (H,C)
PaddlePaddle:
def lstm(inputs, state, params):
[W_xi, W_hi, b_i, W_xf, W_hf, b_f, W_xo, W_ho, b_o, W_xc, W_hc, b_c,
W_hq, b_q] = params
(H, C) = state
outputs = []
for X in inputs:
I = Function.sigmoid((X @ W_xi) + (H @ W_hi) + b_i)
F = Function.sigmoid((X @ W_xf) + (H @ W_hf) + b_f)
O = Function.sigmoid((X @ W_xo) + (H @ W_ho) + b_o)
C_tilda = paddle.tanh((X @ W_xc) + (H @ W_hc) + b_c)
C = F * C + I * C_tilda
H = O * paddle.tanh(C)
Y = (H @ W_hq) + b_q
outputs.append(Y)
return paddle.concat(outputs, axis=0), (H, C)
9.2.2.3 Обучение и предсказание
Обучим LSTM, создав экземпляр класса RNNModelScratch, который мы ввели в разделе 8.5, так же как делали это для управляемого рекуррентного блока в разделе 9.1.
MXNet, PyTorch:
vocab_size, num_hiddens, device = len(vocab), 256, d2l.try_gpu()
num_epochs, lr = 500, 1
model = d2l.RNNModelScratch(len(vocab), num_hiddens, device, get_lstm_params,
init_lstm_state, lstm)
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
TensorFlow:
vocab_size, num_hiddens, device_name = len(vocab), 256, d2l.try_gpu()._device_name
num_epochs, lr = 500, 1
strategy = tf.distribute.OneDeviceStrategy(device_name)
with strategy.scope():
model = d2l.RNNModelScratch(len(vocab), num_hiddens, init_lstm_state, lstm, get_lstm_params)
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, strategy)
PaddlePaddle:
vocab_size, num_hiddens, device = len(vocab), 256, d2l.try_gpu()
num_epochs, lr = 500, 1.0
model = d2l.RNNModelScratch(len(vocab), num_hiddens, get_lstm_params,
init_lstm_state, lstm)
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
9.2.3 Краткая реализация
С помощью высокоуровневого API можно напрямую создать модель LSTM. Высокоуровневый API инкапсулирует все детали конфигурации, описанные выше. Этот код работает значительно быстрее, потому что многие детали обрабатываются скомпилированными операторами, а не кодом на Python.
MXNet:
lstm_layer = rnn.LSTM(num_hiddens)
model = d2l.RNNModel(lstm_layer, len(vocab))
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
PyTorch:
num_inputs = vocab_size
lstm_layer = nn.LSTM(num_inputs, num_hiddens)
model = d2l.RNNModel(lstm_layer, len(vocab))
model = model.to(device)
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
TensorFlow:
lstm_cell = tf.keras.layers.LSTMCell(num_hiddens,
kernel_initializer='glorot_uniform')
lstm_layer = tf.keras.layers.RNN(lstm_cell, time_major=True,
return_sequences=True, return_state=True)
device_name = d2l.try_gpu()._device_name
strategy = tf.distribute.OneDeviceStrategy(device_name)
with strategy.scope():
model = d2l.RNNModel(lstm_layer, vocab_size=len(vocab))
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, strategy)
PaddlePaddle:
num_inputs = vocab_size
lstm_layer = nn.LSTM(num_inputs, num_hiddens, time_major=True)
model = d2l.RNNModel(lstm_layer, len(vocab))
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
Долгая краткосрочная память — типичный пример авторегрессионной модели со скрытыми переменными и важным управлением состоянием. За годы было предложено много её вариантов, например многослойные модели, остаточные связи и различные виды регуляризации. Однако из-за длинных зависимостей в последовательностях обучение LSTM и других последовательных моделей, например управляемых рекуррентных блоков, остаётся достаточно затратным. В дальнейших главах мы рассмотрим более совершенные альтернативы, например Transformer.
Резюме
- В долгой краткосрочной памяти три типа вентилей: входной, забывания и выходной.
- Скрытый слой LSTM выдаёт «скрытое состояние» и «ячейку памяти». Только скрытое состояние передаётся в выходной слой, а ячейка памяти остаётся внутренней информацией.
- LSTM помогает смягчить проблемы затухающих и взрывных градиентов.
Упражнения
- Настройте гиперпараметры и проанализируйте их влияние на время работы, перплексию и порядок выходных символов.
- Как изменить модель, чтобы она генерировала слова, а не последовательности символов?
- При заданном размере скрытого слоя сравните вычислительные затраты управляемого рекуррентного блока, LSTM и обычной рекуррентной нейронной сети. Особое внимание уделите затратам на обучение и на вывод.
- Кандидат ячейки памяти уже ограничен интервалом благодаря функции . Зачем скрытому состоянию снова использовать , чтобы выход также оставался в интервале ?
- Реализуйте модель LSTM, которая делает прогнозы по временному ряду, а не по последовательности символов.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735–1780.
9.3 Глубокие рекуррентные нейронные сети
До сих пор мы рассматривали только рекуррентные нейронные сети с одним однонаправленным скрытым слоем. В них способ взаимодействия скрытых переменных и наблюдений с конкретными функциями выбирается довольно произвольно. Пока тип этого взаимодействия достаточно гибок, это не проблема. Однако для одного слоя задача может оказаться очень трудной. В линейных моделях мы решали такую задачу, добавляя больше слоёв. В рекуррентных нейронных сетях сначала нужно понять, как добавить слои и где вставить дополнительную нелинейность, поэтому вопрос непростой.
На самом деле можно сложить несколько рекуррентных слоёв друг на друга: комбинация простых слоёв даёт гибкий механизм. В частности, данные могут быть связаны с разными уровнями такой «стопки» слоёв. Например, мы хотим иметь доступ к макроданным о состоянии финансового рынка (медвежьем или бычьем), а микроданные фиксируют лишь краткосрочную динамику.
На рис. 9.3.1 показана глубокая рекуррентная нейронная сеть с скрытыми слоями: каждое скрытое состояние непрерывно передаётся на следующий временной шаг текущего слоя и на текущий временной шаг следующего слоя.
Рис. 9.3.1. Структура глубокой рекуррентной нейронной сети
9.3.1 Функциональные зависимости
Зависимости в глубокой архитектуре с скрытыми слоями (рис. 9.3.1) можно записать формально. Дальнейшее обсуждение в основном относится к классической рекуррентной нейронной сети, но сделанные выводы применимы и к другим последовательным моделям.
Пусть на временном шаге задан минибатч входных данных (число примеров , число входов в каждом примере ). Скрытое состояние -го скрытого слоя () обозначим через (число скрытых элементов ), а выход выходного слоя — через (число выходов ). Положим , а для -го скрытого слоя используем функцию активации . Тогда
где весовые параметры , и параметр смещения относятся к -му скрытому слою.
Наконец, выходной слой вычисляется только на основе скрытого состояния последнего, -го, скрытого слоя:
где весовой параметр и параметр смещения относятся к выходному слою.
Как и в многослойном перцептроне, число скрытых слоёв и число скрытых элементов — гиперпараметры. Иными словами, их можно настраивать. Кроме того, если в (9.3.1) заменить скрытое состояние на состояние управляемого рекуррентного блока или LSTM, легко получить глубокую управляемую рекуррентную сеть или глубокую LSTM.
9.3.2 Краткая реализация
Многие детали реализации многослойной рекуррентной сети уже есть в высокоуровневом API. Для простоты покажем только использование таких встроенных средств. Возьмём модель LSTM: код очень похож на код из раздела 9.2, и отличие лишь в том, что мы задаём число слоёв, а не используем значение по умолчанию (один слой). Как обычно, начнём с загрузки набора данных.
MXNet:
from d2l import mxnet as d2l
from mxnet import npx
from mxnet.gluon import rnn
npx.set_np()
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
batch_size, num_steps = 32, 35
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
Выбор архитектурных параметров тоже очень похож на тот, что мы делали в разделе 9.2. Поскольку словарь тот же, входы и выходы выбираем одного размера, то есть vocab_size. Число скрытых элементов по-прежнему равно . Единственное отличие: теперь число скрытых слоёв задаётся значением num_layers.
MXNet:
vocab_size, num_hiddens, num_layers = len(vocab), 256, 2
device = d2l.try_gpu()
lstm_layer = rnn.LSTM(num_hiddens, num_layers)
model = d2l.RNNModel(lstm_layer, len(vocab))
PyTorch:
vocab_size, num_hiddens, num_layers = len(vocab), 256, 2
num_inputs = vocab_size
device = d2l.try_gpu()
lstm_layer = nn.LSTM(num_inputs, num_hiddens, num_layers)
model = d2l.RNNModel(lstm_layer, len(vocab))
model = model.to(device)
PaddlePaddle:
vocab_size, num_hiddens, num_layers = len(vocab), 256, 2
num_inputs = vocab_size
device = d2l.try_gpu()
lstm_layer = nn.LSTM(num_inputs, num_hiddens, num_layers, time_major=True)
model = d2l.RNNModel(lstm_layer, len(vocab))
9.3.3 Обучение и предсказание
Поскольку мы использовали модель LSTM с двумя слоями, обучение заметно замедлилось.
num_epochs, lr = 500, 2
d2l.train_ch8(model, train_iter, vocab, lr*1.0, num_epochs, device)
Резюме
- В глубокой рекуррентной нейронной сети скрытое состояние передаётся на следующий временной шаг текущего слоя и на текущий временной шаг следующего слоя.
- Существует много вариантов глубоких рекуррентных нейронных сетей, например на основе LSTM, управляемых рекуррентных блоков или классических рекуррентных ячеек. Все они есть в высокоуровневых API фреймворков глубокого обучения.
- В целом глубокие рекуррентные сети требуют много настройки (например, скорости обучения и отсечения градиентов), чтобы обеспечить хорошую сходимость, а инициализацию модели нужно выполнять внимательно.
Упражнения
- Опираясь на реализацию одного слоя, которую мы рассмотрели в разделе 8.5, попробуйте реализовать с нуля двухслойную рекуррентную нейронную сеть.
- В модели, обученной в этом разделе, сравните точность и скорость обучения при замене LSTM на управляемый рекуррентный блок.
- Насколько низко можно снизить перплексию, если увеличить объём обучающих данных?
- При моделировании текста можно ли объединять исходные данные разных авторов? Каковы плюсы и минусы такого подхода?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
9.4 Двунаправленные рекуррентные нейронные сети
В задачах последовательного обучения мы обычно предполагали, что цель — при заданных наблюдениях смоделировать следующий выход (например, в контексте временного ряда или языковой модели). Это типичный сценарий, но не единственный. Какие ещё ситуации возможны? Рассмотрим три задачи на заполнение пропусков в текстовой последовательности:
- Я
___. - Я
___голоден. - Я
___голоден, и я могу съесть полсвиньи.
В зависимости от объёма доступной информации пропуск можно заполнить разными словами, например «рад» (happy), «не» (not) или «очень» (very). Очевидно, что контекст справа от пропуска (если он есть) несёт важную информацию, которая влияет на выбор слова. Поэтому последовательная модель, которая не может использовать этот контекст, будет плохо справляться с такими задачами. Например, для хорошего распознавания именованных сущностей (чтобы понять, означает ли «Green» «мистера Грина» или зелёный цвет) важен контекст разной длины по обе стороны от слова. Чтобы найти идею решения, сначала обратимся к вероятностным графическим моделям.
9.4.1 Динамическое программирование в скрытых марковских моделях
Этот подраздел нужен для иллюстрации задачи динамического программирования. Технические детали здесь не важны для понимания моделей глубокого обучения, но они помогают понять, зачем используется глубокое обучение и почему выбирается та или иная архитектура.
Если мы хотим решить задачу с помощью вероятностной графической модели, можно построить модель со скрытыми переменными. На каждом временном шаге предполагаем существование скрытой переменной , которая с вероятностью определяет наблюдаемое . Кроме того, любой переход задаётся вероятностью перехода . Такая графическая модель называется скрытой марковской моделью (hidden Markov model, HMM), см. рис. 9.4.1.
Рис. 9.4.1. Скрытая марковская модель
Итак, для последовательности из наблюдений совместное распределение наблюдаемых и скрытых состояний имеет вид:
Пусть мы наблюдаем все , кроме , и наша цель — вычислить , где . Поскольку в нет скрытых переменных, мы должны просуммировать по всем возможным комбинациям значений . Если каждая может принимать различных значений (конечное число состояний), нам придётся суммировать слагаемых, и эта задача очевидно невыполнима. К счастью, есть изящное решение — динамическое программирование (dynamic programming).
Чтобы понять, как работает динамическое программирование, рассмотрим последовательное суммирование по скрытым переменным . Из (9.4.1) получаем:
Обычно прямую рекурсию (forward recursion) записывают так:
Рекурсия инициализируется значением . Для краткости её можно записать как , где — некоторая обучаемая функция. Это похоже на уравнения обновления для скрытых переменных в рекуррентных нейронных сетях.
Как и с прямой рекурсией, мы можем использовать обратную рекурсию для суммирования по тем же скрытым переменным. В результате получаем:
Поэтому обратную рекурсию (backward recursion) можно записать так:
с инициализацией . И прямая, и обратная рекурсии позволяют просуммировать по всем значениям за время , то есть линейно, а не экспоненциально. Это одно из больших преимуществ вероятностного вывода с помощью графических моделей. Кроме того, это очень частный случай общего алгоритма передачи сообщений (Aji and McEliece, 2000). Комбинируя прямую и обратную рекурсии, мы получаем
Обратную рекурсию для краткости можно записать как , где — обучаемая функция. Снова это похоже на уравнение обновления, но только вычисляется оно не в прямом, а в обратном направлении, в отличие от того, что мы видели в рекуррентных нейронных сетях. Действительно, знание будущих данных полезно для скрытой марковской модели. Специалисты по обработке сигналов различают два случая — когда будущие наблюдения известны и когда их нет; это интерполяция и экстраполяция соответственно. Подробнее см. (Doucet et al., 2001).
9.4.2 Двунаправленные модели
Если мы хотим, чтобы в рекуррентной нейронной сети был механизм, который даёт возможность заглядывать вперёд, похожий на тот, что есть в скрытой марковской модели, нужно изменить архитектуру. Это несложно концептуально: достаточно добавить рекуррентную сеть, которая работает «от последнего токена к первому», то есть в обратном направлении, помимо сети, которая работает в прямом направлении, от первого токена. Двунаправленные рекуррентные нейронные сети (bidirectional RNNs) добавляют скрытый слой, передающий информацию в обратном направлении, и позволяют гибко обрабатывать такую информацию. На рис. 9.4.2 показана архитектура двунаправленной рекуррентной нейронной сети с одним скрытым слоем.
Рис. 9.4.2. Архитектура двунаправленной рекуррентной нейронной сети
По сути, это мало отличается от прямой и обратной рекурсий динамического программирования в скрытой марковской модели. Основное различие в том, что уравнения скрытой марковской модели имеют строгий статистический смысл, тогда как у двунаправленных рекуррентных сетей такой наглядной интерпретации нет: их можно рассматривать только как универсальные обучаемые функции. Этот переход хорошо иллюстрирует принцип современных глубоких сетей: сначала берут тип функциональной зависимости из классической статистической модели, а затем параметризуют её в общем виде.
9.4.2.1 Определение
Двунаправленные рекуррентные нейронные сети были предложены в работе (Schuster and Paliwal, 1997), подробное обсуждение различных архитектур есть в (Graves and Schmidhuber, 2005). Рассмотрим подробнее устройство такой сети.
Для произвольного временного шага пусть задан минибатч входных данных (число примеров , число входов в каждом примере ), а функция активации скрытого слоя — . В двунаправленной архитектуре пусть прямое и обратное скрытые состояния на временном шаге равны соответственно и , где — число скрытых элементов. Прямое и обратное скрытые состояния обновляются так:
где весовые параметры , , , и параметры смещения , — это параметры модели.
Затем прямое скрытое состояние и обратное скрытое состояние объединяются (конкатенируются), и получается скрытое состояние , которое передаётся в выходной слой. В глубокой двунаправленной рекуррентной нейронной сети с несколькими скрытыми слоями эта информация передаётся на вход следующего двунаправленного слоя. Наконец, выходной слой вычисляет выход (где — число выходных элементов):
Здесь весовая матрица и смещение — параметры выходного слоя. По сути, два направления могут иметь разное число скрытых элементов.
9.4.2.2 Вычислительные затраты модели и её применение
Ключевое свойство двунаправленной рекуррентной нейронной сети в том, что для вычисления выхода используется информация с обоих концов последовательности. То есть для предсказания текущего наблюдения мы используем наблюдения из прошлого и будущего. Но для предсказания следующего токена такая модель не подходит. Ведь при предсказании следующего токена мы не знаем, каким будет его правый контекст, поэтому точность окажется невысокой. В частности, во время обучения мы можем использовать прошлые и будущие данные, чтобы оценить пропущенное слово, а во время тестирования у нас есть только прошлые данные, и точность будет плохой. Следующий эксперимент это иллюстрирует.
Ещё одна серьёзная проблема: двунаправленные рекуррентные нейронные сети вычисляются очень медленно. Основная причина в том, что прямое распространение в такой сети требует прямой и обратной рекурсий в двунаправленных слоях, а обратное распространение зависит от результатов прямого распространения. Поэтому цепочка для вычисления градиентов получается очень длинной.
Двунаправленные слои на практике используются очень редко и только в отдельных случаях, например для заполнения пропущенных слов, аннотирования токенов (например, для распознавания именованных сущностей) и для кодирования последовательности как одного из этапов конвейера обработки (например, в машинном переводе). В разделах 14.8 и 15.2 мы покажем, как двунаправленные рекуррентные нейронные сети используются для кодирования текстовых последовательностей.
9.4.3 Ошибочное применение двунаправленных рекуррентных нейронных сетей
Поскольку двунаправленная рекуррентная нейронная сеть использует и прошлые, и будущие данные, мы не можем слепо применять эту языковую модель к любой задаче предсказания. Хотя перплексия, которую выдаёт модель, выглядит разумно, её способность предсказывать будущие токены может оказаться серьёзно ошибочной. Приведённый ниже пример кода служит предостережением: не используйте такие модели в неподходящих условиях.
MXNet:
from d2l import mxnet as d2l
from mxnet import npx
from mxnet.gluon import rnn
npx.set_np()
# Загружаем данные
batch_size, num_steps, device = 32, 35, d2l.try_gpu()
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
# Определяем двунаправленную LSTM-модель, задав bidirectional=True
vocab_size, num_hiddens, num_layers = len(vocab), 256, 2
lstm_layer = rnn.LSTM(num_hiddens, num_layers, bidirectional=True)
model = d2l.RNNModel(lstm_layer, len(vocab))
# Обучаем модель
num_epochs, lr = 500, 1
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
# Загружаем данные
batch_size, num_steps, device = 32, 35, d2l.try_gpu()
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
# Определяем двунаправленную LSTM-модель, задав bidirectional=True
vocab_size, num_hiddens, num_layers = len(vocab), 256, 2
num_inputs = vocab_size
lstm_layer = nn.LSTM(num_inputs, num_hiddens, num_layers, bidirectional=True)
model = d2l.RNNModel(lstm_layer, len(vocab))
model = model.to(device)
# Обучаем модель
num_epochs, lr = 500, 1
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
# Загружаем данные
batch_size, num_steps, device = 32, 35, d2l.try_gpu()
train_iter, vocab = d2l.load_data_time_machine(batch_size, num_steps)
# Определяем двунаправленную LSTM-модель, задав direction='bidirect'
vocab_size, num_hiddens, num_layers = len(vocab), 256, 2
num_inputs = vocab_size
lstm_layer = nn.LSTM(num_inputs, num_hiddens, num_layers, direction='bidirect', time_major=True)
model = d2l.RNNModel(lstm_layer, len(vocab))
# Обучаем модель
num_epochs, lr = 500, 1.0
d2l.train_ch8(model, train_iter, vocab, lr, num_epochs, device)
Полученный результат, очевидно, ошеломляет. О том, как эффективнее использовать двунаправленные рекуррентные нейронные сети, см. применение к классификации тональности в разделе 15.2.
Резюме
- В двунаправленной рекуррентной нейронной сети скрытое состояние на каждом временном шаге определяется одновременно данными, которые идут до и после этого шага.
- Двунаправленная рекуррентная нейронная сеть похожа на алгоритм «прямой — обратный» (forward-backward) в вероятностных графических моделях.
- Двунаправленные рекуррентные нейронные сети в основном используются для кодирования последовательностей и для оценки наблюдений при заданном двунаправленном контексте.
- Из-за более длинной цепочки градиентов обучение двунаправленных рекуррентных нейронных сетей очень дорого.
Упражнения
- Как изменится форма , если в разных направлениях использовать разное число скрытых элементов?
- Спроектируйте двунаправленную рекуррентную нейронную сеть с несколькими скрытыми слоями.
- В естественном языке многозначность слов очень распространена. Например, слово «bank» имеет разные значения в контекстах «i went to the bank to deposit cash» и «i went to the bank to sit down». Как спроектировать нейронную модель, которая по заданной последовательности контекста и слову возвращает векторное представление этого слова в данном контексте? Какой тип архитектуры нейронной сети лучше всего подходит для работы со многозначностью?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Aji, S. M., & McEliece, R. J. (2000). The generalized distributive law. IEEE Transactions on Information Theory, 46(2), 325–343.
- Doucet, A., De Freitas, N., & Gordon, N. (2001). An introduction to sequential Monte Carlo methods. In Sequential Monte Carlo methods in practice, 3–14.
- Schuster, M., & Paliwal, K. K. (1997). Bidirectional recurrent neural networks. IEEE Transactions on Signal Processing, 45(11), 2673–2681.
- Graves, A., & Schmidhuber, J. (2005). Framewise phoneme classification with bidirectional LSTM and other neural network architectures. Neural Networks, 18(5–6), 602–610.
9.5 Машинный перевод и набор данных
Языковые модели — ключ к обработке естественного языка, а машинный перевод (machine translation) — самый успешный эталон для их проверки. Машинный перевод — это центральная задача моделей преобразования последовательностей (sequence transduction), которые превращают входную последовательность в выходную. Такие модели играют решающую роль во многих современных приложениях искусственного интеллекта, поэтому им будут посвящены оставшаяся часть этой главы и глава 10. В этом разделе мы опишем задачу машинного перевода и набор данных, который понадобится дальше.
Машинный перевод (machine translation) — это автоматический перевод последовательности с одного языка на другой. Эта область восходит к 1940-м годам, сразу после появления цифровых компьютеров, когда их использовали для взлома языковых шифров во время Второй мировой войны. На протяжении десятилетий, до появления сквозного обучения с помощью нейронных сетей, доминировали статистические методы (Brown et al., 1988; Brown et al., 1990). Поскольку статистический машинный перевод (statistical machine translation) включает статистический анализ таких компонентов, как модель перевода и языковая модель, подходы на основе нейронных сетей часто называют нейронным машинным переводом (neural machine translation), чтобы отличать их от статистических.
В этой книге мы сосредоточимся на нейронных методах машинного перевода, подчёркивающих сквозное обучение. В отличие от задачи языкового моделирования, где корпус состоит из текста на одном языке (см. раздел 8.3), набор данных для машинного перевода состоит из пар текстовых последовательностей на исходном и целевом языках. Поэтому нам нужен совсем другой подход к предобработке набора данных для машинного перевода, а не повторное использование предобработки для языковых моделей. Далее посмотрим, как загрузить предобработанные данные в минибатчи для обучения.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
import os
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
import os
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
import os
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import os
9.5.1 Загрузка и предобработка набора данных
Сначала загрузим набор данных «английский — французский», состоящий из двуязычных пар предложений проекта Tatoeba. Каждая строка набора — пара текстовых последовательностей, разделённых табуляцией: английская последовательность и её французский перевод. Заметим, что каждая текстовая последовательность может быть как одним предложением, так и абзацем из нескольких предложений. В этой задаче перевода с английского на французский английский — исходный язык (source language), а французский — целевой язык (target language).
#@save
d2l.DATA_HUB['fra-eng'] = (d2l.DATA_URL + 'fra-eng.zip',
'94646ad1522d915e7b0f9296181140edcf86a4f5')
#@save
def read_data_nmt():
"""Загружает набор данных «английский — французский»"""
data_dir = d2l.download_extract('fra-eng')
with open(os.path.join(data_dir, 'fra.txt'), 'r',
encoding='utf-8') as f:
return f.read()
raw_text = read_data_nmt()
print(raw_text[:75])
После загрузки набора данных исходный текст проходит через несколько шагов предобработки. Например, мы заменяем неразрывные пробелы (non-breaking space) обычными пробелами, заменяем заглавные буквы строчными и вставляем пробелы между словами и знаками препинания.
#@save
def preprocess_nmt(text):
"""Предобрабатывает набор данных «английский — французский»"""
def no_space(char, prev_char):
return char in set(',.!?') and prev_char != ' '
# Заменяем неразрывные пробелы обычными пробелами
# Заменяем заглавные буквы строчными
text = text.replace(' ', ' ').replace('\xa0', ' ').lower()
# Вставляем пробелы между словами и знаками препинания
out = [' ' + char if i > 0 and no_space(char, text[i - 1]) else char
for i, char in enumerate(text)]
return ''.join(out)
text = preprocess_nmt(raw_text)
print(text[:80])
9.5.2 Токенизация
В отличие от посимвольной токенизации из раздела 8.3, в машинном переводе мы предпочитаем токенизацию по словам (самые современные модели могут использовать более сложные методы токенизации). Функция tokenize_nmt ниже токенизирует первые num_examples пар текстовых последовательностей. Каждый токен — это слово или знак препинания. Функция возвращает два списка токенов: source и target. source[i] — это список токенов -й текстовой последовательности исходного языка (здесь английского), а target[i] — список токенов -й текстовой последовательности целевого языка (здесь французского).
#@save
def tokenize_nmt(text, num_examples=None):
"""Токенизирует набор данных «английский — французский»"""
source, target = [], []
for i, line in enumerate(text.split('\n')):
if num_examples and i > num_examples:
break
parts = line.split('\t')
if len(parts) == 2:
source.append(parts[0].split(' '))
target.append(parts[1].split(' '))
return source, target
source, target = tokenize_nmt(text)
source[:6], target[:6]
Построим гистограмму числа токенов в каждой текстовой последовательности. В этом простом наборе данных «английский — французский» у большинства текстовых последовательностей меньше токенов.
#@save
def show_list_len_pair_hist(legend, xlabel, ylabel, xlist, ylist):
"""Строит гистограмму длин пар списков"""
d2l.set_figsize()
_, _, patches = d2l.plt.hist(
[[len(l) for l in xlist], [len(l) for l in ylist]])
d2l.plt.xlabel(xlabel)
d2l.plt.ylabel(ylabel)
for patch in patches[1].patches:
patch.set_hatch('/')
d2l.plt.legend(legend)
show_list_len_pair_hist(['source', 'target'], '# tokens per sequence',
'count', source, target);
9.5.3 Словарь
Поскольку набор данных для машинного перевода состоит из пар языков, мы можем построить два словаря: один для исходного языка и один для целевого. При пословной токенизации словарь получается заметно больше, чем при посимвольной. Чтобы смягчить эту проблему, здесь мы будем считать редкие токены, которые встречаются меньше 2 раз, одним и тем же неизвестным токеном <unk>. Кроме того, мы задаём дополнительные служебные токены: токен заполнения <pad>, который используется для выравнивания длины последовательностей в минибатче, а также токены начала последовательности <bos> и конца последовательности <eos>. Эти служебные токены часто используются в задачах обработки естественного языка.
src_vocab = d2l.Vocab(source, min_freq=2,
reserved_tokens=['<pad>', '<bos>', '<eos>'])
len(src_vocab)
9.5.4 Загрузка набора данных
Напомним, что в языковой модели последовательности-примеры имеют фиксированную длину, независимо от того, являются ли они частью предложения или фрагментом, охватывающим несколько предложений. Эта длина задаётся параметром num_steps (число временных шагов, или число токенов) из раздела 8.3. В машинном переводе каждый пример — это пара текстовых последовательностей, исходной и целевой, и длина каждой из них может быть разной.
Чтобы повысить эффективность вычислений, мы по-прежнему можем обрабатывать минибатчи текстовых последовательностей с помощью усечения (truncation) и дополнения (padding). Пусть все последовательности одного минибатча имеют одну и ту же длину num_steps. Если в последовательности меньше num_steps токенов, мы дописываем в её конец служебный токен <pad>, пока её длина не станет равна num_steps. Если же последовательность длиннее, мы усекаем её, оставляя первые num_steps токенов, а остальные отбрасываем. Так каждая текстовая последовательность получает одинаковую длину и может загружаться минибатчами одной формы.
Как и раньше, функция truncate_pad ниже обрезает или дополняет текстовую последовательность.
#@save
def truncate_pad(line, num_steps, padding_token):
"""Обрезает или дополняет текстовую последовательность"""
if len(line) > num_steps:
return line[:num_steps] # Обрезка
return line + [padding_token] * (num_steps - len(line)) # Дополнение
truncate_pad(src_vocab[source[0]], 10, src_vocab['<pad>'])
Теперь определим функцию, которая преобразует текстовые последовательности в минибатч для обучения. Мы добавляем служебный токен <eos> в конец каждой последовательности, чтобы обозначить её окончание. Когда модель генерирует последовательность токен за токеном, появление <eos> означает, что вывод завершён. Кроме того, мы записываем длину каждой текстовой последовательности, не учитывая токены заполнения: некоторые модели, которые мы рассмотрим позже, используют эту информацию.
#@save
def build_array_nmt(lines, vocab, num_steps):
"""Преобразует текстовые последовательности машинного перевода в минибатч"""
lines = [vocab[l] for l in lines]
lines = [l + [vocab['<eos>']] for l in lines]
array = d2l.tensor([truncate_pad(
l, num_steps, vocab['<pad>']) for l in lines])
valid_len = d2l.reduce_sum(
d2l.astype(array != vocab['<pad>'], d2l.int32), 1)
return array, valid_len
9.5.5 Обучение модели
Наконец, определим функцию load_data_nmt, которая возвращает итератор по данным, а также словари для исходного и целевого языков.
#@save
def load_data_nmt(batch_size, num_steps, num_examples=600):
"""Возвращает итератор по набору данных для перевода и словари"""
text = preprocess_nmt(read_data_nmt())
source, target = tokenize_nmt(text, num_examples)
src_vocab = d2l.Vocab(source, min_freq=2,
reserved_tokens=['<pad>', '<bos>', '<eos>'])
tgt_vocab = d2l.Vocab(target, min_freq=2,
reserved_tokens=['<pad>', '<bos>', '<eos>'])
src_array, src_valid_len = build_array_nmt(source, src_vocab, num_steps)
tgt_array, tgt_valid_len = build_array_nmt(target, tgt_vocab, num_steps)
data_arrays = (src_array, src_valid_len, tgt_array, tgt_valid_len)
data_iter = d2l.load_array(data_arrays, batch_size)
return data_iter, src_vocab, tgt_vocab
Теперь прочитаем первый минибатч из набора данных «английский — французский».
train_iter, src_vocab, tgt_vocab = load_data_nmt(batch_size=2, num_steps=8)
for X, X_valid_len, Y, Y_valid_len in train_iter:
print('X:', d2l.astype(X, d2l.int32))
print('действительная длина X:', X_valid_len)
print('Y:', d2l.astype(Y, d2l.int32))
print('действительная длина Y:', Y_valid_len)
break
Резюме
- Машинный перевод — это автоматический перевод текстовой последовательности с одного языка на другой.
- При пословной токенизации словарь заметно больше, чем при посимвольной. Чтобы его уменьшить, можно считать редкие токены одним и тем же неизвестным токеном.
- Усечение и дополнение текстовых последовательностей позволяют сделать все последовательности одинаковой длины и загружать их минибатчами.
Упражнения
- Попробуйте разные значения параметра
num_examplesв функцииload_data_nmt. Как это влияет на размеры словарей исходного и целевого языков? - В некоторых языках (например, китайском и японском) в тексте нет границ слов, таких как пробелы. Хорошая ли идея использовать пословную токенизацию в таком случае? Почему?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Brown, P. F., Cocke, J., Della Pietra, S. A., Della Pietra, V. J., Jelinek, F., Mercer, R. L., & Roossin, P. (1988). A statistical approach to language translation. Coling Budapest 1988 Volume 1: International Conference on Computational Linguistics.
- Brown, P. F., Cocke, J., Della Pietra, S. A., Della Pietra, V. J., Jelinek, F., Lafferty, J., Mercer, R. L., & Roossin, P. S. (1990). A statistical approach to machine translation. Computational Linguistics, 16(2), 79–85.
9.6 Архитектура «кодировщик — декодировщик»
Как мы обсуждали в разделе 9.5, машинный перевод — центральная задача моделей преобразования последовательностей, у которых и вход, и выход имеют переменную длину. Чтобы работать с такими входами и выходами, можно спроектировать архитектуру из двух основных компонентов. Первый компонент — кодировщик (encoder): он принимает последовательность переменной длины на входе и преобразует её в закодированное состояние фиксированной формы. Второй компонент — декодировщик (decoder): он отображает закодированное состояние фиксированной формы в последовательность переменной длины. Эта конструкция называется архитектурой «кодировщик — декодировщик» (encoder-decoder) и показана на рис. 9.6.1.
Рис. 9.6.1. Архитектура «кодировщик — декодировщик»
Рассмотрим перевод с английского на французский. Пусть на вход подана английская последовательность «They», «are», «watching», «.». Сначала архитектура «кодировщик — декодировщик» кодирует входную последовательность переменной длины в некоторое «состояние», а затем декодирует его: на выход по одному токену выдаётся переведённая последовательность «Ils», «regardent», «.». Поскольку архитектура «кодировщик — декодировщик» служит основой для разных моделей преобразования последовательностей в следующих главах, в этом разделе мы превратим её в набор интерфейсов, удобных для последующей реализации.
9.6.1 Кодировщик
В интерфейсе кодировщика мы задаём только входную последовательность переменной длины X. Любая модель, которая наследует базовый класс Encoder, должна реализовать его метод.
MXNet:
from mxnet.gluon import nn
#@save
class Encoder(nn.Block):
"""Базовый интерфейс кодировщика в архитектуре «кодировщик — декодировщик»"""
def __init__(self, **kwargs):
super(Encoder, self).__init__(**kwargs)
def forward(self, X, *args):
raise NotImplementedError
PyTorch:
from torch import nn
#@save
class Encoder(nn.Module):
"""Базовый интерфейс кодировщика в архитектуре «кодировщик — декодировщик»"""
def __init__(self, **kwargs):
super(Encoder, self).__init__(**kwargs)
def forward(self, X, *args):
raise NotImplementedError
TensorFlow:
import tensorflow as tf
#@save
class Encoder(tf.keras.layers.Layer):
"""Базовый интерфейс кодировщика в архитектуре «кодировщик — декодировщик»"""
def __init__(self, **kwargs):
super(Encoder, self).__init__(**kwargs)
def call(self, X, *args, **kwargs):
raise NotImplementedError
PaddlePaddle:
import warnings
warnings.filterwarnings("ignore")
from paddle import nn
#@save
class Encoder(nn.Layer):
"""Базовый интерфейс кодировщика в архитектуре «кодировщик — декодировщик»"""
def __init__(self, **kwargs):
super(Encoder, self).__init__(**kwargs)
def forward(self, X, *args):
raise NotImplementedError
9.6.2 Декодировщик
В интерфейсе декодировщика мы добавляем функцию init_state, которая преобразует выход кодировщика (enc_outputs) в закодированное состояние. Обратите внимание, что для этого шага может понадобиться дополнительный вход, например эффективная длина входной последовательности; это объясняется в разделе 9.5.4. Чтобы генерировать последовательность токенов переменной длины по одному токену, декодировщик на каждом временном шаге отображает входные данные (например, токен, сгенерированный на предыдущем шаге) и закодированное состояние в выходной токен текущего шага.
MXNet:
#@save
class Decoder(nn.Block):
"""Базовый интерфейс декодировщика в архитектуре «кодировщик — декодировщик»"""
def __init__(self, **kwargs):
super(Decoder, self).__init__(**kwargs)
def init_state(self, enc_outputs, *args):
raise NotImplementedError
def forward(self, X, state):
raise NotImplementedError
PyTorch:
#@save
class Decoder(nn.Module):
"""Базовый интерфейс декодировщика в архитектуре «кодировщик — декодировщик»"""
def __init__(self, **kwargs):
super(Decoder, self).__init__(**kwargs)
def init_state(self, enc_outputs, *args):
raise NotImplementedError
def forward(self, X, state):
raise NotImplementedError
TensorFlow:
#@save
class Decoder(tf.keras.layers.Layer):
"""Базовый интерфейс декодировщика в архитектуре «кодировщик — декодировщик»"""
def __init__(self, **kwargs):
super(Decoder, self).__init__(**kwargs)
def init_state(self, enc_outputs, *args):
raise NotImplementedError
def call(self, X, state, **kwargs):
raise NotImplementedError
PaddlePaddle:
#@save
class Decoder(nn.Layer):
"""Базовый интерфейс декодировщика в архитектуре «кодировщик — декодировщик»"""
def __init__(self, **kwargs):
super(Decoder, self).__init__(**kwargs)
def init_state(self, enc_outputs, *args):
raise NotImplementedError
def forward(self, X, state):
raise NotImplementedError
9.6.3 Объединение кодировщика и декодировщика
Итак, архитектура «кодировщик — декодировщик» содержит кодировщик и декодировщик и может иметь дополнительные параметры. В прямом распространении выход кодировщика используется для получения закодированного состояния, которое затем подаётся декодировщику как часть его входа.
MXNet:
#@save
class EncoderDecoder(nn.Block):
"""Базовый класс архитектуры «кодировщик — декодировщик»"""
def __init__(self, encoder, decoder, **kwargs):
super(EncoderDecoder, self).__init__(**kwargs)
self.encoder = encoder
self.decoder = decoder
def forward(self, enc_X, dec_X, *args):
enc_outputs = self.encoder(enc_X, *args)
dec_state = self.decoder.init_state(enc_outputs, *args)
return self.decoder(dec_X, dec_state)
PyTorch:
#@save
class EncoderDecoder(nn.Module):
"""Базовый класс архитектуры «кодировщик — декодировщик»"""
def __init__(self, encoder, decoder, **kwargs):
super(EncoderDecoder, self).__init__(**kwargs)
self.encoder = encoder
self.decoder = decoder
def forward(self, enc_X, dec_X, *args):
enc_outputs = self.encoder(enc_X, *args)
dec_state = self.decoder.init_state(enc_outputs, *args)
return self.decoder(dec_X, dec_state)
TensorFlow:
#@save
class EncoderDecoder(tf.keras.Model):
"""Базовый класс архитектуры «кодировщик — декодировщик»"""
def __init__(self, encoder, decoder, **kwargs):
super(EncoderDecoder, self).__init__(**kwargs)
self.encoder = encoder
self.decoder = decoder
def call(self, enc_X, dec_X, *args, **kwargs):
enc_outputs = self.encoder(enc_X, *args, **kwargs)
dec_state = self.decoder.init_state(enc_outputs, *args)
return self.decoder(dec_X, dec_state, **kwargs)
PaddlePaddle:
#@save
class EncoderDecoder(nn.Layer):
"""Базовый класс архитектуры «кодировщик — декодировщик»"""
def __init__(self, encoder, decoder, **kwargs):
super(EncoderDecoder, self).__init__(**kwargs)
self.encoder = encoder
self.decoder = decoder
def forward(self, enc_X, dec_X, *args):
enc_outputs = self.encoder(enc_X, *args)
dec_state = self.decoder.init_state(enc_outputs, *args)
return self.decoder(dec_X, dec_state)
Термин состояние в архитектуре «кодировщик — декодировщик» наводит на мысль, что для её реализации стоит использовать нейронные сети с состоянием. В следующем разделе мы разберём, как применять рекуррентные нейронные сети для построения моделей преобразования последовательностей на основе архитектуры «кодировщик — декодировщик».
Резюме
- Архитектура «кодировщик — декодировщик» принимает и выдаёт последовательности переменной длины, поэтому подходит для задач преобразования последовательностей, таких как машинный перевод.
- Кодировщик принимает последовательность переменной длины и преобразует её в закодированное состояние фиксированной формы.
- Декодировщик отображает закодированное состояние фиксированной формы в последовательность переменной длины.
Упражнения
- Предположим, что мы реализуем архитектуру «кодировщик — декодировщик» с помощью нейронных сетей. Обязаны ли кодировщик и декодировщик быть нейронными сетями одного и того же типа?
- Помимо машинного перевода, есть ли другие приложения, подходящие для архитектуры «кодировщик — декодировщик»?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
9.7 Обучение «последовательность в последовательность» (seq2seq)
Как мы видели в разделе 9.5, и входная, и выходная последовательности в машинном переводе имеют переменную длину. Чтобы решать такие задачи, в разделе 9.6 мы спроектировали общую архитектуру «кодировщик — декодировщик». В этом разделе мы используем две рекуррентные нейронные сети: кодировщик и декодировщик, и применим их к задачам обучения «последовательность в последовательность» (sequence to sequence, seq2seq) (Sutskever et al., 2014; Cho et al., 2014a).
Следуя принципам архитектуры «кодировщик — декодировщик», рекуррентный кодировщик принимает на вход последовательность переменной длины и преобразует её в скрытое состояние фиксированной формы. Иными словами, информация входной последовательности кодируется в скрытом состоянии рекуррентного кодировщика. Чтобы последовательно генерировать токены выходной последовательности, отдельный рекуррентный декодировщик предсказывает следующий токен, опираясь на закодированную информацию входной последовательности и на уже увиденные или сгенерированные токены выходной последовательности. На рис. 9.7.1 показано, как две рекуррентные нейронные сети используются для обучения «последовательность в последовательность» в задаче машинного перевода.
Рис. 9.7.1. Обучение «последовательность в последовательность» с рекуррентным кодировщиком и рекуррентным декодировщиком
На рис. 9.7.1 специальный токен <eos> обозначает конец последовательности. Как только выходная последовательность его генерирует, модель прекращает предсказание. В начальный временной шаг рекуррентного декодировщика принимаются два конструктивных решения. Во-первых, специальный токен <bos> обозначает начало последовательности и является первым токеном входа декодировщика. Во-вторых, скрытое состояние декодировщика инициализируется конечным скрытым состоянием рекуррентного кодировщика. Например, в работе (Sutskever et al., 2014) именно так закодированная информация входной последовательности передаётся декодировщику для генерации выходной последовательности. В других архитектурах (Cho et al., 2014a), как показано на рис. 9.7.1, конечное скрытое состояние кодировщика на каждом временном шаге также подаётся на вход декодировщика как часть входной последовательности. По аналогии с обучением языковой модели из раздела 8.3 можно сдвинуть метки: исходная выходная последовательность с токенами «Ils», «regardent», «.» и <eos> служит целевой для входа, который начинается с <bos>, «Ils», «regardent», «.». Так предсказание смещается на одну позицию.
Ниже мы реализуем архитектуру, показанную на рис. 9.7.1, и обучим модель машинного перевода на наборе данных «английский — французский», описанном в разделе 9.5.
MXNet:
import collections
from d2l import mxnet as d2l
import math
from mxnet import np, npx, init, gluon, autograd
from mxnet.gluon import nn, rnn
npx.set_np()
PyTorch:
import collections
from d2l import torch as d2l
import math
import torch
from torch import nn
TensorFlow:
import collections
from d2l import tensorflow as d2l
import math
import tensorflow as tf
PaddlePaddle:
import collections
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import paddle
from paddle import nn
9.7.1 Кодировщик
Технически кодировщик преобразует входную последовательность переменной длины в контекстную переменную фиксированной формы и кодирует в ней информацию входной последовательности. Как показано на рис. 9.7.1, для кодировщика можно использовать рекуррентную нейронную сеть.
Рассмотрим одну последовательность в качестве примера (размер батча равен ). Пусть входная последовательность — , где — -й токен входного текста. На временном шаге рекуррентная нейронная сеть преобразует входной вектор признаков токена и (скрытое состояние предыдущего шага) в (скрытое состояние текущего шага). Преобразование, которое выполняет рекуррентный слой, опишем функцией :
В целом кодировщик с помощью выбранной функции преобразует скрытые состояния всех временных шагов в контекстную переменную:
Например, если выбрать (как на рис. 9.7.1), контекстная переменная — это просто скрытое состояние входной последовательности на последнем временном шаге .
До сих пор мы использовали однонаправленную рекуррентную нейронную сеть для построения кодировщика, в которой скрытое состояние зависит только от подпоследовательности входа, начиная с первой позиции и до текущего временного шага (включительно). Можно построить кодировщик и на основе двунаправленной рекуррентной нейронной сети, в которой скрытое состояние зависит от двух подпоследовательностей: одной, которая идёт до текущего шага, и другой, которая идёт после него (включительно). Тогда скрытое состояние кодирует информацию обо всей последовательности.
Теперь реализуем рекуррентный кодировщик. Обратите внимание, что мы используем слой вложений (embedding layer), чтобы получить вектор признаков для каждого токена входной последовательности. Веса слоя вложений — это матрица, число строк которой равно размеру входного словаря (vocab_size), а число столбцов — размерности вектора признаков (embed_size). Для любого индекса входного токена слой вложений берёт -ю строку матрицы весов (нумерация с нуля) и возвращает его вектор признаков. Кроме того, для реализации кодировщика здесь выбран многослойный управляемый рекуррентный блок.
MXNet:
#@save
class Seq2SeqEncoder(d2l.Encoder):
"""Рекуррентный кодировщик для обучения «последовательность в последовательность»"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqEncoder, self).__init__(**kwargs)
# Слой вложений
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = rnn.GRU(num_hiddens, num_layers, dropout=dropout)
def forward(self, X, *args):
# Форма 'X': (batch_size, num_steps, embed_size)
X = self.embedding(X)
# В рекуррентных нейронных сетях первая ось соответствует временным шагам
X = X.swapaxes(0, 1)
state = self.rnn.begin_state(batch_size=X.shape[1], ctx=X.ctx)
output, state = self.rnn(X, state)
# Форма output: (num_steps, batch_size, num_hiddens)
# Форма state: (num_layers, batch_size, num_hiddens)
return output, state
PyTorch:
#@save
class Seq2SeqEncoder(d2l.Encoder):
"""Рекуррентный кодировщик для обучения «последовательность в последовательность»"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqEncoder, self).__init__(**kwargs)
# Слой вложений
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = nn.GRU(embed_size, num_hiddens, num_layers,
dropout=dropout)
def forward(self, X, *args):
# Форма 'X': (batch_size, num_steps, embed_size)
X = self.embedding(X)
# В рекуррентных нейронных сетях первая ось соответствует временным шагам
X = X.permute(1, 0, 2)
# Если состояние не задано, оно по умолчанию равно 0
output, state = self.rnn(X)
# Форма output: (num_steps, batch_size, num_hiddens)
# Форма state: (num_layers, batch_size, num_hiddens)
return output, state
TensorFlow:
#@save
class Seq2SeqEncoder(d2l.Encoder):
"""Рекуррентный кодировщик для обучения «последовательность в последовательность»"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers, dropout=0, **kwargs):
super().__init__(*kwargs)
# Слой вложений
self.embedding = tf.keras.layers.Embedding(vocab_size, embed_size)
self.rnn = tf.keras.layers.RNN(tf.keras.layers.StackedRNNCells(
[tf.keras.layers.GRUCell(num_hiddens, dropout=dropout)
for _ in range(num_layers)]), return_sequences=True,
return_state=True)
def call(self, X, *args, **kwargs):
# Форма входа 'X': (batch_size, num_steps)
# Форма выхода 'X': (batch_size, num_steps, embed_size)
X = self.embedding(X)
output = self.rnn(X, **kwargs)
state = output[1:]
return output[0], state
PaddlePaddle:
#@save
class Seq2SeqEncoder(d2l.Encoder):
"""Рекуррентный кодировщик для обучения «последовательность в последовательность»"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqEncoder, self).__init__(**kwargs)
weight_ih_attr = paddle.ParamAttr(initializer=nn.initializer.XavierUniform())
weight_hh_attr = paddle.ParamAttr(initializer=nn.initializer.XavierUniform())
# Слой вложений
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = nn.GRU(embed_size, num_hiddens, num_layers, dropout=dropout,
time_major=True, weight_ih_attr=weight_ih_attr, weight_hh_attr=weight_hh_attr)
def forward(self, X, *args):
# Форма 'X': (batch_size, num_steps, embed_size)
X = self.embedding(X)
# В рекуррентных нейронных сетях первая ось соответствует временным шагам
X = X.transpose([1, 0, 2])
# Если состояние не задано, оно по умолчанию равно 0
output, state = self.rnn(X)
# Форма output у слоя GRU в PaddlePaddle: (batch_size, time_steps, num_directions * num_hiddens),
# нужно задать time_major=True, чтобы первая размерность input была time_steps
# Форма state[0]: (num_layers, batch_size, num_hiddens)
return output, state
О возвращаемых значениях рекуррентного слоя см. раздел 8.6.
Теперь создадим экземпляр описанного выше кодировщика. Мы используем двухслойный управляемый рекуррентный блок с скрытыми элементами. Пусть задан минибатч входных последовательностей X (размер батча , временных шагов ). После обработки всех временных шагов выход последнего слоя — это тензор output, который возвращает рекуррентный слой кодировщика, формы (число временных шагов, размер батча, число скрытых элементов).
MXNet:
encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.initialize()
X = d2l.zeros((4, 7))
output, state = encoder(X)
output.shape
PyTorch:
encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.eval()
X = d2l.zeros((4, 7), dtype=torch.long)
output, state = encoder(X)
output.shape
TensorFlow:
encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16, num_layers=2)
X = tf.zeros((4, 7))
output, state = encoder(X, training=False)
output.shape
PaddlePaddle:
encoder = Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.eval()
X = d2l.zeros((4, 7), dtype=paddle.int64)
output, state = encoder(X)
output.shape
Поскольку мы используем управляемый рекуррентный блок, форма скрытого состояния на последнем временном шаге для нескольких слоёв равна (число скрытых слоёв, размер батча, число скрытых элементов). Если бы использовалась LSTM, в state также содержалась бы информация о ячейке памяти.
MXNet:
len(state), state[0].shape
PyTorch, PaddlePaddle:
state.shape
TensorFlow:
len(state), [element.shape for element in state]
9.7.2 Декодировщик
Как говорилось выше, контекстная переменная , которую выдаёт кодировщик, кодирует всю входную последовательность . Пусть выходная последовательность из обучающего набора данных — . Для каждого временного шага (он не совпадает с шагом входной последовательности или кодировщика) вероятность выхода декодировщика зависит от предыдущей выходной подпоследовательности и контекстной переменной , то есть .
Чтобы смоделировать такую условную вероятность для последовательностей, можно использовать ещё одну рекуррентную нейронную сеть в качестве декодировщика. На любом временном шаге выходной последовательности рекуррентная сеть принимает в качестве входа выход предыдущего шага и контекстную переменную . Затем она преобразует их вместе с предыдущим скрытым состоянием в скрытое состояние текущего шага. Поэтому преобразование скрытого слоя декодировщика можно записать функцией :
Получив скрытое состояние декодировщика, мы можем с помощью выходного слоя и операции softmax вычислить распределение условных вероятностей выхода на временном шаге : .
Как показано на рис. 9.7.1, при реализации декодировщика мы напрямую используем скрытое состояние кодировщика на последнем временном шаге, чтобы инициализировать скрытое состояние декодировщика. Поэтому рекуррентные кодировщик и декодировщик должны иметь одинаковое число слоёв и скрытых элементов. Чтобы дополнительно передать закодированную информацию входной последовательности, контекстная переменная соединяется (конкатенируется) с входом декодировщика на всех временных шагах. Для предсказания распределения вероятностей выходных токенов на последнем слое рекуррентного декодировщика используется полносвязный слой, который преобразует скрытое состояние.
MXNet:
class Seq2SeqDecoder(d2l.Decoder):
"""Рекуррентный декодировщик для обучения «последовательность в последовательность»"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqDecoder, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = rnn.GRU(num_hiddens, num_layers, dropout=dropout)
self.dense = nn.Dense(vocab_size, flatten=False)
def init_state(self, enc_outputs, *args):
return enc_outputs[1]
def forward(self, X, state):
# Форма 'X': (batch_size, num_steps, embed_size)
X = self.embedding(X).swapaxes(0, 1)
# Форма context: (batch_size, num_hiddens)
context = state[0][-1]
# Расширяем context (broadcast), чтобы у него было то же num_steps, что и у X
context = np.broadcast_to(context, (
X.shape[0], context.shape[0], context.shape[1]))
X_and_context = d2l.concat((X, context), 2)
output, state = self.rnn(X_and_context, state)
output = self.dense(output).swapaxes(0, 1)
# Форма output: (batch_size, num_steps, vocab_size)
# Форма state: (num_layers, batch_size, num_hiddens)
return output, state
PyTorch:
class Seq2SeqDecoder(d2l.Decoder):
"""Рекуррентный декодировщик для обучения «последовательность в последовательность»"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqDecoder, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = nn.GRU(embed_size + num_hiddens, num_hiddens, num_layers,
dropout=dropout)
self.dense = nn.Linear(num_hiddens, vocab_size)
def init_state(self, enc_outputs, *args):
return enc_outputs[1]
def forward(self, X, state):
# Форма 'X': (batch_size, num_steps, embed_size)
X = self.embedding(X).permute(1, 0, 2)
# Расширяем context (broadcast), чтобы у него было то же num_steps, что и у X
context = state[-1].repeat(X.shape[0], 1, 1)
X_and_context = d2l.concat((X, context), 2)
output, state = self.rnn(X_and_context, state)
output = self.dense(output).permute(1, 0, 2)
# Форма output: (batch_size, num_steps, vocab_size)
# Форма state: (num_layers, batch_size, num_hiddens)
return output, state
TensorFlow:
class Seq2SeqDecoder(d2l.Decoder):
"""Рекуррентный декодировщик для обучения «последовательность в последовательность»"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super().__init__(**kwargs)
self.embedding = tf.keras.layers.Embedding(vocab_size, embed_size)
self.rnn = tf.keras.layers.RNN(tf.keras.layers.StackedRNNCells(
[tf.keras.layers.GRUCell(num_hiddens, dropout=dropout)
for _ in range(num_layers)]), return_sequences=True,
return_state=True)
self.dense = tf.keras.layers.Dense(vocab_size)
def init_state(self, enc_outputs, *args):
return enc_outputs[1]
def call(self, X, state, **kwargs):
# Форма 'X': (batch_size, num_steps, embed_size)
X = self.embedding(X)
# Расширяем context (broadcast), чтобы у него было то же num_steps, что и у X
context = tf.repeat(tf.expand_dims(state[-1], axis=1), repeats=X.shape[1], axis=1)
X_and_context = tf.concat((X, context), axis=2)
rnn_output = self.rnn(X_and_context, state, **kwargs)
output = self.dense(rnn_output[0])
# Форма output: (batch_size, num_steps, vocab_size)
# state — список из num_layers элементов, каждый формы (batch_size, num_hiddens)
return output, rnn_output[1:]
PaddlePaddle:
class Seq2SeqDecoder(d2l.Decoder):
"""Рекуррентный декодировщик для обучения «последовательность в последовательность»"""
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqDecoder, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
weight_attr = paddle.ParamAttr(initializer=nn.initializer.XavierUniform())
weight_ih_attr = paddle.ParamAttr(initializer=nn.initializer.XavierUniform())
weight_hh_attr = paddle.ParamAttr(initializer=nn.initializer.XavierUniform())
self.rnn = nn.GRU(embed_size + num_hiddens, num_hiddens, num_layers, dropout=dropout,
time_major=True, weight_ih_attr=weight_ih_attr,weight_hh_attr=weight_hh_attr)
self.dense = nn.Linear(num_hiddens, vocab_size,weight_attr=weight_attr)
def init_state(self, enc_outputs, *args):
return enc_outputs[1]
def forward(self, X, state):
# Форма 'X': (batch_size, num_steps, embed_size)
X = self.embedding(X).transpose([1, 0, 2])
# Расширяем context (broadcast), чтобы у него было то же num_steps, что и у X
context = state[-1].tile([X.shape[0], 1, 1])
X_and_context = d2l.concat((X, context), 2)
output, state = self.rnn(X_and_context, state)
output = self.dense(output).transpose([1, 0, 2])
# Форма output: (batch_size, num_steps, vocab_size)
# Форма state[0]: (num_layers, batch_size, num_hiddens)
return output, state
Теперь создадим экземпляр декодировщика с теми же гиперпараметрами, что и у кодировщика. Как видно, форма выхода декодировщика становится (размер батча, число временных шагов, размер словаря), где последняя размерность тензора хранит распределение предсказанных токенов.
MXNet:
decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.initialize()
state = decoder.init_state(encoder(X))
output, state = decoder(X, state)
output.shape, len(state), state[0].shape
PyTorch:
decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.eval()
state = decoder.init_state(encoder(X))
output, state = decoder(X, state)
output.shape, state.shape
TensorFlow:
decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16, num_layers=2)
state = decoder.init_state(encoder(X))
output, state = decoder(X, state, training=False)
output.shape, len(state), state[0].shape
PaddlePaddle:
decoder = Seq2SeqDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.eval()
state = decoder.init_state(encoder(X))
output, state = decoder(X, state)
output.shape, state.shape
Итак, слои описанной выше модели «кодировщик — декодировщик» на основе рекуррентных нейронных сетей показаны на рис. 9.7.2.
Рис. 9.7.2. Слои модели «кодировщик — декодировщик» на основе рекуррентных нейронных сетей
9.7.3 Функция потерь
На каждом временном шаге декодировщик предсказывает распределение вероятностей выходных токенов. Как и в языковой модели, можно использовать softmax, чтобы получить распределение, и оптимизировать модель, вычисляя кросс-энтропийную функцию потерь. Напомним, что в разделе 9.5 в конец последовательностей были добавлены служебные токены заполнения, чтобы последовательности разной длины можно было загружать минибатчами одинаковой формы. Однако предсказания для токенов заполнения следует исключить из вычисления функции потерь.
Для этого можно использовать функцию sequence_mask ниже, которая обнуляет нерелевантные элементы, так что последующие вычисления с нерелевантными предсказаниями дают ноль при умножении. Например, если у двух последовательностей допустимые (без токенов заполнения) длины равны и , то первый элемент первой последовательности и первые два элемента второй остаются, а все остальные элементы обнуляются.
MXNet:
X = np.array([[1, 2, 3], [4, 5, 6]])
npx.sequence_mask(X, np.array([1, 2]), True, axis=1)
PyTorch:
#@save
def sequence_mask(X, valid_len, value=0):
"""Маскирует нерелевантные элементы в последовательности"""
maxlen = X.size(1)
mask = torch.arange((maxlen), dtype=torch.float32,
device=X.device)[None, :] < valid_len[:, None]
X[~mask] = value
return X
X = torch.tensor([[1, 2, 3], [4, 5, 6]])
sequence_mask(X, torch.tensor([1, 2]))
TensorFlow:
#@save
def sequence_mask(X, valid_len, value=0):
"""Маскирует нерелевантные элементы в последовательности"""
maxlen = X.shape[1]
mask = tf.range(start=0, limit=maxlen, dtype=tf.float32)[
None, :] < tf.cast(valid_len[:, None], dtype=tf.float32)
if len(X.shape) == 3:
return tf.where(tf.expand_dims(mask, axis=-1), X, value)
else:
return tf.where(mask, X, value)
X = tf.constant([[1, 2, 3], [4, 5, 6]])
sequence_mask(X, tf.constant([1, 2]))
PaddlePaddle:
#@save
def sequence_mask(X, valid_len, value=0):
"""Маскирует нерелевантные элементы в последовательности"""
maxlen = X.shape[1]
mask = paddle.arange((maxlen), dtype=paddle.float32)[None, :] < valid_len[:, None]
Xtype = X.dtype
X = X.astype(paddle.float32)
X[~mask] = float(value)
return X.astype(Xtype)
X = paddle.to_tensor([[1, 2, 3], [4, 5, 6]])
sequence_mask(X, paddle.to_tensor([1, 2]))
Мы также можем обнулять все элементы по последним осям. Если нужно, эти элементы можно заменить ненулевым значением.
MXNet:
X = d2l.ones((2, 3, 4))
npx.sequence_mask(X, np.array([1, 2]), True, value=-1, axis=1)
PyTorch:
X = d2l.ones(2, 3, 4)
sequence_mask(X, torch.tensor([1, 2]), value=-1)
TensorFlow:
X = tf.ones((2,3,4))
sequence_mask(X, tf.constant([1, 2]), value=-1)
PaddlePaddle:
X = d2l.ones([2, 3, 4])
sequence_mask(X, paddle.to_tensor([1, 2]), value=-1)
Теперь мы можем исключить нерелевантные предсказания, расширив функцию кросс-энтропийных потерь softmax. Сначала маски всех предсказанных токенов равны 1. Как только задана допустимая длина, маски токенов заполнения становятся равными 0. Наконец, потери всех токенов умножаются на маску, чтобы отфильтровать нерелевантные предсказания, возникающие из-за токенов заполнения.
MXNet:
class MaskedSoftmaxCELoss(gluon.loss.SoftmaxCELoss):
"""Softmax-функция кросс-энтропийных потерь с маскированием"""
# Форма pred: (batch_size, num_steps, vocab_size)
# Форма label: (batch_size, num_steps)
# Форма valid_len: (batch_size,)
def forward(self, pred, label, valid_len):
# Форма weights: (batch_size, num_steps, 1)
weights = np.expand_dims(np.ones_like(label), axis=-1)
weights = npx.sequence_mask(weights, valid_len, True, axis=1)
return super(MaskedSoftmaxCELoss, self).forward(pred, label, weights)
PyTorch:
#@save
class MaskedSoftmaxCELoss(nn.CrossEntropyLoss):
"""Softmax-функция кросс-энтропийных потерь с маскированием"""
# Форма pred: (batch_size, num_steps, vocab_size)
# Форма label: (batch_size, num_steps)
# Форма valid_len: (batch_size,)
def forward(self, pred, label, valid_len):
weights = torch.ones_like(label)
weights = sequence_mask(weights, valid_len)
self.reduction='none'
unweighted_loss = super(MaskedSoftmaxCELoss, self).forward(
pred.permute(0, 2, 1), label)
weighted_loss = (unweighted_loss * weights).mean(dim=1)
return weighted_loss
TensorFlow:
#@save
class MaskedSoftmaxCELoss(tf.keras.losses.Loss):
"""Softmax-функция кросс-энтропийных потерь с маскированием"""
def __init__(self, valid_len):
super().__init__(reduction='none')
self.valid_len = valid_len
# Форма pred: (batch_size, num_steps, vocab_size)
# Форма label: (batch_size, num_steps)
# Форма valid_len: (batch_size,)
def call(self, label, pred):
weights = tf.ones_like(label, dtype=tf.float32)
weights = sequence_mask(weights, self.valid_len)
label_one_hot = tf.one_hot(label, depth=pred.shape[-1])
unweighted_loss = tf.keras.losses.CategoricalCrossentropy(
from_logits=True, reduction='none')(label_one_hot, pred)
weighted_loss = tf.reduce_mean((unweighted_loss*weights), axis=1)
return weighted_loss
PaddlePaddle:
#@save
class MaskedSoftmaxCELoss(nn.CrossEntropyLoss):
"""Softmax-функция кросс-энтропийных потерь с маскированием"""
# Форма pred: (batch_size, num_steps, vocab_size)
# Форма label: (batch_size, num_steps)
# Форма valid_len: (batch_size,)
def forward(self, pred, label, valid_len):
weights = paddle.ones_like(label)
weights = sequence_mask(weights, valid_len)
self.reduction='none'
unweighted_loss = super(MaskedSoftmaxCELoss, self).forward(
pred, label)
weighted_loss = (unweighted_loss * weights).mean(axis=1)
return weighted_loss
Мы можем создать три одинаковые последовательности для проверки корректности кода, а затем задать для них допустимые длины , и . В результате потери первой последовательности должны быть вдвое больше, чем у второй, а потери третьей — равны нулю.
MXNet:
loss = MaskedSoftmaxCELoss()
loss(d2l.ones((3, 4, 10)), d2l.ones((3, 4)), np.array([4, 2, 0]))
PyTorch:
loss = MaskedSoftmaxCELoss()
loss(d2l.ones(3, 4, 10), d2l.ones((3, 4), dtype=torch.long),
torch.tensor([4, 2, 0]))
TensorFlow:
loss = MaskedSoftmaxCELoss(tf.constant([4, 2, 0]))
loss(tf.ones((3,4), dtype = tf.int32), tf.ones((3, 4, 10))).numpy()
PaddlePaddle:
loss = MaskedSoftmaxCELoss()
loss(d2l.ones([3, 4, 10]), d2l.ones((3, 4), dtype=paddle.int64),
paddle.to_tensor([4, 2, 0]))
9.7.4 Обучение
В приведённом ниже цикле обучения, как показано на рис. 9.7.1, специальный токен начала последовательности (<bos>) и исходная выходная последовательность (без токена конца <eos>) объединяются и подаются на вход декодировщика. Этот приём называется принудительным обучением (teacher forcing), потому что исходная выходная последовательность (метки токенов) подаётся в декодировщик. В качестве альтернативы текущим входом декодировщика может быть токен, полученный как предсказание на предыдущем временном шаге.
MXNet:
#@save
def train_seq2seq(net, data_iter, lr, num_epochs, tgt_vocab, device):
"""Обучает модель «последовательность в последовательность»"""
net.initialize(init.Xavier(), force_reinit=True, ctx=device)
trainer = gluon.Trainer(net.collect_params(), 'adam',
{'learning_rate': lr})
loss = MaskedSoftmaxCELoss()
animator = d2l.Animator(xlabel='epoch', ylabel='loss',
xlim=[10, num_epochs])
for epoch in range(num_epochs):
timer = d2l.Timer()
metric = d2l.Accumulator(2) # Сумма потерь на обучении и число токенов
for batch in data_iter:
X, X_valid_len, Y, Y_valid_len = [
x.as_in_ctx(device) for x in batch]
bos = np.array([tgt_vocab['<bos>']] * Y.shape[0],
ctx=device).reshape(-1, 1)
dec_input = np.concatenate([bos, Y[:, :-1]], 1) # Принудительное обучение
with autograd.record():
Y_hat, _ = net(X, dec_input, X_valid_len)
l = loss(Y_hat, Y, Y_valid_len)
l.backward()
d2l.grad_clipping(net, 1)
num_tokens = Y_valid_len.sum()
trainer.step(num_tokens)
metric.add(l.sum(), num_tokens)
if (epoch + 1) % 10 == 0:
animator.add(epoch + 1, (metric[0] / metric[1],))
print(f'loss {metric[0] / metric[1]:.3f}, {metric[1] / timer.stop():.1f} '
f'tokens/sec on {str(device)}')
PyTorch:
#@save
def train_seq2seq(net, data_iter, lr, num_epochs, tgt_vocab, device):
"""Обучает модель «последовательность в последовательность»"""
def xavier_init_weights(m):
if type(m) == nn.Linear:
nn.init.xavier_uniform_(m.weight)
if type(m) == nn.GRU:
for param in m._flat_weights_names:
if "weight" in param:
nn.init.xavier_uniform_(m._parameters[param])
net.apply(xavier_init_weights)
net.to(device)
optimizer = torch.optim.Adam(net.parameters(), lr=lr)
loss = MaskedSoftmaxCELoss()
net.train()
animator = d2l.Animator(xlabel='epoch', ylabel='loss',
xlim=[10, num_epochs])
for epoch in range(num_epochs):
timer = d2l.Timer()
metric = d2l.Accumulator(2) # Сумма потерь на обучении и число токенов
for batch in data_iter:
optimizer.zero_grad()
X, X_valid_len, Y, Y_valid_len = [x.to(device) for x in batch]
bos = torch.tensor([tgt_vocab['<bos>']] * Y.shape[0],
device=device).reshape(-1, 1)
dec_input = torch.cat([bos, Y[:, :-1]], 1) # Принудительное обучение
Y_hat, _ = net(X, dec_input, X_valid_len)
l = loss(Y_hat, Y, Y_valid_len)
l.sum().backward() # Обратное распространение от скаляра функции потерь
d2l.grad_clipping(net, 1)
num_tokens = Y_valid_len.sum()
optimizer.step()
with torch.no_grad():
metric.add(l.sum(), num_tokens)
if (epoch + 1) % 10 == 0:
animator.add(epoch + 1, (metric[0] / metric[1],))
print(f'loss {metric[0] / metric[1]:.3f}, {metric[1] / timer.stop():.1f} '
f'tokens/sec on {str(device)}')
TensorFlow:
#@save
def train_seq2seq(net, data_iter, lr, num_epochs, tgt_vocab, device):
"""Обучает модель «последовательность в последовательность»"""
optimizer = tf.keras.optimizers.Adam(learning_rate=lr)
animator = d2l.Animator(xlabel="epoch", ylabel="loss",
xlim=[10, num_epochs])
for epoch in range(num_epochs):
timer = d2l.Timer()
metric = d2l.Accumulator(2) # Сумма потерь на обучении и число токенов
for batch in data_iter:
X, X_valid_len, Y, Y_valid_len = [x for x in batch]
bos = tf.reshape(tf.constant([tgt_vocab['<bos>']] * Y.shape[0]),
shape=(-1, 1))
dec_input = tf.concat([bos, Y[:, :-1]], 1) # Принудительное обучение
with tf.GradientTape() as tape:
Y_hat, _ = net(X, dec_input, X_valid_len, training=True)
l = MaskedSoftmaxCELoss(Y_valid_len)(Y, Y_hat)
gradients = tape.gradient(l, net.trainable_variables)
gradients = d2l.grad_clipping(gradients, 1)
optimizer.apply_gradients(zip(gradients, net.trainable_variables))
num_tokens = tf.reduce_sum(Y_valid_len).numpy()
metric.add(tf.reduce_sum(l), num_tokens)
if (epoch + 1) % 10 == 0:
animator.add(epoch + 1, (metric[0] / metric[1],))
print(f'loss {metric[0] / metric[1]:.3f}, {metric[1] / timer.stop():.1f} '
f'tokens/sec on {str(device)}')
PaddlePaddle:
#@save
def train_seq2seq(net, data_iter, lr, num_epochs, tgt_vocab, device):
"""Обучает модель «последовательность в последовательность»"""
optimizer = paddle.optimizer.Adam(learning_rate=lr, parameters=net.parameters())
loss = MaskedSoftmaxCELoss()
net.train()
animator = d2l.Animator(xlabel='epoch', ylabel='loss',
xlim=[10, num_epochs])
for epoch in range(num_epochs):
timer = d2l.Timer()
metric = d2l.Accumulator(2) # Сумма потерь на обучении и число токенов
for batch in data_iter:
optimizer.clear_grad()
X, X_valid_len, Y, Y_valid_len = [paddle.to_tensor(x, place=device) for x in batch]
bos = paddle.to_tensor([tgt_vocab['<bos>']] * Y.shape[0]).reshape([-1, 1])
dec_input = paddle.concat([bos, Y[:, :-1]], 1) # Принудительное обучение
Y_hat, _ = net(X, dec_input, X_valid_len.squeeze())
l = loss(Y_hat, Y, Y_valid_len.squeeze())
l.backward() # Обратное распространение от скаляра функции потерь
d2l.grad_clipping(net, 1)
num_tokens = Y_valid_len.sum()
optimizer.step()
with paddle.no_grad():
metric.add(l.sum(), num_tokens)
if (epoch + 1) % 10 == 0:
animator.add(epoch + 1, (metric[0] / metric[1],))
print(f'loss {metric[0] / metric[1]:.3f}, {metric[1] / timer.stop():.1f} '
f'tokens/sec on {str(device)}')
Теперь на наборе данных для машинного перевода мы можем создать и обучить рекуррентную модель «кодировщик — декодировщик» для обучения «последовательность в последовательность».
embed_size, num_hiddens, num_layers, dropout = 32, 32, 2, 0.1
batch_size, num_steps = 64, 10
lr, num_epochs, device = 0.005, 300, d2l.try_gpu()
train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
encoder = Seq2SeqEncoder(len(src_vocab), embed_size, num_hiddens, num_layers,
dropout)
decoder = Seq2SeqDecoder(len(tgt_vocab), embed_size, num_hiddens, num_layers,
dropout)
net = d2l.EncoderDecoder(encoder, decoder)
train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
9.7.5 Предсказание
Чтобы предсказывать выходную последовательность токен за токеном, на каждом временном шаге декодировщика вход берётся из предсказанного токена предыдущего шага. Как и при обучении, в начальный временной шаг декодировщику подаётся токен начала последовательности (<bos>). Процесс предсказания показан на рис. 9.7.3. Он завершается, когда в выходной последовательности появляется токен конца последовательности (<eos>).
Рис. 9.7.3. Предсказание выходной последовательности токен за токеном с помощью рекуррентного кодировщика-декодировщика
Различные стратегии генерации последовательностей мы рассмотрим в разделе 9.8.
MXNet:
#@save
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps,
device, save_attention_weights=False):
"""Предсказание для модели «последовательность в последовательность»"""
src_tokens = src_vocab[src_sentence.lower().split(' ')] + [
src_vocab['<eos>']]
enc_valid_len = np.array([len(src_tokens)], ctx=device)
src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])
# Добавляем ось батча
enc_X = np.expand_dims(np.array(src_tokens, ctx=device), axis=0)
enc_outputs = net.encoder(enc_X, enc_valid_len)
dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)
# Добавляем ось батча
dec_X = np.expand_dims(np.array([tgt_vocab['<bos>']], ctx=device),
axis=0)
output_seq, attention_weight_seq = [], []
for _ in range(num_steps):
Y, dec_state = net.decoder(dec_X, dec_state)
# Токен с наибольшей предсказанной вероятностью подаём на вход декодировщика на следующем шаге
dec_X = Y.argmax(axis=2)
pred = dec_X.squeeze(axis=0).astype('int32').item()
# Сохраняем веса внимания (обсудим позже)
if save_attention_weights:
attention_weight_seq.append(net.decoder.attention_weights)
# Как только предсказан токен конца последовательности, генерация выхода завершается
if pred == tgt_vocab['<eos>']:
break
output_seq.append(pred)
return ' '.join(tgt_vocab.to_tokens(output_seq)), attention_weight_seq
PyTorch:
#@save
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps,
device, save_attention_weights=False):
"""Предсказание для модели «последовательность в последовательность»"""
# При предсказании переводим net в режим оценки
net.eval()
src_tokens = src_vocab[src_sentence.lower().split(' ')] + [
src_vocab['<eos>']]
enc_valid_len = torch.tensor([len(src_tokens)], device=device)
src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])
# Добавляем ось батча
enc_X = torch.unsqueeze(
torch.tensor(src_tokens, dtype=torch.long, device=device), dim=0)
enc_outputs = net.encoder(enc_X, enc_valid_len)
dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)
# Добавляем ось батча
dec_X = torch.unsqueeze(torch.tensor(
[tgt_vocab['<bos>']], dtype=torch.long, device=device), dim=0)
output_seq, attention_weight_seq = [], []
for _ in range(num_steps):
Y, dec_state = net.decoder(dec_X, dec_state)
# Токен с наибольшей предсказанной вероятностью подаём на вход декодировщика на следующем шаге
dec_X = Y.argmax(dim=2)
pred = dec_X.squeeze(dim=0).type(torch.int32).item()
# Сохраняем веса внимания (обсудим позже)
if save_attention_weights:
attention_weight_seq.append(net.decoder.attention_weights)
# Как только предсказан токен конца последовательности, генерация выхода завершается
if pred == tgt_vocab['<eos>']:
break
output_seq.append(pred)
return ' '.join(tgt_vocab.to_tokens(output_seq)), attention_weight_seq
TensorFlow:
#@save
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps,
save_attention_weights=False):
"""Предсказание для модели «последовательность в последовательность»"""
src_tokens = src_vocab[src_sentence.lower().split(' ')] + [
src_vocab['<eos>']]
enc_valid_len = tf.constant([len(src_tokens)])
src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])
# Добавляем ось батча
enc_X = tf.expand_dims(src_tokens, axis=0)
enc_outputs = net.encoder(enc_X, enc_valid_len, training=False)
dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)
# Добавляем ось батча
dec_X = tf.expand_dims(tf.constant([tgt_vocab['<bos>']]), axis=0)
output_seq, attention_weight_seq = [], []
for _ in range(num_steps):
Y, dec_state = net.decoder(dec_X, dec_state, training=False)
# Токен с наибольшей предсказанной вероятностью подаём на вход декодировщика на следующем шаге
dec_X = tf.argmax(Y, axis=2)
pred = tf.squeeze(dec_X, axis=0)
# Сохраняем веса внимания
if save_attention_weights:
attention_weight_seq.append(net.decoder.attention_weights)
# Как только предсказан токен конца последовательности, генерация выхода завершается
if pred == tgt_vocab['<eos>']:
break
output_seq.append(pred.numpy())
return ' '.join(tgt_vocab.to_tokens(tf.reshape(output_seq,
shape = -1).numpy().tolist())), attention_weight_seq
PaddlePaddle:
#@save
def predict_seq2seq(net, src_sentence, src_vocab, tgt_vocab, num_steps,
device, save_attention_weights=False):
"""Предсказание для модели «последовательность в последовательность»"""
# При предсказании переводим net в режим оценки
net.eval()
src_tokens = src_vocab[src_sentence.lower().split(' ')] + [
src_vocab['<eos>']]
enc_valid_len = paddle.to_tensor([len(src_tokens)], place=device)
src_tokens = d2l.truncate_pad(src_tokens, num_steps, src_vocab['<pad>'])
# Добавляем ось батча
enc_X = paddle.unsqueeze(
paddle.to_tensor(src_tokens, dtype=paddle.int64, place=device), axis=0)
enc_outputs = net.encoder(enc_X, enc_valid_len)
dec_state = net.decoder.init_state(enc_outputs, enc_valid_len)
# Добавляем ось батча
dec_X = paddle.unsqueeze(paddle.to_tensor(
[tgt_vocab['<bos>']], dtype=paddle.int64, place=device), axis=0)
output_seq, attention_weight_seq = [], []
for _ in range(num_steps):
Y, dec_state = net.decoder(dec_X, dec_state)
# Токен с наибольшей предсказанной вероятностью подаём на вход декодировщика на следующем шаге
dec_X = Y.argmax(axis=2)
pred = dec_X.squeeze(axis=0).astype(paddle.int32).item()
# Сохраняем веса внимания (обсудим позже)
if save_attention_weights:
attention_weight_seq.append(net.decoder.attention_weights)
# Как только предсказан токен конца последовательности, генерация выхода завершается
if pred == tgt_vocab['<eos>']:
break
output_seq.append(pred)
return ' '.join(tgt_vocab.to_tokens(output_seq)), attention_weight_seq
9.7.6 Оценка предсказанных последовательностей
Предсказанные последовательности можно оценивать, сравнивая их с истинными метками. Хотя метрика BLEU (bilingual evaluation understudy) (Papineni et al., 2002) первоначально предложена для оценки результатов машинного перевода, сейчас её широко используют для измерения качества выходных последовательностей во многих приложениях. По сути, для каждой -граммы предсказанной последовательности BLEU проверяет, встречается ли эта -грамма в последовательности меток.
Определим BLEU так:
где — число токенов в последовательности меток, — число токенов в предсказанной последовательности, а — длина самой длинной -граммы, используемой для сопоставления. Кроме того, — точность -грамм, то есть отношение двух величин: первая — число -грамм предсказанной последовательности, совпадающих с -граммами последовательности меток, вторая — общее число -грамм в предсказанной последовательности. Например, для меток , , , , , и предсказания , , , , получаем , , и .
Согласно определению BLEU (9.7.2), если предсказанная последовательность в точности совпадает с последовательностью меток, BLEU равен . Кроме того, поскольку более длинные -граммы сложнее совпасть, BLEU придаёт больший вес точности более длинных -грамм. Конкретно, при фиксированном величина растёт с увеличением (в исходной статье используется ). Поскольку более короткие предсказанные последовательности дают более высокие , множитель перед произведением в (9.7.2) штрафует короткие предсказания. Например, при для меток , , , , , и предсказания , хотя , штрафной множитель снижает BLEU.
Реализация BLEU приведена ниже.
#@save
def bleu(pred_seq, label_seq, k):
"""Вычисляет BLEU"""
pred_tokens, label_tokens = pred_seq.split(' '), label_seq.split(' ')
len_pred, len_label = len(pred_tokens), len(label_tokens)
score = math.exp(min(0, 1 - len_label / len_pred))
for n in range(1, k + 1):
num_matches, label_subs = 0, collections.defaultdict(int)
for i in range(len_label - n + 1):
label_subs[' '.join(label_tokens[i: i + n])] += 1
for i in range(len_pred - n + 1):
if label_subs[' '.join(pred_tokens[i: i + n])] > 0:
num_matches += 1
label_subs[' '.join(pred_tokens[i: i + n])] -= 1
score *= math.pow(num_matches / (len_pred - n + 1), math.pow(0.5, n))
return score
Наконец, с помощью обученной рекуррентной модели «кодировщик — декодировщик» переведём несколько английских предложений на французский и вычислим итоговое значение BLEU.
MXNet, PyTorch, PaddlePaddle:
engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
translation, attention_weight_seq = predict_seq2seq(
net, eng, src_vocab, tgt_vocab, num_steps, device)
print(f'{eng} => {translation}, bleu {bleu(translation, fra, k=2):.3f}')
TensorFlow:
engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
translation, attention_weight_seq = predict_seq2seq(
net, eng, src_vocab, tgt_vocab, num_steps)
print(f'{eng} => {translation}, bleu {bleu(translation, fra, k=2):.3f}')
Резюме
- В соответствии с архитектурой «кодировщик — декодировщик» две рекуррентные нейронные сети можно использовать для построения модели обучения «последовательность в последовательность».
- При реализации кодировщика и декодировщика можно использовать многослойные рекуррентные нейронные сети.
- Маскирование позволяет отфильтровать нерелевантные вычисления, например при вычислении потерь.
- При обучении «кодировщик — декодировщик» метод принудительного обучения подаёт в декодировщик исходную выходную последовательность, а не предсказанные результаты.
- BLEU — распространённая метрика оценки, которая измеряет совпадение -грамм предсказанной и эталонной последовательностей.
Упражнения
- Попробуйте улучшить качество перевода, подбирая гиперпараметры.
- Повторите эксперимент без маскирования при вычислении потерь. Что вы наблюдаете? Почему результат именно такой?
- Как инициализировать скрытое состояние декодировщика, если число слоёв или скрытых элементов у кодировщика и декодировщика различается?
- Что будет, если во время обучения вместо принудительного обучения подавать в декодировщик предсказания предыдущего временного шага?
- Повторите эксперименты, заменив управляемый рекуррентный блок на LSTM.
- Какие ещё способы можно использовать для построения выходного слоя декодировщика?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to sequence learning with neural networks. Advances in Neural Information Processing Systems, 3104–3112.
- Cho, K., Van Merrienboer, B., Gulcehre, C., Bahdanau, D., Bougares, F., Schwenk, H., & Bengio, Y. (2014a). Learning phrase representations using RNN encoder-decoder for statistical machine translation. arXiv preprint arXiv:1406.1078.
- Papineni, K., Roukos, S., Ward, T., & Zhu, W. J. (2002). BLEU: a method for automatic evaluation of machine translation. In Proceedings of the 40th Annual Meeting of the Association for Computational Linguistics, 311–318.
9.8 Лучевой поиск
В разделе 9.7 мы предсказывали выходную последовательность поэлементно, пока не появится специальный токен конца последовательности <eos>. В этом разделе сначала рассмотрим стратегию жадного поиска (greedy search) и обсудим её проблемы, а затем сравним её с альтернативами: исчерпывающим поиском (exhaustive search) и лучевым поиском (beam search).
Прежде чем вводить жадный поиск, определим задачу поиска с помощью тех же математических обозначений, что и в разделе 9.7. На любом временном шаге вероятность выхода декодировщика зависит от выходной подпоследовательности до этого шага и от контекстной переменной , которая кодирует информацию о входной последовательности. Чтобы оценить вычислительные затраты, обозначим выходной словарь через , включив в него <eos>. Тогда мощность — это размер словаря. Максимальное число токенов в выходной последовательности обозначим через . Наша цель — найти наилучшую выходную последовательность среди всех возможных. Разумеется, всё, что идёт после <eos>, не относится к предложению и отбрасывается в итоговом выводе.
9.8.1 Жадный поиск
Начнём с простой стратегии — жадного поиска, которую мы уже использовали для предсказания последовательностей в разделе 9.7. На каждом временном шаге выходной последовательности жадный поиск выбирает из токен с наибольшей условной вероятностью:
Генерация завершается, когда в выходе появляется <eos> или когда достигнута максимальная длина .
Рис. 9.8.1. На каждом временном шаге жадный поиск выбирает токен с наибольшей условной вероятностью
Как показано на рис. 9.8.1, предположим, что в выходе есть четыре токена: «A», «B», «C» и <eos>. Четыре числа на каждом временном шаге — это условные вероятности генерации «A», «B», «C» и <eos> на этом шаге. На каждом шаге жадный поиск выбирает токен с наибольшей условной вероятностью. Поэтому на рис. 9.8.1 будет предсказана выходная последовательность «A», «B», «C» и <eos>. Условная вероятность этой последовательности равна .
В чём же проблема жадного поиска? На практике оптимальная последовательность (optimal sequence) — это та выходная последовательность, которая максимизирует произведение , то есть условную вероятность выхода при заданном входе. Однако жадный поиск не может гарантировать, что найдёт оптимальную последовательность.
Рис. 9.8.2. На временном шаге 2 выбран токен «C» со второй по величине условной вероятностью (а не с наибольшей)
Другой пример на рис. 9.8.2 иллюстрирует эту проблему. В отличие от рис. 9.8.1, на временном шаге мы выбираем токен «C» с второй по величине условной вероятностью. Поскольку выходная подпоследовательность на шагах 1 и 2 изменилась с «A» и «B» (рис. 9.8.1) на «A» и «C» (рис. 9.8.2), условные вероятности токенов на шаге 3 тоже меняются. Пусть на шаге 3 выбран токен «B». Тогда текущий шаг 4 зависит от выходной подпоследовательности «A», «C» и «B» из первых трёх шагов, а не от «A», «B» и «C», как на рис. 9.8.1. Поэтому условные вероятности генерации токенов на шаге 4 на рис. 9.8.2 тоже отличаются от рис. 9.8.1. В результате условная вероятность выходной последовательности «A», «C», «B» и <eos> на рис. 9.8.2 равна , и это больше, чем у последовательности жадного поиска на рис. 9.8.1. Этот пример показывает, что последовательность «A», «B», «C» и <eos>, найденная жадным поиском, не обязательно является наилучшей.
9.8.2 Исчерпывающий поиск
Если цель — получить оптимальную последовательность, можно использовать исчерпывающий поиск (exhaustive search): перебрать все возможные выходные последовательности и их условные вероятности, а затем выбрать ту, у которой условная вероятность наибольшая.
Хотя исчерпывающий поиск позволяет найти оптимальную последовательность, его вычислительная сложность может оказаться поразительно высокой. Например, при и нужно перебрать последовательностей — это огромное число, которое современные компьютеры практически не в состоянии обработать. Вычислительная сложность жадного поиска значительно меньше, чем у исчерпывающего поиска. Например, при и нужно оценить лишь последовательностей.
9.8.3 Лучевой поиск
Какую же стратегию поиска выбрать? Если важнее всего точность, очевидный выбор — исчерпывающий поиск. Если важнее всего вычислительные затраты, очевидный выбор — жадный поиск. Практическое применение лучевого поиска лежит между этими крайностями.
Лучевой поиск (beam search) — это улучшенная версия жадного поиска. У него есть гиперпараметр — ширина луча (beam size) . На временном шаге мы выбираем токенов с наибольшей условной вероятностью. Эти токенов станут первыми токенами кандидатных выходных последовательностей. На каждом последующем временном шаге, опираясь на кандидатных выходных последовательностей предыдущего шага, мы продолжаем выбирать из возможных продолжений кандидатных последовательностей с наибольшей условной вероятностью.
Рис. 9.8.3. Процесс лучевого поиска (ширина луча: 2, максимальная длина выходной последовательности: 3). Кандидатные выходные последовательности: , , , , и
На рис. 9.8.3 показан процесс лучевого поиска. Пусть выходной словарь содержит только пять элементов , один из которых — <eos>. Ширина луча равна , а максимальная длина выходной последовательности — . На временном шаге токены с наибольшей условной вероятностью — это и . На временном шаге для всех вычисляем:
Из этих десяти значений выбираем два наибольших, например и . Затем на временном шаге для всех вычисляем:
Из этих десяти значений выбираем два наибольших, а именно и , и получаем шесть кандидатных выходных последовательностей: (1) ; (2) ; (3) ; (4) ; (5) ; (6) .
Наконец, на основе этих шести последовательностей (например, отбросив <eos> и всё, что идёт после него) получаем окончательное множество кандидатных выходных последовательностей. Затем выбираем ту из них, у которой нормированное по длине логарифмическое правдоподобие максимально:
где — длина окончательной кандидатной последовательности, а обычно равно . Поскольку более длинная последовательность содержит больше логарифмических слагаемых в сумме, знаменатель используется для штрафа за длину.
Вычислительная сложность лучевого поиска лежит между сложностями жадного и исчерпывающего поиска. Жадный поиск можно рассматривать как частный случай лучевого поиска с шириной луча . Выбирая ширину луча, можно найти компромисс между точностью и вычислительными затратами.
Резюме
- Стратегии поиска последовательностей включают жадный поиск, исчерпывающий поиск и лучевой поиск.
- Жадный поиск требует наименьших вычислений, но даёт относительно низкую точность.
- Исчерпывающий поиск даёт наивысшую точность, но требует наибольших вычислений.
- Лучевой поиск позволяет найти компромисс между точностью и вычислительными затратами, гибко выбирая ширину луча.
Упражнения
- Можно ли рассматривать исчерпывающий поиск как особый случай лучевого поиска? Почему?
- Примените лучевой поиск в задаче машинного перевода из раздела 9.7. Как ширина луча влияет на скорость предсказания и на результат?
- В разделе 8.5 мы генерировали текст с помощью языковой модели на основе заданного пользователем префикса. Какая стратегия поиска используется в этом примере? Можно ли её улучшить?
10. Механизмы внимания
Зрительная система приматов получает огромный объём сенсорных данных, который намного превышает то, что мозг способен полностью обработать. Однако не все стимулы одинаково важны. Сосредоточенность сознания позволяет приматам направлять внимание на интересующие объекты в сложной визуальной среде, например на добычу или хищника. Способность сосредотачиваться на небольшой части информации важна для эволюции: она помогает людям выживать и добиваться успеха.
С XIX века учёные изучают внимание в области когнитивной нейронауки. Многие разделы этой главы опираются на такие исследования.
Сначала мы рассмотрим классическую схему внимания, которая объясняет, как внимание распределяется в визуальной сцене. Вдохновляясь подсказками внимания (attention cues) из этой схемы, мы спроектируем модели, которые умеют их использовать. Ядерная регрессия Надарая — Ватсона (Nadaraya-Watson kernel regression) 1964 года — простая демонстрация машинного обучения с механизмом внимания (attention mechanism).
Далее мы рассмотрим функции внимания, которые широко применяются при проектировании моделей внимания в глубоком обучении. В частности, мы покажем, как с их помощью построить внимание Баданау (Bahdanau attention). Оно стало прорывом в глубоком обучении: выравнивает входы и выходы двунаправленно и допускает дифференцирование.
Наконец, мы опишем архитектуру Transformer, построенную только на механизмах внимания, в которой используются многоголовое внимание (multi-head attention) и самовнимание (self-attention). Со времени появления в 2017 году Transformer широко применяется в современных приложениях глубокого обучения: в обработке языка, компьютерном зрении, распознавании речи и обучении с подкреплением.
10.1 Подсказки внимания
Спасибо, что читаете эту книгу: внимание читателя — ограниченный ресурс. Сейчас вы читаете эту книгу и тем самым не читаете другие, поэтому ваше внимание оплачивается упущенной выгодой, подобно деньгам. Чтобы внимание, которое вы сейчас вкладываете, окупилось, авторы стараются (всем своим вниманием) написать хорошую книгу.
Экономика изучает распределение ограниченных ресурсов, и сегодня мы живём в эпоху «экономики внимания», где человеческое внимание рассматривают как обмениваемый, ограниченный, ценный и дефицитный товар. Многие бизнес-модели строятся на этом: в музыкальных и видеосервисах люди либо тратят внимание на рекламу, либо платят, чтобы её скрыть; в сетевых играх, чтобы расти, люди либо тратят внимание на бои и помогают привлекать новых игроков, либо платят, чтобы сразу стать сильнее. Словом, внимание не бывает бесплатным.
Внимание ограничено, а вокруг много информации, которая его отвлекает. Например, зрительный нерв человека передаёт около бит информации в секунду, что намного превышает то, что мозг способен полностью обработать. К счастью, наши предки уже из опыта (то есть из данных) поняли, что не все сенсорные данные одинаково важны. На протяжении всей истории человечества способность направлять внимание только на небольшую часть интересующей информации позволяла мозгу разумнее распределять ресурсы для выживания, роста и общения: для поиска хищников, еды и партнёров.
10.1.1 Подсказки внимания в биологии
Как внимание применяется к визуальному миру? Начнём с распространённой сегодня двухкомпонентной (two-component) схемы. Её истоки восходят к 1890-м годам, к Уильяму Джеймсу, которого считают «отцом американской психологии» (James, 2007). В этой схеме испытуемый целенаправленно выбирает фокус внимания, опираясь на непроизвольные подсказки и произвольные подсказки.
Непроизвольные подсказки основаны на заметности и броскости объектов в окружении. Представим, что перед нами пять предметов: газета, научная статья, чашка кофе, блокнот и книга (рис. 10.1.1). Все бумажные предметы напечатаны чёрно-белыми, а кофейная чашка красная. Иными словами, в этой визуальной обстановке чашка выделяется и невольно привлекает внимание. Поэтому мы направляем самый острый взгляд на кофе, как показано на рис. 10.1.1.
Рис. 10.1.1. Непроизвольная подсказка благодаря заметности (красная чашка): внимание непроизвольно направлено на чашку кофе
После кофе мы становимся бодрее и хотим почитать, поэтому поворачиваем голову, заново фокусируем взгляд и смотрим на книгу, как показано на рис. 10.1.2. В отличие от выбора на рис. 10.1.1, который определяется заметностью, выбор книги контролируется познанием и сознанием, поэтому внимание, опирающееся на произвольные подсказки, действует осторожнее. Сила такого выбора больше, поскольку его подталкивает субъективное намерение испытуемого.
Рис. 10.1.2. Произвольная подсказка, зависящая от задачи (хочется почитать книгу): внимание сознательно направлено на книгу
10.1.2 Запросы, ключи и значения
Произвольные и непроизвольные подсказки объясняют, как устроено человеческое внимание. Теперь посмотрим, как с помощью этих двух видов подсказок спроектировать нейросетевой механизм внимания.
Сначала рассмотрим относительно простой случай, когда используются только непроизвольные подсказки. Чтобы смещать выбор в сторону сенсорных входов, можно просто использовать параметризованный полносвязный слой или даже непараметризованные слои максимального или среднего пулинга.
Поэтому именно наличие произвольных подсказок отличает механизм внимания от полносвязных слоёв или слоёв пулинга. В контексте механизма внимания произвольные подсказки называют запросом (query). Для любого запроса механизм внимания через агрегацию внимания (attention pooling) направляет выбор на сенсорные входы (sensory inputs), например на промежуточные представления признаков. В механизме внимания такие сенсорные входы называют значениями (value). Более общо, каждое значение связано с ключом (key), который можно представить как непроизвольную подсказку для сенсорного входа. Как показано на рис. 10.1.3, агрегацию внимания можно спроектировать так, чтобы заданный запрос (произвольная подсказка) сопоставлялся с ключами (непроизвольными подсказками), и выбор падал на наиболее подходящее значение (сенсорный вход).
Рис. 10.1.3. Механизм внимания объединяет запрос (произвольную подсказку) и ключ (непроизвольную подсказку) через агрегацию внимания, что приводит к предпочтительному выбору значения (сенсорного входа)
Поскольку описанная схема занимает центральное место на рис. 10.1.3, модели, построенные по ней, станут основным объектом изучения в этой главе. Однако у механизмов внимания есть и альтернативы. Например, можно спроектировать недифференцируемую модель внимания и обучать её методами обучения с подкреплением (Mnih et al., 2014).
10.1.3 Визуализация внимания
Слой среднего пулинга можно рассматривать как взвешенное среднее входов, где веса всех входов одинаковы. На самом деле агрегация внимания даёт взвешенную сумму значений, а веса вычисляются между заданным запросом и разными ключами.
Чтобы визуализировать веса внимания, определим функцию show_heatmaps. Её вход matrices имеет форму (число строк для показа, число столбцов для показа, число запросов, число ключей).
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
#@save
def show_heatmaps(matrices, xlabel, ylabel, titles=None, figsize=(2.5, 2.5),
cmap='Reds'):
"""Отображает тепловые карты матриц"""
d2l.use_svg_display()
num_rows, num_cols = matrices.shape[0], matrices.shape[1]
fig, axes = d2l.plt.subplots(num_rows, num_cols, figsize=figsize,
sharex=True, sharey=True, squeeze=False)
for i, (row_axes, row_matrices) in enumerate(zip(axes, matrices)):
for j, (ax, matrix) in enumerate(zip(row_axes, row_matrices)):
pcm = ax.imshow(d2l.numpy(matrix), cmap=cmap)
if i == num_rows - 1:
ax.set_xlabel(xlabel)
if j == 0:
ax.set_ylabel(ylabel)
if titles:
ax.set_title(titles[j])
fig.colorbar(pcm, ax=axes, shrink=0.6);
В примере ниже вес внимания равен 1, только если запрос и ключ совпадают, а в остальных случаях равен 0.
attention_weights = d2l.reshape(d2l.eye(10), (1, 1, 10, 10))
show_heatmaps(attention_weights, xlabel='Keys', ylabel='Queries')
В следующих разделах функция show_heatmaps будет вызываться часто, чтобы показать веса внимания.
Резюме
- Внимание человека ограничено, ценно и дефицитно.
- Испытуемые избирательно направляют внимание, используя непроизвольные и произвольные подсказки. Первые основаны на заметности, вторые — на сознательном выборе.
- Механизм внимания отличается от полносвязных слоёв или слоёв пулинга наличием произвольных подсказок.
- Механизм внимания через агрегацию внимания смещает выбор в сторону значений (сенсорных входов), где запросы (произвольные подсказки) и ключи (непроизвольные подсказки) определяют веса. Ключи и значения образуют пары.
- Веса внимания между запросами и ключами можно визуализировать.
Упражнения
- При декодировании последовательности в машинном переводе какой может быть произвольная подсказка? Что будет непроизвольной подсказкой и сенсорным входом?
- Случайно сгенерируйте матрицу и примените операцию
softmax, чтобы каждая строка была корректным распределением вероятностей. Затем визуализируйте выходные веса внимания.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- James, W. (2007). The Principles of Psychology. Cosimo, Inc.
- Mnih, V., Heess, N., Graves, A., & others (2014). Recurrent models of visual attention. Advances in Neural Information Processing Systems, 2204–2212.
10.2 Агрегация внимания: ядерная регрессия Надарая — Ватсона
В предыдущем разделе мы ввели основные компоненты механизма внимания в рамках схемы из рис. 10.1.3: взаимодействие запроса (произвольная подсказка) и ключей (непроизвольные подсказки) образует агрегацию внимания, которая избирательно собирает значения (сенсорные входы) для получения итогового выхода. В этом разделе мы подробнее разберём агрегацию внимания, чтобы в общих чертах понимать, как механизм внимания работает на практике. Конкретно, модель ядерной регрессии Надарая — Ватсона 1964 года — простой, но полный пример, на котором можно продемонстрировать машинное обучение с механизмом внимания.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, gluon, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
tf.random.set_seed(seed=1322)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
10.2.1 Генерация набора данных
Для простоты рассмотрим следующую задачу регрессии: по заданному набору пар «вход — выход» как выучить функцию , которая предсказывает выход для любого нового входа ?
Сгенерируем искусственный набор данных по нелинейной функции с добавлением шума :
где распределён нормально, со средним и стандартным отклонением . Здесь мы создаём обучающих и тестовых примеров. Чтобы лучше визуализировать модели внимания, которые появятся позже, обучающие примеры отсортируем.
MXNet:
n_train = 50 # Число обучающих примеров
x_train = np.sort(d2l.rand(n_train) * 5) # Отсортированные обучающие примеры
PyTorch:
n_train = 50 # Число обучающих примеров
x_train, _ = torch.sort(d2l.rand(n_train) * 5) # Отсортированные обучающие примеры
TensorFlow:
n_train = 50
x_train = tf.sort(tf.random.uniform(shape=(n_train,), maxval=5))
PaddlePaddle:
n_train = 50 # Число обучающих примеров
x_train = paddle.sort(paddle.rand([n_train]) * 5) # Отсортированные обучающие примеры
MXNet:
def f(x):
return 2 * d2l.sin(x) + x**0.8
y_train = f(x_train) + d2l.normal(0.0, 0.5, (n_train,)) # Выходы обучающих примеров
x_test = d2l.arange(0, 5, 0.1) # Тестовые примеры
y_truth = f(x_test) # Истинные выходы тестовых примеров
n_test = len(x_test) # Число тестовых примеров
n_test
PyTorch:
def f(x):
return 2 * d2l.sin(x) + x**0.8
y_train = f(x_train) + d2l.normal(0.0, 0.5, (n_train,)) # Выходы обучающих примеров
x_test = d2l.arange(0, 5, 0.1) # Тестовые примеры
y_truth = f(x_test) # Истинные выходы тестовых примеров
n_test = len(x_test) # Число тестовых примеров
n_test
TensorFlow:
def f(x):
return 2 * d2l.sin(x) + x**0.8
y_train = f(x_train) + d2l.normal((n_train,), 0.0, 0.5) # Выходы обучающих примеров
x_test = d2l.arange(0, 5, 0.1) # Тестовые примеры
y_truth = f(x_test) # Истинные выходы тестовых примеров
n_test = len(x_test) # Число тестовых примеров
n_test
PaddlePaddle:
def f(x):
return 2 * paddle.sin(x) + x**0.8
y_train = f(x_train) + paddle.normal(0.0, 0.5, (n_train,)) # Выходы обучающих примеров
x_test = d2l.arange(0, 5, 0.1, dtype='float32') # Тестовые примеры
y_truth = f(x_test) # Истинные выходы тестовых примеров
n_test = len(x_test) # Число тестовых примеров
n_test
Следующая функция нарисует все обучающие примеры (они показаны кружками), истинную функцию генерации данных без шума (обозначена «Truth»), а также предсказанную функцию (обозначена «Pred»).
#@save
def plot_kernel_reg(y_hat):
d2l.plot(x_test, [y_truth, y_hat], 'x', 'y', legend=['Truth', 'Pred'],
xlim=[0, 5], ylim=[-1, 5])
d2l.plt.plot(x_train, y_train, 'o', alpha=0.5);
10.2.2 Среднее агрегирование
Начнём с самой простой оценки для решения задачи регрессии. Вычислим среднее значение выходов всех обучающих примеров:
Как видно на рисунке ниже, такая оценка действительно не очень умна: истинная функция («Truth») и предсказанная функция («Pred») сильно расходятся.
MXNet:
y_hat = y_train.mean().repeat(n_test)
plot_kernel_reg(y_hat)
PyTorch:
y_hat = torch.repeat_interleave(y_train.mean(), n_test)
plot_kernel_reg(y_hat)
TensorFlow:
y_hat = tf.repeat(tf.reduce_mean(y_train), repeats=n_test)
plot_kernel_reg(y_hat)
PaddlePaddle:
y_hat = paddle.repeat_interleave(y_train.mean(), n_test)
plot_kernel_reg(y_hat)
10.2.3 Непараметрическая агрегация внимания
Очевидно, что среднее агрегирование игнорирует входы . Поэтому Надарая (Nadaraya, 1964) и Ватсон (Watson, 1964) предложили более удачную идею: взвешивать выходы по положению входов:
где — ядро (kernel). Оценка, описанная формулой (10.2.2), называется ядерной регрессией Надарая — Ватсона (Nadaraya-Watson kernel regression). Здесь мы не будем углубляться в детали ядерных функций. Но, вдохновляясь этим примером, мы можем переписать (10.2.2) в рамках схемы механизма внимания из рис. 10.1.3 и получить более общую формулу агрегации внимания (attention pooling):
где — запрос, а — пары «ключ — значение». Сравнивая (10.2.3) и (10.2.1), видим, что агрегация внимания — это взвешенное среднее . Связь между запросом и ключом моделируется как вес внимания (attention weight) , который, как показано в (10.2.3), назначается каждому соответствующему значению . Для любого запроса веса внимания по всем парам «ключ — значение» образуют корректное распределение вероятностей: они неотрицательны и в сумме дают .
Чтобы лучше понять агрегацию внимания, рассмотрим гауссово ядро (Gaussian kernel):
Подставляя гауссово ядро в (10.2.3) и (10.2.2), получаем:
В (10.2.4) чем ближе ключ к заданному запросу , тем больше вес внимания, назначенный соответствующему значению , то есть тем больше «внимания» он получает.
Важно отметить, что ядерная регрессия Надарая — Ватсона — непараметрическая модель. Поэтому (10.2.4) — это непараметрическая агрегация внимания (nonparametric attention pooling). Далее мы построим предсказания именно на основе этой непараметрической модели. Из полученного графика видно, что линия предсказаний новой модели гладкая и ближе к истинной функции, чем предсказания среднего агрегирования.
MXNet:
# Форма X_repeat: (n_test, n_train),
# каждая строка содержит один и тот же тестовый вход (то есть один и тот же запрос)
X_repeat = d2l.reshape(x_test.repeat(n_train), (-1, n_train))
# x_train содержит ключи. Форма attention_weights: (n_test, n_train),
# каждая строка содержит веса внимания, которые распределяются между значениями (y_train) для каждого запроса
attention_weights = npx.softmax(-(X_repeat - x_train)**2 / 2)
# Каждый элемент y_hat — взвешенное среднее значений, где весами служат веса внимания
y_hat = d2l.matmul(attention_weights, y_train)
plot_kernel_reg(y_hat)
PyTorch:
# Форма X_repeat: (n_test, n_train),
# каждая строка содержит один и тот же тестовый вход (то есть один и тот же запрос)
X_repeat = d2l.reshape(x_test.repeat_interleave(n_train), (-1, n_train))
# x_train содержит ключи. Форма attention_weights: (n_test, n_train),
# каждая строка содержит веса внимания, которые распределяются между значениями (y_train) для каждого запроса
attention_weights = nn.functional.softmax(-(X_repeat - x_train)**2 / 2, dim=1)
# Каждый элемент y_hat — взвешенное среднее значений, где весами служат веса внимания
y_hat = d2l.matmul(attention_weights, y_train)
plot_kernel_reg(y_hat)
TensorFlow:
# Форма X_repeat: (n_test, n_train),
# каждая строка содержит один и тот же тестовый вход (то есть один и тот же запрос)
X_repeat = tf.repeat(tf.expand_dims(x_train, axis=0), repeats=n_train, axis=0)
# x_train содержит ключи. Форма attention_weights: (n_test, n_train),
# каждая строка содержит веса внимания, которые распределяются между значениями (y_train) для каждого запроса
attention_weights = tf.nn.softmax(-(X_repeat - tf.expand_dims(x_train, axis=1))**2/2, axis=1)
# Каждый элемент y_hat — взвешенное среднее значений, где весами служат веса внимания
y_hat = tf.matmul(attention_weights, tf.expand_dims(y_train, axis=1))
plot_kernel_reg(y_hat)
PaddlePaddle:
# Форма X_repeat: (n_test, n_train),
# каждая строка содержит один и тот же тестовый вход (то есть один и тот же запрос)
X_repeat = d2l.reshape(x_test.repeat_interleave(n_train), (-1, n_train))
# x_train содержит ключи. Форма attention_weights: (n_test, n_train),
# каждая строка содержит веса внимания, которые распределяются между значениями (y_train) для каждого запроса
attention_weights = nn.functional.softmax(-(X_repeat - x_train)**2 / 2, axis=1)
# Каждый элемент y_hat — взвешенное среднее значений, где весами служат веса внимания
y_hat = d2l.matmul(attention_weights, y_train)
plot_kernel_reg(y_hat)
Теперь посмотрим на веса внимания. Входы тестовых данных играют роль запросов, а входы обучающих данных — роль ключей. Поскольку оба набора входов отсортированы, видно, что чем ближе пара «запрос — ключ», тем выше вес внимания в агрегации внимания.
MXNet:
d2l.show_heatmaps(np.expand_dims(np.expand_dims(attention_weights, 0), 0),
xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')
PyTorch:
d2l.show_heatmaps(attention_weights.unsqueeze(0).unsqueeze(0),
xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')
TensorFlow:
d2l.show_heatmaps(tf.expand_dims(
tf.expand_dims(attention_weights, axis=0), axis=0),
xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')
PaddlePaddle:
d2l.show_heatmaps(attention_weights.unsqueeze(0).unsqueeze(0),
xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')
10.2.4 Параметрическая агрегация внимания
Непараметрическая ядерная регрессия Надарая — Ватсона обладает свойством состоятельности (consistency): при достаточном количестве данных эта модель сходится к оптимальному результату. Тем не менее обучаемые параметры легко встроить в агрегацию внимания.
Например, в отличие от (10.2.4), расстояние между запросом и ключом умножается на обучаемый параметр :
Оставшаяся часть раздела посвящена обучению этой модели (10.2.5), то есть обучению параметров агрегации внимания.
10.2.4.1 Пакетное матричное умножение
Чтобы эффективнее вычислять внимание для минибатчей, мы можем использовать пакетное матричное умножение, которое предоставляют фреймворки глубокого обучения.
Пусть в первом минибатче есть матриц формы , а во втором минибатче — матриц формы . Их пакетное матричное умножение даёт матриц формы . Таким образом, если два тензора имеют формы и , то результат их пакетного матричного умножения имеет форму .
MXNet:
X = d2l.ones((2, 1, 4))
Y = d2l.ones((2, 4, 6))
npx.batch_dot(X, Y).shape
PyTorch:
X = d2l.ones((2, 1, 4))
Y = d2l.ones((2, 4, 6))
torch.bmm(X, Y).shape
TensorFlow:
X = tf.ones((2, 1, 4))
Y = tf.ones((2, 4, 6))
tf.matmul(X, Y).shape
PaddlePaddle:
X = paddle.ones((2, 1, 4))
Y = paddle.ones((2, 4, 6))
paddle.bmm(X, Y).shape
В контексте механизма внимания пакетное матричное умножение можно использовать, чтобы вычислять взвешенные средние значения в минибатче.
MXNet:
weights = d2l.ones((2, 10)) * 0.1
values = d2l.reshape(d2l.arange(20), (2, 10))
npx.batch_dot(np.expand_dims(weights, 1), np.expand_dims(values, -1))
PyTorch:
weights = d2l.ones((2, 10)) * 0.1
values = d2l.reshape(d2l.arange(20.0), (2, 10))
torch.bmm(weights.unsqueeze(1), values.unsqueeze(-1))
TensorFlow:
weights = tf.ones((2, 10)) * 0.1
values = tf.reshape(tf.range(20.0), shape = (2, 10))
tf.matmul(tf.expand_dims(weights, axis=1), tf.expand_dims(values, axis=-1)).numpy()
PaddlePaddle:
weights = paddle.ones((2, 10)) * 0.1
values = paddle.arange(20, dtype='float32').reshape((2, 10))
paddle.bmm(weights.unsqueeze(1), values.unsqueeze(-1))
10.2.4.2 Определение модели
На основе параметрической агрегации внимания (10.2.5) с использованием пакетного матричного умножения определим параметрическую версию ядерной регрессии Надарая — Ватсона:
MXNet:
class NWKernelRegression(nn.Block):
def __init__(self, **kwargs):
super().__init__(**kwargs)
self.w = self.params.get('w', shape=(1,))
def forward(self, queries, keys, values):
# Форма queries и attention_weights: (число запросов, число пар «ключ — значение»)
queries = d2l.reshape(
queries.repeat(keys.shape[1]), (-1, keys.shape[1]))
self.attention_weights = npx.softmax(
-((queries - keys) * self.w.data())**2 / 2)
# Форма values: (число запросов, число пар «ключ — значение»)
return npx.batch_dot(np.expand_dims(self.attention_weights, 1),
np.expand_dims(values, -1)).reshape(-1)
PyTorch:
class NWKernelRegression(nn.Module):
def __init__(self, **kwargs):
super().__init__(**kwargs)
self.w = nn.Parameter(torch.rand((1,), requires_grad=True))
def forward(self, queries, keys, values):
# Форма queries и attention_weights: (число запросов, число пар «ключ — значение»)
queries = d2l.reshape(
queries.repeat_interleave(keys.shape[1]), (-1, keys.shape[1]))
self.attention_weights = nn.functional.softmax(
-((queries - keys) * self.w)**2 / 2, dim=1)
# Форма values: (число запросов, число пар «ключ — значение»)
return torch.bmm(self.attention_weights.unsqueeze(1),
values.unsqueeze(-1)).reshape(-1)
TensorFlow:
class NWKernelRegression(tf.keras.layers.Layer):
def __init__(self, **kwargs):
super().__init__(**kwargs)
self.w = tf.Variable(initial_value=tf.random.uniform(shape=(1,)))
def call(self, queries, keys, values, **kwargs):
# При обучении «запросы» — это x_train, «ключи» — расстояния от каждой точки до обучающих данных, «значения» — y_train
# Форма queries и attention_weights: (число запросов, число пар «ключ — значение»)
queries = tf.repeat(tf.expand_dims(queries, axis=1), repeats=keys.shape[1], axis=1)
self.attention_weights = tf.nn.softmax(-((queries - keys) * self.w)**2 /2, axis =1)
# Форма values: (число запросов, число пар «ключ — значение»)
return tf.squeeze(tf.matmul(tf.expand_dims(self.attention_weights, axis=1), tf.expand_dims(values, axis=-1)))
PaddlePaddle:
class NWKernelRegression(nn.Layer):
def __init__(self, **kwargs):
super().__init__(**kwargs)
self.w = paddle.create_parameter((1,), dtype='float32')
def forward(self, queries, keys, values):
# Форма queries и attention_weights: (число запросов, число пар «ключ — значение»)
queries = queries.reshape((queries.shape[0], 1)) \
.tile([keys.shape[1]]) \
.reshape((-1, keys.shape[1]))
self.attention_weight = nn.functional.softmax(
-((queries - keys) * self.w)**2 / 2, axis=1)
# Форма values: (число запросов, число пар «ключ — значение»)
return paddle.bmm(self.attention_weight.unsqueeze(1),
values.unsqueeze(-1)).reshape((-1, ))
10.2.4.3 Обучение
Далее преобразуем обучающий набор данных в ключи и значения для обучения модели внимания. В параметрической модели агрегации внимания вход каждого обучающего примера вычисляется со всеми парами «ключ — значение» остальных обучающих примеров (кроме его самого), и так получается его предсказанный выход.
MXNet:
# Форма X_tile: (n_train, n_train), каждая строка содержит одни и те же обучающие входы
X_tile = np.tile(x_train, (n_train, 1))
# Форма Y_tile: (n_train, n_train), каждая строка содержит одни и те же обучающие выходы
Y_tile = np.tile(y_train, (n_train, 1))
# Форма keys: (n_train, n_train - 1)
keys = d2l.reshape(X_tile[(1 - d2l.eye(n_train)).astype('bool')],
(n_train, -1))
# Форма values: (n_train, n_train - 1)
values = d2l.reshape(Y_tile[(1 - d2l.eye(n_train)).astype('bool')],
(n_train, -1))
PyTorch:
# Форма X_tile: (n_train, n_train), каждая строка содержит одни и те же обучающие входы
X_tile = x_train.repeat((n_train, 1))
# Форма Y_tile: (n_train, n_train), каждая строка содержит одни и те же обучающие выходы
Y_tile = y_train.repeat((n_train, 1))
# Форма keys: (n_train, n_train - 1)
keys = d2l.reshape(X_tile[(1 - d2l.eye(n_train)).type(torch.bool)],
(n_train, -1))
# Форма values: (n_train, n_train - 1)
values = d2l.reshape(Y_tile[(1 - d2l.eye(n_train)).type(torch.bool)],
(n_train, -1))
TensorFlow:
# Форма X_tile: (n_train, n_train), каждая строка содержит одни и те же обучающие входы
X_tile = tf.repeat(tf.expand_dims(x_train, axis=0), repeats=n_train, axis=0)
# Форма Y_tile: (n_train, n_train), каждая строка содержит одни и те же обучающие выходы
Y_tile = tf.repeat(tf.expand_dims(y_train, axis=0), repeats=n_train, axis=0)
# Форма keys: (n_train, n_train - 1)
keys = tf.reshape(X_tile[tf.cast(1 - tf.eye(n_train), dtype=tf.bool)], shape=(n_train, -1))
# Форма values: (n_train, n_train - 1)
values = tf.reshape(Y_tile[tf.cast(1 - tf.eye(n_train), dtype=tf.bool)], shape=(n_train, -1))
PaddlePaddle:
# Форма X_tile: (n_train, n_train), каждая строка содержит одни и те же обучающие входы
X_tile = x_train.tile([n_train, 1])
# Форма Y_tile: (n_train, n_train), каждая строка содержит одни и те же обучающие выходы
Y_tile = y_train.tile([n_train, 1])
# Форма keys: (n_train, n_train - 1)
keys = X_tile[(1 - paddle.eye(n_train)).astype(paddle.bool)].reshape((n_train, -1))
# Форма values: (n_train, n_train - 1)
values = Y_tile[(1 - paddle.eye(n_train)).astype(paddle.bool)].reshape((n_train, -1))
Обучая параметрическую модель агрегации внимания, мы используем функцию потерь «квадрат ошибки» и стохастический градиентный спуск.
MXNet:
net = NWKernelRegression()
net.initialize()
loss = gluon.loss.L2Loss()
trainer = gluon.Trainer(net.collect_params(), 'sgd', {'learning_rate': 0.5})
animator = d2l.Animator(xlabel='epoch', ylabel='loss', xlim=[1, 5])
for epoch in range(5):
with autograd.record():
l = loss(net(x_train, keys, values), y_train)
l.backward()
trainer.step(1)
print(f'epoch {epoch + 1}, loss {float(l.sum()):.6f}')
animator.add(epoch + 1, float(l.sum()))
PyTorch:
net = NWKernelRegression()
loss = nn.MSELoss(reduction='none')
trainer = torch.optim.SGD(net.parameters(), lr=0.5)
animator = d2l.Animator(xlabel='epoch', ylabel='loss', xlim=[1, 5])
for epoch in range(5):
trainer.zero_grad()
l = loss(net(x_train, keys, values), y_train)
l.sum().backward()
trainer.step()
print(f'epoch {epoch + 1}, loss {float(l.sum()):.6f}')
animator.add(epoch + 1, float(l.sum()))
TensorFlow:
net = NWKernelRegression()
loss_object = tf.keras.losses.MeanSquaredError()
optimizer = tf.keras.optimizers.SGD(learning_rate=0.5)
animator = d2l.Animator(xlabel='epoch', ylabel='loss', xlim=[1, 5])
for epoch in range(5):
with tf.GradientTape() as t:
loss = loss_object(y_train, net(x_train, keys, values)) * len(y_train)
grads = t.gradient(loss, net.trainable_variables)
optimizer.apply_gradients(zip(grads, net.trainable_variables))
print(f'epoch {epoch + 1}, loss {float(loss):.6f}')
animator.add(epoch + 1, float(loss))
PaddlePaddle:
net = NWKernelRegression()
loss = nn.MSELoss(reduction='none')
trainer = paddle.optimizer.SGD(learning_rate=0.5, parameters=net.parameters())
animator = d2l.Animator(xlabel='epoch', ylabel='loss', xlim=[1, 5])
for epoch in range(5):
trainer.clear_grad()
l = loss(net(x_train, keys, values), y_train)
l.sum().backward()
trainer.step()
print(f'epoch {epoch + 1}, loss {float(l.sum()):.6f}')
animator.add(epoch + 1, float(l.sum()))
Как видно ниже, после обучения параметрической модели агрегации внимания при попытке подогнать зашумлённые обучающие данные график предсказаний получается менее гладким, чем у непараметрической модели.
MXNet:
# Форма keys: (n_test, n_train), каждая строка содержит одни и те же обучающие входы (то есть одни и те же ключи)
keys = np.tile(x_train, (n_test, 1))
# Форма values: (n_test, n_train)
values = np.tile(y_train, (n_test, 1))
y_hat = net(x_test, keys, values)
plot_kernel_reg(y_hat)
PyTorch:
# Форма keys: (n_test, n_train), каждая строка содержит одни и те же обучающие входы (то есть одни и те же ключи)
keys = x_train.repeat((n_test, 1))
# Форма values: (n_test, n_train)
values = y_train.repeat((n_test, 1))
y_hat = net(x_test, keys, values).unsqueeze(1).detach()
plot_kernel_reg(y_hat)
TensorFlow:
# Форма keys: (n_test, n_train), каждая строка содержит одни и те же обучающие входы (то есть одни и те же ключи)
keys = tf.repeat(tf.expand_dims(x_train, axis=0), repeats=n_test, axis=0)
# Форма values: (n_test, n_train)
values = tf.repeat(tf.expand_dims(y_train, axis=0), repeats=n_test, axis=0)
y_hat = net(x_test, keys, values)
plot_kernel_reg(y_hat)
PaddlePaddle:
# Форма keys: (n_test, n_train), каждая строка содержит одни и те же обучающие входы (то есть одни и те же ключи)
keys = x_train.tile([n_test, 1])
# Форма values: (n_test, n_train)
values = y_train.tile([n_test, 1])
y_hat = net(x_test, keys, values).unsqueeze(1).detach()
plot_kernel_reg(y_hat)
Почему новая модель стала менее гладкой? Посмотрим на график весов внимания. По сравнению с непараметрической моделью агрегации внимания, в параметрической модели после добавления обучаемых параметров кривая становится менее гладкой в областях с большими весами внимания.
MXNet:
d2l.show_heatmaps(np.expand_dims(
np.expand_dims(net.attention_weights, 0), 0),
xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')
PyTorch:
d2l.show_heatmaps(net.attention_weights.unsqueeze(0).unsqueeze(0),
xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')
TensorFlow:
d2l.show_heatmaps(tf.expand_dims(
tf.expand_dims(net.attention_weights, axis=0), axis=0),
xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')
PaddlePaddle:
d2l.show_heatmaps(net.attention_weight.unsqueeze(0).unsqueeze(0),
xlabel='Sorted training inputs',
ylabel='Sorted testing inputs')
Резюме
- Ядерная регрессия Надарая — Ватсона — это машинное обучение с механизмом внимания.
- Агрегация внимания в ядерной регрессии Надарая — Ватсона — это взвешенное среднее обучающих выходов. С точки зрения внимания вес внимания, назначенный каждому значению, зависит от функции ключа и запроса, которые подаются на вход.
- Агрегация внимания бывает непараметрической и параметрической.
Упражнения
- Увеличив число обучающих примеров, можно ли получить лучшую непараметрическую модель ядерной регрессии Надарая — Ватсона?
- Какую роль играет обученный параметр в эксперименте с параметрической агрегацией внимания? Почему при визуализации весов внимания он делает взвешенные области более резкими?
- Как добавить гиперпараметры в непараметрическую ядерную регрессию Надарая — Ватсона, чтобы улучшить предсказания?
- Предложите новую параметрическую модель агрегации внимания для ядерной регрессии из этого раздела. Обучите её и визуализируйте её веса внимания.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Nadaraya, E. A. (1964). On estimating regression. Theory of Probability & Its Applications, 9(1), 141–142.
- Watson, G. S. (1964). Smooth regression analysis. Sankhyā: The Indian Journal of Statistics, Series A, 359–372.
10.3 Функции оценки внимания
В разделе 10.2 для моделирования связи между запросом и ключами использовалось гауссово ядро. Показатель экспоненты в гауссовом ядре (10.2.4) можно рассматривать как функцию оценки внимания (attention scoring function), или просто функцию оценки. Её выход подаётся в функцию softmax. В результате получается распределение вероятностей по значениям, соответствующим ключам, то есть веса внимания. Наконец, выход агрегации внимания — это взвешенная сумма значений с этими весами внимания.
С высоты птичьего полёта этот алгоритм позволяет реализовать схему механизма внимания с рис. 10.1.3. На рис. 10.3.1 показано, как вычислить выход агрегации внимания как взвешенную сумму значений, где обозначает функцию оценки внимания. Поскольку веса внимания образуют распределение вероятностей, взвешенная сумма по сути является взвешенным средним.
Рис. 10.3.1. Вычисление выхода агрегации внимания как взвешенной суммы значений
Математически предположим, что есть запрос и пар «ключ — значение» , где , . Функция агрегации внимания представляется как взвешенная сумма значений:
где вес внимания (скаляр) для запроса и ключа получается так: функция оценки внимания переводит два вектора в скаляр, после чего применяется операция softmax:
Как показано на рисунке выше, выбор разной функции оценки внимания приводит к разным операциям агрегации внимания. В этом разделе мы рассмотрим две популярные функции оценки; позже с их помощью построим более сложные механизмы внимания.
MXNet:
import math
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import math
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import math
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
10.3.1 Маскированная операция softmax
Как сказано выше, операция softmax выдаёт распределение вероятностей в качестве весов внимания. В некоторых случаях не все значения должны участвовать в агрегации внимания. Например, чтобы эффективно обрабатывать минибатчи в разделе 9.5, некоторые текстовые последовательности дополнены бессмысленными служебными токенами. Чтобы в агрегации внимания учитывались только осмысленные токены, можно задать действительную длину (то есть число токенов) и отфильтровать при вычислении softmax позиции, которые выходят за пределы этого диапазона. Ниже функция masked_softmax реализует такую маскированную операцию softmax (masked softmax operation), в которой любые позиции за пределами действительной длины маскируются и приравниваются к 0.
MXNet:
#@save
def masked_softmax(X, valid_lens):
"""Выполняет softmax, маскируя элементы по последней оси"""
# X: трёхмерный тензор, valid_lens: одномерный или двумерный тензор
if valid_lens is None:
return npx.softmax(X)
else:
shape = X.shape
if valid_lens.ndim == 1:
valid_lens = valid_lens.repeat(shape[1])
else:
valid_lens = valid_lens.reshape(-1)
# Замаскированные элементы по последней оси заменяются очень большим отрицательным числом,
# поэтому их выход softmax равен 0
X = npx.sequence_mask(X.reshape(-1, shape[-1]), valid_lens, True,
value=-1e6, axis=1)
return npx.softmax(X).reshape(shape)
PyTorch:
#@save
def masked_softmax(X, valid_lens):
"""Выполняет softmax, маскируя элементы по последней оси"""
# X: трёхмерный тензор, valid_lens: одномерный или двумерный тензор
if valid_lens is None:
return nn.functional.softmax(X, dim=-1)
else:
shape = X.shape
if valid_lens.dim() == 1:
valid_lens = torch.repeat_interleave(valid_lens, shape[1])
else:
valid_lens = valid_lens.reshape(-1)
# Замаскированные элементы по последней оси заменяются очень большим отрицательным числом,
# поэтому их выход softmax равен 0
X = d2l.sequence_mask(X.reshape(-1, shape[-1]), valid_lens,
value=-1e6)
return nn.functional.softmax(X.reshape(shape), dim=-1)
TensorFlow:
#@save
def masked_softmax(X, valid_lens):
"""Выполняет softmax, маскируя элементы по последней оси"""
# X: трёхмерный тензор, valid_lens: одномерный или двумерный тензор
if valid_lens is None:
return tf.nn.softmax(X, axis=-1)
else:
shape = X.shape
if len(valid_lens.shape) == 1:
valid_lens = tf.repeat(valid_lens, repeats=shape[1])
else:
valid_lens = tf.reshape(valid_lens, shape=-1)
# Замаскированные элементы по последней оси заменяются очень большим отрицательным числом,
# поэтому их выход softmax равен 0
X = d2l.sequence_mask(tf.reshape(X, shape=(-1, shape[-1])),
valid_lens, value=-1e6)
return tf.nn.softmax(tf.reshape(X, shape=shape), axis=-1)
PaddlePaddle:
#@save
def masked_softmax(X, valid_lens):
"""Выполняет softmax, маскируя элементы по последней оси"""
# X: трёхмерный тензор, valid_lens: одномерный или двумерный тензор
if valid_lens is None:
return nn.functional.softmax(X, axis=-1)
else:
shape = X.shape
if valid_lens.dim() == 1:
valid_lens = paddle.repeat_interleave(valid_lens, shape[1])
else:
valid_lens = valid_lens.reshape((-1,))
# Замаскированные элементы по последней оси заменяются очень большим отрицательным числом,
# поэтому их выход softmax равен 0
X = d2l.sequence_mask(X.reshape((-1, shape[-1])), valid_lens,
value=-1e6)
return nn.functional.softmax(X.reshape(shape), axis=-1)
Чтобы продемонстрировать работу этой функции, рассмотрим примеры, представленные двумя матрицами , с действительными длинами и . После маскированной операции softmax значения за пределами действительной длины обнуляются.
MXNet:
masked_softmax(np.random.uniform(size=(2, 2, 4)), d2l.tensor([2, 3]))
PyTorch:
masked_softmax(torch.rand(2, 2, 4), torch.tensor([2, 3]))
TensorFlow:
masked_softmax(tf.random.uniform(shape=(2, 2, 4)), tf.constant([2, 3]))
PaddlePaddle:
masked_softmax(paddle.rand((2, 2, 4)), paddle.to_tensor([2, 3]))
Аналогично, можно использовать двумерный тензор и задать действительную длину для каждой строки матричного примера.
MXNet:
masked_softmax(np.random.uniform(size=(2, 2, 4)),
d2l.tensor([[1, 3], [2, 4]]))
PyTorch:
masked_softmax(torch.rand(2, 2, 4), d2l.tensor([[1, 3], [2, 4]]))
TensorFlow:
masked_softmax(tf.random.uniform(shape=(2, 2, 4)), tf.constant([[1, 3], [2, 4]]))
PaddlePaddle:
masked_softmax(paddle.rand((2, 2, 4)), paddle.to_tensor([[1, 3], [2, 4]]))
10.3.2 Аддитивное внимание
В общем случае, когда запросы и ключи — векторы разной длины, в качестве функции оценки можно использовать аддитивное внимание. Для запроса и ключа функция оценки аддитивного внимания (additive attention) имеет вид
где обучаемые параметры — , и . Как видно из (10.3.3), запрос и ключ объединяются и подаются в многослойный перцептрон (MLP) с одним скрытым слоем, число скрытых элементов которого — гиперпараметр. В качестве функции активации используется , а смещение отключено.
Теперь реализуем аддитивное внимание.
MXNet:
#@save
class AdditiveAttention(nn.Block):
"""Аддитивное внимание"""
def __init__(self, num_hiddens, dropout, **kwargs):
super(AdditiveAttention, self).__init__(**kwargs)
# Используем flatten=False, чтобы преобразовывалась только последняя ось, а форма остальных осей сохранялась
self.W_k = nn.Dense(num_hiddens, use_bias=False, flatten=False)
self.W_q = nn.Dense(num_hiddens, use_bias=False, flatten=False)
self.w_v = nn.Dense(1, use_bias=False, flatten=False)
self.dropout = nn.Dropout(dropout)
def forward(self, queries, keys, values, valid_lens):
queries, keys = self.W_q(queries), self.W_k(keys)
# После расширения размерностей
# форма queries: (batch_size, число запросов, 1, num_hidden)
# форма keys: (batch_size, 1, число пар «ключ — значение», num_hiddens)
# Складываем с помощью broadcasting
features = np.expand_dims(queries, axis=2) + np.expand_dims(
keys, axis=1)
features = np.tanh(features)
# У self.w_v один выход, поэтому удаляем последнюю размерность формы.
# Форма scores: (batch_size, число запросов, число пар «ключ — значение»)
scores = np.squeeze(self.w_v(features), axis=-1)
self.attention_weights = masked_softmax(scores, valid_lens)
# Форма values: (batch_size, число пар «ключ — значение», размерность значений)
return npx.batch_dot(self.dropout(self.attention_weights), values)
PyTorch:
#@save
class AdditiveAttention(nn.Module):
"""Аддитивное внимание"""
def __init__(self, key_size, query_size, num_hiddens, dropout, **kwargs):
super(AdditiveAttention, self).__init__(**kwargs)
self.W_k = nn.Linear(key_size, num_hiddens, bias=False)
self.W_q = nn.Linear(query_size, num_hiddens, bias=False)
self.w_v = nn.Linear(num_hiddens, 1, bias=False)
self.dropout = nn.Dropout(dropout)
def forward(self, queries, keys, values, valid_lens):
queries, keys = self.W_q(queries), self.W_k(keys)
# После расширения размерностей
# форма queries: (batch_size, число запросов, 1, num_hidden)
# форма keys: (batch_size, 1, число пар «ключ — значение», num_hiddens)
# Складываем с помощью broadcasting
features = queries.unsqueeze(2) + keys.unsqueeze(1)
features = torch.tanh(features)
# У self.w_v один выход, поэтому удаляем последнюю размерность формы.
# Форма scores: (batch_size, число запросов, число пар «ключ — значение»)
scores = self.w_v(features).squeeze(-1)
self.attention_weights = masked_softmax(scores, valid_lens)
# Форма values: (batch_size, число пар «ключ — значение», размерность значений)
return torch.bmm(self.dropout(self.attention_weights), values)
TensorFlow:
#@save
class AdditiveAttention(tf.keras.layers.Layer):
"""Аддитивное внимание"""
def __init__(self, key_size, query_size, num_hiddens, dropout, **kwargs):
super().__init__(**kwargs)
self.W_k = tf.keras.layers.Dense(num_hiddens, use_bias=False)
self.W_q = tf.keras.layers.Dense(num_hiddens, use_bias=False)
self.w_v = tf.keras.layers.Dense(1, use_bias=False)
self.dropout = tf.keras.layers.Dropout(dropout)
def call(self, queries, keys, values, valid_lens, **kwargs):
queries, keys = self.W_q(queries), self.W_k(keys)
# После расширения размерностей
# форма queries: (batch_size, число запросов, 1, num_hidden)
# форма keys: (batch_size, 1, число пар «ключ — значение», num_hiddens)
# Складываем с помощью broadcasting
features = tf.expand_dims(queries, axis=2) + tf.expand_dims(
keys, axis=1)
features = tf.nn.tanh(features)
# У self.w_v один выход, поэтому удаляем последнюю размерность формы.
# Форма scores: (batch_size, число запросов, число пар «ключ — значение»)
scores = tf.squeeze(self.w_v(features), axis=-1)
self.attention_weights = masked_softmax(scores, valid_lens)
# Форма values: (batch_size, число пар «ключ — значение», размерность значений)
return tf.matmul(self.dropout(
self.attention_weights, **kwargs), values)
PaddlePaddle:
#@save
class AdditiveAttention(nn.Layer):
"""Аддитивное внимание"""
def __init__(self, key_size, query_size, num_hiddens, dropout, **kwargs):
super(AdditiveAttention, self).__init__(**kwargs)
self.W_k = nn.Linear(key_size, num_hiddens, bias_attr=False)
self.W_q = nn.Linear(query_size, num_hiddens, bias_attr=False)
self.w_v = nn.Linear(num_hiddens, 1, bias_attr=False)
self.dropout = nn.Dropout(dropout)
def forward(self, queries, keys, values, valid_lens):
queries, keys = self.W_q(queries), self.W_k(keys)
# После расширения размерностей
# форма queries: (batch_size, число запросов, 1, num_hidden)
# форма keys: (batch_size, 1, число пар «ключ — значение», num_hiddens)
# Складываем с помощью broadcasting
features = queries.unsqueeze(2) + keys.unsqueeze(1)
features = paddle.tanh(features)
# У self.w_v один выход, поэтому удаляем последнюю размерность формы.
# Форма scores: (batch_size, число запросов, число пар «ключ — значение»)
scores = self.w_v(features).squeeze(-1)
self.attention_weights = masked_softmax(scores, valid_lens)
# Форма values: (batch_size, число пар «ключ — значение», размерность значений)
return paddle.bmm(self.dropout(self.attention_weights), values)
Чтобы продемонстрировать класс AdditiveAttention на небольшом примере, возьмём запросы, ключи и значения формы (размер батча, число шагов или длина последовательности токенов, размерность признаков). Фактические формы: , и . Форма выхода агрегации внимания — (размер батча, число шагов запроса, размерность значений).
MXNet:
queries, keys = d2l.normal(0, 1, (2, 1, 20)), d2l.ones((2, 10, 2))
# В минибатче values две одинаковые матрицы значений
values = np.arange(40).reshape(1, 10, 4).repeat(2, axis=0)
valid_lens = d2l.tensor([2, 6])
attention = AdditiveAttention(num_hiddens=8, dropout=0.1)
attention.initialize()
attention(queries, keys, values, valid_lens)
PyTorch:
queries, keys = d2l.normal(0, 1, (2, 1, 20)), d2l.ones((2, 10, 2))
# В минибатче values две одинаковые матрицы значений
values = torch.arange(40, dtype=torch.float32).reshape(1, 10, 4).repeat(
2, 1, 1)
valid_lens = d2l.tensor([2, 6])
attention = AdditiveAttention(key_size=2, query_size=20, num_hiddens=8,
dropout=0.1)
attention.eval()
attention(queries, keys, values, valid_lens)
TensorFlow:
queries, keys = tf.random.normal(shape=(2, 1, 20)), tf.ones((2, 10, 2))
# В минибатче values две одинаковые матрицы значений
values = tf.repeat(tf.reshape(
tf.range(40, dtype=tf.float32), shape=(1, 10, 4)), repeats=2, axis=0)
valid_lens = tf.constant([2, 6])
attention = AdditiveAttention(key_size=2, query_size=20, num_hiddens=8,
dropout=0.1)
attention(queries, keys, values, valid_lens, training=False)
PaddlePaddle:
queries, keys = paddle.normal(0, 1, (2, 1, 20)), paddle.ones((2, 10, 2))
# В минибатче values две одинаковые матрицы значений
values = paddle.arange(40, dtype=paddle.float32).reshape((1, 10, 4)).tile(
[2, 1, 1])
valid_lens = paddle.to_tensor([2, 6])
attention = AdditiveAttention(key_size=2, query_size=20, num_hiddens=8,
dropout=0.1)
attention.eval()
attention(queries, keys, values, valid_lens)
Хотя аддитивное внимание содержит обучаемые параметры, в этом примере все ключи одинаковы, поэтому веса внимания равномерны и определяются заданными действительными длинами.
d2l.show_heatmaps(d2l.reshape(attention.attention_weights, (1, 1, 2, 10)),
xlabel='Keys', ylabel='Queries')
10.3.3 Масштабированное скалярное произведение внимания
Скалярное произведение даёт более эффективную с вычислительной точки зрения функцию оценки, но для него требуется, чтобы запрос и ключ имели одинаковую длину . Предположим, что все элементы запроса и ключа — независимые случайные величины с нулевым средним и единичной дисперсией. Тогда скалярное произведение двух векторов имеет среднее и дисперсию . Чтобы дисперсия скалярного произведения оставалась равной независимо от длины векторов, разделим скалярное произведение на . Тогда функция оценки масштабированного скалярного произведения внимания (scaled dot-product attention) имеет вид:
На практике для повышения эффективности удобнее рассматривать минибатчи. Например, внимание можно вычислить для запросов и пар «ключ — значение», где длина запросов и ключей равна , а длина значений — . Масштабированное скалярное произведение внимания для запросов , ключей и значений равно:
Реализация масштабированного скалярного произведения внимания ниже использует исключение (dropout) для регуляризации модели.
MXNet:
#@save
class DotProductAttention(nn.Block):
"""Масштабированное скалярное произведение внимания"""
def __init__(self, dropout, **kwargs):
super(DotProductAttention, self).__init__(**kwargs)
self.dropout = nn.Dropout(dropout)
# Форма queries: (batch_size, число запросов, d)
# Форма keys: (batch_size, число пар «ключ — значение», d)
# Форма values: (batch_size, число пар «ключ — значение», размерность значений)
# Форма valid_lens: (batch_size,) или (batch_size, число запросов)
def forward(self, queries, keys, values, valid_lens=None):
d = queries.shape[-1]
# Задаём transpose_b=True, чтобы поменять местами две последние размерности keys
scores = npx.batch_dot(queries, keys, transpose_b=True) / math.sqrt(d)
self.attention_weights = masked_softmax(scores, valid_lens)
return npx.batch_dot(self.dropout(self.attention_weights), values)
PyTorch:
#@save
class DotProductAttention(nn.Module):
"""Масштабированное скалярное произведение внимания"""
def __init__(self, dropout, **kwargs):
super(DotProductAttention, self).__init__(**kwargs)
self.dropout = nn.Dropout(dropout)
# Форма queries: (batch_size, число запросов, d)
# Форма keys: (batch_size, число пар «ключ — значение», d)
# Форма values: (batch_size, число пар «ключ — значение», размерность значений)
# Форма valid_lens: (batch_size,) или (batch_size, число запросов)
def forward(self, queries, keys, values, valid_lens=None):
d = queries.shape[-1]
# Задаём transpose_b=True, чтобы поменять местами две последние размерности keys
scores = torch.bmm(queries, keys.transpose(1,2)) / math.sqrt(d)
self.attention_weights = masked_softmax(scores, valid_lens)
return torch.bmm(self.dropout(self.attention_weights), values)
TensorFlow:
#@save
class DotProductAttention(tf.keras.layers.Layer):
"""Масштабированное скалярное произведение внимания"""
def __init__(self, dropout, **kwargs):
super().__init__(**kwargs)
self.dropout = tf.keras.layers.Dropout(dropout)
# Форма queries: (batch_size, число запросов, d)
# Форма keys: (batch_size, число пар «ключ — значение», d)
# Форма values: (batch_size, число пар «ключ — значение», размерность значений)
# Форма valid_lens: (batch_size,) или (batch_size, число запросов)
def call(self, queries, keys, values, valid_lens, **kwargs):
d = queries.shape[-1]
scores = tf.matmul(queries, keys, transpose_b=True)/tf.math.sqrt(
tf.cast(d, dtype=tf.float32))
self.attention_weights = masked_softmax(scores, valid_lens)
return tf.matmul(self.dropout(self.attention_weights, **kwargs), values)
PaddlePaddle:
#@save
class DotProductAttention(nn.Layer):
"""Масштабированное скалярное произведение внимания"""
def __init__(self, dropout, **kwargs):
super(DotProductAttention, self).__init__(**kwargs)
self.dropout = nn.Dropout(dropout)
# Форма queries: (batch_size, число запросов, d)
# Форма keys: (batch_size, число пар «ключ — значение», d)
# Форма values: (batch_size, число пар «ключ — значение», размерность значений)
# Форма valid_lens: (batch_size,) или (batch_size, число запросов)
def forward(self, queries, keys, values, valid_lens=None):
d = queries.shape[-1]
# Задаём transpose_b=True, чтобы поменять местами две последние размерности keys
scores = paddle.bmm(queries, keys.transpose((0,2,1))) / math.sqrt(d)
self.attention_weights = masked_softmax(scores, valid_lens)
return paddle.bmm(self.dropout(self.attention_weights), values)
Чтобы продемонстрировать DotProductAttention, используем те же ключи, значения и действительные длины, что и в примере с аддитивным вниманием. Для скалярного произведения задаём размерность признаков запроса такой же, как у ключей.
MXNet:
queries = d2l.normal(0, 1, (2, 1, 2))
attention = DotProductAttention(dropout=0.5)
attention.initialize()
attention(queries, keys, values, valid_lens)
PyTorch:
queries = d2l.normal(0, 1, (2, 1, 2))
attention = DotProductAttention(dropout=0.5)
attention.eval()
attention(queries, keys, values, valid_lens)
TensorFlow:
queries = tf.random.normal(shape=(2, 1, 2))
attention = DotProductAttention(dropout=0.5)
attention(queries, keys, values, valid_lens, training=False)
PaddlePaddle:
queries = paddle.normal(0, 1, (2, 1, 2))
attention = DotProductAttention(dropout=0.5)
attention.eval()
attention(queries, keys, values, valid_lens)
Как и в примере с аддитивным вниманием, ключи содержат одинаковые элементы, которые нельзя различить никаким запросом, поэтому получаются равномерные веса внимания.
d2l.show_heatmaps(d2l.reshape(attention.attention_weights, (1, 1, 2, 10)),
xlabel='Keys', ylabel='Queries')
Резюме
- Выход агрегации внимания можно вычислять как взвешенное среднее значений; выбор разной функции оценки внимания приводит к разной агрегации внимания.
- Когда запросы и ключи — векторы разной длины, можно использовать аддитивную функцию оценки внимания. Когда их длины совпадают, масштабированное скалярное произведение эффективнее с вычислительной точки зрения.
Упражнения
- Измените ключи в маленьком примере и визуализируйте веса внимания. Дают ли аддитивное внимание и масштабированное скалярное произведение по-прежнему одинаковый результат? Почему?
- Можно ли, используя только операции матричного умножения, спроектировать новую функцию оценки для запросов и ключей разной длины?
- Когда запросы и ключи имеют одинаковую длину, является ли сложение векторов как функция оценки лучше скалярного произведения? Почему?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
10.4 Внимание Баданау
В разделе 9.7 мы рассмотрели задачу машинного перевода: с помощью архитектуры «кодировщик — декодировщик» на основе двух рекуррентных нейронных сетей выполняется обучение «последовательность в последовательность». Конкретно, рекуррентный кодировщик преобразует последовательность переменной длины в контекстную переменную фиксированной формы, а рекуррентный декодировщик генерирует выходную последовательность токен за токеном, опираясь на сгенерированные токены и контекстную переменную. Однако даже если не все входные (исходные) токены полезны для декодирования некоторого токена, на каждом шаге декодирования используется одна и та же контекстная переменная, закодированная из всех входных токенов. Есть ли способ сделать контекстную переменную зависящей от шага декодирования?
Мы ищем вдохновение в работе (Graves, 2013): при генерации рукописного текста по заданной текстовой последовательности Грейвз спроектировал дифференцируемую модель внимания, которая выравнивает символы текста с более длинной записью, причём выравнивание сдвигается только в одном направлении. Вдохновлённые идеей обучаемого выравнивания, Баданау и соавторы предложили дифференцируемую модель внимания без строгого однонаправленного ограничения выравнивания (Bahdanau et al., 2014). При предсказании токена, если не все входные токены одинаково важны, модель выравнивает (или учитывает) только ту часть входной последовательности, которая связана с текущим предсказанием. Это достигается тем, что контекстная переменная рассматривается как выход, сфокусированный вниманием.
10.4.1 Модель
Описанная ниже модель внимания Баданау использует те же обозначения, что и раздел 9.7. Эта новая модель на основе внимания ничем не отличается от модели из раздела 9.7, за исключением того, что контекстная переменная в (9.7.1) на любом шаге декодирования заменяется на . Пусть во входной последовательности токенов. Тогда контекстная переменная на шаге декодирования — это выход, сфокусированный вниманием:
где скрытое состояние декодировщика на временном шаге служит запросом, а скрытые состояния кодировщика одновременно являются и ключами, и значениями. Веса внимания вычисляются с помощью аддитивной функции оценки внимания, определённой в (10.3.2).
Архитектура Баданау немного отличается от архитектуры рекуррентного кодировщика-декодировщика из раздела 9.7: на рис. 10.4.1 показана архитектура внимания Баданау.
Рис. 10.4.1. Рекуррентная модель «кодировщик — декодировщик» с вниманием Баданау
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import rnn, nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
10.4.2 Определение декодировщика с вниманием
Теперь посмотрим, как определить внимание Баданау, чтобы реализовать рекуррентную модель «кодировщик — декодировщик». По сути, достаточно заново определить декодировщик. Чтобы веса обученного внимания было удобнее показывать, класс AttentionDecoder ниже задаёт базовый интерфейс декодировщика с механизмом внимания.
#@save
class AttentionDecoder(d2l.Decoder):
"""Базовый интерфейс декодировщика с механизмом внимания"""
def __init__(self, **kwargs):
super(AttentionDecoder, self).__init__(**kwargs)
@property
def attention_weights(self):
raise NotImplementedError
Далее реализуем рекуррентный декодировщик с вниманием Баданау в классе Seq2SeqAttentionDecoder. Сначала для инициализации состояния декодировщика нужны следующие входы:
- финальный слой скрытых состояний кодировщика на всех временных шагах, который служит ключами и значениями для внимания;
- скрытые состояния всех слоёв кодировщика на последнем временном шаге, которые служат для инициализации скрытого состояния декодировщика;
- действительная длина кодировщика (без токенов заполнения, которые исключаются из пула внимания).
На каждом шаге декодирования финальный слой скрытого состояния декодировщика на предыдущем шаге используется как запрос. Поэтому выход внимания и вложение входа объединяются и подаются на вход рекуррентного декодировщика.
MXNet:
class Seq2SeqAttentionDecoder(AttentionDecoder):
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqAttentionDecoder, self).__init__(**kwargs)
self.attention = d2l.AdditiveAttention(num_hiddens, dropout)
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = rnn.GRU(num_hiddens, num_layers, dropout=dropout)
self.dense = nn.Dense(vocab_size, flatten=False)
def init_state(self, enc_outputs, enc_valid_lens, *args):
# Форма outputs: (num_steps, batch_size, num_hiddens)
# Форма hidden_state[0]: (num_layers, batch_size, num_hiddens)
outputs, hidden_state = enc_outputs
return (outputs.swapaxes(0, 1), hidden_state, enc_valid_lens)
def forward(self, X, state):
# Форма enc_outputs: (batch_size, num_steps, num_hiddens).
# Форма hidden_state[0]: (num_layers, batch_size,
# num_hiddens)
enc_outputs, hidden_state, enc_valid_lens = state
# Форма X на выходе: (num_steps, batch_size, embed_size)
X = self.embedding(X).swapaxes(0, 1)
outputs, self._attention_weights = [], []
for x in X:
# Форма query: (batch_size, 1, num_hiddens)
query = np.expand_dims(hidden_state[0][-1], axis=1)
# Форма context: (batch_size, 1, num_hiddens)
context = self.attention(
query, enc_outputs, enc_outputs, enc_valid_lens)
# Конкатенируем по размерности признаков
x = np.concatenate((context, np.expand_dims(x, axis=1)), axis=-1)
# Преобразуем x к форме (1, batch_size, embed_size + num_hiddens)
out, hidden_state = self.rnn(x.swapaxes(0, 1), hidden_state)
outputs.append(out)
self._attention_weights.append(self.attention.attention_weights)
# После преобразования полносвязным слоем форма outputs:
# (num_steps, batch_size, vocab_size)
outputs = self.dense(np.concatenate(outputs, axis=0))
return outputs.swapaxes(0, 1), [enc_outputs, hidden_state,
enc_valid_lens]
@property
def attention_weights(self):
return self._attention_weights
PyTorch:
class Seq2SeqAttentionDecoder(AttentionDecoder):
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqAttentionDecoder, self).__init__(**kwargs)
self.attention = d2l.AdditiveAttention(
num_hiddens, num_hiddens, num_hiddens, dropout)
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = nn.GRU(
embed_size + num_hiddens, num_hiddens, num_layers,
dropout=dropout)
self.dense = nn.Linear(num_hiddens, vocab_size)
def init_state(self, enc_outputs, enc_valid_lens, *args):
# Форма outputs: (batch_size, num_steps, num_hiddens).
# Форма hidden_state: (num_layers, batch_size, num_hiddens)
outputs, hidden_state = enc_outputs
return (outputs.permute(1, 0, 2), hidden_state, enc_valid_lens)
def forward(self, X, state):
# Форма enc_outputs: (batch_size, num_steps, num_hiddens).
# Форма hidden_state: (num_layers, batch_size,
# num_hiddens)
enc_outputs, hidden_state, enc_valid_lens = state
# Форма X на выходе: (num_steps, batch_size, embed_size)
X = self.embedding(X).permute(1, 0, 2)
outputs, self._attention_weights = [], []
for x in X:
# Форма query: (batch_size, 1, num_hiddens)
query = torch.unsqueeze(hidden_state[-1], dim=1)
# Форма context: (batch_size, 1, num_hiddens)
context = self.attention(
query, enc_outputs, enc_outputs, enc_valid_lens)
# Конкатенируем по размерности признаков
x = torch.cat((context, torch.unsqueeze(x, dim=1)), dim=-1)
# Преобразуем x к форме (1, batch_size, embed_size + num_hiddens)
out, hidden_state = self.rnn(x.permute(1, 0, 2), hidden_state)
outputs.append(out)
self._attention_weights.append(self.attention.attention_weights)
# После преобразования полносвязным слоем форма outputs:
# (num_steps, batch_size, vocab_size)
outputs = self.dense(torch.cat(outputs, dim=0))
return outputs.permute(1, 0, 2), [enc_outputs, hidden_state,
enc_valid_lens]
@property
def attention_weights(self):
return self._attention_weights
TensorFlow:
class Seq2SeqAttentionDecoder(AttentionDecoder):
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super().__init__(**kwargs)
self.attention = d2l.AdditiveAttention(num_hiddens, num_hiddens,
num_hiddens, dropout)
self.embedding = tf.keras.layers.Embedding(vocab_size, embed_size)
self.rnn = tf.keras.layers.RNN(tf.keras.layers.StackedRNNCells(
[tf.keras.layers.GRUCell(num_hiddens, dropout=dropout)
for _ in range(num_layers)]),
return_sequences=True,
return_state=True)
self.dense = tf.keras.layers.Dense(vocab_size)
def init_state(self, enc_outputs, enc_valid_lens, *args):
# Форма outputs: (num_steps, batch_size, num_hiddens)
# Форма hidden_state[0]: (num_layers, batch_size, num_hiddens)
outputs, hidden_state = enc_outputs
return (outputs, hidden_state, enc_valid_lens)
def call(self, X, state, **kwargs):
# Форма enc_outputs: (batch_size, num_steps, num_hiddens)
# Форма hidden_state[0]: (num_layers, batch_size, num_hiddens)
enc_outputs, hidden_state, enc_valid_lens = state
# Форма X на выходе: (num_steps, batch_size, embed_size)
X = self.embedding(X) # Форма входа X: (batch_size, num_steps)
X = tf.transpose(X, perm=(1, 0, 2))
outputs, self._attention_weights = [], []
for x in X:
# Форма query: (batch_size, 1, num_hiddens)
query = tf.expand_dims(hidden_state[-1], axis=1)
# Форма context: (batch_size, 1, num_hiddens)
context = self.attention(query, enc_outputs, enc_outputs,
enc_valid_lens, **kwargs)
# Конкатенируем по размерности признаков
x = tf.concat((context, tf.expand_dims(x, axis=1)), axis=-1)
out = self.rnn(x, hidden_state, **kwargs)
hidden_state = out[1:]
outputs.append(out[0])
self._attention_weights.append(self.attention.attention_weights)
# После преобразования полносвязным слоем форма outputs: (num_steps, batch_size, vocab_size)
outputs = self.dense(tf.concat(outputs, axis=1))
return outputs, [enc_outputs, hidden_state, enc_valid_lens]
@property
def attention_weights(self):
return self._attention_weights
PaddlePaddle:
class Seq2SeqAttentionDecoder(AttentionDecoder):
def __init__(self, vocab_size, embed_size, num_hiddens, num_layers,
dropout=0, **kwargs):
super(Seq2SeqAttentionDecoder, self).__init__(**kwargs)
self.attention = d2l.AdditiveAttention(
num_hiddens, num_hiddens, num_hiddens, dropout)
self.embedding = nn.Embedding(vocab_size, embed_size)
self.rnn = nn.GRU(embed_size + num_hiddens, num_hiddens,
num_layers, bias_ih_attr=True,
time_major=True, dropout=dropout)
self.dense = nn.Linear(num_hiddens, vocab_size)
def init_state(self, enc_outputs, enc_valid_lens, *args):
# Форма outputs: (batch_size, num_steps, num_hiddens).
# Форма hidden_state: (num_layers, batch_size, num_hiddens)
outputs, hidden_state = enc_outputs
return (outputs.transpose((1, 0, 2)), hidden_state, enc_valid_lens)
def forward(self, X, state):
# Форма enc_outputs: (batch_size, num_steps, num_hiddens).
# Форма hidden_state: (num_layers, batch_size, num_hiddens)
enc_outputs, hidden_state, enc_valid_lens = state
# Форма X на выходе: (num_steps, batch_size, embed_size)
X = self.embedding(X).transpose((1, 0, 2))
outputs, self._attention_weights = [], []
for x in X:
# Форма query: (batch_size, 1, num_hiddens)
query = paddle.unsqueeze(hidden_state[-1], axis=1)
# Форма context: (batch_size, 1, num_hiddens)
context = self.attention(
query, enc_outputs, enc_outputs, enc_valid_lens)
# Конкатенируем по размерности признаков
x = paddle.concat((context, paddle.unsqueeze(x, axis=1)), axis=-1)
# Преобразуем x к форме (1, batch_size, embed_size + num_hiddens)
out, hidden_state = self.rnn(x.transpose((1, 0, 2)), hidden_state)
outputs.append(out)
self._attention_weights.append(self.attention.attention_weights)
# После преобразования полносвязным слоем форма outputs:
# (num_steps, batch_size, vocab_size)
outputs = self.dense(paddle.concat(outputs, axis=0))
return outputs.transpose((1, 0, 2)), [enc_outputs, hidden_state,
enc_valid_lens]
@property
def attention_weights(self):
return self._attention_weights
Далее проверим декодировщик внимания Баданау на минибатче из четырёх последовательностей входа с семью временными шагами.
MXNet:
encoder = d2l.Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.initialize()
decoder = Seq2SeqAttentionDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.initialize()
X = d2l.zeros((4, 7)) # (batch_size, num_steps)
state = decoder.init_state(encoder(X), None)
output, state = decoder(X, state)
output.shape, len(state), state[0].shape, len(state[1]), state[1][0].shape
PyTorch:
encoder = d2l.Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.eval()
decoder = Seq2SeqAttentionDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.eval()
X = d2l.zeros((4, 7), dtype=torch.long) # (batch_size, num_steps)
state = decoder.init_state(encoder(X), None)
output, state = decoder(X, state)
output.shape, len(state), state[0].shape, len(state[1]), state[1][0].shape
TensorFlow:
encoder = d2l.Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder = Seq2SeqAttentionDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
X = tf.zeros((4, 7))
state = decoder.init_state(encoder(X, training=False), None)
output, state = decoder(X, state, training=False)
output.shape, len(state), state[0].shape, len(state[1]), state[1][0].shape
PaddlePaddle:
encoder = d2l.Seq2SeqEncoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
encoder.eval()
decoder = Seq2SeqAttentionDecoder(vocab_size=10, embed_size=8, num_hiddens=16,
num_layers=2)
decoder.eval()
X = paddle.zeros((4, 7), dtype='int64') # (batch_size, num_steps)
state = decoder.init_state(encoder(X), None)
output, state = decoder(X, state)
output.shape, len(state), state[0].shape, len(state[1]), state[1][0].shape
10.4.3 Обучение
Как и в разделе 9.7.4, здесь мы задаём гиперпараметры, создаём кодировщик и декодировщик с вниманием Баданау и обучаем модель машинному переводу. Из-за добавленного механизма внимания обучение заметно медленнее, чем в разделе 9.7 без внимания.
embed_size, num_hiddens, num_layers, dropout = 32, 32, 2, 0.1
batch_size, num_steps = 64, 10
lr, num_epochs, device = 0.005, 250, d2l.try_gpu()
train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
encoder = d2l.Seq2SeqEncoder(
len(src_vocab), embed_size, num_hiddens, num_layers, dropout)
decoder = Seq2SeqAttentionDecoder(
len(tgt_vocab), embed_size, num_hiddens, num_layers, dropout)
net = d2l.EncoderDecoder(encoder, decoder)
d2l.train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
После обучения модели мы переводим несколько английских предложений на французский и вычисляем их оценки BLEU.
MXNet, PyTorch, PaddlePaddle:
engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
translation, dec_attention_weight_seq = d2l.predict_seq2seq(
net, eng, src_vocab, tgt_vocab, num_steps, device, True)
print(f'{eng} => {translation}, ',
f'bleu {d2l.bleu(translation, fra, k=2):.3f}')
TensorFlow:
engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
translation, dec_attention_weight_seq = d2l.predict_seq2seq(
net, eng, src_vocab, tgt_vocab, num_steps, True)
print(f'{eng} => {translation}, ',
f'bleu {d2l.bleu(translation, fra, k=2):.3f}')
attention_weights = d2l.reshape(
d2l.concat([step[0][0][0] for step in dec_attention_weight_seq], 0),
(1, 1, -1, num_steps))
После обучения визуализация весов внимания показывает, что каждый запрос распределяет разные веса по парам «ключ — значение». Это означает, что на каждом шаге декодирования разные части входной последовательности селективно выбираются в пул внимания.
MXNet:
# Включаем токен конца последовательности
d2l.show_heatmaps(
attention_weights[:, :, :, :len(engs[-1].split()) + 1],
xlabel='Key positions', ylabel='Query positions')
PyTorch, PaddlePaddle:
# Включаем токен конца последовательности
d2l.show_heatmaps(
attention_weights[:, :, :, :len(engs[-1].split()) + 1].cpu(),
xlabel='Key positions', ylabel='Query positions')
TensorFlow:
# Включаем токен конца последовательности
d2l.show_heatmaps(attention_weights[:, :, :, :len(engs[-1].split()) + 1],
xlabel='Key positions', ylabel='Query positions')
Резюме
- Предсказывая токен, если не все входные токены одинаково важны, рекуррентная модель «кодировщик — декодировщик» с вниманием Баданау селективно учитывает разные части входной последовательности. Это достигается за счёт того, что контекстная переменная рассматривается как выход аддитивной агрегации внимания.
- В рекуррентной модели «кодировщик — декодировщик» внимание Баданау рассматривает скрытое состояние декодировщика на предыдущем временном шаге как запрос, а скрытые состояния кодировщика на всех временных шагах — как ключи и значения одновременно.
Упражнения
- В экспериментах замените GRU на LSTM.
- Измените эксперимент так, чтобы вместо аддитивной функции оценки внимания использовалось масштабированное скалярное произведение внимания. Как это повлияет на эффективность обучения?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Graves, A. (2013). Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850.
- Bahdanau, D., Cho, K., & Bengio, Y. (2014). Neural machine translation by jointly learning to align and translate. arXiv preprint arXiv:1409.0473.
10.5 Многоголовое внимание
На практике при одном и том же наборе запросов, ключей и значений мы хотим, чтобы модель могла, опираясь на один и тот же механизм внимания, выучивать разные виды поведения, а затем объединять их как знания, чтобы захватывать зависимости разного масштаба внутри последовательности (например, краткосрочные и долгосрочные зависимости). Поэтому полезно позволить механизму внимания комбинировать разные подпространства представлений (representation subspaces) запросов, ключей и значений.
Для этого вместо одной агрегации внимания мы можем преобразовать запросы, ключи и значения с помощью независимо выученных линейных проекций (linear projections). Затем эти преобразованных запросов, ключей и значений параллельно подаются в агрегацию внимания. Наконец, выходы агрегаций внимания конкатенируются и преобразуются ещё одной обучаемой линейной проекцией, чтобы получить итоговый выход. Такая конструкция называется многоголовым вниманием (multihead attention) (Vaswani et al., 2017). Каждая из агрегаций внимания называется головой (head). На рис. 10.5.1 показано многоголовое внимание, в котором обучаемые линейные преобразования реализованы полносвязными слоями.
Рис. 10.5.1. Многоголовое внимание: несколько голов конкатенируются, а затем проходят линейное преобразование
10.5.1 Модель
Прежде чем реализовывать многоголовое внимание, опишем модель математически. Даны запрос , ключ и значение . Каждая голова внимания () вычисляется так:
где обучаемые параметры включают , и , а — функция агрегации внимания. Функцией может быть аддитивное внимание или масштабированное скалярное произведение внимания из раздела 10.3. Выход многоголового внимания проходит ещё одно линейное преобразование, которое соответствует конкатенации голов, поэтому обучаемый параметр — :
Благодаря этой конструкции каждая голова может обращать внимание на разные части входа, и вместе они способны представлять функции более сложные, чем простое взвешенное среднее.
MXNet:
from d2l import mxnet as d2l
import math
from mxnet import autograd, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import math
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import paddle
from paddle import nn
10.5.2 Реализация
На практике при реализации в качестве каждой головы внимания обычно выбирают масштабированное скалярное произведение внимания. Чтобы избежать резкого роста вычислительных затрат и затрат на параметры, положим . Заметим, что если задать число выходов линейных преобразований запросов, ключей и значений равным , то голов можно вычислять параллельно. В реализации ниже задаётся параметром num_hiddens.
MXNet:
#@save
class MultiHeadAttention(nn.Block):
"""Многоголовое внимание"""
def __init__(self, num_hiddens, num_heads, dropout, use_bias=False,
**kwargs):
super(MultiHeadAttention, self).__init__(**kwargs)
self.num_heads = num_heads
self.attention = d2l.DotProductAttention(dropout)
self.W_q = nn.Dense(num_hiddens, use_bias=use_bias, flatten=False)
self.W_k = nn.Dense(num_hiddens, use_bias=use_bias, flatten=False)
self.W_v = nn.Dense(num_hiddens, use_bias=use_bias, flatten=False)
self.W_o = nn.Dense(num_hiddens, use_bias=use_bias, flatten=False)
def forward(self, queries, keys, values, valid_lens):
# Формы queries, keys, values:
# (batch_size, число запросов или пар «ключ — значение», num_hiddens)
# Форма valid_lens:
# (batch_size,) или (batch_size, число запросов)
# После преобразования формы queries, keys, values:
# (batch_size*num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
queries = transpose_qkv(self.W_q(queries), self.num_heads)
keys = transpose_qkv(self.W_k(keys), self.num_heads)
values = transpose_qkv(self.W_v(values), self.num_heads)
if valid_lens is not None:
# По оси 0 первый элемент (скаляр или вектор) повторяем num_heads раз,
# затем так же повторяем второй элемент и так далее.
valid_lens = valid_lens.repeat(self.num_heads, axis=0)
# Форма output: (batch_size*num_heads, число запросов,
# num_hiddens/num_heads)
output = self.attention(queries, keys, values, valid_lens)
# Форма output_concat: (batch_size, число запросов, num_hiddens)
output_concat = transpose_output(output, self.num_heads)
return self.W_o(output_concat)
PyTorch:
#@save
class MultiHeadAttention(nn.Module):
"""Многоголовое внимание"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
num_heads, dropout, bias=False, **kwargs):
super(MultiHeadAttention, self).__init__(**kwargs)
self.num_heads = num_heads
self.attention = d2l.DotProductAttention(dropout)
self.W_q = nn.Linear(query_size, num_hiddens, bias=bias)
self.W_k = nn.Linear(key_size, num_hiddens, bias=bias)
self.W_v = nn.Linear(value_size, num_hiddens, bias=bias)
self.W_o = nn.Linear(num_hiddens, num_hiddens, bias=bias)
def forward(self, queries, keys, values, valid_lens):
# Формы queries, keys, values:
# (batch_size, число запросов или пар «ключ — значение», num_hiddens)
# Форма valid_lens:
# (batch_size,) или (batch_size, число запросов)
# После преобразования формы queries, keys, values:
# (batch_size*num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
queries = transpose_qkv(self.W_q(queries), self.num_heads)
keys = transpose_qkv(self.W_k(keys), self.num_heads)
values = transpose_qkv(self.W_v(values), self.num_heads)
if valid_lens is not None:
# По оси 0 первый элемент (скаляр или вектор) повторяем num_heads раз,
# затем так же повторяем второй элемент и так далее.
valid_lens = torch.repeat_interleave(
valid_lens, repeats=self.num_heads, dim=0)
# Форма output: (batch_size*num_heads, число запросов,
# num_hiddens/num_heads)
output = self.attention(queries, keys, values, valid_lens)
# Форма output_concat: (batch_size, число запросов, num_hiddens)
output_concat = transpose_output(output, self.num_heads)
return self.W_o(output_concat)
TensorFlow:
#@save
class MultiHeadAttention(tf.keras.layers.Layer):
"""Многоголовое внимание"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
num_heads, dropout, bias=False, **kwargs):
super().__init__(**kwargs)
self.num_heads = num_heads
self.attention = d2l.DotProductAttention(dropout)
self.W_q = tf.keras.layers.Dense(num_hiddens, use_bias=bias)
self.W_k = tf.keras.layers.Dense(num_hiddens, use_bias=bias)
self.W_v = tf.keras.layers.Dense(num_hiddens, use_bias=bias)
self.W_o = tf.keras.layers.Dense(num_hiddens, use_bias=bias)
def call(self, queries, keys, values, valid_lens, **kwargs):
# Формы queries, keys, values:
# (batch_size, число запросов или пар «ключ — значение», num_hiddens)
# Форма valid_lens:
# (batch_size,) или (batch_size, число запросов)
# После преобразования формы queries, keys, values:
# (batch_size*num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
queries = transpose_qkv(self.W_q(queries), self.num_heads)
keys = transpose_qkv(self.W_k(keys), self.num_heads)
values = transpose_qkv(self.W_v(values), self.num_heads)
if valid_lens is not None:
# По оси 0 первый элемент (скаляр или вектор) повторяем num_heads раз,
# затем так же повторяем второй элемент и так далее.
valid_lens = tf.repeat(valid_lens, repeats=self.num_heads, axis=0)
# Форма output: (batch_size*num_heads, число запросов,
# num_hiddens/num_heads)
output = self.attention(queries, keys, values, valid_lens, **kwargs)
# Форма output_concat: (batch_size, число запросов, num_hiddens)
output_concat = transpose_output(output, self.num_heads)
return self.W_o(output_concat)
PaddlePaddle:
#@save
class MultiHeadAttention(nn.Layer):
"""Многоголовое внимание"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
num_heads, dropout, bias=False, **kwargs):
super(MultiHeadAttention, self).__init__(**kwargs)
self.num_heads = num_heads
self.attention = d2l.DotProductAttention(dropout)
self.W_q = nn.Linear(query_size, num_hiddens, bias_attr=bias)
self.W_k = nn.Linear(key_size, num_hiddens, bias_attr=bias)
self.W_v = nn.Linear(value_size, num_hiddens, bias_attr=bias)
self.W_o = nn.Linear(num_hiddens, num_hiddens, bias_attr=bias)
def forward(self, queries, keys, values, valid_lens):
# Формы queries, keys, values:
# (batch_size, число запросов или пар «ключ — значение», num_hiddens)
# Форма valid_lens:
# (batch_size,) или (batch_size, число запросов)
# После преобразования формы queries, keys, values:
# (batch_size*num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
queries = transpose_qkv(self.W_q(queries), self.num_heads)
keys = transpose_qkv(self.W_k(keys), self.num_heads)
values = transpose_qkv(self.W_v(values), self.num_heads)
if valid_lens is not None:
# По оси 0 первый элемент (скаляр или вектор) повторяем num_heads раз,
# затем так же повторяем второй элемент и так далее.
valid_lens = paddle.repeat_interleave(
valid_lens, repeats=self.num_heads, axis=0)
# Форма output: (batch_size*num_heads, число запросов,
# num_hiddens/num_heads)
output = self.attention(queries, keys, values, valid_lens)
# Форма output_concat: (batch_size, число запросов, num_hiddens)
output_concat = transpose_output(output, self.num_heads)
return self.W_o(output_concat)
Чтобы все головы вычислялись параллельно, класс MultiHeadAttention выше использует две функции транспонирования, определённые ниже. Функция transpose_output обращает операцию функции transpose_qkv.
MXNet:
#@save
def transpose_qkv(X, num_heads):
"""Меняет форму для параллельного вычисления нескольких голов внимания"""
# Форма входа X: (batch_size, число запросов или пар «ключ — значение», num_hiddens)
# Форма выхода X: (batch_size, число запросов или пар «ключ — значение», num_heads,
# num_hiddens/num_heads)
X = X.reshape(X.shape[0], X.shape[1], num_heads, -1)
# Форма выхода X: (batch_size, num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
X = X.transpose(0, 2, 1, 3)
# Форма итогового выхода: (batch_size*num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
return X.reshape(-1, X.shape[2], X.shape[3])
#@save
def transpose_output(X, num_heads):
"""Обращает операцию функции transpose_qkv"""
X = X.reshape(-1, num_heads, X.shape[1], X.shape[2])
X = X.transpose(0, 2, 1, 3)
return X.reshape(X.shape[0], X.shape[1], -1)
PyTorch:
#@save
def transpose_qkv(X, num_heads):
"""Меняет форму для параллельного вычисления нескольких голов внимания"""
# Форма входа X: (batch_size, число запросов или пар «ключ — значение», num_hiddens)
# Форма выхода X: (batch_size, число запросов или пар «ключ — значение», num_heads,
# num_hiddens/num_heads)
X = X.reshape(X.shape[0], X.shape[1], num_heads, -1)
# Форма выхода X: (batch_size, num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
X = X.permute(0, 2, 1, 3)
# Форма итогового выхода: (batch_size*num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
return X.reshape(-1, X.shape[2], X.shape[3])
#@save
def transpose_output(X, num_heads):
"""Обращает операцию функции transpose_qkv"""
X = X.reshape(-1, num_heads, X.shape[1], X.shape[2])
X = X.permute(0, 2, 1, 3)
return X.reshape(X.shape[0], X.shape[1], -1)
TensorFlow:
#@save
def transpose_qkv(X, num_heads):
"""Меняет форму для параллельного вычисления нескольких голов внимания"""
# Форма входа X: (batch_size, число запросов или пар «ключ — значение», num_hiddens)
# Форма выхода X: (batch_size, число запросов или пар «ключ — значение», num_heads,
# num_hiddens/num_heads)
X = tf.reshape(X, shape=(X.shape[0], X.shape[1], num_heads, -1))
# Форма выхода X: (batch_size, num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
X = tf.transpose(X, perm=(0, 2, 1, 3))
# Форма итогового выхода: (batch_size*num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
return tf.reshape(X, shape=(-1, X.shape[2], X.shape[3]))
#@save
def transpose_output(X, num_heads):
"""Обращает операцию функции transpose_qkv"""
X = tf.reshape(X, shape=(-1, num_heads, X.shape[1], X.shape[2]))
X = tf.transpose(X, perm=(0, 2, 1, 3))
return tf.reshape(X, shape=(X.shape[0], X.shape[1], -1))
PaddlePaddle:
#@save
def transpose_qkv(X, num_heads):
"""Меняет форму для параллельного вычисления нескольких голов внимания"""
# Форма входа X: (batch_size, число запросов или пар «ключ — значение», num_hiddens)
# Форма выхода X: (batch_size, число запросов или пар «ключ — значение», num_heads,
# num_hiddens/num_heads)
X = X.reshape((X.shape[0], X.shape[1], num_heads, -1))
# Форма выхода X: (batch_size, num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
X = X.transpose((0, 2, 1, 3))
# Форма итогового выхода: (batch_size*num_heads, число запросов или пар «ключ — значение»,
# num_hiddens/num_heads)
return X.reshape((-1, X.shape[2], X.shape[3]))
#@save
def transpose_output(X, num_heads):
"""Обращает операцию функции transpose_qkv"""
X = X.reshape((-1, num_heads, X.shape[1], X.shape[2]))
X = X.transpose((0, 2, 1, 3))
return X.reshape((X.shape[0], X.shape[1], -1))
Проверим класс MultiHeadAttention на небольшом примере, в котором ключи и значения совпадают. Форма выхода многоголового внимания — (batch_size, num_queries, num_hiddens).
MXNet:
num_hiddens, num_heads = 100, 5
attention = MultiHeadAttention(num_hiddens, num_heads, 0.5)
attention.initialize()
PyTorch:
num_hiddens, num_heads = 100, 5
attention = MultiHeadAttention(num_hiddens, num_hiddens, num_hiddens,
num_hiddens, num_heads, 0.5)
attention.eval()
TensorFlow:
num_hiddens, num_heads = 100, 5
attention = MultiHeadAttention(num_hiddens, num_hiddens, num_hiddens,
num_hiddens, num_heads, 0.5)
PaddlePaddle:
num_hiddens, num_heads = 100, 5
attention = MultiHeadAttention(num_hiddens, num_hiddens, num_hiddens,
num_hiddens, num_heads, 0.5)
attention.eval()
MXNet, PyTorch, PaddlePaddle:
batch_size, num_queries = 2, 4
num_kvpairs, valid_lens = 6, d2l.tensor([3, 2])
X = d2l.ones((batch_size, num_queries, num_hiddens))
Y = d2l.ones((batch_size, num_kvpairs, num_hiddens))
attention(X, Y, Y, valid_lens).shape
TensorFlow:
batch_size, num_queries = 2, 4
num_kvpairs, valid_lens = 6, d2l.tensor([3, 2])
X = tf.ones((batch_size, num_queries, num_hiddens))
Y = tf.ones((batch_size, num_kvpairs, num_hiddens))
attention(X, Y, Y, valid_lens, training=False).shape
Резюме
- Многоголовое внимание объединяет знания, полученные из нескольких агрегаций внимания, которые опираются на разные подпространства представлений одних и тех же запросов, ключей и значений.
- Опираясь на подходящие тензорные операции, можно реализовать параллельное вычисление многоголового внимания.
Упражнения
- Визуализируйте веса внимания для каждой головы в этом эксперименте.
- Предположим, что есть обученная модель на основе многоголового внимания, и мы хотим удалить наименее важные головы внимания, чтобы ускорить предсказание. Как спланировать эксперимент, чтобы измерить важность голов внимания?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 5998–6008.
10.6 Самовнимание и позиционное кодирование
В глубоком обучении для кодирования последовательностей часто используют свёрточные нейронные сети (CNN) или рекуррентные нейронные сети (RNN). Представим, что после появления механизма внимания мы подаём последовательность токенов в агрегацию внимания так, что один и тот же набор токенов одновременно выступает в роли запросов, ключей и значений. Конкретно, каждый запрос обращает внимание на все пары «ключ — значение» и порождает выход внимания. Поскольку запросы, ключи и значения происходят из одного и того же набора входов, это называется самовниманием (self-attention) (Lin et al., 2017; Vaswani et al., 2017), а также внутренним вниманием (intra-attention) (Cheng et al., 2016; Parikh et al., 2016; Paulus et al., 2017). В этом разделе мы используем самовнимание для кодирования последовательностей и посмотрим, как порядок элементов последовательности может служить дополнительной информацией.
MXNet:
from d2l import mxnet as d2l
import math
from mxnet import autograd, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import math
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import numpy as np
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import math
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
10.6.1 Самовнимание
Дана входная последовательность из токенов , где каждый (). Выход самовнимания для этой последовательности — последовательность той же длины , где
и функция агрегации внимания определена в (10.3.1). Ниже приведён фрагмент кода, который вычисляет самовнимание для тензора с помощью многоголового внимания. Форма тензора — (размер батча, число временных шагов или длина последовательности токенов, ). Форма выхода совпадает с формой входа.
MXNet:
num_hiddens, num_heads = 100, 5
attention = d2l.MultiHeadAttention(num_hiddens, num_heads, 0.5)
attention.initialize()
PyTorch:
num_hiddens, num_heads = 100, 5
attention = d2l.MultiHeadAttention(num_hiddens, num_hiddens, num_hiddens,
num_hiddens, num_heads, 0.5)
attention.eval()
TensorFlow:
num_hiddens, num_heads = 100, 5
attention = d2l.MultiHeadAttention(num_hiddens, num_hiddens, num_hiddens,
num_hiddens, num_heads, 0.5)
PaddlePaddle:
num_hiddens, num_heads = 100, 5
attention = d2l.MultiHeadAttention(num_hiddens, num_hiddens, num_hiddens,
num_hiddens, num_heads, 0.5)
attention.eval()
MXNet, PyTorch, PaddlePaddle:
batch_size, num_queries, valid_lens = 2, 4, d2l.tensor([3, 2])
X = d2l.ones((batch_size, num_queries, num_hiddens))
attention(X, X, X, valid_lens).shape
TensorFlow:
batch_size, num_queries, valid_lens = 2, 4, tf.constant([3, 2])
X = tf.ones((batch_size, num_queries, num_hiddens))
attention(X, X, X, valid_lens, training=False).shape
10.6.2 Сравнение свёрточных, рекуррентных сетей и самовнимания
Сравним несколько архитектур, цель которых — отобразить последовательность из токенов в последовательность той же длины, где каждый входной и выходной токен представлен вектором размерности . Конкретно мы сравним свёрточные нейронные сети, рекуррентные нейронные сети и самовнимание по вычислительной сложности, числу последовательных операций и максимальной длине пути. Заметим, что последовательные операции препятствуют параллельным вычислениям, а чем короче путь между любыми позициями последовательности, тем легче выучить дальние зависимости в последовательности (Hochreiter et al., 2001).
Рис. 10.6.1. Сравнение трёх архитектур: свёрточной нейронной сети (токены заполнения игнорируются), рекуррентной нейронной сети и самовнимания
Рассмотрим свёрточный слой с размером ядра . В следующих главах мы подробнее разберём обработку последовательностей с помощью свёрточных сетей. Сейчас достаточно знать, что поскольку длина последовательности равна , а число входных и выходных каналов равно , вычислительная сложность свёрточного слоя составляет . Как показано на рис. 10.6.1, свёрточная сеть иерархична, поэтому для неё требуется последовательных операций, а максимальная длина пути равна . Например, и попадают в рецептивное поле двухслойной свёрточной сети с ядром размера 3, показанной на рис. 10.6.1.
При обновлении скрытого состояния рекуррентной нейронной сети умножение матрицы весов на скрытое состояние размерности имеет сложность . Поскольку длина последовательности равна , вычислительная сложность рекуррентного слоя составляет . По рис. 10.6.1 видно, что рекуррентная сеть требует последовательных операций, которые нельзя распараллелить, а максимальная длина пути также равна .
В самовнимании запросы, ключи и значения — матрицы размера . Рассмотрим масштабированное скалярное произведение внимания из (10.3.4): умножение матрицы на матрицу , затем умножение полученной матрицы на матрицу . Поэтому самовнимание имеет вычислительную сложность . Как видно из рис. 10.6.1, каждый токен напрямую связан с любым другим токеном через самовнимание. Поэтому для параллельного вычисления требуется последовательных операций, а максимальная длина пути также равна .
Итак, и свёрточные сети, и самовнимание допускают параллельные вычисления, причём у самовнимания самая короткая максимальная длина пути. Однако его вычислительная сложность квадратична по длине последовательности, поэтому на очень длинных последовательностях вычисления будут очень медленными.
10.6.3 Позиционное кодирование
При обработке последовательности токенов рекуррентная нейронная сеть обрабатывает токены по одному и повторяет эту операцию, а самовнимание из-за параллельных вычислений отказывается от последовательных операций. Чтобы использовать информацию о порядке в последовательности, в представление входа добавляют позиционное кодирование (positional encoding), которое внедряет абсолютную или относительную информацию о позиции. Позиционное кодирование может быть обучаемым или фиксированным. Ниже описано фиксированное позиционное кодирование на основе синусов и косинусов (Vaswani et al., 2017).
Пусть входное представление содержит -мерные векторные вложения для токенов последовательности. Позиционное кодирование возвращает , где матрица позиционных вложений имеет ту же форму. Элементы в -й строке, -м и -м столбцах равны:
На первый взгляд такая конструкция на основе тригонометрических функций выглядит странно. Прежде чем её объяснять, реализуем её в классе PositionalEncoding ниже.
MXNet:
#@save
class PositionalEncoding(nn.Block):
"""Позиционное кодирование"""
def __init__(self, num_hiddens, dropout, max_len=1000):
super(PositionalEncoding, self).__init__()
self.dropout = nn.Dropout(dropout)
# Создаём достаточно длинную P
self.P = d2l.zeros((1, max_len, num_hiddens))
X = d2l.arange(max_len).reshape(-1, 1) / np.power(
10000, np.arange(0, num_hiddens, 2) / num_hiddens)
self.P[:, :, 0::2] = np.sin(X)
self.P[:, :, 1::2] = np.cos(X)
def forward(self, X):
X = X + self.P[:, :X.shape[1], :].as_in_ctx(X.ctx)
return self.dropout(X)
PyTorch:
#@save
class PositionalEncoding(nn.Module):
"""Позиционное кодирование"""
def __init__(self, num_hiddens, dropout, max_len=1000):
super(PositionalEncoding, self).__init__()
self.dropout = nn.Dropout(dropout)
# Создаём достаточно длинную P
self.P = d2l.zeros((1, max_len, num_hiddens))
X = d2l.arange(max_len, dtype=torch.float32).reshape(
-1, 1) / torch.pow(10000, torch.arange(
0, num_hiddens, 2, dtype=torch.float32) / num_hiddens)
self.P[:, :, 0::2] = torch.sin(X)
self.P[:, :, 1::2] = torch.cos(X)
def forward(self, X):
X = X + self.P[:, :X.shape[1], :].to(X.device)
return self.dropout(X)
TensorFlow:
#@save
class PositionalEncoding(tf.keras.layers.Layer):
"""Позиционное кодирование"""
def __init__(self, num_hiddens, dropout, max_len=1000):
super().__init__()
self.dropout = tf.keras.layers.Dropout(dropout)
# Создаём достаточно длинную P
self.P = np.zeros((1, max_len, num_hiddens))
X = np.arange(max_len, dtype=np.float32).reshape(
-1,1)/np.power(10000, np.arange(
0, num_hiddens, 2, dtype=np.float32) / num_hiddens)
self.P[:, :, 0::2] = np.sin(X)
self.P[:, :, 1::2] = np.cos(X)
def call(self, X, **kwargs):
X = X + self.P[:, :X.shape[1], :]
return self.dropout(X, **kwargs)
PaddlePaddle:
#@save
class PositionalEncoding(nn.Layer):
"""Позиционное кодирование"""
def __init__(self, num_hiddens, dropout, max_len=1000):
super(PositionalEncoding, self).__init__()
self.dropout = nn.Dropout(dropout)
# Создаём достаточно длинную P
self.P = paddle.zeros((1, max_len, num_hiddens))
X = paddle.arange(max_len, dtype=paddle.float32).reshape(
(-1, 1)) / paddle.pow(paddle.to_tensor([10000.0]), paddle.arange(
0, num_hiddens, 2, dtype=paddle.float32) / num_hiddens)
self.P[:, :, 0::2] = paddle.sin(X)
self.P[:, :, 1::2] = paddle.cos(X)
def forward(self, X):
X = X + self.P[:, :X.shape[1], :]
return self.dropout(X)
В матрице позиционных вложений строки соответствуют позициям токенов в последовательности, а столбцы — разным измерениям позиционного кодирования. Из примера ниже видно, что частота в 6-м и 7-м столбцах матрицы позиционных вложений выше, чем в 8-м и 9-м. Сдвиг между 6-м и 7-м столбцами (так же как между 8-м и 9-м) обусловлен чередованием синуса и косинуса.
MXNet:
encoding_dim, num_steps = 32, 60
pos_encoding = PositionalEncoding(encoding_dim, 0)
pos_encoding.initialize()
X = pos_encoding(np.zeros((1, num_steps, encoding_dim)))
P = pos_encoding.P[:, :X.shape[1], :]
d2l.plot(d2l.arange(num_steps), P[0, :, 6:10].T, xlabel='Row (position)',
figsize=(6, 2.5), legend=["Col %d" % d for d in d2l.arange(6, 10)])
PyTorch:
encoding_dim, num_steps = 32, 60
pos_encoding = PositionalEncoding(encoding_dim, 0)
pos_encoding.eval()
X = pos_encoding(d2l.zeros((1, num_steps, encoding_dim)))
P = pos_encoding.P[:, :X.shape[1], :]
d2l.plot(d2l.arange(num_steps), P[0, :, 6:10].T, xlabel='Row (position)',
figsize=(6, 2.5), legend=["Col %d" % d for d in d2l.arange(6, 10)])
TensorFlow:
encoding_dim, num_steps = 32, 60
pos_encoding = PositionalEncoding(encoding_dim, 0)
X = pos_encoding(tf.zeros((1, num_steps, encoding_dim)), training=False)
P = pos_encoding.P[:, :X.shape[1], :]
d2l.plot(np.arange(num_steps), P[0, :, 6:10].T, xlabel='Row (position)',
figsize=(6, 2.5), legend=["Col %d" % d for d in np.arange(6, 10)])
PaddlePaddle:
encoding_dim, num_steps = 32, 60
pos_encoding = PositionalEncoding(encoding_dim, 0)
pos_encoding.eval()
X = pos_encoding(paddle.zeros((1, num_steps, encoding_dim)))
P = pos_encoding.P[:, :X.shape[1], :]
d2l.plot(paddle.arange(num_steps), P[0, :, 6:10].T, xlabel='Row (position)',
figsize=(6, 2.5), legend=["Col %d" % d for d in paddle.arange(6, 10)])
10.6.3.1 Абсолютная позиционная информация
Чтобы понять связь между частотой, которая монотонно убывает по измерениям кодирования, и абсолютной позиционной информацией, выведем двоичное представление чисел . Как видно, в двоичной записи каждого числа, каждой пары и каждой четвёрки чисел значения битов чередуются соответственно в младшем, втором и третьем разрядах.
MXNet, PyTorch, TensorFlow, PaddlePaddle:
for i in range(8):
print(f'Двоичное представление {i}: {i:>03b}')
В двоичной записи биты старших разрядов чередуются реже, чем младших. Это похоже на тепловую карту ниже, с той разницей, что позиционное кодирование использует тригонометрические функции и снижает частоту по измерениям кодирования. Поскольку выходы — числа с плавающей точкой, такое непрерывное представление экономнее двоичной записи.
MXNet:
P = np.expand_dims(np.expand_dims(P[0, :, :], 0), 0)
d2l.show_heatmaps(P, xlabel='Column (encoding dimension)',
ylabel='Row (position)', figsize=(3.5, 4), cmap='Blues')
PyTorch:
P = P[0, :, :].unsqueeze(0).unsqueeze(0)
d2l.show_heatmaps(P, xlabel='Column (encoding dimension)',
ylabel='Row (position)', figsize=(3.5, 4), cmap='Blues')
TensorFlow:
P = tf.expand_dims(tf.expand_dims(P[0, :, :], axis=0), axis=0)
d2l.show_heatmaps(P, xlabel='Column (encoding dimension)',
ylabel='Row (position)', figsize=(3.5, 4), cmap='Blues')
PaddlePaddle:
P = P[0, :, :].unsqueeze(0).unsqueeze(0)
d2l.show_heatmaps(P, xlabel='Column (encoding dimension)',
ylabel='Row (position)', figsize=(3.5, 4), cmap='Blues')
10.6.3.2 Относительная позиционная информация
Помимо абсолютной позиционной информации, описанное позиционное кодирование позволяет модели выучивать относительную позиционную информацию в последовательности входа. Это возможно потому, что для любого фиксированного смещения позиции позиционное кодирование на позиции можно выразить линейным преобразованием позиционного кодирования на позиции .
Математически это выглядит так. Пусть . Тогда для любого фиксированного смещения любая пара из (10.6.1) линейно проецируется в :
где матрица проекции размера не зависит от индекса позиции .
Резюме
- В самовнимании запросы, ключи и значения происходят из одного и того же набора входов.
- Свёрточные нейронные сети и самовнимание допускают параллельные вычисления, а у самовнимания самая короткая максимальная длина пути. Однако его вычислительная сложность квадратична по длине последовательности, поэтому на очень длинных последовательностях вычисления будут очень медленными.
- Чтобы использовать информацию о порядке в последовательности, в представление входа можно добавлять позиционное кодирование, внедряя абсолютную или относительную позиционную информацию.
Упражнения
- Предположим, что мы строим глубокую архитектуру, которая представляет последовательность, складывая слои самовнимания с позиционным кодированием. Какие проблемы могут возникнуть?
- Предложите способ обучаемого позиционного кодирования.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Lin, Z., Feng, M., Santos, C. N. d., Yu, M., Xiang, B., Zhou, B., & Bengio, Y. (2017). A structured self-attentive sentence embedding. arXiv preprint arXiv:1703.03130.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 5998–6008.
- Cheng, J., Dong, L., & Lapata, M. (2016). Long short-term memory-networks for machine reading. In Proceedings of the 2016 Conference on Empirical Methods in Natural Language Processing, 551–561.
- Parikh, A. P., Täckström, O., Das, D., & Uszkoreit, J. (2016). A decomposable attention model for natural language inference. arXiv preprint arXiv:1606.01933.
- Paulus, R., Xiong, C., & Socher, R. (2017). A deep reinforced model for abstractive summarization. arXiv preprint arXiv:1705.04304.
- Hochreiter, S., Bengio, Y., Frasconi, P., & Schmidhuber, J. (2001). Gradient flow in recurrent nets: the difficulty of learning long-term dependencies. In A Field Guide to Dynamical Recurrent Neural Networks. IEEE Press.
10.7 Transformer
В разделе 10.6 мы сравнили свёрточные нейронные сети (CNN), рекуррентные нейронные сети (RNN) и самовнимание (self-attention) (см. раздел 10.6.2). Самовнимание одновременно допускает параллельные вычисления и имеет самую короткую максимальную длину пути, поэтому проектировать на его основе глубокие архитектуры очень привлекательно. Ранние модели самовнимания по-прежнему опирались на рекуррентные нейронные сети для представления входа (Cheng et al., 2016; Lin et al., 2017; Paulus et al., 2017). Модель Transformer полностью основана на механизмах внимания и не содержит ни свёрточных, ни рекуррентных слоёв (Vaswani et al., 2017). Хотя Transformer изначально применялся к текстовым данным для обучения «последовательность в последовательность», сейчас его обобщили на многие области современного глубокого обучения, например на язык, зрение, речь и обучение с подкреплением.
10.7.1 Модель
Transformer — экземпляр архитектуры «кодировщик — декодировщик». Его общая схема показана на рис. 10.7.1. Как видно, Transformer состоит из кодировщика и декодировщика. По сравнению с обучением «последовательность в последовательность» на основе внимания Баданау (рис. 10.4.1), блоки кодировщика и декодировщика Transformer строятся из модулей самовнимания, а вложения исходной и целевой последовательностей дополняются позиционным кодированием, прежде чем подаются в кодировщик и декодировщик.
Рис. 10.7.1. Архитектура Transformer
На рис. 10.7.1 изображена общая схема Transformer. Если смотреть в целом, кодировщик Transformer — это стопка из нескольких одинаковых слоёв, каждый из которых состоит из двух подслоёв (подслои обозначены ). Первый подслой — многоголовое самовнимание (multi-head self-attention) с агрегацией, второй — позиционная полносвязная сеть (positionwise feed-forward network). При вычислении самовнимания кодировщика запросы, ключи и значения происходят из выхода предыдущего слоя кодировщика. Вдохновлённые остаточными сетями из раздела 7.6, каждый подслой использует остаточное соединение (residual connection). В Transformer для любого входа в любой позиции последовательности требуется , чтобы остаточное соединение давало . После сложения в остаточном соединении сразу применяется нормализация слоя (layer normalization) (Ba et al., 2016). Таким образом, для каждой позиции входной последовательности кодировщик Transformer выдаёт -мерный вектор представления.
Декодировщик Transformer также состоит из нескольких одинаковых слоёв с остаточными соединениями и нормализацией слоёв. Помимо двух подслоёв кодировщика, декодировщик вставляет между ними третий подслой — внимание «кодировщик — декодировщик» (encoder-decoder attention). В этом внимании запросы происходят из выхода предыдущего слоя декодировщика, а ключи и значения — из выхода всего кодировщика. В самовнимании декодировщика запросы, ключи и значения происходят из выхода предыдущего слоя декодировщика. Однако каждая позиция декодировщика может учитывать только позиции до неё. Такое маскированное (masked) внимание сохраняет авторегрессионное (auto-regressive) свойство: предсказание зависит только от уже сгенерированных выходов.
Многоголовое внимание с масштабированным скалярным произведением (раздел 10.5) и позиционное кодирование (раздел 10.6.3) мы уже описали и реализовали. Теперь реализуем оставшиеся части Transformer.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, np, npx
from mxnet.gluon import nn
import pandas as pd
npx.set_np()
PyTorch:
from d2l import torch as d2l
import math
import pandas as pd
import torch
from torch import nn
TensorFlow:
from d2l import tensorflow as d2l
import numpy as np
import pandas as pd
import tensorflow as tf
PaddlePaddle:
from d2l import paddle as d2l
import math
import pandas as pd
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
10.7.2 Позиционная полносвязная сеть
Позиционная полносвязная сеть применяет одну и ту же многослойную сеть (MLP) к представлениям всех позиций последовательности; поэтому её называют позиционной (positionwise). В реализации ниже вход X формы (размер батча, число временных шагов или длина последовательности, число скрытых элементов или размерность признаков) двухслойным перцептроном преобразуется в выходной тензор формы (размер батча, число временных шагов, ffn_num_outputs).
MXNet:
#@save
class PositionWiseFFN(nn.Block):
"""Позиционная полносвязная сеть"""
def __init__(self, ffn_num_hiddens, ffn_num_outputs, **kwargs):
super(PositionWiseFFN, self).__init__(**kwargs)
self.dense1 = nn.Dense(ffn_num_hiddens, flatten=False,
activation='relu')
self.dense2 = nn.Dense(ffn_num_outputs, flatten=False)
def forward(self, X):
return self.dense2(self.dense1(X))
PyTorch:
#@save
class PositionWiseFFN(nn.Module):
"""Позиционная полносвязная сеть"""
def __init__(self, ffn_num_input, ffn_num_hiddens, ffn_num_outputs,
**kwargs):
super(PositionWiseFFN, self).__init__(**kwargs)
self.dense1 = nn.Linear(ffn_num_input, ffn_num_hiddens)
self.relu = nn.ReLU()
self.dense2 = nn.Linear(ffn_num_hiddens, ffn_num_outputs)
def forward(self, X):
return self.dense2(self.relu(self.dense1(X)))
TensorFlow:
#@save
class PositionWiseFFN(tf.keras.layers.Layer):
"""Позиционная полносвязная сеть"""
def __init__(self, ffn_num_hiddens, ffn_num_outputs, **kwargs):
super().__init__(*kwargs)
self.dense1 = tf.keras.layers.Dense(ffn_num_hiddens)
self.relu = tf.keras.layers.ReLU()
self.dense2 = tf.keras.layers.Dense(ffn_num_outputs)
def call(self, X):
return self.dense2(self.relu(self.dense1(X)))
PaddlePaddle:
#@save
class PositionWiseFFN(nn.Layer):
"""Позиционная полносвязная сеть"""
def __init__(self, ffn_num_input, ffn_num_hiddens, ffn_num_outputs,
**kwargs):
super(PositionWiseFFN, self).__init__(**kwargs)
self.dense1 = nn.Linear(ffn_num_input, ffn_num_hiddens)
self.relu = nn.ReLU()
self.dense2 = nn.Linear(ffn_num_hiddens, ffn_num_outputs)
def forward(self, X):
return self.dense2(self.relu(self.dense1(X)))
Пример показывает, что изменение размерности последнего измерения тензора меняет размерность выхода позиционной полносвязной сети. Поскольку одна и та же многослойная сеть применяется ко всем позициям, если входы во всех этих позициях одинаковы, то и выходы тоже одинаковы.
MXNet:
ffn = PositionWiseFFN(4, 8)
ffn.initialize()
ffn(np.ones((2, 3, 4)))[0]
PyTorch:
ffn = PositionWiseFFN(4, 4, 8)
ffn.eval()
ffn(d2l.ones((2, 3, 4)))[0]
TensorFlow:
ffn = PositionWiseFFN(4, 8)
ffn(tf.ones((2, 3, 4)))[0]
PaddlePaddle:
ffn = PositionWiseFFN(4, 4, 8)
ffn.eval()
ffn(d2l.ones((2, 3, 4)))[0]
10.7.3 Остаточные соединения и нормализация слоёв
Теперь рассмотрим компонент сложение и нормализация (add&norm) на рис. 10.7.1. Как сказано выше, он состоит из остаточного соединения, за которым следует нормализация слоёв. Оба элемента важны для построения эффективных глубоких архитектур.
В разделе 7.5 мы объясняли, как пакетная нормализация перецентрирует и перемасштабирует данные внутри минибатча. Нормализация слоёв и пакетная нормализация преследуют одну цель, но нормализация слоёв выполняется по признакам. Хотя пакетная нормализация широко применяется в компьютерном зрении, в задачах обработки естественного языка, где входы обычно имеют переменную длину, она обычно работает хуже нормализации слоёв.
Следующий код сравнивает нормализацию слоёв и пакетную нормализацию по разным измерениям.
MXNet:
ln = nn.LayerNorm()
ln.initialize()
bn = nn.BatchNorm()
bn.initialize()
X = d2l.tensor([[1, 2], [2, 3]])
# Вычисляем среднее и дисперсию X в режиме обучения
with autograd.record():
print('нормализация слоёв:', ln(X), '\nпакетная нормализация:', bn(X))
PyTorch:
ln = nn.LayerNorm(2)
bn = nn.BatchNorm1d(2)
X = d2l.tensor([[1, 2], [2, 3]], dtype=torch.float32)
# Вычисляем среднее и дисперсию X в режиме обучения
print('нормализация слоёв:', ln(X), '\nпакетная нормализация:', bn(X))
TensorFlow:
ln = tf.keras.layers.LayerNormalization()
bn = tf.keras.layers.BatchNormalization()
X = tf.constant([[1, 2], [2, 3]], dtype=tf.float32)
print('нормализация слоёв:', ln(X), '\nпакетная нормализация:', bn(X, training=True))
PaddlePaddle:
ln = nn.LayerNorm(2)
bn = nn.BatchNorm1D(2)
X = d2l.tensor([[1, 2], [2, 3]], dtype=paddle.float32)
# Вычисляем среднее и дисперсию X в режиме обучения
print('нормализация слоёв:', ln(X), '\nпакетная нормализация:', bn(X))
Теперь можно использовать остаточные соединения и нормализацию слоёв для реализации класса AddNorm. Исключение (dropout) также применяется здесь как метод регуляризации.
MXNet:
#@save
class AddNorm(nn.Block):
"""Нормализация слоёв после остаточного соединения"""
def __init__(self, dropout, **kwargs):
super(AddNorm, self).__init__(**kwargs)
self.dropout = nn.Dropout(dropout)
self.ln = nn.LayerNorm()
def forward(self, X, Y):
return self.ln(self.dropout(Y) + X)
PyTorch:
#@save
class AddNorm(nn.Module):
"""Нормализация слоёв после остаточного соединения"""
def __init__(self, normalized_shape, dropout, **kwargs):
super(AddNorm, self).__init__(**kwargs)
self.dropout = nn.Dropout(dropout)
self.ln = nn.LayerNorm(normalized_shape)
def forward(self, X, Y):
return self.ln(self.dropout(Y) + X)
TensorFlow:
#@save
class AddNorm(tf.keras.layers.Layer):
"""Нормализация слоёв после остаточного соединения"""
def __init__(self, normalized_shape, dropout, **kwargs):
super().__init__(**kwargs)
self.dropout = tf.keras.layers.Dropout(dropout)
self.ln = tf.keras.layers.LayerNormalization(normalized_shape)
def call(self, X, Y, **kwargs):
return self.ln(self.dropout(Y, **kwargs) + X)
PaddlePaddle:
#@save
class AddNorm(nn.Layer):
"""Нормализация слоёв после остаточного соединения"""
def __init__(self, normalized_shape, dropout, **kwargs):
super(AddNorm, self).__init__(**kwargs)
self.dropout = nn.Dropout(dropout)
self.ln = nn.LayerNorm(normalized_shape)
def forward(self, X, Y):
return self.ln(self.dropout(Y) + X)
Остаточное соединение требует, чтобы два входа имели одинаковую форму, чтобы после сложения выход имел ту же форму.
MXNet:
add_norm = AddNorm(0.5)
add_norm.initialize()
add_norm(d2l.ones((2, 3, 4)), d2l.ones((2, 3, 4))).shape
PyTorch, PaddlePaddle:
add_norm = AddNorm([3, 4], 0.5)
add_norm.eval()
add_norm(d2l.ones((2, 3, 4)), d2l.ones((2, 3, 4))).shape
TensorFlow:
add_norm = AddNorm([1, 2], 0.5)
add_norm(tf.ones((2, 3, 4)), tf.ones((2, 3, 4)), training=False).shape
10.7.4 Кодировщик
Имея базовые компоненты кодировщика Transformer, сначала реализуем один слой кодировщика. Класс EncoderBlock ниже содержит два подслоя: многоголовое самовнимание и позиционную полносвязную сеть. Оба используют остаточные соединения и последующую нормализацию слоёв.
MXNet:
#@save
class EncoderBlock(nn.Block):
"""Блок кодировщика Transformer"""
def __init__(self, num_hiddens, ffn_num_hiddens, num_heads, dropout,
use_bias=False, **kwargs):
super(EncoderBlock, self).__init__(**kwargs)
self.attention = d2l.MultiHeadAttention(
num_hiddens, num_heads, dropout, use_bias)
self.addnorm1 = AddNorm(dropout)
self.ffn = PositionWiseFFN(ffn_num_hiddens, num_hiddens)
self.addnorm2 = AddNorm(dropout)
def forward(self, X, valid_lens):
Y = self.addnorm1(X, self.attention(X, X, X, valid_lens))
return self.addnorm2(Y, self.ffn(Y))
PyTorch:
#@save
class EncoderBlock(nn.Module):
"""Блок кодировщика Transformer"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
dropout, use_bias=False, **kwargs):
super(EncoderBlock, self).__init__(**kwargs)
self.attention = d2l.MultiHeadAttention(
key_size, query_size, value_size, num_hiddens, num_heads, dropout,
use_bias)
self.addnorm1 = AddNorm(norm_shape, dropout)
self.ffn = PositionWiseFFN(
ffn_num_input, ffn_num_hiddens, num_hiddens)
self.addnorm2 = AddNorm(norm_shape, dropout)
def forward(self, X, valid_lens):
Y = self.addnorm1(X, self.attention(X, X, X, valid_lens))
return self.addnorm2(Y, self.ffn(Y))
TensorFlow:
#@save
class EncoderBlock(tf.keras.layers.Layer):
"""Блок кодировщика Transformer"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_hiddens, num_heads, dropout, bias=False, **kwargs):
super().__init__(**kwargs)
self.attention = d2l.MultiHeadAttention(key_size, query_size, value_size, num_hiddens,
num_heads, dropout, bias)
self.addnorm1 = AddNorm(norm_shape, dropout)
self.ffn = PositionWiseFFN(ffn_num_hiddens, num_hiddens)
self.addnorm2 = AddNorm(norm_shape, dropout)
def call(self, X, valid_lens, **kwargs):
Y = self.addnorm1(X, self.attention(X, X, X, valid_lens, **kwargs), **kwargs)
return self.addnorm2(Y, self.ffn(Y), **kwargs)
PaddlePaddle:
#@save
class EncoderBlock(nn.Layer):
"""Блок кодировщика Transformer"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
dropout, use_bias=False, **kwargs):
super(EncoderBlock, self).__init__(**kwargs)
self.attention = d2l.MultiHeadAttention(
key_size, query_size, value_size, num_hiddens, num_heads, dropout,
use_bias)
self.addnorm1 = AddNorm(norm_shape, dropout)
self.ffn = PositionWiseFFN(
ffn_num_input, ffn_num_hiddens, num_hiddens)
self.addnorm2 = AddNorm(norm_shape, dropout)
def forward(self, X, valid_lens):
Y = self.addnorm1(X, self.attention(X, X, X, valid_lens))
return self.addnorm2(Y, self.ffn(Y))
Как видно из кода, ни один слой кодировщика Transformer не меняет форму своего входа.
MXNet:
X = d2l.ones((2, 100, 24))
valid_lens = d2l.tensor([3, 2])
encoder_blk = EncoderBlock(24, 48, 8, 0.5)
encoder_blk.initialize()
encoder_blk(X, valid_lens).shape
PyTorch:
X = d2l.ones((2, 100, 24))
valid_lens = d2l.tensor([3, 2])
encoder_blk = EncoderBlock(24, 24, 24, 24, [100, 24], 24, 48, 8, 0.5)
encoder_blk.eval()
encoder_blk(X, valid_lens).shape
TensorFlow:
X = tf.ones((2, 100, 24))
valid_lens = tf.constant([3, 2])
norm_shape = [i for i in range(len(X.shape))][1:]
encoder_blk = EncoderBlock(24, 24, 24, 24, norm_shape, 48, 8, 0.5)
encoder_blk(X, valid_lens, training=False).shape
PaddlePaddle:
X = d2l.ones((2, 100, 24))
valid_lens = d2l.tensor([3, 2])
encoder_blk = EncoderBlock(24, 24, 24, 24, [100, 24], 24, 48, 8, 0.5)
encoder_blk.eval()
encoder_blk(X, valid_lens).shape
Ниже реализован Transformer-кодировщик: в нём складываются num_layers экземпляров класса EncoderBlock. Поскольку здесь используется фиксированное позиционное кодирование со значениями от до , значения обучаемых вложений входа сначала умножаются на квадратный корень из размерности вложения, а затем складываются с позиционным кодированием.
MXNet:
#@save
class TransformerEncoder(d2l.Encoder):
"""Кодировщик Transformer"""
def __init__(self, vocab_size, num_hiddens, ffn_num_hiddens,
num_heads, num_layers, dropout, use_bias=False, **kwargs):
super(TransformerEncoder, self).__init__(**kwargs)
self.num_hiddens = num_hiddens
self.embedding = nn.Embedding(vocab_size, num_hiddens)
self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
self.blks = nn.Sequential()
for _ in range(num_layers):
self.blks.add(
EncoderBlock(num_hiddens, ffn_num_hiddens, num_heads, dropout,
use_bias))
def forward(self, X, valid_lens, *args):
# Поскольку значения позиционного кодирования лежат между -1 и 1,
# поэтому значения вложений умножаем на квадратный корень из размерности вложения,
# а затем складываем с позиционным кодированием.
X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
self.attention_weights = [None] * len(self.blks)
for i, blk in enumerate(self.blks):
X = blk(X, valid_lens)
self.attention_weights[
i] = blk.attention.attention.attention_weights
return X
PyTorch:
#@save
class TransformerEncoder(d2l.Encoder):
"""Кодировщик Transformer"""
def __init__(self, vocab_size, key_size, query_size, value_size,
num_hiddens, norm_shape, ffn_num_input, ffn_num_hiddens,
num_heads, num_layers, dropout, use_bias=False, **kwargs):
super(TransformerEncoder, self).__init__(**kwargs)
self.num_hiddens = num_hiddens
self.embedding = nn.Embedding(vocab_size, num_hiddens)
self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
self.blks = nn.Sequential()
for i in range(num_layers):
self.blks.add_module("block"+str(i),
EncoderBlock(key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens,
num_heads, dropout, use_bias))
def forward(self, X, valid_lens, *args):
# Поскольку значения позиционного кодирования лежат между -1 и 1,
# поэтому значения вложений умножаем на квадратный корень из размерности вложения,
# а затем складываем с позиционным кодированием.
X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
self.attention_weights = [None] * len(self.blks)
for i, blk in enumerate(self.blks):
X = blk(X, valid_lens)
self.attention_weights[
i] = blk.attention.attention.attention_weights
return X
TensorFlow:
#@save
class TransformerEncoder(d2l.Encoder):
"""Кодировщик Transformer"""
def __init__(self, vocab_size, key_size, query_size, value_size,
num_hiddens, norm_shape, ffn_num_hiddens, num_heads,
num_layers, dropout, bias=False, **kwargs):
super().__init__(**kwargs)
self.num_hiddens = num_hiddens
self.embedding = tf.keras.layers.Embedding(vocab_size, num_hiddens)
self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
self.blks = [EncoderBlock(
key_size, query_size, value_size, num_hiddens, norm_shape,
ffn_num_hiddens, num_heads, dropout, bias) for _ in range(
num_layers)]
def call(self, X, valid_lens, **kwargs):
# Поскольку значения позиционного кодирования лежат между -1 и 1,
# поэтому значения вложений умножаем на квадратный корень из размерности вложения,
# а затем складываем с позиционным кодированием.
X = self.pos_encoding(self.embedding(X) * tf.math.sqrt(
tf.cast(self.num_hiddens, dtype=tf.float32)), **kwargs)
self.attention_weights = [None] * len(self.blks)
for i, blk in enumerate(self.blks):
X = blk(X, valid_lens, **kwargs)
self.attention_weights[
i] = blk.attention.attention.attention_weights
return X
PaddlePaddle:
#@save
class TransformerEncoder(d2l.Encoder):
"""Кодировщик Transformer"""
def __init__(self, vocab_size, key_size, query_size, value_size,
num_hiddens, norm_shape, ffn_num_input, ffn_num_hiddens,
num_heads, num_layers, dropout, use_bias=False, **kwargs):
super(TransformerEncoder, self).__init__(**kwargs)
self.num_hiddens = num_hiddens
self.embedding = nn.Embedding(vocab_size, num_hiddens)
self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
self.blks = nn.Sequential()
for i in range(num_layers):
self.blks.add_sublayer(str(i),
EncoderBlock(key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens,
num_heads, dropout, use_bias))
def forward(self, X, valid_lens, *args):
# Поскольку значения позиционного кодирования лежат между -1 и 1,
# поэтому значения вложений умножаем на квадратный корень из размерности вложения,
# а затем складываем с позиционным кодированием.
X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
self.attention_weights = [None] * len(self.blks)
for i, blk in enumerate(self.blks):
X = blk(X, valid_lens)
self.attention_weights[
i] = blk.attention.attention.attention_weights
return X
Создадим двухслойный Transformer-кодировщик с заданными гиперпараметрами. Выход Transformer-кодировщика имеет форму (размер батча, число временных шагов, num_hiddens).
MXNet:
encoder = TransformerEncoder(200, 24, 48, 8, 2, 0.5)
encoder.initialize()
encoder(np.ones((2, 100)), valid_lens).shape
PyTorch:
encoder = TransformerEncoder(
200, 24, 24, 24, 24, [100, 24], 24, 48, 8, 2, 0.5)
encoder.eval()
encoder(d2l.ones((2, 100), dtype=torch.long), valid_lens).shape
TensorFlow:
encoder = TransformerEncoder(200, 24, 24, 24, 24, [1, 2], 48, 8, 2, 0.5)
encoder(tf.ones((2, 100)), valid_lens, training=False).shape
PaddlePaddle:
encoder = TransformerEncoder(
200, 24, 24, 24, 24, [100, 24], 24, 48, 8, 2, 0.5)
encoder.eval()
encoder(d2l.ones((2, 100), dtype=paddle.int64), valid_lens).shape
10.7.5 Декодировщик
Как показано на рис. 10.7.1, Transformer-декодировщик тоже состоит из нескольких одинаковых слоёв. Каждый слой, реализованный в классе DecoderBlock, содержит три подслоя: самовнимание декодировщика, внимание «кодировщик — декодировщик» и позиционную полносвязную сеть. Все они также обрамлены остаточными соединениями и последующей нормализацией слоёв.
Как говорилось выше, в маскированном многоголовом самовнимании декодировщика (первом подслое) запросы, ключи и значения происходят из выхода предыдущего слоя декодировщика. Что касается модели «последовательность в последовательность», на этапе обучения токены всех позиций выходной последовательности известны, однако на этапе предсказания токены выходной последовательности генерируются по одному. Поэтому на любом шаге декодирования в самовнимании декодировщика используются только уже сгенерированные токены. Чтобы сохранить авторегрессионное свойство в декодировщике, маскированное самовнимание задаёт параметр dec_valid_lens, так что каждый запрос учитывает только позиции уже сгенерированных токенов декодировщика, то есть позиции до текущего запроса включительно.
MXNet:
class DecoderBlock(nn.Block):
"""i-й блок декодировщика"""
def __init__(self, num_hiddens, ffn_num_hiddens, num_heads,
dropout, i, **kwargs):
super(DecoderBlock, self).__init__(**kwargs)
self.i = i
self.attention1 = d2l.MultiHeadAttention(num_hiddens, num_heads,
dropout)
self.addnorm1 = AddNorm(dropout)
self.attention2 = d2l.MultiHeadAttention(num_hiddens, num_heads,
dropout)
self.addnorm2 = AddNorm(dropout)
self.ffn = PositionWiseFFN(ffn_num_hiddens, num_hiddens)
self.addnorm3 = AddNorm(dropout)
def forward(self, X, state):
enc_outputs, enc_valid_lens = state[0], state[1]
# На этапе обучения все токены выходной последовательности обрабатываются одновременно,
# поэтому state[2][self.i] инициализируется значением None.
# На этапе предсказания выходная последовательность декодируется токен за токеном,
# поэтому state[2][self.i] содержит выходные представления, декодированные i-м блоком до текущего шага
if state[2][self.i] is None:
key_values = X
else:
key_values = np.concatenate((state[2][self.i], X), axis=1)
state[2][self.i] = key_values
if autograd.is_training():
batch_size, num_steps, _ = X.shape
# Начало dec_valid_lens: (batch_size, num_steps),
# где каждая строка равна [1, 2, ..., num_steps]
dec_valid_lens = np.tile(np.arange(1, num_steps + 1, ctx=X.ctx),
(batch_size, 1))
else:
dec_valid_lens = None
# Самовнимание
X2 = self.attention1(X, key_values, key_values, dec_valid_lens)
Y = self.addnorm1(X, X2)
# Внимание «кодировщик — декодировщик».
# Начало enc_outputs: (batch_size, num_steps, num_hiddens)
Y2 = self.attention2(Y, enc_outputs, enc_outputs, enc_valid_lens)
Z = self.addnorm2(Y, Y2)
return self.addnorm3(Z, self.ffn(Z)), state
PyTorch:
class DecoderBlock(nn.Module):
"""i-й блок декодировщика"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
dropout, i, **kwargs):
super(DecoderBlock, self).__init__(**kwargs)
self.i = i
self.attention1 = d2l.MultiHeadAttention(
key_size, query_size, value_size, num_hiddens, num_heads, dropout)
self.addnorm1 = AddNorm(norm_shape, dropout)
self.attention2 = d2l.MultiHeadAttention(
key_size, query_size, value_size, num_hiddens, num_heads, dropout)
self.addnorm2 = AddNorm(norm_shape, dropout)
self.ffn = PositionWiseFFN(ffn_num_input, ffn_num_hiddens,
num_hiddens)
self.addnorm3 = AddNorm(norm_shape, dropout)
def forward(self, X, state):
enc_outputs, enc_valid_lens = state[0], state[1]
# На этапе обучения все токены выходной последовательности обрабатываются одновременно,
# поэтому state[2][self.i] инициализируется значением None.
# На этапе предсказания выходная последовательность декодируется токен за токеном,
# поэтому state[2][self.i] содержит выходные представления, декодированные i-м блоком до текущего шага
if state[2][self.i] is None:
key_values = X
else:
key_values = torch.cat((state[2][self.i], X), axis=1)
state[2][self.i] = key_values
if self.training:
batch_size, num_steps, _ = X.shape
# Начало dec_valid_lens: (batch_size, num_steps),
# где каждая строка равна [1, 2, ..., num_steps]
dec_valid_lens = torch.arange(
1, num_steps + 1, device=X.device).repeat(batch_size, 1)
else:
dec_valid_lens = None
# Самовнимание
X2 = self.attention1(X, key_values, key_values, dec_valid_lens)
Y = self.addnorm1(X, X2)
# Внимание «кодировщик — декодировщик».
# Начало enc_outputs: (batch_size, num_steps, num_hiddens)
Y2 = self.attention2(Y, enc_outputs, enc_outputs, enc_valid_lens)
Z = self.addnorm2(Y, Y2)
return self.addnorm3(Z, self.ffn(Z)), state
TensorFlow:
class DecoderBlock(tf.keras.layers.Layer):
"""i-й блок декодировщика"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_hiddens, num_heads, dropout, i, **kwargs):
super().__init__(**kwargs)
self.i = i
self.attention1 = d2l.MultiHeadAttention(key_size, query_size, value_size, num_hiddens, num_heads, dropout)
self.addnorm1 = AddNorm(norm_shape, dropout)
self.attention2 = d2l.MultiHeadAttention(key_size, query_size, value_size, num_hiddens, num_heads, dropout)
self.addnorm2 = AddNorm(norm_shape, dropout)
self.ffn = PositionWiseFFN(ffn_num_hiddens, num_hiddens)
self.addnorm3 = AddNorm(norm_shape, dropout)
def call(self, X, state, **kwargs):
enc_outputs, enc_valid_lens = state[0], state[1]
# На этапе обучения все токены выходной последовательности обрабатываются одновременно,
# поэтому state[2][self.i] инициализируется значением None.
# На этапе предсказания выходная последовательность декодируется токен за токеном,
# поэтому state[2][self.i] содержит выходные представления, декодированные i-м блоком до текущего шага
if state[2][self.i] is None:
key_values = X
else:
key_values = tf.concat((state[2][self.i], X), axis=1)
state[2][self.i] = key_values
if kwargs["training"]:
batch_size, num_steps, _ = X.shape
# Начало dec_valid_lens: (batch_size, num_steps),
# где каждая строка равна [1, 2, ..., num_steps]
dec_valid_lens = tf.repeat(tf.reshape(tf.range(1, num_steps + 1),
shape=(-1, num_steps)), repeats=batch_size, axis=0)
else:
dec_valid_lens = None
# Самовнимание
X2 = self.attention1(X, key_values, key_values, dec_valid_lens, **kwargs)
Y = self.addnorm1(X, X2, **kwargs)
# Внимание «кодировщик — декодировщик».
# Начало enc_outputs: (batch_size, num_steps, num_hiddens)
Y2 = self.attention2(Y, enc_outputs, enc_outputs, enc_valid_lens, **kwargs)
Z = self.addnorm2(Y, Y2, **kwargs)
return self.addnorm3(Z, self.ffn(Z), **kwargs), state
PaddlePaddle:
class DecoderBlock(nn.Layer):
"""i-й блок декодировщика"""
def __init__(self, key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
dropout, i, **kwargs):
super(DecoderBlock, self).__init__(**kwargs)
self.i = i
self.attention1 = d2l.MultiHeadAttention(
key_size, query_size, value_size, num_hiddens, num_heads, dropout)
self.addnorm1 = AddNorm(norm_shape, dropout)
self.attention2 = d2l.MultiHeadAttention(
key_size, query_size, value_size, num_hiddens, num_heads, dropout)
self.addnorm2 = AddNorm(norm_shape, dropout)
self.ffn = PositionWiseFFN(ffn_num_input, ffn_num_hiddens,
num_hiddens)
self.addnorm3 = AddNorm(norm_shape, dropout)
def forward(self, X, state):
enc_outputs, enc_valid_lens = state[0], state[1]
# На этапе обучения все токены выходной последовательности обрабатываются одновременно,
# поэтому state[2][self.i] инициализируется значением None.
# На этапе предсказания выходная последовательность декодируется токен за токеном,
# поэтому state[2][self.i] содержит выходные представления, декодированные i-м блоком до текущего шага
if state[2][self.i] is None:
key_values = X
else:
key_values = paddle.concat((state[2][self.i], X), axis=1)
state[2][self.i] = key_values
if self.training:
batch_size, num_steps, _ = X.shape
# Начало dec_valid_lens: (batch_size, num_steps),
# где каждая строка равна [1, 2, ..., num_steps]
dec_valid_lens = paddle.arange(
1, num_steps + 1).tile((batch_size, 1))
else:
dec_valid_lens = None
# Самовнимание
X2 = self.attention1(X, key_values, key_values, dec_valid_lens)
Y = self.addnorm1(X, X2)
# Внимание «кодировщик — декодировщик».
# Начало enc_outputs: (batch_size, num_steps, num_hiddens)
Y2 = self.attention2(Y, enc_outputs, enc_outputs, enc_valid_lens)
Z = self.addnorm2(Y, Y2)
return self.addnorm3(Z, self.ffn(Z)), state
Чтобы удобнее было выполнять масштабированное скалярное произведение во внимании «кодировщик — декодировщик» и сложение в остаточных соединениях, размерность признаков кодировщика и декодировщика одинакова и равна num_hiddens.
MXNet:
decoder_blk = DecoderBlock(24, 48, 8, 0.5, 0)
decoder_blk.initialize()
X = np.ones((2, 100, 24))
state = [encoder_blk(X, valid_lens), valid_lens, [None]]
decoder_blk(X, state)[0].shape
PyTorch, PaddlePaddle:
decoder_blk = DecoderBlock(24, 24, 24, 24, [100, 24], 24, 48, 8, 0.5, 0)
decoder_blk.eval()
X = d2l.ones((2, 100, 24))
state = [encoder_blk(X, valid_lens), valid_lens, [None]]
decoder_blk(X, state)[0].shape
TensorFlow:
decoder_blk = DecoderBlock(24, 24, 24, 24, [1, 2], 48, 8, 0.5, 0)
X = tf.ones((2, 100, 24))
state = [encoder_blk(X, valid_lens), valid_lens, [None]]
decoder_blk(X, state, training=False)[0].shape
Теперь построим полный Transformer-декодировщик из num_layers экземпляров DecoderBlock. Наконец, полносвязный слой вычисляет предсказания для всех vocab_size возможных выходных токенов. Веса самовнимания декодировщика и веса внимания «кодировщик — декодировщик» сохраняются, чтобы их можно было визуализировать позже.
MXNet:
class TransformerDecoder(d2l.AttentionDecoder):
def __init__(self, vocab_size, num_hiddens, ffn_num_hiddens,
num_heads, num_layers, dropout, **kwargs):
super(TransformerDecoder, self).__init__(**kwargs)
self.num_hiddens = num_hiddens
self.num_layers = num_layers
self.embedding = nn.Embedding(vocab_size, num_hiddens)
self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
self.blks = nn.Sequential()
for i in range(num_layers):
self.blks.add(
DecoderBlock(num_hiddens, ffn_num_hiddens, num_heads,
dropout, i))
self.dense = nn.Dense(vocab_size, flatten=False)
def init_state(self, enc_outputs, enc_valid_lens, *args):
return [enc_outputs, enc_valid_lens, [None] * self.num_layers]
def forward(self, X, state):
X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
self._attention_weights = [[None] * len(self.blks) for _ in range (2)]
for i, blk in enumerate(self.blks):
X, state = blk(X, state)
# Веса самовнимания декодировщика
self._attention_weights[0][
i] = blk.attention1.attention.attention_weights
# Веса внимания «кодировщик — декодировщик»
self._attention_weights[1][
i] = blk.attention2.attention.attention_weights
return self.dense(X), state
@property
def attention_weights(self):
return self._attention_weights
PyTorch:
class TransformerDecoder(d2l.AttentionDecoder):
def __init__(self, vocab_size, key_size, query_size, value_size,
num_hiddens, norm_shape, ffn_num_input, ffn_num_hiddens,
num_heads, num_layers, dropout, **kwargs):
super(TransformerDecoder, self).__init__(**kwargs)
self.num_hiddens = num_hiddens
self.num_layers = num_layers
self.embedding = nn.Embedding(vocab_size, num_hiddens)
self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
self.blks = nn.Sequential()
for i in range(num_layers):
self.blks.add_module("block"+str(i),
DecoderBlock(key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens,
num_heads, dropout, i))
self.dense = nn.Linear(num_hiddens, vocab_size)
def init_state(self, enc_outputs, enc_valid_lens, *args):
return [enc_outputs, enc_valid_lens, [None] * self.num_layers]
def forward(self, X, state):
X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
self._attention_weights = [[None] * len(self.blks) for _ in range (2)]
for i, blk in enumerate(self.blks):
X, state = blk(X, state)
# Веса самовнимания декодировщика
self._attention_weights[0][
i] = blk.attention1.attention.attention_weights
# Веса внимания «кодировщик — декодировщик»
self._attention_weights[1][
i] = blk.attention2.attention.attention_weights
return self.dense(X), state
@property
def attention_weights(self):
return self._attention_weights
TensorFlow:
class TransformerDecoder(d2l.AttentionDecoder):
def __init__(self, vocab_size, key_size, query_size, value_size,
num_hiddens, norm_shape, ffn_num_hidens, num_heads, num_layers, dropout, **kwargs):
super().__init__(**kwargs)
self.num_hiddens = num_hiddens
self.num_layers = num_layers
self.embedding = tf.keras.layers.Embedding(vocab_size, num_hiddens)
self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
self.blks = [DecoderBlock(key_size, query_size, value_size, num_hiddens, norm_shape,
ffn_num_hiddens, num_heads, dropout, i) for i in range(num_layers)]
self.dense = tf.keras.layers.Dense(vocab_size)
def init_state(self, enc_outputs, enc_valid_lens, *args):
return [enc_outputs, enc_valid_lens, [None] * self.num_layers]
def call(self, X, state, **kwargs):
X = self.pos_encoding(self.embedding(X) * tf.math.sqrt(tf.cast(self.num_hiddens, dtype=tf.float32)), **kwargs)
self._attention_weights = [[None] * len(self.blks) for _ in range(2)] # В декодировщике 2 слоя внимания
for i, blk in enumerate(self.blks):
X, state = blk(X, state, **kwargs)
# Веса самовнимания декодировщика
self._attention_weights[0][i] = blk.attention1.attention.attention_weights
# Веса внимания «кодировщик — декодировщик»
self._attention_weights[1][i] = blk.attention2.attention.attention_weights
return self.dense(X), state
@property
def attention_weights(self):
return self._attention_weights
PaddlePaddle:
class TransformerDecoder(d2l.AttentionDecoder):
def __init__(self, vocab_size, key_size, query_size, value_size,
num_hiddens, norm_shape, ffn_num_input, ffn_num_hiddens,
num_heads, num_layers, dropout, **kwargs):
super(TransformerDecoder, self).__init__(**kwargs)
self.num_hiddens = num_hiddens
self.num_layers = num_layers
self.embedding = nn.Embedding(vocab_size, num_hiddens)
self.pos_encoding = d2l.PositionalEncoding(num_hiddens, dropout)
self.blks = nn.Sequential()
for i in range(num_layers):
self.blks.add_sublayer(str(i),
DecoderBlock(key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens,
num_heads, dropout, i))
self.dense = nn.Linear(num_hiddens, vocab_size)
def init_state(self, enc_outputs, enc_valid_lens, *args):
return [enc_outputs, enc_valid_lens, [None] * self.num_layers]
def forward(self, X, state):
X = self.pos_encoding(self.embedding(X) * math.sqrt(self.num_hiddens))
self._attention_weights = [[None] * len(self.blks) for _ in range (2)]
for i, blk in enumerate(self.blks):
X, state = blk(X, state)
# Веса самовнимания декодировщика
self._attention_weights[0][
i] = blk.attention1.attention.attention_weights
# Веса внимания «кодировщик — декодировщик»
self._attention_weights[1][
i] = blk.attention2.attention.attention_weights
return self.dense(X), state
@property
def attention_weights(self):
return self._attention_weights
10.7.6 Обучение
Создадим модель «кодировщик — декодировщик» в соответствии с архитектурой Transformer. Здесь заданы два слоя для кодировщика и декодировщика, и каждый использует 4 головы внимания. Как и в разделе 9.7.4, для обучения «последовательность в последовательность» обучим Transformer на наборе данных машинного перевода «английский — французский».
MXNet:
num_hiddens, num_layers, dropout, batch_size, num_steps = 32, 2, 0.1, 64, 10
lr, num_epochs, device = 0.005, 200, d2l.try_gpu()
ffn_num_hiddens, num_heads = 64, 4
train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
encoder = TransformerEncoder(
len(src_vocab), num_hiddens, ffn_num_hiddens, num_heads, num_layers,
dropout)
decoder = TransformerDecoder(
len(tgt_vocab), num_hiddens, ffn_num_hiddens, num_heads, num_layers,
dropout)
net = d2l.EncoderDecoder(encoder, decoder)
d2l.train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
PyTorch:
num_hiddens, num_layers, dropout, batch_size, num_steps = 32, 2, 0.1, 64, 10
lr, num_epochs, device = 0.005, 200, d2l.try_gpu()
ffn_num_input, ffn_num_hiddens, num_heads = 32, 64, 4
key_size, query_size, value_size = 32, 32, 32
norm_shape = [32]
train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
encoder = TransformerEncoder(
len(src_vocab), key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
num_layers, dropout)
decoder = TransformerDecoder(
len(tgt_vocab), key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
num_layers, dropout)
net = d2l.EncoderDecoder(encoder, decoder)
d2l.train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
TensorFlow:
num_hiddens, num_layers, dropout, batch_size, num_steps = 32, 2, 0.1, 64, 10
lr, num_epochs, device = 0.005, 200, d2l.try_gpu()
ffn_num_hiddens, num_heads = 64, 4
key_size, query_size, value_size = 32, 32, 32
norm_shape = [2]
train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
encoder = TransformerEncoder(
len(src_vocab), key_size, query_size, value_size, num_hiddens, norm_shape,
ffn_num_hiddens, num_heads, num_layers, dropout)
decoder = TransformerDecoder(
len(tgt_vocab), key_size, query_size, value_size, num_hiddens, norm_shape,
ffn_num_hiddens, num_heads, num_layers, dropout)
net = d2l.EncoderDecoder(encoder, decoder)
d2l.train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
PaddlePaddle:
num_hiddens, num_layers, dropout, batch_size, num_steps = 32, 2, 0.1, 64, 10
lr, num_epochs, device = 0.005, 200, d2l.try_gpu()
ffn_num_input, ffn_num_hiddens, num_heads = 32, 64, 4
key_size, query_size, value_size = 32, 32, 32
norm_shape = [32]
train_iter, src_vocab, tgt_vocab = d2l.load_data_nmt(batch_size, num_steps)
encoder = TransformerEncoder(
len(src_vocab), key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
num_layers, dropout)
decoder = TransformerDecoder(
len(tgt_vocab), key_size, query_size, value_size, num_hiddens,
norm_shape, ffn_num_input, ffn_num_hiddens, num_heads,
num_layers, dropout)
net = d2l.EncoderDecoder(encoder, decoder)
d2l.train_seq2seq(net, train_iter, lr, num_epochs, tgt_vocab, device)
После обучения модель Transformer переводит несколько английских предложений на французский, и мы вычисляем их оценки BLEU.
MXNet, PyTorch, PaddlePaddle:
engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
translation, dec_attention_weight_seq = d2l.predict_seq2seq(
net, eng, src_vocab, tgt_vocab, num_steps, device, True)
print(f'{eng} => {translation}, ',
f'bleu {d2l.bleu(translation, fra, k=2):.3f}')
TensorFlow:
engs = ['go .', "i lost .", 'he\'s calm .', 'i\'m home .']
fras = ['va !', 'j\'ai perdu .', 'il est calme .', 'je suis chez moi .']
for eng, fra in zip(engs, fras):
translation, dec_attention_weight_seq = d2l.predict_seq2seq(
net, eng, src_vocab, tgt_vocab, num_steps, True)
print(f'{eng} => {translation}, ',
f'bleu {d2l.bleu(translation, fra, k=2):.3f}')
Теперь, когда переводим последнее английское предложение на французский, давайте визуализируем веса внимания Transformer. Форма весов самовнимания кодировщика: (число слоёв кодировщика, число голов внимания, num_steps или число запросов, num_steps или число пар «ключ — значение»).
enc_attention_weights = d2l.reshape(
d2l.concat(net.encoder.attention_weights, 0),
(num_layers, num_heads, -1, num_steps))
enc_attention_weights.shape
В самовнимании кодировщика запросы и ключи происходят из одной и той же входной последовательности. Поскольку токены заполнения не несут информации, указание действительной длины входной последовательности позволяет не вычислять внимание от запросов к позициям с токенами заполнения. Ниже построчно показаны веса двух слоёв многоголового внимания. Каждая голова внимания описывает разные отношения, опираясь на различные подпространства представлений запросов, ключей и значений.
MXNet, TensorFlow:
d2l.show_heatmaps(
enc_attention_weights, xlabel='Key positions', ylabel='Query positions',
titles=['Head %d' % i for i in range(1, 5)], figsize=(7, 3.5))
PyTorch, PaddlePaddle:
d2l.show_heatmaps(
enc_attention_weights.cpu(), xlabel='Key positions',
ylabel='Query positions', titles=['Head %d' % i for i in range(1, 5)],
figsize=(7, 3.5))
Чтобы визуализировать веса самовнимания декодировщика и веса внимания «кодировщик — декодировщик», нужно выполнить больше операций над данными. Например, заполнить нулями веса маскированного внимания. Заметим, что у весов самовнимания декодировщика и весов внимания «кодировщик — декодировщик» один и тот же запрос: они начинаются с токена начала последовательности (beginning-of-sequence, BOS), за которым следуют уже выведенные токены.
MXNet:
dec_attention_weights_2d = [d2l.tensor(head[0]).tolist()
for step in dec_attention_weight_seq
for attn in step for blk in attn for head in blk]
dec_attention_weights_filled = d2l.tensor(
pd.DataFrame(dec_attention_weights_2d).fillna(0.0).values)
dec_attention_weights = d2l.reshape(dec_attention_weights_filled,
(-1, 2, num_layers, num_heads, num_steps))
dec_self_attention_weights, dec_inter_attention_weights = \
dec_attention_weights.transpose(1, 2, 3, 0, 4)
dec_self_attention_weights.shape, dec_inter_attention_weights.shape
PyTorch:
dec_attention_weights_2d = [head[0].tolist()
for step in dec_attention_weight_seq
for attn in step for blk in attn for head in blk]
dec_attention_weights_filled = d2l.tensor(
pd.DataFrame(dec_attention_weights_2d).fillna(0.0).values)
dec_attention_weights = d2l.reshape(dec_attention_weights_filled,
(-1, 2, num_layers, num_heads, num_steps))
dec_self_attention_weights, dec_inter_attention_weights = \
dec_attention_weights.permute(1, 2, 3, 0, 4)
dec_self_attention_weights.shape, dec_inter_attention_weights.shape
TensorFlow:
dec_attention_weights_2d = [head[0] for step in dec_attention_weight_seq
for attn in step
for blk in attn for head in blk]
dec_attention_weights_filled = tf.convert_to_tensor(
np.asarray(pd.DataFrame(dec_attention_weights_2d).fillna(
0.0).values).astype(np.float32))
dec_attention_weights = tf.reshape(dec_attention_weights_filled, shape=(
-1, 2, num_layers, num_heads, num_steps))
dec_self_attention_weights, dec_inter_attention_weights = tf.transpose(
dec_attention_weights, perm=(1, 2, 3, 0, 4))
print(dec_self_attention_weights.shape, dec_inter_attention_weights.shape)
PaddlePaddle:
dec_attention_weights_2d = [head[0].tolist()
for step in dec_attention_weight_seq
for attn in step for blk in attn for head in blk]
dec_attention_weights_filled = paddle.to_tensor(
pd.DataFrame(dec_attention_weights_2d).fillna(0.0).values)
dec_attention_weights = dec_attention_weights_filled.reshape((
-1, 2, num_layers, num_heads, num_steps))
dec_self_attention_weights, dec_inter_attention_weights = \
dec_attention_weights.transpose((1, 2, 3, 0, 4))
dec_self_attention_weights.shape, dec_inter_attention_weights.shape
Из-за авторегрессионного свойства самовнимания декодировщика запросы не вычисляют внимание к парам «ключ — значение» после текущей позиции.
# Добавляем единицу, чтобы включить токен начала последовательности
d2l.show_heatmaps(
dec_self_attention_weights[:, :, :, :len(translation.split()) + 1],
xlabel='Key positions', ylabel='Query positions',
titles=['Head %d' % i for i in range(1, 5)], figsize=(7, 3.5))
Как и в случае с самовниманием кодировщика, указание действительной длины входной последовательности позволяет запросам выходной последовательности не вычислять внимание к позициям входной последовательности с токенами заполнения.
d2l.show_heatmaps(
dec_inter_attention_weights, xlabel='Key positions',
ylabel='Query positions', titles=['Head %d' % i for i in range(1, 5)],
figsize=(7, 3.5))
Хотя архитектура Transformer предложена для обучения «последовательность в последовательность», как будет сказано далее в книге, кодировщик или декодировщик Transformer часто используют отдельно для разных задач глубокого обучения.
Резюме
- Transformer — пример архитектуры «кодировщик — декодировщик», хотя на практике кодировщик или декодировщик может использоваться и отдельно.
- В Transformer многоголовое самовнимание используется для представления входной и выходной последовательностей, однако декодировщик должен сохранять авторегрессионное свойство с помощью маскирования.
- Остаточные соединения и нормализация слоёв в Transformer — важные инструменты для обучения очень глубоких моделей.
- Позиционная полносвязная сеть в Transformer — одна и та же многослойная сеть, которая преобразует представления всех позиций последовательности.
Упражнения
- Как обучение более глубокого Transformer повлияет на скорость обучения и качество перевода?
- Хорошая ли идея заменить в Transformer масштабированное скалярное произведение внимания на аддитивное внимание? Почему?
- Для языковой модели что лучше использовать: кодировщик Transformer, декодировщик или оба? Как это спроектировать?
- Какие проблемы возникают у Transformer при длинных входных последовательностях? Почему?
- Как повысить скорость вычислений и эффективность использования памяти в Transformer? Подсказка: см. (Tay et al., 2020).
- Как спроектировать задачу классификации изображений на основе Transformer без свёрточных сетей? Подсказка: см. Vision Transformer (Dosovitskiy et al., 2021).
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Cheng, J., Dong, L., & Lapata, M. (2016). Long short-term memory-networks for machine reading. In Proceedings of the 2016 Conference on Empirical Methods in Natural Language Processing, 551–561.
- Lin, Z., Feng, M., Santos, C. N. d., Yu, M., Xiang, B., Zhou, B., & Bengio, Y. (2017). A structured self-attentive sentence embedding. arXiv preprint arXiv:1703.03130.
- Paulus, R., Xiong, C., & Socher, R. (2017). A deep reinforced model for abstractive summarization. arXiv preprint arXiv:1705.04304.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 5998–6008.
- Ba, J. L., Kiros, J. R., & Hinton, G. E. (2016). Layer normalization. arXiv preprint arXiv:1607.06450.
- Tay, Y., Dehghani, M., Bahri, D., & Metzler, D. (2020). Efficient transformers: A survey. arXiv preprint arXiv:2009.06732.
- Dosovitskiy, A., Beyer, L., Kolesnikov, A., Weissenborn, D., Zhai, X., Unterthiner, T., Dehghani, M., Minderer, M., Heigold, G., Gelly, S., & others (2021). An image is worth 16x16 words: Transformers for image recognition at scale. International Conference on Learning Representations.
11. Алгоритмы оптимизации
До сих пор в этой книге мы использовали множество алгоритмов оптимизации для обучения моделей глубокого обучения. Они позволяют продолжать обновлять параметры модели и минимизировать значение функции потерь, вычисленное на обучающем наборе. Тот, кто воспринимает оптимизацию как чёрный ящик, который минимизирует целевую функцию в простых условиях, наверняка знает набор таких «заклинаний» — с названиями вроде «SGD» и «Adam».
Однако чтобы делать это лучше, нужны более глубокие знания. Оптимизация очень важна для глубокого обучения. С одной стороны, обучение сложных моделей может занимать часы, дни и даже недели, и производительность алгоритмов оптимизации напрямую влияет на эффективность обучения. С другой стороны, понимание принципов разных алгоритмов и роли их гиперпараметров позволяет целенаправленно подбирать гиперпараметры и повышать качество модели.
В этой главе мы подробно рассмотрим распространённые алгоритмы оптимизации для глубокого обучения. Почти все задачи оптимизации, возникающие в глубоком обучении, невыпуклые. Тем не менее проектировать и анализировать алгоритмы на примере выпуклых задач очень полезно. Поэтому в главе есть введение в выпуклую оптимизацию и доказательство сходимости очень простого алгоритма стохастического градиентного спуска для выпуклых целевых функций.
11.1 Оптимизация и глубокое обучение
В этом разделе мы обсудим связь между оптимизацией и глубоким обучением, а также трудности, с которыми сталкивается использование оптимизации в глубоком обучении. Для задачи глубокого обучения мы обычно сначала определяем функцию потерь. Когда функция потерь задана, мы можем применить алгоритм оптимизации, чтобы минимизировать потери. В оптимизации функцию потерь обычно называют целевой функцией задачи оптимизации. По традиции большинство алгоритмов оптимизации рассматривают задачу минимизации. Если же нужно максимизировать целевую функцию, существует простое решение: поменять знак целевой функции.
11.1.1 Цели оптимизации
Хотя оптимизация даёт способ минимизировать функцию потерь в глубоком обучении, по сути цели оптимизации и глубокого обучения принципиально различаются. Оптимизация в первую очередь занимается минимизацией целевой функции, тогда как глубокое обучение стремится найти подходящую модель при ограниченном объёме данных. В разделе 4.4 мы подробно обсуждали различие между этими целями. Например, ошибка на обучении и ошибка обобщения обычно различаются: поскольку целевая функция алгоритма оптимизации обычно основана на функции потерь на обучающем наборе данных, цель оптимизации — уменьшить ошибку на обучении. Однако цель глубокого обучения (или статистического вывода в более широком смысле) — уменьшить ошибку обобщения. Чтобы достичь второй цели, помимо алгоритмов оптимизации, которые уменьшают ошибку на обучении, нам нужно следить за переобучением.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mpl_toolkits import mplot3d
from mxnet import np, npx
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import numpy as np
from mpl_toolkits import mplot3d
import torch
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import numpy as np
from mpl_toolkits import mplot3d
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import numpy as np
from mpl_toolkits import mplot3d
import paddle
Чтобы показать различие между этими целями, введём два понятия: риск и эмпирический риск. Как сказано в разделе 4.9.3.1, эмпирический риск — это среднее значение потерь на обучающем наборе данных, а риск — ожидаемые потери по всей генеральной совокупности. Ниже мы определяем две функции: функцию риска f и функцию эмпирического риска g. Предположим, что у нас есть только конечный объём обучающих данных. Поэтому g оказывается менее гладкой, чем f.
#@save
def f(x):
return x * d2l.cos(np.pi * x)
def g(x):
return f(x) + 0.2 * d2l.cos(5 * np.pi * x)
На рисунке ниже видно, что минимум эмпирического риска на обучающем наборе может отличаться от минимума риска (ошибки обобщения).
MXNet, PyTorch, TensorFlow:
def annotate(text, xy, xytext): #@save
d2l.plt.gca().annotate(text, xy=xy, xytext=xytext,
arrowprops=dict(arrowstyle='->'))
x = d2l.arange(0.5, 1.5, 0.01)
d2l.set_figsize((4.5, 2.5))
d2l.plot(x, [f(x), g(x)], 'x', 'risk')
annotate('min of\nempirical risk', (1.0, -1.2), (0.5, -1.1))
annotate('min of risk', (1.1, -1.05), (0.95, -0.5))
PaddlePaddle:
def annotate(text, xy, xytext): #@save
d2l.plt.gca().annotate(text, xy=xy, xytext=xytext,
arrowprops=dict(arrowstyle='->'))
x = d2l.arange(0.5, 1.5, 0.01, dtype='float32')
d2l.set_figsize((4.5, 2.5))
d2l.plot(x, [f(x), g(x)], 'x', 'risk')
annotate('min of\nempirical risk', (1.0, -1.2), (0.5, -1.1))
annotate('min of risk', (1.1, -1.05), (0.95, -0.5))
11.1.2 Трудности оптимизации в глубоком обучении
В этой главе мы будем изучать производительность алгоритмов оптимизации в задаче минимизации целевой функции, а не ошибку обобщения модели. В разделе 3.1 мы различали аналитические и численные решения задач оптимизации. В глубоком обучении большинство целевых функций сложны и не имеют аналитического решения. Вместо этого приходится использовать численные алгоритмы оптимизации. Алгоритмы этой главы относятся именно к такому типу.
В оптимизации глубокого обучения есть много трудностей. Самые досадные из них — локальные минимумы, седловые точки и затухание градиента.
11.1.2.1 Локальные минимумы
Для любой целевой функции , если значение в точке меньше, чем значение в любой другой точке в окрестности , то может быть локальным минимумом. Если значение в точке — наименьшее значение целевой функции на всей области определения, то — глобальный минимум.
Например, для функции
можно приближённо найти её локальный и глобальный минимумы.
MXNet, PyTorch, TensorFlow:
x = d2l.arange(-1.0, 2.0, 0.01)
d2l.plot(x, [f(x), ], 'x', 'f(x)')
annotate('local minimum', (-0.3, -0.25), (-0.77, -1.0))
annotate('global minimum', (1.1, -0.95), (0.6, 0.8))
PaddlePaddle:
x = d2l.arange(-1.0, 2.0, 0.01, dtype='float32')
d2l.plot(x, [f(x), ], 'x', 'f(x)')
annotate('local minimum', (-0.3, -0.25), (-0.77, -1.0))
annotate('global minimum', (1.1, -0.95), (0.6, 0.8))
Целевые функции моделей глубокого обучения обычно имеют много локальных оптимумов. Когда численное решение задачи оптимизации находится вблизи локального оптимума, а градиент целевой функции стремится к нулю или становится нулевым, итоговое численное решение может оптимизировать целевую функцию лишь локально, а не глобально. Только определённый уровень шума может вытолкнуть параметры из локального минимума. Фактически это одно из полезных свойств минибатчевого стохастического градиентного спуска: естественные колебания градиента на минибатчах способны вывести параметры из локального минимума.
11.1.2.2 Седловые точки
Помимо локальных минимумов, другой причиной затухания градиента являются седловые точки. Седловая точка (saddle point) — это точка, в которой все градиенты функции обращаются в нуль, но которая не является ни глобальным, ни локальным минимумом. Рассмотрим функцию . Её первая и вторая производные в точке равны нулю. В этой точке оптимизация может остановиться, хотя это не минимум.
MXNet, PyTorch, TensorFlow:
x = d2l.arange(-2.0, 2.0, 0.01)
d2l.plot(x, [x**3], 'x', 'f(x)')
annotate('saddle point', (0, -0.2), (-0.52, -5.0))
PaddlePaddle:
x = d2l.arange(-2.0, 2.0, 0.01, dtype='float32')
d2l.plot(x, [x**3], 'x', 'f(x)')
annotate('saddle point', (0, -0.2), (-0.52, -5.0))
Как показывает следующий пример, седловые точки в пространствах большей размерности ещё более коварны. Рассмотрим функцию . Её седловая точка — . По это максимум, а по — минимум. Кроме того, поверхность напоминает седло, отсюда и название.
MXNet:
x, y = d2l.meshgrid(
d2l.linspace(-1.0, 1.0, 101), d2l.linspace(-1.0, 1.0, 101))
z = x**2 - y**2
ax = d2l.plt.figure().add_subplot(111, projection='3d')
ax.plot_wireframe(x.asnumpy(), y.asnumpy(), z.asnumpy(),
**{'rstride': 10, 'cstride': 10})
ax.plot([0], [0], [0], 'rx')
ticks = [-1, 0, 1]
d2l.plt.xticks(ticks)
d2l.plt.yticks(ticks)
ax.set_zticks(ticks)
d2l.plt.xlabel('x')
d2l.plt.ylabel('y');
PyTorch, TensorFlow, PaddlePaddle:
x, y = d2l.meshgrid(
d2l.linspace(-1.0, 1.0, 101), d2l.linspace(-1.0, 1.0, 101))
z = x**2 - y**2
ax = d2l.plt.figure().add_subplot(111, projection='3d')
ax.plot_wireframe(x, y, z, **{'rstride': 10, 'cstride': 10})
ax.plot([0], [0], [0], 'rx')
ticks = [-1, 0, 1]
d2l.plt.xticks(ticks)
d2l.plt.yticks(ticks)
ax.set_zticks(ticks)
d2l.plt.xlabel('x')
d2l.plt.ylabel('y');
Будем считать, что вход функции — -мерный вектор, а выход — скаляр. Тогда её матрица Гессе (матрица вторых производных) будет иметь собственных значений (см. онлайн-приложение о спектральном разложении). Решение функции может быть локальным минимумом, локальным максимумом или седловой точкой в месте, где градиент функции равен нулю:
- если все собственные значения матрицы Гессе в точке нулевого градиента положительны, то в этой точке функция имеет локальный минимум;
- если все собственные значения матрицы Гессе в точке нулевого градиента отрицательны, то в этой точке функция имеет локальный максимум;
- если в точке нулевого градиента матрица Гессе имеет как положительные, так и отрицательные собственные значения, то это седловая точка функции.
Для задач высокой размерности вероятность того, что хотя бы часть собственных значений отрицательна, довольно велика. Поэтому седловые точки встречаются чаще, чем локальные минимумы. Некоторые исключения из этого правила мы обсудим в следующем разделе, посвящённом выпуклости. Коротко говоря, выпуклая функция — это функция, у которой собственные значения матрицы Гессе никогда не бывают отрицательными. К сожалению, большинство задач глубокого обучения к этому классу не относятся. Тем не менее выпуклость — хороший инструмент для изучения алгоритмов оптимизации.
11.1.2.3 Затухание градиента
Самая коварная проблема — затухание градиента. Вспомним функции активации и их производные, которые мы часто использовали в разделе 4.1.2. Например, предположим, что мы хотим минимизировать функцию , и начинаем из точки . Как видно, градиент близок к нулю. Точнее, , поэтому . Значит, оптимизация будет долго стоять на месте, прежде чем мы продвинемся. Это одна из причин, по которой обучение глубоких моделей было довольно трудным до появления функции активации ReLU.
MXNet, PyTorch, TensorFlow:
x = d2l.arange(-2.0, 5.0, 0.01)
d2l.plot(x, [d2l.tanh(x)], 'x', 'f(x)')
annotate('vanishing gradient', (4, 1), (2, 0.0))
PaddlePaddle:
x = d2l.arange(-2.0, 5.0, 0.01, dtype='float32')
d2l.plot(x, [d2l.tanh(x)], 'x', 'f(x)')
annotate('vanishing gradient', (4, 1), (2, 0.0))
Как видим, оптимизация в глубоком обучении полна трудностей. К счастью, существует набор мощных алгоритмов, которые хорошо работают и просты в использовании даже для начинающих. Кроме того, находить оптимальное решение не обязательно: локальный оптимум или его приближение всё равно очень полезны.
Резюме
- Минимизация ошибки на обучении не гарантирует, что мы найдём наилучший набор параметров для минимизации ошибки обобщения.
- У задачи оптимизации может быть много локальных минимумов.
- У задачи может быть много седловых точек, поскольку задачи, как правило, не выпуклые.
- Затухание градиента может привести к остановке оптимизации; перепараметризация обычно помогает. Удачная инициализация параметров тоже может быть полезной.
Упражнения
- Рассмотрим простой многослойный перцептрон с одним скрытым слоем размерности и одним выходом. Докажите, что для любого локального минимума существует по меньшей мере эквивалентных решений.
- Пусть есть симметричная случайная матрица , элементы которой независимо извлекаются из некоторого распределения . Кроме того, пусть , то есть распределение симметрично (подробности см. в (Wigner, 1958)).
- Докажите, что распределение собственных значений тоже симметрично. То есть для любого собственного вектора соответствующее собственное значение удовлетворяет .
- Почему из этого не следует, что ?
- Какие ещё трудности могут возникнуть при оптимизации в глубоком обучении?
- Представьте, что вы хотите удержать (настоящий) шар на (настоящем) седле.
- Почему это трудно?
- Можно ли использовать этот эффект в алгоритме оптимизации?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
11.2 Выпуклость
Выпуклость (convexity) играет решающую роль в разработке алгоритмов оптимизации, главным образом потому, что в этом случае алгоритмы легче анализировать и проверять. Иными словами, если алгоритм плохо работает в условиях выпуклости, то обычно трудно ожидать хороших результатов в других условиях. Кроме того, хотя задачи оптимизации в глубоком обучении обычно невыпуклые, они часто демонстрируют некоторую выпуклость вблизи локальных минимумов. Это может привести к интересным новым вариантам оптимизации, таким как (Izmailov et al., 2018).
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mpl_toolkits import mplot3d
from mxnet import np, npx
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import numpy as np
from mpl_toolkits import mplot3d
import torch
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import numpy as np
from mpl_toolkits import mplot3d
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import numpy as np
from mpl_toolkits import mplot3d
import paddle
11.2.1 Определения
Прежде чем проводить выпуклый анализ, нужно определить выпуклые множества (convex sets) и выпуклые функции (convex functions).
11.2.1.1 Выпуклые множества
Выпуклое множество (convex set) — основа выпуклости. Проще говоря, множество в векторном пространстве называется выпуклым (convex), если для любых отрезок, соединяющий и , тоже лежит в . В математических обозначениях это означает, что для всех
Это звучит довольно абстрактно, поэтому посмотрим на пример на рис. 11.2.1. В первом наборе есть отрезки, которые не полностью лежат внутри множества, поэтому этот набор невыпуклый, а два других набора такой проблемы не имеют.
Рис. 11.2.1. Первый набор невыпуклый, два других выпуклые
Теперь рассмотрим пересечение (рис. 11.2.2). Пусть и — выпуклые множества. Тогда тоже выпукло. Действительно, возьмём произвольные . Поскольку и выпуклы, отрезок, соединяющий и , содержится и в , и в . Значит, он содержится и в , что и требовалось доказать.
Рис. 11.2.2. Пересечение двух выпуклых множеств выпукло
Легко получить и более общий результат: для выпуклых множеств их пересечение выпукло. Обратное неверно. Рассмотрим два непересекающихся множества и возьмём и . Поскольку , на рис. 11.2.3 отрезок, соединяющий и , обязан содержать часть, которая не принадлежит ни , ни . Значит, отрезок не лежит и в , откуда следует, что объединение выпуклых множеств не обязательно выпукло, то есть невыпукло (nonconvex).
Рис. 11.2.3. Объединение двух выпуклых множеств не обязательно выпукло
Как правило, задачи глубокого обучения определяются на выпуклых множествах. Например, , то есть множество -мерных векторов вещественных чисел, выпукло (ведь отрезок между любыми двумя точками из тоже лежит в ). В некоторых случаях используют переменные с ограниченной длиной, например шар радиуса определяется как .
11.2.1.2 Выпуклые функции
Теперь, когда мы определили выпуклые множества, можно ввести выпуклую функцию (convex function) . Пусть задано выпуклое множество . Функция называется выпуклой, если для всех и всех
Чтобы проиллюстрировать это, построим несколько функций и проверим, какие из них удовлетворяют условию. Ниже мы определяем выпуклые и невыпуклые функции.
MXNet, PyTorch, TensorFlow:
f = lambda x: 0.5 * x**2 # Выпуклая функция
g = lambda x: d2l.cos(np.pi * x) # Невыпуклая функция
h = lambda x: d2l.exp(0.5 * x) # Выпуклая функция
x, segment = d2l.arange(-2, 2, 0.01), d2l.tensor([-1.5, 1])
d2l.use_svg_display()
_, axes = d2l.plt.subplots(1, 3, figsize=(9, 3))
for ax, func in zip(axes, [f, g, h]):
d2l.plot([x, segment], [func(x), func(segment)], axes=ax)
PaddlePaddle:
f = lambda x: 0.5 * x**2 # Выпуклая функция
g = lambda x: d2l.cos(np.pi * x) # Невыпуклая функция
h = lambda x: d2l.exp(0.5 * x) # Выпуклая функция
x, segment = d2l.arange(-2, 2, 0.01, dtype='float32'), d2l.tensor([-1.5, 1])
d2l.use_svg_display()
_, axes = d2l.plt.subplots(1, 3, figsize=(9, 3))
for ax, func in zip(axes, [f, g, h]):
d2l.plot([x, segment], [func(x), func(segment)], axes=ax)
Как и ожидалось, косинус невыпуклый, а парабола и экспонента выпуклые. Обратите внимание, что условие на как выпуклое множество необходимо для того, чтобы выражение было осмысленным. В противном случае результат может оказаться не определён.
11.2.1.3 Неравенство Йенсена
Для выпуклой функции один из самых полезных математических инструментов — неравенство Йенсена (Jensen’s inequality). Оно является обобщением определения выпуклости:
где — неотрицательные вещественные числа с суммой , а — случайная величина. Другими словами, математическое ожидание выпуклой функции не меньше, чем выпуклая функция от математического ожидания, причём вторая часто оказывается более простым выражением. Чтобы доказать первое неравенство, мы многократно применяем определение выпуклости к одному слагаемому суммы.
Частое применение неравенства Йенсена — оценить сложное выражение более простым. Например, его можно применить к логарифмическому правдоподобию частично наблюдаемой случайной величины. А именно, поскольку , получаем
где — типичная ненаблюдаемая случайная величина, — наилучшая догадка о её распределении, а — распределение, полученное интегрированием по . Например, в кластеризации может быть меткой кластера, а — порождающей моделью при использовании меток кластеров.
11.2.2 Свойства
Рассмотрим некоторые интересные свойства выпуклых функций.
11.2.2.1 Локальный минимум является глобальным минимумом
Прежде всего, локальный минимум выпуклой функции является также глобальным минимумом. Докажем это методом от противного.
Предположим, что — локальный минимум. Тогда существует достаточно малое положительное число такое, что для , удовлетворяющих , выполняется .
Допустим теперь, что локальный минимум не является глобальным минимумом : существует , для которого . Тогда найдётся , например , такое что .
Однако по свойству выпуклости
что противоречит тому, что — локальный минимум. Следовательно, не существует , для которого . Итак, локальный минимум является также глобальным минимумом.
Например, у выпуклой функции есть локальный минимум , который является и глобальным минимумом.
f = lambda x: (x - 1) ** 2
d2l.set_figsize()
d2l.plot([x, segment], [f(x), f(segment)], 'x', 'f(x)')
То, что локальный минимум выпуклой функции является и глобальным, удобно. Это означает, что при минимизации функции мы не «застреваем». Однако заметим, что это не означает, что не может быть нескольких глобальных минимумов или что глобальный минимум может не существовать. Например, функция достигает минимума на всём интервале . Напротив, функция на не имеет минимума: при она стремится к , но ни при каком не принимает значения .
11.2.2.2 Множества подуровня выпуклой функции выпуклы
Выпуклые множества удобно определять через множества подуровня (below sets) выпуклой функции. Точнее, для выпуклой функции , определённой на выпуклом множестве , любое её множество подуровня
выпукло.
Докажем это. Для любых нужно показать, что при выполнено . Поскольку и , имеем
11.2.2.3 Выпуклость и вторая производная
Если у функции существует вторая производная, то выпуклость легко проверить. Нужно лишь убедиться, что , то есть для всех выполняется . Например, функция выпукла, поскольку , то есть её производная является единичной матрицей.
Более строго: выпукла тогда и только тогда, когда выпукла любая дважды дифференцируемая одномерная функция . Для любой дважды дифференцируемой многомерной функции она выпукла тогда и только тогда, когда её матрица Гессе .
Сначала докажем одномерный случай. Чтобы показать, что для выпуклой функции , воспользуемся
Поскольку вторая производная задаётся пределом конечной разности, получаем
Чтобы показать, что из следует выпуклость , используем тот факт, что означает, что — монотонно неубывающая функция. Пусть — три точки в , где и . По теореме о среднем существуют и , такие что
Из монотонности , поэтому
Поскольку , получаем
что и доказывает выпуклость.
Во-вторых, для доказательства многомерного случая нам понадобится лемма: функция выпукла тогда и только тогда, когда для всех выпукла функция
Чтобы показать, что выпуклость влечёт выпуклость , достаточно проверить, что для всех (так что )
Чтобы показать обратное, достаточно проверить для всех
Наконец, используя лемму и результат для одномерного случая, докажем многомерный случай: многомерная функция выпукла тогда и только тогда, когда выпукла при , . По одномерному случаю это условие выполнено тогда и только тогда, когда для всех выполнено (). По определению положительно полуопределённой матрицы это эквивалентно .
11.2.3 Ограничения
Удобное свойство выпуклой оптимизации — возможность эффективно работать с ограничениями (constraints). Она позволяет решать оптимизацию с ограничениями (constrained optimization) вида
Здесь — целевая функция, а — функции ограничений. Например, первое ограничение ограничивает параметр единичным шаром. Если же второе ограничение , то оно соответствует всем из полупространства. Одновременное выполнение обоих ограничений эквивалентно выбору в качестве множества ограничений сегмента шара.
11.2.3.1 Функция Лагранжа
Решать задачу оптимизации с ограничениями в общем случае трудно, и один из способов решения возникает из довольно простой физической интуиции. Представьте шар в коробке: шар скатится в самое низкое место, а сила тяжести будет уравновешена силами, с которыми стенки коробки действуют на шар. Коротко говоря, градиент целевой функции (то есть силы тяжести) компенсируется градиентом функции ограничения (из-за «отталкивания» стенки, которое удерживает шар внутри коробки). Заметим, что любое неактивное ограничение (то есть когда шар не касается стенки) не оказывает никакой силы на шар.
Здесь мы кратко выведем функцию Лагранжа ; описанные выше соображения можно выразить через следующую задачу поиска седловой точки:
Переменные () называются множителями Лагранжа (Lagrange multipliers): они обеспечивают корректное выполнение ограничений. Их величину выбирают так, чтобы для всех выполнялось . Например, для любого , при котором , в итоге выбираем . Кроме того, это задача поиска седловой точки (saddle point): мы хотим максимизировать по и одновременно минимизировать его по . Существует большое количество литературы о том, как получить функцию . Нам здесь достаточно знать, что седловая точка является оптимальным решением исходной задачи оптимизации с ограничениями.
11.2.3.2 Штрафы
Один из способов хотя бы приближённо удовлетворить задаче оптимизации с ограничениями — использовать функцию Лагранжа . Помимо выполнения , достаточно добавить к целевой функции . Это гарантирует, что ограничения не будут сильно нарушены.
Мы фактически уже использовали этот приём. Например, в затухании весов (раздел 4.5) к целевой функции добавляется , чтобы не становился слишком большим. Если рассматривать это как задачу с ограничениями, то для некоторого радиуса это гарантирует . Регулируя значение , можно менять размер .
Обычно добавление штрафа — хороший способ обеспечить приближённое выполнение ограничений. На практике это оказывается надёжнее, чем точное выполнение. Кроме того, для невыпуклых задач многие свойства точных методов из выпуклого случая (например, существование оптимального решения) перестают выполняться.
11.2.3.3 Проекции
Ещё одна стратегия выполнения ограничений — проекции (projections). Мы уже встречались с ними, например при отсечении градиентов в разделе 8.5, где длина градиента ограничивалась величиной :
Это и есть проекция на шар радиуса . В общем случае проекция на выпуклое множество определяется как
Это точка множества , ближайшая к .
Рис. 11.2.4. Выпуклые проекции
Определение проекции может показаться абстрактным, поэтому рассмотрим рис. 11.2.4. На нём два выпуклых множества: круг и ромб. Точки внутри каждого множества (жёлтые) при проекции остаются на месте. Точки вне множеств (чёрные) проецируются в ближайшие к исходным точкам точки внутри множеств (красные). Хотя для шара направление сохраняется, в общем случае это не обязательно.
Одно из применений выпуклых проекций — вычисление разреженных весовых векторов. В этом случае вектор весов проецируется на шар , который является обобщением примера с ромбом на рис. 11.2.4.
Резюме
В контексте глубокого обучения главная цель выпуклых функций — помочь нам глубже понять алгоритмы оптимизации. Из них мы выводим, как появляются градиентный спуск и стохастический градиентный спуск.
- Пересечение выпуклых множеств выпукло, а объединение — не обязательно.
- По неравенству Йенсена «полное математическое ожидание многомерной выпуклой функции» не меньше, чем «значение этой функции, вычисленное по математическим ожиданиям переменных».
- Дважды дифференцируемая функция выпукла тогда и только тогда, когда её матрица Гессе (матрица вторых производных) является положительно полуопределённой.
- Выпуклые ограничения можно добавить с помощью функции Лагранжа. На практике достаточно добавить штраф к целевой функции.
- Проекция отображает точку в ближайшую к ней точку выпуклого множества.
Упражнения
- Предположим, мы хотим проверить выпуклость множества, проводя все прямые между точками внутри множества и проверяя, лежат ли эти прямые целиком внутри него. i. Докажите, что достаточно проверить только точки на границе. ii. Докажите, что достаточно проверить только вершины множества.
- Обозначим шар радиуса через -норму и докажите, что выпукло при всех .
- Даны выпуклые функции и . Покажите, что тоже выпукла. Докажите, что невыпукла.
- Докажите, что нормировка softmax выпукла, то есть выпукла функция .
- Докажите, что линейное подпространство — выпуклое множество.
- Докажите, что при линейном подпространстве с проекция на матрицу может быть записана как .
- Докажите, что для выпуклой дважды дифференцируемой функции при можно записать .
- Для выпуклого множества и двух векторов и докажите, что проекция не увеличивает расстояние: .
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Izmailov, P., Podoprikhin, D., Garipov, T., Vetrov, D., & Wilson, A. G. (2018). Averaging weights leads to wider optima and better generalization. arXiv preprint arXiv:1803.05407.
- Wigner, E. P. (1958). On the distribution of the roots of certain symmetric matrices. Annals of Mathematics, 325–327.
11.3 Градиентный спуск
Хотя градиентный спуск (gradient descent) редко применяют в глубоком обучении напрямую, понимание этого метода — ключ к пониманию алгоритма стохастического градиентного спуска из следующего раздела. Например, из-за слишком большой скорости обучения задача оптимизации может расходиться; это явление уже проявляется в градиентном спуске. Аналогично, предобусловливание (preconditioning) — распространённый приём в градиентном спуске, который переносится и на более совершенные алгоритмы. Начнём с простого одномерного случая.
11.3.1 Одномерный градиентный спуск
Почему алгоритм градиентного спуска может оптимизировать целевую функцию? Одномерный градиентный спуск даёт хорошее представление об этом. Рассмотрим класс непрерывно дифференцируемых вещественных функций . С помощью разложения в ряд Тейлора получаем
То есть в первом приближении определяется значением функции и её первой производной в точке . Можно предположить, что при движении в направлении антеградиента на малую величину значение уменьшится. Для простоты выберем фиксированный шаг и положим . Подставив это в разложение Тейлора, получим
Если производная не обращается в нуль, мы можем продолжать разложение, поскольку . Кроме того, мы всегда можем выбрать достаточно малым, чтобы члены более высокого порядка стали пренебрежимо малы. Поэтому
Это означает, что если итеративно обновлять по правилу
то значение функции , скорее всего, будет уменьшаться. Таким образом, в градиентном спуске мы сначала выбираем начальное значение и константу , а затем итеративно обновляем до выполнения условия остановки — например, когда модуль градиента становится достаточно малым или когда число итераций достигает заданного значения.
Покажем, как реализовать градиентный спуск. Для простоты возьмём целевую функцию . Хотя мы знаем, что достигает минимума при , мы всё же используем эту простую функцию, чтобы наблюдать за изменением .
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import numpy as np
import torch
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import numpy as np
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import numpy as np
import paddle
def f(x): # Целевая функция
return x ** 2
def f_grad(x): # Градиент (производная) целевой функции
return 2 * x
Далее возьмём в качестве начального значения и предположим, что . Применив градиентный спуск к на 10 итераций, мы увидим, что значение в конце концов приблизится к оптимальному решению.
MXNet, PyTorch, TensorFlow:
def gd(eta, f_grad):
x = 10.0
results = [x]
for i in range(10):
x -= eta * f_grad(x)
results.append(float(x))
print(f'эпоха 10, x: {x:f}')
return results
results = gd(0.2, f_grad)
PaddlePaddle:
def gd(eta, f_grad):
x = 10.0
results = [x]
for i in range(10):
x -= eta * f_grad(x)
results.append(float(x))
print(f'эпоха 10, x: {float(x):f}')
return results
results = gd(0.2, f_grad)
Процесс оптимизации можно изобразить так.
MXNet, PyTorch, TensorFlow:
def show_trace(results, f):
n = max(abs(min(results)), abs(max(results)))
f_line = d2l.arange(-n, n, 0.01)
d2l.set_figsize()
d2l.plot([f_line, results], [[f(x) for x in f_line], [
f(x) for x in results]], 'x', 'f(x)', fmts=['-', '-o'])
show_trace(results, f)
PaddlePaddle:
def show_trace(results, f):
n = max(abs(min(results)), abs(max(results)))
f_line = d2l.arange(-n, n, 0.01, dtype='float32')
d2l.set_figsize()
d2l.plot([f_line, results], [[f(x) for x in f_line], [
f(x) for x in results]], 'x', 'f(x)', fmts=['-', '-o'])
show_trace(results, f)
11.3.1.1 Скорость обучения
Скорость обучения (learning rate) определяет, сойдётся ли целевая функция к локальному минимуму и когда это произойдёт. Скорость обучения задаёт разработчик алгоритма. Заметим, что если выбрать слишком маленькую скорость обучения, обновления будут очень медленными, и понадобится больше итераций. Например, рассмотрим ход той же задачи оптимизации при . Как видно ниже, даже за 10 шагов мы всё ещё далеки от оптимального решения.
show_trace(gd(0.05, f_grad), f)
Напротив, если выбрать слишком большую скорость обучения, может оказаться слишком большим для линейного приближения первого порядка. То есть член в формуле (11.3.2) может стать существенным. В этом случае итерации по уже не гарантируют уменьшения . Например, при значение перескакивает оптимальное решение и постепенно расходится.
show_trace(gd(1.1, f_grad), f)
11.3.1.2 Локальные минимумы
Чтобы продемонстрировать градиентный спуск для невыпуклой функции, рассмотрим функцию , где — некоторая константа. Эта функция имеет бесконечно много локальных минимумов. В зависимости от выбранной скорости обучения мы в итоге можем получить лишь одно из многих решений. Следующий пример показывает, как (нереалистично) большая скорость обучения приводит к худшему локальному минимуму.
c = d2l.tensor(0.15 * np.pi)
def f(x): # Целевая функция
return x * d2l.cos(c * x)
def f_grad(x): # Градиент целевой функции
return d2l.cos(c * x) - c * x * d2l.sin(c * x)
show_trace(gd(2, f_grad), f)
11.3.2 Многомерный градиентный спуск
Теперь, когда одномерный случай понятен, рассмотрим . То есть целевая функция отображает вектор в скаляр. Соответственно, её градиент тоже многомерный: это вектор из частных производных:
Каждый элемент градиента показывает скорость изменения в точке по входу . Как и в одномерном случае, для многомерных функций можно использовать соответствующее разложение Тейлора. А именно,
Иными словами, с точностью до членов второго порядка по направление наибыстрейшего убывания задаёт антеградиент . Выбрав подходящую скорость обучения , получаем типичный алгоритм градиентного спуска:
Как этот алгоритм работает на практике? Рассмотрим целевую функцию с двумерным вектором на входе и скаляром на выходе. Градиент задаётся формулой . Мы будем наблюдать траекторию при градиентном спуске из начальной точки .
Нам понадобятся две вспомогательные функции: первая — это функция update, которую мы применим к начальному значению 20 раз; вторая — функция, которая отображает траекторию .
MXNet, PyTorch, TensorFlow:
def train_2d(trainer, steps=20, f_grad=None): #@save
"""Оптимизация 2D-целевой функции с помощью пользовательского тренера"""
# s1 и s2 — внутренние переменные состояния, которые будут использованы позже
x1, x2, s1, s2 = -5, -2, 0, 0
results = [(x1, x2)]
for i in range(steps):
if f_grad:
x1, x2, s1, s2 = trainer(x1, x2, s1, s2, f_grad)
else:
x1, x2, s1, s2 = trainer(x1, x2, s1, s2)
results.append((x1, x2))
print(f'эпоха {i + 1}, x1: {float(x1):f}, x2: {float(x2):f}')
return results
MXNet, TensorFlow:
def show_trace_2d(f, results): #@save
"""Отображение траектории 2D-переменных в ходе оптимизации"""
d2l.set_figsize()
d2l.plt.plot(*zip(*results), '-o', color='#ff7f0e')
x1, x2 = d2l.meshgrid(d2l.arange(-5.5, 1.0, 0.1),
d2l.arange(-3.0, 1.0, 0.1))
d2l.plt.contour(x1, x2, f(x1, x2), colors='#1f77b4')
d2l.plt.xlabel('x1')
d2l.plt.ylabel('x2')
PyTorch:
def show_trace_2d(f, results): #@save
"""Отображение траектории 2D-переменных в ходе оптимизации"""
d2l.set_figsize()
d2l.plt.plot(*zip(*results), '-o', color='#ff7f0e')
x1, x2 = d2l.meshgrid(d2l.arange(-5.5, 1.0, 0.1),
d2l.arange(-3.0, 1.0, 0.1), indexing='ij')
d2l.plt.contour(x1, x2, f(x1, x2), colors='#1f77b4')
d2l.plt.xlabel('x1')
d2l.plt.ylabel('x2')
PaddlePaddle:
def train_2d(trainer, steps=20, f_grad=None): #@save
"""Оптимизация 2D-целевой функции с помощью пользовательского тренера"""
# s1 и s2 — внутренние переменные состояния, которые будут использованы позже
x1, x2, s1, s2 = -5, -2, 0, 0
results = [(x1, x2)]
for i in range(steps):
if f_grad:
x1, x2, s1, s2 = trainer(x1, x2, s1, s2, f_grad)
else:
x1, x2, s1, s2 = trainer(x1, x2, s1, s2)
results.append((x1, x2))
print(f'эпоха {i + 1}, x1: {float(x1):f}, x2: {float(x2):f}')
return results
def show_trace_2d(f, results): #@save
"""Отображение траектории 2D-переменных в ходе оптимизации"""
d2l.set_figsize()
d2l.plt.plot(*zip(*results), '-o', color='#ff7f0e')
x1, x2 = d2l.meshgrid(d2l.arange(-5.5, 1.0, 0.1, dtype='float32'),
d2l.arange(-3.0, 1.0, 0.1, dtype='float32'))
d2l.plt.contour(x1, x2, f(x1, x2), colors='#1f77b4')
d2l.plt.xlabel('x1')
d2l.plt.ylabel('x2')
Далее мы наблюдаем траекторию переменной при скорости обучения . Видно, что после 20 шагов значение приближается к минимуму в точке . Прогресс идёт довольно уверенно, но медленно.
def f_2d(x1, x2): # Целевая функция
return x1 ** 2 + 2 * x2 ** 2
def f_2d_grad(x1, x2): # Градиент целевой функции
return (2 * x1, 4 * x2)
def gd_2d(x1, x2, s1, s2, f_grad):
g1, g2 = f_grad(x1, x2)
return (x1 - eta * g1, x2 - eta * g2, 0, 0)
eta = 0.1
show_trace_2d(f_2d, train_2d(gd_2d, f_grad=f_2d_grad))
11.3.3 Адаптивные методы
Как мы видели в разделе 11.3.1.1, выбрать «правильную» скорость обучения непросто. Если её выбрать слишком маленькой, прогресса почти не будет; если слишком большой — решение начнёт колебаться и может даже расходиться. А что, если бы мы могли определять автоматически или вообще не выбирать скорость обучения? Выход может дать метод второго порядка, который учитывает не только значение и градиент целевой функции, но и её кривизну. Хотя из-за вычислительных затрат такие методы напрямую неприменимы в глубоком обучении, они дают полезную интуицию для построения продвинутых алгоритмов оптимизации, которые могут воспроизводить многие желаемые свойства описанных ниже алгоритмов.
11.3.3.1 Метод Ньютона
Вспомним разложение Тейлора для функции . Фактически его можно записать так:
Чтобы не громоздить обозначения, определим как гессиан ; это матрица размера . Для малых и простых задач вычислить легко. Однако для глубоких нейронных сетей может быть очень большой: хранение элементов обходится дорого, а вычисление через обратное распространение может сделать ситуацию ещё хуже. Тем не менее пока отвлечёмся от этих соображений и посмотрим, какой алгоритм из этого получится.
В конце концов, минимум удовлетворяет условию . Следуя правилам математического анализа из раздела 2.4, возьмём производную от по выражению (11.3.4) и отбросим несущественные члены высшего порядка. В результате получаем
То есть в рамках задачи оптимизации нам нужно обратить гессиан .
Для простого примера имеем и . Поэтому для любого получаем . Иными словами, для идеальной сходимости достаточно одного шага без каких-либо настроек. Здесь нам повезло: разложение Тейлора точное, так как .
Рассмотрим другие задачи. Пусть задана выпуклая функция (гиперболический косинус), где — некоторая константа. Видно, что после нескольких итераций мы получаем глобальный минимум в точке .
c = d2l.tensor(0.5)
def f(x): # Целевая функция
return d2l.cosh(c * x)
def f_grad(x): # Градиент целевой функции
return c * d2l.sinh(c * x)
def f_hess(x): # Гессиан целевой функции
return c**2 * d2l.cosh(c * x)
def newton(eta=1):
x = 10.0
results = [x]
for i in range(10):
x -= eta * f_grad(x) / f_hess(x)
results.append(float(x))
print('эпоха 10, x:', x)
return results
show_trace(newton(), f)
Теперь рассмотрим невыпуклую функцию, например , где — некоторая константа. Обратите внимание: в методе Ньютона в конце концов мы делим на гессиан. Это значит, что если вторая производная отрицательна, значение может начать расти. Это фатальный недостаток алгоритма! Посмотрим, что происходит на практике.
c = d2l.tensor(0.15 * np.pi)
def f(x): # Целевая функция
return x * d2l.cos(c * x)
def f_grad(x): # Градиент целевой функции
return d2l.cos(c * x) - c * x * d2l.sin(c * x)
def f_hess(x): # Гессиан целевой функции
return - 2 * c * d2l.sin(c * x) - x * c**2 * d2l.cos(c * x)
show_trace(newton(), f)
Результат получился катастрофическим. Как это исправить? Один из способов — заменить гессиан его абсолютным значением; другая стратегия — снова ввести скорость обучения. Это может показаться противоречащим исходной идее, но это не совсем так: знание второго порядка позволяет быть осторожным там, где кривизна велика, и использовать большую скорость обучения там, где целевая функция более пологая. Посмотрим, как это работает при несколько меньшей скорости обучения, например . Как видим, получился довольно эффективный алгоритм.
show_trace(newton(0.5), f)
11.3.3.2 Анализ сходимости
Здесь мы на примере некоторых выпуклых функций проанализируем скорость сходимости метода Ньютона. Эти функции трижды дифференцируемы, а вторая производная не равна нулю, то есть . Поскольку доказательство для многомерного случая является прямым обобщением доказательства для приведённого ниже одномерного случая и не добавляет понимания задачи, мы опускаем многомерный случай.
Обозначим через значение на -й итерации, а через — расстояние до оптимальности на -й итерации. Разложив в ряд Тейлора, получаем, что условие можно записать в виде
где . Разделив это разложение на , получаем
Вспомним предыдущее уравнение обновления . Подставив его и взяв модули обеих частей, получаем
Следовательно, всякий раз, когда мы находимся в ограниченной области, где , ошибка убывает квадратично:
С другой стороны, специалисты по оптимизации называют сходимость «линейной» при условии , а при этом говорят о «постоянной» скорости сходимости. Заметим, что скорость сходимости в целом оценить нельзя, но как только мы оказываемся вблизи минимума, сходимость становится очень быстрой. Кроме того, такой анализ требует, чтобы хорошо вела себя при высоких порядках производных, то есть чтобы не обладала какими-либо «экстремальными» свойствами в том, как быстро меняется её значение.
11.3.3.3 Предобусловливание
Вычислять и хранить полный гессиан очень дорого, и один из способов смягчить эту проблему — «предобусловливание». Оно позволяет обойтись без вычисления всего гессиана и учитывает только его «диагональные» элементы; алгоритм обновляется по формуле:
Это не так точно, как полный метод Ньютона, но всё же гораздо лучше, чем обходиться без него. Почему предобусловливание работает? Представьте, что одна переменная измеряет высоту в миллиметрах, а другая — в километрах. Если оба естественных масштаба выражены в метрах, наша параметризация сильно рассогласована. К счастью, предобусловливание устраняет это несоответствие. Эффективное предобусловливание градиентного спуска равносильно выбору разной скорости обучения для каждой координаты вектора . Мы увидим в одном из следующих разделов, что предобусловливание стимулировало ряд новшеств в алгоритмах стохастического градиентного спуска.
11.3.3.4 Градиентный спуск и линейный поиск
Одна из ключевых проблем градиентного спуска в том, что можно перескочить цель или продвигаться слишком медленно. Простое решение этой проблемы — комбинировать линейный поиск с градиентным спуском. А именно, мы используем направление, заданное , и затем проводим двоичный поиск, чтобы определить такую скорость обучения , при которой принимает минимальное значение.
С точки зрения анализа и доказательств этот алгоритм сходится быстро (см. Boyd and Vandenberghe, 2004). Однако для глубокого обучения он малопригоден, поскольку каждый шаг линейного поиска требует вычисления целевой функции на всём наборе данных, и такой способ реализации слишком дорог.
Резюме
- Величина скорости обучения важна: слишком большая скорость приводит к расходимости модели, слишком малая — к отсутствию прогресса.
- Градиентный спуск может застрять в локальном минимуме и не найти глобальный минимум.
- В моделях высокой размерности настроить скорость обучения сложно.
- Предобусловливание помогает выравнивать масштабы.
- В выпуклых задачах метод Ньютона, как только начинает работать корректно, сходится гораздо быстрее.
- Для невыпуклых задач не следует применять метод Ньютона без дополнительных настроек.
Упражнения
- Проведите эксперименты с градиентным спуском при разных скоростях обучения и разных целевых функциях.
- Реализуйте линейный поиск на отрезке для минимизации выпуклой функции.
- Нужны ли производные для двоичного поиска, то есть для выбора между и ?
- Насколько быстро сходится алгоритм?
- Реализуйте этот алгоритм и примените его для нахождения минимума .
- Постройте целевую функцию, определённую на , для которой градиентный спуск будет очень медленным. Подсказка: масштабы разных координат должны различаться.
- Реализуйте облегчённую версию метода Ньютона с предобусловливанием.
- Используйте диагональный гессиан в качестве предобусловливателя.
- Используйте его абсолютное значение вместо фактического (возможно, со знаком).
- Примените это к задаче выше.
- Примените описанный алгоритм к нескольким целевым функциям (выпуклым и невыпуклым). Что будет, если повернуть координаты на градусов?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Boyd, S., & Vandenberghe, L. (2004). Convex Optimization. Cambridge University Press.
11.4 Стохастический градиентный спуск
В предыдущих разделах мы использовали стохастический градиентный спуск в процессе обучения, но не объясняли, почему он работает. Чтобы прояснить это, в разделе 11.3 мы описали основные принципы градиентного спуска. В этом разделе подробнее рассмотрим стохастический градиентный спуск (stochastic gradient descent, SGD).
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
import math
from mxnet import np, npx
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import math
import torch
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import math
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import paddle
11.4.1 Обновление по случайному градиенту
В глубоком обучении целевая функция обычно является средним значением функций потерь по каждому примеру обучающего набора данных. Пусть задан обучающий набор из примеров, и — функция потерь для обучающего примера с индексом , где — вектор параметров. Тогда мы получаем целевую функцию
Градиент целевой функции в точке вычисляется как
Если использовать градиентный спуск, то вычислительная стоимость каждой итерации обновления параметров составляет и линейно растёт с ростом . Поэтому при большом обучающем наборе данных каждая итерация градиентного спуска обходится дорого.
Стохастический градиентный спуск (SGD) снижает вычислительную стоимость каждой итерации. На каждой итерации SGD равномерно и случайно выбирает индекс из и вычисляет градиент , чтобы обновить :
где — скорость обучения. Видно, что стоимость каждой итерации снижается с у градиентного спуска до константы . Кроме того, стоит подчеркнуть, что стохастический градиент является несмещённой оценкой полного градиента , поскольку
Это означает, что в среднем стохастический градиент — хорошая оценка градиента.
Теперь сравним его с градиентным спуском, добавив к градиенту случайный шум со средним и дисперсией , чтобы смоделировать стохастический градиентный спуск.
def f(x1, x2): # Целевая функция
return x1 ** 2 + 2 * x2 ** 2
def f_grad(x1, x2): # Градиент целевой функции
return 2 * x1, 4 * x2
MXNet, PyTorch, PaddlePaddle:
def sgd(x1, x2, s1, s2, f_grad):
g1, g2 = f_grad(x1, x2)
# Имитация зашумлённого градиента
g1 += d2l.normal(0.0, 1, (1,)).item()
g2 += d2l.normal(0.0, 1, (1,)).item()
eta_t = eta * lr()
return (x1 - eta_t * g1, x2 - eta_t * g2, 0, 0)
TensorFlow:
def sgd(x1, x2, s1, s2, f_grad):
g1, g2 = f_grad(x1, x2)
# Имитация зашумлённого градиента
g1 += d2l.normal([1], 0.0, 1)
g2 += d2l.normal([1], 0.0, 1)
eta_t = eta * lr()
return (x1 - eta_t * g1, x2 - eta_t * g2, 0, 0)
def constant_lr():
return 1
eta = 0.1
lr = constant_lr # Постоянная скорость обучения
d2l.show_trace_2d(f, d2l.train_2d(sgd, steps=50, f_grad=f_grad))
Как видно, траектория переменных при стохастическом градиентном спуске гораздо более шумная, чем траектория при градиентном спуске, которую мы наблюдали в разделе 11.3. Это следствие случайной природы градиента. Иными словами, даже вблизи минимума мы всё ещё подвержены неопределённости, которую вносит мгновенный градиент . Даже после 50 итераций качество решения остаётся невысоким. Хуже того, с дальнейшими шагами оно не улучшается. Остаётся единственный выход — менять скорость обучения . Но если выбрать её слишком маленькой, то в самом начале мы не добьёмся никакого заметного прогресса; если же выбрать её слишком большой, мы не получим хорошего решения, как показано выше. Единственный способ примирить эти противоречивые цели — динамически уменьшать скорость обучения в процессе оптимизации.
Именно поэтому в функцию шага sgd добавлена функция скорости обучения lr. В приведённом выше примере функция планирования скорости обучения «спит», поскольку мы задали для lr постоянное значение.
11.4.2 Динамическая скорость обучения
Замена на зависящую от времени скорость обучения усложняет управление сходимостью алгоритма оптимизации. В частности, нужно понять, с какой скоростью убывает . Если убывание слишком быстрое, оптимизация остановится преждевременно; если слишком медленное — мы потратим на оптимизацию слишком много времени. Ниже приведены несколько базовых стратегий изменения во времени (более продвинутые стратегии мы обсудим позже):
В первом, кусочно-постоянном (piecewise constant), сценарии мы уменьшаем скорость обучения, например, каждый раз, когда прогресс оптимизации останавливается. Это распространённая стратегия при обучении глубоких сетей. Или же можно уменьшать её агрессивнее с помощью экспоненциального затухания (exponential decay). К сожалению, это часто приводит к преждевременной остановке алгоритма до его сходимости. Популярный выбор — полиномиальное затухание (polynomial decay) с . Для выпуклой оптимизации есть много свидетельств того, что такой темп убывания работает хорошо.
Посмотрим, как выглядит экспоненциальное затухание на практике.
def exponential_lr():
# Глобальная переменная, которая определена вне функции и обновляется внутри неё
global t
t += 1
return math.exp(-0.1 * t)
t = 1
lr = exponential_lr
d2l.show_trace_2d(f, d2l.train_2d(sgd, steps=1000, f_grad=f_grad))
Как и ожидалось, дисперсия параметров значительно уменьшилась. Однако это произошло ценой того, что алгоритм не сошёлся к оптимальному решению . Даже после 1000 итераций мы всё ещё далеки от оптимума. По сути, алгоритм вообще не сходится. С другой стороны, если использовать полиномиальное затухание, при котором скорость обучения убывает обратно пропорционально квадратному корню из числа итераций, то уже после 50 итераций сходимость окажется лучше.
def polynomial_lr():
# Глобальная переменная, которая определена вне функции и обновляется внутри неё
global t
t += 1
return (1 + 0.1 * t) ** (-0.5)
t = 1
lr = polynomial_lr
d2l.show_trace_2d(f, d2l.train_2d(sgd, steps=50, f_grad=f_grad))
Существует и много других вариантов выбора скорости обучения. Например, можно начать с небольшой скорости, затем быстро поднять её, а потом снова уменьшать, хотя это будет происходить медленнее. Можно даже переключаться между маленькими и большими значениями. Однако сейчас мы сосредоточимся на схемах скорости обучения, для которых можно провести полный теоретический анализ, то есть на скорости обучения в выпуклом случае. Для общих невыпуклых задач трудно получить содержательные гарантии сходимости, поскольку в целом минимизация нелинейных невыпуклых задач является NP-трудной. Обзор соответствующих исследований можно найти, например, в превосходных лекционных заметках Тибширани (Tibshirani) за 2015 год.
11.4.3 Анализ сходимости для выпуклых целей
Следующий анализ сходимости стохастического градиентного спуска для выпуклых целевых функций является необязательным и в основном служит для того, чтобы передать больше интуиции об этой задаче. Мы ограничимся одним из самых простых доказательств (Nesterov and Vial, 2000). Существуют заметно более продвинутые методы доказательства, например, для случаев, когда целевая функция ведёт себя особенно хорошо.
Предположим, что для всех целевая функция выпукла по . Более конкретно, рассмотрим обновление стохастического градиентного спуска:
где — целевая функция обучающего примера , который извлекается из некоторого распределения на шаге , а — параметры модели. Обозначим через
ожидаемый риск, а через — минимальный риск для . Наконец, пусть — точка минимума (мы предполагаем, что она лежит в области определения ). В этом случае мы можем отслеживать расстояние между текущими параметрами в момент времени и минимизатором риска , чтобы проверить, улучшается ли оно со временем:
Предположим, что -норма стохастического градиента ограничена некоторой константой , поэтому
Нас больше всего интересует математическое ожидание того, как меняется расстояние между и . На самом деле для любой конкретной последовательности шагов расстояние может увеличиться — это зависит от того, какие нам встретятся. Поэтому нам нужна оценка для скалярного произведения. Поскольку для любой выпуклой функции и любых и выполнено , из выпуклости следует
Подставив неравенства (11.4.2) и (11.4.3) в (11.4.1), мы получим оценку расстояния между параметрами на шаге :
Это означает, что прогресс мы получаем всякий раз, когда разница между текущими потерями и оптимальными потерями превышает . Поскольку эта разница обязательно стремится к нулю, скорость обучения тоже должна стремиться к нулю.
Далее возьмём математическое ожидание от (11.4.4). Получаем
Последний шаг — сложить неравенства по . При суммировании промежуточные члены сокращаются, а затем отбрасываем члены низших порядков, и получаем
Заметим, что поскольку задано, математическое ожидание можно опустить. Наконец, определим
Поскольку
то по неравенству Йенсена (уравнение (11.2.1) при , ) и из выпуклости , которая даёт , мы получаем
Подставив это в (11.4.5), получаем оценку
где — оценка расстояния между начальным выбором параметров и конечным результатом. Коротко говоря, скорость сходимости зависит от того, как ограничена норма стохастического градиента (), и от расстояния между начальным значением параметров и оптимальным решением (). Обратите внимание, что оценка выражена через , а не через , потому что — это сглаженная версия траектории оптимизации. Зная , и , можно выбрать скорость обучения . Тогда верхняя оценка равна . То есть мы сходимся к оптимальному решению со скоростью .
11.4.4 Стохастический градиент и конечные выборки
До сих пор, говоря о стохастическом градиентном спуске, мы действовали несколько поверхностно. Мы предполагали, что примеры (обычно вместе с метками ) выбираются из распределения , и использовали их для обновления параметров модели определённым образом. В частности, для конечного числа примеров мы рассматривали только дискретное распределение , состоящее из функций и , которые позволяют выполнять по нему стохастический градиентный спуск.
Однако на самом деле мы так не поступали. В простом примере этого раздела мы просто добавляли шум к другому, нестохастическому градиенту, то есть делали вид, будто у нас есть пары . Оказывается, для данного случая такой подход оправдан (подробное обсуждение см. в упражнениях). Но во всех предыдущих рассуждениях мы явно так не поступали. Вместо этого мы проходили по всем примерам ровно один раз. Чтобы понять, почему это предпочтительнее, рассмотрим обратную ситуацию: мы с возвращением выбираем наблюдений из дискретного распределения. Вероятность выбрать элемент при каждом выборе равна . Поэтому вероятность выбрать его хотя бы один раз равна
Аналогичные рассуждения показывают, что вероятность выбрать какой-то пример ровно один раз равна
Это приводит к увеличению дисперсии и снижению эффективности использования данных по сравнению с выборкой без возвращения. Поэтому на практике мы используем последнюю (это выбор по умолчанию в этой книге). И последнее замечание: при повторном проходе по обучающему набору данных его обходят в другом случайном порядке.
Резюме
- Для выпуклых задач можно доказать, что при широком выборе скорости обучения стохастический градиентный спуск сходится к оптимальному решению.
- В глубоком обучении это обычно не так. Однако анализ выпуклых задач даёт представление о том, как следует проводить оптимизацию: постепенно уменьшать скорость обучения, но не слишком быстро.
- Проблемы возникают, если скорость обучения слишком мала или слишком велика. На практике подходящую скорость обучения обычно находят только после многочисленных экспериментов.
- Когда в обучающем наборе данных много примеров, каждая итерация градиентного спуска обходится дороже, поэтому в таких случаях предпочтителен стохастический градиентный спуск.
- Гарантии оптимальности стохастического градиентного спуска в невыпуклом случае, как правило, недоступны, поскольку число локальных минимумов, которые нужно проверить, может быть экспоненциальным.
Упражнения
- Поэкспериментируйте с различными графиками скорости обучения для стохастического градиентного спуска и с разным числом итераций. В частности, постройте график зависимости расстояния до оптимального решения от числа итераций.
- Докажите, что для функции добавление к градиенту нормального шума эквивалентно минимизации функции потерь , где извлекается из нормального распределения.
- Сравните сходимость стохастического градиентного спуска при выборке из с возвращением и без возвращения.
- Как изменится решатель стохастического градиентного спуска, если некоторые градиенты (точнее, связанные с ними координаты) всегда больше всех остальных?
- Пусть . Сколько у локальных минимумов? Попробуйте изменить так, чтобы для минимизации потребовалось вычислить все локальные минимумы.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Nesterov, Y., & Vial, J.-P. (2000). Confidence level solutions for stochastic programming. Stochastic Programming E-Print Series.
11.5 Минибатчевый стохастический градиентный спуск
До сих пор в градиентных методах обучения мы встречались с двумя крайними случаями: в разделе 11.3 для вычисления градиента и обновления параметров использовался полный набор данных, а в разделе 11.4 на каждом шаге обрабатывался один обучающий пример. У обоих подходов есть свои недостатки: градиентный спуск не слишком «эффективен по данным», когда данные очень похожи друг на друга. А стохастический градиентный спуск не особенно «эффективен по вычислениям», поскольку процессоры CPU и GPU не могут полностью использовать векторизацию. Это подсказывает, что между ними может существовать компромисс — и это и есть минибатчевый стохастический градиентный спуск (minibatch gradient descent).
11.5.1 Векторизация и кэш
Ключевой аргумент в пользу минибатчей — вычислительная эффективность. Это особенно наглядно видно при параллельных вычислениях на нескольких GPU и нескольких серверах. В этом случае каждому GPU нужно передать хотя бы одно изображение. При 8 GPU на каждом сервере и 16 серверах мы получаем минибатч размером 128.
Когда речь идёт об одном GPU или даже CPU, всё устроено тоньше: у этих устройств есть несколько типов памяти, обычно несколько типов вычислительных блоков и разные ограничения пропускной способности между ними. Например, у CPU есть небольшое число регистров, кэши L1 и L2, а также кэш L3, общий для разных ядер процессора. С ростом объёма кэша растёт и его задержка, а пропускная способность падает. Можно сказать, что процессор способен выполнять гораздо больше операций, чем может обеспечить интерфейс основной памяти.
Во-первых, 2-гигагерцовый CPU с 16 ядрами и векторизацией AVX-512 может обработать до байт в секунду. В то же время производительность GPU легко превышает эту величину в 100 раз. С другой стороны, пропускная способность типичного серверного процессора среднего класса вряд ли превышает 100 Гбит/с, то есть меньше одной десятой того, что требуется для полной загрузки процессора. Более того, не все обращения к памяти одинаково выгодны: интерфейс памяти обычно имеет ширину 64 бита или больше (например, у GPU — до 384 бит). Поэтому чтение одного байта приводит к накладным расходам, поскольку фактически читается более широкий блок.
Во-вторых, первое обращение к памяти сопряжено со значительными накладными расходами, тогда как последовательный доступ (sequential access) или пакетное чтение (burst read) обходится относительно дёшево. Подробнее об этом можно прочитать в статье Википедии об иерархии кэшей.
Смягчить эти ограничения позволяет достаточно быстрая иерархия кэшей процессора, которая снабжает процессор данными. Именно эта идея стоит за пакетной обработкой в глубоком обучении. Простой пример — умножение матриц. Пусть . Существует много способов вычислить . Например, можно попробовать следующие:
- Вычислить , то есть поэлементно через скалярные произведения.
- Вычислить , то есть по одному столбцу за раз. Аналогично можно вычислять по одной строке .
- Просто вычислить .
- Разбить и на блочные матрицы меньшего размера и вычислять по одному блоку за раз.
Если использовать первый вариант, то при каждом вычислении элемента строку и столбец нужно копировать в CPU. Ещё хуже то, что поскольку элементы матрицы выровнены последовательно, при чтении из памяти приходится обращаться ко многим несмежным позициям в обоих векторах. Второй вариант относительно выгоднее: мы можем держать столбец в кэше CPU, пока проходим по . Это вдвое снижает требования к пропускной способности памяти и соответственно ускоряет доступ. Третий вариант на первый взгляд самый предпочтительный, однако большинство матриц, скорее всего, целиком не поместятся в кэш. Четвёртый вариант даёт практически полезное решение: можно переносить в кэш блоки матриц и перемножать их локально. Посмотрим, насколько эффективны эти операции на практике.
Помимо эффективности вычислений, существенные накладные расходы создают сам Python и фреймворк глубокого обучения. Напомним, что каждый раз, когда мы выполняем код, интерпретатор Python отправляет фреймворку глубокого обучения команду, которая должна добавить операцию в вычислительный граф и обработать её при планировании выполнения. Такие накладные расходы могут быть весьма ощутимыми. Итак, лучше всего использовать векторизацию (и матрицы).
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, gluon, init, np, npx
from mxnet.gluon import nn
npx.set_np()
timer = d2l.Timer()
A = np.zeros((256, 256))
B = np.random.normal(0, 1, (256, 256))
C = np.random.normal(0, 1, (256, 256))
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
from torch import nn
import numpy as np
timer = d2l.Timer()
A = torch.zeros(256, 256)
B = torch.randn(256, 256)
C = torch.randn(256, 256)
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
import numpy as np
timer = d2l.Timer()
A = tf.Variable(d2l.zeros((256, 256)))
B = tf.Variable(d2l.normal([256, 256], 0, 1))
C = tf.Variable(d2l.normal([256, 256], 0, 1))
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
import numpy as np
timer = d2l.Timer()
A = d2l.zeros((256, 256))
B = d2l.randn((256, 256))
C = d2l.randn((256, 256))
Поэлементное присваивание требует обойти все строки и столбцы и , чтобы присвоить значение элементу .
MXNet:
# Вычисление A=BC поэлементно
timer.start()
for i in range(256):
for j in range(256):
A[i, j] = np.dot(B[i, :], C[:, j])
A.wait_to_read()
timer.stop()
PyTorch:
# Вычисление A=BC поэлементно
timer.start()
for i in range(256):
for j in range(256):
A[i, j] = torch.dot(B[i, :], C[:, j])
timer.stop()
TensorFlow:
# Вычисление A=BC поэлементно
timer.start()
for i in range(256):
for j in range(256):
A[i, j].assign(tf.tensordot(B[i, :], C[:, j], axes=1))
timer.stop()
PaddlePaddle:
# Вычисление A=BC поэлементно
timer.start()
for i in range(256):
for j in range(256):
A[i, j] = paddle.dot(B[i, :], C[:, j])
timer.stop()
Более быстрая стратегия — вычислять по столбцам.
MXNet:
# Вычисление A=BC по столбцам
timer.start()
for j in range(256):
A[:, j] = np.dot(B, C[:, j])
A.wait_to_read()
timer.stop()
PyTorch:
# Вычисление A=BC по столбцам
timer.start()
for j in range(256):
A[:, j] = torch.mv(B, C[:, j])
timer.stop()
TensorFlow:
timer.start()
for j in range(256):
A[:, j].assign(tf.tensordot(B, C[:, j], axes=1))
timer.stop()
PaddlePaddle:
# Вычисление A=BC по столбцам
timer.start()
for j in range(256):
A[:, j] = paddle.mv(B, C[:, j])
timer.stop()
Наиболее эффективный способ — выполнить всю операцию одним блоком. Посмотрим, с какой скоростью работает каждый из вариантов.
MXNet:
# Вычисление A=BC за один раз
timer.start()
A = np.dot(B, C)
A.wait_to_read()
timer.stop()
# Умножение и сложение как отдельные операции (на практике объединяются)
gigaflops = [2/i for i in timer.times]
print(f'производительность в гигафлопсах: поэлементно {gigaflops[0]:.3f}, '
f'по столбцам {gigaflops[1]:.3f}, полностью {gigaflops[2]:.3f}')
PyTorch:
# Вычисление A=BC за один раз
timer.start()
A = torch.mm(B, C)
timer.stop()
# Умножение и сложение как отдельные операции (на практике объединяются)
gigaflops = [2/i for i in timer.times]
print(f'производительность в гигафлопсах: поэлементно {gigaflops[0]:.3f}, '
f'по столбцам {gigaflops[1]:.3f}, полностью {gigaflops[2]:.3f}')
TensorFlow:
# Вычисление A=BC за один раз
timer.start()
A.assign(tf.tensordot(B, C, axes=1))
timer.stop()
# Умножение и сложение как отдельные операции (на практике объединяются)
gigaflops = [2/i for i in timer.times]
print(f'производительность в гигафлопсах: поэлементно {gigaflops[0]:.3f}, '
f'по столбцам {gigaflops[1]:.3f}, полностью {gigaflops[2]:.3f}')
PaddlePaddle:
# Вычисление A=BC за один раз
timer.start()
A = paddle.mm(B, C)
timer.stop()
# Умножение и сложение как отдельные операции (на практике объединяются)
gigaflops = [2/i for i in timer.times]
print(f'производительность в гигафлопсах: поэлементно {gigaflops[0]:.3f}, '
f'по столбцам {gigaflops[1]:.3f}, полностью {gigaflops[2]:.3f}')
11.5.2 Минибатчи
Ранее мы без раздумий считывали минибатчи данных, а не отдельные наблюдения, чтобы обновлять параметры. Теперь кратко объясним причины. Обработка одного наблюдения требует выполнения множества отдельных умножений матрицы на вектор (или даже вектора на вектор), что довольно затратно и сопряжено с большими накладными расходами со стороны фреймворка. Это справедливо как для вычисления градиентов при обновлении параметров, так и для предсказания с помощью нейронной сети. То есть каждое выполнение обходится дорого, где
Мы можем повысить вычислительную эффективность этой операции, применив её к минибатчу наблюдений. То есть вместо градиента для одного наблюдения мы используем градиент для минибатча:
Посмотрим, как это влияет на статистические свойства . Поскольку и все элементы минибатча выбираются случайно из обучающего набора, математическое ожидание градиента остаётся неизменным. С другой стороны, дисперсия существенно уменьшается. Поскольку градиент минибатча состоит из независимых градиентов, которые усредняются, его стандартное отклонение уменьшается в раз. Это само по себе хорошо, поскольку обновление становится ближе к полному градиенту.
Интуитивно понятно, что выбор большого минибатча обычно оправдан. Однако через некоторое время дополнительное уменьшение стандартного отклонения становится незначительным по сравнению с линейным ростом вычислительных затрат. На практике мы выбираем минибатч достаточно большим, чтобы обеспечить хорошую вычислительную эффективность, но при этом он всё ещё помещался в память GPU. Далее рассмотрим код, реализующий эту идею. Мы выполним то же самое умножение матриц, но теперь разобьём его на «минибатчи» по 64 столбца.
timer.start()
for j in range(0, 256, 64):
A[:, j:j+64] = np.dot(B, C[:, j:j+64])
timer.stop()
print(f'производительность в гигафлопсах: блоками {2 / timer.times[3]:.3f}')
PyTorch:
timer.start()
for j in range(0, 256, 64):
A[:, j:j+64] = torch.mm(B, C[:, j:j+64])
timer.stop()
print(f'производительность в гигафлопсах: блоками {2 / timer.times[3]:.3f}')
TensorFlow:
timer.start()
for j in range(0, 256, 64):
A[:, j:j+64].assign(tf.tensordot(B, C[:, j:j+64], axes=1))
timer.stop()
print(f'производительность в гигафлопсах: блоками {2 / timer.times[3]:.3f}')
PaddlePaddle:
timer.start()
for j in range(0, 256, 64):
A[:, j:j+64] = paddle.mm(B, C[:, j:j+64])
timer.stop()
print(f'производительность в гигафлопсах: блоками {2 / timer.times[3]:.3f}')
Очевидно, что вычисления на минибатчах практически так же эффективны, как и на полной матрице. Стоит отметить, что в разделе 7.5 мы использовали вид регуляризации, который в значительной степени зависит от дисперсии внутри минибатча. По мере её роста дисперсия уменьшается, и вместе с этим исчезает польза от шума, который вносит пакетная нормализация. Подробности о том, как пересчитывать масштаб и вычислять соответствующие величины, см. в работе (Ioffe, 2017).
11.5.3 Чтение набора данных
Посмотрим, как эффективно генерировать минибатчи из данных. Ниже для сравнения алгоритмов оптимизации мы используем набор данных о шуме, который создают различные летательные аппараты и который измерило НАСА на испытательных аэродинамических профилях крыла (airfoil self-noise dataset). Для удобства возьмём только первые примеров. Данные уже предобработаны: мы убрали среднее значение и масштабировали дисперсию так, что для каждой координаты она равна .
MXNet:
#@save
d2l.DATA_HUB['airfoil'] = (d2l.DATA_URL + 'airfoil_self_noise.dat',
'76e5be1548fd8222e5074cf0faae75edff8cf93f')
#@save
def get_data_ch11(batch_size=10, n=1500):
data = np.genfromtxt(d2l.download('airfoil'),
dtype=np.float32, delimiter='\t')
data = (data - data.mean(axis=0)) / data.std(axis=0)
data_iter = d2l.load_array(
(data[:n, :-1], data[:n, -1]), batch_size, is_train=True)
return data_iter, data.shape[1]-1
PyTorch:
#@save
d2l.DATA_HUB['airfoil'] = (d2l.DATA_URL + 'airfoil_self_noise.dat',
'76e5be1548fd8222e5074cf0faae75edff8cf93f')
#@save
def get_data_ch11(batch_size=10, n=1500):
data = np.genfromtxt(d2l.download('airfoil'),
dtype=np.float32, delimiter='\t')
data = torch.from_numpy((data - data.mean(axis=0)) / data.std(axis=0))
data_iter = d2l.load_array((data[:n, :-1], data[:n, -1]),
batch_size, is_train=True)
return data_iter, data.shape[1]-1
TensorFlow:
#@save
d2l.DATA_HUB['airfoil'] = (d2l.DATA_URL + 'airfoil_self_noise.dat',
'76e5be1548fd8222e5074cf0faae75edff8cf93f')
#@save
def get_data_ch11(batch_size=10, n=1500):
data = np.genfromtxt(d2l.download('airfoil'),
dtype=np.float32, delimiter='\t')
data = (data - data.mean(axis=0)) / data.std(axis=0)
data_iter = d2l.load_array((data[:n, :-1], data[:n, -1]),
batch_size, is_train=True)
return data_iter, data.shape[1]-1
PaddlePaddle:
#@save
d2l.DATA_HUB['airfoil'] = (d2l.DATA_URL + 'airfoil_self_noise.dat',
'76e5be1548fd8222e5074cf0faae75edff8cf93f')
#@save
def get_data_ch11(batch_size=10, n=1500):
data = np.genfromtxt(d2l.download('airfoil'),
dtype=np.float32, delimiter='\t')
data = d2l.tensor((data - data.mean(axis=0)) / data.std(axis=0))
data_iter = d2l.load_array((data[:n, :-1], data[:n, -1]),
batch_size, is_train=True)
return data_iter, data.shape[1]-1
11.5.4 Реализация с нуля
Минибатчевый стохастический градиентный спуск уже был реализован в разделе 3.2.
Здесь мы сделаем его входные параметры более общими, главным образом для того, чтобы другие алгоритмы оптимизации, описанные в этой главе, могли использовать те же входы.
А именно, мы добавляем входное состояние states и помещаем гиперпараметры в словарь hyperparams.
Кроме того, мы будем усреднять потери по отдельным минибатчам в функции обучения, поэтому градиенты в алгоритме оптимизации не нужно делить на размер батча.
MXNet:
def sgd(params, states, hyperparams):
for p in params:
p[:] -= hyperparams['lr'] * p.grad
PyTorch:
def sgd(params, states, hyperparams):
for p in params:
p.data.sub_(hyperparams['lr'] * p.grad)
p.grad.data.zero_()
TensorFlow:
def sgd(params, grads, states, hyperparams):
for param, grad in zip(params, grads):
param.assign_sub(hyperparams['lr']*grad)
PaddlePaddle:
def sgd(params, states, hyperparams):
a = []
with paddle.no_grad():
for p in params:
p = p - hyperparams['lr'] * p.grad
p.stop_gradient = False
a.append(p)
return a
Ниже реализуем общую функцию обучения, которую будем использовать для других алгоритмов оптимизации в этой главе. Она инициализирует модель линейной регрессии, а затем позволяет обучать модель с помощью минибатчевого стохастического градиентного спуска и других алгоритмов, которые описаны в последующих подразделах.
MXNet:
#@save
def train_ch11(trainer_fn, states, hyperparams, data_iter,
feature_dim, num_epochs=2):
# Инициализация модели
w = np.random.normal(scale=0.01, size=(feature_dim, 1))
b = np.zeros(1)
w.attach_grad()
b.attach_grad()
net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
# Обучение модели
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[0, num_epochs], ylim=[0.22, 0.35])
n, timer = 0, d2l.Timer()
for _ in range(num_epochs):
for X, y in data_iter:
with autograd.record():
l = loss(net(X), y).mean()
l.backward()
trainer_fn([w, b], states, hyperparams)
n += X.shape[0]
if n % 200 == 0:
timer.stop()
animator.add(n/X.shape[0]/len(data_iter),
(d2l.evaluate_loss(net, data_iter, loss),))
timer.start()
print(f'потери: {animator.Y[0][-1]:.3f}, {timer.avg():.3f} сек/эпоху')
return timer.cumsum(), animator.Y[0]
PyTorch:
#@save
def train_ch11(trainer_fn, states, hyperparams, data_iter,
feature_dim, num_epochs=2):
# Инициализация модели
w = torch.normal(mean=0.0, std=0.01, size=(feature_dim, 1),
requires_grad=True)
b = torch.zeros((1), requires_grad=True)
net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
# Обучение модели
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[0, num_epochs], ylim=[0.22, 0.35])
n, timer = 0, d2l.Timer()
for _ in range(num_epochs):
for X, y in data_iter:
l = loss(net(X), y).mean()
l.backward()
trainer_fn([w, b], states, hyperparams)
n += X.shape[0]
if n % 200 == 0:
timer.stop()
animator.add(n/X.shape[0]/len(data_iter),
(d2l.evaluate_loss(net, data_iter, loss),))
timer.start()
print(f'потери: {animator.Y[0][-1]:.3f}, {timer.avg():.3f} сек/эпоху')
return timer.cumsum(), animator.Y[0]
TensorFlow:
#@save
def train_ch11(trainer_fn, states, hyperparams, data_iter,
feature_dim, num_epochs=2):
# Инициализация модели
w = tf.Variable(tf.random.normal(shape=(feature_dim, 1),
mean=0, stddev=0.01),trainable=True)
b = tf.Variable(tf.zeros(1), trainable=True)
# Обучение модели
net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[0, num_epochs], ylim=[0.22, 0.35])
n, timer = 0, d2l.Timer()
for _ in range(num_epochs):
for X, y in data_iter:
with tf.GradientTape() as g:
l = tf.math.reduce_mean(loss(net(X), y))
dw, db = g.gradient(l, [w, b])
trainer_fn([w, b], [dw, db], states, hyperparams)
n += X.shape[0]
if n % 200 == 0:
timer.stop()
p = n/X.shape[0]
q = p/tf.data.experimental.cardinality(data_iter).numpy()
r = (d2l.evaluate_loss(net, data_iter, loss),)
animator.add(q, r)
timer.start()
print(f'потери: {animator.Y[0][-1]:.3f}, {timer.avg():.3f} сек/эпоху')
return timer.cumsum(), animator.Y[0]
PaddlePaddle:
#@save
def train_ch11(trainer_fn, states, hyperparams, data_iter,
feature_dim, num_epochs=2):
# Инициализация модели
w = d2l.tensor(d2l.normal(mean=0.0, std=0.01, shape=(feature_dim, 1)), stop_gradient=False)
b = d2l.tensor(d2l.zeros((1,)), stop_gradient=False)
net, loss = lambda X: d2l.linreg(X, w, b), d2l.squared_loss
# Обучение модели
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[0, num_epochs], ylim=[0.22, 0.35])
n, timer = 0, d2l.Timer()
for _ in range(num_epochs):
for X, y in data_iter:
l = loss(net(X), y).mean()
l.backward()
w, b = trainer_fn([w, b], states, hyperparams)
n += X.shape[0]
if n % 200 == 0:
timer.stop()
animator.add(n/X.shape[0]/len(data_iter),
(d2l.evaluate_loss(net, data_iter, loss),))
timer.start()
print(f'потери: {animator.Y[0][-1]:.3f}, {timer.avg():.3f} сек/эпоху')
return timer.cumsum(), animator.Y[0]
Посмотрим, как проходит оптимизация пакетным градиентным спуском. Этого можно добиться, установив размер минибатча равным 1500 (то есть общему числу примеров). Тогда параметры модели обновляются один раз за эпоху.
def train_sgd(lr, batch_size, num_epochs=2):
data_iter, feature_dim = get_data_ch11(batch_size)
return train_ch11(
sgd, None, {'lr': lr}, data_iter, feature_dim, num_epochs)
gd_res = train_sgd(1, 1500, 10)
Когда размер минибатча равен 1, оптимизация использует стохастический градиентный спуск. Для упрощения реализации мы выбрали очень маленькую скорость обучения. В эксперименте со стохастическим градиентным спуском параметры модели обновляются каждый раз, когда обработан один пример. В данном случае это соответствует 1500 обновлениям за эпоху. Видно, что снижение значения целевой функции становится довольно пологим уже после одной эпохи. Хотя оба примера обрабатывают 1500 примеров за одну эпоху, стохастическому градиентному спуску требуется больше времени на эпоху. Это объясняется тем, что стохастический градиентный спуск чаще обновляет параметры и обрабатывать отдельные наблюдения менее эффективно.
sgd_res = train_sgd(0.005, 1)
Наконец, при размере минибатча 100 мы используем минибатчевый стохастический градиентный спуск. Время на эпоху здесь меньше, чем у стохастического и пакетного градиентного спуска.
mini1_res = train_sgd(.4, 100)
Если уменьшить размер минибатча до 10, время на эпоху снова вырастет, поскольку каждая порция работы выполняется менее эффективно.
mini2_res = train_sgd(.05, 10)
Теперь сравним время и потери для первых четырёх экспериментов. Видно, что хотя по числу обработанных примеров стохастический градиентный спуск сходится быстрее градиентного спуска, для достижения того же значения потерь ему требуется больше времени, поскольку вычисление градиента по одному примеру не так эффективно. Минибатчевый стохастический градиентный спуск позволяет сбалансировать скорость сходимости и вычислительную эффективность. Минибатч размером 10 эффективнее стохастического градиентного спуска; минибатч размером 100 даже по времени выполнения опережает градиентный спуск.
d2l.set_figsize([6, 3])
d2l.plot(*list(map(list, zip(gd_res, sgd_res, mini1_res, mini2_res))),
'время (сек)', 'потери', xlim=[1e-2, 10],
legend=['градиентный спуск', 'стохастический градиентный спуск',
'размер батча=100', 'размер батча=10'])
d2l.plt.gca().set_xscale('log')
11.5.5 Краткая реализация
Ниже мы используем алгоритмы, встроенные в фреймворк глубокого обучения, чтобы реализовать общую функцию обучения; её мы будем использовать в других подразделах этой главы.
MXNet:
#@save
def train_concise_ch11(tr_name, hyperparams, data_iter, num_epochs=2):
# Инициализация модели
net = nn.Sequential()
net.add(nn.Dense(1))
net.initialize(init.Normal(sigma=0.01))
trainer = gluon.Trainer(net.collect_params(), tr_name, hyperparams)
loss = gluon.loss.L2Loss()
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[0, num_epochs], ylim=[0.22, 0.35])
n, timer = 0, d2l.Timer()
for _ in range(num_epochs):
for X, y in data_iter:
with autograd.record():
l = loss(net(X), y)
l.backward()
trainer.step(X.shape[0])
n += X.shape[0]
if n % 200 == 0:
timer.stop()
animator.add(n/X.shape[0]/len(data_iter),
(d2l.evaluate_loss(net, data_iter, loss),))
timer.start()
print(f'потери: {animator.Y[0][-1]:.3f}, {timer.avg():.3f} сек/эпоху')
PyTorch:
#@save
def train_concise_ch11(trainer_fn, hyperparams, data_iter, num_epochs=4):
# Инициализация модели
net = nn.Sequential(nn.Linear(5, 1))
def init_weights(m):
if type(m) == nn.Linear:
torch.nn.init.normal_(m.weight, std=0.01)
net.apply(init_weights)
optimizer = trainer_fn(net.parameters(), **hyperparams)
loss = nn.MSELoss(reduction='none')
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[0, num_epochs], ylim=[0.22, 0.35])
n, timer = 0, d2l.Timer()
for _ in range(num_epochs):
for X, y in data_iter:
optimizer.zero_grad()
out = net(X)
y = y.reshape(out.shape)
l = loss(out, y)
l.mean().backward()
optimizer.step()
n += X.shape[0]
if n % 200 == 0:
timer.stop()
# MSELoss вычисляет квадратичную ошибку без множителя 1/2
animator.add(n/X.shape[0]/len(data_iter),
(d2l.evaluate_loss(net, data_iter, loss) / 2,))
timer.start()
print(f'потери: {animator.Y[0][-1]:.3f}, {timer.avg():.3f} сек/эпоху')
TensorFlow:
#@save
def train_concise_ch11(trainer_fn, hyperparams, data_iter, num_epochs=2):
# Инициализация модели
net = tf.keras.Sequential()
net.add(tf.keras.layers.Dense(1,
kernel_initializer=tf.random_normal_initializer(stddev=0.01)))
optimizer = trainer_fn(**hyperparams)
loss = tf.keras.losses.MeanSquaredError()
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[0, num_epochs], ylim=[0.22, 0.35])
n, timer = 0, d2l.Timer()
for _ in range(num_epochs):
for X, y in data_iter:
with tf.GradientTape() as g:
out = net(X)
l = loss(y, out)
params = net.trainable_variables
grads = g.gradient(l, params)
optimizer.apply_gradients(zip(grads, params))
n += X.shape[0]
if n % 200 == 0:
timer.stop()
p = n/X.shape[0]
q = p/tf.data.experimental.cardinality(data_iter).numpy()
# MeanSquaredError вычисляет квадратичную ошибку без множителя 1/2
r = (d2l.evaluate_loss(net, data_iter, loss) / 2,)
animator.add(q, r)
timer.start()
print(f'потери: {animator.Y[0][-1]:.3f}, {timer.avg():.3f} сек/эпоху')
PaddlePaddle:
#@save
def train_concise_ch11(trainer_fn, hyperparams, data_iter, num_epochs=4):
# Инициализация модели
net = nn.Sequential(nn.Linear(5, 1))
def init_weights(m):
if type(m) == nn.Linear:
paddle.nn.initializer.Normal(m.weight, std=0.01)
net.apply(init_weights)
optimizer = trainer_fn(parameters=net.parameters(), **hyperparams)
loss = nn.MSELoss(reduction='none')
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[0, num_epochs], ylim=[0.22, 0.35])
n, timer = 0, d2l.Timer()
for _ in range(num_epochs):
for X, y in data_iter:
optimizer.clear_grad()
out = net(X)
y = y.reshape(out.shape)
l = loss(out, y)
l.mean().backward()
optimizer.step()
n += X.shape[0]
if n % 200 == 0:
timer.stop()
# MSELoss вычисляет квадратичную ошибку без множителя 1/2
animator.add(n/X.shape[0]/len(data_iter),
(d2l.evaluate_loss(net, data_iter, loss) / 2,))
timer.start()
print(f'потери: {animator.Y[0][-1]:.3f}, {timer.avg():.3f} сек/эпоху')
Теперь используем эту функцию обучения, чтобы повторить предыдущие эксперименты.
MXNet:
data_iter, _ = get_data_ch11(10)
train_concise_ch11('sgd', {'learning_rate': 0.05}, data_iter)
PyTorch:
data_iter, _ = get_data_ch11(10)
trainer = torch.optim.SGD
train_concise_ch11(trainer, {'lr': 0.01}, data_iter)
TensorFlow:
data_iter, _ = get_data_ch11(10)
trainer = tf.keras.optimizers.SGD
train_concise_ch11(trainer, {'learning_rate': 0.05}, data_iter)
PaddlePaddle:
data_iter, _ = get_data_ch11(10)
trainer = paddle.optimizer.SGD
train_concise_ch11(trainer, {'learning_rate': 0.01}, data_iter)
Резюме
- Векторизация делает код более эффективным благодаря сокращению накладных расходов фреймворка глубокого обучения, лучшему размещению данных в памяти и использованию кэшей CPU и GPU.
- Существует компромисс между «статистической эффективностью» стохастического градиентного спуска и «вычислительной эффективностью» пакетной обработки больших объёмов данных сразу. Минибатчевый стохастический градиентный спуск даёт то и другое: вычислительную и статистическую эффективность.
- В минибатчевом стохастическом градиентном спуске мы обрабатываем батчи, полученные из случайной перестановки обучающих данных (то есть каждое наблюдение обрабатывается один раз, но в случайном порядке).
- Снижение скорости обучения в ходе обучения помогает обучению.
- В целом минибатчевый стохастический градиентный спуск быстрее стохастического и обычного градиентного спуска и менее рискован с точки зрения сходимости.
Упражнения
- Измените размер минибатча и скорость обучения и наблюдайте за скоростью снижения значения целевой функции и временем, затрачиваемым на эпоху.
- Сравните минибатчевый стохастический градиентный спуск с вариантом, который выбирает примеры из обучающего набора с возвращением. Что вы заметите?
- Злой дух скопировал ваш набор данных без вашего ведома (то есть каждое наблюдение встречается дважды, и набор данных вырос до удвоенного исходного размера, но никто вам об этом не сказал). Как изменится поведение стохастического градиентного спуска, минибатчевого стохастического градиентного спуска и градиентного спуска?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Ioffe, S. (2017). Batch renormalization: Towards reducing minibatch dependence in batch-normalized models. Advances in Neural Information Processing Systems, 1945–1953.
11.6 Метод импульса
В разделе 11.4 мы подробно разобрали стохастический градиентный спуск, то есть что происходит при оптимизации, когда доступны только зашумлённые градиенты. Для зашумлённых градиентов мы должны особенно внимательно выбирать скорость обучения. Если она уменьшается слишком быстро, сходимость останавливается. Если же уменьшение слишком медленное, мы можем не сойтись к оптимальному решению.
11.6.1 Основы
В этом разделе рассматриваются более эффективные алгоритмы оптимизации, в первую очередь для некоторых типов задач, которые часто встречаются на практике.
11.6.1.1 Экспоненциально затухающее среднее
В предыдущем разделе мы рассматривали минибатчевый стохастический градиентный спуск как способ ускорить вычисления. У него есть и приятный побочный эффект: усреднение градиентов уменьшает дисперсию. Минибатчевый стохастический градиентный спуск можно вычислить так:
Чтобы сохранить обозначения простыми, здесь мы используем как стохастический градиент для примера при весах , обновлённых на шаге . Было бы хорошо, если бы мы могли воспользоваться эффектом снижения дисперсии даже сверх усреднения градиентов по минибатчу. Один из вариантов решения этой задачи — заменить вычисление градиента экспоненциально затухающим средним (leaky average):
где . Это эффективно заменяет мгновенный градиент усреднённым значением нескольких «прошлых» градиентов. называют импульсом (momentum), он накапливает прошлые градиенты. Чтобы объяснить это подробнее, рекурсивно раскроем :
Большое соответствует длинному среднему, тогда как малое лишь немного корректирует обычный градиентный спуск. Новый градиент больше не указывает направление наибольшего спуска для конкретного примера, а указывает направление взвешенного среднего прошлых градиентов. Это позволяет получить большую часть выгоды от усреднения по батчу, не платя за фактическое вычисление градиента для каждого из них.
Описанные рассуждения лежат в основе «ускоренных» методов градиента, например, градиентного спуска с импульсом. Для задач оптимизации с плохой обусловленностью (например, когда одни направления продвигаются гораздо медленнее других, как в узкой долине) ускоренные методы дают дополнительный выигрыш в эффективности. Кроме того, они позволяют усреднять последующие градиенты, чтобы получить более устойчивое направление спуска. Надо признать, что даже для задач выпуклой оптимизации без шума ускорение — одна из ключевых причин, по которым импульс так хорошо работает.
Как и следовало ожидать, благодаря своей эффективности импульс стал предметом активных исследований в глубоком обучении и последующей оптимизации. Например, см. статью (автор — Goh, 2017), в которой приведён подробный анализ и интерактивные анимации. Импульс был предложен в работе (Polyak, 1964). Nesterov (2018) подробно рассматривает его теорию в контексте выпуклой оптимизации. Давно известно, что импульс полезен и в глубоком обучении. Подробности с примерами см. в обсуждении у (Sutskever et al., 2013).
11.6.1.2 Плохо обусловленные задачи
Чтобы лучше понять геометрию метода импульса, вспомним градиентный спуск, хотя его целевая функция явно менее приятна. Напомним, что в разделе 11.3 мы использовали — умеренно вытянутый эллипсоид. Мы сделаем эту функцию ещё более вытянутой, растянув её вдоль направления :
Как и прежде, имеет минимум в точке . Эта функция очень плоская в направлении . Посмотрим, что происходит при градиентном спуске для этой новой функции.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
eta = 0.4
def f_2d(x1, x2):
return 0.1 * x1 ** 2 + 2 * x2 ** 2
def gd_2d(x1, x2, s1, s2):
return (x1 - eta * 0.2 * x1, x2 - eta * 4 * x2, 0, 0)
d2l.show_trace_2d(f_2d, d2l.train_2d(gd_2d))
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
eta = 0.4
def f_2d(x1, x2):
return 0.1 * x1 ** 2 + 2 * x2 ** 2
def gd_2d(x1, x2, s1, s2):
return (x1 - eta * 0.2 * x1, x2 - eta * 4 * x2, 0, 0)
d2l.show_trace_2d(f_2d, d2l.train_2d(gd_2d))
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
eta = 0.4
def f_2d(x1, x2):
return 0.1 * x1 ** 2 + 2 * x2 ** 2
def gd_2d(x1, x2, s1, s2):
return (x1 - eta * 0.2 * x1, x2 - eta * 4 * x2, 0, 0)
d2l.show_trace_2d(f_2d, d2l.train_2d(gd_2d))
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
eta = 0.4
def f_2d(x1, x2):
return 0.1 * x1 ** 2 + 2 * x2 ** 2
def gd_2d(x1, x2, s1, s2):
return (x1 - eta * 0.2 * x1, x2 - eta * 4 * x2, 0, 0)
d2l.show_trace_2d(f_2d, d2l.train_2d(gd_2d))
По построению градиент в направлении гораздо больше и меняется гораздо быстрее, чем горизонтальный градиент по . Поэтому мы оказываемся в затруднительном положении: если выбрать малую скорость обучения, мы гарантируем, что решение не будет расходиться в направлении , но миримся с медленной сходимостью по . Наоборот, при большой скорости обучения мы быстро продвигаемся по , но расходимся по . Следующий пример показывает, что даже при небольшом увеличении скорости обучения с до поведение меняется. Сходимость по улучшается, но в целом качество решения становится хуже.
eta = 0.6
d2l.show_trace_2d(f_2d, d2l.train_2d(gd_2d))
11.6.1.3 Метод импульса
Метод импульса (momentum) позволяет решить описанную выше проблему градиентного спуска. Глядя на траекторию оптимизации выше, можно предположить, что вычисление усреднённого прошлого градиента должно хорошо работать. В самом деле, в направлении это позволит суммировать хорошо согласованные градиенты и тем самым увеличит расстояние, которое мы проходим на каждом шаге. Напротив, в направлении , где градиент колеблется, усреднённый градиент уменьшит размер шага, поскольку колебания взаимно гасятся. Использование вместо градиента даёт следующие уравнения обновления:
Заметим, что при мы получаем обычный градиентный спуск. Прежде чем углубляться в математические свойства метода, быстро посмотрим, как он работает на практике.
def momentum_2d(x1, x2, v1, v2):
v1 = beta * v1 + 0.2 * x1
v2 = beta * v2 + 4 * x2
return x1 - eta * v1, x2 - eta * v2, v1, v2
eta, beta = 0.6, 0.5
d2l.show_trace_2d(f_2d, d2l.train_2d(momentum_2d))
Как видно, несмотря на ту же скорость обучения, что и раньше, метод импульса хорошо сходится. Посмотрим, что будет, если уменьшить параметр импульса. Если уменьшить его вдвое, до , траектория почти не сходится. Тем не менее это намного лучше, чем расходимость без импульса.
eta, beta = 0.6, 0.25
d2l.show_trace_2d(f_2d, d2l.train_2d(momentum_2d))
Заметим, что метод импульса можно комбинировать со стохастическим градиентным спуском, в частности с минибатчевым стохастическим градиентным спуском. Единственное отличие в том, что в этом случае мы заменяем градиент на . Для удобства инициализируем в момент времени .
11.6.1.4 Эффективные веса выборок
Напомним, что . В предельном случае . Иначе говоря, вместо шага в градиентном спуске или стохастическом градиентном спуске мы используем шаг и одновременно учитываем потенциально лучшее направление спуска. Это сочетает в себе два преимущества. Чтобы показать, как влияют разные значения на веса, посмотрите на график ниже.
d2l.set_figsize()
betas = [0.95, 0.9, 0.6, 0]
for beta in betas:
x = d2l.numpy(d2l.arange(40))
d2l.plt.plot(x, beta ** x, label=f'β = {beta:.2f}')
d2l.plt.xlabel('время')
d2l.plt.legend();
11.6.2 Практические эксперименты
Посмотрим, как метод импульса работает на практике. Для этого нам нужна более масштабируемая реализация.
11.6.2.1 Реализация с нуля
По сравнению с минибатчевым стохастическим градиентным спуском метод импульса требует хранения дополнительного набора вспомогательных переменных — скоростей.
Они имеют ту же форму, что и градиенты и переменные задачи оптимизации.
В приведённой ниже реализации мы называем эти переменные states.
MXNet, PyTorch:
def init_momentum_states(feature_dim):
v_w = d2l.zeros((feature_dim, 1))
v_b = d2l.zeros(1)
return (v_w, v_b)
TensorFlow:
def init_momentum_states(features_dim):
v_w = tf.Variable(d2l.zeros((features_dim, 1)))
v_b = tf.Variable(d2l.zeros(1))
return (v_w, v_b)
PaddlePaddle:
def init_momentum_states(feature_dim):
v_w = d2l.zeros((feature_dim, 1))
v_b = d2l.zeros([1])
return (v_w, v_b)
MXNet:
def sgd_momentum(params, states, hyperparams):
for p, v in zip(params, states):
v[:] = hyperparams['momentum'] * v + p.grad
p[:] -= hyperparams['lr'] * v
PyTorch:
def sgd_momentum(params, states, hyperparams):
for p, v in zip(params, states):
with torch.no_grad():
v[:] = hyperparams['momentum'] * v + p.grad
p[:] -= hyperparams['lr'] * v
p.grad.data.zero_()
TensorFlow:
def sgd_momentum(params, grads, states, hyperparams):
for p, v, g in zip(params, states, grads):
v[:].assign(hyperparams['momentum'] * v + g)
p[:].assign(p - hyperparams['lr'] * v)
PaddlePaddle:
def sgd_momentum(params, states, hyperparams):
a = []
for p, v in zip(params, states):
with paddle.no_grad():
v[:] = hyperparams['momentum'] * v + p.grad
p[:] -= hyperparams['lr'] * v
p.grad.zero_()
a.append(p)
return a
Посмотрим, как это работает на практике.
def train_momentum(lr, momentum, num_epochs=2):
d2l.train_ch11(sgd_momentum, init_momentum_states(feature_dim),
{'lr': lr, 'momentum': momentum}, data_iter,
feature_dim, num_epochs)
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
train_momentum(0.02, 0.5)
Когда мы увеличиваем гиперпараметр импульса momentum до 0.9, эффективное число выборок становится равным .
Чтобы сохранить процесс управляемым, мы немного уменьшаем скорость обучения до .
train_momentum(0.01, 0.9)
Дополнительное снижение скорости обучения помогает справиться с трудностями, которые возникают при негладкой оптимизации. Если установить её равной , сходимость станет хорошей.
train_momentum(0.005, 0.9)
11.6.2.2 Краткая реализация
Поскольку метод импульса уже реализован в оптимизаторах фреймворков глубокого обучения, при подборе тех же параметров мы получаем очень похожую траекторию.
d2l.train_concise_ch11('sgd', {'learning_rate': 0.005, 'momentum': 0.9},
data_iter)
PyTorch:
trainer = torch.optim.SGD
d2l.train_concise_ch11(trainer, {'lr': 0.005, 'momentum': 0.9}, data_iter)
TensorFlow:
trainer = tf.keras.optimizers.SGD
d2l.train_concise_ch11(trainer, {'learning_rate': 0.005, 'momentum': 0.9},
data_iter)
PaddlePaddle:
trainer = paddle.optimizer.Momentum
d2l.train_concise_ch11(trainer, {'learning_rate': 0.005, 'momentum': 0.9}, data_iter)
11.6.3 Теоретический анализ
Пример с 2D-функцией может показаться надуманным. Ниже мы увидим, что он довольно типичен для реальных задач, по крайней мере при минимизации выпуклых квадратичных целевых функций.
11.6.3.1 Выпуклые квадратичные функции
Рассмотрим функцию
Это обычная квадратичная функция. Для положительно определённой матрицы , то есть для матрицы с положительными собственными значениями, минимизатор равен , а минимальное значение — . Поэтому можно переписать в виде
Градиент задаётся формулой . То есть он равен расстоянию между и минимизатором, умноженному на . Поэтому и обновление импульса представляет собой линейную комбинацию членов .
Поскольку положительно определена, её можно разложить как , где — ортогональная (поворотная) матрица, а — диагональная матрица с положительными собственными значениями. Это позволяет перейти от переменной к переменной и получить очень простое выражение:
Здесь . Поскольку — всего лишь ортогональная матрица, она не искажает градиент по существу. Градиентный спуск в координатах принимает вид
Важный факт, который следует из этого выражения, состоит в том, что градиентный спуск не смешивает различные собственные подпространства. То есть если работать в собственной системе , задача оптимизации решается покоординатно. Это справедливо и для метода импульса:
Таким образом, мы доказали следующее: градиентный спуск с импульсом для невыпуклой квадратичной функции можно разложить на покоординатную оптимизацию вдоль собственных векторов квадратичной матрицы.
11.6.3.2 Скалярная функция
С учётом полученного результата рассмотрим, что происходит при минимизации функции . Для градиентного спуска имеем
При эта оптимизация сходится с экспоненциальной скоростью, поскольку после шагов получаем . Это показывает, как сначала растёт скорость сходимости по мере увеличения скорости обучения до значения, при котором . За этим значением градиент начинает расходиться, а при оптимизация расходится.
lambdas = [0.1, 1, 10, 19]
eta = 0.1
d2l.set_figsize((6, 4))
for lam in lambdas:
t = d2l.numpy(d2l.arange(20))
d2l.plt.plot(t, (1 - eta * lam) ** t, label=f'λ = {lam:.2f}')
d2l.plt.xlabel('время')
d2l.plt.legend();
Чтобы проанализировать сходимость метода импульса, сначала перепишем уравнения обновления через два скалярных значения: одно для и одно для импульса . Получаем:
Матрицей обозначим матрицу, которая определяет поведение сходимости. После шагов начальные значения становятся равными . Поэтому скорость сходимости определяется собственными значениями . Прекрасную анимацию можно найти в статье (Goh, 2017). Подробный анализ приведён в работе (Flammarion and Bach, 2015). Вкратце, метод импульса сходится при . Это более широкий диапазон допустимых параметров по сравнению с для градиентного спуска. Кроме того, в целом предпочтительны большие значения .
Резюме
- Метод импульса заменяет градиент средним значением прошлых градиентов, что существенно ускоряет сходимость.
- Метод импульса полезен как для градиентного спуска без шума, так и для стохастического градиентного спуска с шумом.
- Метод импульса может предотвратить застревание оптимизации в процессе стохастического градиентного спуска.
- Из-за экспоненциального затухания весов прошлых данных эффективное число градиентов равно .
- Для выпуклых квадратичных задач метод импульса допускает явный и подробный анализ.
- Реализация метода импульса очень проста, но требует хранения дополнительного вектора состояния (импульса ).
Упражнения
- Поэкспериментируйте с другими комбинациями гиперпараметров импульса и скорости обучения, наблюдайте и анализируйте результаты.
- Попробуйте градиентный спуск и метод импульса на квадратичной задаче с несколькими собственными значениями, то есть , например, при . Постройте график того, как уменьшается при инициализации .
- Найдите минимум и минимизатор функции .
- Что меняется при выполнении стохастического градиентного спуска с импульсом? Что происходит при использовании минибатчевого стохастического градиентного спуска с импульсом? Поэкспериментируйте с параметрами.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Flammarion, N., & Bach, F. (2015). From averaging to acceleration, there is only a step-size. Conference on Learning Theory, 658–695.
- Goh, G. (2017). Why momentum really works. Distill.
- Nesterov, Y. (2018). Lectures on Convex Optimization. Springer.
- Polyak, B. T. (1964). Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics, 4, 1–17.
- Sutskever, I., Martens, J., Dahl, G., & Hinton, G. (2013). On the importance of initialization and momentum in deep learning. International Conference on Machine Learning, 1139–1147.
11.7 Алгоритм AdaGrad
Начнём с вопроса, который редко возникает при обучении признаков.
11.7.1 Разреженные признаки и скорость обучения
Предположим, мы обучаем языковую модель. Чтобы добиться хорошей точности, мы обычно хотим уменьшать скорость обучения по ходу обучения, примерно как или медленнее. Теперь рассмотрим обучение модели на разреженных признаках, то есть признаках, которые встречаются лишь изредка. Это типично для естественного языка. Например, слово «предобусловливание» встречается гораздо реже, чем слово «обучение». Однако такая ситуация характерна и для других областей, например, для компьютерной рекламы и персонализированной совместной фильтрации.
Параметры, связанные с редкими признаками, получают осмысленное обновление только тогда, когда эти признаки встречаются. При уменьшающейся скорости обучения может случиться так, что параметры частых признаков довольно быстро сходятся к оптимальным значениям, а для редких признаков мы всё ещё не накопили достаточно наблюдений, чтобы определить их оптимальные значения. Иными словами, скорость обучения либо снижается слишком медленно для частых признаков, либо слишком быстро для редких.
Один из способов решить эту проблему — подсчитывать, сколько раз мы видели конкретный признак, и использовать это число для корректировки скорости обучения. То есть вместо можно использовать скорость обучения . Здесь — число наблюдений признака до момента . Это очень легко реализовать и не требует дополнительных вычислительных затрат.
Алгоритм AdaGrad (Duchi et al., 2011) решает эту задачу, заменяя грубый счётчик на сумму квадратов градиентов, наблюдавшихся ранее. Скорость обучения корректируется по правилу . Это даёт два преимущества: во-первых, нам больше не нужно решать, когда градиент считается достаточно большим; во-вторых, поправка автоматически зависит от величины градиента. Координаты, которым соответствуют большие градиенты, заметно уменьшаются, а те, у которых градиенты малы, получают более мягкое обращение. На практике это позволило создать очень эффективные оптимизаторы для компьютерной рекламы и смежных задач. Однако такая формулировка скрывает ещё одно важное достоинство AdaGrad, которое легче увидеть в контексте предобусловливания.
11.7.2 Предобусловливание
Задачи выпуклой оптимизации полезны для анализа свойств алгоритмов. В самом деле, для большинства невыпуклых задач получить содержательные теоретические гарантии трудно, но интуиция и понимание часто переносятся на них. Рассмотрим задачу минимизации .
Как и в разделе 11.6, мы можем переписать задачу, используя её разложение по собственным значениям , и получить гораздо более простую задачу, в которой каждую координату можно найти отдельно:
Здесь мы использовали , а значит, и . Оптимум преобразованной задачи равен , а минимальное значение — . Это легче вычислить, поскольку — диагональная матрица с собственными значениями .
Если немного возмутить , мы ожидаем лишь небольших изменений минимизатора . К сожалению, это не так. Хотя малое изменение приводит к такому же малому изменению , минимизатор (а значит, и ) ведёт себя иначе. Всякий раз, когда собственное значение велико, мы видим лишь небольшие изменения и минимального значения . Напротив, для малых изменения могут быть резкими. Отношение наибольшего собственного значения к наименьшему называют числом обусловленности (condition number) задачи оптимизации.
Если число обусловленности велико, точно решить задачу оптимизации трудно. Нужно быть осторожным, когда диапазон собственных значений оказывается очень широким: нельзя ли просто «исправить» проблему, деформировав пространство так, чтобы все собственные значения стали равны ? Теоретически это несложно: достаточно собственных значений и собственных векторов , чтобы привести задачу от к . В новой системе координат сводится к . К сожалению, эта идея малопригодна на практике: вычисление собственных значений и собственных векторов обычно гораздо дороже, чем решение исходной задачи.
Хотя точное вычисление собственных значений может быть дорогим, даже грубая оценка и последующее использование этих значений может быть значительно лучше, чем отсутствие каких-либо действий. В частности, можно взять диагональные элементы и соответствующим образом их перемасштабировать. Это обходится гораздо дешевле вычисления собственных значений.
В этом случае , и, в частности, для всех выполняется . В большинстве случаев это значительно упрощает число обусловленности. Например, в рассмотренном ранее примере это полностью устраняет проблему, поскольку задача выровнена по осям.
К сожалению, есть и другая проблема: в глубоком обучении мы обычно даже не можем вычислить вторые производные целевой функции. Для даже на минибатче для вычисления вторых производных может понадобиться памяти, что делает подход практически невозможным. Остроумная идея AdaGrad состоит в том, чтобы использовать в качестве суррогата диагональ матрицы Гессе (Hessian), которую относительно легко вычислить и которая эффективна.
Чтобы понять, как это работает, посмотрим на . Имеем
где — оптимизатор . Таким образом, величина градиента определяется и разницей с оптимальным значением. Если бы не менялось, этого было бы достаточно. В самом деле, в таком случае величины градиента хватало бы для нахождения решения. Поскольку AdaGrad — это алгоритм стохастического градиентного спуска, мы будем видеть градиенты с ненулевой дисперсией даже в оптимальной точке. Поэтому можно смело использовать дисперсию градиента в качестве дешёвой замены масштабу матрицы Гессе. Подробный анализ (его объяснение заняло бы несколько страниц) выходит за рамки этого раздела; читателю стоит обратиться к работе (Duchi et al., 2011).
11.7.3 Алгоритм
Продолжим рассуждение и перейдём к формальному описанию. Введём переменную , которая накапливает дисперсии прошлых градиентов:
Здесь все операции применяются поэлементно. То есть имеет элементы . Аналогично имеет элементы , а — элементы . Как и раньше, — скорость обучения, а — константа, добавляемая для численной устойчивости, чтобы мы не делили на . Наконец, инициализируем .
Так же, как в методе импульса нам нужна вспомогательная переменная, в алгоритме AdaGrad мы разрешаем каждой координате иметь собственную скорость обучения. По сравнению с SGD это заметно не увеличивает стоимость AdaGrad, поскольку основные вычисления приходятся на и её производные.
Заметим, что накопление квадратов градиентов в означает, что растёт в основном линейно (на самом деле чуть медленнее, поскольку градиенты с самого начала уменьшаются). Это даёт скорость обучения , но настроенную отдельно для каждой координаты. Для выпуклых задач этого вполне достаточно. Однако в глубоком обучении может понадобиться уменьшать скорость обучения медленнее. Это привело к появлению многих вариантов AdaGrad, которые мы рассмотрим в следующих разделах. А пока посмотрим, как алгоритм работает на квадратичной выпуклой задаче. Используем ту же функцию:
Реализуем AdaGrad с той же скоростью обучения, что и раньше, . Видно, что траектория аргумента получается более гладкой. Однако из-за накопления скорость обучения непрерывно уменьшается, поэтому на поздних итерациях аргумент движется на небольшие расстояния.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
import math
from mxnet import np, npx
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import math
import torch
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import math
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import paddle
def adagrad_2d(x1, x2, s1, s2):
eps = 1e-6
g1, g2 = 0.2 * x1, 4 * x2
s1 += g1 ** 2
s2 += g2 ** 2
x1 -= eta / math.sqrt(s1 + eps) * g1
x2 -= eta / math.sqrt(s2 + eps) * g2
return x1, x2, s1, s2
def f_2d(x1, x2):
return 0.1 * x1 ** 2 + 2 * x2 ** 2
eta = 0.4
d2l.show_trace_2d(f_2d, d2l.train_2d(adagrad_2d))
Увеличим скорость обучения до и увидим лучший результат. Это уже показывает, что даже без шума скорость обучения может уменьшаться довольно резко, и нам нужно следить за тем, чтобы параметры сходились должным образом.
eta = 2
d2l.show_trace_2d(f_2d, d2l.train_2d(adagrad_2d))
11.7.4 Реализация с нуля
Как и в методе импульса, AdaGrad требует хранения переменной состояния для каждого параметра, имеющей ту же форму, что и сам параметр.
MXNet:
def init_adagrad_states(feature_dim):
s_w = d2l.zeros((feature_dim, 1))
s_b = d2l.zeros(1)
return (s_w, s_b)
def adagrad(params, states, hyperparams):
eps = 1e-6
for p, s in zip(params, states):
s[:] += np.square(p.grad)
p[:] -= hyperparams['lr'] * p.grad / np.sqrt(s + eps)
PyTorch:
def init_adagrad_states(feature_dim):
s_w = d2l.zeros((feature_dim, 1))
s_b = d2l.zeros(1)
return (s_w, s_b)
def adagrad(params, states, hyperparams):
eps = 1e-6
for p, s in zip(params, states):
with torch.no_grad():
s[:] += torch.square(p.grad)
p[:] -= hyperparams['lr'] * p.grad / torch.sqrt(s + eps)
p.grad.data.zero_()
TensorFlow:
def init_adagrad_states(feature_dim):
s_w = tf.Variable(d2l.zeros((feature_dim, 1)))
s_b = tf.Variable(d2l.zeros(1))
return (s_w, s_b)
def adagrad(params, grads, states, hyperparams):
eps = 1e-6
for p, s, g in zip(params, states, grads):
s[:].assign(s + tf.math.square(g))
p[:].assign(p - hyperparams['lr'] * g / tf.math.sqrt(s + eps))
PaddlePaddle:
def init_adagrad_states(feature_dim):
s_w = d2l.zeros((feature_dim, 1))
s_b = d2l.zeros(shape=(1, ))
return (s_w, s_b)
def adagrad(params, states, hyperparams):
a = []
eps = 1e-6
for p, s in zip(params, states):
with paddle.no_grad():
s[:] += paddle.square(p.grad)
p[:] -= hyperparams['lr'] * p.grad / paddle.sqrt(s + eps)
p.grad.zero_()
a.append(p)
return a
По сравнению с экспериментами из раздела 11.5 здесь мы обучаем модель с большей скоростью обучения.
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(adagrad, init_adagrad_states(feature_dim),
{'lr': 0.1}, data_iter, feature_dim);
11.7.5 Краткая реализация
Мы можем использовать алгоритм AdaGrad, уже реализованный во фреймворке глубокого обучения, для обучения модели.
d2l.train_concise_ch11('adagrad', {'learning_rate': 0.1}, data_iter)
PyTorch:
trainer = torch.optim.Adagrad
d2l.train_concise_ch11(trainer, {'lr': 0.1}, data_iter)
TensorFlow:
trainer = tf.keras.optimizers.Adagrad
d2l.train_concise_ch11(trainer, {'learning_rate' : 0.1}, data_iter)
PaddlePaddle:
trainer = paddle.optimizer.Adagrad
d2l.train_concise_ch11(trainer, {'learning_rate': 0.1}, data_iter)
Резюме
- Алгоритм AdaGrad динамически уменьшает скорость обучения на уровне отдельных координат.
- AdaGrad использует величину градиента как инструмент для регулировки темпа: координаты с большими градиентами компенсируются меньшей скоростью обучения.
- В задачах глубокого обучения из-за ограничений памяти и вычислений точное вычисление вторых производных обычно невозможно. Градиент может служить эффективной заменой.
- Если структура задачи оптимизации существенно неоднородна, AdaGrad может помочь смягчить искажения.
- AdaGrad особенно эффективен для разреженных признаков, когда скорость обучения для редко встречающихся признаков должна уменьшаться медленнее.
- В задачах глубокого обучения AdaGrad иногда слишком сильно снижает скорость обучения. Стратегии борьбы с этим мы обсудим в разделе 11.10.
Упражнения
- Докажите, что для ортогональной матрицы и вектора выполняется равенство . Почему это означает, что после ортогонального преобразования переменных величина возмущения не меняется?
- Попробуйте применить AdaGrad к функции и к той же функции, повёрнутой на 45 градусов, то есть . Будет ли поведение различаться?
- Докажите теорему о кругах Гершгорина, которая утверждает, что собственное значение матрицы удовлетворяет условию хотя бы для одного .
- Что теорема Гершгорина говорит о собственных значениях диагонально предобусловленной матрицы ?
- Попробуйте применить AdaGrad к подходящей глубокой сети, например, к сети из раздела 6.6, которую мы использовали для Fashion-MNIST.
- Как нужно изменить алгоритм AdaGrad, чтобы снижение скорости обучения было менее агрессивным?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Duchi, J., Hazan, E., & Singer, Y. (2011). Adaptive subgradient methods for online learning and stochastic optimization. Journal of Machine Learning Research, 12, 2121–2159.
11.8 Алгоритм RMSProp
Одна из ключевых проблем алгоритма AdaGrad из раздела 11.7 состоит в том, что скорость обучения уменьшается по заранее заданному графику . Хотя так обычно и делают для выпуклых задач, для невыпуклых задач, с которыми мы сталкиваемся в глубоком обучении, такое поведение может быть не идеальным. Однако как предобусловливатель покоординатная адаптивность AdaGrad очень желательна.
Тилеман и Хинтон (Tieleman and Hinton, 2012) предложили алгоритм RMSProp как простое исправление, которое отделяет расписание скорости обучения от покоординатной адаптации скорости обучения. Проблема в том, что AdaGrad суммирует квадраты градиентов в векторе состояния . Поэтому из-за отсутствия нормировки продолжает расти, примерно линейно, и это происходит и тогда, когда алгоритм уже сходится.
Один из способов решить эту проблему — использовать . Для разумных распределений это значение будет сходиться. К сожалению, эффект ограничения может проявиться не скоро, поскольку эта процедура помнит всю траекторию значений. Другой способ — использовать экспоненциально затухающее среднее, как в методе импульса: , где параметр . Если сохранить всё остальное без изменений, получится алгоритм RMSProp.
11.8.1 Алгоритм
Запишем эти уравнения подробно.
Константа обычно выбирается равной , чтобы не допустить деления на ноль или слишком большого шага. С учётом этого расширения мы теперь можем свободно управлять скоростью обучения , не обращая внимания на масштабирование, применяемое к каждой координате. Что касается экспоненциально затухающего среднего, можно использовать те же рассуждения, что и для метода импульса. Раскроем определение :
Как и в разделе 11.6.1.3 о методе импульса, мы используем . Поэтому сумма весов нормирована к , а период полураспада наблюдения равен . Изобразим веса для разных значений за последние 40 шагов по времени.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
import math
from mxnet import np, npx
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
import math
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
import math
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import math
d2l.set_figsize()
gammas = [0.95, 0.9, 0.8, 0.7]
for gamma in gammas:
x = d2l.numpy(d2l.arange(40))
d2l.plt.plot(x, (1-gamma) * gamma ** x, label=f'γ = {gamma:.2f}')
d2l.plt.xlabel('время');
11.8.2 Реализация с нуля
Как и раньше, мы используем квадратичную функцию , чтобы наблюдать за траекторией алгоритма RMSProp. Вспомним, что в разделе 11.7 при использовании AdaGrad с коэффициентом скорости обучения 0.4 переменная на поздних стадиях алгоритма двигалась очень медленно, поскольку скорость обучения быстро убывала. В RMSProp этого не происходит, потому что задаётся отдельно.
def rmsprop_2d(x1, x2, s1, s2):
g1, g2, eps = 0.2 * x1, 4 * x2, 1e-6
s1 = gamma * s1 + (1 - gamma) * g1 ** 2
s2 = gamma * s2 + (1 - gamma) * g2 ** 2
x1 -= eta / math.sqrt(s1 + eps) * g1
x2 -= eta / math.sqrt(s2 + eps) * g2
return x1, x2, s1, s2
def f_2d(x1, x2):
return 0.1 * x1 ** 2 + 2 * x2 ** 2
eta, gamma = 0.4, 0.9
d2l.show_trace_2d(f_2d, d2l.train_2d(rmsprop_2d))
Далее реализуем алгоритм RMSProp для глубокой сети.
MXNet, PyTorch:
def init_rmsprop_states(feature_dim):
s_w = d2l.zeros((feature_dim, 1))
s_b = d2l.zeros(1)
return (s_w, s_b)
PaddlePaddle:
def init_rmsprop_states(feature_dim):
s_w = d2l.zeros((feature_dim, 1))
s_b = d2l.zeros([1])
return (s_w, s_b)
TensorFlow:
def init_rmsprop_states(feature_dim):
s_w = tf.Variable(d2l.zeros((feature_dim, 1)))
s_b = tf.Variable(d2l.zeros(1))
return (s_w, s_b)
MXNet:
def rmsprop(params, states, hyperparams):
gamma, eps = hyperparams['gamma'], 1e-6
for p, s in zip(params, states):
s[:] = gamma * s + (1 - gamma) * np.square(p.grad)
p[:] -= hyperparams['lr'] * p.grad / np.sqrt(s + eps)
PyTorch:
def rmsprop(params, states, hyperparams):
gamma, eps = hyperparams['gamma'], 1e-6
for p, s in zip(params, states):
with torch.no_grad():
s[:] = gamma * s + (1 - gamma) * torch.square(p.grad)
p[:] -= hyperparams['lr'] * p.grad / torch.sqrt(s + eps)
p.grad.data.zero_()
TensorFlow:
def rmsprop(params, grads, states, hyperparams):
gamma, eps = hyperparams['gamma'], 1e-6
for p, s, g in zip(params, states, grads):
s[:].assign(gamma * s + (1 - gamma) * tf.math.square(g))
p[:].assign(p - hyperparams['lr'] * g / tf.math.sqrt(s + eps))
PaddlePaddle:
def rmsprop(params, states, hyperparams):
a = []
gamma, eps = hyperparams['gamma'], 1e-6
for p, s in zip(params, states):
with paddle.no_grad():
s[:] = gamma * s + (1 - gamma) * paddle.square(p.grad)
p[:] -= hyperparams['lr'] * p.grad / paddle.sqrt(s + eps)
p.grad.zero_()
a.append(p)
return a
Начальную скорость обучения установим равной 0.01, а весовой коэффициент — 0.9. То есть накапливает среднее значение последних наблюдений квадратов градиентов.
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(rmsprop, init_rmsprop_states(feature_dim),
{'lr': 0.01, 'gamma': 0.9}, data_iter, feature_dim);
11.8.3 Краткая реализация
Мы можем использовать алгоритм RMSProp, уже реализованный во фреймворке глубокого обучения, для обучения модели.
d2l.train_concise_ch11('rmsprop', {'learning_rate': 0.01, 'gamma1': 0.9},
data_iter)
PyTorch:
trainer = torch.optim.RMSprop
d2l.train_concise_ch11(trainer, {'lr': 0.01, 'alpha': 0.9},
data_iter)
TensorFlow:
trainer = tf.keras.optimizers.RMSprop
d2l.train_concise_ch11(trainer, {'learning_rate': 0.01, 'rho': 0.9},
data_iter)
PaddlePaddle:
trainer = paddle.optimizer.RMSProp
d2l.train_concise_ch11(trainer, {'learning_rate': 0.01, 'rho': 0.9},
data_iter)
Резюме
- Алгоритм RMSProp очень похож на AdaGrad, поскольку оба используют квадраты градиентов для масштабирования коэффициентов.
- RMSProp и метод импульса используют экспоненциально затухающее среднее. Однако RMSProp применяет этот приём, чтобы настроить покоординатный предобусловливатель.
- В экспериментах скорость обучения должна подбираться экспериментатором.
- Коэффициент определяет, насколько долго учитывается история при настройке масштаба для каждой координаты.
Упражнения
- Что произойдёт в эксперименте, если задать ? Почему?
- Поверните задачу оптимизации так, чтобы минимизировать . Что произойдёт со сходимостью?
- Попробуйте применить RMSProp к настоящей задаче машинного обучения, например, к обучению на Fashion-MNIST. Подберите скорость обучения, перебирая разные значения.
- Нужно ли корректировать по ходу оптимизации? Насколько чувствителен RMSProp к этому параметру?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Tieleman, T., & Hinton, G. (2012). Lecture 6.5-RMSProp: Divide the gradient by a running average of its recent magnitude. COURSERA: Neural Networks for Machine Learning, 4, 26–31.
11.9 Adadelta
Adadelta — это ещё один вариант AdaGrad (раздел 11.7). Основное отличие в том, что он уменьшает объём адаптации скорости обучения к координатам. Кроме того, в широком смысле говорят, что у Adadelta нет скорости обучения, поскольку он использует сами величины изменений в качестве калибровки для будущих изменений. Алгоритм Adadelta предложен в работе (Zeiler, 2012).
11.9.1 Алгоритм Adadelta
Коротко говоря, Adadelta использует две переменные состояния: хранит экспоненциально затухающее среднее квадратов градиентов, а хранит экспоненциально затухающее среднее квадратов изменений самих параметров модели. Обратите внимание, что для совместимости с другими публикациями и реализациями мы используем оригинальные обозначения и названия авторов. (Нет иной веской причины, по которой в методе импульса, AdaGrad, RMSProp и Adadelta для одного и того же назначения следовало бы использовать разные греческие буквы.)
Ниже приведены технические детали Adadelta. Обозначив параметр через , получаем следующее обновление с затуханием, аналогичное разделу 11.8:
Отличие от раздела 11.8 состоит в том, что обновление выполняется с помощью перемасштабированного градиента :
Что же представляет собой скорректированный градиент ? Его можно вычислить так:
где — экспоненциально затухающее среднее квадратов перемасштабированных градиентов . Мы инициализируем нулём, а затем на каждом шаге обновляем его с помощью :
а (малая величина, например ) добавляется для численной устойчивости.
11.9.2 Реализация кода
Adadelta требует хранить две переменные состояния для каждой переменной: и . Это приводит к следующей реализации.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
def init_adadelta_states(feature_dim):
s_w, s_b = d2l.zeros((feature_dim, 1)), d2l.zeros(1)
delta_w, delta_b = d2l.zeros((feature_dim, 1)), d2l.zeros(1)
return ((s_w, delta_w), (s_b, delta_b))
def adadelta(params, states, hyperparams):
rho, eps = hyperparams['rho'], 1e-5
for p, (s, delta) in zip(params, states):
# Обновления на месте через [:]
s[:] = rho * s + (1 - rho) * np.square(p.grad)
g = (np.sqrt(delta + eps) / np.sqrt(s + eps)) * p.grad
p[:] -= g
delta[:] = rho * delta + (1 - rho) * g * g
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
def init_adadelta_states(feature_dim):
s_w, s_b = d2l.zeros((feature_dim, 1)), d2l.zeros(1)
delta_w, delta_b = d2l.zeros((feature_dim, 1)), d2l.zeros(1)
return ((s_w, delta_w), (s_b, delta_b))
def adadelta(params, states, hyperparams):
rho, eps = hyperparams['rho'], 1e-5
for p, (s, delta) in zip(params, states):
with torch.no_grad():
# Обновления на месте через [:]
s[:] = rho * s + (1 - rho) * torch.square(p.grad)
g = (torch.sqrt(delta + eps) / torch.sqrt(s + eps)) * p.grad
p[:] -= g
delta[:] = rho * delta + (1 - rho) * g * g
p.grad.data.zero_()
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
def init_adadelta_states(feature_dim):
s_w = tf.Variable(d2l.zeros((feature_dim, 1)))
s_b = tf.Variable(d2l.zeros(1))
delta_w = tf.Variable(d2l.zeros((feature_dim, 1)))
delta_b = tf.Variable(d2l.zeros(1))
return ((s_w, delta_w), (s_b, delta_b))
def adadelta(params, grads, states, hyperparams):
rho, eps = hyperparams['rho'], 1e-5
for p, (s, delta), grad in zip(params, states, grads):
s[:].assign(rho * s + (1 - rho) * tf.math.square(grad))
g = (tf.math.sqrt(delta + eps) / tf.math.sqrt(s + eps)) * grad
p[:].assign(p - g)
delta[:].assign(rho * delta + (1 - rho) * g * g)
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
def init_adadelta_states(feature_dim):
s_w, s_b = d2l.zeros(shape=(feature_dim, 1)), d2l.zeros(shape=(1, ))
delta_w, delta_b = d2l.zeros(shape=(feature_dim, 1)), d2l.zeros(shape=(1, ))
return ((s_w, delta_w), (s_b, delta_b))
def adadelta(params, states, hyperparams):
a = []
rho, eps = hyperparams['rho'], 1e-5
for p, (s, delta) in zip(params, states):
with paddle.no_grad():
# Обновления на месте через [:]
s[:] = rho * s + (1 - rho) * paddle.square(p.grad)
g = (paddle.sqrt(delta + eps) / paddle.sqrt(s + eps)) * p.grad
p[:] -= g
delta[:] = rho * delta + (1 - rho) * g * g
p.grad.zero_()
a.append(p)
return a
Для каждого обновления параметров выбор соответствует 10 периодам полураспада. В результате получаем:
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(adadelta, init_adadelta_states(feature_dim),
{'rho': 0.9}, data_iter, feature_dim);
Для краткой реализации достаточно использовать алгоритм Adadelta из высокоуровневого API.
d2l.train_concise_ch11('adadelta', {'rho': 0.9}, data_iter)
PyTorch:
trainer = torch.optim.Adadelta
d2l.train_concise_ch11(trainer, {'rho': 0.9}, data_iter)
TensorFlow:
# Adadelta не сходится при скорости обучения по умолчанию,
# но сходится при lr=5.0
trainer = tf.keras.optimizers.Adadelta
d2l.train_concise_ch11(trainer, {'learning_rate':5.0, 'rho': 0.9}, data_iter)
PaddlePaddle:
trainer = paddle.optimizer.Adadelta
d2l.train_concise_ch11(trainer, {'rho': 0.9}, data_iter)
Резюме
- У Adadelta нет параметра скорости обучения. Вместо этого он использует скорость изменения самих параметров, чтобы корректировать скорость обучения.
- Adadelta требует двух переменных состояния для хранения второго момента градиента и изменений параметров.
- Adadelta использует экспоненциально затухающие средние, чтобы поддерживать скользящие оценки соответствующих статистик.
Упражнения
- Что произойдёт, если менять значение ?
- Покажите, как реализовать алгоритм без использования . Почему это может быть хорошей идеей?
- Действительно ли у Adadelta скорость обучения равна нулю? Можно ли найти задачу оптимизации, которую Adadelta не может решить?
- Сравните поведение сходимости Adadelta с поведением AdaGrad и RMSProp.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Zeiler, M. D. (2012). ADADELTA: An adaptive learning rate method. arXiv preprint arXiv:1212.5701.
11.10 Алгоритм Adam
В этой главе мы уже изучили множество эффективных методов оптимизации. Прежде чем переходить к новому, вспомним их подробно:
- В разделе 11.4 мы узнали, что стохастический градиентный спуск эффективнее градиентного спуска при решении задач оптимизации.
- В разделе 11.5 мы узнали, что использование большего набора наблюдений в минибатче даёт дополнительную эффективность за счёт векторизации. Это ключ к эффективному параллелизму на нескольких машинах, нескольких GPU и в целом.
- В разделе 11.6 мы добавили механизм, который суммирует историю прошлых градиентов, чтобы ускорить сходимость.
- В разделе 11.7 мы использовали предобусловливатель, который эффективно вычисляется за счёт покоординатного масштабирования.
- В разделе 11.8 мы отделили масштабирование каждой координаты от управления скоростью обучения.
Алгоритм Adam (Kingma and Ba, 2014) объединяет все эти приёмы в один эффективный алгоритм обучения. Неудивительно, что он стал очень популярным: это один из самых мощных и эффективных оптимизаторов, используемых в глубоком обучении. Однако у него есть и проблемы. В частности, Редди и соавторы (Reddi et al., 2019) показали, что Adam иногда может расходиться из-за плохого контроля дисперсии. В качестве доработки Захир и соавторы (Zaheer et al., 2018) предложили «быстрое исправление» для Adam под названием Yogi. Ниже мы рассмотрим алгоритм Adam.
11.10.1 Алгоритм
Одна из ключевых составляющих алгоритма Adam — использование экспоненциально взвешенных скользящих средних для оценки первого момента (импульса) и второго момента градиента. То есть используются переменные состояния
Здесь и — неотрицательные весовые параметры. Обычно их выбирают равными и . То есть оценка дисперсии смещается гораздо медленнее, чем оценка импульса. Заметим, что если инициализировать , возникает заметное начальное смещение. Его можно устранить, воспользовавшись равенством . Соответственно, нормированные переменные состояния получаются по формулам
Теперь, имея корректные оценки, можно записать уравнения обновления. Сначала мы перемасштабируем градиент очень похожим на RMSProp образом:
В отличие от RMSProp, наше обновление использует импульс , а не сам градиент. Кроме того, из-за масштабирования с помощью , а не , результаты немного различаются. На практике первый вариант работает чуть лучше, поэтому он и отличает алгоритм от RMSProp. Обычно мы выбираем , что обеспечивает хороший баланс между численной устойчивостью и точностью.
Наконец, выполняем простое обновление:
Если взглянуть на алгоритм Adam, его замысел становится очевидным. Во-первых, импульс и масштаб явно выражены в переменных состояния. Их довольно своеобразное определение позволяет убрать смещение (это можно исправить с помощью немного другой инициализации и условий обновления). Во-вторых, комбинация двух слагаемых из RMSProp очень проста. Наконец, явная скорость обучения позволяет управлять размером шага для решения проблем сходимости.
11.10.2 Реализация
Реализовать алгоритм Adam с нуля нетрудно.
Для удобства мы храним номер временного шага в словаре hyperparams.
Во всём остальном всё просто.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
def init_adam_states(feature_dim):
v_w, v_b = d2l.zeros((feature_dim, 1)), d2l.zeros(1)
s_w, s_b = d2l.zeros((feature_dim, 1)), d2l.zeros(1)
return ((v_w, s_w), (v_b, s_b))
def adam(params, states, hyperparams):
beta1, beta2, eps = 0.9, 0.999, 1e-6
for p, (v, s) in zip(params, states):
v[:] = beta1 * v + (1 - beta1) * p.grad
s[:] = beta2 * s + (1 - beta2) * np.square(p.grad)
v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
p[:] -= hyperparams['lr'] * v_bias_corr / (np.sqrt(s_bias_corr) + eps)
hyperparams['t'] += 1
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
def init_adam_states(feature_dim):
v_w, v_b = d2l.zeros((feature_dim, 1)), d2l.zeros(1)
s_w, s_b = d2l.zeros((feature_dim, 1)), d2l.zeros(1)
return ((v_w, s_w), (v_b, s_b))
def adam(params, states, hyperparams):
beta1, beta2, eps = 0.9, 0.999, 1e-6
for p, (v, s) in zip(params, states):
with torch.no_grad():
v[:] = beta1 * v + (1 - beta1) * p.grad
s[:] = beta2 * s + (1 - beta2) * torch.square(p.grad)
v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
p[:] -= hyperparams['lr'] * v_bias_corr / (torch.sqrt(s_bias_corr)
+ eps)
p.grad.data.zero_()
hyperparams['t'] += 1
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
def init_adam_states(feature_dim):
v_w = tf.Variable(d2l.zeros((feature_dim, 1)))
v_b = tf.Variable(d2l.zeros(1))
s_w = tf.Variable(d2l.zeros((feature_dim, 1)))
s_b = tf.Variable(d2l.zeros(1))
return ((v_w, s_w), (v_b, s_b))
def adam(params, grads, states, hyperparams):
beta1, beta2, eps = 0.9, 0.999, 1e-6
for p, (v, s), grad in zip(params, states, grads):
v[:].assign(beta1 * v + (1 - beta1) * grad)
s[:].assign(beta2 * s + (1 - beta2) * tf.math.square(grad))
v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
p[:].assign(p - hyperparams['lr'] * v_bias_corr
/ tf.math.sqrt(s_bias_corr) + eps)
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
def init_adam_states(feature_dim):
v_w, v_b = d2l.zeros((feature_dim, 1)), d2l.zeros((1, ))
s_w, s_b = d2l.zeros((feature_dim, 1)), d2l.zeros((1, ))
return ((v_w, s_w), (v_b, s_b))
def adam(params, states, hyperparams):
beta1, beta2, eps = 0.9, 0.999, 1e-6
a = []
for p, (v, s) in zip(params, states):
with paddle.no_grad():
v[:] = beta1 * v + (1 - beta1) * p.grad
s[:] = beta2 * s + (1 - beta2) * paddle.square(p.grad)
v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
p[:] -= hyperparams['lr'] * v_bias_corr / (paddle.sqrt(s_bias_corr)
+ eps)
p.grad.zero_()
a.append(p)
hyperparams['t'] += 1
return a
Теперь обучим модель с помощью описанного алгоритма Adam, используя скорость обучения .
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(adam, init_adam_states(feature_dim),
{'lr': 0.01, 't': 1}, data_iter, feature_dim);
Кроме того, Adam можно использовать из фреймворка глубокого обучения: достаточно передать параметры конфигурации.
MXNet:
d2l.train_concise_ch11('adam', {'learning_rate': 0.01}, data_iter)
PyTorch:
trainer = torch.optim.Adam
d2l.train_concise_ch11(trainer, {'lr': 0.01}, data_iter)
TensorFlow:
trainer = tf.keras.optimizers.Adam
d2l.train_concise_ch11(trainer, {'learning_rate': 0.01}, data_iter)
PaddlePaddle:
trainer = paddle.optimizer.Adam
d2l.train_concise_ch11(trainer, {'learning_rate': 0.01}, data_iter)
11.10.3 Yogi
У Adam есть и свои проблемы: даже в выпуклой постановке он может не сходиться, когда оценка второго момента «взрывается». Захир и соавторы (Zaheer et al., 2018) предложили улучшенное обновление и инициализацию для . В статье предлагается переписать обновление Adam следующим образом:
Всякий раз, когда принимает большие значения или обновления очень разрежены, может слишком быстро «забыть» прошлые значения. Эффективное решение — заменить на . Это и есть обновление Yogi: величина шага теперь не зависит от размера отклонения.
В статье авторы также предлагают инициализировать импульс не поточечной оценкой, а большим начальным минибатчем.
MXNet:
def yogi(params, states, hyperparams):
beta1, beta2, eps = 0.9, 0.999, 1e-3
for p, (v, s) in zip(params, states):
v[:] = beta1 * v + (1 - beta1) * p.grad
s[:] = s + (1 - beta2) * np.sign(
np.square(p.grad) - s) * np.square(p.grad)
v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
p[:] -= hyperparams['lr'] * v_bias_corr / (np.sqrt(s_bias_corr) + eps)
hyperparams['t'] += 1
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(yogi, init_adam_states(feature_dim),
{'lr': 0.01, 't': 1}, data_iter, feature_dim);
PyTorch:
def yogi(params, states, hyperparams):
beta1, beta2, eps = 0.9, 0.999, 1e-3
for p, (v, s) in zip(params, states):
with torch.no_grad():
v[:] = beta1 * v + (1 - beta1) * p.grad
s[:] = s + (1 - beta2) * torch.sign(
torch.square(p.grad) - s) * torch.square(p.grad)
v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
p[:] -= hyperparams['lr'] * v_bias_corr / (torch.sqrt(s_bias_corr)
+ eps)
p.grad.data.zero_()
hyperparams['t'] += 1
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(yogi, init_adam_states(feature_dim),
{'lr': 0.01, 't': 1}, data_iter, feature_dim);
TensorFlow:
def yogi(params, grads, states, hyperparams):
beta1, beta2, eps = 0.9, 0.999, 1e-6
for p, (v, s), grad in zip(params, states, grads):
v[:].assign(beta1 * v + (1 - beta1) * grad)
s[:].assign(s + (1 - beta2) * tf.math.sign(
tf.math.square(grad) - s) * tf.math.square(grad))
v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
p[:].assign(p - hyperparams['lr'] * v_bias_corr
/ tf.math.sqrt(s_bias_corr) + eps)
hyperparams['t'] += 1
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(yogi, init_adam_states(feature_dim),
{'lr': 0.01, 't': 1}, data_iter, feature_dim);
PaddlePaddle:
def yogi(params, states, hyperparams):
beta1, beta2, eps = 0.9, 0.999, 1e-3
a=[]
for p, (v, s) in zip(params, states):
with paddle.no_grad():
v[:] = beta1 * v + (1 - beta1) * p.grad
s[:] = s + (1 - beta2) * paddle.sign(
paddle.square(p.grad) - s) * paddle.square(p.grad)
v_bias_corr = v / (1 - beta1 ** hyperparams['t'])
s_bias_corr = s / (1 - beta2 ** hyperparams['t'])
p[:] -= hyperparams['lr'] * v_bias_corr / (paddle.sqrt(s_bias_corr)
+ eps)
p.grad.zero_()
a.append(p)
hyperparams['t'] += 1
return a
data_iter, feature_dim = d2l.get_data_ch11(batch_size=10)
d2l.train_ch11(yogi, init_adam_states(feature_dim),
{'lr': 0.01, 't': 1}, data_iter, feature_dim);
Резюме
- Adam объединяет множество приёмов оптимизации в довольно мощное правило обновления.
- Adam создан на основе RMSProp и дополнительно использует экспоненциально взвешенные скользящие средние (EWMA) для минибатчевых стохастических градиентов.
- При оценке импульса и второго момента Adam использует коррекцию смещения, чтобы компенсировать медленный старт.
- Для градиентов с заметно различающейся дисперсией могут возникать проблемы со сходимостью. Их можно смягчить, используя больший минибатч или переключившись на улучшенную оценку . Альтернативу предлагает Yogi.
Упражнения
- Подберите скорость обучения и понаблюдайте и проанализируйте результаты экспериментов.
- Попробуйте переписать обновления импульса и второго момента так, чтобы коррекция смещения не требовалась.
- Почему при сходимости нужно уменьшать скорость обучения ?
- Постройте пример, в котором Adam расходится, а Yogi сходится.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Kingma, D. P., & Ba, J. (2014). Adam: A method for stochastic optimization. arXiv preprint arXiv:1412.6980.
- Reddi, S. J., Kale, S., & Kumar, S. (2019). On the convergence of Adam and beyond. arXiv preprint arXiv:1904.09237.
- Zaheer, M., Reddi, S., Sachan, D., Kale, S., & Kumar, S. (2018). Adaptive methods for nonconvex optimization. Advances in Neural Information Processing Systems, 9793–9803.
11.11 Планировщики скорости обучения
До сих пор мы в основном рассматривали алгоритмы оптимизации, которые определяют, как обновлять весовой вектор, но не то, с какой скоростью это делать. Однако настройка скорости обучения часто не менее важна, чем сам алгоритм. Нужно учитывать следующие аспекты:
- Во-первых, важна величина скорости обучения. Если она слишком велика, оптимизация расходится; если слишком мала, обучение занимает слишком много времени или мы в итоге получаем лишь субоптимальный результат. Ранее мы видели, что число обусловленности задачи важно (подробности см. в разделе 11.6). Интуитивно это отношение наименьшего изменения к наибольшему по чувствительности направлениям.
- Во-вторых, важна и скорость убывания. Если скорость обучения остаётся слишком высокой, мы можем в конце концов «прыгать» вокруг минимума и не достигнуть оптимального решения. Этот вопрос подробно обсуждается в разделе 11.5, а в разделе 11.4 мы анализировали гарантии производительности. Коротко говоря, мы хотим, чтобы скорость убывала медленнее, чем ; это хороший выбор для выпуклых задач.
- Ещё один не менее важный аспект — инициализация. Это касается как первоначальной установки параметров (подробности см. в разделе 4.8), так и того, как они меняются в начале. Это шутливо называют разогревом (warmup): насколько быстро мы начинаем двигаться к решению. Большие шаги в начале могут быть бесполезны, особенно потому, что начальный набор параметров случаен. Направление первых обновлений тоже может быть бессмысленным.
- Наконец, существует множество вариантов оптимизации, которые выполняют периодическую корректировку скорости обучения. Это выходит за рамки этой главы; за подробностями мы рекомендуем обратиться к работе (Izmailov et al., 2018). Например, там показано, как получить лучшее решение, усредняя параметры по всему пути оптимизации.
Поскольку управление скоростью обучения требует много деталей, большинство фреймворков глубокого обучения имеют инструменты для автоматического решения этой задачи. В этой главе мы рассмотрим, как разные стратегии расписания влияют на точность, и покажем, как эффективно управлять ими с помощью планировщика скорости обучения (learning rate scheduler).
11.11.1 Простой пример
Начнём с простой задачи, которую легко посчитать, но которая достаточно хорошо иллюстрирует суть.
Возьмём несколько модернизированную версию LeNet (функция активации relu вместо sigmoid, а вместо average pooling — max pooling) и применим её к набору данных Fashion-MNIST.
Кроме того, мы гибридизируем сеть для повышения производительности.
Поскольку большая часть кода стандартна, мы поясним только основы и не будем подробно обсуждать детали. При необходимости обратитесь к главе 6 за повторением материала.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, gluon, init, lr_scheduler, np, npx
from mxnet.gluon import nn
npx.set_np()
net = nn.HybridSequential()
net.add(nn.Conv2D(channels=6, kernel_size=5, padding=2, activation='relu'),
nn.MaxPool2D(pool_size=2, strides=2),
nn.Conv2D(channels=16, kernel_size=5, activation='relu'),
nn.MaxPool2D(pool_size=2, strides=2),
nn.Dense(120, activation='relu'),
nn.Dense(84, activation='relu'),
nn.Dense(10))
net.hybridize()
loss = gluon.loss.SoftmaxCrossEntropyLoss()
device = d2l.try_gpu()
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size=batch_size)
# Код почти такой же, как d2l.train_ch6 из раздела о LeNet в главе о свёрточных нейронных сетях
def train(net, train_iter, test_iter, num_epochs, loss, trainer, device):
net.initialize(force_reinit=True, ctx=device, init=init.Xavier())
animator = d2l.Animator(xlabel='эпоха', xlim=[0, num_epochs],
legend=['потери на обучении', 'точность на обучении',
'точность на тесте'])
for epoch in range(num_epochs):
metric = d2l.Accumulator(3) # Потери на обучении, точность на обучении, число примеров
for i, (X, y) in enumerate(train_iter):
X, y = X.as_in_ctx(device), y.as_in_ctx(device)
with autograd.record():
y_hat = net(X)
l = loss(y_hat, y)
l.backward()
trainer.step(X.shape[0])
metric.add(l.sum(), d2l.accuracy(y_hat, y), X.shape[0])
train_loss = metric[0] / metric[2]
train_acc = metric[1] / metric[2]
if (i + 1) % 50 == 0:
animator.add(epoch + i / len(train_iter),
(train_loss, train_acc, None))
test_acc = d2l.evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch + 1, (None, None, test_acc))
print(f'потери на обучении {train_loss:.3f}, точность на обучении {train_acc:.3f}, '
f'точность на тесте {test_acc:.3f}')
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import math
import torch
from torch import nn
from torch.optim import lr_scheduler
def net_fn():
model = nn.Sequential(
nn.Conv2d(1, 6, kernel_size=5, padding=2), nn.ReLU(),
nn.MaxPool2d(kernel_size=2, stride=2),
nn.Conv2d(6, 16, kernel_size=5), nn.ReLU(),
nn.MaxPool2d(kernel_size=2, stride=2),
nn.Flatten(),
nn.Linear(16 * 5 * 5, 120), nn.ReLU(),
nn.Linear(120, 84), nn.ReLU(),
nn.Linear(84, 10))
return model
loss = nn.CrossEntropyLoss()
device = d2l.try_gpu()
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size=batch_size)
# Код почти такой же, как d2l.train_ch6 из раздела о LeNet в главе о свёрточных нейронных сетях
def train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler=None):
net.to(device)
animator = d2l.Animator(xlabel='эпоха', xlim=[0, num_epochs],
legend=['потери на обучении', 'точность на обучении',
'точность на тесте'])
for epoch in range(num_epochs):
metric = d2l.Accumulator(3) # Потери на обучении, точность на обучении, число примеров
for i, (X, y) in enumerate(train_iter):
net.train()
trainer.zero_grad()
X, y = X.to(device), y.to(device)
y_hat = net(X)
l = loss(y_hat, y)
l.backward()
trainer.step()
with torch.no_grad():
metric.add(l * X.shape[0], d2l.accuracy(y_hat, y), X.shape[0])
train_loss = metric[0] / metric[2]
train_acc = metric[1] / metric[2]
if (i + 1) % 50 == 0:
animator.add(epoch + i / len(train_iter),
(train_loss, train_acc, None))
test_acc = d2l.evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch+1, (None, None, test_acc))
if scheduler:
if scheduler.__module__ == lr_scheduler.__name__:
# Встроенный планировщик PyTorch
scheduler.step()
else:
# Пользовательский планировщик
for param_group in trainer.param_groups:
param_group['lr'] = scheduler(epoch)
print(f'потери на обучении {train_loss:.3f}, точность на обучении {train_acc:.3f}, '
f'точность на тесте {test_acc:.3f}')
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
import math
from tensorflow.keras.callbacks import LearningRateScheduler
def net():
return tf.keras.models.Sequential([
tf.keras.layers.Conv2D(filters=6, kernel_size=5, activation='relu',
padding='same'),
tf.keras.layers.AvgPool2D(pool_size=2, strides=2),
tf.keras.layers.Conv2D(filters=16, kernel_size=5,
activation='relu'),
tf.keras.layers.AvgPool2D(pool_size=2, strides=2),
tf.keras.layers.Flatten(),
tf.keras.layers.Dense(120, activation='relu'),
tf.keras.layers.Dense(84, activation='sigmoid'),
tf.keras.layers.Dense(10)])
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size=batch_size)
# Код почти такой же, как d2l.train_ch6 из раздела о LeNet в главе о свёрточных нейронных сетях
def train(net_fn, train_iter, test_iter, num_epochs, lr,
device=d2l.try_gpu(), custom_callback = False):
device_name = device._device_name
strategy = tf.distribute.OneDeviceStrategy(device_name)
with strategy.scope():
optimizer = tf.keras.optimizers.SGD(learning_rate=lr)
loss = tf.keras.losses.SparseCategoricalCrossentropy(from_logits=True)
net = net_fn()
net.compile(optimizer=optimizer, loss=loss, metrics=['accuracy'])
callback = d2l.TrainCallback(net, train_iter, test_iter, num_epochs,
device_name)
if custom_callback is False:
net.fit(train_iter, epochs=num_epochs, verbose=0,
callbacks=[callback])
else:
net.fit(train_iter, epochs=num_epochs, verbose=0,
callbacks=[callback, custom_callback])
return net
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import paddle
from paddle import nn
from paddle.optimizer import lr as lr_scheduler
def net_fn():
model = nn.Sequential(
nn.Conv2D(1, 6, kernel_size=5, padding=2), nn.ReLU(),
nn.MaxPool2D(kernel_size=2, stride=2),
nn.Conv2D(6, 16, kernel_size=5), nn.ReLU(),
nn.MaxPool2D(kernel_size=2, stride=2),
nn.Flatten(),
nn.Linear(16 * 5 * 5, 120), nn.ReLU(),
nn.Linear(120, 84), nn.ReLU(),
nn.Linear(84, 10))
return model
loss = nn.CrossEntropyLoss()
device = d2l.try_gpu()
batch_size = 256
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size=batch_size)
# Код почти такой же, как d2l.train_ch6 из раздела о LeNet в главе о свёрточных нейронных сетях
def train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler=None):
animator = d2l.Animator(xlabel='эпоха', xlim=[0, num_epochs],
legend=['потери на обучении', 'точность на обучении',
'точность на тесте'])
for epoch in range(num_epochs):
metric = d2l.Accumulator(3) # Потери на обучении, точность на обучении, число примеров
for i, (X, y) in enumerate(train_iter):
net.train()
trainer.clear_grad()
y_hat = net(X)
l = loss(y_hat, y)
l.backward()
trainer.step()
with paddle.no_grad():
metric.add(l * X.shape[0], d2l.accuracy(y_hat,y), X.shape[0])
train_loss = metric[0] / metric[2]
train_acc = metric[1] / metric[2]
if (i + 1) % 50 == 0:
animator.add(epoch + i / len(train_iter),
(train_loss, train_acc, None))
test_acc = d2l.evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch+1, (None, None, test_acc))
if scheduler:
if scheduler.__module__ == lr_scheduler.__name__:
# Встроенный планировщик PaddlePaddle
scheduler.step()
else:
# Пользовательский планировщик
trainer.set_lr(scheduler(epoch))
print(f'потери на обучении {train_loss:.3f}, точность на обучении {train_acc:.3f}, 'f'точность на тесте {test_acc:.3f}')
Посмотрим, что произойдёт, если использовать настройки по умолчанию. Например, установим скорость обучения равной и обучим модель за итераций. Обратите внимание, что после определённого момента прогресс точности на тесте останавливается, в то время как точность на обучении продолжает расти. Разрыв между двумя кривыми указывает на переобучение.
MXNet:
lr, num_epochs = 0.3, 30
net.initialize(force_reinit=True, ctx=device, init=init.Xavier())
trainer = gluon.Trainer(net.collect_params(), 'sgd', {'learning_rate': lr})
train(net, train_iter, test_iter, num_epochs, loss, trainer, device)
PyTorch:
lr, num_epochs = 0.3, 30
net = net_fn()
trainer = torch.optim.SGD(net.parameters(), lr=lr)
train(net, train_iter, test_iter, num_epochs, loss, trainer, device)
TensorFlow:
lr, num_epochs = 0.3, 30
train(net, train_iter, test_iter, num_epochs, lr)
PaddlePaddle:
lr, num_epochs = 0.3, 30
net = net_fn()
trainer = paddle.optimizer.SGD(learning_rate=lr, parameters=net.parameters())
train(net, train_iter, test_iter, num_epochs, loss, trainer, device)
11.11.2 Планировщики скорости обучения
Мы можем понижать скорость обучения после каждой эпохи (или даже после каждого минибатча). Например, это можно делать динамически, реагируя на ход оптимизации.
MXNet:
trainer.set_learning_rate(0.1)
print(f'скорость обучения теперь {trainer.learning_rate:.2f}')
PyTorch:
lr = 0.1
trainer.param_groups[0]["lr"] = lr
print(f'скорость обучения теперь {trainer.param_groups[0]["lr"]:.2f}')
TensorFlow:
lr = 0.1
dummy_model = tf.keras.models.Sequential([tf.keras.layers.Dense(10)])
dummy_model.compile(tf.keras.optimizers.SGD(learning_rate=lr), loss='mse')
print(f'скорость обучения теперь ,', dummy_model.optimizer.lr.numpy())
PaddlePaddle:
lr = 0.1
trainer.set_lr(lr)
print(f'скорость обучения теперь {trainer.get_lr():.2f}')
В более общем случае мы должны определить планировщик. При вызове с номером обновления он возвращает подходящее значение скорости обучения. Определим простой метод, который задаёт скорость обучения .
class SquareRootScheduler:
def __init__(self, lr=0.1):
self.lr = lr
def __call__(self, num_update):
return self.lr * pow(num_update + 1.0, -0.5)
Построим график его поведения на наборе значений.
scheduler = SquareRootScheduler(lr=0.1)
d2l.plot(d2l.arange(num_epochs), [scheduler(t) for t in range(num_epochs)])
Теперь посмотрим, как это влияет на обучение на наборе Fashion-MNIST. Мы просто передаём планировщик как дополнительный параметр алгоритма обучения.
MXNet:
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'lr_scheduler': scheduler})
train(net, train_iter, test_iter, num_epochs, loss, trainer, device)
PyTorch:
net = net_fn()
trainer = torch.optim.SGD(net.parameters(), lr)
train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler)
TensorFlow:
train(net, train_iter, test_iter, num_epochs, lr,
custom_callback=LearningRateScheduler(scheduler))
PaddlePaddle:
net = net_fn()
trainer = paddle.optimizer.SGD(learning_rate=lr , parameters=net.parameters())
train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler)
Это немного лучше, чем раньше: кривые стали более гладкими, а переобучение меньше. К сожалению, есть взгляды, объясняющие, почему некоторые стратегии в теории приводят к более слабому переобучению: меньший шаг приводит к тому, что параметры ближе к нулю и, следовательно, проще. Однако это не полностью объясняет явление, поскольку мы не останавливали обучение раньше времени, а лишь плавно снижали скорость обучения.
11.11.3 Стратегии
Хотя мы не можем рассмотреть все типы планировщиков скорости обучения, попробуем кратко описать часто используемые стратегии: полиномиальное затухание и кусочно-постоянный график. Кроме того, косинусный планировщик хорошо работает на некоторых задачах. А на некоторых задачах полезно прогреть оптимизатор перед использованием высокой скорости обучения.
11.11.3.1 Планировщик с мультипликативным затуханием
Альтернативой полиномиальному затуханию является мультипликативное затухание, то есть , где . Чтобы скорость обучения не опускалась ниже разумного нижнего предела, уравнение обновления часто модифицируют так: .
class FactorScheduler:
def __init__(self, factor=1, stop_factor_lr=1e-7, base_lr=0.1):
self.factor = factor
self.stop_factor_lr = stop_factor_lr
self.base_lr = base_lr
def __call__(self, num_update):
self.base_lr = max(self.stop_factor_lr, self.base_lr * self.factor)
return self.base_lr
scheduler = FactorScheduler(factor=0.9, stop_factor_lr=1e-2, base_lr=2.0)
d2l.plot(d2l.arange(50), [scheduler(t) for t in range(50)])
Далее мы будем использовать встроенные планировщики, но здесь мы лишь поясняем, как они работают.
11.11.3.2 Многоступенчатый планировщик
Одна из распространённых стратегий обучения глубоких сетей — поддерживать скорость обучения на уровне кусочно-постоянных значений и время от времени умножать её на заданный коэффициент. В частности, задав набор моментов, в которые скорость обучения снижается, например , при мы уменьшаем скорость по правилу . Если предположить, что на каждом шаге значение уменьшается вдвое, то реализовать это можно так.
MXNet:
scheduler = lr_scheduler.MultiFactorScheduler(step=[15, 30], factor=0.5,
base_lr=0.5)
d2l.plot(d2l.arange(num_epochs), [scheduler(t) for t in range(num_epochs)])
PyTorch:
net = net_fn()
trainer = torch.optim.SGD(net.parameters(), lr=0.5)
scheduler = lr_scheduler.MultiStepLR(trainer, milestones=[15, 30], gamma=0.5)
def get_lr(trainer, scheduler):
lr = scheduler.get_last_lr()[0]
trainer.step()
scheduler.step()
return lr
d2l.plot(d2l.arange(num_epochs), [get_lr(trainer, scheduler)
for t in range(num_epochs)])
TensorFlow:
class MultiFactorScheduler:
def __init__(self, step, factor, base_lr):
self.step = step
self.factor = factor
self.base_lr = base_lr
def __call__(self, epoch):
if epoch in self.step:
self.base_lr = self.base_lr * self.factor
return self.base_lr
else:
return self.base_lr
scheduler = MultiFactorScheduler(step=[15, 30], factor=0.5, base_lr=0.5)
d2l.plot(d2l.arange(num_epochs), [scheduler(t) for t in range(num_epochs)])
PaddlePaddle:
net = net_fn()
scheduler =paddle.optimizer.lr.MultiStepDecay(learning_rate=0.5, milestones=[15,30], gamma=0.5)
trainer = paddle.optimizer.SGD(learning_rate=scheduler, parameters=net.parameters())
def get_lr(trainer, scheduler):
lr=trainer.state_dict()['LR_Scheduler']['last_lr']
trainer.step()
scheduler.step()
return lr
d2l.plot(paddle.arange(num_epochs), [get_lr(trainer, scheduler)
for t in range(num_epochs)])
Интуиция этого кусочно-постоянного расписания такова: пусть оптимизация продолжается, пока распределение весового вектора не достигнет стационарной точки. И только тогда мы снижаем скорость обучения, чтобы получить более качественное приближение к хорошему локальному минимуму. Пример ниже показывает, как этот подход может дать лучшее решение.
MXNet:
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'lr_scheduler': scheduler})
train(net, train_iter, test_iter, num_epochs, loss, trainer, device)
PyTorch:
train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler)
TensorFlow:
train(net, train_iter, test_iter, num_epochs, lr,
custom_callback=LearningRateScheduler(scheduler))
PaddlePaddle:
train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler)
11.11.3.3 Косинусный планировщик
Косинусный планировщик — эвристический алгоритм, предложенный в работе (Loshchilov and Hutter, 2016). Он основан на идее, что мы, возможно, не хотим слишком сильно снижать скорость обучения в самом начале, а в конце хотим «улучшить» решение очень маленькой скоростью обучения. В результате получается расписание, похожее на косинус; его функциональная форма показана ниже, при этом значения скорости обучения лежат на отрезке .
Здесь — начальная скорость обучения, а — целевая скорость обучения при . Кроме того, при мы просто фиксируем значение на уровне и больше его не увеличиваем. В следующем примере задаём максимальное число шагов обновления .
scheduler = lr_scheduler.CosineScheduler(max_update=20, base_lr=0.3,
final_lr=0.01)
d2l.plot(d2l.arange(num_epochs), [scheduler(t) for t in range(num_epochs)])
class CosineScheduler:
def __init__(self, max_update, base_lr=0.01, final_lr=0,
warmup_steps=0, warmup_begin_lr=0):
self.base_lr_orig = base_lr
self.max_update = max_update
self.final_lr = final_lr
self.warmup_steps = warmup_steps
self.warmup_begin_lr = warmup_begin_lr
self.max_steps = self.max_update - self.warmup_steps
def get_warmup_lr(self, epoch):
increase = (self.base_lr_orig - self.warmup_begin_lr) \
* float(epoch) / float(self.warmup_steps)
return self.warmup_begin_lr + increase
def __call__(self, epoch):
if epoch < self.warmup_steps:
return self.get_warmup_lr(epoch)
if epoch <= self.max_update:
self.base_lr = self.final_lr + (
self.base_lr_orig - self.final_lr) * (1 + math.cos(
math.pi * (epoch - self.warmup_steps) / self.max_steps)) / 2
return self.base_lr
scheduler = CosineScheduler(max_update=20, base_lr=0.3, final_lr=0.01)
d2l.plot(d2l.arange(num_epochs), [scheduler(t) for t in range(num_epochs)])
В контексте компьютерного зрения такой график может дать улучшенные результаты. Однако, как показано ниже, это улучшение не обязательно будет иметь место.
MXNet:
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'lr_scheduler': scheduler})
train(net, train_iter, test_iter, num_epochs, loss, trainer, device)
PyTorch:
net = net_fn()
trainer = torch.optim.SGD(net.parameters(), lr=0.3)
train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler)
TensorFlow:
train(net, train_iter, test_iter, num_epochs, lr,
custom_callback=LearningRateScheduler(scheduler))
PaddlePaddle:
net = net_fn()
trainer = paddle.optimizer.SGD(learning_rate=0.3, parameters=net.parameters())
train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler)
11.11.3.4 Разогрев
В некоторых случаях инициализации параметров недостаточно для получения хорошего решения. Это особенно проблематично для некоторых сложных архитектур сетей и может приводить к нестабильным результатам оптимизации. С одной стороны, можно выбрать достаточно малую скорость обучения, чтобы предотвратить расходимость в самом начале; однако тогда прогресс слишком медленный. С другой стороны, высокая скорость обучения с самого начала приводит к расходимости.
Довольно простой способ выйти из этой дилеммы — использовать период разогрева, в течение которого скорость обучения возрастает до своего начального максимума, а затем снижается до конца оптимизации. Для простоты обычно используют линейный рост. Так получается расписание, показанное в таблице ниже.
MXNet:
scheduler = lr_scheduler.CosineScheduler(20, warmup_steps=5, base_lr=0.3,
final_lr=0.01)
d2l.plot(np.arange(num_epochs), [scheduler(t) for t in range(num_epochs)])
PyTorch, TensorFlow, PaddlePaddle:
scheduler = CosineScheduler(20, warmup_steps=5, base_lr=0.3, final_lr=0.01)
d2l.plot(d2l.arange(num_epochs), [scheduler(t) for t in range(num_epochs)])
Обратите внимание: на первых 5 эпохах сеть сходится лучше.
MXNet:
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'lr_scheduler': scheduler})
train(net, train_iter, test_iter, num_epochs, loss, trainer, device)
PyTorch:
net = net_fn()
trainer = torch.optim.SGD(net.parameters(), lr=0.3)
train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler)
TensorFlow:
train(net, train_iter, test_iter, num_epochs, lr,
custom_callback=LearningRateScheduler(scheduler))
PaddlePaddle:
net = net_fn()
trainer = paddle.optimizer.SGD(learning_rate=0.3, parameters=net.parameters())
train(net, train_iter, test_iter, num_epochs, loss, trainer, device,
scheduler)
Разогрев можно применять к любому планировщику, а не только к косинусному. Более подробные эксперименты и обсуждение расписаний скорости обучения см. в работе (Gotmare et al., 2018). Там, в частности, показано ключевое наблюдение: фаза разогрева ограничивает степень расходимости параметров в очень глубоких сетях. Это интуитивно понятно: в тех частях сети, которые в начале медленнее всего прогрессируют, случайная инициализация порождает сильную расходимость.
Резюме
- Постепенное снижение скорости обучения во время обучения повышает точность и уменьшает переобучение модели.
- В экспериментах очень эффективно снижать скорость обучения, когда прогресс выходит на плато. По сути, это гарантирует, что мы эффективно сходимся к подходящему решению, и только тогда уменьшение скорости обучения позволяет снизить внутренний разброс параметров.
- Косинусный планировщик популярен для некоторых задач компьютерного зрения.
- Период разогрева перед оптимизацией может предотвратить расходимость.
- Оптимизация имеет много применений в глубоком обучении. Для одной и той же ошибки на обучении выбор разных алгоритмов оптимизации и расписаний скорости обучения может давать разную степень обобщения и переобучения на тестовом наборе, помимо минимизации времени обучения.
Упражнения
- Исследуйте поведение оптимизации при фиксированной скорости обучения. Какую лучшую модель можно получить в этом случае?
- Как изменится сходимость, если менять показатель степени в убывании скорости обучения? В экспериментах для удобства используйте
PolyScheduler. - Примените косинусный планировщик к большой задаче компьютерного зрения, например, к обучению на наборе ImageNet. Как он влияет на производительность по сравнению с другими планировщиками?
- Как долго должен длиться период разогрева?
- Можно ли связать оптимизацию с семплированием? В качестве первого шага используйте результаты (Welling and Teh, 2011) для стохастической градиентной динамики Ланжевена.
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Gotmare, A., Keskar, N. S., Xiong, C., & Socher, R. (2018). A closer look at deep learning heuristics: Learning rate restarts, warmup and distillation. arXiv preprint arXiv:1810.13243.
- Izmailov, P., Podoprikhin, D., Garipov, T., Vetrov, D., & Wilson, A. G. (2018). Averaging weights leads to wider optima and better generalization. arXiv preprint arXiv:1803.05407.
- Loshchilov, I., & Hutter, F. (2016). SGDR: Stochastic gradient descent with warm restarts. arXiv preprint arXiv:1608.03983.
- Welling, M., & Teh, Y. W. (2011). Bayesian learning via stochastic gradient Langevin dynamics. Proceedings of the 28th International Conference on Machine Learning (ICML-11), 681–688.
12. Вычислительная производительность
В глубоком обучении наборы данных и модели обычно очень велики, а значит, велики и вычислительные затраты. Поэтому производительность вычислений очень важна. В этой главе мы сосредоточимся на основных факторах, которые на неё влияют: императивном программировании, символьном программировании, асинхронных вычислениях, автоматическом распараллеливании и вычислениях на нескольких GPU. Изучив эту главу, можно дополнительно повысить производительность моделей из предыдущих глав. Например, можно заметно сократить время обучения, не жертвуя точностью.
12.1 Компиляторы и интерпретаторы
До сих пор в этой книге мы в основном рассматривали императивное программирование (imperative programming). Императивное программирование использует такие операторы, как print, «+» и if, чтобы изменять состояние программы. Рассмотрим простую императивную программу:
def add(a, b):
return a + b
def fancy_func(a, b, c, d):
e = add(a, b)
f = add(c, d)
g = add(e, f)
return g
print(fancy_func(1, 2, 3, 4))
Python — это интерпретируемый язык (interpreted language). Поэтому при вычислении функции fancy_func выше он последовательно выполняет операции тела функции. То есть он вычислит e = add(a, b), сохранит результат в переменной e и тем самым изменит состояние программы. Следующие две инструкции, f = add(c, d) и g = add(e, f), работают так же: выполняют сложение и сохраняют результат в переменной. На рис. 12.1.1 показан поток данных.
Рис. 12.1.1. Поток данных при императивном программировании
Императивное программирование удобно, но может быть неэффективным. Во-первых, Python выполняет три вызова функций по отдельности и не учитывает, что add повторно вызывается внутри fancy_func. Если выполнять такие команды на одном GPU (или на нескольких), накладные расходы интерпретатора Python могут оказаться очень большими. Кроме того, значения переменных e и f нужно хранить до тех пор, пока не выполнятся все инструкции fancy_func. Дело в том, что программа не знает, понадобятся ли переменные e и f другим частям кода после выполнения инструкций e = add(a, b) и f = add(c, d).
12.1.1 Символьное программирование
Рассмотрим другой вариант — символьное программирование (symbolic programming): код обычно выполняет вычисления только после того, как процедура полностью определена. Эту стратегию используют несколько фреймворков глубокого обучения, в том числе Theano и TensorFlow (у которого со временем появился и императивный режим). Обычно процесс состоит из следующих шагов:
- определить вычислительный процесс;
- скомпилировать процесс в исполняемую программу;
- при заданных входных данных вызвать скомпилированную программу для выполнения.
Это позволяет проводить многочисленные оптимизации. Во-первых, в большинстве случаев можно обойтись без интерпретатора Python. Это устраняет узкое место в производительности, которое возникает, когда несколько быстрых GPU работают вместе с одним потоком Python на одном CPU. Во-вторых, компилятор может оптимизировать и переписать код, например превратив print((1 + 2) + (3 + 4)) в print(10). Такая оптимизация возможна потому, что компилятор видит весь код до того, как преобразовать его в машинные инструкции. Например, компилятор может освободить память, как только переменная больше не нужна (или вообще не выделять её), либо заменить фрагмент кода на полностью эквивалентный. Ниже мы имитируем императивное программирование, чтобы лучше понять идею символьного программирования.
def add_():
return '''
def add(a, b):
return a + b
'''
def fancy_func_():
return '''
def fancy_func(a, b, c, d):
e = add(a, b)
f = add(c, d)
g = add(e, f)
return g
'''
def evoke_():
return add_() + fancy_func_() + 'print(fancy_func(1, 2, 3, 4))'
prog = evoke_()
print(prog)
y = compile(prog, '', 'exec')
exec(y)
Различия между императивным (интерпретируемым) и символьным программированием таковы:
- императивное программирование проще в использовании. В Python большая часть императивного кода понятна и проста. Его также легче отлаживать, потому что получить и напечатать все промежуточные значения переменных или использовать встроенные средства отладки Python гораздо проще;
- символьное программирование работает эффективнее и легче переносится. Его проще оптимизировать во время компиляции, а программу можно перенести в формат, не зависящий от Python. Это позволяет запускать программу в средах без Python и избежать возможных проблем с производительностью, связанных с интерпретатором Python.
12.1.2 Гибридное программирование
Исторически большинство фреймворков глубокого обучения выбирали между императивным и символьным программированием. Например, Theano, TensorFlow (созданный под влиянием Theano), Keras и CNTK использовали символьное программирование. Напротив, Chainer и PyTorch выбрали императивное программирование. В последующих версиях TensorFlow 2.0 и Keras добавили императивное программирование.
MXNet: Разработчики Gluon задались вопросом: можно ли объединить достоинства обеих моделей программирования? Так появилась гибридная модель программирования (hybrid programming). Она позволяет разрабатывать и отлаживать код в чисто императивном стиле, но при этом превращать большинство программ в символьные, когда нужны производительность промышленного уровня и развёртывание.
На практике это означает, что модели строятся с помощью классов HybridBlock или HybridSequential. По умолчанию они работают так же, как классы Block и Sequential в императивном программировании. Класс HybridSequential наследуется от HybridBlock так же, как Sequential наследуется от Block. Когда вызывается функция hybridize, Gluon компилирует модель в форму, которая используется в символьном программировании. Это позволяет оптимизировать вычислительно сложные компоненты, не меняя способа реализации модели. Ниже мы подробно опишем преимущества этого подхода на примере Sequential и Block.
PyTorch: Как было сказано выше, PyTorch основан на императивном программировании и использует динамический вычислительный граф. Чтобы использовать переносимость и эффективность символьного программирования, разработчики задались вопросом: можно ли объединить достоинства обеих моделей программирования? Так появился TorchScript. Он позволяет разрабатывать и отлаживать код в чисто императивном стиле, но при этом превращать большинство программ в символьные, когда нужны производительность промышленного уровня и развёртывание.
TensorFlow: Императивное программирование сейчас выбрано по умолчанию в TensorFlow 2, что удобно для тех, кто только начинает работать с этим языком. Тем не менее символьное программирование и вычислительные графы по-прежнему доступны в TensorFlow: их можно использовать через простой в применении декоратор tf.function. Это даёт TensorFlow императивную парадигму, позволяя определять более понятные функции, а затем оборачивать их с помощью механизма, который команда TensorFlow называет autograph, и автоматически компилировать в вычислительный граф.
PaddlePaddle: Как было сказано выше, PaddlePaddle основан на императивном программировании и использует динамический вычислительный граф. Чтобы использовать переносимость и эффективность символьного программирования, разработчики задались вопросом: можно ли объединить достоинства обеих моделей программирования? Так появилась PaddlePaddle 2.0. Начиная с версии 2.0 PaddlePaddle позволяет разрабатывать и отлаживать код в чисто императивном стиле, но при этом превращать большинство программ в символьные, когда нужны производительность промышленного уровня и развёртывание.
12.1.3 Гибридное программирование для Sequential
Проще всего понять, как работает гибридное программирование, рассмотрев глубокую сеть с несколькими слоями. По традиции интерпретатор Python должен выполнить код всех слоёв, чтобы сформировать одну инструкцию, а затем передать её на CPU или GPU. Для одного (быстрого) вычислительного устройства это не создаёт серьёзных проблем. С другой стороны, если использовать мощный сервер с восемью GPU, например экземпляр AWS P3dn.24xlarge, Python будет с трудом загружать все GPU. Здесь узким местом становится однопоточный интерпретатор Python. Посмотрим, как решить эту проблему в коде, заменив Sequential на HybridSequential. Сначала определим простой многослойный перцептрон.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
from mxnet.gluon import nn
npx.set_np()
# Фабричная функция для создания сети
def get_net():
net = nn.HybridSequential()
net.add(nn.Dense(256, activation='relu'),
nn.Dense(128, activation='relu'),
nn.Dense(2))
net.initialize()
return net
x = np.random.normal(size=(1, 512))
net = get_net()
net(x)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
# Фабричная функция для создания сети
def get_net():
net = nn.Sequential(nn.Linear(512, 256),
nn.ReLU(),
nn.Linear(256, 128),
nn.ReLU(),
nn.Linear(128, 2))
return net
x = torch.randn(size=(1, 512))
net = get_net()
net(x)
TensorFlow:
from d2l import tensorflow as d2l
import tensorflow as tf
from tensorflow.keras.layers import Dense
# Фабричная функция для создания сети
def get_net():
net = tf.keras.Sequential()
net.add(Dense(256, input_shape = (512,), activation = "relu"))
net.add(Dense(128, activation = "relu"))
net.add(Dense(2, activation = "linear"))
return net
x = tf.random.normal([1,512])
net = get_net()
net(x)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
from paddle.jit import to_static
from paddle.static import InputSpec
# Фабричная функция для создания сети
def get_net():
blocks = [
nn.Linear(512, 256),
nn.ReLU(),
nn.Linear(256, 128),
nn.ReLU(),
nn.Linear(128, 2)
]
net = nn.Sequential(*blocks)
return net
x = paddle.randn((1, 512))
net = get_net()
net(x)
MXNet: Вызвав функцию hybridize, мы получаем возможность компилировать и оптимизировать вычисления в многослойном перцептроне, при этом результаты вычислений модели не меняются.
PyTorch: Преобразовав модель с помощью функции torch.jit.script, мы получаем возможность компилировать и оптимизировать вычисления в многослойном перцептроне, при этом результаты вычислений модели не меняются.
TensorFlow: Изначально все функции в TensorFlow строились как вычислительные графы и по умолчанию компилировались JIT. Однако с выходом TensorFlow 2.x и EagerTensor граф перестал быть поведением по умолчанию. Включить эту возможность снова можно с помощью tf.function. Обычно tf.function используют как декоратор функции, как показано ниже, но его также можно вызывать напрямую, как обычную функцию Python. Результаты вычислений модели не меняются.
PaddlePaddle: Преобразовав модель с помощью функции paddle.jit.to_static, мы получаем возможность компилировать и оптимизировать вычисления в многослойном перцептроне, при этом результаты вычислений модели не меняются.
MXNet:
net.hybridize()
net(x)
PyTorch:
net = torch.jit.script(net)
net(x)
TensorFlow:
net = tf.function(net)
net(x)
PaddlePaddle:
net = paddle.jit.to_static(net)
net(x)
MXNet: Нам достаточно объявить блок как HybridSequential, написать тот же код, что и раньше, и вызвать hybridize. После этого сеть будет оптимизирована (сравнение производительности приведено ниже). К сожалению, такая магия работает не для каждого слоя: если слой унаследован от класса Block, а не HybridBlock, он оптимизирован не будет.
PyTorch: Мы пишем тот же код, что и раньше, и просто преобразуем модель с помощью torch.jit.script. После этого сеть будет оптимизирована (сравнение производительности приведено ниже).
TensorFlow: Мы пишем тот же код, что и раньше, и просто преобразуем модель с помощью tf.function. После этого сеть будет построена как вычислительный граф в промежуточном представлении MLIR в TensorFlow и пройдёт множество оптимизаций на уровне компилятора для быстрого выполнения (сравнение производительности приведено ниже). Включить XLA (ускорение линейной алгебры) в TensorFlow можно явно, добавив флаг jit_compile = True в вызов tf.function(). В некоторых случаях XLA может дополнительно оптимизировать JIT-скомпилированный код. Если указать это явно не нужно, режим графа всё равно включается, но XLA может ускорить некоторые крупные операции линейной алгебры, похожие на те, что встречаются в программах глубокого обучения, особенно в среде с GPU.
PaddlePaddle: Мы пишем тот же код, что и раньше, и просто преобразуем модель с помощью paddle.jit.to_static. После этого сеть будет оптимизирована (сравнение производительности приведено ниже).
12.1.3.1 Ускорение с помощью гибридного программирования
Чтобы показать, что компиляция действительно повышает производительность, сравним время выполнения net(x) до и после гибридизации. Сначала определим класс для измерения времени. Он пригодится в этой главе, когда будем оценивать и улучшать производительность моделей.
#@save
class Benchmark:
"""Измерение времени выполнения"""
def __init__(self, description='Готово'):
self.description = description
def __enter__(self):
self.timer = d2l.Timer()
return self
def __exit__(self, *args):
print(f'{self.description}: {self.timer.stop():.4f} сек')
MXNet: Теперь вызовем сеть дважды: с гибридизацией и без неё.
PyTorch: Теперь вызовем сеть дважды: с TorchScript и без него.
TensorFlow: Теперь вызовем сеть трижды: в режиме eager, в режиме графа и с JIT-компиляцией через XLA.
PaddlePaddle: Теперь вызовем сеть дважды: в динамическом императивном режиме и в статическом символьном режиме.
MXNet:
net = get_net()
with Benchmark('без гибридизации'):
for i in range(1000): net(x)
npx.waitall()
net.hybridize()
with Benchmark('с гибридизацией'):
for i in range(1000): net(x)
npx.waitall()
PyTorch:
net = get_net()
with Benchmark('без torchscript'):
for i in range(1000): net(x)
net = torch.jit.script(net)
with Benchmark('с torchscript'):
for i in range(1000): net(x)
TensorFlow:
net = get_net()
with Benchmark('Режим eager'):
for i in range(1000): net(x)
net = tf.function(net)
with Benchmark('Режим графа'):
for i in range(1000): net(x)
PaddlePaddle:
net = get_net()
with Benchmark('Императивный режим PaddlePaddle (динамический граф)'):
for i in range(1000): net(x)
# InputSpec описывает сигнатуру входных данных модели: shape, dtype и name
x_spec = InputSpec(shape=[-1, 512], name='x')
net = paddle.jit.to_static(get_net(),input_spec=[x_spec])
with Benchmark('Символьный режим PaddlePaddle (статический граф)'):
for i in range(1000): net(x)
MXNet: Как видно из результатов, после вызова hybridize для экземпляра HybridSequential вычислительная производительность выросла благодаря символьному программированию.
PyTorch: Как видно из результатов, после того как экземпляр nn.Sequential преобразован функцией torch.jit.script, вычислительная производительность выросла благодаря символьному программированию.
TensorFlow: Как видно из результатов, после того как экземпляр tf.keras.Sequential преобразован функцией tf.function, производительность выросла благодаря символьному программированию, реализованному через режим выполнения графа в TensorFlow.
PaddlePaddle: Как видно из результатов, после того как экземпляр nn.Sequential преобразован функцией paddle.jit.to_static, вычислительная производительность выросла благодаря символьному программированию.
12.1.3.2 Сериализация
MXNet: Одно из преимуществ компилированных моделей в том, что модель вместе с параметрами можно сериализовать (сохранить) на диск. Это позволяет развёртывать обученные модели на других устройствах и удобно использовать их из других языков программирования. Кроме того, скомпилированный код обычно выполняется быстрее, чем императивный. Посмотрим, что делает export.
PyTorch: Одно из преимуществ компилированных моделей в том, что модель вместе с параметрами можно сериализовать (сохранить) на диск. Это позволяет развёртывать обученные модели на других устройствах и удобно использовать их из других языков программирования. Кроме того, скомпилированный код обычно выполняется быстрее, чем императивный. Посмотрим, что делает save.
TensorFlow: Одно из преимуществ компилированных моделей в том, что модель вместе с параметрами можно сериализовать (сохранить) на диск. Это позволяет развёртывать обученные модели на других устройствах и удобно использовать их из других языков программирования. Кроме того, скомпилированный код обычно выполняется быстрее, чем императивный. Низкоуровневый API для сохранения моделей в TensorFlow — tf.saved_model. Посмотрим, как работает saved_model.
PaddlePaddle: Одно из преимуществ компилированных моделей в том, что модель вместе с параметрами можно сериализовать (сохранить) на диск. Это позволяет развёртывать обученные модели на других устройствах и удобно использовать их из других языков программирования. Кроме того, скомпилированный код обычно выполняется быстрее, чем императивный. Посмотрим, что делает paddle.jit.save.
MXNet:
net.export('my_mlp')
!ls -lh my_mlp*
PyTorch:
net.save('my_mlp')
!ls -lh my_mlp*
TensorFlow:
net = get_net()
tf.saved_model.save(net, 'my_mlp')
!ls -lh my_mlp*
PaddlePaddle:
paddle.jit.save(net, './my_mlp')
!ls -lh my_mlp*
MXNet: Модель разбивается на два файла: один большой двоичный файл с параметрами и JSON-файл с описанием программы, необходимой для вычисления модели. Эти файлы могут читать и другие языки программирования, например C++, R, Scala и Perl, если они поддерживаются Python или MXNet. Посмотрим первые строки описания модели.
!head my_mlp-symbol.json
MXNet: Ранее мы показали, что после вызова hybridize модель получает высокую вычислительную производительность и переносимость. Обратите внимание, что гибридизация может ограничивать гибкость модели, особенно в том, что касается управления потоком выполнения.
Кроме того, в то время как экземпляр Block требует вызова функции forward, экземпляр HybridBlock использует функцию hybrid_forward.
MXNet:
class HybridNet(nn.HybridBlock):
def __init__(self, **kwargs):
super(HybridNet, self).__init__(**kwargs)
self.hidden = nn.Dense(4)
self.output = nn.Dense(2)
def hybrid_forward(self, F, x):
print('модуль F: ', F)
print('значение x: ', x)
x = F.npx.relu(self.hidden(x))
print('результат : ', x)
return self.output(x)
MXNet: Приведённый код реализует простую сеть с скрытыми элементами и выходами. Аргумент F добавлен в функцию hybrid_forward потому, что от режима гибридизации зависит, какая библиотека (ndarray или symbol) будет использоваться в коде. Эти два класса выполняют очень похожие функции, поэтому MXNet определяет этот аргумент автоматически. Чтобы понять, что происходит, мы выведем аргументы как часть вызова функции.
net = HybridNet()
net.initialize()
x = np.random.normal(size=(1, 3))
net(x)
MXNet: Повторное прямое распространение даст тот же результат (подробности опущены). Теперь посмотрим, что происходит при вызове hybridize.
net.hybridize()
net(x)
MXNet: Программа использует модуль symbol вместо модуля ndarray для представления F. Кроме того, даже если входные данные имеют тип ndarray, данные, проходящие через сеть, теперь преобразуются в тип symbol. Это преобразование и есть часть процесса компиляции. Повторный вызов функции даёт неожиданный результат:
net(x)
MXNet: Это сильно отличается от того, что было раньше. Все операторы печати в hybrid_forward игнорируются. Действительно, при гибридном выполнении net(x) интерпретатор Python больше не используется. Это означает, что любой код Python (например, операторы print) будет проигнорирован ради более экономного выполнения и лучшей производительности. MXNet вместо интерпретатора Python напрямую вызывает бэкенд на C++. Кроме того, учтите, что модуль symbol не поддерживает некоторые функции (например, asnumpy), поэтому такие операции, как a += b и a[:] = a + b, нужно переписать в виде a = a + b. Тем не менее, когда важна скорость, компиляция модели того стоит. Выигрыш в скорости может составлять от небольшого процента до более чем двукратного, в зависимости в основном от сложности модели, быстродействия CPU и количества и быстродействия GPU.
Резюме
- Императивное программирование упрощает разработку новых моделей: код можно писать, опираясь на управление потоком выполнения, а также пользоваться зрелой экосистемой Python.
- Символьное программирование требует сначала определить и скомпилировать программу, а потом её выполнить. Его преимущество — более высокая вычислительная производительность.
MXNet:
- MXNet может объединять достоинства императивного и символьного программирования в зависимости от потребностей пользователя.
- Модели, построенные из классов
HybridSequentialиHybridBlock, с помощью функцииhybridizeмогут преобразовать императивную программу в символьную.
Упражнения
MXNet:
- Добавьте
x.asnumpy()в первую строку функцииhybrid_forwardклассаHybridNetиз этого раздела, выполните код и посмотрите, какая возникнет ошибка. Почему так происходит? - Что произойдёт, если в функцию
hybrid_forwardдобавить управляющие конструкции Python:ifиfor? - Вспомните модели из предыдущих глав, которые вас заинтересовали. Можно ли повысить их вычислительную производительность, переписав их?
PyTorch, TensorFlow:
- Вспомните модели из предыдущих глав, которые вас заинтересовали. Можно ли повысить их вычислительную производительность?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение
12.2 Асинхронные вычисления
Современные компьютеры — высокопараллельные системы: они состоят из нескольких процессорных ядер, нескольких GPU и множества вычислительных блоков. Обычно каждое ядро CPU имеет несколько потоков, каждое устройство — несколько GPU, а каждый GPU — несколько вычислительных блоков. Иными словами, мы можем одновременно делать много разных вещей, часто на разных устройствах. К сожалению, Python плохо приспособлен для написания параллельного и асинхронного кода, по крайней мере без дополнительной помощи: он однопоточный, и вряд ли это изменится в будущем. Поэтому многие фреймворки глубокого обучения, например MXNet и TensorFlow, используют модель асинхронного программирования (asynchronous programming) для повышения производительности, а PyTorch использует собственный планировщик Python и выбирает другой компромисс между производительностью и простотой. В PyTorch GPU-операции по умолчанию асинхронны: при вызове функции, работающей на GPU, операция ставится в очередь на определённом устройстве, но не обязана выполняться немедленно. Это позволяет параллельно выполнять больше вычислений, в том числе на CPU или на других GPU.
Поэтому понимание того, как устроено асинхронное программирование, помогает писать более эффективные программы: мы сознательно уменьшаем вычислительные затраты и зависимости между операциями. Это снижает нагрузку на память и повышает загрузку процессора.
MXNet:
from d2l import mxnet as d2l
import numpy, os, subprocess
from mxnet import autograd, gluon, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import numpy, os, subprocess
import torch
from torch import nn
PaddlePaddle:
from d2l import paddle as d2l
import numpy, os, subprocess
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
d2l.try_gpu()
12.2.1 Асинхронная обработка на уровне бэкенда
Для разминки рассмотрим простую задачу: сгенерируем случайную матрицу и перемножим её. Сделаем это и в NumPy, и в mxnet.np, и посмотрим, в чём разница.
MXNet:
with d2l.Benchmark('numpy'):
for _ in range(10):
a = numpy.random.normal(size=(1000, 1000))
b = numpy.dot(a, a)
with d2l.Benchmark('mxnet.np'):
for _ in range(10):
a = np.random.normal(size=(1000, 1000))
b = np.dot(a, a)
Для разминки рассмотрим простую задачу: сгенерируем случайную матрицу и перемножим её. Сделаем это в NumPy и в тензорах PyTorch, чтобы увидеть разницу. Обратите внимание, что тензоры PyTorch создаются на GPU.
PyTorch:
# Прогрев GPU
device = d2l.try_gpu()
a = torch.randn(size=(1000, 1000), device=device)
b = torch.mm(a, a)
with d2l.Benchmark('numpy'):
for _ in range(10):
a = numpy.random.normal(size=(1000, 1000))
b = numpy.dot(a, a)
with d2l.Benchmark('torch'):
for _ in range(10):
a = torch.randn(size=(1000, 1000), device=device)
b = torch.mm(a, a)
Для разминки рассмотрим простую задачу: сгенерируем случайную матрицу и перемножим её. Сделаем это в NumPy и в тензорах PaddlePaddle, чтобы увидеть разницу. Обратите внимание, что тензоры PaddlePaddle создаются на GPU.
PaddlePaddle:
# Прогрев GPU
a = paddle.randn(shape=(1000, 1000))
b = paddle.mm(a, a)
with d2l.Benchmark('numpy'):
for _ in range(10):
a = numpy.random.normal(size=(1000, 1000))
b = numpy.dot(a, a)
with d2l.Benchmark('paddle'):
for _ in range(10):
a = paddle.randn(shape=(1000, 1000))
b = paddle.mm(a, a)
MXNet: По результатам бенчмарка MXNet работает быстрее на несколько порядков. Оба варианта выполняются на одном и том же процессоре, поэтому причина должна быть в чём-то другом. Принудительное ожидание завершения всех вычислений бэкенда перед возвратом результата показывает, что происходило раньше: вычисления выполняет бэкенд, а фронтенд возвращает управление Python.
PyTorch: По результатам бенчмарка PyTorch работает быстрее на несколько порядков. Скалярное произведение NumPy выполняется на CPU, а матричное умножение PyTorch — на GPU, и оно значительно быстрее. Но такой огромный разрыв во времени говорит о том, что есть и другая причина. По умолчанию GPU-операции в PyTorch асинхронны. Принудительное ожидание завершения всех вычислений перед возвратом результата показывает, что происходило раньше: вычисления выполняет бэкенд, а фронтенд возвращает управление Python.
PaddlePaddle: По результатам бенчмарка PaddlePaddle работает быстрее на несколько порядков. Скалярное произведение NumPy выполняется на CPU, а матричное умножение PaddlePaddle — на GPU, и оно значительно быстрее. Но такой огромный разрыв во времени говорит о том, что есть и другая причина. По умолчанию GPU-операции в PaddlePaddle асинхронны. Принудительное ожидание завершения всех вычислений перед возвратом результата показывает, что происходило раньше: вычисления выполняет бэкенд, а фронтенд возвращает управление Python.
MXNet:
with d2l.Benchmark():
for _ in range(10):
a = np.random.normal(size=(1000, 1000))
b = np.dot(a, a)
npx.waitall()
PyTorch:
with d2l.Benchmark():
for _ in range(10):
a = torch.randn(size=(1000, 1000), device=device)
b = torch.mm(a, a)
torch.cuda.synchronize(device)
PaddlePaddle:
with d2l.Benchmark():
for _ in range(10):
a = paddle.randn(shape=(1000, 1000))
b = paddle.mm(a, a)
paddle.device.cuda.synchronize()
MXNet: В общих чертах MXNet состоит из фронтенда — интерфейса для прямого взаимодействия с пользователем, например через Python, — и бэкенда, которым система выполняет вычисления. Как показано на рис. 12.2.1, программы MXNet можно писать на разных языках: Python, R, Scala и C++. Независимо от языка фронтенда выполнение программы MXNet происходит в основном в бэкенде, реализованном на C++. Операции, которые отправляет фронтенд, передаются в бэкенд на выполнение. Бэкенд управляет собственными потоками, которые непрерывно забирают из очереди и выполняют задачи. Чтобы это работало, бэкенд должен отслеживать зависимости между шагами вычислительного графа. Поэтому невозможно распараллелить операции, которые зависят друг от друга.
PyTorch: В общих чертах PyTorch состоит из фронтенда — интерфейса для прямого взаимодействия с пользователем, например через Python, — и бэкенда, которым система выполняет вычисления. Как показано на рис. 12.2.1, программы PyTorch можно писать на разных языках, например на Python и C++. Независимо от языка фронтенда выполнение программы PyTorch происходит в основном в бэкенде, реализованном на C++. Операции, которые отправляет фронтенд, передаются в бэкенд на выполнение. Бэкенд управляет собственными потоками, которые непрерывно забирают из очереди и выполняют задачи. Чтобы это работало, бэкенд должен отслеживать зависимости между шагами вычислительного графа. Поэтому невозможно распараллелить операции, которые зависят друг от друга.
PaddlePaddle: В общих чертах PaddlePaddle состоит из фронтенда — интерфейса для прямого взаимодействия с пользователем, например через Python, — и бэкенда, которым система выполняет вычисления. Как показано на рис. 12.2.1, программы PaddlePaddle можно писать на разных языках: в основном на Python и C++. Независимо от языка фронтенда выполнение программы PaddlePaddle происходит в основном в бэкенде, реализованном на C++. Операции, которые отправляет фронтенд, передаются в бэкенд на выполнение. Бэкенд управляет собственными потоками, которые непрерывно забирают из очереди и выполняют задачи. Чтобы это работало, бэкенд должен отслеживать зависимости между шагами вычислительного графа. Поэтому невозможно распараллелить операции, которые зависят друг от друга.
Рис. 12.2.1. Языковые фронтенды и бэкенд фреймворка глубокого обучения
Рассмотрим ещё один простой пример, чтобы лучше понять граф зависимостей.
MXNet:
x = np.ones((1, 2))
y = np.ones((1, 2))
z = x * y + 2
z
PyTorch:
x = torch.ones((1, 2), device=device)
y = torch.ones((1, 2), device=device)
z = x * y + 2
z
PaddlePaddle:
x = paddle.ones((1, 2))
y = paddle.ones((1, 2))
z = x * y + 2
z
Рис. 12.2.2. Бэкенд отслеживает зависимости между шагами вычислительного графа
Этот фрагмент кода проиллюстрирован на рис. 12.2.2. Каждый раз, когда поток Python-фронтенда выполняет одну из первых трёх строк, он лишь передаёт задачу в очередь бэкенда. Когда результат последней строки нужно вывести, поток Python-фронтенда ждёт, пока поток бэкенда на C++ вычислит значение переменной z. Преимущество такой схемы в том, что поток фронтенда не выполняет сами вычисления. Поэтому производительность Python почти не влияет на общую производительность программы. На рис. 12.2.3 показано, как фронтенд и бэкенд взаимодействуют.
Рис. 12.2.3. Взаимодействие фронтенда и бэкенда
12.2.2 Барьеры и блокировки
MXNet: Есть несколько операций, которые заставляют Python ждать завершения вычислений:
- самая очевидная —
npx.waitall(): она не учитывает момент отправки команд и ждёт, пока завершатся все вычисления. На практике этой операцией лучше не злоупотреблять, если нет крайней необходимости, так как она может заметно снизить производительность; - если нужно дождаться готовности только одной конкретной переменной, можно вызвать
z.wait_to_read(). В этом случае MXNet не возвращает управление Python до тех пор, пока не будет вычислена переменнаяz. Вычисления, которые зависят отz, могут продолжиться после этого.
Посмотрим, как это работает на практике.
MXNet:
with d2l.Benchmark('waitall'):
b = np.dot(a, a)
npx.waitall()
with d2l.Benchmark('wait_to_read'):
b = np.dot(a, a)
b.wait_to_read()
MXNet: Обе операции завершаются примерно за одно и то же время. Помимо явных блокировок, стоит помнить о неявных блокировках. Печать переменной — это блокировка, потому что для вывода значение должно быть готово. Кроме того, преобразование переменной в NumPy-массив через z.asnumpy() и в скаляр через z.item() тоже блокирующие операции. В NumPy нет понятия асинхронности, поэтому доступ к значениям требует ожидания, как и в функции print.
Частое копирование небольших объёмов данных из области MXNet в NumPy может испортить производительность даже эффективного кода: каждая такая операция требует вычислить все промежуточные результаты графа, чтобы получить нужные значения, и только потом можно делать что-то ещё.
MXNet:
with d2l.Benchmark('numpy conversion'):
b = np.dot(a, a)
b.asnumpy()
with d2l.Benchmark('scalar conversion'):
b = np.dot(a, a)
b.sum().item()
12.2.3 Улучшение вычислений
MXNet: В системах с сильной многопоточностью (даже обычный ноутбук имеет четыре и более потоков, а на многопроцессорных серверах их может быть больше 256) стоимость планирования операций может стать очень большой. Поэтому так важно, чтобы вычисления и планирование были асинхронными и параллельными. Чтобы показать пользу этого подхода, сравним, что происходит при последовательном (синхронном) и асинхронном выполнении многократного увеличения переменной на . Синхронное выполнение имитируется вставкой барьера wait_to_read между сложениями.
with d2l.Benchmark('synchronous'):
for _ in range(10000):
y = x + 1
y.wait_to_read()
with d2l.Benchmark('asynchronous'):
for _ in range(10000):
y = x + 1
npx.waitall()
Упрощённо взаимодействие потока Python-фронтенда и потока бэкенда на C++ можно описать так:
- фронтенд отправляет бэкенду команду поставить в очередь вычисление
y = x + 1; - затем бэкенд получает вычислительную задачу из очереди и выполняет её;
- затем бэкенд возвращает результат вычисления фронтенду.
Пусть длительности этих трёх этапов равны . Без асинхронного программирования общее время выполнения 10 000 вычислений составляет примерно . При асинхронном программировании фронтенду не нужно ждать, пока бэкенд вернёт результат каждой итерации, поэтому общее время выполнения 10 000 вычислений сокращается до (при условии ).
Резюме
- Фреймворки глубокого обучения отделяют управление в Python-фронтенде от выполнения в бэкенде, поэтому команды можно быстро и асинхронно ставить в очередь бэкенда, где они выполняются параллельно.
- Асинхронность даёт достаточно гибкий фронтенд, но имейте в виду: слишком длинная очередь задач может привести к чрезмерному потреблению памяти. Рекомендуется синхронизировать выполнение на каждом минибатче, чтобы фронтенд и бэкенд работали примерно синхронно.
- Производители чипов предлагают сложные инструменты профилирования, которые позволяют точнее понять эффективность глубокого обучения.
MXNet:
- Преобразование памяти, управляемой MXNet, в Python заставляет бэкенд ждать готовности конкретных переменных. Такой же эффект имеют функции
print,asnumpyиitem. Обратите внимание: неправильное использование синхронизации может испортить производительность программы.
Упражнения
MXNet:
- Выше говорилось, что с асинхронными вычислениями общее время выполнения 10 000 вычислений сокращается до . Почему мы предполагаем, что ?
- Измерьте разницу между
waitallиwait_to_read. Подсказка: выполните несколько инструкций и синхронизируйтесь, чтобы получить промежуточные результаты.
PyTorch:
- Проведите бенчмарк той же операции умножения матриц из этого раздела на CPU. Можно ли по-прежнему наблюдать асинхронность через бэкенд?
PaddlePaddle:
- Проведите бенчмарк той же операции умножения матриц из этого раздела на CPU. Можно ли по-прежнему наблюдать асинхронность через бэкенд?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
12.3 Автоматическое распараллеливание
Фреймворки глубокого обучения (например, MXNet, PaddlePaddle и PyTorch) автоматически строят вычислительный граф в бэкенде. Благодаря графу система знает все зависимости и может по выбору выполнять параллельно несколько независимых задач, чтобы ускорить вычисления. Например, на рис. 12.2.2 из раздела 12.2 две переменные инициализируются независимо друг от друга, поэтому система может выполнить эти операции параллельно.
Обычно одна операция использует все вычислительные ресурсы CPU или одного GPU. Например, даже если на машине несколько процессоров CPU, операция dot задействует все ядра (и потоки) всех CPU. То же относится к одному GPU. Поэтому распараллеливание почти не даёт выигрыша на компьютере с одним устройством, а на нескольких устройствах оно становится важным. Хотя распараллеливание обычно применяют к нескольким GPU, добавление локального CPU тоже немного повышает производительность. Например, в работе (Hadjis et al., 2016) обучение, которое одновременно использует GPU и CPU, применяется к моделям компьютерного зрения. Благодаря удобству фреймворка автоматического распараллеливания ту же цель можно достичь несколькими строками кода Python. Обсуждение автоматических параллельных вычислений в основном посвящено параллельным вычислениям на CPU и GPU, а также распараллеливанию вычислений и коммуникации.
Обратите внимание, что для запуска экспериментов из этого раздела нужно как минимум два GPU.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import numpy as np
12.3.1 Параллельные вычисления на GPU
Начнём с определения эталонной тестовой нагрузки: функция run выполняет умножений «матрица на матрицу», а данные для них размещаются в двух переменных (x_gpu1 и x_gpu2), которые находятся на разных выбранных устройствах.
MXNet:
devices = d2l.try_all_gpus()
def run(x):
return [x.dot(x) for _ in range(50)]
x_gpu1 = np.random.uniform(size=(4000, 4000), ctx=devices[0])
x_gpu2 = np.random.uniform(size=(4000, 4000), ctx=devices[1])
PyTorch:
devices = d2l.try_all_gpus()
def run(x):
return [x.mm(x) for _ in range(50)]
x_gpu1 = torch.rand(size=(4000, 4000), device=devices[0])
x_gpu2 = torch.rand(size=(4000, 4000), device=devices[1])
PaddlePaddle:
devices = d2l.try_all_gpus()
def run(x, index=0):
paddle.set_device(f"gpu:{index}")
return [x.matmul(x) for _ in range(50)]
data = np.random.rand(4000, 4000)
x_gpu1 = paddle.to_tensor(data, place=devices[0])
x_gpu2 = paddle.to_tensor(data, place=devices[1])
MXNet: Теперь используем функции для обработки данных. Чтобы кэш не повлиял на итоговый результат, перед измерением нужно прогреть устройство: выполнить один проход.
PyTorch: Теперь используем функции для обработки данных. Чтобы кэш не повлиял на итоговый результат, перед измерением нужно прогреть устройство: выполнить один проход. Функция torch.cuda.synchronize() ждёт завершения вычислений всех ядер во всех потоках CUDA-устройства. Функция принимает аргумент device, который задаёт, какое устройство нужно синхронизировать. Если device равен None (значение по умолчанию), используется текущее устройство, которое возвращает current_device().
PaddlePaddle: Теперь используем функции для обработки данных. Чтобы кэш не повлиял на итоговый результат, перед измерением прогреваем устройство: выполняем один проход. Функция paddle.device.cuda.synchronize() ждёт завершения вычислений всех ядер во всех потоках CUDA-устройства. Функция принимает аргумент device, который задаёт, какое устройство нужно синхронизировать. Если device равен None (значение по умолчанию), используется текущее устройство, которое возвращает current_device().
MXNet:
run(x_gpu1) # Прогрев устройства
run(x_gpu2)
npx.waitall()
with d2l.Benchmark('время GPU1'):
run(x_gpu1)
npx.waitall()
with d2l.Benchmark('время GPU2'):
run(x_gpu2)
npx.waitall()
PyTorch:
run(x_gpu1)
run(x_gpu2) # Прогрев устройства
torch.cuda.synchronize(devices[0])
torch.cuda.synchronize(devices[1])
with d2l.Benchmark('время GPU1'):
run(x_gpu1)
torch.cuda.synchronize(devices[0])
with d2l.Benchmark('время GPU2'):
run(x_gpu2)
torch.cuda.synchronize(devices[1])
PaddlePaddle:
run(x_gpu1, 0)
run(x_gpu2, 1) # Прогрев устройства
paddle.device.cuda.synchronize(devices[0])
paddle.device.cuda.synchronize(devices[1])
with d2l.Benchmark('время GPU1'):
run(x_gpu1, 0)
paddle.device.cuda.synchronize(devices[0])
with d2l.Benchmark('время GPU2'):
run(x_gpu2, 1)
paddle.device.cuda.synchronize(devices[1])
MXNet: Если удалить waitall между двумя задачами, система сможет автоматически выполнить вычисления на двух устройствах параллельно.
PyTorch: Если удалить synchronize между двумя задачами, система сможет автоматически выполнить вычисления на двух устройствах параллельно.
PaddlePaddle: Если удалить synchronize между двумя задачами, система сможет автоматически выполнить вычисления на двух устройствах параллельно.
MXNet:
with d2l.Benchmark('GPU1 & GPU2'):
run(x_gpu1)
run(x_gpu2)
npx.waitall()
PyTorch:
with d2l.Benchmark('GPU1 & GPU2'):
run(x_gpu1)
run(x_gpu2)
torch.cuda.synchronize()
PaddlePaddle:
with d2l.Benchmark('GPU1 & GPU2'):
run(x_gpu1, 0)
run(x_gpu2, 1)
paddle.device.cuda.synchronize()
В этом случае общее время выполнения меньше суммы времён выполнения обеих частей, потому что фреймворк глубокого обучения автоматически планирует вычисления на двух GPU, и пользователю не нужно писать для этого сложный код.
12.3.2 Параллельные вычисления и коммуникация
Во многих случаях данные нужно переносить между разными устройствами: между CPU и GPU или между разными GPU. Например, при распределённой оптимизации нужно переносить данные, чтобы объединить градиенты с нескольких ускорителей. Смоделируем этот процесс: выполним вычисления на GPU, а затем скопируем результат обратно на CPU.
MXNet:
def copy_to_cpu(x):
return [y.copyto(npx.cpu()) for y in x]
with d2l.Benchmark('выполнение на GPU1'):
y = run(x_gpu1)
npx.waitall()
with d2l.Benchmark('копирование на CPU'):
y_cpu = copy_to_cpu(y)
npx.waitall()
PyTorch:
def copy_to_cpu(x, non_blocking=False):
return [y.to('cpu', non_blocking=non_blocking) for y in x]
with d2l.Benchmark('выполнение на GPU1'):
y = run(x_gpu1)
torch.cuda.synchronize()
with d2l.Benchmark('копирование на CPU'):
y_cpu = copy_to_cpu(y)
torch.cuda.synchronize()
PaddlePaddle:
def copy_to_cpu(x):
return [paddle.to_tensor(y, place=paddle.CPUPlace()) for y in x]
with d2l.Benchmark('выполнение на GPU1'):
y = run(x_gpu1, 0)
paddle.device.cuda.synchronize()
with d2l.Benchmark('копирование на CPU'):
y_cpu = copy_to_cpu(y)
paddle.device.cuda.synchronize()
MXNet: Этот способ неэффективен. Заметим, что части y можно начать копировать на CPU ещё до того, как вычислена остальная часть списка. Например, при вычислении градиентов для минибатча градиенты одних параметров готовы раньше, чем градиенты других. Поэтому выгодно начать передавать данные по шине PCI-Express, пока GPU ещё работает. Чтобы смоделировать этот сценарий, удалим waitall между этими двумя частями.
PyTorch: Этот способ неэффективен. Заметим, что части y можно начать копировать на CPU ещё до того, как вычислена остальная часть списка. Например, при вычислении (обратного распространения) градиентов для минибатча градиенты одних параметров готовы раньше, чем градиенты других. Поэтому выгодно начать передавать данные по шине PCI-Express, пока GPU ещё работает. В PyTorch такие функции, как to() и copy_(), принимают явный параметр non_blocking. Если он равен True, вызывающий код может не дожидаться синхронизации, когда она не нужна. Установим non_blocking=True, чтобы смоделировать этот сценарий.
PaddlePaddle: Этот способ неэффективен. Заметим, что части y можно начать копировать на CPU ещё до того, как вычислена остальная часть списка. Например, при вычислении (обратного распространения) градиентов для минибатча градиенты одних параметров готовы раньше, чем градиенты других. Поэтому выгодно начать передавать данные по шине PCI-Express, пока GPU ещё работает.
MXNet:
with d2l.Benchmark('выполнение на GPU1 и копирование на CPU'):
y = run(x_gpu1)
y_cpu = copy_to_cpu(y)
npx.waitall()
PyTorch:
with d2l.Benchmark('выполнение на GPU1 и копирование на CPU'):
y = run(x_gpu1)
y_cpu = copy_to_cpu(y, True)
torch.cuda.synchronize()
PaddlePaddle:
with d2l.Benchmark('выполнение на GPU1 и копирование на CPU'):
y = run(x_gpu1)
y_cpu = copy_to_cpu(y)
paddle.device.cuda.synchronize()
Общее время двух операций меньше суммы времён их частей. Заметим разницу с параллельными вычислениями: здесь операции используют разные ресурсы, а именно шину между CPU и GPU. Фактически мы можем одновременно выполнять вычисления и коммуникацию на двух устройствах. Как было сказано выше, между вычислением и копированием есть зависимость: сначала нужно вычислить y[i], и только потом его можно скопировать на CPU. К счастью, система может копировать y[i-1], пока вычисляется y[i], что сокращает общее время выполнения.
Наконец, в этом разделе приведён пример вычислительного графа и его зависимостей для простого двухслойного многослойного перцептрона, обучаемого на CPU и двух GPU, как показано на рис. 12.3.1. Вручную распланировать полученную параллельную программу было бы очень трудно. Именно здесь проявляется преимущество графового вычислительного бэкенда, который выполняет оптимизацию.
Рис. 12.3.1. Вычислительный граф двухслойного многослойного перцептрона на одном CPU и двух GPU и его зависимости
Резюме
- Современные системы содержат множество устройств, таких как несколько GPU и несколько CPU. Их можно использовать параллельно и асинхронно.
- В современных системах есть и разнообразные ресурсы коммуникации, например PCI Express, хранилище (обычно твердотельный накопитель или сетевое хранилище) и сетевая пропускная способность. Для достижения наибольшей эффективности их тоже можно использовать параллельно.
- Бэкенд может повысить производительность, автоматически распараллеливая вычисления и коммуникацию.
Упражнения
- В функции
run, определённой в этом разделе, выполняется восемь операций, и между ними нет зависимостей. Спроектируйте эксперимент, чтобы проверить, будут ли фреймворки глубокого обучения выполнять их параллельно автоматически. - Когда объём работы одной операции достаточно мал, распараллеливание может помочь даже на одном CPU или GPU. Спроектируйте эксперимент, который это проверит.
- Спроектируйте эксперимент, в котором параллельные вычисления и коммуникация используются одновременно на CPU и GPU.
- Используйте отладчик, например Nsight от NVIDIA, чтобы проверить, что код работает так, как задумано.
- Спроектируйте и проведите эксперименты с более сложными вычислительными задачами с зависимостями по данным, чтобы проверить, можно ли повысить производительность и при этом получить правильный результат.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Hadjis, S., Zhang, C., Mitliagkas, I., Iter, D., & Ré, C. (2016). Omnivore: An optimizer for multi-device deep learning on CPUs and GPUs. arXiv preprint arXiv:1606.04487.
12.4 Аппаратное обеспечение
Чтобы строить системы с хорошей производительностью и улавливать статистические особенности задачи, нужно хорошо понимать алгоритмы и модели. При этом необходимо хотя бы примерно представлять, как устроено нижележащее аппаратное обеспечение. Этот раздел не заменяет курсов по проектированию аппаратуры и систем. Скорее, он служит отправной точкой для понимания того, почему одни алгоритмы работают эффективнее других и как добиться хорошей пропускной способности. Хорошо продуманная конструкция может дать разницу на порядки: одна и та же сеть либо обучается за одну неделю, либо не обучается вовсе, когда на обучение уходит три месяца и срок сдачи оказывается сорван. Начнём с компьютера в целом, затем подробно рассмотрим CPU и GPU, а в конце посмотрим, как соединяются между собой несколько компьютеров в дата-центре или в облаке.
Рис. 12.4.1. Инфографика «Задержки, которые должен знать каждый программист» (из интерактивной публикации Колина Скотта по данным лекции Джеффа Дина, Stanford, 2010) не включена в перевод. Её данные приведены в таблицах 12.4.1 и 12.4.2 ниже
Общее представление о порядках величин даёт инфографика выше, а также таблицы в конце этого раздела. Они основаны на исследовании, которое отражает прогресс последнего десятилетия. Ниже обсуждаются базовые принципы этих чисел и то, как они помогают выбирать алгоритмы. Обсуждение очень общее и приблизительное. Разумеется, оно не заменяет полноценный курс, а лишь даёт статистическим моделистам достаточно сведений, чтобы принимать обоснованные проектные решения. Для углублённого знакомства с архитектурой компьютеров рекомендуем (Hennessy and Patterson, 2011) или актуальный курс по этой теме, например курс Krste Asanović.
12.4.1 Компьютер
Большинство исследователей и практиков глубокого обучения могут работать на компьютере с достаточным объёмом памяти, вычислительными ресурсами и каким-либо ускорителем, например одним или несколькими GPU. Компьютер состоит из следующих ключевых компонентов:
- процессор (также называемый CPU), который, помимо работы операционной системы и многих других функций, выполняет заданные программы. Обычно он содержит или более ядер;
- оперативная память (RAM), в которой хранятся и из которой извлекаются результаты вычислений: векторы весов, параметры активаций, а также обучающие данные;
- один или несколько сетевых интерфейсов Ethernet, скорость которых варьируется от 1 ГБ/с до 100 ГБ/с. На высокопроизводительных серверах могут использоваться более совершенные соединения;
- высокоскоростная шина расширения (PCIe), которая связывает систему с одним или несколькими GPU. Серверы поддерживают до ускорителей, обычно соединённых по более сложной топологии, а настольные системы имеют или ускорителя в зависимости от бюджета пользователя и мощности блока питания;
- энергонезависимые устройства хранения, например жёсткие диски и твердотельные накопители, которые во многих случаях подключаются через высокоскоростную шину расширения. Они обеспечивают достаточную скорость передачи для обучающих данных и промежуточных контрольных точек.
Рис. 12.4.2. Соединение компонентов компьютера
Как показано на рис. 12.4.2, высокоскоростная шина расширения состоит из нескольких линий, которые напрямую подключены к CPU и связывают его с большинством компонентов: сетью, GPU и хранилищем. Например, у AMD Threadripper 3 есть линии PCIe 4.0, каждая из которых может передавать данные в обоих направлениях со скоростью 16 Гбит/с. Память напрямую подключена к CPU, а её суммарная пропускная способность достигает 100 ГБ/с.
Когда мы запускаем код на компьютере, данные нужно передать процессору (CPU или GPU) для вычислений, а затем вернуть результаты в оперативную и постоянную память. Поэтому для хорошей производительности нужно, чтобы все шаги работы стыковались без задержек и ни одна часть системы не становилась узким местом. Например, если изображения загружаются медленно, процессор будет простаивать. Точно так же, если матрицы медленно передаются в CPU (или GPU), вычислительное устройство не сможет работать на полной скорости. Наконец, если нужно синхронизировать несколько компьютеров по сети, сеть не должна замедлять вычисления. Один из вариантов — чередовать коммуникацию и вычисления. Далее мы подробнее рассмотрим каждый компонент.
12.4.2 Память
Ключевые характеристики оперативной памяти — пропускная способность (bandwidth) и задержка (latency). То же справедливо и для устройств хранения, только различия между ними могут быть гораздо больше.
12.4.2.1 Жёсткие диски
Жёсткий диск (hard disk drive, HDD) используется уже полвека. Проще говоря, он содержит множество вращающихся пластин, над которыми может быть установлена головка для чтения и записи на любой заданной дорожке. Старшие модели вмещают до 16 ТБ на девяти пластинах. Одно из главных достоинств жёсткого диска — относительно низкая цена, а его многочисленные недостатки — характерные катастрофические режимы отказа и довольно высокая задержка чтения.
Чтобы понять последнее, нужно знать, что жёсткие диски вращаются примерно со скоростью 7200 оборотов в минуту. Быстрее вращать их нельзя: центробежная сила разрушила бы пластины. При обращении к определённому сектору диска есть ещё одна существенная проблема: нужно дождаться, пока пластина повернётся нужным местом под головку (головку можно перемещать, а раскрутить диск заново нельзя). Поэтому на получение нужных данных может уйти миллисекунд. Обычно говорят, что жёсткий диск работает примерно со скоростью 100 IOPS (операций ввода-вывода в секунду), и за последние двадцать лет эта цифра почти не изменилась. Не менее неприятно и то, что пропускная способность (около 100–200 МБ/с) тоже плохо растёт. Ведь каждая головка считывает биты одной дорожки, поэтому скорость передачи растёт лишь пропорционально квадратному корню из плотности записи. Поэтому для очень больших наборов данных жёсткие диски быстро переходят в роль архивного и низкоуровневого хранилища.
12.4.2.2 Твердотельные накопители
Твердотельные накопители (solid state drives, SSD) хранят информацию во флеш-памяти. Это позволяет получать сохранённые записи гораздо быстрее. Современные SSD способны выполнять – тысяч IOPS, то есть примерно на три порядка быстрее жёстких дисков. Их пропускная способность составляет 1–3 ГБ/с, то есть примерно на порядок выше. Эти улучшения кажутся невероятными, но из-за особенностей устройства SSD у них остаются следующие дополнительные ограничения.
- SSD хранят информацию блоками (256 КБ и больше). Блок можно записать только целиком, поэтому запись отдельных битов в случайном порядке занимает много времени и производительность SSD при таком режиме очень низкая. Кроме того, запись часто требует много времени, потому что блок нужно сначала прочитать, стереть, а затем записать заново с новой информацией. Контроллеры и прошивка современных SSD уже содержат алгоритмы, которые смягчают эту проблему. Тем не менее запись всё равно остаётся гораздо медленнее чтения, особенно у накопителей QLC (четырёхуровневых ячеек). Ключ к производительности — поддерживать очередь операций, в которой чтение и запись крупных блоков по возможности выполняются в первую очередь;
- ячейки памяти в SSD изнашиваются довольно быстро (обычно после нескольких тысяч циклов записи). Алгоритмы выравнивания износа распределяют деградацию между многими ячейками. Поэтому SSD не рекомендуется использовать для файлов подкачки или больших журналов;
- наконец, резкий рост пропускной способности вынудил разработчиков компьютеров подключать SSD к шине PCIe. Такие накопители называют NVMe (энергонезависимая память с расширенным интерфейсом); они могут использовать до линий PCIe. На PCIe 4.0 их скорость достигает 8 ГБ/с.
12.4.2.3 Облачное хранилище
Облачное хранилище предлагает набор настраиваемых характеристик производительности. Иными словами, объём и скорость хранилища виртуальной машины можно динамически подбирать под потребности пользователя. Если задержка слишком велика (например, при обучении с большим количеством мелких записей), рекомендуется увеличить количество IOPS в настройках.
12.4.3 CPU
Центральный процессор (central processing unit, CPU) — основа любого компьютера. Он состоит из многих ключевых компонентов: ядер процессора (processor cores), которые выполняют машинный код; шины (bus), которая связывает разные компоненты (шины заметно различаются в зависимости от модели процессора, поколения и производителя); кэша (cache), который обеспечивает более высокую пропускную способность чтения и меньшую задержку по сравнению с основной памятью. Наконец, поскольку высокопроизводительная линейная алгебра и свёртки широко используются в обработке мультимедиа и машинном обучении, почти все современные CPU содержат векторный процессорный блок (vector processing unit), который помогает выполнять эти вычисления.
Рис. 12.4.3. Потребительский четырёхъядерный CPU Intel Skylake
На рис. 12.4.3 показан потребительский четырёхъядерный CPU Intel Skylake. Он включает встроенный GPU, кэш и кольцевую шину, которая соединяет четыре ядра. Периферийные устройства, такие как Ethernet, Wi-Fi, Bluetooth, контроллер SSD и USB, либо входят в состав чипсета, либо подключаются к CPU напрямую через PCIe.
12.4.3.1 Микроархитектура
Каждое ядро процессора состоит из довольно сложного набора компонентов. Хотя подробности у разных поколений и производителей различаются, базовые функции стандартны. Фронтенд загружает инструкции и пытается предсказать, по какому пути они пойдут (например, для управления потоком), а затем декодирует инструкции из ассемблерного кода в микроинструкции. Ассемблерный код обычно не является самым низкоуровневым кодом, который выполняет процессор: сложные микроинструкции могут декодироваться в набор более простых операций, которые затем обрабатываются исполнительными ядрами. Обычно исполнительное ядро способно одновременно выполнять много операций. Например, ядро ARM Cortex A77 на рис. 12.4.4 может одновременно выполнять до операций.
Рис. 12.4.4. Микроархитектура ARM Cortex A77
Это означает, что эффективная программа может выполнять несколько инструкций за один такт, если эти инструкции независимы друг от друга. Не все блоки обработки одинаковы: одни предназначены для целочисленных инструкций, а другие оптимизированы для операций с плавающей точкой. Чтобы повысить пропускную способность, процессор может одновременно выполнять несколько путей кода в ветвлениях, а затем отбрасывать результаты невыбранных ветвей. Поэтому блок предсказания ветвлений во фронтенде важен: дальше продолжается выполнение только самых перспективных путей.
12.4.3.2 Векторизация
Объём вычислений в глубоком обучении очень велик. Поэтому, чтобы справляться с задачами машинного обучения, CPU должен выполнять много операций за один такт. Такой режим работы обеспечивают векторные процессорные блоки. На ARM они называются NEON, а на x86 — AVX2. Типичная их возможность — выполнение операций по схеме SIMD (single instruction multiple data, одна инструкция — много данных). На рис. 12.4.5 показано, как на ARM за один такт выполняется целочисленных сложений.
Рис. 12.4.5. 128-битная векторизация NEON
В зависимости от архитектуры такие регистры могут достигать бит и объединять до пар чисел. Например, можно перемножить два числа и прибавить к результату третье. Эта операция называется слиянием умножения и сложения (fused multiply-add). Intel OpenVINO использует именно эти процессоры, чтобы получать ощутимую пропускную способность при глубоком обучении на серверных CPU. Однако стоит отметить, что по сравнению с возможностями GPU эта цифра выглядит скромно. Например, у NVIDIA RTX 2080 Ti есть CUDA-ядра, каждое из которых может выполнять такую операцию в любой момент.
12.4.3.3 Кэш
Рассмотрим такой случай: у нас есть CPU среднего размера с ядрами, как показано на рис. 12.4.3, работающий на частоте 2 ГГц. Пусть векторный процессорный блок поддерживает AVX2 с шириной бит, а количество инструкций за такт (IPC) равно 1. Предположим также, что для каждой операции AVX2 хотя бы один регистр должен получить инструкцию из памяти. Тогда CPU потребляет данных за каждый такт. Если мы не сможем передавать процессору байт в секунду, он будет испытывать нехватку данных. К сожалению, интерфейс памяти этого чипа поддерживает только 20–40 Гбит/с, то есть на порядок меньше. Выход — по возможности не загружать новые данные из памяти, а хранить их в кэше CPU. Для этого и используется кэш. Обычно он состоит из следующих уровней.
- Регистры строго говоря не относятся к кэшу. Они помогают организовать выполнение инструкций. То есть регистры — это места хранения, к которым CPU обращается на тактовой скорости без задержки. У CPU есть несколько десятков регистров, поэтому эффективное их использование зависит от компилятора (или программиста). Например, в языке C есть ключевое слово
register; - кэш первого уровня (L1) — первый рубеж защиты от высоких требований к пропускной способности памяти. Он очень мал (обычно 32–64 КБ) и делится на данные и инструкции. Если нужные данные найдены в кэше L1, доступ к ним очень быстрый. Если их там нет, поиск продолжается вниз по иерархии кэша;
- кэш второго уровня (L2) — следующий уровень. В зависимости от архитектуры и размера процессора он может быть эксклюзивным или общим, то есть использоваться только одним ядром либо разделяться между несколькими ядрами. Кэш L2 больше L1 (обычно 256–512 КБ на ядро), но медленнее. Кроме того, сначала нужно проверить, что данных нет в L1, и только потом обращаться к L2, что добавляет небольшую задержку;
- кэш третьего уровня (L3) разделяется между несколькими ядрами и может быть очень большим. Серверные CPU AMD EPYC 3 имеют до 256 МБ кэша на нескольких кристаллах. Более типичные значения — 4–8 МБ.
Предсказание того, какие данные понадобятся дальше, — один из ключевых параметров при проектировании чипа. Например, рекомендуется обходить память вперёд, поскольку большинство алгоритмов кэширования пытаются читать данные заранее по возрастанию адресов, а не назад. Кроме того, хорошим способом повысить производительность является сохранение локальности обращений к памяти.
Добавление кэша — палка о двух концах. С одной стороны, он гарантирует, что ядрам процессора не будет не хватать данных. С другой стороны, он увеличивает размер чипа и занимает площадь, которую можно было бы использовать для повышения вычислительной мощности. Кроме того, промах кэша может оказаться очень дорогим. Рассмотрим худший случай — ложное разделение (false sharing), показанное на рис. 12.4.6. Когда поток на процессоре запрашивает данные, ячейка памяти кэширована на процессоре . Чтобы удовлетворить запрос, процессор должен приостановить текущую работу, записать данные обратно в основную память, и только после этого процессор может прочитать их из памяти. На время этой операции оба процессора простаивают. По сравнению с эффективной однопроцессорной реализацией такой код на нескольких процессорах может работать значительно медленнее. Это ещё одна причина, по которой размер кэша ограничен, помимо его физического размера.
Рис. 12.4.6. Ложное разделение (иллюстрация предоставлена Intel)
12.4.4 GPU и другие ускорители
Без GPU глубокого обучения не было бы. Не будет преувеличением сказать, что именно глубокое обучение заметно увеличило доходы производителей GPU. Эта совместная эволюция аппаратуры и алгоритмов привела к тому, что глубокое обучение стало, к лучшему или к худшему, предпочтительной парадигмой статистического моделирования. Поэтому полезно понимать, в чём преимущества GPU и других ускорителей, например TPU (Jouppi et al., 2017).
На практике часто важно различие между ускорителями, оптимизированными для обучения, и теми, что оптимизированы для вывода (инференса). Для вывода достаточно вычислить прямое распространение в сети. Обратное распространение не требует хранения промежуточных данных. Кроме того, часто не нужна очень высокая точность вычислений (обычно достаточно FP16 или INT8). При обучении все промежуточные результаты нужно хранить, чтобы вычислять градиенты. Накопление градиентов также требует более высокой точности, чтобы избежать численного антипереполнения (или переполнения). Поэтому минимальный вариант — FP16 или смешанная точность FP16/FP32. Всё это требует более быстрой и более ёмкой памяти (HBM2 или GDDR6) и большей вычислительной мощности. Например, NVIDIA оптимизировала GPU Turing T4 для вывода, а GPU V100 — для обучения.
Вспомним векторизацию, показанную на рис. 12.4.5. Добавление векторных процессорных блоков в ядра CPU заметно повышает пропускную способность. Например, в примере на рис. 12.4.5 можно одновременно выполнить операций. Во-первых, что даст добавление операций, оптимизированных не только для векторных, но и для матричных вычислений? Позже мы обсудим тензорные ядра (tensor cores), созданные по этой стратегии. Во-вторых, что если добавить больше ядер? Коротко говоря, это две стратегии проектирования GPU. На рис. 12.4.7 показан общий вид базового блока обработки.
Рис. 12.4.7. Блок обработки NVIDIA Turing (иллюстрация производителя) не включена в перевод. Блок содержит целочисленных и блоков с плавающей точкой, а также два тензорных ядра, которые ускоряют узкий набор операций глубокого обучения. Каждый потоковый мультипроцессор состоит из четырёх таких блоков
Далее потоковых мультипроцессоров объединяются в графические кластеры, из которых строится высокопроизводительный процессор TU102. Достаточное количество каналов памяти и кэш второго уровня дополняют конфигурацию. Подробности приведены на рис. 12.4.8. Причина такого проектирования — возможность независимо добавлять или удалять модули, что помогает создавать более компактные чипы и учитывать выход годных кристаллов (неисправные модули могут не включаться). К счастью, программирование таких устройств скрыто за CUDA и уровнем фреймворков, так что исследователь в глубоком обучении обычно этого не замечает. В частности, на GPU можно одновременно выполнять несколько программ, пока есть свободные ресурсы. Тем не менее полезно знать ограничения устройства, чтобы не выбрать модель памяти, которая не подходит по размеру.
Рис. 12.4.8. Архитектура NVIDIA Turing (иллюстрация производителя) не включена в перевод. Она показывает кластеры потоковых мультипроцессоров, каналы памяти и кэш второго уровня
Наконец, стоит отдельно упомянуть тензорные ядра (tensor cores). Они являются примером растущей тенденции добавлять специализированные схемы оптимизации, которые особенно эффективны для глубокого обучения. Например, в TPU добавлена систолическая матрица для быстрого умножения матриц (Kung, 1988). Она рассчитана на очень большие операции над очень малым количеством данных (в TPU первого поколения — на одну величину). Тензорные ядра идут в противоположном направлении: они оптимизированы для небольших операций над матрицами размером и в зависимости от числовой точности. Обзор оптимизаций приведён на рис. 12.4.9.
Рис. 12.4.9. Тензорные ядра в архитектуре NVIDIA Turing (иллюстрация производителя) не включена в перевод
Очевидно, что при оптимизации вычислений приходится идти на некоторые компромиссы. Один из них: GPU плохо справляются с разреженными данными и прерываниями. Хотя есть заметные исключения, например Gunrock (Wang et al., 2016), высокая пропускная способность GPU при чтении пакетами не подходит для шаблонов доступа к разреженным матрицам и векторам. Задачи эффективного доступа к разреженным данным и обработки прерываний активно исследуются. Например, существует библиотека DGL, созданная специально для глубокого обучения на графах.
12.4.5 Сеть и шины
Когда одного устройства недостаточно для оптимизации, данные приходится передавать туда и обратно, чтобы выполнять синхронизированную обработку, и тогда на первый план выходят сеть и шины. У них много параметров проектирования: пропускная способность, стоимость, расстояние и гибкость. На краю сети находится Wi-Fi: он очень удобен в использовании, охватывает хорошую зону и дёшев (ведь не нужны кабели), но даёт относительно скромную пропускную способность и высокую задержку. Ни один разумный исследователь машинного обучения не станет строить на нём серверный кластер. Далее мы сосредоточимся на соединениях, подходящих для глубокого обучения.
- PCIe — специализированная шина для высокой пропускной способности при соединении точка-точка (на каждой линии в слоте x16 — до 32 ГБ/с для PCIe 4.0) с задержкой порядка нескольких микросекунд (5 мкс). Линии PCIe очень ценны. Количество линий, которое есть у процессора: у AMD EPYC 3 — , у Intel Xeon — на чип; у настольных CPU — (Ryzen 9) и (Core i9). Поскольку у GPU обычно линий, число GPU, которые могут работать на полной пропускной способности с CPU, ограничено. К тому же им приходится делить канал с другими высокоскоростными периферийными устройствами, например с хранилищем и Ethernet. Как и в случае с оперативной памятью, передача больших пакетов данных эффективнее, потому что уменьшаются накладные расходы на пакеты;
- Ethernet — самый распространённый способ подключения компьютеров. Он гораздо медленнее PCIe, но его установка очень дешева, он очень гибок и покрывает значительно большие расстояния. Типичная пропускная способность недорогих серверов составляет 1 Гбит/с. Высокопроизводительные устройства (например, экземпляры C5 в облаке) обеспечивают 10–100 Гбит/с. Как и во всех предыдущих случаях, передача данных сопряжена с большими накладными расходами. Обратите внимание, что «голый» Ethernet почти никогда не используется напрямую: поверх физического соединения работают протоколы (например, UDP или TCP/IP), которые добавляют ещё больше накладных расходов. Как и PCIe, Ethernet предназначен для соединения двух устройств, например компьютера и коммутатора;
- коммутатор — способ соединить несколько устройств так, что любые два из них могут одновременно обмениваться данными по соединению «точка-точка» (обычно на полной пропускной способности). Например, Ethernet-коммутатор может с высокой пропускной способностью соединять серверов. Коммутаторы встречаются не только в традиционных компьютерных сетях. Даже линии PCIe могут коммутироваться, например в экземплярах P2, где много GPU подключаются к одному хост-процессору;
- NVLink — альтернатива PCIe для очень высокопроизводительных соединений. Он обеспечивает скорость передачи до 300 Гбит/с на одну линию. Серверный GPU (Volta V100) имеет шесть линий, а потребительский GPU (RTX 2080 Ti) — только одну, и его скорость снижена до 100 Гбит/с. Для высокоскоростного обмена данными между GPU рекомендуется использовать NCCL.
12.4.6 Дополнительные задержки
Сводки из раздела выше взяты из работы Eliot Eshelman, который сохранил обновлённую версию чисел в GitHub gist. Они приведены в таблицах 12.4.1 и 12.4.2.
Таблица 12.4.1. Общие задержки
| Операция | Время | Примечания |
|---|---|---|
| Обращение к L1 / попадание в L1 | 1.5 нс | 4 такта |
| Сложение, умножение и FMA с плавающей точкой | 1.5 нс | 4 такта |
| Обращение к L2 / попадание в L2 | 5 нс | 12–17 тактов |
| Ошибочное предсказание ветвления | 6 нс | 15–20 тактов |
| Попадание в L3 (кэш не разделяется) | 16 нс | 42 такта |
| Попадание в L3 (разделяется с другим ядром) | 25 нс | 65 тактов |
| Блокировка и разблокировка мьютекса | 25 нс | |
| Попадание в L3 (строка изменена в другом ядре) | 29 нс | 75 тактов |
| Попадание в L3 (на удалённом сокете CPU) | 40 нс | 100–300 тактов (40–116 нс) |
| Переход по QPI к другому CPU (за один переход) | 40 нс | |
| Обращение к памяти 64 МБ (локальный CPU) | 46 нс | TinyMemBench на Broadwell E5-2690v4 |
| Обращение к памяти 64 МБ (удалённый CPU) | 70 нс | TinyMemBench на Broadwell E5-2690v4 |
| Обращение к памяти 256 МБ (локальный CPU) | 75 нс | TinyMemBench на Broadwell E5-2690v4 |
| Случайная запись в Intel Optane | 94 нс | UCSD Non-Volatile Systems Lab |
| Обращение к памяти 256 МБ (удалённый CPU) | 120 нс | TinyMemBench на Broadwell E5-2690v4 |
| Случайное чтение из Intel Optane | 305 нс | UCSD Non-Volatile Systems Lab |
| Отправка 4 КБ по HPC-сети 100 Гбит/с | 1 мкс | MVAPICH2 поверх Intel Omni-Path |
| Сжатие 1 КБ алгоритмом Google Snappy | 3 мкс | |
| Отправка 4 КБ по Ethernet 10 Гбит/с | 10 мкс | |
| Случайная запись 4 КБ на NVMe SSD | 30 мкс | DC P3608 NVMe SSD (QoS 99%: 500 мкс) |
| Передача 1 МБ к GPU с NVLink и обратно | 30 мкс | ~33 ГБ/с, NVIDIA 40GB NVLink |
| Передача 1 МБ к GPU через PCIe и обратно | 80 мкс | ~12 ГБ/с, линия PCIe 3.0 x16 |
| Случайное чтение 4 КБ с NVMe SSD | 120 мкс | DC P3608 NVMe SSD (QoS 99%) |
| Последовательное чтение 1 МБ с NVMe SSD | 208 мкс | ~4.8 ГБ/с, DC P3608 NVMe SSD |
| Случайная запись 4 КБ на SATA SSD | 500 мкс | DC S3510 SATA SSD (QoS 99.9%) |
| Случайное чтение 4 КБ с SATA SSD | 500 мкс | DC S3510 SATA SSD (QoS 99.9%) |
| Полный цикл внутри одного дата-центра | 500 мкс | Односторонний пинг ~250 мкс |
| Последовательное чтение 1 МБ с SATA SSD | 2 мс | ~550 МБ/с, DC S3510 SATA SSD |
| Последовательное чтение 1 МБ с диска | 5 мс | ~200 МБ/с, серверный HDD |
| Случайный доступ к диску (поиск и вращение) | 10 мс | |
| Отправка пакета Калифорния → Нидерланды → Калифорния | 150 мс |
Таблица 12.4.2. Задержки GPU NVIDIA Tesla
| Операция | Время | Примечания |
|---|---|---|
| Доступ к разделяемой памяти GPU | 30 нс | 30–90 тактов (конфликты банков добавляют задержку) |
| Доступ к глобальной памяти GPU | 200 нс | 200–800 тактов |
| Запуск ядра CUDA на GPU | 10 мкс | Хост-CPU даёт GPU команду начать выполнение ядра |
| Передача 1 МБ к GPU с NVLink и обратно | 30 мкс | ~33 ГБ/с, NVIDIA 40GB NVLink |
| Передача 1 МБ к GPU через PCIe и обратно | 80 мкс | ~12 ГБ/с, линия PCI-Express x16 |
Резюме
- У устройств есть накладные расходы на запуск. Поэтому передавать данные лучше крупными порциями и реже, а не мелкими и часто. Это относится к оперативной памяти, твердотельным накопителям, сети и GPU.
- Векторизация — ключ к производительности. Важно хорошо знать специфические возможности ускорителя. Например, некоторые процессоры Intel Xeon особенно подходят для операций INT8, GPU NVIDIA Volta хорошо справляются с матричными операциями FP16, а NVIDIA Turing работает с FP16, INT8 и INT4.
- Переполнение, возникающее из-за слишком малых типов данных в процессе обучения, может быть проблемой (при выводе оно обычно менее важно).
- Наложение данных (aliasing) может сильно ухудшить производительность. CPU с 64-битной архитектурой следует выравнивать по 64-битным границам. На GPU рекомендуется выравнивать размеры свёрток, например под тензорные ядра.
- Согласуйте алгоритм с аппаратурой (например, по объёму памяти и пропускной способности). Если параметры помещаются в кэш, можно получить ускорение на порядки.
- Прежде чем проверять результаты экспериментов, полезно набросать производительность нового алгоритма на бумаге. Это важно потому, что речь идёт о разнице на порядки и больше.
- Для поиска узких мест в производительности используйте отладчик и профилировщик.
- Аппаратура для обучения и аппаратура для вывода различаются по производительности и цене, и у каждой есть свои достоинства.
Упражнения
- Напишите программу на C, которая проверит, есть ли разница в скорости доступа к выровненной и невыровненной памяти. (Подсказка: учитывайте влияние кэша.)
- Проверьте разницу в скорости при последовательном доступе к памяти и при доступе с заданным шагом.
- Как измерить размер кэша на CPU?
- Как распределить данные по нескольким каналам памяти, чтобы получить максимальную пропускную способность? Как это сделать, если есть много мелких потоков?
- Жёсткий диск корпоративного класса вращается со скоростью 10 000 оборотов в минуту. В худшем случае за какое минимальное время диск может прочитать данные (считая, что головка перемещается почти мгновенно)? Почему 2,5-дюймовые жёсткие диски становятся всё популярнее в серверах по сравнению с 3,5- и 5,25-дюймовыми?
- Допустим, производитель HDD увеличил плотность записи с 1 Тбит на квадратный дюйм до 5 Тбит на квадратный дюйм. Сколько информации поместится на одном кольце 2,5-дюймового жёсткого диска? Есть ли разница между внутренней и внешней дорожками?
- При переходе от 8-битных типов данных к 16-битным количество кремния примерно увеличивается в четыре раза. Почему? Почему NVIDIA добавила операции INT4 в свои GPU Turing?
- На сколько быстрее чтение в памяти вперёд, чем назад? Отличается ли эта цифра у разных компьютеров и производителей CPU? Почему? Напишите код на C, чтобы провести эксперимент.
- Можно ли измерить размер кэша диска? Каков типичный размер у жёсткого диска? Нужен ли кэш твердотельному накопителю?
- Измерьте накладные расходы на пакеты при отправке сообщения по Ethernet. Найдите различия между соединениями UDP и TCP/IP.
- Прямой доступ к памяти (DMA) позволяет устройствам вне CPU напрямую записывать данные в память (и читать из неё). Зачем это нужно?
- Посмотрите на показатели производительности GPU Turing T4. Почему производительность при переходе от FP16 к INT8 и INT4 только удваивается?
- Сколько времени занимает путь пакета в оба конца от Сан-Франциско до Амстердама? Подсказка: можно считать, что расстояние составляет 10 000 км.
Литература
- Hennessy, J. L., & Patterson, D. A. (2011). Computer architecture: A quantitative approach. Elsevier.
- Kung, S. Y. (1988). VLSI array processors. Prentice Hall.
- Jouppi, N. P., Young, C., Patil, N., Patterson, D., et al. (2017). In-datacenter performance analysis of a tensor processing unit. Proceedings of the 44th Annual International Symposium on Computer Architecture (ISCA), 1–12.
- Wang, Y., Davidson, A., Pan, Y., Wu, Y., Riffel, A., & Owens, J. D. (2016). Gunrock: A high-performance graph processing library on the GPU. ACM SIGPLAN Notices, 51(8), 11.
12.5 Обучение на нескольких GPU
До сих пор мы обсуждали, как эффективно обучать модели на CPU и GPU. В разделе 12.3 мы показали, как фреймворки глубокого обучения автоматически распараллеливают вычисления и коммуникацию между CPU и GPU, а в разделе 5.6 — как с помощью команды nvidia-smi вывести список доступных на компьютере GPU. Однако мы не обсуждали, как на практике распараллелить обучение глубокой сети. Есть ли способ разбить данные между несколькими устройствами так, чтобы всё работало правильно? Этот раздел подробно описывает, как обучать сеть параллельно с нуля, используя алгоритм стохастического градиентного спуска по минибатчам (см. раздел 11.5). Далее мы расскажем, как обучать сеть параллельно с помощью высокоуровневого API (см. раздел 12.6).
12.5.1 Разбиение задачи
Начнём с простой задачи компьютерного зрения и немного устаревшей сети. Эта сеть содержит несколько свёрточных и пулинговых слоёв, а в конце, возможно, несколько полносвязных слоёв. Она очень похожа на LeNet (LeCun et al., 1998) или AlexNet (Krizhevsky et al., 2012). Предположим, что у нас есть несколько GPU: на настольном сервере их два, на AWS g4dn.12xlarge — четыре, на p3.16xlarge — восемь, на p2.16xlarge — шестнадцать. Мы хотим разбить обучение так, чтобы получить хорошее ускорение и при этом пользоваться простыми и воспроизводимыми проектными решениями. В конце концов, несколько GPU одновременно увеличивают объём памяти и вычислительную мощность. Коротко говоря, для минибатча обучающих данных, который нужно классифицировать, у нас есть следующие варианты.
Первый подход — разбить сеть между несколькими GPU. Каждый GPU получает данные, поступающие в определённый слой, обрабатывает их через несколько последовательных слоёв и передаёт результат следующему GPU. Так можно обработать более крупную сеть, чем помещается на одном GPU. Кроме того, объём памяти (memory footprint), занимаемый на каждом GPU, хорошо контролируется, хотя он составляет лишь часть памяти всей сети.
Однако плотная синхронизация между интерфейсами GPU может быть трудной, особенно если вычислительная нагрузка слоёв плохо сбалансирована. Кроме того, интерфейсы между слоями требуют передачи большого объёма данных (например, активаций и градиентов), что может превысить пропускную способность шины GPU. К тому же порядок вычислительно затратных операций важен при таком разбиении. Лучшие результаты по этому вопросу описаны в работе (Mirhoseini et al., 2017). Это по-прежнему сложная задача, и пока неясно, может ли исследование дать хорошее линейное масштабирование для конкретной задачи. Итак, если фреймворк или операционная система сами не поддерживают объединение нескольких GPU, мы не рекомендуем этот подход.
Второй подход — разбить работу внутри слоя. Например, задачу можно распределить между четырьмя GPU, каждый из которых вычисляет каналов данных вместо каналов на одном GPU. То же можно сделать для полносвязного слоя, разбив количество выходных нейронов. На рис. 12.5.1 показана такая схема; она использовалась для GPU с очень малым объёмом памяти (тогда — 2 ГБ). Когда количество каналов или нейронов не слишком мало, такой подход даёт хороший прирост производительности. Кроме того, поскольку доступная память растёт линейно, несколько GPU могут обрабатывать всё более крупные сети.
Рис. 12.5.1. Модельный параллелизм в исходной схеме AlexNet из-за ограниченной памяти GPU
Однако здесь требуется много синхронизаций, или барьерных операций (barrier operation), потому что каждый слой зависит от результатов всех остальных слоёв. Кроме того, объём данных, которые нужно передавать, может быть даже больше, чем при разбиении слоёв между GPU. Поэтому с учётом затрат на пропускную способность и сложности мы не рекомендуем и этот подход.
Последний подход — разбить данные между несколькими GPU. Все GPU при этом получают разные наблюдения, но выполняют одну и ту же работу. После обработки каждого минибатча градиенты агрегируются на GPU. Это самый простой подход, он применим в любой ситуации, а синхронизация нужна лишь после обработки каждого минибатча. Более того, градиентные параметры, которые уже вычислены, можно начинать передавать, пока вычисляются остальные. Чем больше GPU, тем больше данных входит в минибатч, а значит, выше эффективность обучения. Однако добавление GPU не позволяет обучать более крупные модели.
Рис. 12.5.2. Параллелизация на нескольких GPU. Слева направо: исходная задача, параллелизм сети, послойный параллелизм, параллелизм данных
На рис. 12.5.2 сравниваются разные способы параллелизации на нескольких GPU. В целом, пока объём памяти GPU достаточен, параллелизм данных — самый удобный вариант. Подробное описание распределённого разбиения обучения см. в работе (Li et al., 2014). В ранние годы глубокого обучения память GPU была серьёзным ограничением, однако сейчас, за исключением очень специальных случаев, эта проблема решена. Дальше мы сосредоточимся на параллелизме данных.
12.5.2 Параллелизм данных
Допустим, в машине есть GPU. Учитывая модель, которую нужно обучить, каждый GPU хотя и имеет одинаковые и синхронизированные значения параметров, поддерживает независимо свой полный набор параметров модели. Например, на рис. 12.5.3 показано обучение модели с параллелизмом данных при .
Рис. 12.5.3. Параллельное вычисление стохастического градиентного спуска по минибатчу с использованием данных на двух GPU
В общем случае обучение на GPU параллельно выполняется следующим образом:
- на каждой итерации обучения случайный минибатч делится на частей, которые равномерно распределяются по GPU;
- каждый GPU вычисляет значения функции потерь и градиенты параметров модели для своей части минибатча;
- локальные градиенты всех GPU агрегируются, чтобы получить стохастический градиент для текущего минибатча;
- агрегированный градиент рассылается на каждый GPU;
- каждый GPU, используя этот градиент минибатча, обновляет свой полный набор параметров модели.
На практике при обучении на GPU нужно увеличивать размер минибатча в раз, чтобы каждый GPU получал такой же объём работы, как при обучении на одном GPU. Поэтому на 16-GPU сервере размер минибатча можно заметно увеличить, и, вероятно, потребуется соответствующим образом повысить скорость обучения. Обратите также внимание, что пакетную нормализацию из раздела 7.5 тоже нужно скорректировать, например сохранять отдельные параметры пакетной нормализации для каждого GPU.
Далее мы используем простую сеть, чтобы продемонстрировать обучение на нескольких GPU.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, gluon, np, npx
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
from torch import nn
from torch.nn import functional as F
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
from paddle.nn import functional as F
12.5.3 Простая сеть
Мы используем LeNet из раздела 6.6 (с небольшими изменениями) и определим его с нуля, чтобы подробно показать обмен параметрами и их синхронизацию.
MXNet:
# Инициализация параметров модели
scale = 0.01
W1 = np.random.normal(scale=scale, size=(20, 1, 3, 3))
b1 = np.zeros(20)
W2 = np.random.normal(scale=scale, size=(50, 20, 5, 5))
b2 = np.zeros(50)
W3 = np.random.normal(scale=scale, size=(800, 128))
b3 = np.zeros(128)
W4 = np.random.normal(scale=scale, size=(128, 10))
b4 = np.zeros(10)
params = [W1, b1, W2, b2, W3, b3, W4, b4]
# Определение модели
def lenet(X, params):
h1_conv = npx.convolution(data=X, weight=params[0], bias=params[1],
kernel=(3, 3), num_filter=20)
h1_activation = npx.relu(h1_conv)
h1 = npx.pooling(data=h1_activation, pool_type='avg', kernel=(2, 2),
stride=(2, 2))
h2_conv = npx.convolution(data=h1, weight=params[2], bias=params[3],
kernel=(5, 5), num_filter=50)
h2_activation = npx.relu(h2_conv)
h2 = npx.pooling(data=h2_activation, pool_type='avg', kernel=(2, 2),
stride=(2, 2))
h2 = h2.reshape(h2.shape[0], -1)
h3_linear = np.dot(h2, params[4]) + params[5]
h3 = npx.relu(h3_linear)
y_hat = np.dot(h3, params[6]) + params[7]
return y_hat
# Функция потерь: перекрёстная энтропия
loss = gluon.loss.SoftmaxCrossEntropyLoss()
PyTorch:
# Инициализация параметров модели
scale = 0.01
W1 = torch.randn(size=(20, 1, 3, 3)) * scale
b1 = torch.zeros(20)
W2 = torch.randn(size=(50, 20, 5, 5)) * scale
b2 = torch.zeros(50)
W3 = torch.randn(size=(800, 128)) * scale
b3 = torch.zeros(128)
W4 = torch.randn(size=(128, 10)) * scale
b4 = torch.zeros(10)
params = [W1, b1, W2, b2, W3, b3, W4, b4]
# Определение модели
def lenet(X, params):
h1_conv = F.conv2d(input=X, weight=params[0], bias=params[1])
h1_activation = F.relu(h1_conv)
h1 = F.avg_pool2d(input=h1_activation, kernel_size=(2, 2), stride=(2, 2))
h2_conv = F.conv2d(input=h1, weight=params[2], bias=params[3])
h2_activation = F.relu(h2_conv)
h2 = F.avg_pool2d(input=h2_activation, kernel_size=(2, 2), stride=(2, 2))
h2 = h2.reshape(h2.shape[0], -1)
h3_linear = torch.mm(h2, params[4]) + params[5]
h3 = F.relu(h3_linear)
y_hat = torch.mm(h3, params[6]) + params[7]
return y_hat
# Функция потерь: перекрёстная энтропия
loss = nn.CrossEntropyLoss(reduction='none')
PaddlePaddle:
# Инициализация параметров модели
scale = 0.01
W1 = paddle.randn(shape=[20, 1, 3, 3]) * scale
b1 = paddle.zeros(shape=[20])
W2 = paddle.randn(shape=[50, 20, 5, 5]) * scale
b2 = paddle.zeros(shape=[50])
W3 = paddle.randn(shape=[800, 128]) * scale
b3 = paddle.zeros(shape=[128])
W4 = paddle.randn(shape=[128, 10]) * scale
b4 = paddle.zeros(shape=[10])
params = [W1, b1, W2, b2, W3, b3, W4, b4]
# Определение модели
def lenet(X, params):
h1_conv = F.conv2d(x=X, weight=params[0], bias=params[1])
h1_activation = F.relu(h1_conv)
h1 = F.avg_pool2d(x=h1_activation, kernel_size=(2, 2), stride=(2, 2))
h2_conv = F.conv2d(x=h1, weight=params[2], bias=params[3])
h2_activation = F.relu(h2_conv)
h2 = F.avg_pool2d(x=h2_activation, kernel_size=(2, 2), stride=(2, 2))
h2 = h2.reshape([h2.shape[0], -1])
h3_linear = paddle.mm(h2, params[4]) + params[5]
h3 = F.relu(h3_linear)
y_hat = paddle.mm(h3, params[6]) + params[7]
return y_hat
# Функция потерь: перекрёстная энтропия
loss = nn.CrossEntropyLoss(reduction='none')
12.5.4 Синхронизация данных
Для эффективного обучения на нескольких GPU нужны две базовые операции. Во-первых, нужно распределить параметры модели по нескольким устройствам и прикрепить к ним градиенты (get_params). Без параметров невозможно вычислить сеть на GPU. Во-вторых, нужно суммировать параметры по нескольким устройствам, то есть нужна функция allreduce.
MXNet:
def get_params(params, device):
new_params = [p.copyto(device) for p in params]
for p in new_params:
p.attach_grad()
return new_params
PyTorch:
def get_params(params, device):
new_params = [p.to(device) for p in params]
for p in new_params:
p.requires_grad_()
return new_params
PaddlePaddle:
def get_params(params, device):
new_params = [paddle.to_tensor(p, place=device) for p in params]
for p in new_params:
p.stop_gradient = False
return new_params
Скопируем параметры модели на один GPU.
new_params = get_params(params, d2l.try_gpu(0))
print('вес b1:', new_params[1])
print('градиент b1:', new_params[1].grad)
Поскольку вычислений ещё не было, градиент весового параметра по-прежнему равен нулю. Допустим, теперь есть вектор, распределённый по нескольким GPU. Функция allreduce складывает все векторы и рассылает результат всем GPU. Обратите внимание, что данные нужно копировать на устройство, где накапливается результат, чтобы функция работала правильно.
MXNet:
def allreduce(data):
for i in range(1, len(data)):
data[0][:] += data[i].copyto(data[0].ctx)
for i in range(1, len(data)):
data[0].copyto(data[i])
PyTorch:
def allreduce(data):
for i in range(1, len(data)):
data[0][:] += data[i].to(data[0].device)
for i in range(1, len(data)):
data[i][:] = data[0].to(data[i].device)
PaddlePaddle:
def allreduce(data):
paddle.set_device("gpu:0")
for i in range(1, len(data)):
data[0] += paddle.to_tensor(data[i], place=data[0].place)
for i in range(1, len(data)):
data[i] = paddle.to_tensor(data[0], place=data[i].place)
Создадим на разных устройствах векторы с разными значениями и сложим их.
MXNet:
data = [np.ones((1, 2), ctx=d2l.try_gpu(i)) * (i + 1) for i in range(2)]
print('до allreduce:\n', data[0], '\n', data[1])
allreduce(data)
print('после allreduce:\n', data[0], '\n', data[1])
PyTorch:
data = [torch.ones((1, 2), device=d2l.try_gpu(i)) * (i + 1) for i in range(2)]
print('до allreduce:\n', data[0], '\n', data[1])
allreduce(data)
print('после allreduce:\n', data[0], '\n', data[1])
PaddlePaddle:
num_gpus = 2
devices = [d2l.try_gpu(i) for i in range(num_gpus)]
data = [paddle.to_tensor(paddle.ones(shape=[1, 2]) * (i + 1), place=devices[i]) for i in range(2)]
print('до allreduce:\n', data[0], '\n', data[1])
allreduce(data)
print('после allreduce:\n', data[0], '\n', data[1])
12.5.5 Распределение данных
Нам нужна простая вспомогательная функция, которая равномерно распределяет минибатч по нескольким GPU. Например, при двух GPU мы хотим, чтобы каждый GPU копировал половину данных. Поскольку встроенные функции фреймворков короче и удобнее, попробуем их на матрице .
MXNet:
data = np.arange(20).reshape(4, 5)
devices = [npx.gpu(0), npx.gpu(1)]
split = gluon.utils.split_and_load(data, devices)
print('вход:', data)
print('устройства:', devices)
print('выход:', split)
PyTorch:
data = torch.arange(20).reshape(4, 5)
devices = [torch.device('cuda:0'), torch.device('cuda:1')]
split = nn.parallel.scatter(data, devices)
print('вход:', data)
print('загрузка на', devices)
print('выход:', split)
PaddlePaddle:
def paddlescatter(XY, devices):
xy = XY.shape[0]//len(devices) # Размер блока по числу GPU
return [paddle.to_tensor(XY[i*xy:(i+1)*xy], place=device) for i,device in enumerate(devices)]
# Распределение данных
data = paddle.arange(20).reshape([4, 5])
split = paddlescatter(data, devices)
print('вход:', data)
print('загрузка на', devices)
print('выход:', split)
Для удобного повторного использования определим функцию split_batch, которая одновременно разбивает данные и метки.
MXNet:
#@save
def split_batch(X, y, devices):
"""Разбивает X и y по нескольким устройствам"""
assert X.shape[0] == y.shape[0]
return (gluon.utils.split_and_load(X, devices),
gluon.utils.split_and_load(y, devices))
PyTorch:
#@save
def split_batch(X, y, devices):
"""Разбивает X и y по нескольким устройствам"""
assert X.shape[0] == y.shape[0]
return (nn.parallel.scatter(X, devices),
nn.parallel.scatter(y, devices))
PaddlePaddle:
#@save
def split_batch(X, y, devices):
"""Разбивает X и y по нескольким устройствам"""
assert X.shape[0] == y.shape[0]
return (paddlescatter(X, devices),
paddlescatter(y, devices))
12.5.6 Обучение
Теперь мы можем реализовать обучение с несколькими GPU на одном минибатче. Для синхронизации данных между GPU используем рассмотренные вспомогательные функции allreduce и split_and_load. Никакого специального кода для параллелизма писать не нужно: поскольку в вычислительном графе внутри минибатча нет зависимостей между устройствами, вычисления выполняются параллельно «автоматически».
MXNet:
def train_batch(X, y, device_params, devices, lr):
X_shards, y_shards = split_batch(X, y, devices)
with autograd.record(): # Вычисляем потери на каждом GPU отдельно
ls = [loss(lenet(X_shard, device_W), y_shard)
for X_shard, y_shard, device_W in zip(
X_shards, y_shards, device_params)]
for l in ls: # Обратное распространение выполняется на каждом GPU отдельно
l.backward()
# Суммируем градиенты всех GPU и рассылаем результат на все GPU
for i in range(len(device_params[0])):
allreduce([device_params[c][i].grad for c in range(len(devices))])
# Обновляем параметры модели на каждом GPU отдельно
for param in device_params:
d2l.sgd(param, lr, X.shape[0]) # Здесь используем полный размер минибатча
PyTorch:
def train_batch(X, y, device_params, devices, lr):
X_shards, y_shards = split_batch(X, y, devices)
# Вычисляем потери на каждом GPU отдельно
ls = [loss(lenet(X_shard, device_W), y_shard).sum()
for X_shard, y_shard, device_W in zip(
X_shards, y_shards, device_params)]
for l in ls: # Обратное распространение выполняется на каждом GPU отдельно
l.backward()
# Суммируем градиенты всех GPU и рассылаем результат на все GPU
with torch.no_grad():
for i in range(len(device_params[0])):
allreduce(
[device_params[c][i].grad for c in range(len(devices))])
# Обновляем параметры модели на каждом GPU отдельно
for param in device_params:
d2l.sgd(param, lr, X.shape[0]) # Здесь используем полный размер минибатча
PaddlePaddle:
def train_batch(X, y, device_params, devices, lr):
X_shards, y_shards = split_batch(X, y, devices)
# Вычисляем потери на каждом GPU отдельно
for i, (X_shard, y_shard, device_W) in enumerate(zip(
X_shards, y_shards, device_params)) :
# Выбираем GPU, на котором выполняется вычисление
paddle.set_device(f"gpu:{i}")
y_shard = paddle.squeeze(y_shard)
l = loss(lenet(X_shard, device_W), y_shard).sum()
# Обратное распространение выполняется на каждом GPU отдельно
l.backward()
# Суммируем градиенты всех GPU и рассылаем результат на все GPU
with paddle.no_grad():
for i in range(len(device_params[0])):
allreduce(
[device_params[c][i].grad for c in range(len(devices))])
# Обновляем параметры модели на каждом GPU отдельно
for i in range(len(device_params)):
paddle.set_device(f"gpu:{i}")
param = device_params[i]
d2l.sgd(param, lr, X.shape[0]) # Здесь используем полный размер минибатча
Теперь можно определить функцию обучения. В отличие от предыдущих глав, функция обучения должна выделять GPU и копировать все параметры модели на все устройства. Каждый минибатч обрабатывается функцией train_batch с использованием нескольких GPU. Точность модели мы вычисляем только на одном GPU, а остальные GPU в это время простаивают. Это относительно неэффективно, но удобно и позволяет сохранить код коротким.
MXNet:
def train(num_gpus, batch_size, lr):
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
devices = [d2l.try_gpu(i) for i in range(num_gpus)]
# Копируем параметры модели на num_gpus GPU
device_params = [get_params(params, d) for d in devices]
num_epochs = 10
animator = d2l.Animator('эпоха', 'точность (тест)', xlim=[1, num_epochs])
timer = d2l.Timer()
for epoch in range(num_epochs):
timer.start()
for X, y in train_iter:
# Обучение на одном минибатче с несколькими GPU
train_batch(X, y, device_params, devices, lr)
npx.waitall()
timer.stop()
# Оцениваем модель на GPU0
animator.add(epoch + 1, (d2l.evaluate_accuracy_gpu(
lambda x: lenet(x, device_params[0]), test_iter, devices[0]),))
print(f'Точность на тесте: {animator.Y[0][-1]:.2f}, {timer.avg():.1f} с/эпоху, '
f'на {str(devices)}')
PyTorch:
def train(num_gpus, batch_size, lr):
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
devices = [d2l.try_gpu(i) for i in range(num_gpus)]
# Копируем параметры модели на num_gpus GPU
device_params = [get_params(params, d) for d in devices]
num_epochs = 10
animator = d2l.Animator('эпоха', 'точность (тест)', xlim=[1, num_epochs])
timer = d2l.Timer()
for epoch in range(num_epochs):
timer.start()
for X, y in train_iter:
# Обучение на одном минибатче с несколькими GPU
train_batch(X, y, device_params, devices, lr)
torch.cuda.synchronize()
timer.stop()
# Оцениваем модель на GPU0
animator.add(epoch + 1, (d2l.evaluate_accuracy_gpu(
lambda x: lenet(x, device_params[0]), test_iter, devices[0]),))
print(f'Точность на тесте: {animator.Y[0][-1]:.2f}, {timer.avg():.1f} с/эпоху, '
f'на {str(devices)}')
PaddlePaddle:
def train(num_gpus, batch_size, lr):
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
devices = [d2l.try_gpu(i) for i in range(num_gpus)]
# Копируем параметры модели на num_gpus GPU
device_params = [get_params(params, d) for d in devices]
num_epochs = 10
animator = d2l.Animator('эпоха', 'точность (тест)', xlim=[1, num_epochs])
timer = d2l.Timer()
for epoch in range(num_epochs):
timer.start()
for X, y in train_iter:
# Обучение на одном минибатче с несколькими GPU
train_batch(X, y, device_params, devices, lr)
paddle.device.cuda.synchronize()
timer.stop()
# Оцениваем модель на GPU0
animator.add(epoch + 1, (d2l.evaluate_accuracy_gpu(
lambda x: lenet(x, device_params[0]), test_iter, devices[0]),))
print(f'Точность на тесте: {animator.Y[0][-1]:.2f}, {timer.avg():.1f} с/эпоху, '
f'на {str(devices)}')
Посмотрим, насколько хорошо работает обучение на одном GPU. Сначала используем размер минибатча и скорость обучения .
train(num_gpus=1, batch_size=256, lr=0.2)
Оставим размер минибатча и скорость обучения без изменений и увеличим число GPU до 2: точность на тесте почти такая же, как в предыдущем эксперименте. Число GPU не влияет на сам алгоритм оптимизации. К сожалению, значимого ускорения нет: модель слишком мала, да и набор данных тоже слишком мал. В этом наборе данных наш простой способ обучения на нескольких GPU сильно страдает от накладных расходов Python. В будущем мы встретим более сложные модели и более сложные способы распараллеливания. Тем не менее посмотрим, что происходит на наборе данных Fashion-MNIST.
MXNet, PyTorch:
train(num_gpus=2, batch_size=256, lr=0.2)
Резюме
- Обучение глубокой сети на нескольких GPU можно организовать разными способами. Сеть можно разбивать между слоями, внутри слоёв или по данным. Первые два варианта требуют тщательно организованной передачи данных, а последний — самая простая стратегия.
- Параллельное обучение по данным не сложно само по себе: оно повышает эффективность обучения за счёт увеличения размера эффективного минибатча.
- При параллелизме данных данные делятся между несколькими GPU, каждый GPU выполняет свои прямое и обратное распространение, затем все градиенты агрегируются в один, и результат рассылается на все GPU.
- При большем размере минибатча скорость обучения также нужно немного повысить.
Упражнения
- При обучении на GPU измените размер минибатча с на , то есть масштабируйте его по количеству GPU.
- Сравните точность модели при разных скоростях обучения. Как скорость обучения должна масштабироваться при увеличении количества GPU?
- Реализуйте более эффективную функцию
allreduceдля агрегирования различных параметров на разных GPU. Почему такая реализация эффективнее? - Реализуйте вычисление точности модели на тестовых данных при обучении на нескольких GPU.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Li, M., Andersen, D. G., Park, J. W., Smola, A. J., Ahmed, A., Josifovski, V., Long, J., Shekita, E. J., & Su, B.-Y. (2014). Scaling distributed machine learning with the parameter server. 11th USENIX Symposium on Operating Systems Design and Implementation (OSDI 14), 583–598.
- Mirhoseini, A., Pham, H., Le, Q. V., Steiner, B., Larsen, R., Zhou, Y., Kumar, N., Norouzi, M., Bengio, S., & Dean, J. (2017). Device placement optimization with reinforcement learning. Proceedings of the 34th International Conference on Machine Learning, 70, 2430–2439.
12.6 Краткая реализация обучения на нескольких GPU
Реализовывать параллельные вычисления для каждой новой модели с нуля — неинтересно. Кроме того, полезно оптимизировать инструменты синхронизации, чтобы добиться высокой производительности. Ниже мы покажем, как сделать это с помощью высокоуровневого API фреймворков глубокого обучения. Математика и алгоритмы такие же, как в разделе 12.5. Код этого раздела запускается как минимум на двух GPU.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, gluon, init, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
12.6.1 Простая сеть
Возьмём сеть, более содержательную, чем LeNet из раздела 12.5, которую при этом можно обучать быстро и легко. Мы выбираем ResNet-18 из работы (He et al., 2016a). Поскольку входные изображения очень маленькие, мы немного её изменим: по сравнению с разделом 7.6 в начале сети используются меньшие ядра свёртки, шаги и заполнение, а слой максимального пулинга удалён.
MXNet:
#@save
def resnet18(num_classes):
"""ResNet-18 с небольшими изменениями"""
def resnet_block(num_channels, num_residuals, first_block=False):
blk = nn.Sequential()
for i in range(num_residuals):
if i == 0 and not first_block:
blk.add(d2l.Residual(
num_channels, use_1x1conv=True, strides=2))
else:
blk.add(d2l.Residual(num_channels))
return blk
net = nn.Sequential()
# В этой модели использованы меньшие ядра свёртки, шаги и паддинг, а также удалён слой максимального пулинга
net.add(nn.Conv2D(64, kernel_size=3, strides=1, padding=1),
nn.BatchNorm(), nn.Activation('relu'))
net.add(resnet_block(64, 2, first_block=True),
resnet_block(128, 2),
resnet_block(256, 2),
resnet_block(512, 2))
net.add(nn.GlobalAvgPool2D(), nn.Dense(num_classes))
return net
PyTorch:
#@save
def resnet18(num_classes, in_channels=1):
"""ResNet-18 с небольшими изменениями"""
def resnet_block(in_channels, out_channels, num_residuals,
first_block=False):
blk = []
for i in range(num_residuals):
if i == 0 and not first_block:
blk.append(d2l.Residual(in_channels, out_channels,
use_1x1conv=True, strides=2))
else:
blk.append(d2l.Residual(out_channels, out_channels))
return nn.Sequential(*blk)
# В этой модели использованы меньшие ядра свёртки, шаги и паддинг, а также удалён слой максимального пулинга
net = nn.Sequential(
nn.Conv2d(in_channels, 64, kernel_size=3, stride=1, padding=1),
nn.BatchNorm2d(64),
nn.ReLU())
net.add_module("resnet_block1", resnet_block(
64, 64, 2, first_block=True))
net.add_module("resnet_block2", resnet_block(64, 128, 2))
net.add_module("resnet_block3", resnet_block(128, 256, 2))
net.add_module("resnet_block4", resnet_block(256, 512, 2))
net.add_module("global_avg_pool", nn.AdaptiveAvgPool2d((1,1)))
net.add_module("fc", nn.Sequential(nn.Flatten(),
nn.Linear(512, num_classes)))
return net
PaddlePaddle:
#@save
def resnet18(num_classes, in_channels=1):
"""ResNet-18 с небольшими изменениями"""
def resnet_block(in_channels, out_channels, num_residuals,
first_block=False):
blk = []
for i in range(num_residuals):
if i == 0 and not first_block:
blk.append(d2l.Residual(in_channels, out_channels,
use_1x1conv=True, strides=2))
else:
blk.append(d2l.Residual(out_channels, out_channels))
return nn.Sequential(*blk)
# В этой модели использованы меньшие ядра свёртки, шаги и паддинг, а также удалён слой максимального пулинга
net = nn.Sequential(
nn.Conv2D(in_channels, 64, kernel_size=3, stride=1, padding=1),
nn.BatchNorm2D(64),
nn.ReLU())
net.add_sublayer("resnet_block1", resnet_block(
64, 64, 2, first_block=True))
net.add_sublayer("resnet_block2", resnet_block(64, 128, 2))
net.add_sublayer("resnet_block3", resnet_block(128, 256, 2))
net.add_sublayer("resnet_block4", resnet_block(256, 512, 2))
net.add_sublayer("global_avg_pool", nn.AdaptiveAvgPool2D((1, 1)))
net.add_sublayer("fc", nn.Sequential(nn.Flatten(),
nn.Linear(512, num_classes)))
return net
12.6.2 Инициализация сети
MXNet: Функция initialize позволяет инициализировать параметры на выбранных устройствах. Методы инициализации мы повторяли в разделе 4.8. Эта функция особенно удобна, когда сеть инициализируется сразу на нескольких устройствах. Посмотрим, как она работает на практике.
PyTorch: Сеть мы инициализируем в цикле обучения. Методы инициализации см. в разделе 4.8.
MXNet:
net = resnet18(10)
# Получаем список GPU
devices = d2l.try_all_gpus()
# Инициализируем все параметры сети
net.initialize(init=init.Normal(sigma=0.01), ctx=devices)
PyTorch:
net = resnet18(10)
# Получаем список GPU
devices = d2l.try_all_gpus()
# Сеть инициализируем в коде обучения
PaddlePaddle:
net = resnet18(10)
# Получаем список GPU
devices = d2l.try_all_gpus()
# Сеть инициализируем в коде обучения
MXNet: Функция split_and_load из раздела 12.5 разбивает минибатч данных и копирует части на устройства из списка devices. Сеть автоматически использует подходящий GPU, чтобы вычислить прямое распространение. Ниже мы сгенерируем наблюдения и разобьём их между GPU.
x = np.random.uniform(size=(4, 1, 28, 28))
x_shards = gluon.utils.split_and_load(x, devices)
net(x_shards[0]), net(x_shards[1])
MXNet: Как только данные проходят через сеть, соответствующие параметры сети инициализируются на устройствах, через которые прошли данные. Это означает, что инициализация выполняется отдельно на каждом устройстве. Поскольку мы выбрали GPU0 и GPU1, сеть инициализируется только на этих двух GPU, а не на CPU. Действительно, на CPU этих параметров даже нет. Проверим это, выведя параметры и посмотрев, не возникнет ли ошибка.
weight = net[0].params.get('weight')
try:
weight.data()
except RuntimeError:
print('not initialized on cpu')
weight.data(devices[0])[0], weight.data(devices[1])[0]
MXNet: Далее заменим код оценки модели кодом, который работает параллельно на нескольких устройствах. Это замена функции evaluate_accuracy_gpu из раздела 6.6. Основное отличие в том, что перед вызовом сети минибатч разбивается, в остальном код по сути тот же.
#@save
def evaluate_accuracy_gpus(net, data_iter, split_f=d2l.split_batch):
"""Вычисляет точность модели на наборе данных с помощью нескольких GPU"""
# Получаем список устройств
devices = list(net.collect_params().values())[0].list_ctx()
# Число верных предсказаний и общее число предсказаний
metric = d2l.Accumulator(2)
for features, labels in data_iter:
X_shards, y_shards = split_f(features, labels, devices)
# Параллельный запуск
pred_shards = [net(X_shard) for X_shard in X_shards]
metric.add(sum(float(d2l.accuracy(pred_shard, y_shard)) for
pred_shard, y_shard in zip(
pred_shards, y_shards)), labels.size)
return metric[0] / metric[1]
12.6.3 Обучение
Как и раньше, код обучения должен выполнять несколько базовых функций, чтобы параллелизм был эффективным:
- нужно инициализировать параметры сети на всех устройствах;
- при итерации по набору данных минибатчи нужно распределять по всем устройствам;
- нужно параллельно вычислять потери и их градиенты на всех устройствах;
- нужно агрегировать градиенты и соответствующим образом обновлять параметры.
Наконец, точность вычисляется параллельно, и выводится итоговая производительность сети. Кроме разбиения и агрегации данных, код обучения очень похож на реализации из предыдущих глав.
MXNet:
def train(num_gpus, batch_size, lr):
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
ctx = [d2l.try_gpu(i) for i in range(num_gpus)]
net.initialize(init=init.Normal(sigma=0.01), ctx=ctx, force_reinit=True)
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'learning_rate': lr})
loss = gluon.loss.SoftmaxCrossEntropyLoss()
timer, num_epochs = d2l.Timer(), 10
animator = d2l.Animator('эпоха', 'точность (тест)', xlim=[1, num_epochs])
for epoch in range(num_epochs):
timer.start()
for features, labels in train_iter:
X_shards, y_shards = d2l.split_batch(features, labels, ctx)
with autograd.record():
ls = [loss(net(X_shard), y_shard) for X_shard, y_shard
in zip(X_shards, y_shards)]
for l in ls:
l.backward()
trainer.step(batch_size)
npx.waitall()
timer.stop()
animator.add(epoch + 1, (evaluate_accuracy_gpus(net, test_iter),))
print(f'Точность на тесте: {animator.Y[0][-1]:.2f}, {timer.avg():.1f} с/эпоху, '
f'на {str(ctx)}')
PyTorch:
def train(net, num_gpus, batch_size, lr):
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
devices = [d2l.try_gpu(i) for i in range(num_gpus)]
def init_weights(m):
if type(m) in [nn.Linear, nn.Conv2d]:
nn.init.normal_(m.weight, std=0.01)
net.apply(init_weights)
# Настраиваем модель на нескольких GPU
net = nn.DataParallel(net, device_ids=devices)
trainer = torch.optim.SGD(net.parameters(), lr)
loss = nn.CrossEntropyLoss()
timer, num_epochs = d2l.Timer(), 10
animator = d2l.Animator('эпоха', 'точность (тест)', xlim=[1, num_epochs])
for epoch in range(num_epochs):
net.train()
timer.start()
for X, y in train_iter:
trainer.zero_grad()
X, y = X.to(devices[0]), y.to(devices[0])
l = loss(net(X), y)
l.backward()
trainer.step()
timer.stop()
animator.add(epoch + 1, (d2l.evaluate_accuracy_gpu(net, test_iter),))
print(f'Точность на тесте: {animator.Y[0][-1]:.2f}, {timer.avg():.1f} с/эпоху, '
f'на {str(devices)}')
PaddlePaddle:
def train(net, num_gpus, batch_size, lr):
train_iter, test_iter = d2l.load_data_fashion_mnist(batch_size)
devices = [d2l.try_gpu(i) for i in range(num_gpus)]
init_normal = nn.initializer.Normal(mean=0.0, std=0.01)
for i in net.sublayers():
if type(i) in [nn.Linear, nn.Conv2D]:
init_normal(i.weight)
# Настраиваем модель на нескольких GPU
net = paddle.DataParallel(net)
trainer = paddle.optimizer.SGD(parameters=net.parameters(), learning_rate=lr)
loss = nn.CrossEntropyLoss()
timer, num_epochs = d2l.Timer(), 10
animator = d2l.Animator('эпоха', 'точность (тест)', xlim=[1, num_epochs])
for epoch in range(num_epochs):
net.train()
timer.start()
for X, y in train_iter:
trainer.clear_grad()
X, y = paddle.to_tensor(X, place=devices[0]), paddle.to_tensor(y, place=devices[0])
l = loss(net(X), y)
l.backward()
trainer.step()
timer.stop()
animator.add(epoch + 1, (d2l.evaluate_accuracy_gpu(net, test_iter),))
print(f'Точность на тесте: {animator.Y[0][-1]:.2f}, {timer.avg():.1f} с/эпоху, '
f'на {str(devices)}')
Посмотрим, как это работает на практике. Сначала обучим сеть на одном GPU в качестве разминки.
MXNet:
train(num_gpus=1, batch_size=256, lr=0.1)
PyTorch, PaddlePaddle:
train(net, num_gpus=1, batch_size=256, lr=0.1)
Далее обучим сеть на 2 GPU. По сравнению с LeNet из раздела 12.5 модель ResNet-18 намного сложнее. Здесь заметно проявляется преимущество параллелизма: время вычислений существенно превышает время синхронизации параметров. Поскольку накладные расходы на параллелизм относительно невелики, такой подход повышает масштабируемость модели.
MXNet:
train(num_gpus=2, batch_size=512, lr=0.2)
PyTorch:
train(net, num_gpus=2, batch_size=512, lr=0.2)
Резюме
MXNet:
- Gluon предоставляет примитивы инициализации модели на нескольких устройствах, принимая список контекстов.
- Нейронную сеть можно автоматически вычислять на одном GPU (там, где находятся данные).
- Сеть на каждом устройстве нужно сначала инициализировать, прежде чем обращаться к параметрам этого устройства, иначе возникнет ошибка.
- Алгоритмы оптимизации автоматически агрегируют данные с нескольких GPU.
PyTorch, PaddlePaddle:
- Нейронную сеть можно автоматически вычислять на одном GPU (там, где находятся данные).
- Сеть на каждом устройстве нужно сначала инициализировать, прежде чем обращаться к параметрам этого устройства, иначе возникнет ошибка.
- Алгоритмы оптимизации автоматически агрегируют данные с нескольких GPU.
Упражнения
MXNet:
- В этом разделе используется ResNet-18. Попробуйте разное количество эпох, размеры минибатчей и скорости обучения, а также больше GPU для вычислений. Что произойдёт, если попробовать это на GPU (например, на экземпляре AWS p2.16xlarge)?
- Иногда разные устройства имеют разную вычислительную мощность, и мы можем использовать одновременно GPU и CPU. Как тогда распределять работу? Почему?
- Что будет, если убрать
npx.waitall()? Как изменить обучение, чтобы параллельные операции перекрывались не более чем в два шага?
PyTorch, PaddlePaddle:
- В этом разделе используется ResNet-18. Попробуйте разное количество эпох, размеры минибатчей и скорости обучения, а также больше GPU для вычислений. Что произойдёт, если попробовать это на GPU (например, на экземпляре AWS p2.16xlarge)?
- Иногда разные устройства имеют разную вычислительную мощность, и мы можем использовать одновременно GPU и CPU. Как тогда распределять работу? Почему?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
12.7 Сервер параметров
Когда мы переходим от одного GPU к нескольким GPU, а затем к нескольким серверам с несколькими GPU (которые могут быть распределены по разным стойкам и сетевым коммутаторам), алгоритмы распределённого параллельного обучения тоже становятся сложнее. Выяснится, что пропускная способность разных способов соединения сильно различается. Например, NVLink может обеспечить до 100 ГБ/с по шести линиям, 16-канальный PCIe 4.0 даёт 32 ГБ/с, а даже скоростной 100GbE Ethernet — лишь около 10 ГБ/с. С другой стороны, было бы нереалистично ожидать, что разработчик, занимающийся статистическим моделированием обучения, будет ещё и экспертом в системах и сетях.
Основная идея сервера параметров была впервые предложена в работе (Smola and Narayanamurthy, 2010) в контексте распределённых скрытых переменных. Затем в работе (Ahmed et al., 2012) были описаны семантики push и pull, а в (Li et al., 2014) — системы и открытые библиотеки. Ниже мы опишем компоненты, которые повышают вычислительную эффективность.
12.7.1 Обучение с распараллеливанием данных
Вспомним подход к обучению с распараллеливанием данных в распределённой архитектуре. Поскольку на практике его реализовать относительно просто, мы ограничимся только им. Современные GPU имеют большой объём памяти, поэтому в реальных сценариях (за исключением обучения на графах) рекомендуется только такой вариант параллельного обучения. На рис. 12.7.1 показан вариант параллелизма данных, рассмотренный в разделе 12.5. Ключевой момент здесь в том, что агрегация градиентов выполняется на одном GPU (GPU 0), после чего обновлённые параметры рассылаются всем GPU.
Рис. 12.7.1. Слева — обучение на одном GPU; справа — вариант обучения на нескольких GPU: (1) вычисляются потери и градиенты, (2) все градиенты агрегируются на одном GPU, (3) выполняется обновление параметров и они повторно рассылаются всем GPU
Если оглянуться, выбор GPU 0 для агрегации может показаться произвольным. Конечно, можно агрегировать на CPU. Более того, на практике, если оптимизационный алгоритм это поддерживает, часть параметров можно агрегировать на одном GPU, а другую часть — на другом. Например, если есть четыре градиента , связанных с вектором параметров, их агрегацию можно выполнить на отдельном GPU для каждого ().
Такие рассуждения могут показаться легкомысленными и произвольными: математика ведь должна быть логически непротиворечивой. Однако мы имеем дело с реальным физическим оборудованием, описанным в разделе 12.4, где разные шины обладают разной пропускной способностью. Рассмотрим реальный сервер с четырьмя GPU, описанный в разделе 12.4. Если соединения в нём особенно полноценные, у него может быть сетевая карта 100GbE. Более типичные значения — в диапазоне 1–10 GbE, с эффективной пропускной способностью от 100 МБ/с до 1 ГБ/с. Поскольку у CPU слишком мало линий PCIe (например, у потребительских процессоров Intel их 24), подключить к нему напрямую все GPU нельзя, поэтому нужен коммутатор (multiplexer). Пропускная способность CPU по каналу x16 Gen3 составляет 16 ГБ/с, с такой же скоростью каждый GPU подключён к коммутатору. Это означает, что обмен данными между GPU происходит эффективнее.
Рис. 12.7.2. Сервер с четырьмя GPU
Для удобства примем, что градиенты всех параметров в сумме занимают 160 МБ. В этом случае передача градиентов трёх GPU на четвёртый займёт 30 мс (на каждую передачу требуется 10 мс = 160 МБ / 16 ГБ/с). Ещё 30 мс уйдёт на обратную передачу вектора весов, и в итоге получается 60 мс. Если отправлять все данные на CPU, понадобится 80 мс, причём 40 мс будут потрачены впустую, потому что каждый из четырёх GPU должен отправить данные на CPU. Наконец, предположим, что градиенты можно разбить на четыре части по 40 МБ и агрегировать каждую часть на своём GPU одновременно. Поскольку коммутатор PCIe обеспечивает полную пропускную способность между всеми линиями, передача займёт мс вместо 30 мс, а вся операция синхронизации — 15 мс. Итак, одна и та же операция синхронизации параметров может занимать от 15 мс до 80 мс в зависимости от стратегии. На рис. 12.7.3 показаны разные стратегии обмена параметрами.
Рис. 12.7.3. Стратегии синхронизации параметров
Обратите внимание, что можно использовать ещё один инструмент для повышения производительности. В глубокой сети вычисление всех градиентов от верхних слоёв до нижних занимает некоторое время. Поэтому можно начать синхронизировать градиенты уже готовых параметров, не дожидаясь, пока будут вычислены градиенты остальных. Подробности см. в работе (Sergeev and Del Balso, 2018), а практическая реализация описана в Horovod.
12.7.2 Кольцевая синхронизация (ring synchronization)
Когда речь заходит о синхронизации в современном аппаратном обеспечении для глубокого обучения, мы часто сталкиваемся с большим количеством специализированных сетевых соединений. Например, в экземплярах AWS p3.16xlarge и NVIDIA DGX-2 используется структура, показанная на рис. 12.7.4. Каждый GPU подключён к центральному процессору по линии PCIe, которая может работать со скоростью не более 16 ГБ/с. Кроме того, у каждого GPU есть шесть соединений NVLink, и каждое из них может передавать данные в обоих направлениях со скоростью 300 Гбит/с. Это примерно на каждое соединение в каждом направлении. Иными словами, совокупная пропускная способность NVLink заметно выше пропускной способности PCIe, и вопрос в том, как использовать её эффективно.
Рис. 12.7.4. Соединение NVLink на серверах с восемью GPU V100 (иллюстрация NVIDIA)
Результаты работы (Wang et al., 2018) показывают, что оптимальная стратегия синхронизации — разбить сеть на два кольца и синхронизировать данные непосредственно по этим кольцам. На рис. 12.7.5 показано, что сеть можно разложить на кольцо с удвоенной пропускной способностью NVLink (1-2-3-4-5-6-7-8-1) и кольцо с обычной пропускной способностью (1-4-6-3-5-8-2-7-1). В этом случае очень важно разработать эффективный протокол синхронизации.
Рис. 12.7.5. Разложение сети NVLink на два кольца
Рассмотрим мысленный эксперимент. Пусть есть кольцо из вычислительных узлов (или GPU). Градиенты можно передавать от первого узла ко второму; второй узел складывает свои локальные градиенты с полученными и отправляет результат третьему узлу, и так далее. После шага агрегированный градиент окажется в последнем посещённом узле. То есть время агрегации градиентов растёт линейно с количеством узлов. Но если действовать именно так, алгоритм будет довольно неэффективным: в любой момент времени обменивается данными только один узел. Что если разбить градиенты на блоков и начать синхронизацию блока с узла ? Поскольку размер каждого блока равен , общее время составит . Иными словами, при увеличении размера кольца время агрегации градиентов не растёт. Это довольно удивительный результат. На рис. 12.7.6 показана последовательность шагов для узлов.
Рис. 12.7.6. Кольцевая синхронизация на 4 узлах. Каждый узел начинает отправлять часть градиентов своему левому соседу, пока у правого соседа не появится агрегированный градиент
Если применить тот же пример и синхронизировать 160 МБ данных на 8 GPU V100, получим примерно . Это лучше, чем результат при использовании шины PCIe, даже если теперь у нас 8 GPU. Заметим, что на практике эти цифры обычно немного хуже, потому что фреймворки глубокого обучения не могут объединять коммуникацию в большие пакетные передачи.
Есть распространённое заблуждение, что кольцевая синхронизация принципиально отличается от других алгоритмов синхронизации. На самом деле по сравнению с простым древовидным алгоритмом её единственное отличие в том, что путь синхронизации немного более тонко организован.
12.7.3 Обучение на нескольких машинах
На нескольких машинах распределённое обучение сталкивается с новыми трудностями: серверам нужно обмениваться данными, а соединены они через относительно медленную сетевую структуру. В некоторых случаях скорость такого соединения может быть ниже на порядок, поэтому синхронизация между устройствами становится сложной задачей. Ведь код обучения на разных машинах работает с незначительно разной скоростью, поэтому, если мы хотим использовать алгоритм синхронизации для распределённой оптимизации, нужно синхронизировать (synchronize) эти машины. На рис. 12.7.7 показано, как происходит распределённое параллельное обучение.
- На каждой машине читается свой набор (отличающихся) минибатчей. Данные делятся между несколькими GPU и передаются в память GPU. Затем на каждом GPU отдельно вычисляются предсказания и градиенты по его минибатчу.
- Градиенты со всех локальных GPU одной машины агрегируются на одном GPU (или их части агрегируются на разных GPU).
- Градиенты каждой машины отправляются в её локальный CPU.
- Все CPU отправляют градиенты на центральный сервер параметров, который агрегирует все градиенты.
- Затем агрегированные градиенты используются для обновления параметров, и обновлённые параметры рассылаются обратно на CPU.
- Информация об обновлённых параметрах отправляется на один (или несколько) локальных GPU.
- Обновление параметров на всех GPU завершено.
Рис. 12.7.7. Распределённое параллельное обучение на нескольких машинах с несколькими GPU
Все эти операции кажутся довольно простыми, и на самом деле их можно эффективно выполнять внутри одной машины. Однако при большем числе машин центральный сервер параметров становится узким местом. Действительно, пропускная способность каждого сервера ограничена, поэтому для рабочих узлов время отправки всех градиентов на сервер равно . Этот барьер можно преодолеть, увеличив число серверов параметров до . Тогда каждый сервер должен хранить лишь параметров, и общее время обновления и оптимизации становится . Совпадение этих двух величин даёт стабильное масштабирование, независимо от того, сколько рабочих узлов мы используем. На практике одна и та же машина служит одновременно и рабочим узлом, и сервером. Схема приведена на рис. 12.7.8 (технические подробности см. в работе (Li et al., 2014)). В частности, очень трудно добиться того, чтобы несколько машин работали без неоправданных задержек.
Рис. 12.7.8. Сверху: один сервер параметров — узкое место из-за ограниченной пропускной способности; снизу: несколько серверов параметров хранят часть параметров и используют совокупную пропускную способность
12.7.4 Хранилище «ключ — значение»
На практике реализовать шаги, необходимые для распределённого обучения на нескольких GPU, совсем не просто. Поэтому стоит использовать общую абстракцию, а именно переопределить хранилище «ключ — значение» (key-value store) с семантикой обновления.
Для многих рабочих узлов и многих GPU вычисление градиента можно записать так:
где — часть градиента , которая расположена на GPU рабочего узла . Ключевое свойство этой операции в том, что она является коммутативной редукцией (commutative reduction): она превращает много векторов в один, и порядок, в котором это делается, не важен. Это очень удобно для нашей задачи, потому что не нужно тонко контролировать, в какой момент получать какой градиент. Кроме того, заметим, что эта операция независима для разных .
Это позволяет определить две операции: push (для накопления градиентов) и pull (для получения агрегированных градиентов). Поскольку слоёв много, а значит, и много разных наборов градиентов, градиенты нужно индексировать ключом . Сходство с хранилищем «ключ — значение», введённым в Dynamo (DeCandia et al., 2007), не случайно: у них много общих свойств, особенно при распределении параметров между несколькими серверами.
Операции push и pull для хранилища «ключ — значение» описываются так:
- push(key, value) отправляет конкретные значения градиента от рабочего узла в общее хранилище, где значения агрегируются определённым образом (например, складываются);
- pull(key, value) получает из общего хранилища агрегированное значение, полученное определённым образом (например, объединяя градиенты со всех рабочих узлов).
Скрывая всю сложность синхронизации за простыми операциями push и pull, мы разделяем задачи специалиста по статистическому моделированию (который хочет выражать оптимизацию простыми средствами) и системного инженера (которому приходится разбираться с неизбежной сложностью распределённой синхронизации).
Резюме
- Синхронизация должна в высокой степени учитывать конкретную сетевую инфраструктуру и соединения внутри сервера, так как от этого существенно зависит время синхронизации.
- Кольцевая синхронизация оптимальна для серверов p3 и DGX-2, но для других серверов это может быть не так.
- Когда для увеличения пропускной способности добавляется несколько серверов параметров, хорошо работает иерархическая стратегия синхронизации.
Упражнения
- Попробуйте дополнительно улучшить производительность кольцевой синхронизации. (Подсказка: сообщения можно отправлять в обоих направлениях.)
- Можно ли разрешить асинхронную коммуникацию, пока вычисления ещё продолжаются? Как это повлияет на производительность?
- Как справиться с ситуацией, когда в процессе длительных вычислений выходит из строя один из серверов? Попробуйте придумать механизм отказоустойчивости, который позволит не перезапускать вычисления.
Литература
- DeCandia, G., Hastorun, D., Jampani, M., Kakulapati, G., Lakshman, A., Pilchin, A., Sivasubramanian, S., Vosshall, P., & Vogels, W. (2007). Dynamo: Amazon’s highly available key-value store. ACM SIGOPS Operating Systems Review, 41(6), 205–220.
- Wang, L., Li, M., Liberty, E., & Smola, A. J. (2018). Optimal message scheduling for aggregation. Networks, 2–3.
- Ahmed, A., Aly, M., Gonzalez, J., Narayanamurthy, S., & Smola, A. J. (2012). Scalable inference in latent variable models. Proceedings of the Fifth ACM International Conference on Web Search and Data Mining, 123–132.
- Li, M., Andersen, D. G., Park, J. W., Smola, A. J., Ahmed, A., Josifovski, V., Long, J., Shekita, E. J., & Su, B.-Y. (2014). Scaling distributed machine learning with the parameter server. 11th USENIX Symposium on Operating Systems Design and Implementation (OSDI 14), 583–598.
- Smola, A., & Narayanamurthy, S. (2010). An architecture for parallel topic models. Proceedings of the VLDB Endowment, 3(1–2), 703–710.
13. Компьютерное зрение
В последние годы глубокое обучение стало движущей силой повышения качества систем компьютерного зрения. Медицинская диагностика, беспилотные автомобили, интеллектуальные фильтры, видеонаблюдение — многие приложения компьютерного зрения тесно связаны с нашей жизнью сегодня и в будущем. Можно сказать, что самые современные приложения компьютерного зрения почти неотделимы от глубокого обучения. Поэтому в этой главе мы сосредоточимся на компьютерном зрении и рассмотрим методы и приложения, которые в последнее время заметно повлияли на научное сообщество и промышленность.
В главах 6 и 7 мы изучали различные свёрточные нейронные сети, широко используемые в компьютерном зрении, и применяли их к простым задачам классификации изображений. В начале этой главы мы познакомимся с двумя методами, которые помогают улучшить обобщающую способность моделей, — аугментацией изображений и дообучением, и применим их к классификации изображений. Поскольку глубокие нейронные сети эффективно представляют изображения на нескольких уровнях, такое иерархическое представление успешно используется во многих задачах компьютерного зрения, например в обнаружении объектов (object detection), семантической сегментации (semantic segmentation) и переносе стиля (style transfer). Опираясь на идею использования иерархических представлений в компьютерном зрении, мы начнём с основных компонентов и методов обнаружения объектов. Затем покажем, как использовать полносвёрточные сети для семантической сегментации изображений, и объясним, как с помощью переноса стиля создавать изображения, похожие на обложку этой книги. В завершение главы мы применим знания из этой и предыдущих глав к двум популярным эталонным наборам данных для компьютерного зрения.
13.1 Аугментация изображений
В разделе 7.1 уже говорилось, что большие наборы данных — необходимое условие успешного применения глубоких нейронных сетей. Аугментация изображений (image augmentation) на основе обучающих изображений создаёт похожие, но разные обучающие примеры: случайно изменяет изображения и тем самым расширяет обучающий набор. Кроме того, аугментация полезна потому, что случайные изменения примеров уменьшают зависимость модели от некоторых свойств и повышают её способность к обобщению. Например, можно по-разному обрезать изображение, чтобы объект оказывался в разных местах кадра, и тем самым снизить зависимость модели от положения объекта. Можно также менять яркость, цвет и другие параметры, чтобы уменьшить чувствительность модели к цвету. Можно сказать, что методы аугментации были необходимы для успеха AlexNet. В этом разделе мы рассмотрим этот метод, широко применяемый в компьютерном зрении.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, gluon, image, init, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.vision as paddlevision
from paddle import nn
13.1.1 Распространённые методы аугментации
Для изучения методов аугментации мы будем использовать изображение размером в качестве примера.
MXNet:
d2l.set_figsize()
img = image.imread('../img/cat1.jpg')
d2l.plt.imshow(img.asnumpy());
PyTorch, PaddlePaddle:
d2l.set_figsize()
img = d2l.Image.open('../img/cat1.jpg')
d2l.plt.imshow(img);
Большинство методов аугментации содержат элемент случайности. Чтобы наглядно увидеть эффект аугментации, определим вспомогательную функцию apply. Она многократно применяет метод аугментации aug к входному изображению img и выводит все результаты.
def apply(img, aug, num_rows=2, num_cols=4, scale=1.5):
Y = [aug(img) for _ in range(num_rows * num_cols)]
d2l.show_images(Y, num_rows, num_cols, scale=scale)
13.1.1.1 Отражение и обрезка
Горизонтальное отражение изображения обычно не меняет класс объекта. Это один из самых ранних и самых широко используемых методов аугментации. Создадим экземпляр RandomFlipLeftRight из модуля transforms: с вероятностью 50% изображение отразится влево или вправо.
MXNet:
apply(img, gluon.data.vision.transforms.RandomFlipLeftRight())
PyTorch:
apply(img, torchvision.transforms.RandomHorizontalFlip())
PaddlePaddle:
apply(img, paddlevision.transforms.RandomHorizontalFlip())
Вертикальное отражение изображения используется реже, чем горизонтальное. Однако для данного примера изображения вертикальное отражение не мешает распознаванию. Создадим экземпляр RandomFlipTopBottom, чтобы с вероятностью 50% изображение отразилось вверх или вниз.
MXNet:
apply(img, gluon.data.vision.transforms.RandomFlipTopBottom())
PyTorch:
apply(img, torchvision.transforms.RandomVerticalFlip())
PaddlePaddle:
apply(img, paddlevision.transforms.RandomVerticalFlip())
В примере кошка находится в центре изображения, но так бывает не всегда. В разделе 6.5 мы объясняли, что слой пулинга снижает чувствительность свёрточного слоя к положению объекта. Кроме того, можно случайно обрезать изображение, чтобы объект появлялся в разных местах кадра и в разном масштабе. Это тоже снижает чувствительность модели к положению объекта.
В приведённом ниже коде случайно обрезается область, площадь которой составляет от 10% до 100% исходной, а отношение сторон случайно выбирается от 0,5 до 2. Затем ширина и высота области масштабируются до 200 пикселей. В этом разделе (если не оговорено иное) случайное число между и — это непрерывное значение, равномерно выбранное из отрезка .
MXNet:
shape_aug = gluon.data.vision.transforms.RandomResizedCrop(
(200, 200), scale=(0.1, 1), ratio=(0.5, 2))
apply(img, shape_aug)
PyTorch:
shape_aug = torchvision.transforms.RandomResizedCrop(
(200, 200), scale=(0.1, 1), ratio=(0.5, 2))
apply(img, shape_aug)
PaddlePaddle:
shape_aug = paddlevision.transforms.RandomResizedCrop(
(200, 200), scale=(0.1, 1), ratio=(0.5, 2))
apply(img, shape_aug)
13.1.1.2 Изменение цвета
Другой способ аугментации — изменение цвета. Можно изменять четыре параметра цвета изображения: яркость, контраст, насыщенность и оттенок. В примере ниже мы случайно меняем яркость изображения в пределах от 50% () до 150% () от исходного значения.
MXNet:
apply(img, gluon.data.vision.transforms.RandomBrightness(0.5))
PyTorch:
apply(img, torchvision.transforms.ColorJitter(
brightness=0.5, contrast=0, saturation=0, hue=0))
PaddlePaddle:
apply(img, paddlevision.transforms.ColorJitter(
brightness=0.5, contrast=0, saturation=0, hue=0))
Аналогично мы можем случайно менять оттенок изображения.
MXNet:
apply(img, gluon.data.vision.transforms.RandomHue(0.5))
PyTorch:
apply(img, torchvision.transforms.ColorJitter(
brightness=0, contrast=0, saturation=0, hue=0.5))
PaddlePaddle:
apply(img, paddlevision.transforms.ColorJitter(
brightness=0, contrast=0, saturation=0, hue=0.5))
Можно также создать экземпляр RandomColorJitter и задать, как случайно менять яркость (brightness), контраст (contrast), насыщенность (saturation) и оттенок (hue) изображения одновременно.
MXNet:
color_aug = gluon.data.vision.transforms.RandomColorJitter(
brightness=0.5, contrast=0.5, saturation=0.5, hue=0.5)
apply(img, color_aug)
PyTorch:
color_aug = torchvision.transforms.ColorJitter(
brightness=0.5, contrast=0.5, saturation=0.5, hue=0.5)
apply(img, color_aug)
PaddlePaddle:
color_aug = paddlevision.transforms.ColorJitter(
brightness=0.5, contrast=0.5, saturation=0.5, hue=0.5)
apply(img, color_aug)
13.1.1.3 Комбинирование нескольких методов аугментации
На практике мы комбинируем несколько методов аугментации. Например, можно объединить описанные выше методы с помощью экземпляра Compose и применять их к каждому изображению.
MXNet:
augs = gluon.data.vision.transforms.Compose([
gluon.data.vision.transforms.RandomFlipLeftRight(), color_aug, shape_aug])
apply(img, augs)
PyTorch:
augs = torchvision.transforms.Compose([
torchvision.transforms.RandomHorizontalFlip(), color_aug, shape_aug])
apply(img, augs)
PaddlePaddle:
augs = paddlevision.transforms.Compose([
paddle.vision.transforms.RandomHorizontalFlip(), color_aug, shape_aug])
apply(img, augs)
13.1.2 Обучение с использованием аугментации изображений
Теперь обучим модель с аугментацией. Здесь мы используем набор данных CIFAR-10, а не Fashion-MNIST, который применяли раньше. Причина в том, что в Fashion-MNIST положение и размер объектов уже нормализованы, а в CIFAR-10 различия в цвете и размере объектов выражены сильнее. Первые 32 обучающих изображения CIFAR-10 показаны ниже.
MXNet:
d2l.show_images(gluon.data.vision.CIFAR10(
train=True)[0:32][0], 4, 8, scale=0.8);
PyTorch:
all_images = torchvision.datasets.CIFAR10(train=True, root="../data",
download=True)
d2l.show_images([all_images[i][0] for i in range(32)], 4, 8, scale=0.8);
PaddlePaddle:
all_images = paddlevision.datasets.Cifar10(mode='train' , download=True)
print(len(all_images))
d2l.show_images([all_images[i][0] for i in range(32)], 4, 8, scale=0.8);
Чтобы результат предсказания был однозначным, аугментацию обычно применяют только к обучающим примерам, а при предсказании случайные методы аугментации не используют. Здесь мы используем только самое простое — случайное горизонтальное отражение. Кроме того, экземпляр ToTensor преобразует пакет изображений в формат, который требуется фреймворку глубокого обучения: 32-битные числа с плавающей точкой, форма (размер батча, число каналов, высота, ширина), значения от 0 до 1.
MXNet:
train_augs = gluon.data.vision.transforms.Compose([
gluon.data.vision.transforms.RandomFlipLeftRight(),
gluon.data.vision.transforms.ToTensor()])
test_augs = gluon.data.vision.transforms.Compose([
gluon.data.vision.transforms.ToTensor()])
PyTorch:
train_augs = torchvision.transforms.Compose([
torchvision.transforms.RandomHorizontalFlip(),
torchvision.transforms.ToTensor()])
test_augs = torchvision.transforms.Compose([
torchvision.transforms.ToTensor()])
PaddlePaddle:
train_augs = paddlevision.transforms.Compose([
paddlevision.transforms.RandomHorizontalFlip(),
paddlevision.transforms.ToTensor()])
test_augs = paddlevision.transforms.Compose([
paddlevision.transforms.ToTensor()])
MXNet: Далее определим вспомогательную функцию, которая читает изображения и применяет аугментацию. Функция transform_first из набора данных Gluon применяет аугментацию к первому элементу каждого обучающего примера (то есть к изображению, а не к метке). Подробнее о DataLoader см. в разделе 3.5.
PyTorch: Далее определим вспомогательную функцию, которая читает изображения и применяет аугментацию. Параметр transform набора данных PyTorch применяет аугментацию к изображениям. Подробнее о DataLoader см. в разделе 3.5.
MXNet:
def load_cifar10(is_train, augs, batch_size):
return gluon.data.DataLoader(
gluon.data.vision.CIFAR10(train=is_train).transform_first(augs),
batch_size=batch_size, shuffle=is_train,
num_workers=d2l.get_dataloader_workers())
PyTorch:
def load_cifar10(is_train, augs, batch_size):
dataset = torchvision.datasets.CIFAR10(root="../data", train=is_train,
transform=augs, download=True)
dataloader = torch.utils.data.DataLoader(dataset, batch_size=batch_size,
shuffle=is_train, num_workers=d2l.get_dataloader_workers())
return dataloader
PaddlePaddle:
def load_cifar10(is_train, augs, batch_size):
dataset = paddlevision.datasets.Cifar10(mode="train",
transform=augs, download=True)
dataloader = paddle.io.DataLoader(dataset, batch_size=batch_size,
num_workers=d2l.get_dataloader_workers(), shuffle=is_train)
return dataloader
13.1.2.1 Обучение на нескольких GPU
Мы обучим модель ResNet-18 из раздела 7.6 на CIFAR-10. Напомним, что обучение на нескольких GPU описано в разделе 12.6. Далее определим функцию, которая обучает и оценивает модель на нескольких GPU.
MXNet:
#@save
def train_batch_ch13(net, features, labels, loss, trainer, devices,
split_f=d2l.split_batch):
"""Обучение на минибатче с использованием нескольких GPU"""
X_shards, y_shards = split_f(features, labels, devices)
with autograd.record():
pred_shards = [net(X_shard) for X_shard in X_shards]
ls = [loss(pred_shard, y_shard) for pred_shard, y_shard
in zip(pred_shards, y_shards)]
for l in ls:
l.backward()
# Флаг True разрешает использовать устаревшие градиенты, это полезно (например, при дообучении BERT)
trainer.step(labels.shape[0], ignore_stale_grad=True)
train_loss_sum = sum([float(l.sum()) for l in ls])
train_acc_sum = sum(d2l.accuracy(pred_shard, y_shard)
for pred_shard, y_shard in zip(pred_shards, y_shards))
return train_loss_sum, train_acc_sum
PyTorch:
#@save
def train_batch_ch13(net, X, y, loss, trainer, devices):
"""Обучение на минибатче с использованием нескольких GPU"""
if isinstance(X, list):
# Нужно для дообучения BERT
X = [x.to(devices[0]) for x in X]
else:
X = X.to(devices[0])
y = y.to(devices[0])
net.train()
trainer.zero_grad()
pred = net(X)
l = loss(pred, y)
l.sum().backward()
trainer.step()
train_loss_sum = l.sum()
train_acc_sum = d2l.accuracy(pred, y)
return train_loss_sum, train_acc_sum
PaddlePaddle:
#@save
def train_batch_ch13(net, X, y, loss, trainer, devices):
"""Обучение на минибатче с использованием нескольких GPU.
PaddlePaddle не поддерживает обучение на нескольких GPU в notebook"""
if isinstance(X, list):
# Нужно для дообучения BERT (см. далее)
X = [paddle.to_tensor(x, place=devices[0]) for x in X]
else:
X = paddle.to_tensor(X, place=devices[0])
y = paddle.to_tensor(y, place=devices[0])
net.train()
trainer.clear_grad()
pred = net(X)
l = loss(pred, y)
l.sum().backward()
trainer.step()
train_loss_sum = l.sum()
train_acc_sum = d2l.accuracy(pred, y)
return train_loss_sum, train_acc_sum
MXNet:
#@save
def train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices=d2l.try_all_gpus(), split_f=d2l.split_batch):
"""Обучение модели с использованием нескольких GPU"""
timer, num_batches = d2l.Timer(), len(train_iter)
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs], ylim=[0, 1],
legend=['потери (обучение)', 'точность (обучение)',
'точность (тест)'])
for epoch in range(num_epochs):
# 4 величины: сумма потерь на обучении, точность на обучении, число примеров, число элементов
metric = d2l.Accumulator(4)
for i, (features, labels) in enumerate(train_iter):
timer.start()
l, acc = train_batch_ch13(
net, features, labels, loss, trainer, devices, split_f)
metric.add(l, acc, labels.shape[0], labels.size)
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[2], metric[1] / metric[3],
None))
test_acc = d2l.evaluate_accuracy_gpus(net, test_iter, split_f)
animator.add(epoch + 1, (None, None, test_acc))
print(f'потери {metric[0] / metric[2]:.3f}, точность на обучении '
f'{metric[1] / metric[3]:.3f}, точность на тесте {test_acc:.3f}')
print(f'{metric[2] * num_epochs / timer.sum():.1f} примеров/с на '
f'{str(devices)}')
PyTorch:
#@save
def train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices=d2l.try_all_gpus()):
"""Обучение модели с использованием нескольких GPU"""
timer, num_batches = d2l.Timer(), len(train_iter)
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs], ylim=[0, 1],
legend=['потери (обучение)', 'точность (обучение)',
'точность (тест)'])
net = nn.DataParallel(net, device_ids=devices).to(devices[0])
for epoch in range(num_epochs):
# 4 величины: сумма потерь на обучении, точность на обучении, число примеров, число элементов
metric = d2l.Accumulator(4)
for i, (features, labels) in enumerate(train_iter):
timer.start()
l, acc = train_batch_ch13(
net, features, labels, loss, trainer, devices)
metric.add(l, acc, labels.shape[0], labels.numel())
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[2], metric[1] / metric[3],
None))
test_acc = d2l.evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch + 1, (None, None, test_acc))
print(f'потери {metric[0] / metric[2]:.3f}, точность на обучении '
f'{metric[1] / metric[3]:.3f}, точность на тесте {test_acc:.3f}')
print(f'{metric[2] * num_epochs / timer.sum():.1f} примеров/с на '
f'{str(devices)}')
PaddlePaddle:
#@save
def train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices=d2l.try_all_gpus()):
"""Обучение модели с использованием нескольких GPU"""
timer, num_batches = d2l.Timer(), len(train_iter)
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs], ylim=[0, 1],
legend=['потери (обучение)', 'точность (обучение)',
'точность (тест)'])
net = paddle.DataParallel(net)
for epoch in range(num_epochs):
# 4 величины: сумма потерь на обучении, точность на обучении, число примеров, число элементов
metric = d2l.Accumulator(4)
for i, (features, labels) in enumerate(train_iter):
timer.start()
l, acc = train_batch_ch13(
net, features, labels, loss, trainer, devices)
metric.add(l, acc, labels.shape[0], labels.numel())
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[2], metric[1] / metric[3],
None))
test_acc = d2l.evaluate_accuracy_gpu(net, test_iter)
animator.add(epoch + 1, (None, None, test_acc))
print(f'потери {metric[0] / metric[2]:.3f}, точность на обучении '
f'{metric[1] / metric[3]:.3f}, точность на тесте {test_acc:.3f}')
print(f'{metric[2] * num_epochs / timer.sum():.1f} примеров/с на '
f'{str(devices)}')
Теперь определим функцию train_with_data_aug, которая обучает модель с аугментацией изображений. Она использует все доступные GPU, оптимизирует модель алгоритмом Adam, применяет аугментацию к обучающему набору и в конце вызывает определённую выше функцию train_ch13 для обучения и оценки модели.
MXNet:
batch_size, devices, net = 256, d2l.try_all_gpus(), d2l.resnet18(10)
net.initialize(init=init.Xavier(), ctx=devices)
def train_with_data_aug(train_augs, test_augs, net, lr=0.001):
train_iter = load_cifar10(True, train_augs, batch_size)
test_iter = load_cifar10(False, test_augs, batch_size)
loss = gluon.loss.SoftmaxCrossEntropyLoss()
trainer = gluon.Trainer(net.collect_params(), 'adam',
{'learning_rate': lr})
train_ch13(net, train_iter, test_iter, loss, trainer, 10, devices)
PyTorch:
batch_size, devices, net = 256, d2l.try_all_gpus(), d2l.resnet18(10, 3)
def init_weights(m):
if type(m) in [nn.Linear, nn.Conv2d]:
nn.init.xavier_uniform_(m.weight)
net.apply(init_weights)
def train_with_data_aug(train_augs, test_augs, net, lr=0.001):
train_iter = load_cifar10(True, train_augs, batch_size)
test_iter = load_cifar10(False, test_augs, batch_size)
loss = nn.CrossEntropyLoss(reduction="none")
trainer = torch.optim.Adam(net.parameters(), lr=lr)
train_ch13(net, train_iter, test_iter, loss, trainer, 10, devices)
PaddlePaddle:
batch_size, devices, net = 256, d2l.try_all_gpus(), d2l.resnet18(10, 3)
def init_weights(m):
if type(m) in [nn.Linear, nn.Conv2D]:
nn.initializer.XavierUniform(m.weight)
net.apply(init_weights)
def train_with_data_aug(train_augs, test_augs, net, lr=0.001):
train_iter = load_cifar10(True, train_augs, batch_size)
test_iter = load_cifar10(False, test_augs, batch_size)
loss = nn.CrossEntropyLoss(reduction="none")
trainer = paddle.optimizer.Adam(learning_rate=lr, parameters=net.parameters())
train_ch13(net, train_iter, test_iter, loss, trainer, 10, devices[:1])
Теперь обучим модель, используя аугментацию со случайным горизонтальным отражением.
train_with_data_aug(train_augs, test_augs, net)
Резюме
- Аугментация изображений создаёт случайные изображения на основе существующих обучающих данных и повышает способность модели к обобщению.
- Чтобы результат предсказания был однозначным, аугментацию обычно применяют только к обучающим примерам, а при предсказании случайные методы аугментации не используют.
- Фреймворки глубокого обучения предлагают множество методов аугментации изображений, которые можно применять одновременно.
Упражнения
- Обучите модель без аугментации:
train_with_data_aug(no_aug, no_aug). Сравните результаты обучения и точность на тесте при использовании аугментации и без неё. Подтверждает ли этот эксперимент, что аугментация изображений уменьшает переобучение? Почему? - Обучите модель на CIFAR-10, комбинируя несколько разных методов аугментации. Повышает ли это точность на тесте?
- Изучите онлайн-документацию фреймворка глубокого обучения. Какие ещё методы аугментации изображений в нём есть?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
13.2 Дообучение
В предыдущих разделах мы обучали модели на наборе Fashion-MNIST, в котором всего 60 тысяч изображений. Мы также упоминали ImageNet — самый широко используемый в научном сообществе набор изображений, содержащий более 10 миллионов изображений и 1000 классов объектов. Однако наборы данных, с которыми мы встречаемся на практике, обычно по размеру находятся между этими двумя.
Предположим, мы хотим распознавать на фотографиях разные типы стульев, чтобы затем предлагать пользователю ссылки для покупки. Один из возможных способов — сначала выбрать 100 распространённых видов стульев, сфотографировать каждый вид с 1000 разных ракурсов, а затем обучить классификационную модель на собранном наборе изображений. Хотя такой набор данных о стульях может быть больше Fashion-MNIST, число примеров по-прежнему составляет менее одной десятой от ImageNet. Сложная модель, подходящая для ImageNet, на таком наборе о стульях, скорее всего, переобучится. Кроме того, из-за ограниченного числа обучающих примеров точность обученной модели может не соответствовать практическим требованиям.
Очевидное решение этих проблем — собрать больше данных. Однако сбор и разметка данных могут занимать много времени и средств. Например, чтобы собрать набор данных ImageNet, исследователи потратили миллионы долларов на финансирование исследований. Хотя стоимость сбора данных сейчас значительно снизилась, её нельзя игнорировать.
Другое решение — применить трансферное обучение (transfer learning) и перенести знания, полученные на исходном наборе данных (source dataset), на целевой набор данных (target dataset). Например, хотя большинство изображений в наборе ImageNet не имеют отношения к стульям, модель, обученная на этом наборе, может выделять более общие признаки изображений. Они помогают распознавать края, текстуры, формы и сочетания объектов. Такие же признаки могут эффективно работать и для распознавания стульев.
13.2.1 Этапы
В этом разделе рассматривается распространённый приём трансферного обучения: дообучение (fine-tuning). Как показано на рис. 13.2.1, дообучение включает четыре этапа.
- Предварительно обучить нейронную сеть на исходном наборе данных (например, ImageNet). Это исходная модель (source model).
- Создать новую нейронную сеть — целевую модель (target model). Она копирует все элементы архитектуры исходной модели и её параметры, кроме выходного слоя. Мы предполагаем, что параметры содержат знания, полученные на исходном наборе данных, которые применимы и к целевому набору. Также мы предполагаем, что выходной слой исходной модели тесно связан с метками исходного набора данных, поэтому в целевой модели этот слой не используется.
- Добавить в целевую модель выходной слой с числом выходов, равным числу классов целевого набора данных. Затем случайным образом инициализировать параметры этого слоя.
- Обучить целевую модель на целевом наборе данных (например, наборе о стульях). Выходной слой обучается с нуля, а параметры всех остальных слоёв дообучаются на основе параметров исходной модели.
Рис. 13.2.1. Дообучение
Когда целевой набор данных значительно меньше исходного, дообучение помогает повысить способность модели к обобщению.
13.2.2 Распознавание хот-догов
Продемонстрируем дообучение на конкретном примере: распознавании хот-догов. Мы дообучим модель ResNet на небольшом наборе данных. Эта модель предварительно обучена на ImageNet. Набор содержит несколько тысяч изображений с хот-догами и без них. Мы будем использовать дообученную модель, чтобы определять, есть ли на изображении хот-дог.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import gluon, init, np, npx
from mxnet.gluon import nn
import os
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
from torch import nn
import torch
import torchvision
import os
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
from paddle import nn
import paddle
import paddle.vision as paddlevision
import os
13.2.2.1 Получение набора данных
Набор данных о хот-догах взят из интернета. Он содержит 1400 изображений «положительного» класса с хот-догами и столько же изображений «отрицательного» класса с другими продуктами. По 1000 изображений каждого класса используются для обучения, остальные — для тестирования.
После распаковки скачанного набора данных мы получаем две папки: hotdog/train и hotdog/test. В каждой из них есть подпапки hotdog (есть хот-дог) и not-hotdog (нет хот-дога), а в подпапках находятся изображения соответствующего класса.
#@save
d2l.DATA_HUB['hotdog'] = (d2l.DATA_URL + 'hotdog.zip',
'fba480ffa8aa7e0febbb511d181409f899b9baa5')
data_dir = d2l.download_extract('hotdog')
Создадим два экземпляра, которые читают все изображения из обучающего и тестового наборов данных.
MXNet:
train_imgs = gluon.data.vision.ImageFolderDataset(
os.path.join(data_dir, 'train'))
test_imgs = gluon.data.vision.ImageFolderDataset(
os.path.join(data_dir, 'test'))
PyTorch:
train_imgs = torchvision.datasets.ImageFolder(os.path.join(data_dir, 'train'))
test_imgs = torchvision.datasets.ImageFolder(os.path.join(data_dir, 'test'))
PaddlePaddle:
train_imgs = paddlevision.datasets.DatasetFolder(os.path.join(data_dir, 'train'))
test_imgs = paddlevision.datasets.DatasetFolder(os.path.join(data_dir, 'test'))
Ниже показаны первые 8 изображений положительного класса и последние 8 изображений отрицательного класса. Как видно, размер и соотношение сторон изображений различаются.
hotdogs = [train_imgs[i][0] for i in range(8)]
not_hotdogs = [train_imgs[-i - 1][0] for i in range(8)]
d2l.show_images(hotdogs + not_hotdogs, 2, 8, scale=1.4);
Во время обучения мы сначала вырезаем из изображения область случайного размера со случайным соотношением сторон, а затем масштабируем её до входного изображения размером . Во время тестирования мы масштабируем высоту и ширину изображения до 256 пикселей и затем вырезаем центральную область в качестве входа. Кроме того, для каналов RGB (красного, зелёного и синего) мы нормализуем каждый канал отдельно. А именно, из каждого значения канала вычитается среднее значение по этому каналу, а результат делится на стандартное отклонение по нему.
MXNet:
# Нормализуем каждый канал по средним значениям и стандартным отклонениям RGB-каналов
normalize = gluon.data.vision.transforms.Normalize(
[0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
train_augs = gluon.data.vision.transforms.Compose([
gluon.data.vision.transforms.RandomResizedCrop(224),
gluon.data.vision.transforms.RandomFlipLeftRight(),
gluon.data.vision.transforms.ToTensor(),
normalize])
test_augs = gluon.data.vision.transforms.Compose([
gluon.data.vision.transforms.Resize(256),
gluon.data.vision.transforms.CenterCrop(224),
gluon.data.vision.transforms.ToTensor(),
normalize])
PyTorch:
# Нормализуем каждый канал по средним значениям и стандартным отклонениям RGB-каналов
normalize = torchvision.transforms.Normalize(
[0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
train_augs = torchvision.transforms.Compose([
torchvision.transforms.RandomResizedCrop(224),
torchvision.transforms.RandomHorizontalFlip(),
torchvision.transforms.ToTensor(),
normalize])
test_augs = torchvision.transforms.Compose([
torchvision.transforms.Resize([256, 256]),
torchvision.transforms.CenterCrop(224),
torchvision.transforms.ToTensor(),
normalize])
PaddlePaddle:
# Нормализуем каждый канал по средним значениям и стандартным отклонениям RGB-каналов
normalize = paddle.vision.transforms.Normalize(
[0.485, 0.456, 0.406], [0.229, 0.224, 0.225])
train_augs = paddlevision.transforms.Compose([
paddlevision.transforms.RandomResizedCrop(224),
paddlevision.transforms.RandomHorizontalFlip(),
paddlevision.transforms.ToTensor(),
normalize])
test_augs = paddlevision.transforms.Compose([
paddlevision.transforms.Resize(256),
paddlevision.transforms.CenterCrop(224),
paddlevision.transforms.ToTensor(),
normalize])
13.2.2.2 Определение и инициализация модели
Мы используем ResNet-18, предварительно обученную на ImageNet, в качестве исходной модели. Здесь мы указываем pretrained=True, чтобы автоматически загрузить предобученные параметры модели. Если эта модель используется впервые, для загрузки нужен доступ в интернет.
MXNet:
pretrained_net = gluon.model_zoo.vision.resnet18_v2(pretrained=True)
PyTorch:
pretrained_net = torchvision.models.resnet18(pretrained=True)
PaddlePaddle:
pretrained_net = paddlevision.models.resnet18(pretrained=True)
MXNet: Экземпляр предобученной исходной модели содержит два атрибута: features и output. Первый содержит все слои модели, кроме выходного, второй — выходной слой модели. Основное назначение такого разделения — упростить дообучение параметров всех слоёв, кроме выходного. Атрибут output исходной модели показан ниже.
PyTorch, PaddlePaddle: Экземпляр предобученной исходной модели содержит множество слоёв признаков и выходной слой fc. Основное назначение такого разделения — упростить дообучение параметров всех слоёв, кроме выходного. Атрибут fc исходной модели показан ниже.
MXNet:
pretrained_net.output
PyTorch, PaddlePaddle:
pretrained_net.fc
После глобального среднего пулинга ResNet полносвязный слой выдаёт 1000 выходов — по числу классов ImageNet. Затем мы строим новую нейронную сеть как целевую модель. Она определяется так же, как предобученная исходная модель, но число выходов последнего слоя задаётся равным числу классов целевого набора данных (а не 1000).
В приведённом ниже коде параметры атрибута features целевой модели finetune_net инициализируются значениями соответствующих слоёв исходной модели. Поскольку эти параметры предобучены на ImageNet и достаточно хороши, обычно для их дообучения достаточно небольшой скорости обучения.
Параметры атрибута output инициализируются случайно; для обучения с нуля обычно нужна более высокая скорость обучения. Пусть скорость обучения в Trainer равна , тогда для параметров output мы зададим скорость обучения .
MXNet:
finetune_net = gluon.model_zoo.vision.resnet18_v2(classes=2)
finetune_net.features = pretrained_net.features
finetune_net.output.initialize(init.Xavier())
# Скорость обучения выходного слоя в десять раз больше, чем у остальных слоёв
finetune_net.output.collect_params().setattr('lr_mult', 10)
PyTorch:
finetune_net = torchvision.models.resnet18(pretrained=True)
finetune_net.fc = nn.Linear(finetune_net.fc.in_features, 2)
nn.init.xavier_uniform_(finetune_net.fc.weight);
PaddlePaddle:
finetune_net = paddlevision.models.resnet18(pretrained=True)
finetune_net.fc = nn.Linear(pretrained_net.fc.state_dict()['weight'].shape[0], 2)
nn.initializer.XavierUniform(pretrained_net.fc.state_dict()['weight']);
13.2.2.3 Дообучение модели
Сначала определим функцию обучения train_fine_tuning, которая использует дообучение и поэтому может вызываться многократно.
MXNet:
def train_fine_tuning(net, learning_rate, batch_size=128, num_epochs=5):
train_iter = gluon.data.DataLoader(
train_imgs.transform_first(train_augs), batch_size, shuffle=True)
test_iter = gluon.data.DataLoader(
test_imgs.transform_first(test_augs), batch_size)
devices = d2l.try_all_gpus()
net.collect_params().reset_ctx(devices)
net.hybridize()
loss = gluon.loss.SoftmaxCrossEntropyLoss()
trainer = gluon.Trainer(net.collect_params(), 'sgd', {
'learning_rate': learning_rate, 'wd': 0.001})
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)
PyTorch:
# Если param_group=True, параметры выходного слоя используют в десять раз большую скорость обучения
def train_fine_tuning(net, learning_rate, batch_size=128, num_epochs=5,
param_group=True):
train_iter = torch.utils.data.DataLoader(torchvision.datasets.ImageFolder(
os.path.join(data_dir, 'train'), transform=train_augs),
batch_size=batch_size, shuffle=True)
test_iter = torch.utils.data.DataLoader(torchvision.datasets.ImageFolder(
os.path.join(data_dir, 'test'), transform=test_augs),
batch_size=batch_size)
devices = d2l.try_all_gpus()
loss = nn.CrossEntropyLoss(reduction="none")
if param_group:
params_1x = [param for name, param in net.named_parameters()
if name not in ["fc.weight", "fc.bias"]]
trainer = torch.optim.SGD([{'params': params_1x},
{'params': net.fc.parameters(),
'lr': learning_rate * 10}],
lr=learning_rate, weight_decay=0.001)
else:
trainer = torch.optim.SGD(net.parameters(), lr=learning_rate,
weight_decay=0.001)
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)
PaddlePaddle:
# Если param_group=True, параметры выходного слоя используют в десять раз большую скорость обучения
def train_fine_tuning(net, learning_rate, batch_size=128, num_epochs=5,
param_group=True):
train_iter = paddle.io.DataLoader(paddle.vision.datasets.DatasetFolder(
os.path.join(data_dir, 'train'), transform=train_augs),
batch_size=batch_size, shuffle=True)
test_iter = paddle.io.DataLoader(paddle.vision.datasets.DatasetFolder(
os.path.join(data_dir, 'test'), transform=test_augs),
batch_size=batch_size)
devices = d2l.try_all_gpus()
loss = nn.CrossEntropyLoss(reduction="none")
if param_group:
params_1x = [param for name, param in net.named_parameters()
if name not in ["fc.weight", "fc.bias"]]
trainer = paddle.optimizer.SGD(learning_rate=learning_rate, parameters=[{'params': params_1x},
{'params': net.fc.parameters(),
'learning_rate': learning_rate * 10}],
weight_decay=0.001)
else:
trainer = paddle.optimizer.SGD(learning_rate=learning_rate, parameters=net.parameters(),
weight_decay=0.001)
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
Теперь дообучим модель с небольшой скоростью обучения на параметрах, полученных предобучением.
MXNet:
train_fine_tuning(finetune_net, 0.01)
PyTorch, PaddlePaddle:
train_fine_tuning(finetune_net, 5e-5)
Для сравнения определим такую же модель, но инициализируем все её параметры случайными значениями. Поскольку вся модель обучается с нуля, нужна более высокая скорость обучения.
MXNet:
scratch_net = gluon.model_zoo.vision.resnet18_v2(classes=2)
scratch_net.initialize(init=init.Xavier())
train_fine_tuning(scratch_net, 0.1)
PyTorch:
scratch_net = torchvision.models.resnet18()
scratch_net.fc = nn.Linear(scratch_net.fc.in_features, 2)
train_fine_tuning(scratch_net, 5e-4, param_group=False)
PaddlePaddle:
scratch_net = paddlevision.models.resnet18()
scratch_net.fc = nn.Linear(pretrained_net.fc.state_dict()['weight'].shape[0], 2)
train_fine_tuning(scratch_net, 5e-4, param_group=False)
Как и ожидалось, дообученная модель обычно показывает лучший результат, поскольку её начальные значения параметров удачнее.
Резюме
- Трансферное обучение переносит знания, полученные на исходном наборе данных, на целевой набор данных. Дообучение — распространённый приём трансферного обучения.
- Целевая модель копирует все элементы архитектуры исходной модели вместе с её параметрами, кроме выходного слоя, и дообучает эти параметры на целевом наборе данных. Выходной слой целевой модели нужно обучать с нуля.
- Обычно параметры для дообучения берут с небольшой скоростью обучения, а выходной слой, обучаемый с нуля, — с более высокой.
Упражнения
- Продолжайте увеличивать скорость обучения
finetune_net. Как изменится точность модели? - В сравнительном эксперименте дополнительно подберите гиперпараметры для
finetune_netиscratch_net. Различаются ли их точности и теперь? - Задайте параметры
finetune_netперед выходным слоем равными параметрам исходной модели и не обновляйте их во время обучения. Как изменится точность модели? Подсказка: можно использовать такой код.
MXNet:
finetune_net.features.collect_params().setattr('grad_req', 'null')
PyTorch:
for param in finetune_net.parameters():
param.requires_grad = False
PaddlePaddle:
for param in finetune_net.parameters():
param.stop_gradient = True
- На самом деле в наборе данных
ImageNetесть класс «хот-дог». Мы можем получить соответствующие весовые параметры его выходного слоя с помощью следующего кода. Но как нам использовать эти весовые параметры?
MXNet:
weight = pretrained_net.output.weight
hotdog_w = np.split(weight.data(), 1000, axis=0)[713]
hotdog_w.shape
PyTorch:
weight = pretrained_net.fc.weight
hotdog_w = torch.split(weight.data, 1, dim=0)[934]
hotdog_w.shape
PaddlePaddle:
weight = pretrained_net.fc.weight
hotdog_w = paddle.split(weight.T, 1000, axis=0)[713]
hotdog_w.shape
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
13.3 Обнаружение объектов и ограничивающие рамки
В предыдущих разделах (например, в разделах 7.1–7.4) мы рассматривали различные модели классификации изображений. В задачах классификации мы предполагаем, что на изображении есть только один главный объект, и нас интересует лишь его класс. Однако часто на изображении есть несколько интересующих нас объектов, и нам нужно знать не только их классы, но и то, где именно они находятся. В компьютерном зрении такие задачи называют обнаружением объектов (object detection) или распознаванием объектов (object recognition).
Обнаружение объектов широко используется в разных областях. Например, в беспилотных автомобилях нужно планировать маршрут по видеоизображениям, распознавая положение автомобилей, пешеходов, дорог и препятствий. Роботы тоже часто решают эту задачу, чтобы находить интересующие их объекты. В сфере безопасности нужно обнаруживать подозрительные объекты, например оружие или взрывчатку.
В следующих разделах мы рассмотрим несколько методов глубокого обучения для обнаружения объектов. Сначала мы введём понятие положения объекта.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import image, npx, np
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
Загрузим пример изображения, которое будем использовать в этом разделе. Слева на изображении собака, справа — кошка. Это два главных объекта на этом изображении.
MXNet:
d2l.set_figsize()
img = image.imread('../img/catdog.jpg').asnumpy()
d2l.plt.imshow(img);
PyTorch, TensorFlow, PaddlePaddle:
d2l.set_figsize()
img = d2l.plt.imread('../img/catdog.jpg')
d2l.plt.imshow(img);
13.3.1 Ограничивающие рамки
В задачах обнаружения объектов положение объекта в пространстве обычно описывают ограничивающей рамкой (bounding box). Ограничивающая рамка — это прямоугольник, заданный координатами и левого верхнего и правого нижнего углов. Другой распространённый способ задать ограничивающую рамку — координаты её центра, а также ширина и высота.
Здесь мы определяем функции, которые переводят одно представление в другое: box_corner_to_center преобразует представление «два угла» в представление «центр, ширина и высота», а box_center_to_corner делает обратное. Входной параметр boxes может быть тензором длины 4 или двумерным тензором формы (, 4), где — количество ограничивающих рамок.
#@save
def box_corner_to_center(boxes):
"""Преобразование из формата (левый верхний, правый нижний) в формат (центр, ширина, высота)"""
x1, y1, x2, y2 = boxes[:, 0], boxes[:, 1], boxes[:, 2], boxes[:, 3]
cx = (x1 + x2) / 2
cy = (y1 + y2) / 2
w = x2 - x1
h = y2 - y1
boxes = d2l.stack((cx, cy, w, h), axis=-1)
return boxes
#@save
def box_center_to_corner(boxes):
"""Преобразование из формата (центр, ширина, высота) в формат (левый верхний, правый нижний)"""
cx, cy, w, h = boxes[:, 0], boxes[:, 1], boxes[:, 2], boxes[:, 3]
x1 = cx - 0.5 * w
y1 = cy - 0.5 * h
x2 = cx + 0.5 * w
y2 = cy + 0.5 * h
boxes = d2l.stack((x1, y1, x2, y2), axis=-1)
return boxes
Зададим ограничивающие рамки собаки и кошки по координатам. Начало координат изображения находится в левом верхнем углу; ось направлена вправо, ось — вниз.
# bbox — сокращение от английского «bounding box» (ограничивающая рамка)
dog_bbox, cat_bbox = [60.0, 45.0, 378.0, 516.0], [400.0, 112.0, 655.0, 493.0]
Проверить правильность функций преобразования можно, выполнив преобразование дважды.
boxes = d2l.tensor((dog_bbox, cat_bbox))
box_center_to_corner(box_corner_to_center(boxes)) == boxes
Чтобы проверить точность рамок, нарисуем их на изображении. Перед этим определим вспомогательную функцию bbox_to_rect. Она переводит ограничивающую рамку в формат matplotlib.
#@save
def bbox_to_rect(bbox, color):
# Преобразуем ограничивающую рамку (x левого верхнего, y левого верхнего,
# x правого нижнего, y правого нижнего) в формат matplotlib:
# ((x левого верхнего, y левого верхнего), ширина, высота)
return d2l.plt.Rectangle(
xy=(bbox[0], bbox[1]), width=bbox[2]-bbox[0], height=bbox[3]-bbox[1],
fill=False, edgecolor=color, linewidth=2)
После добавления ограничивающих рамок на изображение видно, что основные контуры обоих объектов находятся внутри рамок.
fig = d2l.plt.imshow(img)
fig.axes.add_patch(bbox_to_rect(dog_bbox, 'blue'))
fig.axes.add_patch(bbox_to_rect(cat_bbox, 'red'));
Резюме
- Обнаружение объектов не только распознаёт все интересующие объекты на изображении, но и определяет их положение, которое обычно задаётся прямоугольной ограничивающей рамкой.
- Два распространённых представления ограничивающих рамок — (центр, ширина, высота) и (левый верхний угол, правый нижний угол) — можно переводить друг в друга.
Упражнения
- Найдите другое изображение и попробуйте разметить на нём ограничивающие рамки объектов. Что занимает больше времени: разметка ограничивающих рамок или разметка классов?
- Почему внутреннее (последнее) измерение входных параметров
box_corner_to_centerиbox_center_to_cornerвсегда равно 4?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
13.4 Якорные рамки
Алгоритмы обнаружения объектов обычно выбирают большое количество областей входного изображения, определяют, содержат ли они интересующие нас объекты, и уточняют границы областей, чтобы точнее предсказать истинную ограничивающую рамку (ground-truth bounding box) объекта. Разные модели могут использовать разные способы выбора областей. Здесь мы рассмотрим один из них: для каждого пикселя мы создаём несколько ограничивающих рамок с разными масштабами и разными соотношениями сторон (aspect ratio). Такие рамки называются якорными рамками (anchor box). В разделе 13.7 мы спроектируем модель обнаружения на основе якорных рамок.
Сначала изменим точность вывода, чтобы результаты были компактнее.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import gluon, image, np, npx
np.set_printoptions(2) # Уменьшаем точность вывода
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
torch.set_printoptions(2) # Уменьшаем точность вывода
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import numpy as np
paddle.set_printoptions(2) # Уменьшаем точность вывода
13.4.1 Генерация нескольких якорных рамок
Пусть высота входного изображения равна , а ширина — . Мы создаём якорные рамки с центром в каждом пикселе изображения: масштаб (scale) равен , а соотношение сторон (aspect ratio) — . Тогда ширина и высота якорной рамки равны и соответственно. Заметим, что если задано положение центра, то при известных ширине и высоте рамка определена однозначно.
Чтобы получить рамки разных форм, зададим несколько значений масштаба и несколько значений соотношения сторон . Если использовать все комбинации этих масштабов и соотношений сторон с центром в каждом пикселе, то входное изображение получит всего якорных рамок. Хотя такие рамки, возможно, покроют все истинные ограничивающие рамки, вычислительная сложность легко становится слишком высокой. На практике мы рассматриваем только те комбинации, которые содержат или :
Таким образом, число якорных рамок с центром в одном пикселе равно . Для всего входного изображения будет сгенерировано якорных рамок.
Описанный способ генерации якорных рамок реализован в функции multibox_prior ниже. Мы передаём ей входное изображение, список масштабов и список соотношений сторон, а функция возвращает все якорные рамки.
MXNet:
#@save
def multibox_prior(data, sizes, ratios):
"""Генерирует якорные рамки разной формы с центром в каждом пикселе"""
in_height, in_width = data.shape[-2:]
device, num_sizes, num_ratios = data.ctx, len(sizes), len(ratios)
boxes_per_pixel = (num_sizes + num_ratios - 1)
size_tensor = d2l.tensor(sizes, ctx=device)
ratio_tensor = d2l.tensor(ratios, ctx=device)
# Чтобы переместить опорные точки в центр пикселя, задаём смещение.
# Так как высота и ширина пикселя равны 1, смещаем центр на 0.5
offset_h, offset_w = 0.5, 0.5
steps_h = 1.0 / in_height # Шаг масштабирования по оси y
steps_w = 1.0 / in_width # Шаг масштабирования по оси x
# Генерируем все центры якорных рамок
center_h = (d2l.arange(in_height, ctx=device) + offset_h) * steps_h
center_w = (d2l.arange(in_width, ctx=device) + offset_w) * steps_w
shift_x, shift_y = d2l.meshgrid(center_w, center_h)
shift_x, shift_y = shift_x.reshape(-1), shift_y.reshape(-1)
# Генерируем «boxes_per_pixel» значений высоты и ширины,
# которые затем используются для вычисления угловых координат якорных рамок (xmin, xmax, ymin, ymax)
w = np.concatenate((size_tensor * np.sqrt(ratio_tensor[0]),
sizes[0] * np.sqrt(ratio_tensor[1:]))) \
* in_height / in_width # Учитываем прямоугольный вход
h = np.concatenate((size_tensor / np.sqrt(ratio_tensor[0]),
sizes[0] / np.sqrt(ratio_tensor[1:])))
# Делим на 2, чтобы получить полувысоту и полуширину
anchor_manipulations = np.tile(np.stack((-w, -h, w, h)).T,
(in_height * in_width, 1)) / 2
# У каждого центра будет «boxes_per_pixel» якорных рамок,
# поэтому создаём сетку всех центров якорных рамок, повторённую «boxes_per_pixel» раз
out_grid = d2l.stack([shift_x, shift_y, shift_x, shift_y],
axis=1).repeat(boxes_per_pixel, axis=0)
output = out_grid + anchor_manipulations
return np.expand_dims(output, axis=0)
PyTorch:
#@save
def multibox_prior(data, sizes, ratios):
"""Генерирует якорные рамки разной формы с центром в каждом пикселе"""
in_height, in_width = data.shape[-2:]
device, num_sizes, num_ratios = data.device, len(sizes), len(ratios)
boxes_per_pixel = (num_sizes + num_ratios - 1)
size_tensor = d2l.tensor(sizes, device=device)
ratio_tensor = d2l.tensor(ratios, device=device)
# Чтобы переместить опорные точки в центр пикселя, задаём смещение.
# Так как высота и ширина пикселя равны 1, смещаем центр на 0.5
offset_h, offset_w = 0.5, 0.5
steps_h = 1.0 / in_height # Шаг масштабирования по оси y
steps_w = 1.0 / in_width # Шаг масштабирования по оси x
# Генерируем все центры якорных рамок
center_h = (torch.arange(in_height, device=device) + offset_h) * steps_h
center_w = (torch.arange(in_width, device=device) + offset_w) * steps_w
shift_y, shift_x = torch.meshgrid(center_h, center_w, indexing='ij')
shift_y, shift_x = shift_y.reshape(-1), shift_x.reshape(-1)
# Генерируем «boxes_per_pixel» значений высоты и ширины,
# которые затем используются для вычисления угловых координат якорных рамок (xmin, xmax, ymin, ymax)
w = torch.cat((size_tensor * torch.sqrt(ratio_tensor[0]),
sizes[0] * torch.sqrt(ratio_tensor[1:])))\
* in_height / in_width # Учитываем прямоугольный вход
h = torch.cat((size_tensor / torch.sqrt(ratio_tensor[0]),
sizes[0] / torch.sqrt(ratio_tensor[1:])))
# Делим на 2, чтобы получить полувысоту и полуширину
anchor_manipulations = torch.stack((-w, -h, w, h)).T.repeat(
in_height * in_width, 1) / 2
# У каждого центра будет «boxes_per_pixel» якорных рамок,
# поэтому создаём сетку всех центров якорных рамок, повторённую «boxes_per_pixel» раз
out_grid = torch.stack([shift_x, shift_y, shift_x, shift_y],
dim=1).repeat_interleave(boxes_per_pixel, dim=0)
output = out_grid + anchor_manipulations
return output.unsqueeze(0)
PaddlePaddle:
#@save
def multibox_prior(data, sizes, ratios):
"""Генерирует якорные рамки разной формы с центром в каждом пикселе"""
in_height, in_width = data.shape[-2:]
place, num_sizes, num_ratios = data.place, len(sizes), len(ratios)
boxes_per_pixel = (num_sizes + num_ratios - 1)
size_tensor = paddle.to_tensor(sizes, place=place)
ratio_tensor = paddle.to_tensor(ratios, place=place)
# Чтобы переместить опорные точки в центр пикселя, задаём смещение.
# Так как высота и ширина пикселя равны 1, смещаем центр на 0.5
offset_h, offset_w = 0.5, 0.5
steps_h = 1.0 / in_height # Шаг масштабирования по оси y
steps_w = 1.0 / in_width # Шаг масштабирования по оси x
# Генерируем все центры якорных рамок
center_h = (paddle.arange(in_height) + offset_h) * steps_h
center_w = (paddle.arange(in_width) + offset_w) * steps_w
shift_y, shift_x = paddle.meshgrid(center_h, center_w)
shift_y, shift_x = shift_y.reshape([-1]), shift_x.reshape([-1])
# Генерируем «boxes_per_pixel» значений высоты и ширины,
# которые затем используются для вычисления угловых координат якорных рамок (xmin, xmax, ymin, ymax)
w = paddle.concat((size_tensor * paddle.sqrt(ratio_tensor[0]),
sizes[0] * paddle.sqrt(ratio_tensor[1:])))\
* in_height / in_width # Учитываем прямоугольный вход
h = paddle.concat((size_tensor / paddle.sqrt(ratio_tensor[0]),
sizes[0] / paddle.sqrt(ratio_tensor[1:])))
# Делим на 2, чтобы получить полувысоту и полуширину
anchor_manipulations = paddle.tile(paddle.stack((-w, -h, w, h)).T,
(in_height * in_width, 1)) / 2
# У каждого центра будет «boxes_per_pixel» якорных рамок,
# поэтому создаём сетку всех центров якорных рамок, повторённую «boxes_per_pixel» раз
out_grid = paddle.stack([shift_x, shift_y, shift_x, shift_y], axis=1)
out_grid = paddle.tile(out_grid, repeat_times=[boxes_per_pixel]).reshape((-1, out_grid.shape[1]))
output = out_grid + anchor_manipulations
return output.unsqueeze(0)
Посмотрим, какую форму имеет возвращаемая переменная Y: (размер батча, число якорных рамок, 4).
MXNet:
img = image.imread('../img/catdog.jpg').asnumpy()
h, w = img.shape[:2]
print(h, w)
X = np.random.uniform(size=(1, 3, h, w))
Y = multibox_prior(X, sizes=[0.75, 0.5, 0.25], ratios=[1, 2, 0.5])
Y.shape
PyTorch:
img = d2l.plt.imread('../img/catdog.jpg')
h, w = img.shape[:2]
print(h, w)
X = torch.rand(size=(1, 3, h, w))
Y = multibox_prior(X, sizes=[0.75, 0.5, 0.25], ratios=[1, 2, 0.5])
Y.shape
PaddlePaddle:
img = d2l.plt.imread('../img/catdog.jpg')
h, w = img.shape[:2]
print(h, w)
X = paddle.rand(shape=(1, 3, h, w))
Y = multibox_prior(X, sizes=[0.75, 0.5, 0.25], ratios=[1, 2, 0.5])
Y.shape
Если изменить форму переменной якорных рамок Y на (высота изображения, ширина изображения, число якорных рамок с центром в одном пикселе, 4), то мы получим все якорные рамки с центром в заданном пикселе. Далее получим первую якорную рамку с центром в пикселе (250, 250). Она содержит четыре элемента: координаты левого верхнего и правого нижнего углов рамки. Координаты по обеим осям в выводе поделены на ширину и высоту изображения соответственно.
MXNet, PyTorch:
boxes = Y.reshape(h, w, 5, 4)
boxes[250, 250, 0, :]
PaddlePaddle:
boxes = Y.reshape([h, w, 5, 4])
boxes[250, 250, 0, :]
Чтобы показать все якорные рамки с центром в некотором пикселе изображения, определим функцию show_bboxes, которая рисует несколько ограничивающих рамок на изображении.
#@save
def show_bboxes(axes, bboxes, labels=None, colors=None):
"""Показывает все ограничивающие рамки"""
def _make_list(obj, default_values=None):
if obj is None:
obj = default_values
elif not isinstance(obj, (list, tuple)):
obj = [obj]
return obj
labels = _make_list(labels)
colors = _make_list(colors, ['b', 'g', 'r', 'm', 'c'])
for i, bbox in enumerate(bboxes):
color = colors[i % len(colors)]
rect = d2l.bbox_to_rect(d2l.numpy(bbox), color)
axes.add_patch(rect)
if labels and len(labels) > i:
text_color = 'k' if color == 'w' else 'w'
axes.text(rect.xy[0], rect.xy[1], labels[i],
va='center', ha='center', fontsize=9, color=text_color,
bbox=dict(facecolor=color, lw=0))
Как видно из кода выше, значения координат по осям и в переменной boxes поделены на ширину и высоту изображения. При рисовании якорных рамок нужно вернуть исходные значения координат. Поэтому ниже мы определяем переменную bbox_scale. Теперь можно нарисовать все якорные рамки с центром в (250, 250). Как показано ниже, синяя якорная рамка с масштабом 0.75 и соотношением сторон 1 хорошо охватывает собаку на изображении.
d2l.set_figsize()
bbox_scale = d2l.tensor((w, h, w, h))
fig = d2l.plt.imshow(img)
show_bboxes(fig.axes, boxes[250, 250, :, :] * bbox_scale,
['s=0.75, r=1', 's=0.5, r=1', 's=0.25, r=1', 's=0.75, r=2',
's=0.75, r=0.5'])
13.4.2 Пересечение над объединением (IoU)
Мы только что сказали, что некоторая якорная рамка «хорошо» охватывает собаку на изображении. Как можно количественно оценить это «хорошо», если известна истинная ограничивающая рамка объекта? Интуитивно можно измерить сходство якорной рамки и истинной ограничивающей рамки. Коэффициент Жаккара (Jaccard index) измеряет сходство двух множеств. Для множеств и коэффициент Жаккара равен отношению размера их пересечения к размеру их объединения:
Фактически мы можем рассматривать область пикселей любой ограничивающей рамки как множество пикселей. Так можно измерить сходство двух ограничивающих рамок с помощью коэффициента Жаккара их множеств пикселей. Для двух ограничивающих рамок этот коэффициент обычно называют пересечением над объединением (intersection over union, IoU): это отношение площади пересечения двух рамок к площади их объединения, как показано на рис. 13.4.1. Значения IoU лежат в диапазоне от 0 до 1: 0 означает, что рамки не имеют общих пикселей, а 1 — что рамки полностью совпадают.
Рис. 13.4.1. Пересечение над объединением — это отношение площади пересечения двух ограничивающих рамок к площади их объединения
В следующих разделах IoU будет использоваться для измерения сходства между якорной рамкой и истинной ограничивающей рамкой, а также между разными якорными рамками. Для двух списков якорных или ограничивающих рамок функция box_iou ниже вычисляет попарные значения IoU.
MXNet:
#@save
def box_iou(boxes1, boxes2):
"""Вычисляет попарное IoU для двух списков якорных или ограничивающих рамок"""
box_area = lambda boxes: ((boxes[:, 2] - boxes[:, 0]) *
(boxes[:, 3] - boxes[:, 1]))
# Формы boxes1, boxes2, areas1, areas2:
# boxes1: (количество boxes1, 4),
# boxes2: (количество boxes2, 4),
# areas1: (количество boxes1,),
# areas2: (количество boxes2,)
areas1 = box_area(boxes1)
areas2 = box_area(boxes2)
# Формы inter_upperlefts, inter_lowerrights, inters:
# (количество boxes1, количество boxes2, 2)
inter_upperlefts = np.maximum(boxes1[:, None, :2], boxes2[:, :2])
inter_lowerrights = np.minimum(boxes1[:, None, 2:], boxes2[:, 2:])
inters = (inter_lowerrights - inter_upperlefts).clip(min=0)
# Форма inter_areas и union_areas: (количество boxes1, количество boxes2)
inter_areas = inters[:, :, 0] * inters[:, :, 1]
union_areas = areas1[:, None] + areas2 - inter_areas
return inter_areas / union_areas
PyTorch:
#@save
def box_iou(boxes1, boxes2):
"""Вычисляет попарное IoU для двух списков якорных или ограничивающих рамок"""
box_area = lambda boxes: ((boxes[:, 2] - boxes[:, 0]) *
(boxes[:, 3] - boxes[:, 1]))
# Формы boxes1, boxes2, areas1, areas2:
# boxes1: (количество boxes1, 4),
# boxes2: (количество boxes2, 4),
# areas1: (количество boxes1,),
# areas2: (количество boxes2,)
areas1 = box_area(boxes1)
areas2 = box_area(boxes2)
# Формы inter_upperlefts, inter_lowerrights, inters:
# (количество boxes1, количество boxes2, 2)
inter_upperlefts = torch.max(boxes1[:, None, :2], boxes2[:, :2])
inter_lowerrights = torch.min(boxes1[:, None, 2:], boxes2[:, 2:])
inters = (inter_lowerrights - inter_upperlefts).clamp(min=0)
# Форма inter_areas и union_areas: (количество boxes1, количество boxes2)
inter_areas = inters[:, :, 0] * inters[:, :, 1]
union_areas = areas1[:, None] + areas2 - inter_areas
return inter_areas / union_areas
PaddlePaddle:
#@save
def box_iou(boxes1, boxes2):
"""Вычисляет попарное IoU для двух списков якорных или ограничивающих рамок"""
box_area = lambda boxes: ((boxes[:, 2] - boxes[:, 0]) *
(boxes[:, 3] - boxes[:, 1]))
# Формы boxes1, boxes2, areas1, areas2:
# boxes1: (количество boxes1, 4),
# boxes2: (количество boxes2, 4),
# areas1: (количество boxes1,),
# areas2: (количество boxes2,)
areas1 = box_area(boxes1)
areas2 = box_area(boxes2)
# Формы inter_upperlefts, inter_lowerrights, inters:
# (количество boxes1, количество boxes2, 2)
inter_upperlefts = paddle.maximum(boxes1[:, None, :2], boxes2[:, :2])
inter_lowerrights = paddle.minimum(boxes1[:, None, 2:], boxes2[:, 2:])
inters = (inter_lowerrights - inter_upperlefts).clip(min=0)
# Форма inter_areas и union_areas: (количество boxes1, количество boxes2)
inter_areas = inters[:, :, 0] * inters[:, :, 1]
union_areas = areas1[:, None] + areas2 - inter_areas
return inter_areas / union_areas
13.4.3 Разметка якорных рамок в обучающих данных
В обучающем наборе каждую якорную рамку мы рассматриваем как обучающий пример. Чтобы обучить модель обнаружения объектов, нам нужны метки класса (class) и смещения (offset) для каждой якорной рамки. Класс — это категория объекта, связанного с якорной рамкой, а смещение — это смещение истинной ограничивающей рамки относительно якорной рамки. При предсказании мы генерируем много якорных рамок для каждого изображения, предсказываем классы и смещения всех якорных рамок, уточняем их положение по предсказанным смещениям, чтобы получить предсказанные ограничивающие рамки, и в конце выводим только те предсказанные рамки, которые удовлетворяют заданным условиям.
Обучающий набор для обнаружения объектов содержит положения истинных ограничивающих рамок и метки категорий объектов, которые в них находятся. Чтобы разметить любую сгенерированную якорную рамку, мы можем использовать положение и метку класса той истинной ограничивающей рамки, которая ближе всего к этой якорной рамке. Ниже описан алгоритм, который назначает ближайшую истинную ограничивающую рамку каждой якорной рамке.
13.4.3.1 Назначение истинных ограничивающих рамок якорным рамкам
Пусть якорные рамки — , а истинные ограничивающие рамки — , где . Определим матрицу , в которой элемент в -й строке и -м столбце — это IoU якорной рамки и истинной ограничивающей рамки . Алгоритм состоит из следующих шагов.
- Найдём наибольший элемент матрицы и обозначим его индекс строки и индекс столбца через и . Затем назначим истинную ограничивающую рамку якорной рамке . Это интуитивно понятно, поскольку и — самая близкая пара среди всех сочетаний якорных и истинных рамок. После этого назначения удалим все элементы в -й строке и -м столбце матрицы.
- Найдём наибольший из оставшихся элементов матрицы и обозначим его индекс строки и индекс столбца через и . Назначим истинную ограничивающую рамку якорной рамке и удалим все элементы в -й строке и -м столбце матрицы.
- Теперь в матрице удалены элементы двух строк и двух столбцов. Продолжаем так, пока не удалим все элементы в столбцах матрицы . К этому моменту каждой из якорных рамок назначена своя истинная ограничивающая рамка.
- Проходим только по оставшимся якорным рамкам. Например, для любой якорной рамки находим в -й строке матрицы истинную ограничивающую рамку с наибольшим IoU с . Назначаем рамке только в том случае, если это IoU больше заранее заданного порога.
Рассмотрим этот алгоритм на конкретном примере. Как показано на рис. 13.4.2 (слева), пусть наибольший элемент матрицы равен . Тогда назначаем истинную ограничивающую рамку якорной рамке . Далее удаляем все элементы второй строки и третьего столбца, находим наибольший элемент среди оставшихся (затенённая область) и назначаем рамку якорной рамке . Затем, как показано на рис. 13.4.2 (в центре), удаляем все элементы седьмой строки и первого столбца, находим наибольший элемент среди оставшихся (затенённая область) и назначаем рамку якорной рамке . Наконец, как показано на рис. 13.4.2 (справа), удаляем все элементы пятой строки и четвёртого столбца, находим наибольший элемент среди оставшихся (затенённая область) и назначаем рамку якорной рамке . После этого остаётся пройти по оставшимся якорным рамкам и решить, назначать ли им истинные рамки, исходя из порога.
Рис. 13.4.2. Назначение истинных ограничивающих рамок якорным рамкам
Этот алгоритм реализован в функции assign_anchor_to_bbox ниже.
MXNet:
#@save
def assign_anchor_to_bbox(ground_truth, anchors, device, iou_threshold=0.5):
"""Назначает ближайшую истинную ограничивающую рамку якорным рамкам"""
num_anchors, num_gt_boxes = anchors.shape[0], ground_truth.shape[0]
# Элемент x_ij в строке i и столбце j — это IoU якорной рамки i и истинной ограничивающей рамки j
jaccard = box_iou(anchors, ground_truth)
# Тензор назначенных истинных ограничивающих рамок для каждой якорной рамки
anchors_bbox_map = np.full((num_anchors,), -1, dtype=np.int32, ctx=device)
# По порогу решаем, назначать ли истинную ограничивающую рамку
max_ious, indices = np.max(jaccard, axis=1), np.argmax(jaccard, axis=1)
anc_i = np.nonzero(max_ious >= iou_threshold)[0]
box_j = indices[max_ious >= iou_threshold]
anchors_bbox_map[anc_i] = box_j
col_discard = np.full((num_anchors,), -1)
row_discard = np.full((num_gt_boxes,), -1)
for _ in range(num_gt_boxes):
max_idx = np.argmax(jaccard)
box_idx = (max_idx % num_gt_boxes).astype('int32')
anc_idx = (max_idx / num_gt_boxes).astype('int32')
anchors_bbox_map[anc_idx] = box_idx
jaccard[:, box_idx] = col_discard
jaccard[anc_idx, :] = row_discard
return anchors_bbox_map
PyTorch:
#@save
def assign_anchor_to_bbox(ground_truth, anchors, device, iou_threshold=0.5):
"""Назначает ближайшую истинную ограничивающую рамку якорным рамкам"""
num_anchors, num_gt_boxes = anchors.shape[0], ground_truth.shape[0]
# Элемент x_ij в строке i и столбце j — это IoU якорной рамки i и истинной ограничивающей рамки j
jaccard = box_iou(anchors, ground_truth)
# Тензор назначенных истинных ограничивающих рамок для каждой якорной рамки
anchors_bbox_map = torch.full((num_anchors,), -1, dtype=torch.long,
device=device)
# По порогу решаем, назначать ли истинную ограничивающую рамку
max_ious, indices = torch.max(jaccard, dim=1)
anc_i = torch.nonzero(max_ious >= iou_threshold).reshape(-1)
box_j = indices[max_ious >= iou_threshold]
anchors_bbox_map[anc_i] = box_j
col_discard = torch.full((num_anchors,), -1)
row_discard = torch.full((num_gt_boxes,), -1)
for _ in range(num_gt_boxes):
max_idx = torch.argmax(jaccard)
box_idx = (max_idx % num_gt_boxes).long()
anc_idx = (max_idx / num_gt_boxes).long()
anchors_bbox_map[anc_idx] = box_idx
jaccard[:, box_idx] = col_discard
jaccard[anc_idx, :] = row_discard
return anchors_bbox_map
PaddlePaddle:
#@save
def assign_anchor_to_bbox(ground_truth, anchors, place, iou_threshold=0.5):
"""Назначает ближайшую истинную ограничивающую рамку якорным рамкам"""
num_anchors, num_gt_boxes = anchors.shape[0], ground_truth.shape[0]
# Элемент x_ij в строке i и столбце j — это IoU якорной рамки i и истинной ограничивающей рамки j
jaccard = box_iou(anchors, ground_truth)
# Тензор назначенных истинных ограничивающих рамок для каждой якорной рамки
anchors_bbox_map = paddle.full((num_anchors,), -1, dtype=paddle.int64)
# По порогу решаем, назначать ли истинную ограничивающую рамку
max_ious = paddle.max(jaccard, axis=1)
indices = paddle.argmax(jaccard, axis=1)
anc_i = paddle.nonzero(max_ious >= 0.5).reshape([-1])
box_j = indices[max_ious >= 0.5]
anchors_bbox_map[anc_i] = box_j
col_discard = paddle.full((num_anchors,), -1)
row_discard = paddle.full((num_gt_boxes,), -1)
for _ in range(num_gt_boxes):
max_idx = paddle.argmax(jaccard)
box_idx = paddle.cast((max_idx % num_gt_boxes), dtype='int64')
anc_idx = paddle.cast((max_idx / num_gt_boxes), dtype='int64')
anchors_bbox_map[anc_idx] = box_idx
jaccard[:, box_idx] = col_discard
jaccard[anc_idx, :] = row_discard
return anchors_bbox_map
13.4.3.2 Разметка классов и смещений
Теперь можно разметить классы и смещения каждой якорной рамки. Пусть якорная рамка назначена истинной рамке . С одной стороны, класс якорной рамки помечается так же, как класс . С другой стороны, смещение якорной рамки задаётся по относительному положению центров и , а также по относительному размеру этих рамок. Поскольку положения и размеры рамок в наборе данных различаются, мы можем применить к этим относительным величинам преобразование, чтобы смещения были распределены равномернее и их было легче аппроксимировать. Здесь мы используем одно распространённое преобразование. Пусть даны рамки и с координатами центров и , шириной и и высотой и . Тогда смещение рамки записывается как:
где по умолчанию , , а . Это преобразование реализовано в функции offset_boxes ниже.
#@save
def offset_boxes(anchors, assigned_bb, eps=1e-6):
"""Преобразование смещений якорных рамок"""
c_anc = d2l.box_corner_to_center(anchors)
c_assigned_bb = d2l.box_corner_to_center(assigned_bb)
offset_xy = 10 * (c_assigned_bb[:, :2] - c_anc[:, :2]) / c_anc[:, 2:]
offset_wh = 5 * d2l.log(eps + c_assigned_bb[:, 2:] / c_anc[:, 2:])
offset = d2l.concat([offset_xy, offset_wh], axis=1)
return offset
Если якорной рамке не назначена истинная ограничивающая рамка, мы просто помечаем её класс как фон (background). Якорные рамки класса «фон» обычно называют отрицательными, а остальные — положительными. Мы реализуем функцию multibox_target ниже: она использует истинные ограничивающие рамки (параметр labels) и размечает классы и смещения якорных рамок (параметр anchors). Индекс фона полагается равным нулю, а индекс каждого нового класса увеличивается на единицу.
MXNet:
#@save
def multibox_target(anchors, labels):
"""Размечает якорные рамки с помощью истинных ограничивающих рамок"""
batch_size, anchors = labels.shape[0], anchors.squeeze(0)
batch_offset, batch_mask, batch_class_labels = [], [], []
device, num_anchors = anchors.ctx, anchors.shape[0]
for i in range(batch_size):
label = labels[i, :, :]
anchors_bbox_map = assign_anchor_to_bbox(
label[:, 1:], anchors, device)
bbox_mask = np.tile((np.expand_dims((anchors_bbox_map >= 0),
axis=-1)), (1, 4)).astype('int32')
# Инициализируем метки классов и координаты назначенных рамок нулями
class_labels = d2l.zeros(num_anchors, dtype=np.int32, ctx=device)
assigned_bb = d2l.zeros((num_anchors, 4), dtype=np.float32,
ctx=device)
# С помощью истинных ограничивающих рамок размечаем классы якорных рамок.
# Если якорная рамка не назначена, помечаем её как фон (значение ноль)
indices_true = np.nonzero(anchors_bbox_map >= 0)[0]
bb_idx = anchors_bbox_map[indices_true]
class_labels[indices_true] = label[bb_idx, 0].astype('int32') + 1
assigned_bb[indices_true] = label[bb_idx, 1:]
# Преобразование смещений
offset = offset_boxes(anchors, assigned_bb) * bbox_mask
batch_offset.append(offset.reshape(-1))
batch_mask.append(bbox_mask.reshape(-1))
batch_class_labels.append(class_labels)
bbox_offset = d2l.stack(batch_offset)
bbox_mask = d2l.stack(batch_mask)
class_labels = d2l.stack(batch_class_labels)
return (bbox_offset, bbox_mask, class_labels)
PyTorch:
#@save
def multibox_target(anchors, labels):
"""Размечает якорные рамки с помощью истинных ограничивающих рамок"""
batch_size, anchors = labels.shape[0], anchors.squeeze(0)
batch_offset, batch_mask, batch_class_labels = [], [], []
device, num_anchors = anchors.device, anchors.shape[0]
for i in range(batch_size):
label = labels[i, :, :]
anchors_bbox_map = assign_anchor_to_bbox(
label[:, 1:], anchors, device)
bbox_mask = ((anchors_bbox_map >= 0).float().unsqueeze(-1)).repeat(
1, 4)
# Инициализируем метки классов и координаты назначенных рамок нулями
class_labels = torch.zeros(num_anchors, dtype=torch.long,
device=device)
assigned_bb = torch.zeros((num_anchors, 4), dtype=torch.float32,
device=device)
# С помощью истинных ограничивающих рамок размечаем классы якорных рамок.
# Если якорная рамка не назначена, помечаем её как фон (значение ноль)
indices_true = torch.nonzero(anchors_bbox_map >= 0)
bb_idx = anchors_bbox_map[indices_true]
class_labels[indices_true] = label[bb_idx, 0].long() + 1
assigned_bb[indices_true] = label[bb_idx, 1:]
# Преобразование смещений
offset = offset_boxes(anchors, assigned_bb) * bbox_mask
batch_offset.append(offset.reshape(-1))
batch_mask.append(bbox_mask.reshape(-1))
batch_class_labels.append(class_labels)
bbox_offset = torch.stack(batch_offset)
bbox_mask = torch.stack(batch_mask)
class_labels = torch.stack(batch_class_labels)
return (bbox_offset, bbox_mask, class_labels)
PaddlePaddle:
#@save
def multibox_target(anchors, labels):
"""Размечает якорные рамки с помощью истинных ограничивающих рамок"""
batch_size, anchors = labels.shape[0], anchors.squeeze(0)
batch_offset, batch_mask, batch_class_labels = [], [], []
place, num_anchors = anchors.place, anchors.shape[0]
for i in range(batch_size):
label = labels[i, :, :]
anchors_bbox_map = assign_anchor_to_bbox(
label[:, 1:], anchors, place)
bbox_mask = paddle.tile(paddle.to_tensor((anchors_bbox_map >= 0), dtype='float32').unsqueeze(-1), (1, 4))
# Инициализируем метки классов и координаты назначенных рамок нулями
class_labels = paddle.zeros(paddle.to_tensor(num_anchors), dtype=paddle.int64)
assigned_bb = paddle.zeros(paddle.to_tensor((num_anchors, 4)), dtype=paddle.float32)
# С помощью истинных ограничивающих рамок размечаем классы якорных рамок.
# Если якорная рамка не назначена, помечаем её как фон (значение ноль)
indices_true = paddle.nonzero(anchors_bbox_map >= 0).numpy()
bb_idx = anchors_bbox_map[indices_true].numpy()
class_labels[indices_true] = label.numpy()[bb_idx, 0][:] + 1
assigned_bb[indices_true] = label.numpy()[bb_idx, 1:]
class_labels = paddle.to_tensor(class_labels)
assigned_bb = paddle.to_tensor(assigned_bb)
# Преобразование смещений
offset = offset_boxes(anchors, assigned_bb) * bbox_mask
batch_offset.append(offset.reshape([-1]))
batch_mask.append(bbox_mask.reshape([-1]))
batch_class_labels.append(class_labels)
bbox_offset = paddle.stack(batch_offset)
bbox_mask = paddle.stack(batch_mask)
class_labels = paddle.stack(batch_class_labels)
return (bbox_offset, bbox_mask, class_labels)
13.4.3.3 Пример
Рассмотрим разметку якорных рамок на конкретном примере. Мы уже определили истинные ограничивающие рамки собаки и кошки на загруженном изображении. Первый элемент каждой рамки — класс (0 — собака, 1 — кошка), остальные четыре элемента — координаты левого верхнего и правого нижнего углов (значения от 0 до 1). Также построим пять якорных рамок, заданных координатами левого верхнего и правого нижнего углов: (индексы начинаются с 0). Нарисуем на изображении эти истинные ограничивающие рамки и якорные рамки.
ground_truth = d2l.tensor([[0, 0.1, 0.08, 0.52, 0.92],
[1, 0.55, 0.2, 0.9, 0.88]])
anchors = d2l.tensor([[0, 0.1, 0.2, 0.3], [0.15, 0.2, 0.4, 0.4],
[0.63, 0.05, 0.88, 0.98], [0.66, 0.45, 0.8, 0.8],
[0.57, 0.3, 0.92, 0.9]])
fig = d2l.plt.imshow(img)
show_bboxes(fig.axes, ground_truth[:, 1:] * bbox_scale, ['dog', 'cat'], 'k')
show_bboxes(fig.axes, anchors * bbox_scale, ['0', '1', '2', '3', '4']);
С помощью функции multibox_target, определённой выше, мы можем разметить классы и смещения этих якорных рамок по истинным ограничивающим рамкам собаки и кошки. В этом примере индексы классов фона, собаки и кошки равны 0, 1 и 2 соответственно. Ниже мы добавляем размерность и для якорных рамок, и для истинных ограничивающих рамок.
MXNet:
labels = multibox_target(np.expand_dims(anchors, axis=0),
np.expand_dims(ground_truth, axis=0))
PyTorch:
labels = multibox_target(anchors.unsqueeze(dim=0),
ground_truth.unsqueeze(dim=0))
PaddlePaddle:
labels = multibox_target(anchors.unsqueeze(axis=0),
ground_truth.unsqueeze(axis=0))
Возвращаются три тензора. Третий содержит размеченные классы входных якорных рамок.
Разберём метки классов, возвращённые ниже, исходя из положения якорных и истинных рамок на изображении. Прежде всего среди всех пар якорных и истинных рамок наибольшее IoU у якорной рамки и истинной рамки кошки. Поэтому класс помечается как кошка. Исключим пары, в которые входят или истинная рамка кошки. Среди оставшихся пар наибольшее IoU у якорной рамки и истинной рамки собаки. Поэтому класс помечается как собака. Далее нужно пройти по трём оставшимся неразмеченным якорным рамкам: , и . Для истинная рамка с наибольшим IoU относится к классу собаки, но IoU ниже заранее заданного порога (0.5), поэтому класс помечается как фон. Для истинная рамка с наибольшим IoU относится к классу кошки, и IoU превышает порог, поэтому класс помечается как кошка. Для истинная рамка с наибольшим IoU относится к классу кошки, но значение ниже порога, поэтому класс помечается как фон.
labels[2]
Второй возвращаемый элемент — маска, её форма (размер батча, число якорных рамок ×4). Элементы маски соответствуют четырём смещениям каждой якорной рамки. Поскольку нас не интересует обнаружение фона, смещения отрицательного класса не должны влиять на целевую функцию. Поэлементным умножением нули маски отфильтровывают смещения отрицательных классов до вычисления целевой функции.
labels[1]
Первый возвращаемый элемент содержит четыре смещения, размеченные для каждой якорной рамки. Обратите внимание, что смещения якорных рамок отрицательного класса помечены нулями.
labels[0]
13.4.4 Предсказание ограничивающих рамок с помощью подавления немаксимумов
При предсказании мы сначала генерируем много якорных рамок для изображения, затем для каждой из них предсказываем класс и смещение. Предсказанная ограничивающая рамка строится по одной из якорных рамок с предсказанным смещением. Ниже мы реализуем функцию offset_inverse, которая принимает якорные рамки и предсказанные смещения и применяет обратное преобразование смещений, чтобы получить координаты предсказанных ограничивающих рамок.
#@save
def offset_inverse(anchors, offset_preds):
"""Предсказание ограничивающих рамок по якорным рамкам с предсказанными смещениями"""
anc = d2l.box_corner_to_center(anchors)
pred_bbox_xy = (offset_preds[:, :2] * anc[:, 2:] / 10) + anc[:, :2]
pred_bbox_wh = d2l.exp(offset_preds[:, 2:] / 5) * anc[:, 2:]
pred_bbox = d2l.concat((pred_bbox_xy, pred_bbox_wh), axis=1)
predicted_bbox = d2l.box_center_to_corner(pred_bbox)
return predicted_bbox
Когда якорных рамок много, может получиться много похожих предсказанных ограничивающих рамок с заметным перекрытием, которые окружают один и тот же объект. Чтобы упростить вывод, мы можем использовать подавление немаксимумов (non-maximum suppression, NMS): оно объединяет похожие предсказанные рамки, относящиеся к одному объекту.
Вот как работает подавление немаксимумов. Для предсказанной ограничивающей рамки модель обнаружения вычисляет предсказанную вероятность каждого класса. Пусть наибольшая из них равна ; класс, которому она соответствует, и есть предсказанный класс . Величину называют уверенностью (confidence) предсказанной рамки . Для одного изображения все предсказанные непустые (не фоновые) ограничивающие рамки сортируются по убыванию уверенности, и получается список . Затем мы обрабатываем отсортированный список следующими шагами.
- Выбираем из предсказанную рамку с наибольшей уверенностью в качестве эталона и удаляем из все остальные предсказанные рамки, у которых IoU с превышает заранее заданный порог . Теперь содержит рамку с наибольшей уверенностью и не содержит других рамок, слишком похожих на неё. Иными словами, рамки с немаксимальной уверенностью подавлены.
- Выбираем из предсказанную рамку со второй по величине уверенностью в качестве нового эталона и удаляем из все остальные рамки, у которых IoU с больше .
- Повторяем процесс, пока каждая предсказанная рамка в не побывает эталоном. К этому моменту любая пара рамок в имеет IoU меньше порога , поэтому никакие две рамки не слишком похожи друг на друга.
- Выводим все предсказанные рамки из списка .
Функция nms ниже сортирует уверенности по убыванию и возвращает их индексы.
MXNet:
#@save
def nms(boxes, scores, iou_threshold):
"""Сортирует уверенности предсказанных ограничивающих рамок"""
B = scores.argsort()[::-1]
keep = [] # Индексы рамок, которые нужно сохранить
while B.size > 0:
i = B[0]
keep.append(i)
if B.size == 1: break
iou = box_iou(boxes[i, :].reshape(-1, 4),
boxes[B[1:], :].reshape(-1, 4)).reshape(-1)
inds = np.nonzero(iou <= iou_threshold)[0]
B = B[inds + 1]
return np.array(keep, dtype=np.int32, ctx=boxes.ctx)
PyTorch:
#@save
def nms(boxes, scores, iou_threshold):
"""Сортирует уверенности предсказанных ограничивающих рамок"""
B = torch.argsort(scores, dim=-1, descending=True)
keep = [] # Индексы рамок, которые нужно сохранить
while B.numel() > 0:
i = B[0]
keep.append(i)
if B.numel() == 1: break
iou = box_iou(boxes[i, :].reshape(-1, 4),
boxes[B[1:], :].reshape(-1, 4)).reshape(-1)
inds = torch.nonzero(iou <= iou_threshold).reshape(-1)
B = B[inds + 1]
return d2l.tensor(keep, device=boxes.device)
PaddlePaddle:
#@save
def nms(boxes, scores, iou_threshold):
"""Сортирует уверенности предсказанных ограничивающих рамок"""
B = paddle.argsort(scores, axis=-1, descending=True)
keep = [] # Индексы рамок, которые нужно сохранить
while B.numel().item() > 0:
i = B[0]
keep.append(i.item())
if B.numel().item() == 1: break
iou = box_iou(boxes[i.numpy(), :].reshape([-1, 4]),
paddle.to_tensor(boxes.numpy()[B[1:].numpy(), :]).reshape([-1, 4])).reshape([-1])
inds = paddle.nonzero(iou <= iou_threshold).numpy().reshape([-1])
B = paddle.to_tensor(B.numpy()[inds + 1])
return paddle.to_tensor(keep, place=boxes.place, dtype='int64')
Определим функцию multibox_detection, которая применяет подавление немаксимумов к предсказанным ограничивающим рамкам. Реализация немного сложнее, не беспокойтесь о ней. Сразу после реализации мы покажем её работу на конкретном примере.
MXNet:
#@save
def multibox_detection(cls_probs, offset_preds, anchors, nms_threshold=0.5,
pos_threshold=0.009999999):
"""Предсказывает ограничивающие рамки с помощью подавления немаксимумов"""
device, batch_size = cls_probs.ctx, cls_probs.shape[0]
anchors = np.squeeze(anchors, axis=0)
num_classes, num_anchors = cls_probs.shape[1], cls_probs.shape[2]
out = []
for i in range(batch_size):
cls_prob, offset_pred = cls_probs[i], offset_preds[i].reshape(-1, 4)
conf, class_id = np.max(cls_prob[1:], 0), np.argmax(cls_prob[1:], 0)
predicted_bb = offset_inverse(anchors, offset_pred)
keep = nms(predicted_bb, conf, nms_threshold)
# Находим все индексы, которые не вошли в keep, и помечаем их классом «фон»
all_idx = np.arange(num_anchors, dtype=np.int32, ctx=device)
combined = d2l.concat((keep, all_idx))
unique, counts = np.unique(combined, return_counts=True)
non_keep = unique[counts == 1]
all_id_sorted = d2l.concat((keep, non_keep))
class_id[non_keep] = -1
class_id = class_id[all_id_sorted].astype('float32')
conf, predicted_bb = conf[all_id_sorted], predicted_bb[all_id_sorted]
# pos_threshold — порог для непустых предсказаний
below_min_idx = (conf < pos_threshold)
class_id[below_min_idx] = -1
conf[below_min_idx] = 1 - conf[below_min_idx]
pred_info = d2l.concat((np.expand_dims(class_id, axis=1),
np.expand_dims(conf, axis=1),
predicted_bb), axis=1)
out.append(pred_info)
return d2l.stack(out)
PyTorch:
#@save
def multibox_detection(cls_probs, offset_preds, anchors, nms_threshold=0.5,
pos_threshold=0.009999999):
"""Предсказывает ограничивающие рамки с помощью подавления немаксимумов"""
device, batch_size = cls_probs.device, cls_probs.shape[0]
anchors = anchors.squeeze(0)
num_classes, num_anchors = cls_probs.shape[1], cls_probs.shape[2]
out = []
for i in range(batch_size):
cls_prob, offset_pred = cls_probs[i], offset_preds[i].reshape(-1, 4)
conf, class_id = torch.max(cls_prob[1:], 0)
predicted_bb = offset_inverse(anchors, offset_pred)
keep = nms(predicted_bb, conf, nms_threshold)
# Находим все индексы, которые не вошли в keep, и помечаем их классом «фон»
all_idx = torch.arange(num_anchors, dtype=torch.long, device=device)
combined = torch.cat((keep, all_idx))
uniques, counts = combined.unique(return_counts=True)
non_keep = uniques[counts == 1]
all_id_sorted = torch.cat((keep, non_keep))
class_id[non_keep] = -1
class_id = class_id[all_id_sorted]
conf, predicted_bb = conf[all_id_sorted], predicted_bb[all_id_sorted]
# pos_threshold — порог для непустых предсказаний
below_min_idx = (conf < pos_threshold)
class_id[below_min_idx] = -1
conf[below_min_idx] = 1 - conf[below_min_idx]
pred_info = torch.cat((class_id.unsqueeze(1),
conf.unsqueeze(1),
predicted_bb), dim=1)
out.append(pred_info)
return d2l.stack(out)
PaddlePaddle:
#@save
def multibox_detection(cls_probs, offset_preds, anchors, nms_threshold=0.5,
pos_threshold=0.009999999):
"""Предсказывает ограничивающие рамки с помощью подавления немаксимумов"""
batch_size = cls_probs.shape[0]
anchors = anchors.squeeze(0)
num_classes, num_anchors = cls_probs.shape[1], cls_probs.shape[2]
out = []
for i in range(batch_size):
cls_prob, offset_pred = cls_probs[i], offset_preds[i].reshape([-1, 4])
conf = paddle.max(cls_prob[1:], 0)
class_id = paddle.argmax(cls_prob[1:], 0)
predicted_bb = offset_inverse(anchors, offset_pred)
keep = nms(predicted_bb, conf, nms_threshold)
# Находим все индексы, которые не вошли в keep, и помечаем их классом «фон»
all_idx = paddle.arange(num_anchors, dtype='int64')
combined = paddle.concat((keep, all_idx))
uniques, counts = combined.unique(return_counts=True)
non_keep = uniques[counts == 1]
all_id_sorted = paddle.concat([keep, non_keep])
class_id[non_keep.numpy()] = -1
class_id = class_id[all_id_sorted]
conf, predicted_bb = conf[all_id_sorted], predicted_bb[all_id_sorted]
# pos_threshold — порог для непустых предсказаний
below_min_idx = (conf < pos_threshold)
class_id[below_min_idx.numpy()] = -1
conf[below_min_idx.numpy()] = 1 - conf[below_min_idx.numpy()]
pred_info = paddle.concat((paddle.to_tensor(class_id, dtype='float32').unsqueeze(1),
paddle.to_tensor(conf, dtype='float32').unsqueeze(1),
predicted_bb), axis=1)
out.append(pred_info)
return paddle.stack(out)
Теперь применим описанный алгоритм к конкретному примеру с четырьмя якорными рамками. Для простоты предположим, что все предсказанные смещения равны нулю, то есть предсказанные ограничивающие рамки совпадают с якорными. Для каждого из классов фона, собаки и кошки зададим предсказанную вероятность.
MXNet, PyTorch:
anchors = d2l.tensor([[0.1, 0.08, 0.52, 0.92], [0.08, 0.2, 0.56, 0.95],
[0.15, 0.3, 0.62, 0.91], [0.55, 0.2, 0.9, 0.88]])
offset_preds = d2l.tensor([0] * d2l.size(anchors))
cls_probs = d2l.tensor([[0] * 4, # Предсказанные вероятности фона
[0.9, 0.8, 0.7, 0.1], # Предсказанные вероятности собаки
[0.1, 0.2, 0.3, 0.9]]) # Предсказанные вероятности кошки
PaddlePaddle:
anchors = d2l.tensor([[0.1, 0.08, 0.52, 0.92], [0.08, 0.2, 0.56, 0.95],
[0.15, 0.3, 0.62, 0.91], [0.55, 0.2, 0.9, 0.88]])
offset_preds = d2l.tensor([0] * anchors.numel().item())
cls_probs = d2l.tensor([[0] * 4, # Предсказанные вероятности фона
[0.9, 0.8, 0.7, 0.1], # Предсказанные вероятности собаки
[0.1, 0.2, 0.3, 0.9]]) # Предсказанные вероятности кошки
Мы можем нарисовать на изображении эти предсказанные ограничивающие рамки и уверенности.
fig = d2l.plt.imshow(img)
show_bboxes(fig.axes, anchors * bbox_scale,
['dog=0.9', 'dog=0.8', 'dog=0.7', 'cat=0.9'])
Теперь вызовем функцию multibox_detection для подавления немаксимумов с порогом 0.5. Заметим, что мы добавили размерность к входным тензорам.
Результат имеет форму (размер батча, число якорных рамок, 6). Шесть элементов самой внутренней размерности описывают одну и ту же предсказанную ограничивающую рамку. Первый элемент — индекс предсказанного класса, начиная с 0 (0 — собака, 1 — кошка), значение -1 означает фон или то, что рамка удалена при подавлении немаксимумов. Второй элемент — уверенность предсказанной рамки. Остальные четыре элемента — координаты левого верхнего и правого нижнего углов предсказанной рамки (значения от 0 до 1).
MXNet:
output = multibox_detection(np.expand_dims(cls_probs, axis=0),
np.expand_dims(offset_preds, axis=0),
np.expand_dims(anchors, axis=0),
nms_threshold=0.5)
output
PyTorch:
output = multibox_detection(cls_probs.unsqueeze(dim=0),
offset_preds.unsqueeze(dim=0),
anchors.unsqueeze(dim=0),
nms_threshold=0.5)
output
PaddlePaddle:
output = multibox_detection(cls_probs.unsqueeze(axis=0),
offset_preds.unsqueeze(axis=0),
anchors.unsqueeze(axis=0),
nms_threshold=0.5)
output
Удалив предсказанные ограничивающие рамки класса -1 (фон), мы можем вывести окончательные предсказанные ограничивающие рамки, сохранённые после подавления немаксимумов.
fig = d2l.plt.imshow(img)
for i in d2l.numpy(output[0]):
if i[0] == -1:
continue
label = ('dog=', 'cat=')[int(i[0])] + str(i[1])
show_bboxes(fig.axes, [d2l.tensor(i[2:]) * bbox_scale], label)
На практике перед подавлением немаксимумов можно удалить предсказанные рамки с низкой уверенностью, чтобы уменьшить вычислительную нагрузку этого алгоритма. Также можно выполнить постобработку результата подавления немаксимумов, например оставить только рамки с более высокой уверенностью в качестве окончательного вывода.
Резюме
- Мы создаём якорные рамки разной формы с центром в каждом пикселе изображения.
- Пересечение над объединением (IoU), также называемое коэффициентом Жаккара, измеряет сходство двух ограничивающих рамок. Это отношение площади их пересечения к площади их объединения.
- В обучающем наборе каждой якорной рамке нужны две метки: класс объекта, связанного с ней, и смещение истинной ограничивающей рамки относительно якорной рамки.
- При предсказании подавление немаксимумов (NMS) позволяет удалить похожие предсказанные ограничивающие рамки и упростить вывод.
Упражнения
- Измените значения
sizesиratiosв функцииmultibox_prior. Как меняются созданные якорные рамки? - Постройте и визуализируйте две ограничивающие рамки с IoU, равным 0.5. Как они перекрываются?
- Измените переменную
anchorsв разделах 13.4.3 и 13.4.4. Как изменятся результаты? - Подавление немаксимумов — жадный алгоритм, который подавляет предсказанные рамки, удаляя их. Возможно ли, что некоторые удалённые рамки на самом деле полезны? Как изменить алгоритм, чтобы подавление было мягким? Можно обратиться к Soft-NMS (Bodla et al., 2017).
- Можно ли обучить подавление немаксимумов вместо того, чтобы задавать его вручную?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Bodla, N., Singh, B., Chellappa, R., & Davis, L. S. (2017). Soft-NMS — Improving object detection with one line of code. Proceedings of the IEEE International Conference on Computer Vision, 5561–5569.
13.5 Обнаружение объектов в нескольких масштабах
В разделе 13.4 мы создавали несколько якорных рамок с центром в каждом пикселе входного изображения. По сути, эти рамки представляют выборку разных областей изображения. Однако если создавать якорные рамки для каждого пикселя, то в итоге получится слишком много рамок для вычислений. Представим входное изображение размером . Если с центром в каждом пикселе создать пять рамок разной формы, нужно будет разметить и предсказать более 2 миллионов якорных рамок ().
13.5.1 Многомасштабные якорные рамки
Уменьшить число якорных рамок несложно. Например, можно равномерно выбрать небольшую долю пикселей входного изображения и создавать рамки с центрами в них. Кроме того, для разных масштабов можно создавать разное количество рамок разного размера. Интуитивно понятно, что маленькие объекты встречаются на изображении в большем разнообразии положений, чем большие. Например, объекты размером , и могут появиться на изображении четырьмя, двумя и одним способом соответственно. Поэтому при обнаружении мелких объектов с помощью мелких рамок можно выбирать больше областей, а для крупных объектов — меньше.
Чтобы показать, как генерировать якорные рамки в нескольких масштабах, сначала загрузим изображение. Его высота и ширина равны 561 и 728 пикселям.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import image, np, npx
npx.set_np()
img = image.imread('../img/catdog.jpg')
h, w = img.shape[:2]
h, w
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
img = d2l.plt.imread('../img/catdog.jpg')
h, w = img.shape[:2]
h, w
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
img = d2l.plt.imread('../img/catdog.jpg')
h, w = img.shape[:2]
h, w
Напомним, что в разделе 6.2 мы называли двумерный выход свёрточного слоя картой признаков (feature map). Задав форму карты признаков, мы можем определить центры якорных рамок, равномерно распределённые по любому изображению.
Функция display_anchors определена ниже. Мы создаём якорные рамки (anchors) на карте признаков (fmap), используя каждую ячейку (пиксель) как центр якорной рамки. Поскольку значения координат в якорных рамках (anchors) уже поделены на ширину и высоту карты признаков (fmap), эти значения лежат между 0 и 1 и задают относительное положение якорной рамки на карте признаков.
Так как центры якорных рамок (anchors) распределены по всем ячейкам карты признаков (fmap), эти центры должны быть равномерно распределены по любому входному изображению в соответствии с их относительным пространственным положением. Более конкретно, при заданных ширине и высоте карты признаков fmap_w и fmap_h следующая функция равномерно выбирает пиксели в fmap_h строках и fmap_w столбцах любого входного изображения. С центрами в этих равномерно выбранных пикселях будут созданы якорные рамки размера s (предполагается, что список s содержит один элемент) с разными соотношениями сторон (ratios).
MXNet:
def display_anchors(fmap_w, fmap_h, s):
d2l.set_figsize()
# Значения первых двух измерений не влияют на результат
fmap = np.zeros((1, 10, fmap_h, fmap_w))
anchors = npx.multibox_prior(fmap, sizes=s, ratios=[1, 2, 0.5])
bbox_scale = np.array((w, h, w, h))
d2l.show_bboxes(d2l.plt.imshow(img.asnumpy()).axes,
anchors[0] * bbox_scale)
PyTorch:
def display_anchors(fmap_w, fmap_h, s):
d2l.set_figsize()
# Значения первых двух измерений не влияют на результат
fmap = d2l.zeros((1, 10, fmap_h, fmap_w))
anchors = d2l.multibox_prior(fmap, sizes=s, ratios=[1, 2, 0.5])
bbox_scale = d2l.tensor((w, h, w, h))
d2l.show_bboxes(d2l.plt.imshow(img).axes,
anchors[0] * bbox_scale)
PaddlePaddle:
def display_anchors(fmap_w, fmap_h, s):
d2l.set_figsize()
# Значения первых двух измерений не влияют на результат
fmap = paddle.zeros(shape=[1, 10, fmap_h, fmap_w])
anchors = d2l.multibox_prior(fmap, sizes=s, ratios=[1, 2, 0.5])
bbox_scale = paddle.to_tensor((w, h, w, h))
d2l.show_bboxes(d2l.plt.imshow(img).axes,
anchors[0] * bbox_scale)
Сначала рассмотрим обнаружение мелких объектов. Чтобы рамки было легче различить на рисунке, рамки с разными центрами здесь не перекрываются: масштаб якорных рамок равен 0.15, высота и ширина карты признаков равны 4. Видно, что центры якорных рамок на 4 строках и 4 столбцах изображения распределены равномерно.
display_anchors(fmap_w=4, fmap_h=4, s=[0.15])
Далее уменьшим высоту и ширину карты признаков вдвое и используем якорные рамки большего размера для обнаружения крупных объектов. При масштабе 0.4 некоторые якорные рамки будут перекрывать друг друга.
display_anchors(fmap_w=2, fmap_h=2, s=[0.4])
Наконец, ещё раз уменьшим высоту и ширину карты признаков вдвое и увеличим масштаб якорных рамок до 0.8. Теперь центр якорной рамки совпадает с центром изображения.
display_anchors(fmap_w=1, fmap_h=1, s=[0.8])
13.5.2 Обнаружение в нескольких масштабах
Теперь, когда мы создали якорные рамки в нескольких масштабах, мы используем их для обнаружения объектов разных размеров в разных масштабах. Ниже мы опишем метод обнаружения на основе свёрточной нейронной сети, который реализуем в разделе 13.7.
На одном масштабе пусть у нас есть карт признаков формы . По методу из раздела 13.5.1 мы создаём групп якорных рамок, и в каждой группе рамок с одинаковым центром. Например, на первом масштабе описанного выше эксперимента при 10 (число каналов) картах признаков размером мы получаем 16 групп якорных рамок, в каждой из которых 3 рамки с одинаковым центром. Затем каждая якорная рамка размечается классом и смещением относительно истинной ограничивающей рамки. На текущем масштабе модель обнаружения должна предсказать классы и смещения для групп якорных рамок входного изображения, где у разных групп разные центры.
Предположим, что карт признаков здесь — промежуточный результат, который свёрточная сеть выдаёт при прямом распространении для входного изображения. Поскольку на каждой карте признаков есть разных пространственных положений, одно и то же пространственное положение можно рассматривать как элементов. По определению рецептивного поля из раздела 6.2 элементов карт признаков в одном и том же пространственном положении имеют одинаковое рецептивное поле на входном изображении: они описывают одну и ту же информацию входного изображения в пределах этого рецептивного поля. Поэтому мы можем преобразовать элементов карт признаков в одном и том же пространственном положении в классы и смещения для якорных рамок, построенных с центром в этом положении. По сути, мы используем информацию входного изображения в области определённого рецептивного поля, чтобы предсказать классы и смещения якорных рамок, расположенных вблизи этой области.
Когда карты признаков разных слоёв имеют на входном изображении рецептивные поля разного размера, их можно использовать для обнаружения объектов разного размера. Например, можно спроектировать нейронную сеть так, чтобы элементы карт признаков ближе к выходному слою имели более широкие рецептивные поля; тогда они смогут обнаруживать на входном изображении более крупные объекты.
Короче говоря, мы можем использовать глубокую нейронную сеть, которая строит иерархическое представление изображения на нескольких уровнях, и так реализовать обнаружение объектов в нескольких масштабах. В разделе 13.7 мы разберём конкретный пример, который показывает, как это работает.
Резюме
- В нескольких масштабах мы можем создавать якорные рамки разных размеров для обнаружения объектов разных размеров.
- Задав форму карт признаков, мы можем определить центры равномерно распределённых на любом изображении якорных рамок.
- Мы используем информацию входного изображения в области определённого рецептивного поля, чтобы предсказать классы и смещения якорных рамок, расположенных вблизи этой области.
- Глубокое обучение позволяет использовать иерархическое представление изображения на нескольких уровнях для обнаружения объектов в нескольких масштабах.
Упражнения
- Согласно нашему обсуждению в разделе 7.1, глубокие нейронные сети постепенно строят иерархию абстракций признаков изображения по мере увеличения глубины сети. Соответствуют ли карты признаков разных масштабов в обнаружении объектов в нескольких масштабах разным уровням абстракции? Почему?
- В эксперименте из раздела 13.5.1 на первом масштабе (
fmap_w=4, fmap_h=4) создайте равномерно распределённые якорные рамки, которые могут перекрываться. - Дана переменная карты признаков формы , где , и — число каналов, высота и ширина карты признаков. Как преобразовать эту переменную в классы и смещения якорных рамок? Какова форма результата?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
13.6 Набор данных для обнаружения объектов
Для обнаружения объектов нет таких небольших наборов данных, как MNIST или Fashion-MNIST. Чтобы быстро проверить модели обнаружения, мы соберём и разметим небольшой набор данных. Сначала мы сфотографировали бананы и получили 1000 изображений бананов под разными углами и разных размеров. Затем мы поместили изображения бананов в случайные места фоновых изображений. Наконец, на этих изображениях мы разметили ограничивающие рамки бананов.
13.6.1 Загрузка набора данных
Набор данных для обнаружения бананов, содержащий все изображения и CSV-файл с метками, можно загрузить напрямую из интернета.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import gluon, image, np, npx
import os
import pandas as pd
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
import os
import pandas as pd
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import os
import pandas as pd
import paddle
import paddle.vision as paddlevision
#@save
d2l.DATA_HUB['banana-detection'] = (
d2l.DATA_URL + 'banana-detection.zip',
'5de26c8fce5ccdea9f91267273464dc968d20d72')
13.6.2 Чтение набора данных
С помощью функции read_data_bananas мы читаем набор данных для обнаружения бананов. Набор включает CSV-файл с метками классов и координатами левого верхнего и правого нижнего углов истинных ограничивающих рамок.
MXNet:
#@save
def read_data_bananas(is_train=True):
"""Читает изображения и метки из набора данных для обнаружения бананов"""
data_dir = d2l.download_extract('banana-detection')
csv_fname = os.path.join(data_dir, 'bananas_train' if is_train
else 'bananas_val', 'label.csv')
csv_data = pd.read_csv(csv_fname)
csv_data = csv_data.set_index('img_name')
images, targets = [], []
for img_name, target in csv_data.iterrows():
images.append(image.imread(
os.path.join(data_dir, 'bananas_train' if is_train else
'bananas_val', 'images', f'{img_name}')))
# Здесь target содержит (класс, x левого верхнего, y левого верхнего, x правого нижнего, y правого нижнего),
# причём все изображения имеют один и тот же класс «банан» (индекс 0)
targets.append(list(target))
return images, np.expand_dims(np.array(targets), 1) / 256
PyTorch:
#@save
def read_data_bananas(is_train=True):
"""Читает изображения и метки из набора данных для обнаружения бананов"""
data_dir = d2l.download_extract('banana-detection')
csv_fname = os.path.join(data_dir, 'bananas_train' if is_train
else 'bananas_val', 'label.csv')
csv_data = pd.read_csv(csv_fname)
csv_data = csv_data.set_index('img_name')
images, targets = [], []
for img_name, target in csv_data.iterrows():
images.append(torchvision.io.read_image(
os.path.join(data_dir, 'bananas_train' if is_train else
'bananas_val', 'images', f'{img_name}')))
# Здесь target содержит (класс, x левого верхнего, y левого верхнего, x правого нижнего, y правого нижнего),
# причём все изображения имеют один и тот же класс «банан» (индекс 0)
targets.append(list(target))
return images, torch.tensor(targets).unsqueeze(1) / 256
PaddlePaddle:
#@save
def read_data_bananas(is_train=True):
"""Читает изображения и метки из набора данных для обнаружения бананов"""
data_dir = d2l.download_extract('banana-detection')
csv_fname = os.path.join(data_dir, 'bananas_train' if is_train
else 'bananas_val', 'label.csv')
csv_data = pd.read_csv(csv_fname)
csv_data = csv_data.set_index('img_name')
images, targets = [], []
for img_name, target in csv_data.iterrows():
paddle.vision.set_image_backend('cv2')
images.append(paddlevision.image_load(os.path.join(data_dir, 'bananas_train' if is_train else
'bananas_val', 'images', f'{img_name}'))[..., ::-1])
# Здесь target содержит (класс, x левого верхнего, y левого верхнего, x правого нижнего, y правого нижнего),
# причём все изображения имеют один и тот же класс «банан» (индекс 0)
targets.append(list(target))
return images, paddle.to_tensor(targets).unsqueeze(1) / 256
Используя функцию read_data_bananas для чтения изображений и меток, класс BananasDataset ниже позволяет создать собственный экземпляр Dataset для загрузки набора данных для обнаружения бананов.
MXNet:
#@save
class BananasDataset(gluon.data.Dataset):
"""Пользовательский набор данных для загрузки набора для обнаружения бананов"""
def __init__(self, is_train):
self.features, self.labels = read_data_bananas(is_train)
print('прочитано ' + str(len(self.features)) + (f' обучающих примеров' if
is_train else f' проверочных примеров'))
def __getitem__(self, idx):
return (self.features[idx].astype('float32').transpose(2, 0, 1),
self.labels[idx])
def __len__(self):
return len(self.features)
PyTorch:
#@save
class BananasDataset(torch.utils.data.Dataset):
"""Пользовательский набор данных для загрузки набора для обнаружения бананов"""
def __init__(self, is_train):
self.features, self.labels = read_data_bananas(is_train)
print('прочитано ' + str(len(self.features)) + (f' обучающих примеров' if
is_train else f' проверочных примеров'))
def __getitem__(self, idx):
return (self.features[idx].float(), self.labels[idx])
def __len__(self):
return len(self.features)
PaddlePaddle:
#@save
class BananasDataset(paddle.io.Dataset):
"""Пользовательский набор данных для загрузки набора для обнаружения бананов"""
def __init__(self, is_train):
self.features, self.labels = read_data_bananas(is_train)
print('прочитано ' + str(len(self.features)) + (f' обучающих примеров' if
is_train else f' проверочных примеров'))
def __getitem__(self, idx):
return (paddle.to_tensor(self.features[idx], dtype='float32').transpose([2, 0, 1]), self.labels[idx])
def __len__(self):
return len(self.features)
Наконец, определим функцию load_data_bananas, которая возвращает два экземпляра загрузчика данных для обучающего и тестового наборов. Для тестового набора не нужно читать данные в случайном порядке.
MXNet:
#@save
def load_data_bananas(batch_size):
"""Загружает набор данных для обнаружения бананов"""
train_iter = gluon.data.DataLoader(BananasDataset(is_train=True),
batch_size, shuffle=True)
val_iter = gluon.data.DataLoader(BananasDataset(is_train=False),
batch_size)
return train_iter, val_iter
PyTorch:
#@save
def load_data_bananas(batch_size):
"""Загружает набор данных для обнаружения бананов"""
train_iter = torch.utils.data.DataLoader(BananasDataset(is_train=True),
batch_size, shuffle=True)
val_iter = torch.utils.data.DataLoader(BananasDataset(is_train=False),
batch_size)
return train_iter, val_iter
PaddlePaddle:
#@save
def load_data_bananas(batch_size):
"""Загружает набор данных для обнаружения бананов"""
train_iter = paddle.io.DataLoader(BananasDataset(is_train=True),
batch_size=batch_size, return_list=True, shuffle=True)
val_iter = paddle.io.DataLoader(BananasDataset(is_train=False),
batch_size=batch_size, return_list=True)
return train_iter, val_iter
Прочитаем один минибатч и выведем формы изображений и меток. Форма минибатча изображений — (размер батча, число каналов, высота, ширина), как и в задачах классификации изображений. Форма минибатча меток — (размер батча, , 5), где — максимальное число ограничивающих рамок, которое может встретиться на изображении набора данных.
Вычисления на минибатчах эффективны, но требуют, чтобы у всех изображений в одном батче было одинаковое число ограничивающих рамок. Обычно число рамок у изображений разное, поэтому изображения с числом рамок меньше дополняются фиктивными (недопустимыми) рамками до . Тогда метка каждой рамки представлена массивом длины 5. Первый элемент массива — класс объекта в рамке, где -1 означает фиктивную (недопустимую) рамку, добавленную для дополнения. Остальные четыре элемента — координаты левого верхнего и правого нижнего углов рамки (значения от 0 до 1). В наборе данных о бананах на каждом изображении ровно одна рамка, поэтому .
batch_size, edge_size = 32, 256
train_iter, _ = load_data_bananas(batch_size)
batch = next(iter(train_iter))
batch[0].shape, batch[1].shape
13.6.3 Демонстрация
Покажем 10 изображений с истинными ограничивающими рамками. Видно, что на всех этих изображениях бананы повёрнуты по-разному, имеют разный размер и расположены в разных местах. Разумеется, это простой искусственный набор данных; реальные наборы данных на практике обычно гораздо сложнее.
MXNet:
imgs = (batch[0][0:10].transpose(0, 2, 3, 1)) / 255
axes = d2l.show_images(imgs, 2, 5, scale=2)
for ax, label in zip(axes, batch[1][0:10]):
d2l.show_bboxes(ax, [label[0][1:5] * edge_size], colors=['w'])
PyTorch:
imgs = (batch[0][0:10].permute(0, 2, 3, 1)) / 255
axes = d2l.show_images(imgs, 2, 5, scale=2)
for ax, label in zip(axes, batch[1][0:10]):
d2l.show_bboxes(ax, [label[0][1:5] * edge_size], colors=['w'])
PaddlePaddle:
imgs = (batch[0][0:10].transpose([0, 2, 3, 1])) / 255
axes = d2l.show_images(imgs, 2, 5, scale=2)
for ax, label in zip(axes, batch[1][0:10]):
d2l.show_bboxes(ax, [label[0][1:5] * edge_size], colors=['w'])
Резюме
- Собранный нами набор данных для обнаружения бананов можно использовать для демонстрации моделей обнаружения объектов.
- Загрузка данных для обнаружения объектов похожа на загрузку данных для классификации изображений. Однако в обнаружении объектов метки также содержат информацию об истинных ограничивающих рамках, которой нет в классификации изображений.
Упражнения
- Продемонстрируйте другие изображения с истинными ограничивающими рамками из набора данных для обнаружения бананов. Чем они отличаются по рамкам и объектам?
- Допустим, мы хотим применить аугментацию данных (например, случайную обрезку) к обнаружению объектов. Чем это отличается от классификации изображений? Подсказка: что будет, если обрезанное изображение содержит только небольшую часть объекта?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
13.7 Одноступенчатое обнаружение с несколькими окнами (SSD)
В разделах 13.3–13.6 мы рассмотрели ограничивающие рамки, якорные рамки, обнаружение в нескольких масштабах и набор данных для обнаружения. Теперь мы готовы использовать эти знания, чтобы спроектировать модель обнаружения объектов: одноступенчатое обнаружение с несколькими окнами (single shot multibox detection, SSD) (Liu et al., 2016). Эта модель простая, быстрая и широко используется. Хотя это лишь один из многих методов обнаружения объектов, некоторые проектные решения и детали реализации из этого раздела применимы и к другим моделям.
13.7.1 Модель
На рис. 13.7.1 показана архитектура модели SSD. Модель в основном состоит из базовой сети, за которой следуют несколько блоков многомасштабных признаков. Базовая сеть извлекает признаки из входного изображения, поэтому в ней можно использовать глубокую свёрточную сеть. В оригинальной статье SSD базовой сетью была VGG, обрезанная перед слоем классификации (Liu et al., 2016); сейчас её также часто заменяют на ResNet. Базовую сеть можно спроектировать так, чтобы её выход имел большие высоту и ширину. Тогда на основе этой карты признаков будет создано больше якорных рамок, которые помогут обнаруживать мелкие объекты. Каждый следующий блок многомасштабных признаков уменьшает высоту и ширину карты признаков, полученной от предыдущего слоя (например, вдвое), и расширяет рецептивное поле каждого элемента карты признаков на входном изображении.
Напомним из раздела 13.5 идею обнаружения в нескольких масштабах: глубокая нейронная сеть строит иерархическое представление изображения. Карты признаков, расположенные ближе к верху рис. 13.7.1, малы, но имеют большое рецептивное поле, поэтому они подходят для обнаружения меньшего количества, но более крупных объектов. Итак, с помощью блоков многомасштабных признаков SSD создаёт якорные рамки разных размеров и обнаруживает объекты разных размеров, предсказывая классы и смещения ограничивающих рамок. Поэтому это модель обнаружения в нескольких масштабах.
Рис. 13.7.1. Модель одноступенчатого обнаружения с несколькими окнами состоит из базового блока и нескольких блоков многомасштабных признаков, соединённых последовательно
Далее мы рассмотрим детали реализации отдельных блоков на рис. 13.7.1. Сначала обсудим, как реализовать предсказание классов и ограничивающих рамок.
13.7.1.1 Слой предсказания классов
Пусть количество классов объектов равно . Тогда у якорных рамок класс, где класс 0 — фон. Пусть на некотором масштабе высота и ширина карты признаков равны и . Если с центром в каждом её элементе создать якорных рамок, то нужно классифицировать якорных рамок. Если использовать полносвязный слой для выхода, легко получить слишком много параметров модели. Вспомним метод из раздела 7.3, в котором каналы свёрточного слоя используются для вывода предсказаний классов: одноступенчатое обнаружение с несколькими окнами применяет тот же подход, чтобы снизить сложность модели.
Конкретно, слой предсказания классов использует свёрточный слой, который сохраняет высоту и ширину входа. Тогда выход и вход соответствуют друг другу по пространственным координатам карты признаков. Рассмотрим одну и ту же пространственную позицию (, ) на выходе и на входе: каналы выходной карты признаков в этой позиции содержат предсказания классов для всех якорных рамок, созданных с центром в позиции (, ) входной карты признаков. Поэтому число выходных каналов равно , и канал с индексом () соответствует предсказанию для якорной рамки с индексом и класса с индексом .
Ниже мы определяем такой слой предсказания классов; параметры num_anchors и num_classes задают и соответственно. Слой использует свёртку с заполнением 1. Высота и ширина входа и выхода этого свёрточного слоя не меняются.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, gluon, image, init, np, npx
from mxnet.gluon import nn
npx.set_np()
def cls_predictor(num_anchors, num_classes):
return nn.Conv2D(num_anchors * (num_classes + 1), kernel_size=3,
padding=1)
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
from torch.nn import functional as F
def cls_predictor(num_inputs, num_anchors, num_classes):
return nn.Conv2d(num_inputs, num_anchors * (num_classes + 1),
kernel_size=3, padding=1)
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
from paddle.nn import functional as F
import paddle.vision as paddlevision
def cls_predictor(num_inputs, num_anchors, num_classes):
return nn.Conv2D(num_inputs, num_anchors * (num_classes + 1),
kernel_size=3, padding=1)
13.7.1.2 Слой предсказания ограничивающих рамок
Слой предсказания ограничивающих рамок устроен так же, как слой предсказания классов. Единственное отличие в том, что для каждой якорной рамки здесь нужно предсказать 4 смещения, а не значений классов.
MXNet:
def bbox_predictor(num_anchors):
return nn.Conv2D(num_anchors * 4, kernel_size=3, padding=1)
PyTorch:
def bbox_predictor(num_inputs, num_anchors):
return nn.Conv2d(num_inputs, num_anchors * 4, kernel_size=3, padding=1)
PaddlePaddle:
def bbox_predictor(num_inputs, num_anchors):
return nn.Conv2D(num_inputs, num_anchors * 4, kernel_size=3, padding=1)
13.7.1.3 Объединение предсказаний разных масштабов
Как мы уже говорили, SSD использует карты признаков разных масштабов, чтобы создавать якорные рамки и предсказывать их классы и смещения. На разных масштабах форма карт признаков или число якорных рамок с центром в одном элементе могут различаться. Поэтому формы предсказаний на разных масштабах могут отличаться.
В следующем примере мы строим для одного минибатча две карты признаков разных масштабов (Y1 и Y2), где высота и ширина Y2 вдвое меньше, чем у Y1. В качестве примера возьмём предсказание классов: допустим, каждый элемент Y1 и Y2 создаёт соответственно 5 и 3 якорные рамки. Допустим также, что число классов объектов равно 10. Тогда число каналов в выходе предсказания классов для карт признаков Y1 и Y2 равно и соответственно. Форма любого выхода — (размер батча, число каналов, высота, ширина).
MXNet:
def forward(x, block):
block.initialize()
return block(x)
Y1 = forward(np.zeros((2, 8, 20, 20)), cls_predictor(5, 10))
Y2 = forward(np.zeros((2, 16, 10, 10)), cls_predictor(3, 10))
Y1.shape, Y2.shape
PyTorch:
def forward(x, block):
return block(x)
Y1 = forward(torch.zeros((2, 8, 20, 20)), cls_predictor(8, 5, 10))
Y2 = forward(torch.zeros((2, 16, 10, 10)), cls_predictor(16, 3, 10))
Y1.shape, Y2.shape
PaddlePaddle:
def forward(x, block):
return block(x)
Y1 = forward(paddle.zeros((2, 8, 20, 20)), cls_predictor(8, 5, 10))
Y2 = forward(paddle.zeros((2, 16, 10, 10)), cls_predictor(16, 3, 10))
Y1.shape, Y2.shape
Как видно, кроме размера батча, все остальные три измерения у двух выходов разные. Чтобы объединить эти два выхода предсказаний и повысить эффективность вычислений, мы приведём тензоры к более единообразному формату.
Измерение каналов содержит предсказания для якорных рамок с одним и тем же центром. Сначала мы переносим измерение каналов в последнее место. Поскольку размер батча на разных масштабах не меняется, мы можем привести предсказания к двумерному виду (размер батча, высота × ширина × число каналов), что удобно для последующего объединения по измерению 1.
MXNet:
def flatten_pred(pred):
return npx.batch_flatten(pred.transpose(0, 2, 3, 1))
def concat_preds(preds):
return np.concatenate([flatten_pred(p) for p in preds], axis=1)
PyTorch:
def flatten_pred(pred):
return torch.flatten(pred.permute(0, 2, 3, 1), start_dim=1)
def concat_preds(preds):
return torch.cat([flatten_pred(p) for p in preds], dim=1)
PaddlePaddle:
def flatten_pred(pred):
return paddle.flatten(pred.transpose([0, 2, 3, 1]), start_axis=1)
def concat_preds(preds):
return paddle.concat([flatten_pred(p) for p in preds], axis=1)
Так, хотя Y1 и Y2 различаются по числу каналов, высоте и ширине, мы всё равно можем объединить эти два выхода предсказаний для одного минибатча на двух разных масштабах.
concat_preds([Y1, Y2]).shape
13.7.1.4 Блок уменьшения высоты и ширины вдвое
Чтобы обнаруживать объекты на нескольких масштабах, мы определяем блок down_sample_blk, который уменьшает вдвое высоту и ширину входной карты признаков. По сути, этот блок устроен по образцу VGG-блока из раздела 7.2. Точнее, каждый блок уменьшения вдвое состоит из двух свёрточных слоёв с заполнением 1 и слоя максимального пулинга с шагом 2. Мы знаем, что свёрточный слой с заполнением 1 не меняет форму карты признаков. Однако последующий слой максимального пулинга уменьшает высоту и ширину входной карты признаков вдвое. Для входа и выхода этого блока, поскольку , каждый элемент выхода имеет рецептивное поле на входе. Поэтому блок уменьшения вдвое расширяет рецептивное поле каждого элемента в выходной карте признаков.
MXNet:
def down_sample_blk(num_channels):
blk = nn.Sequential()
for _ in range(2):
blk.add(nn.Conv2D(num_channels, kernel_size=3, padding=1),
nn.BatchNorm(in_channels=num_channels),
nn.Activation('relu'))
blk.add(nn.MaxPool2D(2))
return blk
PyTorch:
def down_sample_blk(in_channels, out_channels):
blk = []
for _ in range(2):
blk.append(nn.Conv2d(in_channels, out_channels,
kernel_size=3, padding=1))
blk.append(nn.BatchNorm2d(out_channels))
blk.append(nn.ReLU())
in_channels = out_channels
blk.append(nn.MaxPool2d(2))
return nn.Sequential(*blk)
PaddlePaddle:
def down_sample_blk(in_channels, out_channels):
blk = []
for _ in range(2):
blk.append(nn.Conv2D(in_channels, out_channels,
kernel_size=3, padding=1))
blk.append(nn.BatchNorm2D(out_channels))
blk.append(nn.ReLU())
in_channels = out_channels
blk.append(nn.MaxPool2D(2))
return nn.Sequential(*blk)
В следующем примере блок уменьшения вдвое меняет число входных каналов и вдвое уменьшает высоту и ширину входной карты признаков.
MXNet:
forward(np.zeros((2, 3, 20, 20)), down_sample_blk(10)).shape
PyTorch:
forward(torch.zeros((2, 3, 20, 20)), down_sample_blk(3, 10)).shape
PaddlePaddle:
forward(paddle.zeros((2, 3, 20, 20)), down_sample_blk(3, 10)).shape
13.7.1.5 Базовый блок сети
Базовый блок сети извлекает признаки из входного изображения. Для простоты вычислений мы строим небольшую базовую сеть, которая последовательно соединяет 3 блока уменьшения вдвое и постепенно удваивает число каналов. При входном изображении размером этот базовый блок выдаёт карту признаков размером ().
MXNet:
def base_net():
blk = nn.Sequential()
for num_filters in [16, 32, 64]:
blk.add(down_sample_blk(num_filters))
return blk
forward(np.zeros((2, 3, 256, 256)), base_net()).shape
PyTorch:
def base_net():
blk = []
num_filters = [3, 16, 32, 64]
for i in range(len(num_filters) - 1):
blk.append(down_sample_blk(num_filters[i], num_filters[i+1]))
return nn.Sequential(*blk)
forward(torch.zeros((2, 3, 256, 256)), base_net()).shape
PaddlePaddle:
def base_net():
blk = []
num_filters = [3, 16, 32, 64]
for i in range(len(num_filters) - 1):
blk.append(down_sample_blk(num_filters[i], num_filters[i+1]))
return nn.Sequential(*blk)
forward(paddle.zeros((2, 3, 256, 256)), base_net()).shape
13.7.1.6 Полная модель
Полная модель одноступенчатого обнаружения с несколькими окнами состоит из пяти блоков. Карта признаков, которую выдаёт каждый блок, используется и для создания якорных рамок, и для предсказания их классов и смещений. Из этих пяти блоков первый — базовый блок сети, со второго по четвёртый — блоки уменьшения вдвое, а последний блок использует глобальный максимальный пулинг, чтобы уменьшить высоту и ширину до 1. Технически блоки со второго по пятый — это блоки многомасштабных признаков с рис. 13.7.1.
MXNet:
def get_blk(i):
if i == 0:
blk = base_net()
elif i == 4:
blk = nn.GlobalMaxPool2D()
else:
blk = down_sample_blk(128)
return blk
PyTorch:
def get_blk(i):
if i == 0:
blk = base_net()
elif i == 1:
blk = down_sample_blk(64, 128)
elif i == 4:
blk = nn.AdaptiveMaxPool2d((1,1))
else:
blk = down_sample_blk(128, 128)
return blk
PaddlePaddle:
def get_blk(i):
if i == 0:
blk = base_net()
elif i == 1:
blk = down_sample_blk(64, 128)
elif i == 4:
blk = nn.AdaptiveMaxPool2D((1,1))
else:
blk = down_sample_blk(128, 128)
return blk
Теперь определим прямое распространение для каждого блока. В отличие от задачи классификации изображений, выход здесь включает: карту признаков Y свёрточной сети; якорные рамки, созданные по Y на текущем масштабе; предсказанные по Y классы и смещения этих якорных рамок.
MXNet:
def blk_forward(X, blk, size, ratio, cls_predictor, bbox_predictor):
Y = blk(X)
anchors = d2l.multibox_prior(Y, sizes=size, ratios=ratio)
cls_preds = cls_predictor(Y)
bbox_preds = bbox_predictor(Y)
return (Y, anchors, cls_preds, bbox_preds)
PyTorch:
def blk_forward(X, blk, size, ratio, cls_predictor, bbox_predictor):
Y = blk(X)
anchors = d2l.multibox_prior(Y, sizes=size, ratios=ratio)
cls_preds = cls_predictor(Y)
bbox_preds = bbox_predictor(Y)
return (Y, anchors, cls_preds, bbox_preds)
PaddlePaddle:
def blk_forward(X, blk, size, ratio, cls_predictor, bbox_predictor):
Y = blk(X)
anchors = d2l.multibox_prior(Y, sizes=size, ratios=ratio)
cls_preds = cls_predictor(Y)
bbox_preds = bbox_predictor(Y)
return (Y, anchors, cls_preds, bbox_preds)
Напомним, что на рис. 13.7.1 блок многомасштабных признаков ближе к верху предназначен для обнаружения крупных объектов, поэтому ему нужны якорные рамки большего размера. В приведённом выше прямом распространении для каждого блока многомасштабных признаков мы передаём в функцию multibox_prior через параметр sizes список из двух значений масштаба. Ниже интервал от 0.2 до 1.05 равномерно делится на пять частей, чтобы задать меньшие значения масштаба для пяти блоков: 0.2, 0.37, 0.54, 0.71 и 0.88. Большие значения масштаба для каждого блока вычисляются как , и так далее.
sizes = [[0.2, 0.272], [0.37, 0.447], [0.54, 0.619], [0.71, 0.79],
[0.88, 0.961]]
ratios = [[1, 2, 0.5]] * 5
num_anchors = len(sizes[0]) + len(ratios[0]) - 1
Теперь мы можем определить полную модель TinySSD следующим образом.
MXNet:
class TinySSD(nn.Block):
def __init__(self, num_classes, **kwargs):
super(TinySSD, self).__init__(**kwargs)
self.num_classes = num_classes
for i in range(5):
# Эквивалентно присваиванию self.blk_i = get_blk(i)
setattr(self, f'blk_{i}', get_blk(i))
setattr(self, f'cls_{i}', cls_predictor(num_anchors, num_classes))
setattr(self, f'bbox_{i}', bbox_predictor(num_anchors))
def forward(self, X):
anchors, cls_preds, bbox_preds = [None] * 5, [None] * 5, [None] * 5
for i in range(5):
# getattr(self, 'blk_%d' % i) — это обращение к self.blk_i
X, anchors[i], cls_preds[i], bbox_preds[i] = blk_forward(
X, getattr(self, f'blk_{i}'), sizes[i], ratios[i],
getattr(self, f'cls_{i}'), getattr(self, f'bbox_{i}'))
anchors = np.concatenate(anchors, axis=1)
cls_preds = concat_preds(cls_preds)
cls_preds = cls_preds.reshape(
cls_preds.shape[0], -1, self.num_classes + 1)
bbox_preds = concat_preds(bbox_preds)
return anchors, cls_preds, bbox_preds
PyTorch:
class TinySSD(nn.Module):
def __init__(self, num_classes, **kwargs):
super(TinySSD, self).__init__(**kwargs)
self.num_classes = num_classes
idx_to_in_channels = [64, 128, 128, 128, 128]
for i in range(5):
# Эквивалентно присваиванию self.blk_i = get_blk(i)
setattr(self, f'blk_{i}', get_blk(i))
setattr(self, f'cls_{i}', cls_predictor(idx_to_in_channels[i],
num_anchors, num_classes))
setattr(self, f'bbox_{i}', bbox_predictor(idx_to_in_channels[i],
num_anchors))
def forward(self, X):
anchors, cls_preds, bbox_preds = [None] * 5, [None] * 5, [None] * 5
for i in range(5):
# getattr(self, 'blk_%d' % i) — это обращение к self.blk_i
X, anchors[i], cls_preds[i], bbox_preds[i] = blk_forward(
X, getattr(self, f'blk_{i}'), sizes[i], ratios[i],
getattr(self, f'cls_{i}'), getattr(self, f'bbox_{i}'))
anchors = torch.cat(anchors, dim=1)
cls_preds = concat_preds(cls_preds)
cls_preds = cls_preds.reshape(
cls_preds.shape[0], -1, self.num_classes + 1)
bbox_preds = concat_preds(bbox_preds)
return anchors, cls_preds, bbox_preds
PaddlePaddle:
class TinySSD(nn.Layer):
def __init__(self, num_classes, **kwargs):
super(TinySSD, self).__init__(**kwargs)
self.num_classes = num_classes
idx_to_in_channels = [64, 128, 128, 128, 128]
for i in range(5):
# Эквивалентно присваиванию self.blk_i = get_blk(i)
setattr(self, f'blk_{i}', get_blk(i))
setattr(self, f'cls_{i}', cls_predictor(idx_to_in_channels[i],
num_anchors, num_classes))
setattr(self, f'bbox_{i}', bbox_predictor(idx_to_in_channels[i],
num_anchors))
def forward(self, X):
anchors, cls_preds, bbox_preds = [None] * 5, [None] * 5, [None] * 5
for i in range(5):
# getattr(self, 'blk_%d' % i) — это обращение к self.blk_i
X, anchors[i], cls_preds[i], bbox_preds[i] = blk_forward(
X, getattr(self, f'blk_{i}'), sizes[i], ratios[i],
getattr(self, f'cls_{i}'), getattr(self, f'bbox_{i}'))
anchors = paddle.concat(anchors, axis=1)
cls_preds = concat_preds(cls_preds)
cls_preds = cls_preds.reshape(
(cls_preds.shape[0], -1, self.num_classes + 1))
bbox_preds = concat_preds(bbox_preds)
return anchors, cls_preds, bbox_preds
Создадим экземпляр модели и выполним прямое распространение для минибатча изображений X размером пикселей.
Как показано выше, первый блок выдаёт карту признаков размером . Напомним, что со второго по четвёртый блоки — это блоки уменьшения вдвое, а пятый блок — глобальный слой пулинга. Поскольку с центром в каждом элементе карты признаков создаются 4 якорные рамки, на всех пяти масштабах для одного изображения получается якорных рамок.
MXNet:
net = TinySSD(num_classes=1)
net.initialize()
X = np.zeros((32, 3, 256, 256))
anchors, cls_preds, bbox_preds = net(X)
print('выходные якорные рамки:', anchors.shape)
print('выход предсказаний классов:', cls_preds.shape)
print('выход предсказаний рамок:', bbox_preds.shape)
PyTorch:
net = TinySSD(num_classes=1)
X = torch.zeros((32, 3, 256, 256))
anchors, cls_preds, bbox_preds = net(X)
print('выходные якорные рамки:', anchors.shape)
print('выход предсказаний классов:', cls_preds.shape)
print('выход предсказаний рамок:', bbox_preds.shape)
PaddlePaddle:
net = TinySSD(num_classes=1)
X = paddle.zeros((32, 3, 256, 256))
anchors, cls_preds, bbox_preds = net(X)
print('выходные якорные рамки:', anchors.shape)
print('выход предсказаний классов:', cls_preds.shape)
print('выход предсказаний рамок:', bbox_preds.shape)
13.7.2 Обучение модели
Теперь опишем, как обучать модель одноступенчатого обнаружения с несколькими окнами для обнаружения объектов.
13.7.2.1 Чтение набора данных и инициализация
Сначала загрузим набор данных для обнаружения бананов, описанный в разделе 13.6.
batch_size = 32
train_iter, _ = d2l.load_data_bananas(batch_size)
В наборе данных для обнаружения бананов у объектов один класс. После определения модели нужно инициализировать её параметры и задать алгоритм оптимизации.
MXNet:
device, net = d2l.try_gpu(), TinySSD(num_classes=1)
net.initialize(init=init.Xavier(), ctx=device)
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'learning_rate': 0.2, 'wd': 5e-4})
PyTorch:
device, net = d2l.try_gpu(), TinySSD(num_classes=1)
trainer = torch.optim.SGD(net.parameters(), lr=0.2, weight_decay=5e-4)
PaddlePaddle:
device, net = d2l.try_gpu(), TinySSD(num_classes=1)
trainer = paddle.optimizer.SGD(learning_rate=0.2,
parameters=net.parameters(),
weight_decay=5e-4)
13.7.2.2 Определение функций потерь и оценки
Для обнаружения объектов есть два типа потерь. Первый — потеря, связанная с классами якорных рамок: её можно вычислить с помощью функции кросс-энтропии, которую мы использовали в задачах классификации. Второй — потеря, связанная со смещениями положительных якорных рамок: предсказание смещений — это задача регрессии. Однако здесь для этой задачи мы не используем квадратичную потерю из раздела 3.1, а берём потерю в норме , то есть модуль разности предсказанного и истинного значений. Маска bbox_masks исключает из вычисления потерь отрицательные и фиктивные (дополняющие) якорные рамки. Наконец, мы складываем потери классов и смещений якорных рамок и получаем итоговую функцию потерь модели.
MXNet:
cls_loss = gluon.loss.SoftmaxCrossEntropyLoss()
bbox_loss = gluon.loss.L1Loss()
def calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels, bbox_masks):
cls = cls_loss(cls_preds, cls_labels)
bbox = bbox_loss(bbox_preds * bbox_masks, bbox_labels * bbox_masks)
return cls + bbox
PyTorch:
cls_loss = nn.CrossEntropyLoss(reduction='none')
bbox_loss = nn.L1Loss(reduction='none')
def calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels, bbox_masks):
batch_size, num_classes = cls_preds.shape[0], cls_preds.shape[2]
cls = cls_loss(cls_preds.reshape(-1, num_classes),
cls_labels.reshape(-1)).reshape(batch_size, -1).mean(dim=1)
bbox = bbox_loss(bbox_preds * bbox_masks,
bbox_labels * bbox_masks).mean(dim=1)
return cls + bbox
PaddlePaddle:
cls_loss = nn.CrossEntropyLoss(reduction='none')
bbox_loss = nn.L1Loss(reduction='none')
def calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels, bbox_masks):
batch_size, num_classes = cls_preds.shape[0], cls_preds.shape[2]
cls = cls_loss(cls_preds.reshape((-1, num_classes)),
cls_labels.reshape([-1])).reshape((batch_size, -1)).mean(axis=1)
bbox = bbox_loss(bbox_preds * bbox_masks,
bbox_labels * bbox_masks).mean(axis=1)
return cls + bbox
Для оценки результатов классификации можно использовать точность. Поскольку для смещений применяется потеря в норме , для оценки предсказаний ограничивающих рамок мы используем среднюю абсолютную ошибку (mean absolute error). Эти предсказания получаются из созданных якорных рамок и их предсказанных смещений.
MXNet:
def cls_eval(cls_preds, cls_labels):
# Поскольку предсказания классов находятся в последнем измерении, в argmax нужно указать последнее измерение.
return float((cls_preds.argmax(axis=-1).astype(
cls_labels.dtype) == cls_labels).sum())
def bbox_eval(bbox_preds, bbox_labels, bbox_masks):
return float((np.abs((bbox_labels - bbox_preds) * bbox_masks)).sum())
PyTorch:
def cls_eval(cls_preds, cls_labels):
# Поскольку предсказания классов находятся в последнем измерении, в argmax нужно указать последнее измерение.
return float((cls_preds.argmax(dim=-1).type(
cls_labels.dtype) == cls_labels).sum())
def bbox_eval(bbox_preds, bbox_labels, bbox_masks):
return float((torch.abs((bbox_labels - bbox_preds) * bbox_masks)).sum())
PaddlePaddle:
def cls_eval(cls_preds, cls_labels):
# Поскольку предсказания классов находятся в последнем измерении, в argmax нужно указать последнее измерение.
return float((cls_preds.argmax(axis=-1).astype(
cls_labels.dtype) == cls_labels).sum())
def bbox_eval(bbox_preds, bbox_labels, bbox_masks):
return float((paddle.abs((bbox_labels - bbox_preds) * bbox_masks)).sum())
13.7.2.3 Обучение модели
При обучении модели в прямом распространении мы генерируем многомасштабные якорные рамки (anchors) и предсказываем их классы (cls_preds) и смещения (bbox_preds). Затем по разметке Y мы размечаем классы (cls_labels) и смещения (bbox_labels) якорных рамок. В конце мы вычисляем функцию потерь по предсказанным и размеченным классам и смещениям. Для краткости тестовый набор данных здесь не оценивается.
MXNet:
num_epochs, timer = 20, d2l.Timer()
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=['ошибка классов', 'MAE рамок'])
for epoch in range(num_epochs):
# Метрики: сумма верных предсказаний классов, число предсказаний классов,
# сумма абсолютных ошибок рамок, число значений в этой сумме
metric = d2l.Accumulator(4)
for features, target in train_iter:
timer.start()
X = features.as_in_ctx(device)
Y = target.as_in_ctx(device)
with autograd.record():
# Генерируем многомасштабные якорные рамки и предсказываем для каждой из них класс и смещение
anchors, cls_preds, bbox_preds = net(X)
# Размечаем классы и смещения для каждой якорной рамки
bbox_labels, bbox_masks, cls_labels = d2l.multibox_target(anchors,
Y)
# По предсказанным и размеченным классам и смещениям вычисляем функцию потерь
l = calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels,
bbox_masks)
l.backward()
trainer.step(batch_size)
metric.add(cls_eval(cls_preds, cls_labels), cls_labels.size,
bbox_eval(bbox_preds, bbox_labels, bbox_masks),
bbox_labels.size)
cls_err, bbox_mae = 1 - metric[0] / metric[1], metric[2] / metric[3]
animator.add(epoch + 1, (cls_err, bbox_mae))
print(f'ошибка классов {cls_err:.2e}, MAE рамок {bbox_mae:.2e}')
print(f'{len(train_iter._dataset) / timer.stop():.1f} примеров/с на '
f'{str(device)}')
PyTorch:
num_epochs, timer = 20, d2l.Timer()
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=['ошибка классов', 'MAE рамок'])
net = net.to(device)
for epoch in range(num_epochs):
# Сумма верных предсказаний классов, число предсказаний классов,
# сумма абсолютных ошибок рамок, число значений в этой сумме
metric = d2l.Accumulator(4)
net.train()
for features, target in train_iter:
timer.start()
trainer.zero_grad()
X, Y = features.to(device), target.to(device)
# Генерируем многомасштабные якорные рамки и предсказываем для каждой из них класс и смещение
anchors, cls_preds, bbox_preds = net(X)
# Размечаем классы и смещения для каждой якорной рамки
bbox_labels, bbox_masks, cls_labels = d2l.multibox_target(anchors, Y)
# По предсказанным и размеченным классам и смещениям вычисляем функцию потерь
l = calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels,
bbox_masks)
l.mean().backward()
trainer.step()
metric.add(cls_eval(cls_preds, cls_labels), cls_labels.numel(),
bbox_eval(bbox_preds, bbox_labels, bbox_masks),
bbox_labels.numel())
cls_err, bbox_mae = 1 - metric[0] / metric[1], metric[2] / metric[3]
animator.add(epoch + 1, (cls_err, bbox_mae))
print(f'ошибка классов {cls_err:.2e}, MAE рамок {bbox_mae:.2e}')
print(f'{len(train_iter.dataset) / timer.stop():.1f} примеров/с на '
f'{str(device)}')
PaddlePaddle:
num_epochs, timer = 20, d2l.Timer()
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=['ошибка классов', 'MAE рамок'])
for epoch in range(num_epochs):
# Сумма верных предсказаний классов, число предсказаний классов,
# сумма абсолютных ошибок рамок, число значений в этой сумме
metric = d2l.Accumulator(4)
net.train()
for features, target in train_iter:
timer.start()
trainer.clear_grad()
X, Y = features, target
# Генерируем многомасштабные якорные рамки и предсказываем для каждой из них класс и смещение
anchors, cls_preds, bbox_preds = net(X)
# Размечаем классы и смещения для каждой якорной рамки
bbox_labels, bbox_masks, cls_labels = d2l.multibox_target(anchors, Y)
# По предсказанным и размеченным классам и смещениям вычисляем функцию потерь
l = calc_loss(cls_preds, cls_labels, bbox_preds, bbox_labels,
bbox_masks)
l.mean().backward()
trainer.step()
metric.add(cls_eval(cls_preds, cls_labels), cls_labels.numel(),
bbox_eval(bbox_preds, bbox_labels, bbox_masks),
bbox_labels.numel())
cls_err, bbox_mae = 1 - metric[0] / metric[1], metric[2] / metric[3]
animator.add(epoch + 1, (cls_err, bbox_mae))
print(f'ошибка классов {cls_err:.2e}, MAE рамок {bbox_mae:.2e}')
print(f'{len(train_iter.dataset) / timer.stop():.1f} примеров/с на '
f'{str(device)}')
13.7.3 Предсказание объектов
На этапе предсказания мы хотим найти все интересующие нас объекты на изображении. Ниже мы загружаем тестовое изображение, меняем его размер и приводим к четырёхмерному формату, который нужен свёрточным слоям.
MXNet:
img = image.imread('../img/banana.jpg')
feature = image.imresize(img, 256, 256).astype('float32')
X = np.expand_dims(feature.transpose(2, 0, 1), axis=0)
PyTorch:
X = torchvision.io.read_image('../img/banana.jpg').unsqueeze(0).float()
img = X.squeeze(0).permute(1, 2, 0).long()
PaddlePaddle:
X = paddle.to_tensor(
paddlevision.image.image_load(
'../img/banana.jpg', backend="cv2"
)[..., ::-1].transpose([2,0,1])
).unsqueeze(0).astype(paddle.float32)
img = X.squeeze(0).transpose([1, 2, 0]).astype(paddle.int64)
С помощью функции multibox_detection ниже мы по якорным рамкам и их предсказанным смещениям получаем предсказанные ограничивающие рамки. Затем с помощью подавления немаксимумов удаляем похожие предсказанные рамки.
MXNet:
def predict(X):
anchors, cls_preds, bbox_preds = net(X.as_in_ctx(device))
cls_probs = npx.softmax(cls_preds).transpose(0, 2, 1)
output = d2l.multibox_detection(cls_probs, bbox_preds, anchors)
idx = [i for i, row in enumerate(output[0]) if row[0] != -1]
return output[0, idx]
output = predict(X)
PyTorch:
def predict(X):
net.eval()
anchors, cls_preds, bbox_preds = net(X.to(device))
cls_probs = F.softmax(cls_preds, dim=2).permute(0, 2, 1)
output = d2l.multibox_detection(cls_probs, bbox_preds, anchors)
idx = [i for i, row in enumerate(output[0]) if row[0] != -1]
return output[0, idx]
output = predict(X)
PaddlePaddle:
def predict(X):
net.eval()
anchors, cls_preds, bbox_preds = net(X)
cls_probs = F.softmax(cls_preds, axis=2).transpose([0, 2, 1])
output = d2l.multibox_detection(cls_probs, bbox_preds, anchors)
idx = [i for i, row in enumerate(output[0]) if row[0] != -1]
return output[0, :][idx]
output = predict(X)
Наконец, выведем все ограничивающие рамки с уверенностью не ниже 0.9 как итоговый результат.
MXNet:
def display(img, output, threshold):
d2l.set_figsize((5, 5))
fig = d2l.plt.imshow(img.asnumpy())
for row in output:
score = float(row[1])
if score < threshold:
continue
h, w = img.shape[0:2]
bbox = [row[2:6] * np.array((w, h, w, h), ctx=row.ctx)]
d2l.show_bboxes(fig.axes, bbox, '%.2f' % score, 'w')
display(img, output, threshold=0.9)
PyTorch:
def display(img, output, threshold):
d2l.set_figsize((5, 5))
fig = d2l.plt.imshow(img)
for row in output:
score = float(row[1])
if score < threshold:
continue
h, w = img.shape[0:2]
bbox = [row[2:6] * torch.tensor((w, h, w, h), device=row.device)]
d2l.show_bboxes(fig.axes, bbox, '%.2f' % score, 'w')
display(img, output.cpu(), threshold=0.9)
PaddlePaddle:
def display(img, output, threshold):
d2l.set_figsize((5, 5))
fig = d2l.plt.imshow(img)
for row in output:
score = float(row[1])
if score < threshold:
continue
h, w = img.shape[0:2]
bbox = [row[2:6] * paddle.to_tensor((w, h, w, h))]
d2l.show_bboxes(fig.axes, bbox, '%.2f' % score, 'w')
display(img, output.cpu(), threshold=0.9)
Резюме
- Одноступенчатое обнаружение с несколькими окнами — это модель обнаружения в нескольких масштабах. На основе базового блока сети и нескольких блоков многомасштабных признаков SSD создаёт якорные рамки разного числа и размера и обнаруживает объекты разного размера, предсказывая классы и смещения этих якорных рамок.
- При обучении модели одноступенчатого обнаружения с несколькими окнами функция потерь вычисляется по предсказанным и размеченным классам и смещениям якорных рамок.
Упражнения
- Можно ли улучшить одноступенчатое обнаружение с несколькими окнами, изменив функцию потерь? Например, заменить потерю в норме , которую мы используем для предсказания смещений, на сглаженную потерю в норме . Вблизи нуля она использует квадратичную функцию и поэтому становится более гладкой. Эта гладкость задаётся гиперпараметром :
При очень большом эта потеря похожа на потерю в норме . Когда значение мало, функция потерь становится более гладкой.
MXNet:
sigmas = [10, 1, 0.5]
lines = ['-', '--', '-.']
x = np.arange(-2, 2, 0.1)
d2l.set_figsize()
for l, s in zip(lines, sigmas):
y = npx.smooth_l1(x, scalar=s)
d2l.plt.plot(x.asnumpy(), y.asnumpy(), l, label='sigma=%.1f' % s)
d2l.plt.legend();
PyTorch:
def smooth_l1(data, scalar):
out = []
for i in data:
if abs(i) < 1 / (scalar ** 2):
out.append(((scalar * i) ** 2) / 2)
else:
out.append(abs(i) - 0.5 / (scalar ** 2))
return torch.tensor(out)
sigmas = [10, 1, 0.5]
lines = ['-', '--', '-.']
x = torch.arange(-2, 2, 0.1)
d2l.set_figsize()
for l, s in zip(lines, sigmas):
y = smooth_l1(x, scalar=s)
d2l.plt.plot(x, y, l, label='sigma=%.1f' % s)
d2l.plt.legend();
PaddlePaddle:
def smooth_l1(data, scalar):
out = []
for i in data.numpy():
if abs(i) < 1 / (scalar ** 2):
out.append(((scalar * i) ** 2) / 2)
else:
out.append(abs(i) - 0.5 / (scalar ** 2))
return paddle.to_tensor(out)
sigmas = [10, 1, 0.5]
lines = ['-', '--', '-.']
x = paddle.arange(-2.0, 2.0, 0.1, dtype=paddle.float32)
d2l.set_figsize()
for l, s in zip(lines, sigmas):
y = smooth_l1(x, scalar=s)
d2l.plt.plot(x, y, l, label='sigma=%.1f' % s)
d2l.plt.legend();
Кроме того, для предсказания классов в эксперименте использовалась кросс-энтропия: если предсказанная вероятность истинного класса равна , то потеря равна . Также можно использовать фокальную потерю (Lin et al., 2017). При заданных гиперпараметрах и эта потеря определяется так:
Видно, что увеличение эффективно уменьшает относительную потерю для примеров с большой предсказанной вероятностью правильного класса (например, ), поэтому обучение может сосредоточиться на трудных примерах, которые классифицируются неверно.
MXNet:
def focal_loss(gamma, x):
return -(1 - x) ** gamma * np.log(x)
x = np.arange(0.01, 1, 0.01)
for l, gamma in zip(lines, [0, 1, 5]):
y = d2l.plt.plot(x.asnumpy(), focal_loss(gamma, x).asnumpy(), l,
label='gamma=%.1f' % gamma)
d2l.plt.legend();
PyTorch:
def focal_loss(gamma, x):
return -(1 - x) ** gamma * torch.log(x)
x = torch.arange(0.01, 1, 0.01)
for l, gamma in zip(lines, [0, 1, 5]):
y = d2l.plt.plot(x, focal_loss(gamma, x), l, label='gamma=%.1f' % gamma)
d2l.plt.legend();
PaddlePaddle:
def focal_loss(gamma, x):
return -(1 - x) ** gamma * paddle.log(x)
x = paddle.arange(0.01, 1, 0.01, dtype=paddle.float32)
for l, gamma in zip(lines, [0, 1, 5]):
y = d2l.plt.plot(x, focal_loss(gamma, x), l, label='gamma=%.1f' % gamma)
d2l.plt.legend();
- Из-за ограничений объёма в этом разделе мы опустили некоторые детали реализации модели одноступенчатого обнаружения с несколькими окнами. Можно ли улучшить модель в следующих направлениях:
- когда объекты намного меньше изображения, модель может увеличить входное изображение;
- обычно есть много отрицательных якорных рамок. Чтобы распределение классов было более сбалансированным, можно уменьшить вдвое высоту и ширину отрицательных якорных рамок;
- в функции потерь задать гиперпараметры, которые по-разному взвешивают потерю классов и потерю смещений;
- оценивать модель обнаружения объектов другими методами, например теми, что описаны в статье об одноступенчатом обнаружении с несколькими окнами (Liu et al., 2016).
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Liu, W., Anguelov, D., Erhan, D., Szegedy, C., Reed, S., Fu, C.-Y., & Berg, A. C. (2016). SSD: Single shot multibox detector. European Conference on Computer Vision, 21–37.
13.8 Семейство R-CNN
Помимо одноступенчатого обнаружения с несколькими окнами, описанного в разделе 13.7, одним из первых шагов в применении глубоких моделей к обнаружению объектов стали свёрточные нейронные сети на основе областей (region-based CNN, или regions with CNN features, R-CNN) (Girshick et al., 2014). В этом разделе мы рассмотрим R-CNN и несколько его улучшений: быстрый R-CNN (Fast R-CNN) (Girshick, 2015), более быстрый R-CNN (Faster R-CNN) (Ren et al., 2015) и R-CNN с масками (Mask R-CNN) (He et al., 2017). Из-за ограниченного объёма мы опишем лишь основные идеи этих моделей.
13.8.1 R-CNN
R-CNN сначала выбирает из входного изображения несколько (например, 2000) предложенных областей (region proposals). Выбирать их можно и с помощью якорных рамок. Каждая область размечается классом и ограничивающей рамкой (например, смещением) (Girshick et al., 2014). Затем свёрточная нейронная сеть выполняет прямое распространение для каждой предложенной области и извлекает её признаки. Далее по признакам каждой предложенной области предсказываются класс и ограничивающая рамка.
Рис. 13.8.1. Модель R-CNN
На рис. 13.8.1 показана модель R-CNN. Конкретно, R-CNN включает четыре шага:
- Применить к входному изображению выборочный поиск (selective search), чтобы выбрать несколько качественных предложенных областей (Uijlings et al., 2013). Такие области обычно выбираются на нескольких масштабах и имеют разную форму и размер. Каждой предложенной области назначаются класс и истинная ограничивающая рамка;
- Выбрать предобученную свёрточную нейронную сеть и обрезать её перед выходным слоем. Каждую предложенную область привести к размеру, нужному сети, и выполнить прямое распространение, чтобы получить признаки предложенной области;
- Использовать признаки каждой предложенной области вместе с её размеченным классом как обучающий пример. Обучить несколько машин опорных векторов (SVM) для классификации объектов, где каждая машина определяет, принадлежит ли пример определённому классу;
- Использовать признаки каждой предложенной области вместе с её размеченной ограничивающей рамкой как обучающий пример. Обучить модель линейной регрессии, которая предсказывает истинную ограничивающую рамку.
Хотя модель R-CNN эффективно извлекает признаки изображения с помощью предобученной свёрточной сети, она работает медленно. Представим, что из одного изображения выбирается тысяча предложенных областей. Тогда для обнаружения объектов потребуется тысяча прямых распространений свёрточной сети. Такой большой объём вычислений затрудняет широкое применение R-CNN на практике.
13.8.2 Fast R-CNN
Главное узкое место R-CNN в том, что прямое распространение свёрточной сети для каждой предложенной области выполняется независимо, без совместного использования вычислений. Поскольку эти области часто перекрываются, независимое извлечение признаков приводит к повторным вычислениям. Одно из главных улучшений в Fast R-CNN (Girshick, 2015) по сравнению с R-CNN состоит в том, что прямое распространение свёрточной сети выполняется только один раз — для всего изображения.
Рис. 13.8.2. Модель Fast R-CNN
На рис. 13.8.2 показана модель Fast R-CNN. Её основные вычисления таковы:
- По сравнению с R-CNN свёрточная сеть, которая извлекает признаки в Fast R-CNN, получает на вход всё изображение, а не отдельные предложенные области. Кроме того, эта сеть обычно обучается вместе с остальной моделью. Пусть входом служит одно изображение, а форма выхода свёрточной сети — ;
- Пусть выборочный поиск выдал предложенных областей. Эти области разной формы на выходе свёрточной сети задают области интереса (RoI) разной формы. Затем из этих областей интереса нужно извлечь признаки одинаковой формы (например, с заданной высотой и шириной ), чтобы их можно было объединить на выходе. Для этого Fast R-CNN вводит пулинг по областям интереса (RoI pooling): на вход он получает выход свёрточной сети и предложенные области, а на выход выдаёт объединённые признаки каждой предложенной области формы ;
- С помощью полносвязного слоя форма выхода приводится к , где гиперпараметр зависит от архитектуры модели;
- Для каждой из предложенных областей предсказываются класс и ограничивающая рамка. Точнее, при предсказании класса и рамки выход полносвязного слоя преобразуется в выход формы ( — число классов) и выход формы соответственно. Классы предсказываются с помощью softmax-регрессии.
Пулинг по областям интереса, введённый в Fast R-CNN, отличается от пулинга из раздела 6.5. В обычном пулинге форма выхода задаётся косвенно — через размер окна, заполнение и шаг. Пулинг по областям интереса позволяет напрямую задать форму выхода для каждой области.
Например, зададим высоту и ширину выхода для каждой области равными и . Для любой области интереса формы её делят на сетку подокон , где размер каждого подокна примерно равен . На практике высоту и ширину каждого подокна округляют вверх, а максимальный элемент подокна становится его выходом. Поэтому пулинг по областям интереса извлекает признаки одинаковой формы из областей интереса разной формы.
Для иллюстрации на рис. 13.8.3 показан вход , из которого мы выбрали область интереса в левом верхнем углу. Для этой области с помощью пулинга по областям интереса мы получаем выход . Обратите внимание: четыре разделённых подокна содержат элементы 0, 1, 4, 5 (максимум 5); 2, 6 (максимум 6); 8, 9 (максимум 9); и 10.
Рис. 13.8.3. Пулинг по областям интереса
Ниже мы показываем, как вычисляется пулинг по областям интереса. Пусть признаки X, которые извлекла свёрточная сеть, имеют высоту и ширину 4 и один канал.
MXNet:
from mxnet import np, npx
npx.set_np()
X = np.arange(16).reshape(1, 1, 4, 4)
X
PyTorch:
import torch
import torchvision
X = torch.arange(16.).reshape(1, 1, 4, 4)
X
PaddlePaddle:
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.vision as paddlevision
X = paddle.reshape(paddle.arange(16, dtype='float32'), (1,1,4,4))
X
Допустим также, что высота и ширина входного изображения равны 40 пикселям, а выборочный поиск выдал на нём две предложенные области. Каждая область описывается пятью элементами: классом области и координатами левого верхнего и правого нижнего углов.
MXNet:
rois = np.array([[0, 0, 0, 20, 20], [0, 0, 10, 30, 30]])
PyTorch:
rois = torch.Tensor([[0, 0, 0, 20, 20], [0, 0, 10, 30, 30]])
PaddlePaddle:
rois = paddle.to_tensor([[0, 0, 20, 20], [0, 10, 30, 30]]).astype('float32')
Поскольку высота и ширина X в 10 раз меньше, чем у входного изображения, координаты двух предложенных областей сначала умножаются на spatial_scale, равный 0.1. Затем на X отмечаются две области интереса X[:, :, 0:3, 0:3] и X[:, :, 1:4, 0:4]. Наконец, в пулинге по областям интереса каждая область делится на сетку подокон, и из неё извлекаются признаки одной и той же формы .
MXNet:
npx.roi_pooling(X, rois, pooled_size=(2, 2), spatial_scale=0.1)
PyTorch:
torchvision.ops.roi_pool(X, rois, output_size=(2, 2), spatial_scale=0.1)
PaddlePaddle:
boxes_num = paddle.to_tensor([len(rois)]).astype('int32')
paddlevision.ops.roi_pool(X, rois, boxes_num, output_size=(2, 2), spatial_scale=0.1)
13.8.3 Faster R-CNN
Чтобы точно обнаруживать объекты, модели Fast R-CNN обычно требуется много предложенных областей, которые создаёт выборочный поиск. Faster R-CNN (Ren et al., 2015) предлагает заменить выборочный поиск на сеть предложения областей (region proposal network). Это позволяет уменьшить число предложенных областей и сохранить точность обнаружения.
Рис. 13.8.4. Модель Faster R-CNN
На рис. 13.8.4 показана модель Faster R-CNN. По сравнению с Fast R-CNN в Faster R-CNN меняется только способ создания предложенных областей: вместо выборочного поиска используется сеть предложения областей, а остальная часть модели остаётся прежней. Конкретно, вычисления в сети предложения областей такие:
- Преобразовать выход свёрточной сети с помощью свёрточного слоя с заполнением 1, а число выходных каналов обозначить . Тогда каждый элемент карты признаков, которую извлекла свёрточная сеть для изображения, получает новый признак длины ;
- С центром в каждом пикселе карты признаков создать несколько якорных рамок разного размера и соотношения сторон и разметить их;
- По признаку длины в центральном элементе якорной рамки предсказать её бинарный класс (объект или фон) и ограничивающую рамку;
- С помощью подавления немаксимумов удалить похожие результаты среди предсказанных ограничивающих рамок, класс которых — объект. Оставшиеся предсказанные ограничивающие рамки и являются предложенными областями, которые нужны пулингу по областям интереса.
Стоит отметить, что сеть предложения областей — часть модели Faster R-CNN и обучается вместе со всей моделью. Иными словами, целевая функция Faster R-CNN включает не только предсказание классов и ограничивающих рамок для обнаружения объектов, но и предсказание бинарных классов и ограничивающих рамок якорных рамок в сети предложения областей. В результате сквозного обучения сеть предложения областей учится генерировать качественные предложенные области. Благодаря этому модель сохраняет точность обнаружения даже при меньшем числе предложенных областей.
13.8.4 Mask R-CNN
Если в обучающем наборе для каждого объекта также размечено его положение на уровне пикселей изображения, то Mask R-CNN (He et al., 2017) может эффективно использовать эту подробную разметку, чтобы дополнительно повысить точность обнаружения.
Рис. 13.8.5. Модель Mask R-CNN
Как показано на рис. 13.8.5, Mask R-CNN построена на основе Faster R-CNN. Конкретно, Mask R-CNN заменяет пулинг по областям интереса на слой выравнивания областей интереса (RoI align), который использует билинейную интерполяцию (bilinear interpolation), чтобы сохранить пространственную информацию карты признаков. Это делает модель более пригодной для предсказаний на уровне пикселей. Выход слоя выравнивания содержит признаки одинаковой формы для всех областей интереса. Они используются не только для предсказания класса и ограничивающей рамки каждой области интереса, но и для предсказания положения объекта на уровне пикселей с помощью дополнительной полносвёрточной сети. Следующие разделы главы подробнее расскажут, как с помощью полносвёрточных сетей предсказывать семантику на уровне пикселей изображения.
Резюме
- R-CNN выбирает из изображения несколько предложенных областей, для каждой из них выполняет прямое распространение свёрточной сети, чтобы извлечь признаки, а затем по этим признакам предсказывает класс и ограничивающую рамку предложенной области.
- Fast R-CNN — главное улучшение R-CNN: прямое распространение свёрточной сети выполняется только для всего изображения. Кроме того, он вводит пулинг по областям интереса, который извлекает признаки одинаковой формы из областей интереса разной формы.
- Faster R-CNN заменяет выборочный поиск из Fast R-CNN на обучаемую сеть предложения областей. Благодаря этому число предложенных областей уменьшается, а точность обнаружения сохраняется.
- Mask R-CNN добавляет к Faster R-CNN полносвёрточную сеть, которая использует положения объектов на уровне пикселей и дополнительно повышает точность обнаружения.
Упражнения
- Можно ли рассматривать обнаружение объектов как задачу регрессии, например предсказывать ограничивающие рамки и вероятности классов? Можно опереться на архитектуру YOLO (Redmon et al., 2016).
- Сравните одноступенчатое обнаружение с несколькими окнами и методы из этого раздела. В чём их главное различие? Можно посмотреть рисунок 2 в статье (Zhao et al., 2019).
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Girshick, R. (2015). Fast R-CNN. Proceedings of the IEEE International Conference on Computer Vision, 1440–1448.
- Girshick, R., Donahue, J., Darrell, T., & Malik, J. (2014). Rich feature hierarchies for accurate object detection and semantic segmentation. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 580–587.
- Zhao, Z.-Q., Zheng, P., Xu, S.-T., & Wu, X. (2019). Object detection with deep learning: A review. IEEE Transactions on Neural Networks and Learning Systems, 30(11), 3212–3232.
- He, K., Gkioxari, G., Dollár, P., & Girshick, R. (2017). Mask R-CNN. Proceedings of the IEEE International Conference on Computer Vision, 2961–2969.
- Ren, S., He, K., Girshick, R., & Sun, J. (2015). Faster R-CNN: Towards real-time object detection with region proposal networks. Advances in Neural Information Processing Systems, 91–99.
- Redmon, J., Divvala, S., Girshick, R., & Farhadi, A. (2016). You only look once: Unified, real-time object detection. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 779–788.
- Uijlings, J. R. R., Van De Sande, K. E. A., Gevers, T., & Smeulders, A. W. M. (2013). Selective search for object recognition. International Journal of Computer Vision, 104(2), 154–171.
13.9 Семантическая сегментация и набор данных
В задачах обнаружения объектов, которые обсуждались в разделах 13.3–13.8, мы всегда размечали и предсказывали объекты на изображении с помощью прямоугольных ограничивающих рамок. Этот раздел посвящён семантической сегментации (semantic segmentation): она делит изображение на области, которые относятся к разным семантическим классам. В отличие от обнаружения объектов, семантическая сегментация распознаёт и понимает содержимое каждого пикселя изображения: разметка и предсказание семантических областей выполняются на уровне пикселей. На рис. 13.9.1 показана разметка изображения для семантической сегментации с классами «собака», «кошка» и «фон». По сравнению с обнаружением объектов пиксельные границы, которые задаёт сегментация, заметно точнее.
Рис. 13.9.1. Разметка для семантической сегментации изображения с классами «собака», «кошка» и «фон»
13.9.1 Сегментация изображений и сегментация экземпляров
В компьютерном зрении есть ещё две важные задачи, близкие к семантической сегментации: сегментация изображений (image segmentation) и сегментация экземпляров (instance segmentation). Коротко различим их с семантической сегментацией.
- Сегментация изображений делит изображение на составляющие области. Методы этой задачи обычно используют связи между пикселями изображения. При обучении им не нужна разметка пикселей, а при предсказании нельзя гарантировать, что выделенные области будут иметь нужный нам смысл. Если взять изображение с рис. 13.9.1 как вход, сегментация изображений может разделить собаку на две области: одну, где преобладают чёрный цвет (нос и глаза), и другую, где преобладает жёлтый (остальное тело).
- Сегментация экземпляров, или одновременное обнаружение и сегментация (simultaneous detection and segmentation), изучает, как выделять на уровне пикселей области отдельных экземпляров объектов на изображении. В отличие от семантической сегментации, сегментация экземпляров различает не только семантические классы, но и отдельные экземпляры объектов. Например, если на изображении две собаки, сегментация экземпляров должна определить, какой из двух собак принадлежит каждый пиксель.
13.9.2 Набор данных семантической сегментации Pascal VOC2012
Один из важнейших наборов данных для семантической сегментации — Pascal VOC2012. Ниже мы подробнее рассмотрим этот набор.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import gluon, image, np, npx
import os
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
import os
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.vision as paddlevision
import os
Архив набора данных весит около 2 ГБ, поэтому загрузка может занять некоторое время. Распакованный набор находится в ../data/VOCdevkit/VOC2012.
#@save
d2l.DATA_HUB['voc2012'] = (d2l.DATA_URL + 'VOCtrainval_11-May-2012.tar',
'4e443f8a2eca6b1dac8a6c57641b67dd40621a49')
voc_dir = d2l.download_extract('voc2012', 'VOCdevkit/VOC2012')
В каталоге ../data/VOCdevkit/VOC2012 находятся различные компоненты набора данных. Каталог ImageSets/Segmentation содержит текстовые файлы с перечнями обучающих и тестовых примеров, а каталоги JPEGImages и SegmentationClass хранят входные изображения и метки каждого примера соответственно. Метки здесь тоже представлены в виде изображений того же размера, что и размеченное входное изображение. Кроме того, пиксели одного цвета на метке принадлежат одному семантическому классу. Функция read_voc_images ниже читает все входные изображения и метки в память.
MXNet:
#@save
def read_voc_images(voc_dir, is_train=True):
"""Читает все изображения VOC и их разметку"""
txt_fname = os.path.join(voc_dir, 'ImageSets', 'Segmentation',
'train.txt' if is_train else 'val.txt')
with open(txt_fname, 'r') as f:
images = f.read().split()
features, labels = [], []
for i, fname in enumerate(images):
features.append(image.imread(os.path.join(
voc_dir, 'JPEGImages', f'{fname}.jpg')))
labels.append(image.imread(os.path.join(
voc_dir, 'SegmentationClass', f'{fname}.png')))
return features, labels
train_features, train_labels = read_voc_images(voc_dir, True)
PyTorch:
#@save
def read_voc_images(voc_dir, is_train=True):
"""Читает все изображения VOC и их разметку"""
txt_fname = os.path.join(voc_dir, 'ImageSets', 'Segmentation',
'train.txt' if is_train else 'val.txt')
mode = torchvision.io.image.ImageReadMode.RGB
with open(txt_fname, 'r') as f:
images = f.read().split()
features, labels = [], []
for i, fname in enumerate(images):
features.append(torchvision.io.read_image(os.path.join(
voc_dir, 'JPEGImages', f'{fname}.jpg')))
labels.append(torchvision.io.read_image(os.path.join(
voc_dir, 'SegmentationClass' ,f'{fname}.png'), mode))
return features, labels
train_features, train_labels = read_voc_images(voc_dir, True)
PaddlePaddle:
#@save
def read_voc_images(voc_dir, is_train=True):
"""Читает все изображения VOC и их разметку"""
txt_fname = os.path.join(voc_dir, 'ImageSets', 'Segmentation',
'train.txt' if is_train else 'val.txt')
with open(txt_fname, 'r') as f:
images = f.read().split()
features, labels = [], []
for i, fname in enumerate(images):
features.append(paddle.vision.image.image_load(os.path.join(
voc_dir, 'JPEGImages', f'{fname}.jpg'), backend='cv2')[..., ::-1].transpose(
[2, 0, 1]))
labels.append(paddle.vision.image.image_load(os.path.join(
voc_dir, 'SegmentationClass', f'{fname}.png'), backend='cv2')[..., ::-1].transpose(
[2, 0, 1]))
return features, labels
train_features, train_labels = read_voc_images(voc_dir, True)
Ниже мы рисуем первые 5 входных изображений и их метки. На метках белый и чёрный цвета обозначают границы и фон, а остальные цвета соответствуют разным классам.
MXNet:
n = 5
imgs = train_features[0:n] + train_labels[0:n]
d2l.show_images(imgs, 2, n);
PyTorch:
n = 5
imgs = train_features[0:n] + train_labels[0:n]
imgs = [img.permute(1,2,0) for img in imgs]
d2l.show_images(imgs, 2, n);
PaddlePaddle:
n = 5
imgs = train_features[0:n] + train_labels[0:n]
imgs = [img.transpose([1, 2, 0]) for img in imgs]
d2l.show_images(imgs, 2, n);
Далее перечислим значения цветов RGB и названия классов.
#@save
VOC_COLORMAP = [[0, 0, 0], [128, 0, 0], [0, 128, 0], [128, 128, 0],
[0, 0, 128], [128, 0, 128], [0, 128, 128], [128, 128, 128],
[64, 0, 0], [192, 0, 0], [64, 128, 0], [192, 128, 0],
[64, 0, 128], [192, 0, 128], [64, 128, 128], [192, 128, 128],
[0, 64, 0], [128, 64, 0], [0, 192, 0], [128, 192, 0],
[0, 64, 128]]
#@save
VOC_CLASSES = ['background', 'aeroplane', 'bicycle', 'bird', 'boat',
'bottle', 'bus', 'car', 'cat', 'chair', 'cow',
'diningtable', 'dog', 'horse', 'motorbike', 'person',
'potted plant', 'sheep', 'sofa', 'train', 'tv/monitor']
С помощью этих двух констант можно удобно найти индекс класса для каждого пикселя метки. Мы определяем функцию voc_colormap2label, которая строит отображение из указанных выше значений RGB в индекс класса, и функцию voc_label_indices, которая отображает значения RGB меток набора Pascal VOC2012 в индексы классов.
MXNet:
#@save
def voc_colormap2label():
"""Строит отображение из RGB в индекс класса VOC"""
colormap2label = np.zeros(256 ** 3)
for i, colormap in enumerate(VOC_COLORMAP):
colormap2label[
(colormap[0] * 256 + colormap[1]) * 256 + colormap[2]] = i
return colormap2label
#@save
def voc_label_indices(colormap, colormap2label):
"""Отображает значения RGB в метках VOC в их индексы классов"""
colormap = colormap.astype(np.int32)
idx = ((colormap[:, :, 0] * 256 + colormap[:, :, 1]) * 256
+ colormap[:, :, 2])
return colormap2label[idx]
PyTorch:
#@save
def voc_colormap2label():
"""Строит отображение из RGB в индекс класса VOC"""
colormap2label = torch.zeros(256 ** 3, dtype=torch.long)
for i, colormap in enumerate(VOC_COLORMAP):
colormap2label[
(colormap[0] * 256 + colormap[1]) * 256 + colormap[2]] = i
return colormap2label
#@save
def voc_label_indices(colormap, colormap2label):
"""Отображает значения RGB в метках VOC в их индексы классов"""
colormap = colormap.permute(1, 2, 0).numpy().astype('int32')
idx = ((colormap[:, :, 0] * 256 + colormap[:, :, 1]) * 256
+ colormap[:, :, 2])
return colormap2label[idx]
PaddlePaddle:
#@save
def voc_colormap2label():
"""Строит отображение из RGB в индекс класса VOC"""
colormap2label = paddle.zeros([256 ** 3], dtype=paddle.int64)
for i, colormap in enumerate(VOC_COLORMAP):
colormap2label[
(colormap[0] * 256 + colormap[1]) * 256 + colormap[2]] = i
return colormap2label
#@save
def voc_label_indices(colormap, colormap2label):
"""Отображает значения RGB в метках VOC в их индексы классов"""
colormap = colormap.transpose([1, 2, 0]).astype('int32')
idx = ((colormap[:, :, 0] * 256 + colormap[:, :, 1]) * 256
+ colormap[:, :, 2])
return colormap2label[idx]
Например, на первом примере изображения индекс класса для головы самолёта равен 1, а индекс фона равен 0.
y = voc_label_indices(train_labels[0], voc_colormap2label())
y[105:115, 130:140], VOC_CLASSES[1]
13.9.2.1 Предобработка данных
В предыдущих экспериментах, например в разделах 7.1–7.4, мы масштабировали изображения так, чтобы они соответствовали входной форме модели. В семантической сегментации такой подход требует пересчитывать предсказанные классы пикселей обратно к исходному размеру входного изображения. Такое отображение может быть недостаточно точным, особенно для областей разных семантических классов. Чтобы избежать этой проблемы, мы не масштабируем изображения, а обрезаем их до фиксированного размера. Конкретно, мы используем случайную обрезку из раздела 13.1, обрезая одну и ту же область входного изображения и метки.
MXNet:
#@save
def voc_rand_crop(feature, label, height, width):
"""Случайно обрезает признаки и метку"""
feature, rect = image.random_crop(feature, (width, height))
label = image.fixed_crop(label, *rect)
return feature, label
PyTorch:
#@save
def voc_rand_crop(feature, label, height, width):
"""Случайно обрезает признаки и метку"""
rect = torchvision.transforms.RandomCrop.get_params(
feature, (height, width))
feature = torchvision.transforms.functional.crop(feature, *rect)
label = torchvision.transforms.functional.crop(label, *rect)
return feature, label
PaddlePaddle:
#@save
def voc_rand_crop(feature, label, height, width):
"""Случайно обрезает признаки и метку"""
rect = paddle.vision.transforms.RandomCrop((height, width))._get_param(
img=feature, output_size=(height, width))
feature = paddle.vision.transforms.crop(feature, *rect)
label = paddle.vision.transforms.crop(label, *rect)
return feature, label
MXNet:
imgs = []
for _ in range(n):
imgs += voc_rand_crop(train_features[0], train_labels[0], 200, 300)
d2l.show_images(imgs[::2] + imgs[1::2], 2, n);
PyTorch:
imgs = []
for _ in range(n):
imgs += voc_rand_crop(train_features[0], train_labels[0], 200, 300)
imgs = [img.permute(1, 2, 0) for img in imgs]
d2l.show_images(imgs[::2] + imgs[1::2], 2, n);
PaddlePaddle:
imgs = []
for _ in range(n):
imgs += voc_rand_crop(train_features[0].transpose([1, 2, 0]), train_labels[0].transpose([1, 2, 0]), 200, 300)
imgs = [img for img in imgs]
d2l.show_images(imgs[::2] + imgs[1::2], 2, n);
13.9.2.2 Собственный класс набора данных для семантической сегментации
Мы наследуем класс Dataset из высокоуровневого API и определяем собственный класс набора данных для семантической сегментации VOCSegDataset. Реализуя функцию __getitem__, мы можем получить доступ к входному изображению с индексом idx и к индексам классов его пикселей. Поскольку некоторые изображения набора могут быть меньше, чем размер случайной обрезки, такие примеры удаляются с помощью собственной функции filter. Кроме того, мы определяем функцию normalize_image, которая стандартизирует значения трёх каналов RGB входного изображения.
MXNet:
#@save
class VOCSegDataset(gluon.data.Dataset):
"""Пользовательский набор данных для загрузки VOC"""
def __init__(self, is_train, crop_size, voc_dir):
self.rgb_mean = np.array([0.485, 0.456, 0.406])
self.rgb_std = np.array([0.229, 0.224, 0.225])
self.crop_size = crop_size
features, labels = read_voc_images(voc_dir, is_train=is_train)
self.features = [self.normalize_image(feature)
for feature in self.filter(features)]
self.labels = self.filter(labels)
self.colormap2label = voc_colormap2label()
print('прочитано ' + str(len(self.features)) + ' примеров')
def normalize_image(self, img):
return (img.astype('float32') / 255 - self.rgb_mean) / self.rgb_std
def filter(self, imgs):
return [img for img in imgs if (
img.shape[0] >= self.crop_size[0] and
img.shape[1] >= self.crop_size[1])]
def __getitem__(self, idx):
feature, label = voc_rand_crop(self.features[idx], self.labels[idx],
*self.crop_size)
return (feature.transpose(2, 0, 1),
voc_label_indices(label, self.colormap2label))
def __len__(self):
return len(self.features)
PyTorch:
#@save
class VOCSegDataset(torch.utils.data.Dataset):
"""Пользовательский набор данных для загрузки VOC"""
def __init__(self, is_train, crop_size, voc_dir):
self.transform = torchvision.transforms.Normalize(
mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
self.crop_size = crop_size
features, labels = read_voc_images(voc_dir, is_train=is_train)
self.features = [self.normalize_image(feature)
for feature in self.filter(features)]
self.labels = self.filter(labels)
self.colormap2label = voc_colormap2label()
print('прочитано ' + str(len(self.features)) + ' примеров')
def normalize_image(self, img):
return self.transform(img.float() / 255)
def filter(self, imgs):
return [img for img in imgs if (
img.shape[1] >= self.crop_size[0] and
img.shape[2] >= self.crop_size[1])]
def __getitem__(self, idx):
feature, label = voc_rand_crop(self.features[idx], self.labels[idx],
*self.crop_size)
return (feature, voc_label_indices(label, self.colormap2label))
def __len__(self):
return len(self.features)
PaddlePaddle:
#@save
class VOCSegDataset(paddle.io.Dataset):
"""Пользовательский набор данных для загрузки VOC"""
def __init__(self, is_train, crop_size, voc_dir):
self.transform = paddle.vision.transforms.Normalize(
mean=[0.485, 0.456, 0.406], std=[0.229, 0.224, 0.225])
self.crop_size = crop_size
features, labels = read_voc_images(voc_dir, is_train=is_train)
self.features = [self.normalize_image(feature)
for feature in self.filter(features)]
self.labels = self.filter(labels)
self.colormap2label = voc_colormap2label()
print('прочитано ' + str(len(self.features)) + ' примеров')
def normalize_image(self, img):
return self.transform(img.astype("float32") / 255)
def filter(self, imgs):
return [img for img in imgs if (
img.shape[1] >= self.crop_size[0] and
img.shape[2] >= self.crop_size[1])]
def __getitem__(self, idx):
feature = paddle.to_tensor(self.features[idx],dtype='float32')
label = paddle.to_tensor(self.labels[idx],dtype='float32')
feature, label = voc_rand_crop(feature,label,
*self.crop_size)
return (feature, voc_label_indices(label, self.colormap2label))
def __len__(self):
return len(self.features)
13.9.2.3 Чтение набора данных
С помощью класса VOCSegDataset мы создаём отдельные экземпляры для обучающего и тестового наборов. Допустим, что размер случайно обрезанного выходного изображения равен . Тогда мы можем посмотреть, сколько примеров осталось в обучающем и тестовом наборах.
crop_size = (320, 480)
voc_train = VOCSegDataset(True, crop_size, voc_dir)
voc_test = VOCSegDataset(False, crop_size, voc_dir)
Задав размер батча 64, создадим итератор для обучающего набора. Если вывести форму первого минибатча, видно, что в отличие от классификации изображений или обнаружения объектов метки здесь представляют собой трёхмерный массив.
MXNet:
batch_size = 64
train_iter = gluon.data.DataLoader(voc_train, batch_size, shuffle=True,
last_batch='discard',
num_workers=d2l.get_dataloader_workers())
for X, Y in train_iter:
print(X.shape)
print(Y.shape)
break
PyTorch:
batch_size = 64
train_iter = torch.utils.data.DataLoader(voc_train, batch_size, shuffle=True,
drop_last=True,
num_workers=d2l.get_dataloader_workers())
for X, Y in train_iter:
print(X.shape)
print(Y.shape)
break
PaddlePaddle:
batch_size = 64
train_iter = paddle.io.DataLoader(voc_train, batch_size=batch_size, shuffle=True,
drop_last=True,
return_list=True,
num_workers=d2l.get_dataloader_workers())
for X, Y in train_iter:
print(X.shape)
print(Y.shape)
break
13.9.2.4 Сборка всех компонентов
Наконец, определим функцию load_data_voc, которая загружает и читает набор данных Pascal VOC2012 для семантической сегментации. Она возвращает итераторы данных для обучающего и тестового наборов.
MXNet:
#@save
def load_data_voc(batch_size, crop_size):
"""Загружает набор данных VOC для семантической сегментации"""
voc_dir = d2l.download_extract('voc2012', os.path.join(
'VOCdevkit', 'VOC2012'))
num_workers = d2l.get_dataloader_workers()
train_iter = gluon.data.DataLoader(
VOCSegDataset(True, crop_size, voc_dir), batch_size,
shuffle=True, last_batch='discard', num_workers=num_workers)
test_iter = gluon.data.DataLoader(
VOCSegDataset(False, crop_size, voc_dir), batch_size,
last_batch='discard', num_workers=num_workers)
return train_iter, test_iter
PyTorch:
#@save
def load_data_voc(batch_size, crop_size):
"""Загружает набор данных VOC для семантической сегментации"""
voc_dir = d2l.download_extract('voc2012', os.path.join(
'VOCdevkit', 'VOC2012'))
num_workers = d2l.get_dataloader_workers()
train_iter = torch.utils.data.DataLoader(
VOCSegDataset(True, crop_size, voc_dir), batch_size,
shuffle=True, drop_last=True, num_workers=num_workers)
test_iter = torch.utils.data.DataLoader(
VOCSegDataset(False, crop_size, voc_dir), batch_size,
drop_last=True, num_workers=num_workers)
return train_iter, test_iter
PaddlePaddle:
#@save
def load_data_voc(batch_size, crop_size):
"""Загружает набор данных VOC для семантической сегментации"""
voc_dir = d2l.download_extract('voc2012', os.path.join(
'VOCdevkit', 'VOC2012'))
num_workers = d2l.get_dataloader_workers()
train_iter = paddle.io.DataLoader(
VOCSegDataset(True, crop_size, voc_dir), batch_size=batch_size,
shuffle=True, return_list=True, drop_last=True, num_workers=num_workers)
test_iter = paddle.io.DataLoader(
VOCSegDataset(False, crop_size, voc_dir), batch_size=batch_size,
drop_last=True, return_list=True, num_workers=num_workers)
return train_iter, test_iter
Резюме
- Семантическая сегментация делит изображение на области, принадлежащие разным семантическим классам, и распознаёт содержимое изображения на уровне пикселей.
- Важный набор данных для семантической сегментации называется Pascal VOC2012.
- Поскольку входное изображение и метка при семантической сегментации соответствуют друг другу пиксель в пиксель, входное изображение обрезается до фиксированного размера, а не масштабируется.
Упражнения
- Как можно применить семантическую сегментацию в беспилотных автомобилях и в диагностике по медицинским изображениям? Можете ли вы назвать другие области применения?
- Вспомните описание аугментации данных в разделе 13.1. Какой из методов аугментации изображений, используемых в классификации, трудно применить в семантической сегментации?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
13.10 Транспонированная свёртка
Слои свёрточных нейронных сетей, которые мы рассматривали до сих пор, например свёрточные слои (раздел 6.2) и слои пулинга (раздел 6.5), обычно уменьшают пространственные размеры (высоту и ширину) входного изображения. Однако при семантической сегментации, где классификация выполняется на уровне пикселей, удобно, когда размеры входа и выхода совпадают. Например, канал выхода в каждой позиции может содержать результат классификации входного пикселя в той же позиции.
Чтобы этого добиться, особенно после того как пространственные размеры уменьшены слоями свёрточной сети, можно использовать другой тип слоя, который увеличивает пространственные размеры промежуточных карт признаков. В этом разделе мы рассмотрим транспонированную свёртку (transposed convolution) (Dumoulin and Visin, 2016), которая обращает уменьшение пространственных размеров, вызванное понижающей дискретизацией (downsampling).
MXNet:
from mxnet import np, npx, init
from mxnet.gluon import nn
from d2l import mxnet as d2l
npx.set_np()
PyTorch:
import torch
from torch import nn
from d2l import torch as d2l
PaddlePaddle:
from d2l import paddle as d2l
import paddle
from paddle import nn
13.10.1 Базовая операция
Временно игнорируем каналы и начнём с базовой транспонированной свёртки с шагом 1 и без заполнения. Пусть есть входной тензор размера и ядро свёртки размера . Сдвигая окно ядра с шагом 1, раз в каждой строке и раз в каждом столбце, мы получаем промежуточных результатов. Каждый промежуточный результат — тензор размера , изначально заполненный нулями. Чтобы вычислить каждый промежуточный тензор, каждый элемент входного тензора умножается на ядро, и полученный тензор записывается в соответствующую часть промежуточного тензора. Заметим, что положение этой части в промежуточном тензоре соответствует положению элемента во входном тензоре. Наконец, все промежуточные результаты складываются, и получается итоговый результат.
Например, на рис. 13.10.1 показано, как вычислить транспонированную свёртку с ядром для входного тензора .
Рис. 13.10.1. Транспонированная свёртка с ядром . Затенённые части — часть промежуточного тензора, а также элементы входного тензора и ядра, использованные в вычислении
Выполним базовую операцию транспонированной свёртки для входной матрицы X и матрицы ядра K с помощью функции trans_conv.
def trans_conv(X, K):
h, w = K.shape
Y = d2l.zeros((X.shape[0] + h - 1, X.shape[1] + w - 1))
for i in range(X.shape[0]):
for j in range(X.shape[1]):
Y[i: i + h, j: j + w] += X[i, j] * K
return Y
В отличие от обычной свёртки, которая «уменьшает» входные элементы с помощью ядра (раздел 6.2), транспонированная свёртка «распространяет» входные элементы с помощью ядра и тем самым даёт выход больше входа. Мы можем проверить вывод этой реализации, построив входной тензор X и тензор ядра K как на рис. 13.10.1. Эта реализация — базовая двумерная транспонированная свёртка.
X = d2l.tensor([[0.0, 1.0], [2.0, 3.0]])
K = d2l.tensor([[0.0, 1.0], [2.0, 3.0]])
trans_conv(X, K)
Кроме того, если входной тензор X и ядро K — четырёхмерные тензоры, можно получить тот же результат с помощью высокоуровневого API.
MXNet:
X, K = X.reshape(1, 1, 2, 2), K.reshape(1, 1, 2, 2)
tconv = nn.Conv2DTranspose(1, kernel_size=2)
tconv.initialize(init.Constant(K))
tconv(X)
PyTorch:
X, K = X.reshape(1, 1, 2, 2), K.reshape(1, 1, 2, 2)
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, bias=False)
tconv.weight.data = K
tconv(X)
PaddlePaddle:
X, K = X.reshape([1, 1, 2, 2]), K.reshape([1, 1, 2, 2])
tconv = nn.Conv2DTranspose(1, 1, kernel_size=2, bias_attr=False)
K = paddle.create_parameter(shape=K.shape, dtype="float32",
default_initializer=paddle.nn.initializer.Assign(K))
tconv.weight = K
tconv(X)
13.10.2 Заполнение, шаг и многоканальность
В отличие от обычной свёртки, в транспонированной свёртке заполнение применяется к выходу (в обычной свёртке — к входу). Например, если задать заполнение по высоте и ширине равным 1, то первая и последняя строки и столбцы выхода транспонированной свёртки удаляются.
MXNet:
tconv = nn.Conv2DTranspose(1, kernel_size=2, padding=1)
tconv.initialize(init.Constant(K))
tconv(X)
PyTorch:
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, padding=1, bias=False)
tconv.weight.data = K
tconv(X)
PaddlePaddle:
tconv = nn.Conv2DTranspose(1, 1, kernel_size=2, padding=1, bias_attr=False)
tconv.weight = K
tconv(X)
В транспонированной свёртке шаг задаётся для промежуточного результата (выхода), а не для входа. Используем те же входной тензор и тензор ядра, что и на рис. 13.10.1, и изменим шаг с 1 на 2. Это увеличивает высоту и ширину промежуточного тензора, а выходной тензор показан на рис. 13.10.2.
Рис. 13.10.2. Транспонированная свёртка с ядром и шагом 2. Затенённые части — часть промежуточного тензора, а также элементы входного тензора и ядра, использованные в вычислении
Следующий код проверяет выход транспонированной свёртки с шагом 2 из рис. 13.10.2.
MXNet:
tconv = nn.Conv2DTranspose(1, kernel_size=2, strides=2)
tconv.initialize(init.Constant(K))
tconv(X)
PyTorch:
tconv = nn.ConvTranspose2d(1, 1, kernel_size=2, stride=2, bias=False)
tconv.weight.data = K
tconv(X)
PaddlePaddle:
tconv = nn.Conv2DTranspose(1, 1, kernel_size=2, stride=2, bias_attr=False)
tconv.weight = K
tconv(X)
Для нескольких входных и выходных каналов транспонированная свёртка работает так же, как обычная. Пусть вход имеет каналов, и транспонированная свёртка назначает каждому входному каналу тензор ядра . Если задано несколько выходных каналов, то для каждого выходного канала будет ядро размера .
Аналогично, если подать на вход свёрточного слоя , получить выход и создать транспонированный свёрточный слой с теми же гиперпараметрами, но с числом выходных каналов, равным числу каналов в , то форма совпадёт с формой . Следующий пример это иллюстрирует.
MXNet:
X = np.random.uniform(size=(1, 10, 16, 16))
conv = nn.Conv2D(20, kernel_size=5, padding=2, strides=3)
tconv = nn.Conv2DTranspose(10, kernel_size=5, padding=2, strides=3)
conv.initialize()
tconv.initialize()
tconv(conv(X)).shape == X.shape
PyTorch:
X = torch.rand(size=(1, 10, 16, 16))
conv = nn.Conv2d(10, 20, kernel_size=5, padding=2, stride=3)
tconv = nn.ConvTranspose2d(20, 10, kernel_size=5, padding=2, stride=3)
tconv(conv(X)).shape == X.shape
PaddlePaddle:
X = paddle.rand(shape=(1, 10, 16, 16))
conv = nn.Conv2D(10, 20, kernel_size=5, padding=2, stride=3)
tconv = nn.Conv2DTranspose(20, 10, kernel_size=5, padding=2, stride=3)
tconv(conv(X)).shape == X.shape
13.10.3 Связь с матричным транспонированием
Почему транспонированная свёртка получила название от матричного транспонирования? Сначала посмотрим, как реализовать свёртку с помощью матричного умножения. В приведённом ниже примере мы задаём входной тензор X размера и ядро K размера , а затем с помощью функции corr2d вычисляем выход свёртки Y.
MXNet, PyTorch:
X = d2l.arange(9.0).reshape(3, 3)
K = d2l.tensor([[1.0, 2.0], [3.0, 4.0]])
Y = d2l.corr2d(X, K)
Y
PaddlePaddle:
X = d2l.arange(9.0, dtype="float32").reshape((3, 3))
K = d2l.tensor([[1.0, 2.0], [3.0, 4.0]])
Y = d2l.corr2d(X, K)
Y
Далее перепишем ядро K в виде разреженной весовой матрицы W, в которой много нулей. Форма весовой матрицы равна (4, 9), а ненулевые элементы берутся из ядра K.
MXNet, PyTorch:
def kernel2matrix(K):
k, W = d2l.zeros(5), d2l.zeros((4, 9))
k[:2], k[3:5] = K[0, :], K[1, :]
W[0, :5], W[1, 1:6], W[2, 3:8], W[3, 4:] = k, k, k, k
return W
W = kernel2matrix(K)
W
PaddlePaddle:
def kernel2matrix(K):
k, W = d2l.zeros([5]), d2l.zeros((4, 9))
k[:2], k[3:5] = K[0, :], K[1, :]
W[0, :5], W[1, 1:6], W[2, 3:8], W[3, 4:] = k, k, k, k
return W
W = kernel2matrix(K)
W
Входной тензор X построчно преобразуется в вектор длины 9. Затем умножение матрицы W на векторизованный X даёт вектор длины 4. После изменения его формы получается тот же результат Y, что и при исходной свёртке: мы только что реализовали свёртку с помощью матричного умножения.
MXNet, PyTorch:
Y == d2l.matmul(W, d2l.reshape(X, -1)).reshape(2, 2)
PaddlePaddle:
Y == d2l.matmul(W, d2l.reshape(X, [-1])).reshape((2, 2))
Аналогично можно реализовать транспонированную свёртку с помощью матричного умножения. В следующем примере мы берём выход Y обычной свёртки выше в качестве входа транспонированной свёртки. Чтобы реализовать её матричным умножением, достаточно транспонировать матрицу весов W до формы (9, 4).
MXNet, PyTorch:
Z = trans_conv(Y, K)
Z == d2l.matmul(W.T, d2l.reshape(Y, -1)).reshape(3, 3)
PaddlePaddle:
Z = trans_conv(Y, K)
Z == d2l.matmul(W.T, d2l.reshape(Y, [-1])).reshape((3, 3))
В общем виде, для входного вектора и матрицы весов прямое распространение свёртки можно реализовать как умножение входа на матрицу весов, выдающее вектор . Поскольку обратное распространение следует правилу цепочки и , обратное распространение свёртки можно реализовать как умножение входа на транспонированную матрицу весов . Поэтому транспонированный свёрточный слой может поменять местами прямое и обратное распространение обычного свёрточного слоя: его прямое и обратное распространение умножают входной вектор на и соответственно.
Резюме
- В отличие от обычной свёртки, которая уменьшает входные элементы с помощью ядра, транспонированная свёртка распространяет входные элементы с помощью ядра и тем самым даёт выход, форма которого больше формы входа.
- Если подать на вход свёрточного слоя , получить выход и создать транспонированный свёрточный слой с теми же гиперпараметрами, но с числом выходных каналов, равным числу каналов в , то форма совпадёт с формой .
- Свёртку можно реализовать с помощью матричного умножения. Транспонированный свёрточный слой может поменять местами прямое и обратное распространение обычного свёрточного слоя.
Упражнения
- В разделе 13.10.3 входной тензор
Xсвёртки и выход транспонированной свёрткиZимеют одинаковую форму. Совпадают ли их значения? Почему? - Эффективно ли реализовывать свёртку через матричное умножение? Почему?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Dumoulin, V., & Visin, F. (2016). A guide to convolution arithmetic for deep learning. arXiv preprint arXiv:1603.07285.
13.11 Полносвёрточные сети
Как было показано в разделе 13.9, семантическая сегментация классифицирует каждый пиксель изображения. Полносвёрточная сеть (fully convolutional network, FCN) использует свёрточную нейронную сеть для преобразования пикселей изображения в классы пикселей (Long et al., 2015). В отличие от свёрточных сетей, которые мы рассматривали в задачах классификации изображений или обнаружения объектов, полносвёрточная сеть возвращает высоту и ширину карт признаков промежуточных слоёв к размерам входного изображения. Для этого используется транспонированная свёртка (transposed convolution), введённая в разделе 13.10. Поэтому выход классификации соответствует входному изображению пиксель в пиксель: канал выхода в каждой позиции содержит предсказание класса для пикселя в этой позиции.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import gluon, image, init, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
from torch.nn import functional as F
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
from paddle.nn import functional as F
import paddle.vision as paddlevision
13.11.1 Построение модели
Рассмотрим самую базовую конструкцию полносвёрточной сети. Как показано на рис. 13.11.1, полносвёрточная сеть сначала использует свёрточную нейронную сеть для извлечения признаков изображения, затем свёрточным слоем приводит число каналов к числу классов, а в конце с помощью транспонированного свёрточного слоя (раздел 13.10) возвращает высоту и ширину карты признаков к размеру входного изображения. Поэтому выход модели имеет ту же высоту и ширину, что и входное изображение, а его каналы содержат предсказания классов для пикселя в этой позиции.
Рис. 13.11.1. Полносвёрточная сеть
Далее используем ResNet-18, предобученную на ImageNet, чтобы извлекать признаки изображения. Обозначим эту сеть как pretrained_net. Последние слои ResNet-18 — глобальный средний пулинг и полносвязный слой, но для полносвёрточной сети они не нужны.
MXNet:
pretrained_net = gluon.model_zoo.vision.resnet18_v2(pretrained=True)
pretrained_net.features[-3:], pretrained_net.output
PyTorch:
pretrained_net = torchvision.models.resnet18(pretrained=True)
list(pretrained_net.children())[-3:]
PaddlePaddle:
pretrained_net = paddlevision.models.resnet18(pretrained=True)
list(pretrained_net.children())[-3:]
Теперь создадим полносвёрточную сеть net. Она повторяет большую часть предобученных слоёв ResNet-18, за исключением последнего глобального среднего пулинга и полносвязного слоя, ближайшего к выходу.
MXNet:
net = nn.HybridSequential()
for layer in pretrained_net.features[:-2]:
net.add(layer)
PyTorch, PaddlePaddle:
net = nn.Sequential(*list(pretrained_net.children())[:-2])
Если на вход подать изображение высотой 320 и шириной 480, то прямое распространение net уменьшит высоту и ширину входа в 32 раза, то есть до 10 и 15.
MXNet:
X = np.random.uniform(size=(1, 3, 320, 480))
net(X).shape
PyTorch:
X = torch.rand(size=(1, 3, 320, 480))
net(X).shape
PaddlePaddle:
X = paddle.rand(shape=(1, 3, 320, 480))
net(X).shape
Далее с помощью свёрточного слоя приведём число выходных каналов к числу классов набора Pascal VOC2012 (21 класс). Наконец, нужно увеличить высоту и ширину карты признаков в 32 раза, чтобы вернуть их к высоте и ширине входного изображения. Вспомним, как вычисляется форма выхода свёрточного слоя из раздела 6.3. Поскольку и , построим транспонированный свёрточный слой с шагом 32, а высоту и ширину ядра зададим равными 64, заполнение — 16. Видно, что если шаг равен , заполнение равно (предполагаем, что — целое число), а высота и ширина ядра равны , то транспонированная свёртка увеличит высоту и ширину входа в раз.
MXNet:
num_classes = 21
net.add(nn.Conv2D(num_classes, kernel_size=1),
nn.Conv2DTranspose(
num_classes, kernel_size=64, padding=16, strides=32))
PyTorch:
num_classes = 21
net.add_module('final_conv', nn.Conv2d(512, num_classes, kernel_size=1))
net.add_module('transpose_conv', nn.ConvTranspose2d(num_classes, num_classes,
kernel_size=64, padding=16, stride=32))
PaddlePaddle:
num_classes = 21
net.add_sublayer('final_conv', nn.Conv2D(512, num_classes, kernel_size=1))
net.add_sublayer('transpose_conv', nn.Conv2DTranspose(num_classes, num_classes,
kernel_size=64, padding=16, stride=32))
13.11.2 Инициализация транспонированного свёрточного слоя
При обработке изображений иногда нужно увеличить изображение, то есть выполнить повышающую дискретизацию (upsampling). Билинейная интерполяция (bilinear interpolation) — один из распространённых методов повышающей дискретизации. Её также часто используют для инициализации транспонированных свёрточных слоёв.
Чтобы объяснить билинейную интерполяцию, пусть задано входное изображение, и мы хотим вычислить значение каждого пикселя выходного изображения после повышающей дискретизации.
- Отобразить координаты пикселя выходного изображения в координаты входного изображения, например по отношению размеров входа и выхода. Заметим, что и после отображения — вещественные числа.
- Найти на входном изображении 4 ближайших к точке пикселя.
- Значение пикселя выходного изображения с координатами вычислить по этим 4 пикселям входного изображения с учётом их относительного расстояния до .
Повышающая дискретизация билинейной интерполяцией может быть реализована транспонированным свёрточным слоем, ядро которого строится функцией bilinear_kernel, приведённой ниже. Ради краткости мы приводим только реализацию функции bilinear_kernel, без обсуждения принципа алгоритма.
MXNet:
def bilinear_kernel(in_channels, out_channels, kernel_size):
factor = (kernel_size + 1) // 2
if kernel_size % 2 == 1:
center = factor - 1
else:
center = factor - 0.5
og = (np.arange(kernel_size).reshape(-1, 1),
np.arange(kernel_size).reshape(1, -1))
filt = (1 - np.abs(og[0] - center) / factor) * \
(1 - np.abs(og[1] - center) / factor)
weight = np.zeros((in_channels, out_channels, kernel_size, kernel_size))
weight[range(in_channels), range(out_channels), :, :] = filt
return np.array(weight)
PyTorch:
def bilinear_kernel(in_channels, out_channels, kernel_size):
factor = (kernel_size + 1) // 2
if kernel_size % 2 == 1:
center = factor - 1
else:
center = factor - 0.5
og = (torch.arange(kernel_size).reshape(-1, 1),
torch.arange(kernel_size).reshape(1, -1))
filt = (1 - torch.abs(og[0] - center) / factor) * \
(1 - torch.abs(og[1] - center) / factor)
weight = torch.zeros((in_channels, out_channels,
kernel_size, kernel_size))
weight[range(in_channels), range(out_channels), :, :] = filt
return weight
PaddlePaddle:
def bilinear_kernel(in_channels, out_channels, kernel_size):
factor = (kernel_size + 1) // 2
if kernel_size % 2 == 1:
center = factor - 1
else:
center = factor - 0.5
og = (paddle.arange(kernel_size).reshape([-1, 1]),
paddle.arange(kernel_size).reshape([1, -1]))
filt = (1 - paddle.abs(og[0] - center) / factor) * \
(1 - paddle.abs(og[1] - center) / factor)
weight = paddle.zeros((in_channels, out_channels,
kernel_size, kernel_size))
weight[range(in_channels), range(out_channels), :, :] = filt
return weight
Теперь проведём эксперимент с повышающей дискретизацией билинейной интерполяцией, которую реализует транспонированный свёрточный слой. Создадим транспонированный свёрточный слой, который увеличивает высоту и ширину входа в 2 раза, и инициализируем его ядро функцией bilinear_kernel.
MXNet:
conv_trans = nn.Conv2DTranspose(3, kernel_size=4, padding=1, strides=2)
conv_trans.initialize(init.Constant(bilinear_kernel(3, 3, 4)))
PyTorch:
conv_trans = nn.ConvTranspose2d(3, 3, kernel_size=4, padding=1, stride=2,
bias=False)
conv_trans.weight.data.copy_(bilinear_kernel(3, 3, 4));
PaddlePaddle:
conv_trans = nn.Conv2DTranspose(3, 3, kernel_size=4, padding=1, stride=2,
bias_attr=False)
conv_trans.weight.set_value(bilinear_kernel(3, 3, 4));
Прочитаем изображение X и результат повышающей дискретизации обозначим Y. Чтобы вывести изображение, нужно поменять местами измерения каналов.
MXNet:
img = image.imread('../img/catdog.jpg')
X = np.expand_dims(img.astype('float32').transpose(2, 0, 1), axis=0) / 255
Y = conv_trans(X)
out_img = Y[0].transpose(1, 2, 0)
PyTorch:
img = torchvision.transforms.ToTensor()(d2l.Image.open('../img/catdog.jpg'))
X = img.unsqueeze(0)
Y = conv_trans(X)
out_img = Y[0].permute(1, 2, 0).detach()
PaddlePaddle:
img = paddlevision.transforms.ToTensor()(d2l.Image.open('../img/catdog.jpg'))
X = img.unsqueeze(0)
Y = conv_trans(X)
out_img = Y[0].transpose([1, 2, 0]).detach()
Видно, что транспонированный свёрточный слой увеличил высоту и ширину изображения в 2 раза. Кроме различия в масштабе координат, изображение, увеличенное билинейной интерполяцией, почти не отличается от исходного, который мы выводили в разделе 13.3.
MXNet:
d2l.set_figsize()
print('input image shape:', img.shape)
d2l.plt.imshow(img.asnumpy());
print('output image shape:', out_img.shape)
d2l.plt.imshow(out_img.asnumpy());
PyTorch:
d2l.set_figsize()
print('input image shape:', img.permute(1, 2, 0).shape)
d2l.plt.imshow(img.permute(1, 2, 0));
print('output image shape:', out_img.shape)
d2l.plt.imshow(out_img);
PaddlePaddle:
d2l.set_figsize()
print('input image shape:', img.transpose([1, 2, 0]).shape)
d2l.plt.imshow(img.transpose([1, 2, 0]));
print('output image shape:', out_img.shape)
d2l.plt.imshow(out_img);
Полносвёрточная сеть инициализирует транспонированный свёрточный слой повышающей дискретизацией билинейной интерполяцией. Для свёрточного слоя параметры инициализируются методом Xavier.
MXNet:
W = bilinear_kernel(num_classes, num_classes, 64)
net[-1].initialize(init.Constant(W))
net[-2].initialize(init=init.Xavier())
PyTorch:
W = bilinear_kernel(num_classes, num_classes, 64)
net.transpose_conv.weight.data.copy_(W);
PaddlePaddle:
W = bilinear_kernel(num_classes, num_classes, 64)
net.transpose_conv.weight.set_value(W);
13.11.3 Чтение набора данных
Для чтения набора данных используем интерфейс загрузки данных семантической сегментации из раздела 13.9. Зададим форму случайно обрезанного выходного изображения : и высота, и ширина делятся на .
MXNet, PyTorch:
batch_size, crop_size = 32, (320, 480)
train_iter, test_iter = d2l.load_data_voc(batch_size, crop_size)
PaddlePaddle:
import os
def load_data_voc(batch_size, crop_size):
"""Загружает набор данных VOC для семантической сегментации"""
voc_dir = d2l.download_extract('voc2012', os.path.join(
'VOCdevkit', 'VOC2012'))
train_iter = paddle.io.DataLoader(
d2l.VOCSegDataset(True, crop_size, voc_dir), batch_size=batch_size,
shuffle=True, return_list=True, drop_last=True, num_workers=0)
test_iter = paddle.io.DataLoader(
d2l.VOCSegDataset(False, crop_size, voc_dir), batch_size=batch_size,
drop_last=True, return_list=True, num_workers=0)
return train_iter, test_iter
batch_size, crop_size = 32, (320, 480)
train_iter, test_iter = load_data_voc(batch_size, crop_size)
13.11.4 Обучение
Теперь можно обучить полносвёрточную сеть. Функции потерь и вычисления точности здесь принципиально не отличаются от задачи классификации изображений: поскольку мы предсказываем классы пикселей с помощью каналов транспонированного свёрточного слоя, в вычислении потерь нужно явно указать измерение каналов. Кроме того, точность модели считается по тому, правильно ли предсказан класс каждого пикселя.
MXNet:
num_epochs, lr, wd, devices = 5, 0.1, 1e-3, d2l.try_all_gpus()
loss = gluon.loss.SoftmaxCrossEntropyLoss(axis=1)
net.collect_params().reset_ctx(devices)
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'learning_rate': lr, 'wd': wd})
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
PyTorch:
def loss(inputs, targets):
return F.cross_entropy(inputs, targets, reduction='none').mean(1).mean(1)
num_epochs, lr, wd, devices = 5, 0.001, 1e-3, d2l.try_all_gpus()
trainer = torch.optim.SGD(net.parameters(), lr=lr, weight_decay=wd)
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
PaddlePaddle:
def loss(inputs, targets):
return F.cross_entropy(inputs.transpose([0, 2, 3, 1]), targets, reduction='none').mean(1).mean(1)
num_epochs, lr, wd, devices = 5, 0.001, 1e-3, d2l.try_all_gpus()
trainer = paddle.optimizer.SGD(learning_rate=lr, parameters=net.parameters(), weight_decay=wd)
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices[:1])
13.11.5 Предсказание
При предсказании нужно стандартизировать входное изображение по каждому каналу и привести его к четырёхмерному формату, который требуется свёрточной нейронной сети.
MXNet:
def predict(img):
X = test_iter._dataset.normalize_image(img)
X = np.expand_dims(X.transpose(2, 0, 1), axis=0)
pred = net(X.as_in_ctx(devices[0])).argmax(axis=1)
return pred.reshape(pred.shape[1], pred.shape[2])
PyTorch:
def predict(img):
X = test_iter.dataset.normalize_image(img).unsqueeze(0)
pred = net(X.to(devices[0])).argmax(dim=1)
return pred.reshape(pred.shape[1], pred.shape[2])
PaddlePaddle:
def predict(img):
X = paddle.to_tensor(test_iter.dataset.normalize_image(img),dtype='float32').unsqueeze(0)
pred = net(X).argmax(axis=1)
return pred.reshape([pred.shape[1], pred.shape[2]])
Чтобы визуализировать предсказанный класс каждого пикселя, сопоставим предсказанные классы с цветами их разметки в наборе данных.
MXNet:
def label2image(pred):
colormap = np.array(d2l.VOC_COLORMAP, ctx=devices[0], dtype='uint8')
X = pred.astype('int32')
return colormap[X, :]
PyTorch:
def label2image(pred):
colormap = torch.tensor(d2l.VOC_COLORMAP, device=devices[0])
X = pred.long()
return colormap[X, :]
PaddlePaddle:
def label2image(pred):
colormap = paddle.to_tensor(d2l.VOC_COLORMAP)
X = pred.astype(paddle.int32)
return colormap[X]
Размеры и формы изображений в тестовом наборе различаются. Поскольку модель использует транспонированный свёрточный слой с шагом 32, если высота или ширина входного изображения не делятся на 32, то высота или ширина выхода транспонированного свёрточного слоя будет отличаться от размера входного изображения. Чтобы решить эту проблему, можно вырезать из изображения несколько прямоугольных областей с высотой и шириной, кратными 32, и выполнить прямое распространение для пикселей каждой из этих областей. Заметим, что объединение этих областей должно полностью покрывать входное изображение. Если пиксель покрыт несколькими областями, то среднее значение выходов транспонированного свёрточного слоя для этого пикселя в разных областях можно использовать как вход операции softmax, чтобы предсказать класс.
Для простоты мы читаем лишь несколько крупных тестовых изображений и для предсказания вырезаем области размером , начиная с левого верхнего угла изображения. Для каждого из этих тестовых изображений мы по очереди выводим вырезанную область, результат предсказания и размеченный класс.
MXNet:
voc_dir = d2l.download_extract('voc2012', 'VOCdevkit/VOC2012')
test_images, test_labels = d2l.read_voc_images(voc_dir, False)
n, imgs = 4, []
for i in range(n):
crop_rect = (0, 0, 480, 320)
X = image.fixed_crop(test_images[i], *crop_rect)
pred = label2image(predict(X))
imgs += [X, pred, image.fixed_crop(test_labels[i], *crop_rect)]
d2l.show_images(imgs[::3] + imgs[1::3] + imgs[2::3], 3, n, scale=2);
PyTorch:
voc_dir = d2l.download_extract('voc2012', 'VOCdevkit/VOC2012')
test_images, test_labels = d2l.read_voc_images(voc_dir, False)
n, imgs = 4, []
for i in range(n):
crop_rect = (0, 0, 320, 480)
X = torchvision.transforms.functional.crop(test_images[i], *crop_rect)
pred = label2image(predict(X))
imgs += [X.permute(1,2,0), pred.cpu(),
torchvision.transforms.functional.crop(
test_labels[i], *crop_rect).permute(1,2,0)]
d2l.show_images(imgs[::3] + imgs[1::3] + imgs[2::3], 3, n, scale=2);
PaddlePaddle:
voc_dir = d2l.download_extract('voc2012', 'VOCdevkit/VOC2012')
test_images, test_labels = d2l.read_voc_images(voc_dir, False)
n, imgs = 4, []
for i in range(n):
crop_rect = (0, 0, 320, 480)
X = paddlevision.transforms.crop(test_images[i], *crop_rect)
pred = label2image(predict(X))
imgs += [X.transpose([1,2,0]).astype('uint8'), pred,
paddlevision.transforms.crop(
test_labels[i], *crop_rect).transpose([1, 2, 0]).astype("uint8")]
d2l.show_images(imgs[::3] + imgs[1::3] + imgs[2::3], 3, n, scale=2);
Резюме
- Полносвёрточная сеть сначала использует свёрточную нейронную сеть для извлечения признаков изображения, затем свёрточным слоем приводит число каналов к числу классов, а в конце транспонированным свёрточным слоем возвращает высоту и ширину карты признаков к размеру входного изображения.
- В полносвёрточной сети транспонированный свёрточный слой можно инициализировать билинейной интерполяцией для повышающей дискретизации.
Упражнения
- Если инициализировать транспонированный свёрточный слой случайным образом методом Xavier, что изменится в результатах?
- Можно ли дополнительно повысить точность модели, подобрав гиперпараметры?
- Предскажите классы всех пикселей тестовых изображений.
- В оригинальной статье о полносвёрточных сетях (Long et al., 2015) также использовались выходы некоторых промежуточных слоёв свёрточной сети. Попробуйте реализовать эту идею.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Long, J., Shelhamer, E., & Darrell, T. (2015). Fully convolutional networks for semantic segmentation. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 3431–3440.
13.12 Перенос стиля
Любители фотографии, возможно, знакомы с фильтрами. Они меняют цветовой стиль фотографии, например делают пейзаж резче или кожу на портрете светлее. Однако фильтр обычно меняет лишь один аспект изображения. Чтобы получить желаемый стиль, может понадобиться перебрать множество различных комбинаций. Эта работа не менее сложна, чем настройка гиперпараметров модели.
В этом разделе мы покажем, как с помощью свёрточных нейронных сетей автоматически применить стиль одного изображения к другому, то есть выполнить перенос стиля (style transfer) (Gatys et al., 2016). Здесь нужны два входных изображения: содержимое (content image) и стиль (style image). Мы будем использовать нейронную сеть, чтобы изменить изображение содержимого и приблизить его по стилю к изображению стиля. Например, изображение содержимого на рис. 13.12.1 — это пейзаж, который автор книги сфотографировал в национальном парке Рейнир на окраине Сиэтла, а изображение стиля — картина с осенним дубом. Итоговое синтезированное изображение применяет мазки кисти из картины стиля, делая цвета ярче, и при этом сохраняет форму объектов из изображения содержимого.
Рис. 13.12.1. Входные изображения содержимого и стиля и синтезированное изображение после переноса стиля
13.12.1 Метод
На простом примере рис. 13.12.2 поясняет метод переноса стиля на основе свёрточной нейронной сети. Сначала мы инициализируем синтезированное изображение, например как копию изображения содержимого. Синтезированное изображение — единственная переменная, которую нужно обновлять в ходе переноса стиля, то есть это параметр модели, который итеративно обновляется в процессе переноса. Затем мы выбираем предобученную свёрточную нейронную сеть, которая извлекает признаки изображения, и её параметры в ходе обучения не обновляются. Эта глубокая свёрточная сеть постепенно извлекает признаки изображения через несколько слоёв, и мы можем выбрать выходы некоторых слоёв как признаки содержимого или признаки стиля. В примере на рис. 13.12.2 предобученная сеть содержит три свёрточных слоя: второй слой выдаёт признаки содержимого, а первый и третий — признаки стиля.
Рис. 13.12.2. Перенос стиля на основе свёрточной нейронной сети. Сплошные стрелки и пунктирные стрелки обозначают прямое и обратное распространение соответственно
Далее прямым распространением (направление сплошных стрелок) мы вычисляем функцию потерь переноса стиля, а обратным распространением (направление пунктирных стрелок) итеративно обновляем параметры модели, то есть само синтезированное изображение. Обычно функция потерь переноса стиля состоит из трёх частей:
- потеря содержимого приближает синтезированное изображение к изображению содержимого по признакам содержимого;
- потеря стиля приближает синтезированное изображение к изображению стиля по признакам стиля;
- потеря полной вариации помогает уменьшить шум на синтезированном изображении.
Когда обучение закончено, мы выводим параметры модели переноса стиля — то есть итоговое синтезированное изображение.
Далее в коде мы подробнее разберём технические детали переноса стиля.
13.12.2 Чтение изображений содержимого и стиля
Сначала прочитаем изображения содержимого и стиля. По подписям осей на выведенных изображениях видно, что их размеры различаются.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import autograd, gluon, image, init, np, npx
from mxnet.gluon import nn
npx.set_np()
d2l.set_figsize()
content_img = image.imread('../img/rainier.jpg')
d2l.plt.imshow(content_img.asnumpy());
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
d2l.set_figsize()
content_img = d2l.Image.open('../img/rainier.jpg')
d2l.plt.imshow(content_img);
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import paddle
import paddle.vision as paddlevision
import paddle.nn as nn
d2l.set_figsize()
content_img = d2l.Image.open('../img/rainier.jpg')
d2l.plt.imshow(content_img);
MXNet:
style_img = image.imread('../img/autumn-oak.jpg')
d2l.plt.imshow(style_img.asnumpy());
PyTorch, PaddlePaddle:
style_img = d2l.Image.open('../img/autumn-oak.jpg')
d2l.plt.imshow(style_img);
13.12.3 Предобработка и постобработка
Определим функции предобработки и постобработки изображений. Функция предобработки preprocess стандартизирует входное изображение по каждому из трёх каналов RGB и приводит результат к формату входа, который принимает свёрточная нейронная сеть. Функция постобработки postprocess возвращает значения пикселей выходного изображения к значениям до стандартизации. Поскольку функция вывода изображения требует, чтобы значения пикселей были в диапазоне от 0 до 1, значения меньше 0 и больше 1 мы заменяем на 0 и 1 соответственно.
MXNet:
rgb_mean = np.array([0.485, 0.456, 0.406])
rgb_std = np.array([0.229, 0.224, 0.225])
def preprocess(img, image_shape):
img = image.imresize(img, *image_shape)
img = (img.astype('float32') / 255 - rgb_mean) / rgb_std
return np.expand_dims(img.transpose(2, 0, 1), axis=0)
def postprocess(img):
img = img[0].as_in_ctx(rgb_std.ctx)
return (img.transpose(1, 2, 0) * rgb_std + rgb_mean).clip(0, 1)
PyTorch:
rgb_mean = torch.tensor([0.485, 0.456, 0.406])
rgb_std = torch.tensor([0.229, 0.224, 0.225])
def preprocess(img, image_shape):
transforms = torchvision.transforms.Compose([
torchvision.transforms.Resize(image_shape),
torchvision.transforms.ToTensor(),
torchvision.transforms.Normalize(mean=rgb_mean, std=rgb_std)])
return transforms(img).unsqueeze(0)
def postprocess(img):
img = img[0].to(rgb_std.device)
img = torch.clamp(img.permute(1, 2, 0) * rgb_std + rgb_mean, 0, 1)
return torchvision.transforms.ToPILImage()(img.permute(2, 0, 1))
PaddlePaddle:
rgb_mean = paddle.to_tensor([0.485, 0.456, 0.406])
rgb_std = paddle.to_tensor([0.229, 0.224, 0.225])
def preprocess(img, image_shape):
transforms = paddlevision.transforms.Compose([
paddlevision.transforms.Resize(image_shape),
paddlevision.transforms.ToTensor(),
paddlevision.transforms.Normalize(mean=rgb_mean, std=rgb_std)])
return transforms(img).unsqueeze(0)
def postprocess(img):
img = img[0]
img = paddle.clip(img.transpose((1, 2, 0)) * rgb_std + rgb_mean, 0, 1)
return img
13.12.4 Извлечение признаков изображения
Для извлечения признаков изображения содержимого и стиля используем VGG-19, предобученную на наборе ImageNet (Gatys et al., 2016).
MXNet:
pretrained_net = gluon.model_zoo.vision.vgg19(pretrained=True)
PyTorch:
pretrained_net = torchvision.models.vgg19(pretrained=True)
PaddlePaddle:
pretrained_net = paddlevision.models.vgg19(pretrained=True)
Чтобы извлечь признаки содержимого и стиля изображения, можно взять выходы некоторых слоёв сети VGG. Вообще говоря, чем ближе слой к входу, тем легче извлечь детали изображения; и наоборот, чем ближе слой к выходу, тем легче извлечь глобальную информацию. Чтобы синтезированное изображение не слишком сохраняло детали изображения содержимого, для признаков содержимого мы выбираем слой, который находится ближе к выходу VGG, — слой содержимого. Для согласования локальных и глобальных стилей мы также берём выходы разных слоёв VGG. Эти слои называются слоями стиля. Как описано в разделе 7.2, сеть VGG использует 5 блоков свёрток. В эксперименте мы выбираем в качестве слоя содержимого последний свёрточный слой четвёртого блока, а в качестве слоёв стиля — первый свёрточный слой каждого блока. Индексы этих слоёв можно узнать, выведя экземпляр pretrained_net.
style_layers, content_layers = [0, 5, 10, 19, 28], [25]
Чтобы извлекать признаки с помощью слоёв VGG, нужны все слои от входа до ближайшего к выходу слоя содержимого или стиля. Ниже мы строим новую сеть net, которая содержит только нужные слои VGG.
MXNet:
net = nn.Sequential()
for i in range(max(content_layers + style_layers) + 1):
net.add(pretrained_net.features[i])
PyTorch, PaddlePaddle:
net = nn.Sequential(*[pretrained_net.features[i] for i in
range(max(content_layers + style_layers) + 1)])
Для входа X простой вызов прямого распространения net(X) даёт только выход последнего слоя. Поскольку нам нужны выходы промежуточных слоёв, здесь мы вычисляем слой за слоем и сохраняем выходы слоёв содержимого и стиля.
def extract_features(X, content_layers, style_layers):
contents = []
styles = []
for i in range(len(net)):
X = net[i](X)
if i in style_layers:
styles.append(X)
if i in content_layers:
contents.append(X)
return contents, styles
Ниже определены две функции: функция get_contents извлекает признаки содержимого из изображения содержимого, а функция get_styles — признаки стиля из изображения стиля. Поскольку в процессе обучения параметры предобученной VGG менять не нужно, признаки содержимого и стиля можно извлечь до начала обучения. Поскольку синтезированное изображение — параметр модели, которую нужно обновлять в ходе переноса, признаки содержимого и стиля синтезированного изображения мы можем извлекать только во время обучения, вызывая функцию extract_features.
MXNet:
def get_contents(image_shape, device):
content_X = preprocess(content_img, image_shape).copyto(device)
contents_Y, _ = extract_features(content_X, content_layers, style_layers)
return content_X, contents_Y
def get_styles(image_shape, device):
style_X = preprocess(style_img, image_shape).copyto(device)
_, styles_Y = extract_features(style_X, content_layers, style_layers)
return style_X, styles_Y
PyTorch:
def get_contents(image_shape, device):
content_X = preprocess(content_img, image_shape).to(device)
contents_Y, _ = extract_features(content_X, content_layers, style_layers)
return content_X, contents_Y
def get_styles(image_shape, device):
style_X = preprocess(style_img, image_shape).to(device)
_, styles_Y = extract_features(style_X, content_layers, style_layers)
return style_X, styles_Y
PaddlePaddle:
def get_contents(image_shape):
content_X = preprocess(content_img, image_shape)
contents_Y, _ = extract_features(content_X, content_layers, style_layers)
return content_X, contents_Y
def get_styles(image_shape):
style_X = preprocess(style_img, image_shape)
_, styles_Y = extract_features(style_X, content_layers, style_layers)
return style_X, styles_Y
13.12.5 Определение функции потерь
Теперь опишем функцию потерь переноса стиля. Она состоит из трёх частей: потери содержимого, потери стиля и потери полной вариации.
13.12.5.1 Потеря содержимого
Как и функция потерь в линейной регрессии, потеря содержимого измеряет различие между синтезированным изображением и изображением содержимого в признаках содержимого с помощью функции квадратичной ошибки. Оба аргумента этой функции — выходы слоя содержимого, которые вычисляет функция extract_features.
MXNet:
def content_loss(Y_hat, Y):
return np.square(Y_hat - Y).mean()
PyTorch:
def content_loss(Y_hat, Y):
# Отделяем целевое значение от графа, который динамически вычисляет градиенты:
# это заданное значение, а не переменная
return torch.square(Y_hat - Y.detach()).mean()
PaddlePaddle:
def content_loss(Y_hat, Y):
# Отделяем целевое значение от графа, который динамически вычисляет градиенты:
# это заданное значение, а не переменная
return paddle.square(Y_hat - Y.detach()).mean()
13.12.5.2 Потеря стиля
Потеря стиля, как и потеря содержимого, использует функцию квадратичной ошибки, чтобы измерить различие между синтезированным изображением и изображением стиля по стилю. Чтобы выразить стиль выхода слоя стиля, сначала вычислим выход слоя стиля с помощью функции extract_features. Пусть число примеров в выходе равно 1, число каналов — , высота и ширина — и . Тогда этот выход можно преобразовать в матрицу с строками и столбцами. Эту матрицу можно рассматривать как составленную из векторов длины . Вектор представляет признаки стиля в канале .
В матрице Грама элемент в строке и столбце — это скалярное произведение векторов и . Он отражает корреляцию признаков стиля в каналах и . Именно такой матрицей Грама мы выражаем стиль выхода слоя стиля. Заметим, что при большом элементы матрицы Грама могут принимать большие значения. Кроме того, матрица Грама имеет размер , где — число каналов. Чтобы величина потери стиля не зависела от масштаба этих значений, функция gram ниже делит матрицу Грама на число её элементов, то есть на .
def gram(X):
num_channels, n = X.shape[1], d2l.size(X) // X.shape[1]
X = d2l.reshape(X, (num_channels, n))
return d2l.matmul(X, X.T) / (num_channels * n)
Естественно, два аргумента функции квадратичной ошибки для потери стиля — это матрицы Грама, построенные по выходам слоёв стиля для синтезированного изображения и изображения стиля. Здесь предполагается, что матрица Грама gram_Y для изображения стиля вычислена заранее.
MXNet:
def style_loss(Y_hat, gram_Y):
return np.square(gram(Y_hat) - gram_Y).mean()
PyTorch:
def style_loss(Y_hat, gram_Y):
return torch.square(gram(Y_hat) - gram_Y.detach()).mean()
PaddlePaddle:
def style_loss(Y_hat, gram_Y):
return paddle.square(gram(Y_hat) - gram_Y.detach()).mean()
13.12.5.3 Потеря полной вариации
Иногда в синтезированном изображении остаётся много высокочастотного шума, то есть особенно ярких или особенно тёмных пикселей. Распространённый способ подавить шум — шумоподавление полной вариацией (total variation denoising). Пусть — значение пикселя с координатами . Уменьшение потери полной вариации
стремится сделать значения соседних пикселей как можно более близкими.
def tv_loss(Y_hat):
return 0.5 * (d2l.abs(Y_hat[:, :, 1:, :] - Y_hat[:, :, :-1, :]).mean() +
d2l.abs(Y_hat[:, :, :, 1:] - Y_hat[:, :, :, :-1]).mean())
13.12.5.4 Функция потерь
Функция потерь переноса стиля — это взвешенная сумма потери содержимого, потери стиля и потери полной вариации. Регулируя эти весовые гиперпараметры, мы можем задать относительную важность сохранения содержимого, переноса стиля и шумоподавления для синтезированного изображения.
content_weight, style_weight, tv_weight = 1, 1e3, 10
def compute_loss(X, contents_Y_hat, styles_Y_hat, contents_Y, styles_Y_gram):
# Вычисляем потерю содержимого, потерю стиля и потерю полной вариации по отдельности
contents_l = [content_loss(Y_hat, Y) * content_weight for Y_hat, Y in zip(
contents_Y_hat, contents_Y)]
styles_l = [style_loss(Y_hat, Y) * style_weight for Y_hat, Y in zip(
styles_Y_hat, styles_Y_gram)]
tv_l = tv_loss(X) * tv_weight
# Суммируем все потери
l = sum(10 * styles_l + contents_l + [tv_l])
return contents_l, styles_l, tv_l, l
13.12.6 Инициализация синтезированного изображения
При переносе стиля синтезированное изображение — единственная переменная, которую обновляют в ходе обучения. Поэтому мы можем определить простую модель SynthesizedImage и рассматривать синтезированное изображение как параметр модели. Прямое распространение модели просто возвращает параметр модели.
MXNet:
class SynthesizedImage(nn.Block):
def __init__(self, img_shape, **kwargs):
super(SynthesizedImage, self).__init__(**kwargs)
self.weight = self.params.get('weight', shape=img_shape)
def forward(self):
return self.weight.data()
PyTorch:
class SynthesizedImage(nn.Module):
def __init__(self, img_shape, **kwargs):
super(SynthesizedImage, self).__init__(**kwargs)
self.weight = nn.Parameter(torch.rand(*img_shape))
def forward(self):
return self.weight
PaddlePaddle:
class SynthesizedImage(nn.Layer):
def __init__(self, img_shape, **kwargs):
super(SynthesizedImage, self).__init__(**kwargs)
self.weight = paddle.create_parameter(shape=img_shape,
dtype="float32")
def forward(self):
return self.weight
Далее определим функцию get_inits. Она создаёт экземпляр модели синтезированного изображения и инициализирует его изображением X. Матрицы Грама styles_Y_gram для изображения стиля на всех слоях стиля вычисляются заранее, до начала обучения.
MXNet:
def get_inits(X, device, lr, styles_Y):
gen_img = SynthesizedImage(X.shape)
gen_img.initialize(init.Constant(X), ctx=device, force_reinit=True)
trainer = gluon.Trainer(gen_img.collect_params(), 'adam',
{'learning_rate': lr})
styles_Y_gram = [gram(Y) for Y in styles_Y]
return gen_img(), styles_Y_gram, trainer
PyTorch:
def get_inits(X, device, lr, styles_Y):
gen_img = SynthesizedImage(X.shape).to(device)
gen_img.weight.data.copy_(X.data)
trainer = torch.optim.Adam(gen_img.parameters(), lr=lr)
styles_Y_gram = [gram(Y) for Y in styles_Y]
return gen_img(), styles_Y_gram, trainer
PaddlePaddle:
def get_inits(X, lr, styles_Y):
gen_img = SynthesizedImage(X.shape)
gen_img.weight.set_value(X)
trainer = paddle.optimizer.Adam(parameters = gen_img.parameters(), learning_rate=lr)
styles_Y_gram = [gram(Y) for Y in styles_Y]
return gen_img(), styles_Y_gram, trainer
13.12.7 Обучение модели
Во время обучения при переносе стиля мы многократно извлекаем признаки содержимого и стиля синтезированного изображения и вычисляем функцию потерь. Ниже определён цикл обучения.
MXNet:
def train(X, contents_Y, styles_Y, device, lr, num_epochs, lr_decay_epoch):
X, styles_Y_gram, trainer = get_inits(X, device, lr, styles_Y)
animator = d2l.Animator(xlabel='epoch', ylabel='loss',
xlim=[10, num_epochs], ylim=[0, 20],
legend=['content', 'style', 'TV'],
ncols=2, figsize=(7, 2.5))
for epoch in range(num_epochs):
with autograd.record():
contents_Y_hat, styles_Y_hat = extract_features(
X, content_layers, style_layers)
contents_l, styles_l, tv_l, l = compute_loss(
X, contents_Y_hat, styles_Y_hat, contents_Y, styles_Y_gram)
l.backward()
trainer.step(1)
if (epoch + 1) % lr_decay_epoch == 0:
trainer.set_learning_rate(trainer.learning_rate * 0.8)
if (epoch + 1) % 10 == 0:
animator.axes[1].imshow(postprocess(X).asnumpy())
animator.add(epoch + 1, [float(sum(contents_l)),
float(sum(styles_l)), float(tv_l)])
return X
PyTorch:
def train(X, contents_Y, styles_Y, device, lr, num_epochs, lr_decay_epoch):
X, styles_Y_gram, trainer = get_inits(X, device, lr, styles_Y)
scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_decay_epoch, 0.8)
animator = d2l.Animator(xlabel='epoch', ylabel='loss',
xlim=[10, num_epochs],
legend=['content', 'style', 'TV'],
ncols=2, figsize=(7, 2.5))
for epoch in range(num_epochs):
trainer.zero_grad()
contents_Y_hat, styles_Y_hat = extract_features(
X, content_layers, style_layers)
contents_l, styles_l, tv_l, l = compute_loss(
X, contents_Y_hat, styles_Y_hat, contents_Y, styles_Y_gram)
l.backward()
trainer.step()
scheduler.step()
if (epoch + 1) % 10 == 0:
animator.axes[1].imshow(postprocess(X))
animator.add(epoch + 1, [float(sum(contents_l)),
float(sum(styles_l)), float(tv_l)])
return X
PaddlePaddle:
def train(X, contents_Y, styles_Y, lr, num_epochs, step_size):
scheduler = paddle.optimizer.lr.StepDecay(learning_rate=lr, gamma=0.8, step_size=step_size)
X, styles_Y_gram, trainer = get_inits(X, scheduler, styles_Y)
animator = d2l.Animator(xlabel='epoch', ylabel='loss',
xlim=[10, num_epochs],
legend=['content', 'style', 'TV'],
ncols=2, figsize=(7, 2.5))
for epoch in range(num_epochs):
trainer.clear_grad()
contents_Y_hat, styles_Y_hat = extract_features(
X, content_layers, style_layers)
contents_l, styles_l, tv_l, l = compute_loss(
X, contents_Y_hat, styles_Y_hat, contents_Y, styles_Y_gram)
l.backward()
trainer.step()
scheduler.step()
if (epoch + 1) % 10 == 0:
animator.axes[1].imshow(postprocess(X))
animator.add(epoch + 1, [float(sum(contents_l)),
float(sum(styles_l)), float(tv_l)])
return X
Теперь обучим модель: сначала приведём высоту и ширину изображений содержимого и стиля к 300 и 450 пикселям и инициализируем синтезированное изображение изображением содержимого.
MXNet:
device, image_shape = d2l.try_gpu(), (450, 300)
net.collect_params().reset_ctx(device)
content_X, contents_Y = get_contents(image_shape, device)
_, styles_Y = get_styles(image_shape, device)
output = train(content_X, contents_Y, styles_Y, device, 0.9, 500, 50)
PyTorch:
device, image_shape = d2l.try_gpu(), (300, 450)
net = net.to(device)
content_X, contents_Y = get_contents(image_shape, device)
_, styles_Y = get_styles(image_shape, device)
output = train(content_X, contents_Y, styles_Y, device, 0.3, 500, 50)
PaddlePaddle:
device, image_shape = d2l.try_gpu(),(300, 450)
content_X, contents_Y = get_contents(image_shape)
_, styles_Y = get_styles(image_shape)
output = train(content_X, contents_Y, styles_Y, 0.3, 500, 50)
Видно, что синтезированное изображение сохранило пейзаж и объекты изображения содержимого и одновременно перенесло цвета изображения стиля. Например, у синтезированного изображения есть цветовые пятна, как на изображении стиля, а некоторые из них даже имеют мелкую текстуру мазков кисти.
Резюме
- Функция потерь переноса стиля обычно состоит из трёх частей: (1) потеря содержимого приближает синтезированное изображение к изображению содержимого по признакам содержимого; (2) потеря стиля приближает синтезированное изображение к изображению стиля по признакам стиля; (3) потеря полной вариации помогает уменьшить шум на синтезированном изображении.
- Мы можем извлекать признаки изображения с помощью предобученной свёрточной нейронной сети и минимизировать функцию потерь, чтобы постепенно обновлять синтезированное изображение как параметр модели.
- Для выражения стиля выходов слоя стиля мы используем матрицы Грама.
Упражнения
- Как меняется выход при выборе других слоёв содержимого и стиля?
- Подберите весовые гиперпараметры функции потерь. Сохраняет ли результат больше содержимого или лучше подавляет шум?
- Замените в эксперименте изображения содержимого и стиля. Можно ли создать более интересные синтезированные изображения?
- Можно ли применить перенос стиля к тексту? Подсказка: см. обзорную работу (Hu et al., 2020).
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Gatys, L. A., Ecker, A. S., & Bethge, M. (2016). Image style transfer using convolutional neural networks. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2414–2423.
- Hu, Z., Lee, R. K.-W., Aggarwal, C. C., & Zhang, A. (2020). Text style transfer: A review and experimental evaluation. arXiv preprint arXiv:2010.12742.
13.13 Практика: соревнование Kaggle по классификации изображений (CIFAR-10)
В предыдущих разделах мы получали наборы изображений сразу в виде тензоров с помощью высокоуровневого API фреймворков. Однако на практике изображения обычно хранятся в виде файлов. В этом разделе мы начнём с исходных файлов изображений, а затем шаг за шагом организуем данные, прочитаем их и преобразуем в формат тензоров.
В разделе 13.1 мы проводили эксперимент с набором данных CIFAR-10, который является важным набором данных в области компьютерного зрения. В этом разделе мы применим знания из предыдущих разделов и примем участие в соревновании Kaggle по классификации изображений CIFAR-10, адрес соревнования: https://www.kaggle.com/c/cifar-10.
На рис. 13.13.1 показана страница соревнования с описанием. Чтобы отправить результаты, сначала нужно зарегистрировать аккаунт на Kaggle.
Рис. 13.13.1. Страница соревнования по классификации изображений CIFAR-10 с описанием. Данные для соревнования доступны на вкладке «Data». Скриншот страницы стороннего сайта в перевод не включён
Сначала импортируем пакеты и модули, которые нужны для соревнования.
MXNet:
import collections
from d2l import mxnet as d2l
import math
from mxnet import gluon, init, npx
from mxnet.gluon import nn
import os
import pandas as pd
import shutil
npx.set_np()
PyTorch:
import collections
from d2l import torch as d2l
import math
import torch
import torchvision
from torch import nn
import os
import pandas as pd
import shutil
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import collections
import math
import os
import pandas as pd
import shutil
import paddle
from paddle import nn
import paddle.vision as paddlevision
13.13.1 Получение и организация набора данных
Набор данных соревнования разделён на обучающий и тестовый наборы: в обучающей 50 000 изображений, в тестовой — 300 000. Из тестового набора для оценки используются 10 000 изображений, а остальные 290 000 не оцениваются и включены лишь для того, чтобы нельзя было вручную разметить тестовый набор и отправить разметку. Изображения в обоих наборах имеют формат PNG, высоту и ширину 32 пикселя и три цветовых канала (RGB). Эти изображения относятся к 10 классам: самолёт, автомобиль, птица, кошка, олень, собака, лягушка, лошадь, корабль и грузовик.
13.13.1.1 Загрузка набора данных
После входа в Kaggle можно открыть вкладку «Data» на странице соревнования CIFAR-10 (рис. 13.13.1) и нажать кнопку «Download All», чтобы загрузить набор данных. После распаковки загруженного файла в каталоге ../data и распаковки в нём архивов train.7z и test.7z весь набор данных будет доступен по следующим путям:
../data/cifar-10/train/[1-50000].png../data/cifar-10/test/[1-300000].png../data/cifar-10/trainLabels.csv../data/cifar-10/sampleSubmission.csv
Папки train и test содержат обучающие и тестовые изображения соответственно, файл trainLabels.csv содержит метки обучающих изображений, а sampleSubmission.csv — пример файла для отправки.
Чтобы было проще начать, мы подготовили небольшую версию набора: первые 1000 обучающих изображений и 5 случайных тестовых изображений. Чтобы использовать полный набор данных соревнования, нужно установить переменную demo равной False.
#@save
d2l.DATA_HUB['cifar10_tiny'] = (d2l.DATA_URL + 'kaggle_cifar10_tiny.zip',
'2068874e4b9a9f0fb07ebe0ad2b29754449ccacd')
# Если используется полный набор данных соревнования Kaggle, установите demo в False
demo = True
if demo:
data_dir = d2l.download_extract('cifar10_tiny')
else:
data_dir = '../data/cifar-10/'
13.13.1.2 Организация набора данных
Чтобы обучать и тестировать модель, нужно организовать набор данных. Сначала с помощью функции ниже прочитаем метки из CSV-файла. Она возвращает словарь, который сопоставляет имя файла без расширения с его меткой.
#@save
def read_csv_labels(fname):
"""Читает fname и возвращает словарь, отображающий имя файла в метку"""
with open(fname, 'r') as f:
# Пропускаем строку заголовка (названия столбцов)
lines = f.readlines()[1:]
tokens = [l.rstrip().split(',') for l in lines]
return dict(((name, label) for name, label in tokens))
labels = read_csv_labels(os.path.join(data_dir, 'trainLabels.csv'))
print('# обучающих примеров :', len(labels))
print('# классов :', len(set(labels.values())))
Далее определим функцию reorg_train_valid, которая выделяет проверочный набор из исходного обучающего набора. Параметр valid_ratio этой функции — отношение числа примеров проверочного набора к числу примеров исходного обучающего набора. Точнее, пусть равно числу изображений в наименее представленном классе, а — это отношение. Тогда для каждого класса в проверочный набор попадает изображений. Возьмём valid_ratio=0.1: поскольку исходный обучающий набор содержит 50 000 изображений, в каталоге train_valid_test/train будет 45 000 изображений для обучения, а оставшиеся 5 000 изображений станут проверочным набором в каталоге train_valid_test/valid. После организации данных изображения одного класса будут лежать в одной папке.
#@save
def copyfile(filename, target_dir):
"""Копирует файл в целевой каталог"""
os.makedirs(target_dir, exist_ok=True)
shutil.copy(filename, target_dir)
#@save
def reorg_train_valid(data_dir, labels, valid_ratio):
"""Выделяет проверочный набор из исходного обучающего набора"""
# Число примеров в наименее представленном классе обучающего набора
n = collections.Counter(labels.values()).most_common()[-1][1]
# Число примеров каждого класса в проверочном наборе
n_valid_per_label = max(1, math.floor(n * valid_ratio))
label_count = {}
for train_file in os.listdir(os.path.join(data_dir, 'train')):
label = labels[train_file.split('.')[0]]
fname = os.path.join(data_dir, 'train', train_file)
copyfile(fname, os.path.join(data_dir, 'train_valid_test',
'train_valid', label))
if label not in label_count or label_count[label] < n_valid_per_label:
copyfile(fname, os.path.join(data_dir, 'train_valid_test',
'valid', label))
label_count[label] = label_count.get(label, 0) + 1
else:
copyfile(fname, os.path.join(data_dir, 'train_valid_test',
'train', label))
return n_valid_per_label
Функция reorg_test ниже организует тестовый набор на этапе предсказания так, чтобы его было удобно читать.
#@save
def reorg_test(data_dir):
"""Организует тестовый набор на этапе предсказания так, чтобы его было удобно читать"""
for test_file in os.listdir(os.path.join(data_dir, 'test')):
copyfile(os.path.join(data_dir, 'test', test_file),
os.path.join(data_dir, 'train_valid_test', 'test',
'unknown'))
Наконец, используем функцию, которая вызывает определённые выше функции read_csv_labels, reorg_train_valid и reorg_test.
def reorg_cifar10_data(data_dir, valid_ratio):
labels = read_csv_labels(os.path.join(data_dir, 'trainLabels.csv'))
reorg_train_valid(data_dir, labels, valid_ratio)
reorg_test(data_dir)
Здесь для примера мы задаём размер батча 32. При реальном обучении и тестировании следует использовать полный набор данных соревнования и задать batch_size побольше, например 128. Мы будем использовать 10% обучающих примеров как проверочный набор для подбора гиперпараметров.
batch_size = 32 if demo else 128
valid_ratio = 0.1
reorg_cifar10_data(data_dir, valid_ratio)
13.13.2 Аугментация изображений
Чтобы бороться с переобучением, используем аугментацию изображений. Например, в обучении мы можем случайно отражать изображения по горизонтали. Кроме того, для трёх RGB-каналов цветного изображения можно выполнить стандартизацию. Ниже перечислены некоторые из операций, которые можно настраивать.
MXNet:
transform_train = gluon.data.vision.transforms.Compose([
# Увеличиваем изображение по высоте и ширине до квадрата 40 пикселей
gluon.data.vision.transforms.Resize(40),
# Случайно вырезаем квадратное изображение высотой и шириной 40 пикселей:
# площадь вырезанного квадрата составляет от 0.64 до 1 площади исходного изображения,
# затем масштабируем его до квадрата высотой и шириной 32 пикселя
gluon.data.vision.transforms.RandomResizedCrop(32, scale=(0.64, 1.0),
ratio=(1.0, 1.0)),
gluon.data.vision.transforms.RandomFlipLeftRight(),
gluon.data.vision.transforms.ToTensor(),
# Стандартизируем каждый канал изображения
gluon.data.vision.transforms.Normalize([0.4914, 0.4822, 0.4465],
[0.2023, 0.1994, 0.2010])])
PyTorch:
transform_train = torchvision.transforms.Compose([
# Увеличиваем изображение по высоте и ширине до квадрата 40 пикселей
torchvision.transforms.Resize(40),
# Случайно вырезаем квадратное изображение высотой и шириной 40 пикселей:
# площадь вырезанного квадрата составляет от 0.64 до 1 площади исходного изображения,
# затем масштабируем его до квадрата высотой и шириной 32 пикселя
torchvision.transforms.RandomResizedCrop(32, scale=(0.64, 1.0),
ratio=(1.0, 1.0)),
torchvision.transforms.RandomHorizontalFlip(),
torchvision.transforms.ToTensor(),
# Стандартизируем каждый канал изображения
torchvision.transforms.Normalize([0.4914, 0.4822, 0.4465],
[0.2023, 0.1994, 0.2010])])
PaddlePaddle:
transform_train = paddlevision.transforms.Compose([
# Увеличиваем изображение по высоте и ширине до квадрата 40 пикселей
paddlevision.transforms.Resize(40),
# Случайно вырезаем квадратное изображение высотой и шириной 40 пикселей:
# площадь вырезанного квадрата составляет от 0.64 до 1 площади исходного изображения,
# затем масштабируем его до квадрата высотой и шириной 32 пикселя
paddlevision.transforms.RandomResizedCrop(32, scale=(0.64, 1.0),
ratio=(1.0, 1.0)),
paddlevision.transforms.RandomHorizontalFlip(),
paddlevision.transforms.ToTensor(),
# Стандартизируем каждый канал изображения
paddlevision.transforms.Normalize([0.4914, 0.4822, 0.4465],
[0.2023, 0.1994, 0.2010])])
На этапе тестирования мы только стандартизируем изображения, чтобы исключить случайность в оценке результатов.
MXNet:
transform_test = gluon.data.vision.transforms.Compose([
gluon.data.vision.transforms.ToTensor(),
gluon.data.vision.transforms.Normalize([0.4914, 0.4822, 0.4465],
[0.2023, 0.1994, 0.2010])])
PyTorch:
transform_test = torchvision.transforms.Compose([
torchvision.transforms.ToTensor(),
torchvision.transforms.Normalize([0.4914, 0.4822, 0.4465],
[0.2023, 0.1994, 0.2010])])
PaddlePaddle:
transform_test = paddlevision.transforms.Compose([
paddlevision.transforms.ToTensor(),
paddlevision.transforms.Normalize([0.4914, 0.4822, 0.4465],
[0.2023, 0.1994, 0.2010])])
13.13.3 Чтение набора данных
Далее прочитаем набор данных из исходных изображений: каждый пример состоит из изображения и метки.
MXNet:
train_ds, valid_ds, train_valid_ds, test_ds = [
gluon.data.vision.ImageFolderDataset(
os.path.join(data_dir, 'train_valid_test', folder))
for folder in ['train', 'valid', 'train_valid', 'test']]
PyTorch:
train_ds, train_valid_ds = [torchvision.datasets.ImageFolder(
os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_train) for folder in ['train', 'train_valid']]
valid_ds, test_ds = [torchvision.datasets.ImageFolder(
os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_test) for folder in ['valid', 'test']]
PaddlePaddle:
train_ds, train_valid_ds = [paddlevision.datasets.DatasetFolder(
os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_train) for folder in ['train', 'train_valid']]
valid_ds, test_ds = [paddlevision.datasets.DatasetFolder(
os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_test) for folder in ['valid', 'test']]
На этапе обучения нужно указать все описанные выше операции аугментации. Когда проверочный набор используется для оценки модели при подборе гиперпараметров, случайность аугментации не должна вноситься. Перед окончательным предсказанием мы обучаем модель на объединении обучающих и проверочных наборов, чтобы использовать все размеченные данные.
MXNet:
train_iter, train_valid_iter = [gluon.data.DataLoader(
dataset.transform_first(transform_train), batch_size, shuffle=True,
last_batch='discard') for dataset in (train_ds, train_valid_ds)]
valid_iter = gluon.data.DataLoader(
valid_ds.transform_first(transform_test), batch_size, shuffle=False,
last_batch='discard')
test_iter = gluon.data.DataLoader(
test_ds.transform_first(transform_test), batch_size, shuffle=False,
last_batch='keep')
PyTorch:
train_iter, train_valid_iter = [torch.utils.data.DataLoader(
dataset, batch_size, shuffle=True, drop_last=True)
for dataset in (train_ds, train_valid_ds)]
valid_iter = torch.utils.data.DataLoader(valid_ds, batch_size, shuffle=False,
drop_last=True)
test_iter = torch.utils.data.DataLoader(test_ds, batch_size, shuffle=False,
drop_last=False)
PaddlePaddle:
train_iter, train_valid_iter = [paddle.io.DataLoader(
dataset, batch_size=batch_size, shuffle=True, drop_last=True)
for dataset in (train_ds, train_valid_ds)]
valid_iter = paddle.io.DataLoader(valid_ds, batch_size=batch_size, shuffle=False,
drop_last=True)
test_iter = paddle.io.DataLoader(test_ds, batch_size=batch_size, shuffle=False,
drop_last=False)
13.13.4 Определение модели
MXNet: Здесь остаточные блоки строятся на основе класса HybridBlock, что немного отличается от реализации из раздела 7.6, но повышает вычислительную эффективность.
class Residual(nn.HybridBlock):
def __init__(self, num_channels, use_1x1conv=False, strides=1, **kwargs):
super(Residual, self).__init__(**kwargs)
self.conv1 = nn.Conv2D(num_channels, kernel_size=3, padding=1,
strides=strides)
self.conv2 = nn.Conv2D(num_channels, kernel_size=3, padding=1)
if use_1x1conv:
self.conv3 = nn.Conv2D(num_channels, kernel_size=1,
strides=strides)
else:
self.conv3 = None
self.bn1 = nn.BatchNorm()
self.bn2 = nn.BatchNorm()
def hybrid_forward(self, F, X):
Y = F.npx.relu(self.bn1(self.conv1(X)))
Y = self.bn2(self.conv2(Y))
if self.conv3:
X = self.conv3(X)
return F.npx.relu(Y + X)
MXNet: Далее определим модель ResNet-18.
def resnet18(num_classes):
net = nn.HybridSequential()
net.add(nn.Conv2D(64, kernel_size=3, strides=1, padding=1),
nn.BatchNorm(), nn.Activation('relu'))
def resnet_block(num_channels, num_residuals, first_block=False):
blk = nn.HybridSequential()
for i in range(num_residuals):
if i == 0 and not first_block:
blk.add(Residual(num_channels, use_1x1conv=True, strides=2))
else:
blk.add(Residual(num_channels))
return blk
net.add(resnet_block(64, 2, first_block=True),
resnet_block(128, 2),
resnet_block(256, 2),
resnet_block(512, 2))
net.add(nn.GlobalAvgPool2D(), nn.Dense(num_classes))
return net
MXNet: Перед началом обучения используем инициализацию Xavier, описанную в разделе 4.8.
def get_net(devices):
num_classes = 10
net = resnet18(num_classes)
net.initialize(ctx=devices, init=init.Xavier())
return net
loss = gluon.loss.SoftmaxCrossEntropyLoss()
PyTorch: Мы определяем модель ResNet-18, описанную в разделе 7.6.
def get_net():
num_classes = 10
net = d2l.resnet18(num_classes, 3)
return net
loss = nn.CrossEntropyLoss(reduction="none")
PaddlePaddle: Мы определяем модель ResNet-18, описанную в разделе 7.6.
def get_net():
num_classes = 10
net = d2l.resnet18(num_classes, 3)
return net
loss = nn.CrossEntropyLoss(reduction="none")
13.13.5 Определение функции обучения
Мы будем выбирать модель и подбирать гиперпараметры по её качеству на проверочном наборе. Ниже определена функция обучения модели train.
MXNet:
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay):
trainer = gluon.Trainer(net.collect_params(), 'sgd',
{'learning_rate': lr, 'momentum': 0.9, 'wd': wd})
num_batches, timer = len(train_iter), d2l.Timer()
legend = ['потери (обучение)', 'точность (обучение)']
if valid_iter is not None:
legend.append('точность (валидация)')
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=legend)
for epoch in range(num_epochs):
metric = d2l.Accumulator(3)
if epoch > 0 and epoch % lr_period == 0:
trainer.set_learning_rate(trainer.learning_rate * lr_decay)
for i, (features, labels) in enumerate(train_iter):
timer.start()
l, acc = d2l.train_batch_ch13(
net, features, labels.astype('float32'), loss, trainer,
devices, d2l.split_batch)
metric.add(l, acc, labels.shape[0])
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[2], metric[1] / metric[2],
None))
if valid_iter is not None:
valid_acc = d2l.evaluate_accuracy_gpus(net, valid_iter,
d2l.split_batch)
animator.add(epoch + 1, (None, None, valid_acc))
measures = (f'потери (обучение) {metric[0] / metric[2]:.3f}, '
f'точность (обучение) {metric[1] / metric[2]:.3f}')
if valid_iter is not None:
measures += f', точность (валидация) {valid_acc:.3f}'
print(measures + f'\n{metric[2] * num_epochs / timer.sum():.1f}'
f' примеров/с на {str(devices)}')
PyTorch:
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay):
trainer = torch.optim.SGD(net.parameters(), lr=lr, momentum=0.9,
weight_decay=wd)
scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_period, lr_decay)
num_batches, timer = len(train_iter), d2l.Timer()
legend = ['потери (обучение)', 'точность (обучение)']
if valid_iter is not None:
legend.append('точность (валидация)')
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=legend)
net = nn.DataParallel(net, device_ids=devices).to(devices[0])
for epoch in range(num_epochs):
net.train()
metric = d2l.Accumulator(3)
for i, (features, labels) in enumerate(train_iter):
timer.start()
l, acc = d2l.train_batch_ch13(net, features, labels,
loss, trainer, devices)
metric.add(l, acc, labels.shape[0])
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[2], metric[1] / metric[2],
None))
if valid_iter is not None:
valid_acc = d2l.evaluate_accuracy_gpu(net, valid_iter)
animator.add(epoch + 1, (None, None, valid_acc))
scheduler.step()
measures = (f'потери (обучение) {metric[0] / metric[2]:.3f}, '
f'точность (обучение) {metric[1] / metric[2]:.3f}')
if valid_iter is not None:
measures += f', точность (валидация) {valid_acc:.3f}'
print(measures + f'\n{metric[2] * num_epochs / timer.sum():.1f}'
f' примеров/с на {str(devices)}')
PaddlePaddle:
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay):
scheduler = paddle.optimizer.lr.StepDecay(lr, lr_period, lr_decay)
trainer = paddle.optimizer.Momentum(learning_rate=scheduler, momentum=0.9, parameters=net.parameters(),
weight_decay=wd)
num_batches, timer = len(train_iter), d2l.Timer()
legend = ['потери (обучение)', 'точность (обучение)']
if valid_iter is not None:
legend.append('точность (валидация)')
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=legend)
net = paddle.DataParallel(net)
for epoch in range(num_epochs):
net.train()
metric = d2l.Accumulator(3)
for i, (features, labels) in enumerate(train_iter):
timer.start()
l, acc = d2l.train_batch_ch13(net, features, labels,
loss, trainer, devices)
metric.add(l, acc, labels.shape[0])
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[2], metric[1] / metric[2],
None))
if valid_iter is not None:
valid_acc = d2l.evaluate_accuracy_gpu(net, valid_iter)
animator.add(epoch + 1, (None, None, valid_acc))
scheduler.step()
measures = (f'потери (обучение) {metric[0] / metric[2]:.3f}, '
f'точность (обучение) {metric[1] / metric[2]:.3f}')
if valid_iter is not None:
measures += f', точность (валидация) {valid_acc:.3f}'
print(measures + f'\n{metric[2] * num_epochs / timer.sum():.1f}'
f' примеров/с на {str(devices)}')
13.13.6 Обучение и проверка модели
Теперь можно обучить и проверить модель; все перечисленные ниже гиперпараметры можно подбирать. Например, можно увеличить число эпох. Если lr_period и lr_decay равны 4 и 0.9, то скорость обучения оптимизатора будет умножаться на 0.9 каждые 4 эпохи. Для простоты мы обучаем модель здесь лишь 20 эпох.
MXNet:
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 20, 0.02, 5e-4
lr_period, lr_decay, net = 4, 0.9, get_net(devices)
net.hybridize()
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay)
PyTorch:
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 20, 2e-4, 5e-4
lr_period, lr_decay, net = 4, 0.9, get_net()
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay)
PaddlePaddle:
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 20, 2e-4, 5e-4
lr_period, lr_decay, net = 4, 0.9, get_net()
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay)
13.13.7 Классификация тестового набора и отправка результатов на Kaggle
Получив удовлетворительную модель с подобранными гиперпараметрами, мы переобучаем модель на всех размеченных данных (включая проверочный набор) и классифицируем тестовый набор.
MXNet:
net, preds = get_net(devices), []
net.hybridize()
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
lr_decay)
for X, _ in test_iter:
y_hat = net(X.as_in_ctx(devices[0]))
preds.extend(y_hat.argmax(axis=1).astype(int).asnumpy())
sorted_ids = list(range(1, len(test_ds) + 1))
sorted_ids.sort(key=lambda x: str(x))
df = pd.DataFrame({'id': sorted_ids, 'label': preds})
df['label'] = df['label'].apply(lambda x: train_valid_ds.synsets[x])
df.to_csv('submission.csv', index=False)
PyTorch:
net, preds = get_net(), []
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
lr_decay)
for X, _ in test_iter:
y_hat = net(X.to(devices[0]))
preds.extend(y_hat.argmax(dim=1).type(torch.int32).cpu().numpy())
sorted_ids = list(range(1, len(test_ds) + 1))
sorted_ids.sort(key=lambda x: str(x))
df = pd.DataFrame({'id': sorted_ids, 'label': preds})
df['label'] = df['label'].apply(lambda x: train_valid_ds.classes[x])
df.to_csv('submission.csv', index=False)
PaddlePaddle:
net, preds = get_net(), []
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
lr_decay)
for X, _ in test_iter:
y_hat = net(X)
preds.extend(y_hat.argmax(axis=1).astype(paddle.int32).numpy())
sorted_ids = list(range(1, len(test_ds) + 1))
sorted_ids.sort(key=lambda x: str(x))
df = pd.DataFrame({'id': sorted_ids, 'label': preds})
df['label'] = df['label'].apply(lambda x: train_valid_ds.classes[x])
df.to_csv('submission.csv', index=False)
Отправка результатов на Kaggle выполняется так же, как в разделе 4.10. Код выше создаёт файл submission.csv в формате, который требуется соревнованием Kaggle.
Резюме
- Организовав исходные файлы изображений набора данных в нужном формате, мы можем его прочитать.
MXNet:
- В соревновании по классификации изображений можно использовать свёрточные нейронные сети, аугментацию изображений и гибридное программирование.
PyTorch, PaddlePaddle:
- В соревновании по классификации изображений можно использовать свёрточные нейронные сети и аугментацию изображений.
Упражнения
- Используйте в этом соревновании Kaggle полный набор данных CIFAR-10. Задайте гиперпараметры
batch_size = 128,num_epochs = 100,lr = 0.1,lr_period = 50,lr_decay = 0.1. Какой точности и какого места в рейтинге можно добиться? Можно ли улучшить результат? - Какую точность можно получить без аугментации изображений?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
13.14 Практика: соревнование Kaggle по распознаванию пород собак (ImageNet Dogs)
В этом разделе мы решим задачу распознавания пород собак на Kaggle. Адрес соревнования: https://www.kaggle.com/c/dog-breed-identification. Страница соревнования с описанием показана на рис. 13.14.1. Чтобы отправить результаты, нужен аккаунт Kaggle.
В этом соревновании нужно распознать 120 пород собак. Этот набор данных на самом деле является подмножеством известного набора ImageNet. В отличие от изображений из набора CIFAR-10 из раздела 13.13, изображения ImageNet больше по высоте и ширине и имеют разные размеры.
Рис. 13.14.1. Страница соревнования по распознаванию пород собак. Данные соревнования доступны на вкладке «Data». Скриншот страницы стороннего сайта в перевод не включён
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, gluon, init, npx
from mxnet.gluon import nn
import os
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
import torchvision
from torch import nn
import os
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import paddle.vision as paddlevision
from paddle import nn
import os
13.14.1 Получение и организация набора данных
Наборы данных соревнования разделены на обучающий и тестовый: в них содержится соответственно 10 222 и 10 357 JPEG-изображений в цветовом пространстве RGB. В обучающем наборе 120 пород собак, среди которых лабрадор, пудель, такса, самоед, хаски, чихуахуа и йоркширский терьер.
13.14.1.1 Загрузка набора данных
После входа в Kaggle можно открыть вкладку «Data» на странице соревнования (см. рис. 13.14.1), нажать кнопку «Download All» и загрузить набор данных. После распаковки загруженного файла в каталоге ../data весь набор данных будет доступен по следующим путям:
- ../data/dog-breed-identification/labels.csv
- ../data/dog-breed-identification/sample_submission.csv
- ../data/dog-breed-identification/train
- ../data/dog-breed-identification/test
Структура, как и в наборе CIFAR-10 из раздела 13.13, такая: папки train/ и test/ содержат обучающие и тестовые изображения собак соответственно, а файл labels.csv содержит метки обучающих изображений.
Чтобы было проще начать, мы подготовили небольшую версию полного набора данных: train_valid_test_tiny.zip. Чтобы использовать полный набор данных соревнования Kaggle, нужно изменить переменную demo ниже на False.
#@save
d2l.DATA_HUB['dog_tiny'] = (d2l.DATA_URL + 'kaggle_dog_tiny.zip',
'0cb91d09b814ecdc07b50f31f8dcad3e81d6a86d')
# Если используется полный набор данных соревнования Kaggle, поменяйте значение переменной на False
demo = True
if demo:
data_dir = d2l.download_extract('dog_tiny')
else:
data_dir = os.path.join('..', 'data', 'dog-breed-identification')
13.14.1.2 Организация набора данных
Набор данных можно организовать так же, как в разделе 13.13: выделить проверочный набор из исходного обучающего набора и переместить изображения в подпапки, сгруппированные по меткам.
Функция reorg_dog_data ниже читает метки обучающих данных, выделяет проверочный набор и организует обучающий набор.
def reorg_dog_data(data_dir, valid_ratio):
labels = d2l.read_csv_labels(os.path.join(data_dir, 'labels.csv'))
d2l.reorg_train_valid(data_dir, labels, valid_ratio)
d2l.reorg_test(data_dir)
batch_size = 32 if demo else 128
valid_ratio = 0.1
reorg_dog_data(data_dir, valid_ratio)
13.14.2 Аугментация изображений
Напомним, что набор данных о породах собак — это подмножество ImageNet, а изображения в нём крупнее, чем в CIFAR-10 из раздела 13.13. Ниже мы посмотрим, как применять аугментацию к относительно большим изображениям.
MXNet:
transform_train = gluon.data.vision.transforms.Compose([
# Случайно вырезаем часть изображения площадью от 0.08 до 1 площади исходного изображения
# с отношением сторон от 3/4 до 4/3. Затем масштабируем изображение до нового размера 224x224
gluon.data.vision.transforms.RandomResizedCrop(224, scale=(0.08, 1.0),
ratio=(3.0/4.0, 4.0/3.0)),
gluon.data.vision.transforms.RandomFlipLeftRight(),
# Случайно меняем яркость, контраст и насыщенность
gluon.data.vision.transforms.RandomColorJitter(brightness=0.4,
contrast=0.4,
saturation=0.4),
# Добавляем случайный шум
gluon.data.vision.transforms.RandomLighting(0.1),
gluon.data.vision.transforms.ToTensor(),
# Стандартизируем каждый канал изображения
gluon.data.vision.transforms.Normalize([0.485, 0.456, 0.406],
[0.229, 0.224, 0.225])])
PyTorch:
transform_train = torchvision.transforms.Compose([
# Случайно вырезаем часть изображения площадью от 0.08 до 1 площади исходного изображения
# с отношением сторон от 3/4 до 4/3. Затем масштабируем изображение до нового размера 224x224
torchvision.transforms.RandomResizedCrop(224, scale=(0.08, 1.0),
ratio=(3.0/4.0, 4.0/3.0)),
torchvision.transforms.RandomHorizontalFlip(),
# Случайно меняем яркость, контраст и насыщенность
torchvision.transforms.ColorJitter(brightness=0.4,
contrast=0.4,
saturation=0.4),
# Добавляем случайный шум
torchvision.transforms.ToTensor(),
# Стандартизируем каждый канал изображения
torchvision.transforms.Normalize([0.485, 0.456, 0.406],
[0.229, 0.224, 0.225])])
PaddlePaddle:
transform_train = paddlevision.transforms.Compose([
# Случайно вырезаем часть изображения площадью от 0.08 до 1 площади исходного изображения
# с отношением сторон от 3/4 до 4/3. Затем масштабируем изображение до нового размера 224x224
paddlevision.transforms.RandomResizedCrop(224, scale=(0.08, 1.0),
ratio=(3.0/4.0, 4.0/3.0)),
paddlevision.transforms.RandomHorizontalFlip(),
# Случайно меняем яркость, контраст и насыщенность
paddlevision.transforms.ColorJitter(brightness=0.4,
contrast=0.4,
saturation=0.4),
# Добавляем случайный шум
paddlevision.transforms.ToTensor(),
# Стандартизируем каждый канал изображения
paddlevision.transforms.Normalize([0.485, 0.456, 0.406],
[0.229, 0.224, 0.225])])
На этапе тестирования мы используем только детерминированные операции предобработки.
MXNet:
transform_test = gluon.data.vision.transforms.Compose([
gluon.data.vision.transforms.Resize(256),
# Вырезаем из центра изображения область 224x224
gluon.data.vision.transforms.CenterCrop(224),
gluon.data.vision.transforms.ToTensor(),
gluon.data.vision.transforms.Normalize([0.485, 0.456, 0.406],
[0.229, 0.224, 0.225])])
PyTorch:
transform_test = torchvision.transforms.Compose([
torchvision.transforms.Resize(256),
# Вырезаем из центра изображения область 224x224
torchvision.transforms.CenterCrop(224),
torchvision.transforms.ToTensor(),
torchvision.transforms.Normalize([0.485, 0.456, 0.406],
[0.229, 0.224, 0.225])])
PaddlePaddle:
transform_test = paddlevision.transforms.Compose([
paddlevision.transforms.Resize(256),
# Вырезаем из центра изображения область 224x224
paddlevision.transforms.CenterCrop(224),
paddlevision.transforms.ToTensor(),
paddlevision.transforms.Normalize([0.485, 0.456, 0.406],
[0.229, 0.224, 0.225])])
13.14.3 Чтение набора данных
Как и в разделе 13.13, мы читаем организованный набор данных, состоящий из исходных файлов изображений.
MXNet:
train_ds, valid_ds, train_valid_ds, test_ds = [
gluon.data.vision.ImageFolderDataset(
os.path.join(data_dir, 'train_valid_test', folder))
for folder in ('train', 'valid', 'train_valid', 'test')]
PyTorch:
train_ds, train_valid_ds = [torchvision.datasets.ImageFolder(
os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_train) for folder in ['train', 'train_valid']]
valid_ds, test_ds = [torchvision.datasets.ImageFolder(
os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_test) for folder in ['valid', 'test']]
PaddlePaddle:
train_ds, train_valid_ds = [paddlevision.datasets.DatasetFolder(
os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_train) for folder in ['train', 'train_valid']]
valid_ds, test_ds = [paddlevision.datasets.DatasetFolder(
os.path.join(data_dir, 'train_valid_test', folder),
transform=transform_test) for folder in ['valid', 'test']]
Создать экземпляры загрузчиков данных можно так же, как в разделе 13.13.
MXNet:
train_iter, train_valid_iter = [gluon.data.DataLoader(
dataset.transform_first(transform_train), batch_size, shuffle=True,
last_batch='discard') for dataset in (train_ds, train_valid_ds)]
valid_iter = gluon.data.DataLoader(
valid_ds.transform_first(transform_test), batch_size, shuffle=False,
last_batch='discard')
test_iter = gluon.data.DataLoader(
test_ds.transform_first(transform_test), batch_size, shuffle=False,
last_batch='keep')
PyTorch:
train_iter, train_valid_iter = [torch.utils.data.DataLoader(
dataset, batch_size, shuffle=True, drop_last=True)
for dataset in (train_ds, train_valid_ds)]
valid_iter = torch.utils.data.DataLoader(valid_ds, batch_size, shuffle=False,
drop_last=True)
test_iter = torch.utils.data.DataLoader(test_ds, batch_size, shuffle=False,
drop_last=False)
PaddlePaddle:
train_iter, train_valid_iter = [paddle.io.DataLoader(
dataset, batch_size=batch_size, shuffle=True, drop_last=True)
for dataset in (train_ds, train_valid_ds)]
valid_iter = paddle.io.DataLoader(valid_ds, batch_size=batch_size, shuffle=False,
drop_last=True)
test_iter = paddle.io.DataLoader(test_ds, batch_size=batch_size, shuffle=False,
drop_last=False)
13.14.4 Дообучение предобученной модели
Набор данных этого соревнования также является подмножеством ImageNet. Поэтому мы можем использовать методы из раздела 13.2: выбрать модель, предобученную на полном ImageNet, извлекать с её помощью признаки изображений и подавать их на небольшую пользовательскую выходную сеть. Фреймворки предоставляют высокоуровневый API с различными моделями, предобученными на ImageNet. Здесь мы выбираем предобученную модель ResNet-34 и используем повторно только признаки, которые она выдаёт перед выходным слоем. Затем исходный выходной слой мы заменяем небольшой обучаемой пользовательской выходной сетью, например из двух полносвязных слоёв. В отличие от экспериментов из раздела 13.2, предобученную модель для извлечения признаков мы не дообучаем. Это экономит время на градиентный спуск и память.
Напомним, что для нормализации полного набора ImageNet мы используем средние значения и стандартные отклонения трёх RGB-каналов. Это как раз и соответствует стандартизации, которую применяют к моделям, предобученным на ImageNet.
MXNet:
def get_net(devices):
finetune_net = gluon.model_zoo.vision.resnet34_v2(pretrained=True)
# Определяем новую выходную сеть
finetune_net.output_new = nn.HybridSequential(prefix='')
finetune_net.output_new.add(nn.Dense(256, activation='relu'))
# Всего 120 классов на выходе
finetune_net.output_new.add(nn.Dense(120))
# Инициализируем выходную сеть
finetune_net.output_new.initialize(init.Xavier(), ctx=devices)
# Распределяем параметры модели по CPU или GPU, которые используются для вычислений
finetune_net.collect_params().reset_ctx(devices)
return finetune_net
PyTorch:
def get_net(devices):
finetune_net = nn.Sequential()
finetune_net.features = torchvision.models.resnet34(pretrained=True)
# Определяем новую выходную сеть из 120 выходных классов
finetune_net.output_new = nn.Sequential(nn.Linear(1000, 256),
nn.ReLU(),
nn.Linear(256, 120))
# Распределяем параметры модели по CPU или GPU, которые используются для вычислений
finetune_net = finetune_net.to(devices[0])
# Замораживаем параметры
for param in finetune_net.features.parameters():
param.requires_grad = False
return finetune_net
PaddlePaddle:
def get_net(devices):
finetune_net = nn.Sequential()
finetune_net.features = paddlevision.models.resnet34(pretrained=True)
# Определяем новую выходную сеть из 120 выходных классов
finetune_net.output_new = nn.Sequential(nn.Linear(1000, 256),
nn.ReLU(),
nn.Linear(256, 120))
# Замораживаем параметры
for param in finetune_net.features.parameters():
param.stop_gradient = True
return finetune_net
Перед вычислением потерь сначала получим вход выходного слоя предобученной модели, то есть извлечённые признаки. Затем эти признаки подаём на вход нашей небольшой пользовательской выходной сети и вычисляем потери.
MXNet:
loss = gluon.loss.SoftmaxCrossEntropyLoss()
def evaluate_loss(data_iter, net, devices):
l_sum, n = 0.0, 0
for features, labels in data_iter:
X_shards, y_shards = d2l.split_batch(features, labels, devices)
output_features = [net.features(X_shard) for X_shard in X_shards]
outputs = [net.output_new(feature) for feature in output_features]
ls = [loss(output, y_shard).sum() for output, y_shard
in zip(outputs, y_shards)]
l_sum += sum([float(l.sum()) for l in ls])
n += labels.size
return l_sum / n
PyTorch:
loss = nn.CrossEntropyLoss(reduction='none')
def evaluate_loss(data_iter, net, devices):
l_sum, n = 0.0, 0
for features, labels in data_iter:
features, labels = features.to(devices[0]), labels.to(devices[0])
outputs = net(features)
l = loss(outputs, labels)
l_sum += l.sum()
n += labels.numel()
return (l_sum / n).to('cpu')
PaddlePaddle:
loss = nn.CrossEntropyLoss(reduction='none')
def evaluate_loss(data_iter, net, devices):
l_sum, n = 0.0, 0
for features, labels in data_iter:
outputs = net(features)
l = loss(outputs, labels)
l_sum += l.sum()
n += labels.numel()
return l_sum / n
13.14.5 Определение функции обучения
Модель мы выбираем и подбираем гиперпараметры по качеству на проверочном наборе. Функция обучения train итеративно настраивает только параметры небольшой пользовательской выходной сети.
MXNet:
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay):
# Обучаем только небольшую пользовательскую выходную сеть
trainer = gluon.Trainer(net.output_new.collect_params(), 'sgd',
{'learning_rate': lr, 'momentum': 0.9, 'wd': wd})
num_batches, timer = len(train_iter), d2l.Timer()
legend = ['потери (обучение)']
if valid_iter is not None:
legend.append('потери (валидация)')
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=legend)
for epoch in range(num_epochs):
metric = d2l.Accumulator(2)
if epoch > 0 and epoch % lr_period == 0:
trainer.set_learning_rate(trainer.learning_rate * lr_decay)
for i, (features, labels) in enumerate(train_iter):
timer.start()
X_shards, y_shards = d2l.split_batch(features, labels, devices)
output_features = [net.features(X_shard) for X_shard in X_shards]
with autograd.record():
outputs = [net.output_new(feature)
for feature in output_features]
ls = [loss(output, y_shard).sum() for output, y_shard
in zip(outputs, y_shards)]
for l in ls:
l.backward()
trainer.step(batch_size)
metric.add(sum([float(l.sum()) for l in ls]), labels.shape[0])
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[1], None))
if valid_iter is not None:
valid_loss = evaluate_loss(valid_iter, net, devices)
animator.add(epoch + 1, (None, valid_loss))
measures = f'потери (обучение) {metric[0] / metric[1]:.3f}'
if valid_iter is not None:
measures += f', потери (валидация) {valid_loss:.3f}'
print(measures + f'\n{metric[1] * num_epochs / timer.sum():.1f}'
f' примеров/с на {str(devices)}')
PyTorch:
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay):
# Обучаем только небольшую пользовательскую выходную сеть
net = nn.DataParallel(net, device_ids=devices).to(devices[0])
trainer = torch.optim.SGD((param for param in net.parameters()
if param.requires_grad), lr=lr,
momentum=0.9, weight_decay=wd)
scheduler = torch.optim.lr_scheduler.StepLR(trainer, lr_period, lr_decay)
num_batches, timer = len(train_iter), d2l.Timer()
legend = ['потери (обучение)']
if valid_iter is not None:
legend.append('потери (валидация)')
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=legend)
for epoch in range(num_epochs):
metric = d2l.Accumulator(2)
for i, (features, labels) in enumerate(train_iter):
timer.start()
features, labels = features.to(devices[0]), labels.to(devices[0])
trainer.zero_grad()
output = net(features)
l = loss(output, labels).sum()
l.backward()
trainer.step()
metric.add(l, labels.shape[0])
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[1], None))
measures = f'потери (обучение) {metric[0] / metric[1]:.3f}'
if valid_iter is not None:
valid_loss = evaluate_loss(valid_iter, net, devices)
animator.add(epoch + 1, (None, valid_loss.detach().cpu()))
scheduler.step()
if valid_iter is not None:
measures += f', потери (валидация) {valid_loss:.3f}'
print(measures + f'\n{metric[1] * num_epochs / timer.sum():.1f}'
f' примеров/с на {str(devices)}')
PaddlePaddle:
def train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay):
# Обучаем только небольшую пользовательскую выходную сеть
net = paddle.DataParallel(net)
scheduler = paddle.optimizer.lr.StepDecay(lr, lr_period, lr_decay)
trainer = paddle.optimizer.Momentum(learning_rate=scheduler,
parameters=(param for param in net.parameters() if not param.stop_gradient),
momentum=0.9,
weight_decay=wd)
num_batches, timer = len(train_iter), d2l.Timer()
legend = ['потери (обучение)']
if valid_iter is not None:
legend.append('потери (валидация)')
animator = d2l.Animator(xlabel='эпоха', xlim=[1, num_epochs],
legend=legend)
for epoch in range(num_epochs):
metric = d2l.Accumulator(2)
for i, (features, labels) in enumerate(train_iter):
timer.start()
trainer.clear_grad()
output = net(features)
l = loss(output, labels).sum()
l.backward()
trainer.step()
metric.add(l, labels.shape[0])
timer.stop()
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[1], None))
measures = f'потери (обучение) {metric[0] / metric[1]:.3f}'
if valid_iter is not None:
valid_loss = evaluate_loss(valid_iter, net, devices)
animator.add(epoch + 1, (None, valid_loss.detach()))
scheduler.step()
if valid_iter is not None:
measures += f', потери (валидация) {float(valid_loss):.3f}'
print(measures + f'\n{metric[1] * num_epochs / timer.sum():.1f}'
f' примеров/с на {str(devices)}')
13.14.6 Обучение и проверка модели
Теперь можно обучить и проверить модель; все перечисленные ниже гиперпараметры можно настраивать. Например, можно увеличить число эпох. Поскольку lr_period и lr_decay равны 2 и 0.9, скорость обучения оптимизатора умножается на 0.9 каждые 2 эпохи.
MXNet:
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 10, 5e-3, 1e-4
lr_period, lr_decay, net = 2, 0.9, get_net(devices)
net.hybridize()
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay)
PyTorch:
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 10, 1e-4, 1e-4
lr_period, lr_decay, net = 2, 0.9, get_net(devices)
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay)
PaddlePaddle:
devices, num_epochs, lr, wd = d2l.try_all_gpus(), 10, 1e-4, 1e-4
lr_period, lr_decay, net = 2, 0.9, get_net(devices)
train(net, train_iter, valid_iter, num_epochs, lr, wd, devices, lr_period,
lr_decay)
13.14.7 Классификация тестового набора и отправка результатов на Kaggle
Как и в последнем шаге раздела 13.13, все размеченные данные, включая проверочный набор, используются для обучения модели, а затем модель классифицирует тестовый набор. Классификацию выполняет обученная пользовательская выходная сеть.
MXNet:
net = get_net(devices)
net.hybridize()
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
lr_decay)
preds = []
for data, label in test_iter:
output_features = net.features(data.as_in_ctx(devices[0]))
output = npx.softmax(net.output_new(output_features))
preds.extend(output.asnumpy())
ids = sorted(os.listdir(
os.path.join(data_dir, 'train_valid_test', 'test', 'unknown')))
with open('submission.csv', 'w') as f:
f.write('id,' + ','.join(train_valid_ds.synsets) + '\n')
for i, output in zip(ids, preds):
f.write(i.split('.')[0] + ',' + ','.join(
[str(num) for num in output]) + '\n')
PyTorch:
net = get_net(devices)
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
lr_decay)
preds = []
for data, label in test_iter:
output = torch.nn.functional.softmax(net(data.to(devices[0])), dim=1)
preds.extend(output.cpu().detach().numpy())
ids = sorted(os.listdir(
os.path.join(data_dir, 'train_valid_test', 'test', 'unknown')))
with open('submission.csv', 'w') as f:
f.write('id,' + ','.join(train_valid_ds.classes) + '\n')
for i, output in zip(ids, preds):
f.write(i.split('.')[0] + ',' + ','.join(
[str(num) for num in output]) + '\n')
PaddlePaddle:
net = get_net(devices)
train(net, train_valid_iter, None, num_epochs, lr, wd, devices, lr_period,
lr_decay)
preds = []
for data, label in test_iter:
output = paddle.nn.functional.softmax(net(data), axis=0)
preds.extend(output.detach().numpy())
ids = sorted(os.listdir(
os.path.join(data_dir, 'train_valid_test', 'test', 'unknown')))
with open('submission.csv', 'w') as f:
f.write('id,' + ','.join(train_valid_ds.classes) + '\n')
for i, output in zip(ids, preds):
f.write(i.split('.')[0] + ',' + ','.join(
[str(num) for num in output]) + '\n')
Код выше создаёт файл submission.csv, который можно отправить на Kaggle так же, как описано в разделе 4.10.
Резюме
- Изображения ImageNet крупнее, чем изображения CIFAR-10, поэтому для задач на разных наборах данных может понадобиться менять операции аугментации изображений.
- Чтобы классифицировать подмножество набора ImageNet, можно использовать модель, предобученную на полном ImageNet, для извлечения признаков и обучать только небольшую пользовательскую выходную сеть. Это экономит время вычислений и память.
Упражнения
- Попробуйте использовать полный набор данных соревнования Kaggle, увеличить
batch_sizeиnum_epochs, а также задать другие гиперпараметры:lr = 0.01,lr_period = 10,lr_decay = 0.1. Какой результат вы получите? - Дают ли более глубокие предобученные модели лучший результат? Как настроить гиперпараметры? Можно ли дополнительно улучшить результат?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
14. Обработка естественного языка: предобучение
Людям необходимо общаться. Из этой базовой потребности каждый день возникает огромное количество письменных текстов. Богатые тексты в социальных сетях, мессенджерах, электронной почте, отзывах о товарах, новостных статьях, научных работах и книгах делают крайне важным научить компьютеры понимать такие тексты, чтобы помогать людям или принимать решения на основе человеческого языка.
Обработка естественного языка (natural language processing) изучает взаимодействие между компьютерами и людьми, использующими естественный язык. На практике методы обработки естественного языка очень часто применяют для обработки и анализа текстовых данных: примерами служат языковые модели из раздела 8.3 и модели машинного перевода из раздела 9.5.
Чтобы понимать текст, можно начать с изучения его представления. Используя существующие последовательности текста из больших корпусов, самоконтролируемое обучение (self-supervised learning) широко применяется для предобучения представлений текста: например, скрытую часть текста предсказывают по остальным частям окружающего текста. Так модели могут учиться «с учителем» на огромных объёмах текстовых данных, не нуждаясь в дорогой разметке!
В этой главе мы увидим, что если считать каждое слово или подслово отдельным токеном, то представление каждого токена можно предобучить на больших корпусах с помощью word2vec, GloVe или моделей вложения подслов. После предобучения представление каждого токена — это вектор. Однако он остаётся неизменным независимо от контекста. Например, векторное представление слова «bank» (по-русски «банк» или «берег») одинаково в предложениях «go to the bank to deposit some money» («пойти в банк, чтобы положить деньги») и «go to the bank to sit down» («пойти на берег, чтобы присесть»). Поэтому многие более новые предобученные модели подстраивают представление одного и того же токена под разные контексты. К ним относится BERT — более глубокая самоконтролируемая модель на основе кодировщика Transformer. В этой главе мы сосредоточимся на том, как предобучать такие представления текста, как показано на рис. 14.1.
Рис. 14.1. Предобученные представления текста можно подать в разные архитектуры глубокого обучения для разных задач обработки естественного языка (в этой главе мы изучаем предобучение представлений текста — «предшествующий» (upstream) этап)
На рис. 14.1 показано, что предобученные представления текста можно подать в различные архитектуры глубокого обучения и применить к разным задачам обработки естественного языка. Их мы рассмотрим в главе 15.
14.1 Вложения слов (word2vec)
Естественный язык — сложная система, с помощью которой выражают мысли. В этой системе слово — основная единица смысла. Как следует из названия, векторы слов — это векторы, представляющие значение слов; их можно также считать векторами признаков или представлениями слов. Технику отображения слов в вещественные векторы называют вложением слов (word embedding). В последние годы вложения слов постепенно стали базовым знанием в обработке естественного языка.
14.1.1 Почему one-hot-векторы — плохой выбор
В разделе 8.5 мы использовали one-hot-векторы для представления слов (слова там были символами). Пусть число различных слов в словаре (размер словаря) равно , а каждому слову соответствует своё целое число (индекс) от до . Чтобы получить one-hot-вектор слова с индексом , мы создаём вектор длины , состоящий из нулей, и ставим 1 в позицию . Так каждое слово представляется вектором длины , который можно сразу подавать в нейронную сеть.
Хотя one-hot-векторы легко строить, обычно они — плохой выбор. Главная причина в том, что one-hot-векторы не могут точно выразить сходство между разными словами, например часто используемое нами «косинусное сходство». Для векторов их косинусное сходство — это косинус угла между ними:
Поскольку косинусное сходство между one-hot-векторами любых двух разных слов равно 0, one-hot-векторы не могут кодировать сходство между словами.
14.1.2 Самоконтролируемый word2vec
Инструмент word2vec предложен именно для решения этой проблемы. Он отображает каждое слово в вектор фиксированной длины, и эти векторы лучше выражают сходство и аналогии между разными словами. Инструмент word2vec включает две модели: модель skip-gram («пропуск-грамма») (Mikolov et al., 2013b) и непрерывный мешок слов (continuous bag of words, CBOW) (Mikolov et al., 2013a). Чтобы получить семантически осмысленные представления, их обучение опирается на условные вероятности, которые можно рассматривать как предсказание одних слов корпуса по другим. Поскольку размеченных данных нет, и skip-gram, и CBOW — самоконтролируемые модели.
Ниже мы опишем эти две модели и методы их обучения.
14.1.3 Модель skip-gram
Модель skip-gram предполагает, что слово можно использовать для порождения окружающих его слов в текстовой последовательности. Возьмём в качестве примера последовательность «the», «man», «loves», «his», «son». Пусть центральным словом выбрано «loves», а размер контекстного окна равен 2. Как показано на рис. 14.1.1, при заданном центральном слове «loves» модель skip-gram рассматривает условную вероятность порождения контекстных слов «the», «man», «his», «son»:
Предположим, что контекстные слова порождаются независимо при заданном центральном слове (условная независимость). Тогда указанную условную вероятность можно переписать так:
Рис. 14.1.1. Модель skip-gram рассматривает условную вероятность порождения окружающих контекстных слов при заданном центральном слове
В модели skip-gram у каждого слова есть два -мерных вектора, которые используются для вычисления условных вероятностей. Точнее, для слова с индексом в словаре обозначим через и два его вектора, когда оно выступает центральным словом и контекстным словом соответственно. Условную вероятность порождения любого контекстного слова (с индексом в словаре) при заданном центральном слове (с индексом в словаре) можно смоделировать операцией softmax над скалярными произведениями векторов:
где множество индексов словаря . Пусть дана текстовая последовательность длины , где слово на временном шаге обозначено . Предположим, что контекстные слова порождаются независимо при любом центральном слове. Для контекстного окна размера функция правдоподобия модели skip-gram — это вероятность порождения всех контекстных слов при любом заданном центральном слове:
где можно опустить любые временные шаги, меньшие или большие .
14.1.3.1 Обучение
Параметры модели skip-gram — это вектор центрального слова и вектор контекстного слова для каждого слова словаря. При обучении мы находим параметры модели, максимизируя функцию правдоподобия (то есть методом максимального правдоподобия). Это равносильно минимизации следующей функции потерь:
Если для минимизации потерь используется стохастический градиентный спуск, то на каждой итерации можно случайно выбирать более короткую подпоследовательность, вычислять по ней (стохастический) градиент и обновлять параметры модели. Для вычисления этого (стохастического) градиента нужно получить градиенты логарифма условной вероятности по вектору центрального слова и по векторам контекстных слов. В общем случае, согласно (14.1.1), логарифм условной вероятности для центрального слова и контекстного слова равен
Дифференцируя, получаем градиент по вектору центрального слова :
Обратите внимание: для вычисления в (14.1.3) нужны условные вероятности всех слов словаря при центральном слове . Градиенты для остальных векторов слов получаются аналогично.
После обучения для слова с индексом словаря мы получаем два вектора: (как для центрального слова) и (как для контекстного слова). В приложениях обработки естественного языка в качестве представления слова обычно используют вектор центрального слова модели skip-gram.
14.1.4 Модель непрерывного мешка слов (CBOW)
Модель непрерывного мешка слов (CBOW) похожа на модель skip-gram. Главное отличие в том, что CBOW предполагает: центральное слово порождается по окружающим его контекстным словам в текстовой последовательности. Например, в последовательности «the», «man», «loves», «his», «son» при центральном слове «loves» и контекстном окне размера 2 модель CBOW рассматривает условную вероятность порождения центрального слова «loves» по контекстным словам «the», «man», «his», «son» (как показано на рис. 14.1.2), то есть
Рис. 14.1.2. Модель непрерывного мешка слов рассматривает условную вероятность порождения центрального слова по окружающим контекстным словам
Поскольку в модели CBOW несколько контекстных слов, при вычислении условной вероятности векторы этих слов усредняются. Точнее, для слова с индексом в словаре обозначим через и два вектора, используемых для контекстного и центрального слова соответственно (обозначения противоположны модели skip-gram). Условную вероятность порождения любого центрального слова (с индексом в словаре) при заданных контекстных словах (с индексами в словаре) можно смоделировать формулой
Для краткости положим и . Тогда (14.1.4) упрощается до
Пусть дана текстовая последовательность длины , где слово на временном шаге обозначено . Для контекстного окна размера функция правдоподобия модели CBOW — это вероятность порождения всех центральных слов при заданных их контекстных словах:
14.1.4.1 Обучение
Обучение модели CBOW почти не отличается от обучения модели skip-gram. Оценка максимального правдоподобия для CBOW равносильна минимизации следующей функции потерь:
Заметим, что
Дифференцируя, получаем градиент по любому вектору контекстного слова ():
Градиенты для остальных векторов слов получаются аналогично. В отличие от модели skip-gram, в CBOW в качестве представления слова обычно используют векторы контекстных слов.
Резюме
- Векторы слов — это векторы, представляющие значение слов; их можно также считать векторами признаков слов. Технику отображения слов в вещественные векторы называют вложением слов.
- Инструмент word2vec включает модель skip-gram и модель непрерывного мешка слов.
- Модель skip-gram предполагает, что слово можно использовать для порождения окружающих его слов в текстовой последовательности, а модель непрерывного мешка слов — что центральное слово порождается по контекстным словам.
Упражнения
- Какова вычислительная сложность каждого градиента? Какие проблемы возникают, если словарь велик?
- Некоторые устойчивые словосочетания английского языка состоят из нескольких слов, например «new york». Как обучить для них векторы слов? Подсказка: см. раздел 4 статьи о word2vec (Mikolov et al., 2013b).
- Рассмотрим устройство word2vec на примере модели skip-gram. Как связаны скалярное произведение двух векторов слов в модели skip-gram и косинусное сходство? Почему косинусное сходство векторов (обученных skip-gram) для пары семантически близких слов может быть высоким?
Литература
- Mikolov, T., Sutskever, I., Chen, K., Corrado, G. S., & Dean, J. (2013b). Distributed representations of words and phrases and their compositionality. In Advances in neural information processing systems, 3111–3119.
- Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013a). Efficient estimation of word representations in vector space. arXiv preprint arXiv:1301.3781.
14.2 Приближённое обучение
Вспомним наше обсуждение в разделе 14.1. Основная идея модели skip-gram — с помощью операции softmax вычислить условную вероятность порождения контекстного слова при заданном центральном слове (формула (14.1.1)); соответствующие логарифмические потери даны в (14.1.2).
Из-за свойств операции softmax контекстное слово может быть любым элементом словаря , поэтому в (14.1.2) стоит сумма с числом слагаемых, равным размеру всего словаря. Следовательно, вычисление градиента модели skip-gram в (14.1.3) и градиента модели непрерывного мешка слов в (14.1.5) тоже содержит суммирование. К сожалению, вычислять градиент такой суммы по словарю (обычно из сотен тысяч или миллионов слов) очень дорого!
Чтобы снизить эту вычислительную сложность, в этом разделе мы рассмотрим два метода приближённого обучения: отрицательную выборку (negative sampling) и иерархический softmax (hierarchical softmax). Из-за сходства моделей skip-gram и непрерывного мешка слов мы опишем эти два метода на примере модели skip-gram.
14.2.1 Отрицательная выборка
Отрицательная выборка изменяет исходную целевую функцию. Пусть задано контекстное окно центрального слова . Будем считать, что любое контекстное слово из этого окна — событие, вероятность которого моделируется так:
где использует определение сигмоидной функции активации:
Начнём обучение вложений слов с максимизации совместной вероятности всех таких событий в текстовой последовательности. Точнее, пусть дана текстовая последовательность длины , слово на временном шаге обозначено , а размер контекстного окна равен . Рассмотрим максимизацию совместной вероятности
Однако (14.2.2) учитывает только события с положительными примерами. Совместная вероятность в (14.2.2) достигает максимума 1 лишь тогда, когда все векторы слов равны бесконечности. Разумеется, такой результат бессмыслен. Чтобы целевая функция стала осмысленнее, отрицательная выборка добавляет отрицательные примеры, выбранные из заранее заданного распределения.
Обозначим через событие «контекстное слово взято из контекстного окна центрального слова ». Для этого события, включающего , из заранее заданного распределения выбираем шумовых слов, не взятых из этого контекстного окна. Обозначим через событие «шумовое слово () не взято из контекстного окна ». Предположим, что события для положительного и отрицательных примеров взаимно независимы. Отрицательная выборка переписывает совместную вероятность из (14.2.2) (содержащую только положительные примеры) как
а условную вероятность приближает через события :
Обозначим через и индексы слова на временном шаге текстовой последовательности и шумового слова соответственно. Логарифмические потери для условной вероятности в (14.2.3) равны
Теперь видно, что стоимость вычисления градиента на каждом шаге обучения не зависит от размера словаря, а линейно зависит от . Если гиперпараметр мал, то стоимость вычисления градиента на каждом шаге обучения с отрицательной выборкой невелика.
14.2.2 Иерархический softmax
В качестве другого метода приближённого обучения иерархический softmax использует бинарное дерево (структуру данных, показанную на рис. 14.2.1), в котором каждый лист представляет слово словаря .
Рис. 14.2.1. Иерархический softmax для приближённого обучения: каждый лист дерева представляет слово словаря
Обозначим через число узлов (включая оба конца) на пути от корня до листа, представляющего слово , в бинарном дереве. Пусть — -й узел на этом пути, а его вектор контекстного слова равен . Например, на рис. 14.2.1 . Иерархический softmax приближает условную вероятность из (14.1.1) выражением
где функция определена в (14.2.1), — левый потомок узла , а , если истинно, и в противном случае.
Для иллюстрации вычислим условную вероятность порождения слова при заданном слове на рис. 14.2.1. Для этого нужны скалярные произведения вектора слова и векторов нелистовых узлов на пути от корня до (путь выделен жирным на рис. 14.2.1), который последовательно проходит влево, вправо и влево:
Поскольку , условные вероятности порождения всех слов словаря при любом заданном слове в сумме дают 1:
К счастью, благодаря структуре бинарного дерева величина имеет порядок . Когда размер словаря велик, вычислительная стоимость каждого шага обучения с иерархическим softmax значительно ниже, чем без приближённого обучения.
Резюме
- Отрицательная выборка строит функцию потерь, рассматривая взаимно независимые события, в которые входят и положительные, и отрицательные примеры. Объём вычислений при обучении линейно зависит от числа шумовых слов на каждом шаге.
- Иерархический softmax строит функцию потерь по пути от корня до листа в бинарном дереве. Вычислительная стоимость обучения зависит от логарифма размера словаря.
Упражнения
- Как выбирать шумовые слова при отрицательной выборке?
- Проверьте, что (14.2.4) выполняется.
- Как обучить модель непрерывного мешка слов с помощью отрицательной выборки и иерархического softmax соответственно?
14.3 Набор данных для предобучения вложений слов
Теперь, когда мы знаем технические детали модели word2vec и общий порядок её обучения, перейдём к реализации. Конкретно, в качестве примера мы возьмём модель skip-gram из раздела 14.1 и отрицательную выборку из раздела 14.2. Этот раздел начинается с набора данных для предобучения модели вложений слов: исходный формат данных будет преобразован в минибатчи, по которым можно итерироваться во время обучения.
MXNet:
from d2l import mxnet as d2l
import math
from mxnet import gluon, np
import os
import random
PyTorch:
from d2l import torch as d2l
import math
import torch
import os
import random
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import paddle
import os
import random
14.3.1 Чтение набора данных
Мы используем набор данных Penn Tree Bank (PTB). Этот корпус составлен из статей «Уолл-стрит джорнал» и разделён на обучающую, проверочную и тестовую части. В исходном формате каждая строка текстового файла — одно предложение, слова в котором разделены пробелами. Каждое слово мы будем считать токеном.
#@save
d2l.DATA_HUB['ptb'] = (d2l.DATA_URL + 'ptb.zip',
'319d85e578af0cdc590547f26231e4e31cdf1e42')
#@save
def read_ptb():
"""Загружает набор данных PTB в список строк текста"""
data_dir = d2l.download_extract('ptb')
# Читаем обучающую часть
with open(os.path.join(data_dir, 'ptb.train.txt')) as f:
raw_text = f.read()
return [line.split() for line in raw_text.split('\n')]
sentences = read_ptb()
f'# предложений: {len(sentences)}'
После чтения обучающей части мы строим словарь корпуса: все слова, встречающиеся меньше 10 раз, заменяются токеном <unk>. Заметим, что исходный набор данных уже содержит токены <unk>, обозначающие редкие (неизвестные) слова.
vocab = d2l.Vocab(sentences, min_freq=10)
f'размер словаря: {len(vocab)}'
14.3.2 Прореживание частых слов
В текстовых данных обычно есть частые слова — «the», «a», «in»: в очень большом корпусе они могут встречаться миллиарды раз. Однако такие слова часто встречаются в контекстных окнах вместе со множеством разных слов и дают мало полезной информации. Например, рассмотрим слово «chip» в контекстном окне: интуитивно его совместная встречаемость с редким словом «intel» полезнее для обучения, чем с частым словом «a». Кроме того, обучение на большом числе (частых) слов идёт медленно. Поэтому при обучении модели вложений слов частые слова можно прореживать (subsampling) (Mikolov et al., 2013b). Точнее, каждое слово набора данных будет отброшено с вероятностью
где — отношение числа вхождений слова к общему числу слов набора данных, а константа — гиперпараметр (в эксперименте ). Видно, что (частое) слово может быть отброшено, только когда его относительная частота , причём чем выше относительная частота слова, тем больше вероятность его отбросить.
#@save
def subsample(sentences, vocab):
"""Прореживает частые слова"""
# Исключаем неизвестные токены '<unk>'
sentences = [[token for token in line if vocab[token] != vocab.unk]
for line in sentences]
counter = d2l.count_corpus(sentences)
num_tokens = sum(counter.values())
# Возвращает True, если токен сохраняется при прореживании
def keep(token):
return(random.uniform(0, 1) <
math.sqrt(1e-4 / counter[token] * num_tokens))
return ([[token for token in line if keep(token)] for line in sentences],
counter)
subsampled, counter = subsample(sentences, vocab)
Следующий фрагмент кода строит гистограмму числа токенов в предложении до и после прореживания. Как и ожидалось, прореживание заметно укорачивает предложения, удаляя частые слова, что ускорит обучение.
d2l.show_list_len_pair_hist(
['до прореживания', 'после прореживания'], 'токенов в предложении',
'количество', sentences, subsampled);
Для отдельных токенов видно, что частое слово «the» сохраняется с вероятностью менее 1/20.
def compare_counts(token):
return (f'количество "{token}": '
f'до={sum([l.count(token) for l in sentences])}, '
f'после={sum([l.count(token) for l in subsampled])}')
compare_counts('the')
Напротив, редкое слово «join» сохраняется полностью.
compare_counts('join')
После прореживания мы отображаем токены в их индексы в корпусе.
corpus = [vocab[line] for line in subsampled]
corpus[:3]
14.3.3 Извлечение центральных и контекстных слов
Следующая функция get_centers_and_contexts извлекает из corpus все центральные слова и их контекстные слова. Для каждого центрального слова она случайно выбирает целое число от 1 до max_window_size в качестве размера контекстного окна. Контекстными словами центрального слова считаются слова, расстояние до которых не превышает выбранный размер окна.
#@save
def get_centers_and_contexts(corpus, max_window_size):
"""Возвращает центральные и контекстные слова модели skip-gram"""
centers, contexts = [], []
for line in corpus:
# Чтобы получить пару «центральное слово — контекстное слово»,
# в предложении должно быть не меньше 2 слов
if len(line) < 2:
continue
centers += line
for i in range(len(line)): # Контекстное окно с центром в i
window_size = random.randint(1, max_window_size)
indices = list(range(max(0, i - window_size),
min(len(line), i + 1 + window_size)))
# Исключаем центральное слово из контекстных
indices.remove(i)
contexts.append([line[idx] for idx in indices])
return centers, contexts
Далее создадим искусственный набор данных из двух предложений по 7 и 3 слова. Зададим максимальный размер контекстного окна 2 и выведем все центральные слова и их контекстные слова.
tiny_dataset = [list(range(7)), list(range(7, 10))]
print('набор данных', tiny_dataset)
for center, context in zip(*get_centers_and_contexts(tiny_dataset, 2)):
print('центральное слово', center, '— контекстные слова:', context)
При обучении на наборе данных PTB мы задаём максимальный размер контекстного окна 5. Ниже извлекаются все центральные слова набора данных и их контекстные слова.
all_centers, all_contexts = get_centers_and_contexts(corpus, 5)
f'# пар «центральное слово — контекстное слово»: {sum([len(contexts) for contexts in all_contexts])}'
14.3.4 Отрицательная выборка
Для приближённого обучения мы используем отрицательную выборку. Чтобы выбирать шумовые слова по заранее заданному распределению, определим следующий класс RandomGenerator, в который (возможно, ненормированное) распределение выборки передаётся через переменную sampling_weights.
#@save
class RandomGenerator:
"""Случайно выбирает из {1, ..., n} согласно n весам выборки"""
def __init__(self, sampling_weights):
# Индекс 0 исключён
self.population = list(range(1, len(sampling_weights) + 1))
self.sampling_weights = sampling_weights
self.candidates = []
self.i = 0
def draw(self):
if self.i == len(self.candidates):
# Кэшируем k случайных результатов выборки
self.candidates = random.choices(
self.population, self.sampling_weights, k=10000)
self.i = 0
self.i += 1
return self.candidates[self.i - 1]
Например, мы можем выбрать 10 значений случайной величины из индексов 1, 2 и 3 с вероятностями и следующим образом.
#@save
generator = RandomGenerator([2, 3, 4])
[generator.draw() for _ in range(10)]
Для пары «центральное слово — контекстное слово» мы случайно выбираем K (в эксперименте 5) шумовых слов. Следуя рекомендации статьи о word2vec, вероятность выбора шумового слова , , полагается равной его относительной частоте в словаре, возведённой в степень 0.75 (Mikolov et al., 2013b).
#@save
def get_negatives(all_contexts, vocab, counter, K):
"""Возвращает шумовые слова для отрицательной выборки"""
# Индексы 1, 2, ... (индекс 0 — неизвестный токен, исключённый из словаря)
sampling_weights = [counter[vocab.to_tokens(i)]**0.75
for i in range(1, len(vocab))]
all_negatives, generator = [], RandomGenerator(sampling_weights)
for contexts in all_contexts:
negatives = []
while len(negatives) < len(contexts) * K:
neg = generator.draw()
# Шумовое слово не может быть контекстным
if neg not in contexts:
negatives.append(neg)
all_negatives.append(negatives)
return all_negatives
all_negatives = get_negatives(all_contexts, vocab, counter, 5)
14.3.5 Загрузка обучающих примеров минибатчами
После извлечения всех центральных слов с их контекстными словами и выборки шумовых слов мы преобразуем их в минибатчи примеров, по которым можно итерироваться во время обучения.
В минибатче -й пример состоит из центрального слова, его контекстных слов и шумовых слов. Из-за разного размера контекстного окна различается для разных . Поэтому для каждого примера мы конкатенируем его контекстные и шумовые слова в переменной contexts_negatives и дополняем нулями, пока длина конкатенации не достигнет (max_len). Чтобы исключить дополнение при вычислении потерь, мы определяем маску masks. Элементы masks и contexts_negatives находятся во взаимно однозначном соответствии: нули в masks отвечают дополнению в contexts_negatives (иначе в masks стоят единицы).
Чтобы различать положительные и отрицательные примеры, в contexts_negatives мы отделяем контекстные слова от шумовых с помощью переменной labels. Как и для masks, между элементами labels и contexts_negatives есть взаимно однозначное соответствие: единицы в labels отвечают контекстным словам (положительным примерам) в contexts_negatives, а в остальных позициях стоят нули.
Эта идея реализована в следующей функции batchify. Её вход data — список длины, равной размеру минибатча, в котором каждый элемент — пример из центрального слова center, его контекстных слов context и его шумовых слов negative. Функция возвращает минибатч, который можно загружать для вычислений во время обучения, в том числе с переменной-маской.
#@save
def batchify(data):
"""Возвращает минибатч примеров для модели skip-gram с отрицательной выборкой"""
max_len = max(len(c) + len(n) for _, c, n in data)
centers, contexts_negatives, masks, labels = [], [], [], []
for center, context, negative in data:
cur_len = len(context) + len(negative)
centers += [center]
contexts_negatives += \
[context + negative + [0] * (max_len - cur_len)]
masks += [[1] * cur_len + [0] * (max_len - cur_len)]
labels += [[1] * len(context) + [0] * (max_len - len(context))]
return (d2l.reshape(d2l.tensor(centers), (-1, 1)), d2l.tensor(
contexts_negatives), d2l.tensor(masks), d2l.tensor(labels))
Проверим эту функцию на минибатче из двух примеров.
x_1 = (1, [2, 2], [3, 3, 3, 3])
x_2 = (1, [2, 2, 2], [3, 3])
batch = batchify((x_1, x_2))
names = ['centers', 'contexts_negatives', 'masks', 'labels']
for name, data in zip(names, batch):
print(name, '=', data)
14.3.6 Сборка кода
Наконец, определим функцию load_data_ptb, которая читает набор данных PTB и возвращает итератор данных и словарь.
MXNet:
#@save
def load_data_ptb(batch_size, max_window_size, num_noise_words):
"""Загружает набор данных PTB и помещает его в память"""
sentences = read_ptb()
vocab = d2l.Vocab(sentences, min_freq=10)
subsampled, counter = subsample(sentences, vocab)
corpus = [vocab[line] for line in subsampled]
all_centers, all_contexts = get_centers_and_contexts(
corpus, max_window_size)
all_negatives = get_negatives(
all_contexts, vocab, counter, num_noise_words)
dataset = gluon.data.ArrayDataset(
all_centers, all_contexts, all_negatives)
data_iter = gluon.data.DataLoader(
dataset, batch_size, shuffle=True,batchify_fn=batchify,
num_workers=d2l.get_dataloader_workers())
return data_iter, vocab
PyTorch:
#@save
def load_data_ptb(batch_size, max_window_size, num_noise_words):
"""Загружает набор данных PTB и помещает его в память"""
num_workers = d2l.get_dataloader_workers()
sentences = read_ptb()
vocab = d2l.Vocab(sentences, min_freq=10)
subsampled, counter = subsample(sentences, vocab)
corpus = [vocab[line] for line in subsampled]
all_centers, all_contexts = get_centers_and_contexts(
corpus, max_window_size)
all_negatives = get_negatives(
all_contexts, vocab, counter, num_noise_words)
class PTBDataset(torch.utils.data.Dataset):
def __init__(self, centers, contexts, negatives):
assert len(centers) == len(contexts) == len(negatives)
self.centers = centers
self.contexts = contexts
self.negatives = negatives
def __getitem__(self, index):
return (self.centers[index], self.contexts[index],
self.negatives[index])
def __len__(self):
return len(self.centers)
dataset = PTBDataset(all_centers, all_contexts, all_negatives)
data_iter = torch.utils.data.DataLoader(
dataset, batch_size, shuffle=True,
collate_fn=batchify, num_workers=num_workers)
return data_iter, vocab
PaddlePaddle:
#@save
def load_data_ptb(batch_size, max_window_size, num_noise_words):
"""Загружает набор данных PTB и помещает его в память"""
num_workers = d2l.get_dataloader_workers()
sentences = read_ptb()
vocab = d2l.Vocab(sentences, min_freq=10)
subsampled, counter = subsample(sentences, vocab)
corpus = [vocab[line] for line in subsampled]
all_centers, all_contexts = get_centers_and_contexts(
corpus, max_window_size)
all_negatives = get_negatives(
all_contexts, vocab, counter, num_noise_words)
class PTBDataset(paddle.io.Dataset):
def __init__(self, centers, contexts, negatives):
assert len(centers) == len(contexts) == len(negatives)
self.centers = centers
self.contexts = contexts
self.negatives = negatives
def __getitem__(self, index):
return (self.centers[index], self.contexts[index],
self.negatives[index])
def __len__(self):
return len(self.centers)
dataset = PTBDataset(all_centers, all_contexts, all_negatives)
data_iter = paddle.io.DataLoader(
dataset, batch_size=batch_size, shuffle=True, return_list=True,
collate_fn=batchify, num_workers=num_workers)
return data_iter, vocab
Выведем первый минибатч итератора данных.
data_iter, vocab = load_data_ptb(512, 5, 5)
for batch in data_iter:
for name, data in zip(names, batch):
print(name, 'shape:', data.shape)
break
Резюме
- Частые слова могут оказаться не очень полезными при обучении. Их можно прореживать, чтобы ускорить обучение.
- Для повышения эффективности вычислений мы загружаем примеры минибатчами. Можно определить дополнительные переменные, которые отличают дополняющие элементы от остальных, а также положительные примеры от отрицательных.
Упражнения
- Как изменится время работы кода этого раздела, если не использовать прореживание?
- Класс
RandomGeneratorкэшируетkслучайных результатов выборки. Задайте дляkдругие значения и посмотрите, как это влияет на скорость загрузки данных. - Какие ещё гиперпараметры кода этого раздела могут влиять на скорость загрузки данных?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Mikolov, T., Sutskever, I., Chen, K., Corrado, G. S., & Dean, J. (2013b). Distributed representations of words and phrases and their compositionality. In Advances in neural information processing systems, 3111–3119.
14.4 Предобучение word2vec
Продолжим реализацию модели skip-gram, определённой в разделе 14.1. Затем мы предобучим word2vec с отрицательной выборкой на наборе данных PTB. Для начала получим итератор данных и словарь для этого набора, вызвав функцию d2l.load_data_ptb, которая описана в разделе 14.3.
MXNet:
from d2l import mxnet as d2l
import math
from mxnet import autograd, gluon, np, npx
from mxnet.gluon import nn
npx.set_np()
batch_size, max_window_size, num_noise_words = 512, 5, 5
data_iter, vocab = d2l.load_data_ptb(batch_size, max_window_size,
num_noise_words)
PyTorch:
from d2l import torch as d2l
import math
import torch
from torch import nn
batch_size, max_window_size, num_noise_words = 512, 5, 5
data_iter, vocab = d2l.load_data_ptb(batch_size, max_window_size,
num_noise_words)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import math
import paddle
from paddle import nn
batch_size, max_window_size, num_noise_words = 512, 5, 5
data_iter, vocab = d2l.load_data_ptb(batch_size, max_window_size,
num_noise_words)
14.4.1 Модель skip-gram
Мы реализуем модель skip-gram с помощью слоёв вложений и пакетного матричного умножения. Сначала вспомним, как работают слои вложений.
14.4.1.1 Слой вложений
Как описано в разделе 9.7, слой вложений отображает индекс токена в его вектор признаков. Вес этого слоя — матрица, число строк которой равно размеру словаря (input_dim), а число столбцов — размерности вектора каждого токена (output_dim). После обучения модели вложений слов именно этот вес нам и нужен.
MXNet:
embed = nn.Embedding(input_dim=20, output_dim=4)
embed.initialize()
embed.weight
PyTorch:
embed = nn.Embedding(num_embeddings=20, embedding_dim=4)
print(f'Параметр embedding_weight ({embed.weight.shape}, '
f'dtype={embed.weight.dtype})')
PaddlePaddle:
embed = nn.Embedding(num_embeddings=20, embedding_dim=4)
print(f'Параметр embedding_weight ({embed.weight.shape}, '
f'dtype={embed.weight.dtype})')
Входом слоя вложений служит индекс токена (слова). Для любого индекса токена его векторное представление берётся из -й строки матрицы весов слоя вложений. Поскольку размерность вектора (output_dim) равна 4, для минибатча индексов токенов формы (2, 3) слой вложений вернёт векторы формы (2, 3, 4).
x = d2l.tensor([[1, 2, 3], [4, 5, 6]])
embed(x)
14.4.1.2 Определение прямого распространения
При прямом распространении входом модели skip-gram служат индексы центральных слов center формы (размер минибатча, 1) и индексы контекстных и шумовых слов contexts_and_negatives формы (размер минибатча, max_len), где max_len определено в разделе 14.3.5. Эти две переменные сначала преобразуются из индексов токенов в векторы слоем вложений, затем их пакетное матричное умножение (описанное в разделе 10.2.4.1) даёт выход формы (размер минибатча, 1, max_len). Каждый элемент выхода — скалярное произведение вектора центрального слова и вектора контекстного или шумового слова.
MXNet:
def skip_gram(center, contexts_and_negatives, embed_v, embed_u):
v = embed_v(center)
u = embed_u(contexts_and_negatives)
pred = npx.batch_dot(v, u.swapaxes(1, 2))
return pred
PyTorch:
def skip_gram(center, contexts_and_negatives, embed_v, embed_u):
v = embed_v(center)
u = embed_u(contexts_and_negatives)
pred = torch.bmm(v, u.permute(0, 2, 1))
return pred
PaddlePaddle:
def skip_gram(center, contexts_and_negatives, embed_v, embed_u):
v = embed_v(center)
u = embed_u(contexts_and_negatives)
pred = paddle.bmm(v, u.transpose(perm=[0, 2, 1]))
return pred
Выведем форму результата этой функции skip_gram для некоторых тестовых входов.
MXNet:
skip_gram(np.ones((2, 1)), np.ones((2, 4)), embed, embed).shape
PyTorch:
skip_gram(torch.ones((2, 1), dtype=torch.long),
torch.ones((2, 4), dtype=torch.long), embed, embed).shape
PaddlePaddle:
skip_gram(paddle.ones((2, 1), dtype='int64'),
paddle.ones((2, 4), dtype='int64'), embed, embed).shape
14.4.2 Обучение
Прежде чем обучать модель skip-gram с отрицательной выборкой, определим для неё функцию потерь.
14.4.2.1 Бинарные потери кросс-энтропии
Согласно определению функции потерь отрицательной выборки в разделе 14.2.1, мы будем использовать бинарные потери кросс-энтропии.
MXNet:
loss = gluon.loss.SigmoidBCELoss()
PyTorch:
class SigmoidBCELoss(nn.Module):
# Бинарные потери кросс-энтропии с маской
def __init__(self):
super().__init__()
def forward(self, inputs, target, mask=None):
out = nn.functional.binary_cross_entropy_with_logits(
inputs, target, weight=mask, reduction="none")
return out.mean(dim=1)
loss = SigmoidBCELoss()
PaddlePaddle:
class SigmoidBCELoss(nn.Layer):
# Бинарные потери кросс-энтропии с маской
def __init__(self):
super().__init__()
def forward(self, inputs, target, mask=None):
out = nn.functional.binary_cross_entropy_with_logits(
logit=inputs, label=target, weight=mask, reduction="none")
return out.mean(axis=1)
loss = SigmoidBCELoss()
Вспомним описание переменной-маски и переменной-меток в разделе 14.3.5. Ниже вычисляются бинарные потери кросс-энтропии для заданных переменных.
MXNet, PyTorch:
pred = d2l.tensor([[1.1, -2.2, 3.3, -4.4]] * 2)
label = d2l.tensor([[1.0, 0.0, 0.0, 0.0], [0.0, 1.0, 0.0, 0.0]])
mask = d2l.tensor([[1, 1, 1, 1], [1, 1, 0, 0]])
loss(pred, label, mask) * mask.shape[1] / mask.sum(axis=1)
PaddlePaddle:
pred = d2l.tensor([[1.1, -2.2, 3.3, -4.4]] * 2)
label = d2l.tensor([[1.0, 0.0, 0.0, 0.0], [0.0, 1.0, 0.0, 0.0]])
mask = d2l.tensor([[1, 1, 1, 1], [1, 1, 0, 0]], dtype='float32')
loss(pred, label, mask) * mask.shape[1] / mask.sum(axis=1)
Ниже показано, как (менее эффективным способом) вычислить тот же результат с помощью сигмоидной функции активации в бинарных потерях кросс-энтропии. Два выхода можно рассматривать как две нормированные потери, усреднённые по немаскированным предсказаниям.
def sigmd(x):
return -math.log(1 / (1 + math.exp(-x)))
print(f'{(sigmd(1.1) + sigmd(2.2) + sigmd(-3.3) + sigmd(4.4)) / 4:.4f}')
print(f'{(sigmd(-1.1) + sigmd(-2.2)) / 2:.4f}')
14.4.2.2 Инициализация параметров модели
Мы определяем два слоя вложений: один используется для всех слов словаря как центральных, другой — как контекстных. Размерность вектора слова embed_size равна 100.
MXNet:
embed_size = 100
net = nn.Sequential()
net.add(nn.Embedding(input_dim=len(vocab), output_dim=embed_size),
nn.Embedding(input_dim=len(vocab), output_dim=embed_size))
PyTorch, PaddlePaddle:
embed_size = 100
net = nn.Sequential(nn.Embedding(num_embeddings=len(vocab),
embedding_dim=embed_size),
nn.Embedding(num_embeddings=len(vocab),
embedding_dim=embed_size))
14.4.2.3 Определение цикла обучения
Цикл обучения определён ниже. Из-за наличия дополнения вычисление функции потерь немного отличается от прежних функций обучения.
MXNet:
def train(net, data_iter, lr, num_epochs, device=d2l.try_gpu()):
net.initialize(ctx=device, force_reinit=True)
trainer = gluon.Trainer(net.collect_params(), 'adam',
{'learning_rate': lr})
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[1, num_epochs])
# Сумма нормированных потерь, число нормированных потерь
metric = d2l.Accumulator(2)
for epoch in range(num_epochs):
timer, num_batches = d2l.Timer(), len(data_iter)
for i, batch in enumerate(data_iter):
center, context_negative, mask, label = [
data.as_in_ctx(device) for data in batch]
with autograd.record():
pred = skip_gram(center, context_negative, net[0], net[1])
l = (loss(pred.reshape(label.shape), label, mask) *
mask.shape[1] / mask.sum(axis=1))
l.backward()
trainer.step(batch_size)
metric.add(l.sum(), l.size)
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[1],))
print(f'потери {metric[0] / metric[1]:.3f}, '
f'{metric[1] / timer.stop():.1f} токенов/с на {str(device)}')
PyTorch:
def train(net, data_iter, lr, num_epochs, device=d2l.try_gpu()):
def init_weights(m):
if type(m) == nn.Embedding:
nn.init.xavier_uniform_(m.weight)
net.apply(init_weights)
net = net.to(device)
optimizer = torch.optim.Adam(net.parameters(), lr=lr)
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[1, num_epochs])
# Сумма нормированных потерь, число нормированных потерь
metric = d2l.Accumulator(2)
for epoch in range(num_epochs):
timer, num_batches = d2l.Timer(), len(data_iter)
for i, batch in enumerate(data_iter):
optimizer.zero_grad()
center, context_negative, mask, label = [
data.to(device) for data in batch]
pred = skip_gram(center, context_negative, net[0], net[1])
l = (loss(pred.reshape(label.shape).float(), label.float(), mask)
/ mask.sum(axis=1) * mask.shape[1])
l.sum().backward()
optimizer.step()
metric.add(l.sum(), l.numel())
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[1],))
print(f'потери {metric[0] / metric[1]:.3f}, '
f'{metric[1] / timer.stop():.1f} токенов/с на {str(device)}')
PaddlePaddle:
def train(net, data_iter, lr, num_epochs, device=d2l.try_gpu()):
def init_weights(m):
if type(m) == nn.Embedding:
nn.initializer.XavierUniform(m.weight)
net.apply(init_weights)
optimizer = paddle.optimizer.Adam(learning_rate=lr, parameters=net.parameters())
animator = d2l.Animator(xlabel='эпоха', ylabel='потери',
xlim=[1, num_epochs])
# Сумма нормированных потерь, число нормированных потерь
metric = d2l.Accumulator(2)
for epoch in range(num_epochs):
timer, num_batches = d2l.Timer(), len(data_iter)
for i, batch in enumerate(data_iter):
optimizer.clear_grad()
center, context_negative, mask, label = [
paddle.to_tensor(data, place=device) for data in batch]
pred = skip_gram(center, context_negative, net[0], net[1])
l = (loss(pred.reshape(label.shape), paddle.to_tensor(label, dtype='float32'),
paddle.to_tensor(mask, dtype='float32'))
/ mask.sum(axis=1) * mask.shape[1])
l.sum().backward()
optimizer.step()
metric.add(l.sum(), l.numel())
if (i + 1) % (num_batches // 5) == 0 or i == num_batches - 1:
animator.add(epoch + (i + 1) / num_batches,
(metric[0] / metric[1],))
print(f'потери {metric[0] / metric[1]:.3f}, '
f'{metric[1] / timer.stop():.1f} токенов/с на {str(device)}')
Теперь можно обучить модель skip-gram с отрицательной выборкой.
lr, num_epochs = 0.002, 5
train(net, data_iter, lr, num_epochs)
14.4.3 Применение вложений слов
После обучения модели word2vec мы можем по косинусному сходству векторов слов обученной модели найти в словаре слова, семантически наиболее близкие к заданному.
MXNet:
def get_similar_tokens(query_token, k, embed):
W = embed.weight.data()
x = W[vocab[query_token]]
# Вычисляем косинусное сходство. Добавляем 1e-9 для численной устойчивости
cos = np.dot(W, x) / np.sqrt(np.sum(W * W, axis=1) * np.sum(x * x) + \
1e-9)
topk = npx.topk(cos, k=k+1, ret_typ='indices').asnumpy().astype('int32')
for i in topk[1:]: # Исключаем входное слово
print(f'косинусное сходство={float(cos[i]):.3f}: {vocab.to_tokens(i)}')
get_similar_tokens('chip', 3, net[0])
PyTorch:
def get_similar_tokens(query_token, k, embed):
W = embed.weight.data
x = W[vocab[query_token]]
# Вычисляем косинусное сходство. Добавляем 1e-9 для численной устойчивости
cos = torch.mv(W, x) / torch.sqrt(torch.sum(W * W, dim=1) *
torch.sum(x * x) + 1e-9)
topk = torch.topk(cos, k=k+1)[1].cpu().numpy().astype('int32')
for i in topk[1:]: # Исключаем входное слово
print(f'косинусное сходство={float(cos[i]):.3f}: {vocab.to_tokens(i)}')
get_similar_tokens('chip', 3, net[0])
PaddlePaddle:
def get_similar_tokens(query_token, k, embed):
W = embed.weight
x = W[vocab[query_token]]
# Вычисляем косинусное сходство. Добавляем 1e-9 для численной устойчивости
cos = paddle.mv(W, x) / paddle.sqrt(paddle.sum(W * W, axis=1) *
paddle.sum(x * x) + 1e-9)
topk = paddle.topk(cos, k=k+1)[1].numpy().astype('int32')
for i in topk[1:]: # Исключаем входное слово
print(f'косинусное сходство={float(cos[i]):.3f}: {vocab.to_tokens(i)}')
get_similar_tokens('chip', 3, net[0])
Резюме
- Модель skip-gram с отрицательной выборкой можно обучить, используя слои вложений и бинарные потери кросс-энтропии.
- Применения вложений слов включают нахождение семантически близких слов для заданного слова по косинусному сходству их векторов.
Упражнения
- Используя обученную модель, найдите семантически близкие слова для других входных слов. Можно ли улучшить результаты, настроив гиперпараметры?
- Когда обучающий корпус огромен, при обновлении параметров модели контекстные и шумовые слова часто выбирают для центральных слов в текущем минибатче. Иными словами, у одного и того же центрального слова на разных итерациях обучения могут быть разные контекстные или шумовые слова. В чём преимущество такого подхода? Попробуйте реализовать этот метод обучения.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
14.5 Вложения слов на основе глобальных векторов (GloVe)
Совместная встречаемость слов (co-occurrence) в пределах контекстного окна может нести богатую семантическую информацию. Например, в большом корпусе слово «твёрдый» (solid) более вероятно встретится вместе со словом «лёд» (ice), чем слово «газ» (gas), но слово «газ» может встречаться вместе со словом «пар» (steam) чаще, чем со словом «лёд». Кроме того, такую глобальную статистику корпуса можно вычислить заранее, что повышает эффективность обучения. Чтобы использовать статистическую информацию всего корпуса для вложений слов, сначала вернёмся к модели skip-gram из раздела 14.1.3, но истолкуем её через глобальную статистику корпуса, такую как счётчики совместной встречаемости.
14.5.1 Модель skip-gram с глобальной статистикой корпуса
Обозначим через условную вероятность слова при заданном слове в модели skip-gram:
где для любого индекса векторы и представляют слово как центральное и как контекстное соответственно, а — множество индексов словаря.
Слово может встречаться в корпусе много раз. Во всём корпусе все контекстные слова, для которых — центральное слово, образуют мультимножество индексов слов, допускающее несколько экземпляров одного элемента. Число экземпляров элемента называется его кратностью. Для примера предположим, что слово встречается в корпусе дважды, а индексы контекстных слов с центральным словом в двух контекстных окнах равны и . Тогда мультимножество , где кратности элементов равны 2, 4, 1, 1 соответственно.
Теперь обозначим кратность элемента в мультимножестве через . Это глобальный счётчик совместной встречаемости слова (как контекстного) и слова (как центрального) в одном контекстном окне во всём корпусе. С такой глобальной статистикой корпуса функция потерь модели skip-gram эквивалентна
Обозначим через число всех контекстных слов в контекстных окнах, где встречается как центральное слово; это равно . Пусть — условная вероятность порождения контекстного слова . При заданном центральном слове выражение (14.5.1) можно переписать как
В (14.5.2) выражение вычисляет кросс-энтропию условного распределения глобальной статистики корпуса и условного распределения , предсказанного моделью. Как сказано выше, эти потери тоже взвешены по . Минимизация функции потерь в (14.5.2) заставит предсказанное условное распределение приблизиться к условному распределению глобальной статистики корпуса.
Хотя кросс-энтропия обычно служит для измерения расстояния между распределениями вероятностей, здесь она, возможно, не лучший выбор. С одной стороны, как мы отмечали в разделе 14.2, нормировка требует суммирования по всему словарю, что может быть очень дорого вычислительно. С другой стороны, большое число редких событий из большого корпуса часто моделируется кросс-энтропией, которая придаёт им слишком большой вес.
14.5.2 Модель GloVe
Поэтому модель GloVe вносит в модель skip-gram три изменения на основе квадратичных потерь (Pennington et al., 2014):
- Использовать переменные и вместо распределений вероятностей и взять логарифм обеих. Поэтому квадратичное слагаемое потерь равно .
- Добавить для каждого слова два скалярных параметра модели: смещение центрального слова и смещение контекстного слова .
- Заменить вес каждого слагаемого потерь весовой функцией , где возрастает на отрезке .
Собрав всё вместе, обучение GloVe — это минимизация следующей функции потерь:
Для весовой функции рекомендуется такой выбор: (например, ) при (например, ); иначе . Поскольку , для повышения эффективности вычислений можно опустить квадратичное слагаемое потерь для любого . Например, при обучении стохастическим градиентным спуском на минибатчах на каждой итерации мы случайно выбираем минибатч ненулевых , чтобы вычислить градиенты и обновить параметры модели. Обратите внимание: эти ненулевые — заранее вычисленная глобальная статистика корпуса; поэтому модель называется GloVe (Global Vectors, «глобальные векторы»).
Следует подчеркнуть, что если слово встречается в контекстном окне слова , то и слово встречается в контекстном окне слова . Поэтому . В отличие от word2vec, который аппроксимирует асимметричную условную вероятность , GloVe аппроксимирует симметричную величину . Поэтому в модели GloVe вектор центрального слова и вектор контекстного слова любого слова математически эквивалентны. Но на практике из-за различных начальных значений одно и то же слово после обучения может получить разные значения в этих двух векторах: GloVe суммирует их и берёт сумму как выходной вектор.
14.5.3 Интерпретация GloVe через отношение условных вероятностей
Модель GloVe можно понять и с другой стороны. Используя те же обозначения, что в разделе 14.5.1, пусть — условная вероятность порождения контекстного слова при заданном слове как центральном слове корпуса. В табл. 14.5.1 перечислены вероятности совместной встречаемости для слов «ice» и «steam» и их отношения по статистике большого корпуса.
Таблица 14.5.1. Вероятности совместной встречаемости слов в большом корпусе и их отношения (адаптировано из табл. 1 статьи (Pennington et al., 2014))
| = | solid | gas | water | fashion |
|---|---|---|---|---|
| 0.00019 | 0.000066 | 0.003 | 0.000017 | |
| 0.000022 | 0.00078 | 0.0022 | 0.000018 | |
| 8.9 | 0.085 | 1.36 | 0.96 |
Из табл. 14.5.1 можно сделать следующие наблюдения:
- Для слова , связанного с «ice», но не связанного с «steam», например , мы ожидаем большее отношение вероятностей совместной встречаемости, например 8.9.
- Для слова , связанного с «steam», но не связанного с «ice», например , мы ожидаем меньшее отношение вероятностей совместной встречаемости, например 0.085.
- Для слова , связанного и с «ice», и со «steam», например , мы ожидаем отношение вероятностей совместной встречаемости, близкое к 1, например 1.36.
- Для слова , не связанного ни с «ice», ни со «steam», например , мы ожидаем отношение вероятностей совместной встречаемости, близкое к 1, например 0.96.
Видно, что отношение вероятностей совместной встречаемости интуитивно выражает связь между словами. Поэтому можно построить функцию от трёх векторов слов, аппроксимирующую это отношение. Для отношения вероятностей совместной встречаемости , где — центральное слово, а и — контекстные слова, мы хотим аппроксимировать его некоторой функцией :
Среди многих возможных вариантов мы выбираем лишь один разумный, исходя из следующих соображений. Поскольку отношение вероятностей совместной встречаемости — скаляр, потребуем, чтобы была скалярной функцией, например . Поменяв местами индексы слов и в (14.5.4), получаем, что должно выполняться , поэтому одна из возможностей — , то есть
Теперь выберем , где — константа. Поскольку , логарифмируя обе части, получаем . Для аппроксимации можно использовать дополнительные члены смещения, например смещение центрального слова и смещение контекстного слова :
Измеряя взвешенную квадратичную ошибку в (14.5.5), получаем функцию потерь GloVe из (14.5.3).
Резюме
- Модель skip-gram можно истолковать через глобальную статистику корпуса, такую как счётчики совместной встречаемости слов.
- Кросс-энтропия, возможно, не лучший способ измерить различие двух распределений вероятностей, особенно для большого корпуса. GloVe использует квадратичные потери, чтобы аппроксимировать заранее вычисленную глобальную статистику корпуса.
- Вектор центрального слова и вектор контекстного слова любого слова в GloVe математически эквивалентны.
- GloVe можно истолковать через отношение вероятностей совместной встречаемости слов.
Упражнения
- Если слова и встречаются в одном контекстном окне, как использовать расстояние между ними в текстовой последовательности, чтобы переосмыслить способ вычисления условной вероятности ? Подсказка: см. раздел 4.2 статьи о GloVe (Pennington et al., 2014).
- Математически эквивалентны ли для любого слова его смещение как центрального слова и смещение как контекстного? Почему?
Литература
- Pennington, J., Socher, R., & Manning, C. (2014). Glove: Global vectors for word representation. In Proceedings of the 2014 conference on empirical methods in natural language processing (EMNLP), 1532–1543.
14.6 Вложения подслов
В английском языке слова «helps», «helped» и «helping» — словоизменительные формы одного слова «help». Отношение между «dog» и «dogs» такое же, как между «cat» и «cats», а отношение между «boy» и «boyfriend» — такое же, как между «girl» и «girlfriend». В других языках, например во французском и испанском, у многих глаголов более 40 словоизменительных форм, а в финском у существительного может быть до 15 падежных форм. В лингвистике морфология изучает образование слов и отношения между словами. Однако ни word2vec, ни GloVe не исследуют внутреннюю структуру слов.
14.6.1 Модель fastText
Вспомним, как слова представляются в word2vec. И в модели skip-gram, и в модели непрерывного мешка слов разные словоизменительные формы одного и того же слова представляются разными векторами напрямую, без общих параметров. Чтобы использовать морфологическую информацию, модель fastText предложила подход вложения подслов, где подслово — это символьная -грамма (Bojanowski et al., 2017). fastText можно рассматривать как модель skip-gram на уровне подслов: вместо обучения векторных представлений на уровне слов каждое центральное слово представляется суммой векторов его подслов.
Покажем, как получить подслова для каждого центрального слова в fastText, на примере слова «where». Сначала добавим в начало и конец слова специальные символы «<» и «>», чтобы отличать префиксы и суффиксы от других подслов. Затем извлечём из слова символьные -граммы. Например, при мы получим все подслова длины 3: «<wh», «whe», «her», «ere», «re>» и специальное подслово «<where>».
В fastText для любого слова через обозначают объединение всех его подслов длины от 3 до 6 и его специального подслова. Словарь — это объединение подслов всех слов. Пусть — вектор подслова в словаре; тогда вектор слова как центрального слова в модели skip-gram — это сумма векторов его подслов:
Остальное в fastText совпадает с моделью skip-gram. По сравнению с skip-gram словарь fastText больше, а параметров модели больше. Кроме того, чтобы вычислить представление слова, нужно просуммировать векторы всех его подслов, что приводит к более высокой вычислительной сложности. Однако благодаря общим параметрам подслов у слов со сходной структурой редкие слова и даже слова вне словаря могут получать в fastText лучшие векторные представления.
14.6.2 Кодирование пар байтов (Byte Pair Encoding)
В fastText все извлекаемые подслова должны иметь заданную длину, например от до , поэтому размер словаря заранее определить нельзя. Чтобы получить подслова переменной длины в словаре фиксированного размера, можно применить алгоритм сжатия, называемый кодированием пар байтов (byte pair encoding, BPE), для извлечения подслов (Sennrich et al., 2015).
Кодирование пар байтов проводит статистический анализ обучающего набора данных, чтобы найти общие символы внутри слов — последовательности подряд идущих знаков произвольной длины. Начиная с символов длины 1, BPE итеративно объединяет самые частые пары подряд идущих символов, порождая новые, более длинные символы. Для эффективности пары, пересекающие границы слов, не рассматриваются. В итоге слова можно разбивать на подслова, составленные из таких символов. BPE и его варианты использовались для входных представлений в предобученных моделях обработки естественного языка, таких как GPT-2 (Radford et al., 2019) и RoBERTa (Liu et al., 2019). Ниже мы покажем, как работает кодирование пар байтов.
Сначала инициализируем словарь символов всеми строчными буквами английского алфавита, специальным символом конца слова '_' и специальным символом неизвестного токена '[UNK]'.
MXNet, PyTorch:
import collections
symbols = ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j', 'k', 'l', 'm',
'n', 'o', 'p', 'q', 'r', 's', 't', 'u', 'v', 'w', 'x', 'y', 'z',
'_', '[UNK]']
PaddlePaddle:
import collections
symbols = ['a', 'b', 'c', 'd', 'e', 'f', 'g', 'h', 'i', 'j', 'k', 'l', 'm',
'n', 'o', 'p', 'q', 'r', 's', 't', 'u', 'v', 'w', 'x', 'y', 'z',
'_', '[UNK]']
Поскольку пары символов, пересекающие границы слов, не рассматриваются, нам нужен только словарь raw_token_freqs, отображающий слова в их частоты (число вхождений) в наборе данных. Обратите внимание: специальный символ '_' добавляется в конец каждого слова, чтобы по выходной последовательности символов (например, «a_ tall er_ man») легко восстановить последовательность слов (например, «a taller man»). Поскольку мы начинаем процесс слияния только с одиночных символов и специальных символов, между каждой парой подряд идущих символов внутри каждого слова (ключа словаря token_freqs) вставляется пробел. Иными словами, пробел — разделитель между символами слова.
raw_token_freqs = {'fast_': 4, 'faster_': 3, 'tall_': 5, 'taller_': 4}
token_freqs = {}
for token, freq in raw_token_freqs.items():
token_freqs[' '.join(list(token))] = raw_token_freqs[token]
token_freqs
Определим функцию get_max_freq_pair, которая возвращает самую частую пару подряд идущих символов внутри слов; слова берутся из ключей входного словаря token_freqs.
def get_max_freq_pair(token_freqs):
pairs = collections.defaultdict(int)
for token, freq in token_freqs.items():
symbols = token.split()
for i in range(len(symbols) - 1):
# Ключ «pairs» — кортеж из двух подряд идущих символов
pairs[symbols[i], symbols[i + 1]] += freq
return max(pairs, key=pairs.get) # Ключ «pairs» с наибольшим значением
Как жадный метод, основанный на частотах подряд идущих символов, кодирование пар байтов использует следующую функцию merge_symbols, чтобы объединить самую частую пару подряд идущих символов и получить новый символ.
def merge_symbols(max_freq_pair, token_freqs, symbols):
symbols.append(''.join(max_freq_pair))
new_token_freqs = dict()
for token, freq in token_freqs.items():
new_token = token.replace(' '.join(max_freq_pair),
''.join(max_freq_pair))
new_token_freqs[new_token] = token_freqs[token]
return new_token_freqs
Теперь итеративно выполним алгоритм кодирования пар байтов над ключами словаря token_freqs. На первой итерации самая частая пара подряд идущих символов — 't' и 'a', поэтому BPE объединяет их в новый символ 'ta'. На второй итерации BPE продолжает объединять 'ta' и 'l' и получает ещё один новый символ 'tal'.
num_merges = 10
for i in range(num_merges):
max_freq_pair = get_max_freq_pair(token_freqs)
token_freqs = merge_symbols(max_freq_pair, token_freqs, symbols)
print(f'слияние № {i+1}:',max_freq_pair)
После 10 итераций кодирования пар байтов видно, что список symbols теперь содержит ещё 10 символов, итеративно полученных слиянием из других символов.
print(symbols)
Для того же набора данных, заданного ключами словаря raw_token_freqs, в результате алгоритма кодирования пар байтов каждое слово набора теперь разбито на подслова «fast_», «fast», «er_», «tall_» и «tall». Например, слова «faster_» и «taller_» разбиты на «fast er_» и «tall er_» соответственно.
print(list(token_freqs.keys()))
Заметим, что результат кодирования пар байтов зависит от используемого набора данных. Подслова, выученные на одном наборе данных, можно использовать и для разбиения слов другого набора. Как жадный метод, следующая функция segment_BPE пытается разбить слова на самые длинные подслова из входного параметра symbols.
def segment_BPE(tokens, symbols):
outputs = []
for token in tokens:
start, end = 0, len(token)
cur_output = []
# Сегментируем токен самыми длинными подсловами из symbols
while start < len(token) and start < end:
if token[start: end] in symbols:
cur_output.append(token[start: end])
start = end
end = len(token)
else:
end -= 1
if start < len(token):
cur_output.append('[UNK]')
outputs.append(' '.join(cur_output))
return outputs
Мы используем подслова из списка symbols (выученные на описанном выше наборе данных), чтобы представить tokens из другого набора данных.
tokens = ['tallest_', 'fatter_']
print(segment_BPE(tokens, symbols))
Резюме
- Модель fastText предлагает метод вложения подслов: на основе модели skip-gram из word2vec она представляет центральное слово суммой векторов его подслов.
- Кодирование пар байтов проводит статистический анализ обучающего набора данных, чтобы найти общие символы внутри слов. Как жадный метод, оно итеративно объединяет самые частые пары подряд идущих символов.
- Вложения подслов могут улучшить качество представлений редких слов и слов вне словаря.
Упражнения
- Например, в английском языке около возможных -грамм. Какая проблема возникает при слишком большом числе подслов? Как её решить? Подсказка: см. конец раздела 3.2 статьи о fastText (Bojanowski et al., 2017).
- Как спроектировать модель вложений подслов на основе модели непрерывного мешка слов?
- Сколько операций слияния нужно, чтобы получить словарь размера , если размер начального словаря символов равен ?
- Как расширить идею кодирования пар байтов, чтобы извлекать фразы?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Bojanowski, P., Grave, E., Joulin, A., & Mikolov, T. (2017). Enriching word vectors with subword information. Transactions of the Association for Computational Linguistics, 5, 135–146.
- Sennrich, R., Haddow, B., & Birch, A. (2015). Neural machine translation of rare words with subword units. arXiv preprint arXiv:1508.07909.
- Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., & Sutskever, I. (2019). Language models are unsupervised multitask learners. OpenAI Blog, 1(8), 9.
- Liu, Y., Ott, M., Goyal, N., Du, J., Joshi, M., Chen, D., Levy, O., Lewis, M., Zettlemoyer, L., & Stoyanov, V. (2019). Roberta: A robustly optimized bert pretraining approach. arXiv preprint arXiv:1907.11692.
14.7 Сходство слов и задачи на аналогии
В разделе 14.4 мы обучили модель word2vec на небольшом наборе данных и применили её, чтобы находить слова, семантически близкие к заданному. На практике векторы слов, предобученные на больших корпусах, можно применять в прикладных задачах обработки естественного языка, о чём пойдёт речь в главе 15. Чтобы наглядно продемонстрировать семантику предобученных на больших корпусах векторов слов, применим их к задачам на сходство слов и аналогии.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
import os
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
import os
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
import os
14.7.1 Загрузка предобученных векторов слов
Ниже перечислены предобученные вложения GloVe размерностей 50, 100 и 300; их можно скачать с сайта GloVe. Предобученные вложения fastText есть для многих языков. Здесь мы используем английскую версию размерности 300 («wiki.en»), которую можно скачать с сайта fastText.
#@save
d2l.DATA_HUB['glove.6b.50d'] = (d2l.DATA_URL + 'glove.6B.50d.zip',
'0b8703943ccdb6eb788e6f091b8946e82231bc4d')
#@save
d2l.DATA_HUB['glove.6b.100d'] = (d2l.DATA_URL + 'glove.6B.100d.zip',
'cd43bfb07e44e6f27cbcc7bc9ae3d80284fdaf5a')
#@save
d2l.DATA_HUB['glove.42b.300d'] = (d2l.DATA_URL + 'glove.42B.300d.zip',
'b5116e234e9eb9076672cfeabf5469f3eec904fa')
#@save
d2l.DATA_HUB['wiki.en'] = (d2l.DATA_URL + 'wiki.en.zip',
'c1816da3821ae9f43899be655002f6c723e91b88')
Чтобы загрузить эти предобученные вложения GloVe и fastText, определим следующий класс TokenEmbedding.
#@save
class TokenEmbedding:
"""Вложения токенов (GloVe, fastText)"""
def __init__(self, embedding_name):
self.idx_to_token, self.idx_to_vec = self._load_embedding(
embedding_name)
self.unknown_idx = 0
self.token_to_idx = {token: idx for idx, token in
enumerate(self.idx_to_token)}
def _load_embedding(self, embedding_name):
idx_to_token, idx_to_vec = ['<unk>'], []
data_dir = d2l.download_extract(embedding_name)
# Сайт GloVe: https://nlp.stanford.edu/projects/glove/
# Сайт fastText: https://fasttext.cc/
with open(os.path.join(data_dir, 'vec.txt'), 'r') as f:
for line in f:
elems = line.rstrip().split(' ')
token, elems = elems[0], [float(elem) for elem in elems[1:]]
# Пропускаем заголовок, например первую строку в fastText
if len(elems) > 1:
idx_to_token.append(token)
idx_to_vec.append(elems)
idx_to_vec = [[0] * len(idx_to_vec[0])] + idx_to_vec
return idx_to_token, d2l.tensor(idx_to_vec)
def __getitem__(self, tokens):
indices = [self.token_to_idx.get(token, self.unknown_idx)
for token in tokens]
vecs = self.idx_to_vec[d2l.tensor(indices)]
return vecs
def __len__(self):
return len(self.idx_to_token)
Ниже мы загружаем 50-мерные вложения GloVe (предобученные на части «Википедии»). При создании экземпляра TokenEmbedding указанный файл вложений нужно скачать, если этого ещё не сделано.
glove_6b50d = TokenEmbedding('glove.6b.50d')
Выведем размер словаря. Он содержит 400 000 слов (токенов) и один специальный неизвестный токен.
len(glove_6b50d)
Можно получить индекс слова в словаре и наоборот.
glove_6b50d.token_to_idx['beautiful'], glove_6b50d.idx_to_token[3367]
14.7.2 Применение предобученных векторов слов
С помощью загруженных векторов GloVe мы продемонстрируем семантику векторов слов на следующих задачах на сходство слов и аналогии.
14.7.2.1 Сходство слов
Подобно разделу 14.4.3, чтобы находить для заданного слова семантически близкие по косинусному сходству их векторов, мы реализуем следующую функцию knn ( ближайших соседей).
MXNet:
def knn(W, x, k):
# Добавляем 1e-9 для численной устойчивости
cos = np.dot(W, x.reshape(-1,)) / (
np.sqrt(np.sum(W * W, axis=1) + 1e-9) * np.sqrt((x * x).sum()))
topk = npx.topk(cos, k=k, ret_typ='indices')
return topk, [cos[int(i)] for i in topk]
PyTorch:
def knn(W, x, k):
# Добавляем 1e-9 для численной устойчивости
cos = torch.mv(W, x.reshape(-1,)) / (
torch.sqrt(torch.sum(W * W, axis=1) + 1e-9) *
torch.sqrt((x * x).sum()))
_, topk = torch.topk(cos, k=k)
return topk, [cos[int(i)] for i in topk]
PaddlePaddle:
def knn(W, x, k):
# Добавляем 1e-9 для численной устойчивости
cos = paddle.mv(W, x) / (
paddle.sqrt(paddle.sum(W * W, axis=1) + 1e-9) *
paddle.sqrt((x * x).sum()))
_, topk = paddle.topk(cos, k=k)
return topk, [cos[int(i)] for i in topk]
Затем мы ищем похожие слова, используя предобученные векторы слов из экземпляра embed класса TokenEmbedding.
def get_similar_tokens(query_token, k, embed):
topk, cos = knn(embed.idx_to_vec, embed[[query_token]], k + 1)
for i, c in zip(topk[1:], cos[1:]): # Исключаем входное слово
print(f'{embed.idx_to_token[int(i)]}: косинусное сходство={float(c):.3f}')
Словарь предобученных векторов слов glove_6b50d содержит 400 000 слов и один специальный неизвестный токен. Исключив входное слово и неизвестный токен, найдём в словаре три слова, семантически наиболее близких к слову «chip».
get_similar_tokens('chip', 3, glove_6b50d)
Ниже выводятся слова, близкие к «baby» и «beautiful».
get_similar_tokens('baby', 3, glove_6b50d)
get_similar_tokens('beautiful', 3, glove_6b50d)
14.7.2.2 Аналогии слов
Помимо поиска похожих слов, векторы слов можно применять к задаче на аналогии слов. Например, «man» : «woman» :: «son» : «daughter» — аналогия слов: «man» относится к «woman» так же, как «son» к «daughter». Точнее, задачу на аналогию слов можно определить так: для словесной аналогии заданы первые три слова , и , нужно найти . Обозначим вектор слова через . Чтобы решить аналогию, мы найдём слово, вектор которого наиболее похож на результат .
def get_analogy(token_a, token_b, token_c, embed):
vecs = embed[[token_a, token_b, token_c]]
x = vecs[1] - vecs[0] + vecs[2]
topk, cos = knn(embed.idx_to_vec, x, 1)
return embed.idx_to_token[int(topk[0])] # Исключаем неизвестное слово
Проверим на загруженных векторах слов аналогию «мужской — женский род».
get_analogy('man', 'woman', 'son', glove_6b50d)
Ниже — аналогия «столица — страна»: «beijing» : «china» :: «tokyo» : «japan». Она демонстрирует семантику предобученных векторов слов.
get_analogy('beijing', 'china', 'tokyo', glove_6b50d)
Кроме того, для аналогий «прилагательное — превосходная степень», например «bad» : «worst» :: «big» : «biggest», предобученные векторы слов могут улавливать синтаксическую информацию.
get_analogy('bad', 'worst', 'big', glove_6b50d)
Чтобы показать, что предобученные векторы слов улавливают понятие прошедшего времени, можно проверить синтаксис на аналогии «настоящее время — прошедшее время»: «do» : «did» :: «go» : «went».
get_analogy('do', 'did', 'go', glove_6b50d)
Резюме
- На практике векторы слов, предобученные на больших корпусах, можно применять в прикладных задачах обработки естественного языка.
- Предобученные векторы слов можно применять к задачам на сходство слов и аналогии.
Упражнения
- Проверьте результаты fastText с помощью
TokenEmbedding('wiki.en'). - Если словарь очень велик, как быстрее находить похожие слова или решать задачу на аналогию слов?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
14.8 Двунаправленные представления кодировщика Transformer (BERT)
Мы познакомились с несколькими моделями вложений слов для понимания естественного языка. После предобучения результат можно считать матрицей, каждая строка которой — вектор, представляющий слово предопределённого словаря. Фактически все эти модели вложений слов не зависят от контекста. Сначала проиллюстрируем это свойство.
14.8.1 От контекстно-независимых представлений к контекстно-зависимым
Вспомним эксперименты из разделов 14.4 и 14.7. Например, и word2vec, и GloVe присваивают одному и тому же слову один и тот же предобученный вектор независимо от контекста слова (если он есть). Формально контекстно-независимое представление любого токена — это функция , которая принимает на вход только . Учитывая обилие полисемии и сложную семантику естественного языка, у контекстно-независимых представлений есть очевидные ограничения. Например, слово «crane» в контекстах «a crane is flying» («летит журавль») и «a crane driver came» («пришёл крановщик») имеет совершенно разные значения; поэтому одному и тому же слову в зависимости от контекста можно присваивать разные представления.
Это стимулировало развитие «контекстно-зависимых» представлений слов, где представление слова зависит от его контекста. Поэтому контекстно-зависимое представление токена — функция , зависящая от и его контекста . Популярные контекстно-зависимые представления включают TagLM (language-model-augmented sequence tagger — разметчик последовательностей, дополненный языковой моделью) (Peters et al., 2017), CoVe (Context Vectors — контекстные векторы) (McCann et al., 2017) и ELMo (Embeddings from Language Models — вложения из языковых моделей) (Peters et al., 2018).
Например, принимая на вход всю последовательность, ELMo — это функция, которая присваивает представление каждому слову входной последовательности. Точнее, ELMo объединяет представления всех промежуточных слоёв предобученной двунаправленной LSTM в выходное представление. Затем представление ELMo добавляется как дополнительный признак в существующую контролируемую модель для прикладной задачи, например конкатенацией представления ELMo с исходным представлением токена (например, GloVe) в существующей модели. С одной стороны, после добавления представлений ELMo все веса в предобученной двунаправленной LSTM замораживаются. С другой стороны, существующая контролируемая модель специально настроена под данную задачу. Если для разных задач брать разные лучшие на тот момент модели, то добавление ELMo улучшало лучшие известные результаты (state of the art) в шести задачах обработки естественного языка: анализе тональности, логическом выводе на естественном языке, разметке семантических ролей, разрешении кореференции, распознавании именованных сущностей и ответах на вопросы.
14.8.2 От специфичных для задачи к независимым от задачи моделям
Хотя ELMo значительно улучшил решения для ряда задач обработки естественного языка, каждое решение по-прежнему опирается на специфичную для задачи архитектуру. Однако спроектировать конкретную архитектуру для каждой задачи обработки естественного языка на практике непросто. Модель GPT (Generative Pre-Training — генеративное предобучение) предлагает универсальную, не зависящую от задачи модель для контекстно-зависимых представлений (Radford et al., 2018). GPT построена на декодировщике Transformer и предобучает языковую модель, которая будет использоваться для представления текстовых последовательностей. При применении GPT к прикладной задаче выход языковой модели подаётся в дополнительный линейный выходной слой для предсказания метки задачи. В отличие от ELMo, замораживающего параметры предобученной модели, GPT дообучает все параметры предобученного декодировщика Transformer в ходе контролируемого обучения прикладной задачи. GPT оценивалась на двенадцати задачах — логический вывод на естественном языке, ответы на вопросы, сходство предложений и классификация — и улучшила лучшие известные результаты в девяти из них при минимальных изменениях архитектуры модели.
Однако из-за авторегрессионной природы языковых моделей GPT смотрит только вперёд (слева направо). В контекстах «i went to the bank to deposit cash» («я пошёл в банк положить наличные») и «i went to the bank to sit down» («я пошёл на берег присесть») GPT вернёт одно и то же представление «bank», поскольку оно чувствительно к левому контексту, хотя значения слова различаются.
14.8.3 BERT: лучшее из двух миров
Как мы видели, ELMo кодирует контекст двунаправленно, но использует специфичные для задачи архитектуры, а GPT не зависит от задачи, но кодирует контекст слева направо. Объединяя лучшее из двух миров, BERT (Bidirectional Encoder Representations from Transformers — двунаправленные представления кодировщика Transformer) кодирует контекст двунаправленно и требует лишь минимальных изменений архитектуры для широкого круга задач обработки естественного языка (Devlin et al., 2018). Используя предобученный кодировщик Transformer, BERT способен представить любой токен на основе его двунаправленного контекста. При контролируемом обучении прикладных задач BERT похож на GPT в двух аспектах. Во-первых, представления BERT подаются в добавленный выходной слой, причём архитектура модели минимально меняется в зависимости от природы задачи, например предсказание для каждого токена или для всей последовательности. Во-вторых, все параметры предобученного кодировщика Transformer дообучаются, а дополнительный выходной слой обучается с нуля. На рис. 14.8.1 показаны различия между ELMo, GPT и BERT.
Рис. 14.8.1. Сравнение ELMo, GPT и BERT
BERT улучшил лучшие известные результаты в 11 задачах обработки естественного языка, которые делятся на следующие категории: (1) классификация одиночного текста (например, анализ тональности), (2) классификация пар текстов (например, логический вывод на естественном языке), (3) ответы на вопросы, (4) разметка текста (например, распознавание именованных сущностей). Все эти модели — от контекстно-зависимого ELMo до независимых от задачи GPT и BERT — были предложены в 2018 году. Концептуально простое, но эмпирически мощное глубокое предобучение представлений естественного языка совершило переворот в решениях разных задач обработки естественного языка.
В остальной части этой главы мы подробно рассмотрим подготовку BERT к обучению. Когда в главе 15 мы будем объяснять приложения обработки естественного языка, мы покажем дообучение BERT для прикладных задач.
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
14.8.4 Входное представление
В обработке естественного языка одни задачи (например, анализ тональности) принимают на вход один текст, а другие (например, логический вывод на естественном языке) — пару текстовых последовательностей. Входная последовательность BERT однозначно представляет и одиночный текст, и пару текстов. Если вход — одиночный текст, входная последовательность BERT — это конкатенация специального токена класса <cls>, токенов текстовой последовательности и специального разделяющего токена <sep>. Если вход — пара текстов, входная последовательность BERT — это конкатенация <cls>, токенов первой текстовой последовательности, <sep>, токенов второй текстовой последовательности и <sep>. Мы будем последовательно отличать термин «входная последовательность BERT» от других видов «последовательностей». Например, одна входная последовательность BERT может включать либо одну текстовую последовательность, либо две текстовые последовательности.
Чтобы различать пары текстов, обученные вложения сегментов и добавляются к вложениям токенов первой и второй последовательностей соответственно. Для входа из одного текста используется только .
Следующая функция get_tokens_and_segments принимает на вход одно или два предложения и возвращает токены входной последовательности BERT и соответствующие им индексы сегментов.
#@save
def get_tokens_and_segments(tokens_a, tokens_b=None):
"""Возвращает токены входной последовательности BERT и индексы их сегментов"""
tokens = ['<cls>'] + tokens_a + ['<sep>']
# 0 и 1 отмечают сегменты A и B соответственно
segments = [0] * (len(tokens_a) + 2)
if tokens_b is not None:
tokens += tokens_b + ['<sep>']
segments += [1] * (len(tokens_b) + 1)
return tokens, segments
В качестве двунаправленной архитектуры BERT выбирает кодировщик Transformer. В кодировщике Transformer позиционные вложения добавляются к каждой позиции входной последовательности. Однако в отличие от исходного кодировщика Transformer BERT использует обучаемые позиционные вложения. Итак, на рис. 14.8.2 показано, что вложение входной последовательности BERT — это сумма вложений токенов, вложений сегментов и позиционных вложений.
Рис. 14.8.2. Вложение входной последовательности BERT — сумма вложений токенов, вложений сегментов и позиционных вложений
Следующий класс BERTEncoder похож на класс TransformerEncoder, реализованный в разделе 10.7. В отличие от TransformerEncoder, BERTEncoder использует вложения сегментов и обучаемые позиционные вложения.
MXNet:
#@save
class BERTEncoder(nn.Block):
"""Кодировщик BERT"""
def __init__(self, vocab_size, num_hiddens, ffn_num_hiddens, num_heads,
num_layers, dropout, max_len=1000, **kwargs):
super(BERTEncoder, self).__init__(**kwargs)
self.token_embedding = nn.Embedding(vocab_size, num_hiddens)
self.segment_embedding = nn.Embedding(2, num_hiddens)
self.blks = nn.Sequential()
for _ in range(num_layers):
self.blks.add(d2l.EncoderBlock(
num_hiddens, ffn_num_hiddens, num_heads, dropout, True))
# В BERT позиционные вложения обучаемые, поэтому мы создаём
# параметр позиционных вложений достаточной длины
self.pos_embedding = self.params.get('pos_embedding',
shape=(1, max_len, num_hiddens))
def forward(self, tokens, segments, valid_lens):
# В следующем фрагменте кода форма X остаётся прежней:
# (размер минибатча, максимальная длина последовательности, num_hiddens)
X = self.token_embedding(tokens) + self.segment_embedding(segments)
X = X + self.pos_embedding.data(ctx=X.ctx)[:, :X.shape[1], :]
for blk in self.blks:
X = blk(X, valid_lens)
return X
PyTorch:
#@save
class BERTEncoder(nn.Module):
"""Кодировщик BERT"""
def __init__(self, vocab_size, num_hiddens, norm_shape, ffn_num_input,
ffn_num_hiddens, num_heads, num_layers, dropout,
max_len=1000, key_size=768, query_size=768, value_size=768,
**kwargs):
super(BERTEncoder, self).__init__(**kwargs)
self.token_embedding = nn.Embedding(vocab_size, num_hiddens)
self.segment_embedding = nn.Embedding(2, num_hiddens)
self.blks = nn.Sequential()
for i in range(num_layers):
self.blks.add_module(f"{i}", d2l.EncoderBlock(
key_size, query_size, value_size, num_hiddens, norm_shape,
ffn_num_input, ffn_num_hiddens, num_heads, dropout, True))
# В BERT позиционные вложения обучаемые, поэтому мы создаём
# параметр позиционных вложений достаточной длины
self.pos_embedding = nn.Parameter(torch.randn(1, max_len,
num_hiddens))
def forward(self, tokens, segments, valid_lens):
# В следующем фрагменте кода форма X остаётся прежней:
# (размер минибатча, максимальная длина последовательности, num_hiddens)
X = self.token_embedding(tokens) + self.segment_embedding(segments)
X = X + self.pos_embedding.data[:, :X.shape[1], :]
for blk in self.blks:
X = blk(X, valid_lens)
return X
PaddlePaddle:
#@save
class BERTEncoder(nn.Layer):
"""Кодировщик BERT"""
def __init__(self, vocab_size, num_hiddens, norm_shape, ffn_num_input,
ffn_num_hiddens, num_heads, num_layers, dropout,
max_len=1000, key_size=768, query_size=768, value_size=768,
**kwargs):
super(BERTEncoder, self).__init__(**kwargs)
self.token_embedding = nn.Embedding(vocab_size, num_hiddens)
self.segment_embedding = nn.Embedding(2, num_hiddens)
self.blks = nn.Sequential()
for i in range(num_layers):
self.blks.add_sublayer(f"{i}", d2l.EncoderBlock(
key_size, query_size, value_size, num_hiddens, norm_shape,
ffn_num_input, ffn_num_hiddens, num_heads, dropout, True))
# В BERT позиционные вложения обучаемые, поэтому мы создаём
# параметр позиционных вложений достаточной длины
x = paddle.randn([1, max_len, num_hiddens])
self.pos_embedding = paddle.create_parameter(shape=x.shape, dtype=str(x.numpy().dtype),
default_initializer=paddle.nn.initializer.Assign(x))
def forward(self, tokens, segments, valid_lens):
# В следующем фрагменте кода форма X остаётся прежней:
# (размер минибатча, максимальная длина последовательности, num_hiddens)
X = self.token_embedding(tokens) + self.segment_embedding(segments)
X = X + self.pos_embedding[:, :X.shape[1], :]
for blk in self.blks:
X = blk(X, valid_lens)
return X
Допустим, размер словаря равен 10 000. Чтобы продемонстрировать прямое распространение BERTEncoder, создадим экземпляр и инициализируем его параметры.
MXNet:
vocab_size, num_hiddens, ffn_num_hiddens, num_heads = 10000, 768, 1024, 4
num_layers, dropout = 2, 0.2
encoder = BERTEncoder(vocab_size, num_hiddens, ffn_num_hiddens, num_heads,
num_layers, dropout)
encoder.initialize()
PyTorch, PaddlePaddle:
vocab_size, num_hiddens, ffn_num_hiddens, num_heads = 10000, 768, 1024, 4
norm_shape, ffn_num_input, num_layers, dropout = [768], 768, 2, 0.2
encoder = BERTEncoder(vocab_size, num_hiddens, norm_shape, ffn_num_input,
ffn_num_hiddens, num_heads, num_layers, dropout)
Мы определяем tokens как 2 входные последовательности длины 8, где каждый токен — индекс словаря. Прямое распространение BERTEncoder с входом tokens возвращает результат кодирования, в котором каждый токен представлен вектором, длина которого определяется гиперпараметром num_hiddens. Этот гиперпараметр обычно называют скрытым размером (числом скрытых элементов) кодировщика Transformer.
MXNet:
tokens = np.random.randint(0, vocab_size, (2, 8))
segments = np.array([[0, 0, 0, 0, 1, 1, 1, 1], [0, 0, 0, 1, 1, 1, 1, 1]])
encoded_X = encoder(tokens, segments, None)
encoded_X.shape
PyTorch:
tokens = torch.randint(0, vocab_size, (2, 8))
segments = torch.tensor([[0, 0, 0, 0, 1, 1, 1, 1], [0, 0, 0, 1, 1, 1, 1, 1]])
encoded_X = encoder(tokens, segments, None)
encoded_X.shape
PaddlePaddle:
tokens = paddle.randint(0, vocab_size, (2, 8))
segments = paddle.to_tensor([[0, 0, 0, 0, 1, 1, 1, 1], [0, 0, 0, 1, 1, 1, 1, 1]])
encoded_X = encoder(tokens, segments, None)
encoded_X.shape
14.8.5 Задачи предобучения
Прямое распространение BERTEncoder даёт представления BERT для каждого токена входного текста и для вставленных специальных токенов <cls> и <sep>. Далее мы используем эти представления, чтобы вычислить функцию потерь для предобучения BERT. Предобучение включает две задачи: маскированную языковую модель и предсказание следующего предложения.
14.8.5.1 Маскированная языковая модель (Masked Language Modeling)
Как показано в разделе 8.3, языковая модель предсказывает токен по контексту слева. Чтобы двунаправленно кодировать контекст для представления каждого токена, BERT случайно маскирует токены и самоконтролируемо предсказывает замаскированные токены по токенам двунаправленного контекста. Эту задачу называют маскированной языковой моделью.
В этой задаче предобучения 15% токенов случайно выбираются как замаскированные токены для предсказания. Чтобы предсказывать замаскированный токен, не «подсматривая» метку, простой подход — всегда заменять его во входной последовательности специальным токеном <mask>. Однако искусственный специальный токен <mask> никогда не появляется при дообучении. Чтобы избежать такого рассогласования между предобучением и дообучением, если токен замаскирован для предсказания (например, в предложении «this movie is great» выбран для маскирования и предсказания токен «great»), то во входной последовательности он заменяется на:
- специальный токен
<mask>в 80% случаев (например, «this movie is great» превращается в «this movie is<mask>»); - случайный токен в 10% случаев (например, «this movie is great» превращается в «this movie is drink»);
- неизменный токен-метку в 10% случаев (например, «this movie is great» превращается в «this movie is great»).
Заметим, что в 10% из 15% случаев вставляется случайный токен. Этот случайный шум побуждает BERT меньше смещаться в сторону замаскированного токена (особенно когда токен-метка остаётся без изменений) при двунаправленном кодировании контекста.
Мы реализуем следующий класс MaskLM для предсказания замаскированных токенов в задаче маскированной языковой модели при предобучении BERT. В предсказании используется многослойный перцептрон с одним скрытым слоем (self.mlp). При прямом распространении он принимает два входа: результат кодирования BERTEncoder и позиции токенов для предсказания. Выход — результаты предсказания в этих позициях.
MXNet:
#@save
class MaskLM(nn.Block):
"""Задача маскированной языковой модели BERT"""
def __init__(self, vocab_size, num_hiddens, **kwargs):
super(MaskLM, self).__init__(**kwargs)
self.mlp = nn.Sequential()
self.mlp.add(
nn.Dense(num_hiddens, flatten=False, activation='relu'))
self.mlp.add(nn.LayerNorm())
self.mlp.add(nn.Dense(vocab_size, flatten=False))
def forward(self, X, pred_positions):
num_pred_positions = pred_positions.shape[1]
pred_positions = pred_positions.reshape(-1)
batch_size = X.shape[0]
batch_idx = np.arange(0, batch_size)
# Допустим, batch_size=2, num_pred_positions=3,
# тогда batch_idx — это np.array([0, 0, 0, 1, 1, 1])
batch_idx = np.repeat(batch_idx, num_pred_positions)
masked_X = X[batch_idx, pred_positions]
masked_X = masked_X.reshape((batch_size, num_pred_positions, -1))
mlm_Y_hat = self.mlp(masked_X)
return mlm_Y_hat
PyTorch:
#@save
class MaskLM(nn.Module):
"""Задача маскированной языковой модели BERT"""
def __init__(self, vocab_size, num_hiddens, num_inputs=768, **kwargs):
super(MaskLM, self).__init__(**kwargs)
self.mlp = nn.Sequential(nn.Linear(num_inputs, num_hiddens),
nn.ReLU(),
nn.LayerNorm(num_hiddens),
nn.Linear(num_hiddens, vocab_size))
def forward(self, X, pred_positions):
num_pred_positions = pred_positions.shape[1]
pred_positions = pred_positions.reshape(-1)
batch_size = X.shape[0]
batch_idx = torch.arange(0, batch_size)
# Допустим, batch_size=2, num_pred_positions=3,
# тогда batch_idx — это np.array([0, 0, 0, 1, 1, 1])
batch_idx = torch.repeat_interleave(batch_idx, num_pred_positions)
masked_X = X[batch_idx, pred_positions]
masked_X = masked_X.reshape((batch_size, num_pred_positions, -1))
mlm_Y_hat = self.mlp(masked_X)
return mlm_Y_hat
PaddlePaddle:
#@save
class MaskLM(nn.Layer):
"""Задача маскированной языковой модели BERT"""
def __init__(self, vocab_size, num_hiddens, num_inputs=768, **kwargs):
super(MaskLM, self).__init__(**kwargs)
self.mlp = nn.Sequential(nn.Linear(num_inputs, num_hiddens),
nn.ReLU(),
nn.LayerNorm(num_hiddens),
nn.Linear(num_hiddens, vocab_size))
def forward(self, X, pred_positions):
num_pred_positions = pred_positions.shape[1]
pred_positions = pred_positions.reshape([-1])
batch_size = X.shape[0]
batch_idx = paddle.arange(0, batch_size)
# Допустим, batch_size=2, num_pred_positions=3,
# тогда batch_idx — это np.array([0, 0, 0, 1, 1, 1])
batch_idx = paddle.repeat_interleave(batch_idx, num_pred_positions)
masked_X = X[batch_idx, pred_positions]
masked_X = masked_X.reshape((batch_size, num_pred_positions, -1))
mlm_Y_hat = self.mlp(masked_X)
return mlm_Y_hat
Чтобы продемонстрировать прямое распространение MaskLM, создадим его экземпляр mlm и инициализируем. Напомним, что encoded_X — результат прямого распространения BERTEncoder — представляет 2 входные последовательности BERT. Определим mlm_positions как 3 индекса для предсказания в любой из входных последовательностей encoded_X. Прямое распространение mlm возвращает результаты предсказания mlm_Y_hat во всех замаскированных позициях mlm_positions последовательности encoded_X. Для каждого предсказания размер результата равен размеру словаря.
MXNet:
mlm = MaskLM(vocab_size, num_hiddens)
mlm.initialize()
mlm_positions = np.array([[1, 5, 2], [6, 1, 5]])
mlm_Y_hat = mlm(encoded_X, mlm_positions)
mlm_Y_hat.shape
PyTorch:
mlm = MaskLM(vocab_size, num_hiddens)
mlm_positions = torch.tensor([[1, 5, 2], [6, 1, 5]])
mlm_Y_hat = mlm(encoded_X, mlm_positions)
mlm_Y_hat.shape
PaddlePaddle:
mlm = MaskLM(vocab_size, num_hiddens)
mlm_positions = paddle.to_tensor([[1, 5, 2], [6, 1, 5]])
mlm_Y_hat = mlm(encoded_X, mlm_positions)
mlm_Y_hat.shape
С истинными метками mlm_Y предсказанных токенов в замаскированных позициях и предсказаниями mlm_Y_hat можно вычислить потери кросс-энтропии для задачи маскированной языковой модели при предобучении BERT.
MXNet:
mlm_Y = np.array([[7, 8, 9], [10, 20, 30]])
loss = gluon.loss.SoftmaxCrossEntropyLoss()
mlm_l = loss(mlm_Y_hat.reshape((-1, vocab_size)), mlm_Y.reshape(-1))
mlm_l.shape
PyTorch:
mlm_Y = torch.tensor([[7, 8, 9], [10, 20, 30]])
loss = nn.CrossEntropyLoss(reduction='none')
mlm_l = loss(mlm_Y_hat.reshape((-1, vocab_size)), mlm_Y.reshape(-1))
mlm_l.shape
PaddlePaddle:
mlm_Y = paddle.to_tensor([[7, 8, 9], [10, 20, 30]])
loss = nn.CrossEntropyLoss(reduction='none')
mlm_l = loss(mlm_Y_hat.reshape((-1, vocab_size)), mlm_Y.reshape([-1]))
mlm_l.shape
14.8.5.2 Предсказание следующего предложения (Next Sentence Prediction)
Хотя маскированная языковая модель способна кодировать двунаправленный контекст для представления слов, она не моделирует явно логические отношения между парами текстов. Чтобы помочь понять отношение между двумя текстовыми последовательностями, BERT в предобучении рассматривает задачу бинарной классификации — предсказание следующего предложения. При генерации пар предложений для предобучения в половине случаев это действительно подряд идущие предложения с меткой «истина»; в другой половине случаев второе предложение случайно выбирается из корпуса и помечается как «ложь».
Следующий класс NextSentencePred с помощью многослойного перцептрона с одним скрытым слоем предсказывает, является ли второе предложение следующим за первым во входной последовательности BERT. Благодаря самовниманию в кодировщике Transformer представление BERT специального токена <cls> уже кодирует оба входных предложения. Поэтому выходной слой (self.output) классификатора-перцептрона принимает на вход X — выход скрытого слоя перцептрона, входом которого служит закодированный токен <cls>.
MXNet:
#@save
class NextSentencePred(nn.Block):
"""Задача предсказания следующего предложения BERT"""
def __init__(self, **kwargs):
super(NextSentencePred, self).__init__(**kwargs)
self.output = nn.Dense(2)
def forward(self, X):
# Форма X: (размер минибатча, num_hiddens)
return self.output(X)
PyTorch:
#@save
class NextSentencePred(nn.Module):
"""Задача предсказания следующего предложения BERT"""
def __init__(self, num_inputs, **kwargs):
super(NextSentencePred, self).__init__(**kwargs)
self.output = nn.Linear(num_inputs, 2)
def forward(self, X):
# Форма X: (размер минибатча, num_hiddens)
return self.output(X)
PaddlePaddle:
#@save
class NextSentencePred(nn.Layer):
"""Задача предсказания следующего предложения BERT"""
def __init__(self, num_inputs, **kwargs):
super(NextSentencePred, self).__init__(**kwargs)
self.output = nn.Linear(num_inputs, 2)
def forward(self, X):
# Форма X: (размер минибатча, num_hiddens)
return self.output(X)
Видно, что прямое распространение экземпляра NextSentencePred возвращает бинарное предсказание для каждой входной последовательности BERT.
MXNet:
nsp = NextSentencePred()
nsp.initialize()
nsp_Y_hat = nsp(encoded_X)
nsp_Y_hat.shape
PyTorch:
encoded_X = torch.flatten(encoded_X, start_dim=1)
# Форма входа NSP: (размер минибатча, num_hiddens)
nsp = NextSentencePred(encoded_X.shape[-1])
nsp_Y_hat = nsp(encoded_X)
nsp_Y_hat.shape
PaddlePaddle:
encoded_X = paddle.flatten(encoded_X, start_axis=1)
# Форма входа NSP: (размер минибатча, num_hiddens)
nsp = NextSentencePred(encoded_X.shape[-1])
nsp_Y_hat = nsp(encoded_X)
nsp_Y_hat.shape
Можно также вычислить потери кросс-энтропии двух задач бинарной классификации.
MXNet:
nsp_y = np.array([0, 1])
nsp_l = loss(nsp_Y_hat, nsp_y)
nsp_l.shape
PyTorch:
nsp_y = torch.tensor([0, 1])
nsp_l = loss(nsp_Y_hat, nsp_y)
nsp_l.shape
PaddlePaddle:
nsp_y = paddle.to_tensor([0, 1])
nsp_l = loss(nsp_Y_hat, nsp_y)
nsp_l.shape
Стоит отметить, что все метки в двух описанных задачах предобучения можно получить из корпуса предобучения без ручной разметки. Исходный BERT был предобучен на объединении корпуса книг BookCorpus (Zhu et al., 2015) и английской «Википедии». Эти два текстовых корпуса огромны: в них 800 миллионов и 2,5 миллиарда слов соответственно.
14.8.6 Сборка кода
При предобучении BERT итоговая функция потерь — линейная комбинация функции потерь маскированной языковой модели и функции потерь предсказания следующего предложения. Теперь можно определить класс BERTModel, создав экземпляры трёх классов — BERTEncoder, MaskLM и NextSentencePred. Прямое распространение возвращает закодированное представление BERT encoded_X, предсказания маскированной языковой модели mlm_Y_hat и предсказание следующего предложения nsp_Y_hat.
MXNet:
#@save
class BERTModel(nn.Block):
"""Модель BERT"""
def __init__(self, vocab_size, num_hiddens, ffn_num_hiddens, num_heads,
num_layers, dropout, max_len=1000):
super(BERTModel, self).__init__()
self.encoder = BERTEncoder(vocab_size, num_hiddens, ffn_num_hiddens,
num_heads, num_layers, dropout, max_len)
self.hidden = nn.Dense(num_hiddens, activation='tanh')
self.mlm = MaskLM(vocab_size, num_hiddens)
self.nsp = NextSentencePred()
def forward(self, tokens, segments, valid_lens=None,
pred_positions=None):
encoded_X = self.encoder(tokens, segments, valid_lens)
if pred_positions is not None:
mlm_Y_hat = self.mlm(encoded_X, pred_positions)
else:
mlm_Y_hat = None
# Скрытый слой классификатора-перцептрона для предсказания следующего
# предложения; 0 — индекс токена «<cls>»
nsp_Y_hat = self.nsp(self.hidden(encoded_X[:, 0, :]))
return encoded_X, mlm_Y_hat, nsp_Y_hat
PyTorch:
#@save
class BERTModel(nn.Module):
"""Модель BERT"""
def __init__(self, vocab_size, num_hiddens, norm_shape, ffn_num_input,
ffn_num_hiddens, num_heads, num_layers, dropout,
max_len=1000, key_size=768, query_size=768, value_size=768,
hid_in_features=768, mlm_in_features=768,
nsp_in_features=768):
super(BERTModel, self).__init__()
self.encoder = BERTEncoder(vocab_size, num_hiddens, norm_shape,
ffn_num_input, ffn_num_hiddens, num_heads, num_layers,
dropout, max_len=max_len, key_size=key_size,
query_size=query_size, value_size=value_size)
self.hidden = nn.Sequential(nn.Linear(hid_in_features, num_hiddens),
nn.Tanh())
self.mlm = MaskLM(vocab_size, num_hiddens, mlm_in_features)
self.nsp = NextSentencePred(nsp_in_features)
def forward(self, tokens, segments, valid_lens=None,
pred_positions=None):
encoded_X = self.encoder(tokens, segments, valid_lens)
if pred_positions is not None:
mlm_Y_hat = self.mlm(encoded_X, pred_positions)
else:
mlm_Y_hat = None
# Скрытый слой классификатора-перцептрона для предсказания следующего
# предложения; 0 — индекс токена «<cls>»
nsp_Y_hat = self.nsp(self.hidden(encoded_X[:, 0, :]))
return encoded_X, mlm_Y_hat, nsp_Y_hat
PaddlePaddle:
#@save
class BERTModel(nn.Layer):
"""Модель BERT"""
def __init__(self, vocab_size, num_hiddens, norm_shape, ffn_num_input,
ffn_num_hiddens, num_heads, num_layers, dropout,
max_len=1000, key_size=768, query_size=768, value_size=768,
hid_in_features=768, mlm_in_features=768,
nsp_in_features=768):
super(BERTModel, self).__init__()
self.encoder = BERTEncoder(vocab_size, num_hiddens, norm_shape,
ffn_num_input, ffn_num_hiddens, num_heads, num_layers,
dropout, max_len=max_len, key_size=key_size,
query_size=query_size, value_size=value_size)
self.hidden = nn.Sequential(nn.Linear(hid_in_features, num_hiddens),
nn.Tanh())
self.mlm = MaskLM(vocab_size, num_hiddens, mlm_in_features)
self.nsp = NextSentencePred(nsp_in_features)
def forward(self, tokens, segments, valid_lens=None,
pred_positions=None):
encoded_X = self.encoder(tokens, segments, valid_lens)
if pred_positions is not None:
mlm_Y_hat = self.mlm(encoded_X, pred_positions)
else:
mlm_Y_hat = None
# Скрытый слой классификатора-перцептрона для предсказания следующего
# предложения; 0 — индекс токена «<cls>»
nsp_Y_hat = self.nsp(self.hidden(encoded_X[:, 0, :]))
return encoded_X, mlm_Y_hat, nsp_Y_hat
Резюме
- Модели вложений слов, такие как word2vec и GloVe, не зависят от контекста. Они присваивают одному и тому же слову один и тот же предобученный вектор независимо от контекста слова (если он есть). Им трудно справляться с полисемией и сложной семантикой в естественном языке.
- Для контекстно-зависимых представлений слов, таких как ELMo и GPT, представления слов зависят от их контекста.
- ELMo кодирует контекст двунаправленно, но использует специфичные для задачи архитектуры (хотя спроектировать конкретную архитектуру для каждой задачи обработки естественного языка на практике непросто), а GPT не зависит от задачи, но кодирует контекст слева направо.
- BERT объединяет лучшее из двух миров: он кодирует контекст двунаправленно и требует минимальных изменений архитектуры для широкого круга задач обработки естественного языка.
- Вложение входной последовательности BERT — сумма вложений токенов, вложений сегментов и позиционных вложений.
- Предобучение включает две задачи: маскированную языковую модель и предсказание следующего предложения. Первая способна кодировать двунаправленный контекст для представления слов, а вторая явно моделирует логические отношения между парами текстов.
Упражнения
- Почему BERT оказался успешным?
- При прочих равных условиях маскированной языковой модели требуется больше или меньше шагов предобучения для сходимости, чем языковой модели «слева направо»? Почему?
- В исходной реализации BERT позиционная полносвязная сеть в
BERTEncoder(черезd2l.EncoderBlock) и полносвязный слой вMaskLMиспользуют в качестве функции активации линейный элемент с гауссовой ошибкой (Gaussian error linear unit, GELU) (Hendrycks and Gimpel, 2016). Изучите различие между GELU и ReLU.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Peters, M., Ammar, W., Bhagavatula, C., & Power, R. (2017). Semi-supervised sequence tagging with bidirectional language models. In Proceedings of the 55th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 1756–1765.
- McCann, B., Bradbury, J., Xiong, C., & Socher, R. (2017). Learned in translation: Contextualized word vectors. In Advances in Neural Information Processing Systems, 6294–6305.
- Peters, M., Neumann, M., Iyyer, M., Gardner, M., Clark, C., Lee, K., & Zettlemoyer, L. (2018). Deep Contextualized Word Representations. In Proceedings of the 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long Papers), 2227–2237.
- Radford, A., Narasimhan, K., Salimans, T., & Sutskever, I. (2018). Improving language understanding by generative pre-training. OpenAI.
- Devlin, J., Chang, M. W., Lee, K., & Toutanova, K. (2018). Bert: Pre-training of deep bidirectional transformers for language understanding. arXiv preprint arXiv:1810.04805.
- Zhu, Y., Kiros, R., Zemel, R., Salakhutdinov, R., Urtasun, R., Torralba, A., & Fidler, S. (2015). Aligning books and movies: Towards story-like visual explanations by watching movies and reading books. In Proceedings of the IEEE international conference on computer vision, 19–27.
- Hendrycks, D., & Gimpel, K. (2016). Gaussian error linear units (gelus). arXiv preprint arXiv:1606.08415.
14.9 Набор данных для предобучения BERT
Чтобы предобучить модель BERT, реализованную в разделе 14.8, нужно сгенерировать набор данных в удобном формате, подходящем для двух задач предобучения: маскированной языковой модели и предсказания следующего предложения. С одной стороны, исходная модель BERT была предобучена на объединении двух огромных корпусов — BookCorpus и английской «Википедии» (см. раздел 14.8.5), — но большинству читателей этой книги это не подходит. С другой стороны, готовая предобученная модель BERT может не подойти для приложений в специфических областях, например в медицине. Поэтому предобучение BERT на собственном наборе данных становится всё популярнее. Чтобы упростить демонстрацию предобучения BERT, мы используем небольшой корпус WikiText-2 (Merity et al., 2016).
По сравнению с набором данных PTB из раздела 14.3, который использовался для предобучения word2vec, WikiText-2 (1) сохраняет исходную пунктуацию, что подходит для предсказания следующего предложения; (2) сохраняет исходный регистр и числа; (3) более чем вдвое больше.
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, np, npx
import os
import random
npx.set_np()
PyTorch:
from d2l import torch as d2l
import os
import random
import torch
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import os
import random
import paddle
В наборе данных WikiText-2 каждая строка представляет абзац, причём между любым знаком препинания и предшествующим ему токеном вставлен пробел. Сохраняются абзацы, содержащие не менее двух предложений. Для простоты мы разбиваем предложения, используя в качестве разделителя только точку. Обсуждение более сложных методов разбиения на предложения мы оставляем для упражнений в конце раздела.
#@save
d2l.DATA_HUB['wikitext-2'] = (
'https://s3.amazonaws.com/research.metamind.io/wikitext/'
'wikitext-2-v1.zip', '3c914d17d80b1459be871a5039ac23e752a53cbe')
#@save
def _read_wiki(data_dir):
file_name = os.path.join(data_dir, 'wiki.train.tokens')
with open(file_name, 'r') as f:
lines = f.readlines()
# Переводим заглавные буквы в строчные
paragraphs = [line.strip().lower().split(' . ')
for line in lines if len(line.split(' . ')) >= 2]
random.shuffle(paragraphs)
return paragraphs
14.9.1 Вспомогательные функции для задач предобучения
Ниже мы сначала реализуем вспомогательные функции для двух задач предобучения BERT. Эти функции будут вызываться позже, когда исходный текстовый корпус будет преобразован в набор данных нужного формата для предобучения BERT.
14.9.1.1 Генерация данных для задачи предсказания следующего предложения
Согласно описанию в разделе 14.8.5.2, функция _get_next_sentence генерирует обучающие примеры для задачи бинарной классификации.
#@save
def _get_next_sentence(sentence, next_sentence, paragraphs):
if random.random() < 0.5:
is_next = True
else:
# paragraphs — трижды вложенный список
next_sentence = random.choice(random.choice(paragraphs))
is_next = False
return sentence, next_sentence, is_next
Следующая функция генерирует обучающие примеры для предсказания следующего предложения из входного paragraph, вызывая _get_next_sentence. Здесь paragraph — список предложений, каждое из которых — список токенов. Аргумент max_len задаёт максимальную длину входной последовательности BERT при предобучении.
#@save
def _get_nsp_data_from_paragraph(paragraph, paragraphs, vocab, max_len):
nsp_data_from_paragraph = []
for i in range(len(paragraph) - 1):
tokens_a, tokens_b, is_next = _get_next_sentence(
paragraph[i], paragraph[i + 1], paragraphs)
# Учитываем 1 токен '<cls>' и 2 токена '<sep>'
if len(tokens_a) + len(tokens_b) + 3 > max_len:
continue
tokens, segments = d2l.get_tokens_and_segments(tokens_a, tokens_b)
nsp_data_from_paragraph.append((tokens, segments, is_next))
return nsp_data_from_paragraph
14.9.1.2 Генерация данных для задачи маскированной языковой модели
Чтобы сгенерировать обучающие примеры маскированной языковой модели из входной последовательности BERT, мы определяем следующую функцию _replace_mlm_tokens. На входе tokens — список токенов, представляющих входную последовательность BERT, candidate_pred_positions — список индексов токенов входной последовательности BERT без специальных токенов (специальные токены в задаче маскированной языковой модели не предсказываются), а num_mlm_preds указывает число предсказаний (выбирается 15% случайных токенов для предсказания). Согласно определению задачи маскированной языковой модели в разделе 14.8.5.1, в каждой позиции предсказания вход может быть заменён специальным токеном <mask> или случайным токеном либо оставлен без изменений. Наконец, функция возвращает входные токены после возможной замены, индексы токенов, в которых происходит предсказание, и метки для этих предсказаний.
#@save
def _replace_mlm_tokens(tokens, candidate_pred_positions, num_mlm_preds,
vocab):
# Создаём копию токенов для входа маскированной языковой модели, куда
# могут попасть замены '<mask>' или случайные токены
mlm_input_tokens = [token for token in tokens]
pred_positions_and_labels = []
# Перемешиваем, чтобы в задаче маскированной языковой модели получить
# 15% случайных токенов для предсказания
random.shuffle(candidate_pred_positions)
for mlm_pred_position in candidate_pred_positions:
if len(pred_positions_and_labels) >= num_mlm_preds:
break
masked_token = None
# В 80% случаев заменяем слово токеном '<mask>'
if random.random() < 0.8:
masked_token = '<mask>'
else:
# В 10% случаев оставляем слово без изменений
if random.random() < 0.5:
masked_token = tokens[mlm_pred_position]
# В 10% случаев заменяем слово случайным словом
else:
masked_token = random.choice(vocab.idx_to_token)
mlm_input_tokens[mlm_pred_position] = masked_token
pred_positions_and_labels.append(
(mlm_pred_position, tokens[mlm_pred_position]))
return mlm_input_tokens, pred_positions_and_labels
Следующая функция вызывает описанную выше функцию _replace_mlm_tokens: она принимает на вход входную последовательность BERT (tokens) и возвращает индексы входных токенов (после возможной замены токенов, описанной в разделе 14.8.5.1), индексы токенов, в которых происходит предсказание, и индексы меток для этих предсказаний.
#@save
def _get_mlm_data_from_tokens(tokens, vocab):
candidate_pred_positions = []
# tokens — список строк
for i, token in enumerate(tokens):
# Специальные токены в задаче маскированной языковой модели не предсказываются
if token in ['<cls>', '<sep>']:
continue
candidate_pred_positions.append(i)
# В задаче маскированной языковой модели предсказывается 15% случайных токенов
num_mlm_preds = max(1, round(len(tokens) * 0.15))
mlm_input_tokens, pred_positions_and_labels = _replace_mlm_tokens(
tokens, candidate_pred_positions, num_mlm_preds, vocab)
pred_positions_and_labels = sorted(pred_positions_and_labels,
key=lambda x: x[0])
pred_positions = [v[0] for v in pred_positions_and_labels]
mlm_pred_labels = [v[1] for v in pred_positions_and_labels]
return vocab[mlm_input_tokens], pred_positions, vocab[mlm_pred_labels]
14.9.2 Преобразование текста в набор данных для предобучения
Теперь мы почти готовы написать класс Dataset для предобучения BERT. Но прежде нужно определить вспомогательную функцию _pad_bert_inputs, которая дополняет входы специальными токенами <pad>. Её аргумент examples содержит выходы вспомогательных функций _get_nsp_data_from_paragraph и _get_mlm_data_from_tokens для двух задач предобучения.
MXNet:
#@save
def _pad_bert_inputs(examples, max_len, vocab):
max_num_mlm_preds = round(max_len * 0.15)
all_token_ids, all_segments, valid_lens, = [], [], []
all_pred_positions, all_mlm_weights, all_mlm_labels = [], [], []
nsp_labels = []
for (token_ids, pred_positions, mlm_pred_label_ids, segments,
is_next) in examples:
all_token_ids.append(np.array(token_ids + [vocab['<pad>']] * (
max_len - len(token_ids)), dtype='int32'))
all_segments.append(np.array(segments + [0] * (
max_len - len(segments)), dtype='int32'))
# valid_lens не включает подсчёт '<pad>'
valid_lens.append(np.array(len(token_ids), dtype='float32'))
all_pred_positions.append(np.array(pred_positions + [0] * (
max_num_mlm_preds - len(pred_positions)), dtype='int32'))
# Предсказания для дополняющих токенов отфильтровываются в потерях
# умножением на вес 0
all_mlm_weights.append(
np.array([1.0] * len(mlm_pred_label_ids) + [0.0] * (
max_num_mlm_preds - len(pred_positions)), dtype='float32'))
all_mlm_labels.append(np.array(mlm_pred_label_ids + [0] * (
max_num_mlm_preds - len(mlm_pred_label_ids)), dtype='int32'))
nsp_labels.append(np.array(is_next))
return (all_token_ids, all_segments, valid_lens, all_pred_positions,
all_mlm_weights, all_mlm_labels, nsp_labels)
PyTorch:
#@save
def _pad_bert_inputs(examples, max_len, vocab):
max_num_mlm_preds = round(max_len * 0.15)
all_token_ids, all_segments, valid_lens, = [], [], []
all_pred_positions, all_mlm_weights, all_mlm_labels = [], [], []
nsp_labels = []
for (token_ids, pred_positions, mlm_pred_label_ids, segments,
is_next) in examples:
all_token_ids.append(torch.tensor(token_ids + [vocab['<pad>']] * (
max_len - len(token_ids)), dtype=torch.long))
all_segments.append(torch.tensor(segments + [0] * (
max_len - len(segments)), dtype=torch.long))
# valid_lens не включает подсчёт '<pad>'
valid_lens.append(torch.tensor(len(token_ids), dtype=torch.float32))
all_pred_positions.append(torch.tensor(pred_positions + [0] * (
max_num_mlm_preds - len(pred_positions)), dtype=torch.long))
# Предсказания для дополняющих токенов отфильтровываются в потерях
# умножением на вес 0
all_mlm_weights.append(
torch.tensor([1.0] * len(mlm_pred_label_ids) + [0.0] * (
max_num_mlm_preds - len(pred_positions)),
dtype=torch.float32))
all_mlm_labels.append(torch.tensor(mlm_pred_label_ids + [0] * (
max_num_mlm_preds - len(mlm_pred_label_ids)), dtype=torch.long))
nsp_labels.append(torch.tensor(is_next, dtype=torch.long))
return (all_token_ids, all_segments, valid_lens, all_pred_positions,
all_mlm_weights, all_mlm_labels, nsp_labels)
PaddlePaddle:
#@save
def _pad_bert_inputs(examples, max_len, vocab):
max_num_mlm_preds = round(max_len * 0.15)
all_token_ids, all_segments, valid_lens, = [], [], []
all_pred_positions, all_mlm_weights, all_mlm_labels = [], [], []
nsp_labels = []
for (token_ids, pred_positions, mlm_pred_label_ids, segments,
is_next) in examples:
all_token_ids.append(paddle.to_tensor(token_ids + [vocab['<pad>']] * (
max_len - len(token_ids)), dtype=paddle.int64))
all_segments.append(paddle.to_tensor(segments + [0] * (
max_len - len(segments)), dtype=paddle.int64))
# valid_lens не включает подсчёт '<pad>'
valid_lens.append(paddle.to_tensor(len(token_ids), dtype=paddle.float32))
all_pred_positions.append(paddle.to_tensor(pred_positions + [0] * (
max_num_mlm_preds - len(pred_positions)), dtype=paddle.int64))
# Предсказания для дополняющих токенов отфильтровываются в потерях
# умножением на вес 0
all_mlm_weights.append(
paddle.to_tensor([1.0] * len(mlm_pred_label_ids) + [0.0] * (
max_num_mlm_preds - len(pred_positions)),
dtype=paddle.float32))
all_mlm_labels.append(paddle.to_tensor(mlm_pred_label_ids + [0] * (
max_num_mlm_preds - len(mlm_pred_label_ids)), dtype=paddle.int64))
nsp_labels.append(paddle.to_tensor(is_next, dtype=paddle.int64))
return (all_token_ids, all_segments, valid_lens, all_pred_positions,
all_mlm_weights, all_mlm_labels, nsp_labels)
С помощью вспомогательных функций для генерации обучающих примеров двух задач предобучения и вспомогательной функции для дополнения входов определим следующий класс _WikiTextDataset как набор данных WikiText-2 для предобучения BERT. Реализуя функцию __getitem__, мы можем произвольно обращаться к примерам предобучения (маскированной языковой модели и предсказания следующего предложения), сгенерированным из пар предложений корпуса WikiText-2.
Исходная модель BERT использует вложения WordPiece с размером словаря 30 000 (Wu et al., 2016). Токенизация WordPiece — это небольшая модификация исходного алгоритма кодирования пар байтов из раздела 14.6.2. Для простоты мы используем для токенизации функцию d2l.tokenize. Редкие токены, встречающиеся менее 5 раз, отфильтровываются.
MXNet:
#@save
class _WikiTextDataset(gluon.data.Dataset):
def __init__(self, paragraphs, max_len):
# Вход paragraphs[i] — список строк-предложений, представляющих абзац;
# выход paragraphs[i] — список предложений, представляющих абзац,
# где каждое предложение — список токенов
paragraphs = [d2l.tokenize(
paragraph, token='word') for paragraph in paragraphs]
sentences = [sentence for paragraph in paragraphs
for sentence in paragraph]
self.vocab = d2l.Vocab(sentences, min_freq=5, reserved_tokens=[
'<pad>', '<mask>', '<cls>', '<sep>'])
# Получаем данные для задачи предсказания следующего предложения
examples = []
for paragraph in paragraphs:
examples.extend(_get_nsp_data_from_paragraph(
paragraph, paragraphs, self.vocab, max_len))
# Получаем данные для задачи маскированной языковой модели
examples = [(_get_mlm_data_from_tokens(tokens, self.vocab)
+ (segments, is_next))
for tokens, segments, is_next in examples]
# Дополняем входы
(self.all_token_ids, self.all_segments, self.valid_lens,
self.all_pred_positions, self.all_mlm_weights,
self.all_mlm_labels, self.nsp_labels) = _pad_bert_inputs(
examples, max_len, self.vocab)
def __getitem__(self, idx):
return (self.all_token_ids[idx], self.all_segments[idx],
self.valid_lens[idx], self.all_pred_positions[idx],
self.all_mlm_weights[idx], self.all_mlm_labels[idx],
self.nsp_labels[idx])
def __len__(self):
return len(self.all_token_ids)
PyTorch:
#@save
class _WikiTextDataset(torch.utils.data.Dataset):
def __init__(self, paragraphs, max_len):
# Вход paragraphs[i] — список строк-предложений, представляющих абзац;
# выход paragraphs[i] — список предложений, представляющих абзац,
# где каждое предложение — список токенов
paragraphs = [d2l.tokenize(
paragraph, token='word') for paragraph in paragraphs]
sentences = [sentence for paragraph in paragraphs
for sentence in paragraph]
self.vocab = d2l.Vocab(sentences, min_freq=5, reserved_tokens=[
'<pad>', '<mask>', '<cls>', '<sep>'])
# Получаем данные для задачи предсказания следующего предложения
examples = []
for paragraph in paragraphs:
examples.extend(_get_nsp_data_from_paragraph(
paragraph, paragraphs, self.vocab, max_len))
# Получаем данные для задачи маскированной языковой модели
examples = [(_get_mlm_data_from_tokens(tokens, self.vocab)
+ (segments, is_next))
for tokens, segments, is_next in examples]
# Дополняем входы
(self.all_token_ids, self.all_segments, self.valid_lens,
self.all_pred_positions, self.all_mlm_weights,
self.all_mlm_labels, self.nsp_labels) = _pad_bert_inputs(
examples, max_len, self.vocab)
def __getitem__(self, idx):
return (self.all_token_ids[idx], self.all_segments[idx],
self.valid_lens[idx], self.all_pred_positions[idx],
self.all_mlm_weights[idx], self.all_mlm_labels[idx],
self.nsp_labels[idx])
def __len__(self):
return len(self.all_token_ids)
PaddlePaddle:
#@save
class _WikiTextDataset(paddle.io.Dataset):
def __init__(self, paragraphs, max_len):
# Вход paragraphs[i] — список строк-предложений, представляющих абзац;
# выход paragraphs[i] — список предложений, представляющих абзац,
# где каждое предложение — список токенов
paragraphs = [d2l.tokenize(
paragraph, token='word') for paragraph in paragraphs]
sentences = [sentence for paragraph in paragraphs
for sentence in paragraph]
self.vocab = d2l.Vocab(sentences, min_freq=5, reserved_tokens=[
'<pad>', '<mask>', '<cls>', '<sep>'])
# Получаем данные для задачи предсказания следующего предложения
examples = []
for paragraph in paragraphs:
examples.extend(_get_nsp_data_from_paragraph(
paragraph, paragraphs, self.vocab, max_len))
# Получаем данные для задачи маскированной языковой модели
examples = [(_get_mlm_data_from_tokens(tokens, self.vocab)
+ (segments, is_next))
for tokens, segments, is_next in examples]
# Дополняем входы
(self.all_token_ids, self.all_segments, self.valid_lens,
self.all_pred_positions, self.all_mlm_weights,
self.all_mlm_labels, self.nsp_labels) = _pad_bert_inputs(
examples, max_len, self.vocab)
def __getitem__(self, idx):
return (self.all_token_ids[idx], self.all_segments[idx],
self.valid_lens[idx], self.all_pred_positions[idx],
self.all_mlm_weights[idx], self.all_mlm_labels[idx],
self.nsp_labels[idx])
def __len__(self):
return len(self.all_token_ids)
С помощью функции _read_wiki и класса _WikiTextDataset мы определяем следующую функцию load_data_wiki, которая скачивает набор данных WikiText-2 и генерирует из него примеры предобучения.
MXNet:
#@save
def load_data_wiki(batch_size, max_len):
"""Загружает набор данных WikiText-2"""
num_workers = d2l.get_dataloader_workers()
data_dir = d2l.download_extract('wikitext-2', 'wikitext-2')
paragraphs = _read_wiki(data_dir)
train_set = _WikiTextDataset(paragraphs, max_len)
train_iter = gluon.data.DataLoader(train_set, batch_size, shuffle=True,
num_workers=num_workers)
return train_iter, train_set.vocab
PyTorch:
#@save
def load_data_wiki(batch_size, max_len):
"""Загружает набор данных WikiText-2"""
num_workers = d2l.get_dataloader_workers()
data_dir = d2l.download_extract('wikitext-2', 'wikitext-2')
paragraphs = _read_wiki(data_dir)
train_set = _WikiTextDataset(paragraphs, max_len)
train_iter = torch.utils.data.DataLoader(train_set, batch_size,
shuffle=True, num_workers=num_workers)
return train_iter, train_set.vocab
PaddlePaddle:
#@save
def load_data_wiki(batch_size, max_len):
"""Загружает набор данных WikiText-2"""
num_workers = d2l.get_dataloader_workers()
data_dir = d2l.download_extract('wikitext-2', 'wikitext-2')
paragraphs = _read_wiki(data_dir)
train_set = _WikiTextDataset(paragraphs, max_len)
train_iter = paddle.io.DataLoader(dataset=train_set, batch_size=batch_size, return_list=True,
shuffle=True, num_workers=num_workers)
return train_iter, train_set.vocab
Зададим размер минибатча 512 и максимальную длину входной последовательности BERT 64 и выведем формы минибатча примеров предобучения BERT. Обратите внимание: в каждой входной последовательности BERT для задачи маскированной языковой модели предсказывается () позиций.
batch_size, max_len = 512, 64
train_iter, vocab = load_data_wiki(batch_size, max_len)
for (tokens_X, segments_X, valid_lens_x, pred_positions_X, mlm_weights_X,
mlm_Y, nsp_y) in train_iter:
print(tokens_X.shape, segments_X.shape, valid_lens_x.shape,
pred_positions_X.shape, mlm_weights_X.shape, mlm_Y.shape,
nsp_y.shape)
break
Наконец, посмотрим на размер словаря. Даже после отфильтровывания редких токенов он более чем вдвое больше, чем у набора данных PTB.
len(vocab)
Резюме
- По сравнению с набором данных PTB, набор данных WikiText-2 сохраняет исходную пунктуацию, регистр и числа и более чем вдвое больше PTB.
- Мы можем произвольно обращаться к примерам предобучения (маскированной языковой модели и предсказания следующего предложения), сгенерированным из пар предложений корпуса WikiText-2.
Упражнения
- Для простоты точка используется как единственный разделитель при разбиении на предложения. Попробуйте другие методы разбиения на предложения, например из spaCy и NLTK. Возьмём NLTK: сначала нужно установить пакет:
pip install nltk. В коде сначала выполнитеimport nltk. Затем скачайте токенизатор предложений Punkt:nltk.download('punkt'). Чтобы разбить на предложения, например,sentences = 'This is great ! Why not ?', вызовnltk.tokenize.sent_tokenize(sentences)вернёт список из двух строк-предложений:['This is great !', 'Why not ?']. - Каким будет размер словаря, если не отфильтровывать редкие токены?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Merity, S., Xiong, C., Bradbury, J., & Socher, R. (2016). Pointer sentinel mixture models. arXiv preprint arXiv:1609.07843.
- Wu, Y., Schuster, M., Chen, Z., Le, Q. V., Norouzi, M., Macherey, W., Krikun, M., Cao, Y., Gao, Q., Macherey, K., & others (2016). Google’s neural machine translation system: Bridging the gap between human and machine translation. arXiv preprint arXiv:1609.08144.
14.10 Предобучение BERT
Используя модель BERT, реализованную в разделе 14.8, и примеры предобучения, сгенерированные из набора данных WikiText-2 в разделе 14.9, мы предобучим BERT на наборе данных WikiText-2 в этом разделе.
MXNet:
from d2l import mxnet as d2l
from mxnet import autograd, gluon, init, np, npx
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
Сначала мы загружаем набор данных WikiText-2 как минибатчи примеров предобучения для маскированной языковой модели и предсказания следующего предложения. Размер минибатча равен 512, максимальная длина входной последовательности BERT — 64. Заметим, что в исходной модели BERT максимальная длина равна 512.
MXNet, PyTorch:
batch_size, max_len = 512, 64
train_iter, vocab = d2l.load_data_wiki(batch_size, max_len)
PaddlePaddle:
def load_data_wiki(batch_size, max_len):
"""Загружает набор данных WikiText-2
Определено в разделе 14.9.1.2"""
data_dir = d2l.download_extract('wikitext-2', 'wikitext-2')
paragraphs = d2l._read_wiki(data_dir)
train_set = d2l._WikiTextDataset(paragraphs, max_len)
train_iter = paddle.io.DataLoader(dataset=train_set, batch_size=batch_size, return_list=True,
shuffle=True, num_workers=0)
return train_iter, train_set.vocab
batch_size, max_len = 512, 64
train_iter, vocab = load_data_wiki(batch_size, max_len)
14.10.1 Предобучение BERT
У исходного BERT (Devlin et al., 2018) есть две версии разного размера. Базовая модель () использует 12 слоёв (блоков кодировщика Transformer), 768 скрытых элементов (скрытый размер) и 12 голов самовнимания. Большая модель () использует 24 слоя, 1024 скрытых элемента и 16 голов самовнимания. Стоит отметить, что у первой 110 миллионов параметров, а у второй — 340 миллионов. Для простоты демонстрации мы определяем малый BERT с 2 слоями, 128 скрытыми элементами и 2 головами самовнимания.
MXNet:
net = d2l.BERTModel(len(vocab), num_hiddens=128, ffn_num_hiddens=256,
num_heads=2, num_layers=2, dropout=0.2)
devices = d2l.try_all_gpus()
net.initialize(init.Xavier(), ctx=devices)
loss = gluon.loss.SoftmaxCELoss()
PyTorch, PaddlePaddle:
net = d2l.BERTModel(len(vocab), num_hiddens=128, norm_shape=[128],
ffn_num_input=128, ffn_num_hiddens=256, num_heads=2,
num_layers=2, dropout=0.2, key_size=128, query_size=128,
value_size=128, hid_in_features=128, mlm_in_features=128,
nsp_in_features=128)
devices = d2l.try_all_gpus()
loss = nn.CrossEntropyLoss()
Прежде чем определять цикл обучения, определим вспомогательную функцию _get_batch_loss_bert. По обучающим примерам эта функция вычисляет потери двух задач: маскированной языковой модели и предсказания следующего предложения. Обратите внимание: итоговые потери предобучения BERT — это сумма потерь маскированной языковой модели и потерь предсказания следующего предложения.
MXNet:
#@save
def _get_batch_loss_bert(net, loss, vocab_size, tokens_X_shards,
segments_X_shards, valid_lens_x_shards,
pred_positions_X_shards, mlm_weights_X_shards,
mlm_Y_shards, nsp_y_shards):
mlm_ls, nsp_ls, ls = [], [], []
for (tokens_X_shard, segments_X_shard, valid_lens_x_shard,
pred_positions_X_shard, mlm_weights_X_shard, mlm_Y_shard,
nsp_y_shard) in zip(
tokens_X_shards, segments_X_shards, valid_lens_x_shards,
pred_positions_X_shards, mlm_weights_X_shards, mlm_Y_shards,
nsp_y_shards):
# Прямое распространение
_, mlm_Y_hat, nsp_Y_hat = net(
tokens_X_shard, segments_X_shard, valid_lens_x_shard.reshape(-1),
pred_positions_X_shard)
# Вычисляем потери маскированной языковой модели
mlm_l = loss(
mlm_Y_hat.reshape((-1, vocab_size)), mlm_Y_shard.reshape(-1),
mlm_weights_X_shard.reshape((-1, 1)))
mlm_l = mlm_l.sum() / (mlm_weights_X_shard.sum() + 1e-8)
# Вычисляем потери задачи предсказания следующего предложения
nsp_l = loss(nsp_Y_hat, nsp_y_shard)
nsp_l = nsp_l.mean()
mlm_ls.append(mlm_l)
nsp_ls.append(nsp_l)
ls.append(mlm_l + nsp_l)
npx.waitall()
return mlm_ls, nsp_ls, ls
PyTorch:
#@save
def _get_batch_loss_bert(net, loss, vocab_size, tokens_X,
segments_X, valid_lens_x,
pred_positions_X, mlm_weights_X,
mlm_Y, nsp_y):
# Прямое распространение
_, mlm_Y_hat, nsp_Y_hat = net(tokens_X, segments_X,
valid_lens_x.reshape(-1),
pred_positions_X)
# Вычисляем потери маскированной языковой модели
mlm_l = loss(mlm_Y_hat.reshape(-1, vocab_size), mlm_Y.reshape(-1)) *\
mlm_weights_X.reshape(-1, 1)
mlm_l = mlm_l.sum() / (mlm_weights_X.sum() + 1e-8)
# Вычисляем потери задачи предсказания следующего предложения
nsp_l = loss(nsp_Y_hat, nsp_y)
l = mlm_l + nsp_l
return mlm_l, nsp_l, l
PaddlePaddle:
#@save
def _get_batch_loss_bert(net, loss, vocab_size, tokens_X,
segments_X, valid_lens_x,
pred_positions_X, mlm_weights_X,
mlm_Y, nsp_y):
# Прямое распространение
_, mlm_Y_hat, nsp_Y_hat = net(tokens_X, segments_X,
valid_lens_x.reshape([-1]),
pred_positions_X)
# Вычисляем потери маскированной языковой модели
mlm_l = loss(mlm_Y_hat.reshape([-1, vocab_size]), mlm_Y.reshape([-1])) *\
mlm_weights_X.reshape([-1, 1])
mlm_l = mlm_l.sum() / (mlm_weights_X.sum() + 1e-8)
# Вычисляем потери задачи предсказания следующего предложения
nsp_l = loss(nsp_Y_hat, nsp_y)
l = mlm_l + nsp_l
return mlm_l, nsp_l, l
Вызывая две описанные вспомогательные функции, следующая функция train_bert определяет процедуру предобучения BERT (net) на наборе данных WikiText-2 (train_iter). Обучение BERT может занять очень много времени. Вход num_steps следующей функции задаёт число итераций (шагов) обучения, а не число эпох, как в функции train_ch13 (см. раздел 13.1).
MXNet:
def train_bert(train_iter, net, loss, vocab_size, devices, num_steps):
trainer = gluon.Trainer(net.collect_params(), 'adam',
{'learning_rate': 0.01})
step, timer = 0, d2l.Timer()
animator = d2l.Animator(xlabel='шаг', ylabel='потери',
xlim=[1, num_steps], legend=['mlm', 'nsp'])
# Сумма потерь маскированной языковой модели, сумма потерь предсказания
# следующего предложения, число пар предложений, счётчик
metric = d2l.Accumulator(4)
num_steps_reached = False
while step < num_steps and not num_steps_reached:
for batch in train_iter:
(tokens_X_shards, segments_X_shards, valid_lens_x_shards,
pred_positions_X_shards, mlm_weights_X_shards,
mlm_Y_shards, nsp_y_shards) = [gluon.utils.split_and_load(
elem, devices, even_split=False) for elem in batch]
timer.start()
with autograd.record():
mlm_ls, nsp_ls, ls = _get_batch_loss_bert(
net, loss, vocab_size, tokens_X_shards, segments_X_shards,
valid_lens_x_shards, pred_positions_X_shards,
mlm_weights_X_shards, mlm_Y_shards, nsp_y_shards)
for l in ls:
l.backward()
trainer.step(1)
mlm_l_mean = sum([float(l) for l in mlm_ls]) / len(mlm_ls)
nsp_l_mean = sum([float(l) for l in nsp_ls]) / len(nsp_ls)
metric.add(mlm_l_mean, nsp_l_mean, batch[0].shape[0], 1)
timer.stop()
animator.add(step + 1,
(metric[0] / metric[3], metric[1] / metric[3]))
step += 1
if step == num_steps:
num_steps_reached = True
break
print(f'потери MLM {metric[0] / metric[3]:.3f}, '
f'потери NSP {metric[1] / metric[3]:.3f}')
print(f'{metric[2] / timer.sum():.1f} пар предложений/с на '
f'{str(devices)}')
PyTorch:
def train_bert(train_iter, net, loss, vocab_size, devices, num_steps):
net = nn.DataParallel(net, device_ids=devices).to(devices[0])
trainer = torch.optim.Adam(net.parameters(), lr=0.01)
step, timer = 0, d2l.Timer()
animator = d2l.Animator(xlabel='шаг', ylabel='потери',
xlim=[1, num_steps], legend=['mlm', 'nsp'])
# Сумма потерь маскированной языковой модели, сумма потерь предсказания
# следующего предложения, число пар предложений, счётчик
metric = d2l.Accumulator(4)
num_steps_reached = False
while step < num_steps and not num_steps_reached:
for tokens_X, segments_X, valid_lens_x, pred_positions_X,\
mlm_weights_X, mlm_Y, nsp_y in train_iter:
tokens_X = tokens_X.to(devices[0])
segments_X = segments_X.to(devices[0])
valid_lens_x = valid_lens_x.to(devices[0])
pred_positions_X = pred_positions_X.to(devices[0])
mlm_weights_X = mlm_weights_X.to(devices[0])
mlm_Y, nsp_y = mlm_Y.to(devices[0]), nsp_y.to(devices[0])
trainer.zero_grad()
timer.start()
mlm_l, nsp_l, l = _get_batch_loss_bert(
net, loss, vocab_size, tokens_X, segments_X, valid_lens_x,
pred_positions_X, mlm_weights_X, mlm_Y, nsp_y)
l.backward()
trainer.step()
metric.add(mlm_l, nsp_l, tokens_X.shape[0], 1)
timer.stop()
animator.add(step + 1,
(metric[0] / metric[3], metric[1] / metric[3]))
step += 1
if step == num_steps:
num_steps_reached = True
break
print(f'потери MLM {metric[0] / metric[3]:.3f}, '
f'потери NSP {metric[1] / metric[3]:.3f}')
print(f'{metric[2] / timer.sum():.1f} пар предложений/с на '
f'{str(devices)}')
PaddlePaddle:
def train_bert(train_iter, net, loss, vocab_size, devices, num_steps):
trainer = paddle.optimizer.Adam(parameters=net.parameters(), learning_rate=0.01)
step, timer = 0, d2l.Timer()
animator = d2l.Animator(xlabel='шаг', ylabel='потери',
xlim=[1, num_steps], legend=['mlm', 'nsp'])
# Сумма потерь маскированной языковой модели, сумма потерь предсказания
# следующего предложения, число пар предложений, счётчик
metric = d2l.Accumulator(4)
num_steps_reached = False
while step < num_steps and not num_steps_reached:
for tokens_X, segments_X, valid_lens_x, pred_positions_X,\
mlm_weights_X, mlm_Y, nsp_y in train_iter:
trainer.clear_grad()
timer.start()
mlm_l, nsp_l, l = _get_batch_loss_bert(
net, loss, vocab_size, tokens_X, segments_X, valid_lens_x,
pred_positions_X, mlm_weights_X, mlm_Y, nsp_y)
l.backward()
trainer.step()
metric.add(mlm_l, nsp_l, tokens_X.shape[0], 1)
timer.stop()
animator.add(step + 1,
(metric[0] / metric[3], metric[1] / metric[3]))
step += 1
if step == num_steps:
num_steps_reached = True
break
print(f'потери MLM {metric[0] / metric[3]:.3f}, '
f'потери NSP {metric[1] / metric[3]:.3f}')
print(f'{metric[2] / timer.sum():.1f} пар предложений/с на '
f'{str(devices)}')
Во время предобучения можно построить графики потерь маскированной языковой модели и потерь предсказания следующего предложения.
MXNet, PyTorch:
train_bert(train_iter, net, loss, len(vocab), devices, 50)
PaddlePaddle:
train_bert(train_iter, net, loss, len(vocab), devices[:1], 50)
14.10.2 Представление текста с помощью BERT
После предобучения BERT его можно использовать для представления одиночного текста, пар текстов или любого из их токенов. Следующая функция возвращает представления BERT (net) для всех токенов из tokens_a и tokens_b.
MXNet:
def get_bert_encoding(net, tokens_a, tokens_b=None):
tokens, segments = d2l.get_tokens_and_segments(tokens_a, tokens_b)
token_ids = np.expand_dims(np.array(vocab[tokens], ctx=devices[0]),
axis=0)
segments = np.expand_dims(np.array(segments, ctx=devices[0]), axis=0)
valid_len = np.expand_dims(np.array(len(tokens), ctx=devices[0]), axis=0)
encoded_X, _, _ = net(token_ids, segments, valid_len)
return encoded_X
PyTorch:
def get_bert_encoding(net, tokens_a, tokens_b=None):
tokens, segments = d2l.get_tokens_and_segments(tokens_a, tokens_b)
token_ids = torch.tensor(vocab[tokens], device=devices[0]).unsqueeze(0)
segments = torch.tensor(segments, device=devices[0]).unsqueeze(0)
valid_len = torch.tensor(len(tokens), device=devices[0]).unsqueeze(0)
encoded_X, _, _ = net(token_ids, segments, valid_len)
return encoded_X
PaddlePaddle:
def get_bert_encoding(net, tokens_a, tokens_b=None):
tokens, segments = d2l.get_tokens_and_segments(tokens_a, tokens_b)
token_ids = paddle.to_tensor(vocab[tokens]).unsqueeze(0)
segments = paddle.to_tensor(segments).unsqueeze(0)
valid_len = paddle.to_tensor(len(tokens))
encoded_X, _, _ = net(token_ids, segments, valid_len)
return encoded_X
Рассмотрим предложение «a crane is flying». Вспомним входное представление BERT, обсуждавшееся в разделе 14.8.4. После вставки специальных токенов <cls> (для классификации) и <sep> (для разделения) длина входной последовательности BERT равна 6. Поскольку нулевая позиция — токен <cls>, encoded_text[:, 0, :] — представление BERT всего входного предложения. Чтобы оценить многозначный токен «crane», мы также выводим первые три элемента представления BERT этого токена.
tokens_a = ['a', 'crane', 'is', 'flying']
encoded_text = get_bert_encoding(net, tokens_a)
# Токены: '<cls>', 'a', 'crane', 'is', 'flying', '<sep>'
encoded_text_cls = encoded_text[:, 0, :]
encoded_text_crane = encoded_text[:, 2, :]
encoded_text.shape, encoded_text_cls.shape, encoded_text_crane[0][:3]
Теперь рассмотрим пару предложений «a crane driver came» и «he just left». Аналогично, encoded_pair[:, 0, :] — результат кодирования всей пары предложений предобученным BERT. Обратите внимание: первые три элемента многозначного токена «crane» отличаются от тех, что были в другом контексте. Это подтверждает, что представления BERT контекстно-зависимы.
tokens_a, tokens_b = ['a', 'crane', 'driver', 'came'], ['he', 'just', 'left']
encoded_pair = get_bert_encoding(net, tokens_a, tokens_b)
# Токены: '<cls>', 'a', 'crane', 'driver', 'came', '<sep>', 'he', 'just',
# 'left', '<sep>'
encoded_pair_cls = encoded_pair[:, 0, :]
encoded_pair_crane = encoded_pair[:, 2, :]
encoded_pair.shape, encoded_pair_cls.shape, encoded_pair_crane[0][:3]
В главе 15 мы дообучим предобученную модель BERT для прикладных задач обработки естественного языка.
Резюме
- У исходного BERT две версии: базовая модель имеет 110 миллионов параметров, а большая — 340 миллионов.
- После предобучения BERT его можно использовать для представления одиночного текста, пар текстов или любого из их токенов.
- В эксперименте один и тот же токен в разных контекстах имеет разные представления BERT. Это подтверждает контекстную зависимость представлений BERT.
Упражнения
- В эксперименте видно, что потери маскированной языковой модели заметно выше потерь предсказания следующего предложения. Почему?
- Задайте максимальную длину входной последовательности BERT равной 512 (как в исходной модели BERT). Используйте конфигурацию исходной модели BERT, например . Возникают ли ошибки при запуске этого раздела? Почему?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Devlin, J., Chang, M. W., Lee, K., & Toutanova, K. (2018). Bert: Pre-training of deep bidirectional transformers for language understanding. arXiv preprint arXiv:1810.04805.
15. Обработка естественного языка: приложения
Ранее мы научились представлять токены в текстовых последовательностях и в главе 14 обучили представления токенов. Такие предобученные представления текста можно с помощью разных архитектур моделей подавать в различные прикладные задачи обработки естественного языка.
В предыдущих главах мы уже упоминали некоторые приложения обработки естественного языка, не использовавшие предобучение: они лишь объясняли архитектуры глубокого обучения. Например, в главе 8 мы полагались на рекуррентные нейронные сети, чтобы спроектировать языковую модель, генерирующую текст, похожий на роман. В главах 9 и 10 мы также спроектировали модели машинного перевода на основе рекуррентных нейронных сетей и механизмов внимания.
Однако эта книга не стремится охватить все такие приложения. Вместо этого мы сосредоточимся на том, как применять глубокое обучение языковых представлений для решения задач обработки естественного языка. Располагая предобученными представлениями текста, в этой главе мы рассмотрим две популярные и показательные прикладные задачи обработки естественного языка: анализ тональности и логический вывод на естественном языке, которые анализируют соответственно одиночный текст и отношения между парами текстов.
Рис. 15.1. Предобученные представления текста можно с помощью разных архитектур моделей подавать в различные прикладные задачи обработки естественного языка (в этой главе мы сосредоточимся на том, как проектировать модели для разных приложений)
Как показано на рис. 15.1, в этой главе мы опишем и затем используем разные типы архитектур глубокого обучения (многослойные перцептроны, свёрточные нейронные сети, рекуррентные нейронные сети и внимание) для проектирования моделей обработки естественного языка. Хотя на рис. 15.1 любое предобученное представление текста можно комбинировать с архитектурой любого приложения, мы выбрали несколько показательных сочетаний. Конкретно, для анализа тональности мы изучим популярные архитектуры на основе рекуррентных и свёрточных нейронных сетей. Для логического вывода на естественном языке мы выберем внимание и многослойные перцептроны, чтобы показать, как анализировать пары текстов. Наконец, мы расскажем, как дообучать предобученную модель BERT для широкого круга приложений обработки естественного языка — на уровне последовательности (классификация одиночного текста и классификация пар текстов) и на уровне токенов (разметка текста и ответы на вопросы). В качестве конкретного эмпирического примера мы дообучим BERT для логического вывода на естественном языке.
Как мы объясняли в разделе 14.8, BERT требует лишь минимальных изменений архитектуры для широкого круга приложений обработки естественного языка. Однако это преимущество достигается ценой дообучения огромного числа параметров BERT для прикладных задач. Когда ограничены память или время, более реалистичным вариантом становятся тщательно построенные модели на основе многослойных перцептронов, свёрточных нейронных сетей, рекуррентных нейронных сетей и внимания. Ниже мы начнём с приложения анализа тональности и разберём устройство моделей на основе рекуррентных и свёрточных нейронных сетей соответственно.
15.1 Анализ тональности и набор данных
С быстрым развитием социальных сетей и платформ отзывов накапливается огромное количество отзывов. Эти данные обладают большим потенциалом для поддержки принятия решений. Анализ тональности (sentiment analysis) изучает «скрытые» в тексте настроения людей — в отзывах о товарах, комментариях в блогах, обсуждениях на форумах и т. д. Он широко применяется в политике (например, анализ отношения общества к государственным решениям), финансах (например, анализ рыночных настроений) и маркетинге (например, исследование продуктов и управление брендом).
Поскольку тональность можно классифицировать по дискретным полярностям или шкалам (например, положительная и отрицательная), анализ тональности можно рассматривать как задачу классификации текстов, которая преобразует текстовую последовательность переменной длины в категорию текста фиксированной длины. В этом разделе мы будем использовать для анализа тональности большой набор данных рецензий на фильмы (large movie review dataset) Стэнфордского университета. Он состоит из обучающей и тестовой частей и содержит по 25 000 рецензий на фильмы, загруженных с IMDb. В обеих частях поровну «положительных» и «отрицательных» меток, обозначающих разные полярности тональности.
MXNet:
from d2l import mxnet as d2l
from mxnet import np, npx
import os
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
import os
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
import os
15.1.1 Чтение набора данных
Сначала скачаем и распакуем набор данных рецензий IMDb в каталог ../data/aclImdb.
#@save
d2l.DATA_HUB['aclImdb'] = (
'http://ai.stanford.edu/~amaas/data/sentiment/aclImdb_v1.tar.gz',
'01ada507287d82875905620988597833ad4e0903')
data_dir = d2l.download_extract('aclImdb', 'aclImdb')
Затем прочитаем обучающий и тестовый наборы данных. Каждый пример — рецензия с меткой: 1 означает «положительная», 0 — «отрицательная».
#@save
def read_imdb(data_dir, is_train):
"""Читает текстовые последовательности и метки набора рецензий IMDb"""
data, labels = [], []
for label in ('pos', 'neg'):
folder_name = os.path.join(data_dir, 'train' if is_train else 'test',
label)
for file in os.listdir(folder_name):
with open(os.path.join(folder_name, file), 'rb') as f:
review = f.read().decode('utf-8').replace('\n', '')
data.append(review)
labels.append(1 if label == 'pos' else 0)
return data, labels
train_data = read_imdb(data_dir, is_train=True)
print('число обучающих примеров:', len(train_data[0]))
for x, y in zip(train_data[0][:3], train_data[1][:3]):
print('метка:', y, 'рецензия:', x[0:60])
15.1.2 Предобработка набора данных
Считая каждое слово токеном и отфильтровывая слова, встречающиеся меньше 5 раз, создадим словарь по обучающему набору данных.
train_tokens = d2l.tokenize(train_data[0], token='word')
vocab = d2l.Vocab(train_tokens, min_freq=5, reserved_tokens=['<pad>'])
После токенизации построим гистограмму длин рецензий в токенах.
d2l.set_figsize()
d2l.plt.xlabel('# токенов в рецензии')
d2l.plt.ylabel('количество')
d2l.plt.hist([len(line) for line in train_tokens], bins=range(0, 1000, 50));
Как и ожидалось, длины рецензий различаются. Чтобы обрабатывать такие рецензии минибатчами, мы приводим длину каждой рецензии к 500 с помощью усечения и дополнения. Это похоже на этапы предобработки набора данных машинного перевода из раздела 9.5.
num_steps = 500 # Длина последовательности
train_features = d2l.tensor([d2l.truncate_pad(
vocab[line], num_steps, vocab['<pad>']) for line in train_tokens])
print(train_features.shape)
15.1.3 Создание итераторов данных
Теперь можно создать итераторы данных. На каждой итерации возвращается минибатч примеров.
MXNet:
train_iter = d2l.load_array((train_features, train_data[1]), 64)
for X, y in train_iter:
print('X:', X.shape, ', y:', y.shape)
break
print('число минибатчей:', len(train_iter))
PyTorch:
train_iter = d2l.load_array((train_features,
torch.tensor(train_data[1])), 64)
for X, y in train_iter:
print('X:', X.shape, ', y:', y.shape)
break
print('число минибатчей:', len(train_iter))
PaddlePaddle:
train_iter = d2l.load_array((train_features,
d2l.tensor(train_data[1])), 64)
for X, y in train_iter:
print('X:', X.shape, ', y:', y.shape)
break
print('число минибатчей:', len(train_iter))
15.1.4 Сборка кода
Наконец, мы упаковываем описанные шаги в функцию load_data_imdb. Она возвращает итераторы обучающих и тестовых данных и словарь набора рецензий IMDb.
MXNet:
#@save
def load_data_imdb(batch_size, num_steps=500):
"""Возвращает итераторы данных и словарь набора рецензий IMDb"""
data_dir = d2l.download_extract('aclImdb', 'aclImdb')
train_data = read_imdb(data_dir, True)
test_data = read_imdb(data_dir, False)
train_tokens = d2l.tokenize(train_data[0], token='word')
test_tokens = d2l.tokenize(test_data[0], token='word')
vocab = d2l.Vocab(train_tokens, min_freq=5)
train_features = np.array([d2l.truncate_pad(
vocab[line], num_steps, vocab['<pad>']) for line in train_tokens])
test_features = np.array([d2l.truncate_pad(
vocab[line], num_steps, vocab['<pad>']) for line in test_tokens])
train_iter = d2l.load_array((train_features, train_data[1]), batch_size)
test_iter = d2l.load_array((test_features, test_data[1]), batch_size,
is_train=False)
return train_iter, test_iter, vocab
PyTorch:
#@save
def load_data_imdb(batch_size, num_steps=500):
"""Возвращает итераторы данных и словарь набора рецензий IMDb"""
data_dir = d2l.download_extract('aclImdb', 'aclImdb')
train_data = read_imdb(data_dir, True)
test_data = read_imdb(data_dir, False)
train_tokens = d2l.tokenize(train_data[0], token='word')
test_tokens = d2l.tokenize(test_data[0], token='word')
vocab = d2l.Vocab(train_tokens, min_freq=5)
train_features = torch.tensor([d2l.truncate_pad(
vocab[line], num_steps, vocab['<pad>']) for line in train_tokens])
test_features = torch.tensor([d2l.truncate_pad(
vocab[line], num_steps, vocab['<pad>']) for line in test_tokens])
train_iter = d2l.load_array((train_features, torch.tensor(train_data[1])),
batch_size)
test_iter = d2l.load_array((test_features, torch.tensor(test_data[1])),
batch_size,
is_train=False)
return train_iter, test_iter, vocab
PaddlePaddle:
#@save
def load_data_imdb(batch_size, num_steps=500):
"""Возвращает итераторы данных и словарь набора рецензий IMDb"""
data_dir = d2l.download_extract('aclImdb', 'aclImdb')
train_data = read_imdb(data_dir, True)
test_data = read_imdb(data_dir, False)
train_tokens = d2l.tokenize(train_data[0], token='word')
test_tokens = d2l.tokenize(test_data[0], token='word')
vocab = d2l.Vocab(train_tokens, min_freq=5)
train_features = d2l.tensor([d2l.truncate_pad(
vocab[line], num_steps, vocab['<pad>']) for line in train_tokens])
test_features = d2l.tensor([d2l.truncate_pad(
vocab[line], num_steps, vocab['<pad>']) for line in test_tokens])
train_iter = d2l.load_array((train_features, d2l.tensor(train_data[1])),
batch_size)
test_iter = d2l.load_array((test_features, d2l.tensor(test_data[1])),
batch_size,
is_train=False)
return train_iter, test_iter, vocab
Резюме
- Анализ тональности изучает настроения людей в тексте; он рассматривается как задача классификации текстов, преобразующая текстовую последовательность переменной длины в категорию текста фиксированной длины.
- После предобработки с помощью словаря можно загрузить набор рецензий IMDb в итераторы данных.
Упражнения
- Какие гиперпараметры из этого раздела можно изменить, чтобы ускорить обучение модели анализа тональности?
- Реализуйте функцию загрузки набора данных отзывов Amazon в итераторы данных для анализа тональности.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
15.2 Анализ тональности: рекуррентные нейронные сети
Как и в задачах на сходство слов и аналогии, предобученные векторы слов можно применять и к анализу тональности. Поскольку набор рецензий IMDb из раздела 15.1 не очень велик, использование представлений текста, предобученных на крупномасштабных корпусах, может уменьшить переобучение модели. В качестве конкретного примера, показанного на рис. 15.2.1, мы будем представлять каждый токен предобученной моделью GloVe и подавать эти представления токенов в многослойную двунаправленную рекуррентную нейронную сеть, чтобы получить представление текстовой последовательности, которое затем будет преобразовано в выход анализа тональности (Maas et al., 2011). Для той же прикладной задачи позже мы рассмотрим другие архитектурные варианты.
Рис. 15.2.1. Подача GloVe в архитектуру на основе рекуррентной нейронной сети для анализа тональности
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, init, np, npx
from mxnet.gluon import nn, rnn
npx.set_np()
batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
15.2.1 Представление одиночного текста рекуррентной нейронной сетью
В задачах классификации текстов, таких как анализ тональности, текстовая последовательность переменной длины преобразуется в категорию фиксированной длины. В следующем классе BiRNN каждый токен текстовой последовательности получает своё отдельное предобученное представление GloVe через слой вложений (self.embedding), а вся последовательность кодируется двунаправленной рекуррентной нейронной сетью (self.encoder). Точнее, скрытые состояния двунаправленной сети долгой краткосрочной памяти (на последнем слое) в начальный и конечный временные шаги конкатенируются и служат представлением текстовой последовательности. Затем это представление одиночного текста преобразуется в выходные категории полносвязным слоем (self.decoder) с двумя выходами («положительная» и «отрицательная»).
MXNet:
class BiRNN(nn.Block):
def __init__(self, vocab_size, embed_size, num_hiddens,
num_layers, **kwargs):
super(BiRNN, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
# Задаём bidirectional=True, чтобы получить двунаправленную
# рекуррентную нейронную сеть
self.encoder = rnn.LSTM(num_hiddens, num_layers=num_layers,
bidirectional=True, input_size=embed_size)
self.decoder = nn.Dense(2)
def forward(self, inputs):
# Форма inputs: (размер минибатча, число временных шагов).
# Поскольку LSTM требует, чтобы первое измерение входа было временным,
# перед получением представлений токенов вход транспонируется.
# Форма выхода: (число временных шагов, размер минибатча,
# размерность вектора слова)
embeddings = self.embedding(inputs.T)
# Возвращает скрытые состояния последнего скрытого слоя
# на разных временных шагах.
# Форма outputs: (число временных шагов, размер минибатча,
# 2 * число скрытых элементов)
outputs = self.encoder(embeddings)
# Конкатенируем скрытые состояния начального и конечного временных
# шагов как вход полносвязного слоя.
# Его форма: (размер минибатча, 4 * число скрытых элементов)
encoding = np.concatenate((outputs[0], outputs[-1]), axis=1)
outs = self.decoder(encoding)
return outs
PyTorch:
class BiRNN(nn.Module):
def __init__(self, vocab_size, embed_size, num_hiddens,
num_layers, **kwargs):
super(BiRNN, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
# Задаём bidirectional=True, чтобы получить двунаправленную
# рекуррентную нейронную сеть
self.encoder = nn.LSTM(embed_size, num_hiddens, num_layers=num_layers,
bidirectional=True)
self.decoder = nn.Linear(4 * num_hiddens, 2)
def forward(self, inputs):
# Форма inputs: (размер минибатча, число временных шагов).
# Поскольку LSTM требует, чтобы первое измерение входа было временным,
# перед получением представлений токенов вход транспонируется.
# Форма выхода: (число временных шагов, размер минибатча,
# размерность вектора слова)
embeddings = self.embedding(inputs.T)
self.encoder.flatten_parameters()
# Возвращает скрытые состояния последнего скрытого слоя
# на разных временных шагах.
# Форма outputs: (число временных шагов, размер минибатча,
# 2 * число скрытых элементов)
outputs, _ = self.encoder(embeddings)
# Конкатенируем скрытые состояния начального и конечного временных
# шагов как вход полносвязного слоя.
# Его форма: (размер минибатча, 4 * число скрытых элементов)
encoding = torch.cat((outputs[0], outputs[-1]), dim=1)
outs = self.decoder(encoding)
return outs
PaddlePaddle:
class BiRNN(nn.Layer):
def __init__(self, vocab_size, embed_size, num_hiddens,
num_layers, **kwargs):
super(BiRNN, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
# Задаём direction='bidirect' или 'bidirectional', чтобы получить
# двунаправленную рекуррентную нейронную сеть
self.encoder = nn.LSTM(embed_size, num_hiddens, num_layers=num_layers,
direction='bidirect',time_major=True)
self.decoder = nn.Linear(4 * num_hiddens, 2)
def forward(self, inputs):
# Форма inputs: (размер минибатча, число временных шагов).
# Поскольку LSTM требует, чтобы первое измерение входа было временным,
# перед получением представлений токенов вход транспонируется.
# Форма выхода: (число временных шагов, размер минибатча,
# размерность вектора слова)
embeddings = self.embedding(inputs.T)
self.encoder.flatten_parameters()
# Возвращает скрытые состояния последнего скрытого слоя
# на разных временных шагах.
# Форма outputs: (число временных шагов, размер минибатча,
# 2 * число скрытых элементов)
outputs, _ = self.encoder(embeddings)
# Конкатенируем скрытые состояния начального и конечного временных
# шагов как вход полносвязного слоя.
# Его форма: (размер минибатча, 4 * число скрытых элементов)
encoding = paddle.concat((outputs[0], outputs[-1]), axis=1)
outs = self.decoder(encoding)
return outs
Построим двунаправленную рекуррентную нейронную сеть с двумя скрытыми слоями для представления одиночного текста при анализе тональности.
embed_size, num_hiddens, num_layers = 100, 100, 2
devices = d2l.try_all_gpus()
net = BiRNN(len(vocab), embed_size, num_hiddens, num_layers)
MXNet:
net.initialize(init.Xavier(), ctx=devices)
PyTorch:
def init_weights(m):
if type(m) == nn.Linear:
nn.init.xavier_uniform_(m.weight)
if type(m) == nn.LSTM:
for param in m._flat_weights_names:
if "weight" in param:
nn.init.xavier_uniform_(m._parameters[param])
net.apply(init_weights);
PaddlePaddle:
def init_weights(layer):
if isinstance(layer,(nn.Linear, nn.Embedding)):
if isinstance(layer.weight, paddle.Tensor):
nn.initializer.XavierUniform()(layer.weight)
if isinstance(layer, nn.LSTM):
for n, p in layer.named_parameters():
if "weigth" in n:
nn.initializer.XavierUniform()(p)
net.apply(init_weights)
15.2.2 Загрузка предобученных векторов слов
Ниже мы загружаем предобученные 100-мерные (размерность должна совпадать с embed_size) вложения GloVe для слов словаря.
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
Выведем форму векторов всех токенов словаря.
embeds = glove_embedding[vocab.idx_to_token]
embeds.shape
Мы используем эти предобученные векторы слов для представления токенов рецензий и не обновляем эти векторы во время обучения.
MXNet:
net.embedding.weight.set_data(embeds)
net.embedding.collect_params().setattr('grad_req', 'null')
PyTorch:
net.embedding.weight.data.copy_(embeds)
net.embedding.weight.requires_grad = False
PaddlePaddle:
net.embedding.weight.set_value(embeds)
net.embedding.weight.stop_gradient = False
15.2.3 Обучение и оценка модели
Теперь можно обучить двунаправленную рекуррентную нейронную сеть для анализа тональности.
MXNet:
lr, num_epochs = 0.01, 5
trainer = gluon.Trainer(net.collect_params(), 'adam', {'learning_rate': lr})
loss = gluon.loss.SoftmaxCrossEntropyLoss()
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)
PyTorch:
lr, num_epochs = 0.01, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)
PaddlePaddle:
lr, num_epochs = 0.01, 2
trainer = paddle.optimizer.Adam(learning_rate=lr,parameters=net.parameters())
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)
Определим следующую функцию, которая с помощью обученной модели net предсказывает тональность текстовой последовательности.
MXNet:
#@save
def predict_sentiment(net, vocab, sequence):
"""Предсказывает тональность текстовой последовательности"""
sequence = np.array(vocab[sequence.split()], ctx=d2l.try_gpu())
label = np.argmax(net(sequence.reshape(1, -1)), axis=1)
return 'positive' if label == 1 else 'negative'
PyTorch:
#@save
def predict_sentiment(net, vocab, sequence):
"""Предсказывает тональность текстовой последовательности"""
sequence = torch.tensor(vocab[sequence.split()], device=d2l.try_gpu())
label = torch.argmax(net(sequence.reshape(1, -1)), dim=1)
return 'positive' if label == 1 else 'negative'
PaddlePaddle:
#@save
def predict_sentiment(net, vocab, sequence):
"""Предсказывает тональность текстовой последовательности"""
sequence = paddle.to_tensor(vocab[sequence.split()], place=d2l.try_gpu())
label = paddle.argmax(net(sequence.reshape((1, -1))), axis=1)
return 'positive' if label == 1 else 'negative'
Наконец, предскажем тональность двух простых предложений обученной моделью.
predict_sentiment(net, vocab, 'this movie is so great')
predict_sentiment(net, vocab, 'this movie is so bad')
Резюме
- Предобученные векторы слов могут представлять отдельные токены текстовой последовательности.
- Двунаправленные рекуррентные нейронные сети могут представлять текстовую последовательность. Например, конкатенируя скрытые состояния в начальный и конечный временные шаги, можно с помощью полносвязного слоя преобразовать это представление одиночного текста в категорию.
Упражнения
- Повысит ли увеличение числа эпох точность на обучающих и тестовых наборах? А настройка других гиперпараметров?
- Используйте предобученные векторы слов большего размера, например 300-мерные вложения GloVe. Повышает ли это точность классификации?
- Можно ли повысить точность классификации с помощью токенизации spaCy? Нужно установить spaCy (
pip install spacy) и английский языковой пакет (python -m spacy download en). В коде сначала импортируйте spaCy (import spacy). Затем загрузите английский пакет spaCy (spacy_en = spacy.load('en')). Наконец, определите функциюdef tokenizer(text): return [tok.text for tok in spacy_en.tokenizer(text)]и замените ею исходную функциюtokenizer. Обратите внимание на различия в форме токенов-фраз в GloVe и spaCy. Например, токен-фраза «new york» в GloVe имеет вид «new-york», а после токенизации spaCy — «new york».
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Maas, A. L., Daly, R. E., Pham, P. T., Huang, D., Ng, A. Y., & Potts, C. (2011). Learning word vectors for sentiment analysis. In Proceedings of the 49th annual meeting of the association for computational linguistics: Human language technologies-volume 1, 142–150.
15.3 Анализ тональности: свёрточные нейронные сети
В главе 6 мы изучили механизмы обработки двумерных данных изображений двумерными свёрточными нейронными сетями и применили их к локальным признакам, таким как соседние пиксели. Хотя свёрточные нейронные сети изначально проектировались для компьютерного зрения, их широко используют и в обработке естественного языка. Проще говоря, достаточно представить любую текстовую последовательность как одномерное изображение. Так одномерные свёрточные нейронные сети могут обрабатывать локальные признаки в тексте, например -граммы.
В этом разделе мы на модели textCNN покажем, как спроектировать свёрточную нейронную сеть для представления одиночного текста (Kim, 2014). По сравнению с рис. 15.2.1, где для анализа тональности использована рекуррентная архитектура с предобучением GloVe, единственное отличие на рис. 15.3.1 — выбор архитектуры.
Рис. 15.3.1. Подача GloVe в свёрточную архитектуру для анализа тональности
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, init, np, npx
from mxnet.gluon import nn
npx.set_np()
batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
batch_size = 64
train_iter, test_iter, vocab = d2l.load_data_imdb(batch_size)
15.3.1 Одномерные свёртки
Прежде чем перейти к модели, посмотрим, как работает одномерная свёртка. Напомним, что это лишь частный случай двумерной свёртки, основанной на операции взаимной корреляции.
Рис. 15.3.2. Одномерная взаимная корреляция. Затенённые части — первый элемент выхода, а также элементы входного тензора и тензора ядра, использованные для его вычисления:
Как показано на рис. 15.3.2, в одномерном случае окно свёртки скользит по входному тензору слева направо. Во время скольжения подтензор входа, попавший в окно свёртки в некоторой позиции (например, и на рис. 15.3.2), и тензор ядра (например, и на рис. 15.3.2) поэлементно умножаются. Сумма этих произведений даёт одно скалярное значение в соответствующей позиции выходного тензора (например, на рис. 15.3.2).
Одномерную взаимную корреляцию мы реализуем в следующей функции corr1d. Для входного тензора X и тензора ядра K она возвращает выходной тензор Y.
MXNet, PyTorch:
def corr1d(X, K):
w = K.shape[0]
Y = d2l.zeros((X.shape[0] - w + 1))
for i in range(Y.shape[0]):
Y[i] = (X[i: i + w] * K).sum()
return Y
PaddlePaddle:
def corr1d(X, K):
w = K.shape[0]
Y = d2l.zeros([X.shape[0] - w + 1], dtype=X.dtype)
for i in range(Y.shape[0]):
Y[i] = (X[i: i + w] * K).sum()
return Y
Чтобы проверить выход приведённой реализации одномерной взаимной корреляции, построим входной тензор X и тензор ядра K по рис. 15.3.2.
X, K = d2l.tensor([0, 1, 2, 3, 4, 5, 6]), d2l.tensor([1, 2])
corr1d(X, K)
Для любого одномерного входа с несколькими каналами ядро свёртки должно иметь такое же число входных каналов. Затем для каждого канала выполняется взаимная корреляция одномерного входного тензора и одномерного тензора ядра, а результаты по всем каналам суммируются, давая одномерный выходной тензор. На рис. 15.3.3 показана одномерная взаимная корреляция с 3 входными каналами.
Рис. 15.3.3. Одномерная взаимная корреляция с 3 входными каналами. Затенённые части — первый элемент выхода, а также элементы входного тензора и тензора ядра, использованные для его вычисления:
Можно реализовать одномерную взаимную корреляцию для нескольких входных каналов и проверить результаты с рис. 15.3.3.
def corr1d_multi_in(X, K):
# Сначала проходим по нулевому измерению (измерению каналов) X и K.
# Затем складываем результаты
return sum(corr1d(x, k) for x, k in zip(X, K))
X = d2l.tensor([[0, 1, 2, 3, 4, 5, 6],
[1, 2, 3, 4, 5, 6, 7],
[2, 3, 4, 5, 6, 7, 8]])
K = d2l.tensor([[1, 2], [3, 4], [-1, -3]])
corr1d_multi_in(X, K)
Заметим, что одномерная взаимная корреляция с несколькими входными каналами эквивалентна двумерной взаимной корреляции с одним входным каналом. Например, эквивалент одномерной взаимной корреляции с несколькими входными каналами с рис. 15.3.3 — двумерная взаимная корреляция с одним входным каналом на рис. 15.3.4, где высота ядра свёртки должна совпадать с высотой входного тензора.
Рис. 15.3.4. Двумерная взаимная корреляция с одним входным каналом. Затенённые части — первый элемент выхода, а также элементы входного тензора и тензора ядра, использованные для его вычисления:
Выходы на рис. 15.3.2 и рис. 15.3.3 имеют только один канал. Как и для двумерных свёрток с несколькими выходными каналами, описанных в разделе 6.4.2, можно задать несколько выходных каналов и для одномерной свёртки.
15.3.2 Слой максимального пулинга по времени
Аналогично можно использовать слой пулинга, чтобы извлечь из представления последовательности максимальное значение как самый важный признак по временным шагам. Слой максимального пулинга по времени (max-over-time pooling), используемый в textCNN, работает подобно одномерному глобальному пулингу (Collobert et al., 2011). Для многоканального входа, где каждый канал хранит значения на разных временных шагах, выходом каждого канала служит максимальное значение этого канала. Заметим, что максимальный пулинг по времени допускает разное число временных шагов в разных каналах.
15.3.3 Модель textCNN
Используя одномерную свёртку и максимальный пулинг по времени, модель textCNN принимает на вход отдельные предобученные представления токенов, а затем получает и преобразует представление последовательности для прикладной задачи.
Для одиночной текстовой последовательности из токенов, представленных -мерными векторами, ширина, высота и число каналов входного тензора равны , и соответственно. Модель textCNN преобразует вход в выход следующим образом:
- Определяется несколько одномерных ядер свёртки, и свёрточные операции выполняются над входом по отдельности. Ядра разной ширины могут улавливать локальные признаки между разным числом соседних токенов.
- Над всеми выходными каналами выполняется максимальный пулинг по времени, после чего все скалярные выходы пулинга конкатенируются в вектор.
- Конкатенированный вектор преобразуется в выходные категории полносвязным слоем. Для уменьшения переобучения можно использовать dropout.
Рис. 15.3.5. Архитектура модели textCNN
На рис. 15.3.5 архитектура textCNN иллюстрируется конкретным примером. Входом служит предложение из 11 токенов, каждый из которых представлен 6-мерным вектором. Таким образом, у нас 6-канальный вход шириной 11. Определим два одномерных ядра свёртки шириной 2 и 4 с 4 и 5 выходными каналами соответственно. Они дают 4 выходных канала шириной и 5 выходных каналов шириной . Хотя ширина этих 9 каналов различна, слой максимального пулинга по времени даёт конкатенированный 9-мерный вектор, который в итоге преобразуется в 2-мерный выходной вектор для бинарного предсказания тональности.
15.3.3.1 Определение модели
Мы реализуем модель textCNN в следующем классе. По сравнению с двунаправленной рекуррентной моделью из раздела 15.2, помимо замены рекуррентных слоёв свёрточными, мы используем два слоя вложений: один с обучаемыми весами, а другой с фиксированными.
MXNet:
class TextCNN(nn.Block):
def __init__(self, vocab_size, embed_size, kernel_sizes, num_channels,
**kwargs):
super(TextCNN, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
# Этот слой вложений не обучается
self.constant_embedding = nn.Embedding(vocab_size, embed_size)
self.dropout = nn.Dropout(0.5)
self.decoder = nn.Dense(2)
# У слоя максимального пулинга по времени нет параметров,
# поэтому этот экземпляр можно использовать совместно
self.pool = nn.GlobalMaxPool1D()
# Создаём несколько одномерных свёрточных слоёв
self.convs = nn.Sequential()
for c, k in zip(num_channels, kernel_sizes):
self.convs.add(nn.Conv1D(c, k, activation='relu'))
def forward(self, inputs):
# Конкатенируем два слоя вложений вдоль размерности вектора.
# Форма выхода каждого слоя вложений:
# (размер минибатча, число токенов, размерность вектора токена)
embeddings = np.concatenate((
self.embedding(inputs), self.constant_embedding(inputs)), axis=2)
# Согласно формату входа одномерных свёрточных слоёв
# переставляем измерения тензора так, чтобы каналы шли вторым измерением
embeddings = embeddings.transpose(0, 2, 1)
# После слоя максимального пулинга по времени для каждого
# одномерного свёрточного слоя получаем тензор формы
# (размер минибатча, число каналов, 1).
# Удаляем последнее измерение и конкатенируем по измерению каналов
encoding = np.concatenate([
np.squeeze(self.pool(conv(embeddings)), axis=-1)
for conv in self.convs], axis=1)
outputs = self.decoder(self.dropout(encoding))
return outputs
PyTorch:
class TextCNN(nn.Module):
def __init__(self, vocab_size, embed_size, kernel_sizes, num_channels,
**kwargs):
super(TextCNN, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
# Этот слой вложений не обучается
self.constant_embedding = nn.Embedding(vocab_size, embed_size)
self.dropout = nn.Dropout(0.5)
self.decoder = nn.Linear(sum(num_channels), 2)
# У слоя максимального пулинга по времени нет параметров,
# поэтому этот экземпляр можно использовать совместно
self.pool = nn.AdaptiveAvgPool1d(1)
self.relu = nn.ReLU()
# Создаём несколько одномерных свёрточных слоёв
self.convs = nn.ModuleList()
for c, k in zip(num_channels, kernel_sizes):
self.convs.append(nn.Conv1d(2 * embed_size, c, k))
def forward(self, inputs):
# Конкатенируем два слоя вложений вдоль размерности вектора.
# Форма выхода каждого слоя вложений:
# (размер минибатча, число токенов, размерность вектора токена)
embeddings = torch.cat((
self.embedding(inputs), self.constant_embedding(inputs)), dim=2)
# Согласно формату входа одномерных свёрточных слоёв
# переставляем измерения тензора так, чтобы каналы шли вторым измерением
embeddings = embeddings.permute(0, 2, 1)
# После слоя максимального пулинга по времени для каждого
# одномерного свёрточного слоя получаем тензор формы
# (размер минибатча, число каналов, 1).
# Удаляем последнее измерение и конкатенируем по измерению каналов
encoding = torch.cat([
torch.squeeze(self.relu(self.pool(conv(embeddings))), dim=-1)
for conv in self.convs], dim=1)
outputs = self.decoder(self.dropout(encoding))
return outputs
PaddlePaddle:
class TextCNN(nn.Layer):
def __init__(self, vocab_size, embed_size, kernel_sizes, num_channels,
**kwargs):
super(TextCNN, self).__init__(**kwargs)
self.embedding = nn.Embedding(vocab_size, embed_size)
# Этот слой вложений не обучается
self.constant_embedding = nn.Embedding(vocab_size, embed_size)
self.dropout = nn.Dropout(0.5)
self.decoder = nn.Linear(sum(num_channels), 2)
# У слоя максимального пулинга по времени нет параметров,
# поэтому этот экземпляр можно использовать совместно
self.pool = nn.AdaptiveAvgPool1D(1)
self.relu = nn.ReLU()
# Создаём несколько одномерных свёрточных слоёв
self.convs = nn.LayerList()
for c, k in zip(num_channels, kernel_sizes):
self.convs.append(nn.Conv1D(2 * embed_size, c, k))
def forward(self, inputs):
# Конкатенируем два слоя вложений вдоль размерности вектора.
# Форма выхода каждого слоя вложений:
# (размер минибатча, число токенов, размерность вектора токена)
embeddings = paddle.concat((
self.embedding(inputs), self.constant_embedding(inputs)), axis=2)
# Согласно формату входа одномерных свёрточных слоёв
# переставляем измерения тензора так, чтобы каналы шли вторым измерением
embeddings = embeddings.transpose([0, 2, 1])
# После слоя максимального пулинга по времени для каждого
# одномерного свёрточного слоя получаем тензор формы
# (размер минибатча, число каналов, 1).
# Удаляем последнее измерение и конкатенируем по измерению каналов
encoding = paddle.concat([
paddle.squeeze(self.relu(self.pool(conv(embeddings))), axis=-1)
for conv in self.convs], axis=1)
outputs = self.decoder(self.dropout(encoding))
return outputs
Создадим экземпляр textCNN. У него 3 свёрточных слоя с шириной ядер 3, 4 и 5 и по 100 выходных каналов у каждого.
MXNet:
embed_size, kernel_sizes, nums_channels = 100, [3, 4, 5], [100, 100, 100]
devices = d2l.try_all_gpus()
net = TextCNN(len(vocab), embed_size, kernel_sizes, nums_channels)
net.initialize(init.Xavier(), ctx=devices)
PyTorch:
embed_size, kernel_sizes, nums_channels = 100, [3, 4, 5], [100, 100, 100]
devices = d2l.try_all_gpus()
net = TextCNN(len(vocab), embed_size, kernel_sizes, nums_channels)
def init_weights(m):
if type(m) in (nn.Linear, nn.Conv1d):
nn.init.xavier_uniform_(m.weight)
net.apply(init_weights);
PaddlePaddle:
embed_size, kernel_sizes, nums_channels = 100, [3, 4, 5], [100, 100, 100]
devices = d2l.try_all_gpus()
net = TextCNN(len(vocab), embed_size, kernel_sizes, nums_channels)
def init_weights(net):
init_normal = nn.initializer.XavierUniform()
for i in net.sublayers():
if type(i) in [nn.Linear, nn.Conv1D]:
init_normal(i.weight)
init_weights(net)
15.3.3.2 Загрузка предобученных векторов слов
Как и в разделе 15.2, мы загружаем предобученные 100-мерные вложения GloVe в качестве начальных представлений токенов. Эти представления токенов (веса вложений) будут обучаться в embedding и фиксироваться в constant_embedding.
MXNet:
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.set_data(embeds)
net.constant_embedding.weight.set_data(embeds)
net.constant_embedding.collect_params().setattr('grad_req', 'null')
PyTorch:
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.data.copy_(embeds)
net.constant_embedding.weight.data.copy_(embeds)
net.constant_embedding.weight.requires_grad = False
PaddlePaddle:
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.set_value(embeds)
net.constant_embedding.weight.set_value(embeds)
net.constant_embedding.weight.stop_gradient = True
15.3.3.3 Обучение и оценка модели
Теперь можно обучить модель textCNN для анализа тональности.
MXNet:
lr, num_epochs = 0.001, 5
trainer = gluon.Trainer(net.collect_params(), 'adam', {'learning_rate': lr})
loss = gluon.loss.SoftmaxCrossEntropyLoss()
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
PyTorch:
lr, num_epochs = 0.001, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
PaddlePaddle:
lr, num_epochs = 0.001, 5
trainer = paddle.optimizer.Adam(learning_rate=lr, parameters=net.parameters())
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs, devices)
Ниже мы предсказываем тональность двух простых предложений обученной моделью.
d2l.predict_sentiment(net, vocab, 'this movie is so great')
d2l.predict_sentiment(net, vocab, 'this movie is so bad')
Резюме
- Одномерные свёрточные нейронные сети могут обрабатывать локальные признаки в тексте, например -граммы.
- Одномерная взаимная корреляция с несколькими входными каналами эквивалентна двумерной взаимной корреляции с одним входным каналом.
- Слой максимального пулинга по времени допускает разное число временных шагов в разных каналах.
- Модель textCNN преобразует представления отдельных токенов в выходы прикладной задачи с помощью одномерных свёрточных слоёв и слоёв максимального пулинга по времени.
Упражнения
- Настройте гиперпараметры и сравните две архитектуры анализа тональности — из раздела 15.2 и из этого раздела, — например по точности классификации и вычислительной эффективности.
- Попробуйте ещё повысить точность классификации модели методами из упражнений раздела 15.2.
- Добавьте во входное представление позиционное кодирование. Повышает ли оно точность классификации?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Kim, Y. (2014). Convolutional neural networks for sentence classification. arXiv preprint arXiv:1408.5882.
- Collobert, R., Weston, J., Bottou, L., Karlen, M., Kavukcuoglu, K., & Kuksa, P. (2011). Natural language processing (almost) from scratch. Journal of machine learning research, 12, 2493–2537.
15.4 Логический вывод на естественном языке и набор данных
В разделе 15.1 мы обсуждали задачу анализа тональности. Цель этой задачи — отнести одну текстовую последовательность к одной из заранее определённых категорий, например к одной из полярностей тональности. Однако когда нужно решить, можно ли одно предложение вывести из другого, или устранить избыточность между предложениями, выявляя семантически эквивалентные, одного умения классифицировать отдельную текстовую последовательность недостаточно. Вместо этого нужно уметь делать выводы о парах текстовых последовательностей.
15.4.1 Логический вывод на естественном языке
Логический вывод на естественном языке (natural language inference) изучает, можно ли гипотезу (hypothesis) вывести из посылки (premise), причём и то, и другое — текстовые последовательности. Иными словами, логический вывод на естественном языке определяет логическое отношение между парой текстовых последовательностей. Такие отношения обычно делятся на три типа:
- Следование (entailment): гипотезу можно вывести из посылки.
- Противоречие (contradiction): отрицание гипотезы можно вывести из посылки.
- Нейтральность (neutral): все остальные случаи.
Логический вывод на естественном языке также называют задачей распознавания текстового следования. Например, следующая пара получит метку «следование», потому что «проявляют нежность» в гипотезе можно вывести из «обнимают друг друга» в посылке.
Посылка: Две женщины обнимают друг друга.
Гипотеза: Две женщины проявляют нежность.
Ниже пример «противоречия», поскольку «запускает пример кода» означает «не спит», а не «спит».
Посылка: Мужчина запускает пример кода из книги «Погружение в глубокое обучение».
Гипотеза: Мужчина спит.
Третий пример показывает отношение «нейтральности», потому что из факта «выступают для нас» нельзя вывести ни «известны», ни «неизвестны».
Посылка: Музыканты выступают для нас.
Гипотеза: Музыканты известны.
Логический вывод на естественном языке — центральная тема в понимании естественного языка. Он широко применяется — от информационного поиска до ответов на вопросы в открытой предметной области. Чтобы изучить эту задачу, мы начнём с популярного эталонного набора данных для логического вывода на естественном языке.
15.4.2 Набор данных Stanford Natural Language Inference (SNLI)
Корпус Stanford Natural Language Inference (SNLI) — это коллекция из более чем 500 000 размеченных пар английских предложений (Bowman et al., 2015). Мы скачиваем извлечённый набор данных SNLI и сохраняем его по пути ../data/snli_1.0.
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, np, npx
import os
import re
npx.set_np()
#@save
d2l.DATA_HUB['SNLI'] = (
'https://nlp.stanford.edu/projects/snli/snli_1.0.zip',
'9fcde07509c7e87ec61c640c1b2753d9041758e4')
data_dir = d2l.download_extract('SNLI')
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
import os
import re
#@save
d2l.DATA_HUB['SNLI'] = (
'https://nlp.stanford.edu/projects/snli/snli_1.0.zip',
'9fcde07509c7e87ec61c640c1b2753d9041758e4')
data_dir = d2l.download_extract('SNLI')
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
import os
import re
#@save
d2l.DATA_HUB['SNLI'] = (
'https://nlp.stanford.edu/projects/snli/snli_1.0.zip',
'9fcde07509c7e87ec61c640c1b2753d9041758e4')
data_dir = d2l.download_extract('SNLI')
15.4.2.1 Чтение набора данных
Исходный набор данных SNLI содержит гораздо больше информации, чем нам реально нужно в экспериментах. Поэтому мы определяем функцию read_snli, которая извлекает лишь часть набора данных и возвращает списки посылок, гипотез и их меток.
#@save
def read_snli(data_dir, is_train):
"""Разбирает набор данных SNLI на посылки, гипотезы и метки"""
def extract_text(s):
# Удаляем информацию, которую мы не будем использовать
s = re.sub('\\(', '', s)
s = re.sub('\\)', '', s)
# Заменяем два и более подряд идущих пробела одним пробелом
s = re.sub('\\s{2,}', ' ', s)
return s.strip()
label_set = {'entailment': 0, 'contradiction': 1, 'neutral': 2}
file_name = os.path.join(data_dir, 'snli_1.0_train.txt'
if is_train else 'snli_1.0_test.txt')
with open(file_name, 'r') as f:
rows = [row.split('\t') for row in f.readlines()[1:]]
premises = [extract_text(row[1]) for row in rows if row[0] in label_set]
hypotheses = [extract_text(row[2]) for row in rows if row[0] \
in label_set]
labels = [label_set[row[0]] for row in rows if row[0] in label_set]
return premises, hypotheses, labels
Теперь выведем первые 3 пары посылок и гипотез вместе с их метками («0», «1» и «2» соответствуют «следованию», «противоречию» и «нейтральности»).
train_data = read_snli(data_dir, is_train=True)
for x0, x1, y in zip(train_data[0][:3], train_data[1][:3], train_data[2][:3]):
print('посылка:', x0)
print('гипотеза:', x1)
print('метка:', y)
В обучающем наборе около 550 000 пар, а в тестовом — около 10 000. Ниже видно, что в обучающем и тестовом наборах три метки «следование», «противоречие» и «нейтральность» сбалансированы.
test_data = read_snli(data_dir, is_train=False)
for data in [train_data, test_data]:
print([[row for row in data[2]].count(i) for i in range(3)])
15.4.2.2 Определение класса для загрузки набора данных
Ниже мы определяем класс для загрузки набора данных SNLI. Переменная num_steps конструктора класса задаёт длину текстовой последовательности, чтобы все минибатчи последовательностей имели одинаковую форму. Иными словами, в более длинных последовательностях токены после первых num_steps отбрасываются, а к более коротким последовательностям добавляется специальный токен <pad>, пока их длина не станет равной num_steps. Реализовав __getitem__, мы можем произвольно обращаться к посылке, гипотезе и метке с индексом idx.
MXNet:
#@save
class SNLIDataset(gluon.data.Dataset):
"""Пользовательский набор данных для загрузки SNLI"""
def __init__(self, dataset, num_steps, vocab=None):
self.num_steps = num_steps
all_premise_tokens = d2l.tokenize(dataset[0])
all_hypothesis_tokens = d2l.tokenize(dataset[1])
if vocab is None:
self.vocab = d2l.Vocab(all_premise_tokens + \
all_hypothesis_tokens, min_freq=5, reserved_tokens=['<pad>'])
else:
self.vocab = vocab
self.premises = self._pad(all_premise_tokens)
self.hypotheses = self._pad(all_hypothesis_tokens)
self.labels = np.array(dataset[2])
print('прочитано ' + str(len(self.premises)) + ' примеров')
def _pad(self, lines):
return np.array([d2l.truncate_pad(
self.vocab[line], self.num_steps, self.vocab['<pad>'])
for line in lines])
def __getitem__(self, idx):
return (self.premises[idx], self.hypotheses[idx]), self.labels[idx]
def __len__(self):
return len(self.premises)
PyTorch:
#@save
class SNLIDataset(torch.utils.data.Dataset):
"""Пользовательский набор данных для загрузки SNLI"""
def __init__(self, dataset, num_steps, vocab=None):
self.num_steps = num_steps
all_premise_tokens = d2l.tokenize(dataset[0])
all_hypothesis_tokens = d2l.tokenize(dataset[1])
if vocab is None:
self.vocab = d2l.Vocab(all_premise_tokens + \
all_hypothesis_tokens, min_freq=5, reserved_tokens=['<pad>'])
else:
self.vocab = vocab
self.premises = self._pad(all_premise_tokens)
self.hypotheses = self._pad(all_hypothesis_tokens)
self.labels = torch.tensor(dataset[2])
print('прочитано ' + str(len(self.premises)) + ' примеров')
def _pad(self, lines):
return torch.tensor([d2l.truncate_pad(
self.vocab[line], self.num_steps, self.vocab['<pad>'])
for line in lines])
def __getitem__(self, idx):
return (self.premises[idx], self.hypotheses[idx]), self.labels[idx]
def __len__(self):
return len(self.premises)
PaddlePaddle:
#@save
class SNLIDataset(paddle.io.Dataset):
"""Пользовательский набор данных для загрузки SNLI"""
def __init__(self, dataset, num_steps, vocab=None):
self.num_steps = num_steps
all_premise_tokens = d2l.tokenize(dataset[0])
all_hypothesis_tokens = d2l.tokenize(dataset[1])
if vocab is None:
self.vocab = d2l.Vocab(all_premise_tokens + \
all_hypothesis_tokens, min_freq=5, reserved_tokens=['<pad>'])
else:
self.vocab = vocab
self.premises = self._pad(all_premise_tokens)
self.hypotheses = self._pad(all_hypothesis_tokens)
self.labels = paddle.to_tensor(dataset[2])
print('прочитано ' + str(len(self.premises)) + ' примеров')
def _pad(self, lines):
return paddle.to_tensor([d2l.truncate_pad(
self.vocab[line], self.num_steps, self.vocab['<pad>'])
for line in lines])
def __getitem__(self, idx):
return (self.premises[idx], self.hypotheses[idx]), self.labels[idx]
def __len__(self):
return len(self.premises)
15.4.2.3 Сборка кода
Теперь можно вызвать функцию read_snli и класс SNLIDataset, чтобы скачать набор данных SNLI и вернуть экземпляры DataLoader для обучающего и тестового наборов вместе со словарём обучающего набора. Важно отметить, что в качестве словаря тестового набора нужно использовать словарь, построенный по обучающему набору. Поэтому модель, обученная на обучающем наборе, не будет знать никаких новых токенов из тестового набора.
MXNet:
#@save
def load_data_snli(batch_size, num_steps=50):
"""Скачивает набор данных SNLI и возвращает итераторы данных и словарь"""
num_workers = d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_data = read_snli(data_dir, True)
test_data = read_snli(data_dir, False)
train_set = SNLIDataset(train_data, num_steps)
test_set = SNLIDataset(test_data, num_steps, train_set.vocab)
train_iter = gluon.data.DataLoader(train_set, batch_size, shuffle=True,
num_workers=num_workers)
test_iter = gluon.data.DataLoader(test_set, batch_size, shuffle=False,
num_workers=num_workers)
return train_iter, test_iter, train_set.vocab
PyTorch:
#@save
def load_data_snli(batch_size, num_steps=50):
"""Скачивает набор данных SNLI и возвращает итераторы данных и словарь"""
num_workers = d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_data = read_snli(data_dir, True)
test_data = read_snli(data_dir, False)
train_set = SNLIDataset(train_data, num_steps)
test_set = SNLIDataset(test_data, num_steps, train_set.vocab)
train_iter = torch.utils.data.DataLoader(train_set, batch_size,
shuffle=True,
num_workers=num_workers)
test_iter = torch.utils.data.DataLoader(test_set, batch_size,
shuffle=False,
num_workers=num_workers)
return train_iter, test_iter, train_set.vocab
PaddlePaddle:
#@save
def load_data_snli(batch_size, num_steps=50):
"""Скачивает набор данных SNLI и возвращает итераторы данных и словарь"""
num_workers = d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_data = read_snli(data_dir, True)
test_data = read_snli(data_dir, False)
train_set = SNLIDataset(train_data, num_steps)
test_set = SNLIDataset(test_data, num_steps, train_set.vocab)
train_iter = paddle.io.DataLoader(train_set,batch_size=batch_size,
shuffle=True,
num_workers=num_workers,
return_list=True)
test_iter = paddle.io.DataLoader(test_set, batch_size=batch_size,
shuffle=False,
num_workers=num_workers,
return_list=True)
return train_iter, test_iter, train_set.vocab
Здесь мы задаём размер минибатча 128 и длину последовательности 50 и вызываем функцию load_data_snli, чтобы получить итераторы данных и словарь. Затем выводим размер словаря.
train_iter, test_iter, vocab = load_data_snli(128, 50)
len(vocab)
Теперь выведем форму первого минибатча. В отличие от анализа тональности, здесь у нас два входа X[0] и X[1], представляющие пары посылок и гипотез.
for X, Y in train_iter:
print(X[0].shape)
print(X[1].shape)
print(Y.shape)
break
Резюме
- Логический вывод на естественном языке изучает, можно ли «гипотезу» вывести из «посылки», причём обе — текстовые последовательности.
- В логическом выводе на естественном языке отношения между посылкой и гипотезой включают следование, противоречие и нейтральность.
- Корпус Stanford Natural Language Inference (SNLI) — популярный эталонный набор данных для логического вывода на естественном языке.
Упражнения
- Машинный перевод издавна оценивался по поверхностному совпадению -грамм между переведённым выходом и эталонным переводом. Можно ли разработать метод оценки результатов машинного перевода с помощью логического вывода на естественном языке?
- Как изменить гиперпараметры, чтобы уменьшить размер словаря?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Bowman, S. R., Angeli, G., Potts, C., & Manning, C. D. (2015). A large annotated corpus for learning natural language inference. arXiv preprint arXiv:1508.05326.
15.5 Логический вывод на естественном языке: внимание
В разделе 15.4 мы представили задачу логического вывода на естественном языке и набор данных SNLI. Поскольку многие модели основаны на сложных и глубоких архитектурах, Parikh и др. предложили решать задачу логического вывода на естественном языке с помощью механизмов внимания и назвали этот подход «моделью декомпозируемого внимания» (decomposable attention model) (Parikh et al., 2016). Так получилась модель без рекуррентных и свёрточных слоёв, которая достигла на наборе данных SNLI лучшего на тот момент результата с гораздо меньшим числом параметров. В этом разделе мы опишем и реализуем такой метод логического вывода на естественном языке на основе внимания (с использованием многослойных перцептронов), как показано на рис. 15.5.1.
Рис. 15.5.1. Подача предобученных GloVe в архитектуру логического вывода на естественном языке на основе внимания и многослойных перцептронов
15.5.1 Модель
Вместо того чтобы сохранять порядок токенов в посылке и гипотезе, можно выровнять токены одной текстовой последовательности с каждым токеном другой, а затем сравнить и агрегировать эту информацию, чтобы предсказать логическое отношение между посылкой и гипотезой. Подобно выравниванию токенов между исходными и целевыми предложениями в машинном переводе, выравнивание токенов между посылкой и гипотезой можно гибко выполнять с помощью механизмов внимания.
Рис. 15.5.2. Логический вывод на естественном языке с помощью механизмов внимания
На рис. 15.5.2 показан метод логического вывода на естественном языке с механизмами внимания. На высоком уровне он состоит из трёх совместно обучаемых шагов: внимания (attending), сравнения (comparing) и агрегации (aggregating). Ниже мы опишем их шаг за шагом.
MXNet:
from d2l import mxnet as d2l
from mxnet import gluon, init, np, npx
from mxnet.gluon import nn
npx.set_np()
PyTorch:
from d2l import torch as d2l
import torch
from torch import nn
from torch.nn import functional as F
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
from paddle import nn
from paddle.nn import functional as F
15.5.1.1 Внимание (Attending)
Первый шаг — выровнять токены одной текстовой последовательности с каждым токеном другой. Допустим, посылка — «i do need sleep» («мне действительно нужно поспать»), а гипотеза — «i am tired» («я устал»). Из-за семантической близости можно выровнять «i» в гипотезе с «i» в посылке и «tired» в гипотезе с «sleep» в посылке. Аналогично можно выровнять «i» в посылке с «i» в гипотезе, а «need» и «sleep» в посылке — с «tired» в гипотезе. Обратите внимание, что такое выравнивание «мягкое» — оно использует взвешенное среднее, где в идеале большие веса связаны с токенами, которые нужно выровнять. Для простоты демонстрации на рис. 15.5.2 это выравнивание показано «жёстким» способом.
Теперь опишем мягкое выравнивание с механизмами внимания подробнее. Обозначим через и посылку и гипотезу, число токенов в которых равно и соответственно, где () — -мерные векторы слов. Для мягкого выравнивания мы вычисляем веса внимания как
где функция — многослойный перцептрон, определённый в следующей функции mlp. Выходная размерность задаётся аргументом num_hiddens функции mlp.
MXNet:
def mlp(num_hiddens, flatten):
net = nn.Sequential()
net.add(nn.Dropout(0.2))
net.add(nn.Dense(num_hiddens, activation='relu', flatten=flatten))
net.add(nn.Dropout(0.2))
net.add(nn.Dense(num_hiddens, activation='relu', flatten=flatten))
return net
PyTorch:
def mlp(num_inputs, num_hiddens, flatten):
net = []
net.append(nn.Dropout(0.2))
net.append(nn.Linear(num_inputs, num_hiddens))
net.append(nn.ReLU())
if flatten:
net.append(nn.Flatten(start_dim=1))
net.append(nn.Dropout(0.2))
net.append(nn.Linear(num_hiddens, num_hiddens))
net.append(nn.ReLU())
if flatten:
net.append(nn.Flatten(start_dim=1))
return nn.Sequential(*net)
PaddlePaddle:
def mlp(num_inputs, num_hiddens, flatten):
net = []
net.append(nn.Dropout(0.2))
net.append(nn.Linear(num_inputs, num_hiddens))
net.append(nn.ReLU())
if flatten:
net.append(nn.Flatten(start_axis=1))
net.append(nn.Dropout(0.2))
net.append(nn.Linear(num_hiddens, num_hiddens))
net.append(nn.ReLU())
if flatten:
net.append(nn.Flatten(start_axis=1))
return nn.Sequential(*net)
Следует отметить, что в (15.5.1) принимает на вход и по отдельности, а не пару из них вместе. Такой приём декомпозиции приводит к тому, что вычисляется всего раз (линейная сложность), а не раз (квадратичная сложность).
Нормируя веса внимания из (15.5.1), мы вычисляем взвешенное среднее всех векторов токенов гипотезы, чтобы получить представление гипотезы, мягко выровненной с токеном посылки с индексом :
Аналогично вычислим мягкое выравнивание токенов посылки для каждого токена гипотезы с индексом :
Ниже мы определяем класс Attend, который вычисляет мягкое выравнивание гипотезы (beta) с входной посылкой A и мягкое выравнивание посылки (alpha) с входной гипотезой B.
MXNet:
class Attend(nn.Block):
def __init__(self, num_hiddens, **kwargs):
super(Attend, self).__init__(**kwargs)
self.f = mlp(num_hiddens=num_hiddens, flatten=False)
def forward(self, A, B):
# Форма A/B: (размер минибатча, число токенов последовательности A/B,
# embed_size)
# Форма f_A/f_B: (размер минибатча, число токенов
# последовательности A/B, num_hiddens)
f_A = self.f(A)
f_B = self.f(B)
# Форма e: (размер минибатча, число токенов последовательности A,
# число токенов последовательности B)
e = npx.batch_dot(f_A, f_B, transpose_b=True)
# Форма beta: (размер минибатча, число токенов последовательности A,
# embed_size), то есть последовательность B мягко выравнивается
# с каждым токеном последовательности A (измерение 1 у beta)
beta = npx.batch_dot(npx.softmax(e), B)
# Форма alpha: (размер минибатча, число токенов последовательности B,
# embed_size), то есть последовательность A мягко выравнивается
# с каждым токеном последовательности B (измерение 1 у alpha)
alpha = npx.batch_dot(npx.softmax(e.transpose(0, 2, 1)), A)
return beta, alpha
PyTorch:
class Attend(nn.Module):
def __init__(self, num_inputs, num_hiddens, **kwargs):
super(Attend, self).__init__(**kwargs)
self.f = mlp(num_inputs, num_hiddens, flatten=False)
def forward(self, A, B):
# Форма A/B: (размер минибатча, число токенов последовательности A/B,
# embed_size)
# Форма f_A/f_B: (размер минибатча, число токенов
# последовательности A/B, num_hiddens)
f_A = self.f(A)
f_B = self.f(B)
# Форма e: (размер минибатча, число токенов последовательности A,
# число токенов последовательности B)
e = torch.bmm(f_A, f_B.permute(0, 2, 1))
# Форма beta: (размер минибатча, число токенов последовательности A,
# embed_size), то есть последовательность B мягко выравнивается
# с каждым токеном последовательности A (измерение 1 у beta)
beta = torch.bmm(F.softmax(e, dim=-1), B)
# Форма alpha: (размер минибатча, число токенов последовательности B,
# embed_size), то есть последовательность A мягко выравнивается
# с каждым токеном последовательности B (измерение 1 у alpha)
alpha = torch.bmm(F.softmax(e.permute(0, 2, 1), dim=-1), A)
return beta, alpha
PaddlePaddle:
class Attend(nn.Layer):
def __init__(self, num_inputs, num_hiddens, **kwargs):
super(Attend, self).__init__(**kwargs)
self.f = mlp(num_inputs, num_hiddens, flatten=False)
def forward(self, A, B):
# Форма A/B: (размер минибатча, число токенов последовательности A/B,
# embed_size)
# Форма f_A/f_B: (размер минибатча, число токенов
# последовательности A/B, num_hiddens)
f_A = self.f(A)
f_B = self.f(B)
# Форма e: (размер минибатча, число токенов последовательности A,
# число токенов последовательности B)
e = paddle.bmm(f_A, f_B.transpose([0, 2, 1]))
# Форма beta: (размер минибатча, число токенов последовательности A,
# embed_size), то есть последовательность B мягко выравнивается
# с каждым токеном последовательности A (измерение 1 у beta)
beta = paddle.bmm(F.softmax(e, axis=-1), B)
# Форма alpha: (размер минибатча, число токенов последовательности B,
# embed_size), то есть последовательность A мягко выравнивается
# с каждым токеном последовательности B (измерение 1 у alpha)
alpha = paddle.bmm(F.softmax(e.transpose([0, 2, 1]), axis=-1), A)
return beta, alpha
15.5.1.2 Сравнение (Comparing)
На следующем шаге мы сравниваем токен одной последовательности с той последовательностью, которая мягко с ним выровнена. Обратите внимание, что при мягком выравнивании все токены одной последовательности (хотя, возможно, с разными весами внимания) сравниваются с токеном другой последовательности. Для простоты демонстрации на рис. 15.5.2 токены выровнены жёстко. Например, если на шаге внимания (attending) определено, что «need» и «sleep» в посылке выровнены с «tired» в гипотезе, то будет сравниваться пара «tired — need sleep».
На шаге сравнения мы подаём конкатенацию (оператор ) токенов одной последовательности и выровненных токенов другой в функцию (многослойный перцептрон):
В (15.5.2) — это сравнение токена посылки со всеми токенами гипотезы, мягко выровненными с ним, а — сравнение токена гипотезы со всеми токенами посылки, мягко выровненными с ним. Шаг сравнения определяет следующий класс Compare.
MXNet:
class Compare(nn.Block):
def __init__(self, num_hiddens, **kwargs):
super(Compare, self).__init__(**kwargs)
self.g = mlp(num_hiddens=num_hiddens, flatten=False)
def forward(self, A, B, beta, alpha):
V_A = self.g(np.concatenate([A, beta], axis=2))
V_B = self.g(np.concatenate([B, alpha], axis=2))
return V_A, V_B
PyTorch:
class Compare(nn.Module):
def __init__(self, num_inputs, num_hiddens, **kwargs):
super(Compare, self).__init__(**kwargs)
self.g = mlp(num_inputs, num_hiddens, flatten=False)
def forward(self, A, B, beta, alpha):
V_A = self.g(torch.cat([A, beta], dim=2))
V_B = self.g(torch.cat([B, alpha], dim=2))
return V_A, V_B
PaddlePaddle:
class Compare(nn.Layer):
def __init__(self, num_inputs, num_hiddens, **kwargs):
super(Compare, self).__init__(**kwargs)
self.g = mlp(num_inputs, num_hiddens, flatten=False)
def forward(self, A, B, beta, alpha):
V_A = self.g(paddle.concat([A, beta], axis=2))
V_B = self.g(paddle.concat([B, alpha], axis=2))
return V_A, V_B
15.5.1.3 Агрегация (Aggregating)
Теперь у нас есть два набора векторов сравнения () и (). На последнем шаге мы агрегируем эту информацию, чтобы вывести логическое отношение. Сначала суммируем оба набора векторов сравнения:
Затем подаём конкатенацию двух сумм в функцию (многослойный перцептрон), чтобы получить результат классификации логического отношения:
Шаг агрегации определён в следующем классе Aggregate.
MXNet:
class Aggregate(nn.Block):
def __init__(self, num_hiddens, num_outputs, **kwargs):
super(Aggregate, self).__init__(**kwargs)
self.h = mlp(num_hiddens=num_hiddens, flatten=True)
self.h.add(nn.Dense(num_outputs))
def forward(self, V_A, V_B):
# Суммируем два набора векторов сравнения по отдельности
V_A = V_A.sum(axis=1)
V_B = V_B.sum(axis=1)
# Подаём конкатенацию двух сумм в многослойный перцептрон
Y_hat = self.h(np.concatenate([V_A, V_B], axis=1))
return Y_hat
PyTorch:
class Aggregate(nn.Module):
def __init__(self, num_inputs, num_hiddens, num_outputs, **kwargs):
super(Aggregate, self).__init__(**kwargs)
self.h = mlp(num_inputs, num_hiddens, flatten=True)
self.linear = nn.Linear(num_hiddens, num_outputs)
def forward(self, V_A, V_B):
# Суммируем два набора векторов сравнения по отдельности
V_A = V_A.sum(dim=1)
V_B = V_B.sum(dim=1)
# Подаём конкатенацию двух сумм в многослойный перцептрон
Y_hat = self.linear(self.h(torch.cat([V_A, V_B], dim=1)))
return Y_hat
PaddlePaddle:
class Aggregate(nn.Layer):
def __init__(self, num_inputs, num_hiddens, num_outputs, **kwargs):
super(Aggregate, self).__init__(**kwargs)
self.h = mlp(num_inputs, num_hiddens, flatten=True)
self.linear = nn.Linear(num_hiddens, num_outputs)
def forward(self, V_A, V_B):
# Суммируем два набора векторов сравнения по отдельности
V_A = V_A.sum(axis=1)
V_B = V_B.sum(axis=1)
# Подаём конкатенацию двух сумм в многослойный перцептрон
Y_hat = self.linear(self.h(paddle.concat([V_A, V_B], axis=1)))
return Y_hat
15.5.1.4 Сборка кода
Объединяя шаги внимания, сравнения и агрегации, мы определяем модель декомпозируемого внимания, совместно обучающую эти три шага.
MXNet:
class DecomposableAttention(nn.Block):
def __init__(self, vocab, embed_size, num_hiddens, **kwargs):
super(DecomposableAttention, self).__init__(**kwargs)
self.embedding = nn.Embedding(len(vocab), embed_size)
self.attend = Attend(num_hiddens)
self.compare = Compare(num_hiddens)
# Возможны 3 выхода: следование, противоречие и нейтральность
self.aggregate = Aggregate(num_hiddens, 3)
def forward(self, X):
premises, hypotheses = X
A = self.embedding(premises)
B = self.embedding(hypotheses)
beta, alpha = self.attend(A, B)
V_A, V_B = self.compare(A, B, beta, alpha)
Y_hat = self.aggregate(V_A, V_B)
return Y_hat
PyTorch:
class DecomposableAttention(nn.Module):
def __init__(self, vocab, embed_size, num_hiddens, num_inputs_attend=100,
num_inputs_compare=200, num_inputs_agg=400, **kwargs):
super(DecomposableAttention, self).__init__(**kwargs)
self.embedding = nn.Embedding(len(vocab), embed_size)
self.attend = Attend(num_inputs_attend, num_hiddens)
self.compare = Compare(num_inputs_compare, num_hiddens)
# Возможны 3 выхода: следование, противоречие и нейтральность
self.aggregate = Aggregate(num_inputs_agg, num_hiddens, num_outputs=3)
def forward(self, X):
premises, hypotheses = X
A = self.embedding(premises)
B = self.embedding(hypotheses)
beta, alpha = self.attend(A, B)
V_A, V_B = self.compare(A, B, beta, alpha)
Y_hat = self.aggregate(V_A, V_B)
return Y_hat
PaddlePaddle:
class DecomposableAttention(nn.Layer):
def __init__(self, vocab, embed_size, num_hiddens, num_inputs_attend=100,
num_inputs_compare=200, num_inputs_agg=400, **kwargs):
super(DecomposableAttention, self).__init__(**kwargs)
self.embedding = nn.Embedding(len(vocab), embed_size)
self.attend = Attend(num_inputs_attend, num_hiddens)
self.compare = Compare(num_inputs_compare, num_hiddens)
# Возможны 3 выхода: следование, противоречие и нейтральность
self.aggregate = Aggregate(num_inputs_agg, num_hiddens, num_outputs=3)
def forward(self, X):
premises, hypotheses = X
A = self.embedding(premises)
B = self.embedding(hypotheses)
beta, alpha = self.attend(A, B)
V_A, V_B = self.compare(A, B, beta, alpha)
Y_hat = self.aggregate(V_A, V_B)
return Y_hat
15.5.2 Обучение и оценка модели
Теперь мы обучим и оценим определённую модель декомпозируемого внимания на наборе данных SNLI. Начнём с чтения набора данных.
15.5.2.1 Чтение набора данных
Мы скачиваем и читаем набор данных SNLI с помощью функции, определённой в разделе 15.4. Размер минибатча и длина последовательности равны и соответственно.
MXNet, PyTorch:
batch_size, num_steps = 256, 50
train_iter, test_iter, vocab = d2l.load_data_snli(batch_size, num_steps)
PaddlePaddle:
def load_data_snli(batch_size, num_steps=50):
"""Скачивает набор данных SNLI и возвращает итераторы данных и словарь
Определено в разделе 15.4"""
data_dir = d2l.download_extract('SNLI')
train_data = d2l.read_snli(data_dir, True)
test_data = d2l.read_snli(data_dir, False)
train_set = d2l.SNLIDataset(train_data, num_steps)
test_set = d2l.SNLIDataset(test_data, num_steps, train_set.vocab)
train_iter = paddle.io.DataLoader(train_set,batch_size=batch_size,
shuffle=True,
num_workers=0,
return_list=True)
test_iter = paddle.io.DataLoader(test_set, batch_size=batch_size,
shuffle=False,
num_workers=0,
return_list=True)
return train_iter, test_iter, train_set.vocab
batch_size, num_steps = 256, 50
train_iter, test_iter, vocab = load_data_snli(batch_size, num_steps)
15.5.2.2 Создание модели
Для представления входных токенов мы используем предобученные 100-мерные вложения GloVe. Таким образом, размерность векторов и в (15.5.1) заранее задана равной 100. Выходная размерность функции в (15.5.1) и функции в (15.5.2) равна 200. Затем мы создаём экземпляр модели, инициализируем её параметры и загружаем вложения GloVe для инициализации векторов входных токенов.
MXNet:
embed_size, num_hiddens, devices = 100, 200, d2l.try_all_gpus()
net = DecomposableAttention(vocab, embed_size, num_hiddens)
net.initialize(init.Xavier(), ctx=devices)
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.set_data(embeds)
PyTorch:
embed_size, num_hiddens, devices = 100, 200, d2l.try_all_gpus()
net = DecomposableAttention(vocab, embed_size, num_hiddens)
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.data.copy_(embeds);
PaddlePaddle:
embed_size, num_hiddens, devices = 100, 200, d2l.try_all_gpus()
net = DecomposableAttention(vocab, embed_size, num_hiddens)
glove_embedding = d2l.TokenEmbedding('glove.6b.100d')
embeds = glove_embedding[vocab.idx_to_token]
net.embedding.weight.set_value(embeds);
15.5.2.3 Обучение и оценка модели
В отличие от функции split_batch из раздела 12.5, принимающей один вход (например, текстовую последовательность или изображение), мы определяем функцию split_batch_multi_inputs, которая принимает в минибатче несколько входов, например посылки и гипотезы.
MXNet:
#@save
def split_batch_multi_inputs(X, y, devices):
"""Разделяет многовходные 'X' и 'y' между несколькими устройствами"""
X = list(zip(*[gluon.utils.split_and_load(
feature, devices, even_split=False) for feature in X]))
return (X, gluon.utils.split_and_load(y, devices, even_split=False))
Теперь можно обучить и оценить модель на наборе данных SNLI.
MXNet:
lr, num_epochs = 0.001, 4
trainer = gluon.Trainer(net.collect_params(), 'adam', {'learning_rate': lr})
loss = gluon.loss.SoftmaxCrossEntropyLoss()
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices, split_batch_multi_inputs)
PyTorch:
lr, num_epochs = 0.001, 4
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)
PaddlePaddle:
lr, num_epochs = 0.001, 4
trainer = paddle.optimizer.Adam(learning_rate=lr, parameters=net.parameters())
loss = nn.CrossEntropyLoss(reduction="none")
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices[:1])
15.5.2.4 Использование модели
Наконец, определим функцию предсказания, которая выводит логическое отношение между парой посылки и гипотезы.
MXNet:
#@save
def predict_snli(net, vocab, premise, hypothesis):
"""Предсказывает логическое отношение между посылкой и гипотезой"""
premise = np.array(vocab[premise], ctx=d2l.try_gpu())
hypothesis = np.array(vocab[hypothesis], ctx=d2l.try_gpu())
label = np.argmax(net([premise.reshape((1, -1)),
hypothesis.reshape((1, -1))]), axis=1)
return 'entailment' if label == 0 else 'contradiction' if label == 1 \
else 'neutral'
PyTorch:
#@save
def predict_snli(net, vocab, premise, hypothesis):
"""Предсказывает логическое отношение между посылкой и гипотезой"""
net.eval()
premise = torch.tensor(vocab[premise], device=d2l.try_gpu())
hypothesis = torch.tensor(vocab[hypothesis], device=d2l.try_gpu())
label = torch.argmax(net([premise.reshape((1, -1)),
hypothesis.reshape((1, -1))]), dim=1)
return 'entailment' if label == 0 else 'contradiction' if label == 1 \
else 'neutral'
PaddlePaddle:
#@save
def predict_snli(net, vocab, premise, hypothesis):
"""Предсказывает логическое отношение между посылкой и гипотезой"""
net.eval()
premise = paddle.to_tensor(vocab[premise], place=d2l.try_gpu())
hypothesis = paddle.to_tensor(vocab[hypothesis], place=d2l.try_gpu())
label = paddle.argmax(net([premise.reshape((1, -1)),
hypothesis.reshape((1, -1))]), axis=1)
return 'entailment' if label == 0 else 'contradiction' if label == 1 \
else 'neutral'
С помощью обученной модели можно получить результат логического вывода на естественном языке для примера предложений.
predict_snli(net, vocab, ['he', 'is', 'good', '.'], ['he', 'is', 'bad', '.'])
Резюме
- Модель декомпозируемого внимания состоит из трёх шагов для предсказания логического отношения между посылкой и гипотезой: внимания, сравнения и агрегации.
- С помощью механизмов внимания можно выровнять токены одной текстовой последовательности с каждым токеном другой и наоборот. Это выравнивание мягкое и использует взвешенное среднее, где в идеале большие веса связаны с токенами, которые нужно выровнять.
- При вычислении весов внимания приём декомпозиции даёт линейную, а не квадратичную сложность, что выгоднее.
- В качестве входного представления для прикладных задач обработки естественного языка, таких как логический вывод на естественном языке, можно использовать предобученные векторы слов.
Упражнения
- Обучите модель с другими сочетаниями гиперпараметров. Можно ли получить более высокую точность на тестовом наборе?
- Каковы главные недостатки модели декомпозируемого внимания для логического вывода на естественном языке?
- Допустим, нужно получить уровень семантического сходства для любой пары предложений (например, непрерывное значение от 0 до 1). Как собрать и разметить набор данных? Попробуйте спроектировать модель с механизмами внимания.
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
Литература
- Parikh, A. P., Täckström, O., Das, D., & Uszkoreit, J. (2016). A decomposable attention model for natural language inference. arXiv preprint arXiv:1606.01933.
15.6 Дообучение BERT для приложений уровня последовательности и уровня токенов
В предыдущих разделах этой главы мы проектировали разные модели для приложений обработки естественного языка — например, на основе рекуррентных нейронных сетей, свёрточных нейронных сетей, внимания и многослойных перцептронов. Такие модели полезны, когда есть ограничения по пространству или времени, но на практике тщательно проектировать отдельную модель для каждой задачи обработки естественного языка невозможно. В разделе 14.8 мы представили предобученную модель BERT, которой для широкого круга задач обработки естественного языка требуются лишь минимальные изменения архитектуры. С одной стороны, на момент появления BERT улучшил лучшие известные результаты в разных задачах обработки естественного языка. С другой стороны, как отмечено в разделе 14.10, у двух версий исходной модели BERT 110 миллионов и 340 миллионов параметров. Поэтому при достаточных вычислительных ресурсах можно рассмотреть дообучение BERT для прикладных задач обработки естественного языка.
Далее мы рассмотрим ряд приложений обработки естественного языка, разделив их на приложения уровня последовательности и уровня токенов. На уровне последовательности мы покажем, как преобразовать представление текстового входа BERT в выходную метку в задачах классификации одиночного текста и классификации (или регрессии) пар текстов. На уровне токенов мы кратко рассмотрим новые приложения — разметку текста и ответы на вопросы — и покажем, как BERT представляет их входы и преобразует в выходные метки. При дообучении «минимальные изменения архитектуры», необходимые BERT для разных приложений, — это дополнительные полносвязные слои. При контролируемом обучении прикладной задачи параметры дополнительных слоёв обучаются с нуля, а все параметры предобученной модели BERT дообучаются.
15.6.1 Классификация одиночного текста
Классификация одиночного текста принимает на вход одну текстовую последовательность и выдаёт результат её классификации. Помимо анализа тональности, который мы изучали в этой главе, корпус лингвистической приемлемости (Corpus of Linguistic Acceptability, CoLA) — тоже набор данных для классификации одиночного текста, в котором нужно определить, приемлемо ли данное предложение с точки зрения грамматики (Warstadt et al., 2019). Например, «I should study.» приемлемо, а «I should studying.» — нет.
Рис. 15.6.1. Дообучение BERT для приложений классификации одиночного текста, таких как анализ тональности и проверка лингвистической приемлемости (здесь предполагается, что во входном одиночном тексте шесть токенов)
В разделе 14.8 описано входное представление BERT. Входная последовательность BERT однозначно представляет и одиночный текст, и пары текстов, где специальный токен классификации <cls> используется для классификации последовательности, а специальный токен <sep> отмечает конец одиночного текста или разделяет пару текстов. Как показано на рис. 15.6.1, в приложениях классификации одиночного текста представление BERT специального токена <cls> кодирует информацию всей входной текстовой последовательности. Как представление входного одиночного текста оно подаётся в небольшой многослойный перцептрон, состоящий из полносвязных (плотных) слоёв, чтобы получить распределение по всем дискретным значениям меток.
15.6.2 Классификация или регрессия пар текстов
В этой главе мы также изучили логический вывод на естественном языке. Он относится к классификации пар текстов — типу приложений, в которых классифицируется пара текстов.
Семантическое сходство текстов — популярная задача «регрессии пар текстов»: на вход подаётся пара текстов, а на выходе получается непрерывное значение. Эта задача оценивает семантическое сходство предложений. Например, в эталонном наборе данных семантического сходства текстов (Semantic Textual Similarity Benchmark) оценка сходства пары предложений — это балл на шкале от 0 (нет семантического перекрытия) до 5 (семантическая эквивалентность) (Cer et al., 2017). Цель — предсказывать эти баллы. Примеры из этого набора включают (предложение 1, предложение 2, оценка сходства):
- «A plane is taking off.» («Самолёт взлетает.»), «An air plane is taking off.» («Самолёт взлетает.»), 5.000;
- «A woman is eating something.» («Женщина что-то ест.»), «A woman is eating meat.» («Женщина ест мясо.»), 3.000;
- «A woman is dancing.» («Женщина танцует.»), «A man is talking.» («Мужчина разговаривает.»), 0.000.
Рис. 15.6.2. Дообучение BERT для приложений классификации или регрессии пар текстов, таких как логический вывод на естественном языке и семантическое сходство текстов (предполагается, что во входной паре текстов два и три токена соответственно)
По сравнению с классификацией одиночного текста на рис. 15.6.1, дообучение BERT для классификации пар текстов на рис. 15.6.2 отличается входным представлением. Для задач регрессии пар текстов, таких как семантическое сходство текстов, можно внести небольшие изменения, например выдавать непрерывное значение метки и использовать среднеквадратичные потери, которые обычны для регрессии.
15.6.3 Разметка текста
Теперь рассмотрим задачи уровня токенов, например разметку текста (text tagging), где каждому токену присваивается метка. Среди задач разметки текста разметка частей речи присваивает каждому слову метку части речи (например, прилагательное или определитель) в зависимости от роли слова в предложении. Например, по набору тегов Penn Treebank II предложение «John Smith’s car is new» должно быть размечено как «NNP (существительное, имя собственное, единственное число) NNP POS (окончание притяжательного падежа) NN (существительное, единственное число или неисчисляемое) VBZ (глагол, 3-е лицо единственного числа настоящего времени) JJ (прилагательное)».
Рис. 15.6.3. Дообучение BERT для приложений разметки текста, таких как разметка частей речи. Предполагается, что во входном одиночном тексте шесть токенов
Дообучение BERT для приложений разметки текста показано на рис. 15.6.3. По сравнению с рис. 15.6.1, единственное отличие в том, что в разметке текста представление BERT каждого токена входного текста подаётся в один и тот же дополнительный полносвязный слой, чтобы получить метку токена, например метку части речи.
15.6.4 Ответы на вопросы
Как ещё одно приложение уровня токенов, ответы на вопросы отражают способность к чтению с пониманием. Например, Stanford Question Answering Dataset (SQuAD v1.1) состоит из абзацев для чтения и вопросов, где ответом на каждый вопрос служит лишь фрагмент текста (текстовый отрезок) из абзаца (Rajpurkar et al., 2016). Возьмём в качестве примера абзац: «Some experts report that a mask’s efficacy is inconclusive. However, mask makers insist that their products, such as N95 respirator masks, can guard against the virus.» («Некоторые эксперты сообщают, что эффективность масок не доказана. Однако производители масок настаивают, что их продукция, например респираторы N95, может защитить от вируса.») и вопрос: «Who say that N95 respirator masks can guard against the virus?» («Кто говорит, что респираторы N95 могут защитить от вируса?»). Ответом должен быть текстовый отрезок «mask makers» («производители масок») из абзаца. Таким образом, цель SQuAD v1.1 — по заданным вопросу и абзацу предсказать начало и конец текстового отрезка в абзаце.
Рис. 15.6.4. Дообучение BERT для ответов на вопросы (предполагается, что во входной паре текстов два и три токена соответственно)
Чтобы дообучить BERT для ответов на вопросы, вопрос и абзац подаются во вход BERT как первая и вторая текстовые последовательности соответственно. Чтобы предсказать позицию начала текстового отрезка, один и тот же дополнительный полносвязный слой преобразует представление BERT любого токена из позиции в скалярную оценку . Оценки всех токенов абзаца дополнительно преобразуются softmax в распределение вероятностей, так что каждой позиции токена в абзаце присваивается вероятность быть началом текстового отрезка. Предсказание конца текстового отрезка делается так же, только параметры его дополнительного полносвязного слоя не зависят от параметров, использованных для предсказания начала. При предсказании конца токен в позиции преобразуется тем же полносвязным слоем в скалярную оценку . На рис. 15.6.4 показано дообучение BERT для ответов на вопросы.
Для ответов на вопросы цель контролируемого обучения так же проста, как максимизация логарифмического правдоподобия истинных позиций начала и конца. При предсказании отрезка можно вычислять оценку допустимого отрезка от позиции до позиции () и выдавать отрезок с наибольшей оценкой.
Резюме
- Для приложений уровня последовательности и уровня токенов BERT требует лишь минимальных изменений архитектуры (дополнительных полносвязных слоёв) — в классификации одиночного текста (например, анализе тональности и проверке лингвистической приемлемости), классификации или регрессии пар текстов (например, логическом выводе на естественном языке и семантическом сходстве текстов), разметке текста (например, разметке частей речи) и ответах на вопросы.
- При контролируемом обучении прикладной задачи параметры дополнительных слоёв обучаются с нуля, а все параметры предобученной модели BERT дообучаются.
Упражнения
- Давайте спроектируем алгоритм поисковой системы для новостных статей. Когда система получает запрос (например, «нефтяная промышленность во время вспышки коронавируса»), она должна вернуть ранжированный список новостных статей, наиболее релевантных запросу. Допустим, у нас есть огромный пул новостных статей и большое число запросов. Чтобы упростить задачу, предположим, что для каждого запроса размечена наиболее релевантная статья. Как применить отрицательную выборку (см. раздел 14.2.1) и BERT при проектировании алгоритма?
- Как использовать BERT для обучения языковых моделей?
- Можно ли использовать BERT в машинном переводе?
Литература
- Warstadt, A., Singh, A., & Bowman, S. R. (2019). Neural network acceptability judgments. Transactions of the Association for Computational Linguistics, 7, 625–641.
- Cer, D., Diab, M., Agirre, E., Lopez-Gazpio, I., & Specia, L. (2017). SemEval-2017 Task 1: Semantic Textual Similarity Multilingual and Crosslingual Focused Evaluation. In Proceedings of the 11th International Workshop on Semantic Evaluation (SemEval-2017), 1–14.
- Rajpurkar, P., Zhang, J., Lopyrev, K., & Liang, P. (2016). Squad: 100,000+ questions for machine comprehension of text. arXiv preprint arXiv:1606.05250.
15.7 Логический вывод на естественном языке: дообучение BERT
В предыдущих разделах этой главы мы спроектировали архитектуру на основе внимания (раздел 15.5) для задачи логического вывода на естественном языке на наборе данных SNLI (раздел 15.4). Теперь вернёмся к этой задаче, дообучая BERT. Как обсуждалось в разделе 15.6, логический вывод на естественном языке — это задача классификации пар текстов на уровне последовательности, а для дообучения BERT нужна лишь дополнительная архитектура на основе многослойного перцептрона, как показано на рис. 15.7.1.
Рис. 15.7.1. Подача предобученного BERT в архитектуру логического вывода на естественном языке на основе многослойного перцептрона
В этом разделе мы скачаем предобученную малую версию BERT и затем дообучим её для логического вывода на естественном языке на наборе данных SNLI.
MXNet:
from d2l import mxnet as d2l
import json
import multiprocessing
from mxnet import gluon, np, npx
from mxnet.gluon import nn
import os
npx.set_np()
PyTorch:
from d2l import torch as d2l
import json
import multiprocessing
import torch
from torch import nn
import os
PaddlePaddle:
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import json
import multiprocessing
import paddle
from paddle import nn
import os
15.7.1 Загрузка предобученного BERT
Мы предобучили BERT на наборе данных WikiText-2 в разделах 14.9 и 14.10 (заметим, что исходная модель BERT была предобучена на гораздо больших корпусах). Как обсуждалось в разделе 14.10, у исходной модели BERT сотни миллионов параметров. Ниже мы предоставляем две версии предобученного BERT: «bert.base» — такая же большая, как исходная базовая модель BERT, для её дообучения нужно много вычислительных ресурсов, а «bert.small» — малая версия для удобства демонстрации.
MXNet:
d2l.DATA_HUB['bert.base'] = (d2l.DATA_URL + 'bert.base.zip',
'7b3820b35da691042e5d34c0971ac3edbd80d3f4')
d2l.DATA_HUB['bert.small'] = (d2l.DATA_URL + 'bert.small.zip',
'a4e718a47137ccd1809c9107ab4f5edd317bae2c')
PyTorch:
d2l.DATA_HUB['bert.base'] = (d2l.DATA_URL + 'bert.base.torch.zip',
'225d66f04cae318b841a13d32af3acc165f253ac')
d2l.DATA_HUB['bert.small'] = (d2l.DATA_URL + 'bert.small.torch.zip',
'c72329e68a732bef0452e4b96a1c341c8910f81f')
PaddlePaddle:
d2l.DATA_HUB['bert_small'] = ('https://paddlenlp.bj.bcebos.com/models/bert.small.paddle.zip', '9fcde07509c7e87ec61c640c1b277509c7e87ec6153d9041758e4')
d2l.DATA_HUB['bert_base'] = ('https://paddlenlp.bj.bcebos.com/models/bert.base.paddle.zip', '9fcde07509c7e87ec61c640c1b27509c7e87ec61753d9041758e4')
Обе предобученные модели BERT содержат файл «vocab.json», определяющий словарь, и файл «pretrained.params» с предобученными параметрами. Мы реализуем следующую функцию load_pretrained_model, чтобы загрузить предобученные параметры BERT.
MXNet:
def load_pretrained_model(pretrained_model, num_hiddens, ffn_num_hiddens,
num_heads, num_layers, dropout, max_len, devices):
data_dir = d2l.download_extract(pretrained_model)
# Определяем пустой словарь, чтобы загрузить предопределённый словарь
vocab = d2l.Vocab()
vocab.idx_to_token = json.load(open(os.path.join(data_dir,
'vocab.json')))
vocab.token_to_idx = {token: idx for idx, token in enumerate(
vocab.idx_to_token)}
bert = d2l.BERTModel(len(vocab), num_hiddens, ffn_num_hiddens,
num_heads, num_layers, dropout, max_len)
# Загружаем предобученные параметры BERT
bert.load_parameters(os.path.join(data_dir, 'pretrained.params'),
ctx=devices)
return bert, vocab
PyTorch:
def load_pretrained_model(pretrained_model, num_hiddens, ffn_num_hiddens,
num_heads, num_layers, dropout, max_len, devices):
data_dir = d2l.download_extract(pretrained_model)
# Определяем пустой словарь, чтобы загрузить предопределённый словарь
vocab = d2l.Vocab()
vocab.idx_to_token = json.load(open(os.path.join(data_dir,
'vocab.json')))
vocab.token_to_idx = {token: idx for idx, token in enumerate(
vocab.idx_to_token)}
bert = d2l.BERTModel(len(vocab), num_hiddens, norm_shape=[256],
ffn_num_input=256, ffn_num_hiddens=ffn_num_hiddens,
num_heads=4, num_layers=2, dropout=0.2,
max_len=max_len, key_size=256, query_size=256,
value_size=256, hid_in_features=256,
mlm_in_features=256, nsp_in_features=256)
# Загружаем предобученные параметры BERT
bert.load_state_dict(torch.load(os.path.join(data_dir,
'pretrained.params')))
return bert, vocab
PaddlePaddle:
def load_pretrained_model(pretrained_model, num_hiddens, ffn_num_hiddens,
num_heads, num_layers, dropout, max_len, devices):
data_dir = d2l.download_extract(pretrained_model)
# Определяем пустой словарь, чтобы загрузить предопределённый словарь
vocab = d2l.Vocab()
vocab.idx_to_token = json.load(open(os.path.join(data_dir,
'vocab.json')))
vocab.token_to_idx = {token: idx for idx, token in enumerate(
vocab.idx_to_token)}
bert = d2l.BERTModel(len(vocab), num_hiddens, norm_shape=[256],
ffn_num_input=256, ffn_num_hiddens=ffn_num_hiddens,
num_heads=4, num_layers=2, dropout=0.2,
max_len=max_len, key_size=256, query_size=256,
value_size=256, hid_in_features=256,
mlm_in_features=256, nsp_in_features=256)
# Загружаем предобученные параметры BERT
bert.set_state_dict(paddle.load(os.path.join(data_dir,
'pretrained.pdparams')))
return bert, vocab
Чтобы демонстрацию можно было запустить на большинстве машин, в этом разделе мы загрузим и дообучим малую версию предобученного BERT («bert.small»). В упражнениях мы покажем, как дообучить гораздо более крупную «bert.base», чтобы заметно повысить точность на тесте.
MXNet, PyTorch:
devices = d2l.try_all_gpus()
bert, vocab = load_pretrained_model(
'bert.small', num_hiddens=256, ffn_num_hiddens=512, num_heads=4,
num_layers=2, dropout=0.1, max_len=512, devices=devices)
PaddlePaddle:
devices = d2l.try_all_gpus()
bert, vocab = load_pretrained_model(
'bert_small', num_hiddens=256, ffn_num_hiddens=512, num_heads=4,
num_layers=2, dropout=0.1, max_len=512, devices=devices)
15.7.2 Набор данных для дообучения BERT
Для прикладной задачи логического вывода на естественном языке на наборе данных SNLI мы определяем пользовательский класс набора данных SNLIBERTDataset. В каждом примере посылка и гипотеза образуют пару текстовых последовательностей и упаковываются в одну входную последовательность BERT, как показано на рис. 15.6.2. Вспомним из раздела 14.8.4, что индексы сегментов используются для различения посылки и гипотезы во входной последовательности BERT. Для заданной максимальной длины входной последовательности BERT (max_len) мы последовательно удаляем последний токен более длинного из текстов входной пары, пока не будет выполнено условие max_len. Чтобы ускорить генерацию набора данных SNLI для дообучения BERT, мы используем 4 рабочих процесса для параллельной генерации обучающих и тестовых примеров.
MXNet:
class SNLIBERTDataset(gluon.data.Dataset):
def __init__(self, dataset, max_len, vocab=None):
all_premise_hypothesis_tokens = [[
p_tokens, h_tokens] for p_tokens, h_tokens in zip(
*[d2l.tokenize([s.lower() for s in sentences])
for sentences in dataset[:2]])]
self.labels = np.array(dataset[2])
self.vocab = vocab
self.max_len = max_len
(self.all_token_ids, self.all_segments,
self.valid_lens) = self._preprocess(all_premise_hypothesis_tokens)
print('прочитано ' + str(len(self.all_token_ids)) + ' примеров')
def _preprocess(self, all_premise_hypothesis_tokens):
pool = multiprocessing.Pool(4) # Используем 4 процесса
out = pool.map(self._mp_worker, all_premise_hypothesis_tokens)
all_token_ids = [
token_ids for token_ids, segments, valid_len in out]
all_segments = [segments for token_ids, segments, valid_len in out]
valid_lens = [valid_len for token_ids, segments, valid_len in out]
return (np.array(all_token_ids, dtype='int32'),
np.array(all_segments, dtype='int32'),
np.array(valid_lens))
def _mp_worker(self, premise_hypothesis_tokens):
p_tokens, h_tokens = premise_hypothesis_tokens
self._truncate_pair_of_tokens(p_tokens, h_tokens)
tokens, segments = d2l.get_tokens_and_segments(p_tokens, h_tokens)
token_ids = self.vocab[tokens] + [self.vocab['<pad>']] \
* (self.max_len - len(tokens))
segments = segments + [0] * (self.max_len - len(segments))
valid_len = len(tokens)
return token_ids, segments, valid_len
def _truncate_pair_of_tokens(self, p_tokens, h_tokens):
# Резервируем место для токенов '<CLS>', '<SEP>' и '<SEP>' во входе BERT
while len(p_tokens) + len(h_tokens) > self.max_len - 3:
if len(p_tokens) > len(h_tokens):
p_tokens.pop()
else:
h_tokens.pop()
def __getitem__(self, idx):
return (self.all_token_ids[idx], self.all_segments[idx],
self.valid_lens[idx]), self.labels[idx]
def __len__(self):
return len(self.all_token_ids)
PyTorch:
class SNLIBERTDataset(torch.utils.data.Dataset):
def __init__(self, dataset, max_len, vocab=None):
all_premise_hypothesis_tokens = [[
p_tokens, h_tokens] for p_tokens, h_tokens in zip(
*[d2l.tokenize([s.lower() for s in sentences])
for sentences in dataset[:2]])]
self.labels = torch.tensor(dataset[2])
self.vocab = vocab
self.max_len = max_len
(self.all_token_ids, self.all_segments,
self.valid_lens) = self._preprocess(all_premise_hypothesis_tokens)
print('прочитано ' + str(len(self.all_token_ids)) + ' примеров')
def _preprocess(self, all_premise_hypothesis_tokens):
pool = multiprocessing.Pool(4) # Используем 4 процесса
out = pool.map(self._mp_worker, all_premise_hypothesis_tokens)
all_token_ids = [
token_ids for token_ids, segments, valid_len in out]
all_segments = [segments for token_ids, segments, valid_len in out]
valid_lens = [valid_len for token_ids, segments, valid_len in out]
return (torch.tensor(all_token_ids, dtype=torch.long),
torch.tensor(all_segments, dtype=torch.long),
torch.tensor(valid_lens))
def _mp_worker(self, premise_hypothesis_tokens):
p_tokens, h_tokens = premise_hypothesis_tokens
self._truncate_pair_of_tokens(p_tokens, h_tokens)
tokens, segments = d2l.get_tokens_and_segments(p_tokens, h_tokens)
token_ids = self.vocab[tokens] + [self.vocab['<pad>']] \
* (self.max_len - len(tokens))
segments = segments + [0] * (self.max_len - len(segments))
valid_len = len(tokens)
return token_ids, segments, valid_len
def _truncate_pair_of_tokens(self, p_tokens, h_tokens):
# Резервируем место для токенов '<CLS>', '<SEP>' и '<SEP>' во входе BERT
while len(p_tokens) + len(h_tokens) > self.max_len - 3:
if len(p_tokens) > len(h_tokens):
p_tokens.pop()
else:
h_tokens.pop()
def __getitem__(self, idx):
return (self.all_token_ids[idx], self.all_segments[idx],
self.valid_lens[idx]), self.labels[idx]
def __len__(self):
return len(self.all_token_ids)
PaddlePaddle:
class SNLIBERTDataset(paddle.io.Dataset):
def __init__(self, dataset, max_len, vocab=None):
all_premise_hypothesis_tokens = [[
p_tokens, h_tokens] for p_tokens, h_tokens in zip(
*[d2l.tokenize([s.lower() for s in sentences])
for sentences in dataset[:2]])]
self.labels = paddle.to_tensor(dataset[2])
self.vocab = vocab
self.max_len = max_len
(self.all_token_ids, self.all_segments,
self.valid_lens) = self._preprocess(all_premise_hypothesis_tokens)
print('прочитано ' + str(len(self.all_token_ids)) + ' примеров')
def _preprocess(self, all_premise_hypothesis_tokens):
# pool = multiprocessing.Pool(1) # Используем 4 процесса
# out = pool.map(self._mp_worker, all_premise_hypothesis_tokens)
out = []
for i in all_premise_hypothesis_tokens:
tempOut = self._mp_worker(i)
out.append(tempOut)
all_token_ids = [
token_ids for token_ids, segments, valid_len in out]
all_segments = [segments for token_ids, segments, valid_len in out]
valid_lens = [valid_len for token_ids, segments, valid_len in out]
return (paddle.to_tensor(all_token_ids, dtype='int64'),
paddle.to_tensor(all_segments, dtype='int64'),
paddle.to_tensor(valid_lens))
def _mp_worker(self, premise_hypothesis_tokens):
p_tokens, h_tokens = premise_hypothesis_tokens
self._truncate_pair_of_tokens(p_tokens, h_tokens)
tokens, segments = d2l.get_tokens_and_segments(p_tokens, h_tokens)
token_ids = self.vocab[tokens] + [self.vocab['<pad>']] \
* (self.max_len - len(tokens))
segments = segments + [0] * (self.max_len - len(segments))
valid_len = len(tokens)
return token_ids, segments, valid_len
def _truncate_pair_of_tokens(self, p_tokens, h_tokens):
# Резервируем место для токенов '<CLS>', '<SEP>' и '<SEP>' во входе BERT
while len(p_tokens) + len(h_tokens) > self.max_len - 3:
if len(p_tokens) > len(h_tokens):
p_tokens.pop()
else:
h_tokens.pop()
def __getitem__(self, idx):
return (self.all_token_ids[idx], self.all_segments[idx],
self.valid_lens[idx]), self.labels[idx]
def __len__(self):
return len(self.all_token_ids)
После скачивания набора данных SNLI мы генерируем обучающие и тестовые примеры, создавая экземпляры класса SNLIBERTDataset. Эти примеры будут читаться минибатчами при обучении и тестировании логического вывода на естественном языке.
MXNet:
# Если возникает ошибка нехватки видеопамяти, уменьшите «batch_size».
# В исходной модели BERT max_len=512
batch_size, max_len, num_workers = 512, 128, d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_set = SNLIBERTDataset(d2l.read_snli(data_dir, True), max_len, vocab)
test_set = SNLIBERTDataset(d2l.read_snli(data_dir, False), max_len, vocab)
train_iter = gluon.data.DataLoader(train_set, batch_size, shuffle=True,
num_workers=num_workers)
test_iter = gluon.data.DataLoader(test_set, batch_size,
num_workers=num_workers)
PyTorch:
# Если возникает ошибка нехватки видеопамяти, уменьшите «batch_size».
# В исходной модели BERT max_len=512
batch_size, max_len, num_workers = 512, 128, d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_set = SNLIBERTDataset(d2l.read_snli(data_dir, True), max_len, vocab)
test_set = SNLIBERTDataset(d2l.read_snli(data_dir, False), max_len, vocab)
train_iter = torch.utils.data.DataLoader(train_set, batch_size, shuffle=True,
num_workers=num_workers)
test_iter = torch.utils.data.DataLoader(test_set, batch_size,
num_workers=num_workers)
PaddlePaddle:
# Если возникает ошибка нехватки видеопамяти, уменьшите «batch_size».
# В исходной модели BERT max_len=512
batch_size, max_len, num_workers = 512, 128, d2l.get_dataloader_workers()
data_dir = d2l.download_extract('SNLI')
train_set = SNLIBERTDataset(d2l.read_snli(data_dir, True), max_len, vocab)
test_set = SNLIBERTDataset(d2l.read_snli(data_dir, False), max_len, vocab)
train_iter = paddle.io.DataLoader(train_set, batch_size=batch_size, shuffle=True, return_list=True)
test_iter = paddle.io.DataLoader(test_set, batch_size=batch_size, return_list=True)
15.7.3 Дообучение BERT
Как показано на рис. 15.6.2, для дообучения BERT для логического вывода на естественном языке нужен лишь дополнительный многослойный перцептрон из двух полносвязных слоёв (см. self.hidden и self.output в следующем классе BERTClassifier). Этот многослойный перцептрон преобразует представление BERT специального токена <cls>, кодирующее информацию и посылки, и гипотезы, в три выхода логического вывода на естественном языке: следование, противоречие и нейтральность.
MXNet:
class BERTClassifier(nn.Block):
def __init__(self, bert):
super(BERTClassifier, self).__init__()
self.encoder = bert.encoder
self.hidden = bert.hidden
self.output = nn.Dense(3)
def forward(self, inputs):
tokens_X, segments_X, valid_lens_x = inputs
encoded_X = self.encoder(tokens_X, segments_X, valid_lens_x)
return self.output(self.hidden(encoded_X[:, 0, :]))
PyTorch:
class BERTClassifier(nn.Module):
def __init__(self, bert):
super(BERTClassifier, self).__init__()
self.encoder = bert.encoder
self.hidden = bert.hidden
self.output = nn.Linear(256, 3)
def forward(self, inputs):
tokens_X, segments_X, valid_lens_x = inputs
encoded_X = self.encoder(tokens_X, segments_X, valid_lens_x)
return self.output(self.hidden(encoded_X[:, 0, :]))
PaddlePaddle:
class BERTClassifier(nn.Layer):
def __init__(self, bert):
super(BERTClassifier, self).__init__()
self.encoder = bert.encoder
self.hidden = bert.hidden
self.output = nn.Linear(256, 3)
def forward(self, inputs):
tokens_X, segments_X, valid_lens_x = inputs
encoded_X = self.encoder(tokens_X, segments_X, valid_lens_x.squeeze(1))
return self.output(self.hidden(encoded_X[:, 0, :]))
Далее предобученная модель BERT bert подаётся в экземпляр net класса BERTClassifier для прикладной задачи. В типичных реализациях дообучения BERT с нуля обучаются только параметры выходного слоя дополнительного многослойного перцептрона (net.output). Все параметры предобученного кодировщика BERT (net.encoder) и скрытого слоя дополнительного многослойного перцептрона (net.hidden) будут дообучаться.
MXNet:
net = BERTClassifier(bert)
net.output.initialize(ctx=devices)
PyTorch, PaddlePaddle:
net = BERTClassifier(bert)
Вспомним, что в разделе 14.8 классы MaskLM и NextSentencePred содержат параметры в используемых ими многослойных перцептронах. Эти параметры входят в параметры предобученной модели BERT bert и, следовательно, в параметры net. Однако такие параметры используются лишь для вычисления потерь маскированной языковой модели и потерь предсказания следующего предложения при предобучении. Эти две функции потерь не относятся к дообучению для прикладных задач, поэтому при дообучении BERT параметры многослойных перцептронов в MaskLM и NextSentencePred не обновляются (устаревают, stale).
Чтобы допустить параметры с устаревшими градиентами, в функции step внутри d2l.train_batch_ch13 установлен флаг ignore_stale_grad=True. С помощью этой функции мы обучаем и оцениваем модель net на обучающем (train_iter) и тестовом (test_iter) наборах SNLI. Из-за ограниченных вычислительных ресурсов точность обучения и тестирования можно ещё повысить: обсуждение мы оставляем для упражнений.
MXNet:
lr, num_epochs = 1e-4, 5
trainer = gluon.Trainer(net.collect_params(), 'adam', {'learning_rate': lr})
loss = gluon.loss.SoftmaxCrossEntropyLoss()
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices, d2l.split_batch_multi_inputs)
PyTorch:
lr, num_epochs = 1e-4, 5
trainer = torch.optim.Adam(net.parameters(), lr=lr)
loss = nn.CrossEntropyLoss(reduction='none')
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)
PaddlePaddle:
lr, num_epochs = 1e-4, 5
trainer = paddle.optimizer.Adam(learning_rate=lr, parameters=net.parameters())
loss = nn.CrossEntropyLoss(reduction='none')
d2l.train_ch13(net, train_iter, test_iter, loss, trainer, num_epochs,
devices)
Резюме
- Предобученную модель BERT можно дообучить для прикладных задач, например для логического вывода на естественном языке на наборе данных SNLI.
- При дообучении модель BERT становится частью модели прикладной задачи. Параметры, связанные только с потерями предобучения, при дообучении не обновляются.
Упражнения
- Если позволяют вычислительные ресурсы, дообучите гораздо более крупную предобученную модель BERT, такую же большую, как исходная базовая модель BERT. Измените настройки аргументов функции
load_pretrained_model: замените «bert.small» на «bert.base» и увеличьте значенияnum_hiddens=256,ffn_num_hiddens=512,num_heads=4иnum_layers=2до 768, 3072, 12 и 12 соответственно. Увеличив число эпох дообучения (и, возможно, настроив другие гиперпараметры), можно ли получить точность на тесте выше 0.86? - Как усекать пару последовательностей согласно отношению их длин? Сравните этот метод усечения пар с использованным в классе
SNLIBERTDataset. Каковы их плюсы и минусы?
MXNet: Обсуждение
PyTorch: Обсуждение
PaddlePaddle: Обсуждение
16. Приложение: инструменты для глубокого обучения
Чтобы вы могли в полной мере воспользоваться книгой «Погружение в глубокое обучение», в этом приложении мы представим разные инструменты: например, расскажем, как запускать эту интерактивную книгу с открытым исходным кодом и как вносить в неё свой вклад.
16.1 Использование Jupyter Notebook
В этом разделе рассказано, как редактировать и запускать код из глав книги с помощью Jupyter Notebook. Убедитесь, что вы установили Jupyter и скачали код, как описано в разделе «Установка». Если вы хотите узнать о Jupyter больше, обратитесь к отличным руководствам в его документации.
16.1.1 Редактирование и запуск кода локально
Предположим, что локальный путь к коду книги — xx/yy/d2l-zh/. Перейдите в оболочке в этот каталог (cd xx/yy/d2l-zh) и выполните команду jupyter notebook. Если браузер не открылся автоматически, откройте http://localhost:8888. Вы увидите интерфейс Jupyter и все папки с кодом книги, как показано на рис. 16.1.1.
Рис. 16.1.1. Папки с кодом книги
Файлы блокнотов открываются щелчком по папкам на веб-странице. Обычно они имеют расширение «.ipynb». Для краткости мы создали временный файл «test.ipynb». Его содержимое после щелчка показано на рис. 16.1.2. Этот блокнот содержит одну ячейку Markdown и одну ячейку с кодом. В ячейке Markdown находятся «This Is a Title» и «This is text.». Ячейка с кодом содержит две строки кода на Python.
Рис. 16.1.2. Ячейки Markdown и кода в файле «test.ipynb»
Дважды щёлкните по ячейке Markdown, чтобы перейти в режим редактирования. Добавьте в конец ячейки новую строку «Hello world.», как показано на рис. 16.1.3.
Рис. 16.1.3. Редактирование ячейки Markdown
Как показано на рис. 16.1.4, выберите в строке меню «Cell» «Run Cells», чтобы выполнить изменённую ячейку.
Рис. 16.1.4. Выполнение ячейки
После выполнения ячейка Markdown выглядит так, как показано на рис. 16.1.5.
Рис. 16.1.5. Ячейка Markdown после редактирования
Затем щёлкните по ячейке с кодом. Умножьте на 2 элемент после последней строки кода, как показано на рис. 16.1.6.
Рис. 16.1.6. Редактирование ячейки с кодом
Ячейку также можно выполнить сочетанием клавиш (по умолчанию Ctrl+Enter); результат вывода показан на рис. 16.1.7.
Рис. 16.1.7. Выполнение ячейки с кодом и вывод результата
Когда в блокноте много ячеек, можно выбрать в меню «Kernel» «Restart & Run All», чтобы выполнить все ячейки блокнота. Выбрав «Help» «Edit Keyboard Shortcuts», можно изменить сочетания клавиш по своему вкусу.
16.1.2 Дополнительные возможности
Помимо локального редактирования, важны ещё две вещи: редактирование блокнотов в формате Markdown и удалённый запуск Jupyter. Второе важно, когда мы хотим запускать код на более быстром сервере. Первое важно потому, что собственный формат Jupyter — ipynb — хранит много вспомогательных данных, которые на самом деле не относятся к содержимому блокнота, а в основном связаны с тем, как и где запускался код. Это сбивает с толку git и сильно затрудняет слияние правок. К счастью, есть альтернатива — локальное редактирование в Markdown.
16.1.2.1 Файлы Markdown в Jupyter
Если вы хотите внести вклад в содержание книги, вам нужно изменять исходные файлы на GitHub (md-файлы, а не ipynb). С помощью плагина notedown можно изменять блокноты в формате md прямо в Jupyter.
Сначала установите плагин notedown, запустите Jupyter Notebook и загрузите плагин:
pip install d2l-notedown # возможно, придётся удалить исходный notedown
jupyter notebook --NotebookApp.contents_manager_class='notedown.NotedownContentsManager'
Чтобы плагин notedown включался по умолчанию при запуске Jupyter Notebook, сделайте следующее. Сначала сгенерируйте файл конфигурации Jupyter Notebook (если он уже создан, этот шаг можно пропустить).
jupyter notebook --generate-config
Затем добавьте в конец файла конфигурации Jupyter Notebook следующую строку (в Linux/macOS он обычно находится в ~/.jupyter/jupyter_notebook_config.py):
c.NotebookApp.contents_manager_class = 'notedown.NotedownContentsManager'
После этого для запуска с плагином notedown по умолчанию достаточно выполнить команду jupyter notebook.
16.1.2.2 Запуск Jupyter Notebook на удалённом сервере
Иногда бывает нужно запустить Jupyter Notebook на удалённом сервере и работать с ним через браузер на локальном компьютере. Если на локальном компьютере установлена Linux или macOS (в Windows это тоже возможно с помощью стороннего ПО, например PuTTY), можно использовать перенаправление портов:
ssh myserver -L 8888:localhost:8888
Здесь myserver — адрес удалённого сервера. После этого по адресу http://localhost:8888 мы можем обратиться к удалённому серверу myserver, на котором запущен Jupyter Notebook. Как запускать Jupyter Notebook на экземпляре AWS, подробно рассказано в разделе 16.3.
16.1.2.3 Время выполнения
С помощью плагина ExecuteTime можно измерять время выполнения каждой ячейки с кодом в Jupyter Notebook. Установите плагин следующими командами:
pip install jupyter_contrib_nbextensions
jupyter contrib nbextension install --user
jupyter nbextension enable execute_time/ExecuteTime
Резюме
- С помощью Jupyter Notebook можно редактировать и запускать код книги и вносить в неё свой вклад.
- Для запуска Jupyter Notebook на удалённом сервере используется перенаправление портов.
Упражнения
- Отредактируйте и запустите код из этой книги с помощью Jupyter Notebook на локальном компьютере.
- Отредактируйте и запустите код из этой книги удалённо с помощью Jupyter Notebook и перенаправления портов.
- Для двух квадратных матриц и в измерьте время выполнения операций и . Какая из них быстрее?
16.2 Использование Amazon SageMaker
Программам глубокого обучения может требоваться много вычислительных ресурсов — легко больше, чем способен дать ваш локальный компьютер. Облачные сервисы позволяют запускать код этой книги, интенсивно использующий GPU, на более мощных компьютерах и гораздо проще. В этом разделе рассказано, как запускать код книги с помощью Amazon SageMaker.
16.2.1 Регистрация
Сначала нужно зарегистрировать учётную запись на https://aws.amazon.com/. Для повышения безопасности рекомендуется включить двухфакторную аутентификацию. Также стоит настроить подробные оповещения о счетах и расходах, чтобы избежать неприятных неожиданностей — например, если вы забудете остановить работающий экземпляр. Войдя в учётную запись AWS, перейдите в консоль, найдите в ней «Amazon SageMaker» и щёлкните по найденному сервису, чтобы открыть панель SageMaker.
16.2.2 Создание экземпляра SageMaker
Теперь создадим экземпляр блокнота (notebook instance). В левом меню панели SageMaker откройте «Notebook» «Notebook instances», а затем нажмите оранжевую кнопку «Create notebook instance».
SageMaker предлагает несколько типов экземпляров с разной вычислительной мощностью и ценой. При создании экземпляра блокнота можно указать его имя и тип. Мы дадим экземпляру имя «D2L» и выберем тип ml.p3.2xlarge: один GPU Tesla V100 и 8-ядерный CPU. Производительности этого экземпляра достаточно для большей части книги.
MXNet: весь текст книги в формате ipynb для запуска в SageMaker доступен по адресу https://github.com/d2l-ai/d2l-en-sagemaker. Этот URL репозитория GitHub можно указать в настройках экземпляра (раздел «Git repositories» «Default repository», вариант «Clone a public Git repository to this notebook instance only»), чтобы SageMaker клонировал его при создании экземпляра.
PyTorch: весь текст книги в формате ipynb для запуска в SageMaker доступен по адресу https://github.com/d2l-ai/d2l-pytorch-sagemaker. Этот URL репозитория GitHub можно указать в настройках экземпляра (раздел «Git repositories» «Default repository», вариант «Clone a public Git repository to this notebook instance only»), чтобы SageMaker клонировал его при создании экземпляра.
TensorFlow: весь текст книги в формате ipynb для запуска в SageMaker доступен по адресу https://github.com/d2l-ai/d2l-tensorflow-sagemaker. Этот URL репозитория GitHub можно указать в настройках экземпляра (раздел «Git repositories» «Default repository», вариант «Clone a public Git repository to this notebook instance only»), чтобы SageMaker клонировал его при создании экземпляра.
16.2.3 Запуск и остановка экземпляра
Создание экземпляра может занять несколько минут. Когда экземпляр будет готов (статус «InService»), щёлкните рядом с ним по ссылке «Open Jupyter», чтобы редактировать и запускать на этом экземпляре все блокноты Jupyter из этой книги (аналогично шагам из раздела 16.1).
Закончив работу, не забудьте остановить экземпляр, чтобы не платить за него дальше: для этого в списке экземпляров откройте меню «Actions» и выберите «Stop».
16.2.4 Обновление блокнотов
MXNet: блокноты этой книги с открытым исходным кодом регулярно обновляются в репозитории d2l-ai/d2l-en-sagemaker на GitHub. Чтобы обновиться до последней версии, откройте терминал на экземпляре SageMaker: в интерфейсе Jupyter нажмите кнопку «New» и выберите «Terminal».
PyTorch: блокноты этой книги с открытым исходным кодом регулярно обновляются в репозитории d2l-ai/d2l-pytorch-sagemaker на GitHub. Чтобы обновиться до последней версии, откройте терминал на экземпляре SageMaker: в интерфейсе Jupyter нажмите кнопку «New» и выберите «Terminal».
TensorFlow: блокноты этой книги с открытым исходным кодом регулярно обновляются в репозитории d2l-ai/d2l-tensorflow-sagemaker на GitHub. Чтобы обновиться до последней версии, откройте терминал на экземпляре SageMaker: в интерфейсе Jupyter нажмите кнопку «New» и выберите «Terminal».
Возможно, перед получением обновлений из удалённого репозитория вы захотите зафиксировать (commit) локальные изменения. В противном случае просто отбросьте все локальные изменения следующими командами в терминале:
MXNet:
cd SageMaker/d2l-en-sagemaker/
git reset --hard
git pull
PyTorch:
cd SageMaker/d2l-pytorch-sagemaker/
git reset --hard
git pull
TensorFlow:
cd SageMaker/d2l-tensorflow-sagemaker/
git reset --hard
git pull
Резюме
- С помощью Amazon SageMaker можно создать экземпляр блокнота с GPU и запускать на нём ресурсоёмкий код этой книги.
- Блокноты можно обновлять через терминал на экземпляре Amazon SageMaker.
Упражнения
- Отредактируйте и запустите с помощью Amazon SageMaker любой раздел, которому нужен GPU.
- Откройте терминал, чтобы получить доступ к локальному каталогу, где хранятся все блокноты этой книги.
16.3 Использование экземпляров Amazon EC2
В этом разделе показано, как установить все библиотеки на «голой» Linux-машине. Напомним, что в разделе 16.2 рассказывалось об Amazon SageMaker; создание собственного экземпляра в облаке обходится дешевле. Пример состоит из трёх шагов:
- Запросить у AWS EC2 экземпляр Linux с GPU.
- Установить CUDA (или воспользоваться образом Amazon Machine Image с предустановленной CUDA).
- Установить фреймворк глубокого обучения и другие библиотеки, необходимые для запуска кода книги.
Эта процедура подходит и для других экземпляров (и других облаков), хотя потребуются небольшие изменения. Прежде чем продолжить, нужно создать учётную запись AWS; подробности см. в разделе 16.2.
16.3.1 Создание и запуск экземпляра EC2
Войдя в учётную запись AWS, откройте панель EC2, выбрав сервис «EC2» в консоли AWS. На панели EC2 слева находятся разделы «Instances», «Limits» и другие, а в центре — кнопка «Launch Instance».
16.3.1.1 Выбор региона
Выберите ближайший центр обработки данных, чтобы уменьшить задержку, например «Oregon» (Орегон): регион выбирается в меню в правом верхнем углу консоли. Если вы находитесь в Китае, можно выбрать ближайший азиатско-тихоокеанский регион, например Сеул или Токио. Имейте в виду, что в некоторых центрах обработки данных экземпляров с GPU может не быть.
16.3.1.2 Увеличение лимитов
Прежде чем выбирать экземпляр, проверьте, нет ли ограничений на их количество: откройте вкладку «Limits» (лимиты) в левой панели. В нашем примере аккаунт не может запускать экземпляры p2.xlarge в данном регионе. Если нужно запустить один или несколько экземпляров, нажмите ссылку «Request limit increase» (запросить увеличение лимита) и подайте заявку на более высокую квоту. Обычно её обработка занимает один рабочий день.
16.3.1.3 Запуск экземпляра
Далее нажмите кнопку «Launch Instance» (запустить экземпляр) на панели EC2, чтобы запустить свой экземпляр.
Сначала выберем подходящий образ Amazon Machine Image (AMI). Введите в строке поиска «ubuntu» и выберите нужный образ — например, Ubuntu Server 18.04 LTS (HVM), SSD Volume Type, архитектура 64-bit (x86) — кнопкой «Select».
У EC2 множество разных конфигураций экземпляров, и новичку в них порой сложно разобраться. В таблице 16.3.1 перечислены подходящие машины.
Таблица 16.3.1. Типы экземпляров EC2
| Название | GPU | Примечания |
|---|---|---|
| g2 | Grid K520 | устарел |
| p2 | Kepler K80 | старый GPU, но spot-экземпляры обычно дёшевы |
| g3 | Maxwell M60 | хороший баланс |
| p3 | Volta V100 | высокая производительность для FP16 |
| g4 | Turing T4 | оптимизирован для вывода в FP16/INT8 |
Все эти серверы выпускаются в нескольких вариантах, которые различаются числом GPU. Например, у p2.xlarge один GPU, а у p2.16xlarge — 16 GPU и больше памяти. Подробнее см. в документации Amazon EC2.
Обратите внимание: нужно использовать экземпляр с поддержкой GPU, подходящие драйверы и фреймворк глубокого обучения с поддержкой GPU. Иначе вы не получите никакой выгоды от GPU. В нашем примере выберем экземпляр p2.xlarge (в таблице экземпляров он обозначен как «GPU instances»: 4 vCPU, 61 ГБ памяти) и нажмём «Next: Configure Instance Details».
Таким образом, мы выполнили первые два из семи шагов запуска экземпляра EC2 — они показаны во вкладках вверху мастера. В этом примере для шагов «3. Configure Instance» (настройка экземпляра), «5. Add Tags» (добавление тегов) и «6. Configure Security Group» (настройка группы безопасности) оставим конфигурацию по умолчанию. Откройте «4. Add Storage» (добавление хранилища) и увеличьте размер жёсткого диска по умолчанию до 64 ГБ (поле «Size (GiB)»). Учтите, что сама CUDA уже занимает 4 ГБ.
Наконец, перейдите к шагу «7. Review» (проверка) и нажмите «Launch» (запустить), чтобы запустить настроенный экземпляр. Система предложит выбрать пару ключей для доступа к экземпляру. Если пары ключей у вас нет, выберите в первом выпадающем меню «Create a new key pair» (создать новую пару ключей), чтобы сгенерировать её. После этого в этом меню можно будет выбрать «Choose an existing key pair» (выбрать существующую пару ключей) и указать ранее созданную. Нажмите «Launch Instances» (запустить экземпляры), чтобы запустить созданный экземпляр.
Если вы сгенерировали новую пару ключей, обязательно скачайте её и сохраните в надёжном месте: это единственный способ подключиться к серверу по SSH. Щёлкните по идентификатору экземпляра (Instance ID) на странице запуска, чтобы увидеть его состояние.
16.3.1.4 Подключение к экземпляру
Когда состояние экземпляра станет зелёным (running), щёлкните по нему правой кнопкой мыши и выберите Connect (подключиться), чтобы увидеть способы доступа к экземпляру.
Если ключ новый, он не должен быть общедоступным для просмотра, иначе SSH не будет работать. Перейдите в папку, где хранится D2L_key.pem, и выполните следующую команду, чтобы закрыть ключ от просмотра другими пользователями:
chmod 400 D2L_key.pem
Теперь скопируйте команду ssh из диалога подключения (поле «Example») и вставьте её в командную строку:
ssh -i "D2L_key.pem" ubuntu@ec2-xx-xxx-xxx-xxx.y.compute.amazonaws.com
Когда в командной строке появится вопрос «Are you sure you want to continue connecting (yes/no)» («Вы уверены, что хотите продолжить подключение? (да/нет)»), введите «yes» и нажмите Enter, чтобы войти на экземпляр.
Ваш сервер готов.
16.3.2 Установка CUDA
Прежде чем устанавливать CUDA, обновите экземпляр до последних версий драйверов.
sudo apt-get update && sudo apt-get install -y build-essential git libgfortran3
Мы скачиваем здесь CUDA 10.1. Откройте официальный репозиторий NVIDIA, чтобы найти ссылку на загрузку: выберите нужную версию CUDA Toolkit, операционную систему (Linux), архитектуру (x86_64), дистрибутив (Ubuntu), версию (18.04) и тип установщика («deb (local)»); внизу страницы будут показаны команды установки.
Скопируйте эти инструкции в терминал, чтобы установить CUDA 10.1.
# Ссылки и имена файлов могут измениться; ориентируйтесь на официальный сайт NVIDIA
wget https://developer.download.nvidia.com/compute/cuda/repos/ubuntu1804/x86_64/cuda-ubuntu1804.pin
sudo mv cuda-ubuntu1804.pin /etc/apt/preferences.d/cuda-repository-pin-600
wget http://developer.download.nvidia.com/compute/cuda/10.1/Prod/local_installers/cuda-repo-ubuntu1804-10-1-local-10.1.243-418.87.00_1.0-1_amd64.deb
sudo dpkg -i cuda-repo-ubuntu1804-10-1-local-10.1.243-418.87.00_1.0-1_amd64.deb
sudo apt-key add /var/cuda-repo-10-1-local-10.1.243-418.87.00/7fa2af80.pub
sudo apt-get update
sudo apt-get -y install cuda
После установки программы выполните следующую команду, чтобы увидеть GPU:
nvidia-smi
Наконец, добавьте CUDA в путь поиска библиотек, чтобы другие библиотеки могли её найти.
echo "export LD_LIBRARY_PATH=\${LD_LIBRARY_PATH}:/usr/local/cuda/lib64" >> ~/.bashrc
16.3.3 Установка библиотек для запуска кода
Чтобы запустить код этой книги, достаточно выполнить на экземпляре EC2 шаги из раздела «Установка» для пользователей Linux и воспользоваться следующими советами по работе на удалённом Linux-сервере.
- Чтобы скачать bash-скрипт со страницы установки Miniconda, щёлкните по ссылке для скачивания правой кнопкой мыши, выберите «Copy Link Address» (копировать адрес ссылки) и выполните
wget [скопированный адрес ссылки]. - Выполните
~/miniconda3/bin/conda init; чтобы не закрывать и не открывать заново текущую оболочку, возможно, придётся выполнитьsource ~/.bashrc.
16.3.4 Удалённый запуск блокнотов Jupyter
Чтобы запускать блокноты Jupyter удалённо, нужно использовать перенаправление портов SSH. Ведь у облачного сервера нет ни монитора, ни клавиатуры. Для этого войдите на сервер со своего настольного компьютера (или ноутбука) следующим образом:
# Эту команду нужно выполнять в локальной командной строке
ssh -i "/path/to/key.pem" ubuntu@ec2-xx-xxx-xxx-xxx.y.compute.amazonaws.com -L 8889:localhost:8888
Затем перейдите на экземпляре EC2 в каталог, куда скачан код книги, и выполните:
conda activate d2l
jupyter notebook
В выводе запущенного Jupyter Notebook последняя строка — URL порта 8888, вида http://localhost:8888/?token=....
Поскольку мы используем перенаправление на порт 8889, скопируйте эту последнюю строку, замените в URL «8888» на «8889» и откройте её в локальном браузере.
16.3.5 Закрытие неиспользуемых экземпляров
Поскольку облачные сервисы тарифицируются по времени использования, неиспользуемые экземпляры следует закрывать. Обратите внимание, что есть разные варианты:
- «Stopping» (остановка) экземпляра означает, что его можно запустить снова. Это похоже на выключение обычного сервера. Однако за остановленный экземпляр всё равно взимается небольшая плата за зарезервированное место на диске;
- «Terminating» (завершение) экземпляра удаляет все связанные с ним данные, включая диск, поэтому запустить его снова нельзя. Делайте это, только если точно знаете, что он вам больше не понадобится.
Если вы хотите использовать экземпляр как шаблон для создания других, щёлкните по нему правой кнопкой мыши в списке экземпляров и выберите «Image» «Create», чтобы создать образ экземпляра. После этого выберите «Instance State» «Terminate», чтобы завершить экземпляр. В следующий раз, когда понадобится этот экземпляр, можно создать его на основе сохранённого образа по шагам из этого раздела. Единственное отличие: на шаге «1. Choose AMI» нужно слева выбрать «My AMIs» (мои AMI) и указать сохранённый образ. Созданный экземпляр сохранит информацию, записанную на диске образа. Например, вам не придётся заново устанавливать CUDA и другие среды выполнения.
Резюме
- Экземпляры можно запускать и останавливать по требованию, не покупая и не собирая собственный компьютер.
- Прежде чем использовать фреймворк глубокого обучения с поддержкой GPU, нужно установить CUDA.
- Для запуска блокнотов Jupyter на удалённом сервере можно использовать перенаправление портов.
Упражнения
- Облако удобно, но недёшево. Узнайте, как запускать spot-экземпляры, чтобы снизить затраты.
- Попробуйте разные серверы с GPU. Насколько они быстры?
- Попробуйте серверы с несколькими GPU. Насколько хорошо масштабируются вычисления?
16.4 Выбор серверов и GPU
Обучение глубокого обучения обычно требует очень больших вычислений. Сейчас GPU — наиболее экономичные аппаратные ускорители для глубокого обучения. По сравнению с CPU, GPU дешевле и производительнее — зачастую более чем на порядок. Кроме того, один сервер может поддерживать несколько GPU: в высококлассных серверах — до 8. Более типично число до 4 GPU в инженерной рабочей станции, потому что тепловыделение, охлаждение и потребность в питании быстро растут и выходят за пределы того, что может обеспечить офисное здание. Для более крупных развёртываний практичнее облачные вычисления, например экземпляры Amazon P3 и G4.
16.4.1 Выбор серверов
Обычно нет необходимости покупать высококлассный CPU с большим числом потоков, поскольку основная часть вычислений происходит на GPU. Тем не менее из-за глобальной блокировки интерпретатора (global interpreter lock, GIL) в Python однопоточная производительность CPU может быть важна, когда у нас 4–8 GPU. При прочих равных это означает, что экономичнее может оказаться CPU с меньшим числом ядер, но более высокой тактовой частотой. Например, при выборе между 6-ядерным CPU на 4 ГГц и 8-ядерным на 3,5 ГГц предпочтительнее первый, даже если его суммарная скорость ниже. Важно и то, что GPU потребляют много электроэнергии и, следовательно, выделяют много тепла. Это требует очень хорошего охлаждения и достаточно большого корпуса, чтобы вместить GPU. По возможности придерживайтесь следующих рекомендаций:
- Питание. GPU потребляют много энергии. Закладывайте до 350 Вт на устройство (смотрите на пиковую потребность видеокарты, а не на среднюю: эффективный код может потреблять много энергии). Если блока питания не хватает, система станет нестабильной.
- Размер корпуса. GPU велики, а вспомогательным разъёмам питания обычно нужно дополнительное место. Кроме того, большой корпус легче охлаждать.
- Охлаждение GPU. Если у вас много GPU, возможно, стоит вложиться в жидкостное охлаждение. Кроме того, стремитесь к «референсному дизайну», даже если у него меньше вентиляторов, потому что такие карты достаточно тонкие, чтобы воздух поступал между устройствами. Если вы устанавливаете несколько GPU с несколькими вентиляторами, они могут оказаться слишком толстыми, и воздуха не хватит.
- Слоты PCIe. Перемещение данных на GPU и с GPU (а также обмен ими между GPU) требует большой пропускной способности. Рекомендуются слоты PCIe 3.0 с 16 линиями. Если установлено несколько GPU, обязательно внимательно прочитайте описание материнской платы и убедитесь, что при одновременном использовании нескольких GPU по-прежнему доступна пропускная способность 16 и что это именно PCIe 3.0, а не PCIe 2.0 для дополнительных слотов. У некоторых материнских плат при установке нескольких GPU пропускная способность падает до 8 или даже 4. Отчасти это связано с ограниченным числом линий PCIe, которое предоставляет CPU.
Ниже кратко приведены рекомендации по сборке сервера для глубокого обучения.
- Начинающий. Купите недорогой GPU с низким энергопотреблением (дешёвый игровой GPU, подходящий для глубокого обучения, потребляет 150–200 Вт). Если повезёт, ваш нынешний компьютер его поддержит.
- 1 GPU. Достаточно недорогого 4-ядерного CPU, а большинство материнских плат подойдут. Ориентируйтесь на не менее 32 ГБ DRAM и вложитесь в SSD для локального доступа к данным. Блока питания на 600 Вт должно хватить. Купите GPU с большим числом вентиляторов.
- 2 GPU. Достаточно недорогого 4–6-ядерного CPU. Подумайте о 64 ГБ DRAM и вложитесь в SSD. Для двух высококлассных GPU понадобится блок питания на 1000 Вт. Что касается материнской платы, убедитесь, что у неё два слота PCIe 3.0 x16. Если возможно, берите плату, у которой между слотами PCIe 3.0 x16 есть два свободных слота (расстояние 60 мм), чтобы было больше воздуха. В этом случае купите два GPU с большим числом вентиляторов.
- 4 GPU. Убедитесь, что вы покупаете CPU с относительно высокой однопоточной скоростью (то есть с высокой тактовой частотой). Возможно, понадобится CPU с большим числом линий PCIe, например AMD Threadripper. Чтобы получить 4 слота PCIe 3.0 x16, возможно, придётся купить относительно дорогую материнскую плату, поскольку им может понадобиться PLX для мультиплексирования линий PCIe. Покупайте GPU с референсным дизайном: они узкие и пропускают воздух между картами. Нужен блок питания на 1600–2000 Вт, а офисная розетка может такого не выдержать. Такой сервер, возможно, будет громким и горячим во время работы. Вы не захотите ставить его под стол. Рекомендуется 128 ГБ DRAM. Возьмите SSD для локального хранилища (1–2 ТБ NVMe) и жёсткие диски в конфигурации RAID для хранения данных.
- 8 GPU. Нужно купить специализированный серверный корпус для нескольких GPU с несколькими резервными блоками питания (например, 2+1 по 1600 Вт). Потребуются двухсокетные серверные CPU, 256 ГБ памяти ECC DRAM, быстрая сетевая карта (рекомендуется 10 GbE), а также нужно проверить, поддерживает ли сервер физический форм-фактор GPU. Поток воздуха и расположение проводки у потребительских и серверных GPU заметно различаются (например, RTX 2080 и Tesla V100). Это означает, что потребительский GPU, возможно, не удастся установить в сервер из-за недостаточного зазора для силового кабеля или отсутствия подходящей проводки (один из соавторов книги убедился в этом на собственном горьком опыте).
16.4.2 Выбор GPU
В настоящее время AMD и NVIDIA — два основных производителя специализированных GPU. NVIDIA первой пришла в глубокое обучение и благодаря CUDA лучше поддерживается фреймворками глубокого обучения. Поэтому большинство покупателей выбирают GPU NVIDIA.
NVIDIA предлагает два типа GPU: для индивидуальных пользователей (например, серии GTX и RTX) и для корпоративных (серия Tesla). Эти два типа GPU обладают сопоставимой вычислительной мощностью. Однако у корпоративных GPU обычно принудительное (пассивное) охлаждение, больше памяти и память ECC (с коррекцией ошибок). Эти GPU больше подходят для центров обработки данных и обычно стоят в десять раз дороже потребительских.
Если вы крупная компания со 100 серверами, вам стоит присмотреться к серии NVIDIA Tesla или использовать серверы с GPU в облаке. Для лаборатории или малой и средней компании с 10+ серверами наиболее экономичной может оказаться серия NVIDIA RTX; можно купить предварительно сконфигурированные серверы в корпусах Supermicro или Asus, в которых эффективно размещаются 4–8 GPU.
Поставщики GPU обычно выпускают новое поколение раз в один-два года, например серию GTX 1000 (Pascal) в 2017 году и серию RTX 2000 (Turing) в 2019 году. Каждая серия включает несколько моделей с разным уровнем производительности. Производительность GPU определяется в основном комбинацией трёх параметров:
- Вычислительная мощность. Обычно ищут мощность вычислений с плавающей запятой 32 бит. Обучение с 16-битной плавающей запятой (FP16) тоже входит в обиход. Если вас интересует только вывод (предсказание), можно использовать и 8-битные целые числа. Последнее поколение GPU Turing поддерживает ускорение 4 бит. К сожалению, алгоритмы обучения сетей низкой точности пока не получили широкого распространения;
- Объём памяти. По мере роста моделей или размера батчей, используемых при обучении, потребуется больше памяти GPU. Обратите внимание на HBM2 (память с высокой пропускной способностью) и GDDR6 (графическая DDR). HBM2 быстрее, но дороже;
- Пропускная способность памяти. Вычислительную мощность можно использовать на полную только при достаточной пропускной способности памяти. При использовании GDDR6 ищите широкую шину памяти.
Большинству пользователей достаточно посмотреть на вычислительную мощность. Учтите, что у многих GPU есть разные виды ускорения. Например, Tensor Cores от NVIDIA ускоряют подмножество операторов в 5. Убедитесь, что используемые вами библиотеки это поддерживают. Памяти GPU должно быть не менее 4 ГБ (лучше 8 ГБ). Старайтесь не использовать GPU ещё и для вывода графического интерфейса (используйте вместо этого встроенную графику). Если этого не избежать, добавьте 2 ГБ RAM для надёжности.
На рис. 16.4.1 сравниваются вычислительная мощность в GFLOPS и цена различных моделей серий GTX 900, GTX 1000 и RTX 2000. Цены — рекомендованные, взятые из Википедии.
Рис. 16.4.1. Сравнение вычислительной мощности с плавающей запятой и цены
Из рисунка видно несколько вещей:
- Внутри каждой серии цена и производительность примерно пропорциональны. Модели Titan стоят заметно дороже из-за большого объёма памяти GPU. Однако при сравнении 980 Ti и 1080 Ti видно, что новые модели экономичнее. Цена в серии RTX 2000, судя по всему, не очень выросла. Зато они обеспечивают гораздо лучшую производительность при низкой точности (FP16, INT8 и INT4);
- Отношение производительности к цене у серии GTX 1000 примерно вдвое лучше, чем у серии 900;
- Для серии RTX 2000 вычислительная мощность с плавающей запятой — «аффинная» функция цены.
Рис. 16.4.2. Вычислительная мощность с плавающей запятой и энергопотребление
На рис. 16.4.2 видно, что энергопотребление в основном линейно зависит от объёма вычислений. Кроме того, более поздние поколения эффективнее. Это, по-видимому, противоречит графику для серии RTX 2000. Однако так получается из-за непропорционально большого энергопотребления Tensor Cores.
Резюме
- При сборке сервера следите за питанием, линиями шины PCIe, однопоточной скоростью CPU и охлаждением.
- По возможности стоит покупать GPU последнего поколения.
- Для больших развёртываний используйте облако.
- Серверы высокой плотности могут быть несовместимы со всеми GPU. Прежде чем покупать, проверьте механические и тепловые характеристики.
- Для повышения эффективности используйте FP16 или меньшую точность.
16.5 Вклад в развитие книги
Вклад читателей очень помогает нам улучшать качество книги. Если вы нашли опечатку, нерабочую ссылку, место, где, по вашему мнению, мы пропустили цитирование, неизящный код или неясное объяснение, пожалуйста, откликнитесь и помогите читателям. В обычных книгах интервал между тиражами (то есть между исправлениями опечаток) часто составляет годы, а улучшения этой книги обычно занимают от нескольких часов до нескольких дней. Это достаточно эффективно благодаря системе контроля версий и непрерывной автоматической интеграции (CI) с тестированием. Для этого нужно отправить pull request в репозиторий на GitHub. Когда авторы примут ваш pull request в кодовую базу, вы станете соавтором.
Примечание переводчика. Этот раздел описывает работу с репозиторием оригинала (
d2l-ai/d2l-en). Замечания к русскому переводу направляйте в репозиторий, в котором опубликована эта книга; общие правила изложены в файлеCONTRIBUTING.mdв его корне.
16.5.1 Небольшие правки
Самый распространённый вид вклада — правка одного предложения или исправление опечатки. Рекомендуем найти исходный файл (файл Markdown) в репозитории GitHub. Затем нажмите кнопку «Edit this file» в правом верхнем углу страницы файла и внесите изменения в файл Markdown.
После этого в панели «Propose file change» («Предложить изменение файла») внизу страницы заполните описание изменений и нажмите кнопку «Propose file change». Вы будете перенаправлены на новую страницу, где можно просмотреть свои изменения. Если всё в порядке, отправьте pull request, нажав кнопку «Create pull request».
16.5.2 Крупные правки текста или кода
Если вы планируете изменить значительный объём текста или кода, нужно лучше знать формат, используемый в книге. Исходные файлы написаны в формате Markdown с набором расширений, которые предоставляет пакет d2lbook: ссылки на формулы, изображения, разделы и цитаты. Открывать и изменять эти файлы можно в любом редакторе Markdown.
Если вы хотите изменить код, мы рекомендуем открывать эти файлы Markdown в Jupyter Notebook, как описано в разделе 16.1. Так вы сможете запускать и проверять свои изменения. Не забудьте очистить все выходные данные перед отправкой изменений: наша система CI выполнит обновлённые вами разделы и сгенерирует вывод.
Некоторые разделы могут поддерживать реализации для нескольких фреймворков. Если вы добавляете новый блок кода не для mxnet, пометьте первую строку блока кода маркером #@tab. Например, #@tab pytorch — для блока кода PyTorch, #@tab tensorflow — для блока кода TensorFlow, #@tab paddle — для блока кода PaddlePaddle, а #@tab all — для блока кода, общего для всех реализаций. Подробнее см. в пакете d2lbook.
16.5.3 Крупные изменения
Для крупных изменений мы рекомендуем использовать стандартный процесс работы с Git. Если коротко, он выглядит так, как показано на рис. 16.5.1.
Рис. 16.5.1. Вклад в книгу
Мы подробно пройдём по этим шагам. Если вы уже знакомы с Git, этот раздел можно пропустить. В примерах мы будем считать, что имя пользователя автора правки — «astonzhang».
16.5.3.1 Установка Git
В открытой книге о Git описано, как установить Git. Обычно это делается командой apt install git в Ubuntu Linux, установкой инструментов разработчика Xcode в macOS или с помощью настольного клиента GitHub. Если у вас нет учётной записи GitHub, нужно зарегистрироваться.
16.5.3.2 Вход в GitHub
Введите в браузере адрес репозитория с кодом книги. Нажмите кнопку Fork в правом верхнем углу страницы репозитория, чтобы скопировать репозиторий книги. Это будет ваша собственная копия, и вы можете менять её как угодно.
Теперь репозиторий книги будет разветвлён (то есть скопирован) в вашу учётную запись: например, в левом верхнем углу страницы вы увидите astonzhang/d2l-en.
16.5.3.3 Клонирование репозитория
Чтобы клонировать репозиторий (то есть сделать локальную копию), нужно узнать его адрес: он показывается при нажатии зелёной кнопки «Code» на странице репозитория. Если вы решите держать этот форк дольше, следите, чтобы локальная копия была синхронизирована с основным репозиторием. Пока же просто выполните инструкции из раздела «Установка». Главное отличие в том, что теперь вы скачиваете собственный форк репозитория.
# Замените your_github_username своим именем пользователя на GitHub
git clone https://github.com/your_github_username/d2l-en.git
16.5.3.4 Редактирование и отправка изменений
Пора редактировать книгу. Лучше всего делать это в Jupyter Notebook, как описано в разделе 16.1. Внесите изменения и убедитесь, что всё работает. Предположим, мы исправили опечатку в файле ~/d2l-en/chapter_appendix_tools/how-to-contribute.md. Можно проверить, какие файлы вы изменили.
В этот момент Git сообщит, что файл chapter_appendix_tools/how-to-contribute.md изменён.
mylaptop:d2l-en me$ git status
On branch master
Your branch is up-to-date with 'origin/master'.
Changes not staged for commit:
(use "git add <file>..." to update what will be committed)
(use "git checkout -- <file>..." to discard changes in working directory)
modified: chapter_appendix_tools/how-to-contribute.md
Убедившись, что это именно то, что вам нужно, выполните следующие команды:
git add chapter_appendix_tools/how-to-contribute.md
git commit -m 'fix typo in git documentation'
git push
Изменённый код окажется в вашей личной ветке репозитория. Чтобы предложить добавить изменения, нужно создать pull request в официальный репозиторий книги.
16.5.3.5 Отправка pull request
Перейдите на GitHub в свой форк репозитория и нажмите «New pull request». Откроется страница, показывающая различия между вашими правками и текущим содержимым основного репозитория книги.
Наконец, нажмите кнопку «Create pull request», чтобы отправить pull request. Обязательно опишите в нём внесённые изменения. Так авторам будет проще его проверить и слить с книгой. В зависимости от изменений pull request может быть принят сразу, отклонён или, что вероятнее всего, вы получите замечания по изменениям. Когда ваши правки будут слиты, всё готово.
Резюме
- Вносить вклад в книгу можно через GitHub.
- Небольшие правки можно делать прямо на GitHub.
- Для значительных изменений нужно сделать форк репозитория, отредактировать содержимое локально и отправить вклад, когда всё готово.
- Старайтесь не отправлять огромные pull request: их трудно понять и слить. Лучше разбить их на несколько небольших.
Упражнения
- Сделайте звёздочку (star) и форк репозитория
d2l-ai/d2l-en. - Если вы заметили что-то, что нужно улучшить (например, отсутствующую ссылку на источник), отправьте pull request.
- Обычно лучше создавать pull request в новой ветке. Узнайте, как это делать с помощью ветвления Git.
16.6 Документация по API пакета d2l
Реализации перечисленных ниже членов пакета d2l, а также их определения и объяснения можно найти в исходных файлах.
Примечание переводчика. В исходной книге этот раздел собирается автоматически (Sphinx autodoc) из строк документации пакета
d2l. Здесь перечислены только имена членов пакета. Перечисленных классов нет в файлахd2l/*.pyрепозитория, на котором основан перевод; их определения находятся в пакетеd2lанглийской версии книги (ссылка выше).
MXNet: модуль d2l.mxnet.
PyTorch: модуль d2l.torch.
TensorFlow: модуль d2l.tensorflow.
PaddlePaddle: модуль d2l.paddle.
16.6.1 Модели
ModuleLinearRegressionScratchLinearRegressionClassification
16.6.2 Данные
DataModuleSyntheticRegressionDataFashionMNIST
16.6.3 Обучение
TrainerSGD
16.6.4 Общие средства
add_to_class(функция)cpu(функция)gpu(функция)num_gpus(функция)ProgressBoardHyperParameters
Литература
Сводный список источников, на которые ссылаются разделы книги. Списки по отдельным разделам приведены в их конце.
- Ahmed, A., Aly, M., Gonzalez, J., Narayanamurthy, S., & Smola, A. J. (2012). Scalable inference in latent variable models. Proceedings of the Fifth ACM International Conference on Web Search and Data Mining, 123–132.
- Aji, S. M., & McEliece, R. J. (2000). The generalized distributive law. IEEE Transactions on Information Theory, 46(2), 325–343.
- Ba, J. L., Kiros, J. R., & Hinton, G. E. (2016). Layer normalization. arXiv preprint arXiv:1607.06450.
- Bahdanau, D., Cho, K., & Bengio, Y. (2014). Neural machine translation by jointly learning to align and translate. arXiv preprint arXiv:1409.0473.
- Bay, H., Tuytelaars, T., & Van Gool, L. (2006). SURF: Speeded up robust features. European Conference on Computer Vision, 404–417.
- Bengio, Y., Ducharme, R., Vincent, P., & Jauvin, C. (2003). A neural probabilistic language model. Journal of Machine Learning Research, 3, 1137–1155.
- Bishop, C. M. (1995). Training with noise is equivalent to Tikhonov regularization. Neural Computation, 7(1), 108–116.
- Bishop, C. M. (2006). Pattern recognition and machine learning. Springer.
- Bodla, N., Singh, B., Chellappa, R., & Davis, L. S. (2017). Soft-NMS — Improving object detection with one line of code. Proceedings of the IEEE International Conference on Computer Vision, 5561–5569.
- Bojanowski, P., Grave, E., Joulin, A., & Mikolov, T. (2017). Enriching word vectors with subword information. Transactions of the Association for Computational Linguistics, 5, 135–146.
- Bollobás, B. (1999). Linear analysis. Cambridge University Press.
- Bowman, S. R., Angeli, G., Potts, C., & Manning, C. D. (2015). A large annotated corpus for learning natural language inference. arXiv preprint arXiv:1508.05326.
- Boyd, S., & Vandenberghe, L. (2004). Convex Optimization. Cambridge University Press.
- Brown, N., & Sandholm, T. (2017). Libratus: The superhuman AI for no-limit poker. In IJCAI (pp. 5226–5228).
- Brown, P. F., Cocke, J., Della Pietra, S. A., Della Pietra, V. J., Jelinek, F., Lafferty, J., Mercer, R. L., & Roossin, P. S. (1990). A statistical approach to machine translation. Computational Linguistics, 16(2), 79–85.
- Brown, P. F., Cocke, J., Della Pietra, S. A., Della Pietra, V. J., Jelinek, F., Mercer, R. L., & Roossin, P. (1988). A statistical approach to language translation. Coling Budapest 1988 Volume 1: International Conference on Computational Linguistics.
- Campbell, M., Hoane Jr., A. J., & Hsu, F.-h. (2002). Deep Blue. Artificial Intelligence, 134(1–2), 57–83.
- Canny, J. (1987). A computational approach to edge detection. In Readings in Computer Vision (pp. 184–203). Elsevier.
- Cer, D., Diab, M., Agirre, E., Lopez-Gazpio, I., & Specia, L. (2017). SemEval-2017 Task 1: Semantic Textual Similarity Multilingual and Crosslingual Focused Evaluation. In Proceedings of the 11th International Workshop on Semantic Evaluation (SemEval-2017), 1–14.
- Cheng, J., Dong, L., & Lapata, M. (2016). Long short-term memory-networks for machine reading. In Proceedings of the 2016 Conference on Empirical Methods in Natural Language Processing, 551–561.
- Cho, K., Van Merrienboer, B., Bahdanau, D., & Bengio, Y. (2014b). On the properties of neural machine translation: Encoder-decoder approaches. arXiv preprint arXiv:1409.1259.
- Cho, K., Van Merrienboer, B., Gulcehre, C., Bahdanau, D., Bougares, F., Schwenk, H., & Bengio, Y. (2014a). Learning phrase representations using RNN encoder-decoder for statistical machine translation. arXiv preprint arXiv:1406.1078.
- Chung, J., Gulcehre, C., Cho, K., & Bengio, Y. (2014). Empirical evaluation of gated recurrent neural networks on sequence modeling. arXiv preprint arXiv:1412.3555.
- Collobert, R., Weston, J., Bottou, L., Karlen, M., Kavukcuoglu, K., & Kuksa, P. (2011). Natural language processing (almost) from scratch. Journal of machine learning research, 12, 2493–2537.
- Dalal, N., & Triggs, B. (2005). Histograms of oriented gradients for human detection. Proceedings of the IEEE CVPR, 1, 886–893.
- DeCandia, G., Hastorun, D., Jampani, M., Kakulapati, G., Lakshman, A., Pilchin, A., Sivasubramanian, S., Vosshall, P., & Vogels, W. (2007). Dynamo: Amazon’s highly available key-value store. ACM SIGOPS Operating Systems Review, 41(6), 205–220.
- Devlin, J., Chang, M. W., Lee, K., & Toutanova, K. (2018). Bert: Pre-training of deep bidirectional transformers for language understanding. arXiv preprint arXiv:1810.04805.
- Dosovitskiy, A., Beyer, L., Kolesnikov, A., Weissenborn, D., Zhai, X., Unterthiner, T., Dehghani, M., Minderer, M., Heigold, G., Gelly, S., & others (2021). An image is worth 16x16 words: Transformers for image recognition at scale. International Conference on Learning Representations.
- Doucet, A., De Freitas, N., & Gordon, N. (2001). An introduction to sequential Monte Carlo methods. In Sequential Monte Carlo methods in practice, 3–14.
- Duchi, J., Hazan, E., & Singer, Y. (2011). Adaptive subgradient methods for online learning and stochastic optimization. Journal of Machine Learning Research, 12, 2121–2159.
- Dumoulin, V., & Visin, F. (2016). A guide to convolution arithmetic for deep learning. arXiv preprint arXiv:1603.07285.
- Flammarion, N., & Bach, F. (2015). From averaging to acceleration, there is only a step-size. Conference on Learning Theory, 658–695.
- Gatys, L. A., Ecker, A. S., & Bethge, M. (2016). Image style transfer using convolutional neural networks. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2414–2423.
- Girshick, R. (2015). Fast R-CNN. Proceedings of the IEEE International Conference on Computer Vision, 1440–1448.
- Girshick, R., Donahue, J., Darrell, T., & Malik, J. (2014). Rich feature hierarchies for accurate object detection and semantic segmentation. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 580–587.
- Glorot, X., & Bengio, Y. (2010). Understanding the difficulty of training deep feedforward neural networks. Proceedings of the Thirteenth International Conference on Artificial Intelligence and Statistics, 249–256.
- Goh, G. (2017). Why momentum really works. Distill.
- Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press. http://www.deeplearningbook.org
- Goodfellow, I., Pouget-Abadie, J., Mirza, M., Xu, B., Warde-Farley, D., Ozair, S., Courville, A., & Bengio, Y. (2014). Generative adversarial nets. In Advances in Neural Information Processing Systems (pp. 2672–2680).
- Gotmare, A., Keskar, N. S., Xiong, C., & Socher, R. (2018). A closer look at deep learning heuristics: Learning rate restarts, warmup and distillation. arXiv preprint arXiv:1810.13243.
- Graves, A. (2013). Generating sequences with recurrent neural networks. arXiv preprint arXiv:1308.0850.
- Graves, A., & Schmidhuber, J. (2005). Framewise phoneme classification with bidirectional LSTM and other neural network architectures. Neural Networks, 18(5–6), 602–610.
- Hadjis, S., Zhang, C., Mitliagkas, I., Iter, D., & Ré, C. (2016). Omnivore: An optimizer for multi-device deep learning on CPUs and GPUs. arXiv preprint arXiv:1606.04487.
- He, K., Gkioxari, G., Dollár, P., & Girshick, R. (2017). Mask R-CNN. Proceedings of the IEEE International Conference on Computer Vision, 2961–2969.
- He, K., Zhang, X., Ren, S., & Sun, J. (2015). Delving deep into rectifiers: Surpassing human-level performance on ImageNet classification. Proceedings of the IEEE International Conference on Computer Vision, 1026–1034.
- He, K., Zhang, X., Ren, S., & Sun, J. (2016a). Deep residual learning for image recognition. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 770–778.
- He, K., Zhang, X., Ren, S., & Sun, J. (2016b). Identity mappings in deep residual networks. European Conference on Computer Vision, 630–645.
- Hebb, D. O. (1949). The organization of behavior. Wiley.
- Hendrycks, D., & Gimpel, K. (2016). Gaussian error linear units (gelus). arXiv preprint arXiv:1606.08415.
- Hennessy, J. L., & Patterson, D. A. (2011). Computer architecture: A quantitative approach. Elsevier.
- Hochreiter, S., & Schmidhuber, J. (1997). Long short-term memory. Neural Computation, 9(8), 1735–1780.
- Hochreiter, S., Bengio, Y., Frasconi, P., & Schmidhuber, J. (2001). Gradient flow in recurrent nets: the difficulty of learning long-term dependencies. In A Field Guide to Dynamical Recurrent Neural Networks. IEEE Press.
- Hoyer, P. O., Janzing, D., Mooij, J. M., Peters, J., & Schölkopf, B. (2009). Nonlinear causal discovery with additive noise models. Advances in Neural Information Processing Systems, 689–696.
- Hu, J., Shen, L., & Sun, G. (2018). Squeeze-and-excitation networks. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (pp. 7132–7141).
- Hu, Z., Lee, R. K.-W., Aggarwal, C. C., & Zhang, A. (2020). Text style transfer: A review and experimental evaluation. arXiv preprint arXiv:2010.12742.
- Huang, G., Liu, Z., Van Der Maaten, L., & Weinberger, K. Q. (2017). Densely connected convolutional networks. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 4700–4708.
- Ioffe, S. (2017). Batch renormalization: Towards reducing minibatch dependence in batch-normalized models. Advances in Neural Information Processing Systems, 1945–1953.
- Ioffe, S., & Szegedy, C. (2015). Batch normalization: Accelerating deep network training by reducing internal covariate shift. arXiv preprint arXiv:1502.03167.
- Izmailov, P., Podoprikhin, D., Garipov, T., Vetrov, D., & Wilson, A. G. (2018). Averaging weights leads to wider optima and better generalization. arXiv preprint arXiv:1803.05407.
- Jaeger, H. (2002). Tutorial on training recurrent neural networks, covering BPPT, RTRL, EKF and the “echo state network” approach (Vol. 5). GMD-Forschungszentrum Informationstechnik Bonn.
- James, W. (2007). The Principles of Psychology. Cosimo, Inc.
- Jia, X., Song, S., He, W., et al. (2018). Highly scalable deep learning training system with mixed-precision: Training ImageNet in four minutes. arXiv preprint arXiv:1807.11205.
- Jouppi, N. P., Young, C., Patil, N., Patterson, D., et al. (2017). In-datacenter performance analysis of a tensor processing unit. Proceedings of the 44th Annual International Symposium on Computer Architecture (ISCA), 1–12.
- Karras, T., Aila, T., Laine, S., & Lehtinen, J. (2017). Progressive growing of GANs for improved quality, stability, and variation. arXiv preprint arXiv:1710.10196.
- Kim, Y. (2014). Convolutional neural networks for sentence classification. arXiv preprint arXiv:1408.5882.
- Kingma, D. P., & Ba, J. (2014). Adam: A method for stochastic optimization. arXiv preprint arXiv:1412.6980.
- Kolter, Z. (2008). Linear Algebra Review and Reference. Available online.
- Koren, Y. (2009). Collaborative filtering with temporal dynamics. Proceedings of the 15th ACM SIGKDD International Conference on Knowledge Discovery and Data Mining, 447–456.
- Krizhevsky, A., Sutskever, I., & Hinton, G. E. (2012). ImageNet classification with deep convolutional neural networks. Advances in Neural Information Processing Systems, 1097–1105.
- Kung, S. Y. (1988). VLSI array processors. Prentice Hall.
- LeCun, Y., Bottou, L., Bengio, Y., & Haffner, P. (1998). Gradient-based learning applied to document recognition. Proceedings of the IEEE, 86(11), 2278–2324.
- Li, M. (2017). Scaling distributed machine learning with system and algorithm co-design [PhD thesis]. Carnegie Mellon University.
- Li, M., Andersen, D. G., Park, J. W., Smola, A. J., Ahmed, A., Josifovski, V., Long, J., Shekita, E. J., & Su, B.-Y. (2014). Scaling distributed machine learning with the parameter server. 11th USENIX Symposium on Operating Systems Design and Implementation (OSDI 14), 583–598.
- Lin, M., Chen, Q., & Yan, S. (2013). Network in network. arXiv preprint arXiv:1312.4400.
- Lin, Y., Lv, F., Zhu, S., et al. (2010). ImageNet classification: Fast descriptor coding and large-scale SVM training. Large Scale Visual Recognition Challenge.
- Lin, Z., Feng, M., Santos, C. N. d., Yu, M., Xiang, B., Zhou, B., & Bengio, Y. (2017). A structured self-attentive sentence embedding. arXiv preprint arXiv:1703.03130.
- Lipton, Z. C., & Steinhardt, J. (2018). Troubling trends in machine learning scholarship. arXiv preprint arXiv:1807.03341.
- Liu, W., Anguelov, D., Erhan, D., Szegedy, C., Reed, S., Fu, C.-Y., & Berg, A. C. (2016). SSD: Single shot multibox detector. European Conference on Computer Vision, 21–37.
- Liu, Y., Ott, M., Goyal, N., Du, J., Joshi, M., Chen, D., Levy, O., Lewis, M., Zettlemoyer, L., & Stoyanov, V. (2019). Roberta: A robustly optimized bert pretraining approach. arXiv preprint arXiv:1907.11692.
- Long, J., Shelhamer, E., & Darrell, T. (2015). Fully convolutional networks for semantic segmentation. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 3431–3440.
- Loshchilov, I., & Hutter, F. (2016). SGDR: Stochastic gradient descent with warm restarts. arXiv preprint arXiv:1608.03983.
- Lowe, D. G. (2004). Distinctive image features from scale-invariant keypoints. International Journal of Computer Vision, 60(2), 91–110.
- Luo, P., Wang, X., Shao, W., & Peng, Z. (2018). Towards understanding regularization in batch normalization. arXiv preprint.
- Maas, A. L., Daly, R. E., Pham, P. T., Huang, D., Ng, A. Y., & Potts, C. (2011). Learning word vectors for sentiment analysis. In Proceedings of the 49th annual meeting of the association for computational linguistics: Human language technologies-volume 1, 142–150.
- McCann, B., Bradbury, J., Xiong, C., & Socher, R. (2017). Learned in translation: Contextualized word vectors. In Advances in Neural Information Processing Systems, 6294–6305.
- McCulloch, W. S., & Pitts, W. (1943). A logical calculus of the ideas immanent in nervous activity. The Bulletin of Mathematical Biophysics, 5(4), 115–133.
- Merity, S., Xiong, C., Bradbury, J., & Socher, R. (2016). Pointer sentinel mixture models. arXiv preprint arXiv:1609.07843.
- Mikolov, T., Chen, K., Corrado, G., & Dean, J. (2013a). Efficient estimation of word representations in vector space. arXiv preprint arXiv:1301.3781.
- Mikolov, T., Sutskever, I., Chen, K., Corrado, G. S., & Dean, J. (2013b). Distributed representations of words and phrases and their compositionality. In Advances in neural information processing systems, 3111–3119.
- Mirhoseini, A., Pham, H., Le, Q. V., Steiner, B., Larsen, R., Zhou, Y., Kumar, N., Norouzi, M., Bengio, S., & Dean, J. (2017). Device placement optimization with reinforcement learning. Proceedings of the 34th International Conference on Machine Learning, 70, 2430–2439.
- Mnih, V., Heess, N., Graves, A., & others (2014). Recurrent models of visual attention. Advances in Neural Information Processing Systems, 2204–2212.
- Nadaraya, E. A. (1964). On estimating regression. Theory of Probability & Its Applications, 9(1), 141–142.
- Nesterov, Y. (2018). Lectures on Convex Optimization. Springer.
- Nesterov, Y., & Vial, J.-P. (2000). Confidence level solutions for stochastic programming. Stochastic Programming E-Print Series.
- Papineni, K., Roukos, S., Ward, T., & Zhu, W. J. (2002). BLEU: a method for automatic evaluation of machine translation. In Proceedings of the 40th Annual Meeting of the Association for Computational Linguistics, 311–318.
- Parikh, A. P., Täckström, O., Das, D., & Uszkoreit, J. (2016). A decomposable attention model for natural language inference. arXiv preprint arXiv:1606.01933.
- Park, T., Liu, M.-Y., Wang, T.-C., & Zhu, J.-Y. (2019). Semantic image synthesis with spatially-adaptive normalization. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 2337–2346).
- Paulus, R., Xiong, C., & Socher, R. (2017). A deep reinforced model for abstractive summarization. arXiv preprint arXiv:1705.04304.
- Pennington, J., Socher, R., & Manning, C. (2014). Glove: Global vectors for word representation. In Proceedings of the 2014 conference on empirical methods in natural language processing (EMNLP), 1532–1543.
- Peters, J., Janzing, D., & Schölkopf, B. (2017). Elements of causal inference: Foundations and learning algorithms. MIT Press.
- Peters, M., Ammar, W., Bhagavatula, C., & Power, R. (2017). Semi-supervised sequence tagging with bidirectional language models. In Proceedings of the 55th Annual Meeting of the Association for Computational Linguistics (Volume 1: Long Papers), 1756–1765.
- Peters, M., Neumann, M., Iyyer, M., Gardner, M., Clark, C., Lee, K., & Zettlemoyer, L. (2018). Deep Contextualized Word Representations. In Proceedings of the 2018 Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies, Volume 1 (Long Papers), 2227–2237.
- Petersen, K. B., Pedersen, M. S., et al. (2008). The matrix cookbook. Technical University of Denmark, 7(15), 510.
- Polyak, B. T. (1964). Some methods of speeding up the convergence of iteration methods. USSR Computational Mathematics and Mathematical Physics, 4, 1–17.
- Radford, A., Narasimhan, K., Salimans, T., & Sutskever, I. (2018). Improving language understanding by generative pre-training. OpenAI.
- Radford, A., Wu, J., Child, R., Luan, D., Amodei, D., & Sutskever, I. (2019). Language models are unsupervised multitask learners. OpenAI Blog, 1(8), 9.
- Rajpurkar, P., Zhang, J., Lopyrev, K., & Liang, P. (2016). Squad: 100,000+ questions for machine comprehension of text. arXiv preprint arXiv:1606.05250.
- Reddi, S. J., Kale, S., & Kumar, S. (2019). On the convergence of Adam and beyond. arXiv preprint arXiv:1904.09237.
- Redmon, J., Divvala, S., Girshick, R., & Farhadi, A. (2016). You only look once: Unified, real-time object detection. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 779–788.
- Reed, S., & De Freitas, N. (2015). Neural programmer-interpreters. arXiv preprint arXiv:1511.06279.
- Ren, S., He, K., Girshick, R., & Sun, J. (2015). Faster R-CNN: Towards real-time object detection with region proposal networks. Advances in Neural Information Processing Systems, 91–99.
- Russell, S. J., & Norvig, P. (2016). Artificial intelligence: A modern approach. Pearson Education.
- Santurkar, S., Tsipras, D., Ilyas, A., & Madry, A. (2018). How does batch normalization help optimization? Advances in Neural Information Processing Systems, 2483–2493.
- Schuster, M., & Paliwal, K. K. (1997). Bidirectional recurrent neural networks. IEEE Transactions on Signal Processing, 45(11), 2673–2681.
- Sennrich, R., Haddow, B., & Birch, A. (2015). Neural machine translation of rare words with subword units. arXiv preprint arXiv:1508.07909.
- Shao, H., Yao, S., Sun, D., Zhang, A., Liu, S., Liu, D., Wang, J., & Abdelzaher, T. (2020). ControlVAE: Controllable variational autoencoder. Proceedings of the 37th International Conference on Machine Learning.
- Silver, D., Huang, A., Maddison, C. J., et al. (2016). Mastering the game of Go with deep neural networks and tree search. Nature, 529(7587), 484.
- Simonyan, K., & Zisserman, A. (2014). Very deep convolutional networks for large-scale image recognition. arXiv preprint arXiv:1409.1556.
- Smola, A., & Narayanamurthy, S. (2010). An architecture for parallel topic models. Proceedings of the VLDB Endowment, 3(1–2), 703–710.
- Srivastava, N., Hinton, G., Krizhevsky, A., Sutskever, I., & Salakhutdinov, R. (2014). Dropout: A simple way to prevent neural networks from overfitting. Journal of Machine Learning Research, 15(1), 1929–1958.
- Strang, G. (1993). Introduction to linear algebra (Vol. 3). Wellesley-Cambridge Press, Wellesley, MA.
- Sukhbaatar, S., Weston, J., Fergus, R., et al. (2015). End-to-end memory networks. In Advances in Neural Information Processing Systems (pp. 2440–2448).
- Sutskever, I., Martens, J., Dahl, G., & Hinton, G. (2013). On the importance of initialization and momentum in deep learning. International Conference on Machine Learning, 1139–1147.
- Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to sequence learning with neural networks. Advances in Neural Information Processing Systems, 3104–3112.
- Szegedy, C., Ioffe, S., Vanhoucke, V., & Alemi, A. A. (2017). Inception-v4, Inception-ResNet and the impact of residual connections on learning. Thirty-First AAAI Conference on Artificial Intelligence.
- Szegedy, C., Liu, W., Jia, Y., Sermanet, P., Reed, S., Anguelov, D., Erhan, D., Vanhoucke, V., & Rabinovich, A. (2015). Going deeper with convolutions. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 1–9.
- Szegedy, C., Vanhoucke, V., Ioffe, S., Shlens, J., & Wojna, Z. (2016). Rethinking the Inception architecture for computer vision. Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2818–2826.
- Tallec, C., & Ollivier, Y. (2017). Unbiasing truncated backpropagation through time. arXiv preprint arXiv:1705.08209.
- Tay, Y., Dehghani, M., Bahri, D., & Metzler, D. (2020). Efficient transformers: A survey. arXiv preprint arXiv:2009.06732.
- Teye, M., Azizpour, H., & Smith, K. (2018). Bayesian uncertainty estimation for batch normalized deep networks. arXiv preprint arXiv:1802.06455.
- Tieleman, T., & Hinton, G. (2012). Lecture 6.5-RMSProp: Divide the gradient by a running average of its recent magnitude. COURSERA: Neural Networks for Machine Learning, 4, 26–31.
- Turing, A. M. (1950). Computing machinery and intelligence. Mind, 59(236), 433–460.
- Uijlings, J. R. R., Van De Sande, K. E. A., Gevers, T., & Smeulders, A. W. M. (2013). Selective search for object recognition. International Journal of Computer Vision, 104(2), 154–171.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 5998–6008.
- Wang, L., Li, M., Liberty, E., & Smola, A. J. (2018). Optimal message scheduling for aggregation. Networks, 2–3.
- Wang, Y., Davidson, A., Pan, Y., Wu, Y., Riffel, A., & Owens, J. D. (2016). Gunrock: A high-performance graph processing library on the GPU. ACM SIGPLAN Notices, 51(8), 11.
- Warstadt, A., Singh, A., & Bowman, S. R. (2019). Neural network acceptability judgments. Transactions of the Association for Computational Linguistics, 7, 625–641.
- Wasserman, L. (2013). All of statistics: A concise course in statistical inference. Springer Science & Business Media.
- Watkins, C. J. C. H., & Dayan, P. (1992). Q-learning. Machine Learning, 8(3–4), 279–292.
- Watson, G. S. (1964). Smooth regression analysis. Sankhyā: The Indian Journal of Statistics, Series A, 359–372.
- Welling, M., & Teh, Y. W. (2011). Bayesian learning via stochastic gradient Langevin dynamics. Proceedings of the 28th International Conference on Machine Learning (ICML-11), 681–688.
- Werbos, P. J. (1990). Backpropagation through time: What it does and how to do it. Proceedings of the IEEE, 78(10), 1550–1560.
- Wigner, E. P. (1958). On the distribution of the roots of certain symmetric matrices. Annals of Mathematics, 325–327.
- Wood, F., Gasthaus, J., Archambeau, C., James, L., & Teh, Y. W. (2011). The sequence memoizer. Communications of the ACM, 54(2), 91–98.
- Wu, C.-Y., Ahmed, A., Beutel, A., Smola, A. J., & Jing, H. (2017). Recurrent recommender networks. Proceedings of the Tenth ACM International Conference on Web Search and Data Mining, 495–503.
- Wu, Y., Schuster, M., Chen, Z., Le, Q. V., Norouzi, M., Macherey, W., Krikun, M., Cao, Y., Gao, Q., Macherey, K., & others (2016). Google’s neural machine translation system: Bridging the gap between human and machine translation. arXiv preprint arXiv:1609.08144.
- Xiao, H., Rasul, K., & Vollgraf, R. (2017). Fashion-MNIST: A novel image dataset for benchmarking machine learning algorithms. arXiv preprint arXiv:1708.07747.
- Xiong, W., Wu, L., Alleva, F., Droppo, J., Huang, X., & Stolcke, A. (2018). The Microsoft 2017 conversational speech recognition system. In 2018 IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP) (pp. 5934–5938). IEEE.
- You, Y., Gitman, I., & Ginsburg, B. (2017). Large batch training of convolutional networks. arXiv preprint arXiv:1708.03888.
- Zaheer, M., Reddi, S., Sachan, D., Kale, S., & Kumar, S. (2018). Adaptive methods for nonconvex optimization. Advances in Neural Information Processing Systems, 9793–9803.
- Zeiler, M. D. (2012). ADADELTA: An adaptive learning rate method. arXiv preprint arXiv:1212.5701.
- Zhang, A., Tay, Y., Zhang, S., Chan, A., Luu, A. T., Hui, S. C., & Fu, J. (2021). Beyond fully-connected layers with quaternions: Parameterization of hypercomplex multiplications with 1/n parameters. In International Conference on Learning Representations.
- Zhao, Z.-Q., Zheng, P., Xu, S.-T., & Wu, X. (2019). Object detection with deep learning: A review. IEEE Transactions on Neural Networks and Learning Systems, 30(11), 3212–3232.
- Zhu, J.-Y., Park, T., Isola, P., & Efros, A. A. (2017). Unpaired image-to-image translation using cycle-consistent adversarial networks. In Proceedings of the IEEE International Conference on Computer Vision (pp. 2223–2232).
- Zhu, Y., Kiros, R., Zemel, R., Salakhutdinov, R., Urtasun, R., Torralba, A., & Fidler, S. (2015). Aligning books and movies: Towards story-like visual explanations by watching movies and reading books. In Proceedings of the IEEE international conference on computer vision, 19–27.
Уведомление об авторстве
Погружение в глубокое обучение — русскоязычное издание на основе учебника «Dive into Deep Learning» (动手学深度学习, китайская версия).
- Оригинальный материал: Aston Zhang, Zachary C. Lipton, Mu Li, Alexander J. Smola и соавторы. Источник: zh.d2l.ai, исходный репозиторий d2l-ai/d2l-zh.
- Лицензия текста оригинала: CC BY-SA 4.0. Код в примерах: MIT-0 (указано в
config.iniисходного репозитория). - Перевод на русский язык: Сергей Монин. Переведены глава 1 «Введение» (
src/01_introduction.md), глава 2 «Предварительные знания» (src/02_*.md), глава 3 «Линейные нейронные сети» (src/03_*.md), глава 4 «Многослойные перцептроны» (src/04_*.md) глава 5 «Вычисления глубокого обучения» (src/05_*.md) глава 6 «Свёрточные нейронные сети» (src/06_*.md) глава 7 «Современные свёрточные нейронные сети» (src/07_*.md) глава 8 «Рекуррентные нейронные сети» (src/08_*.md), глава 9 «Современные рекуррентные нейронные сети» (src/09_*.md), глава 10 «Механизмы внимания» (src/10_*.md), глава 11 «Алгоритмы оптимизации» (src/11_*.md), глава 12 «Вычислительная производительность» (src/12_*.md), глава 13 «Компьютерное зрение» (src/13_*.md), глава 14 «Обработка естественного языка: предобучение» (src/14_*.md) и глава 15 «Обработка естественного языка: приложения» (src/15_*.md). - Код главы 3 взят из исходного репозитория (MIT-0): переведены комментарии, docstring, строки вывода, подписи графиков и названия классов Fashion-MNIST; сами выражения не изменены.
- Иллюстрации главы 3:
singleneuron.svg,softmaxreg.svgиneuron.svgперерисованы заново с русскими подписями по схемам оригинала (производные работы);fit-linreg.svgвзят из исходного репозитория без изменений (на нём только математические обозначения). - Код главы 2 взят из исходного репозитория (MIT-0): переведены комментарии, строки вывода и подписи графиков; сами выражения не изменены.
- Иллюстрации главы 2 (
polygon-circle.svg,cat-dog-pixels.png) взяты из исходного репозитория без изменений; на них нет текста, который требовал бы перевода. - Схемы
wake-word,ml-loop,supervised-learning,data-collectionиrl-environmentперерисованы заново с русскими подписями по схемам оригинала (src/images/*.svg); это производные работы. - Фотографии и иллюстрации (
death-cap.jpg,stackedanimals.png,speech.png,koebel.jpg) взяты из исходного репозитория. Условия их использования — как у репозитория; при публикации стоит проверить происхождение отдельных изображений. - Код главы 4 взят из исходного репозитория (MIT-0): переведены комментарии, строки вывода и подписи графиков; сами выражения не изменены.
- Иллюстрации главы 4:
mlp.svg,dropout2.svg,capacity-vs-error.svgиcat-dog-train.svg,cat-dog-test.svgпересобраны с русскими подписями по схемам оригинала (производные работы); вcat-dog-*.svgфотографии взяты из исходного репозитория.forward.svgскопирован без изменений (на нём только математические обозначения).popvssoda.pngвзят из исходного репозитория без изменений: карта Alan McConchie, PopVsSoda.com, лицензия CC BY. - Скриншоты страниц Kaggle из исходного репозитория (
kaggle.png,house-pricing.png,kaggle-submit2.png) в перевод не включены: это страницы стороннего сайта. Вместо них в тексте оставлено описание. - Код главы 5 взят из исходного репозитория (MIT-0): переведены комментарии, docstring и строки вывода; сами выражения не изменены.
- Иллюстрации главы 5:
blocks.svgскопирован без изменений (на нём нет текста);copyto.svgперерисован с русской подписью «копирование» по схеме оригинала (производная работа). Подписиgpu(0),gpu(1),X,Y,Zи+сохранены. - Код главы 6 взят из исходного репозитория (MIT-0): переведены комментарии, docstring и строки вывода; сами выражения не изменены.
- Иллюстрации главы 6:
correlation.svg,conv-multi-in.svg,conv-1x1.svg,conv-pad.svg,conv-stride.svg,pooling.svg,lenet.svgиlenet-vert.svgперерисованы заново с русскими подписями по схемам оригинала (производные работы). Фотографии из игры «Где Вальдо?» в перевод не включены. - Код главы 7 взят из исходного репозитория (MIT-0): переведены комментарии, docstring и строки вывода; сами выражения не изменены.
- Иллюстрации главы 7:
alexnet.svg,vgg.svg,nin.svg,inception.svg,inception-full.svg,residual-block.svg,resnet-block.svg,resnet18.svg,functionclasses.svg,densenet.svgиdensenet-block.svgперерисованы заново с русскими подписями по схемам оригинала (производные работы). Иллюстрацияfilters.png(фильтры первого слоя AlexNet из статьи Krizhevsky et al., 2012) в перевод не включена: это рисунок стороннего издания. - Код главы 8 взят из исходного репозитория (MIT-0): переведены комментарии, docstring и строки вывода; сами выражения не изменены.
- Иллюстрации главы 8:
rnn.svg,rnn-train.svgиsequence-model.svgперерисованы заново с русскими подписями по схемам оригинала (производные работы).rnn-bptt.svg,truncated-bptt.svgиtimemachine-5gram.svgскопированы без изменений: на них только математические обозначения и английские примеры данных.ftse100.png(график индекса FTSE 100) взят из исходного репозитория без изменений; на нём остался английский заголовок «FTSE 100 Index». - Код глав 14 и 15 взят из исходного репозитория (MIT-0): переведены комментарии, docstring, строки вывода и подписи графиков; сами выражения не изменены.
- Иллюстрации главы 14:
nlp-map-pretrain.svg,elmo-gpt-bert.svgиbert-input.svgперерисованы заново с русскими подписями по схемам оригинала (производные работы).skip-gram.svg,cbow.svgиhi-softmax.svgскопированы без изменений: на них только английские слова и математические обозначения. - Иллюстрации главы 15:
nlp-map-app.svg,nlp-map-sa-rnn.svg,nlp-map-sa-cnn.svg,nlp-map-nli-attention.svg,nlp-map-nli-bert.svg,conv1d.svg,conv1d-2d.svg,conv1d-channel.svg,textcnn.svg,nli-attention.svg,bert-one-seq.svg,bert-two-seqs.svg,bert-tagging.svgиbert-qa.svgперерисованы заново с русскими подписями по схемам оригинала (производные работы). - Предисловие (
fm_preface.md), установка (fm_installation.md), обозначения (fm_notation.md), приложение (16_*.md) и список литературы (references.md) переведены по тому же исходному репозиторию. Файл16_06_d2l.mdсодержит примечания переводчика о разделах исходного репозитория, которых нет в этой книге. - Скриншоты страниц сторонних сайтов (Kaggle, рис. 13.13.1 и 13.14.1; Amazon) в перевод не включены: вместо них в тексте оставлено описание.
Производные материалы этой книги распространяются по лицензии CC BY-SA 4.0: с указанием авторства оригинала, со ссылкой на лицензию и с отметкой о внесённых изменениях; при переиздании — под той же лицензией.
Происхождение материалов и внесённые изменения описаны в файле PROVENANCE.md (в этой же папке). Условия использования — в файле LICENSE в папке книги и в тексте CC BY-SA 4.0.
Происхождение материалов
Источник
Материал основан на учебнике «Dive into Deep Learning» (动手学深度学习), репозиторий d2l-ai/d2l-zh. Текст лицензирован по CC BY-SA 4.0, код примеров — по MIT-0.
Что есть сейчас
-
Структура книги:
book.toml,meta.toml,NOTICE.md,PROVENANCE.md. -
Вступительная страница
src/README.mdс кратким описанием книги. -
Глава 1 «Введение»:
src/01_introduction.md(перевод всего главного текста, подписей, таблицы и списка литературы). -
Глава 2 «Предварительные знания»:
src/02_preliminaries.md(вступление) и семь разделовsrc/02_01_ndarray.md…src/02_07_lookup_api.md. Соответствие исходникам изchapter_preliminaries/:ndarray,pandas,linear-algebra,calculus,autograd,probability,lookup-api. -
Оглавление
src/SUMMARY.md. -
Иллюстрации главы 1 в
src/images/: пять схем перерисованы в SVG с русскими подписями, четыре фотографии взяты из исходного репозитория. -
Иллюстрации главы 2 в
src/images/:polygon-circle.svgиcat-dog-pixels.pngскопированы без изменений (текста на них нет). -
Глава 3 «Линейные нейронные сети»:
src/03_linear_networks.md(вступление) и семь разделовsrc/03_01_linear_regression.md…src/03_07_softmax_regression_concise.md. Соответствие исходникам изchapter_linear-networks/:linear-regression,linear-regression-scratch,linear-regression-concise,softmax-regression,image-classification-dataset,softmax-regression-scratch,softmax-regression-concise. Исходные файлы*_origin.md(английская версия) не использовались. -
Иллюстрации главы 3 в
src/images/:singleneuron.svg,softmaxreg.svg,neuron.svgперерисованы с русскими подписями;fit-linreg.svgскопирован без изменений.
Предисловие, установка, обозначения, приложение и список литературы переведены; общие изменения перечислены в разделе «Сквозные изменения» в конце файла.
- Глава 4 «Многослойные перцептроны»:
src/04_multilayer_perceptrons.md(вступление) и десять разделовsrc/04_01_mlp.md…src/04_10_kaggle_house_price.md. Соответствие исходникам изchapter_multilayer-perceptrons/:index,mlp,mlp-scratch,mlp-concise,underfit-overfit,weight-decay,dropout,backprop,numerical-stability-and-init,environment,kaggle-house-price. Исходные файлы*_origin.md(английская версия) не использовались. - Иллюстрации главы 4 в
src/images/:mlp.svg,dropout2.svg,capacity-vs-error.svg,cat-dog-train.svg,cat-dog-test.svgперерисованы или пересобраны с русскими подписями;forward.svgиpopvssoda.pngвзяты без изменений. - Глава 5 «Вычисления глубокого обучения»:
src/05_deep_learning_computation.md(вступление) и шесть разделовsrc/05_01_model_construction.md…src/05_06_use_gpu.md. Соответствие исходникам изchapter_deep-learning-computation/:model-construction,parameters,deferred-init,custom-layer,read-write,use-gpu. Исходные файлы*_origin.md(английская версия) не использовались. - Иллюстрации главы 5 в
src/images/:blocks.svgскопирован без изменений (текста на нём нет),copyto.svgперерисован с русской подписью. - Глава 6 «Свёрточные нейронные сети»:
src/06_convolutional_neural_networks.md(вступление) и шесть разделовsrc/06_01_why_conv.md…src/06_06_lenet.md. Соответствие исходникам изchapter_convolutional-neural-networks/:index,why-conv,conv-layer,padding-and-strides,channels,pooling,lenet. Исходные файлы*_origin.md(английская версия) не использовались. - Иллюстрации главы 6 в
src/images/:correlation.svg,conv-multi-in.svg,conv-1x1.svg,conv-pad.svg,conv-stride.svg,pooling.svg,lenet.svg,lenet-vert.svgперерисованы с русскими подписями; фотографии из игры «Где Вальдо?» не включены.
Глава 8: что изменено относительно оригинала
- Переведены вступление главы и разделы 8.1–8.7 (
src/08_*.md): модели последовательностей, предобработка текста, языковые модели и набор данных, рекуррентные нейронные сети, реализация с нуля, краткая реализация и обратное распространение через время (BPTT). Соответствие исходникам изchapter_recurrent-neural-networks/:index,sequence,text-preprocessing,language-models-and-dataset,rnn,rnn-scratch,rnn-concise,bptt. Исходные файлы*_origin.md(английская версия) не использовались. - Код не изменён: переведены комментарии, docstring и строки вывода
printи подписи графиков ('время','частота','эпоха','перплексия'). Разметка#@tabи:begin_tab:заменена подписями фреймворков; общий код (#@tab all) выведен без подписи, как в главах 2–6. - Ссылки Sphinx заменены обычным текстом:
:numref:→ «раздел 3.3», «рис. 8.4.1»;:eqref:→ «(8.7.3)»;:cite:→ «(Wu et al., 2017)». Нумерация формул и рисунков совпадает с книгой: формулы, которым в исходнике присвоена метка, пронумерованы по разделу (8.3.1, 8.4.1–8.4.4, 8.7.1–8.7.9). - Подписи в тексте: названия фильмов «Plan 9 from Outer Space» и «Troll 2» записаны полностью, как в исходнике; ссылки на Википедию и онлайн-приложение по теории информации сохранены.
- Иллюстрации:
- перерисованы заново с русскими подписями (производные работы):
rnn.svg(рис. 8.4.1),rnn-train.svg(рис. 8.4.2),sequence-model.svg(рис. 8.1.2); - скопированы без изменений:
rnn-bptt.svg(рис. 8.7.2),truncated-bptt.svg(рис. 8.7.1) иtimemachine-5gram.svg(рис. 8.3.1). На них только математические обозначения и английские данные примера, перевода не требуется; ftse100.png(рис. 8.1.1) скопирован без изменений. Это растровый график, на котором остался английский заголовок «FTSE 100 Index» и числовые оси; перерисовка потребует исходных данных, поэтому подпись не переведена.
- перерисованы заново с русскими подписями (производные работы):
Глава 7: что изменено относительно оригинала
- Переведены вступление главы и разделы 7.1–7.7 (
src/07_*.md): AlexNet, VGG, NiN, GoogLeNet, пакетная нормализация, ResNet и DenseNet. - Код не изменён: переведены комментарии, docstring и строки вывода
print. Разметка#@tabи:begin_tab:заменена подписями фреймворков (**MXNet:**и т. д.), как в главах 2–6. - Исправления по сравнению с исходником:
- в разделе 7.3 (NiN) исходный текст называет глобальный средний пулинг «суммированием по всем позициям»; в переводе сказано «усреднение», что соответствует самому слою;
- на схеме AlexNet в исходном
vgg.svgвсе три последних свёрточных слоя показаны с 384 каналами; в перерисованной схеме пятый свёрточный слой имеет 256 каналов, как в коде раздела 7.1.
- Иллюстрации перерисованы заново с русскими подписями (производные работы):
alexnet.svg,vgg.svg,nin.svg,inception.svg,inception-full.svg,residual-block.svg,resnet-block.svg,resnet18.svg,functionclasses.svg,densenet.svg,densenet-block.svg. Номера рисунков в тексте соответствуют книге.
Исключено из перевода
- Рис. 7.1.1 исходника (
filters.png, фильтры первого слоя AlexNet из статьи Krizhevsky et al., 2012): рисунок стороннего издания. В тексте оставлено описание и ссылка на статью.
Глава 6: что изменено относительно оригинала
- Вкладки фреймворков оформлены как в главах 2–5: жирная подпись фреймворка перед блоком кода (например, «PyTorch:», «MXNet, PyTorch, PaddlePaddle:»). Общий код (
#@tab all) выведен без подписи. Маркеры#@tabудалены, маркеры#@saveв коде оставлены. - Текст вкладок
:begin_tab:переведён в виде абзацев с жирной подписью фреймворка. Если текст относится к нескольким фреймворкам, подпись общая. - Ссылки Sphinx заменены обычным текстом: «рис. 6.2.1», «раздел 6.1.4.1», «формула (6.1.2)», «раздел 4.8». Номера формул (6.1.1)–(6.1.3) проставлены по помеченным уравнениям раздела 6.1, как в главах 3–4. Ссылка
:cite:оформлена как «(LeCun et al., 1998)»; список литературы приведён в разделе 6.6. - Маркеры выделения
[**…**]и(**…**)переведены в обычное полужирное выделение. Зачёркнутые фрагменты исходника (заголовок «1x1卷积» в разделе 6.4 и «卷积编码器和全连接层密集块» в разделе 6.6) не переносились. - Подписи в выводе программ и на графиках переведены:
эпоха,потери,точность,примеров/с,на. Легенды графиков: «потери (обучение)», «точность (обучение)», «точность (тест)». Имена функций, переменные и выражения не изменены. - Ссылки «Discussions» сохранены, по каждой вкладке оформлены как «Обсуждение» (как в главах 2–5).
- Опечатка в исходнике: в разделе 6.1.2 вместо написано «»; в переводе использовано .
- Иллюстрации
where-wally-walker-books.jpgиwaldo-mask.jpg(сцены из игры «Где Вальдо?») не включены в перевод: это иллюстрации стороннего издания. Вместо них в тексте оставлены подписи с пояснением (как рис. 1.6 в главе 1). - Схемы
correlation.svg,conv-multi-in.svg,conv-1x1.svg,conv-pad.svg,conv-stride.svg,pooling.svg,lenet.svgиlenet-vert.svgперерисованы заново с русскими подписями по схемам оригинала (производные работы). Числа на схемах совпадают с исходными и с текстом (например, 19, 25, 37, 43 в разделе 6.2 и 56, 72, 104, 120 в разделе 6.4). Наlenet.svgвход изображён пустой сеткой 28×28, без рукописной цифры.
Глава 4: что изменено относительно оригинала
- Вкладки фреймворков оформлены как в главах 2–3: жирная подпись фреймворка перед блоком кода (например, «PyTorch:», «MXNet, PyTorch:»). Общий код (
#@tab all) выведен без подписи. Маркер#@tabудалён, маркер#@saveв коде оставлен. - Текст вкладок
:begin_tab:(раздел 4.5.4) переведён в виде абзацев с жирной подписью фреймворка. - Ссылки Sphinx заменены обычным текстом: «рис. 4.1.1», «раздел 3.4.3», «формула (3.1.4)», «глава 3». Ссылки
:cite:оформлены как «(Zhang et al., 2021)», «(Srivastava et al., 2014)», «(Glorot and Bengio, 2010)» и т. д. Номера формул (4.7.1), (4.7.2) и (4.9.1)–(4.9.3) проставлены через\tag{}. - Маркеры выделения
[**…**]и(**…**)переведены в обычное полужирное выделение; для формул выделение убрано. В заголовках маркеров нет. - Вычеркнутое в исходнике предложение в разделе 4.5 («权重衰减是最广泛使用的正则化的技术之一») не переносилось.
- Подписи в выводе программ и на графиках переведены:
эпохи,потери,обучение,тест,вес,L2-норма w,Одна матрица,Фолд,log rmseи т. п. Имена функций, переменные и выражения не изменены. В главе 3 подписиAnimator(xlabel='epoch',legend=['train loss', …]) оставлены на английском; в главе 4 они переведены. При желании главу 3 можно привести к тому же виду. - Подписи к рисункам — текст под изображением, как в главах 1–3.
- Перерисованные схемы: в
mlp.svgиdropout2.svgматематические обозначения (x,h,o) оставлены как в исходнике, заменены только подписи слоёв и «До/После исключения». Вcapacity-vs-error.svgвсе подписи переведены, линии и стрелки сохранены. Вcat-dog-train.svgиcat-dog-test.svgподписи «cat» и «dog» заменены на «кошка» и «собака», фотографии сохранены.
Исключено из перевода
- Скриншоты страниц Kaggle (
kaggle.png,house-pricing.png,kaggle-submit2.png) — страницы стороннего сайта, по аналогии с рис. 1.6 главы 1 они не включены. В разделе 4.10 сохранены текстовые описания и ссылка на соревнование.
Глава 5: что изменено относительно оригинала
- Вкладки фреймворков оформлены как в главах 2–4: жирная подпись фреймворка перед блоком кода. Блоки
{.python .input}без#@tabвыведены с подписью «MXNet:». Общий код (#@tab all) выведен без подписи. Маркер#@tabудалён, маркер#@saveв коде оставлен. - Текст вкладок
:begin_tab:переведён в виде абзацев с жирной подписью. Если текст относится к нескольким фреймворкам, подпись общая, например «MXNet, TensorFlow:» или «PyTorch, PaddlePaddle:». - Ссылки Sphinx заменены обычным текстом: «рис. 5.1.1», «рис. 5.6.1», «раздел 2.5», «раздел 4.3», «раздел 4.8», «раздел 5.1», «раздел 12.1», «таблица 1.1». Ссылка
:cite:оформлена как «(He et al., 2016)»; список литературы в главе не приводится, как и в главе 4. - Маркеры выделения
[**…**]и(**…**)переведены в обычное полужирное выделение; в заголовках маркеров нет. Номера разделов и подразделов проставлены в заголовках, как в главе 4. - Подписи в выводе функций
my_init(раздел 5.2.2.2) переведены:Init→ «Инициализация». - Схема
copyto.svg: подпись «复制» заменена на «копирование», подписиgpu(0),gpu(1),X,Y,Zи+сохранены. Ширина схемы увеличена, чтобы подпись поместилась в зазор между блоками. - Выражения, имена функций и параметры в коде не изменены.
Замечания к исходнику, оставленные без изменений
- Раздел 5.2 (упражнение 1) ссылается на модель
FancyMLP, которой нет в разделе 5.1: там определеныMLP,FixedHiddenMLPиNestMLP. В переводе сохранено как в исходнике.
Глава 3: что изменено относительно оригинала
- Вкладки фреймворков оформлены так же, как в главе 2: жирная подпись с названиями фреймворков (например, «PyTorch:», «MXNet, PyTorch:»). Маркеры
#@tabудалены,#@tab allвыведен без подписи,#@saveоставлен в коде. - Текст вкладок
:begin_tab:(например, пояснения кnn.LinearиDenseв разделе 3.3) переведён в виде абзацев с жирной подписью фреймворка. - Ссылки Sphinx заменены обычным текстом: «рис. 3.1.2», «раздел 2.1.3», «глава 11», «формула (3.4.2)». Номера формул проставлены через
\tag{}для помеченных уравнений (3.1.1)–(3.1.4), (3.4.1)–(3.4.4). - Ссылки
:cite:оформлены как «(Russell and Norvig, 2016)», «(LeCun et al., 1998)», «(Xiao et al., 2017)», «(Zhang et al., 2021)». Список литературы поd2l.bibприведён в конце раздела 3.7. - Подписи к рисункам: в исходнике подписи — это альтернативный текст изображений; в переводе сохранён такой же подход, как в главе 2.
- Зачёркнутый в исходнике заголовок «Две функции для визуализации набора данных» (раздел 3.5) не переносился. Зачёркнутые слова «softmax» (раздел 3.7) и «之前» (раздел 3.7.4) тоже опущены.
- Наименования классов Fashion-MNIST переведены на русский (футболка, брюки, пуловер, платье, пальто, сандалия, рубашка, кроссовок, сумка, ботильон); они используются и в списке меток, и в подписях графиков.
- Строки вывода и подписи графиков (
эпоха,потери,среднее,ст. откл.,Ошибка оценки) переведены. Сами выражения и имена функций не изменены.
Замечания к исходнику, оставленные без изменений
- Раздел 3.4.1: соответствие классов и меток в исходнике противоречиво. Целочисленная кодировка даёт 1 = собака, 2 = кошка, 3 = курица, а прямое кодирование — (1, 0, 0) = кошка, (0, 1, 0) = курица, (0, 0, 1) = собака. В переводе оставлено как в исходнике; сверить с оригиналом.
- Раздел 3.5.3: функция
load_data_fashion_mnistвозвращает итератор «проверочной» (validation) выборки, хотя на деле это тестовый набор Fashion-MNIST. В переводе сохранено как в исходнике. - Раздел 3.6.4 и 3.7.2: ссылка на «трюк LogSumExp» ведёт на английскую Википедию; оставлена без изменений.
- Ссылка на приложение о распределениях и о теории информации (разделы 3.4.6.2 и 3.4.6.3) ведёт на английскую версию приложения на d2l.ai; оставлена без изменений.
Глава 2: что изменено относительно оригинала
- Вкладки фреймворков. В исходнике каждый фрагмент кода и текста помечен для MXNet, PyTorch, TensorFlow или PaddlePaddle (
#@tab,:begin_tab:). В переводе все четыре варианта сохранены, каждый помечен жирной подписью (например, «PyTorch:»). Общий код (#@tab all) выведен без подписи. Маркер#@tabудалён, маркер#@saveв коде оставлен, как в исходной книге. - Ссылки Sphinx заменены обычным текстом: «рис. 2.4.1», «раздел 2.3.10.1», «таблица 2.6.1», «формула (2.3.2)». Номера формул проставлены через
\tag{}для помеченных уравнений (2.3.1), (2.3.2), (2.4.1). - Ссылка
:cite:в разделе 2.3 оформлена как «(Strang, 1993; Kolter, 2008; Petersen and Pedersen, 2008)». Список литературы составлен поd2l.bib; в записи Kolter 2008 исходный URL неполный (http), поэтому указано «Available online». - Маркеры выделения
[**…**]и(**…**)из исходника переведены в обычное полужирное выделение**…**. - Таблицы 2.6.1 и 2.6.2 (тест на ВИЧ) получили подписи по нумерации книги. Подписи в исходнике оформлены как отдельная строка перед таблицей, здесь сохранено такое же расположение.
- Термин
插值法в разделе 2.2 переведён как «импутация» (заполнение пропусков): в контексте речь именно о замене пропусков, а не об интерполяции. - Замечания к исходнику, которые оставлены без изменений:
- ссылка «Discussions» для PaddlePaddle (
discuss.d2l.ai/t/11684) одинакова в разделах 2.4 и 2.5; вероятно, это опечатка в исходной книге, сверить с форумом; - в разделе 2.3.7 определение скалярного произведения повторено в зачёркнутой строке — сохранено как в исходнике.
- ссылка «Discussions» для PaddlePaddle (
- Служебные строки кода (
%matplotlib inline, импорты,npx.set_np(),warnings.filterwarnings) оставлены без изменений.
Что изменено относительно оригинала
- Схемы. В исходных SVG надписи хранятся как контуры глифов, поэтому их нельзя отредактировать. Схемы перерисованы с теми же раскладкой, цветами и стрелками, подписи набраны текстом. Исходные подписи расшифрованы из OmniGraffle-файлов исходного репозитория.
- Ссылки Sphinx (
:numref:,:cite:,:label:,:width:) заменены обычным текстом: «рис. 1.1», «таблица 1.1», «раздел 3.4», а ссылки на литературу — парами «автор, год» (например, «(Turing, 1950)»). - Список литературы составлен по записям
d2l.bibисходного репозитория; названия работ оставлены на языке оригинала. - Исправлены несогласованности и ошибки оригинала:
- год публикации набора данных ирисов Фишера: в тексте китайской версии указаны и 1936, и 1932 год; в переводе — 1936 (статья Фишера);
- TD-Gammon: в китайской версии сказано «五子棋» (гомоку), но речь идёт о программе для нард (backgammon); в переводе — нарды, как в английской версии и в цитируемой работе;
- «库图斯» в китайской версии соответствует программе Libratus (Brown and Sandholm, 2017); в переводе использовано название Libratus;
- ссылки на Википедию «Jacob\uBernoulli» и «Ronald_-Fisher» исправлены на «Jacob_Bernoulli» и «Ronald_Fisher»;
- «克莱德定律» переведено как закон Крайдера (Kryder’s law).
- Подписи к фотографиям и схемам переведены; подписи к таблице 1.1 и её заголовки приведены к русскому тексту.
- Код в главе 1 отсутствует; переведены только текстовые примеры (блоки
text).
Что не включено в перевод
- Рис. 1.6 (скриншот страницы Amazon с рекомендациями книг): изображение принадлежит стороннему сайту, поэтому вместо него в тексте оставлена подпись с пояснением.
- Англоязычные оригиналы глав (файлы
*_origin.md) — это не китайский текст книги. - Статические файлы сайта (
static/), исходники схем (graffle/), служебные скрипты сборки (ci/,.github/), файлы вкладов сообщества (contrib/).
Главы 9–12: что изменено относительно оригинала
- Переведены главы 9 «Современные рекуррентные нейронные сети», 10 «Механизмы внимания», 11 «Алгоритмы оптимизации» и 12 «Вычислительная производительность». Соответствие исходникам:
chapter_recurrent-modern/,chapter_attention-mechanisms/,chapter_optimization/,chapter_computational-performance/(только основные файлы,*_origin.mdне использовались). - Вкладки фреймворков оформлены жирной подписью перед блоком кода (
**MXNet:**,**PyTorch:**,**TensorFlow:**,**PaddlePaddle:**); общий код (#@tab all) выведен без подписи. Маркеры#@tabудалены,#@saveоставлен. - Ссылки Sphinx заменены обычным текстом: «рис. 12.2.1», «раздел 12.3», «таблица 12.4.1», формулы в скобках. Ссылки
:cite:оформлены как «(He et al., 2016)» и т. п.
Глава 12: замечания к исходнику
- 12.3: в тексте сказано « раз» умножения матриц, в коде функции
run—range(50). В переводе сохранено значение из кода (50) и сказано « раз». - 12.3, упражнение 1: сказано «восемь операций», хотя
runвыполняет 50 умножений. Оставлено как в исходнике. - 12.1: в исходнике опечатка
EargeTensor; в переводе записаноEagerTensor. - 12.4: в исходнике «Arste Asanovic» — в переводе «Krste Asanović».
Глава 12: иллюстрации
- Перерисованы заново с русскими подписями (производные работы):
frontends.svg(вместо растровогоfrontends.pngс логотипами, без логотипов),threading.svg,a77.svg,mobo-symbol.svg,neon128.svg,alexnet-original.svg(упрощённая схема двух GPU по мотивам исходной схемы AlexNet, не копия рисунка статьи),data-parallel.svg,splitting.svg,ps.svg,bw-hierarchy.svg,ps-distributed.svg,ps-multips.svg,ps-multimachine.svg. - Скопированы без изменений (на них только английские названия продуктов, код или математика, китайского текста нет):
asyncgraph.svg,computegraph.svg,twogpu.svg(фотографии процессоров и видеокарт из исходника сохранены),skylake.svg,falsesharing.svg,nvlink.svg,nvlink-twoloop.svg,ringsync.svg. - Не включены:
latencynumbers.png(инфографика стороннего автора с числами по мотивам лекции Джеффа Дина; данные приведены в таблицах 12.4.1 и 12.4.2 по исходнику),tensorcore.jpg,turing.png,turing-processing-block.png(иллюстрации производителя GPU, в тексте оставлены пояснения).
Глава 13: что изменено относительно оригинала
- Переведены вступление главы и разделы 13.1–13.14 (
src/13_*.md). Соответствие исходникам изchapter_computer-vision/:image-augmentation,fine-tuning,bounding-box,anchor,multiscale-object-detection,object-detection-dataset,ssd,rcnn,semantic-segmentation-and-dataset,transposed-conv,fcn,neural-style,kaggle-cifar10,kaggle-dog. Исходные файлы*_origin.md(английская версия) не использовались. - Вкладки фреймворков оформлены жирной подписью перед блоком кода (
**MXNet:**,**PyTorch:**,**TensorFlow:**,**PaddlePaddle:**, при общем коде —**PyTorch, PaddlePaddle:**и т. п.); общий код (#@tab all) выведен без подписи. Маркеры#@tabудалены,#@saveоставлен. - Ссылки Sphinx заменены обычным текстом: «рис. 13.2.1», «раздел 7.1», «таблица» и т. п. Ссылки
:cite:оформлены как «(Liu et al., 2016)» и т. п. - Подписи в коде, комментарии, docstring и подписи графиков переведены. Вывод
printи легенды графиков: «потери (обучение)», «точность (тест)», «эпоха» и т. п. Имена функций, переменные и выражения не изменены. - Зачёркнутые в исходнике заголовки (
[~~数据增广~~],[~~超参数~~]) не переносились. - Исправление в тексте: в разделе 13.1 ссылка на раздел об AlexNet переведена как раздел 7.1 (в исходнике
sec_alexnet).
Глава 13: иллюстрации
- Перерисованы заново с русскими подписями (производные работы):
anchor-label.svg,fcn.svg,finetune.svg,iou.svg,trans_conv.svg,trans_conv_stride2.svg,roi.svg,segmentation.svg,r-cnn.svg,fast-rcnn.svg,faster-rcnn.svg,mask-rcnn.svg,ssd.svg,neural-style.svg,style-transfer.svg. Фотографии (кошка и собака изcatdog.jpg, пейзажrainier.jpg, картинаautumn-oak.jpg) встроены в SVG в уменьшенном виде; так схемы отображаются корректно, когда mdBook загружает их как изображения. style-transfer.svgпоказывает только два входных изображения (содержимое и стиль). Синтезированный результат в книге не воспроизведён: он получается при запуске кода раздела 13.12 и не был взят из исходника.- Фотографии из
img/, которые нужны только коду (cat1.jpg,banana.jpg), скопированы вsrc/images/без изменений. - Не включены:
kaggle-cifar10.png(рис. 13.13.1) иkaggle-dog.jpg(рис. 13.14.1) — скриншоты страниц соревнований Kaggle, по аналогии с главой 4 в тексте оставлено описание.
Главы 14–15: что изменено относительно оригинала
- Переведены вступления и разделы 14.1–14.10 (
src/14_*.md) и 15.1–15.7 (src/15_*.md). Соответствие исходникам изchapter_natural-language-processing-pretraining/:word2vec,approx-training,word-embedding-dataset,word2vec-pretraining,glove,subword-embedding,similarity-analogy,bert,bert-dataset,bert-pretraining; и изchapter_natural-language-processing-applications/:sentiment-analysis-and-dataset,sentiment-analysis-rnn,sentiment-analysis-cnn,natural-language-inference-and-dataset,natural-language-inference-attention,finetuning-bert,natural-language-inference-bert. Файлы*_origin.md(английская версия) использовались только для сверки мест, где китайский перевод оказался искажён. - Вкладки фреймворков оформлены жирной подписью перед блоком кода (
**MXNet:**,**PyTorch:**,**PaddlePaddle:**, при общем коде —**MXNet, PyTorch:**и т. п.); общий код (#@tab all) выведен без подписи, а блок без пометки в исходнике — это вкладка MXNet. Маркеры#@tabудалены,#@saveоставлен. - Ссылки Sphinx заменены обычным текстом: «рис. 14.1.1», «раздел 14.8», «табл. 14.5.1»; ссылки на подразделы записаны как «подраздел «…» раздела N.M». К формулам с метками добавлены номера
\tag{14.1.1}. Ссылки:cite:оформлены как «(Mikolov et al., 2013b)»; две статьи Миколова 2013 года различены буквами a и b. В конце разделов с цитированием добавлен список «Литература». - Подписи в коде, комментарии, docstring, вывод
printи подписи графиков переведены; имена функций, переменные и выражения не изменены. Проверка: токены кода во всех блоках совпадают с исходником, различаются только строковые литералы.
Главы 14–15: замечания к исходнику
- 14.8: в исходнике особый токен назван «<seq>» вместо
<sep>; в переводе везде<sep>. - 14.9: в исходнике сказано, что функция
_pad_bert_inputs«добавляет специальные токены<mask>»; она дополняет входы токеном<pad>, в переводе так и сказано. - 14.6: в китайском тексте искажены примеры с символом
_(«a_all er_man»); по английскому оригиналу — «a_ tall er_ man» и «faster_», «taller_» разбиваются на «fast er_» и «tall er_». - 14.3, 14.6: в исходнике обрывочные комментарии (
# Exclude,# Readthetrainingset.) заменены законченными по смыслу. - 15.3: ссылка на несуществующую метку
subsec_multi-output-channelsзаменена ссылкой на подраздел «Несколько выходных каналов» раздела 6.4. - 15.4: в китайском тексте пример следования искажён («表白» — признание в любви); по английскому оригиналу гипотеза — «Две женщины проявляют нежность» (showing affection).
- 15.5: в пояснении к формуле (15.5.2) при в исходнике стоит индекс ; в переводе .
- 15.2: в версии для PaddlePaddle в исходнике
stop_gradient = Falseу весов вложений, хотя по тексту их не нужно обновлять, и опечатка"weigth"в условии инициализации; код оставлен без изменений.
Главы 14–15: иллюстрации
- Перерисованы заново с русскими подписями (производные работы):
nlp-map-pretrain.svg,nlp-map-app.svg,nlp-map-sa-rnn.svg,nlp-map-sa-cnn.svg,nlp-map-nli-attention.svg,nlp-map-nli-bert.svg,elmo-gpt-bert.svg,bert-input.svg,bert-one-seq.svg,bert-two-seqs.svg,bert-tagging.svg,bert-qa.svg,conv1d.svg,conv1d-2d.svg,conv1d-channel.svg,textcnn.svg,nli-attention.svg. Английские примеры внутри схем («i do need sleep», «a model loading and inference api…») сохранены. На схемеnlp-map-nli-attention.svgподписи архитектур выровнены с остальными схемами (в оригинале они английские: MLP, CNN, RNN, Attention). - Скопированы без изменений (на них только английские слова и математика):
skip-gram.svg,cbow.svg,hi-softmax.svg.
Сквозные изменения
- Нумерация. Подписи рисунков — «Рис. N.M.k. …», таблиц — «Таблица N.M.k. …». Формулы с метками переведены в
\tag{N.M.k}. Ссылки Sphinx:numref:и:eqref:заменены на «рис. N.M.k», «раздел N.M», «формула (N.M.k)». - Литература.
:cite:заменён на «(Автор et al., год)». Сводный списокsrc/references.mdсобран из разделов «Литература» глав (155 записей). Записи, которых не было в списках глав, добавлены в разделы, где на них есть ссылка, по библиографииd2l.bibисходного репозитория (авторы и названия оставлены на языке оригинала). - Обсуждения. Ссылки на форум сохранены в виде
[Обсуждение](…). Для нескольких фреймворков используется отдельная строка**FW:**. - Вкладки фреймворков. Подписи
**MXNet:**,**PyTorch:**,**TensorFlow:**,**PaddlePaddle:**ставятся перед блоком кода. Общий код (#@tab all) выведен без подписи. Маркеры#@saveсохранены. - Терминология. «Прямое распространение» вместо «прямой проход». «Подавление немаксимумов» вместо «не-максимальное подавление». «Дообучение» вместо «тонкая настройка». «Минибатч» и «пакетное матричное умножение» — единые термины по всей книге.
- Код. Переведены комментарии, строки вывода, docstring и подписи графиков. Выражения, имена переменных и функций не изменены.
- Исключено из перевода. Скриншоты страниц сторонних сайтов (Kaggle в главе 13, Amazon в главе 16), фотографии из игры «Где Вальдо?» (глава 6),
filters.png(рис. 7.1.1, статья Krizhevsky et al., 2012).ftse100.png(глава 8) оставлен с английским заголовком, так как перерисовка требует исходных данных. - Исправления ошибок исходника. В разделе 7.3 слово «суммирование» заменено на «усреднение», как в самом слое. На схеме AlexNet пятый свёрточный слой показан с 256 каналами, как в коде раздела 7.1. В разделе 15.6.3 тег части речи для глагола «is» исправлен с
VBнаVBZ. Итоговый список исправлений приведён в описании глав выше. - Проверки.
scripts/check_books.pyиscripts/check_links.pyпроходят без ошибок. Перекрёстная проверка «(Автор, год)» ↔ список литературы — без пропусков, кроме одной ссылки в предисловии, где в тексте стоит «Bollobas», а в списке — «Bollobás».
Отображение на сайте
- Подряд идущие блоки кода для разных фреймворков (MXNet, PyTorch, TensorFlow, PaddlePaddle) на сайте показаны вкладками. В исходных
.mdфайлах они остаются отдельными блоками с подписями «PyTorch:» и т. д.; вкладки создаёт препроцессорscripts/mdbook_framework_tabs.pyпри сборке. Выбранный фреймворк запоминается в браузере (по умолчанию PyTorch). - Подписи, за которыми следует текст, а не код, остаются обычными абзацами: в исходниках не отмечено, где такой вариант заканчивается.
- Формулы
\tilde{...}записаны как\widetilde{...}: KaTeX выводит для\tildeзнак «~», который mdBook принимает за зачёркивание.