2.6 Вероятность
Попросту говоря, машинное обучение — это предсказание.
Например, по клинической истории пациента мы можем захотеть предсказать вероятность того, что у него случится сердечный приступ в следующем году. При обнаружении аномалий в работе реактивного двигателя самолёта мы хотим оценить, насколько вероятно, что набор показаний двигателя соответствует нормальной работе. В обучении с подкреплением мы хотим, чтобы агент (agent) разумно действовал в среде. Это означает, что нужно учитывать вероятность получить высокую награду при каждом из возможных действий. При построении рекомендательных систем тоже нужно учитывать вероятности. Например, если мы работаем в большом интернет-магазине книг, нам может понадобиться оценить вероятность того, что определённый пользователь купит определённую книгу. Для этого нам нужна теория вероятностей. Существуют целые курсы, специализации, научные статьи, профессии и даже факультеты, посвящённые теории вероятностей. Поэтому цель этого раздела — не изучить всю дисциплину целиком. Скорее, мы хотим дать читателю базовые сведения о вероятности, чтобы он мог начать строить первые модели глубокого обучения и самостоятельно их исследовать.
Теперь рассмотрим более внимательно первый пример: различение кошек и собак по фотографиям. На первый взгляд это может казаться простой задачей, но для машины она может оказаться серьёзным испытанием. Прежде всего, сложность задачи может зависеть от разрешения изображения.
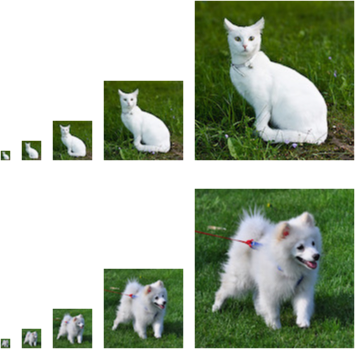
Рис. 2.6.1. Изображения разного разрешения (, , , и пикселей)
Как видно на рис. 2.6.1, хотя человек легко распознаёт кошек и собак при разрешении пикселей, при пикселях это становится трудной задачей, а при пикселях почти невозможно. Иначе говоря, наша способность различать кошек и собак на большом расстоянии (а значит, при меньшем разрешении) может превратиться в простое угадывание. Теория вероятностей даёт нам формальный способ выразить степень нашей уверенности. Если мы полностью уверены, что на изображении кошка, то вероятность того, что метка — «кошка», то есть , равна . Если у нас нет никаких доказательств того, что или , то можно считать эти два варианта равновероятными: . Если мы не очень уверены, что на изображении кошка, можно приписать вероятности значение .
Теперь второй пример: по данным метеонаблюдений мы хотим предсказать вероятность того, что завтра в Пекине будет дождь. Если сейчас лето, вероятность дождя равна 0,5.
В обоих случаях результат нам неизвестен, но между ними есть ключевое различие. В первом случае изображение на самом деле либо кошка, либо собака. Во втором результат действительно является случайным событием. Таким образом, вероятность — гибкий язык для выражения степени нашей уверенности, и его можно эффективно применять в самых разных областях.
2.6.1 Основы теории вероятностей
Допустим, мы бросаем кубик и хотим узнать, какова вероятность выпадения единицы, а не какого-либо другого числа. Если кубик честный, то все шесть исходов равновозможны, и поэтому можно сказать, что вероятность выпадения равна .
Однако для реального кубика, полученного с завода, нужно проверить, нет ли в нём дефекта. Единственный способ сделать это — бросить его много раз и записать результаты. Каждый бросок даёт одно значение из . Для каждого значения естественный способ — разделить число его появлений на общее число бросков. Так мы получаем оценку вероятности этого события (event). Закон больших чисел (law of large numbers) утверждает: по мере увеличения числа бросков эта оценка будет всё ближе к истинной вероятности. Попробуем это на коде!
Сначала импортируем необходимые пакеты.
MXNet:
%matplotlib inline
from d2l import mxnet as d2l
from mxnet import np, npx
import random
npx.set_np()
PyTorch:
%matplotlib inline
from d2l import torch as d2l
import torch
from torch.distributions import multinomial
TensorFlow:
%matplotlib inline
from d2l import tensorflow as d2l
import tensorflow as tf
import tensorflow_probability as tfp
import numpy as np
PaddlePaddle:
%matplotlib inline
from d2l import paddle as d2l
import warnings
warnings.filterwarnings("ignore")
import paddle
import random
import numpy as np
В статистике процесс извлечения выборки из распределения вероятностей называют выборкой (sampling). Грубо говоря, распределение (distribution) можно считать присвоением вероятностей событиям; более строгое определение мы дадим позже. Распределение, которое присваивает вероятности некоторому набору дискретных вариантов, называют мультиномиальным распределением (multinomial distribution).
Чтобы извлечь выборку, то есть бросить кубик, достаточно передать вектор вероятностей. Результат — другой вектор той же длины: его значение с индексом — это число раз, когда в выборке выпал исход .
MXNet:
fair_probs = [1.0 / 6] * 6
np.random.multinomial(1, fair_probs)
PyTorch:
fair_probs = torch.ones([6]) / 6
multinomial.Multinomial(1, fair_probs).sample()
TensorFlow:
fair_probs = tf.ones(6) / 6
tfp.distributions.Multinomial(1, fair_probs).sample()
PaddlePaddle:
fair_probs = [1.0 / 6] * 6
paddle.distribution.Multinomial(1, paddle.to_tensor(fair_probs)).sample()
Когда мы оцениваем честность кубика, нужно сгенерировать много выборок из одного и того же распределения.
Если делать это циклом for на Python, работа будет невероятно медленной.
Поэтому мы используем функции фреймворка глубокого обучения, которые извлекают сразу несколько выборок и возвращают независимые выборки нужной формы.
MXNet:
np.random.multinomial(10, fair_probs)
PyTorch:
multinomial.Multinomial(10, fair_probs).sample()
TensorFlow:
tfp.distributions.Multinomial(10, fair_probs).sample()
PaddlePaddle:
paddle.distribution.Multinomial(10, paddle.to_tensor(fair_probs)).sample()
Теперь, когда мы умеем извлекать выборки для кубика, можно смоделировать 1000 бросков. Затем подсчитаем, сколько раз выпала каждая грань. Конкретно: вычислим относительные частоты, которые и будут оценками истинных вероятностей.
MXNet:
counts = np.random.multinomial(1000, fair_probs).astype(np.float32)
counts / 1000
PyTorch:
# Сохраняем результаты как 32-битные числа с плавающей точкой для деления
counts = multinomial.Multinomial(1000, fair_probs).sample()
counts / 1000  # Относительная частота как оценка
TensorFlow:
counts = tfp.distributions.Multinomial(1000, fair_probs).sample()
counts / 1000
PaddlePaddle:
counts = paddle.distribution.Multinomial(1000, paddle.to_tensor(fair_probs)).sample()
counts / 1000
Поскольку данные получены с честного кубика, мы знаем, что истинная вероятность каждого исхода равна , примерно , поэтому оценки, полученные выше, выглядят разумно.
Мы также можем увидеть, как эти вероятности со временем сходятся к истинным. Проведём 500 групп экспериментов, в каждой из которых возьмём по 10 выборок.
MXNet:
counts = np.random.multinomial(10, fair_probs, size=500)
cum_counts = counts.astype(np.float32).cumsum(axis=0)
estimates = cum_counts / cum_counts.sum(axis=1, keepdims=True)

d2l.set_figsize((6, 4.5))
for i in range(6):
    d2l.plt.plot(estimates[:, i].asnumpy(),
                 label=("P(кубик=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Группы экспериментов')
d2l.plt.gca().set_ylabel('Оценка вероятности')
d2l.plt.legend();
PyTorch:
counts = multinomial.Multinomial(10, fair_probs).sample((500,))
cum_counts = counts.cumsum(dim=0)
estimates = cum_counts / cum_counts.sum(dim=1, keepdims=True)

d2l.set_figsize((6, 4.5))
for i in range(6):
    d2l.plt.plot(estimates[:, i].numpy(),
                 label=("P(кубик=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Группы экспериментов')
d2l.plt.gca().set_ylabel('Оценка вероятности')
d2l.plt.legend();
TensorFlow:
counts = tfp.distributions.Multinomial(10, fair_probs).sample(500)
cum_counts = tf.cumsum(counts, axis=0)
estimates = cum_counts / tf.reduce_sum(cum_counts, axis=1, keepdims=True)

d2l.set_figsize((6, 4.5))
for i in range(6):
    d2l.plt.plot(estimates[:, i].numpy(),
                 label=("P(кубик=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Группы экспериментов')
d2l.plt.gca().set_ylabel('Оценка вероятности')
d2l.plt.legend();
PaddlePaddle:
counts = paddle.distribution.Multinomial(10, paddle.to_tensor(fair_probs)).sample((500,1))
cum_counts = counts.cumsum(axis=0)
cum_counts = cum_counts.squeeze(axis=1)
estimates = cum_counts / cum_counts.sum(axis=1, keepdim=True)

d2l.set_figsize((6, 4.5))
for i in range(6):
    d2l.plt.plot(estimates[:, i],
                 label=("P(кубик=" + str(i + 1) + ")"))
d2l.plt.axhline(y=0.167, color='black', linestyle='dashed')
d2l.plt.gca().set_xlabel('Группы экспериментов')
d2l.plt.gca().set_ylabel('Оценка вероятности')
d2l.plt.legend()
Каждая сплошная линия соответствует одной из шести граней кубика и показывает оценку вероятности выпадения этой грани после каждой группы экспериментов. По мере того как мы получаем больше данных, эти 6 кривых сходятся к истинным вероятностям.
2.6.1.1 Аксиомы теории вероятностей
В случае с бросанием кубика множество называют пространством выборки (sample space) или пространством исходов (outcome space), а каждый его элемент — исходом (outcome). Событие (event) — это набор исходов из пространства выборки. Например, «выпала » () и «выпало нечётное число» () — допустимые события при бросании кубика. Заметим, что если исход случайного эксперимента принадлежит , то событие произошло. То есть если выпала , то, поскольку , можно сказать, что событие «выпало нечётное число» произошло.
Вероятность (probability) можно рассматривать как функцию, которая сопоставляет множествам действительные значения. В заданном пространстве выборки вероятность события , обозначаемая , обладает следующими свойствами:
- для любого события его вероятность никогда не бывает отрицательной: ;
- вероятность всего пространства выборки равна : ;
- для любой счётной последовательности несовместных (mutually exclusive) событий , то есть таких, что для всех , вероятность того, что произойдёт одно из них, равна сумме их вероятностей: .
Перечисленные свойства — аксиомы теории вероятностей, которые предложил Колмогоров в 1933 году. С помощью этой системы аксиом можно обойти философские споры о случайности и вместо этого строго рассуждать на языке математики. Например, пусть событие — всё пространство выборки, а для всех выполнено . Тогда можно доказать, что , то есть вероятность невозможного события равна .
2.6.1.2 Случайные величины
В нашем эксперименте с бросанием кубика мы ввели понятие случайной величины (random variable). Случайная величина может быть почти любой величиной, и она принимает одно из значений, возможных в случайном эксперименте. Рассмотрим случайную величину , значения которой принадлежат пространству выборки кубика . Событие «выпала » можно записать как или , а его вероятность — как или . Записью мы отличаем случайную величину от значений , которые она может принимать. Однако такая запись может быть громоздкой. Чтобы упростить обозначения, с одной стороны, можно записывать как распределение (distribution) случайной величины : оно сообщает, с какой вероятностью принимает то или иное значение. С другой стороны, можно просто писать для вероятности того, что случайная величина принимает значение . Поскольку события в теории вероятностей — это наборы исходов из пространства выборки, можно задавать диапазоны значений случайной величины. Например, обозначает событие , то есть вероятность того, что принимает значение , или . Эквивалентно, — это вероятность того, что случайная величина принимает значения из .
Обратите внимание на различие между дискретными (discrete) случайными величинами (например, гранями кубика) и непрерывными (continuous) случайными величинами (например, весом и ростом человека). В реальной жизни не имеет особого смысла измерять, совпадает ли рост двух людей в точности. Если производить измерения достаточно точно, окажется, что на Земле нет двух людей с одинаковым ростом. В таких случаях осмысленнее спрашивать, попадает ли рост человека в заданный интервал, например между 1,79 м и 1,81 м. В подобных ситуациях возможность получить то или иное значение выражают через плотность (density). Вероятность того, что рост в точности равен 1,80 м, равна 0, но плотность не равна 0. На любом интервале между двумя разными ростами вероятность ненулевая. В оставшейся части раздела мы будем рассматривать вероятности в дискретном пространстве. Вероятности непрерывных случайных величин можно найти в разделе о случайных величинах математического приложения к книге.
2.6.2 Работа с несколькими случайными величинами
Во многих случаях нам приходится рассматривать несколько случайных величин. Например, нам может понадобиться смоделировать связь между болезнями и симптомами. Для заданной болезни и симптома, например «грипп» и «кашель», у пациента каждое из них с некоторой вероятностью присутствует или отсутствует. Нам нужно оценить эти вероятности и связи между ними, чтобы использовать выводы для улучшения медицинской помощи.
Ещё более сложный пример: изображение содержит миллионы пикселей, а значит, миллионы случайных величин. Во многих случаях к изображению прилагается метка (label), указывающая объект на изображении; метку тоже можно рассматривать как случайную величину. Можно даже считать случайными величинами все метаданные: положение, время, диафрагму, фокусное расстояние, ISO, расстояние фокусировки и тип камеры. Все эти величины случайны и встречаются совместно. Когда мы работаем с несколькими случайными величинами, нас интересует сразу несколько из них.
2.6.2.1 Совместная вероятность
Первое понятие — совместная вероятность (joint probability) . Для любых значений и совместная вероятность отвечает на вопрос: какова вероятность того, что одновременно выполняются и ? Заметим, что для любых значений и выполняется . Это очевидно: чтобы одновременно произошли и , должно произойти , и должно произойти (и наоборот). Поэтому вероятность одновременного наступления и не превышает вероятности наступления каждого из этих событий по отдельности.
2.6.2.2 Условная вероятность
Из неравенства для совместной вероятности следует интересное соотношение: . Это отношение называют условной вероятностью (conditional probability) и обозначают : это вероятность того, что , при условии, что уже произошло.
2.6.2.3 Теорема Байеса
Из определения условной вероятности можно вывести одно из самых полезных уравнений статистики — теорему Байеса (Bayes’ theorem). По правилу умножения (multiplication rule) имеем . По симметрии получаем . Предполагая, что , и выражая одну из условных вероятностей, получаем
Здесь мы используем компактную запись: — совместное распределение (joint distribution), а — условное распределение (conditional distribution). Такое распределение можно вычислить при заданных значениях .
2.6.2.4 Маргинализация
Чтобы складывать вероятности событий, нужно правило суммы (sum rule): вероятность равна сумме совместных вероятностей со всеми возможными значениями :
Это называется маргинализацией (marginalization). Вероятность или распределение, полученное в результате маргинализации, называют маргинальной вероятностью (marginal probability) или маргинальным распределением (marginal distribution).
2.6.2.5 Независимость
Другое полезное свойство — зависимость (dependence) и независимость (independence). Если две случайные величины и независимы, то наступление события не зависит от наступления события . В этом случае статистики обычно записывают . По теореме Байеса сразу получаем и . Во всех остальных случаях мы называем и зависимыми. Например, два последовательных броска кубика — независимые события. В отличие от них, положение выключателя и яркость комнаты не независимы (потому что возможны перегорание лампочки, перебой электропитания или поломка выключателя).
Поскольку равносильно , две случайные величины независимы тогда и только тогда, когда их совместное распределение равно произведению их отдельных распределений. Аналогично, при заданной третьей случайной величине две величины и условно независимы (conditionally independent) тогда и только тогда, когда . Это записывают как .
2.6.2.6 Применение
Разберём пример! Предположим, врач проводит пациенту тест на ВИЧ (вирус иммунодефицита человека). Тест довольно точен: если пациент здоров, вероятность ложного положительного результата составляет всего 1%; если пациент действительно инфицирован ВИЧ, тест никогда не даёт отрицательного результата. Обозначим через результат диагностики ( — положительный, — отрицательный), а через — статус ВИЧ-инфекции ( — инфицирован, — нет). Условные вероятности приведены в таблице 2.6.1.
Таблица 2.6.1. Условная вероятность
| Условная вероятность | ||
|---|---|---|
| 1 | 0.01 | |
| 0 | 0.99 |
Заметим, что сумма по каждому столбцу равна 1 (а по строкам — нет), поскольку условные вероятности, как и вероятности, должны в сумме давать 1. Вычислим вероятность того, что пациент инфицирован ВИЧ, если тест положителен, то есть . Очевидно, что ответ зависит от того, насколько распространено заболевание, поскольку это влияет на число ложных срабатываний. Предположим, что население в целом здорово, например . Чтобы применить теорему Байеса, нужно с помощью маргинализации и правила умножения найти
Значит,
Иными словами, несмотря на очень точный тест, вероятность того, что пациент действительно инфицирован ВИЧ, составляет лишь 13,06%. Как видим, вероятности могут противоречить интуиции.
Что делать пациенту после такого тревожного известия? Скорее всего, он попросит врача провести повторный тест, чтобы уточнить диагноз. Второй тест обладает другими характеристиками: он не так точен, как первый, как показано в таблице 2.6.2.
Таблица 2.6.2. Условная вероятность
| Условная вероятность | ||
|---|---|---|
| 0.98 | 0.03 | |
| 0.02 | 0.97 |
К сожалению, второй тест тоже даёт положительный результат. Вычислим необходимые вероятности для применения теоремы Байеса, предполагая условную независимость:
Теперь можно применить маргинализацию и правило умножения:
Наконец, при двух положительных тестах вероятность того, что пациент инфицирован, равна
Таким образом, второй тест позволяет с большей уверенностью судить о наличии заболевания. Хотя второй тест гораздо менее точен, чем первый, он всё же заметно повышает наш прогноз вероятности.
2.6.3 Математическое ожидание и дисперсия
Чтобы охарактеризовать основные свойства распределения вероятностей, нужны количественные меры. Математическое ожидание (expectation, или среднее значение (average)) случайной величины записывается как
Если аргумент функции — случайная величина, взятая из распределения , то математическое ожидание равно
Во многих случаях нам хочется измерить, насколько случайная величина отклоняется от своего математического ожидания. Это можно выразить через дисперсию (variance):
Квадратный корень из дисперсии называют стандартным отклонением (standard deviation). Дисперсия функции случайной величины показывает, насколько значения функции отклоняются от её математического ожидания при выборке различных значений из распределения случайной величины:
Резюме
- Из распределения вероятностей можно извлекать выборки.
- Для анализа нескольких случайных величин можно использовать совместные распределения, условные распределения, теорему Байеса, маргинализацию и предположения о независимости.
- Математическое ожидание и дисперсия — практичные меры, с помощью которых можно обобщённо описать ключевые характеристики распределений вероятностей.
Упражнения
- Проведите групп экспериментов, в каждой из которых берётся выборок. Меняйте и , наблюдайте и анализируйте результаты экспериментов.
- Даны два события с вероятностями и . Вычислите верхнюю и нижнюю границы для и . (Подсказка: используйте диаграмму Венна, чтобы показать эти случаи.)
- Предположим, что у нас есть последовательность случайных величин, например , и , где зависит только от , а зависит только от . Можно ли упростить совместную вероятность ? (Подсказка: это цепь Маркова.)
- В разделе 2.6.2.6 первый тест точнее. Почему бы не провести первый тест дважды вместо того, чтобы проводить первый и второй тесты?
MXNet: Обсуждение
PyTorch: Обсуждение
TensorFlow: Обсуждение
PaddlePaddle: Обсуждение